目录
1. 什么是 A* 搜索算法?
A* (读作“A 星”)是一种最佳优先的图搜索算法,用于找到从起始节点到目标节点的最小代价路径。在人工智能中,它被归类为有信息搜索:广度优先搜索和一致代价搜索只知道已经付出的代价,而 A* 还会利用对剩余代价的估计。
A* 在边界中保存的每个节点都带有三个数值:
- g(n):从起始节点到
n的目前已找到的最佳路径的精确代价。 - h(n):即启发式函数,估计从
n到目标的最低代价。 - f(n) = g(n) + h(n):经过
n的最便宜完整解的估计代价。
算法反复扩展边界中 f值最小的节点。正是这一条规则带来了 A* 最著名的性质:如果启发式函数从不高估真实的剩余代价,那么 A* 从边界中取出的第一个目标节点一定位于最优路径上。
这个定义中没有任何地方提到网格或电子游戏。A* 定义在任意边代价非负的带权图上。这个图可以是道路网络、瓦片地图、滑块拼图的状态空间、机器人的构型空间,或者自动规划器中的部分计划集合。网格寻路只是最容易画出来的例子,它在配套指南网格上的 A* 寻路中有详细介绍。
2. A* 的由来:Hart、Nilsson 与 Raphael(1968)
斯坦福研究所的 Peter E. Hart、Nils J. Nilsson 和 Bertram Raphael 发表了论文 "A Formal Basis for the Heuristic Determination of Minimum Cost Paths",刊登于 IEEE Transactions on Systems Science and Cybernetics第 4 卷第 2 期,第 100 至 107 页,1968 年 7 月。其现实动机是 SRI 的移动机器人 Shakey,它需要自行规划穿过一组房间的路线,而不是沿着预设轨道行进。
这篇论文的两项贡献至今仍在定义这一领域:
- 它把搜索过程与其中的知识分离开来。同一个循环会因为你交给它的
h不同而变成不同的算法。搜索策略从设计决策变成了一个参数。 - 它证明了相应的保证。如果
h从不高估真实的剩余代价,该过程就会返回一条最小代价路径。一个配套结论表明,任何能获得相同启发式信息的算法,都不可能在保证最优性的同时扩展更少的节点。
这个名字是一段留存下来的记号。1968 年的论文用星号标记最优量:g* 是从起点到某个节点的最小代价,h* 是从该节点到目标的最小代价,f* 是两者之和。不带星号的过程称为 A,而 A* 是达到这些最优量的那个版本,也就是启发函数从不高估 h* 的那个版本。它不是缩写,也不代表任何词。
1972 年发表在 SIGART Newsletter 上的一则短文修正了原始的最优性论证。1968 年的证明依赖于作者所称的一致性假设,而这次修正明确指出了当启发式可采纳但不一致时必须做出的改变:必须允许重新打开已经扩展过的节点。这一区别正是下文第 6 节的主题,时隔五十多年,它仍然是 A* 实现悄无声息出错的最常见根源。
如果你是为了引用而来:Hart, P. E., Nilsson, N. J., and Raphael, B. (1968). "A Formal Basis for the Heuristic Determination of Minimum Cost Paths." IEEE Transactions on Systems Science and Cybernetics 4(2), 100 至 107。
3. 评估函数 f(n) = g(n) + h(n)
A* 所做的一切都源于它如何对边界排序。评估函数把对一个解的估计拆成精确已知的部分和猜测的部分:
f(n) = g(n) + h(n)

g(n)   已付出的代价     精确值,沿实际走过的路径测量
h(n)   尚需付出的代价   由启发式函数估计
f(n)   总估计           优先队列据以排序的值
这种设计的价值在于,一个组成部分就能控制搜索的全部行为:
- 处处 h(n) = 0。此时
f = g,A* 退化为一致代价搜索,而在非负权图上它恰好就是 Dijkstra 算法。正确,但缺乏信息:它会向所有方向扩展每一个比目标更便宜的节点。 - h(n) = h*(n),即真实的剩余代价。A* 会沿着最优路径笔直前进,几乎不扩展其他任何节点。这是理论上限,但在实践中无法达到,因为计算
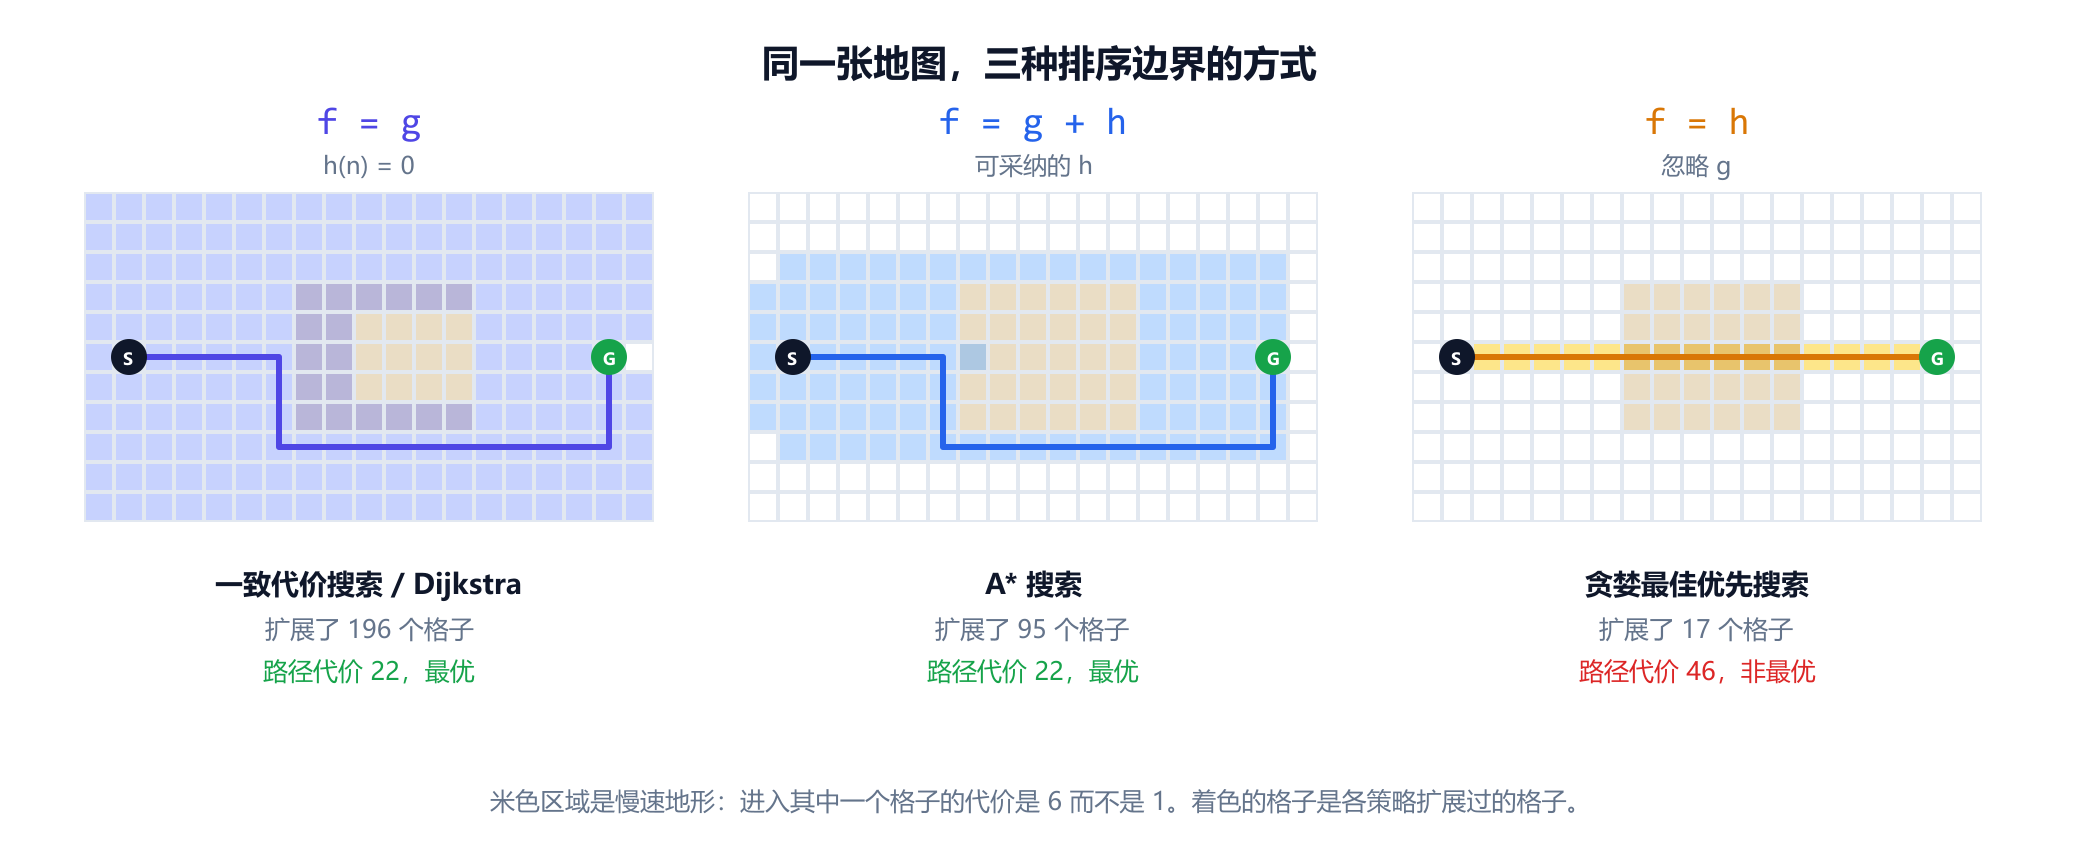
h*本身就是你想要解决的问题。 - 忽略 g,只按 h 排序。这就是贪婪最佳优先搜索。它很快,经常错得很离谱,而且没有任何最优性保证。
- 重新加权:f = g + w × h,其中 w > 1。加权 A* 以有限的解质量损失换取大幅的速度提升。它返回的路径代价绝不会超过最优代价的
w倍。
可以把这份列表看作你对估计值信任程度的刻度。A* 处在中间,启发式函数知道得越少,它投入的工作量就越多:精确的启发式产生一条近似直线的搜索,而弱的启发式产生一个看起来像 Dijkstra 的搜索。
4. A* 如何逐步运行
边界是一个优先队列,传统上称为 OPEN,按 f排序。再加上一张记录已知最佳 g 值的表和一张父指针表,就构成了完整的状态。
function a_star(start, goal, h):
    open   = priority queue ordered by f        # 边界
    g      = map with default infinity          # 从起点出发的已知最佳代价
    parent = map                                # 用于重建路径

    g[start] = 0
    open.push(start, h(start))

    while open is not empty:
        current = open.pop_min()                # f 最小的节点
        if current == goal:
            return reconstruct(parent, goal)    # 在出队时测试目标,而不是在生成时

        for (next, cost) in edges(current):
            tentative = g[current] + cost
            if tentative < g[next]:             # 找到一条到 next 的更便宜路线
                g[next]      = tentative
                parent[next] = current
                open.push_or_update(next, tentative + h(next))

    return failure                              # 目标不可达
四个实现细节承载了大部分微妙之处:
- 目标测试发生在节点出队时,而不是生成时。目标可能很早就沿一条昂贵的路线被生成。在那一刻返回,你得到的是一条路径,但不是最便宜的那条。下面的计算示例中就有这样一个情况:在生成时测试目标,会在最优代价 13 之外多花 7 个单位。
- 松弛操作由
tentative < g[next]把关,而不是由是否属于关闭集决定。这样写之后,当之后出现一条通往已扩展节点的更便宜路线时,循环会自动重新打开该节点,这正是它对任何可采纳启发式都正确的原因。 - 大多数优先队列没有减小键值(decrease key)操作。生产代码通常会压入一个带有更优
f值的重复条目,并在过期条目出队时将其丢弃。这称为惰性删除:它多占一点内存,却省去了大量簿记工作。 - 路径是反向恢复的。从目标沿父指针回溯到起点,再把列表反转。A* 从不存储路径,每个节点只存一个父节点。
5. 带权图上的完整计算示例
网格动画掩盖了其中的算术。下面是一个 AI 课程中常用的小型带权图,我们从头到尾手工推演一遍。
六个节点: S (起点)、 A、 B、 C、 D 和 G (目标)。边的代价是道路距离,启发式函数 h 是到 G的直线距离,这正是它可采纳的原因:直线永远不会比道路更长。
边 (无向, 代价)               启发式 h(n)
S-A  4      A-C  5            S = 11    C = 5
S-B  3      A-D  12           A =  9    D = 3
S-G  20     B-D  7            B =  8    G = 0
C-G  6      D-G  3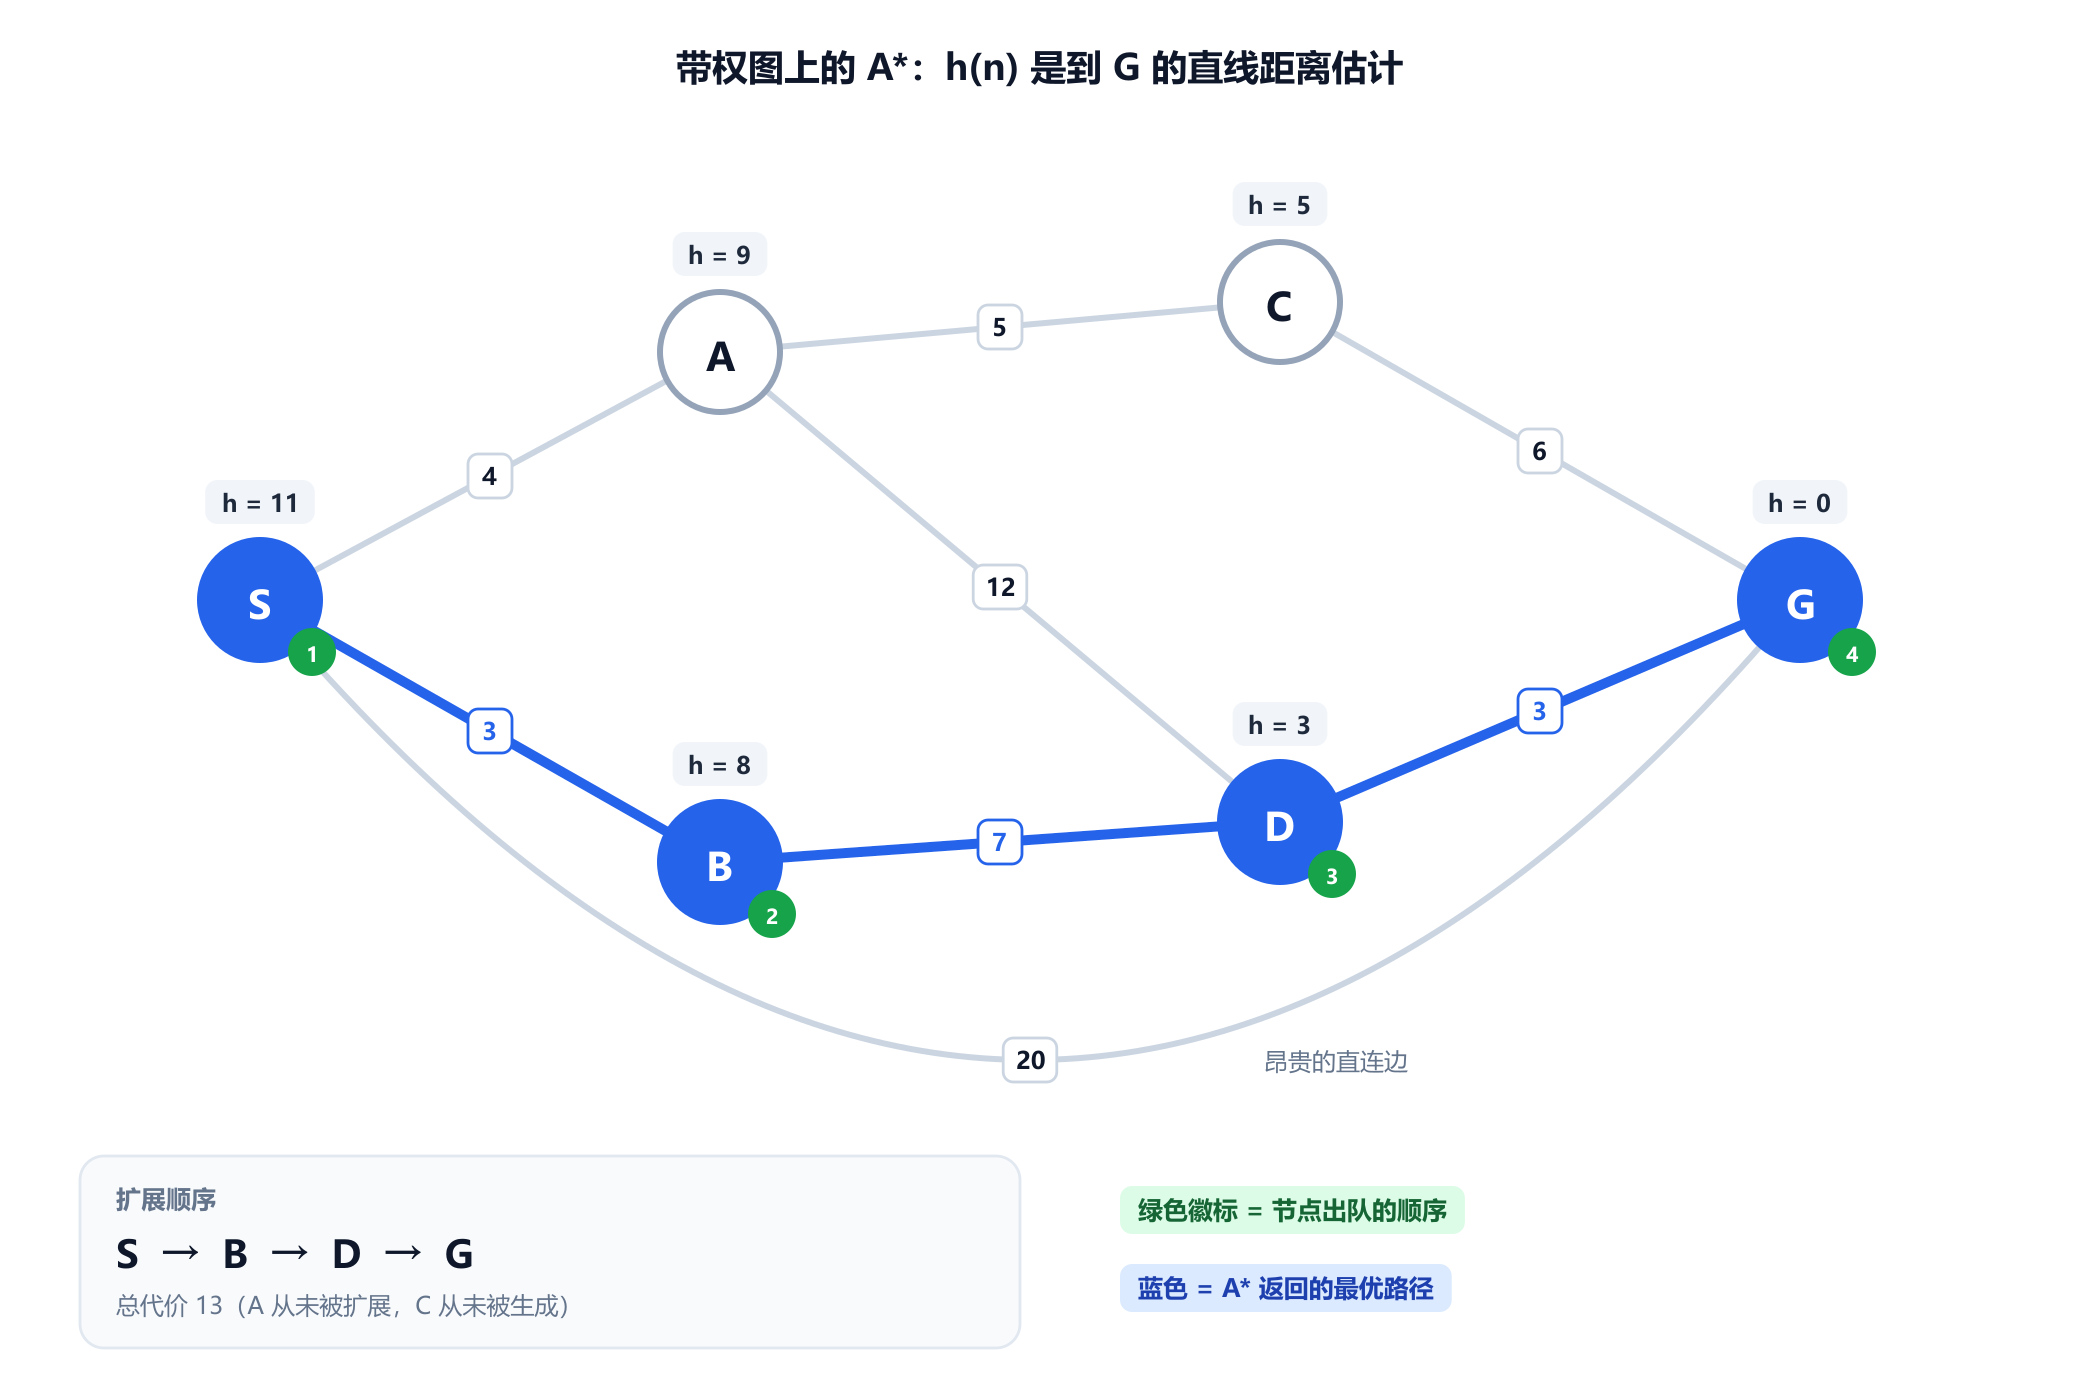
A* 弹出 f最小的节点,平局时优先选择 h更小的节点,这是标准的平局处理规则,因为它偏好离目标更近的节点:
| 步骤 | 出队节点 | g | h | f | 该步之后的边界 |
|---|---|---|---|---|---|
| 1 | S | 0 | 11 | 11 | B 11, A 13, G 20 |
| 2 | B | 3 | 8 | 11 | A 13, D 13, G 20 |
| 3 | D | 10 | 3 | 13 | G 13(由 20 改进),A 13 |
| 4 | G | 13 | 0 | 13 | 目标出队,搜索结束 |
答案是 S → B → D → G,代价为 13。这段推演中有三点值得细看:
- 目标在第 1 步以 f = 20 被生成,但被忽略了。如果实现一生成目标就返回,就会报告一条代价为 20 的路径,比最优解差 54%。A* 把它留在边界中,直到没有更便宜的选项时才接受它。
- 节点 C 甚至从未被生成。在同一个图上,Dijkstra 会扩展所有距离小于 13 的节点,其中包括距离为 9 的 C。A* 从未触及它,因为边界根本没有推进到那么远。
- 节点 A 被生成了,但从未被扩展。它的
f值为 13,与目标持平,而由于f = C*处的平局可以任意打破,A 始终没有值得被打开。这正是最优效率定理所讨论的边界情形。
6. 可采纳启发式与一致启发式
启发式函数 h 的两个性质值得仔细区分,因为人们常常把它们当成一回事,而它们并不相同。
可采纳性
称一个启发式函数是可采纳的,当且仅当它从不高估:
h(n) <= h*(n)   对每个节点 n 成立
                其中 h*(n) 是从 n 到目标的真实最低代价
可采纳性就是乐观。启发式函数可以错得很离谱,只要它是往低处错。 h = 0 是可采纳的,这就是为什么 Dijkstra 是 A* 的一个特例,而不是它的对手。
一致性,也称单调性
称一个启发式函数是一致的,当且仅当它沿每条边都满足三角不等式:
h(n) <= cost(n, n') + h(n')   对每条从 n 到 n' 的边成立
h(goal) = 0换句话说:走一步所降低的估计值,永远不会超过这一步的实际代价。一致性是更强的性质。每个一致的启发式都是可采纳的;反之则不成立。
其实际后果非常明确。当 h 是一致的时, f 沿路径永不减小,所以 A* 第一次弹出某个节点时,它的 g 值就已经是最优的。正是这一点使人们熟悉的优化成为可能:把已扩展的节点放进关闭集,从此不再查看。
当 h 仅仅是可采纳的时,这项许可就被收回了。通往已扩展节点的更便宜路线仍可能被发现,如果实现拒绝重新打开它,最终答案就可能是错的。下面这个图恰好发生了这种情况:
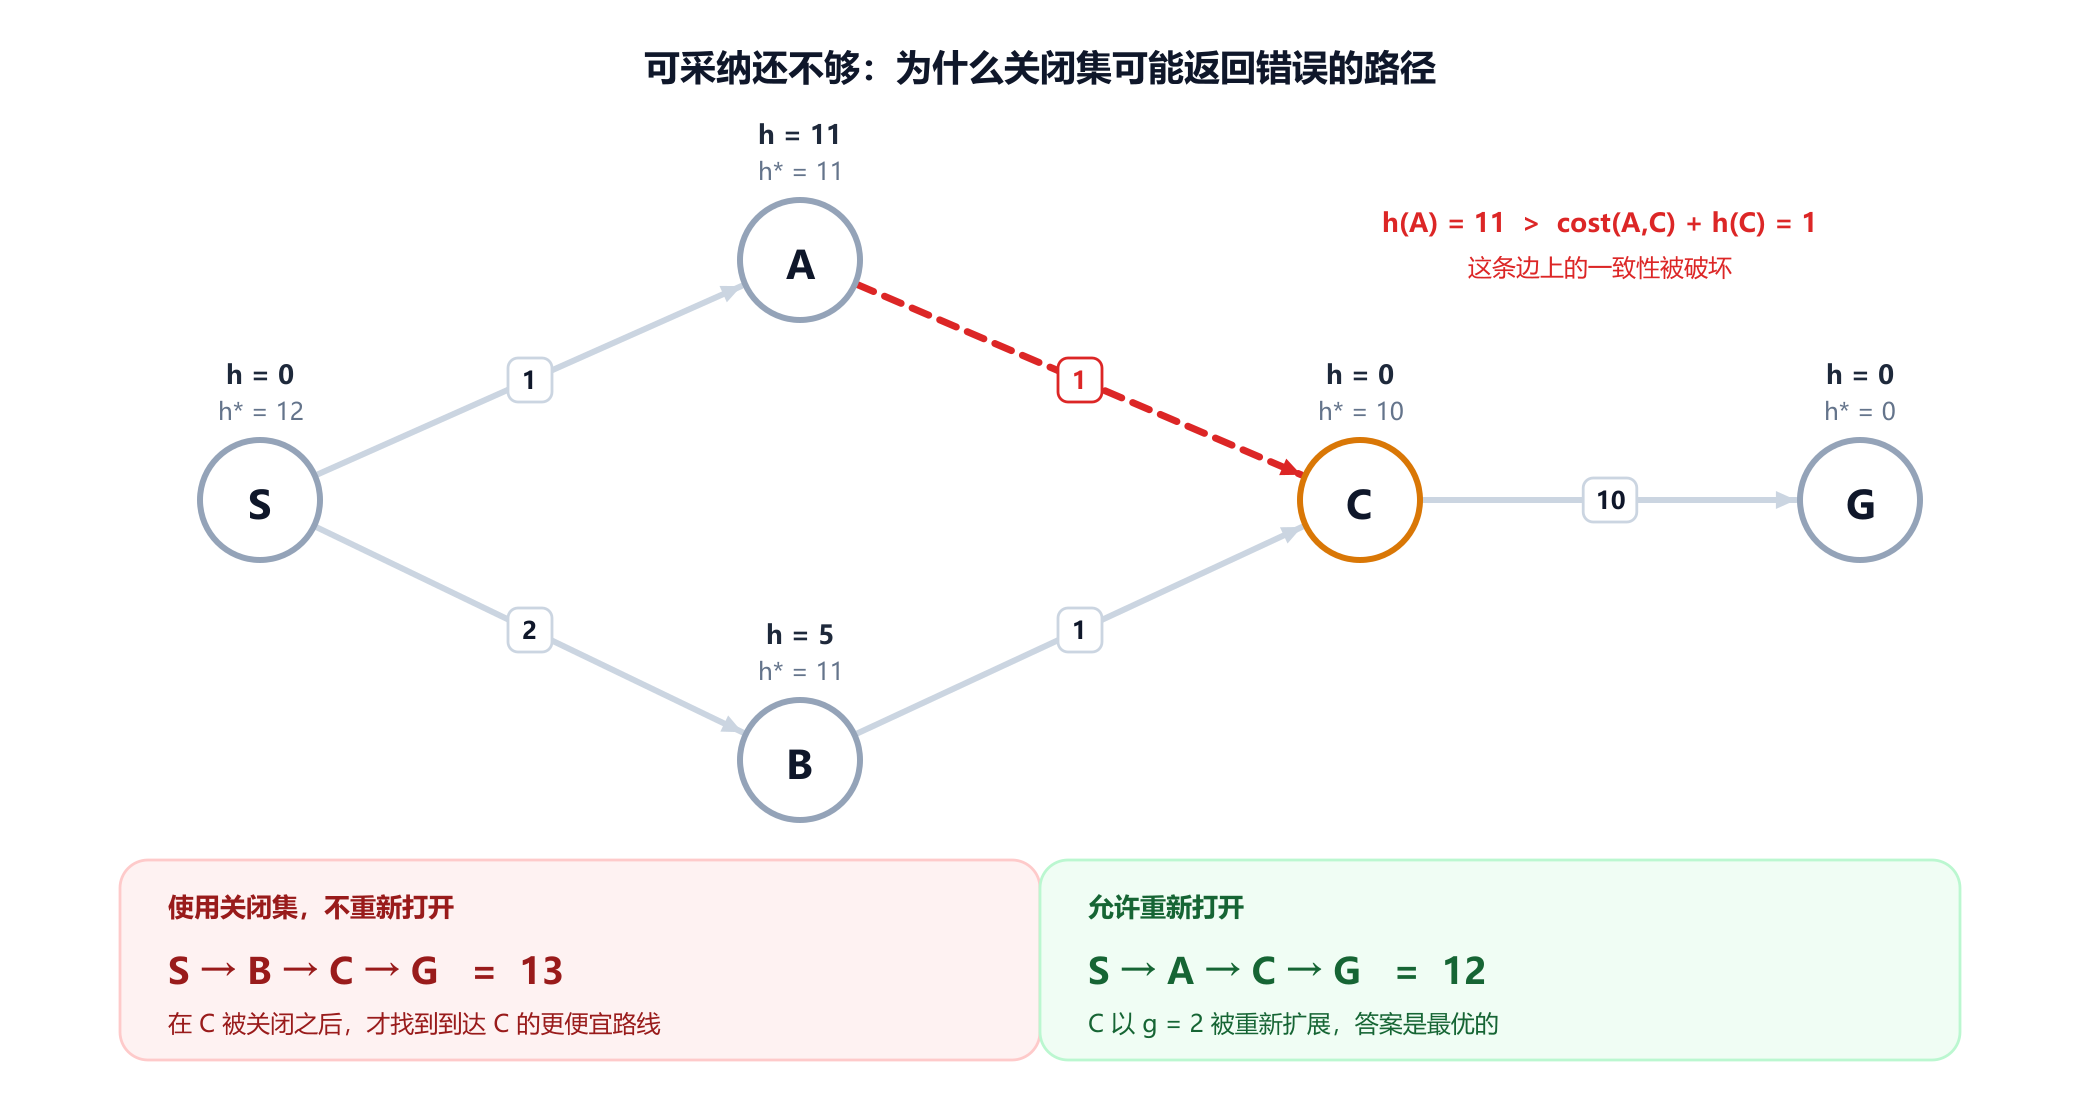
边 (有向, 代价)            启发式 h(n)        真实代价 h*(n)
S -> A   1                 S =  0             S = 12
S -> B   2                 A = 11             A = 11
A -> C   1                 B =  5             B = 11
B -> C   1                 C =  0             C = 10
C -> G  10                 G =  0             G =  0

每个 h(n) <= h*(n),所以该启发式是可采纳的。
边 A -> C 破坏了一致性:h(A) = 11 > cost(A,C) + h(C) = 1。
逐步推演:A* 弹出 S (f = 0),生成 A (f = 1 + 11 = 12)和 B (f = 2 + 5 = 7)。它弹出 B (f = 7),生成 C (g = 3,f = 3)。它弹出 C (f = 3),以 g = 3 将其关闭,并生成 G (f = 13)。直到这时它才弹出 A (f = 12),并发现一条到 C 仅需代价 2 的路线。如果 C 已被关闭,而关闭意味着最终确定,这一发现就会被丢弃,算法返回 13 而不是最优的 12。
有两条出路,你应当有意识地选择其一:证明你的启发式函数是一致的并保留关闭集优化;或者把松弛写成 tentative < g[next] 而不检查关闭集,让重新打开自然发生。令人安心的是,实践中使用的几乎所有启发式,包括直线距离、一致代价网格上的曼哈顿距离,以及任何由松弛问题导出的启发式,都是一致的。也正因如此,这个 bug 可以在多年使用中存活下来,直到某张奇怪的地图把它暴露出来。
7. A* 为什么是最优的,以及何时不是
最优性论证短到可以记在脑子里,而且值得了解,因为当 A* 行为异常时,它能准确告诉你该检查哪个假设。
设 C* 为最优解的代价。假设 A* 即将弹出一个目标节点 G2,它是沿次优路径到达的,因此 g(G2) > C*。由于 h(G2) = 0,它的优先级为 f(G2) = g(G2) > C*。现在考虑从起点到某个真正最优目标的任意一条最优路径。在弹出之前的那一刻,这条路径上至少有一个节点 n 位于边界中,因为起点已被扩展而目标尚未被扩展。对于这个节点, g(n) 是到达它的最优代价,并且由于 h 是可采纳的, f(n) = g(n) + h(n) <= g(n) + h*(n) = C*。所以 f(n) <= C* < f(G2),A* 本应先弹出 n。这个矛盾证明了第一个弹出的目标是最优的。
同样的推理也给出了保证失效的条件:
- 启发式函数在某处高估。不等式
f(n) <= C*不再成立,A* 可能会错过最优路径。这不一定是灾难,但保证已经不存在了,你应该在代码中注明这一点。 - 负的边代价。 A* 与 Dijkstra 一样假定代价非负。存在负权边时,边界的排序毫无意义。请改用 Bellman-Ford 算法。
- 搜索过程中会变化的代价。静态 A* 无法应对计划执行到一半时关上的一扇门。D* Lite 和 Lifelong Planning A* 正是为此而生。
- 无限图或无界图。完备性要求分支因子有限,且边代价有一个正的下界 epsilon。否则,A* 可能会追逐一个无限的、代价越来越小的步骤序列,永远不会终止。
还有一个结论使这套理论更加完整。Dechter 和 Pearl 在 1985 年证明了 A* 是最优高效的:任何使用相同启发式信息的其他最优算法,都不能保证扩展更少的节点。每个满足 f(n) < C* 的节点都必须被任何此类算法扩展,而 A* 恰好扩展这些节点,外加恰好位于 f(n) = C*上的部分节点。不存在更聪明的调度方式;唯一剩下的杠杆是更好的启发式函数。
8. 时间与空间复杂度
教科书给出的数字是 O(bd),其中 b 是分支因子, d 是最优解的深度。这个数字是诚实的,但信息量不大。更精确的表述与启发式的误差有关:除非启发式的误差相对于真实代价是对数有界的,否则 A* 扩展的节点数会呈指数增长:
|h(n) - h*(n)| <= O(log h*(n))实践中几乎没有启发式能达到这个标准,所以诚实的解读是:A* 在最坏情况下是指数级的,好的启发式只是减小了指数的底数,而不是消除指数。在一个已经保存在内存中的显式图上,其计算量与 Dijkstra 相同: O(E log V) (使用二叉堆),因为每条边最多触发一次队列更新。有意思的问题不是这个上界,而是搜索实际触及了这些 V 和 E 中多么小的一部分。
真正卡脖子的是内存。 A* 会把生成的每个节点都保存在内存中,包括边界和已探索集合,因此它的空间复杂度与时间复杂度相同。实际系统往往在耐心耗尽之前很久就耗尽了内存。仅这一事实就解释了第 11 节中的整个变体家族:迭代加深 A*、简化内存受限 A* 以及束搜索式截断,都是为了用最优性或重复计算来换取一个装得下的边界。
9. 如何设计好的启发式函数
既然算法本身是固定的,且可证明是高效的,所有工程工作都集中在 h上。有一个可靠的方法可以构造它。
松弛问题
取真实问题,删掉一个约束,然后精确求解剩下的问题。松弛问题的精确代价总是真实代价的下界,所以它天然是可采纳的;又因为松弛解可以一步一步构建,它同样是一致的。
8 数码问题是标准示例。一个方块可以移动到相邻的空格。删掉约束后,就得到两个经典的启发式:
- h1,错位方块数。允许任何方块一步传送到任何位置。此时代价就是不在目标位置上的方块数量。
- h2,曼哈顿距离。允许方块移动到任意相邻格子,不论是否为空。此时代价就是所有方块到各自目标格子的水平距离与垂直距离之和。
两者都是可采纳的,但实际差距非常大:在需要 12 步的随机 8 数码实例上,Russell 和 Norvig 报告的经典对比显示,迭代加深搜索生成约 360 万个节点,使用 h1 的 A* 生成几百个,使用 h2 的 A* 生成不到一百个。深度为 24 时,差距扩大到 h1 约 39,000 个节点,而 h2约 1,600 个。同样的算法,同样的代码,只是换了一个 h。
优先选择占优的启发式
如果对每个节点都有 h2(n) >= h1(n),且两者都是可采纳的,那么 h2 支配 h1,使用 h2 的 A* 永远不会扩展更多节点。越大越好,直到上限 h*为止。这就是曼哈顿距离胜过错位方块数的原因:它总是至少一样大,而且从不高估。
组合多个启发式
如果你有多个可采纳启发式,而且没有一个支配其他,就取它们的最大值。可采纳启发式的最大值仍是可采纳的,并且支配所有这些启发式。代价是每个节点要计算多个函数,因此收益必须用计算时间来换。
用模式数据库预先计算
对于固定的目标状态,预先穷举求解子问题,并把精确代价存进表中。针对部分方块构建的模式数据库,能给出比任何公式都强得多的可采纳下界。同样的思路也让基于地标的路径规划能在洲际道路网络上运行:预先计算到少数几个地标的精确距离,再用三角不等式为其余距离提供下界。
在网格上,选择与移动方式匹配的度量
4 方向移动用曼哈顿距离,任意角度移动用欧几里得距离,8 方向网格用切比雪夫距离或八方向距离。选择一个比移动规则允许更少自由度的度量,会使启发式不可采纳,并悄无声息地破坏最优性保证。网格寻路指南用具体数字逐一演示了这三种度量。
10. A* 与 Dijkstra、UCS、贪婪最佳优先搜索和 BFS 的比较
这些算法都是同一个循环,只是优先级不同。这是记住它们最有用的方式。
| 算法 | 边界优先级 | 最优? | 适用场景 |
|---|---|---|---|
| 广度优先搜索 | 插入顺序(FIFO) | 是,前提是所有边代价相同 | 无权图,跳数最少 |
| 一致代价搜索 / Dijkstra | f = g | 是 | 带权图,没有可用的估计,或同时有多个目标 |
| 贪婪最佳优先搜索 | f = h | 否 | 需要尽快得到任意一个解,质量可以商量 |
| A* | f = g + h | 是,前提是 h 可采纳 | 单一目标,有不错的估计,路径必须最短 |
| 加权 A* | f = g + w × h | 在 w 倍以内 | A* 太慢,可以接受有界的绕行 |
A* 与 Dijkstra 对比背后的直觉是几何上的。Dijkstra 扩展所有满足 g(n) < C*的节点,在开阔地图上这是一个以起点为中心的圆。A* 扩展所有满足 g(n) + h(n) < C*的节点,这是一个以起点和目标为焦点的椭圆。启发式越精确,这个椭圆就越扁,直到坍缩成路径本身。两者返回相同的最优答案;它们的区别只在于为了确认答案需要查看多大范围的地图。想更全面地了解这一家族,请参阅最短路径算法概览;至于这一切背后的遍历基础,请参阅 BFS 与 DFS。
11. 值得了解的 A* 变体
几乎每个有名字的变体都是在应对两种压力之一:内存,或者需要在证明最优之前就给出答案。
- 加权 A* 将启发式函数乘以
w > 1。解保证在最优解的w倍以内,而在实践中通常远好于这个界,同时运行速度快一个数量级。 - IDA* (迭代加深 A*)以不断增大的
f截断值反复执行深度优先搜索。内存降到搜索深度的量级,代价是每次迭代都要重新扩展节点。这是求解状态空间巨大的拼图问题的标准工具。 - SMA* (简化内存受限 A*)会用满你给它的所有内存,内存耗尽时丢弃最差的叶节点,并在父节点中记住它的值。只要最优路径能装进内存,它仍然是最优的。
- ARA* 以及其他随时(anytime)变体从较大的
w开始,快速返回一个解,然后在剩余时间内不断改进,并逐步收紧界限。 - D* 与 D* Lite 在边代价变化时修复已有计划,而不是从头重新规划。这正是发现地图上没有标出的障碍物的机器人所需要的。
- 跳点搜索(Jump Point Search)利用一致代价网格的对称性,跳过整段相同的格子。答案与 A* 相同,扩展次数通常少一个数量级,但只适用于网格。
- 双向 A* 同时从起点向前、从目标向后搜索。它强大而微妙,因为终止条件和启发式的一致性要求都变得更难处理。
- ALT 与收缩层次(Contraction Hierarchies)是生产环境中的路线规划器真正运行的算法。普通 A* 在洲际道路网络上太慢,所以这些方法会预先计算地标距离或捷径边,然后在一个小得多的有效图上搜索。
12. A* 实现中的常见错误
大多数 A* bug 不会导致崩溃。它们只是在某些输入上、有时候,返回一条稍长的路径。以下是反复出现的原因:
- 单位不匹配。
g以秒为单位而h以米为单位,这是经典错误。如果h哪怕只是略微放大,它就不再可采纳,保证也随之消失。相加之前,先把两者换算成同一种“货币”。 - 关闭集配上不一致的启发式。这就是第 6 节中的失效模式。如果你无法证明一致性,就允许重新打开。
- 没有平局处理。当许多节点具有相同的
f时,任意顺序会让 A* 探索一大片同样有希望的格子。平局时偏向更小的h不花任何代价,并保留所有保证。另一个常见技巧是把h乘以 1 + epsilon,它能在网格上大幅收窄搜索,但会让启发式略微不可采纳,所以使用时要清楚,你是用证明换来了速度。 - 在生成时测试目标。快速、诱人,却会悄无声息地返回次优路径,正如计算示例所示。
- 浮点数比较。欧几里得启发式会产生无理数值,对
f做严格相等判断会产生不可预测的行为。请带容差比较,或者用整数表示代价。 - 忘记 h(goal) = 0。目标处的非零估计会破坏最后一条边上的一致性,并可能扭曲整个搜索。
- 每次队列操作都重新计算 h。启发式函数会被频繁调用。把它缓存在节点上;性能分析器一次又一次地发现这个问题。
- 把可变状态用作字典键。在拼图搜索中,原地修改的棋盘会破坏已访问集合。请存储不可变的编码。
13. A* 的实际应用
凡是需要在一个大到无法枚举的空间中找到最佳决策序列的地方,A* 都有用武之地:
- 机器人与运动规划。最初的 Shakey 应用至今依然适用:为移动机器人、仓储车队和自动驾驶车辆提供网格与栅格规划器,通常由 D* Lite 负责在环境变化时重新规划。
- 游戏 AI。单位在导航网格和瓦片地图上寻路,通常在上层配合分层分解,使长路径先粗略规划,再在局部细化。
- 路线规划。出行规划器运行带地标启发式或收缩层次的 A* 衍生算法,这就是洲际路线能在几毫秒内返回的原因。
- 拼图与状态空间搜索。滑块拼图、魔方求解器及类似的组合问题,通常使用 IDA* 和模式数据库,因为状态空间太大,边界根本装不进内存。
- 自动规划。经典规划器在世界状态空间中搜索,所用的启发式由规划问题的松弛版本自动导出,这正是第 9 节中的松弛方法被机械地应用。
- 生物信息学。多序列比对是高维栅格中的最短路径问题,而带可采纳界的 A* 是一种标准的精确方法。
- 语音与语言解码。在词格上进行 A* 搜索,其中
g是部分假设的得分,h为最佳补全提供上界,这仍是教科书级的解码策略。
模式始终如一:把问题建模成图,为剩余代价找到一个可采纳的下界,剩下的交给优先队列。
14. 常见问题
A* 总能找到最短路径吗?
是的,前提是满足三个条件:启发式是可采纳的(从不高估剩余代价),边代价非负,并且实现在节点出队时而不是生成时测试目标。如果启发式可采纳但不一致,实现还必须允许重新打开已经扩展过的节点。只要违反其中任何一个条件,A* 仍然会返回一条路径,但不再保证是最便宜的那条。
A* 和 Dijkstra 算法有什么区别?
它们是同一个算法,只是优先级不同。Dijkstra 按 g(n)(已付出的代价)对边界排序,因此像一个不断扩大的圆一样向所有方向扩展。A* 按 f(n) = g(n) + h(n) 排序,因此它扩展的区域是一个从起点向目标拉伸的椭圆。令 h(n) = 0,A* 就恰好变成 Dijkstra。当没有可用的估计,或需要同时求到多个目的地的距离时,Dijkstra 是更好的选择;当只有一个目的地且有不错的估计时,A* 是更好的选择。
可采纳启发式和一致启发式有什么区别?
可采纳是指 h(n) 永远不大于真实剩余代价 h*(n)。一致(也称单调)是更强的三角不等式:对每条边都有 h(n) <= cost(n, n') + h(n'),并且 h(goal) = 0。每个一致的启发式都是可采纳的,反之则不然。一致性之所以重要,是因为它保证 A* 第一次弹出某个节点时,该节点的 g 值已经是最优的,这正是关闭集安全的原因。如果启发式仅仅是可采纳的,之后仍可能出现通往已关闭节点的更便宜路线,此时必须重新打开该节点。
A* 的时间和空间复杂度是多少?
最坏情况下两者都是 O(b^d),随解的深度呈指数增长。只有当启发式误差是对数有界时,扩展次数才保持多项式级,而这在实践中几乎从不发生,因此更好的启发式只是减小指数的底数,而不是消除指数。在已经保存在内存中的显式图上,A* 的表现与 Dijkstra 相同,使用二叉堆时为 O(E log V)。空间才是实际的瓶颈:A* 会存储它生成的每个节点,这也是 IDA* 和 SMA* 等内存受限变体存在的原因。
为什么叫 A*?它是人工智能算法还是图算法?
星号是 1968 年那篇论文用来表示最优量的记号,就像 g*、h* 和 f* 一样:不带星号的过程称为 A,而 A* 是启发函数从不高估的那个版本,因此它返回代价最小的路径。它既是人工智能算法,也是图算法。它在人工智能课程中被作为有信息搜索的典型方法讲授,同时也是带权图上的最短路径算法。它不是机器学习:没有任何训练,也不拟合任何数据。知识完全蕴含在你提供的启发式函数中,不过完全可以用一个学习得到的模型来提供启发式。
A* 是完备的吗?如果不存在路径会怎样?
在分支因子有限、边代价有正下界的图上,A* 是完备的:只要存在解,就一定能找到。当不存在路径时,边界会在整个可达连通分量被扩展完之后清空,算法报告失败。失败的情况代价最高,因为要证明不存在解,就必须探索所有可达的部分;这正是在大型地图上预先做一次连通性检查的好理由。