Tabla de Contenidos
- 1. ¿Qué es el algoritmo de búsqueda A*?
- 2. De dónde viene A*: Hart, Nilsson y Raphael (1968)
- 3. La función de evaluación f(n) = g(n) + h(n)
- 4. Cómo funciona A*, paso a paso
- 5. Un ejemplo resuelto sobre un grafo ponderado
- 6. Heurísticas admisibles y consistentes
- 7. Por qué A* es óptimo, y cuándo no lo es
- 8. Complejidad temporal y espacial
- 9. Cómo diseñar una buena heurística
- 10. A* vs Dijkstra, UCS, búsqueda voraz y BFS
- 11. Variantes de A* que conviene conocer
- 12. Errores comunes al implementar A*
- 13. Dónde se usa realmente A*
- 14. Preguntas frecuentes
1. ¿Qué es el algoritmo de búsqueda A*?
A* (pronunciado «A estrella») es un algoritmo de búsqueda en grafos del tipo primero el mejor que encuentra un camino de coste mínimo desde un nodo inicial hasta un nodo objetivo. En inteligencia artificial se clasifica como búsqueda informada: a diferencia de la búsqueda en anchura o la búsqueda de coste uniforme, que solo conocen lo que ya se ha pagado, A* utiliza además una estimación de lo que queda por delante.
Cada nodo que A* mantiene en su frontera lleva tres números:
- g(n): el coste exacto del mejor camino encontrado hasta ahora desde el nodo inicial hasta
n. - h(n): la heurística, una estimación del coste más barato desde
nhasta un objetivo. - f(n) = g(n) + h(n): el coste estimado de la solución completa más barata que pasa por
n.
El algoritmo expande repetidamente el nodo de la frontera con el menor f. Esa única regla produce la propiedad por la que A* es famoso: si la heurística nunca sobreestima el coste restante real, el primer nodo objetivo que A* saca de la frontera está en un camino óptimo.
Nada en esa definición menciona cuadrículas ni videojuegos. A* está definido sobre cualquier grafo ponderado con costes de arista no negativos. El grafo puede ser una red de carreteras, un mapa de casillas, el espacio de estados de un puzle deslizante, el espacio de configuraciones de un robot o el conjunto de planes parciales dentro de un planificador automático. La búsqueda de caminos en cuadrículas es simplemente la imagen más fácil de dibujar, y se trata en la guía complementaria sobre búsqueda de caminos A* en cuadrículas.
2. De dónde viene A*: Hart, Nilsson y Raphael (1968)
Peter E. Hart, Nils J. Nilsson y Bertram Raphael, del Stanford Research Institute, publicaron "A Formal Basis for the Heuristic Determination of Minimum Cost Paths" en IEEE Transactions on Systems Science and Cybernetics, volumen 4, número 2, páginas 100 a 107, julio de 1968. La motivación práctica fue Shakey, el robot móvil del SRI, que tenía que planificar su propia ruta a través de una serie de habitaciones en lugar de seguir un recorrido fijo.
Dos aportaciones de ese artículo siguen definiendo el tema:
- Separó el procedimiento de búsqueda del conocimiento que contiene. El mismo bucle se convierte en un algoritmo distinto según qué
hle proporciones. La estrategia de búsqueda pasó a ser un parámetro en lugar de una decisión de diseño. - Demostró las garantías. Si
hnunca sobreestima el coste restante real, el procedimiento devuelve un camino de coste mínimo. Un resultado complementario mostró que ningún otro algoritmo con acceso a la misma información heurística puede expandir menos nodos y seguir garantizando la optimalidad.
El nombre es una notación que se quedó. El artículo de 1968 marca con una estrella las cantidades óptimas: g* es el coste mínimo desde el inicio hasta un nodo, h* el coste mínimo desde ese nodo hasta una meta, y f* su suma. El procedimiento a secas se llama A, y A* es la versión que alcanza esas cantidades, aquella cuya heurística nunca sobrestima h*. No es una abreviatura y no significa nada.
Una nota de 1972 en el SIGART Newsletter corrigió el argumento de optimalidad original. La prueba de 1968 se apoyaba en lo que los autores llamaron la hipótesis de consistencia, y la corrección explicitó qué debe cambiar cuando una heurística es admisible pero no consistente: los nodos ya expandidos deben poder reabrirse. Esa distinción es la sección 6 más abajo, y más de cincuenta años después sigue siendo la causa más frecuente de implementaciones de A* que fallan en silencio.
Si lo que te ha traído aquí es una cita: Hart, P. E., Nilsson, N. J., y Raphael, B. (1968). "A Formal Basis for the Heuristic Determination of Minimum Cost Paths." IEEE Transactions on Systems Science and Cybernetics 4(2), 100 a 107.
3. La función de evaluación f(n) = g(n) + h(n)
Todo lo que hace A* se deriva de cómo ordena su frontera. La función de evaluación divide la estimación de una solución en una parte que se conoce con exactitud y otra que se adivina:
f(n) = g(n) + h(n)

g(n)   coste ya pagado        exacto, medido a lo largo del camino realmente seguido
h(n)   coste aún por pagar    estimado por la función heurística
f(n)   estimación total       el valor por el que ordena la cola de prioridad
El valor de ese diseño es que un solo componente controla todo el comportamiento de la búsqueda:
- h(n) = 0 en todas partes. Entonces
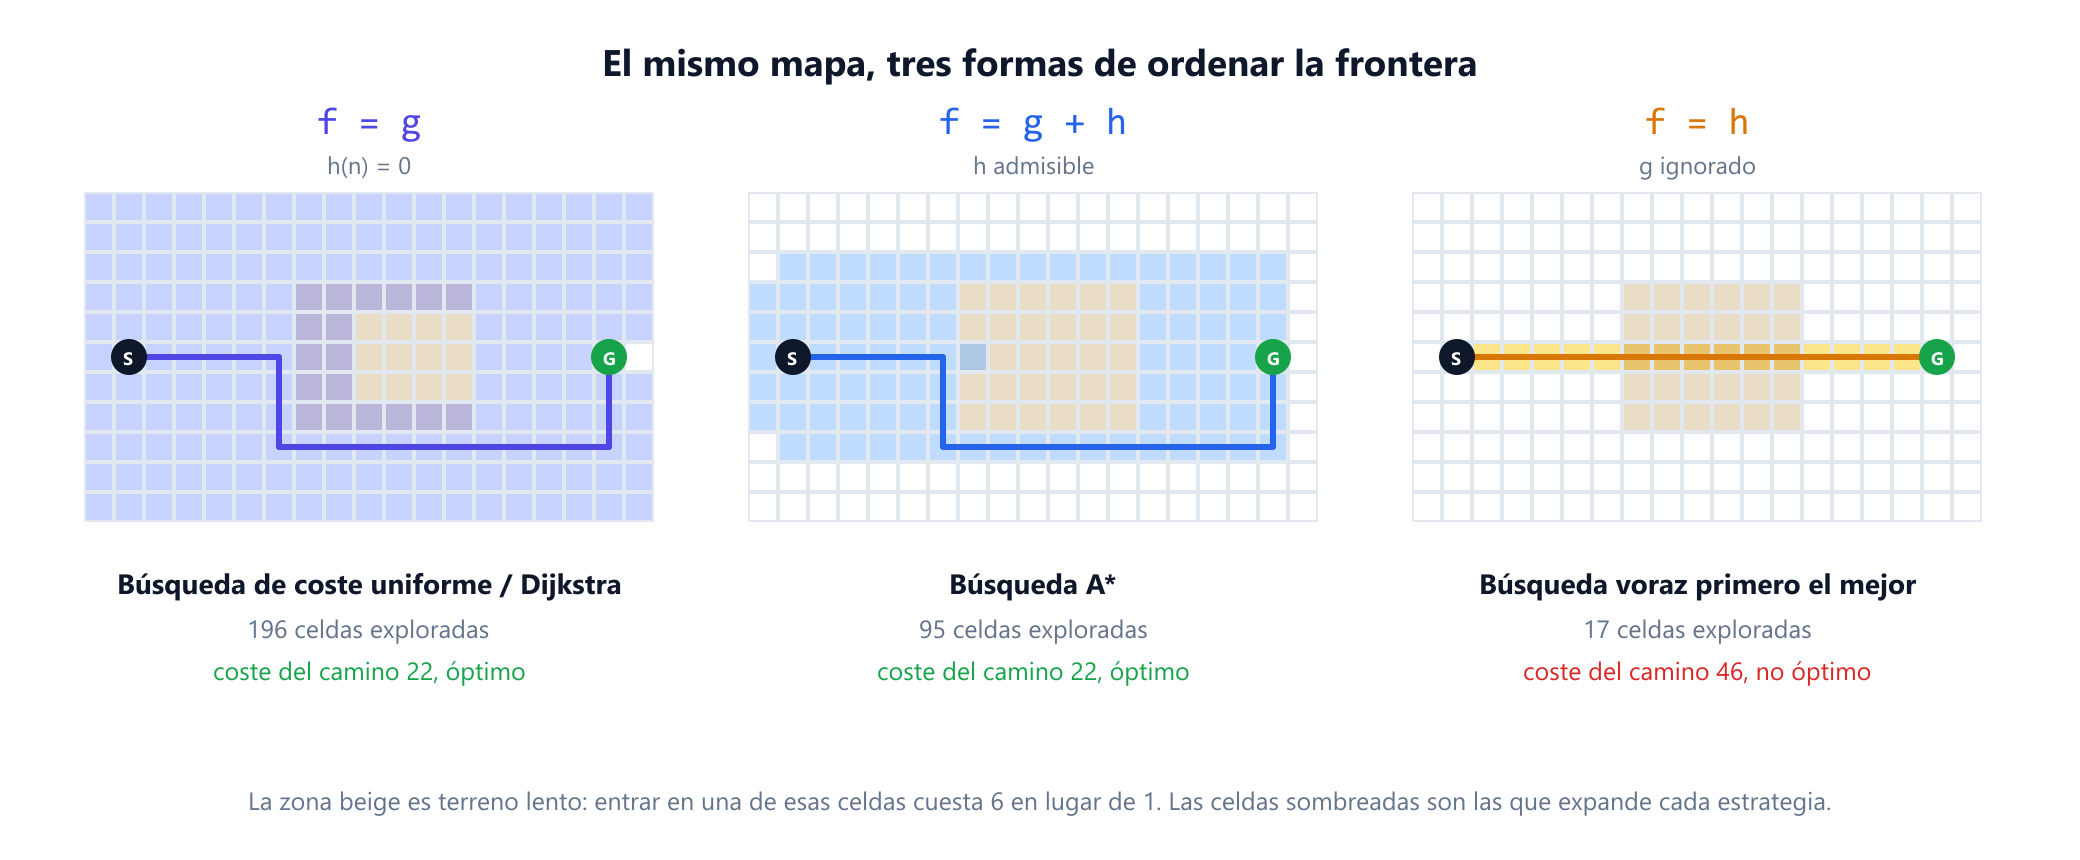
f = gy A* degenera en la búsqueda de coste uniforme, que en un grafo con pesos no negativos es exactamente el algoritmo de Dijkstra. Correcto, pero sin información: expande todos los nodos más baratos que el objetivo, en todas las direcciones. - h(n) = h*(n), el coste restante real. A* avanza en línea recta por un camino óptimo y casi no expande nada más. Es el techo teórico, y en la práctica es inalcanzable porque calcular
h*es precisamente el problema que intentabas resolver. - Ignorar g y ordenar solo por h. Eso es la búsqueda voraz primero el mejor. Es rápida, a menudo se equivoca mucho y no ofrece ninguna garantía de optimalidad.
- Reponderar: f = g + w × h con w > 1. Weighted A* (A* ponderado) cambia una pérdida acotada de calidad de la solución por una gran ganancia de velocidad. El camino que devuelve nunca es peor que
wveces el coste óptimo.
Lee esa lista como una escala de cuánto confías en la estimación. A* está en el medio y dedica esfuerzo en proporción a lo poco que sabe la heurística: una heurística precisa produce una búsqueda que parece una línea recta; una débil, una búsqueda que parece Dijkstra.
4. Cómo funciona A*, paso a paso
La frontera es una cola de prioridad, tradicionalmente llamada OPEN, ordenada por f. Una tabla con los mejores valores g conocidos y una tabla de punteros al padre completan el estado.
function a_star(start, goal, h):
    open   = priority queue ordered by f        # la frontera
    g      = map with default infinity          # mejor coste conocido desde el inicio
    parent = map                                # para reconstruir el camino

    g[start] = 0
    open.push(start, h(start))

    while open is not empty:
        current = open.pop_min()                # nodo con el menor f
        if current == goal:
            return reconstruct(parent, goal)    # test de objetivo al extraer, no al generar

        for (next, cost) in edges(current):
            tentative = g[current] + cost
            if tentative < g[next]:             # una ruta más barata hacia next
                g[next]      = tentative
                parent[next] = current
                open.push_or_update(next, tentative + h(next))

    return failure                              # el objetivo es inalcanzable
Cuatro detalles de implementación concentran la mayor parte de la sutileza:
- El test de objetivo se hace cuando un nodo se extrae, no cuando se genera. Un objetivo puede generarse pronto a través de una ruta cara. Devolver en ese momento te da un camino, pero no el más barato. El ejemplo resuelto de abajo contiene un caso en el que hacer el test al generar cuesta 7 unidades de más sobre las 13 óptimas.
- La relajación está protegida por
tentative < g[next], no por la pertenencia a un conjunto cerrado. Escrito así, el bucle reabre automáticamente un nodo ya expandido cuando más tarde aparece una ruta más barata hacia él, y eso es lo que lo hace correcto para cualquier heurística admisible. - La mayoría de las colas de prioridad no tienen operación de disminuir clave. El código de producción suele insertar una entrada duplicada con el mejor
fy descartar las entradas obsoletas a medida que salen. Esto se llama borrado perezoso: cuesta un poco de memoria y ahorra mucha contabilidad. - El camino se recupera hacia atrás. Sigue los punteros al padre desde el objetivo hasta el inicio e invierte la lista. A* nunca almacena caminos, solo un padre por nodo.
5. Un ejemplo resuelto sobre un grafo ponderado
Las animaciones en cuadrícula ocultan la aritmética. Aquí tienes un pequeño grafo ponderado, del tipo que se usa en los cursos de IA, recorrido a mano de principio a fin.
Seis nodos: S (inicio), A, B, C, D y G (objetivo). Los costes de las aristas son distancias por carretera, y la heurística h es la distancia en línea recta hasta G, que es lo que la hace admisible: una línea recta nunca es más larga que una carretera.
Aristas (no dirigidas, coste) Heurística h(n)
S-A  4      A-C  5            S = 11    C = 5
S-B  3      A-D  12           A =  9    D = 3
S-G  20     B-D  7            B =  8    G = 0
C-G  6      D-G  3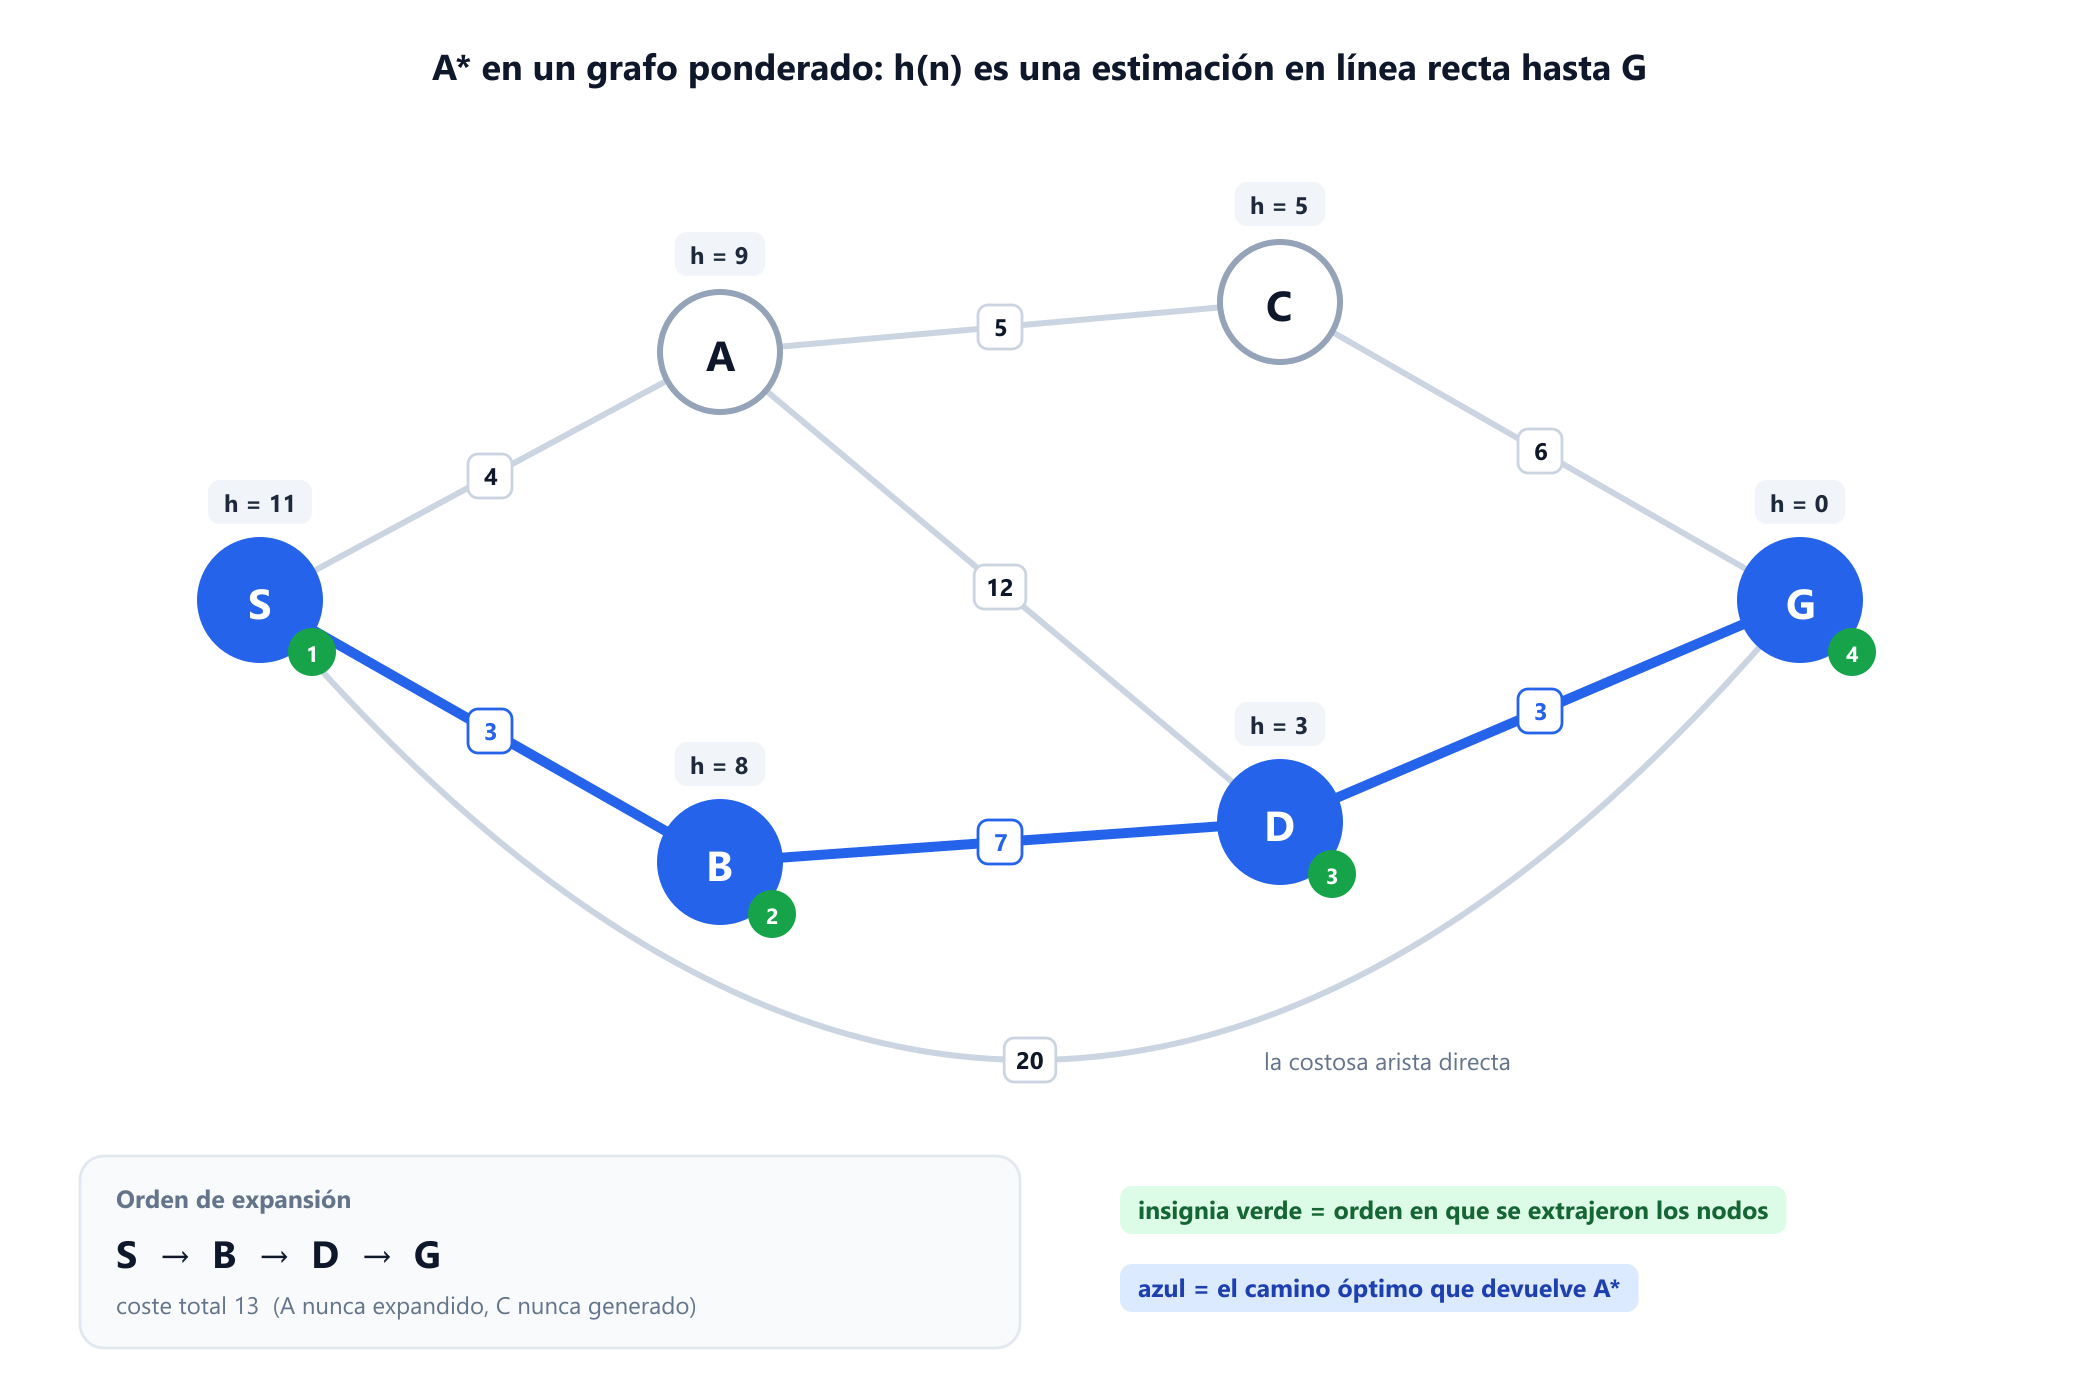
A* extrae el nodo con el menor f, y deshace los empates a favor del menor h, que es el desempate estándar porque prefiere los nodos más cercanos al objetivo:
| Paso | Extraído | g | h | f | Frontera tras el paso |
|---|---|---|---|---|---|
| 1 | S | 0 | 11 | 11 | B 11, A 13, G 20 |
| 2 | B | 3 | 8 | 11 | A 13, D 13, G 20 |
| 3 | D | 10 | 3 | 13 | G 13 (mejorado desde 20), A 13 |
| 4 | G | 13 | 0 | 13 | objetivo extraído, fin de la búsqueda |
La respuesta es S → B → D → G con un coste de 13. Hay tres cosas en esa traza en las que merece la pena detenerse:
- El objetivo se generó en el paso 1 con f = 20 y se ignoró. Una implementación que devuelve en cuanto genera el objetivo habría informado de un camino de coste 20, un 54 por ciento peor que el óptimo. A* lo mantiene en la frontera y solo lo acepta cuando no queda nada más barato.
- El nodo C ni siquiera llegó a generarse. Dijkstra, sobre el mismo grafo, expande todos los nodos con distancia menor que 13, lo que incluye a C con 9. A* nunca lo toca porque la frontera nunca llega tan lejos.
- El nodo A se generó pero nunca se expandió. Su
fde 13 empata con el objetivo, y como un empate enf = C*puede resolverse en cualquier sentido, A nunca llegó a merecer ser abierto. Ese es exactamente el caso límite del que habla el teorema de eficiencia óptima.
6. Heurísticas admisibles y consistentes
Conviene distinguir con cuidado dos propiedades de h, porque a menudo se usan como si fueran lo mismo y no lo son.
Admisibilidad
Una heurística es admisible si nunca sobreestima:
h(n) <= h*(n)   para todo nodo n
                donde h*(n) es el coste real más barato de n a un objetivo
La admisibilidad es optimismo. La heurística puede equivocarse todo lo que quiera, siempre que se equivoque por lo bajo. h = 0 es admisible, y por eso Dijkstra es un caso particular de A* y no su rival.
Consistencia, también llamada monotonía
Una heurística es consistente si cumple una desigualdad triangular a lo largo de cada arista:
h(n) <= cost(n, n') + h(n')   para toda arista de n a n'
h(goal) = 0
Dicho con palabras: dar un paso nunca puede reducir tu estimación en más de lo que el paso costó realmente. La consistencia es la propiedad más fuerte. Toda heurística consistente es admisible; lo contrario es falso.
La consecuencia práctica es precisa. Cuando h es consistente, f nunca disminuye a lo largo de un camino, así que la primera vez que A* extrae un nodo, su valor g ya es óptimo. Eso es lo que autoriza la conocida optimización de meter los nodos expandidos en un conjunto cerrado y no volver a mirarlos nunca.
Cuando h es solo admisible, esa autorización se retira. Todavía puede descubrirse una ruta más barata hacia un nodo ya expandido, y si la implementación se niega a reabrirlo, la respuesta final puede ser incorrecta. Aquí tienes un grafo donde ocurre exactamente eso:
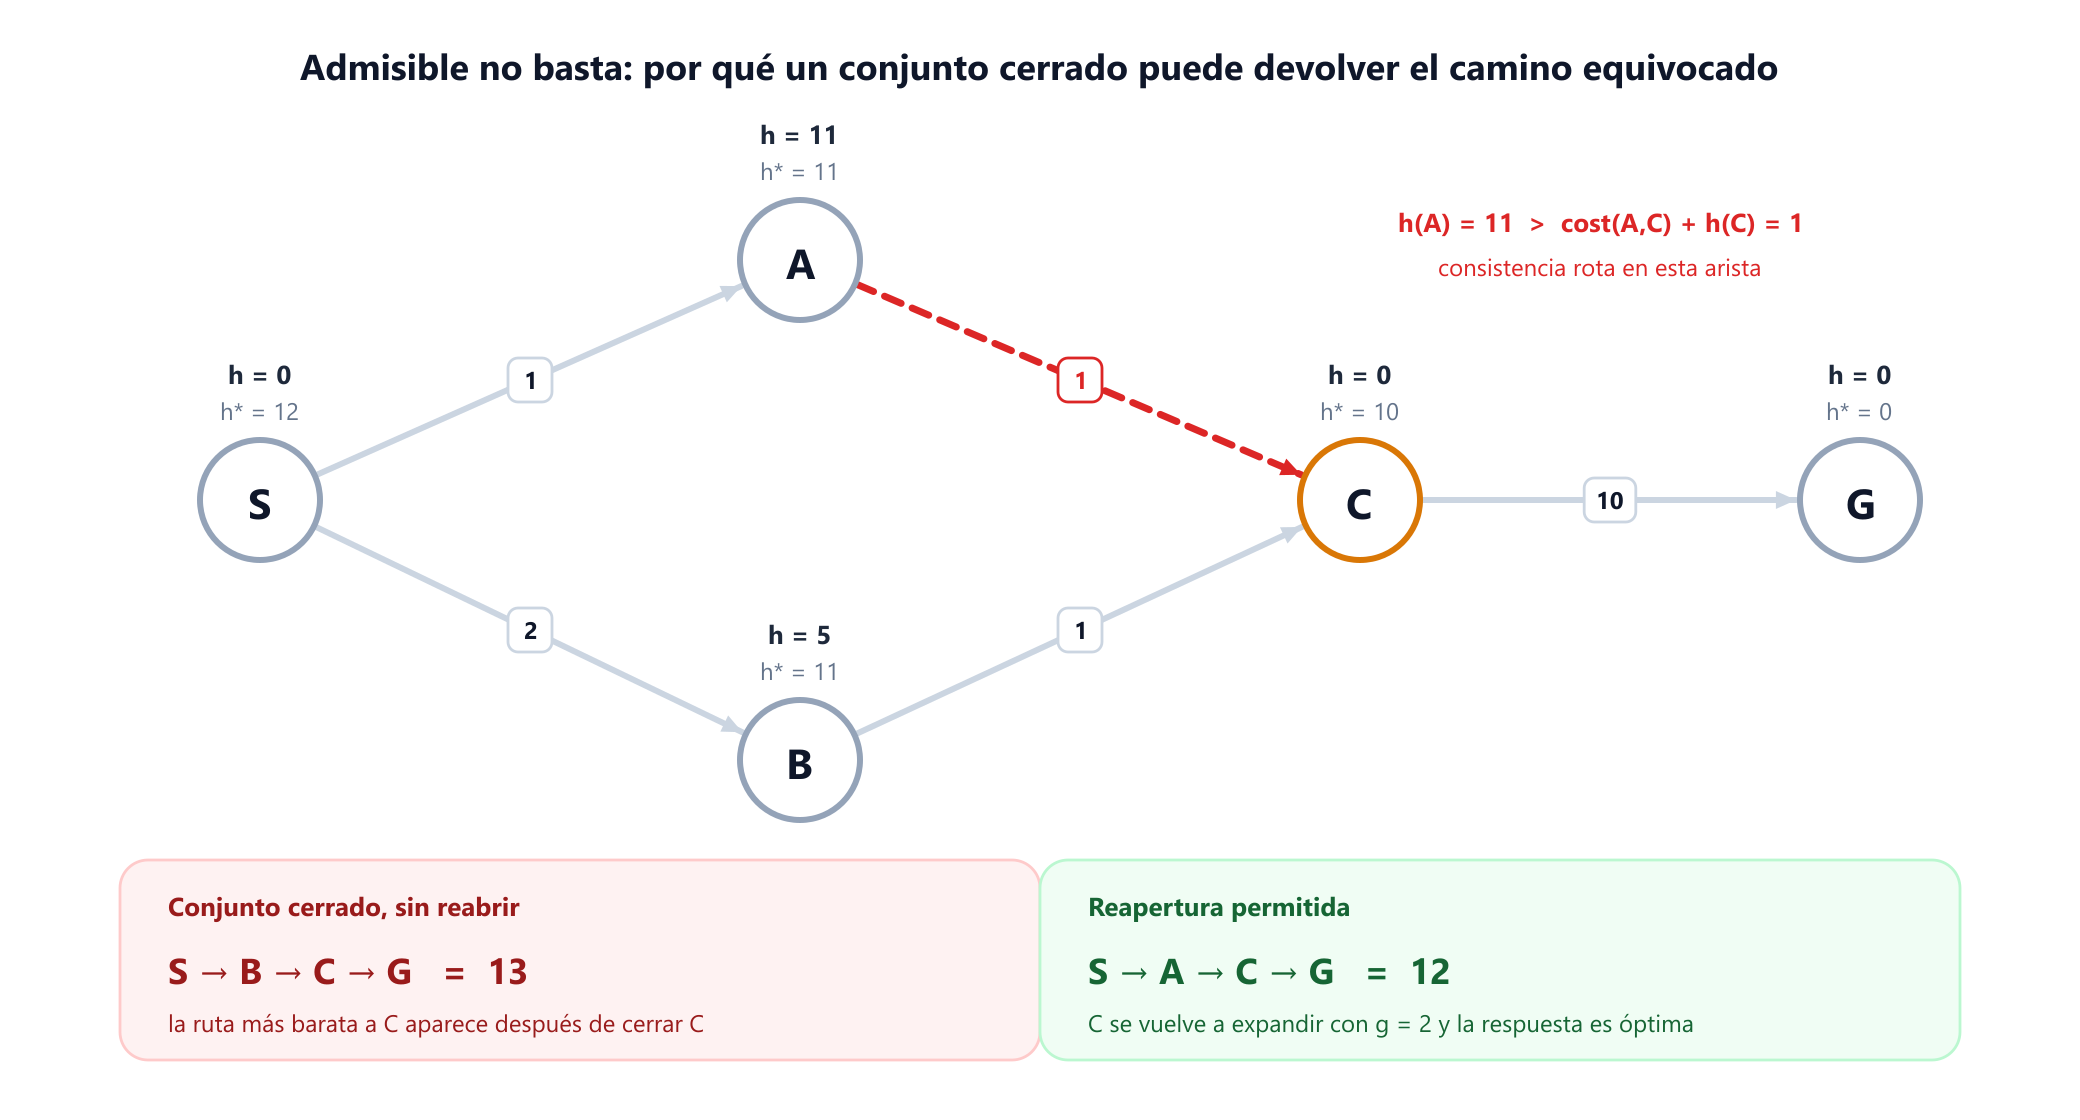
Aristas (dirigidas, coste) Heurística h(n)    Coste real h*(n)
S -> A   1                 S =  0             S = 12
S -> B   2                 A = 11             A = 11
A -> C   1                 B =  5             B = 11
B -> C   1                 C =  0             C = 10
C -> G  10                 G =  0             G =  0

Todo h(n) <= h*(n), así que la heurística es admisible.
La arista A -> C rompe la consistencia: h(A) = 11 > cost(A,C) + h(C) = 1.
Síguelo paso a paso: A* extrae S (f = 0) y genera A con f = 1 + 11 = 12 y B con f = 2 + 5 = 7. Extrae B (f = 7) y genera C con g = 3, f = 3. Extrae C (f = 3), lo cierra con g = 3 y genera G con f = 13. Solo entonces extrae A (f = 12) y descubre una ruta hacia C que cuesta solo 2. Si C está cerrado y cerrado significa definitivo, ese descubrimiento se descarta y el algoritmo devuelve 13 en lugar del óptimo 12.
Hay dos salidas, y deberías elegir una a propósito: demostrar que tu heurística es consistente y conservar la optimización del conjunto cerrado, o escribir la relajación como tentative < g[next] sin comprobar ningún conjunto cerrado, de modo que la reapertura ocurra sola. La buena noticia es que casi todas las heurísticas usadas en la práctica, incluidas la distancia en línea recta, la distancia Manhattan en una cuadrícula de coste uniforme y cualquier heurística derivada de un problema relajado, son consistentes. Precisamente por eso este error puede sobrevivir años de uso hasta que un mapa extraño lo pone al descubierto.
7. Por qué A* es óptimo, y cuándo no lo es
El argumento de optimalidad es lo bastante corto como para tenerlo en la cabeza, y merece la pena conocerlo porque te dice exactamente qué hipótesis revisar cuando A* se comporta mal.
Sea C* el coste de una solución óptima. Supongamos que A* está a punto de extraer un nodo objetivo G2 alcanzado por un camino subóptimo, de modo que g(G2) > C*. Como h(G2) = 0, su prioridad es f(G2) = g(G2) > C*. Considera ahora cualquier camino óptimo desde el inicio hasta un objetivo óptimo real. Justo antes de la extracción, ese camino debe tener al menos un nodo n en la frontera, porque el inicio se expandió y el objetivo no. Para ese nodo, g(n) es el coste óptimo para alcanzarlo y, como h es admisible, f(n) = g(n) + h(n) <= g(n) + h*(n) = C*. Así que f(n) <= C* < f(G2), y A* habría extraído n primero. La contradicción demuestra que el primer objetivo extraído es óptimo.
El mismo razonamiento te da las condiciones en las que la garantía falla:
- La heurística sobreestima en algún punto. La desigualdad
f(n) <= C*se rompe, y A* puede pasar de largo junto al camino óptimo. No siempre es un desastre, pero la garantía desaparece y deberías dejarlo indicado en el código. - Costes de arista negativos. A* supone costes no negativos, igual que Dijkstra. Con aristas negativas, el orden de la frontera no significa nada. Usa en su lugar Bellman-Ford.
- Costes que cambian durante la búsqueda. El A* estático no tiene respuesta para una puerta que se cierra a mitad del plan. Para eso existen D* Lite y Lifelong Planning A*.
- Grafos infinitos o no acotados. La completitud requiere un factor de ramificación finito y costes de arista acotados inferiormente por algún épsilon positivo. Sin eso, A* puede perseguir una secuencia infinita de pasos cada vez más baratos y no terminar nunca.
Un resultado más completa la teoría. Dechter y Pearl demostraron en 1985 que A* es óptimamente eficiente: ningún otro algoritmo óptimo con la misma información heurística tiene garantizado expandir menos nodos. Todo nodo con f(n) < C* debe ser expandido por cualquier algoritmo de ese tipo, y A* expande exactamente esos, más algún subconjunto de los nodos situados exactamente en f(n) = C*. No hay una planificación más ingeniosa por descubrir; la única palanca que queda es una heurística mejor.
8. Complejidad temporal y espacial
La cifra de manual es O(bd), donde b es el factor de ramificación y d es la profundidad de la solución óptima, y esa cifra es honesta pero poco informativa. La afirmación más precisa se refiere al error de la heurística. El número de nodos que expande A* crece exponencialmente a menos que el error de la heurística esté acotado logarítmicamente en el coste real:
|h(n) - h*(n)| <= O(log h*(n))Casi ninguna heurística usada en la práctica supera ese listón, así que la lectura honesta es que A* es exponencial en el peor caso y que una buena heurística reduce la base del exponente en lugar de eliminarlo. En un grafo explícito que ya tienes en memoria, la cuenta es la misma que la de Dijkstra: O(E log V) con un montículo binario, ya que cada arista provoca como mucho una actualización de la cola. La pregunta interesante no es la cota, sino qué poca parte de esos V y E llega a tocar la búsqueda.
La memoria es la restricción que de verdad aprieta. A* guarda en memoria todos los nodos generados, tanto la frontera como el conjunto explorado, así que su complejidad espacial coincide con la temporal. Los sistemas reales se quedan sin RAM mucho antes de quedarse sin paciencia. Este único hecho explica toda la familia de variantes de la sección 11: A* de profundización iterativa, A* simplificado con memoria acotada y los recortes de tipo haz existen para cambiar optimalidad o trabajo repetido por una frontera que quepa en memoria.
9. Cómo diseñar una buena heurística
Como el algoritmo está fijado y es demostrablemente eficiente, toda la ingeniería reside en h. Hay una receta fiable para producir una.
Relajar el problema
Toma el problema real, elimina una restricción y resuelve exactamente lo que queda. El coste exacto de un problema relajado es siempre una cota inferior del coste real, así que es admisible por construcción, y como una solución relajada puede construirse paso a paso, también es consistente.
El 8-puzle es el ejemplo clásico. Una ficha puede moverse a la casilla vacía adyacente. Al eliminar restricciones surgen dos heurísticas clásicas:
- h1, fichas mal colocadas. Permite que cualquier ficha se teletransporte a cualquier sitio en un movimiento. Entonces el coste es simplemente el número de fichas que no están en su posición objetivo.
- h2, distancia Manhattan. Permite que una ficha se mueva a cualquier casilla adyacente, esté vacía o no. Entonces el coste es la suma, sobre todas las fichas, de la distancia horizontal más la vertical hasta la casilla objetivo de cada ficha.
Ambas son admisibles. La diferencia en la práctica es enorme: en instancias aleatorias del 8-puzle que requieren 12 movimientos, la comparación clásica de Russell y Norvig muestra que la búsqueda en profundidad iterativa genera del orden de 3,6 millones de nodos, A* con h1 genera unos cientos, y A* con h2 genera menos de cien. A profundidad 24 la brecha se amplía a unos 39.000 nodos para h1 frente a unos 1.600 para h2. El mismo algoritmo, el mismo código, distinta h.
Preferir una heurística dominante
Si h2(n) >= h1(n) para todo nodo y ambas son admisibles, entonces h2 domina a h1, y A* con h2 nunca expande más nodos. Más grande es mejor, hasta el techo de h*. Por eso la distancia Manhattan supera a las fichas mal colocadas: siempre es al menos igual de grande y nunca sobreestima.
Combinar varias heurísticas
Si tienes varias heurísticas admisibles y ninguna domina a las demás, toma su máximo. El máximo de heurísticas admisibles es admisible y las domina a todas. El precio es que ahora evalúas varias funciones por nodo, así que la ganancia hay que pagarla en tiempo de evaluación.
Precalcular con bases de datos de patrones
Para un estado objetivo fijo, resuelve subproblemas de forma exhaustiva por adelantado y guarda los costes exactos en una tabla. Una base de datos de patrones para un subconjunto de las fichas da una cota admisible mucho más fuerte que cualquier fórmula. Es la misma idea que hace funcionar el enrutamiento basado en puntos de referencia en redes de carreteras continentales: precalcular distancias exactas a un puñado de puntos de referencia y usar la desigualdad triangular para acotar el resto.
En cuadrículas, elegir la métrica que corresponde a los movimientos
Distancia Manhattan para movimiento en 4 direcciones, euclídea para movimiento en cualquier ángulo, Chebyshov u octil para cuadrículas de 8 direcciones. Elegir una métrica que permita menos libertad que las reglas de movimiento hace que la heurística sea inadmisible y destruye en silencio la garantía de optimalidad. La guía de búsqueda de caminos en cuadrículas desarrolla las tres con números concretos.
10. A* vs Dijkstra, UCS, búsqueda voraz y BFS
Todos ellos son el mismo bucle con una prioridad distinta. Esa es la forma más útil de recordarlos.
| Algoritmo | Prioridad de la frontera | ¿Óptimo? | Úsalo cuando |
|---|---|---|---|
| Búsqueda en anchura | orden de inserción (FIFO) | Sí, si todas las aristas cuestan lo mismo | Grafos no ponderados, menos saltos |
| Búsqueda de coste uniforme / Dijkstra | f = g | Sí | Grafo ponderado, sin una estimación útil o con muchos objetivos a la vez |
| Búsqueda voraz primero el mejor | f = h | No | Necesitas cualquier solución rápido y la calidad es negociable |
| A* | f = g + h | Sí, si h es admisible | Un solo objetivo, existe una estimación decente, el camino debe ser el más corto |
| A* ponderado | f = g + w × h | Dentro de un factor w | A* es demasiado lento y un rodeo acotado es aceptable |
La intuición detrás de la comparación entre A* y Dijkstra es geométrica. Dijkstra expande todo lo que cumple g(n) < C*, que en un mapa abierto es un círculo alrededor del inicio. A* expande todo lo que cumple g(n) + h(n) < C*, que es una elipse con el inicio y el objetivo como focos. Cuanto más precisa es la heurística, más se aplana esa elipse, hasta colapsar sobre el propio camino. Ambos devuelven la misma respuesta óptima; solo difieren en cuánta parte del mapa tuvieron que mirar para estar seguros. Para un mapa más amplio de la familia, consulta el panorama de los algoritmos de camino más corto, y para los fundamentos de recorrido que hay debajo de todo ello, BFS vs DFS.
11. Variantes de A* que conviene conocer
Casi todas las variantes con nombre responden a una de dos presiones: la memoria o la necesidad de responder antes de haber demostrado el óptimo.
- A* ponderado multiplica la heurística por
w > 1. Las soluciones están garantizadas dentro de un factorwdel óptimo y, en la práctica, suelen ser mucho mejores que esa cota mientras se ejecutan un orden de magnitud más rápido. - IDA* (A* de profundización iterativa) ejecuta búsquedas en profundidad repetidas con un umbral de
fcreciente. La memoria se reduce a la profundidad de la búsqueda, y el precio es volver a expandir nodos en cada iteración. Es la herramienta estándar para puzles con espacios de estados enormes. - SMA* (A* simplificado con memoria acotada) usa toda la memoria que le des y, cuando se agota, descarta la peor hoja recordando su valor en el padre. Sigue siendo óptimo si el camino óptimo cabe en memoria.
- ARA* y otras variantes anytime empiezan con un
wgrande, devuelven una solución rápidamente y siguen mejorándola mientras queda tiempo, ajustando la cota sobre la marcha. - D* y D* Lite reparan un plan existente cuando cambian los costes de las aristas, en lugar de replanificar desde cero. Es lo que necesita un robot que descubre un obstáculo que no estaba en el mapa.
- Jump Point Search aprovecha la simetría de las cuadrículas de coste uniforme para saltarse tramos enteros de celdas idénticas. La misma respuesta que A*, a menudo con un orden de magnitud menos de expansiones, solo en cuadrículas.
- A* bidireccional busca a la vez hacia delante desde el inicio y hacia atrás desde el objetivo. Es potente y delicado, ya que tanto la condición de parada como los requisitos de consistencia de la heurística se complican.
- ALT y contraction hierarchies son lo que realmente ejecutan los planificadores de rutas en producción. El A* simple es demasiado lento en redes de carreteras continentales, así que precalculan distancias a puntos de referencia o aristas atajo y luego buscan en un grafo efectivo mucho más pequeño.
12. Errores comunes al implementar A*
La mayoría de los errores de A* no provocan un fallo. Devuelven un camino ligeramente demasiado largo, con algunas entradas, a veces. Estas son las causas recurrentes:
- Unidades que no coinciden.
gmedido en segundos yhmedido en metros es el clásico. Sihestá aunque sea ligeramente sobreescalada, deja de ser admisible y la garantía desaparece. Convierte ambos a la misma moneda antes de sumarlos. - Un conjunto cerrado con una heurística inconsistente. El modo de fallo de la sección 6. Si no puedes demostrar la consistencia, permite la reapertura.
- Sin desempate. Cuando muchos nodos comparten el mismo
f, un orden arbitrario hace que A* explore una amplia meseta de celdas igual de prometedoras. Desempatar a favor del menorhno cuesta nada y mantiene intactas todas las garantías. El otro truco habitual, escalarhpor 1 + épsilon, estrecha drásticamente la búsqueda en cuadrículas pero vuelve la heurística ligerísimamente inadmisible, así que úsalo sabiendo que has cambiado la prueba por la velocidad. - Hacer el test de objetivo al generar. Rápido, tentador, y devuelve en silencio caminos subóptimos, como mostró el ejemplo resuelto.
- Comparaciones en coma flotante. Las heurísticas euclídeas producen valores irracionales, y las comprobaciones de igualdad estricta sobre
fse comportan de forma impredecible. Compara con una tolerancia o mantén los costes en enteros. - Olvidar h(goal) = 0. Una estimación distinta de cero en el objetivo rompe la consistencia en la última arista y puede distorsionar toda la búsqueda.
- Recalcular h en cada operación de la cola. La heurística se llama constantemente. Guárdala en el nodo; los perfiladores encuentran este problema una y otra vez.
- Estados mutables usados como claves de diccionario. En la búsqueda de puzles, un tablero modificado en el sitio corrompe el conjunto de visitados. Guarda una codificación inmutable.
13. Dónde se usa realmente A*
A* se gana su lugar allí donde hay que encontrar la mejor secuencia de decisiones en un espacio demasiado grande para enumerarlo:
- Robótica y planificación de movimiento. La aplicación original de Shakey, todavía vigente: planificadores en cuadrícula y en retícula para robots móviles, flotas de almacén y vehículos autónomos, normalmente con D* Lite encargándose de replanificar cuando el mundo cambia.
- IA de videojuegos. Unidades que se desplazan por mallas de navegación y mapas de casillas, normalmente con una descomposición jerárquica por encima para que un camino largo se planifique primero a grandes rasgos y luego se refine localmente.
- Planificación de rutas. Los planificadores de viajes ejecutan derivados de A* con heurísticas de puntos de referencia o contraction hierarchies, y así es como se devuelve una ruta continental en milisegundos.
- Búsqueda en puzles y espacios de estados. Puzles deslizantes, solucionadores del cubo de Rubik y problemas combinatorios similares, normalmente con IDA* y bases de datos de patrones porque los espacios de estados son demasiado grandes para una frontera en memoria.
- Planificación automática. Los planificadores clásicos buscan en el espacio de estados del mundo con heurísticas derivadas automáticamente de una versión relajada del problema de planificación, es decir, la misma receta de relajación de la sección 9 aplicada de forma mecánica.
- Bioinformática. El alineamiento múltiple de secuencias es un problema de camino más corto en una retícula de muchas dimensiones, y A* con una cota admisible es un método exacto estándar.
- Decodificación del habla y del lenguaje. La búsqueda A* sobre una retícula de palabras, donde
ges la puntuación de la hipótesis parcial yhacota la mejor compleción, sigue siendo una estrategia de decodificación de manual.
El patrón es siempre el mismo. Modela el problema como un grafo, encuentra una cota inferior admisible del coste restante y deja que la cola de prioridad haga el resto.
14. Preguntas frecuentes
¿A* encuentra siempre el camino más corto?
Sí, siempre que se cumplan tres condiciones: la heurística es admisible (nunca sobreestima el coste restante), los costes de las aristas son no negativos y la implementación comprueba el objetivo cuando un nodo se extrae, no cuando se genera. Si la heurística es admisible pero no consistente, la implementación también debe permitir reabrir nodos ya expandidos. Si se incumple cualquiera de esas condiciones, A* sigue devolviendo un camino, pero ya no está garantizado que sea el más barato.
¿Cuál es la diferencia entre A* y el algoritmo de Dijkstra?
Son el mismo algoritmo con prioridades distintas. Dijkstra ordena su frontera por g(n), el coste ya pagado, así que se expande hacia fuera en todas direcciones como un círculo que crece. A* ordena por f(n) = g(n) + h(n), de modo que la región que expande es una elipse estirada desde el inicio hacia el objetivo. Con h(n) = 0, A* se convierte exactamente en Dijkstra. Dijkstra es la mejor opción cuando no existe una estimación útil o cuando necesitas distancias a muchos destinos a la vez; A* es la mejor opción para un único destino con una estimación decente disponible.
¿Cuál es la diferencia entre una heurística admisible y una consistente?
Admisible significa que h(n) nunca es mayor que el coste restante real h*(n). Consistente, también llamada monótona, es la desigualdad triangular más fuerte h(n) <= cost(n, n') + h(n') para cada arista, con h(goal) = 0. Toda heurística consistente es admisible, pero no al revés. La consistencia importa porque garantiza que la primera vez que A* extrae un nodo, su valor g ya es óptimo, y eso es lo que hace seguro un conjunto cerrado. Con una heurística solo admisible, más tarde puede aparecer una ruta más barata hacia un nodo cerrado y hay que reabrirlo.
¿Cuál es la complejidad temporal y espacial de A*?
En el peor caso ambas son O(b^d), exponenciales en la profundidad de la solución. El número de expansiones solo se mantiene polinómico cuando el error de la heurística está acotado logarítmicamente, algo que casi nunca ocurre en la práctica, así que una heurística mejor reduce la base del exponente en lugar de eliminarlo. En un grafo explícito que ya está en memoria, A* se comporta como Dijkstra, con O(E log V) usando un montículo binario. El espacio es el límite práctico: A* almacena todos los nodos que genera, y por eso existen variantes con memoria acotada como IDA* y SMA*.
¿Por qué se llama A* y es un algoritmo de IA o de grafos?
La estrella es la notación que el artículo de 1968 usa para las cantidades óptimas, como en g*, h* y f*: el procedimiento a secas se llama A, y A* es la versión cuya heurística nunca sobrestima, así que devuelve un camino de coste mínimo. Es a la vez un algoritmo de IA y de grafos. Se enseña en los cursos de IA como el método canónico de búsqueda informada, y es un algoritmo de camino más corto en grafos ponderados. No es aprendizaje automático: no se entrena nada ni se ajustan datos. Todo el conocimiento reside en la función heurística que proporcionas, aunque un modelo aprendido puede perfectamente usarse para proporcionarla.
¿Es A* completo y qué pasa si no existe ningún camino?
A* es completo en un grafo con factor de ramificación finito cuyos costes de arista están acotados inferiormente por algún valor positivo: si existe una solución, la encontrará. Cuando no existe ningún camino, la frontera se vacía después de expandir toda la componente alcanzable y el algoritmo informa del fracaso. Ese caso de fracaso es el caro, ya que demostrar que no existe nada implica explorar todo lo alcanzable, lo que es una buena razón para añadir una comprobación previa de conectividad en mapas grandes.
Mira cómo avanza la frontera
Ejecuta Dijkstra sobre tu propio grafo en el visualizador interactivo. Es A* con h igual a cero, así que lo que ves extenderse hacia fuera es exactamente el trabajo que ahorra una buena heurística.
Abrir el visualizador