Table des Matières
- 1. Qu'est-ce que l'algorithme de recherche A* ?
- 2. D'où vient A* : Hart, Nilsson et Raphael (1968)
- 3. La fonction d'évaluation f(n) = g(n) + h(n)
- 4. Comment A* s'exécute, pas à pas
- 5. Un exemple détaillé sur un graphe pondéré
- 6. Heuristiques admissibles et cohérentes
- 7. Pourquoi A* est optimal, et quand il ne l'est pas
- 8. Complexité en temps et en espace
- 9. Comment concevoir une bonne heuristique
- 10. A* vs Dijkstra, UCS, recherche gloutonne et BFS
- 11. Les variantes de A* à connaître
- 12. Erreurs courantes dans les implémentations de A*
- 13. Où A* est réellement utilisé
- 14. Questions fréquentes
1. Qu'est-ce que l'algorithme de recherche A* ?
A* (prononcé « A étoile ») est un algorithme de recherche dans les graphes de type meilleur d'abord, qui trouve un chemin de coût minimal entre un nœud de départ et un nœud but. En intelligence artificielle, on le classe parmi les algorithmes de recherche informée : contrairement au parcours en largeur ou à la recherche à coût uniforme, qui ne connaissent que ce qui a déjà été payé, A* utilise aussi une estimation de ce qui reste à parcourir.
Chaque nœud que A* conserve dans sa frontière porte trois nombres :
- g(n) : le coût exact du meilleur chemin trouvé jusqu'ici entre le nœud de départ et
n. - h(n) : la fonction heuristique, une estimation du coût minimal depuis
njusqu'à un but. - f(n) = g(n) + h(n) : le coût estimé de la solution complète la moins chère passant par
n.
L'algorithme développe à chaque étape le nœud de la frontière dont la valeur f est la plus petite. Cette seule règle produit la propriété qui a fait la célébrité de A* : si l'heuristique ne surestime jamais le coût restant réel, le premier nœud but que A* retire de la frontière se trouve sur un chemin optimal.
Rien dans cette définition ne parle de grilles ni de jeux vidéo. A* est défini sur n'importe quel graphe pondéré à coûts d'arêtes positifs ou nuls. Le graphe peut être un réseau routier, une carte en tuiles, l'espace d'états d'un taquin, l'espace des configurations d'un robot ou l'ensemble des plans partiels d'un planificateur automatique. La recherche de chemin sur grille est simplement l'image la plus facile à dessiner, et elle est traitée dans le guide compagnon consacré à la recherche de chemin A* sur grille.
2. D'où vient A* : Hart, Nilsson et Raphael (1968)
Peter E. Hart, Nils J. Nilsson et Bertram Raphael, chercheurs au Stanford Research Institute, ont publié "A Formal Basis for the Heuristic Determination of Minimum Cost Paths" dans IEEE Transactions on Systems Science and Cybernetics, volume 4, numéro 2, pages 100 à 107, juillet 1968. La motivation pratique était Shakey, le robot mobile du SRI, qui devait planifier lui-même son itinéraire à travers une série de pièces au lieu de suivre un parcours prédéfini.
Deux apports de cet article définissent encore le sujet :
- Il a séparé la procédure de recherche des connaissances qu'elle utilise. La même boucle devient un algorithme différent selon la fonction
hqu'on lui fournit. La stratégie de recherche est devenue un paramètre plutôt qu'une décision de conception. - Il a démontré les garanties. Si
hne surestime jamais le coût restant réel, la procédure renvoie un chemin de coût minimal. Un résultat complémentaire a montré qu'aucun autre algorithme disposant de la même information heuristique ne peut développer moins de nœuds tout en garantissant l'optimalité.
Le nom est une notation qui est restée. L’article de 1968 marque d’une étoile les quantités optimales : g* est le coût minimal du départ à un sommet, h* le coût minimal de ce sommet jusqu’à un but, et f* leur somme. La procédure nue s’appelle A, et A* en est la version qui atteint ces quantités, celle dont l’heuristique ne surestime jamais h*. Ce n’est pas une abréviation et cela ne veut rien dire d’autre.
Une note de 1972 parue dans la SIGART Newsletter a corrigé l'argument d'optimalité d'origine. La preuve de 1968 reposait sur ce que les auteurs appelaient l'hypothèse de cohérence, et la correction a précisé ce qui doit changer lorsqu'une heuristique est admissible sans être cohérente : les nœuds déjà développés doivent pouvoir être rouverts. Cette distinction fait l'objet de la section 6 ci-dessous, et plus de cinquante ans plus tard, elle reste la cause la plus fréquente d'implémentations de A* silencieusement fausses.
Si c'est une citation qui vous amène ici : Hart, P. E., Nilsson, N. J., et Raphael, B. (1968). "A Formal Basis for the Heuristic Determination of Minimum Cost Paths." IEEE Transactions on Systems Science and Cybernetics 4(2), 100 à 107.
3. La fonction d'évaluation f(n) = g(n) + h(n)
Tout ce que fait A* découle de la façon dont il ordonne sa frontière. La fonction d'évaluation sépare l'estimation d'une solution en une partie connue exactement et une partie devinée :
f(n) = g(n) + h(n)

g(n)   coût déjà payé         exact, mesuré le long du chemin effectivement suivi
h(n)   coût restant à payer   estimé par la fonction heuristique
f(n)   estimation totale      la valeur selon laquelle la file de priorité trie
L'intérêt de cette conception est qu'un seul composant contrôle tout le comportement de la recherche :
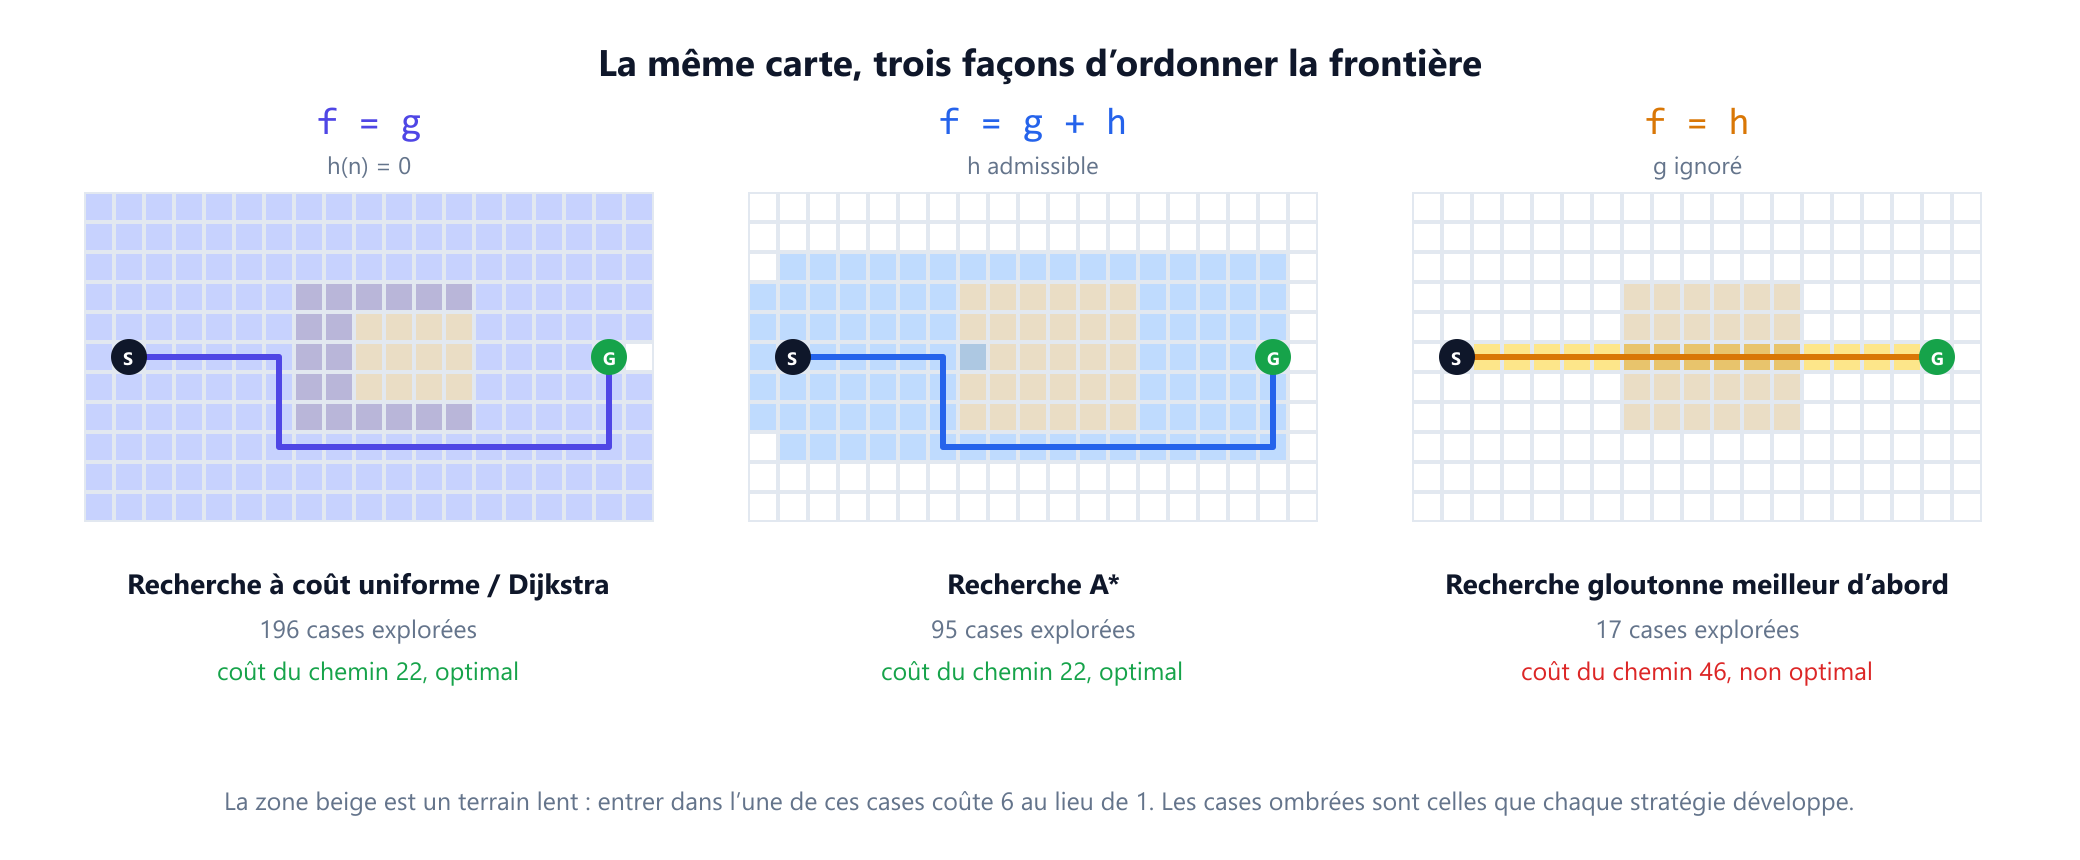
- h(n) = 0 partout. Alors
f = get A* dégénère en recherche à coût uniforme, qui, sur un graphe à poids positifs ou nuls, est exactement l'algorithme de Dijkstra. Correct, mais non informé : il développe tous les nœuds moins chers que le but, dans toutes les directions. - h(n) = h*(n), le coût restant réel. A* suit tout droit un chemin optimal et ne développe presque rien d'autre. C'est le plafond théorique, inaccessible en pratique, car calculer
h*est précisément le problème que vous cherchiez à résoudre. - Ignorer g et trier selon h seul. C'est la recherche gloutonne meilleur d'abord. Elle est rapide, se trompe souvent lourdement et n'offre aucune garantie d'optimalité.
- Repondérer : f = g + w × h avec w > 1. Weighted A* (A* pondéré) échange une perte bornée de qualité de solution contre un gain de vitesse important. Le chemin renvoyé n'est jamais pire que
wfois le coût optimal.
Lisez cette liste comme une échelle du degré de confiance accordé à l'estimation. A* se situe au milieu et consacre un effort proportionnel à ce que l'heuristique ignore : une heuristique précise produit une recherche qui ressemble à une ligne droite, une heuristique faible une recherche qui ressemble à Dijkstra.
4. Comment A* s'exécute, pas à pas
La frontière est une file de priorité, traditionnellement appelée OPEN, ordonnée selon f. Une table des meilleures valeurs g connues et une table de pointeurs vers les parents complètent l'état.
function a_star(start, goal, h):
    open   = priority queue ordered by f        # la frontière
    g      = map with default infinity          # meilleur coût connu depuis le départ
    parent = map                                # pour reconstruire le chemin

    g[start] = 0
    open.push(start, h(start))

    while open is not empty:
        current = open.pop_min()                # nœud de plus petit f
        if current == goal:
            return reconstruct(parent, goal)    # test du but à la sortie, pas à la génération

        for (next, cost) in edges(current):
            tentative = g[current] + cost
            if tentative < g[next]:             # un chemin moins cher vers next
                g[next]      = tentative
                parent[next] = current
                open.push_or_update(next, tentative + h(next))

    return failure                              # le but est inaccessible
Quatre détails d'implémentation concentrent l'essentiel de la subtilité :
- Le test du but a lieu quand un nœud sort de la file, pas quand il est généré. Un but peut être généré tôt par un itinéraire coûteux. S'arrêter à ce moment vous donne un chemin, mais pas le moins cher. L'exemple détaillé ci-dessous contient un cas où tester à la génération coûte 7 unités de plus que les 13 optimales.
- La relaxation est conditionnée par
tentative < g[next], et non par l'appartenance à un ensemble fermé. Écrite ainsi, la boucle rouvre automatiquement un nœud déjà développé lorsqu'un chemin moins cher vers lui apparaît plus tard, et c'est ce qui la rend correcte pour toute heuristique admissible. - La plupart des files de priorité n'offrent pas d'opération de diminution de clé. Le code de production insère généralement une entrée en double avec la meilleure valeur
fet ignore les entrées périmées à leur sortie. C'est ce qu'on appelle la suppression paresseuse : elle coûte un peu de mémoire et épargne beaucoup de gestion. - Le chemin se reconstruit à rebours. Suivez les pointeurs parents du but jusqu'au départ, puis inversez la liste. A* ne stocke jamais de chemins, seulement un parent par nœud.
5. Un exemple détaillé sur un graphe pondéré
Les animations sur grille masquent l'arithmétique. Voici un petit graphe pondéré, du type utilisé dans les cours d'IA, déroulé à la main du début à la fin.
Six nœuds : S (départ), A, B, C, D et G (but). Les coûts des arêtes sont des distances routières, et l'heuristique h est la distance à vol d'oiseau jusqu'à G, ce qui la rend admissible : une ligne droite n'est jamais plus longue qu'une route.
Arêtes (non orientées, coût)  Heuristique h(n)
S-A  4      A-C  5            S = 11    C = 5
S-B  3      A-D  12           A =  9    D = 3
S-G  20     B-D  7            B =  8    G = 0
C-G  6      D-G  3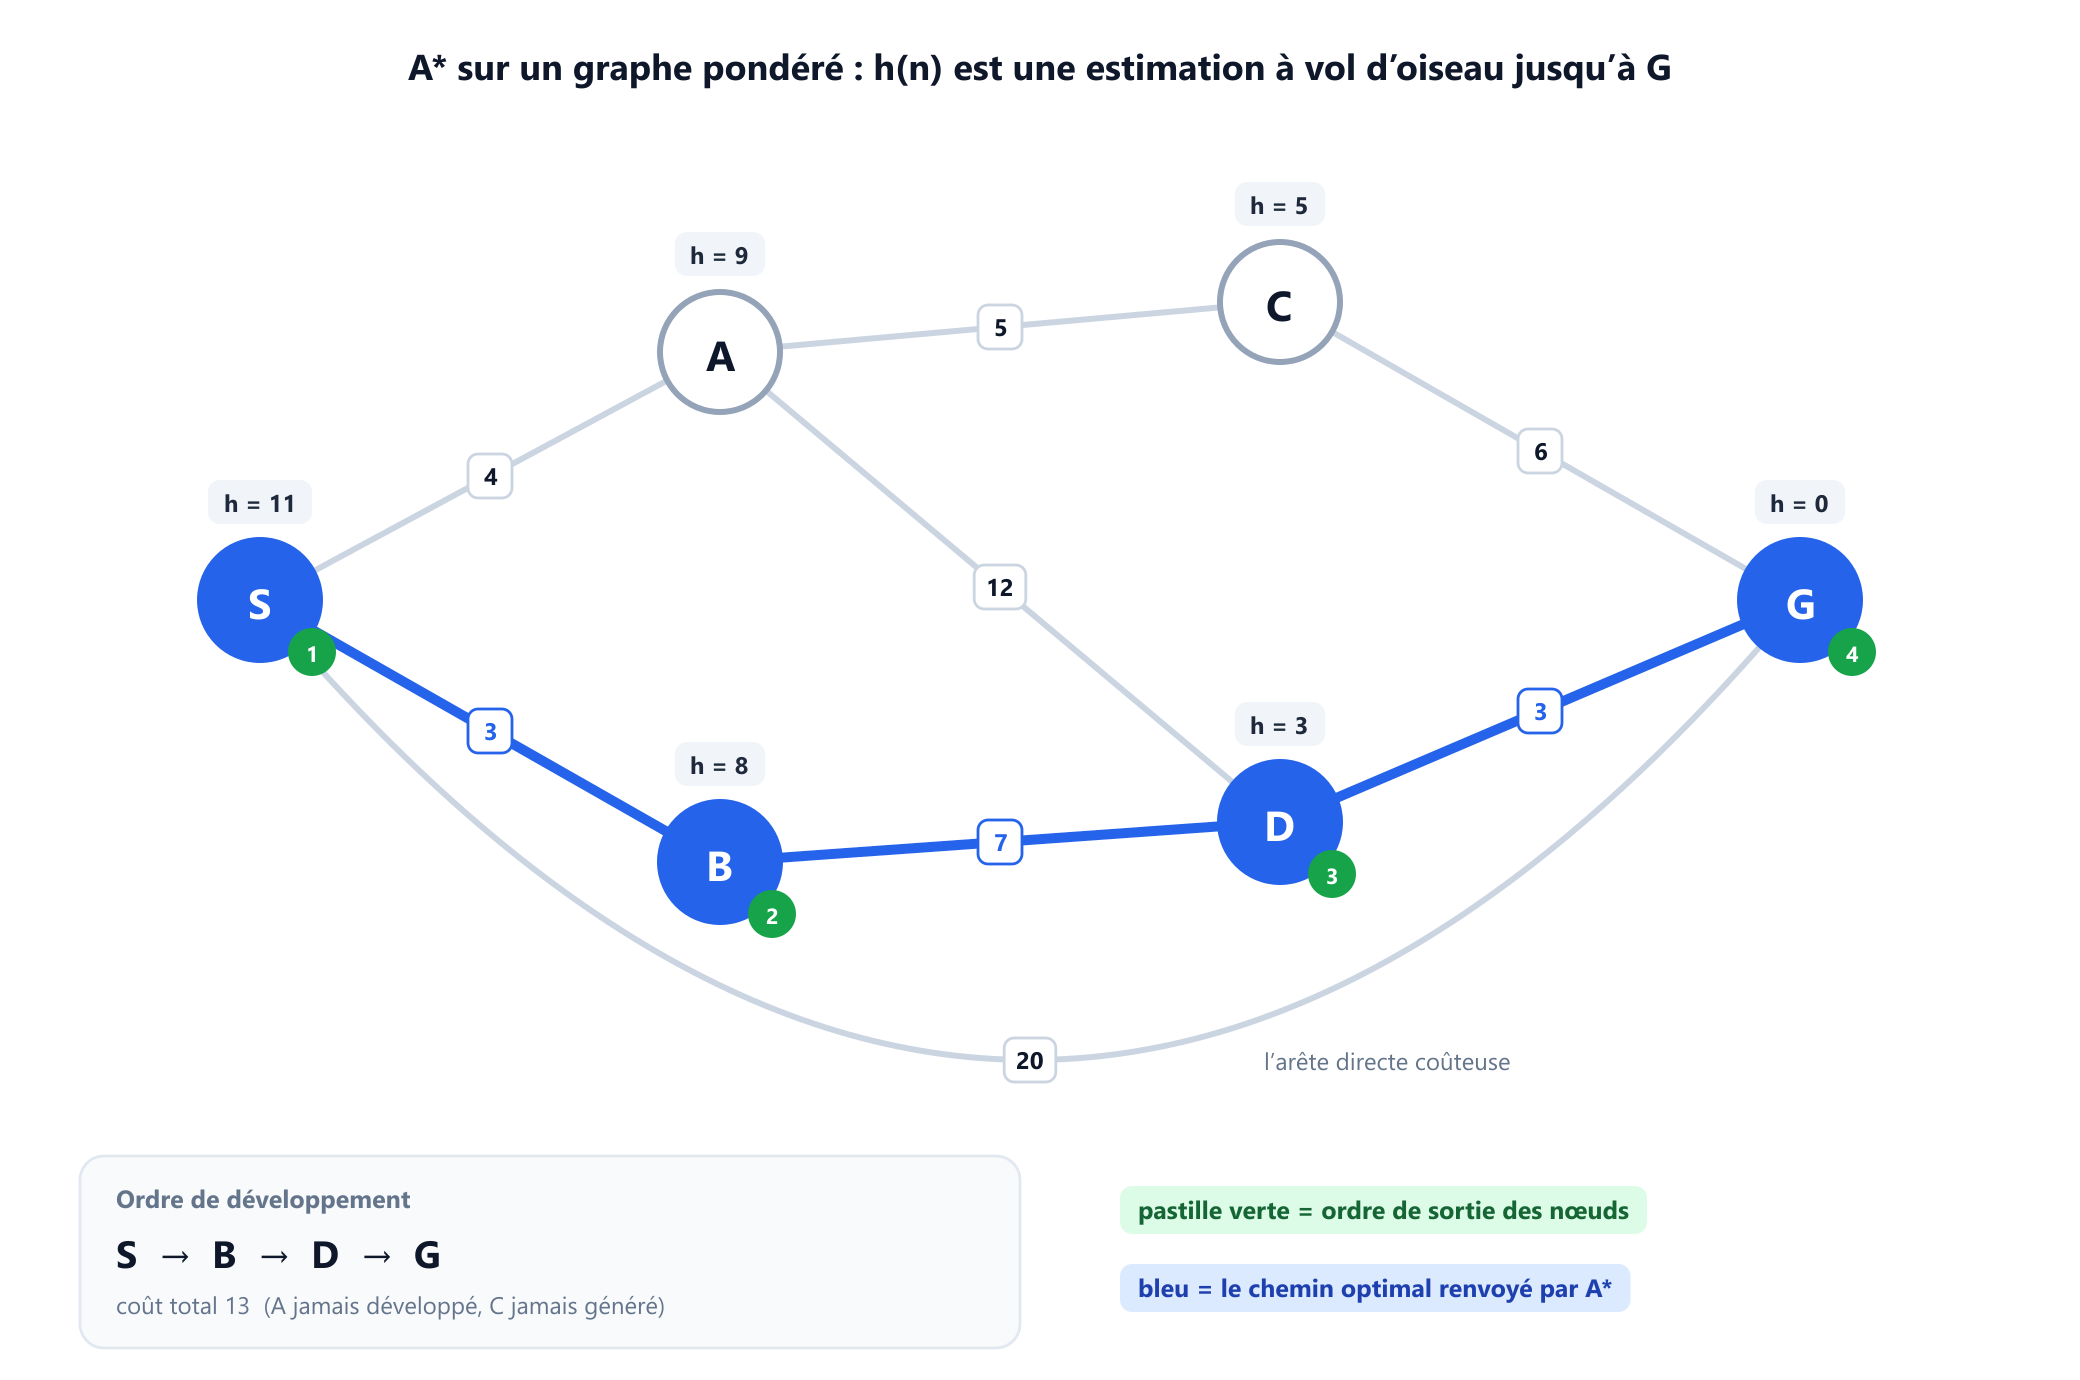
A* sort le nœud dont la valeur f est la plus petite, en départageant les égalités au profit du plus petit h, règle de départage standard car elle favorise les nœuds proches du but :
| Étape | Sorti | g | h | f | Frontière après l'étape |
|---|---|---|---|---|---|
| 1 | S | 0 | 11 | 11 | B 11, A 13, G 20 |
| 2 | B | 3 | 8 | 11 | A 13, D 13, G 20 |
| 3 | D | 10 | 3 | 13 | G 13 (amélioré depuis 20), A 13 |
| 4 | G | 13 | 0 | 13 | but sorti, fin de la recherche |
La réponse est S → B → D → G pour un coût de 13. Trois points de cette trace méritent qu'on s'y arrête :
- Le but a été généré à l'étape 1 avec f = 20, puis ignoré. Une implémentation qui s'arrête dès qu'elle génère le but aurait renvoyé un chemin de coût 20, soit 54 pour cent de plus que l'optimum. A* le garde dans la frontière et ne l'accepte qu'une fois qu'il ne reste rien de moins cher.
- Le nœud C n'a même jamais été généré. Sur le même graphe, Dijkstra développe tous les nœuds à distance inférieure à 13, dont C à distance 9. A* n'y touche jamais, car la frontière ne va jamais aussi loin.
- Le nœud A a été généré mais jamais développé. Sa valeur
fde 13 est à égalité avec le but, et comme une égalité enf = C*peut être tranchée dans un sens ou dans l'autre, A n'a jamais valu la peine d'être ouvert. C'est exactement le cas limite dont parle le théorème d'efficacité optimale.
6. Heuristiques admissibles et cohérentes
Deux propriétés de h méritent d'être soigneusement distinguées, car on les emploie souvent comme si elles étaient identiques, ce qui n'est pas le cas.
Admissibilité
Une heuristique est admissible si elle ne surestime jamais :
h(n) <= h*(n)   pour tout nœud n
                où h*(n) est le vrai coût minimal de n à un but
L'admissibilité, c'est de l'optimisme. L'heuristique peut se tromper énormément, du moment qu'elle se trompe par défaut. h = 0 est admissible, et c'est pourquoi Dijkstra est un cas particulier de A* plutôt qu'un rival.
Cohérence, aussi appelée monotonie
Une heuristique est cohérente si elle satisfait une inégalité triangulaire le long de chaque arête :
h(n) <= cost(n, n') + h(n')   pour toute arête de n vers n'
h(goal) = 0
Autrement dit : faire un pas ne peut jamais réduire votre estimation de plus que ce que ce pas a réellement coûté. La cohérence est la propriété la plus forte. Toute heuristique cohérente est admissible ; la réciproque est fausse.
La conséquence pratique est précise. Lorsque h est cohérente, f ne décroît jamais le long d'un chemin, donc la première fois que A* sort un nœud, sa valeur g est déjà optimale. C'est ce qui autorise l'optimisation bien connue consistant à placer les nœuds développés dans un ensemble fermé et à ne plus jamais les examiner.
Lorsque h est seulement admissible, cette autorisation tombe. Un chemin moins cher vers un nœud déjà développé peut encore être découvert, et si l'implémentation refuse de le rouvrir, la réponse finale peut être fausse. Voici un graphe où c'est exactement ce qui se produit :
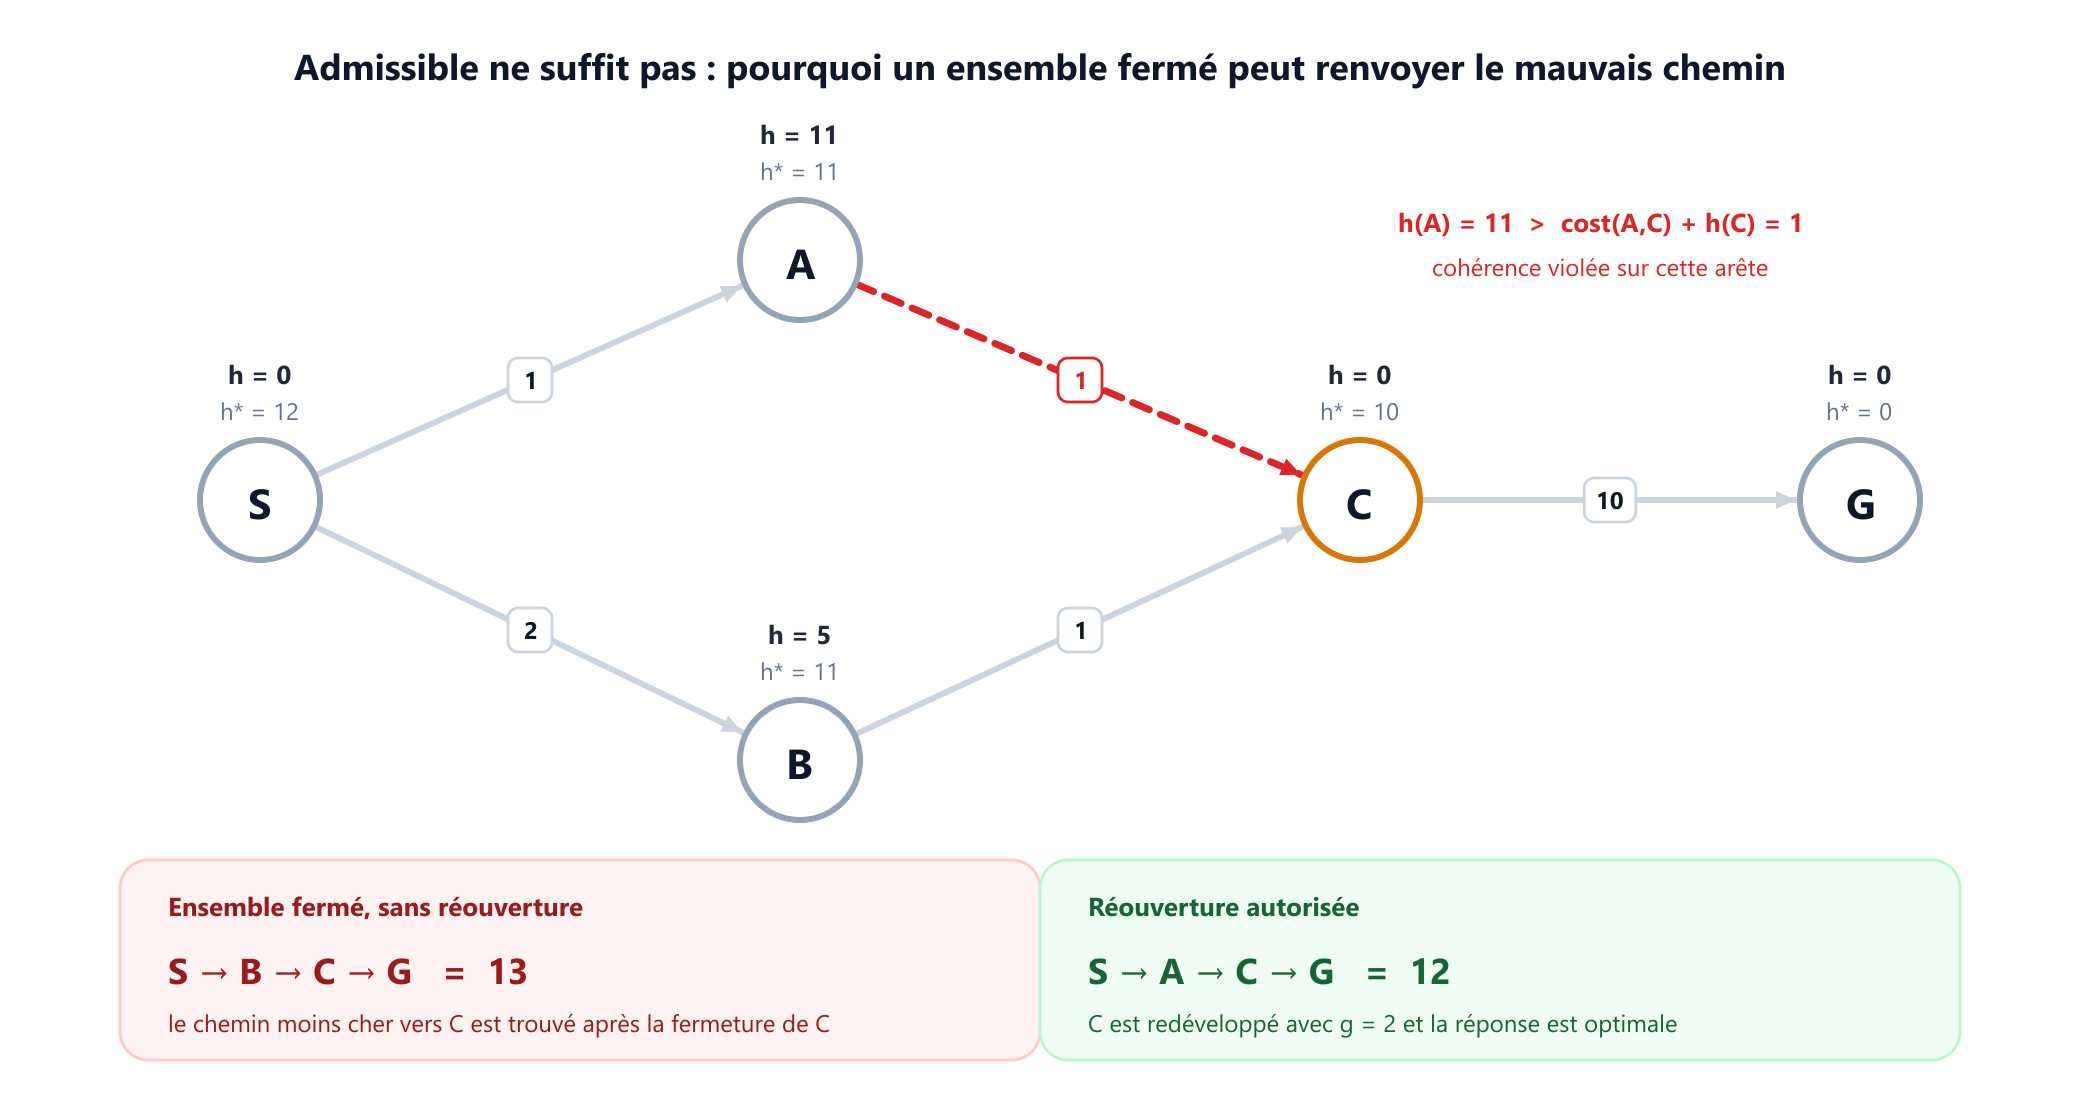
Arêtes (orientées, coût)   Heuristique h(n)   Coût réel h*(n)
S -> A   1                 S =  0             S = 12
S -> B   2                 A = 11             A = 11
A -> C   1                 B =  5             B = 11
B -> C   1                 C =  0             C = 10
C -> G  10                 G =  0             G =  0

Chaque h(n) <= h*(n), donc l'heuristique est admissible.
L'arête A -> C viole la cohérence : h(A) = 11 > cost(A,C) + h(C) = 1.
Déroulons : A* sort S (f = 0) et génère A avec f = 1 + 11 = 12 et B avec f = 2 + 5 = 7. Il sort B (f = 7) et génère C avec g = 3, f = 3. Il sort C (f = 3), le ferme avec g = 3 et génère G avec f = 13. Ce n'est qu'ensuite qu'il sort A (f = 12) et découvre un chemin vers C qui ne coûte que 2. Si C est fermé et que fermé signifie définitif, cette découverte est ignorée et l'algorithme renvoie 13 au lieu de l'optimum 12.
Deux issues, et il faut en choisir une en connaissance de cause : prouver que votre heuristique est cohérente et conserver l'optimisation de l'ensemble fermé, ou écrire la relaxation sous la forme tentative < g[next] sans test d'ensemble fermé, pour que la réouverture se fasse d'elle-même. Bonne nouvelle : presque toutes les heuristiques utilisées en pratique, dont la distance à vol d'oiseau, la distance de Manhattan sur une grille à coût uniforme et toute heuristique dérivée d'un problème relâché, sont cohérentes. C'est précisément pourquoi ce bogue peut survivre des années avant qu'une carte inhabituelle ne le révèle.
7. Pourquoi A* est optimal, et quand il ne l'est pas
L'argument d'optimalité est assez court pour se retenir, et il mérite d'être connu, car il indique exactement quelle hypothèse vérifier lorsque A* se comporte mal.
Soit C* le coût d'une solution optimale. Supposons que A* soit sur le point de sortir un nœud but G2 atteint par un chemin sous-optimal, de sorte que g(G2) > C*. Puisque h(G2) = 0, sa priorité vaut f(G2) = g(G2) > C*. Considérons maintenant un chemin optimal quelconque entre le départ et un véritable but optimal. Juste avant la sortie, ce chemin doit compter au moins un nœud n dans la frontière, car le départ a été développé et le but non. Pour ce nœud, g(n) est le coût optimal pour l'atteindre et, comme h est admissible, f(n) = g(n) + h(n) <= g(n) + h*(n) = C*. Donc f(n) <= C* < f(G2), et A* aurait sorti n en premier. Cette contradiction prouve que le premier but sorti est optimal.
Le même raisonnement donne les conditions dans lesquelles la garantie tombe :
- L'heuristique surestime quelque part. L'inégalité
f(n) <= C*ne tient plus, et A* peut passer à côté du chemin optimal. Ce n'est pas toujours une catastrophe, mais la garantie disparaît et il faut le signaler dans le code. - Coûts d'arêtes négatifs. A* suppose des coûts positifs ou nuls, tout comme Dijkstra. Avec des arêtes négatives, l'ordre de la frontière ne signifie plus rien. Utilisez plutôt Bellman-Ford.
- Des coûts qui changent pendant la recherche. Le A* statique n'a pas de réponse face à une porte qui se ferme en cours de plan. C'est à cela que servent D* Lite et Lifelong Planning A*.
- Graphes infinis ou non bornés. La complétude exige un facteur de branchement fini et des coûts d'arêtes minorés par un epsilon strictement positif. Sans cela, A* peut poursuivre une suite infinie d'étapes toujours moins chères sans jamais terminer.
Un dernier résultat complète la théorie. Dechter et Pearl ont démontré en 1985 que A* est optimalement efficace : aucun autre algorithme optimal utilisant la même information heuristique n'est assuré de développer moins de nœuds. Tout nœud tel que f(n) < C* doit être développé par un tel algorithme, et A* développe exactement ceux-là, plus un sous-ensemble des nœuds situés exactement à f(n) = C*. Il n'y a pas d'ordonnancement plus astucieux à trouver ; le seul levier restant est une meilleure heuristique.
8. Complexité en temps et en espace
La valeur des manuels est O(bd), où b est le facteur de branchement et d la profondeur de la solution optimale, et ce chiffre est honnête mais peu informatif. L'énoncé plus précis porte sur l'erreur de l'heuristique. Le nombre de nœuds développés par A* croît exponentiellement, sauf si l'erreur de l'heuristique est bornée logarithmiquement par rapport au vrai coût :
|h(n) - h*(n)| <= O(log h*(n))Presque aucune heuristique utilisée en pratique ne franchit ce seuil, la lecture honnête est donc que A* est exponentiel dans le pire cas et qu'une bonne heuristique réduit la base de l'exposant plutôt que de le supprimer. Sur un graphe explicite déjà en mémoire, le décompte est le même que pour Dijkstra : O(E log V) avec un tas binaire, puisque chaque arête déclenche au plus une mise à jour de la file. La question intéressante n'est pas la borne, mais la faible part de ces V et E que la recherche touche réellement.
La mémoire est la contrainte qui pèse vraiment. A* garde en mémoire chaque nœud généré, la frontière comme l'ensemble exploré, si bien que sa complexité en espace égale sa complexité en temps. Les systèmes réels manquent de RAM bien avant de manquer de patience. Ce seul fait explique toute la famille de variantes présentée en section 11 : A* à approfondissement itératif, A* simplifié à mémoire bornée et troncatures de type faisceau existent tous pour échanger l'optimalité ou du travail répété contre une frontière qui tient en mémoire.
9. Comment concevoir une bonne heuristique
Puisque l'algorithme est fixé et d'une efficacité démontrée, tout le travail d'ingénierie se concentre dans h. Il existe une recette fiable pour en construire une.
Relâcher le problème
Prenez le vrai problème, supprimez une contrainte et résolvez exactement ce qui reste. Le coût exact d'un problème relâché est toujours un minorant du coût réel, l'heuristique est donc admissible par construction, et comme une solution relâchée peut se construire pas à pas, elle est aussi cohérente.
Le taquin à 8 pièces est l'illustration classique. Une pièce peut glisser vers la case vide adjacente. En supprimant des contraintes, on obtient deux heuristiques classiques :
- h1, pièces mal placées. Autorisez n'importe quelle pièce à se téléporter n'importe où en un coup. Le coût est alors simplement le nombre de pièces qui ne sont pas à leur position finale.
- h2, distance de Manhattan. Autorisez une pièce à glisser vers n'importe quelle case adjacente, vide ou non. Le coût est alors la somme, sur toutes les pièces, des distances horizontale et verticale jusqu'à la case finale de chaque pièce.
Les deux sont admissibles. La différence en pratique est spectaculaire : sur des instances aléatoires du taquin nécessitant 12 coups, la comparaison classique rapportée par Russell et Norvig montre une recherche en profondeur itérative générant de l'ordre de 3,6 millions de nœuds, A* avec h1 quelques centaines, et A* avec h2 moins d'une centaine. À la profondeur 24, l'écart se creuse : environ 39 000 nœuds pour h1 contre environ 1 600 pour h2. Même algorithme, même code, mais une autre fonction h.
Préférer une heuristique dominante
Si h2(n) >= h1(n) pour tout nœud et que les deux sont admissibles, alors h2 domine h1, et A* avec h2 ne développe jamais plus de nœuds. Plus grand, c'est mieux, jusqu'au plafond h*. C'est pourquoi la distance de Manhattan bat les pièces mal placées : elle est toujours au moins aussi grande et ne surestime jamais.
Combiner plusieurs heuristiques
Si vous disposez de plusieurs heuristiques admissibles dont aucune ne domine les autres, prenez leur maximum. Le maximum d'heuristiques admissibles est admissible et les domine toutes. Le prix est d'évaluer plusieurs fonctions par nœud, le gain doit donc être payé en temps d'évaluation.
Précalculer avec des bases de motifs
Pour un état but fixé, résolvez à l'avance des sous-problèmes de manière exhaustive et stockez les coûts exacts dans une table. Une base de motifs (pattern database) pour un sous-ensemble des pièces fournit un minorant admissible bien plus fort que n'importe quelle formule. C'est la même idée qui fait fonctionner le routage par points de repère sur les réseaux routiers continentaux : précalculer les distances exactes vers une poignée de repères, puis utiliser l'inégalité triangulaire pour borner le reste.
Sur une grille, choisir la métrique adaptée aux déplacements
Distance de Manhattan pour un déplacement dans 4 directions, euclidienne pour un déplacement selon n'importe quel angle, Tchebychev ou octile pour les grilles à 8 directions. Choisir une métrique qui accorde moins de liberté que les règles de déplacement rend l'heuristique non admissible et détruit discrètement la garantie d'optimalité. Le guide de recherche de chemin sur grille détaille les trois avec des calculs chiffrés.
10. A* vs Dijkstra, UCS, recherche gloutonne et BFS
Chacun de ces algorithmes est la même boucle avec une priorité différente. C'est la façon la plus utile de les retenir.
| Algorithme | Priorité de la frontière | Optimal ? | À utiliser quand |
|---|---|---|---|
| Parcours en largeur | ordre d'insertion (FIFO) | Oui, si toutes les arêtes ont le même coût | Graphes non pondérés, nombre minimal de sauts |
| Recherche à coût uniforme / Dijkstra | f = g | Oui | Graphe pondéré, sans estimation utile, ou nombreux buts à la fois |
| Recherche gloutonne meilleur d'abord | f = h | Non | Il faut une solution rapidement et la qualité est négociable |
| A* | f = g + h | Oui, si h est admissible | Un seul but, une estimation correcte existe, le chemin doit être le plus court |
| A* pondéré | f = g + w × h | À un facteur w près | A* est trop lent et un détour borné est acceptable |
L'intuition derrière la comparaison entre A* et Dijkstra est géométrique. Dijkstra développe tout ce qui vérifie g(n) < C*, ce qui, sur une carte dégagée, forme un cercle autour du départ. A* développe tout ce qui vérifie g(n) + h(n) < C*, ce qui forme une ellipse dont le départ et le but sont les foyers. Plus l'heuristique est précise, plus cette ellipse s'aplatit, jusqu'à se réduire au chemin lui-même. Les deux renvoient la même réponse optimale ; ils ne diffèrent que par la part de la carte qu'ils ont dû examiner pour en être sûrs. Pour une vue d'ensemble de la famille, consultez le panorama des algorithmes de plus court chemin, et pour les bases du parcours sur lesquelles tout repose, BFS vs DFS.
11. Les variantes de A* à connaître
Presque toutes les variantes connues répondent à l'une de deux contraintes : la mémoire, ou la nécessité de répondre avant d'avoir prouvé l'optimum.
- A* pondéré multiplie l'heuristique par
w > 1. Les solutions sont garanties à un facteurwde l'optimum près et, en pratique, sont généralement bien meilleures que cette borne tout en s'exécutant un ordre de grandeur plus vite. - IDA* (A* à approfondissement itératif) enchaîne des recherches en profondeur avec un seuil de
fcroissant. La mémoire se réduit à la profondeur de la recherche, au prix du redéveloppement des nœuds à chaque itération. C'est l'outil standard pour les casse-tête aux espaces d'états gigantesques. - SMA* (A* simplifié à mémoire bornée) utilise toute la mémoire qu'on lui donne et, quand elle est épuisée, supprime la pire feuille en mémorisant sa valeur dans le parent. Il reste optimal si le chemin optimal tient en mémoire.
- ARA* et les autres variantes anytime démarrent avec un grand
w, renvoient rapidement une solution, puis l'améliorent tant qu'il reste du temps, en resserrant la borne au fur et à mesure. - D* et D* Lite réparent un plan existant lorsque les coûts des arêtes changent, au lieu de tout replanifier. C'est ce dont a besoin un robot qui découvre un obstacle absent de sa carte.
- Jump Point Search exploite la symétrie des grilles à coût uniforme pour sauter des séries entières de cases identiques. Même réponse que A*, souvent avec un ordre de grandeur de développements en moins, uniquement sur grille.
- A* bidirectionnel cherche simultanément vers l'avant depuis le départ et vers l'arrière depuis le but. Il est puissant mais délicat, car la condition d'arrêt comme les exigences de cohérence de l'heuristique deviennent plus difficiles.
- ALT et contraction hierarchies sont ce que les calculateurs d'itinéraires en production exécutent réellement. Le A* simple est trop lent sur les réseaux routiers continentaux ; ces méthodes précalculent donc des distances vers des repères ou des arêtes raccourcis, puis cherchent dans un graphe effectif beaucoup plus petit.
12. Erreurs courantes dans les implémentations de A*
La plupart des bogues de A* ne font pas planter le programme. Ils renvoient un chemin un peu trop long, pour certaines entrées, parfois. Voici les causes récurrentes :
- Des unités incompatibles.
gmesuré en secondes ethmesuré en mètres, c'est le grand classique. Sihest surévaluée, même légèrement, elle cesse d'être admissible et la garantie disparaît. Convertissez les deux dans la même monnaie avant de les additionner. - Un ensemble fermé avec une heuristique incohérente. Le mode d'échec de la section 6. Si vous ne pouvez pas prouver la cohérence, autorisez la réouverture.
- Aucun départage des égalités. Quand de nombreux nœuds partagent la même valeur
f, un ordre arbitraire pousse A* à explorer un large plateau de cases tout aussi prometteuses. Départager en faveur du plus petithne coûte rien et préserve toutes les garanties. L'autre astuce courante, multiplierhpar 1 + epsilon, resserre considérablement la recherche sur grille mais rend l'heuristique très légèrement non admissible : utilisez-la en sachant que vous avez échangé la preuve contre la vitesse. - Tester le but à la génération. Rapide, tentant, et cela renvoie silencieusement des chemins sous-optimaux, comme l'a montré l'exemple détaillé.
- Comparaisons en virgule flottante. Les heuristiques euclidiennes produisent des valeurs irrationnelles, et les tests d'égalité stricte sur
fse comportent de façon imprévisible. Comparez avec une tolérance, ou gardez des coûts entiers. - Oublier h(goal) = 0. Une estimation non nulle au but viole la cohérence sur la dernière arête et peut fausser toute la recherche.
- Recalculer h à chaque opération sur la file. L'heuristique est appelée en permanence. Mettez-la en cache dans le nœud ; les profileurs trouvent ce problème encore et encore.
- Des états mutables utilisés comme clés de dictionnaire. Dans la recherche sur les casse-tête, un plateau modifié sur place corrompt l'ensemble des états visités. Stockez un encodage immuable.
13. Où A* est réellement utilisé
A* a sa place partout où il faut trouver la meilleure suite de décisions dans un espace trop grand pour être énuméré :
- Robotique et planification de mouvement. L'application d'origine de Shakey, toujours d'actualité : planificateurs sur grille et sur treillis pour robots mobiles, flottes d'entrepôt et véhicules autonomes, généralement avec D* Lite pour replanifier quand le monde change.
- IA de jeux vidéo. Des unités qui se déplacent sur des maillages de navigation et des cartes en tuiles, généralement avec une décomposition hiérarchique par-dessus, de sorte qu'un long chemin est d'abord planifié grossièrement puis affiné localement.
- Calcul d'itinéraires. Les calculateurs d'itinéraires utilisent des dérivés de A* avec des heuristiques à repères ou des contraction hierarchies, et c'est ainsi qu'un itinéraire continental est obtenu en quelques millisecondes.
- Casse-tête et recherche dans l'espace d'états. Taquins, solveurs de Rubik's Cube et problèmes combinatoires similaires, généralement avec IDA* et des bases de motifs, car les espaces d'états sont bien trop grands pour qu'une frontière tienne en mémoire.
- Planification automatique. Les planificateurs classiques explorent l'espace des états du monde avec des heuristiques dérivées automatiquement d'une version relâchée du problème de planification, autrement dit la recette de relaxation de la section 9 appliquée mécaniquement.
- Bio-informatique. L'alignement multiple de séquences est un problème de plus court chemin dans un treillis de grande dimension, et A* avec une borne admissible est une méthode exacte standard.
- Décodage de la parole et du langage. La recherche A* sur un treillis de mots, où
gest le score de l'hypothèse partielle ethborne la meilleure complétion, reste une stratégie de décodage classique des manuels.
Le schéma est toujours le même. Modélisez le problème comme un graphe, trouvez un minorant admissible du coût restant et laissez la file de priorité faire le reste.
14. Questions fréquentes
A* trouve-t-il toujours le plus court chemin ?
Oui, à trois conditions : l'heuristique est admissible (elle ne surestime jamais le coût restant), les coûts des arêtes sont positifs ou nuls, et l'implémentation teste le but quand un nœud sort de la file plutôt que lorsqu'il est généré. Si l'heuristique est admissible sans être cohérente, l'implémentation doit aussi autoriser la réouverture des nœuds déjà développés. Enfreignez l'une de ces conditions et A* renvoie toujours un chemin, mais rien ne garantit plus qu'il soit le moins cher.
Quelle est la différence entre A* et l'algorithme de Dijkstra ?
C'est le même algorithme avec des priorités différentes. Dijkstra ordonne sa frontière selon g(n), le coût déjà payé, et s'étend donc dans toutes les directions comme un cercle qui grandit. A* ordonne selon f(n) = g(n) + h(n), si bien que la région développée est une ellipse étirée du départ vers le but. Avec h(n) = 0, A* devient exactement Dijkstra. Dijkstra est le meilleur choix lorsqu'aucune estimation utile n'existe ou lorsqu'il faut les distances vers de nombreuses destinations à la fois ; A* est le meilleur choix pour une seule destination avec une estimation correcte disponible.
Quelle est la différence entre une heuristique admissible et une heuristique cohérente ?
Admissible signifie que h(n) n'est jamais supérieur au vrai coût restant h*(n). Cohérente, aussi appelée monotone, désigne l'inégalité triangulaire plus forte h(n) <= cost(n, n') + h(n') pour chaque arête, avec h(goal) = 0. Toute heuristique cohérente est admissible, mais pas l'inverse. La cohérence compte, car elle garantit que la première fois que A* sort un nœud, sa valeur g est déjà optimale, ce qui rend un ensemble fermé sûr. Avec une heuristique seulement admissible, un chemin moins cher vers un nœud fermé peut encore apparaître plus tard, et le nœud doit être rouvert.
Quelle est la complexité en temps et en espace de A* ?
Dans le pire cas, les deux sont en O(b^d), exponentielles en la profondeur de la solution. Le nombre de développements ne reste polynomial que si l'erreur de l'heuristique est bornée logarithmiquement, ce qui n'arrive presque jamais en pratique ; une meilleure heuristique réduit donc la base de l'exposant plutôt que de le supprimer. Sur un graphe explicite déjà en mémoire, A* se comporte comme Dijkstra, en O(E log V) avec un tas binaire. L'espace est la limite pratique : A* stocke chaque nœud qu'il génère, d'où l'existence de variantes à mémoire bornée comme IDA* et SMA*.
Pourquoi s'appelle-t-il A*, et est-ce un algorithme d'IA ou un algorithme de graphes ?
L’étoile est la notation que l’article de 1968 emploie pour les quantités optimales, comme dans g*, h* et f* : la procédure nue s’appelle A, et A* en est la version dont l’heuristique ne surestime jamais, si bien qu’elle renvoie un chemin de coût minimal. C'est à la fois un algorithme d'IA et un algorithme de graphes. On l'enseigne dans les cours d'IA comme la méthode canonique de recherche informée, et c'est un algorithme de plus court chemin sur les graphes pondérés. Ce n'est pas de l'apprentissage automatique : rien n'est entraîné et aucune donnée n'est ajustée. Toute la connaissance réside dans la fonction heuristique que vous fournissez, même si un modèle appris peut tout à fait servir à en fournir une.
A* est-il complet, et que se passe-t-il s'il n'existe aucun chemin ?
A* est complet sur un graphe à facteur de branchement fini dont les coûts d'arêtes sont minorés par une valeur strictement positive : si une solution existe, il la trouve. Lorsqu'aucun chemin n'existe, la frontière se vide après le développement de toute la composante accessible, et l'algorithme signale un échec. Ce cas d'échec est le plus coûteux, puisque prouver qu'il n'existe rien revient à explorer tout ce qui est accessible, ce qui justifie d'ajouter une vérification préalable de connexité sur les grandes cartes.
Regardez la frontière avancer
Exécutez Dijkstra sur votre propre graphe dans le visualiseur interactif. C'est A* avec h égal à zéro : ce que vous voyez se propager vers l'extérieur correspond exactement au travail qu'une bonne heuristique élimine.
Lancer le visualiseur