Inhaltsverzeichnis
- 1. Was ist der A*-Suchalgorithmus?
- 2. Woher A* kommt: Hart, Nilsson und Raphael (1968)
- 3. Die Bewertungsfunktion f(n) = g(n) + h(n)
- 4. Wie A* Schritt für Schritt abläuft
- 5. Ein Rechenbeispiel auf einem gewichteten Graphen
- 6. Zulässige und konsistente Heuristiken
- 7. Warum A* optimal ist, und wann nicht
- 8. Zeit- und Speicherkomplexität
- 9. Wie man eine gute Heuristik entwirft
- 10. A* vs. Dijkstra, UCS, gierige Bestensuche und BFS
- 11. Varianten von A*, die man kennen sollte
- 12. Häufige Fehler in A*-Implementierungen
- 13. Wo A* tatsächlich eingesetzt wird
- 14. Häufig gestellte Fragen
1. Was ist der A*-Suchalgorithmus?
A* (ausgesprochen „A-Stern“) ist ein Best-First-Graphsuchalgorithmus, der einen Weg minimaler Kosten von einem Startknoten zu einem Zielknoten findet. In der künstlichen Intelligenz wird er als informierte Suche eingestuft: Anders als Breitensuche oder uniforme Kostensuche, die nur wissen, was bereits bezahlt ist, nutzt A* zusätzlich eine Schätzung dessen, was noch bevorsteht.
Jeder Knoten, den A* in seiner Front hält, trägt drei Zahlen:
- g(n): die exakten Kosten des besten bisher gefundenen Weges vom Startknoten zu
n. - h(n): die Heuristik, eine Schätzung der günstigsten Kosten von
nzu einem Ziel. - f(n) = g(n) + h(n): die geschätzten Kosten der günstigsten vollständigen Lösung, die durch
nführt.
Der Algorithmus expandiert wiederholt den Frontknoten mit dem kleinsten f. Diese eine Regel erzeugt die Eigenschaft, für die A* berühmt ist: Wenn die Heuristik die tatsächlichen Restkosten nie überschätzt, liegt der erste Zielknoten, den A* aus der Front entnimmt, auf einem optimalen Weg.
Nichts in dieser Definition erwähnt Gitter oder Videospiele. A* ist auf jedem gewichteten Graphen mit nichtnegativen Kantenkosten definiert. Der Graph kann ein Straßennetz sein, eine Kachelkarte, der Zustandsraum eines Schiebepuzzles, der Konfigurationsraum eines Roboters oder die Menge der Teilpläne in einem automatischen Planer. Wegsuche auf Gittern ist lediglich das Bild, das sich am leichtesten zeichnen lässt, und sie wird im begleitenden Leitfaden zur A*-Wegsuche auf Gittern behandelt.
2. Woher A* kommt: Hart, Nilsson und Raphael (1968)
Peter E. Hart, Nils J. Nilsson und Bertram Raphael vom Stanford Research Institute veröffentlichten "A Formal Basis for the Heuristic Determination of Minimum Cost Paths" in IEEE Transactions on Systems Science and Cybernetics, Band 4, Heft 2, Seiten 100 bis 107, Juli 1968. Der praktische Anlass war Shakey, der mobile Roboter des SRI, der seine Route durch eine Reihe von Räumen selbst planen musste, statt einer festen Strecke zu folgen.
Zwei Beiträge dieser Arbeit prägen das Gebiet bis heute:
- Sie trennte das Suchverfahren vom Wissen darin. Dieselbe Schleife wird zu einem anderen Algorithmus, je nachdem, welches
hman ihr übergibt. Die Suchstrategie wurde zu einem Parameter statt zu einer Entwurfsentscheidung. - Sie bewies die Garantien. Wenn
hdie tatsächlichen Restkosten nie überschätzt, liefert das Verfahren einen Weg minimaler Kosten. Ein begleitendes Resultat zeigte, dass kein anderer Algorithmus mit Zugriff auf dieselbe heuristische Information weniger Knoten expandieren und trotzdem Optimalität garantieren kann.
Der Name ist ein Stück Notation, das geblieben ist. Die Arbeit von 1968 kennzeichnet optimale Größen mit einem Stern: g* sind die geringsten Kosten vom Start zu einem Knoten, h* die geringsten Kosten von diesem Knoten bis zu einem Ziel, und f* ihre Summe. Das bloße Verfahren heißt A, und A* ist die Variante davon, die diese Größen erreicht, nämlich die, deren Heuristik h* nie überschätzt. Es ist keine Abkürzung und steht für nichts.
Eine Notiz von 1972 im SIGART Newsletter korrigierte das ursprüngliche Optimalitätsargument. Der Beweis von 1968 stützte sich auf das, was die Autoren die Konsistenzannahme nannten, und die Korrektur machte ausdrücklich, was sich ändern muss, wenn eine Heuristik zulässig, aber nicht konsistent ist: Bereits expandierte Knoten müssen wieder geöffnet werden dürfen. Diese Unterscheidung ist Gegenstand von Abschnitt 6 und bis heute, mehr als fünfzig Jahre später, die häufigste Ursache für stillschweigend falsche A*-Implementierungen.
Falls Sie eine Quellenangabe hierher geführt hat: Hart, P. E., Nilsson, N. J., und Raphael, B. (1968). "A Formal Basis for the Heuristic Determination of Minimum Cost Paths." IEEE Transactions on Systems Science and Cybernetics 4(2), 100 bis 107.
3. Die Bewertungsfunktion f(n) = g(n) + h(n)
Alles, was A* tut, folgt daraus, wie es seine Front ordnet. Die Bewertungsfunktion teilt die Schätzung einer Lösung in einen exakt bekannten und einen geschätzten Teil:
f(n) = g(n) + h(n)

g(n)   bereits bezahlte Kosten    exakt, gemessen entlang des tatsächlich gewählten Weges
h(n)   noch zu zahlende Kosten    geschätzt durch die Heuristikfunktion
f(n)   Gesamtschätzung            der Wert, nach dem die Prioritätswarteschlange sortiert
Der Wert dieses Entwurfs liegt darin, dass eine einzige Komponente das gesamte Verhalten der Suche steuert:
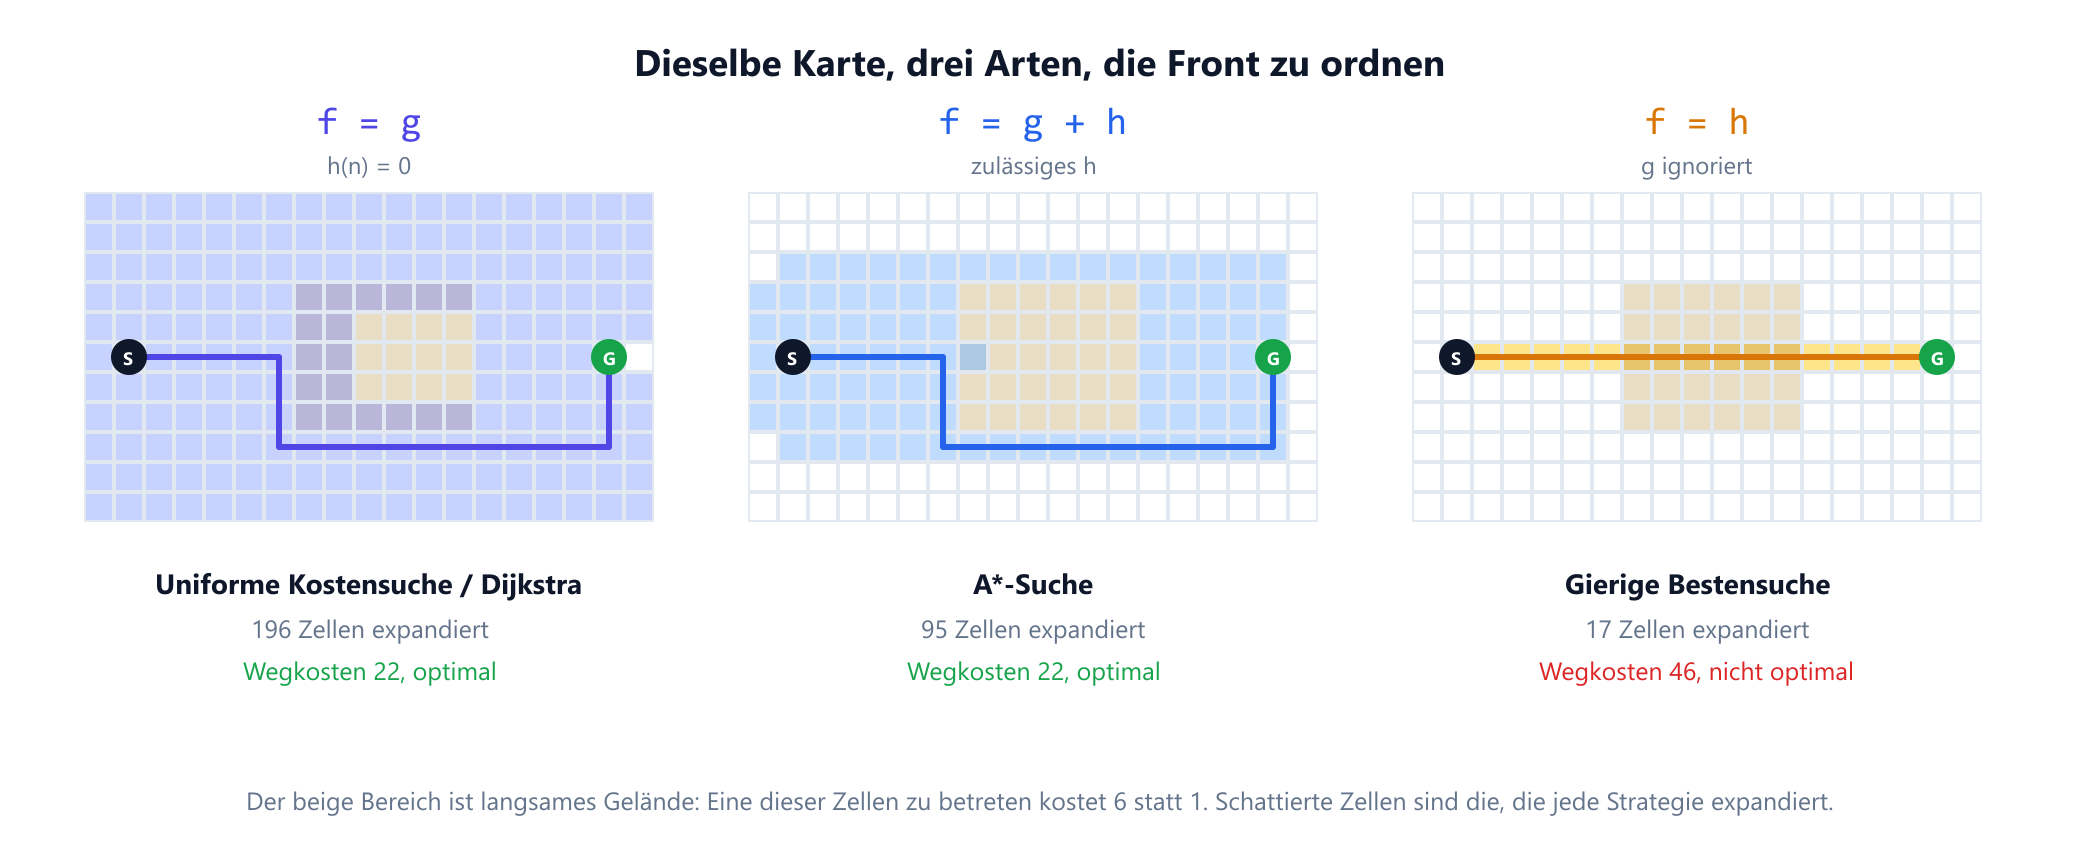
- h(n) = 0 überall. Dann gilt
f = gund A* entartet zur uniformen Kostensuche, die auf einem Graphen mit nichtnegativen Gewichten genau Dijkstras Algorithmus ist. Korrekt, aber uninformiert: Sie expandiert jeden Knoten, der billiger als das Ziel ist, in jede Richtung. - h(n) = h*(n), die tatsächlichen Restkosten. A* läuft geradewegs einen optimalen Weg entlang und expandiert kaum etwas anderes. Das ist die theoretische Obergrenze, und sie ist in der Praxis unerreichbar, weil die Berechnung von
h*genau das Problem ist, das man lösen wollte. - g ignorieren und nur nach h ordnen. Das ist die gierige Bestensuche. Sie ist schnell, liegt oft deutlich daneben und bietet keine Optimalitätsgarantie.
- Umgewichten: f = g + w × h mit w > 1. Weighted A* tauscht einen beschränkten Verlust an Lösungsqualität gegen einen großen Gewinn an Geschwindigkeit. Der gelieferte Weg ist nie schlechter als das
w-Fache der optimalen Kosten.
Lesen Sie diese Liste als Skala dafür, wie sehr man der Schätzung vertraut. A* liegt in der Mitte und investiert umso mehr Aufwand, je weniger die Heuristik weiß: Eine scharfe Heuristik erzeugt eine Suche, die wie eine gerade Linie aussieht, eine schwache eine Suche, die wie Dijkstra aussieht.
4. Wie A* Schritt für Schritt abläuft
Die Front ist eine Prioritätswarteschlange, traditionell OPEN genannt, geordnet nach f. Eine Tabelle der besten bekannten g-Werte und eine Tabelle von Elternzeigern vervollständigen den Zustand.
function a_star(start, goal, h):
    open   = priority queue ordered by f        # die Front
    g      = map with default infinity          # beste bekannte Kosten ab Start
    parent = map                                # für die Wegrekonstruktion

    g[start] = 0
    open.push(start, h(start))

    while open is not empty:
        current = open.pop_min()                # Knoten mit dem kleinsten f
        if current == goal:
            return reconstruct(parent, goal)    # Zieltest beim Entnehmen, nicht beim Erzeugen

        for (next, cost) in edges(current):
            tentative = g[current] + cost
            if tentative < g[next]:             # ein billigerer Weg zu next
                g[next]      = tentative
                parent[next] = current
                open.push_or_update(next, tentative + h(next))

    return failure                              # das Ziel ist unerreichbar
Vier Implementierungsdetails tragen den Großteil der Feinheiten:
- Der Zieltest findet statt, wenn ein Knoten entnommen wird, nicht wenn er erzeugt wird. Ein Ziel kann früh über eine teure Route erzeugt werden. Wer in diesem Moment zurückkehrt, bekommt einen Weg, nur nicht den billigsten. Das Rechenbeispiel unten enthält einen Fall, in dem der Test beim Erzeugen 7 Einheiten zusätzlich zu den optimalen 13 kostet.
- Die Relaxierung wird durch
tentative < g[next]geschützt, nicht durch die Zugehörigkeit zu einer geschlossenen Menge. So geschrieben öffnet die Schleife einen bereits expandierten Knoten automatisch wieder, wenn später ein billigerer Weg zu ihm auftaucht, und genau das macht sie für jede zulässige Heuristik korrekt. - Die meisten Prioritätswarteschlangen haben keine Decrease-Key-Operation. Produktionscode legt meist einen doppelten Eintrag mit dem besseren
fab und verwirft veraltete Einträge, wenn sie herauskommen. Das nennt man Lazy Deletion: Es kostet etwas Speicher und spart viel Buchhaltung. - Der Weg wird rückwärts gewonnen. Folgen Sie den Elternzeigern vom Ziel zum Start und kehren Sie die Liste um. A* speichert nie Wege, nur einen Elternknoten pro Knoten.
5. Ein Rechenbeispiel auf einem gewichteten Graphen
Gitteranimationen verbergen die Arithmetik. Hier ist ein kleiner gewichteter Graph, wie er in KI-Kursen verwendet wird, von Hand von Anfang bis Ende nachvollzogen.
Sechs Knoten: S (Start), A, B, C, D und G (Ziel). Die Kantenkosten sind Straßenentfernungen, und die Heuristik h ist die Luftlinienentfernung zu G, und genau das macht sie zulässig: Eine Luftlinie ist nie länger als eine Straße.
Kanten (ungerichtet, Kosten)  Heuristik h(n)
S-A  4      A-C  5            S = 11    C = 5
S-B  3      A-D  12           A =  9    D = 3
S-G  20     B-D  7            B =  8    G = 0
C-G  6      D-G  3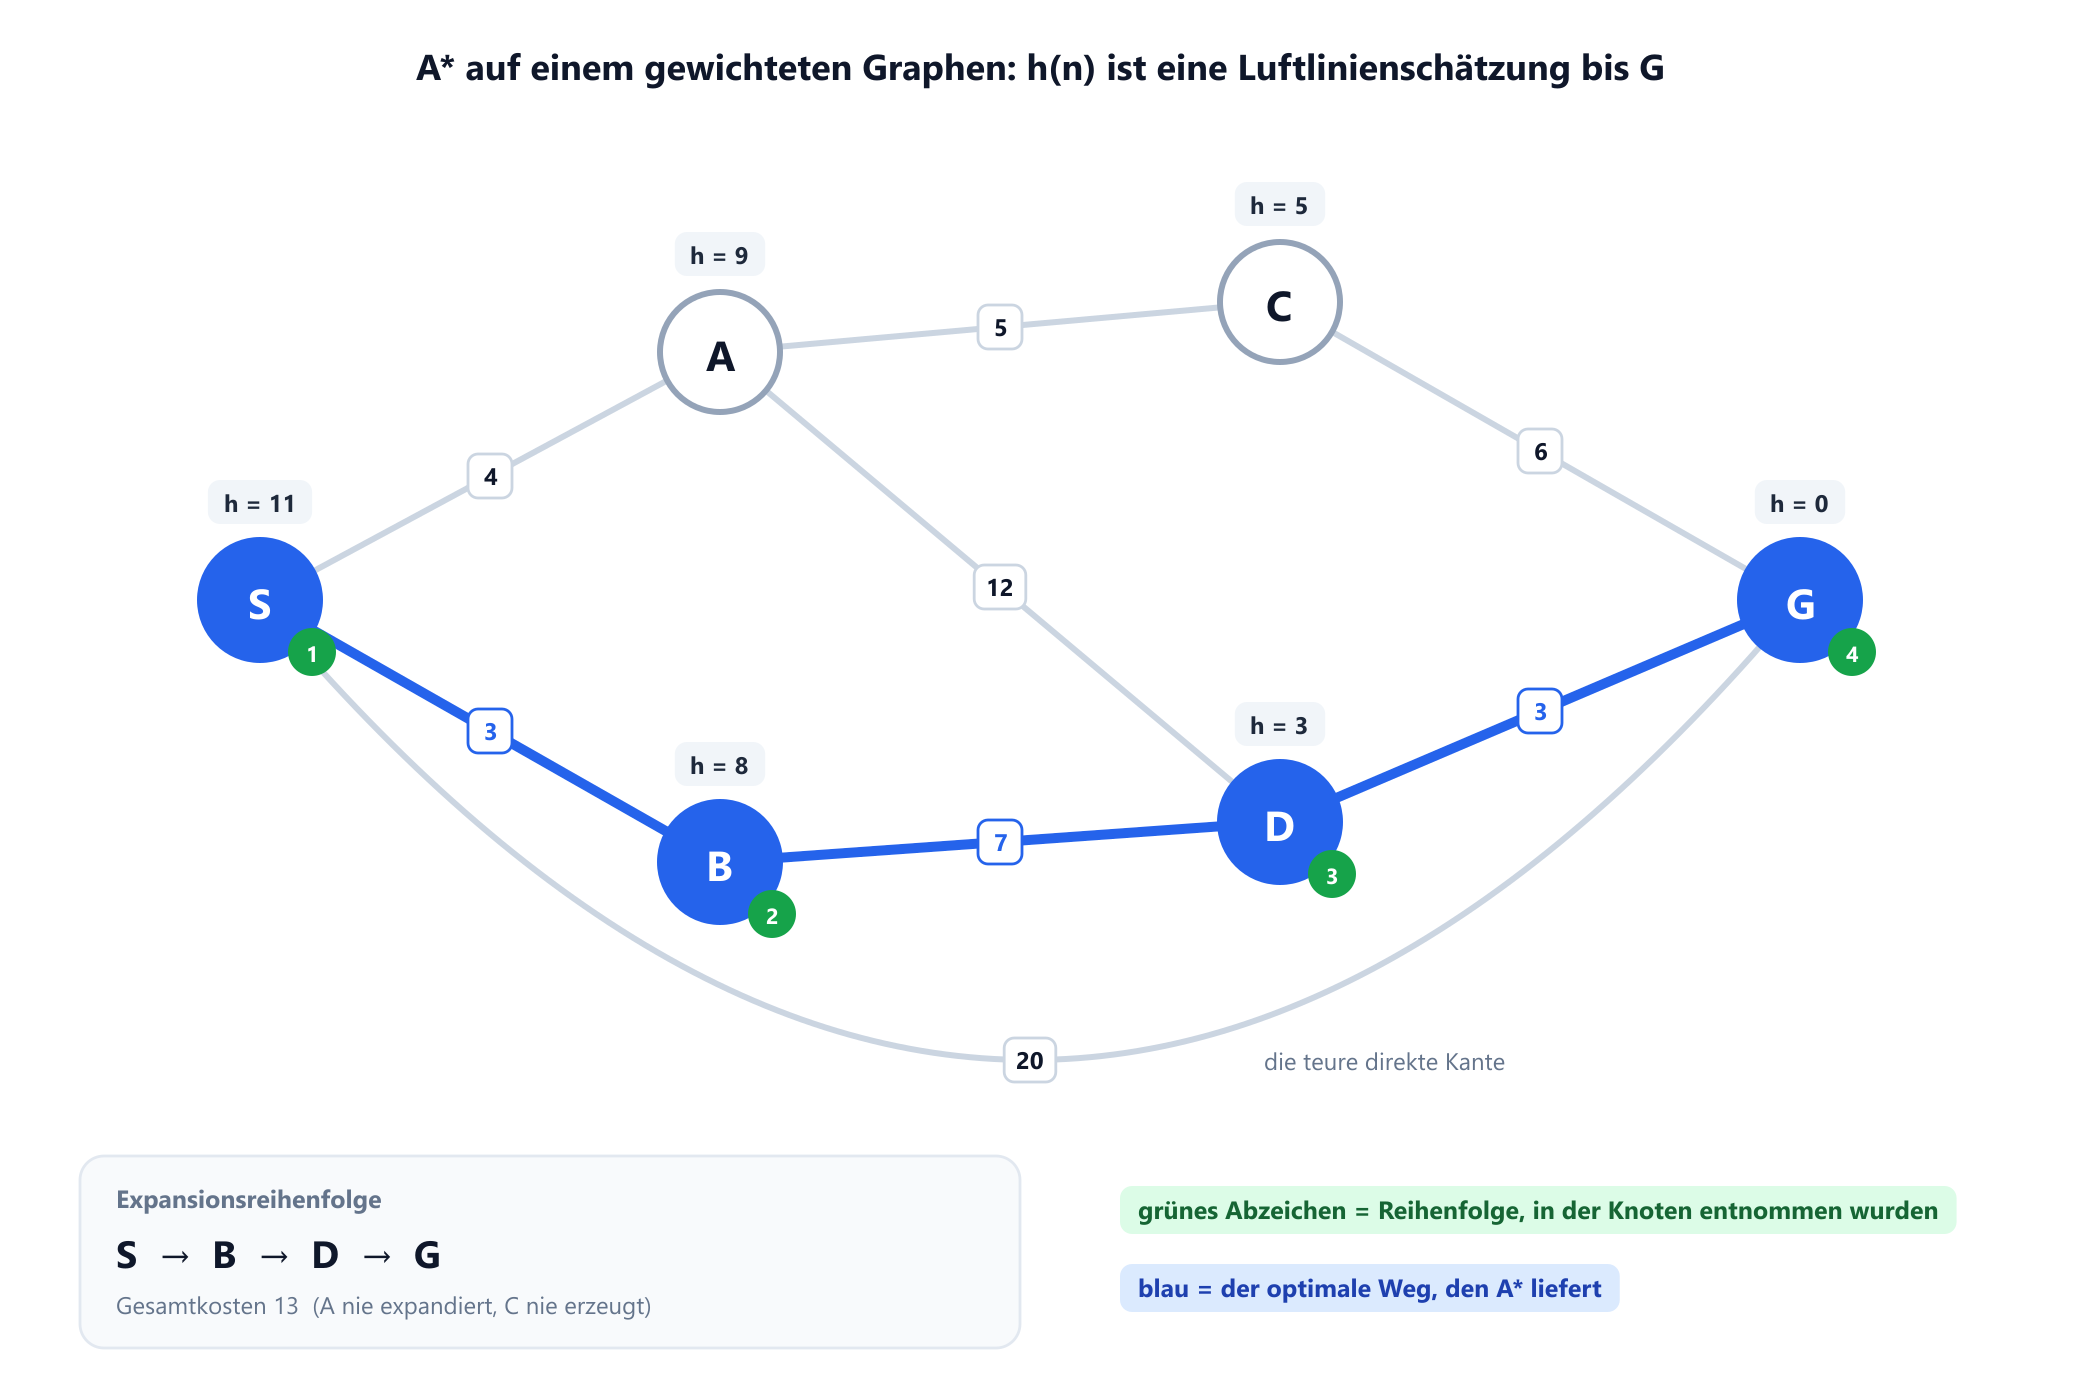
A* entnimmt den Knoten mit dem kleinsten f und löst Gleichstände zugunsten des kleineren h, was der übliche Tie-Break ist, weil er Knoten näher am Ziel bevorzugt:
| Schritt | Entnommen | g | h | f | Front nach dem Schritt |
|---|---|---|---|---|---|
| 1 | S | 0 | 11 | 11 | B 11, A 13, G 20 |
| 2 | B | 3 | 8 | 11 | A 13, D 13, G 20 |
| 3 | D | 10 | 3 | 13 | G 13 (verbessert von 20), A 13 |
| 4 | G | 13 | 0 | 13 | Ziel entnommen, Suche endet |
Die Antwort ist S → B → D → G mit Kosten 13. Drei Dinge in diesem Ablauf verdienen einen genaueren Blick:
- Das Ziel wurde in Schritt 1 mit f = 20 erzeugt und ignoriert. Eine Implementierung, die zurückkehrt, sobald sie das Ziel erzeugt, hätte einen Weg mit Kosten 20 gemeldet, also 54 Prozent schlechter als optimal. A* behält ihn in der Front und akzeptiert ihn erst, wenn nichts Billigeres mehr übrig ist.
- Knoten C wurde nie auch nur erzeugt. Dijkstra expandiert auf demselben Graphen jeden Knoten mit einer Distanz unter 13, darunter C mit 9. A* berührt ihn nie, weil die Front nie so weit kommt.
- Knoten A wurde erzeugt, aber nie expandiert. Sein
f-Wert von 13 liegt gleichauf mit dem Ziel, und da ein Gleichstand beif = C*in beide Richtungen aufgelöst werden kann, wurde A nie lohnend genug, um geöffnet zu werden. Genau das ist der Grenzfall, von dem der Satz über die optimale Effizienz spricht.
6. Zulässige und konsistente Heuristiken
Zwei Eigenschaften von h verdienen eine sorgfältige Unterscheidung, weil sie oft verwendet werden, als wären sie dasselbe, und das sind sie nicht.
Zulässigkeit
Eine Heuristik ist zulässig, wenn sie nie überschätzt:
h(n) <= h*(n)   für jeden Knoten n
                wobei h*(n) die tatsächlich günstigsten Kosten von n zu einem Ziel sind
Zulässigkeit ist Optimismus. Die Heuristik darf beliebig danebenliegen, solange sie nach unten abweicht. h = 0 ist zulässig, und deshalb ist Dijkstra ein Spezialfall von A* und kein Rivale.
Konsistenz, auch Monotonie genannt
Eine Heuristik ist konsistent, wenn sie entlang jeder Kante eine Dreiecksungleichung erfüllt:
h(n) <= cost(n, n') + h(n')   für jede Kante von n nach n'
h(goal) = 0
In Worten: Ein einzelner Schritt kann die Schätzung nie um mehr senken, als der Schritt tatsächlich gekostet hat. Konsistenz ist die stärkere Eigenschaft. Jede konsistente Heuristik ist zulässig; die Umkehrung gilt nicht.
Die praktische Folge ist präzise. Wenn h konsistent ist, fällt f entlang eines Weges nie, und wenn A* einen Knoten zum ersten Mal entnimmt, ist sein g-Wert bereits optimal. Genau das erlaubt die bekannte Optimierung, expandierte Knoten in eine geschlossene Menge zu legen und nie wieder anzusehen.
Wenn h nur zulässig ist, wird diese Erlaubnis entzogen. Ein billigerer Weg zu einem bereits expandierten Knoten kann noch entdeckt werden, und wenn die Implementierung sich weigert, ihn wieder zu öffnen, kann die Endantwort falsch sein. Hier ist ein Graph, in dem genau das passiert:
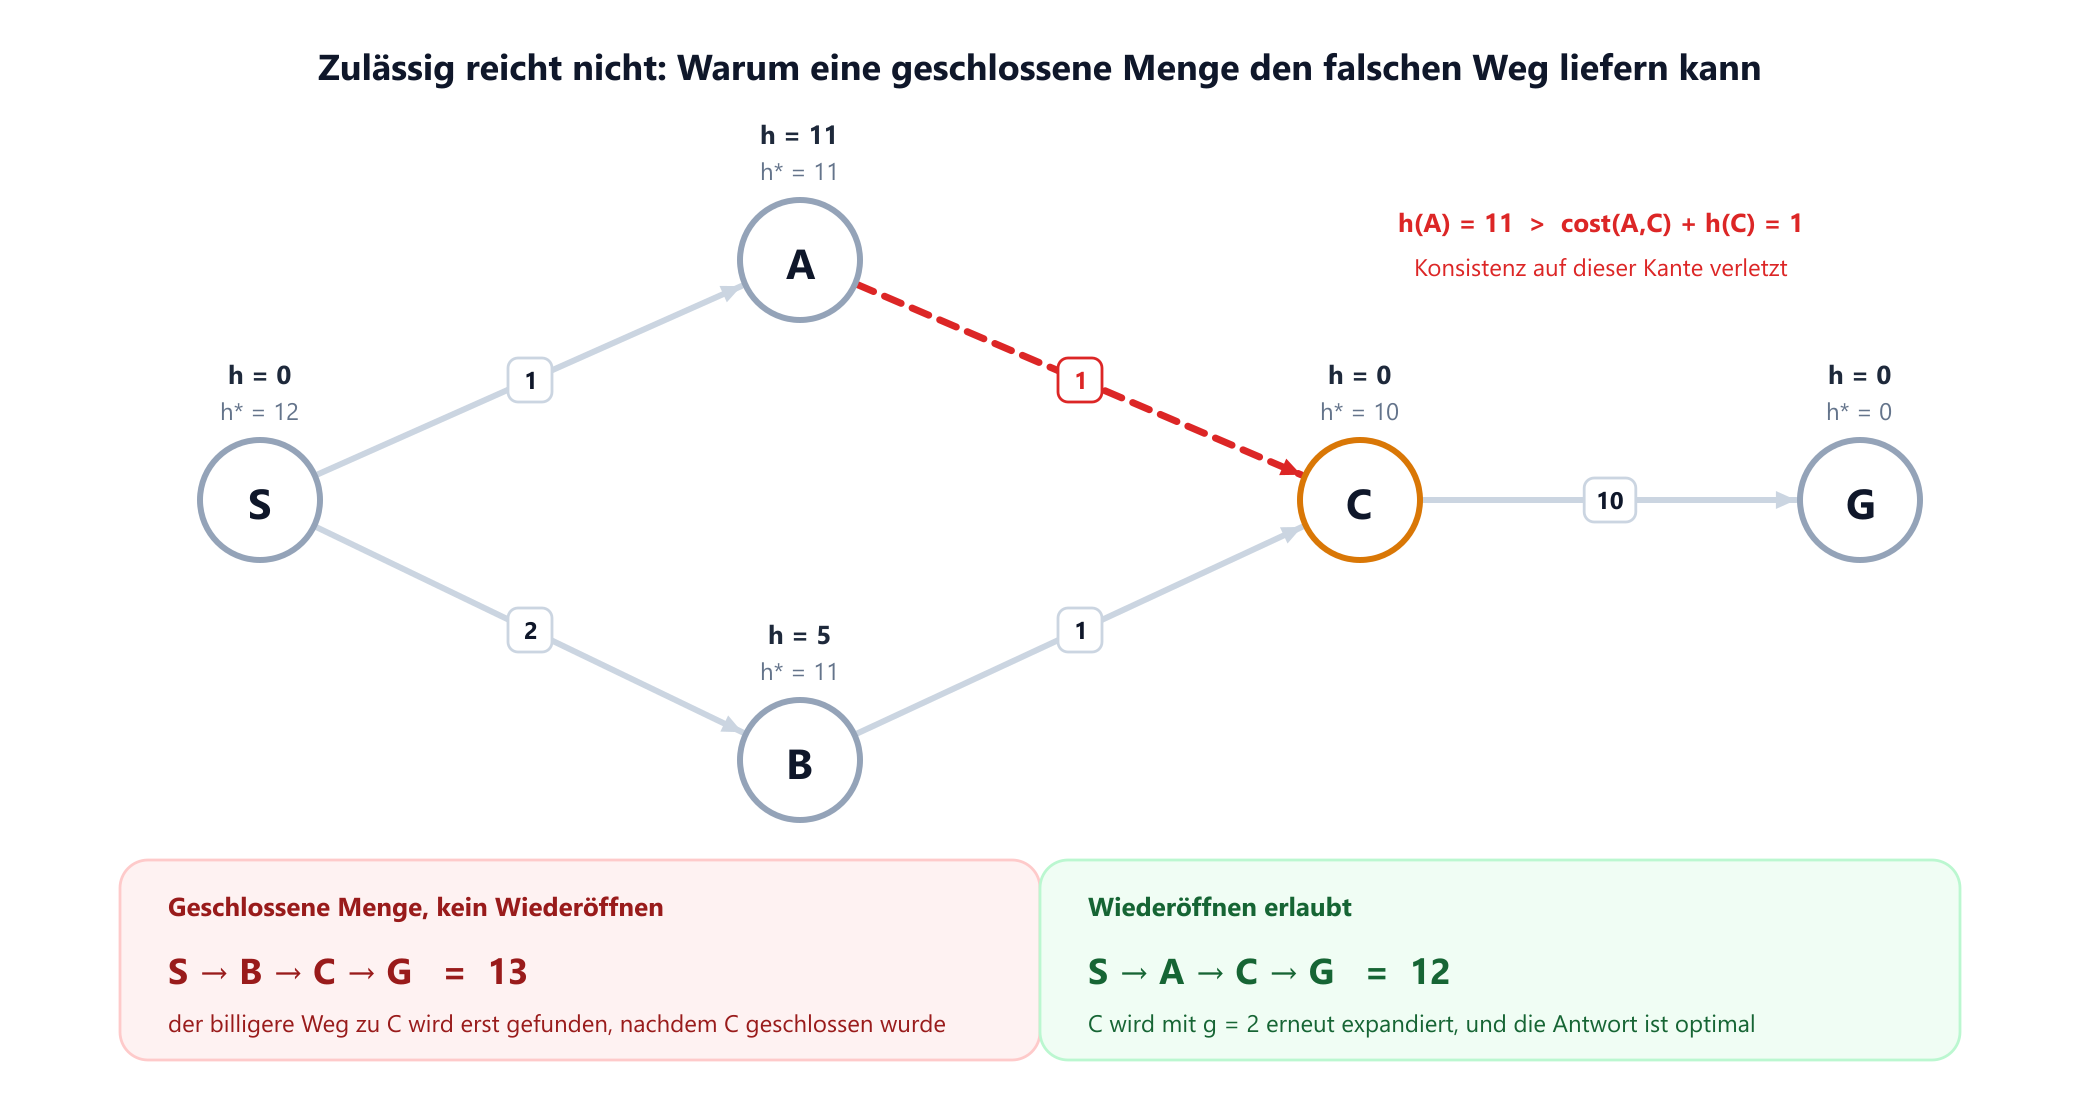
Kanten (gerichtet, Kosten)  Heuristik h(n)     Wahre Kosten h*(n)
S -> A   1                 S =  0             S = 12
S -> B   2                 A = 11             A = 11
A -> C   1                 B =  5             B = 11
B -> C   1                 C =  0             C = 10
C -> G  10                 G =  0             G =  0

Jedes h(n) <= h*(n), also ist die Heuristik zulässig.
Die Kante A -> C verletzt die Konsistenz: h(A) = 11 > cost(A,C) + h(C) = 1.
Verfolgen Sie es: A* entnimmt S (f = 0) und erzeugt A mit f = 1 + 11 = 12 und B mit f = 2 + 5 = 7. Es entnimmt B (f = 7) und erzeugt C mit g = 3, f = 3. Es entnimmt C (f = 3), schließt ihn mit g = 3 und erzeugt G mit f = 13. Erst dann entnimmt es A (f = 12) und entdeckt einen Weg zu C, der nur 2 kostet. Wenn C geschlossen ist und geschlossen endgültig bedeutet, wird diese Entdeckung verworfen, und der Algorithmus liefert 13 statt der optimalen 12.
Zwei Auswege, und Sie sollten einen bewusst wählen: Beweisen Sie, dass Ihre Heuristik konsistent ist, und behalten Sie die Optimierung mit geschlossener Menge, oder schreiben Sie die Relaxierung als tentative < g[next] ohne Prüfung einer geschlossenen Menge, sodass das Wiederöffnen von selbst geschieht. Die beruhigende Nachricht: Fast jede in der Praxis verwendete Heuristik, einschließlich Luftlinienentfernung, Manhattan-Distanz auf einem Gitter mit einheitlichen Kosten und jeder aus einem relaxierten Problem abgeleiteten Heuristik, ist konsistent. Genau deshalb kann dieser Bug jahrelang überleben, bis eine seltsame Karte ihn aufdeckt.
7. Warum A* optimal ist, und wann nicht
Das Optimalitätsargument ist kurz genug, um es im Kopf zu behalten, und es lohnt sich, es zu kennen, weil es genau sagt, welche Annahme man prüfen muss, wenn A* sich falsch verhält.
Sei C* die Kosten einer optimalen Lösung. Angenommen, A* ist dabei, einen Zielknoten G2 zu entnehmen, der über einen suboptimalen Weg erreicht wurde, also g(G2) > C*. Da h(G2) = 0 gilt, ist seine Priorität f(G2) = g(G2) > C*. Betrachten Sie nun einen beliebigen optimalen Weg vom Start zu einem echten optimalen Ziel. Im Moment vor der Entnahme muss dieser Weg mindestens einen Knoten n in der Front haben, weil der Start expandiert wurde und das Ziel nicht. Für diesen Knoten sind g(n) die optimalen Kosten, ihn zu erreichen, und weil h zulässig ist, gilt f(n) = g(n) + h(n) <= g(n) + h*(n) = C*. Also gilt f(n) <= C* < f(G2), und A* hätte n zuerst entnommen. Der Widerspruch beweist, dass das erste entnommene Ziel optimal ist.
Dieselbe Überlegung liefert die Bedingungen, unter denen die Garantie scheitert:
- Die Heuristik überschätzt irgendwo. Die Ungleichung
f(n) <= C*bricht, und A* kann am optimalen Weg vorbeilaufen. Das ist nicht immer eine Katastrophe, aber die Garantie ist weg, und das sollte man im Code vermerken. - Negative Kantenkosten. A* setzt nichtnegative Kosten voraus, genau wie Dijkstra. Mit negativen Kanten bedeutet die Ordnung der Front nichts. Verwenden Sie stattdessen Bellman-Ford.
- Kosten, die sich während der Suche ändern. Statisches A* hat keine Antwort auf eine Tür, die sich mitten im Plan schließt. Dafür gibt es D* Lite und Lifelong Planning A*.
- Unendliche oder unbeschränkte Graphen. Vollständigkeit braucht einen endlichen Verzweigungsgrad und Kantenkosten, die nach unten durch ein positives Epsilon beschränkt sind. Ohne das kann A* einer unendlichen Folge immer billigerer Schritte nachjagen und nie terminieren.
Ein weiteres Resultat rundet die Theorie ab. Dechter und Pearl bewiesen 1985, dass A* optimal effizient ist: Kein anderer optimaler Algorithmus mit derselben heuristischen Information expandiert garantiert weniger Knoten. Jeder Knoten mit f(n) < C* muss von jedem solchen Algorithmus expandiert werden, und A* expandiert genau diese und dazu eine Teilmenge der Knoten mit genau f(n) = C*. Es gibt keine klügere Reihenfolge zu finden; der einzige verbleibende Hebel ist eine bessere Heuristik.
8. Zeit- und Speicherkomplexität
Die Lehrbuchangabe ist O(bd), wobei b der Verzweigungsgrad und d die Tiefe der optimalen Lösung ist, und diese Zahl ist ehrlich, aber wenig aussagekräftig. Die schärfere Aussage betrifft den Fehler der Heuristik. Die Zahl der von A* expandierten Knoten wächst exponentiell, es sei denn, der Fehler der Heuristik ist logarithmisch in den wahren Kosten beschränkt:
|h(n) - h*(n)| <= O(log h*(n))Fast keine in der Praxis verwendete Heuristik erfüllt diese Hürde, die ehrliche Lesart lautet also: A* ist im schlimmsten Fall exponentiell, und eine gute Heuristik verkleinert die Basis des Exponenten, statt ihn zu beseitigen. Auf einem expliziten Graphen, den man bereits im Speicher hält, ist die Bilanz dieselbe wie bei Dijkstra: O(E log V) mit einem binären Heap, da jede Kante höchstens eine Aktualisierung der Warteschlange auslöst. Die interessante Frage ist nicht die Schranke, sondern wie wenige dieser V und E die Suche überhaupt berührt.
Speicher ist die Einschränkung, die tatsächlich zuschlägt. A* hält jeden erzeugten Knoten im Speicher, sowohl die Front als auch die erkundete Menge, daher entspricht seine Speicherkomplexität seiner Zeitkomplexität. Realen Systemen geht lange vor der Geduld der Arbeitsspeicher aus. Diese eine Tatsache erklärt die ganze Familie von Varianten in Abschnitt 11: Iterative Deepening A*, Simplified Memory-Bounded A* und strahlartige Kürzungen gibt es alle, um Optimalität oder wiederholte Arbeit gegen eine Front einzutauschen, die in den Speicher passt.
9. Wie man eine gute Heuristik entwirft
Da der Algorithmus feststeht und nachweislich effizient ist, steckt die gesamte Ingenieursarbeit in h. Es gibt ein verlässliches Rezept, um eine zu erzeugen.
Das Problem relaxieren
Nehmen Sie das echte Problem, streichen Sie eine Nebenbedingung und lösen Sie den Rest exakt. Die exakten Kosten eines relaxierten Problems sind immer eine untere Schranke der echten Kosten, also ist die Heuristik per Konstruktion zulässig, und weil sich eine relaxierte Lösung Schritt für Schritt aufbauen lässt, ist sie auch konsistent.
Das 8-Puzzle ist das Standardbeispiel. Ein Plättchen darf auf das benachbarte leere Feld rücken. Streicht man Nebenbedingungen, ergeben sich zwei klassische Heuristiken:
- h1, falsch platzierte Plättchen. Erlauben Sie jedem Plättchen, sich in einem Zug an jede Stelle zu teleportieren. Dann sind die Kosten einfach die Anzahl der Plättchen, die nicht auf ihrem Zielfeld liegen.
- h2, Manhattan-Distanz. Erlauben Sie einem Plättchen, auf jedes benachbarte Feld zu rücken, ob leer oder nicht. Dann sind die Kosten die Summe der horizontalen plus vertikalen Abstände aller Plättchen zu ihrem Zielfeld.
Beide sind zulässig. Der Unterschied in der Praxis ist dramatisch: Bei zufälligen Instanzen des 8-Puzzles, die 12 Züge erfordern, erzeugt die iterative Tiefensuche im klassischen Vergleich von Russell und Norvig in der Größenordnung von 3,6 Millionen Knoten, A* mit h1 einige hundert und A* mit h2 weniger als hundert. Bei Tiefe 24 wächst der Abstand auf rund 39.000 Knoten für h1 gegenüber rund 1.600 für h2. Gleicher Algorithmus, gleicher Code, anderes h.
Eine dominierende Heuristik bevorzugen
Wenn h2(n) >= h1(n) für jeden Knoten gilt und beide zulässig sind, dann h2 dominiert h1, und A* mit h2 expandiert nie mehr Knoten. Größer ist besser, bis zur Obergrenze h*. Deshalb schlägt die Manhattan-Distanz die falsch platzierten Plättchen: Sie ist immer mindestens so groß und überschätzt nie.
Mehrere Heuristiken kombinieren
Wenn Sie mehrere zulässige Heuristiken haben und keine die anderen dominiert, nehmen Sie ihr Maximum. Das Maximum zulässiger Heuristiken ist zulässig und dominiert alle. Der Preis ist, dass Sie nun pro Knoten mehrere Funktionen auswerten, der Gewinn muss also mit Auswertungszeit bezahlt werden.
Mit Pattern Databases vorberechnen
Lösen Sie für einen festen Zielzustand Teilprobleme vorab erschöpfend und speichern Sie die exakten Kosten in einer Tabelle. Eine Pattern Database für eine Teilmenge der Plättchen liefert eine weit stärkere zulässige Schranke als jede Formel. Dieselbe Idee lässt landmarkenbasiertes Routing auf kontinentalen Straßennetzen funktionieren: Exakte Distanzen zu einer Handvoll Landmarken vorberechnen und den Rest mit der Dreiecksungleichung abschätzen.
Auf Gittern die Metrik wählen, die zu den Zügen passt
Manhattan-Distanz für Bewegung in 4 Richtungen, euklidische Distanz für Bewegung in beliebigem Winkel, Tschebyschow- oder Oktil-Distanz für Gitter mit 8 Richtungen. Eine Metrik, die weniger Freiheit annimmt, als die Bewegungsregeln erlauben, macht die Heuristik unzulässig und zerstört stillschweigend die Optimalitätsgarantie. Der Leitfaden zur Wegsuche auf Gittern geht alle drei mit Zahlenbeispielen durch.
10. A* vs. Dijkstra, UCS, gierige Bestensuche und BFS
Jeder dieser Algorithmen ist dieselbe Schleife mit einer anderen Priorität. So merkt man sie sich am besten.
| Algorithmus | Priorität der Front | Optimal? | Einsetzen, wenn |
|---|---|---|---|
| Breitensuche | Einfügereihenfolge (FIFO) | Ja, wenn alle Kanten gleich viel kosten | Ungewichtete Graphen, wenigste Sprünge |
| Uniforme Kostensuche / Dijkstra | f = g | Ja | Gewichteter Graph, keine brauchbare Schätzung oder viele Ziele zugleich |
| Gierige Bestensuche | f = h | Nein | Sie brauchen schnell irgendeine Lösung, und die Qualität ist verhandelbar |
| A* | f = g + h | Ja, wenn h zulässig ist | Ein Ziel, eine brauchbare Schätzung existiert, der Weg muss der kürzeste sein |
| Weighted A* | f = g + w × h | Bis auf einen Faktor w | A* ist zu langsam, und ein beschränkter Umweg ist akzeptabel |
Die Intuition hinter dem Vergleich von A* mit Dijkstra ist geometrisch. Dijkstra expandiert alles mit g(n) < C*, was auf einer offenen Karte ein Kreis um den Start ist. A* expandiert alles mit g(n) + h(n) < C*, was eine Ellipse mit Start und Ziel als Brennpunkten ist. Je schärfer die Heuristik, desto flacher wird die Ellipse, bis sie auf den Weg selbst zusammenfällt. Beide liefern dieselbe optimale Antwort; sie unterscheiden sich nur darin, wie viel der Karte sie ansehen mussten, um sicher zu sein. Einen breiteren Überblick über die Familie gibt die Übersicht der Kürzeste-Wege-Algorithmen, und für die Durchlaufgrundlagen darunter BFS vs DFS.
11. Varianten von A*, die man kennen sollte
Fast jede benannte Variante ist eine Antwort auf einen von zwei Zwängen: Speicher oder die Notwendigkeit, zu antworten, bevor das Optimum bewiesen ist.
- Weighted A* multipliziert die Heuristik mit
w > 1. Lösungen liegen garantiert innerhalb eines Faktorswdes Optimums und sind in der Praxis meist weit besser als diese Schranke, während sie eine Größenordnung schneller laufen. - IDA* (Iterative Deepening A*) führt wiederholte Tiefensuchen mit steigender
f-Schranke aus. Der Speicher sinkt auf die Tiefe der Suche, und der Preis ist das erneute Expandieren von Knoten in jeder Iteration. Das ist das Standardwerkzeug für Puzzles mit riesigen Zustandsräumen. - SMA* (Simplified Memory-Bounded A*) nutzt allen Speicher, den man ihm gibt, und verwirft bei Speichermangel das schlechteste Blatt, wobei es dessen Wert im Elternknoten festhält. Es bleibt optimal, wenn der optimale Weg in den Speicher passt.
- ARA* und andere Anytime-Varianten starten mit einem großen
w, liefern schnell eine Lösung und verbessern sie weiter, solange Zeit bleibt, wobei sie die Schranke schrittweise verschärfen. - D* und D* Lite reparieren einen bestehenden Plan, wenn sich Kantenkosten ändern, statt von Grund auf neu zu planen. Das braucht ein Roboter, der ein nicht kartiertes Hindernis entdeckt.
- Jump point search nutzt die Symmetrie von Gittern mit einheitlichen Kosten, um ganze Folgen identischer Zellen zu überspringen. Gleiche Antwort wie A*, oft eine Größenordnung weniger Expansionen, nur für Gitter.
- Bidirektionales A* sucht gleichzeitig vorwärts vom Start und rückwärts vom Ziel. Es ist mächtig und heikel, da sowohl die Abbruchbedingung als auch die Konsistenzanforderungen an die Heuristik schwieriger werden.
- ALT und Contraction Hierarchies sind das, was produktive Routenplaner tatsächlich ausführen. Einfaches A* ist auf kontinentalen Straßennetzen zu langsam, deshalb berechnen sie Landmarkendistanzen oder Abkürzungskanten vor und durchsuchen dann einen viel kleineren effektiven Graphen.
12. Häufige Fehler in A*-Implementierungen
Die meisten A*-Bugs führen nicht zum Absturz. Sie liefern einen Weg, der etwas zu lang ist, bei manchen Eingaben, manchmal. Das sind die wiederkehrenden Ursachen:
- Nicht zusammenpassende Einheiten.
gin Sekunden undhin Metern gemessen ist der Klassiker. Wennhauch nur leicht überskaliert ist, ist die Heuristik nicht mehr zulässig und die Garantie ist weg. Rechnen Sie beides in dieselbe Währung um, bevor Sie addieren. - Eine geschlossene Menge mit inkonsistenter Heuristik. Der Fehlerfall aus Abschnitt 6. Wenn Sie Konsistenz nicht beweisen können, erlauben Sie das Wiederöffnen.
- Kein Tie-Breaking. Wenn viele Knoten dasselbe
fhaben, lässt eine willkürliche Reihenfolge A* ein breites Plateau gleich vielversprechender Zellen erkunden. Gleichstände zugunsten des kleinerenhaufzulösen kostet nichts und erhält alle Garantien. Der andere verbreitete Trick, das Skalieren vonhmit 1 + Epsilon, verengt die Suche auf Gittern dramatisch, macht die Heuristik aber minimal unzulässig; setzen Sie ihn also im Wissen ein, dass Sie den Beweis gegen die Geschwindigkeit getauscht haben. - Den Zieltest beim Erzeugen durchführen. Schnell, verlockend, und es liefert stillschweigend suboptimale Wege, wie das Rechenbeispiel gezeigt hat.
- Gleitkommavergleiche. Euklidische Heuristiken erzeugen irrationale Werte, und strikte Gleichheitsprüfungen auf
fverhalten sich unvorhersehbar. Vergleichen Sie mit einer Toleranz oder halten Sie Kosten ganzzahlig. - h(goal) = 0 vergessen. Eine Schätzung ungleich null am Ziel verletzt die Konsistenz auf der letzten Kante und kann die ganze Suche verzerren.
- h bei jeder Warteschlangenoperation neu berechnen. Die Heuristik wird ständig aufgerufen. Speichern Sie sie am Knoten; Profiler finden das immer wieder.
- Veränderliche Zustände als Dictionary-Schlüssel. Bei der Puzzlesuche beschädigt ein an Ort und Stelle verändertes Brett die Menge der besuchten Zustände. Speichern Sie eine unveränderliche Kodierung.
13. Wo A* tatsächlich eingesetzt wird
A* verdient seinen Platz überall dort, wo eine beste Folge von Entscheidungen in einem Raum gefunden werden muss, der zu groß zum Aufzählen ist:
- Robotik und Bewegungsplanung. Die ursprüngliche Shakey-Anwendung, noch immer aktuell: Gitter- und Lattice-Planer für mobile Roboter, Lagerflotten und autonome Fahrzeuge, meist mit D* Lite für die Neuplanung, wenn sich die Welt ändert.
- Spiele-KI. Einheiten, die über Navigation Meshes und Kachelkarten geleitet werden, typischerweise mit hierarchischer Zerlegung darüber, sodass ein langer Weg zuerst grob geplant und dann lokal verfeinert wird.
- Routenplanung. Reiseplaner verwenden A*-Abkömmlinge mit Landmarken-Heuristiken oder Contraction Hierarchies, und so wird eine kontinentale Route in Millisekunden geliefert.
- Puzzle- und Zustandsraumsuche. Schiebepuzzles, Zauberwürfel-Löser und ähnliche kombinatorische Probleme, meist mit IDA* und Pattern Databases, weil die Zustandsräume für eine Front im Speicher viel zu groß sind.
- Automatische Planung. Klassische Planer durchsuchen den Raum der Weltzustände mit Heuristiken, die automatisch aus einer relaxierten Version des Planungsproblems abgeleitet werden, also das Relaxierungsrezept aus Abschnitt 9, mechanisch angewandt.
- Bioinformatik. Mehrfaches Sequenzalignment ist ein Kürzeste-Wege-Problem in einem hochdimensionalen Gitter, und A* mit einer zulässigen Schranke ist eine exakte Standardmethode.
- Sprach- und Textdekodierung. A*-Suche über einem Wortgitter, bei der
gdie Bewertung der Teilhypothese ist undhdie beste Vervollständigung beschränkt, ist nach wie vor eine Lehrbuchstrategie der Dekodierung.
Das Muster ist immer dasselbe. Modellieren Sie das Problem als Graphen, finden Sie eine zulässige untere Schranke für die Restkosten und überlassen Sie den Rest der Prioritätswarteschlange.
14. Häufig gestellte Fragen
Findet A* immer den kürzesten Weg?
Ja, sofern drei Bedingungen erfüllt sind: Die Heuristik ist zulässig (sie überschätzt die Restkosten nie), die Kantenkosten sind nichtnegativ, und die Implementierung prüft das Ziel, wenn ein Knoten entnommen und nicht wenn er erzeugt wird. Ist die Heuristik zulässig, aber nicht konsistent, muss die Implementierung außerdem erlauben, bereits expandierte Knoten wieder zu öffnen. Verletzt man eine dieser Bedingungen, liefert A* trotzdem einen Weg, aber nicht mehr garantiert den billigsten.
Was ist der Unterschied zwischen A* und dem Dijkstra-Algorithmus?
Es ist derselbe Algorithmus mit unterschiedlichen Prioritäten. Dijkstra ordnet seine Front nach g(n), den bereits bezahlten Kosten, und breitet sich daher wie ein wachsender Kreis in alle Richtungen aus. A* ordnet nach f(n) = g(n) + h(n), sodass der expandierte Bereich eine vom Start zum Ziel gestreckte Ellipse ist. Setzt man h(n) = 0, wird A* genau zu Dijkstra. Dijkstra ist die bessere Wahl, wenn keine brauchbare Schätzung existiert oder wenn man Distanzen zu vielen Zielen zugleich braucht; A* ist die bessere Wahl für ein einzelnes Ziel mit einer brauchbaren Schätzung.
Was ist der Unterschied zwischen einer zulässigen und einer konsistenten Heuristik?
Zulässig bedeutet, dass h(n) nie größer ist als die wahren Restkosten h*(n). Konsistent, auch monoton genannt, ist die stärkere Dreiecksungleichung h(n) <= cost(n, n') + h(n') für jede Kante, mit h(goal) = 0. Jede konsistente Heuristik ist zulässig, aber nicht umgekehrt. Konsistenz ist wichtig, weil sie garantiert, dass der g-Wert eines Knotens bereits optimal ist, wenn A* ihn zum ersten Mal entnimmt, und genau das macht eine geschlossene Menge sicher. Mit einer bloß zulässigen Heuristik kann später noch ein billigerer Weg zu einem geschlossenen Knoten auftauchen, und der Knoten muss wieder geöffnet werden.
Wie hoch ist die Zeit- und Speicherkomplexität von A*?
Im schlimmsten Fall beide O(b^d), exponentiell in der Tiefe der Lösung. Die Zahl der Expansionen bleibt nur dann polynomiell, wenn der Fehler der Heuristik logarithmisch beschränkt ist, was in der Praxis fast nie vorkommt; eine bessere Heuristik verkleinert also die Basis des Exponenten, statt ihn zu beseitigen. Auf einem expliziten Graphen, der bereits im Speicher liegt, verhält sich A* wie Dijkstra mit O(E log V) bei einem binären Heap. Speicher ist die praktische Grenze: A* speichert jeden erzeugten Knoten, und deshalb gibt es speicherbeschränkte Varianten wie IDA* und SMA*.
Warum heißt er A*, und ist er ein KI-Algorithmus oder ein Graphenalgorithmus?
Der Stern ist die Notation, die die Arbeit von 1968 für optimale Größen verwendet, wie in g*, h* und f*: Das bloße Verfahren heißt A, und A* ist die Variante davon, deren Heuristik nie überschätzt und die deshalb einen kostenminimalen Pfad liefert. Er ist beides, ein KI-Algorithmus und ein Graphenalgorithmus. In KI-Kursen wird er als kanonisches informiertes Suchverfahren gelehrt, und er ist ein Kürzeste-Wege-Algorithmus auf gewichteten Graphen. Maschinelles Lernen ist er nicht: Nichts wird trainiert, und keine Daten werden angepasst. Das Wissen steckt vollständig in der Heuristikfunktion, die man bereitstellt, auch wenn ein gelerntes Modell durchaus eine liefern kann.
Ist A* vollständig, und was passiert, wenn kein Weg existiert?
A* ist vollständig auf einem Graphen mit endlichem Verzweigungsgrad, dessen Kantenkosten nach unten durch einen positiven Wert beschränkt sind: Existiert eine Lösung, wird sie gefunden. Existiert kein Weg, leert sich die Front, nachdem die gesamte erreichbare Komponente expandiert wurde, und der Algorithmus meldet einen Fehlschlag. Dieser Fehlschlag ist der teure Fall, denn der Nachweis, dass nichts existiert, bedeutet, alles Erreichbare zu erkunden, und das ist ein guter Grund für eine vorgeschaltete Zusammenhangsprüfung auf großen Karten.
Sehen Sie der Front beim Wandern zu
Führen Sie Dijkstra im interaktiven Visualisierer auf Ihrem eigenen Graphen aus. Das ist A* mit h gleich null, und was Sie sich nach außen ausbreiten sehen, ist genau die Arbeit, die eine gute Heuristik einspart.
Visualisierer starten