
Inhaltsverzeichnis
- 1. Warum eine Lieferkette ein Graph ist
- 2. Der Aufbau: Knoten, Kanten und die Zahlen darauf
- 3. Das Netz, das diesen Artikel begleitet
- 4. Lieferzeit: kürzeste Wege
- 5. Kapazität: maximaler Fluss und der Schnitt, der Sie begrenzt
- 6. Kosten: das Transportproblem und der kostenminimale Fluss
- 7. Welche Lager sollte es überhaupt geben?
- 8. Das physische Netz planen: Spannbäume
- 9. Die letzte Meile: Fahrzeuge disponieren
- 10. In der Fabrik: Material und Termine
- 11. Resilienz: was bricht, und wie schwer
- 12. Zwei Modellierungstricks, die man kennen sollte
- 13. Was leicht ist und was schwer
- 14. Vom Modell zur Praxis
- 15. Modellierungsfehler, die selbstbewusst falsche Antworten liefern
- 16. Häufig gestellte Fragen
- 17. Quellen
1. Warum eine Lieferkette ein Graph ist
Eine Lieferkette ist eine Menge von Orten und eine Menge von Bewegungen dazwischen. Lieferanten liefern an Werke, Werke an Lager, Lager an Filialen, und über jede mögliche Bewegung ist etwas wahr oder falsch: Es gibt sie oder es gibt sie nicht, sie kostet so viel je Einheit, sie dauert so viele Tage, sie kann höchstens so viel pro Woche tragen.
Diese Beschreibung ist bereits ein Graph. Die Orte sind Knoten, die Bewegungen sind gerichtete Kanten, und die kaufmännischen Fakten sind Zahlen an den Kanten. Bisher wurde nichts wegvereinfacht, und in dem Moment, in dem das Modell existiert, steht ein Jahrhundert Algorithmen bereit: Der kürzeste Weg beantwortet „wie schnell kommt dies zu jenem“, der maximale Fluss beantwortet „wie viel können wir tatsächlich liefern“, der kostenminimale Fluss beantwortet „was ist der günstigste Plan“, und Zusammenhang beantwortet „was passiert, wenn das hier abbrennt“.
Das ist keine Metapher, die zum Lehren erfunden wurde. Die Mathematik der Lieferketten ist Netzwerkoptimierung. Hitchcock stellte das Transportproblem 1941, Koopmans kam unabhängig davon in einer 1947 vorgestellten und 1949 veröffentlichten Arbeit dazu; Dantzig löste es 1951 mit dem Simplexverfahren; Ford und Fulkerson veröffentlichten 1956 den Algorithmus für den maximalen Fluss und 1962 das Buch Flows in Networks und ihre Beispiele waren Eisenbahnkapazitäten und Transportplanung, keine abstrakten Graphen. Das Fachgebiet, das all das formalisiert hat, ist das Operations Research, und seine zentralen Objekte sind Graphen.
Dieser Artikel nimmt ein kleines Netz mit vier Stufen und beantwortet daran jede übliche Frage zur Lieferkette. Jede unten genannte Zahl wurde durch Lösen des Modells berechnet, nicht geschätzt: die Pläne, die Engpässe, die Fehlmengen nach einem Ausfall und die Kosten jeder Alternative. Wenn Ihnen das zugrunde liegende Vokabular neu ist, deckt die Einführung in die Graphentheorie die Definitionen ab, die dieser Artikel voraussetzt.
2. Der Aufbau: Knoten, Kanten und die Zahlen darauf
Modellieren heißt entscheiden, was man behält. Drei Entscheidungen tragen das meiste Gewicht.
Was ist ein Knoten? Meist ein physischer Ort: ein Lieferantenstandort, ein Werk, ein Distributionszentrum, eine Kundenregion. Manchmal feiner, etwa eine Fertigungslinie oder ein Verladetor, manchmal gröber, etwa ein ganzes Land in einer strategischen Studie. Die Regel lautet: Ein Knoten ist alles, was Sie eröffnen, schließen, begrenzen oder verlieren könnten, denn genau danach wird das Modell gefragt.
Was ist eine Kante? Eine Verbindung: Ursprung, Ziel und meist ein Verkehrsträger. Dieselben zwei Standorte, verbunden per Straße und per Luft, sind zwei Kanten, nicht eine, denn sie haben unterschiedliche Kosten, Zeiten und Kapazitäten. Kanten sind gerichtet, denn nach Osten zu liefern ist nicht dasselbe wie nach Westen; der Unterschied und seine Folgen stehen in gerichtete versus ungerichtete Graphen.
Was steht auf der Kante? Mindestens drei Zahlen, und sie beantworten verschiedene Fragen, es kommt also darauf an, welche Sie anhängen:
- Kapazität, in Einheiten je Periode. Sie begrenzt das Mögliche und ist die Eingabe für den maximalen Fluss.
- Kosten, je gelieferte Einheit. Sie entscheiden, was am günstigsten ist, und sind die Eingabe für den kostenminimalen Fluss.
- Transportzeit, in Tagen. Sie entscheidet, was schnell ist, und ist die Eingabe für den kürzesten Weg.
Anfänger fassen das gern zu einem einzigen „Gewicht“ zusammen und wundern sich dann, warum die Antwort falsch aussieht. Es sind wirklich verschiedene Ziele, und die günstigste Route ist häufig nicht die schnellste, wie Abschnitt 4 an genau diesem Netz zeigt. Der Leitfaden zu gewichteten versus ungewichteten Graphen macht denselben Punkt im Abstrakten.
Zwei weitere Angaben sitzen auf Knoten statt auf Kanten: Angebot an den Quellen, Bedarf an den Senken und manchmal ein Fixkostenbetrag dafür, dass ein Standort überhaupt existiert, was aus einem Flussproblem in Abschnitt 7 ein Standortproblem macht.
3. Das Netz, das diesen Artikel begleitet
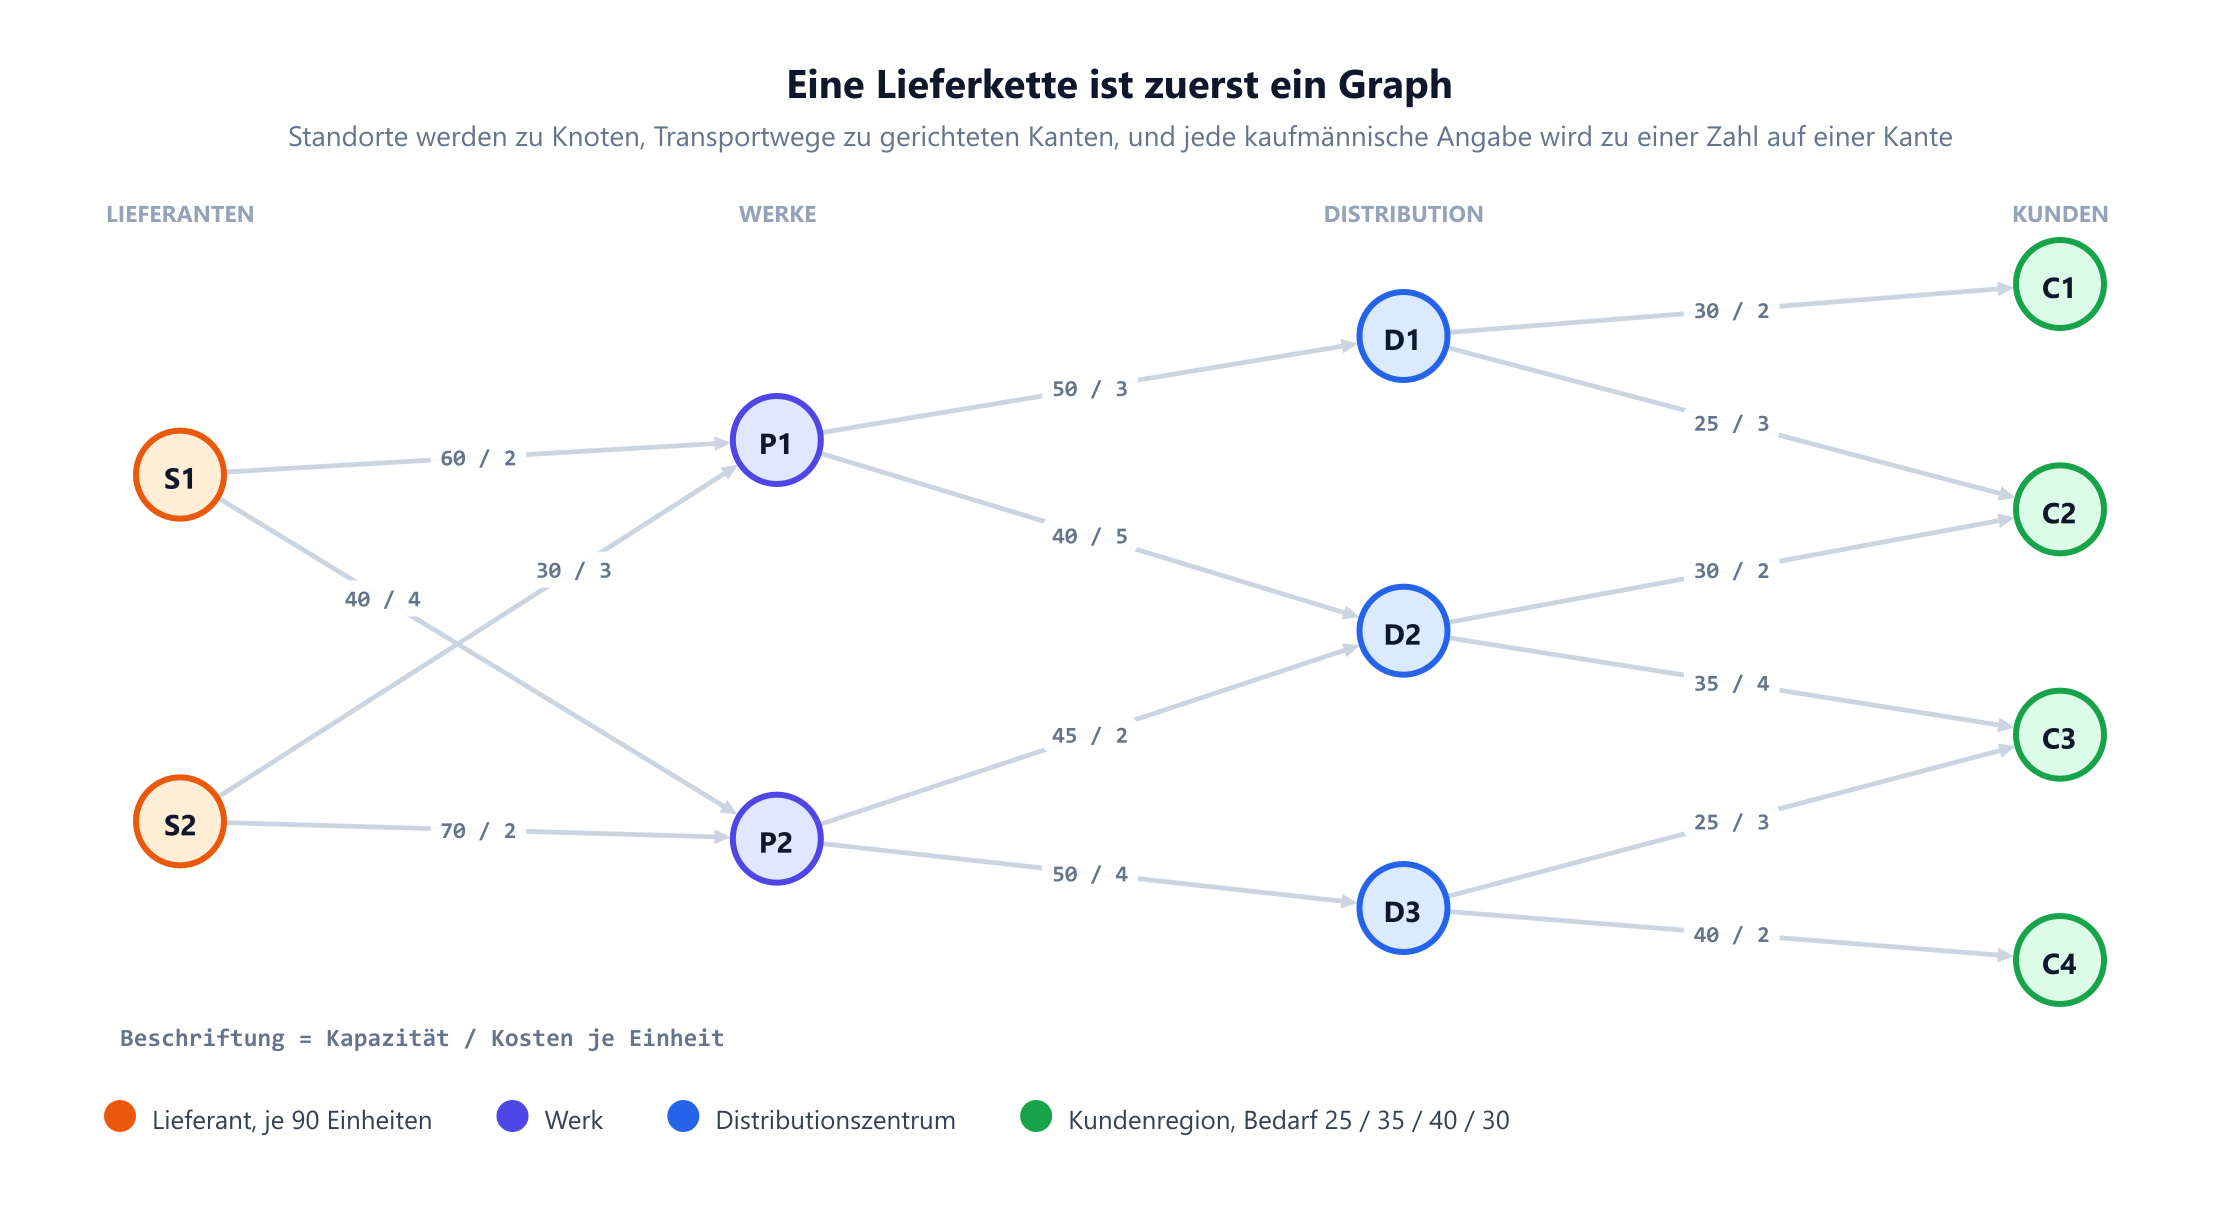
Das laufende Beispiel ist bewusst klein genug, um es von Hand zu prüfen, und reichhaltig genug, um auf interessante Weise zu brechen. Zwei Lieferanten versorgen zwei Werke, die Werke versorgen drei Distributionszentren, und die Zentren bedienen vier Kundenregionen.
| Stufe | Knoten | Zahlen |
|---|---|---|
| Lieferanten | S1, S2 | je 90 Einheiten pro Woche verfügbar |
| Werke | P1, P2 | wandeln Vorprodukte in Fertigware um |
| Distributionszentren | D1, D2, D3 | Kapazitäten 55, 75 und 65 Einheiten |
| Kunden | C1, C2, C3, C4 | Bedarf 25, 35, 40 und 30, zusammen 130 |
Jede der vierzehn Verbindungen trägt eine Kapazität, Kosten je Einheit und eine Transportzeit, wie in der Abbildung oben gezeichnet. Dem Gesamtangebot von 180 steht ein Bedarf von 130 gegenüber, im Grundfall gibt es also Spielraum; Abschnitt 5 nimmt ihn weg.
Ein struktureller Punkt zählt, bevor irgendein Algorithmus läuft. Das Netz ist ein gerichteter azyklischer Graph: Material bewegt sich immer nur von links nach rechts, vom Angebot zum Bedarf. Echte Ketten haben Rückläufe, Nacharbeitsschleifen und Umlagerungen zwischen Lagern, die alle Zyklen erzeugen, und die Algorithmen unten funktionieren trotzdem. Aber der azyklische Fall ist der, in dem die Anschauung am klarsten ist, und dort liegen die meisten taktischen Planungsmodelle tatsächlich.
Ein zweiter Punkt: Das Modell ist einproduktig und einperiodig angelegt. Diese Annahme leistet viel, und Abschnitt 12 zeigt die übliche Graphenkonstruktion, die sie aufhebt.
4. Lieferzeit: kürzeste Wege
Die erste Frage, die man an ein Netz stellt, ist, wie schnell es reagieren kann. Mit Transportzeiten auf den Kanten ist das genau das Kürzeste-Wege-Problem, und Dijkstras Algorithmus beantwortet es für alle Ziele auf einmal in O(m + n log n).
Von jedem Lieferanten aus gelöst, ergibt sich das Servicebild:
| Von | C1 | C2 | C3 | C4 |
|---|---|---|---|---|
| S1 | 6 Tage S1-P1-D1-C1 | 7 Tage S1-P1-D1-C2 | 9 Tage S1-P2-D3-C3 | 8 Tage S1-P2-D3-C4 |
| S2 | 7 Tage S2-P1-D1-C1 | 6 Tage S2-P2-D2-C2 | 6 Tage S2-P2-D3-C3 | 5 Tage S2-P2-D3-C4 |
Drei Dinge folgen aus dieser Tabelle, die Ihnen eine Tabellenkalkulation nicht gesagt hätte. Der schlechteste Service im Netz beträgt 9 Tage, von S1 nach C3, und das ist die Zahl, gegen die ein Service-Level-Agreement geschrieben werden muss. Die beiden Lieferanten sind nicht austauschbar: S1 ist schneller zu C1, S2 ist schneller zu allem anderen, was für Dual Sourcing nach Region statt nach Menge spricht. Und die schnellste Route von S1 nach C3 führt über P2, nicht über das geografisch naheliegende P1, weil der P1-Zweig auf jeder Stufe langsamer ist.
Vergleichen Sie das nun mit den Kosten. Die günstigste Verbindung ab S1 ist S1 → P1 zu 2 je Einheit, und die schnellste Route nach C3 meidet sie vollständig. Tage zu minimieren und Geld zu minimieren sind verschiedene Optimierungen über demselben Graphen, und jedes Planungswerkzeug, das eine einzige „beste Route“ anbietet, wählt stillschweigend eine davon für Sie aus. Der vollständige Entscheidungsbaum, welcher Algorithmus zu welcher Variante passt, steht in Kürzeste-Wege-Algorithmen.
Zwei praktische Erweiterungen sollte man kennen. Eine feste Handlingzeit je Standort bringt man unter, indem man die Verzögerung auf den Knoten legt, den Abschnitt 12 in eine Kante verwandelt. Und wenn die Frage lautet „was ist die schnellste Route, die zugleich weniger als X kostet“, haben Sie ein Kürzeste-Wege-Problem mit Nebenbedingung, das im Allgemeinen NP-schwer ist und meist mit Lagrange-Relaxation oder einem Labeling-Algorithmus statt mit reinem Dijkstra gelöst wird.
5. Kapazität: maximaler Fluss und der Schnitt, der Sie begrenzt
Die zweite Frage ist, wie viel das Netz tatsächlich bewegen kann. Fügen Sie eine künstliche Quelle hinzu, die beide Lieferanten mit ihrer verfügbaren Menge speist, und eine künstliche Senke, die den Bedarf jedes Kunden abzieht, und die Antwort ist eine Berechnung des maximalen Flusses für dieses Netz.
Im Grundfall ist die Antwort unspektakulär: Alle 130 Einheiten kommen durch. Interessant ist, wo die bindende Beschränkung sitzt. Das Flussproblem zu lösen liefert auch den minimalen Schnitt, und hier besteht der Schnitt aus den Kundenkanten selbst. Im Klartext: Nichts im Inneren des Netzes begrenzt irgendetwas, und der einzige Grund, warum nicht mehr Einheiten fließen, ist, dass niemand mehr bestellt hat. Das ist der gesunde Fall, und man sollte ihn bestätigen, bevor jemand um die Freigabe von Investitionen gebeten wird.
Erhöhen Sie nun jeden Bedarf um 40 %, eine maßvolle Hochsaison. Der Bedarf wird zu 182 Einheiten, und das Netz liefert 164.
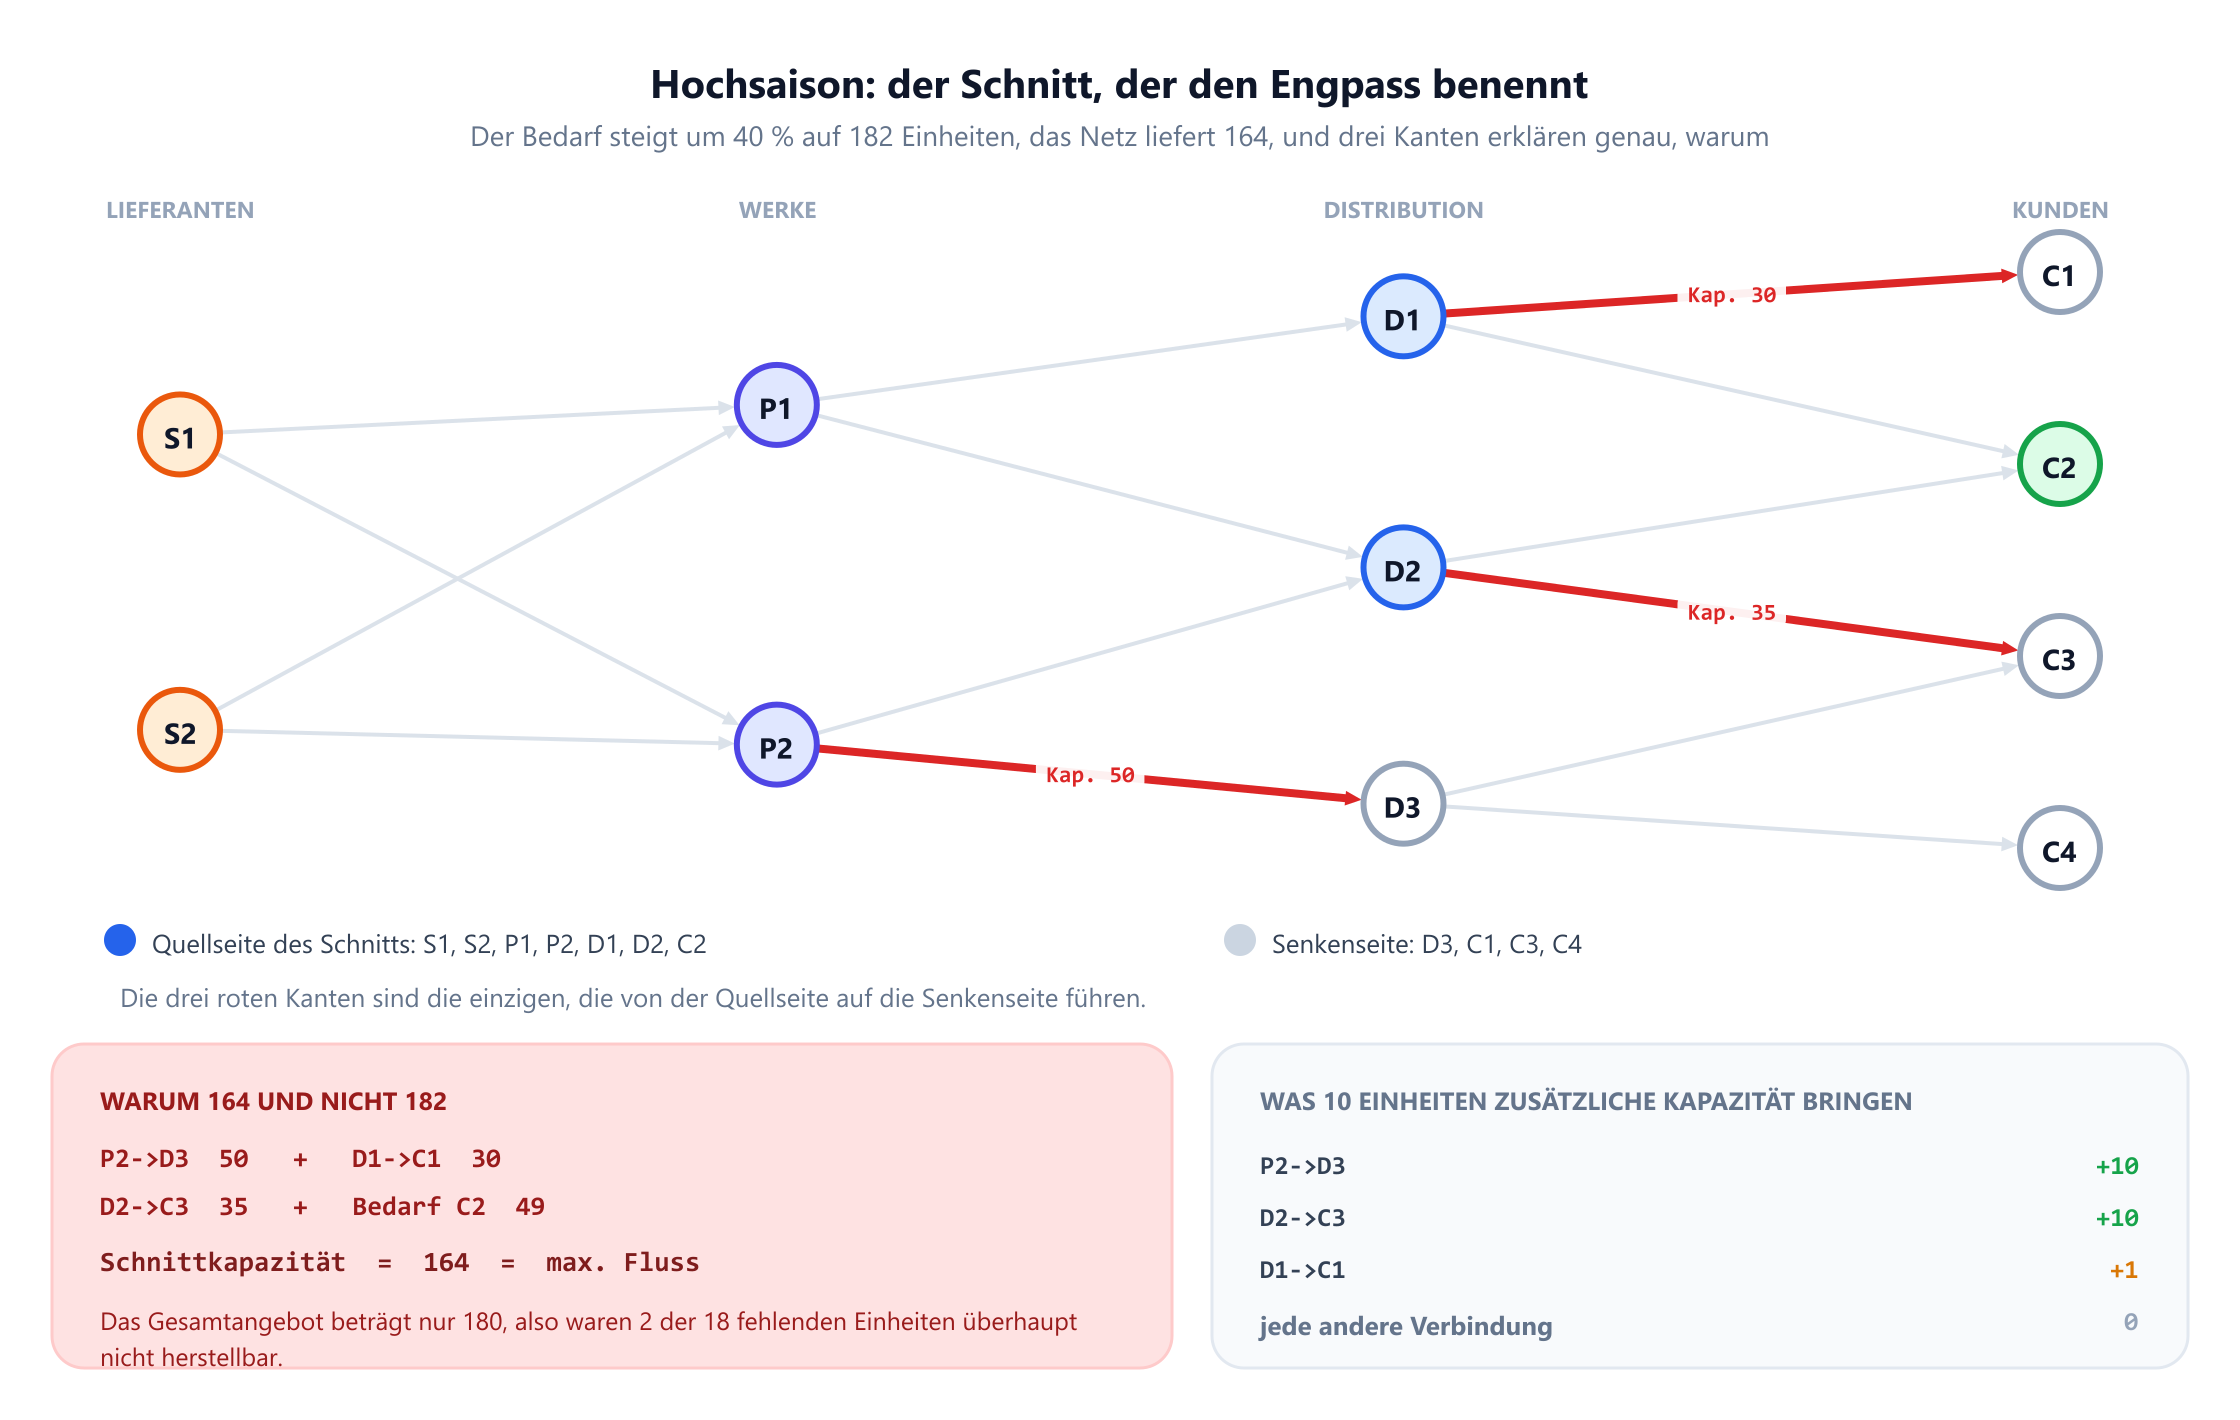
Die 18 fehlenden Einheiten lassen sich genau zerlegen. Das Gesamtangebot beträgt 180, also waren 2 Einheiten nie herstellbar unabhängig vom Netz. Die übrigen 16 gehen an die Struktur verloren, und der minimale Schnitt benennt die Struktur exakt: P2 → D3 mit Kapazität 50, D1 → C1 mit 30, D2 → C3 mit 35, dazu die 49 Einheiten Bedarf von C2, die auf der Quellseite liegen. Das summiert sich zu 164, was nach dem Max-Flow-Min-Cut-Theorem dem maximalen Fluss entsprechen muss, und die Rechnung bestätigt es.
Das ist das Nützlichste, was die Graphentheorie für eine Lieferkette tut, also sei es klar gesagt. Der minimale Schnitt ist die Investitionsliste. Kapazität, die irgendwo sonst hinzukommt, ändert überhaupt nichts. Diese Behauptung an diesem Netz zu prüfen, ergibt ein Resultat, auf das keine Intuition kommt:
- 10 Einheiten mehr auf
P2 → D3: Der Durchsatz steigt von 164 auf 174. - 10 Einheiten mehr auf
D2 → C3: ebenfalls 174. - 10 Einheiten mehr auf
D1 → C1: Der Durchsatz steigt auf 165, und nicht weiter. Eine Einheit, nicht zehn. - 10 Einheiten mehr auf einer der anderen elf Verbindungen: überhaupt keine Änderung.
Der Fall D1 → C1 ist der lehrreiche. Diese Verbindung liegt tatsächlich auf dem minimalen Schnitt, die erste zusätzliche Kapazitätseinheit hilft also, doch danach bindet eine andere Beschränkung und die Investition zahlt sich nicht mehr aus. Ein Schnitt sagt Ihnen, wo die Wand heute steht; er verspricht nicht, dass sie dort stehen bleibt, sobald Sie sie verschieben. In der Praxis wird Kapazitätsplanung deshalb als Folge neuer Rechnungen betrieben und nicht als einmalige Rangliste.
6. Kosten: das Transportproblem und der kostenminimale Fluss
Machbarkeit ist kein Plan. Die operative Frage ist, welcher der vielen machbaren Pläne der günstigste ist, und das ist das Problem des kostenminimalen Flusses: jeden Bedarf decken, jede Kapazität einhalten, die Summe aus Fluss mal Kosten über alle Kanten minimieren.
Sein Vorläufer ist das Transportproblem, 1941 von Hitchcock und unabhängig davon von Koopmans gestellt und 1951 von Dantzig mit einem spezialisierten Simplexverfahren effizient gelöst. Die moderne allgemeine Form löst der Netzwerk-Simplex oder das Verfahren der sukzessiven kürzesten Wege, und Ahuja, Magnanti und Orlins Network Flows bleibt die Standarddarstellung.
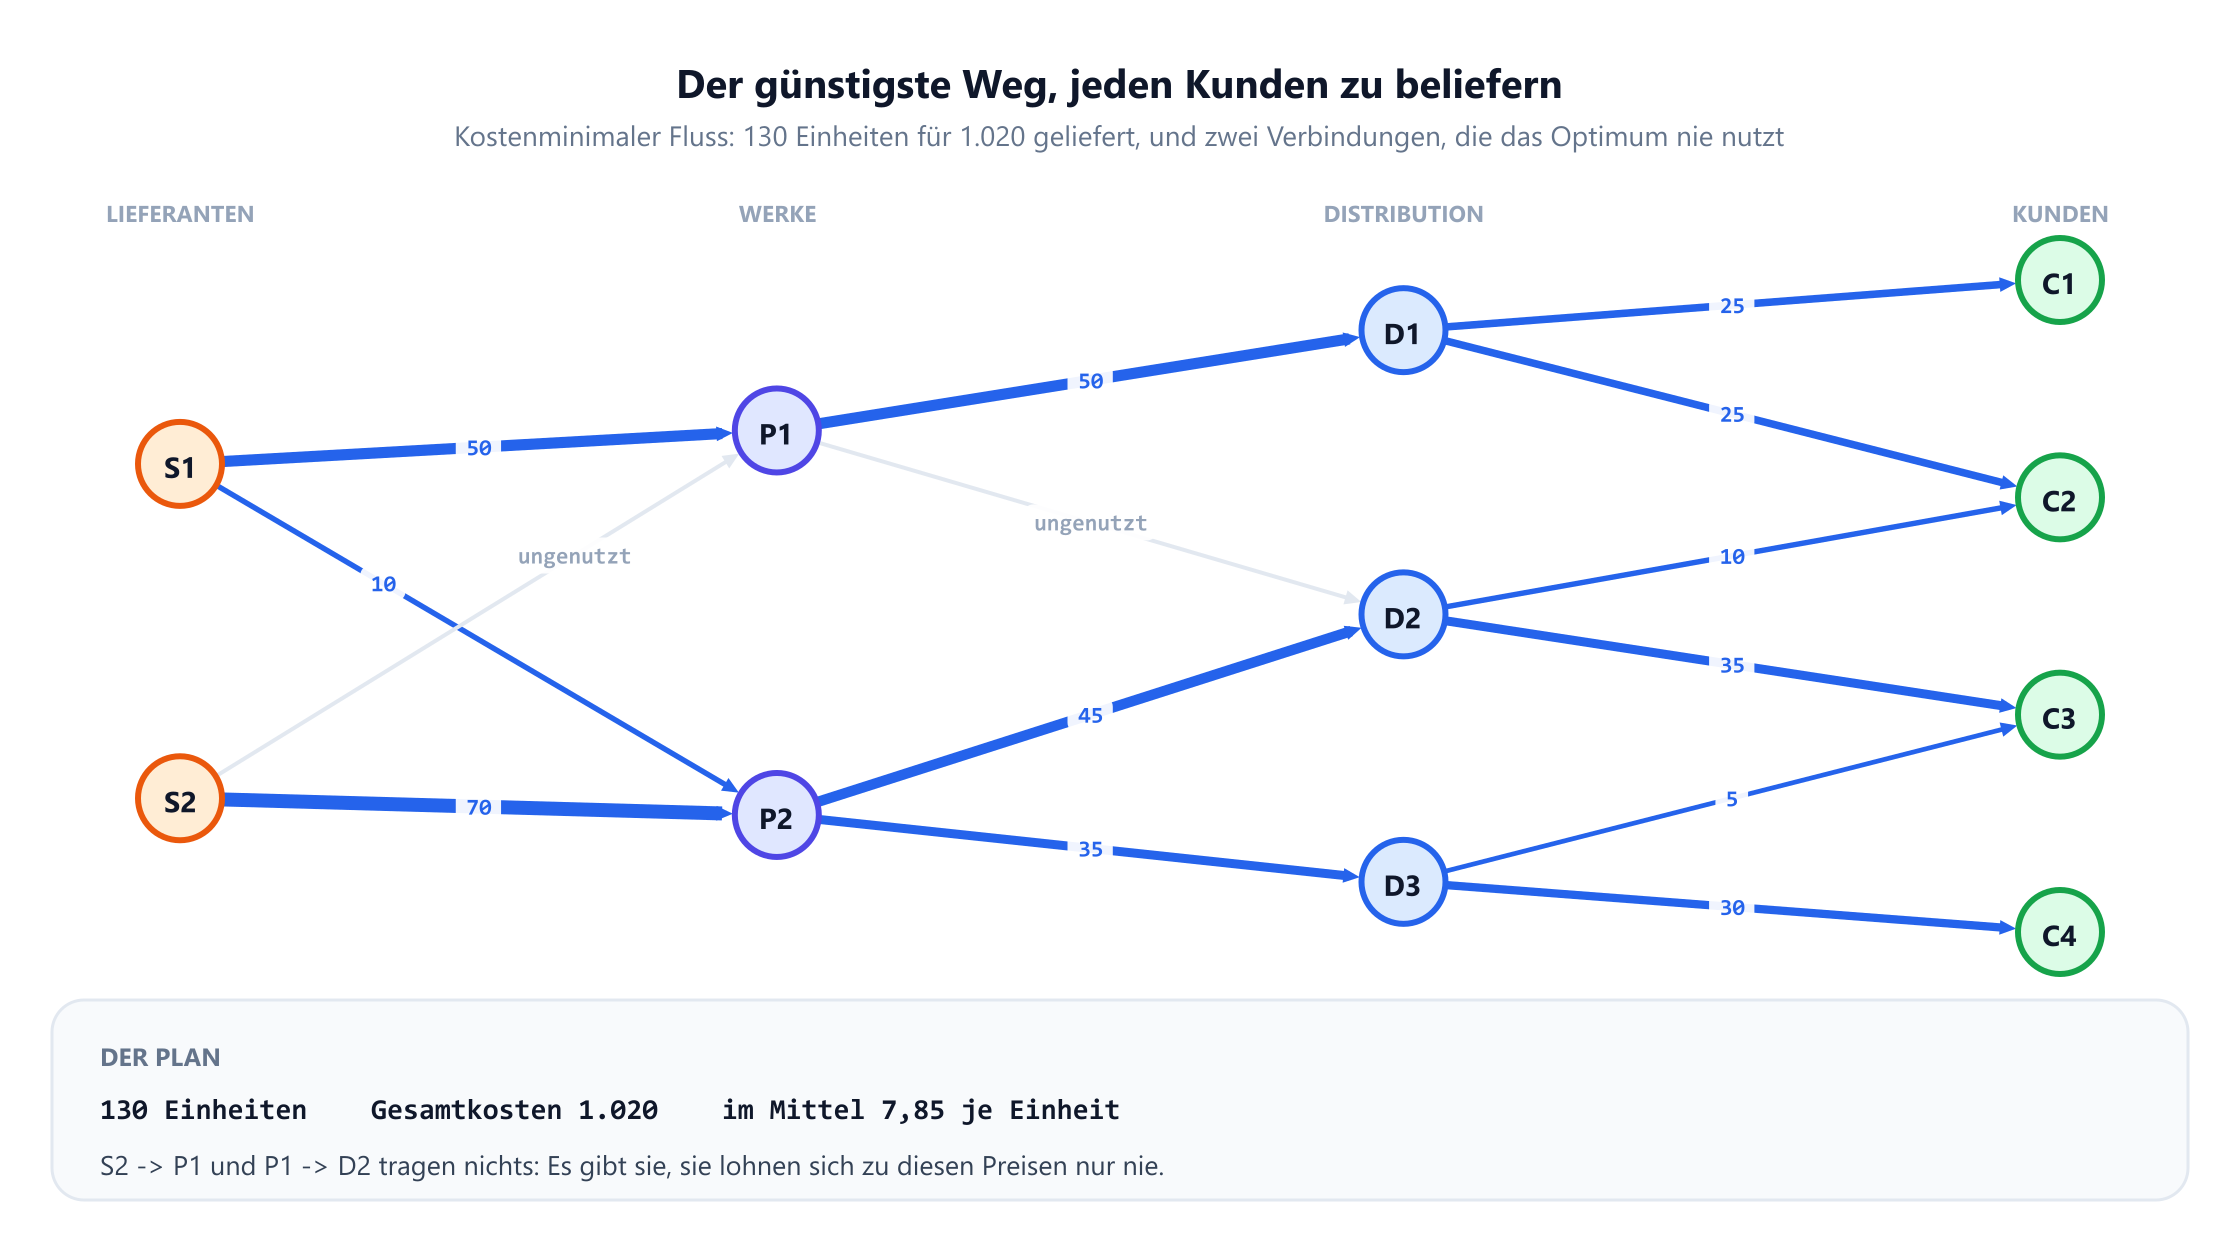
Auf dem laufenden Netz gelöst, kostet der günstigste Weg, alle 130 Einheiten zu liefern, 1.020, im Mittel 7,85 je Einheit:
Drei Eigenschaften der Lösung lohnen genaues Lesen, denn sie sind es, die Leute überraschen.
Zwei Verbindungen tragen nichts. S2 → P1 und P1 → D2 sind völlig nutzbar und zu diesen Preisen nie nutzenswert. Ein Netzdiagramm kann Ihnen das nicht sagen; nur die Optimierung kann es. Es ist auch die Antwort auf „warum zahlen wir für die Unterhaltung dieser Verbindung“, eine Frage, die jährlich gestellt werden sollte.
Der Bedarf wird aufgeteilt. C2 erhält 25 Einheiten von D1 und 10 von D2, und C3 erhält 35 von D2 und 5 von D3. Jeden Kunden aus dem nächstgelegenen Zentrum zu beliefern, ist eine Faustregel, kein Optimum, und hier wäre es teurer. Echte Modelle fügen oft eine Nebenbedingung hinzu, die Aufteilungen verbietet, und der Preis dieser Nebenbedingung sollte gemessen und nicht angenommen werden.
Die Antwort kam in ganzen Einheiten heraus. Das ist kein Glück. Die Nebenbedingungsmatrix eines Netzwerkflussproblems ist total unimodular, deshalb hat das lineare Programm bei ganzzahligen Angeboten und Bedarfen automatisch eine ganzzahlige Optimallösung. Darum löst man Flussprobleme als lineare Programme und erhält trotzdem versandfähige Antworten, und genau das geht in dem Moment verloren, in dem eine binäre Entscheidung „offen oder geschlossen“ hinzukommt, das Thema des nächsten Abschnitts.
7. Welche Lager sollte es überhaupt geben?
Alles bisher nahm das Netz als gegeben. Die strategische Frage ist, welche Standorte existieren sollten, und sie verändert die Mathematik vollständig: Einen Standort zu eröffnen kostet einen festen Betrag, ob er eine Einheit oder tausend versendet, und Fixkosten lassen sich nicht als Kosten je Einheit auf einer Kante ausdrücken.
Geben Sie den drei Distributionszentren wöchentliche Fixkosten von 250, 300 und 200, Kapazitäten von 55, 75 und 65 Einheiten und Kosten je Einheit für die Belieferung jeder Kundenregion. Dann lautet die Frage, welche Teilmenge zu öffnen ist, und für jede mögliche Teilmenge ist die Belieferung selbst ein Transportproblem. Bei drei Standorten gibt es sieben Teilmengen, und wir können schlicht alle lösen.
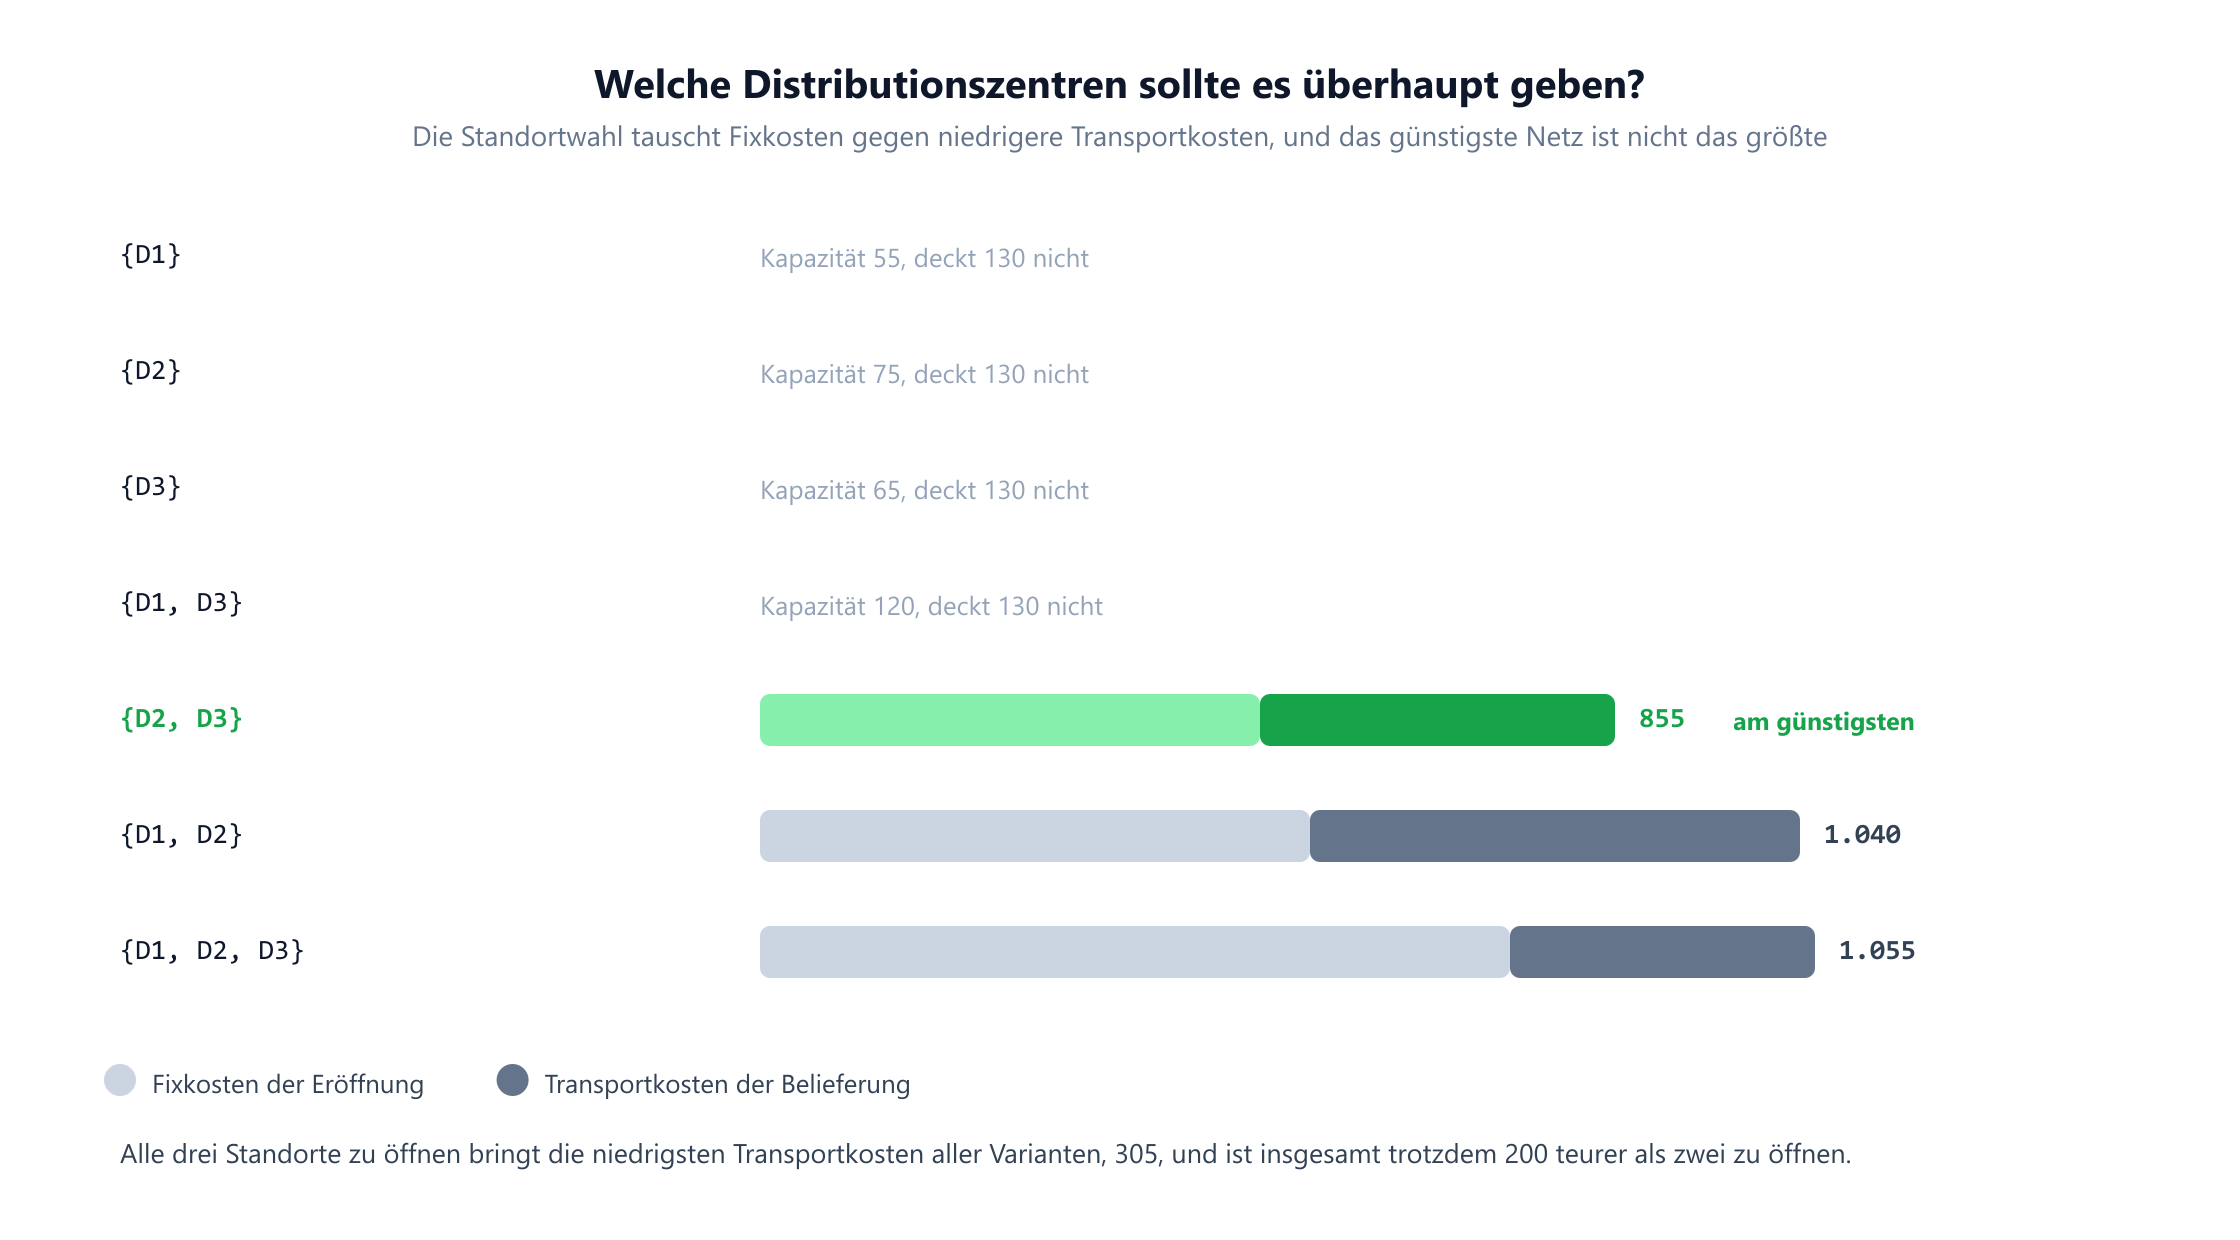
Gewinner ist {D2, D3} mit 855: 500 Fixkosten und 355 Transport. Pädagogisch zählt die letzte Zeile. Alle drei Zentren zu öffnen erzeugt die niedrigsten Transportkosten aller Konfigurationen, nämlich 305, weil dann jeder Kunde aus seiner günstigsten Quelle beliefert werden kann. Insgesamt ist es trotzdem 200 schlechter, weil die Fixkosten des dritten Standorts von 250 nur 50 an Transportersparnis einkaufen. Den Fluss innerhalb eines bereits überdimensionierten Netzes zu optimieren, ist ein guter Weg, effizient falsch zu liegen.
Das ist das kapazitierte Standortproblem, und anders als alles in den Abschnitten 4 bis 6 ist es NP-schwer. Bei drei möglichen Standorten ist rohe Gewalt über acht Teilmengen sofort fertig. Bei dreihundert nicht mehr, und das Fachgebiet löst es mit gemischt-ganzzahliger Optimierung: Balinski gab 1965 die Standardformulierung an, Geoffrion und Graves lösten 1974 ein reales mehrproduktiges Distributionsdesign mit Benders-Dekomposition, und moderne Solver bewältigen industrielle Instanzen routinemäßig. Die Struktur, die das in der Praxis handhabbar macht, ist genau die hier sichtbare: Für jede feste Menge offener Standorte ist der Rest ein Netzwerkfluss, der in polynomieller Zeit lösbar ist. Ein ausführlicheres Beispiel mit Straßenentfernungen, den klassischen Standortheuristiken und dem Preis eines Serviceversprechens steht in Standortwahl: wo das nächste Lager stehen sollte.
8. Das physische Netz planen: Spannbäume
Eine andere Entwurfsfrage lautet nicht „wo sollen Standorte sein“, sondern „welche Verbindungen sollen wir bauen“. Eine eigene Leitung zu legen, einen festen Shuttle zu beauftragen oder ein Anschlussgleis zu bauen kostet je Verbindung etwas, und verlangt ist, dass jeder Standort jeden anderen erreichen kann.
Das Problem heißt minimaler Spannbaum und wird gelöst von Kruskals Algorithmus in O(m log n). Bei sechs Standorten, zwei Werken, drei Zentren und einem gemeinsamen Cross-Docking-Hub, mit elf möglichen Verbindungen zu Preisen zwischen 3 und 10, kostet der günstigste zusammenhängende Entwurf 21 und nutzt fünf Verbindungen: P2-H zu 3, P1-D1 zu 4, D2-H zu 4, P2-D3 zu 5 und D1-H zu 5.
Fünf Verbindungen für sechs Standorte sind kein Zufall. Ein Baum mit n Knoten hat immer genau n - 1 Kanten, und das ist der bestimmende Zielkonflikt des ganzen Ansatzes: Ein Spannbaum ist die günstigste Art, alles zu verbinden, und zugleich die anfälligste. Jede dieser fünf Verbindungen ist eine Brücke, ihr Verlust trennt also das Netz, und drei der sechs Standorte sind Artikulationspunkte. Abschnitt 11 beziffert, was das kostet.
Die praktische Lehre ist, dass der minimale Spannbaum in den meisten Lieferkettensituationen der richtige Algorithmus für das falsche Ziel ist. Gewollt ist meist das günstigste Netz, das den Verlust einer beliebigen einzelnen Verbindung übersteht, also zweifach kantenzusammenhängender Netzentwurf, und dieses Problem ist NP-schwer. Den minimalen Spannbaum zu berechnen lohnt sich trotzdem, denn er ist eine untere Schranke: Kein zusammenhängender Entwurf kann weniger kosten, er nennt Ihnen also den Preis der Redundanz, die Sie gleich kaufen.
9. Die letzte Meile: Fahrzeuge disponieren
Alles Bisherige bewegt Einheiten zwischen Standorten. Der letzte Abschnitt bringt sie an die Tür, und dort entsteht ein großer Teil der Distributionskosten und wird die Mathematik schwer.
Geben Sie einem Fahrzeug eine Menge von Stopps und verlangen Sie die kürzeste Rundreise, die jeden genau einmal besucht und zum Depot zurückkehrt, dann haben Sie das Problem des Handlungsreisenden. Geben Sie einer Flotte Kapazitäten und fragen Sie, welches Fahrzeug welche Stopps bedient, dann haben Sie das Tourenplanungsproblem, 1959 von Dantzig und Ramser unter dem Namen „the truck dispatching problem“ eingeführt und seither um Zeitfenster, gemischte Flotten, Abholung und Zustellung sowie Lenkzeiten erweitert.
Der Unterschied zu den Abschnitten 4 bis 6 ist einer der Art, nicht des Grades. Kürzester Weg, maximaler Fluss und kostenminimaler Fluss sind alle polynomiell: Ein moderner Solver bewältigt ein kontinentales Straßennetz in unter einer Sekunde. TSP und Tourenplanung sind NP-schwer, und die Zahl möglicher Touren durch n Stopps ist (n-1)!/2, was schon bei 20 Stopps 60 Billiarden übersteigt. Deshalb läuft die Praxis auf Heuristiken: Das Ersparnisverfahren von Clarke und Wright aus dem Jahr 1964 ist weiterhin ein Standardverfahren zur Konstruktion, lokale Suche wie 2-opt und Or-opt verbessert das Ergebnis, und Metaheuristiken wie Large Neighbourhood Search treiben kommerzielle Systeme an. Auch exakte Verfahren sind enorm besser geworden, und Instanzen mit hunderten Kunden werden heute beweisbar optimal gelöst, doch das tägliche Disponieren läuft auf Heuristiken, weil es in Minuten beantwortet sein muss.
Der Modellierungspunkt zum Mitnehmen: Die Tourenebene sitzt über der Flussebene. Das Flussmodell entscheidet, dass D3 30 Einheiten in die Region C4 schickt; das Tourenmodell entscheidet die Reihenfolge der Türen innerhalb von C4 und welcher Lkw sie fährt. Beides gemeinsam zu optimieren ist möglich und der Anspruch integrierter Planungssysteme, doch die Zweiteilung ist üblich, weil jede Stufe aus einem anderen Grund schwer ist. Die Tourenebene von Anfang bis Ende durchgerechnet und mit Flottenkosten versehen finden Sie in Optimierung von Lieferrouten.
10. In der Fabrik: Material und Termine
Zoomen Sie in ein einzelnes Werk, und die Graphen hören nicht auf. Zwei davon führen die Fabrik, und beide sind gerichtete azyklische Graphen, die ein Durchlauf in topologischer Ordnung beantwortet.
Der erste ist die Stückliste. Ein Produkt besteht aus Komponenten, von denen jede wieder aus Komponenten besteht, und die Kanten tragen Mengen. Einen Kundenauftrag in Rohmaterialbedarfe aufzulösen heißt, diesen Graphen von oben nach unten zu durchlaufen und dabei zu multiplizieren. Genau das tut die Materialbedarfsplanung, 1975 von Orlicky formalisiert und bis heute die Kernschleife jedes ERP-Systems.
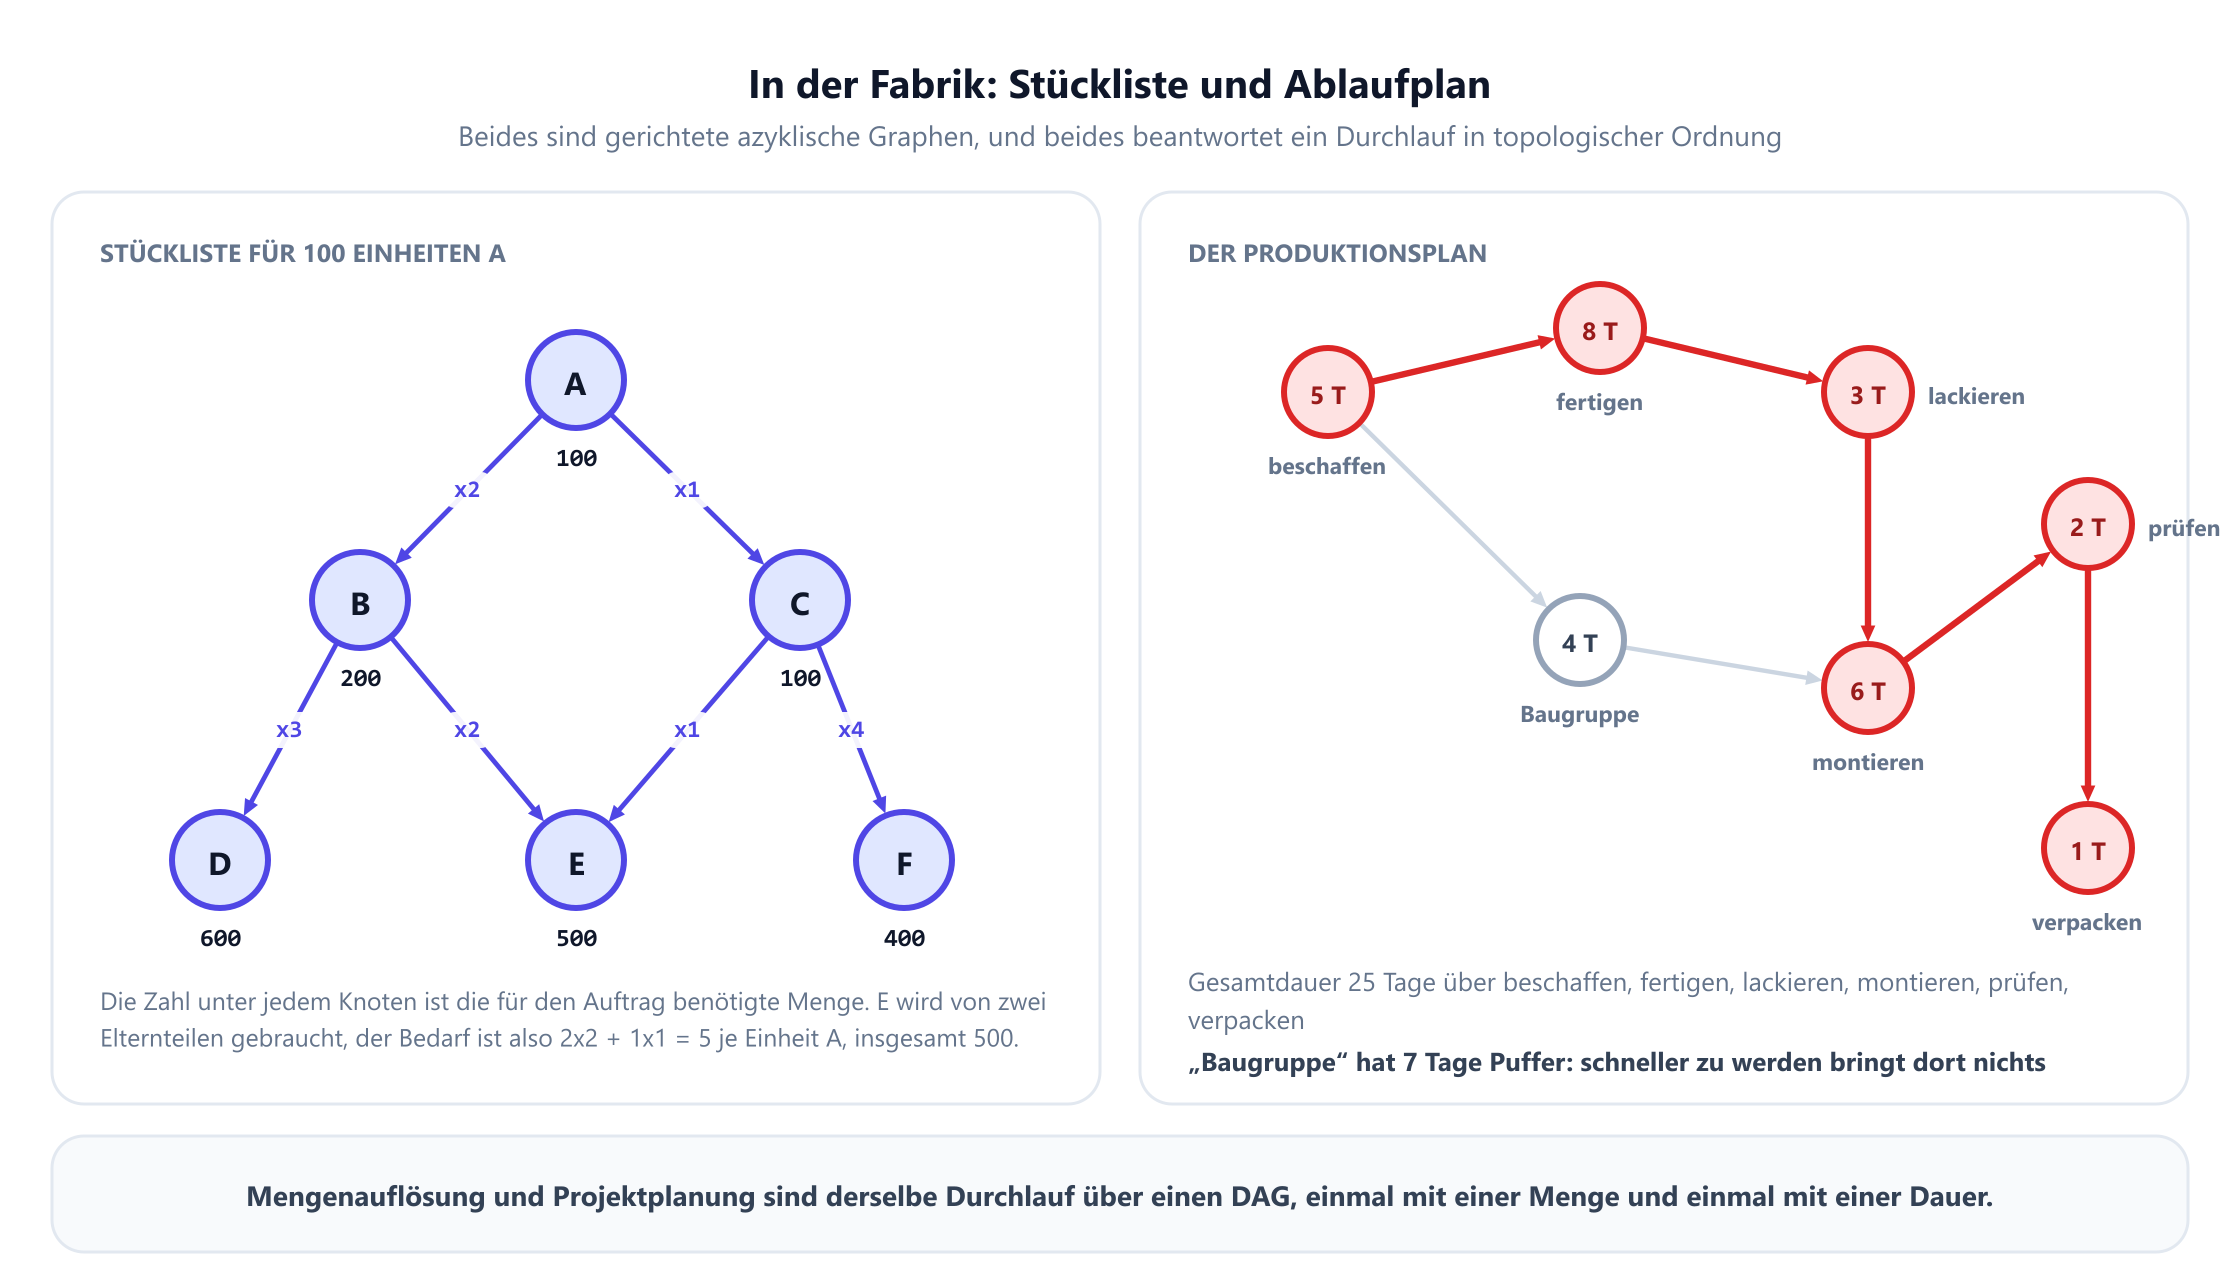
Für einen Auftrag über 100 Einheiten des Produkts A ergibt die Auflösung 200 von B, 100 von C, 600 von D, 500 von E und 400 von F. Bei Komponente E lohnt das Innehalten: Sie taucht unter zwei verschiedenen Elternteilen auf, ihr Bedarf ist also 2 × 2 über B plus 1 × 1 über C, was 5 je Einheit A ergibt. Die Zweige unabhängig voneinander aufzuaddieren, was eine naive Tabellenkalkulation tut, zählt genau diese gemeinsam genutzten Komponenten doppelt oder zu wenig. Die Teile in topologischer Ordnung zu verarbeiten garantiert, dass jedes Elternteil fertig ist, bevor ein Kind gelesen wird, und deshalb stimmt der Durchlauf in einem Zug.
Der zweite Graph ist der Terminplan. Aufgaben haben Dauern und Anordnungsbeziehungen, und die Projektlänge ist der längste Pfad durch den entstehenden DAG. Im Siebenaufgabenplan der Abbildung beträgt die Gesamtdauer 25 Tage, über beschaffen, fertigen, lackieren, montieren, prüfen und verpacken. Diese Kette ist der kritische Pfad aus Kelley und Walkers Methode von 1959, und ihre praktische Bedeutung ist scharf: Jede Verzögerung darauf verzögert den Auftrag eins zu eins, während die Baugruppe 7 Tage Puffer trägt und eine volle Woche später fertig werden könnte, ohne den Liefertermin um eine Stunde zu verschieben.
Beachten Sie die Asymmetrie, die das wertvoll macht. Der längste Pfad ist auf einem allgemeinen Graphen NP-schwer und auf einem DAG linear, Terminplanung ist also gerade deshalb billig, weil Anordnungsbeziehungen keinen Zyklus bilden dürfen. Tun sie es doch, ist der Plan unmöglich, und derselbe Algorithmus erkennt auch das. Kundenaufträge durch die Maschinen selbst zu sequenzieren, mit Terminen, Farbwechseln und Überstunden, wird in Produktionsplanung für Fertiger durchgerechnet.
11. Resilienz: was bricht, und wie schwer
Ein Kostenmodell sagt Ihnen, was zu tun ist, wenn alles funktioniert. Ein Resilienzmodell sagt Ihnen, was passiert, wenn nicht, und es ist derselbe Graph mit einer anderen Frage: einen Knoten entfernen, den Fluss neu lösen und die Fehlmenge ablesen.
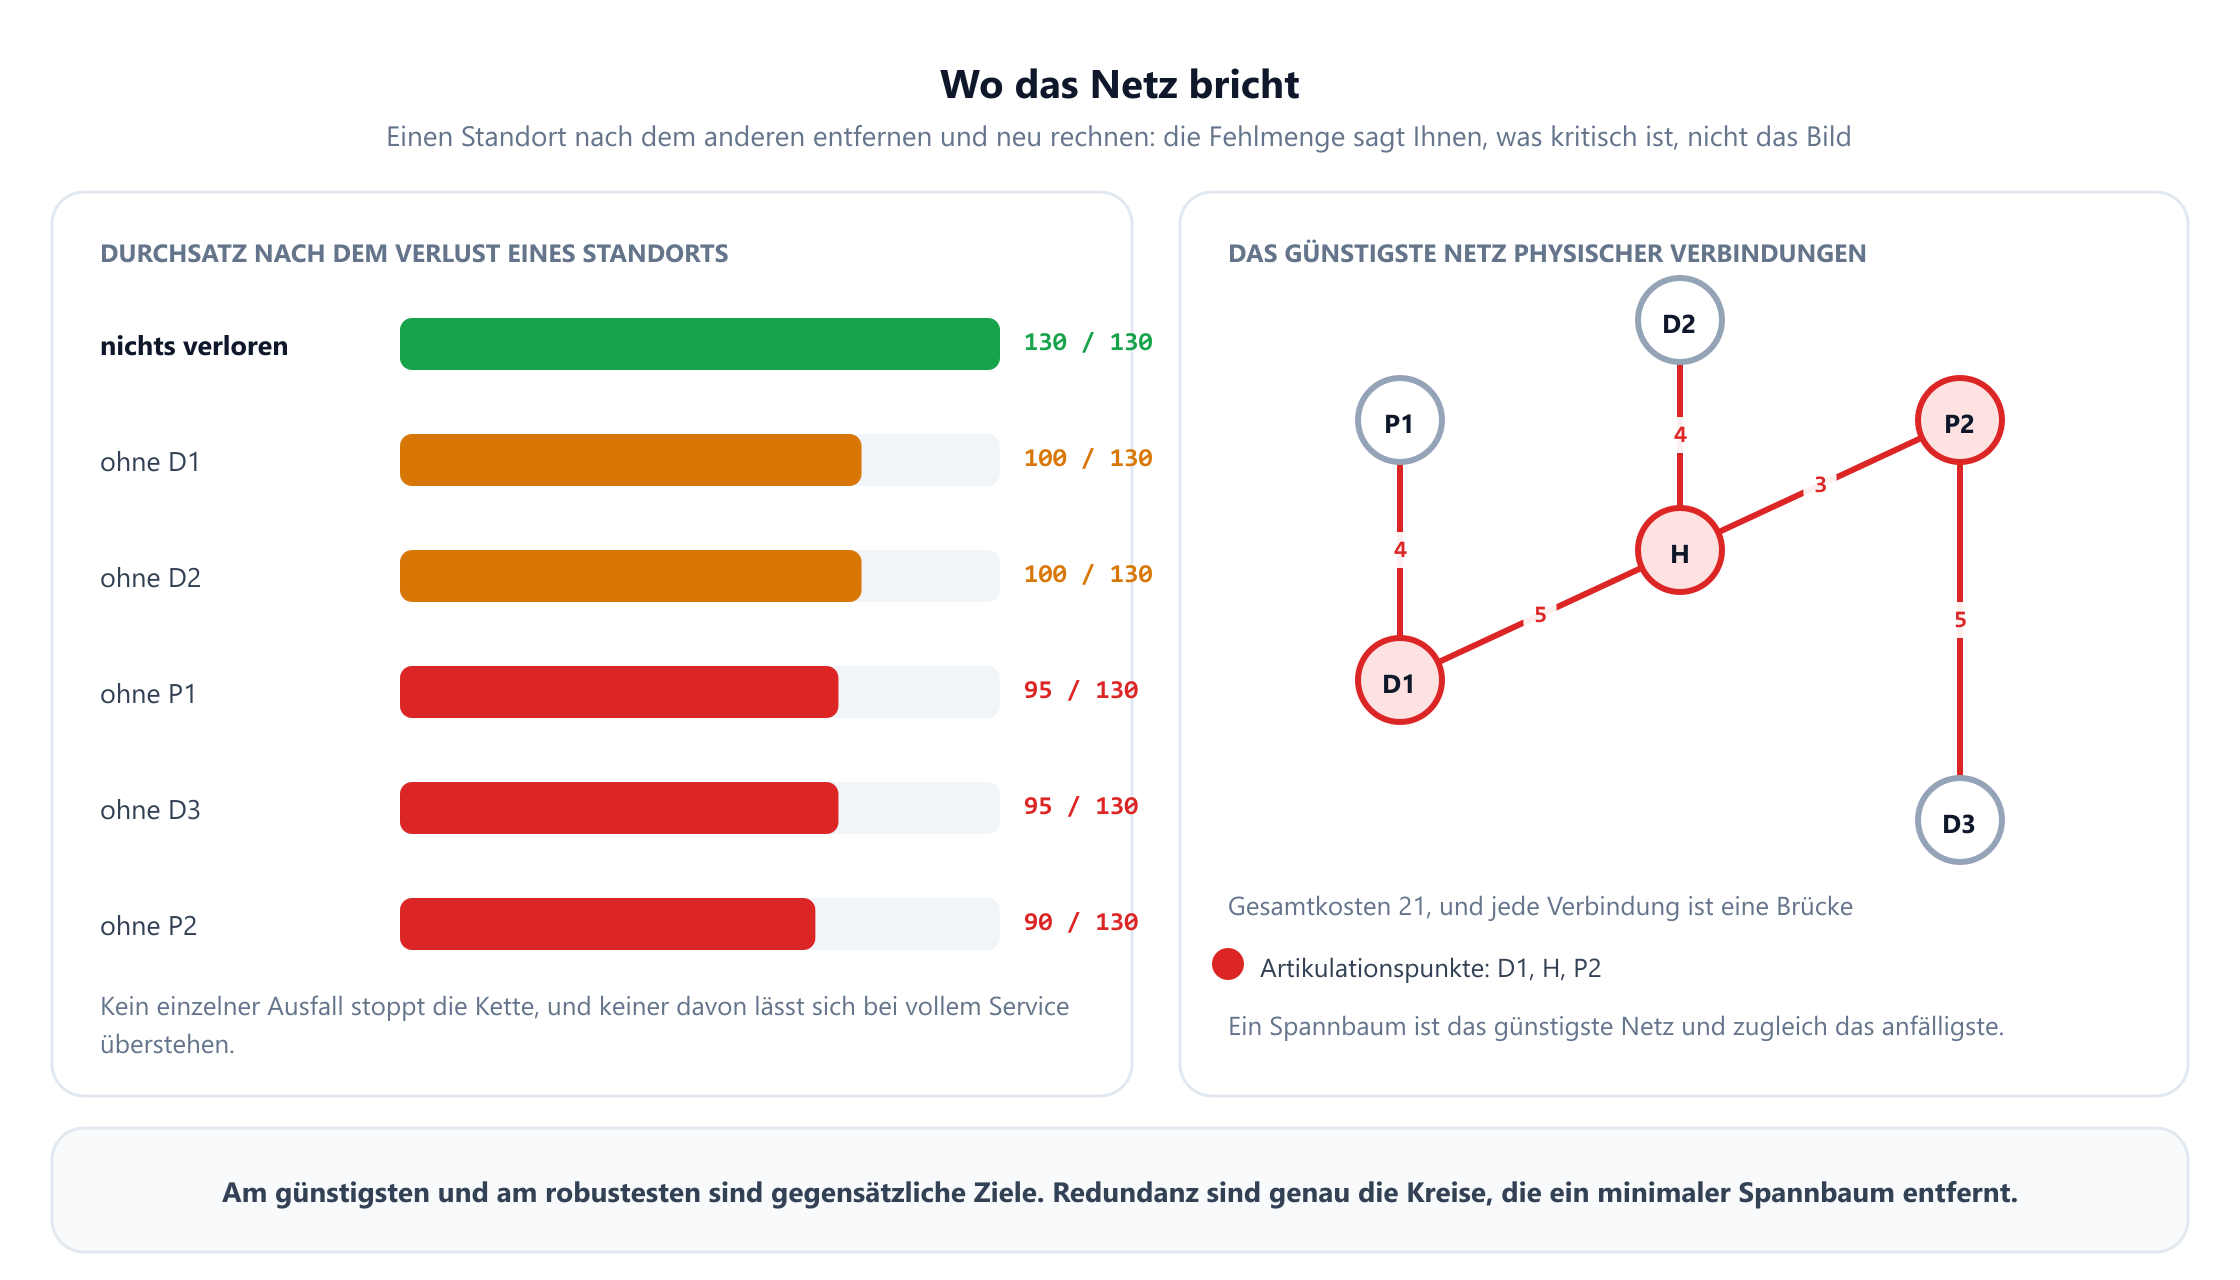
Der Verlust eines beliebigen einzelnen Standorts lässt das Netz noch zwischen 90 und 100 der 130 Einheiten liefern. Der schlimmste Fall ist P2 mit 90 Einheiten, eine Fehlmenge von 31 %, und dieses Ergebnis liest man am besten gegen Abschnitt 6. Der günstigste Plan führt 70 Einheiten über S2 → P2 und insgesamt 80 Einheiten über P2, weil P2 auf den günstigsten Verbindungen liegt. Kostenoptimierung bündelt den Fluss, und gebündelter Fluss ist genau das, wie Fragilität aussieht. Das Optimum und das Risiko entstehen aus derselben Eigenschaft des Netzes.
Auch einzelne Verbindungen zählen, und zwar ungleich. Die schlimmste einzelne Verbindung ist P2 → D3, deren Verlust 35 Einheiten kostet; P1 → D1 und D3 → C4 kosten je 30; D2 → C3 kostet 20; und S1 → P1, D1 → C2 oder D3 → C3 kosten nur 5. Ausgaben zur Risikominderung nach dem Volumen einer Verbindung zu ordnen, würde diese Reihenfolge verfehlen, denn Volumen ist das, was der Plan zu senden beschlossen hat, nicht das, was das Netz verlieren würde.
Die strukturelle Sicht aus Abschnitt 8 sagt dasselbe in einer anderen Sprache. In einem minimalen Spannbaum ist jede Verbindung eine Brücke und mehrere Standorte sind Artikulationspunkte, ein kostenminimales physisches Netz hat also konstruktionsbedingt überhaupt keine Redundanz. Redundanz sind die Zyklen, die der Spannbaum entfernt hat. Resilienz zu kaufen heißt, bewusst Kanten zu kaufen, die ein Kostenmodell ablehnen würde.
Zwei Forschungsstränge verdienen hier eine Nennung. Sheffis The Resilient Enterprise (2005) machte den Fall, dass Flexibilität ein strategisches Gut ist und keine Verschwendung. Und Simchi-Levi und Kollegen formalisierten in Zusammenarbeit mit Ford den Gedanken, dass Risiko an der Zeit bis zur Erholung und der daraus folgenden Ergebniswirkung gemessen werden sollte statt an der Wahrscheinlichkeit einer Störung, die unbekannt ist: Ihre Studie von 2015 fand, dass die Teile mit dem größten Risiko häufig geringwertige Komponenten von Einzelquellenlieferanten waren, die keine ausgabenbasierte Analyse je auffallen ließe. Das ist eine Graphenfrage, und es ist genau die, die dieser Abschnitt berechnet.
12. Zwei Modellierungstricks, die man kennen sollte
Zwei Konstruktionen verwandeln „das kann das Modell nicht ausdrücken“ in „das drückt das Modell problemlos aus“, und zusammen decken sie das meiste ab, worauf Anfänger zuerst stoßen.
Knotenaufspaltung, für Kapazität an einem Standort. Flussalgorithmen legen Kapazität auf Kanten, doch ein Lager hat eine eigene Durchsatzgrenze. Die Lösung ist, den Knoten durch zwei zu ersetzen: eine „In“-Kopie, die alle eingehenden Kanten empfängt, eine „Out“-Kopie, die alle ausgehenden Kanten sendet, und eine einzige Kante dazwischen, die die Kapazität des Standorts trägt.
vorher:        --> [ D2 ] -->

nachher:         --> [D2_in] --(Kapazität 75, Kosten = Handlinggebühr)--> [D2_out] -->
Derselbe Trick trägt auch Handlingkosten oder eine feste Bearbeitungsverzögerung, und so nehmen die Lieferzeiten aus Abschnitt 4 die Zeit auf, die im Gebäude statt auf der Straße vergeht. Er verdoppelt die Knotenzahl und ändert sonst nichts, und jeder Flussalgorithmus dieses Artikels funktioniert danach unverändert.
Zeitexpansion, für Bestände. Ein Einperiodenmodell hat kein Gedächtnis: Was produziert wird, muss sofort versendet werden. Echte Ketten halten Bestand, und Bestand ist Bewegung durch die Zeit statt durch den Raum. Bauen Sie eine Kopie des Netzes je Periode und fügen Sie von jedem Standort in Periode t eine Kante zu demselben Standort in Periode t+1 hinzu. Der Fluss auf dieser Kante ist der Bestand, seine Kosten sind die Lagerkosten, und seine Kapazität ist die Lagergrenze. Wie viel davon zu halten ist und wo, ist ein eigenes Optimierungsproblem, behandelt in unserem Leitfaden zu Bestandsoptimierung und Sicherheitsbestand.
Das Ergebnis heißt zeitexpandiertes Netz, und genau deshalb ist mehrperiodige Produktionsplanung überhaupt lösbar: Ein Problem, das nach einer neuen Theorie auszusehen scheint, entpuppt sich als gewöhnlicher kostenminimaler Fluss auf einem Graphen, der T mal größer ist. Dieselbe Konstruktion behandelt auch die Haltbarkeit, indem man die Kante, die Bestand über das Verfallsdatum hinaustragen würde, schlicht nicht baut.
Beide Tricks teilen eine Moral, die man verinnerlichen sollte. Wenn ein Lieferkettenmerkmal einen neuen Algorithmus zu brauchen scheint, braucht es meist einen neuen Graphen, und der Algorithmus, den Sie schon haben, passt dann unverändert.
13. Was leicht ist und was schwer
Das Wertvollste, was Planende über ihr eigenes Modell wissen können, ist, auf welcher Seite der Berechenbarkeitsgrenze es liegt, denn das entscheidet, ob die Antwort ein Optimum oder ein guter Tipp ist.
| Frage der Lieferkette | Graphenproblem | Aufwand |
|---|---|---|
| Schnellste Route, Servicezusagen | Kürzester Weg | O(m + n log n) |
| Können wir alles liefern? Wo ist der Engpass? | Maximaler Fluss, minimaler Schnitt | Polynomiell |
| Günstigster Versandplan | Kostenminimaler Fluss | Polynomiell |
| Materialbedarf | Topologische Ordnung auf einem DAG | O(n + m) |
| Projektdauer, kritischer Pfad | Längster Pfad auf einem DAG | O(n + m) |
| Günstigste Menge verbindender Leitungen | Minimaler Spannbaum | O(m log n) |
| Welche Standorte öffnen | Standortplanung | NP-schwer |
| Lieferrouten für eine Flotte | Tourenplanung | NP-schwer |
| Günstigstes Netz, das jeden Einzelausfall übersteht | Zweifach kantenzusammenhängender Entwurf | NP-schwer |
| Produktionslose über die Zeit | Losgrößenplanung mit Rüstkosten | im Allgemeinen NP-schwer |
Das Muster ist klar und sei ausgesprochen: Fragen zum Fluss sind leicht, Fragen danach, welche diskreten Objekte gebaut werden, sind schwer. In dem Moment, in dem eine Entscheidung ein Ja oder Nein wird statt eines Wie viel, geht die totale Unimodularität verloren, das lineare Programm gibt keine ganzzahligen Antworten mehr zurück, und Sie sind in der gemischt-ganzzahligen Optimierung.
Schwer heißt nicht aussichtslos. Standortprobleme mit hunderten möglichen Standorten werden täglich beweisbar optimal gelöst, und Tourenplanungsheuristiken landen bei Instanzen, die weit jenseits exakter Verfahren liegen, innerhalb weniger Prozent der besten bekannten Lösungen. Was die Grenze ändert, ist das Versprechen: In der oberen Tabellenhälfte dürfen Sie sagen „das ist optimal“, in der unteren lautet der ehrliche Satz „das ist das Beste, was wir gefunden haben, und hier ist die Schranke“. Eine ausführlichere Behandlung der Aufwände selbst steht in Graphenalgorithmen und Komplexität.
14. Vom Modell zur Praxis
Die Lücke zwischen einem korrekten und einem nützlichen Modell ist überwiegend keine Mathematik. Vier Dinge entscheiden, ob die Arbeit ankommt.
Die Daten sind das Projekt. Kosten, Kapazitäten und Transportzeiten je Verbindung liegen in Transportmanagementsystemen, Verträgen und Tabellen, und sie widersprechen einander. Ein Modell auf einer achtzehn Monate alten Kostentabelle liefert eine selbstbewusste, präzise, falsche Antwort, und die Schuld wird der Optimierung gegeben. Planen Sie hier den größten Teil des Aufwands ein.
Wählen Sie die Granularität bewusst. Eine strategische Netzstudie darf eine ganze Region als einen Kundenknoten behandeln; ein wöchentliches Dispositionsmodell nicht. Bedarfe zu aggregieren ist legitim, Kapazitäten zu aggregieren meist nicht, weil Mittelwerte genau die Spitzen verbergen, die den Engpass aus Abschnitt 5 erzeugen.
Nehmen Sie einen echten Solver. Für Flüsse liefern NetworkX und SciPy beide einen kostenminimalen Fluss mit, und Google OR-Tools deckt Flüsse, Tourenplanung und Terminierung mit einer praxisnahen Schnittstelle ab. Für alles mit binären Entscheidungen ist ein Solver für gemischt-ganzzahlige Optimierung wie Gurobi, CPLEX oder die quelloffenen HiGHS und CBC das richtige Werkzeug. Einen eigenen Netzwerk-Simplex zu schreiben ist gut zum Lernen und schlecht zum Ausliefern.
Modellieren Sie das, was tatsächlich schwankt. Ein deterministisches Modell beantwortet „was ist am besten, wenn nächste Woche genau so aussieht“. Der Bedarf sieht nie genau irgendwie aus, und der klassische Fehlermodus ist hier kein algorithmischer: Forrester beschrieb 1958, wie Bestellpolitiken die Schwankungen stromaufwärts verstärken, und Lee, Padmanabhan und Whang nannten es 1997 den Peitscheneffekt. Keine noch so gute Optimierung des Flusses einer einzelnen Woche adressiert das. Die üblichen Antworten sind Szenarioanalyse, stochastische oder robuste Optimierung und ein rollierender Horizont, der neu rechnet, sobald die Realität eintrifft.
Eine letzte Gewohnheit, die die Zahlen in diesem Artikel vorführen sollen: neu rechnen statt schlussfolgern. Die Behauptung, eine Verbindung sei kritisch, ein Standort verdiene seine Fixkosten oder eine Kapazitätsinvestition rechne sich, kann das Modell in Millisekunden klären, und die Intuition über Netze ist genau in den Fällen unzuverlässig, die zählen. Abschnitt 5 fand eine Verbindung, auf der zehn zusätzliche Kapazitätseinheiten eine Einheit Durchsatz kaufen. Das errät niemand.
15. Modellierungsfehler, die selbstbewusst falsche Antworten liefern
Ein Netzmodell scheitert selten laut. Es liefert einen Plan, der Plan sieht vernünftig aus, und der Fehler ist nur für jemanden sichtbar, der weiß, wo er hinschauen muss. Das sind die Fehler, die wiederkehren.
- Die Kapazität eines Standorts auf eine seiner Kanten legen. Ein Lager, das 75 Einheiten pro Woche bewältigt, ist nicht dasselbe wie eine Verbindung, die 75 tragen kann, und die Grenze auf die gerade am stärksten belastete Kante zu quetschen, erlaubt stillschweigend mehr oder weniger Durchsatz, als die Realität zulässt. Spalten Sie den Knoten, wie in Abschnitt 12.
- Eine einzige Zahl als Kantengewicht verwenden. Kosten, Zeit und Kapazität beantworten verschiedene Fragen, und ein Modell, das nur eine davon trägt, liefert selbstbewusst den günstigsten Plan, wenn nach dem schnellsten gefragt war. In diesem Netz unterscheiden sich die beiden Antworten wirklich.
- Eine Mehrperiodenfrage mit einem Einperiodenmodell beantworten. Ohne Bestandskanten muss alles Produzierte sofort versendet werden, das Modell erklärt also entweder einen machbaren Plan für unmöglich oder erfindet Kapazität, die es nicht hat. Expandieren Sie stattdessen das Netz in der Zeit.
- Kapazität zusammen mit dem Bedarf aggregieren. Vier Wochen Bedarf zu einer zusammenzufassen ist oft vertretbar, Kapazität zusammenzufassen nicht, denn der Mittelwert verbirgt genau die Spitze, die den Engpass erzeugt. Die Spitze von 40 % aus Abschnitt 5 verschwindet unter monatlicher Mittelung vollständig.
- Kosten ohne Servicebedingung optimieren. Ein reines Kostenziel schickt bereitwillig alles über die langsamen günstigen Verbindungen. Die Lieferzeit muss als Nebenbedingung oder als Strafterm hinein, sonst ist das Optimum eines, das niemand betreiben kann.
- Risiken nach Volumen ordnen. Die meistbefahrene Verbindung ist die, die der Plan gewählt hat, und das ist nicht dieselbe, deren Verlust am meisten schmerzt. Rechnen Sie ohne jeden Kandidaten neu und ordnen Sie nach der Fehlmenge, wie es Abschnitt 11 tut und was eine andere Reihenfolge ergibt.
- Eine Lkw-Ladung als Kosten je Einheit bepreisen. Fracht ist häufig eine Treppenfunktion: Die zweite Palette auf einem halbleeren Lkw ist fast umsonst, die erste Palette auf einem neuen Lkw nicht. Lineare Kosten je Einheit glätten das weg und unterschätzen Bündelung systematisch. Treppenkosten brauchen Binärvariablen, was das Modell in die gemischt-ganzzahlige Optimierung verschiebt.
- Vergessen, dass die Kantenliste eine Modellierungsentscheidung ist. Der Optimierer kann nur Verbindungen wählen, die in den Daten stehen. Eine Verbindung, die niemand eingetragen hat, ist eine, die nie in der Antwort auftauchen wird, und „das Modell sagt, wir sollten diese Route nicht nutzen“ heißt oft nur „niemand hat dem Modell gesagt, dass es die Route gibt“.
Der rote Faden ist, dass alle acht plausible Ausgaben erzeugen. Die Verteidigung besteht darin, das Modell gegen einen bereits erlebten Zeitraum zu testen: Wenn es die tatsächlichen Flüsse des letzten Quartals nicht in vernünftiger Genauigkeit reproduzieren kann, ist es nicht bereit, das nächste zu empfehlen.
16. Häufig gestellte Fragen
Wie wird Graphentheorie im Lieferkettenmanagement eingesetzt?
+
Standorte werden zu Knoten und Transportverbindungen zu gerichteten Kanten, und dann werden die üblichen Fragen zu üblichen Algorithmen: kürzester Weg für Lieferzeiten und Servicegrade, maximaler Fluss für Durchsatz und Engpässe, kostenminimaler Fluss für den günstigsten Versandplan, minimaler Spannbaum für den Netzentwurf, topologische Ordnung für Stücklisten und Produktionspläne, und Standortplanung sowie Tourenplanung für die strategischen und die Letzte-Meile-Entscheidungen. Netzwerkoptimierung ist keine Analogie für die Lieferkettenplanung; sie ist die Mathematik, auf der das Fach gebaut ist.
Was ist der Unterschied zwischen maximalem Fluss und kostenminimalem Fluss?
+
Der maximale Fluss fragt, wie viel physisch durchkommt, und ignoriert Geld vollständig; er beantwortet „können wir die Saisonspitze bedienen, und wenn nicht, wo ist die Wand“. Der kostenminimale Fluss fragt nach dem günstigsten Weg, eine geforderte Menge zu bewegen, und ignoriert alles, was keinen Preis hat; er beantwortet „wenn wir den Bedarf decken können, was sollten wir auf jeder Verbindung tatsächlich versenden“. In der Praxis rechnen Sie zuerst den maximalen Fluss, um Machbarkeit und Engpass zu prüfen, und dann den kostenminimalen Fluss, um den Plan zu erzeugen.
Warum ist der minimale Schnitt in der Praxis so nützlich?
+
Weil er eine vage Aussage in eine Liste verwandelt. Das Max-Flow-Min-Cut-Theorem sagt, dass der maximale Durchsatz der Kapazität der kleinsten Kantenmenge entspricht, deren Entfernung Angebot von Bedarf trennt, der Schnitt ist also eine präzise Antwort auf „welche Verbindungen sind die Beschränkung“. Kapazität, die irgendwo sonst hinzukommt, bringt nichts. Im Netz dieses Artikels bringen zehn zusätzliche Einheiten auf einer von zwei benannten Verbindungen zehn Einheiten Durchsatz, auf einer dritten eine, und auf den übrigen elf Verbindungen genau null.
Ist das günstigste Netz auch das beste Netz?
+
Fast nie, und die Graphentheorie erklärt knapp, warum. Der günstigste Weg, eine Menge von Standorten zu verbinden, ist ein Spannbaum, und ein Spannbaum hat keine Zyklen, also keine Ausweichrouten: Jede Verbindung ist eine Brücke, deren Verlust das Netz trennt. Redundanz ist genau die Menge der Zyklen, die ein kostenminimierender Entwurf löscht. Derselbe Effekt zeigt sich im Flussplan, wo das Bündeln der Menge auf die günstigsten Verbindungen einen Einzelausfall teuer macht. Kosten und Resilienz sind konkurrierende Ziele und sollten gegeneinander bepreist statt als vereinbar angenommen werden.
Welche Probleme der Lieferkette sind NP-schwer?
+
Die, die entscheiden, welche diskreten Objekte existieren. Standortplanung, Tourenplanung, Losgrößenplanung mit Rüstkosten und der Entwurf eines Netzes, das jeden Einzelausfall übersteht, sind alle NP-schwer. Alles rund um den Fluss durch ein festes Netz ist polynomiell: kürzester Weg, maximaler Fluss, kostenminimaler Fluss, Spannbäume, topologische Ordnung und kritische Pfade. Die Trennlinie ist der Moment, in dem eine Entscheidung ein Ja oder Nein wird statt eines Wie viel, denn dann hört die Relaxation des linearen Programms auf, von selbst ganzzahlige Antworten zu liefern.
Welche Software löst diese Modelle?
+
Für reine Netzwerkflüsse bringen NetworkX und SciPy beide Solver für den kostenminimalen Fluss mit, und Google OR-Tools deckt Flüsse, Tourenplanung und Terminierung mit einer praxisorientierten Schnittstelle ab. Für alles mit binären Entscheidungen, etwa das Öffnen von Standorten oder das Zuordnen von Lkw, nehmen Sie einen Solver für gemischt-ganzzahlige Optimierung: Gurobi und CPLEX kommerziell, HiGHS und CBC quelloffen, meist über eine Modellierungsschicht wie Pyomo, PuLP oder JuMP. Einen eigenen Netzwerk-Simplex zu schreiben ist ein hervorragender Weg, den Algorithmus zu verstehen, und ein schlechter, ein Planungssystem auszuliefern.
Wie modelliere ich Bestände zwischen Perioden?
+
Mit einem zeitexpandierten Netz. Legen Sie eine Kopie des gesamten Netzes für jede Periode an und fügen Sie von jedem Standort in Periode t eine Kante zu demselben Standort in Periode t plus eins hinzu. Der Fluss auf dieser Kante ist der übertragene Bestand, seine Kosten sind die Lagerkosten und seine Kapazität ist die Lagergrenze. Das Mehrperiodenproblem wird damit zu einem gewöhnlichen kostenminimalen Fluss auf einem Graphen, der T-mal größer ist, lösbar mit genau demselben Algorithmus. Dieselbe Konstruktion modelliert die Haltbarkeit, indem die Kante, die Bestand über das Verfallsdatum hinaustragen würde, einfach nicht gebaut wird.
17. Quellen
Die grundlegenden Arbeiten und die Standardwerke, in chronologischer Reihenfolge.
- Hitchcock, F. L. (1941). “The distribution of a product from several sources to numerous localities.” Journal of Mathematics and Physics, 20(1–4), 224–230.
- Koopmans, T. C. (1949). “Optimum utilization of the transportation system.” Econometrica, 17 (Supplement), 136–146.
- Dantzig, G. B. (1951). “Application of the simplex method to a transportation problem.” In T. C. Koopmans (ed.), Activity Analysis of Production and Allocation, 359–373. New York: Wiley.
- Ford, L. R. und Fulkerson, D. R. (1956). “Maximal flow through a network.” Canadian Journal of Mathematics, 8, 399–404.
- Forrester, J. W. (1958). “Industrial dynamics: a major breakthrough for decision makers.” Harvard Business Review, 36(4), 37–66.
- Dantzig, G. B. und Ramser, J. H. (1959). “The truck dispatching problem.” Management Science, 6(1), 80–91.
- Kelley, J. E. und Walker, M. R. (1959). “Critical-path planning and scheduling.” Proceedings of the Eastern Joint Computer Conference, 160–173.
- Ford, L. R. und Fulkerson, D. R. (1962). Flows in Networks. Princeton: Princeton University Press.
- Clarke, G. und Wright, J. W. (1964). “Scheduling of vehicles from a central depot to a number of delivery points.” Operations Research, 12(4), 568–581.
- Balinski, M. L. (1965). “Integer programming: methods, uses, computation.” Management Science, 12(3), 253–313.
- Geoffrion, A. M. und Graves, G. W. (1974). “Multicommodity distribution system design by Benders decomposition.” Management Science, 20(5), 822–844.
- Orlicky, J. (1975). Material Requirements Planning. New York: McGraw-Hill.
- Ahuja, R. K., Magnanti, T. L. und Orlin, J. B. (1993). Network Flows: Theory, Algorithms, and Applications. Englewood Cliffs: Prentice Hall.
- Lee, H. L., Padmanabhan, V. und Whang, S. (1997). “Information distortion in a supply chain: the bullwhip effect.” Management Science, 43(4), 546–558.
- Sheffi, Y. (2005). The Resilient Enterprise: Overcoming Vulnerability for Competitive Advantage. Cambridge, Massachusetts: MIT Press.
- Toth, P. and Vigo, D. (eds.) (2014). Vehicle Routing: Problems, Methods, and Applications, 2. Auflage. Philadelphia: SIAM.
- Simchi-Levi, D., Schmidt, W., Wei, Y., Zhang, P. Y., Combs, K., Ge, Y., Gusikhin, O., Sanders, M. und Zhang, D. (2015). “Identifying risks and mitigating disruptions in the automotive supply chain.” Interfaces, 45(5), 375–390.
- Chopra, S. und Meindl, P. (2015). Supply Chain Management: Strategy, Planning, and Operation, 6. Auflage. Boston: Pearson.