
目录
1. 为什么供应链是一个图
供应链就是一组地点,加上它们之间的一组移动。供应商发往工厂,工厂发往仓库,仓库发往门店,而关于每一种可能的移动,都有某件事为真或为假:它存在或不存在,每单位成本是多少,需要多少天,每周最多能承运多少。
这段描述本身就是一个图。地点是顶点,移动是有向弧,商业事实是挂在弧上的数字。到这里还没有简化掉任何东西,而模型一旦存在,一个世纪的算法立刻可用:最短路回答“这个到那个有多快”,最大流回答“我们实际能交付多少”,最小成本流回答“最省钱的方案是什么”,连通性回答“这里被烧毁会怎样”。
这不是为了教学而发明的比喻。供应链的数学就是网络优化。Hitchcock 于 1941 年提出运输问题,Koopmans 在 1947 年报告、1949 年发表的工作中独立得到它;Dantzig 于 1951 年用单纯形法求解;Ford 与 Fulkerson 于 1956 年发表最大流算法,并在 1962 年出版了 Flows in Networks 一书,他们的例子是铁路运力和运输计划,而不是抽象的图。把这一切形式化的学科是运筹学,而它的核心对象就是图。
本文要做的,是取一个四级宽的小网络,并在它上面回答每一个标准的供应链问题。下面引用的每个数字都是通过求解模型算出来的,而不是估计的:方案、瓶颈、故障后的缺口,以及每个替代方案的成本。如果你对底层术语还不熟悉,图论入门涵盖了本文默认你已知的定义。
2. 结构解剖:顶点、弧,以及它们上面的数字
建模就是决定保留什么。三个决定承担了大部分分量。
什么是顶点?通常是一个物理地点:一个供应商场地、一家工厂、一个配送中心、一个客户区域。有时更细,比如一条产线或一个装卸门;有时更粗,比如战略研究里的整个国家。规则是:凡是你可能想要开设、关闭、限制产能或失去的东西,就是一个顶点,因为模型要回答的正是这些问题。
什么是弧?一条线路:起点、终点,通常还有运输方式。同样两个设施之间既有公路又有航空,那就是两条弧,而不是一条,因为它们的成本、时间和容量都不同。弧是有向的,因为向东发货和向西发货不是一回事;这个区别及其后果在有向图与无向图中有讨论。
弧上放什么?至少三个数字,而且它们回答不同的问题,所以挂哪一个很重要:
- 容量,以每期的单位数计。它限制什么是可能的,是最大流的输入。
- 成本,按每发运单位计。它决定什么最便宜,是最小成本流的输入。
- 运输时间,以天计。它决定什么最快,是最短路的输入。
初学者常把这些合成一个“权重”,然后奇怪为什么答案看起来不对。它们确实是不同的目标,最便宜的路线往往不是最快的,第 4 节就在这个网络上展示了这一点。关于带权图与无权图的指南在抽象层面讲的是同一件事。
还有两个属性挂在顶点上而不是弧上:供应量在源点,需求量在汇点,有时还有一项固定成本,用于一个设施是否存在本身,而这正是第 7 节里把流问题变成选址问题的原因。
3. 贯穿全文的网络
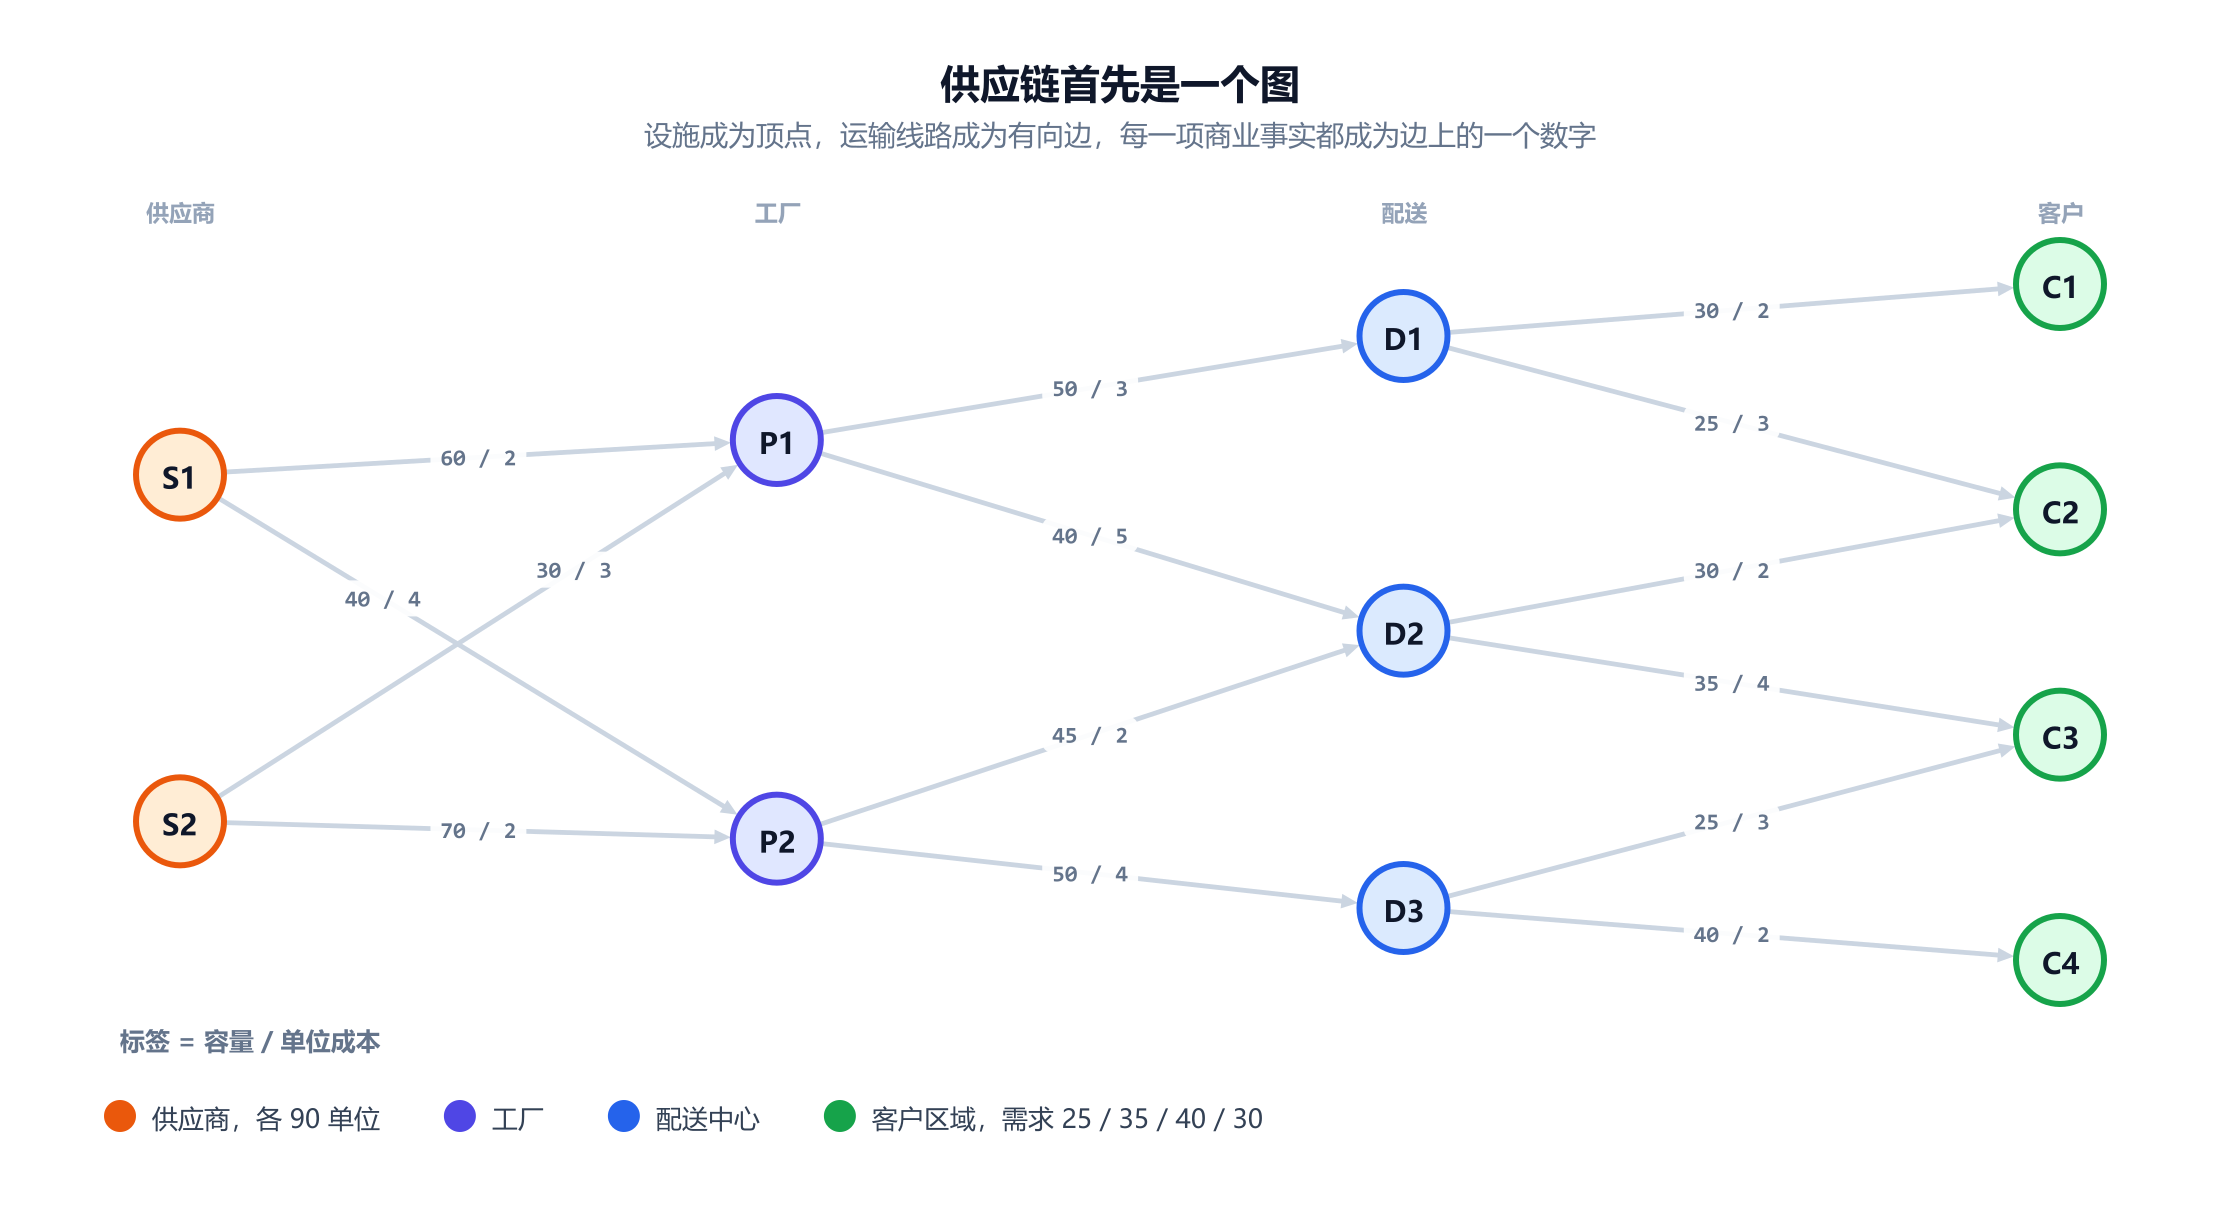
这个例子刻意做得足够小,可以手工核对,又足够丰富,能以有趣的方式出问题。两个供应商供给两家工厂,工厂供给三个配送中心,中心服务四个客户区域。
| 层级 | 节点 | 数字 |
|---|---|---|
| 供应商 | S1, S2 | 每家每周可供 90 单位 |
| 工厂 | P1, P2 | 把供应转化为成品 |
| 配送中心 | D1, D2, D3 | 容量分别为 55、75 和 65 单位 |
| 客户 | C1, C2, C3, C4 | 需求 25、35、40 和 30,合计 130 |
十四条线路各自带有容量、单位成本和运输时间,如上图所示。总供应量 180,对应需求 130,所以基准情形下是有余量的;第 5 节会把它拿掉。
在任何算法开始之前,有一个结构性细节很重要。这个网络是一个有向无环图:物料永远只从左向右流动,从供应走向需求。真实的供应链有退货、返工回路和仓库之间的调拨,它们都会产生环,而下面的算法照样有效。但无环的情形是直觉最清晰的情形,也是多数战术计划模型实际所处的位置。
第二个细节是,这是一个单产品、单周期这样的模型。这个假设承担了很多工作,第 12 节会展示解除它的标准图构造。
4. 交付周期:最短路
任何人向网络提出的第一个问题,都是它能多快响应。弧上带有运输时间时,这恰好就是最短路问题,而 Dijkstra 算法能一次性为所有目的地回答它,用时 O(m + n log n)。
从每个供应商出发求解,就得到服务全景:
| 从 | C1 | C2 | C3 | C4 |
|---|---|---|---|---|
| S1 | 6 天 S1-P1-D1-C1 | 7 天 S1-P1-D1-C2 | 9 天 S1-P2-D3-C3 | 8 天 S1-P2-D3-C4 |
| S2 | 7 天 S2-P1-D1-C1 | 6 天 S2-P2-D2-C2 | 6 天 S2-P2-D3-C3 | 5 天 S2-P2-D3-C4 |
这张表里有三件事是电子表格不会告诉你的。网络中最差的服务是 9 天,从 S1 到 C3,服务水平协议必须按这个数字来写。两个供应商并不可互换:S1 到 C1 更快,S2 到其他所有地方都更快,这支持按区域而不是按数量做双源采购。而且从 S1 到 C3 最快的路线经过 P2,而不是地理上显而易见的 P1,因为 P1 那条分支每一步都更慢。
现在再和成本比较。从 S1 出发最便宜的线路是 S1 → P1 这条线路每单位 2,而到 C3 最快的路线完全避开了它。最小化天数和最小化金钱,是在同一个图上的两种不同优化,任何只给出一个“最佳路线”的规划工具,都在悄悄替你选定其中之一。哪种算法适用于哪种变体,完整的决策树在最短路算法中。
还有两个实用的扩展值得了解。在每个设施加上固定的操作时间,做法是把延迟放在节点上,而第 12 节会把它变成一条弧。而当问题变成“在花费低于 X 的前提下,最快的路线是什么”,你面对的就是带约束的最短路问题,它一般是 NP 难的,通常用拉格朗日松弛或标号算法求解,而不是直接用 Dijkstra。
5. 容量:最大流与限制你的那个割
第二个问题是网络实际能搬运多少。加一个人工源点,按可用量供给两个供应商,再加一个人工汇点,抽走每个客户的需求,答案就是一次最大流计算。
在基准情形下,答案平平无奇:全部 130 单位都能通过。有意思的是起约束作用的限制在哪里。求解流问题同时会得到最小割,而这里的割恰好由客户弧本身组成。说白了:网络内部没有任何东西在限制任何东西,之所以没有更多单位流动,唯一的原因是没人下更多订单。这是健康的情形,在请谁批准资本支出之前,值得先确认这一点。
现在把每个需求都提高 40%,一个不算夸张的旺季。需求变成 182 单位,而网络只交付 164。
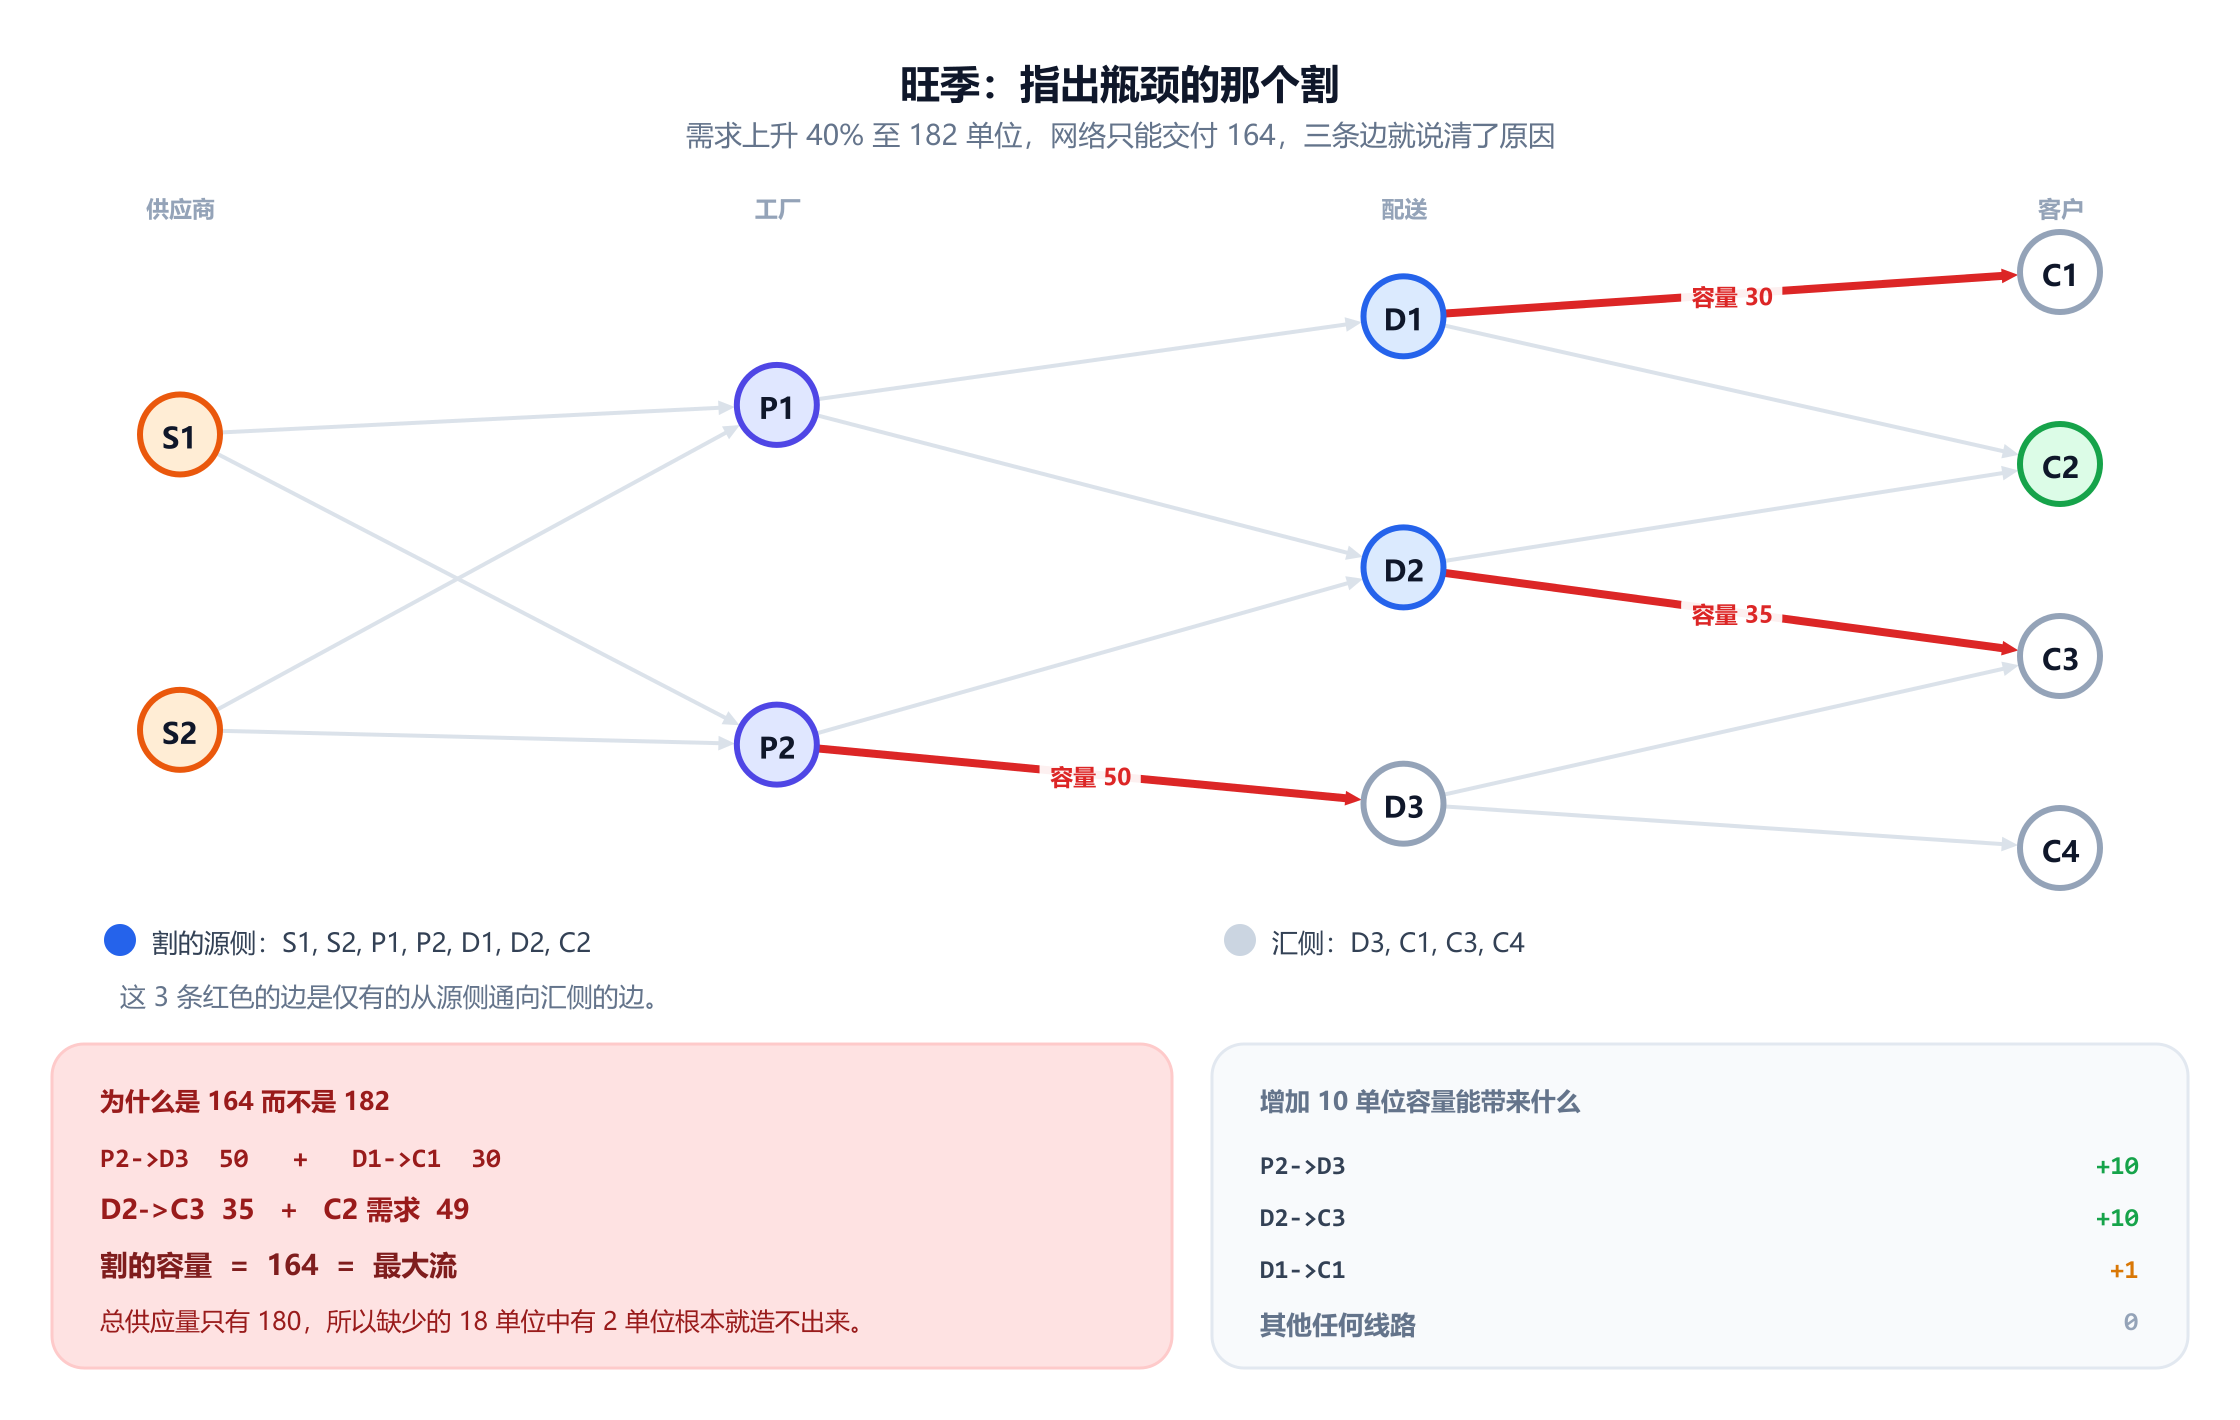
缺少的 18 单位可以精确分解。总供应量是 180,所以有 2 单位根本无法制造,与网络无关。剩下的 16 单位输给了结构,而最小割准确地点出了这个结构: P2 → D3 的容量为 50; D1 → C1 的容量为 30; D2 → C3 的容量为 35,再加上位于源侧的 C2 的 49 单位需求。它们合计 164,最大流最小割定理保证这等于最大流,算术也确认了这一点。
这是图论为供应链所做的最有用的一件事,所以值得直白地说出来。最小割就是投资清单。在其他任何地方增加容量都毫无改变。在这个网络上检验这一说法,得到的结果是任何直觉都想不出来的:
- 在
P2 → D3上多给 10 单位:通过量从 164 升到 174。 - 在
D2 → C3上多给 10 单位:同样是 174。 - 在
D1 → C1上多给 10 单位:通过量升到 165,再无更多。是一单位,不是十单位。 - 在其他十一条线路的任何一条上多给 10 单位:毫无变化。
其中 D1 → C1 这个例子最具启发性。它确实在最小割上,所以第一单位额外容量确有帮助,但此后另一个限制开始起作用,投资就不再有回报。割告诉你今天墙在哪里;它并不保证你把墙推开之后,墙还留在原地。实践中,这就是产能规划要作为一连串重新求解来做,而不是一次排名的原因。
6. 成本:运输问题与最小成本流
可行不等于方案。运营层面的问题是,众多可行方案中哪一个最便宜,而这就是最小成本流问题:满足每一处需求,遵守每一条容量,最小化所有弧上流量乘成本之和。
它的前身是运输问题,由 Hitchcock 于 1941 年提出、Koopmans 独立提出,并由 Dantzig 于 1951 年用专门的单纯形法高效求解。现代的一般形式由网络单纯形法或逐次最短路法求解,而 Ahuja、Magnanti 与 Orlin 的 Network Flows 至今仍是标准论述。
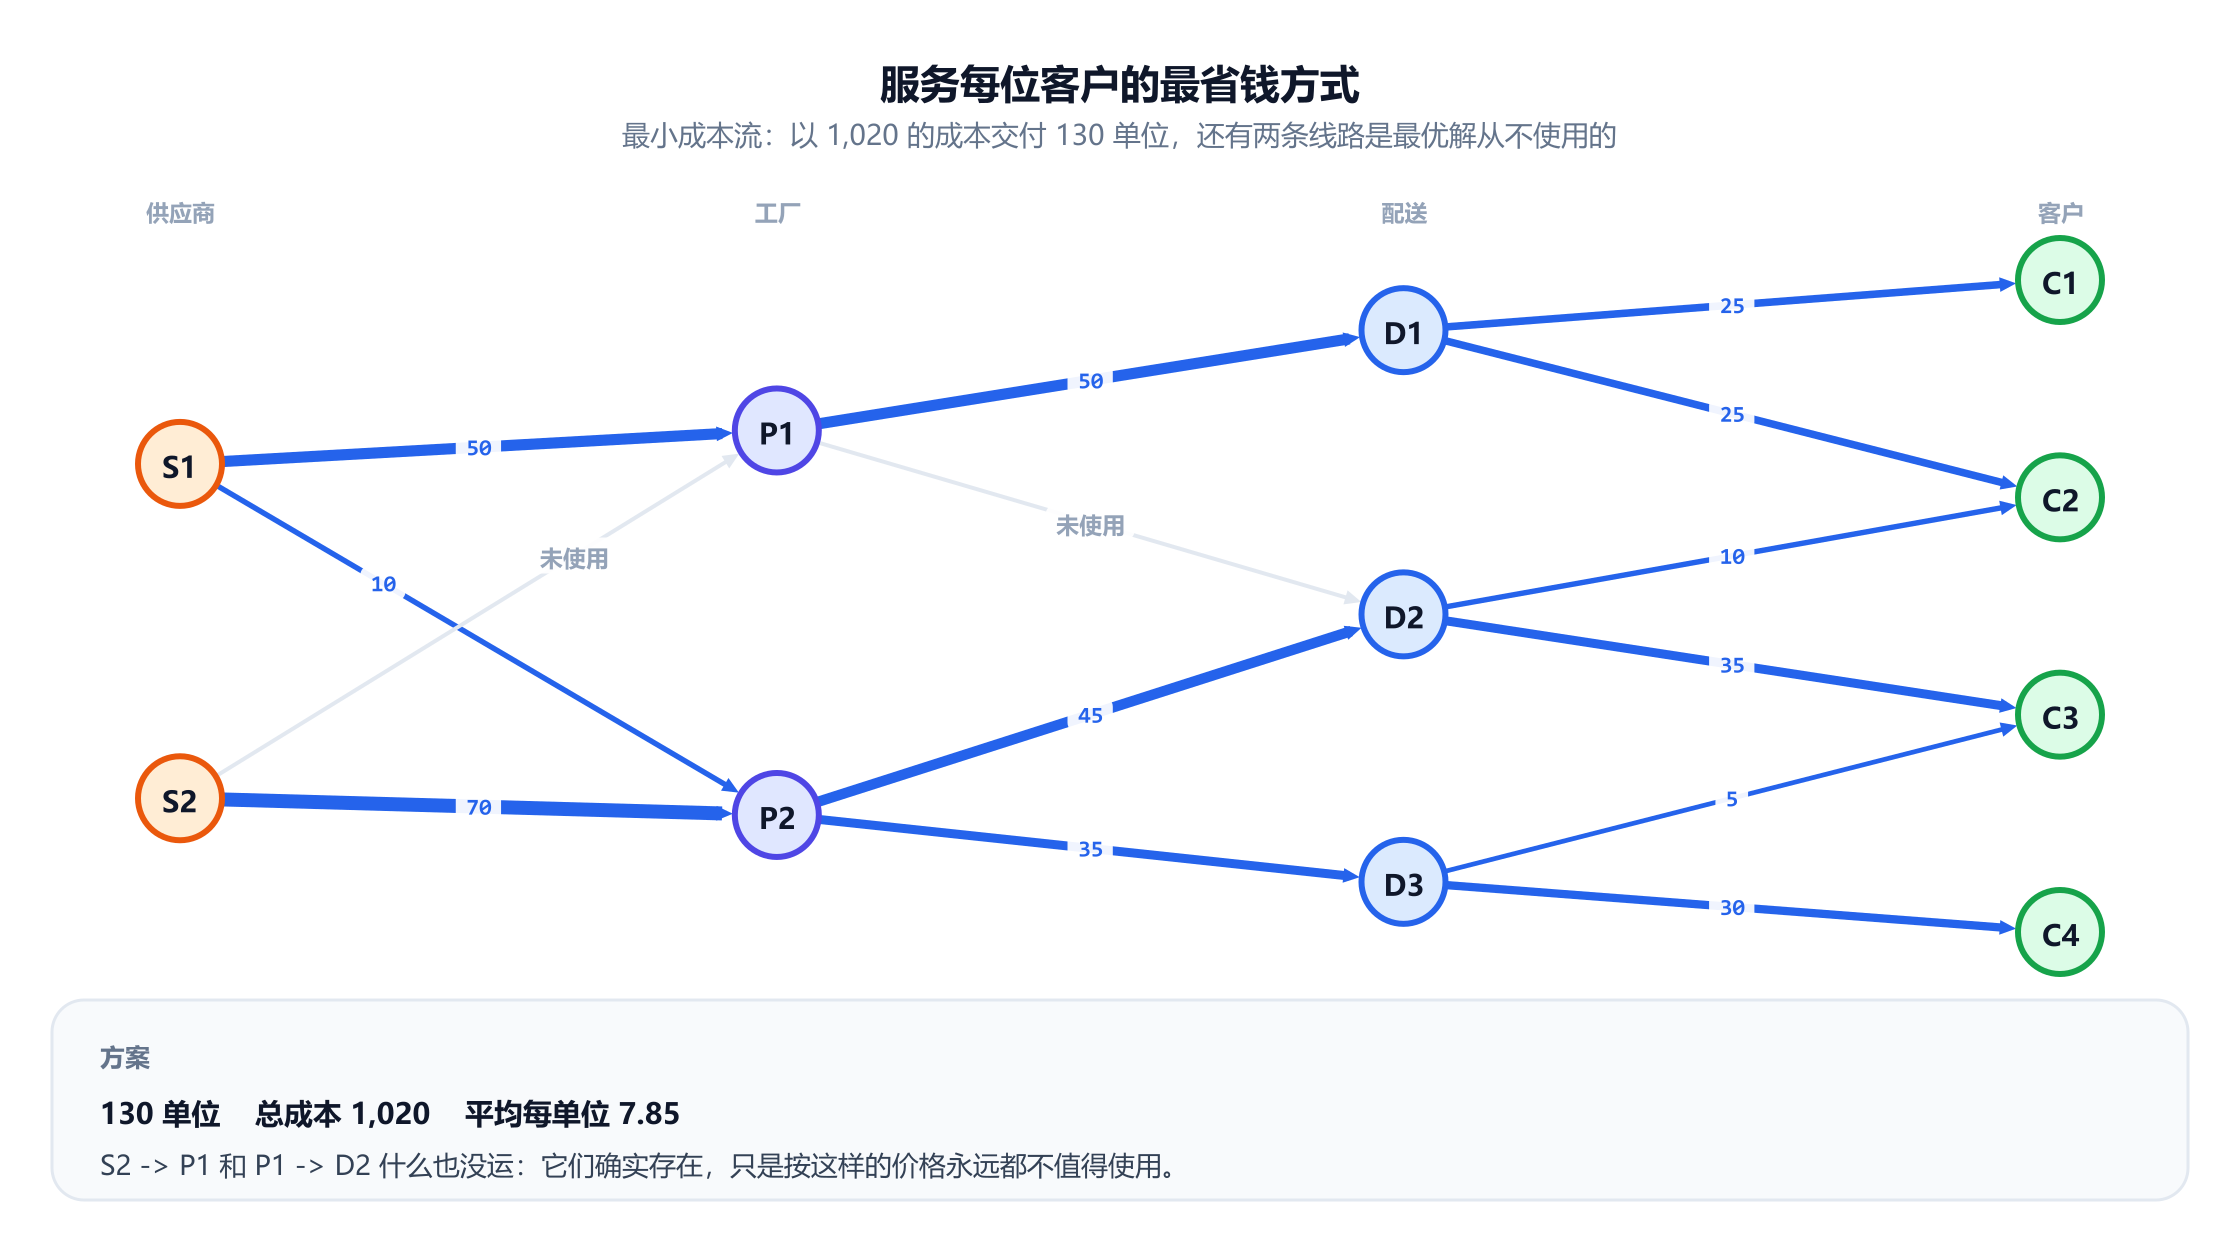
在这个贯穿全文的网络上求解,交付全部 130 单位最便宜的方式花费 1,020,平均每单位 7.85:
这个解有三个特征值得细读,因为正是它们出人意料。
两条线路什么也没运。 S2 → P1 和 P1 → D2 完全可用,只是按这样的价格永远不值得使用。网络图无法告诉你这一点,只有优化能。它也是“我们为什么要花钱维持那条线路”的答案,这个问题每年都值得问一次。
需求被拆分了。 C2 由 D1 供 25 单位、D2 供 10 单位,C3 由 D2 供 35、D3 供 5。让每个客户都由最近的中心供货是一条经验法则,而不是最优解,在这里它会更贵。真实模型常常加入禁止拆分的约束,而这条约束的代价应当被测量,而不是被假定。
答案正好是整数单位。这不是运气。网络流问题的约束矩阵是全幺模的,所以当供应量和需求量都是整数时,线性规划自动具有整数最优解。正因如此,流问题可以当作线性规划来解,得到的答案却直接可以发货;而一旦加入“开或不开”的二元决策,这一点立刻失效,那正是下一节的主题。
7. 到底该有哪些仓库?
到目前为止的一切都把网络当作给定的。战略问题是哪些设施应该存在,而它彻底改变了数学:开一个站点要付固定的一笔钱,无论它发一单位还是一千单位,而固定成本无法表示成弧上的单位成本。
给三个配送中心设定每周固定成本 250、300 和 200,容量 55、75 和 65 单位,以及服务每个客户区域的单位成本。于是问题变成开哪一个子集,而对每个候选子集来说,供货成本本身又是一个运输问题。三个站点共有七个子集,我们干脆把它们全部解一遍。
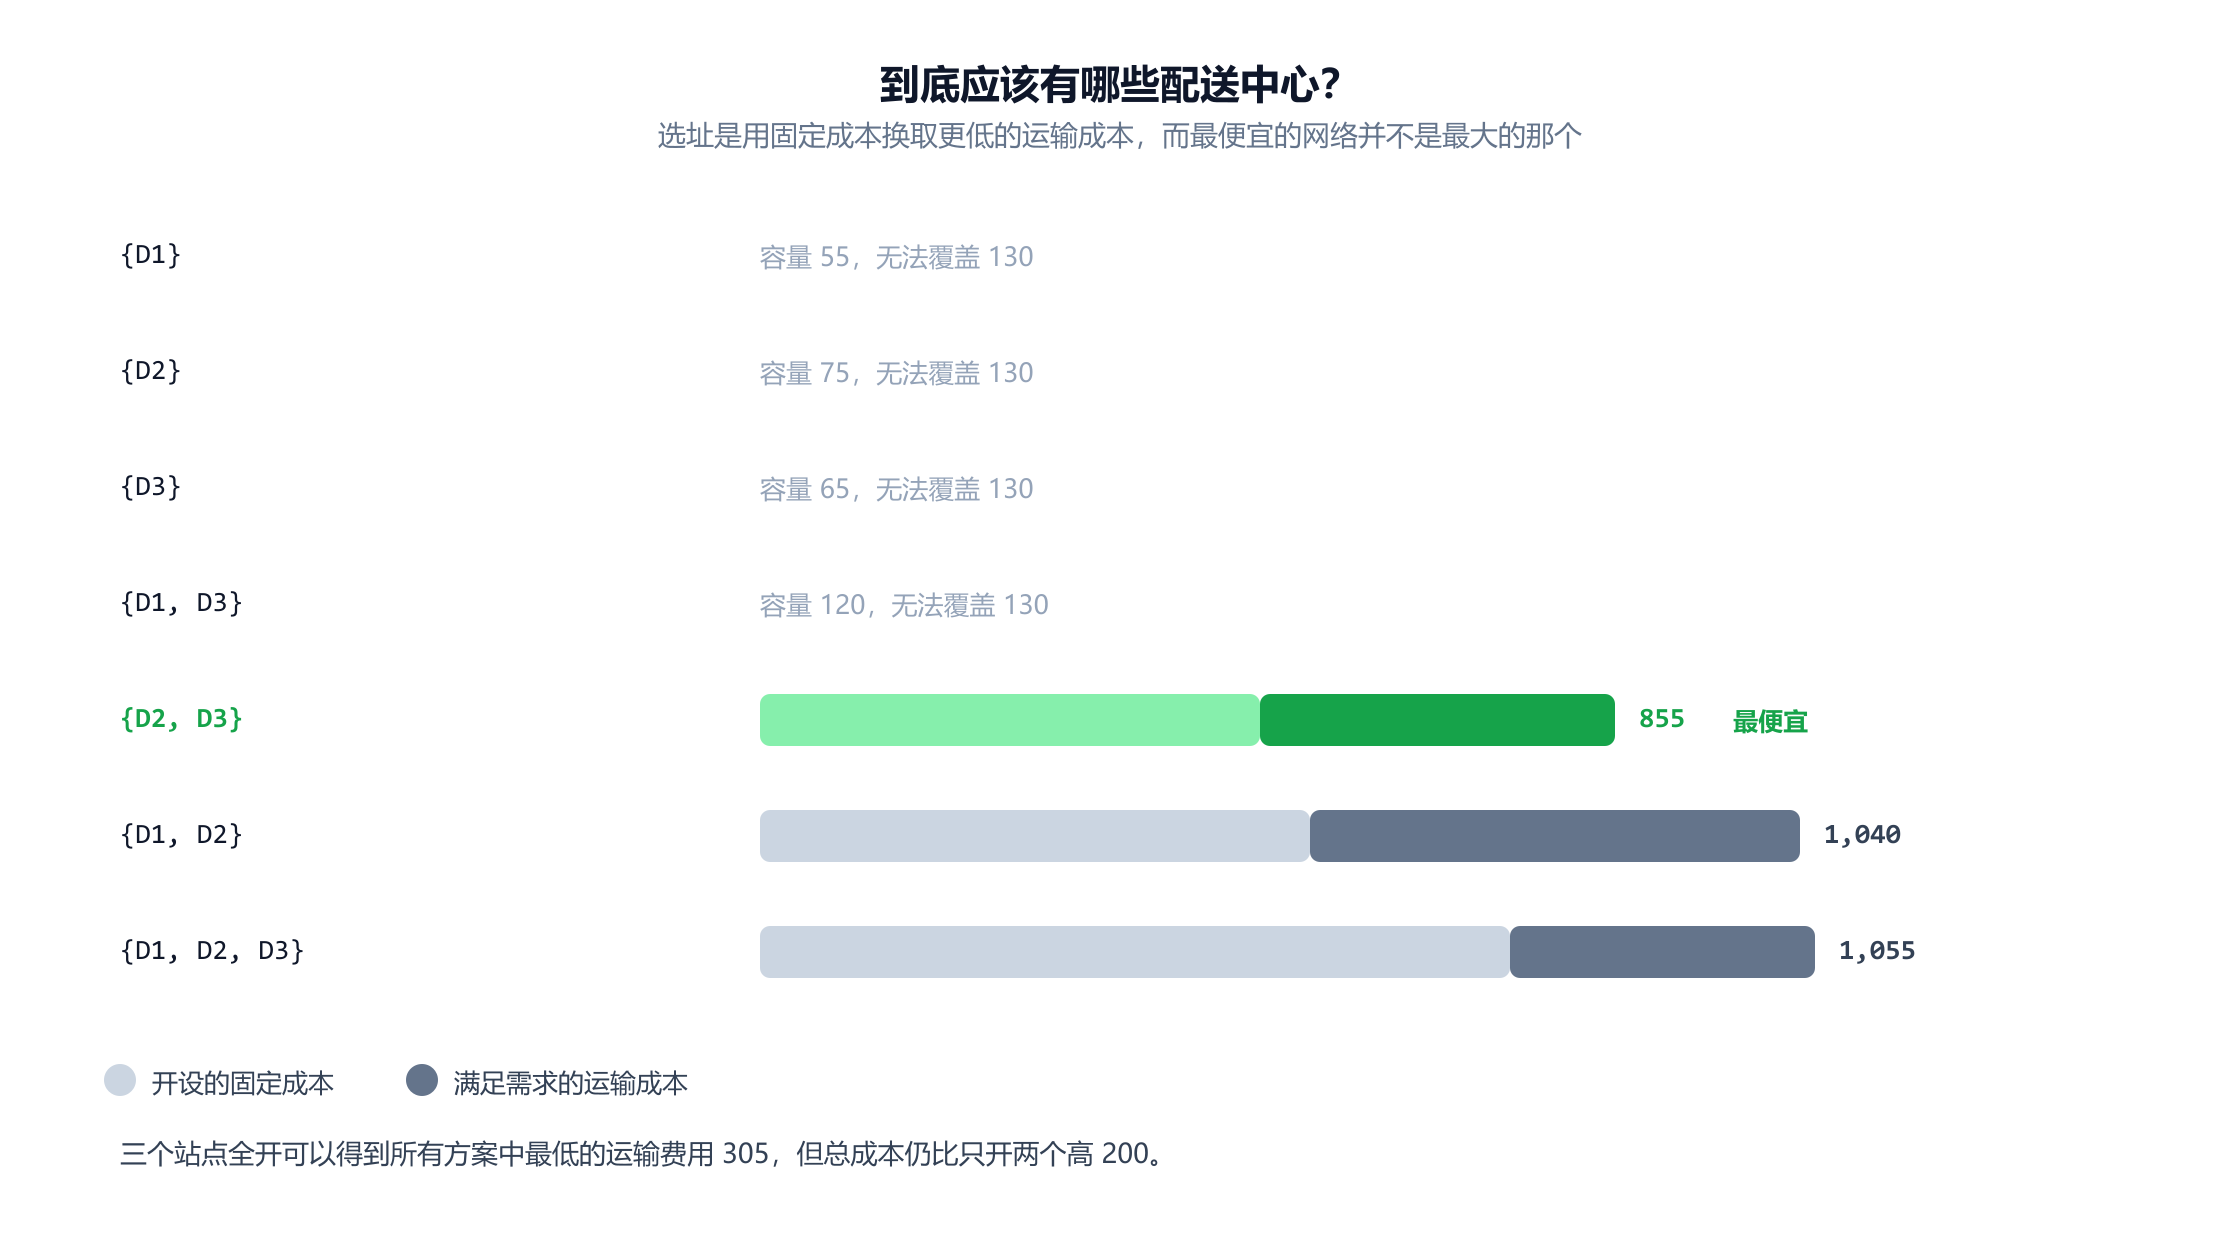
赢家是 {D2, D3},855:固定成本 500 加运输 355。从教学角度最要紧的是最后一行。三个中心全开会带来所有配置中最低的运输成本,即 305,因为那样每个客户都能由最便宜的来源供货。但总成本仍差 200,因为第三个站点 250 的固定成本只换来 50 的运输节省。在一个已经建得过大的网络里优化流量,是一种高效地犯错的好办法。
这就是带容量的设施选址问题,与第 4 到 6 节中的一切不同,它是 NP 难的。在三个候选站点上,对八个子集做穷举瞬间可得。三百个就不行了,学界用混合整数规划来解:Balinski 于 1965 年给出了标准模型,Geoffrion 与 Graves 于 1974 年用 Benders 分解求解了一个真实的多商品配送网络设计,现代求解器也能常规处理工业规模的实例。让它在实践中可解的结构,正是这里能看到的那一条:对任何固定的开设站点集合,剩下的问题都是一个可在多项式时间内求解的网络流。一个更完整的例子,包含公路距离、经典选址启发式方法以及服务承诺的代价,见设施选址:下一个仓库该建在哪里。
8. 设计物理网络:生成树
另一个设计问题不是“设施该建在哪里”,而是“该修哪些连接”。铺一条专线、包一班固定班车或修一段铁路专用线,每条连接都有成本,而要求是每个设施都能到达其他所有设施。
这就是最小生成树问题,由 Kruskal 算法求解,用时 O(m log n)。在六个设施上,两家工厂、三个中心和一个共用的越库枢纽,有十一条可选连接,价格在 3 到 10 之间,最便宜的连通设计花费 21 并使用五条连接:P2-H 为 3,P1-D1 为 4,D2-H 为 4,P2-D3 为 5,D1-H 为 5。
六个设施用五条连接并非巧合。一棵有 n 个顶点的树总是恰好有 n - 1 条边,而这正是整套方法的根本取舍:生成树是把一切连起来最便宜的方式,同时也是最脆弱的方式。这五条连接中的每一条都是桥,也就是说失去它网络就断开,而六个设施中有三个是割点。第 11 节会为此给出数字。
实践中的教训是,在多数供应链场景里,最小生成树是为错误目标选对的算法。你通常想要的,是能在失去任意一条连接后仍然连通的最便宜网络,也就是二边连通的网络设计,而那个问题是 NP 难的。最小生成树仍然值得计算,因为它是一个下界:没有任何连通设计能比它更便宜,所以它告诉你即将购买的冗余要花多少钱。
9. 最后一公里:车辆调度
以上一切都在设施之间搬运单位。最后一段把它们送到门口,配送成本中很大一部分正发生在这里,而数学也在这里变难。
给一辆车一组站点,要求最短的回路,恰好访问每个站点一次并返回车场,你得到的就是旅行商问题。给一支有容量的车队,问哪辆车服务哪些站点,你得到的就是车辆路径问题,由 Dantzig 与 Ramser 在 1959 年以“the truck dispatching problem”之名提出,此后不断推广到时间窗、混合车队、取送货和驾驶时长等情形。
与第 4 到 6 节的差别是性质上的,而不是程度上的。最短路、最大流和最小成本流都是多项式的:现代求解器处理一张洲际公路网只需不到一秒。TSP 和 VRP 是 NP 难的,经过 n 个站点的可能回路数是 (n-1)!/2,在仅仅 20 个站点时就超过 6 京。所以实践依靠启发式算法:Clarke 与 Wright 在 1964 年提出的节约算法至今仍是标准的构造方法,2-opt 和 Or-opt 这类局部搜索改进结果,而大邻域搜索等元启发式驱动着商用引擎。精确方法也有了巨大进步,如今数百个客户的实例已能被证明最优地求解,但每天的派车之所以用启发式,是因为必须在几分钟内给出答案。
值得带走的建模要点是:路径层位于流量层之上。流量模型决定 D3 向 C4 区域发运 30 单位;路径模型决定 C4 内部各个门点的顺序,以及由哪辆卡车来跑。把两者联合优化是可能的,集成计划系统正是这样尝试的,但两段式拆分是惯例,因为每一段难的原因不同。关于路径层从头到尾的完整推演以及车队成本的核算,见配送路线优化。
10. 工厂内部:物料与排程
把镜头拉近到一家工厂,图并不会消失。有两个图在管理这家工厂,而且都是有向无环图,都由一次拓扑顺序的扫描给出答案。
第一个是物料清单。一个产品由部件组成,每个部件又由部件组成,弧上带有数量。把一张客户订单展开成原材料需求,就是自上而下走这张图,一路相乘。这正是物料需求计划所做的事,由 Orlicky 在 1975 年形式化,至今仍是每套 ERP 系统的核心循环。
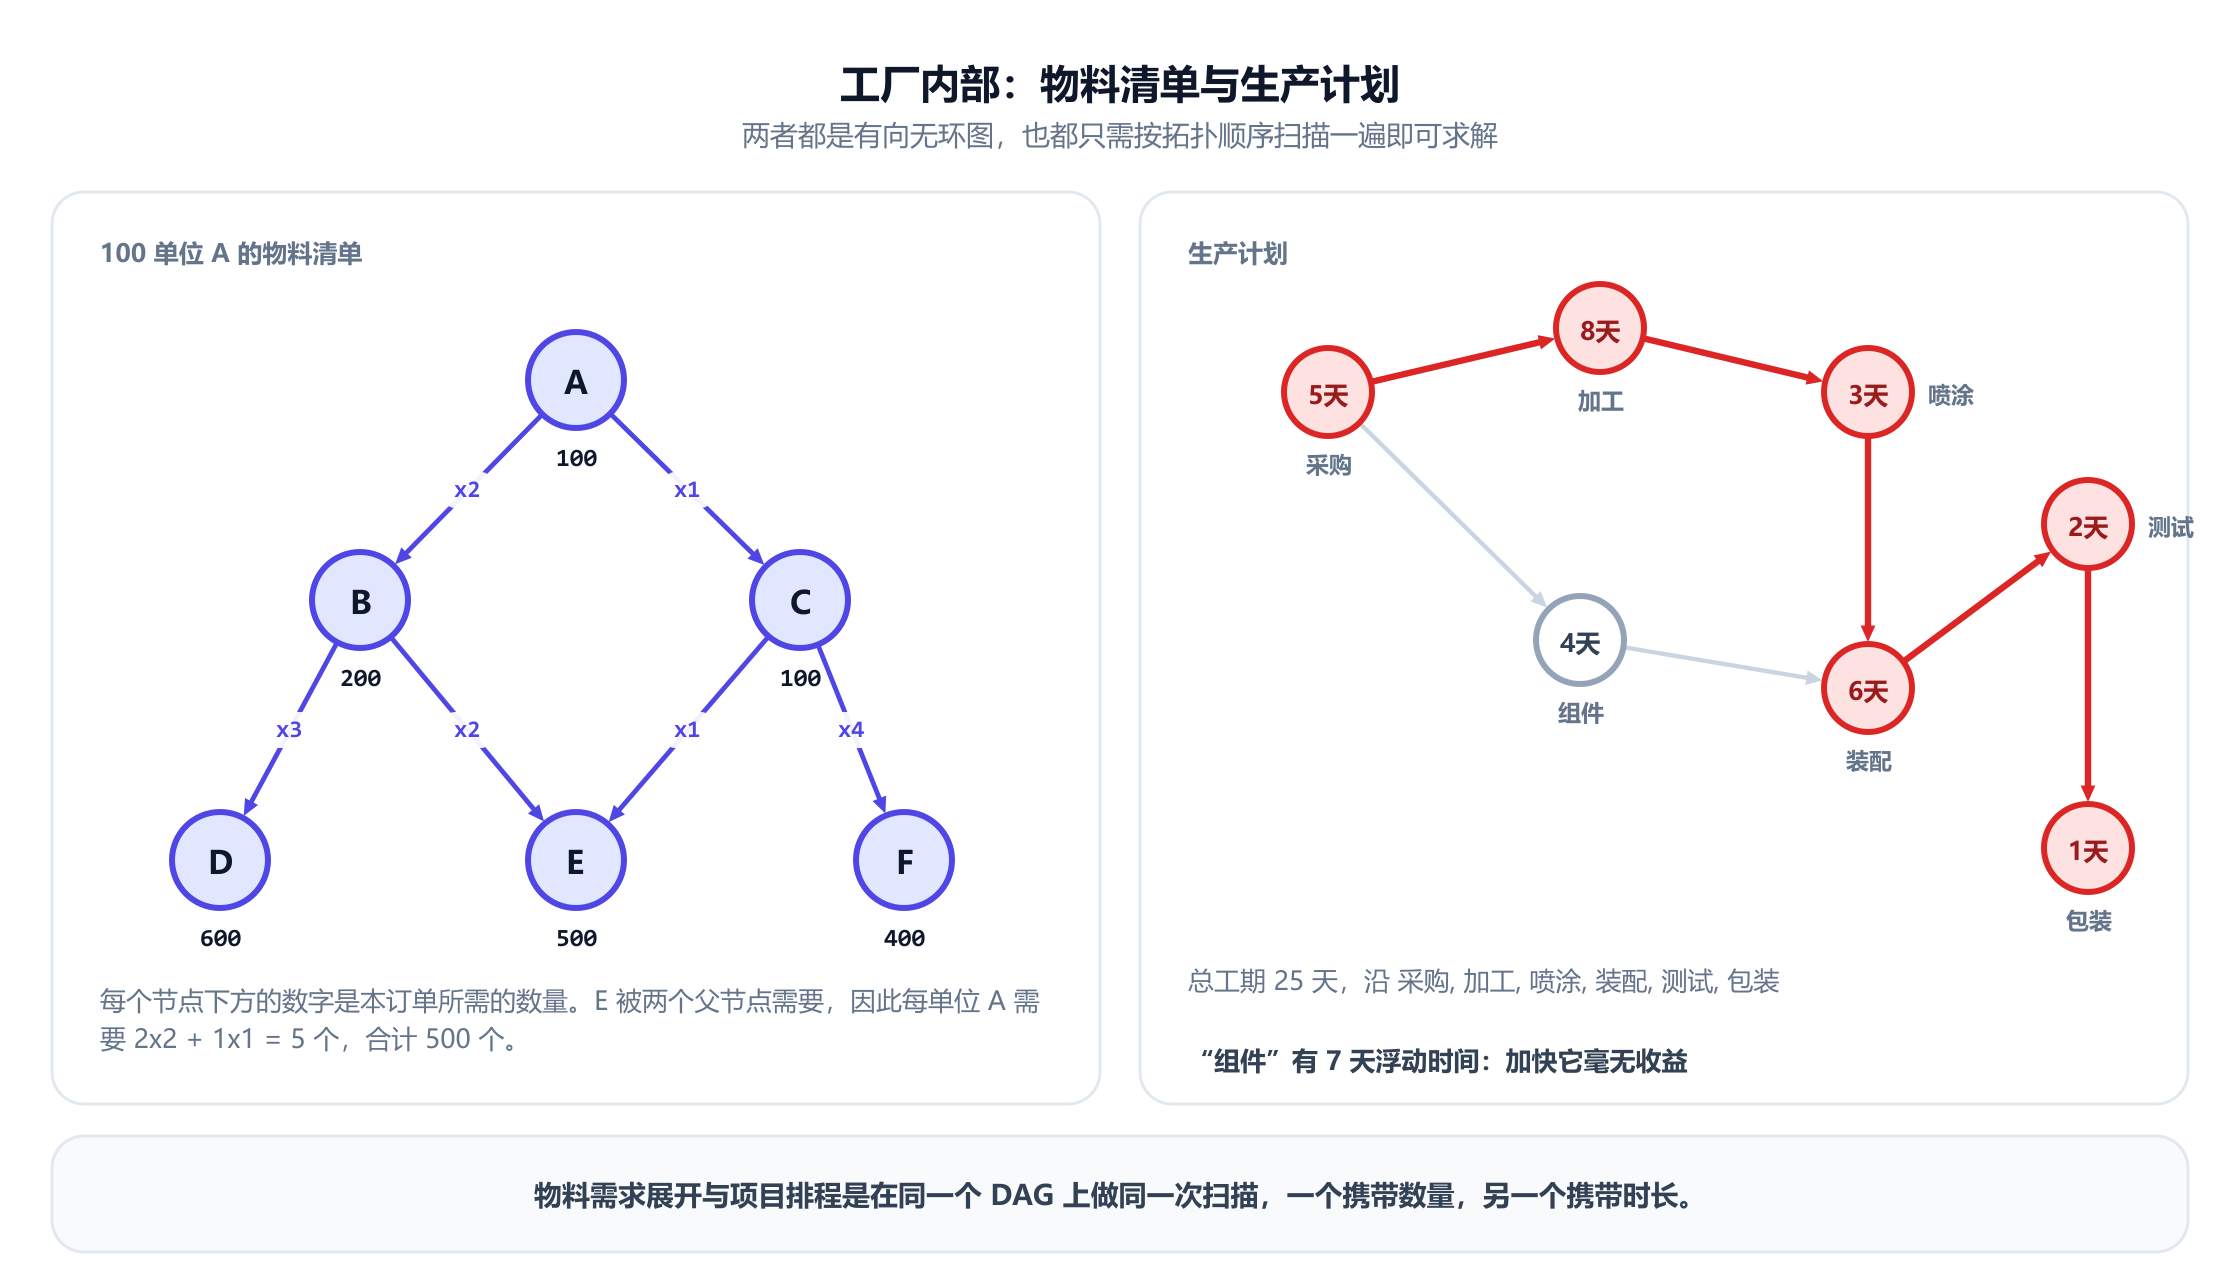
对于 100 单位产品 A 的订单,展开结果是 200 个 B、100 个 C、600 个 D、 500 个 E 和 400 个 F。部件 E 值得停下来看看:它出现在两个不同的父节点之下,所以它的需求是经由 B 的 2 × 2 加上经由 C 的 1 × 1 个,也就是每单位 A 需要 5 个。把各分支独立相加,正是幼稚的电子表格所做的事,会恰好在这些共用部件上算多或算少。按拓扑顺序处理各个物料,保证每个父节点在被读取子节点之前已经确定,这也是一次扫描就正确的原因。
第二个图是排程。任务有工期和先后约束,而项目长度就是所得 DAG 中的最长路径。在图中这份七项任务的计划里,总工期是 25 天,沿着采购、加工、喷涂、装配、测试和包装。这条链就是关键路径,来自 Kelley 与 Walker 1959 年的方法,它的实际含义很锋利:链上任何延误都会一比一地推迟订单,而组件有 7 天浮动时间,整整晚一周完成也不会让交付日期挪动一个小时。
请注意让这一点变得有价值的不对称性。最长路径在一般图上是 NP 难的,在 DAG 上却是线性的,所以排程之所以便宜,正是因为先后约束不可能形成环。若真形成了环,计划就是不可行的,而同一个算法也能检测出来。把客户订单在机器上逐台排序,考虑交期、换色和加班,完整推演见面向制造企业的生产排程。
11. 韧性:什么会断,断得多严重
成本模型告诉你一切正常时该怎么做。韧性模型告诉你不正常时会发生什么,而它是同一个图上的另一个问题:删掉一个顶点,重新求解流量,读出缺口。
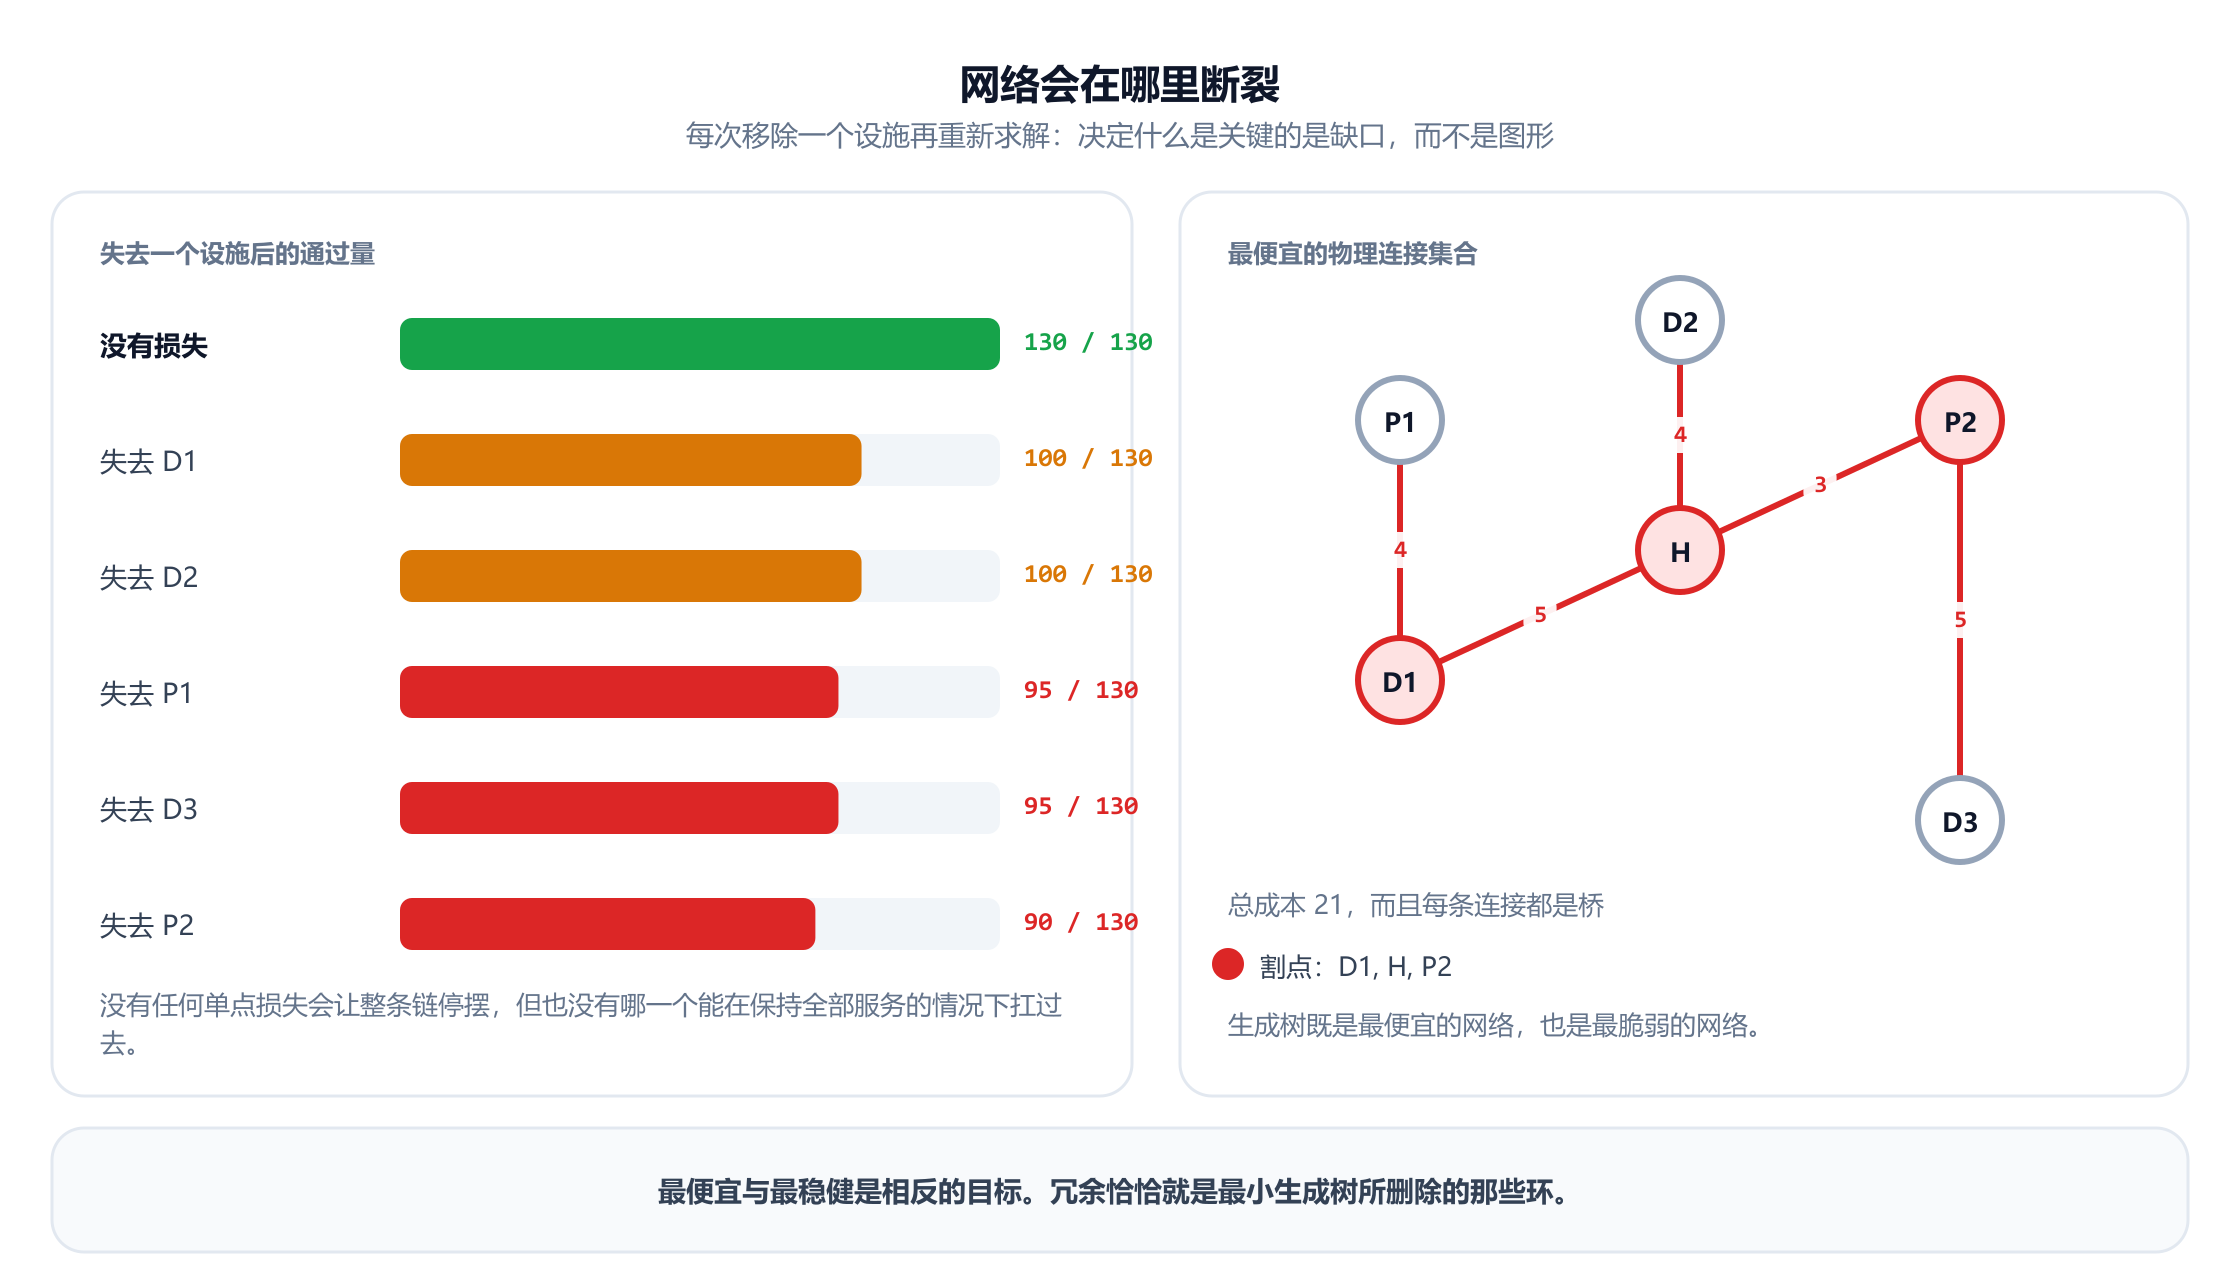
失去任何单个设施,网络仍能交付 130 单位中的 90 到 100 单位。最坏的情况是 P2,只剩 90 单位,缺口达 31%,这个结果最好与第 6 节对照着读。最省钱的方案把 70 单位经由 S2 → P2 运出,经过 P2 的总量是 80 单位,因为 P2 位于最便宜的那些线路上。成本优化会把流量集中,而集中的流量恰恰就是脆弱性的样子。最优解和风险,来自网络的同一个性质。
单条线路同样重要,而且重要程度并不相同。最糟的单条线路是 P2 → D3,失去它要损失 35 单位; P1 → D1 和 D3 → C4 各损失 30; D2 → C3 损失 20;而 S1 → P1, D1 → C2 或 D3 → C3 只损失 5。按线路运量来给风险缓解支出排序会弄错这个次序,因为运量是方案选择去运的东西,而不是网络会失去的东西。
第 8 节的结构视角用另一种语言说的是同一件事。在最小生成树中,每条连接都是桥,若干设施是割点,所以成本最优的物理网络在构造上就完全没有冗余。冗余就是生成树删掉的那些环。购买韧性,意味着刻意购买成本模型会拒绝的边。
这里有两条研究线索值得点名。Sheffi 的 The Resilient Enterprise 一书(2005 年)论证了灵活性是一种战略资产,而不是浪费。而 Simchi-Levi 及其同事与福特合作,提出风险应当用恢复时间及其带来的利润影响来衡量,而不是用中断的概率来衡量,因为后者无从得知:他们 2015 年的研究发现,风险敞口最大的零件常常是来自单一供应商的低价值部件,任何基于采购金额的分析都永远不会把它们标出来。这是一个图论问题,也正是本节所计算的问题。
12. 两个值得知道的建模技巧
有两种构造能把“模型表达不了那个”变成“模型完全能表达那个”,两者合起来覆盖了初学者最先遇到的大部分情况。
拆点,用来给设施加容量。流算法把容量放在弧上,但仓库本身也有处理上限。解决办法是把这个顶点替换成两个:一个接收所有入弧的“入”副本,一个发出所有出弧的“出”副本,以及两者之间承载该设施容量的一条弧。
之前:        --> [ D2 ] -->

之后:         --> [D2_in] --(容量 75,成本 = 操作费)--> [D2_out] -->
同样的技巧也能承载操作成本或固定的处理延迟,第 4 节的交付周期正是这样把花在建筑内部而不是路上的时间吸收进来。它使顶点数翻倍,其余什么都不改变,本文中的每个流算法之后都能原样运行。
时间展开,用来处理库存。单周期模型没有记忆:生产出来的东西必须立刻发运。真实的供应链会持有库存,而库存是穿越时间而不是空间的移动。为每个周期构建一份网络副本,并从周期 t 的每个设施,向周期 t+1的同一设施添加一条弧。这条弧上的流量就是库存,它的成本是持有成本,它的容量是仓储上限。该持有多少、放在哪里,本身又是一个优化问题,见我们关于库存优化与安全库存的指南。
这样得到的结果称为时间展开网络,而这正是多周期生产计划之所以可解的原因:一个看起来需要新理论的问题,结果不过是一个规模大 T 倍的图上的普通最小成本流。同样的构造也能处理保质期,只要不去构建那条会把库存带过有效期的弧即可。
这两个技巧共享一条值得内化的道理。当供应链的某个特性看起来需要新算法时,它通常需要的是一个新的图,而你已经拥有的算法随后就能原样适用。
13. 什么容易,什么困难
计划人员对自己模型能知道的最有价值的事,就是它落在可解性分界线的哪一侧,因为这决定了答案是一个最优解还是一次不错的猜测。
| 供应链问题 | 图论问题 | 代价 |
|---|---|---|
| 最快路线、服务承诺 | 最短路 | O(m + n log n) |
| 我们能全部交付吗?瓶颈在哪里? | 最大流、最小割 | 多项式 |
| 最省钱的发运方案 | 最小成本流 | 多项式 |
| 物料需求 | DAG 上的拓扑顺序 | O(n + m) |
| 项目工期、关键路径 | DAG 上的最长路径 | O(n + m) |
| 最便宜的连接集合 | 最小生成树 | O(m log n) |
| 开哪些设施 | 设施选址 | NP 难 |
| 车队的配送路线 | 车辆路径 | NP 难 |
| 能扛住任意单点故障的最便宜网络 | 二边连通设计 | NP 难 |
| 跨期的生产批量 | 含换产成本的批量计划 | 一般情况下 NP 难 |
这个规律很干净,值得说明白:关于流量的问题是容易的,关于该建造哪些离散对象的问题是困难的。一旦某个决定从“多少”变成“是或否”,全幺模性就失去了,线性规划不再自动给出整数答案,你就进入了混合整数规划。
困难不等于无望。含数百个候选站点的选址实例每天都能被证明最优地求解,而车辆路径的启发式方法在远超精确方法能力的实例上,也能落在已知最优解的百分之几以内。这条分界线改变的是承诺:在表格的上半部分你可以说“这是最优的”,在下半部分诚实的说法是“这是我们找到的最好结果,这里是它的界”。关于这些代价本身更完整的论述,见图算法与复杂度。
14. 从模型到实践
一个正确的模型与一个有用的模型之间的差距,主要不是数学。有四件事决定这项工作能否落地。
数据就是项目本身。线路成本、容量和运输时间散落在运输管理系统、合同和电子表格里,而且彼此矛盾。建立在十八个月前成本表上的模型,会给出一个自信、精确而错误的答案,然后失败会被归咎于优化。请把大部分精力预算在这里。
有意识地选择粒度。一项战略性网络研究可以把整个区域当作一个客户顶点;每周的派车模型不行。把需求聚合是合理的,把容量聚合通常不合理,因为平均值恰好掩盖了制造第 5 节那个瓶颈的高峰。
使用真正的求解器。对于流量问题,NetworkX 和 SciPy 都自带最小成本流,而 Google OR-Tools 以面向实践者的接口覆盖了流量、路径和排程。对于任何含二元决策的问题,Gurobi、CPLEX 这类商用求解器,或 HiGHS 和 CBC 这类开源求解器,才是合适的工具。自己写一个网络单纯形法,是很好的学习方式,却是很糟的交付方式。
对真正会变化的东西建模。确定性模型回答的是“如果下周正好是这样,什么最好”。需求从来不会正好是任何样子,而这里的经典失败模式并不是算法上的:Forrester 在 1958 年描述了订货政策如何把波动向上游放大,Lee、Padmanabhan 与 Whang 在 1997 年把它命名为牛鞭效应。再怎么优化单独一周的流量也无法解决它。常规的应对是情景分析、随机优化或鲁棒优化,以及随着现实到来不断重算的滚动周期。
最后一个习惯,也是本文中的数字想要示范的:重新求解,而不是凭推理下结论。说某条线路是关键的、某个站点值回它的固定成本、某笔产能投资能回本,这些说法模型在几毫秒内就能定夺,而人对网络的直觉恰恰在最要紧的那些情形下不可靠。第 5 节就找到了一条线路,在它上面多给十单位容量只换来一单位通过量。这没人猜得到。
15. 会给出自信却错误答案的建模错误
网络模型很少大声失败。它给出一个方案,方案看起来合理,而错误只有知道该看哪里的人才能发现。以下是反复出现的那些。
- 把设施的容量放到它的某一条弧上。一个每周能处理 75 单位的仓库,和一条能承运 75 单位的线路不是一回事,把这个限制硬塞到看起来最繁忙的那条弧上,会悄悄允许比现实更多或更少的通过量。请像第 12 节那样拆点。
- 用一个数字当作弧的权重。成本、时间和容量回答不同的问题,只携带其中之一的模型,会在你要最快方案时自信地返回最便宜的方案。在这个网络上,这两个答案确实不同。
- 用单周期模型回答多周期问题。没有库存弧,生产出来的一切都必须立刻发运,于是模型要么把可行的方案判为不可行,要么凭空造出并不存在的产能。请改用时间展开的网络。
- 把容量和需求一起聚合。把四周的需求平均成一周往往说得过去;把容量平均则不行,因为平均值恰好掩盖了制造瓶颈的那个高峰。第 5 节里 40% 的高峰,在按月平均之后会完全消失。
- 在没有服务约束的情况下优化成本。纯粹的成本目标会心安理得地把一切都走最慢的便宜线路。交付周期必须以约束或惩罚项的形式进入模型,否则得到的最优解没人能执行。
- 按运量给风险排序。最繁忙的线路是方案选出来的,而这与失去后最痛的那条并不是一回事。请去掉每个候选对象重新求解,按缺口排序,这正是第 11 节所做的,也正是它给出不同次序的原因。
- 把整车运费按单位成本计价。运费常常是阶梯函数:半空卡车上的第二个托盘几乎免费,新开一辆卡车上的第一个托盘则不然。线性的单位成本会把这一点抹平,并系统性地低估拼车整合。阶梯成本需要二元变量,这会把模型推入混合整数规划。
- 忘了弧的清单本身就是一个建模选择。优化器只能选择数据中存在的线路。没有人录入的线路,就是永远不会出现在答案里的线路,而“模型说我们不该走那条路线”往往只是“没人告诉模型这条路线存在”。
共同点在于,这八种错误都会产出看似合理的结果。防御办法是拿一段你已经经历过的时期来检验模型:如果它不能在合理误差内复现上个季度的实际流量,它就还没准备好为下个季度提建议。
16. 常见问题
图论在供应链管理中是如何应用的?
+
设施成为顶点,运输线路成为有向弧,于是标准问题就变成了标准算法:最短路用于交付周期和服务水平,最大流用于通过量和瓶颈,最小成本流用于最省钱的发运方案,最小生成树用于网络设计,拓扑顺序用于物料清单和生产计划,而设施选址和车辆路径用于战略决策和最后一公里决策。网络优化不是供应链计划的类比,它就是这个领域赖以建立的数学。
最大流和最小成本流有什么区别?
+
最大流问的是物理上最多能通过多少,完全不管钱;它回答“我们能不能满足高峰需求,如果不能,墙在哪里”。最小成本流问的是把规定数量运出去最便宜的方式,完全不管没有定价的东西;它回答“既然我们能满足需求,那么每条线路上到底该发多少”。实践中先跑最大流来检查可行性并找到瓶颈,再跑最小成本流来生成方案。
为什么最小割在实践中这么有用?
+
因为它把一句含糊的话变成一张清单。最大流最小割定理说,最大通过量等于把供应与需求分开所需移除的最小弧集合的容量,所以割是对“哪些线路才是约束”的精确回答。在其他任何地方增加容量都换不来什么。在本文的网络上,在两条点名线路中的任何一条上增加十单位能换来十单位通过量,在第三条上只换来一单位,在其余十一条上恰好换来零。
最便宜的网络也是最好的网络吗?
+
几乎从来不是,而图论把原因解释得很干脆。把一组设施连接起来最便宜的方式是生成树,而生成树没有环,也就意味着没有替代路线:每条连接都是桥,失去它网络就断开。冗余正是一个以最小化成本为目标的设计所删除的那组环。同样的效应也出现在流量方案中:把运量集中到最便宜的线路上,正是使单点故障代价高昂的原因。成本与韧性是彼此竞争的目标,应该互相定价,而不是假定它们彼此相容。
供应链中哪些问题是 NP 难的?
+
那些决定哪些离散对象存在的问题。设施选址、车辆路径、含换产成本的批量计划,以及设计一个能扛住任意单点故障的网络,都是 NP 难的。关于在固定网络中流动的一切则都是多项式的:最短路、最大流、最小成本流、生成树、拓扑排序和关键路径。分界线出现在决定从“多少”变成“是或否”的那一刻,因为正是那时线性规划松弛不再自动返回整数答案。
有哪些软件可以求解这些模型?
+
对于纯网络流,NetworkX 和 SciPy 都提供最小成本流求解器,而 Google OR-Tools 以面向实践者的接口覆盖流量、路径和排程。对于任何含二元决策的问题,例如开设设施或分配卡车,请使用混合整数规划求解器:商用有 Gurobi 和 CPLEX,开源有 HiGHS 和 CBC,通常通过 Pyomo、PuLP 或 JuMP 这类建模层来使用。自己写网络单纯形法是理解算法的极好方式,却是交付计划系统的糟糕方式。
跨周期持有的库存该怎么建模?
+
用时间展开的网络。为每个周期复制一份完整网络,并从周期 t 的每个设施向周期 t 加一的同一设施添加一条弧。这条弧上的流量就是结转的库存,它的成本是持有成本,它的容量是仓储上限。多周期问题于是变成一张大 T 倍的图上的普通最小成本流,用完全相同的算法即可求解。同样的构造也能给保质期建模,只要不构建那条会把库存带过有效期的弧即可。
17. 参考文献
奠基性论文与标准著作,按时间顺序排列。
- Hitchcock, F. L. (1941). “The distribution of a product from several sources to numerous localities.” Journal of Mathematics and Physics, 20(1–4), 224–230.
- Koopmans, T. C. (1949). “Optimum utilization of the transportation system.” Econometrica, 17 (Supplement), 136–146.
- Dantzig, G. B. (1951). “Application of the simplex method to a transportation problem.” In T. C. Koopmans (ed.), Activity Analysis of Production and Allocation, 359–373. New York: Wiley.
- Ford, L. R. and Fulkerson, D. R. (1956). “Maximal flow through a network.” Canadian Journal of Mathematics, 8, 399–404.
- Forrester, J. W. (1958). “Industrial dynamics: a major breakthrough for decision makers.” Harvard Business Review, 36(4), 37–66.
- Dantzig, G. B. and Ramser, J. H. (1959). “The truck dispatching problem.” Management Science, 6(1), 80–91.
- Kelley, J. E. and Walker, M. R. (1959). “Critical-path planning and scheduling.” Proceedings of the Eastern Joint Computer Conference, 160–173.
- Ford, L. R. and Fulkerson, D. R. (1962). Flows in Networks. Princeton: Princeton University Press.
- Clarke, G. and Wright, J. W. (1964). “Scheduling of vehicles from a central depot to a number of delivery points.” Operations Research, 12(4), 568–581.
- Balinski, M. L. (1965). “Integer programming: methods, uses, computation.” Management Science, 12(3), 253–313.
- Geoffrion, A. M. and Graves, G. W. (1974). “Multicommodity distribution system design by Benders decomposition.” Management Science, 20(5), 822–844.
- Orlicky, J. (1975). Material Requirements Planning. New York: McGraw-Hill.
- Ahuja, R. K., Magnanti, T. L. and Orlin, J. B. (1993). Network Flows: Theory, Algorithms, and Applications. Englewood Cliffs: Prentice Hall.
- Lee, H. L., Padmanabhan, V. and Whang, S. (1997). “Information distortion in a supply chain: the bullwhip effect.” Management Science, 43(4), 546–558.
- Sheffi, Y. (2005). The Resilient Enterprise: Overcoming Vulnerability for Competitive Advantage. Cambridge, Massachusetts: MIT Press.
- Toth, P. and Vigo, D. (eds.) (2014). Vehicle Routing: Problems, Methods, and Applications, 第 2 版. Philadelphia: SIAM.
- Simchi-Levi, D., Schmidt, W., Wei, Y., Zhang, P. Y., Combs, K., Ge, Y., Gusikhin, O., Sanders, M. and Zhang, D. (2015). “Identifying risks and mitigating disruptions in the automotive supply chain.” Interfaces, 45(5), 375–390.
- Chopra, S. and Meindl, P. (2015). Supply Chain Management: Strategy, Planning, and Operation, 第 6 版. Boston: Pearson.