
Tabla de Contenidos
- 1. Por qué una cadena de suministro es un grafo
- 2. La anatomía: vértices, aristas y los números que llevan
- 3. La red que usamos en todo el artículo
- 4. Plazo de entrega: caminos mínimos
- 5. Capacidad: flujo máximo y el corte que te limita
- 6. Coste: el problema de transporte y el flujo de coste mínimo
- 7. ¿Qué almacenes deberían existir?
- 8. Diseñar la red física: árboles de expansión
- 9. La última milla: rutas de vehículos
- 10. Dentro de la fábrica: materiales y calendarios
- 11. Resiliencia: qué se rompe y con qué gravedad
- 12. Dos trucos de modelado que conviene conocer
- 13. Qué es fácil y qué es difícil
- 14. Del modelo a la práctica
- 15. Errores de modelado que producen respuestas seguras y equivocadas
- 16. Preguntas frecuentes
- 17. Referencias
1. Por qué una cadena de suministro es un grafo
Una cadena de suministro es un conjunto de lugares y un conjunto de movimientos entre ellos. Los proveedores envían a las plantas, las plantas a los almacenes, los almacenes a las tiendas, y de cada movimiento posible hay algo que es verdadero o falso: existe o no existe, cuesta tanto por unidad, tarda tantos días, puede transportar como mucho tanto por semana.
Esa descripción ya es un grafo. Los lugares son vértices, los movimientos son aristas dirigidas, y los datos comerciales son números pegados a las aristas. Todavía no se ha simplificado nada, y en cuanto el modelo existe, un siglo de algoritmos queda disponible: el camino mínimo responde «con qué rapidez llega esto a aquello», el flujo máximo responde «cuánto podemos entregar realmente», el flujo de coste mínimo responde «cuál es el plan más barato», y la conectividad responde «qué pasa si esto se quema».
No es una metáfora inventada para enseñar. Las matemáticas de las cadenas de suministro son optimización de redes. Hitchcock planteó el problema de transporte en 1941 y Koopmans llegó a él de forma independiente en un trabajo presentado en 1947 y publicado en 1949; Dantzig lo resolvió con el método símplex en 1951; Ford y Fulkerson publicaron el algoritmo de flujo máximo en 1956 y el libro Flows in Networks en 1962, y sus ejemplos eran capacidad ferroviaria y planificación de envíos, no grafos abstractos. El campo que lo formalizó todo es la investigación operativa, y sus objetos centrales son grafos.
Lo que hace este artículo es tomar una red pequeña, de cuatro escalones, y responder sobre ella todas las preguntas habituales de una cadena de suministro. Cada número citado abajo se calculó resolviendo el modelo, no estimando: los planes, los cuellos de botella, los déficits tras un fallo y el coste de cada alternativa. Si el vocabulario de base te resulta nuevo, la introducción a la teoría de grafos cubre las definiciones que este artículo da por sabidas.
2. La anatomía: vértices, aristas y los números que llevan
Modelar es decidir qué se conserva. Tres decisiones cargan con casi todo el peso.
¿Qué es un vértice? Normalmente una ubicación física: una planta de un proveedor, una fábrica, un centro de distribución, una región de clientes. A veces es más fino, como una línea de producción o un muelle de carga, y a veces más grueso, como todo un país en un estudio estratégico. La regla es que un vértice es cualquier cosa que puedas querer abrir, cerrar, limitar o perder, porque esas son las preguntas que se le harán al modelo.
¿Qué es una arista? Una ruta: un origen, un destino y normalmente un modo. Las mismas dos instalaciones conectadas por carretera y por aire son dos aristas, no una, porque tienen costes, tiempos y capacidades distintos. Las aristas son dirigidas, ya que enviar al este no es lo mismo que enviar al oeste; la distinción y sus consecuencias se tratan en grafos dirigidos frente a no dirigidos.
¿Qué va en la arista? Al menos tres números, y responden a preguntas distintas, así que importa cuál le pones:
- Capacidad, en unidades por periodo. Limita lo que es posible y es la entrada del flujo máximo.
- Coste, por unidad enviada. Decide qué es lo más barato y es la entrada del flujo de coste mínimo.
- Tiempo de tránsito, en días. Decide qué es rápido y es la entrada del camino mínimo.
Los principiantes suelen juntarlos en un solo «peso» y luego se preguntan por qué la respuesta parece rara. Son objetivos genuinamente distintos, y la ruta más barata a menudo no es la más rápida, como muestra la sección 4 sobre esta misma red. La guía de grafos ponderados frente a no ponderados hace el mismo comentario en abstracto.
Otros dos atributos viven en los vértices y no en las aristas: la oferta en las fuentes, la demanda en los sumideros, y a veces un coste fijo por que una instalación exista siquiera, que es lo que convierte un problema de flujo en un problema de localización en la sección 7.
3. La red que usamos en todo el artículo
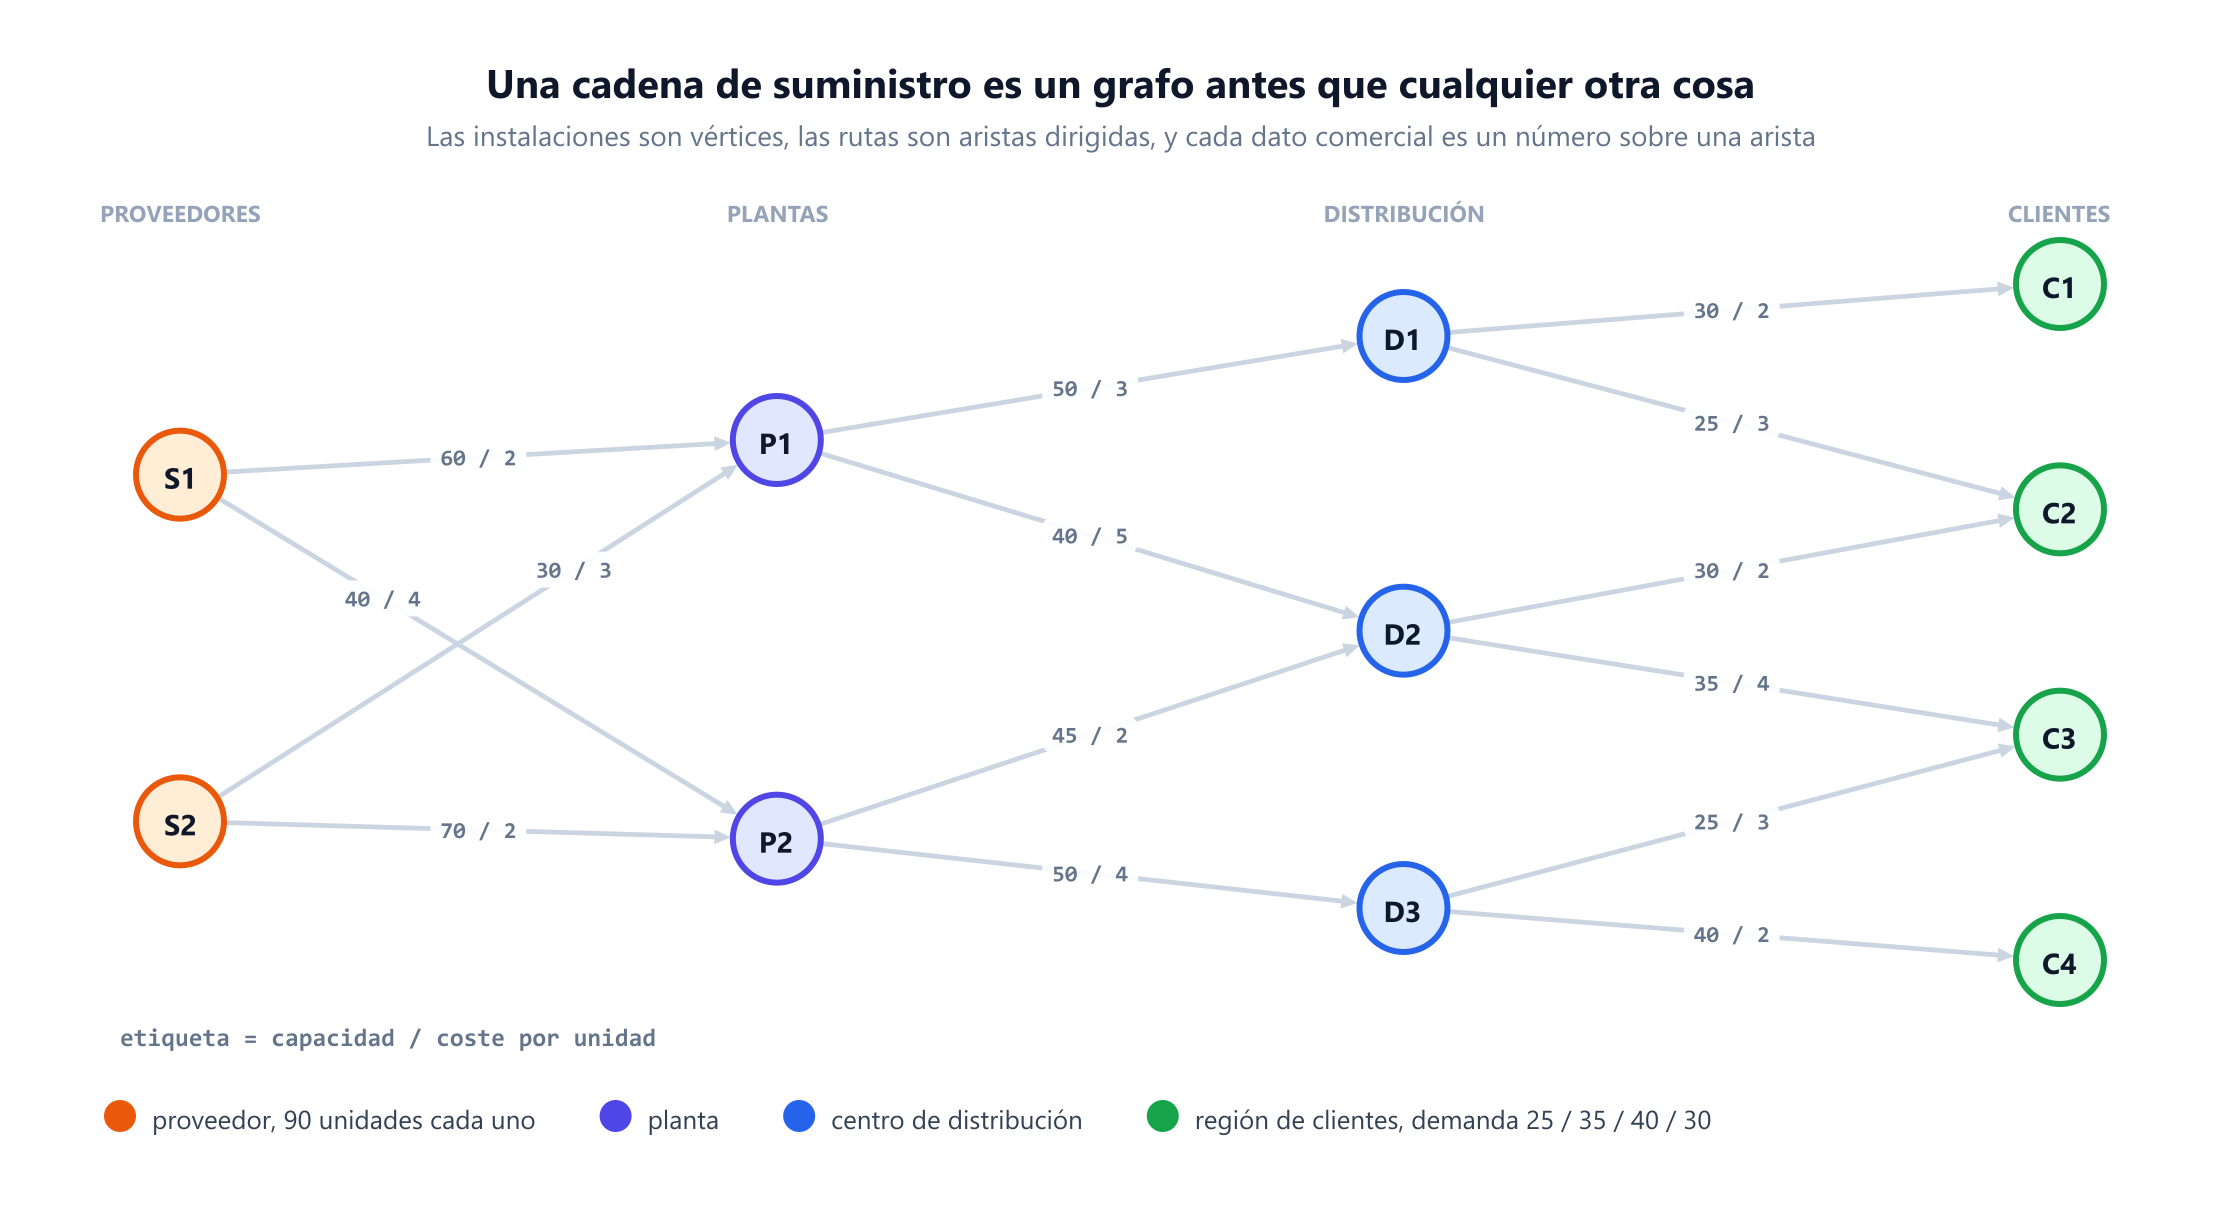
El ejemplo es deliberadamente lo bastante pequeño para comprobarlo a mano y lo bastante rico para romperse de formas interesantes. Dos proveedores alimentan dos plantas, las plantas alimentan tres centros de distribución, y los centros sirven a cuatro regiones de clientes.
| Escalón | Nodos | Números |
|---|---|---|
| Proveedores | S1, S2 | 90 unidades por semana disponibles en cada uno |
| Plantas | P1, P2 | Convierten el suministro en producto terminado |
| Centros de distribución | D1, D2, D3 | Capacidades de 55, 75 y 65 unidades |
| Clientes | C1, C2, C3, C4 | Demanda de 25, 35, 40 y 30, en total 130 |
Cada una de las catorce rutas lleva una capacidad, un coste por unidad y un tiempo de tránsito, como se dibuja en la figura de arriba. La oferta total es 180 frente a una demanda de 130, así que en el caso base hay margen; la sección 5 lo quita.
Un detalle estructural importa antes de que corra ningún algoritmo. La red es un grafo dirigido acíclico: el material solo se mueve de izquierda a derecha, de la oferta hacia la demanda. Las cadenas reales tienen devoluciones, bucles de reproceso y traspasos entre almacenes, y todos ellos crean ciclos, y los algoritmos de abajo siguen funcionando. Pero el caso acíclico es aquel en el que la intuición es más limpia, y es donde viven de hecho la mayoría de los modelos de planificación táctica.
Un segundo detalle es que este es un modelo de un producto y un periodo únicamente. Ese supuesto hace mucho trabajo, y la sección 12 muestra la construcción gráfica estándar que lo elimina.
4. Plazo de entrega: caminos mínimos
La primera pregunta que cualquiera hace a una red es con qué rapidez puede responder. Con tiempos de tránsito en las aristas, eso es exactamente el problema del camino mínimo, y el algoritmo de Dijkstra lo responde para todos los destinos a la vez en O(m + n log n).
Resolverlo desde cada proveedor da la foto del servicio:
| Desde | C1 | C2 | C3 | C4 |
|---|---|---|---|---|
| S1 | 6 días S1-P1-D1-C1 | 7 días S1-P1-D1-C2 | 9 días S1-P2-D3-C3 | 8 días S1-P2-D3-C4 |
| S2 | 7 días S2-P1-D1-C1 | 6 días S2-P2-D2-C2 | 6 días S2-P2-D3-C3 | 5 días S2-P2-D3-C4 |
De esta tabla salen tres cosas que una hoja de cálculo no te habría dicho. El peor servicio de la red es de 9 días, de S1 a C3, y es el número contra el que hay que escribir un acuerdo de nivel de servicio. Los dos proveedores no son intercambiables: S1 es más rápido a C1, S2 es más rápido a todo lo demás, lo que es un argumento para el doble aprovisionamiento por región y no por volumen. Y la ruta más rápida a C3 desde S1 pasa por P2, no por el geográficamente obvio P1, porque la rama de P1 es más lenta en cada paso.
Ahora compara con el coste. La ruta más barata que sale de S1 es S1 → P1 a 2 por unidad, y la ruta más rápida a C3 la evita por completo. Minimizar días y minimizar dinero son optimizaciones distintas sobre el mismo grafo, y cualquier herramienta de planificación que ofrezca una única «mejor ruta» está eligiendo en silencio una de ellas por ti. El árbol de decisión completo sobre qué algoritmo aplica a qué variante está en algoritmos de caminos mínimos.
Conviene conocer dos extensiones prácticas. Añadir un tiempo fijo de manipulación en cada instalación se hace poniendo el retraso en el nodo, que la sección 12 convierte en una arista. Y cuando la pregunta es «cuál es la ruta más rápida que además cuesta menos que X», tienes un problema de camino mínimo con restricciones, que es NP-difícil en general y se resuelve normalmente con relajación lagrangiana o un algoritmo de etiquetado en lugar de con un Dijkstra simple.
5. Capacidad: flujo máximo y el corte que te limita
La segunda pregunta es cuánto puede mover realmente la red. Añade una fuente artificial que alimente a ambos proveedores con su volumen disponible, y un sumidero artificial que extraiga la demanda de cada cliente, y la respuesta es un cálculo de flujo máximo para esta red.
En el caso base la respuesta es poco dramática: pasan las 130 unidades completas. Lo interesante es dónde está la restricción que ata. Resolver el problema de flujo produce además el corte mínimo, y aquí el corte consiste en las propias aristas de cliente. En lenguaje llano: nada dentro de la red limita nada, y la única razón por la que no fluyen más unidades es que nadie las ha pedido. Ese es el caso sano, y conviene confirmarlo antes de pedirle a alguien que apruebe una inversión.
Ahora sube toda la demanda un 40 %, una temporada alta moderada. La demanda pasa a 182 unidades, y la red entrega 164.
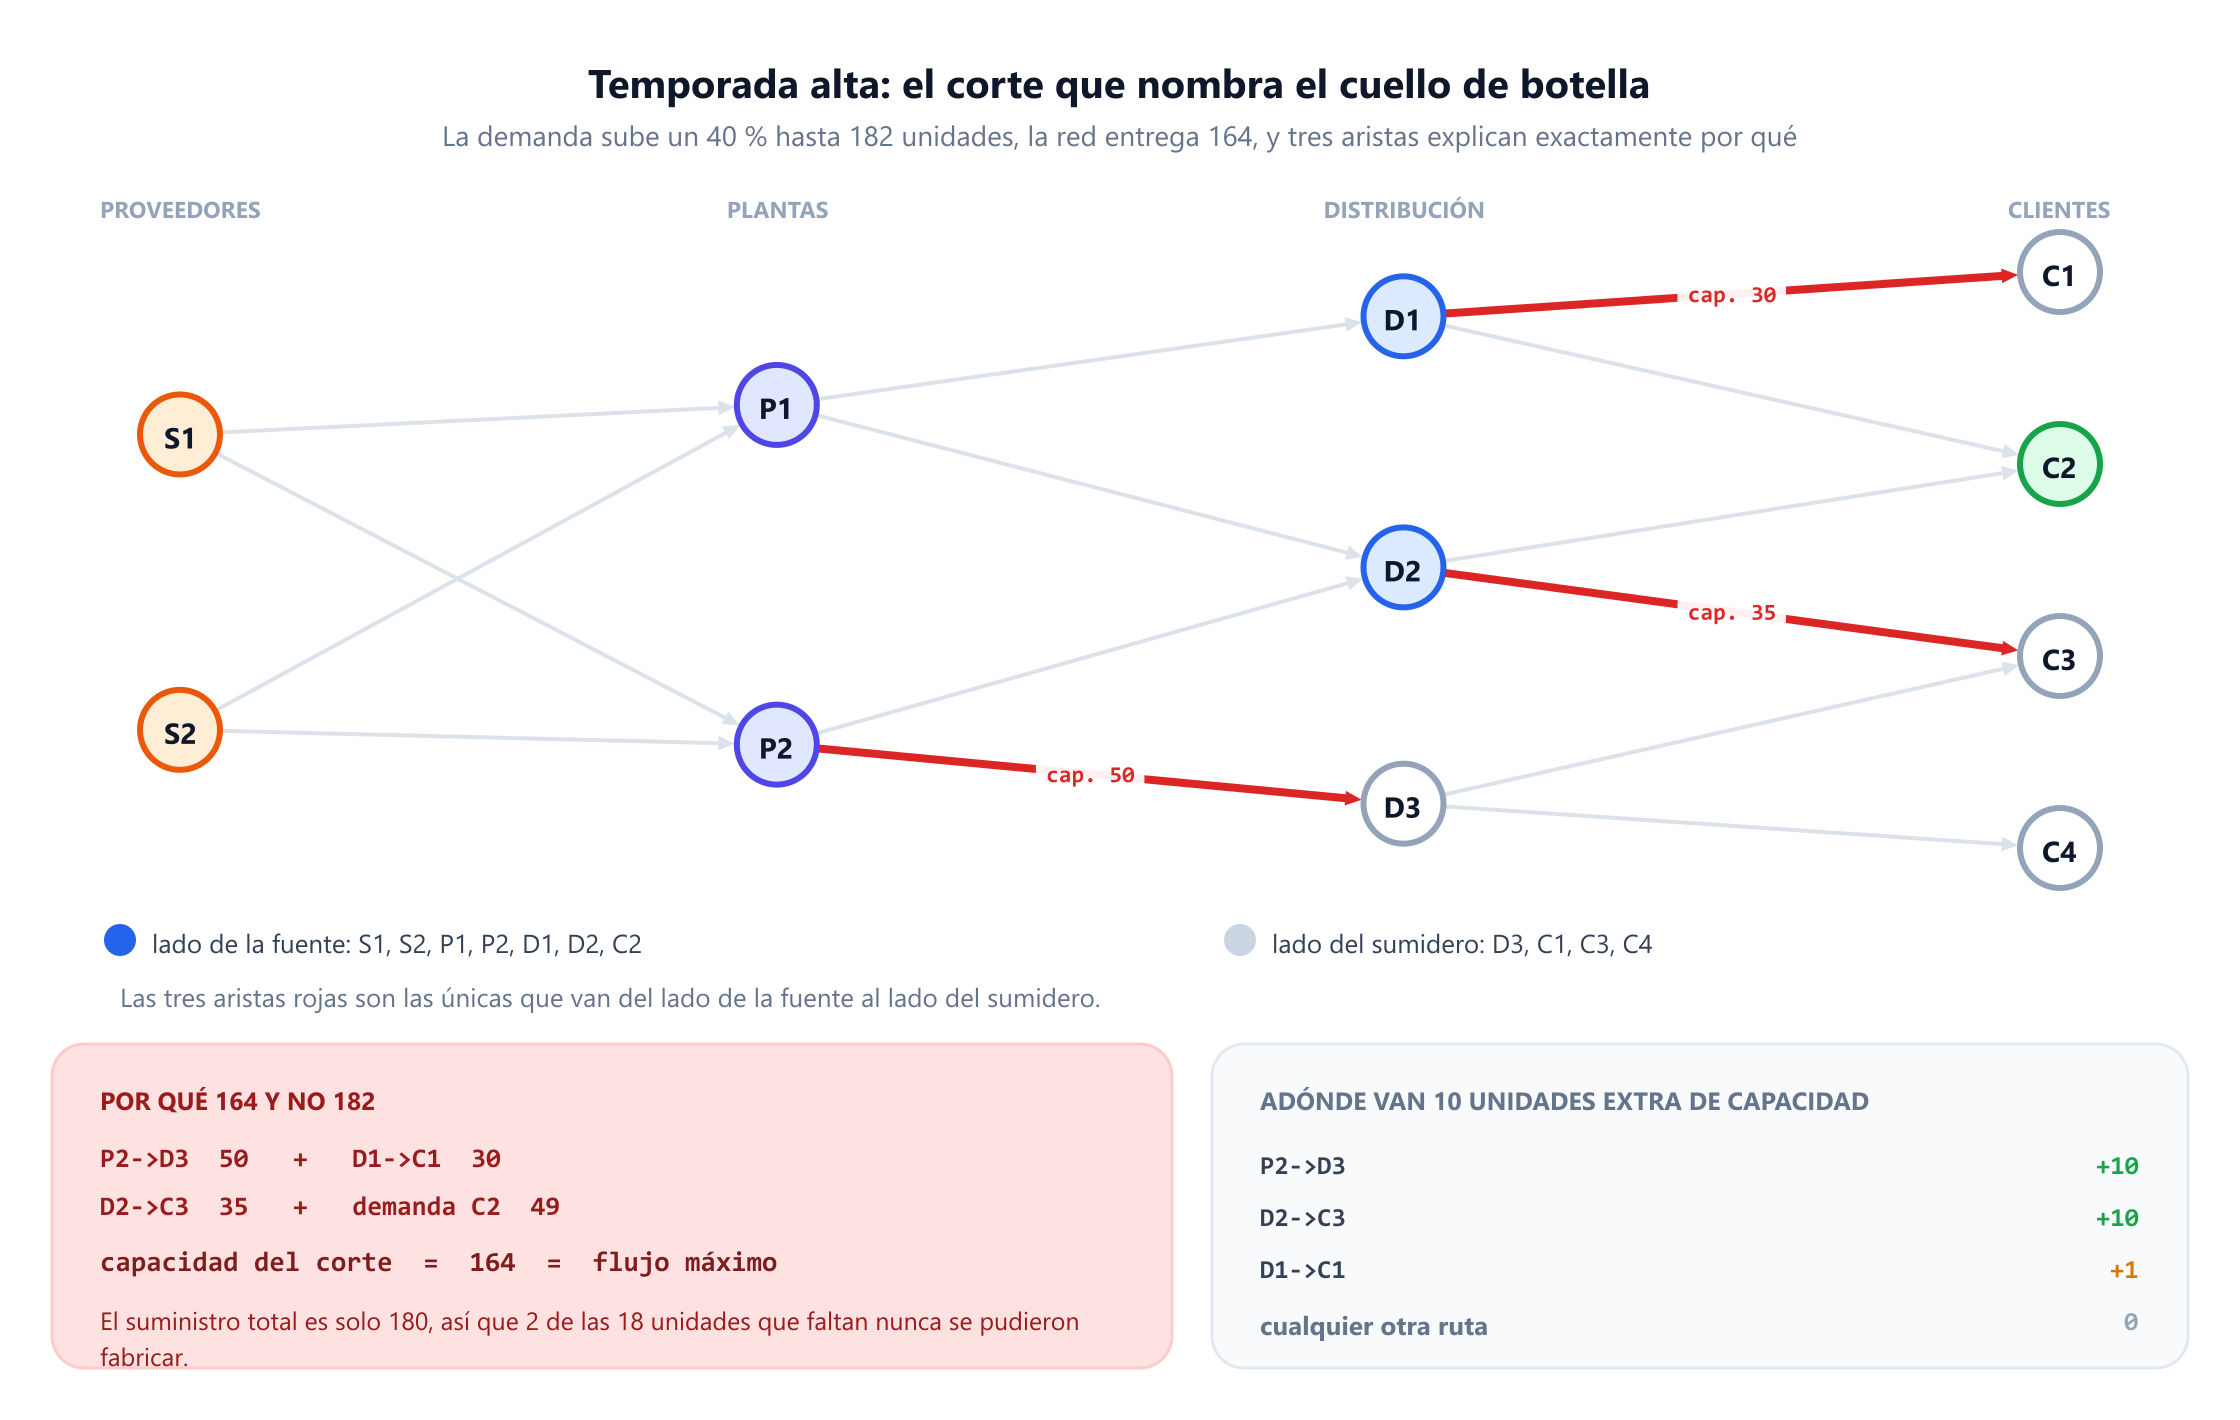
Las 18 unidades que faltan se descomponen con precisión. La oferta total es 180, así que 2 unidades nunca fueron fabricables con independencia de la red. Las 16 restantes se pierden por la estructura, y el corte mínimo nombra la estructura exactamente: P2 → D3 con capacidad 50, D1 → C1 con 30, D2 → C3 con 35, más las 49 unidades de demanda de C2 que quedan del lado de la fuente. Eso suma 164, que el teorema de flujo máximo y corte mínimo garantiza que es igual al flujo máximo, y la aritmética lo confirma.
Esto es lo más útil que la teoría de grafos hace por una cadena de suministro, así que conviene decirlo sin rodeos. El corte mínimo es la lista de inversiones. La capacidad añadida en cualquier otro sitio no cambia absolutamente nada. Probar esa afirmación en esta red da un resultado que ninguna intuición produciría:
- 10 unidades extra en
P2 → D3: la capacidad de entrega sube de 164 a 174. - 10 unidades extra en
D2 → C3: también 174. - 10 unidades extra en
D1 → C1: la capacidad de entrega sube a 165, y no más. Una unidad, no diez. - 10 unidades extra en cualquiera de las otras once rutas: ningún cambio en absoluto.
El caso de D1 → C1 es el instructivo. Está de verdad en el corte mínimo, así que la primera unidad de capacidad extra sí ayuda, pero después ata otra restricción y la inversión deja de pagar. Un corte te dice dónde está el muro hoy; no promete que el muro siga en el mismo sitio en cuanto lo muevas. En la práctica, por eso la planificación de capacidad se hace como una secuencia de nuevas resoluciones y no como una única clasificación.
6. Coste: el problema de transporte y el flujo de coste mínimo
La viabilidad no es un plan. La pregunta operativa es cuál de los muchos planes viables es el más barato, y eso es el problema del flujo de coste mínimo: satisfacer toda la demanda, respetar toda la capacidad, minimizar la suma de flujo por coste sobre todas las aristas.
Su antecesor es el problema de transporte, planteado por Hitchcock en 1941 e independientemente por Koopmans, y resuelto con eficiencia por Dantzig en 1951 con un método símplex especializado. La forma general moderna se resuelve con el algoritmo símplex de redes o con caminos mínimos sucesivos, y el Network Flows de Ahuja, Magnanti y Orlin sigue siendo el tratamiento estándar.
Resuelto sobre la red de ejemplo, la forma más barata de entregar las 130 unidades cuesta 1020, una media de 7,85 por unidad:
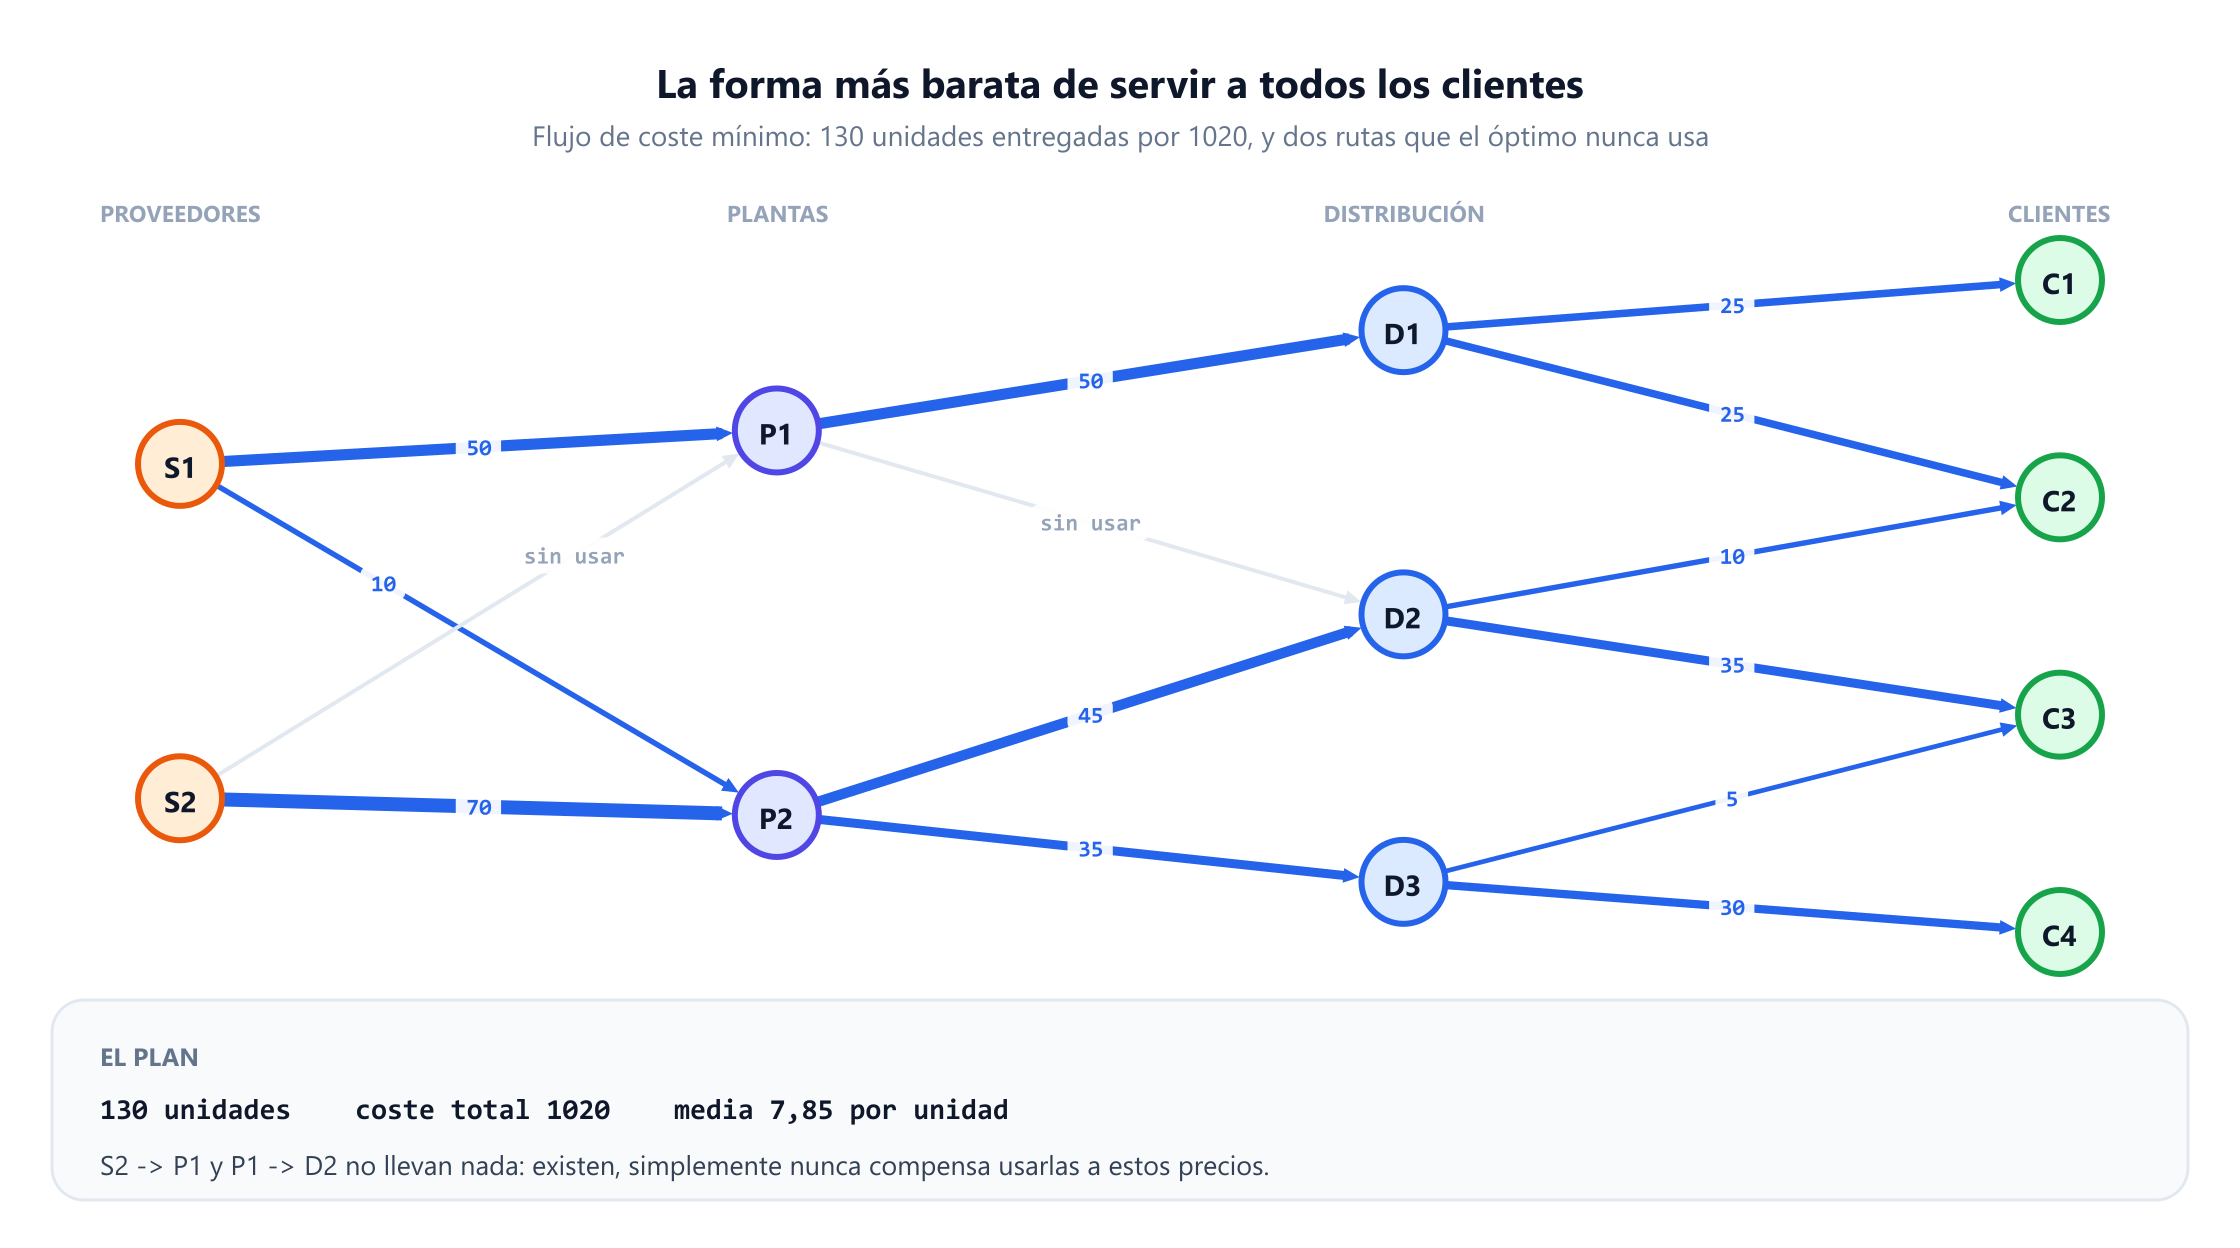
Vale la pena leer con atención tres rasgos de la solución, porque son los que sorprenden a la gente.
Dos rutas no llevan nada. S2 → P1 y P1 → D2 son perfectamente utilizables y nunca compensa usarlas a estos precios. Un diagrama de red no puede decírtelo; solo la optimización puede. Es también la respuesta a «por qué pagamos por mantener esa ruta», una pregunta que merece hacerse cada año.
La demanda se reparte. C2 recibe 25 unidades de D1 y 10 de D2, y C3 recibe 35 de D2 y 5 de D3. Servir a cada cliente desde su centro más cercano es una regla práctica, no un óptimo, y aquí costaría más. Los modelos reales añaden a menudo una restricción que prohíbe los repartos, y el precio de esa restricción debería medirse en vez de suponerse.
La respuesta salió en unidades enteras. Eso no es suerte. La matriz de restricciones de un problema de flujo en redes es totalmente unimodular, así que cuando las ofertas y las demandas son enteras, el programa lineal tiene automáticamente una solución óptima entera. Por eso los problemas de flujo se resuelven como programas lineales y aun así dan respuestas embarcables, y es exactamente lo que falla en cuanto añades una decisión binaria de «abierto o cerrado», que es el tema de la siguiente sección.
7. ¿Qué almacenes deberían existir?
Todo lo anterior daba la red por dada. La pregunta estratégica es qué instalaciones deberían existir, y cambia por completo las matemáticas: abrir un sitio cuesta una cantidad fija tanto si envía una unidad como mil, y un coste fijo no se puede expresar como coste por unidad sobre una arista.
Da a los tres centros de distribución un coste fijo semanal de 250, 300 y 200, capacidades de 55, 75 y 65 unidades, y un coste por unidad para servir a cada región de clientes. Entonces la pregunta es qué subconjunto abrir, y para cada subconjunto candidato el coste de servir es en sí mismo un problema de transporte. Con tres sitios hay siete subconjuntos y podemos resolverlos todos sin más.
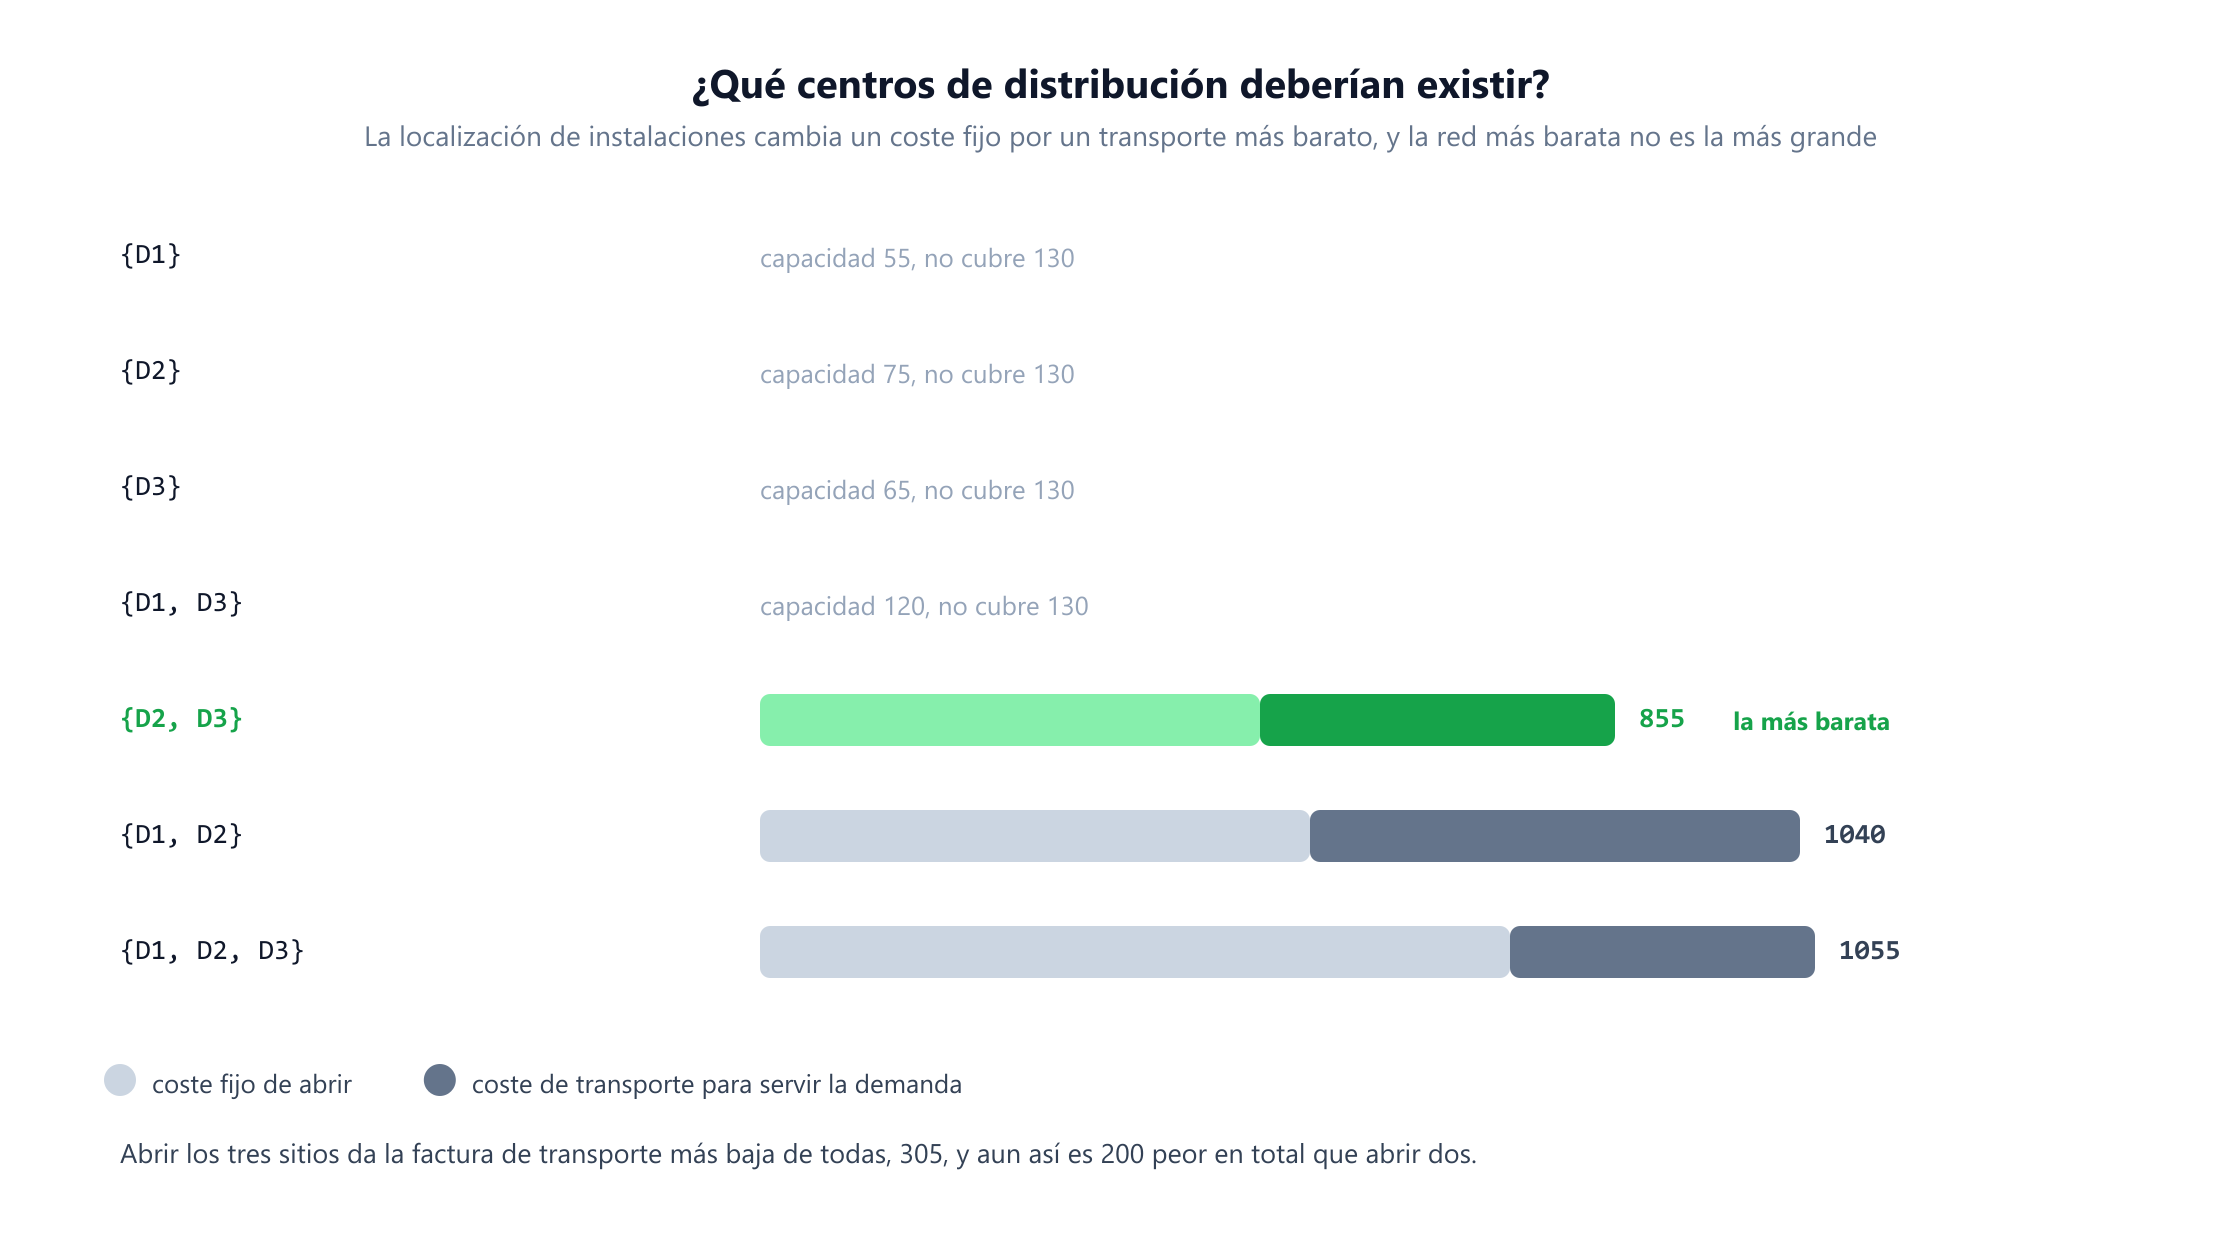
El ganador es {D2, D3} con 855: 500 de coste fijo y 355 de transporte. El resultado que importa pedagógicamente es la última fila. Abrir los tres centros produce el coste de transporte más bajo de todas las configuraciones, 305, porque entonces cada cliente puede servirse desde su fuente más barata. Aun así es 200 peor en total, porque el coste fijo de 250 del tercer sitio solo compra 50 de ahorro en transporte. Optimizar el flujo dentro de una red que ya has sobredimensionado es una buena manera de equivocarte con eficiencia.
Este es el problema de localización de instalaciones con capacidad, y a diferencia de todo lo de las secciones 4 a 6, es NP-difícil. Con tres sitios candidatos, la fuerza bruta sobre ocho subconjuntos es instantánea. Con trescientos no lo es, y el campo lo resuelve con programación entera mixta: Balinski dio la formulación estándar en 1965, Geoffrion y Graves resolvieron un diseño real de distribución multiproducto con descomposición de Benders en 1974, y los solvers modernos manejan instancias industriales de forma rutinaria. La estructura que lo hace tratable en la práctica es exactamente la que se ve aquí: para cualquier conjunto fijo de sitios abiertos, el problema restante es un flujo en redes que se resuelve en tiempo polinómico. Un ejemplo más completo, con distancias por carretera, las heurísticas clásicas de ubicación y el precio de una promesa de servicio, está en localización de instalaciones: dónde poner el próximo almacén.
8. Diseñar la red física: árboles de expansión
Otra pregunta de diseño no es «dónde deberían estar las instalaciones» sino «qué conexiones deberíamos construir». Tender una línea privada, contratar una lanzadera dedicada o construir un ramal ferroviario tiene un coste por enlace, y el requisito es que cada instalación pueda alcanzar a todas las demás.
Ese es el problema del árbol de expansión mínimo y lo resuelve el algoritmo de Kruskal en O(m log n). Con seis instalaciones, dos plantas, tres centros y un hub de cross-docking compartido, y once enlaces posibles con precios entre 3 y 10, el diseño conexo más barato cuesta 21 y usa cinco enlaces: P2-H a 3, P1-D1 a 4, D2-H a 4, P2-D3 a 5 y D1-H a 5.
Cinco enlaces para seis instalaciones no es casualidad. Un árbol con n vértices tiene siempre exactamente n - 1 aristas, y ese es el compromiso que define todo el enfoque: un árbol de expansión es la forma más barata de conectarlo todo, y también la más frágil. Cada uno de esos cinco enlaces es un puente, es decir, su pérdida desconecta la red, y tres de las seis instalaciones son vértices de corte. La sección 11 pone números a lo que eso cuesta.
La lección práctica es que el árbol de expansión mínimo es el algoritmo correcto para el objetivo equivocado en la mayoría de los contextos de cadena de suministro. Lo que normalmente quieres es la red más barata que sobreviva a la pérdida de cualquier enlace, que es el diseño de redes dos-arista-conexas en el sentido de la teoría de grafos, y ese problema es NP-difícil. Aun así vale la pena calcular el árbol mínimo, porque es una cota inferior: ningún diseño conexo puede costar menos, así que te dice el precio de la redundancia que estás a punto de comprar.
9. La última milla: rutas de vehículos
Todo lo anterior mueve unidades entre instalaciones. El último tramo las lleva a las puertas, y ahí se incurre en gran parte del coste de distribución y las matemáticas se vuelven difíciles.
Da a un vehículo un conjunto de paradas y pide el recorrido más corto que visita cada una exactamente una vez y vuelve al depósito, y tienes el problema del viajante. Da a una flota capacidades y pregunta qué vehículo sirve qué paradas, y tienes el problema de rutas de vehículos, introducido por Dantzig y Ramser en 1959 con el nombre de «the truck dispatching problem» y generalizado desde entonces a ventanas horarias, flotas mixtas, recogida y entrega y horas de conducción.
La diferencia con las secciones 4 a 6 es de tipo, no de grado. Camino mínimo, flujo máximo y flujo de coste mínimo son todos polinómicos: un solver moderno maneja una red de carreteras continental en menos de un segundo. El TSP y el VRP son NP-difíciles, y el número de recorridos posibles por n paradas es (n-1)!/2, que supera los 60 billones ya con 20 paradas. Por eso la práctica va con heurísticas: el algoritmo de ahorros de Clarke y Wright de 1964 sigue siendo un método de construcción estándar, la búsqueda local como 2-opt y Or-opt mejora el resultado, y metaheurísticas como la búsqueda de vecindario grande mueven los motores comerciales. Los métodos exactos también han mejorado enormemente, y hoy se resuelven a optimalidad probada instancias con cientos de clientes, pero el despacho diario se resuelve con heurísticas porque hay que responderlo en minutos.
El punto de modelado que conviene llevarse: la capa de rutas se sitúa encima de la capa de flujo. El modelo de flujo decide que D3 envía 30 unidades a la región C4; el modelo de rutas decide la secuencia de puertas dentro de C4 y qué camión lo hace. Optimizar ambas a la vez es posible y es lo que intentan los sistemas de planificación integrada, pero la división en dos etapas es lo estándar porque cada etapa es difícil por un motivo distinto. Para la capa de rutas resuelta de principio a fin y con los costes de flota incluidos, mira optimización de rutas de reparto.
10. Dentro de la fábrica: materiales y calendarios
Acércate a una sola planta y los grafos no se acaban. Dos de ellos gobiernan la fábrica, y ambos son grafos dirigidos acíclicos que se responden con una pasada en orden topológico.
El primero es la lista de materiales. Un producto está hecho de componentes, cada uno de los cuales está hecho de componentes, y las aristas llevan cantidades. Estallar un pedido de cliente en necesidades de materia prima significa recorrer ese grafo de arriba abajo multiplicando sobre la marcha. Eso es lo que hace la planificación de necesidades de materiales, formalizada por Orlicky en 1975 y todavía el bucle central de cualquier ERP.
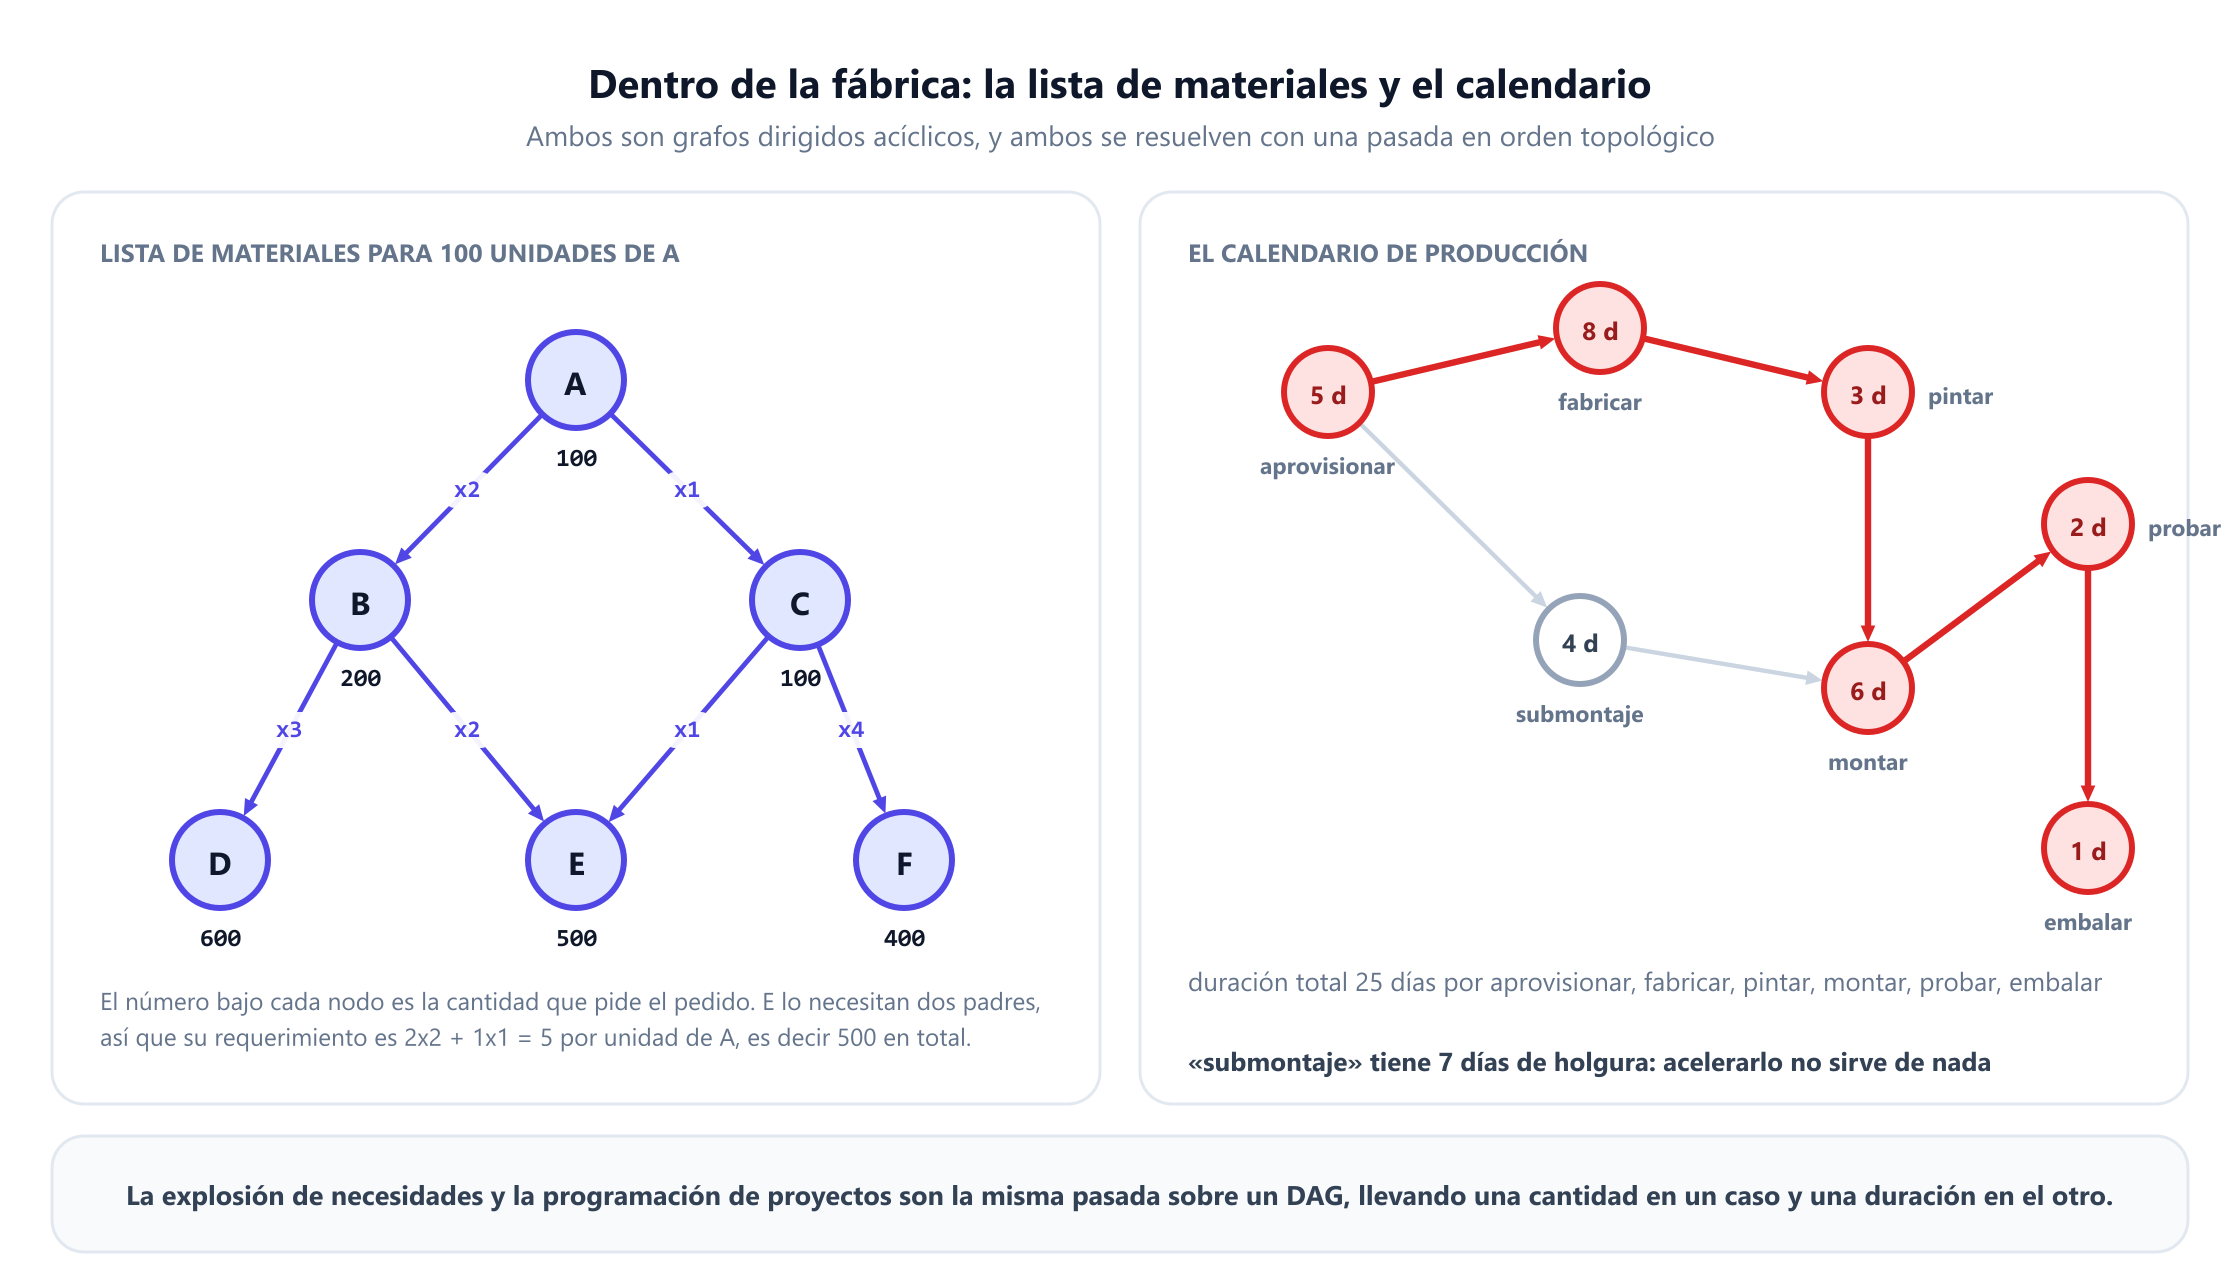
Para un pedido de 100 unidades del producto A, la explosión da 200 de B, 100 de C, 600 de D, 500 de E y 400 de F. El componente E merece una pausa: aparece bajo dos padres distintos, así que su requerimiento es 2 × 2 a través de B más 1 × 1 a través de C, que son 5 por unidad de A. Sumar las ramas de forma independiente, que es lo que hace una hoja de cálculo ingenua, cuenta de más o de menos precisamente estos componentes compartidos. Procesar los artículos en orden topológico garantiza que cada padre está cerrado antes de leer un hijo, y por eso la pasada es correcta a la primera.
El segundo grafo es el calendario. Las tareas tienen duraciones y restricciones de precedencia, y la duración del proyecto es el camino más largo por el DAG resultante. En el plan de siete tareas de la figura la duración total es de 25 días, por aprovisionar, fabricar, pintar, montar, probar y embalar. Esa cadena es la ruta crítica, del método de Kelley y Walker de 1959, y su significado práctico es tajante: cualquier retraso en ella retrasa el pedido uno a uno, mientras que el submontaje lleva 7 días de holgura y podría retrasarse una semana entera sin mover la fecha de entrega ni una hora.
Fíjate en la asimetría que hace esto valioso. El camino más largo es NP-difícil en un grafo general y lineal en un DAG, así que programar sale barato precisamente porque las precedencias no pueden formar un ciclo. Si lo forman, el plan es inviable, y el mismo algoritmo también lo detecta. Secuenciar los pedidos de clientes por las propias máquinas, con fechas de entrega, cambios de color y horas extra, se trabaja en programación de la producción para fabricantes.
11. Resiliencia: qué se rompe y con qué gravedad
Un modelo de costes te dice qué hacer cuando todo funciona. Un modelo de resiliencia te dice qué pasa cuando no, y es el mismo grafo con otra pregunta: quita un vértice, vuelve a resolver el flujo y lee el déficit.
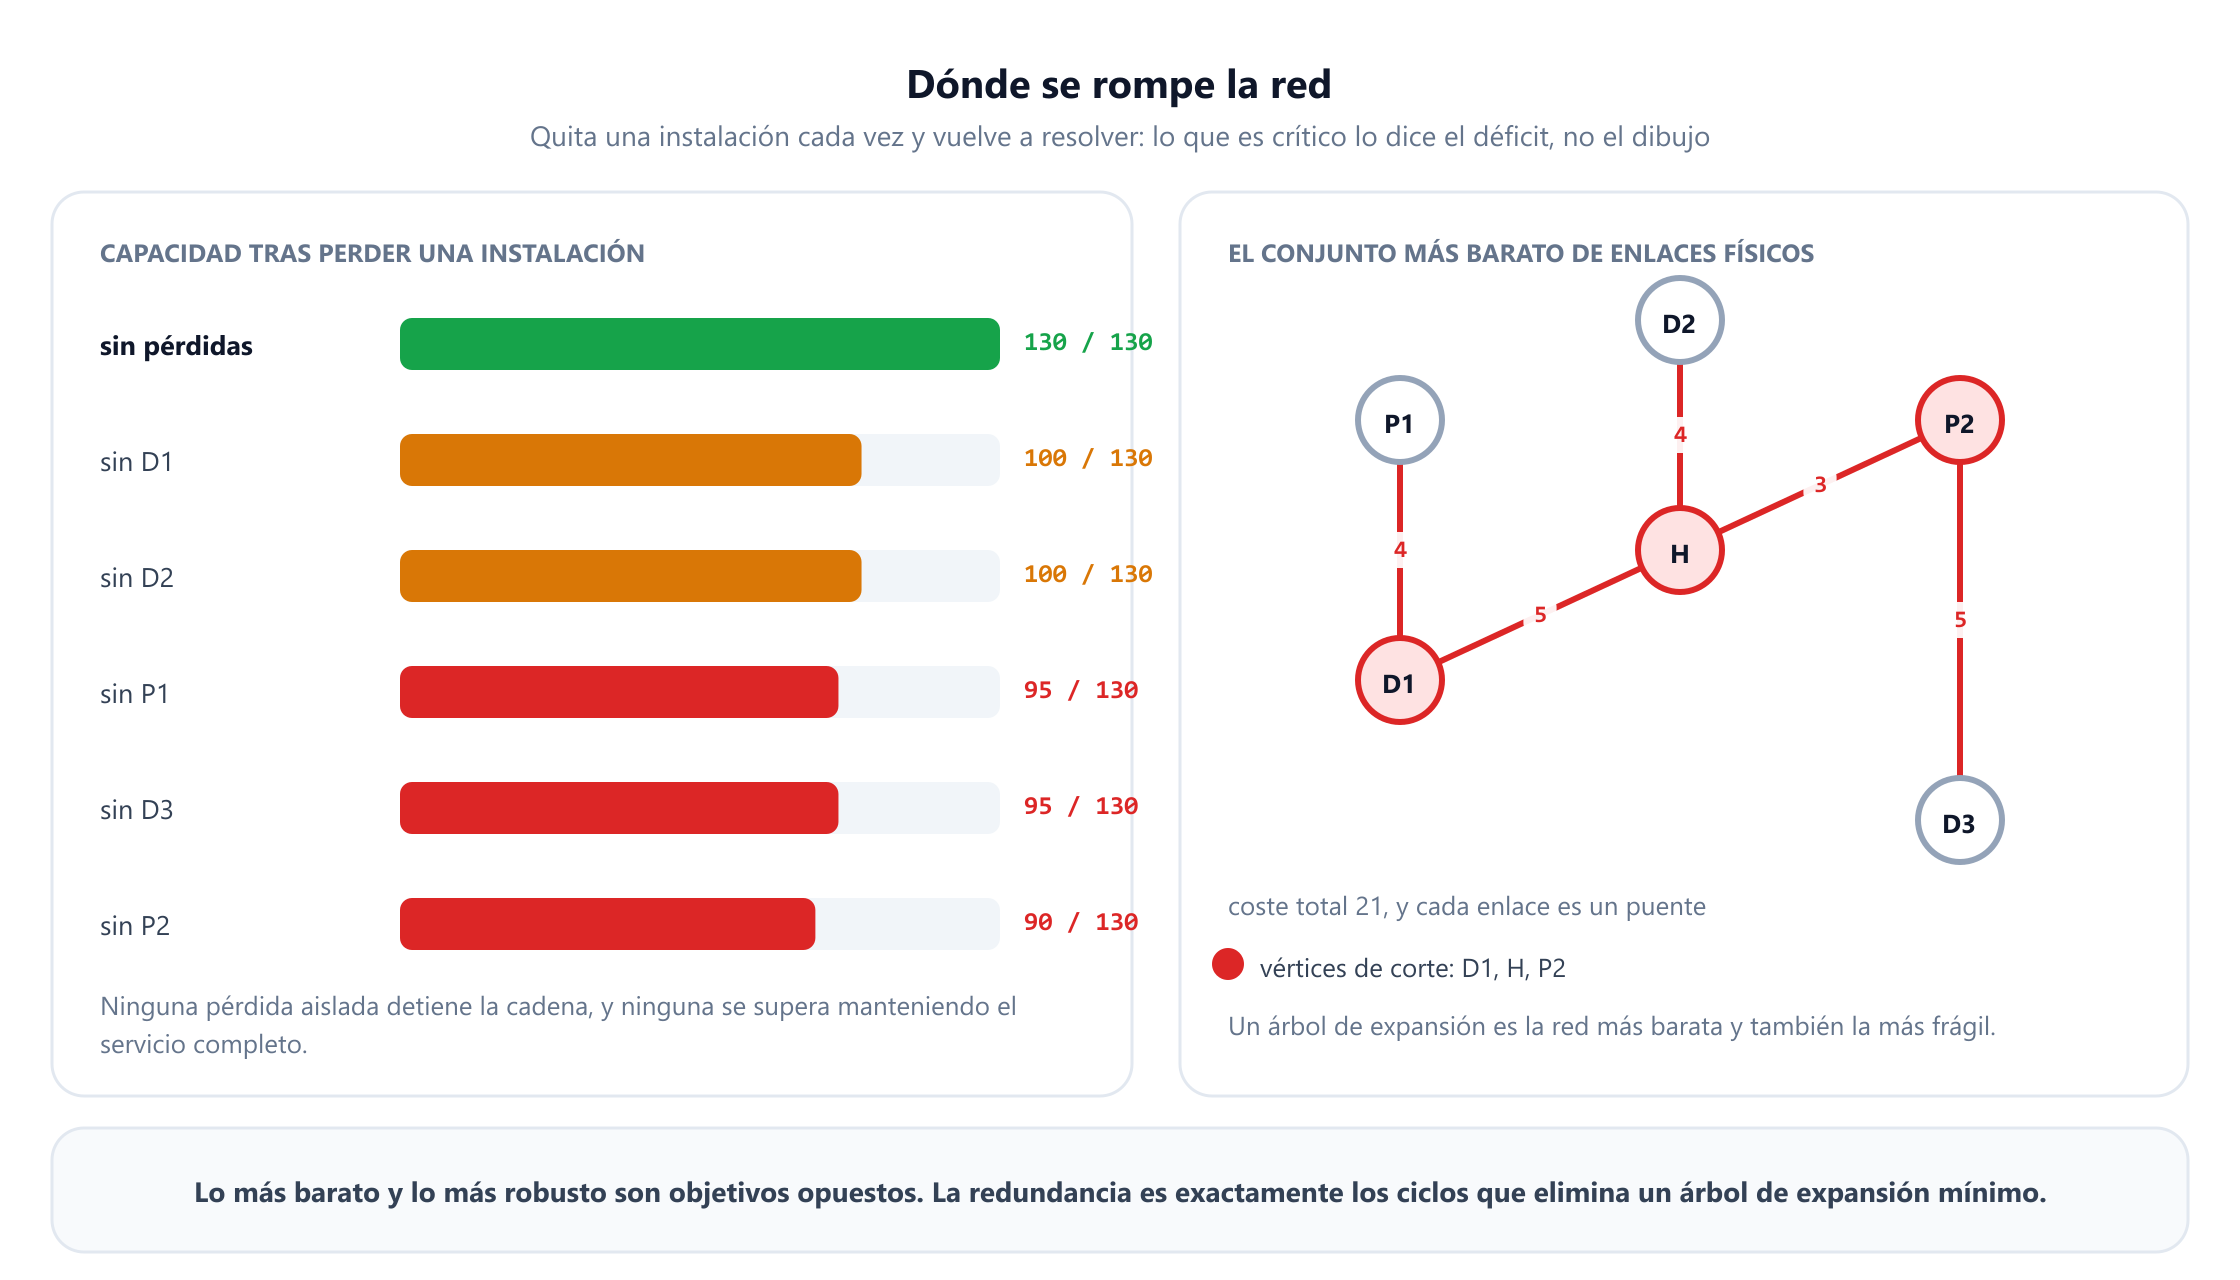
Perder cualquier instalación aislada deja a la red capaz de entregar entre 90 y 100 de las 130 unidades. El peor caso es P2, con 90 unidades, un déficit del 31 %, y ese resultado conviene leerlo junto a la sección 6. El plan más barato encamina 70 unidades por S2 → P2 y 80 unidades por P2 en total, porque P2 está en las rutas más baratas. La optimización de costes concentra el flujo, y el flujo concentrado es exactamente el aspecto que tiene la fragilidad. El óptimo y el riesgo los produce la misma propiedad de la red.
Las rutas individuales también importan, y de forma desigual. La peor ruta aislada es P2 → D3, cuya pérdida cuesta 35 unidades; P1 → D1 y D3 → C4 cuestan 30 cada una; D2 → C3 cuesta 20; y S1 → P1, D1 → C2 o D3 → C3 cuestan solo 5. Ordenar el gasto en mitigación por el volumen de cada ruta daría un orden equivocado, porque el volumen es lo que el plan decidió enviar, no lo que la red perdería.
La visión estructural de la sección 8 dice lo mismo en otro idioma. En un árbol de expansión mínimo cada enlace es un puente y varias instalaciones son vértices de corte, así que una red física de coste mínimo no tiene, por construcción, ninguna redundancia. La redundancia son los ciclos que el árbol de expansión eliminó. Comprar resiliencia significa comprar deliberadamente aristas que un modelo de costes rechazaría.
Merece la pena nombrar dos líneas de investigación. El The Resilient Enterprise de Sheffi (2005) defendió que la flexibilidad es un activo estratégico y no un desperdicio. Y Simchi-Levi y sus colegas, trabajando con Ford, formalizaron la idea de que el riesgo debe medirse por el tiempo hasta la recuperación y el impacto resultante en el beneficio, y no por la probabilidad de una disrupción, que es inconocible: su estudio de 2015 encontró que las piezas con mayor exposición eran con frecuencia componentes de bajo valor de proveedores únicos que ningún análisis basado en el gasto señalaría jamás. Eso es una pregunta de grafos, y es la que calcula esta sección.
12. Dos trucos de modelado que conviene conocer
Dos construcciones convierten «el modelo no puede expresar eso» en «el modelo lo expresa sin problema», y entre las dos cubren casi todo lo que un principiante se encuentra primero.
Dividir el nodo, para poner capacidad en una instalación. Los algoritmos de flujo ponen la capacidad en las aristas, pero un almacén tiene su propio límite de procesamiento. La solución es sustituir el vértice por dos: una copia «de entrada» que recibe todas las aristas entrantes, una copia «de salida» que envía todas las salientes, y una única arista entre ambas que lleva la capacidad de la instalación.
antes:        --> [ D2 ] -->

después:         --> [D2_in] --(capacidad 75, coste = tarifa de manipulación)--> [D2_out] -->
El mismo truco lleva un coste de manipulación o un retraso fijo de proceso, que es como los plazos de la sección 4 absorben el tiempo que se pasa dentro de un edificio y no en la carretera. Duplica el número de vértices y no cambia nada más, y todos los algoritmos de flujo de este artículo funcionan después sin tocarlos.
Expandir en el tiempo, para el inventario. Un modelo de un solo periodo no tiene memoria: lo que se produce debe enviarse de inmediato. Las cadenas reales guardan stock, y el stock es movimiento a través del tiempo en lugar del espacio. Construye una copia de la red por periodo y añade una arista desde cada instalación en el periodo t a la misma instalación en el periodo t+1. El flujo por esa arista es el inventario, su coste es el coste de mantenimiento y su capacidad es el límite de almacenamiento. Cuánto stock guardar y dónde es su propio problema de optimización, tratado en nuestra guía de optimización de inventario y stock de seguridad.
El resultado se llama red expandida en el tiempo, y es exactamente la razón por la que la planificación de producción multiperiodo es resoluble: un problema que parece necesitar una teoría nueva resulta ser un flujo de coste mínimo corriente sobre un grafo T veces mayor. La misma construcción maneja la vida útil, simplemente no construyendo la arista que llevaría stock más allá de su caducidad.
Los dos trucos comparten una moraleja que vale la pena interiorizar. Cuando una característica de la cadena de suministro parece necesitar un algoritmo nuevo, normalmente necesita un grafo nuevo, y el algoritmo que ya tienes se aplica sin cambios.
13. Qué es fácil y qué es difícil
Lo más valioso que un planificador puede saber sobre su propio modelo es de qué lado de la línea de tratabilidad está, porque eso decide si la respuesta es un óptimo o una buena conjetura.
| Pregunta de la cadena de suministro | Problema de grafos | Coste |
|---|---|---|
| Ruta más rápida, compromisos de servicio | Camino mínimo | O(m + n log n) |
| ¿Podemos entregarlo todo? ¿Dónde está el cuello de botella? | Flujo máximo, corte mínimo | Polinómico |
| Plan de envío más barato | Flujo de coste mínimo | Polinómico |
| Necesidades de materiales | Orden topológico en un DAG | O(n + m) |
| Duración del proyecto, ruta crítica | Camino más largo en un DAG | O(n + m) |
| Conjunto de enlaces más barato | Árbol de expansión mínimo | O(m log n) |
| Qué instalaciones abrir | Localización de instalaciones | NP-difícil |
| Rutas de reparto para una flota | Rutas de vehículos | NP-difícil |
| Red más barata que sobrevive a cualquier fallo aislado | Diseño dos-arista-conexo | NP-difícil |
| Lotes de producción a lo largo del tiempo | Dimensionado de lotes con preparaciones | NP-difícil en general |
El patrón es limpio y conviene enunciarlo: las preguntas sobre flujo son fáciles, las preguntas sobre qué objetos discretos construir son difíciles. En cuanto una decisión pasa a ser sí o no en vez de cuánto, se pierde la unimodularidad total, el programa lineal deja de devolver respuestas enteras, y estás en programación entera mixta.
Difícil no significa imposible. Instancias de localización con cientos de sitios candidatos se resuelven a optimalidad probada todos los días, y las heurísticas de rutas quedan a pocos puntos porcentuales de las mejores soluciones conocidas en instancias muy por encima de los métodos exactos. Lo que cambia la línea es la promesa: en la mitad superior de la tabla puedes decir «esto es óptimo», y en la inferior la frase honesta es «esto es lo mejor que encontramos, y esta es la cota». Un tratamiento más amplio de los costes en sí está en algoritmos de grafos y complejidad.
14. Del modelo a la práctica
La distancia entre un modelo correcto y uno útil no es sobre todo matemática. Cuatro cosas deciden si el trabajo aterriza.
Los datos son el proyecto. Los costes, las capacidades y los tiempos de tránsito de cada ruta viven en sistemas de gestión de transporte, contratos y hojas de cálculo, y se contradicen entre sí. Un modelo construido sobre una tabla de costes de hace dieciocho meses producirá una respuesta segura, precisa y equivocada, y la culpa recaerá en la optimización. Presupuesta aquí la mayor parte del esfuerzo.
Elige la granularidad a propósito. Un estudio estratégico de red puede tratar toda una región como un vértice de cliente; un modelo de despacho semanal no. Agregar demanda es legítimo, agregar capacidad normalmente no, porque los promedios esconden justo los picos que crean el cuello de botella de la sección 5.
Usa un solver de verdad. Para flujos, NetworkX y SciPy incluyen flujo de coste mínimo, y Google OR-Tools cubre flujos, rutas y programación con una interfaz pensada para profesionales. Para cualquier cosa con decisiones binarias, un solver de programación entera mixta como Gurobi, CPLEX o los de código abierto HiGHS y CBC es la herramienta correcta. Escribir tu propio símplex de redes es una buena forma de aprender y una mala forma de entregar.
Modela lo que de verdad varía. Un modelo determinista responde «qué es lo mejor si la semana que viene es exactamente así». La demanda no es exactamente nada, y el fallo clásico aquí no es algorítmico: Forrester describió en 1958 cómo las políticas de pedido amplifican la variabilidad aguas arriba, y Lee, Padmanabhan y Whang lo llamaron efecto látigo en 1997. Ninguna optimización del flujo de una sola semana aborda eso. Las respuestas habituales son el análisis de escenarios, la optimización estocástica o robusta, y un horizonte rodante que vuelve a resolver según llega la realidad.
Un último hábito, que los números de este artículo pretenden demostrar: vuelve a resolver en lugar de razonar. La afirmación de que una ruta es crítica, de que un sitio gana su coste fijo o de que una inversión en capacidad se paga es una afirmación que el modelo puede zanjar en milisegundos, y la intuición sobre redes falla justo en los casos que importan. La sección 5 encontró una ruta donde diez unidades extra de capacidad compran una unidad de capacidad de entrega. Eso no lo adivina nadie.
15. Errores de modelado que producen respuestas seguras y equivocadas
Un modelo de red rara vez falla en voz alta. Devuelve un plan, el plan parece razonable, y el error solo es visible para quien sabe dónde mirar. Estos son los que se repiten.
- Poner la capacidad de una instalación en una de sus aristas. Un almacén que puede manejar 75 unidades por semana no es lo mismo que una ruta que puede transportar 75, y meter el límite en la arista que parezca más cargada permite en silencio más o menos capacidad de la que la realidad admite. Divide el nodo, como en la sección 12.
- Usar un solo número como peso de la arista. Coste, tiempo y capacidad responden a preguntas distintas, y un modelo que solo lleva uno de ellos devolverá con seguridad el plan más barato cuando le pedían el más rápido. En esta red esas dos respuestas difieren de verdad.
- Responder una pregunta multiperiodo con un modelo de un periodo. Sin aristas de inventario, todo lo producido debe enviarse de inmediato, así que el modelo declarará inviable un plan viable o inventará capacidad que no tiene. Expande la red en el tiempo en su lugar.
- Agregar la capacidad junto con la demanda. Promediar cuatro semanas de demanda en una suele ser defendible; promediar la capacidad no, porque la media esconde justo el pico que crea el cuello de botella. El pico del 40 % de la sección 5 desaparece por completo con un promedio mensual.
- Optimizar el coste sin restricción de servicio. Un objetivo de coste puro encaminará encantado todo por las rutas baratas más lentas. El plazo tiene que entrar como restricción o como penalización, o el óptimo será uno que nadie pueda operar.
- Ordenar el riesgo por volumen. La ruta más cargada es la que eligió el plan, que no es lo mismo que aquella cuya pérdida duele más. Vuelve a resolver sin cada candidata y ordena por el déficit, que es lo que hace la sección 11 y lo que produce un orden distinto.
- Poner precio a un camión completo como coste por unidad. El flete es a menudo una función escalonada: el segundo palé en un camión medio vacío es casi gratis, el primer palé en un camión nuevo no. Un coste lineal por unidad suaviza eso e infravalora sistemáticamente la consolidación. Los costes escalonados necesitan variables binarias, lo que lleva el modelo a la programación entera mixta.
- Olvidar que la lista de aristas es una decisión de modelado. El optimizador solo puede elegir rutas que existan en los datos. Una ruta que nadie introdujo es una ruta que nunca aparecerá en la respuesta, y «el modelo dice que no deberíamos usar esa ruta» a menudo es solo «nadie le dijo al modelo que la ruta existe».
El hilo común es que los ocho producen resultados plausibles. La defensa es probar el modelo contra un periodo ya vivido: si no puede reproducir los flujos reales del trimestre pasado con una tolerancia sensata, no está listo para recomendar los del próximo.
16. Preguntas frecuentes
¿Cómo se usa la teoría de grafos en la gestión de la cadena de suministro?
+
Las instalaciones pasan a ser vértices y las rutas de transporte aristas dirigidas, y entonces las preguntas habituales se convierten en algoritmos habituales: camino mínimo para plazos y niveles de servicio, flujo máximo para capacidad y cuellos de botella, flujo de coste mínimo para el plan de envío más barato, árbol de expansión mínimo para el diseño de la red, orden topológico para listas de materiales y calendarios de producción, y localización de instalaciones y rutas de vehículos para las decisiones estratégicas y de última milla. La optimización de redes no es una analogía de la planificación de la cadena de suministro; es la matemática sobre la que se construyó el campo.
¿Qué diferencia hay entre flujo máximo y flujo de coste mínimo?
+
El flujo máximo pregunta cuánto puede pasar físicamente e ignora el dinero por completo; responde a «¿podemos servir el pico de demanda y, si no, dónde está el muro?». El flujo de coste mínimo pide la forma más barata de mover una cantidad exigida e ignora todo lo que no tenga precio; responde a «dado que podemos servir la demanda, ¿qué deberíamos enviar realmente por cada ruta?». En la práctica se ejecuta primero el flujo máximo para comprobar la viabilidad y encontrar el cuello de botella, y después el flujo de coste mínimo para producir el plan.
¿Por qué es tan útil el corte mínimo en la práctica?
+
Porque convierte una afirmación vaga en una lista. El teorema de flujo máximo y corte mínimo dice que la capacidad máxima de paso es igual a la capacidad del conjunto más pequeño de aristas cuya eliminación separa la oferta de la demanda, así que el corte es una respuesta precisa a «qué rutas son la restricción». La capacidad añadida en cualquier otro sitio no compra nada. En la red de este artículo, diez unidades extra en cualquiera de dos rutas concretas compran diez unidades de capacidad de entrega, en una tercera compran una, y en las once restantes compran exactamente cero.
¿La red más barata es también la mejor red?
+
Casi nunca, y la teoría de grafos explica por qué con nitidez. La forma más barata de conectar un conjunto de instalaciones es un árbol de expansión, y un árbol de expansión no tiene ciclos, lo que significa que no hay rutas alternativas: cada enlace es un puente cuya pérdida desconecta la red. La redundancia es precisamente el conjunto de ciclos que un diseño que minimiza el coste elimina. El mismo efecto aparece en el plan de flujo, donde concentrar volumen en las rutas más baratas es lo que hace caro un fallo aislado. Coste y resiliencia son objetivos en competencia y deberían ponerse a precio uno contra otro en vez de suponerse compatibles.
¿Qué problemas de la cadena de suministro son NP-difíciles?
+
Los que deciden qué objetos discretos existen. La localización de instalaciones, las rutas de vehículos, el dimensionado de lotes con costes de preparación y el diseño de una red que sobreviva a cualquier fallo aislado son todos NP-difíciles. Todo lo relativo al flujo por una red fija es polinómico: camino mínimo, flujo máximo, flujo de coste mínimo, árboles de expansión, orden topológico y rutas críticas. La línea divisoria es el momento en que una decisión pasa a ser sí o no en vez de cuánto, porque entonces la relajación del programa lineal deja de devolver respuestas enteras por sí sola.
¿Qué software resuelve estos modelos?
+
Para flujos puros en redes, NetworkX y SciPy incluyen solvers de flujo de coste mínimo, y Google OR-Tools cubre flujos, rutas y programación con una interfaz orientada a la práctica. Para cualquier cosa con decisiones binarias, como abrir instalaciones o asignar camiones, usa un solver de programación entera mixta: Gurobi y CPLEX en el terreno comercial, HiGHS y CBC en el de código abierto, normalmente a través de una capa de modelado como Pyomo, PuLP o JuMP. Escribir tu propio símplex de redes es una forma excelente de entender el algoritmo y mala de entregar un sistema de planificación.
¿Cómo modelo el inventario que se guarda entre periodos?
+
Con una red expandida en el tiempo. Haz una copia de toda la red para cada periodo y añade una arista desde cada instalación en el periodo t a la misma instalación en el periodo t más uno. El flujo por esa arista es el inventario que se arrastra, su coste es el coste de mantenimiento y su capacidad es el límite de almacenamiento. El problema multiperiodo se convierte entonces en un flujo de coste mínimo corriente sobre un grafo T veces mayor, resoluble exactamente con el mismo algoritmo. La misma construcción modela la vida útil sin más que no construir la arista que llevaría stock más allá de su fecha de caducidad.
17. Referencias
Los artículos fundacionales y los textos de referencia, en orden cronológico.
- Hitchcock, F. L. (1941). “The distribution of a product from several sources to numerous localities.” Journal of Mathematics and Physics, 20(1–4), 224–230.
- Koopmans, T. C. (1949). “Optimum utilization of the transportation system.” Econometrica, 17 (Supplement), 136–146.
- Dantzig, G. B. (1951). “Application of the simplex method to a transportation problem.” In T. C. Koopmans (ed.), Activity Analysis of Production and Allocation, 359–373. New York: Wiley.
- Ford, L. R. y Fulkerson, D. R. (1956). “Maximal flow through a network.” Canadian Journal of Mathematics, 8, 399–404.
- Forrester, J. W. (1958). “Industrial dynamics: a major breakthrough for decision makers.” Harvard Business Review, 36(4), 37–66.
- Dantzig, G. B. y Ramser, J. H. (1959). “The truck dispatching problem.” Management Science, 6(1), 80–91.
- Kelley, J. E. y Walker, M. R. (1959). “Critical-path planning and scheduling.” Proceedings of the Eastern Joint Computer Conference, 160–173.
- Ford, L. R. y Fulkerson, D. R. (1962). Flows in Networks. Princeton: Princeton University Press.
- Clarke, G. y Wright, J. W. (1964). “Scheduling of vehicles from a central depot to a number of delivery points.” Operations Research, 12(4), 568–581.
- Balinski, M. L. (1965). “Integer programming: methods, uses, computation.” Management Science, 12(3), 253–313.
- Geoffrion, A. M. y Graves, G. W. (1974). “Multicommodity distribution system design by Benders decomposition.” Management Science, 20(5), 822–844.
- Orlicky, J. (1975). Material Requirements Planning. New York: McGraw-Hill.
- Ahuja, R. K., Magnanti, T. L. y Orlin, J. B. (1993). Network Flows: Theory, Algorithms, and Applications. Englewood Cliffs: Prentice Hall.
- Lee, H. L., Padmanabhan, V. y Whang, S. (1997). “Information distortion in a supply chain: the bullwhip effect.” Management Science, 43(4), 546–558.
- Sheffi, Y. (2005). The Resilient Enterprise: Overcoming Vulnerability for Competitive Advantage. Cambridge, Massachusetts: MIT Press.
- Toth, P. and Vigo, D. (eds.) (2014). Vehicle Routing: Problems, Methods, and Applications, 2.ª edición. Philadelphia: SIAM.
- Simchi-Levi, D., Schmidt, W., Wei, Y., Zhang, P. Y., Combs, K., Ge, Y., Gusikhin, O., Sanders, M. y Zhang, D. (2015). “Identifying risks and mitigating disruptions in the automotive supply chain.” Interfaces, 45(5), 375–390.
- Chopra, S. y Meindl, P. (2015). Supply Chain Management: Strategy, Planning, and Operation, 6.ª edición. Boston: Pearson.