
Table des Matières
- 1. Pourquoi une chaîne logistique est un graphe
- 2. L’anatomie : sommets, arcs et les nombres qu’ils portent
- 3. Le réseau qui sert de fil conducteur
- 4. Délai : plus courts chemins
- 5. Capacité : flot maximal et la coupe qui vous limite
- 6. Coût : le problème de transport et le flot de coût minimal
- 7. Quels entrepôts devraient exister ?
- 8. Concevoir le réseau physique : arbres couvrants
- 9. Le dernier kilomètre : les tournées de véhicules
- 10. Dans l’usine : matières et plannings
- 11. Résilience : ce qui casse, et à quel point
- 12. Deux astuces de modélisation à connaître
- 13. Ce qui est facile, ce qui est difficile
- 14. Du modèle à la pratique
- 15. Erreurs de modélisation qui produisent des réponses fausses et assurées
- 16. Questions fréquentes
- 17. Références
1. Pourquoi une chaîne logistique est un graphe
Une chaîne logistique est un ensemble de lieux et un ensemble de mouvements entre eux. Les fournisseurs livrent les usines, les usines livrent les entrepôts, les entrepôts livrent les magasins, et de chaque mouvement possible on peut dire quelque chose de vrai ou de faux : il existe ou non, il coûte tant par unité, il prend tant de jours, il peut transporter au plus tant par semaine.
Cette description est déjà un graphe. Les lieux sont des sommets, les mouvements des arcs orientés, et les données commerciales des nombres attachés aux arcs. Rien n’a encore été simplifié, et dès que le modèle existe, un siècle d’algorithmes devient disponible : le plus court chemin répond à « en combien de temps ceci atteint cela », le flot maximal à « combien pouvons-nous réellement livrer », le flot de coût minimal à « quel est le plan le moins cher », et la connexité à « que se passe-t-il si ceci brûle ».
Ce n’est pas une métaphore inventée pour l’enseignement. Les mathématiques des chaînes logistiques sont l’optimisation de réseaux. Hitchcock a posé le problème de transport en 1941 et Koopmans y est arrivé indépendamment dans un travail présenté en 1947 et publié en 1949 ; Dantzig l’a résolu par la méthode du simplexe en 1951 ; Ford et Fulkerson ont publié l’algorithme de flot maximal en 1956 et le livre Flows in Networks en 1962, et leurs exemples étaient la capacité ferroviaire et la planification des expéditions, pas des graphes abstraits. La discipline qui a tout formalisé est la recherche opérationnelle, et ses objets centraux sont des graphes.
Ce que fait cet article, c’est prendre un petit réseau à quatre niveaux et y répondre à toutes les questions classiques d’une chaîne logistique. Chaque nombre cité plus bas a été calculé en résolvant le modèle, pas estimé : les plans, les goulots, les manques après une panne et le coût de chaque option. Si le vocabulaire de base vous est nouveau, l’ introduction à la théorie des graphes couvre les définitions que cet article suppose connues.
2. L’anatomie : sommets, arcs et les nombres qu’ils portent
Modéliser, c’est décider ce que l’on garde. Trois décisions portent l’essentiel du poids.
Qu’est-ce qu’un sommet ? En général un lieu physique : un site fournisseur, une usine, un centre de distribution, une région client. Parfois plus fin, comme une ligne de production ou un quai de chargement, parfois plus grossier, comme un pays entier dans une étude stratégique. La règle : un sommet est tout ce que vous pourriez vouloir ouvrir, fermer, contraindre ou perdre, car ce sont les questions que l’on posera au modèle.
Qu’est-ce qu’un arc ? Une liaison : une origine, une destination et le plus souvent un mode. Les deux mêmes sites reliés par la route et par les airs sont deux arcs, pas un, car ils ont des coûts, des durées et des capacités différents. Les arcs sont orientés, puisque expédier vers l’est n’est pas la même chose qu’expédier vers l’ouest ; la distinction et ses conséquences sont traitées dans graphes orientés et non orientés.
Que met-on sur l’arc ? Au moins trois nombres, et ils répondent à des questions différentes : le choix compte donc.
- Capacité, en unités par période. Elle limite le possible et alimente le flot maximal.
- Coût, par unité expédiée. Il décide de ce qui est le moins cher et alimente le flot de coût minimal.
- Temps de transit, en jours. Il décide de ce qui est rapide et alimente le plus court chemin.
Les débutants regroupent souvent tout cela en un seul « poids », puis s’étonnent que la réponse paraisse fausse. Ce sont de véritables objectifs distincts, et la route la moins chère n’est souvent pas la plus rapide, comme le montre la section 4 sur ce réseau même. Le guide sur les graphes pondérés et non pondérés fait le même constat dans l’abstrait.
Deux autres attributs vivent sur les sommets plutôt que sur les arcs : l’offre aux sources, la demande aux puits, et parfois un coût fixe pour qu’un site existe tout court, ce qui transforme un problème de flot en problème de localisation à la section 7.
3. Le réseau qui sert de fil conducteur
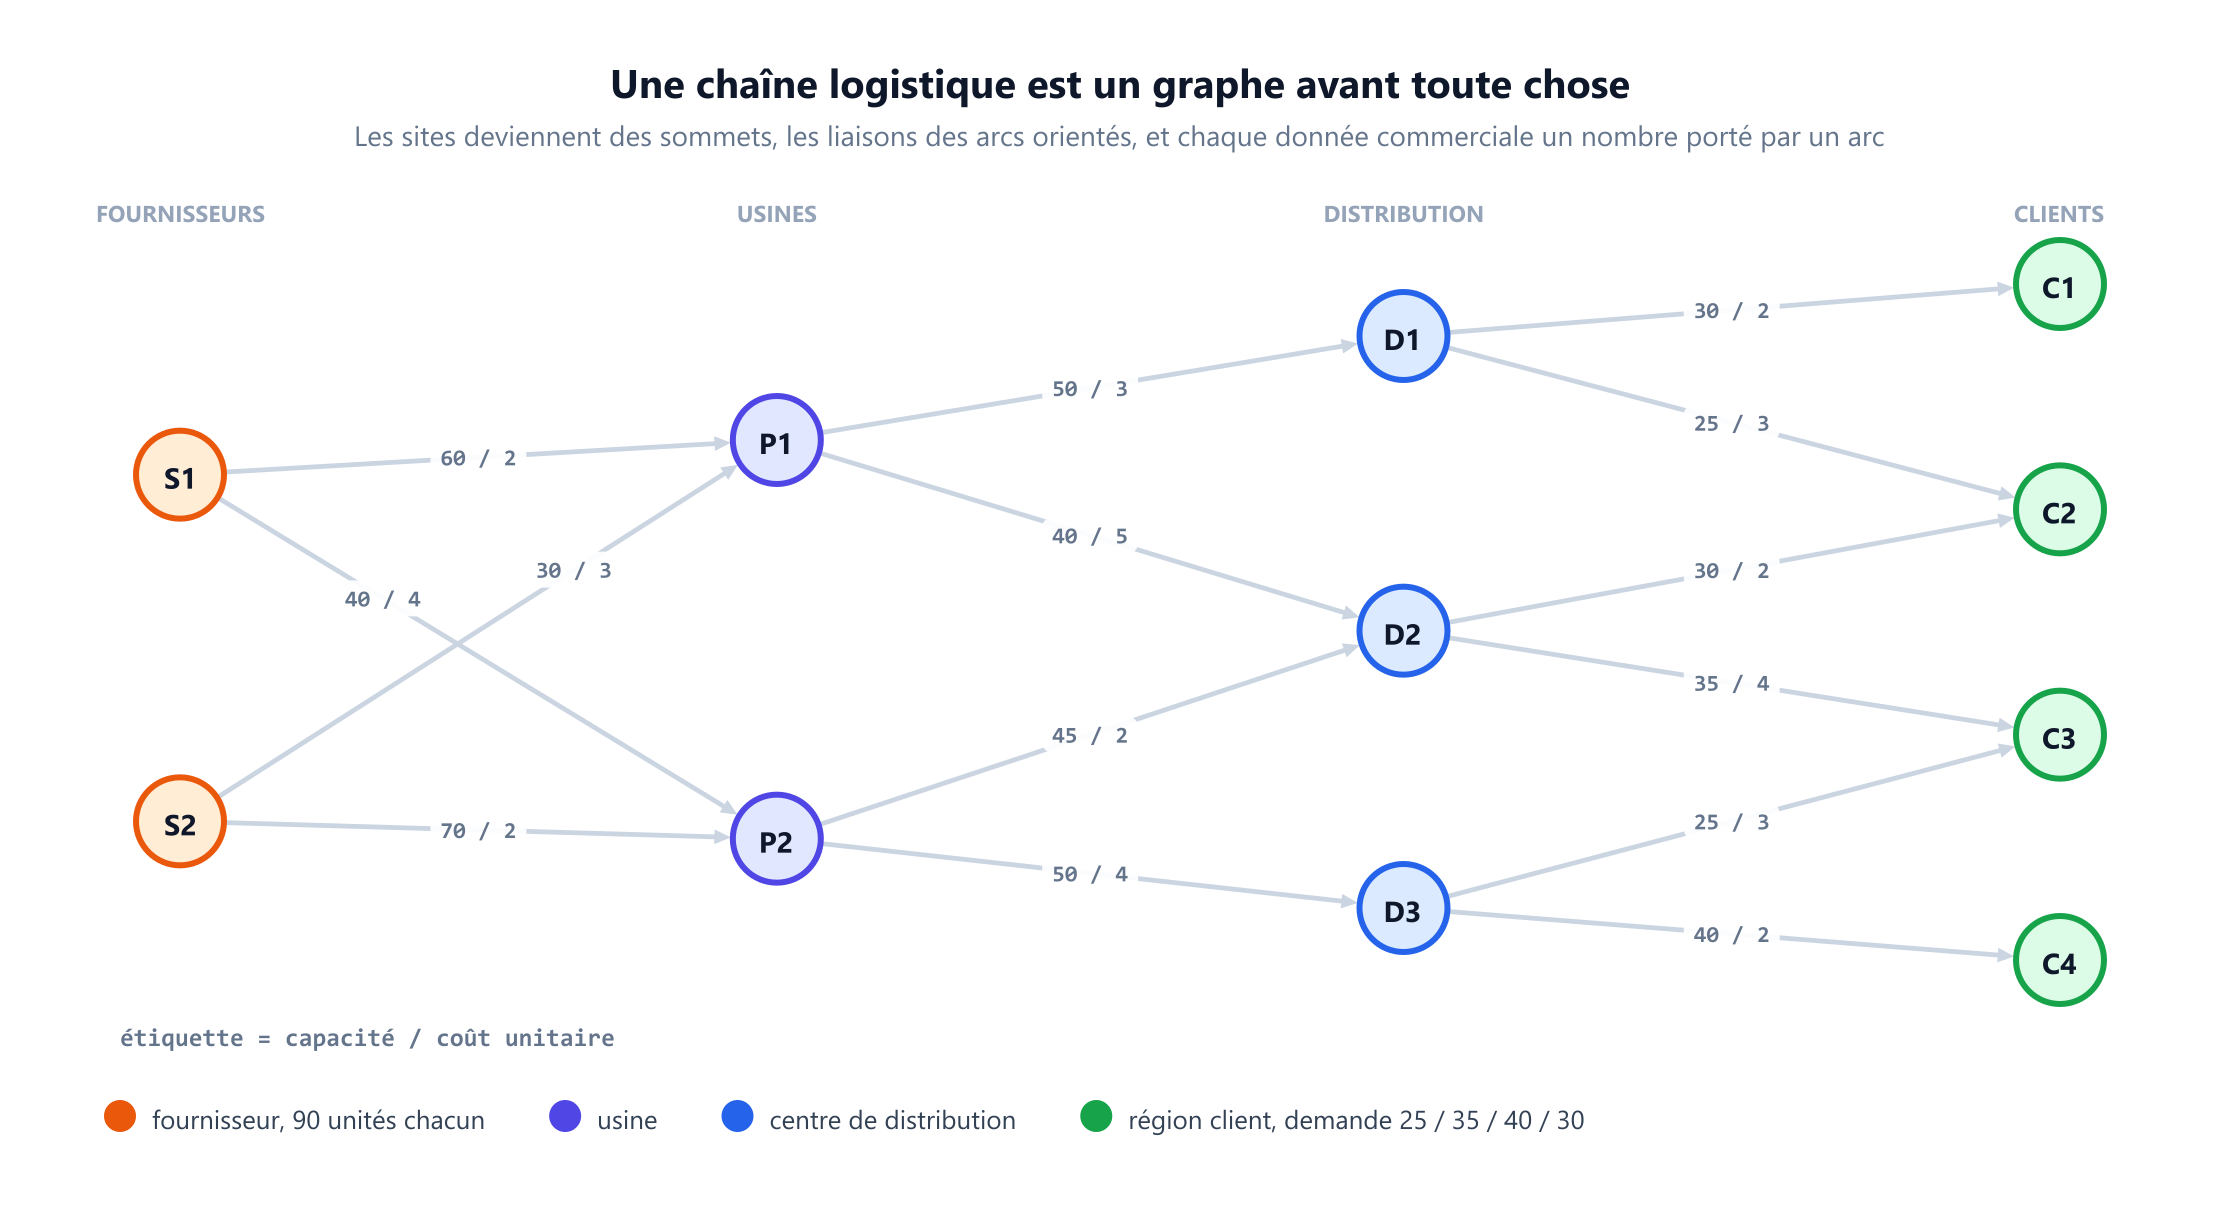
L’exemple est volontairement assez petit pour être vérifié à la main et assez riche pour casser de façons intéressantes. Deux fournisseurs alimentent deux usines, les usines alimentent trois centres de distribution, et les centres servent quatre régions clients.
| Niveau | Sommets | Nombres |
|---|---|---|
| Fournisseurs | S1, S2 | 90 unités par semaine disponibles chez chacun |
| Usines | P1, P2 | Transforment l’approvisionnement en produits finis |
| Centres de distribution | D1, D2, D3 | Capacités de 55, 75 et 65 unités |
| Clients | C1, C2, C3, C4 | Demande de 25, 35, 40 et 30, soit 130 au total |
Chacune des quatorze liaisons porte une capacité, un coût unitaire et un temps de transit, comme dessiné sur la figure ci-dessus. L’offre totale est de 180 contre une demande de 130 : dans le cas de base il y a donc du mou, et la section 5 le supprime.
Un détail structurel compte avant tout algorithme. Le réseau est un graphe orienté acyclique : la matière ne va jamais que de gauche à droite, de l’offre vers la demande. Les vraies chaînes ont des retours, des boucles de reprise et des transferts entre entrepôts, qui créent tous des cycles, et les algorithmes ci-dessous fonctionnent quand même. Mais le cas acyclique est celui où l’intuition est la plus nette, et c’est là que vivent réellement la plupart des modèles de planification tactique.
Deuxième détail : c’est un modèle mono-produit, mono-période uniquement. Cette hypothèse fait beaucoup de travail, et la section 12 montre la construction de graphe standard qui la lève.
4. Délai : plus courts chemins
La première question que l’on pose à un réseau est sa rapidité de réaction. Avec des temps de transit sur les arcs, c’est exactement le problème du plus court chemin, et l’ algorithme de Dijkstra y répond pour toutes les destinations d’un coup en O(m + n log n).
Résolu depuis chaque fournisseur, il donne le tableau de service :
| Depuis | C1 | C2 | C3 | C4 |
|---|---|---|---|---|
| S1 | 6 jours S1-P1-D1-C1 | 7 jours S1-P1-D1-C2 | 9 jours S1-P2-D3-C3 | 8 jours S1-P2-D3-C4 |
| S2 | 7 jours S2-P1-D1-C1 | 6 jours S2-P2-D2-C2 | 6 jours S2-P2-D3-C3 | 5 jours S2-P2-D3-C4 |
Trois choses ressortent de ce tableau qu’un tableur ne vous aurait pas dites. Le pire service du réseau est de 9 jours, de S1 vers C3, et c’est le nombre sur lequel un engagement de service doit être écrit. Les deux fournisseurs ne sont pas interchangeables : S1 est plus rapide vers C1, S2 est plus rapide vers tout le reste, ce qui plaide pour un double sourcing par région plutôt que par volume. Et la route la plus rapide de S1 vers C3 passe par P2, pas par le P1 géographiquement évident, parce que la branche P1 est plus lente à chaque étape.
Comparez maintenant avec le coût. La liaison la moins chère au départ de S1 est S1 → P1 à 2 par unité, et la route la plus rapide vers C3 l’évite entièrement. Minimiser des jours et minimiser de l’argent sont deux optimisations différentes sur le même graphe, et tout outil de planification qui propose une seule « meilleure route » en choisit une pour vous, sans le dire. L’arbre de décision complet des algorithmes selon la variante est dans algorithmes de plus court chemin.
Deux extensions pratiques méritent d’être connues. Ajouter un temps de manutention fixe dans chaque site se fait en posant le délai sur le sommet, que la section 12 transforme en arc. Et quand la question devient « quelle est la route la plus rapide qui coûte aussi moins que X », vous avez un plus court chemin sous contrainte, NP-difficile en général et résolu le plus souvent par relaxation lagrangienne ou par un algorithme d’étiquetage plutôt que par un Dijkstra simple.
5. Capacité : flot maximal et la coupe qui vous limite
La deuxième question est la quantité que le réseau peut réellement déplacer. Ajoutez une source artificielle qui alimente les deux fournisseurs avec leur volume disponible, et un puits artificiel qui tire la demande de chaque client, et la réponse est un calcul de flot maximal sur ce réseau.
Dans le cas de base, la réponse est sans drame : les 130 unités passent toutes. Ce qui est intéressant, c’est où se situe la contrainte qui mord. Résoudre le problème de flot produit aussi la coupe minimale, et ici la coupe est formée des arcs clients eux-mêmes. En clair : rien à l’intérieur du réseau ne limite quoi que ce soit, et la seule raison pour laquelle il ne circule pas plus d’unités est que personne n’en a commandé davantage. C’est le cas sain, et il vaut la peine de le confirmer avant de demander à quiconque d’approuver un investissement.
Augmentez maintenant chaque demande de 40 %, une haute saison modérée. La demande passe à 182 unités, et le réseau en livre 164.
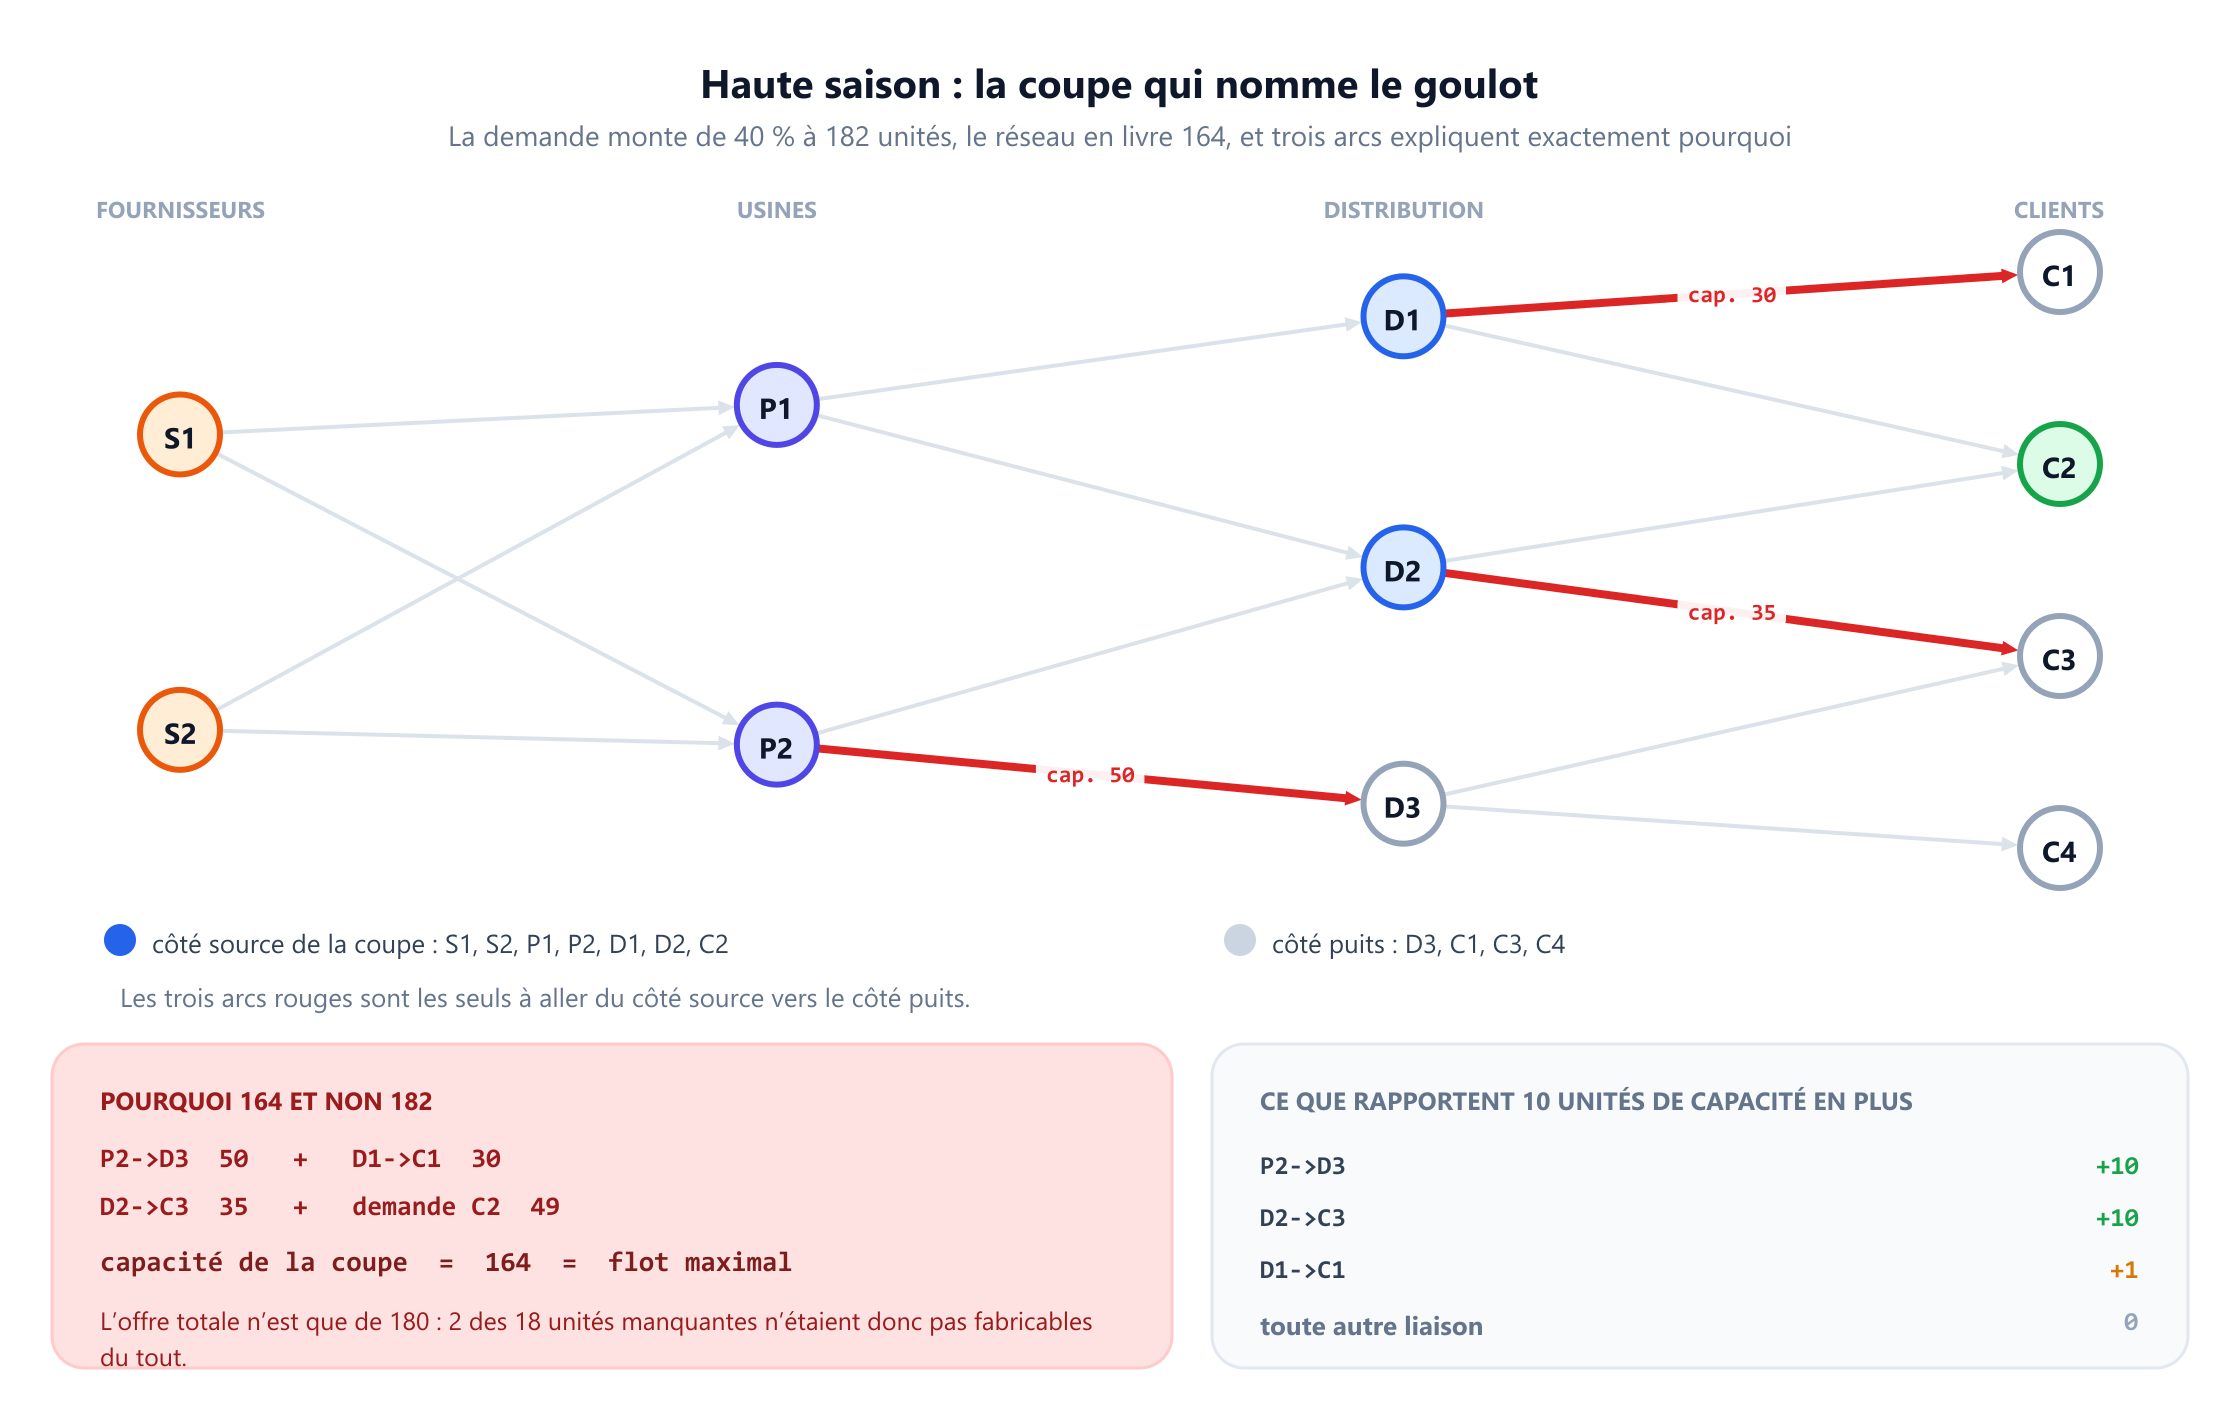
Les 18 unités manquantes se décomposent précisément. L’offre totale est de 180, donc 2 unités n’étaient pas fabricables quel que soit le réseau. Les 16 autres sont perdues par la structure, et la coupe minimale nomme cette structure exactement : P2 → D3 de capacité 50, D1 → C1 de 30, D2 → C3 de 35, plus les 49 unités de demande de C2 qui se trouvent côté source. Cela fait 164, ce que le théorème flot maximal coupe minimale garantit être égal au flot maximal, et l’arithmétique le confirme.
C’est la chose la plus utile que la théorie des graphes fasse pour une chaîne logistique, alors disons-le clairement. La coupe minimale est la liste des investissements. De la capacité ajoutée ailleurs ne change rien du tout. Tester cette affirmation sur ce réseau donne un résultat qu’aucune intuition ne produirait :
- 10 unités de plus sur
P2 → D3: le débit passe de 164 à 174. - 10 unités de plus sur
D2 → C3: également 174. - 10 unités de plus sur
D1 → C1: le débit monte à 165, et pas plus. Une unité, pas dix. - 10 unités de plus sur l’une des onze autres liaisons : aucun changement.
Le cas D1 → C1 est le plus instructif. Cette liaison est bien sur la coupe minimale, donc la première unité de capacité supplémentaire aide, mais ensuite une autre contrainte mord et l’investissement cesse de payer. Une coupe vous dit où est le mur aujourd’hui ; elle ne promet pas qu’il restera au même endroit une fois déplacé. En pratique, c’est pourquoi la planification de capacité se mène comme une suite de nouveaux calculs plutôt que comme un classement unique.
6. Coût : le problème de transport et le flot de coût minimal
La faisabilité n’est pas un plan. La question opérationnelle est de savoir lequel des nombreux plans faisables est le moins cher, et c’est le problème du flot de coût minimal : satisfaire toute la demande, respecter toutes les capacités, minimiser la somme des flots multipliés par les coûts sur tous les arcs.
Son ancêtre est le problème de transport, posé par Hitchcock en 1941 et indépendamment par Koopmans, puis résolu efficacement par Dantzig en 1951 avec un simplexe spécialisé. La forme générale moderne se résout par l’algorithme du simplexe de réseau ou par plus courts chemins successifs, et le Network Flows d’Ahuja, Magnanti et Orlin reste le traitement de référence.
Résolu sur le réseau du fil conducteur, le moyen le moins cher de livrer les 130 unités coûte 1 020, soit en moyenne 7,85 par unité :
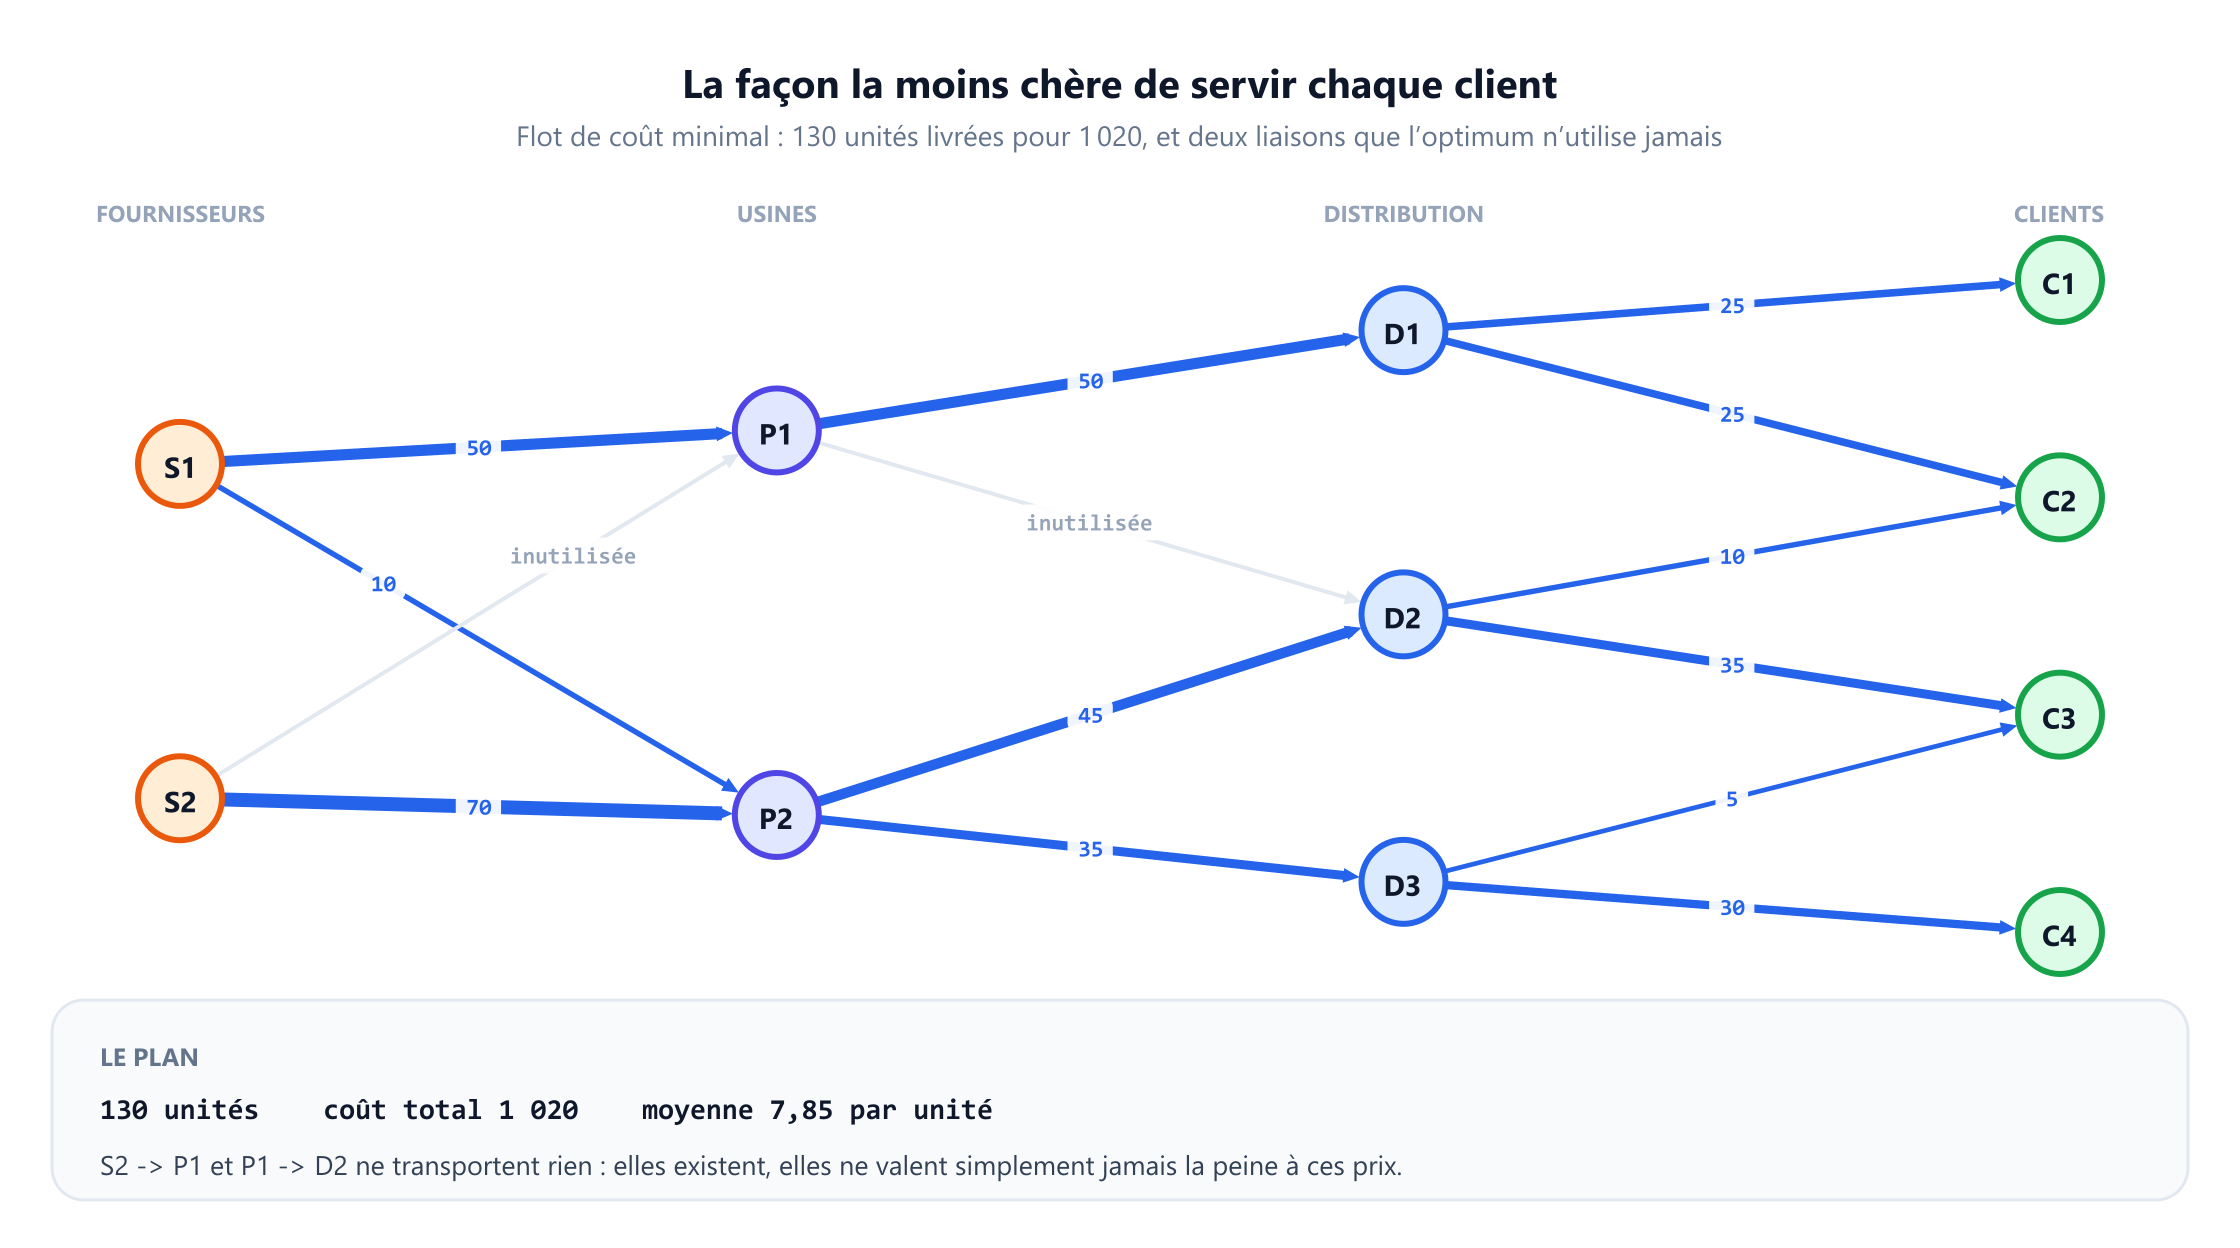
Trois traits de la solution méritent une lecture attentive, car ce sont ceux qui surprennent.
Deux liaisons ne portent rien. S2 → P1 et P1 → D2 sont parfaitement utilisables et ne valent jamais la peine à ces prix. Un schéma de réseau ne peut pas vous le dire ; seule l’optimisation le peut. C’est aussi la réponse à « pourquoi payons-nous l’entretien de cette liaison », une question qui mérite d’être posée chaque année.
La demande est répartie. C2 reçoit 25 unités de D1 et 10 de D2, et C3 reçoit 35 de D2 et 5 de D3. Servir chaque client depuis son centre le plus proche est une règle empirique, pas un optimum, et ici cela coûterait plus cher. Les modèles réels ajoutent souvent une contrainte interdisant les fractionnements, et le prix de cette contrainte devrait être mesuré plutôt que supposé.
La réponse est tombée en unités entières. Ce n’est pas de la chance. La matrice des contraintes d’un problème de flot est totalement unimodulaire : quand les offres et les demandes sont entières, le programme linéaire a automatiquement une solution optimale entière. C’est pourquoi on résout les problèmes de flot comme des programmes linéaires tout en obtenant des réponses expédiables, et c’est exactement ce qui tombe dès qu’on ajoute une décision binaire « ouvert ou fermé », le sujet de la section suivante.
7. Quels entrepôts devraient exister ?
Tout ce qui précède prenait le réseau comme donné. La question stratégique est de savoir quels sites devraient exister, et elle change complètement les mathématiques : ouvrir un site coûte un montant fixe qu’il expédie une unité ou mille, et un coût fixe ne s’exprime pas comme un coût unitaire sur un arc.
Donnez aux trois centres de distribution un coût fixe hebdomadaire de 250, 300 et 200, des capacités de 55, 75 et 65 unités, et un coût unitaire pour servir chaque région client. La question devient alors quel sous-ensemble ouvrir, et pour chaque sous-ensemble candidat le coût de service est lui-même un problème de transport. Avec trois sites, il y a sept sous-ensembles et nous pouvons simplement tous les résoudre.
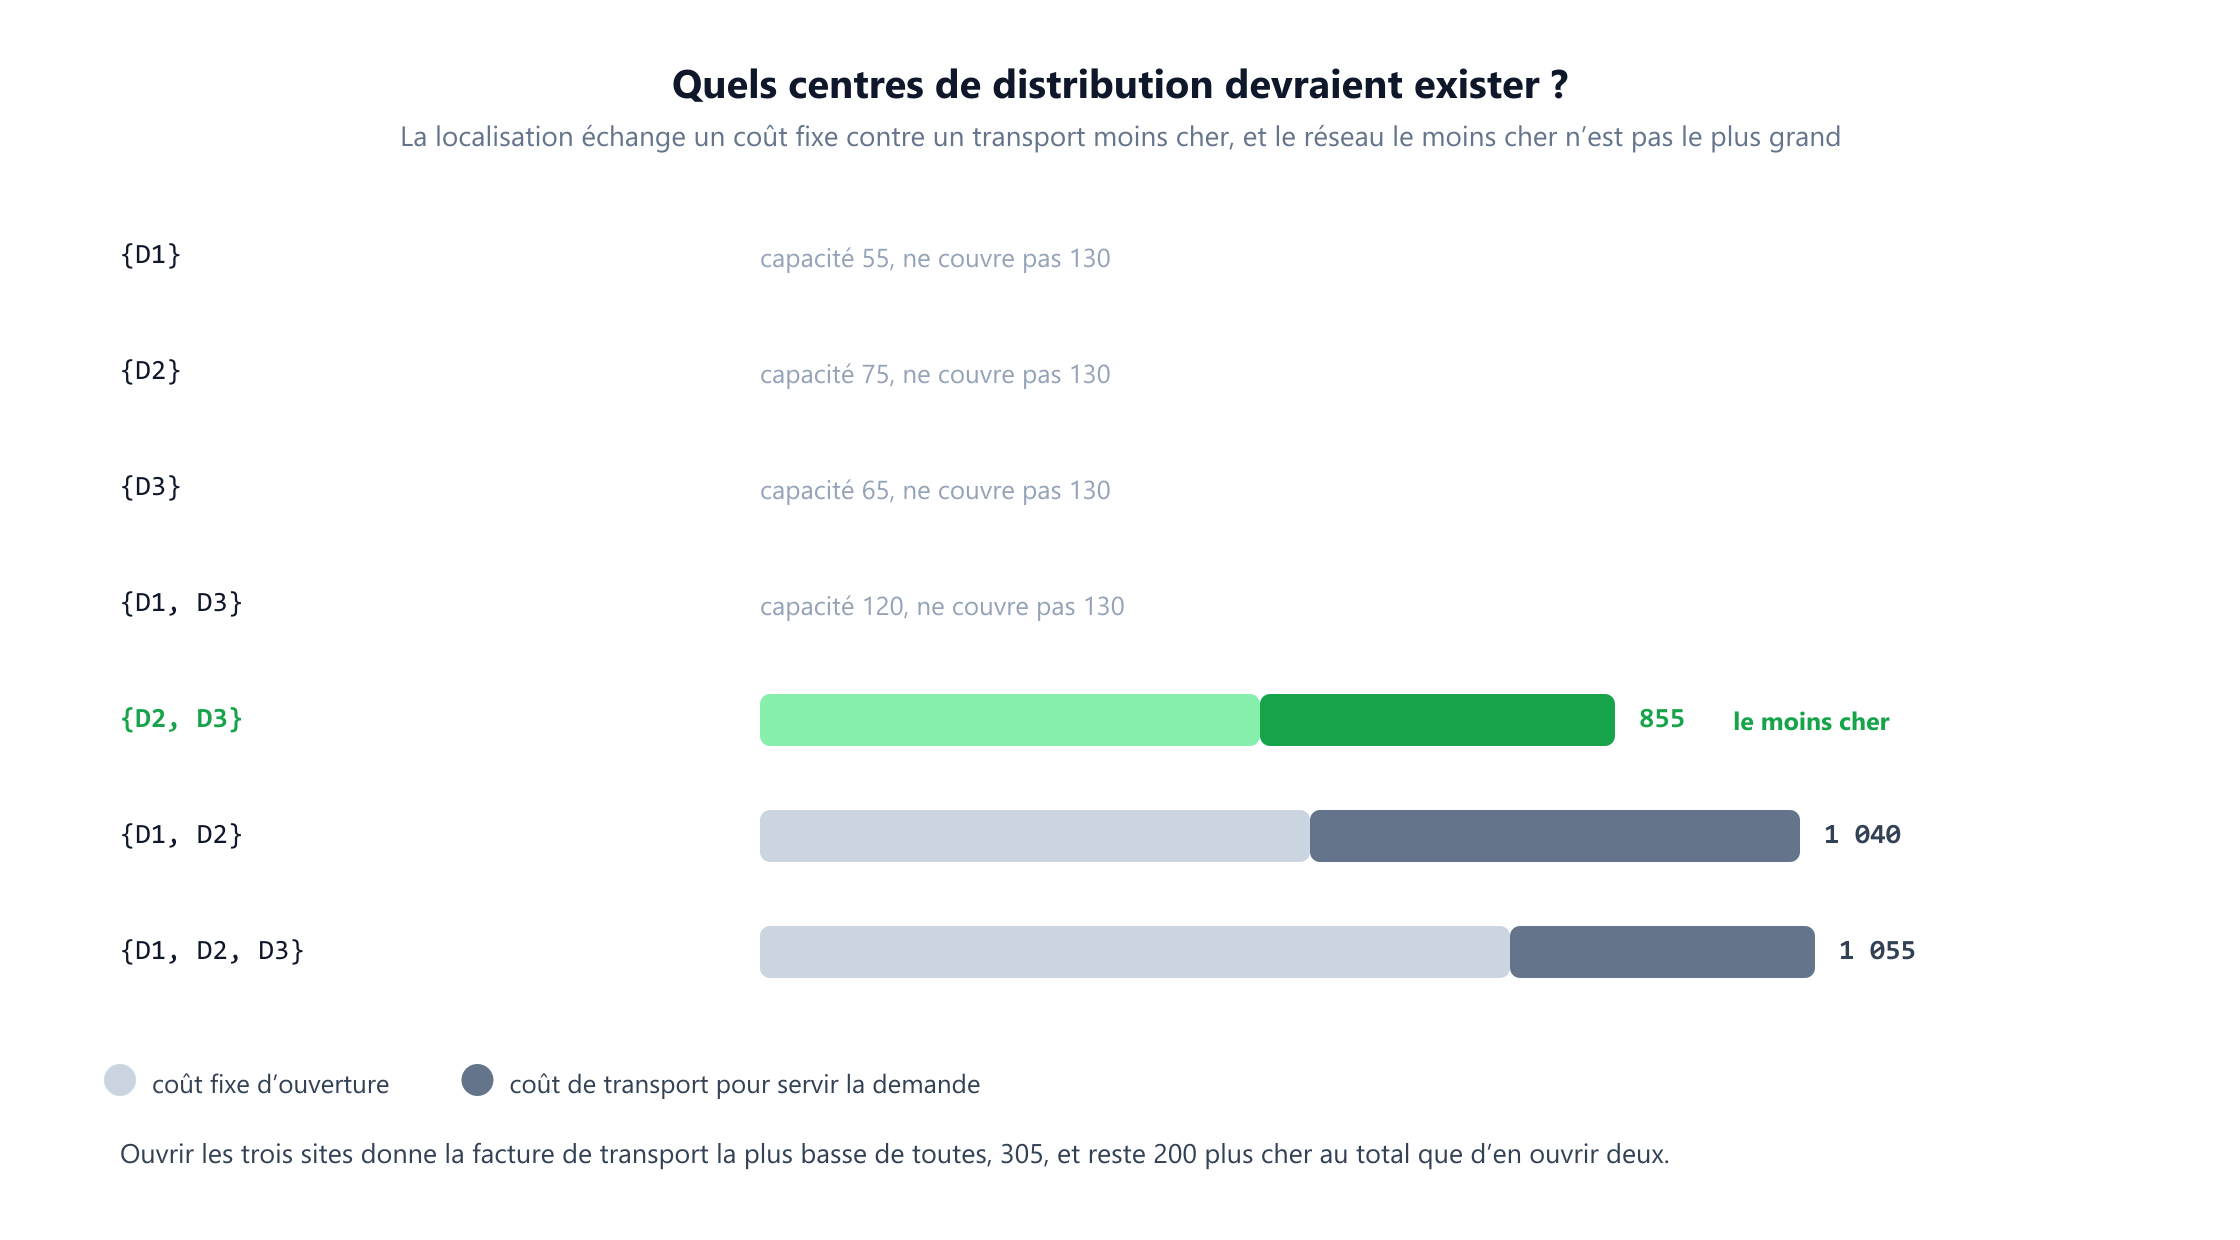
Le gagnant est {D2, D3} à 855 : 500 de coût fixe et 355 de transport. Le résultat qui compte sur le plan pédagogique est la dernière ligne. Ouvrir les trois centres produit le coût de transport le plus bas de toutes les configurations, 305, parce que chaque client peut alors être servi depuis sa source la moins chère. C’est malgré tout 200 plus cher au total, car les 250 de coût fixe du troisième site n’achètent que 50 d’économies de transport. Optimiser le flot à l’intérieur d’un réseau déjà surdimensionné est un bon moyen de se tromper efficacement.
C’est le problème de localisation avec capacités, et contrairement à tout ce qui se trouve dans les sections 4 à 6, il est NP-difficile. Avec trois sites candidats, la force brute sur huit sous-ensembles est instantanée. Avec trois cents, elle ne l’est plus, et la discipline le résout par programmation linéaire en nombres entiers : Balinski a donné la formulation standard en 1965, Geoffrion et Graves ont résolu une vraie conception de distribution multiproduit par décomposition de Benders en 1974, et les solveurs modernes traitent des instances industrielles en routine. La structure qui rend cela traitable en pratique est exactement celle qu’on voit ici : pour tout ensemble fixé de sites ouverts, le problème restant est un flot qui se résout en temps polynomial. Un exemple plus complet, avec distances routières, heuristiques classiques d’implantation et le prix d’une promesse de service, se trouve dans localisation d’installations : où placer le prochain entrepôt.
8. Concevoir le réseau physique : arbres couvrants
Une autre question de conception n’est pas « où placer les sites » mais « quelles liaisons construire ». Poser une ligne privée, affréter une navette dédiée ou construire un embranchement ferroviaire a un coût par liaison, et l’exigence est que chaque site puisse en atteindre tous les autres.
C’est le problème de l’arbre couvrant minimal et il est résolu par l’algorithme de Kruskal en O(m log n). Sur six sites, deux usines, trois centres et un hub de cross-docking partagé, avec onze liaisons possibles facturées entre 3 et 10, la conception connexe la moins chère coûte 21 et utilise cinq liaisons : P2-H à 3, P1-D1 à 4, D2-H à 4, P2-D3 à 5 et D1-H à 5.
Cinq liaisons pour six sites, ce n’est pas un hasard. Un arbre à n sommets a toujours exactement n - 1 arêtes, et c’est l’arbitrage qui définit toute l’approche : un arbre couvrant est la façon la moins chère de tout relier, et c’est aussi la plus fragile. Chacune de ces cinq liaisons est un isthme, c’est-à-dire que sa perte déconnecte le réseau, et trois des six sites sont des points d’articulation. La section 11 chiffre ce que cela coûte.
La leçon pratique est que l’arbre couvrant minimal est le bon algorithme pour le mauvais objectif dans la plupart des situations logistiques. Ce que l’on veut d’ordinaire, c’est le réseau le moins cher qui survit à la perte de n’importe quelle liaison, autrement dit la conception de réseaux deux-arête-connexes au sens de la théorie des graphes, et ce problème est NP-difficile. L’arbre couvrant minimal vaut quand même d’être calculé, car c’est une borne inférieure : aucune conception connexe ne peut coûter moins, il vous donne donc le prix de la redondance que vous vous apprêtez à acheter.
9. Le dernier kilomètre : les tournées de véhicules
Tout ce qui précède déplace des unités entre sites. Le dernier segment les amène aux portes, et c’est là qu’est engagée une grande part du coût de distribution et que les mathématiques deviennent difficiles.
Donnez à un véhicule un ensemble d’arrêts et demandez la tournée la plus courte qui passe par chacun exactement une fois et revient au dépôt : vous avez le problème du voyageur de commerce. Donnez à une flotte des capacités et demandez quel véhicule sert quels arrêts : vous avez le problème de tournées de véhicules, introduit par Dantzig et Ramser en 1959 sous le nom de « the truck dispatching problem » et généralisé depuis aux fenêtres horaires, aux flottes mixtes, à la collecte et livraison et aux temps de conduite.
La différence avec les sections 4 à 6 est de nature, pas de degré. Plus court chemin, flot maximal et flot de coût minimal sont tous polynomiaux : un solveur moderne traite un réseau routier continental en moins d’une seconde. Le TSP et le VRP sont NP-difficiles, et le nombre de tournées possibles sur n arrêts vaut (n-1)!/2, ce qui dépasse 60 millions de milliards dès 20 arrêts. C’est pourquoi la pratique tourne aux heuristiques : l’algorithme des économies de Clarke et Wright, de 1964, reste une méthode de construction standard, la recherche locale comme 2-opt et Or-opt améliore le résultat, et des métaheuristiques comme la recherche à grand voisinage font tourner les moteurs commerciaux. Les méthodes exactes ont aussi énormément progressé, et des instances de plusieurs centaines de clients sont aujourd’hui résolues à l’optimalité prouvée, mais la répartition quotidienne se fait par heuristiques parce qu’il faut répondre en quelques minutes.
Le point de modélisation à retenir : la couche des tournées se place au-dessus de la couche des flots. Le modèle de flot décide que D3 expédie 30 unités vers la région C4 ; le modèle de tournées décide l’ordre des portes à l’intérieur de C4 et quel camion s’en charge. Les optimiser conjointement est possible et c’est ce que tentent les systèmes de planification intégrée, mais la séparation en deux étapes est la norme car chaque étape est difficile pour une raison différente. Pour la couche des tournées traitée de bout en bout et chiffrée en coûts de flotte, voyez optimisation des tournées de livraison.
10. Dans l’usine : matières et plannings
Zoomez sur une seule usine et les graphes ne s’arrêtent pas. Deux d’entre eux font tourner l’usine, et tous deux sont des graphes orientés acycliques auxquels une passe en ordre topologique répond.
Le premier est la nomenclature. Un produit est fait de composants, eux-mêmes faits de composants, et les arcs portent des quantités. Éclater une commande client en besoins de matières premières revient à parcourir ce graphe du haut vers le bas en multipliant au passage. C’est ce que fait le calcul des besoins nets, formalisé par Orlicky en 1975 et toujours la boucle centrale de tout ERP.
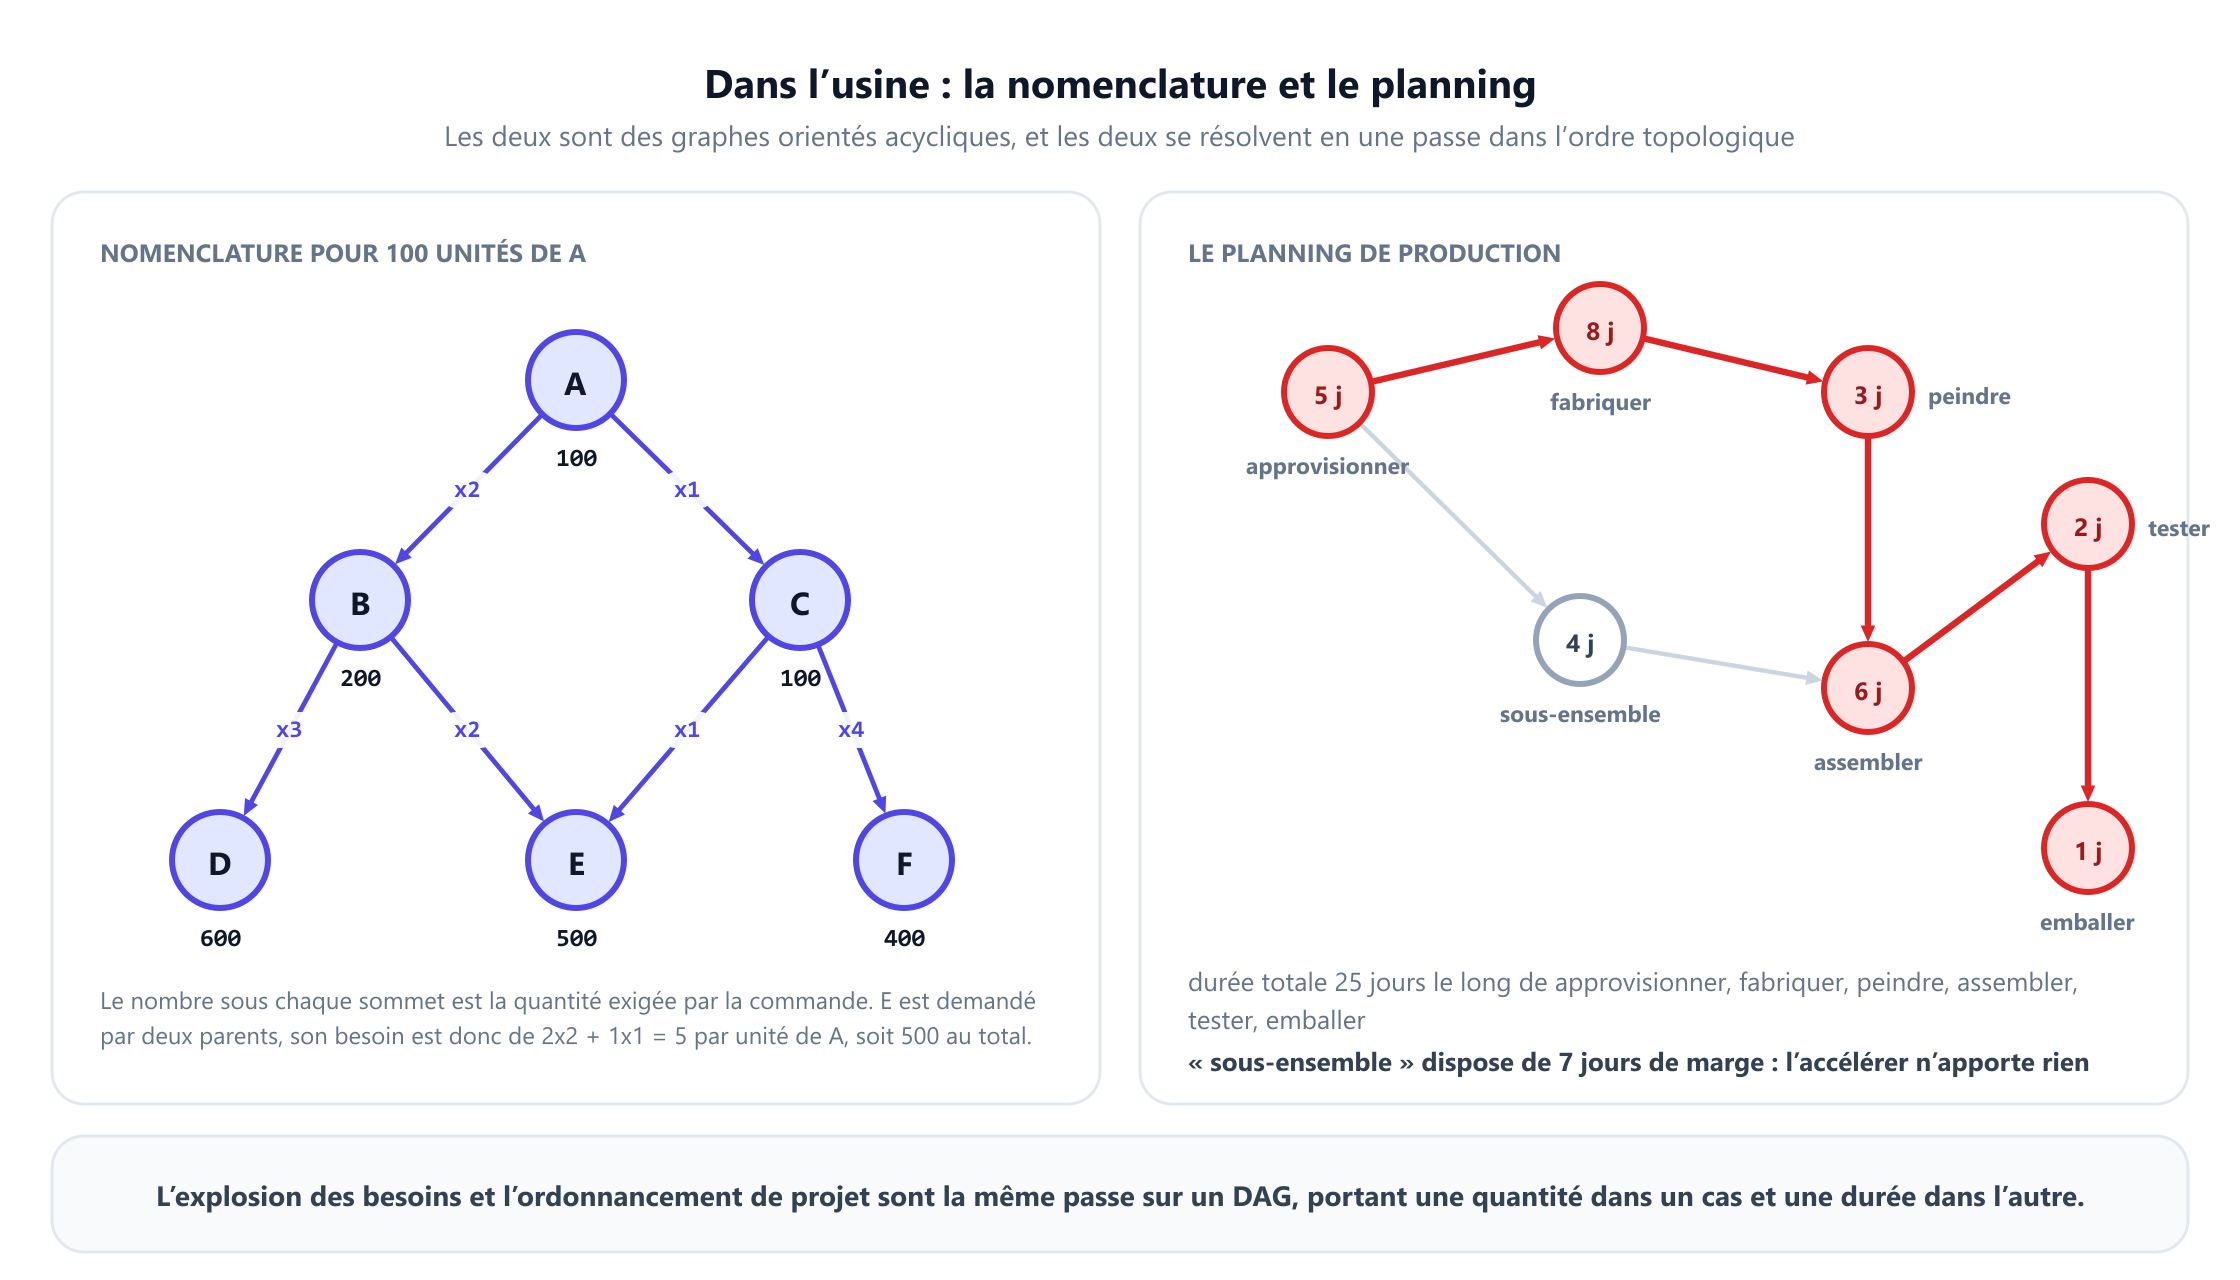
Pour une commande de 100 unités du produit A, l’explosion donne 200 de B, 100 de C, 600 de D, 500 de E et 400 de F. Le composant E mérite qu’on s’y arrête : il apparaît sous deux parents différents, son besoin est donc de 2 × 2 via B plus 1 × 1 via C, soit 5 par unité de A. Additionner les branches indépendamment, ce que fait un tableur naïf, compte en double ou en moins précisément ces composants partagés. Traiter les articles en ordre topologique garantit que chaque parent est définitif avant qu’un enfant soit lu, et c’est pourquoi la passe est correcte du premier coup.
Le second graphe est le planning. Les tâches ont des durées et des contraintes de précédence, et la durée du projet est le plus long chemin dans le DAG obtenu. Sur le plan à sept tâches de la figure, la durée totale est de 25 jours, le long de approvisionner, fabriquer, peindre, assembler, tester et emballer. Cette chaîne est le chemin critique, issu de la méthode de Kelley et Walker de 1959, et sa signification pratique est nette : tout retard sur elle retarde la commande d’autant, tandis que le sous-ensemble porte 7 jours de marge et pourrait glisser d’une semaine entière sans décaler la date de livraison d’une heure.
Notez l’asymétrie qui rend cela précieux. Le plus long chemin est NP-difficile sur un graphe quelconque et linéaire sur un DAG : l’ordonnancement est donc bon marché précisément parce que les contraintes de précédence ne peuvent pas former de cycle. Si elles en forment un, le plan est infaisable, et le même algorithme le détecte aussi. Séquencer les commandes clients sur les machines elles-mêmes, avec dates dues, changements de couleur et heures supplémentaires, est traité dans l’ordonnancement de production pour les industriels.
11. Résilience : ce qui casse, et à quel point
Un modèle de coûts vous dit quoi faire quand tout marche. Un modèle de résilience vous dit ce qui se passe quand ce n’est pas le cas, et c’est le même graphe avec une autre question : retirez un sommet, résolvez de nouveau le flot et lisez le manque.
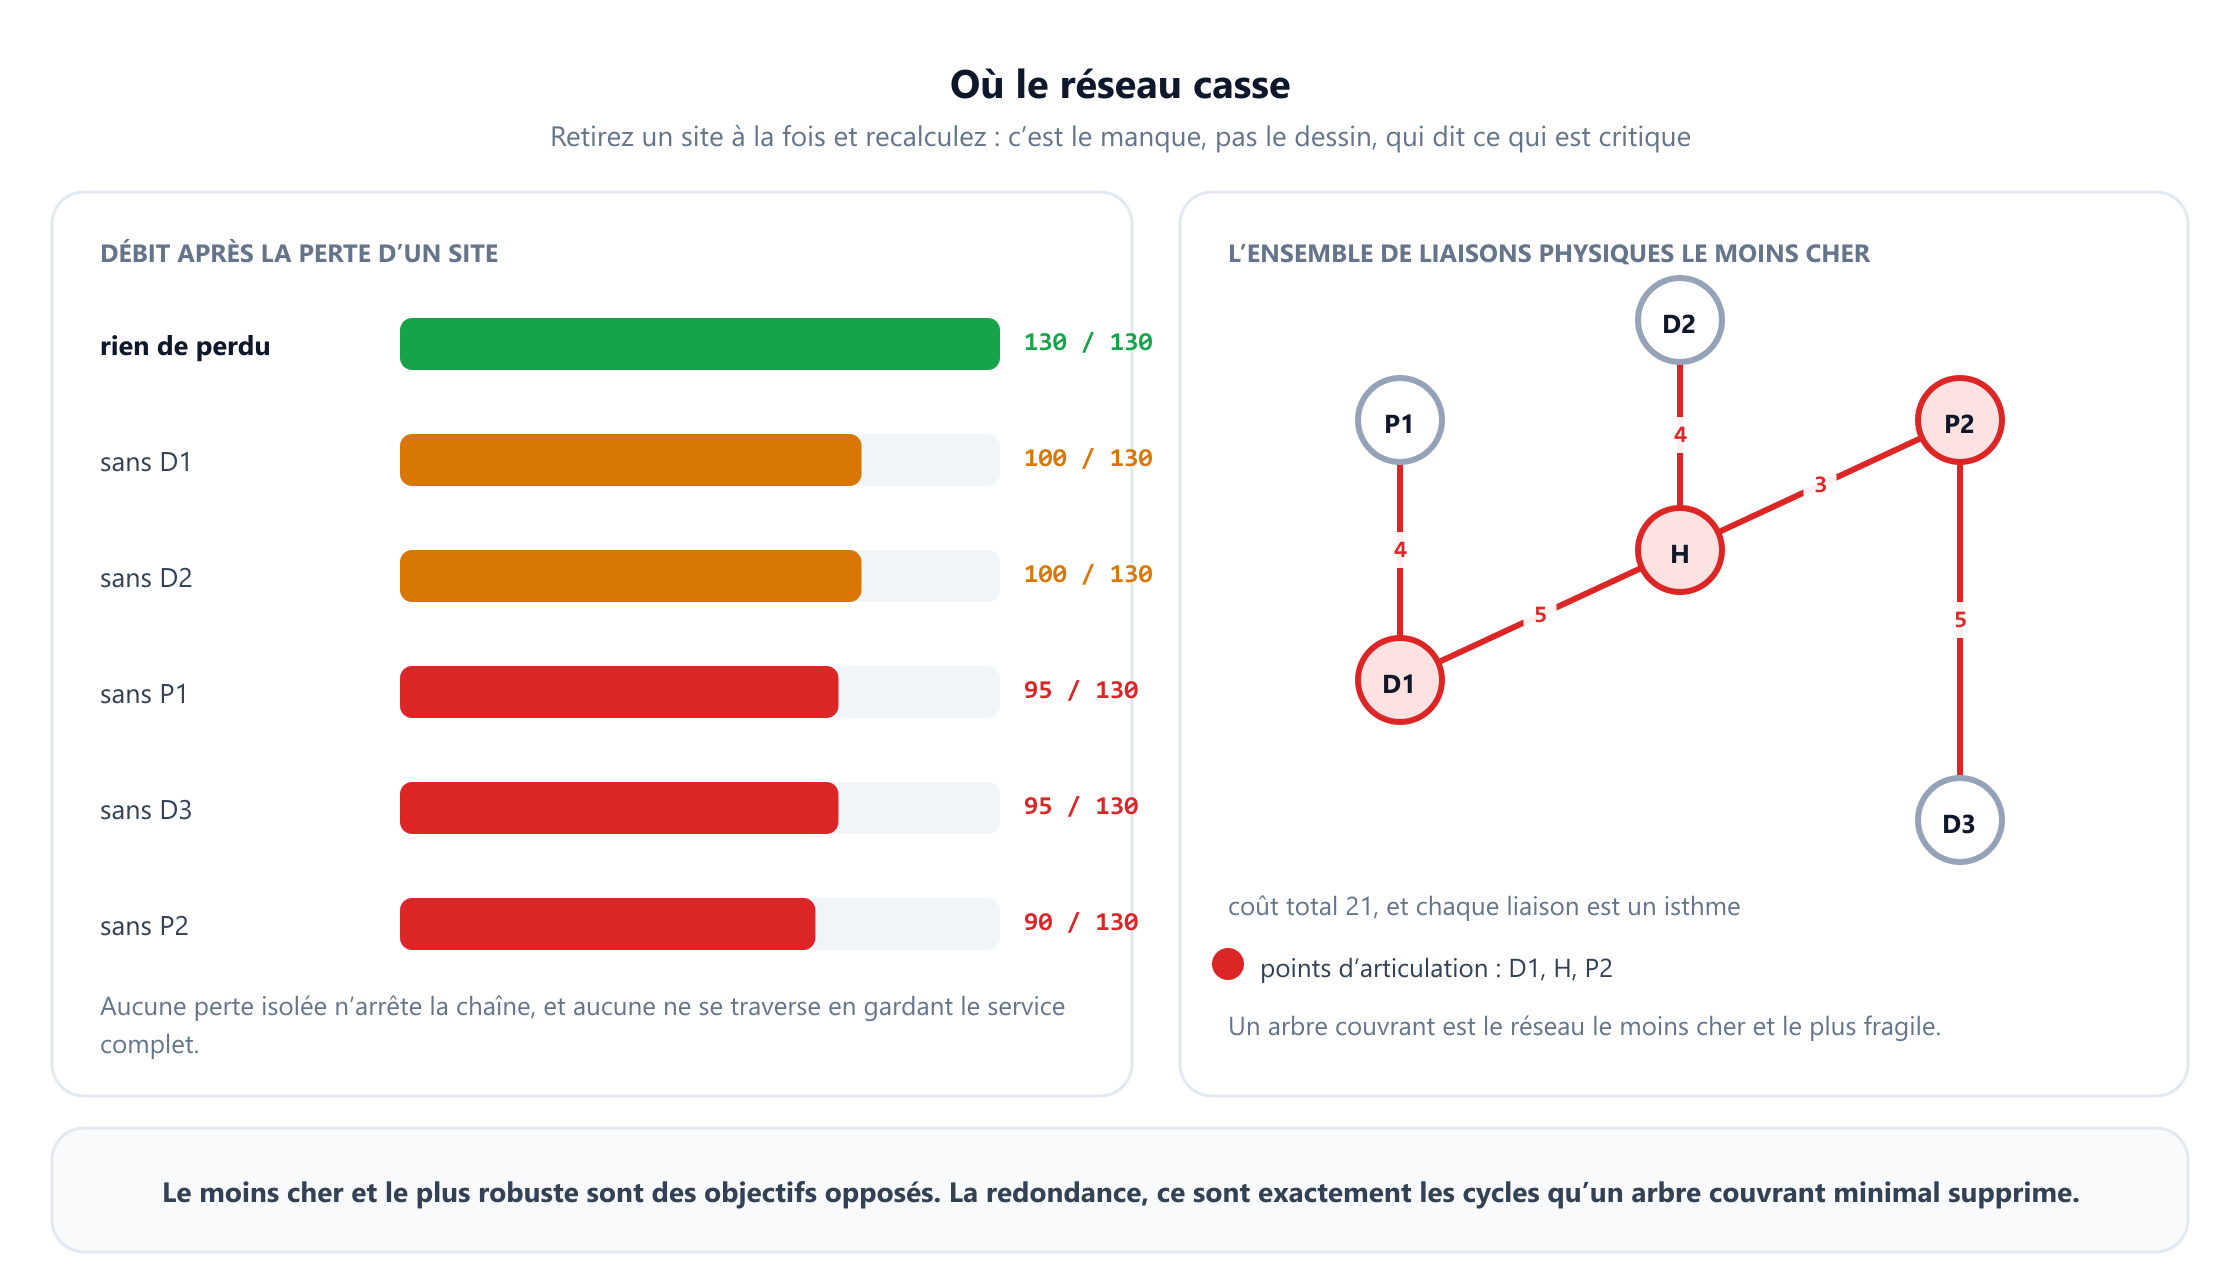
La perte d’un site quelconque laisse le réseau capable de livrer entre 90 et 100 des 130 unités. Le pire cas est P2, à 90 unités, un manque de 31 %, et ce résultat se lit utilement avec la section 6. Le plan le moins cher achemine 70 unités par S2 → P2 et 80 unités au total par P2, parce que P2 se trouve sur les liaisons les moins chères. L’optimisation des coûts concentre le flot, et un flot concentré est exactement ce à quoi ressemble la fragilité. L’optimum et le risque sont produits par la même propriété du réseau.
Les liaisons prises une à une comptent aussi, et de façon inégale. La pire liaison isolée est P2 → D3, dont la perte coûte 35 unités ; P1 → D1 et D3 → C4 coûtent 30 chacune ; D2 → C3 coûte 20 ; et S1 → P1, D1 → C2 ou D3 → C3 ne coûtent que 5. Classer les dépenses d’atténuation par le volume d’une liaison donnerait un ordre faux, car le volume est ce que le plan a choisi d’envoyer, pas ce que le réseau perdrait.
La vue structurelle de la section 8 dit la même chose dans une autre langue. Dans un arbre couvrant minimal, chaque liaison est un isthme et plusieurs sites sont des points d’articulation : un réseau physique de coût minimal n’a donc, par construction, aucune redondance. La redondance, ce sont les cycles que l’arbre couvrant a supprimés. Acheter de la résilience, c’est acheter délibérément des arêtes qu’un modèle de coûts rejetterait.
Deux courants de recherche méritent d’être cités ici. The Resilient Enterprise de Sheffi (2005) a défendu l’idée que la flexibilité est un actif stratégique et non du gaspillage. Et Simchi-Levi et ses collègues, avec Ford, ont formalisé l’idée que le risque devait se mesurer au temps de rétablissement et à l’impact sur le résultat qui en découle, plutôt qu’à la probabilité d’une rupture, qui est inconnaissable : leur étude de 2015 a montré que les pièces les plus exposées étaient souvent des composants de faible valeur venant de fournisseurs uniques qu’aucune analyse par montant d’achat ne signalerait jamais. C’est une question de graphes, et c’est celle que cette section calcule.
12. Deux astuces de modélisation à connaître
Deux constructions transforment « le modèle ne sait pas exprimer cela » en « le modèle l’exprime très bien », et à elles deux elles couvrent l’essentiel de ce que les débutants rencontrent en premier.
Dédoubler le sommet, pour une capacité de site. Les algorithmes de flot mettent la capacité sur les arcs, mais un entrepôt a sa propre limite de traitement. La solution est de remplacer le sommet par deux : une copie « entrée » qui reçoit tous les arcs entrants, une copie « sortie » qui émet tous les arcs sortants, et un unique arc entre les deux portant la capacité du site.
avant :        --> [ D2 ] -->

après :         --> [D2_in] --(capacité 75, coût = frais de manutention)--> [D2_out] -->
La même astuce porte un coût de manutention ou un délai fixe de traitement, et c’est ainsi que les délais de la section 4 absorbent le temps passé dans un bâtiment plutôt que sur la route. Elle double le nombre de sommets et ne change rien d’autre, et tous les algorithmes de flot de cet article fonctionnent ensuite sans modification.
Étendre dans le temps, pour les stocks. Un modèle mono-période n’a pas de mémoire : ce qui est produit doit partir immédiatement. Les vraies chaînes tiennent du stock, et le stock est un mouvement dans le temps plutôt que dans l’espace. Construisez une copie du réseau par période et ajoutez un arc de chaque site à la période t vers le même site à la période t+1. Le flot sur cet arc est le stock, son coût est le coût de possession, et sa capacité est la limite de stockage. Combien en tenir et où est un problème d’optimisation à part entière, traité dans notre guide sur l’ optimisation des stocks et le stock de sécurité.
Le résultat s’appelle un réseau étendu dans le temps, et c’est exactement pourquoi la planification de production multipériode est résoluble : un problème qui semble exiger une nouvelle théorie se révèle être un flot de coût minimal ordinaire sur un graphe T fois plus grand. La même construction gère la durée de vie, en ne construisant simplement pas l’arc qui porterait le stock au-delà de sa péremption.
Les deux astuces partagent une morale à intérioriser. Quand une caractéristique de la chaîne logistique semble réclamer un nouvel algorithme, elle réclame en général un nouveau graphe, et l’algorithme que vous avez déjà s’applique alors sans changement.
13. Ce qui est facile, ce qui est difficile
La chose la plus utile qu’un planificateur puisse savoir sur son propre modèle est de quel côté de la frontière de traitabilité il se trouve, car cela décide si la réponse est un optimum ou une bonne estimation.
| Question logistique | Problème de graphe | Coût |
|---|---|---|
| Route la plus rapide, engagements de service | Plus court chemin | O(m + n log n) |
| Peut-on tout livrer ? Où est le goulot ? | Flot maximal, coupe minimale | Polynomial |
| Plan d’expédition le moins cher | Flot de coût minimal | Polynomial |
| Besoins en matières | Ordre topologique sur un DAG | O(n + m) |
| Durée de projet, chemin critique | Plus long chemin sur un DAG | O(n + m) |
| Ensemble de liaisons le moins cher | Arbre couvrant minimal | O(m log n) |
| Quels sites ouvrir | Localisation d’installations | NP-difficile |
| Tournées de livraison pour une flotte | Tournées de véhicules | NP-difficile |
| Réseau le moins cher survivant à toute panne isolée | Conception deux-arête-connexe | NP-difficile |
| Lotissement de production dans le temps | Dimensionnement de lots avec réglages | NP-difficile en général |
Le motif est net et mérite d’être énoncé : les questions sur les flots sont faciles, les questions sur les objets discrets à construire sont difficiles. Dès qu’une décision devient un oui ou un non plutôt qu’un combien, l’unimodularité totale est perdue, le programme linéaire cesse de rendre des réponses entières, et vous voilà en programmation linéaire en nombres entiers.
Difficile ne veut pas dire sans espoir. Des instances de localisation à plusieurs centaines de sites candidats sont résolues à l’optimalité prouvée tous les jours, et les heuristiques de tournées se placent à quelques pour cent des meilleures solutions connues sur des instances bien au-delà des méthodes exactes. Ce que la frontière change, c’est la promesse : dans la moitié haute du tableau vous pouvez dire « c’est optimal », dans la moitié basse la phrase honnête est « c’est le meilleur que nous ayons trouvé, et voici la borne ». Un traitement plus complet des coûts eux-mêmes se trouve dans algorithmes de graphes et complexité.
14. Du modèle à la pratique
L’écart entre un modèle correct et un modèle utile n’est pas surtout mathématique. Quatre choses décident si le travail porte.
Les données sont le projet. Les coûts, les capacités et les temps de transit des liaisons vivent dans les systèmes de gestion du transport, les contrats et les tableurs, et ils se contredisent. Un modèle bâti sur une table de coûts vieille de dix-huit mois produira une réponse assurée, précise et fausse, et l’échec sera imputé à l’optimisation. Prévoyez ici l’essentiel de l’effort.
Choisissez la granularité exprès. Une étude stratégique de réseau peut traiter toute une région comme un sommet client ; un modèle de répartition hebdomadaire ne le peut pas. Agréger la demande est légitime, agréger la capacité ne l’est généralement pas, car les moyennes cachent précisément les pics qui créent le goulot de la section 5.
Utilisez un vrai solveur. Pour les flots, NetworkX et SciPy proposent tous deux le flot de coût minimal, et Google OR-Tools couvre flots, tournées et ordonnancement avec une interface pensée pour les praticiens. Pour tout ce qui comporte des décisions binaires, un solveur en nombres entiers comme Gurobi, CPLEX ou les logiciels libres HiGHS et CBC est l’outil qui convient. Écrire son propre simplexe de réseau est une bonne façon d’apprendre et une mauvaise façon de livrer.
Modélisez ce qui varie vraiment. Un modèle déterministe répond à « qu’est-ce qui est le mieux si la semaine prochaine ressemble exactement à ceci ». La demande ne ressemble jamais exactement à rien, et le mode de défaillance classique n’est pas algorithmique : Forrester a décrit en 1958 comment les politiques de commande amplifient la variabilité en amont, et Lee, Padmanabhan et Whang l’ont nommé effet coup de fouet en 1997. Aucune optimisation du flot d’une seule semaine n’y répond. Les réponses habituelles sont l’analyse de scénarios, l’optimisation stochastique ou robuste, et un horizon glissant qui recalcule à mesure que la réalité arrive.
Une dernière habitude, que les nombres de cet article ont pour but de démontrer : recalculer plutôt que raisonner. Affirmer qu’une liaison est critique, qu’un site vaut son coût fixe ou qu’un investissement de capacité se rembourse, c’est affirmer quelque chose que le modèle tranche en quelques millisecondes, et l’intuition sur les réseaux est peu fiable exactement dans les cas qui comptent. La section 5 a trouvé une liaison où dix unités de capacité en plus achètent une unité de débit. Personne ne devine cela.
15. Erreurs de modélisation qui produisent des réponses fausses et assurées
Un modèle de réseau échoue rarement bruyamment. Il rend un plan, le plan paraît raisonnable, et l’erreur n’est visible que pour qui sait où regarder. Voici celles qui reviennent.
- Mettre la capacité d’un site sur l’un de ses arcs. Un entrepôt capable de traiter 75 unités par semaine n’est pas la même chose qu’une liaison capable d’en porter 75, et écraser la limite sur l’arc qui paraît le plus chargé autorise en silence plus ou moins de débit que la réalité. Dédoublez le sommet, comme à la section 12.
- Utiliser un seul nombre comme poids d’arc. Coût, temps et capacité répondent à des questions différentes, et un modèle qui n’en porte qu’un rendra avec assurance le plan le moins cher alors qu’on lui demandait le plus rapide. Sur ce réseau, ces deux réponses diffèrent réellement.
- Répondre à une question multipériode avec un modèle mono-période. Sans arcs de stock, tout ce qui est produit doit partir aussitôt : le modèle déclarera donc infaisable un plan faisable, ou inventera de la capacité qu’il n’a pas. Étendez plutôt le réseau dans le temps.
- Agréger la capacité en même temps que la demande. Moyenner quatre semaines de demande en une seule est souvent défendable ; moyenner la capacité ne l’est pas, car la moyenne cache précisément le pic qui crée le goulot. Le pic de 40 % de la section 5 disparaît entièrement sous une moyenne mensuelle.
- Optimiser le coût sans contrainte de service. Un objectif purement financier enverra volontiers tout par les liaisons lentes et bon marché. Le délai doit entrer comme contrainte ou comme pénalité, sinon l’optimum sera inexploitable.
- Classer le risque par volume. La liaison la plus chargée est celle que le plan a choisie, ce qui n’est pas la même chose que celle dont la perte fait le plus mal. Recalculez sans chaque candidate et classez par le manque, ce que fait la section 11 et ce qui produit un ordre différent.
- Facturer un camion complet au coût unitaire. Le fret est souvent une fonction en escalier : la deuxième palette dans un camion à moitié vide est quasi gratuite, la première palette dans un nouveau camion ne l’est pas. Un coût unitaire linéaire lisse cela et sous-évalue systématiquement la consolidation. Les coûts en escalier demandent des variables binaires, ce qui fait basculer le modèle en programmation en nombres entiers.
- Oublier que la liste des arcs est un choix de modélisation. L’optimiseur ne peut choisir que des liaisons présentes dans les données. Une liaison que personne n’a saisie est une liaison qui n’apparaîtra jamais dans la réponse, et « le modèle dit qu’il ne faut pas utiliser cette route » signifie souvent « personne n’a dit au modèle que la route existe ».
Le fil commun est que les huit produisent des résultats plausibles. La parade est de tester le modèle sur une période déjà vécue : s’il ne reproduit pas les flux réels du trimestre passé à une tolérance raisonnable, il n’est pas prêt à recommander ceux du prochain.
16. Questions fréquentes
Comment la théorie des graphes est-elle utilisée en gestion de la chaîne logistique ?
+
Les sites deviennent des sommets et les liaisons de transport des arcs orientés, puis les questions classiques deviennent des algorithmes classiques : plus court chemin pour les délais et les niveaux de service, flot maximal pour le débit et les goulots, flot de coût minimal pour le plan d’expédition le moins cher, arbre couvrant minimal pour la conception du réseau, ordre topologique pour les nomenclatures et les plannings de production, et localisation d’installations et tournées de véhicules pour les décisions stratégiques et de dernier kilomètre. L’optimisation de réseaux n’est pas une analogie de la planification logistique ; c’est la mathématique sur laquelle la discipline est bâtie.
Quelle est la différence entre flot maximal et flot de coût minimal ?
+
Le flot maximal demande combien peut physiquement passer et ignore complètement l’argent ; il répond à « pouvons-nous servir le pic de demande, et sinon, où est le mur ». Le flot de coût minimal demande la façon la moins chère de déplacer une quantité exigée et ignore tout ce qui n’a pas de prix ; il répond à « puisque nous pouvons servir la demande, que devons-nous réellement expédier sur chaque liaison ». En pratique, on lance d’abord le flot maximal pour vérifier la faisabilité et trouver le goulot, puis le flot de coût minimal pour produire le plan.
Pourquoi la coupe minimale est-elle si utile en pratique ?
+
Parce qu’elle transforme une affirmation vague en une liste. Le théorème flot maximal coupe minimale dit que le débit maximal égale la capacité du plus petit ensemble d’arcs dont le retrait sépare l’offre de la demande : la coupe est donc une réponse précise à « quelles liaisons sont la contrainte ». De la capacité ajoutée ailleurs n’achète rien. Sur le réseau de cet article, dix unités de plus sur l’une de deux liaisons nommées achètent dix unités de débit, sur une troisième une seule, et sur les onze restantes exactement zéro.
Le réseau le moins cher est-il aussi le meilleur réseau ?
+
Presque jamais, et la théorie des graphes explique nettement pourquoi. La façon la moins chère de relier un ensemble de sites est un arbre couvrant, et un arbre couvrant n’a pas de cycle, donc pas d’itinéraire de rechange : chaque liaison est un isthme dont la perte déconnecte le réseau. La redondance est précisément l’ensemble des cycles qu’une conception minimisant le coût supprime. Le même effet apparaît dans le plan de flot, où concentrer le volume sur les liaisons les moins chères est ce qui rend une panne isolée coûteuse. Coût et résilience sont des objectifs concurrents et devraient être chiffrés l’un contre l’autre plutôt que supposés compatibles.
Quels problèmes de chaîne logistique sont NP-difficiles ?
+
Ceux qui décident quels objets discrets existent. La localisation d’installations, les tournées de véhicules, le dimensionnement de lots avec coûts de réglage et la conception d’un réseau survivant à toute panne isolée sont tous NP-difficiles. Tout ce qui concerne le flot dans un réseau fixé est polynomial : plus court chemin, flot maximal, flot de coût minimal, arbres couvrants, ordre topologique et chemins critiques. La ligne de partage est le moment où une décision devient un oui ou un non plutôt qu’un combien, car c’est alors que la relaxation linéaire cesse de rendre d’elle-même des réponses entières.
Quels logiciels résolvent ces modèles ?
+
Pour les flots purs, NetworkX et SciPy fournissent tous deux des solveurs de flot de coût minimal, et Google OR-Tools couvre flots, tournées et ordonnancement avec une interface orientée praticiens. Pour tout ce qui comporte des décisions binaires, comme ouvrir des sites ou affecter des camions, utilisez un solveur en nombres entiers : Gurobi et CPLEX côté commercial, HiGHS et CBC côté libre, en général via une couche de modélisation comme Pyomo, PuLP ou JuMP. Écrire son propre simplexe de réseau est un excellent moyen de comprendre l’algorithme et un mauvais moyen de livrer un système de planification.
Comment modéliser le stock gardé entre deux périodes ?
+
Avec un réseau étendu dans le temps. Faites une copie de tout le réseau pour chaque période et ajoutez un arc de chaque site à la période t vers le même site à la période t plus un. Le flot sur cet arc est le stock reporté, son coût est le coût de possession et sa capacité est la limite de stockage. Le problème multipériode devient alors un flot de coût minimal ordinaire sur un graphe T fois plus grand, résoluble avec exactement le même algorithme. La même construction modélise la durée de vie : il suffit de ne pas construire l’arc qui porterait le stock au-delà de sa date de péremption.
17. Références
Les articles fondateurs et les ouvrages de référence, par ordre chronologique.
- Hitchcock, F. L. (1941). “The distribution of a product from several sources to numerous localities.” Journal of Mathematics and Physics, 20(1–4), 224–230.
- Koopmans, T. C. (1949). “Optimum utilization of the transportation system.” Econometrica, 17 (Supplement), 136–146.
- Dantzig, G. B. (1951). “Application of the simplex method to a transportation problem.” In T. C. Koopmans (ed.), Activity Analysis of Production and Allocation, 359–373. New York: Wiley.
- Ford, L. R. et Fulkerson, D. R. (1956). “Maximal flow through a network.” Canadian Journal of Mathematics, 8, 399–404.
- Forrester, J. W. (1958). “Industrial dynamics: a major breakthrough for decision makers.” Harvard Business Review, 36(4), 37–66.
- Dantzig, G. B. et Ramser, J. H. (1959). “The truck dispatching problem.” Management Science, 6(1), 80–91.
- Kelley, J. E. et Walker, M. R. (1959). “Critical-path planning and scheduling.” Proceedings of the Eastern Joint Computer Conference, 160–173.
- Ford, L. R. et Fulkerson, D. R. (1962). Flows in Networks. Princeton: Princeton University Press.
- Clarke, G. et Wright, J. W. (1964). “Scheduling of vehicles from a central depot to a number of delivery points.” Operations Research, 12(4), 568–581.
- Balinski, M. L. (1965). “Integer programming: methods, uses, computation.” Management Science, 12(3), 253–313.
- Geoffrion, A. M. et Graves, G. W. (1974). “Multicommodity distribution system design by Benders decomposition.” Management Science, 20(5), 822–844.
- Orlicky, J. (1975). Material Requirements Planning. New York: McGraw-Hill.
- Ahuja, R. K., Magnanti, T. L. et Orlin, J. B. (1993). Network Flows: Theory, Algorithms, and Applications. Englewood Cliffs: Prentice Hall.
- Lee, H. L., Padmanabhan, V. et Whang, S. (1997). “Information distortion in a supply chain: the bullwhip effect.” Management Science, 43(4), 546–558.
- Sheffi, Y. (2005). The Resilient Enterprise: Overcoming Vulnerability for Competitive Advantage. Cambridge, Massachusetts: MIT Press.
- Toth, P. and Vigo, D. (eds.) (2014). Vehicle Routing: Problems, Methods, and Applications, 2e édition. Philadelphia: SIAM.
- Simchi-Levi, D., Schmidt, W., Wei, Y., Zhang, P. Y., Combs, K., Ge, Y., Gusikhin, O., Sanders, M. et Zhang, D. (2015). “Identifying risks and mitigating disruptions in the automotive supply chain.” Interfaces, 45(5), 375–390.
- Chopra, S. et Meindl, P. (2015). Supply Chain Management: Strategy, Planning, and Operation, 6e édition. Boston: Pearson.