
目录
1. 简短的答案
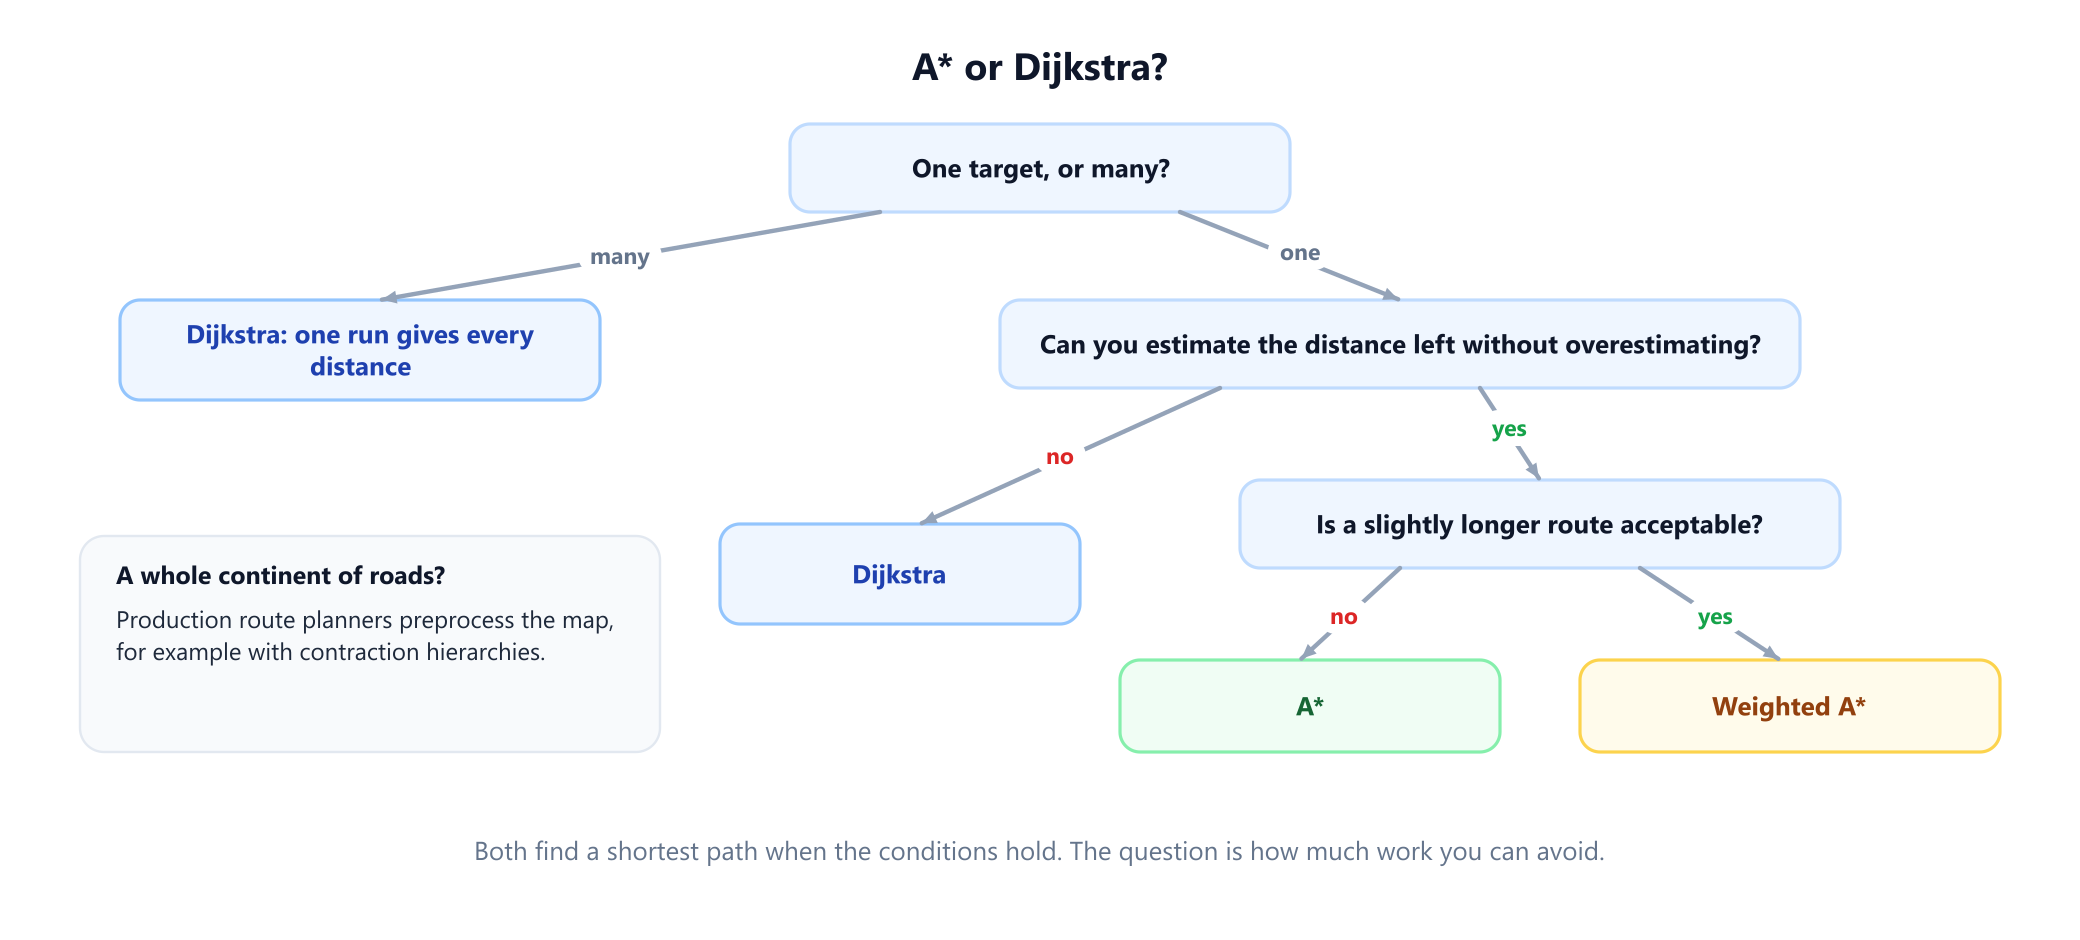
Dijkstra 算法和 A* 都能在边权非负的带权图中求出一条最短路径。区别在于它们掌握的信息。Dijkstra 向各个方向向外搜索,因为它完全不知道目标在哪里。A* 加入了对剩余距离的估计,因此把精力花在看起来有希望的方向上。
| Dijkstra | A* | |
|---|---|---|
| 回答的问题 | 从一个源点到每个顶点,或到一个目标 | 从一个源点到一个目标 |
| 顶点的优先级 | g:到源点的距离 | f = g + h:已走的距离加上估计的剩余距离 |
| 需要 | 边权非负 | 边权非负,以及一个启发式函数 h |
| 保证最短路径 | 是 | 是,前提是 h 从不高估 |
| 探索的顶点 | 比目标更近的所有顶点 | 通常少得多;具体多少取决于 h |
| 显式图上的最坏情况 | O((V + E) log V) | 相同,前提是使用一致的 h,且能在常数时间内算出 |
| 适用场景 | 需要多个目标,或没有可用的估计 | 只要一条路线,并且能估计距离 |
一句话概括: A* 适用于在地图上求单条路线,此时坐标能给出很好的估计; Dijkstra 适用于需要到多个地点的距离,或者没有任何信息能指明目标方向的情况。这两者与其说是竞争对手,不如说是掌握不同信息的同一个算法,下一节会说明这一点。Dijkstra 与能处理负权重的方法相比如何,见 Dijkstra vs Bellman-Ford vs Floyd-Warshall。
2. 一行之差
两种算法都维护一个顶点优先队列,反复扩展优先级值最小的顶点。用 g(v) 表示目前找到的从起点到 v的最佳路线的成本,用 h(v) 表示从 v 到目标的成本估计,称为启发式函数。
Dijkstra:   优先级(v) = g(v)
A*:         优先级(v) = g(v) + h(v)
区别仅此而已。对每个顶点令 h(v) = 0,A* 就变成了 Dijkstra 算法。因此,关于 Dijkstra 的每一个结论,都是关于使用信息量最少的启发式函数的 A* 的结论,而 A* 获得的一切好处都来自 h。逐步讲解见 Dijkstra 算法指南和 A* 搜索算法指南。
这种影响体现在几何形状上。Dijkstra 按到起点的距离顺序扩展顶点,所以探索区域像圆一样增长。A* 按经过每个顶点的路线的估计总长度顺序扩展,因此方向错误的顶点优先级值很高,被留在队列里。圆变成了更接近从起点到目标的一条窄带。
3. 一张地图,两次搜索
贯穿全文的示例是一个有 288 个格子的网格,其中有一堵杯形的墙,占据 24 个格子。机器人从 S 出发,要到达 G,每步向上、下、左、右移动一格,每步成本为 1。这堵墙迫使它绕行:在空网格上 G 只有 22 步之遥,但最短路线需要 26 步。启发式函数是曼哈顿距离,即格子与目标之间的行数加列数,它忽略墙,因此绝不会高估。
import heapq

MAP = ["........................",
       "..........#########.....",
       "..S...............#.....",
       "..................#.....",
       "..................#.....",
       "..................#..G..",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "............#######.....",
       "........................"]

def locate(grid, ch):
    return next((r, row.index(ch)) for r, row in enumerate(grid) if ch in row)

def search(grid, start, goal, h, weight=1):
    """在 f = g + weight * h 上做最佳优先搜索。当 h = 0 时就是 Dijkstra。"""
    g = {start: 0}
    done, count = set(), 0
    heap = [(weight * h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue                                   # 过期条目
        done.add(u)
        if u == goal:
            return g[u], len(done)                     # 路径成本,已扩展的顶点数
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < len(grid) and 0 <= v[1] < len(grid[0]) and grid[v[0]][v[1]] != '#':
                if g[u] + 1 < g.get(v, float('inf')):
                    g[v] = g[u] + 1
                    count += 1
                    heapq.heappush(heap, (g[v] + weight * h(v), count, v))
    return None

S, G = locate(MAP, 'S'), locate(MAP, 'G')
manhattan = lambda v: abs(v[0] - G[0]) + abs(v[1] - G[1])

print('Dijkstra        ', search(MAP, S, G, lambda v: 0))
# Dijkstra         (26, 232)
print('A* (Manhattan)  ', search(MAP, S, G, manhattan))
# A* (Manhattan)   (26, 149)
for w in (2, 5):
    print(f'weighted A*, w={w}', search(MAP, S, G, manhattan, weight=w))
# weighted A*, w=2 (26, 124)
# weighted A*, w=5 (26, 116)
print('greedy best-first', search(MAP, S, G, manhattan, weight=1000))
# greedy best-first (46, 108)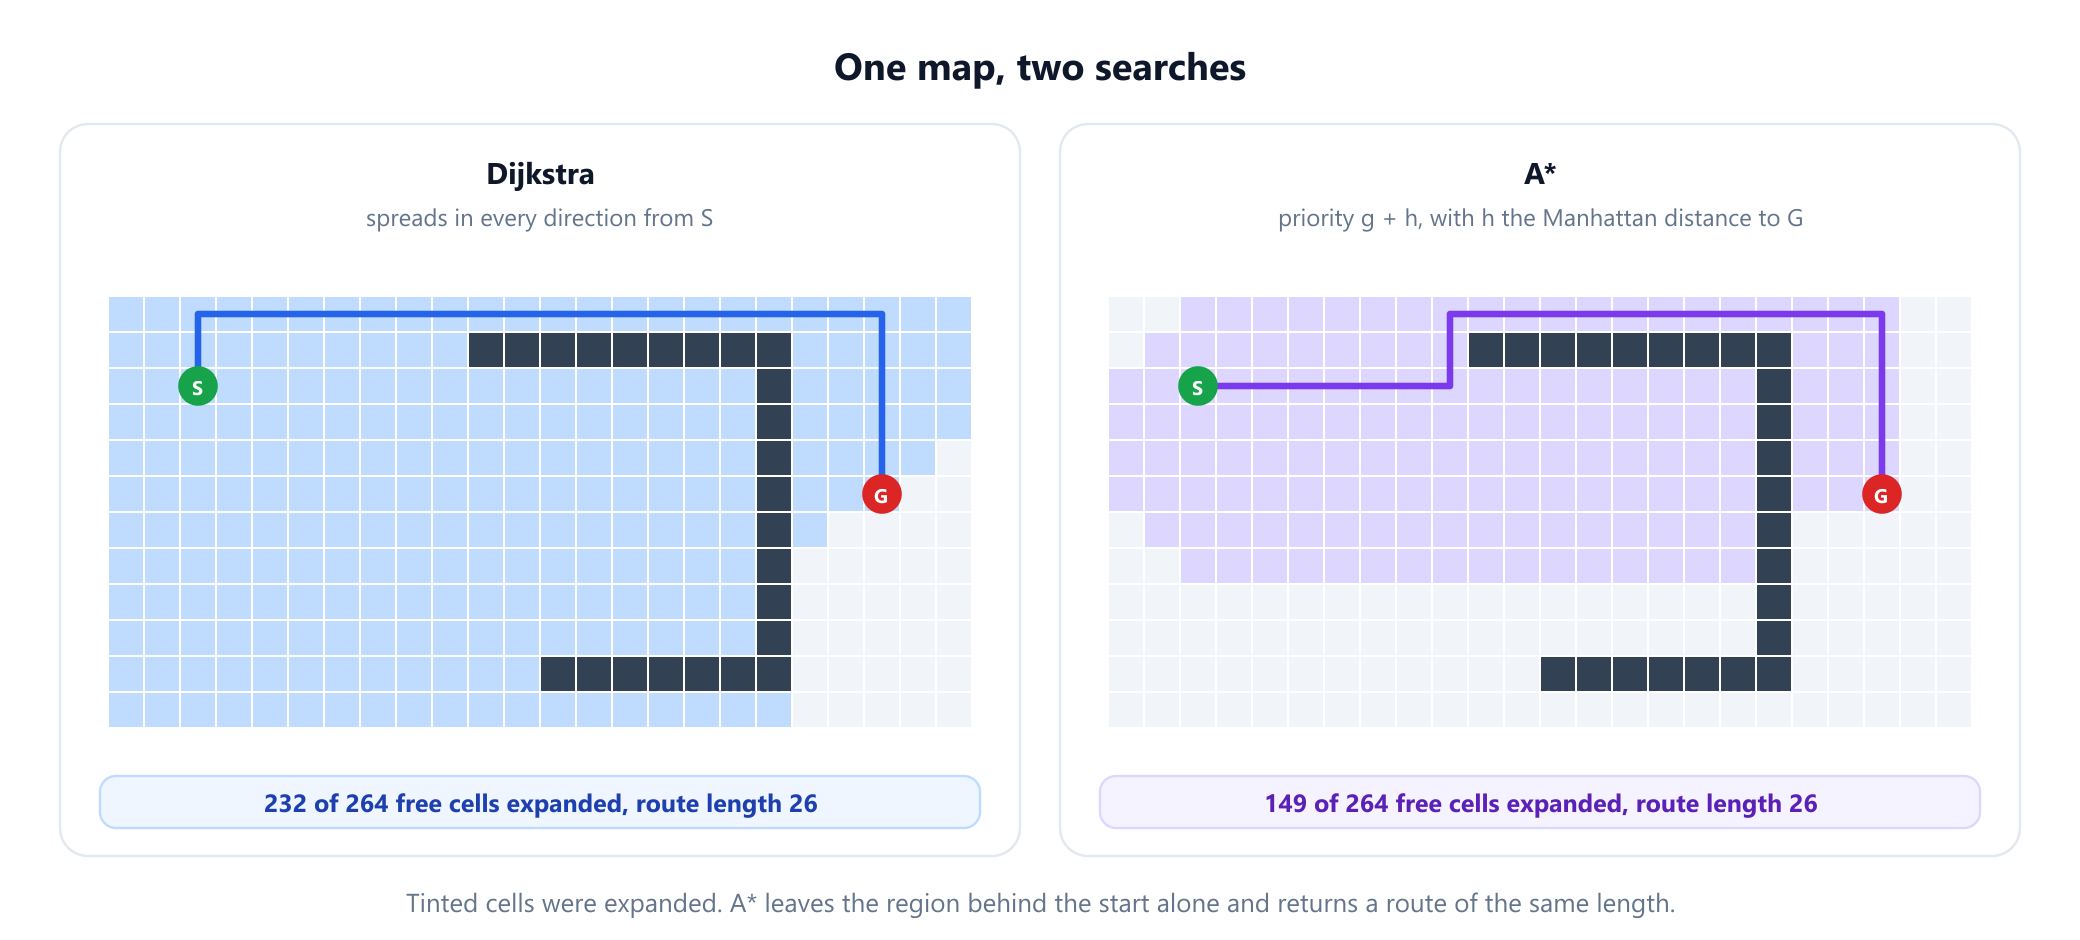
两者返回的路线长度都是 26。Dijkstra 在到达 G之前扩展了 264 个可通行格子中的 232 个,其中包括最左侧那些毫无用处的格子。A* 扩展了 149 个。它不需要扩展全部 232 个,因为任何 f 值超过 26 的格子都不可能位于最短路线上,而 A* 在结束之前根本不会轮到它们。
节省 36% 并不算多,因为这张地图本来就是为了误导启发式函数而设计的:在杯形内部,曼哈顿距离总是暗示可以穿墙直行。第 6 节会在 800 条不那么刁难的路线上测量 A*。
4. A* 为什么仍能找到最短路径
估计听起来有风险,而保证来自一个条件。一个启发式函数如果从不高估真实的剩余成本,就称它是可采纳的。假设 A* 即将以一条成本为 C的路线在目标处结束,但存在一条成本为 C* < C 的更便宜路线。这条更便宜路线上的某个顶点 n 仍在队列中等待,而由于 h 从不高估, f(n) = g(n) + h(n) ≤ C*。因此 f(n) 低于目标的优先级 C,A* 本应先扩展 n。更便宜的路线不可能被漏掉。
一个更强的条件能让实现变得简单。启发式函数称为一致的,如果对每条从 u 到 v 的边,设其权重为 w, h(u) ≤ w + h(v)都成立:沿着一条边移动,估计值的下降量绝不会超过这条边的成本。使用一致的启发式函数时,A* 永远不必把一个顶点扩展两次,这与 Dijkstra 完全一样。事实上,使用一致启发式函数的 A* 就是在重新赋权后的边 w'(u, v) = w(u, v) - h(u) + h(v)上运行的 Dijkstra 算法,这些权重全部非负。人工智能中的 A* 指南给出了完整证明,以及可采纳但不一致的启发式函数的反例。
从严格意义上说,A* 也是单向安全搜索所能达到的最节省的算法。Rina Dechter 和 Judea Pearl 在 1985 年证明,当启发式函数一致时,任何从起点向外扩展顶点、使用相同启发式函数、并且只要启发式函数从不高估就保证找到最短路径的算法,都必须扩展 A* 必然扩展的每个顶点,也就是从起点出发存在某条路径使其到达时 f 低于最优成本的每个顶点。只有平局的处理方式还留有改进余地,而双向搜索不在这一结论的范围内。
5. 启发式函数是一个旋钮
在“一无所知”和“无所不知”之间,还有一整片中间地带,同一份代码就能覆盖,只需使用权重 w,即 f = g + w * h。第 3 节程序的输出展示了示例上的情况:
| 搜索 | 优先级 | 扩展的格子数 | 路线长度 | 保证 |
|---|---|---|---|---|
| Dijkstra | g | 232 | 26 | 最短 |
| A* | g + h | 149 | 26 | 最短 |
加权 A*, w = 2 | g + 2h | 124 | 26 | 不超过最短路线的 2 倍 |
加权 A*, w = 5 | g + 5h | 116 | 26 | 不超过最短路线的 5 倍 |
| 贪心最佳优先 | h | 108 | 46 | 无 |
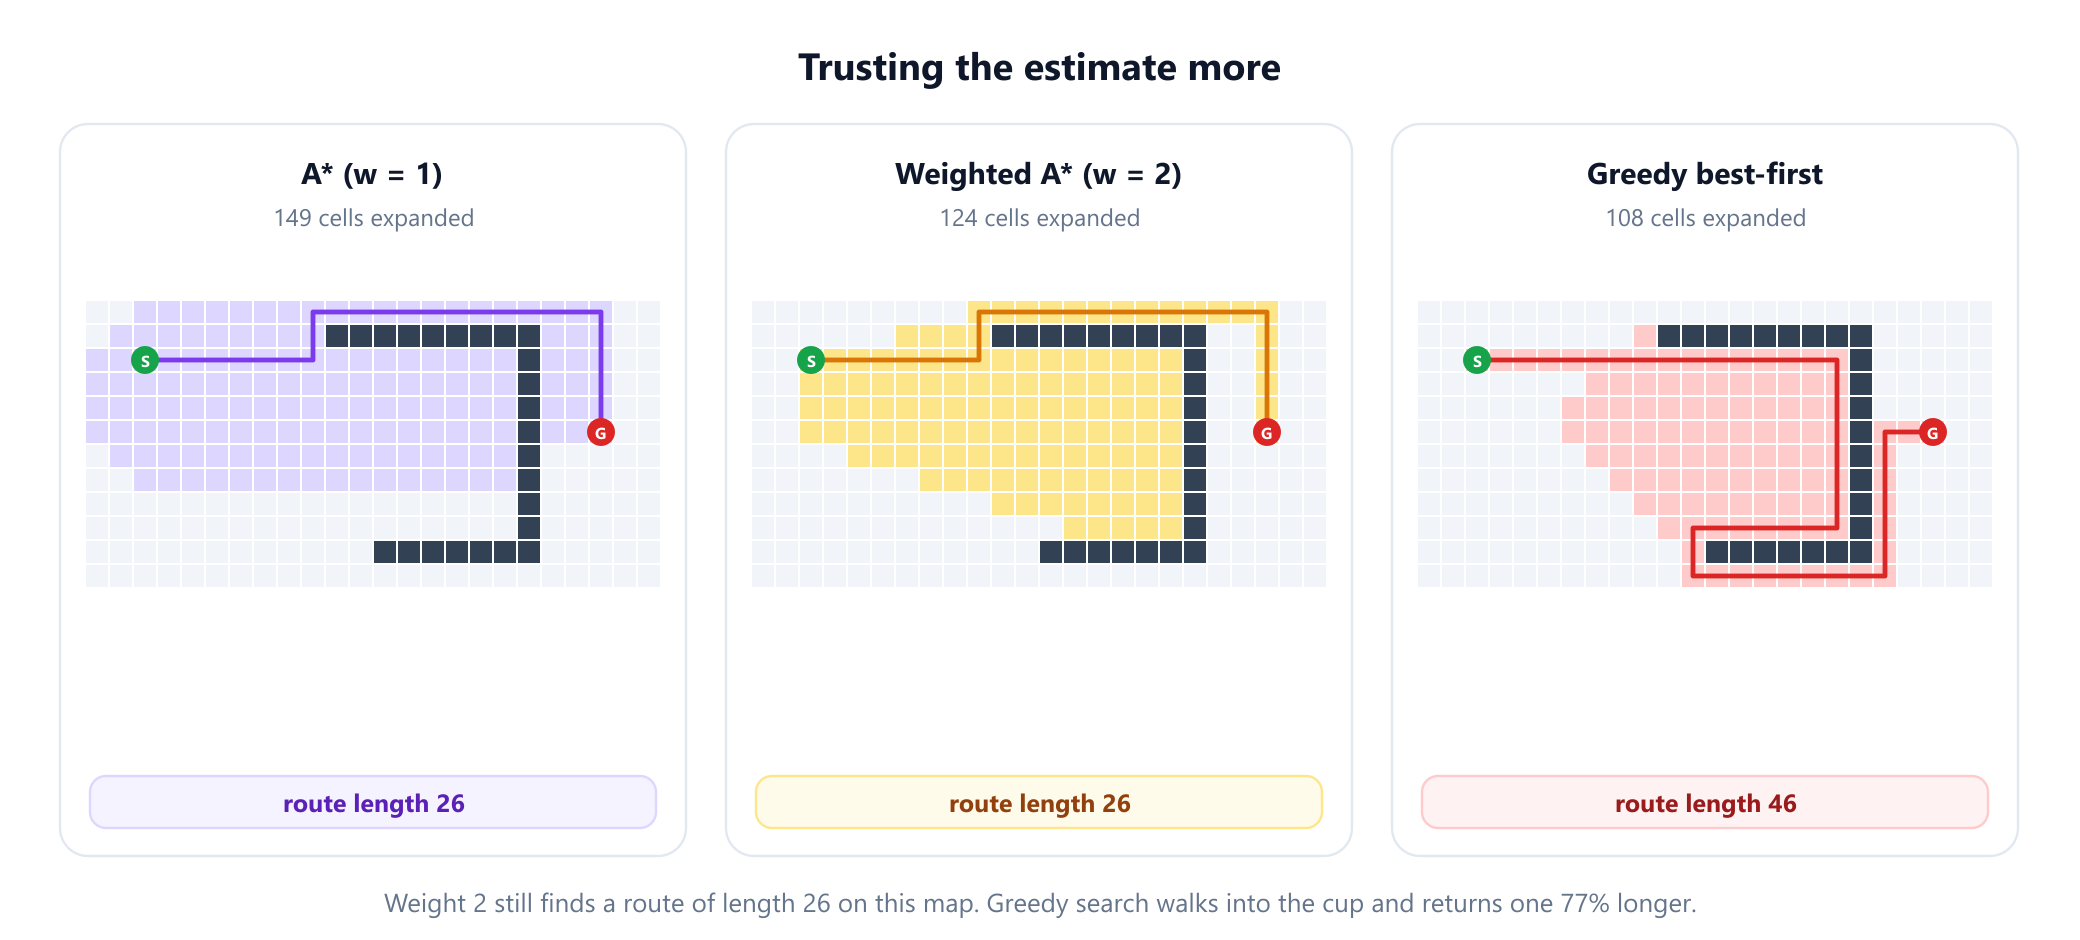
加权 A* 以可控的方式放弃了最优性保证:使用一致的 h时,它返回的路线最多是最短路线的 w 倍。在这张地图上,权重 2 和 5 恰好仍能以更少的工作量找到长度为 26 的路线。贪心最佳优先搜索完全忽略 g,只多节省了一点工作,却径直走进杯形,返回一条 46 步的路线,比必要的长度多 77%。它节省的工作与损失的质量相比微不足道。
在旋钮的另一端,完美的启发式函数,即始终等于真实剩余成本的启发式函数,会让 A* 几乎直奔目标。可采纳的 h 越接近真实值,A* 扩展的顶点就越少。正因如此,启发式函数的设计比任何实现细节都重要。
6. A* 在典型地图上能节省多少
一张地图说明不了什么。下面的程序在四类地图上各用 200 条随机路线比较这两种搜索:墙的比例分别为 0%、20% 和 35% 的 60×60 网格,以及一个路网,它有 1,500 个位于随机位置的城镇,每个城镇通过道路与最近的 4 个邻居相连,道路最多比直线长 40%。在网格上启发式函数是曼哈顿距离,在路网上是直线距离。Dijkstra 一到达目标就停止,以保证比较公平。
import heapq, math, random

def search(neighbours, start, goal, h):
    """A*;传入 h = lambda v: 0 即为 Dijkstra。返回 (成本, 已扩展的顶点数)。"""
    g, done, count = {start: 0}, set(), 0
    heap = [(h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return g[u], len(done)
        for v, w in neighbours(u):
            if g[u] + w < g.get(v, float('inf')):
                g[v] = g[u] + w
                count += 1
                heapq.heappush(heap, (g[v] + h(v), count, v))
    return None

def compare(neighbours, h_for, pairs):
    """在所有连通的点对上,Dijkstra 和 A* 的平均扩展次数。"""
    dij = star = runs = 0
    for s, t in pairs:
        d = search(neighbours, s, t, lambda v: 0)
        if d is None:
            continue
        a = search(neighbours, s, t, h_for(t))
        assert abs(a[0] - d[0]) < 1e-9                 # 每次成本都相同
        dij += d[1]; star += a[1]; runs += 1
    return dij // runs, star // runs

def grid_trial(density, rnd, n=60, trials=200):
    wall = {(r, c) for r in range(n) for c in range(n) if rnd.random() < density}
    free = [(r, c) for r in range(n) for c in range(n) if (r, c) not in wall]
    def neighbours(u):
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < n and 0 <= v[1] < n and v not in wall:
                yield v, 1
    h_for = lambda t: lambda v: abs(v[0] - t[0]) + abs(v[1] - t[1])
    return compare(neighbours, h_for, [rnd.sample(free, 2) for _ in range(trials)])

def road_trial(rnd, n=1500, trials=200):
    """城镇位于随机位置,每个城镇与最近的 4 个城镇相连;道路蜿蜒,最多比直线距离长 40%。"""
    pts = [(rnd.random(), rnd.random()) for _ in range(n)]
    adj = [{} for _ in range(n)]
    for i, p in enumerate(pts):
        for j in sorted((j for j in range(n) if j != i), key=lambda j: math.dist(p, pts[j]))[:4]:
            w = math.dist(p, pts[j]) * rnd.uniform(1.0, 1.4)
            adj[i][j] = adj[j][i] = min(w, adj[i].get(j, w))
    neighbours = lambda u: adj[u].items()
    h_for = lambda t: lambda v: math.dist(pts[v], pts[t])
    return compare(neighbours, h_for, [rnd.sample(range(n), 2) for _ in range(trials)])

rnd = random.Random(1)
for density in (0.0, 0.2, 0.35):
    print(f'grid 60x60, {density:.0%} walls:', grid_trial(density, rnd))
print('road network, 1500 towns:', road_trial(rnd))
# grid 60x60, 0% walls: (1767, 451)
# grid 60x60, 20% walls: (1312, 238)
# grid 60x60, 35% walls: (1105, 397)
# road network, 1500 towns: (731, 235)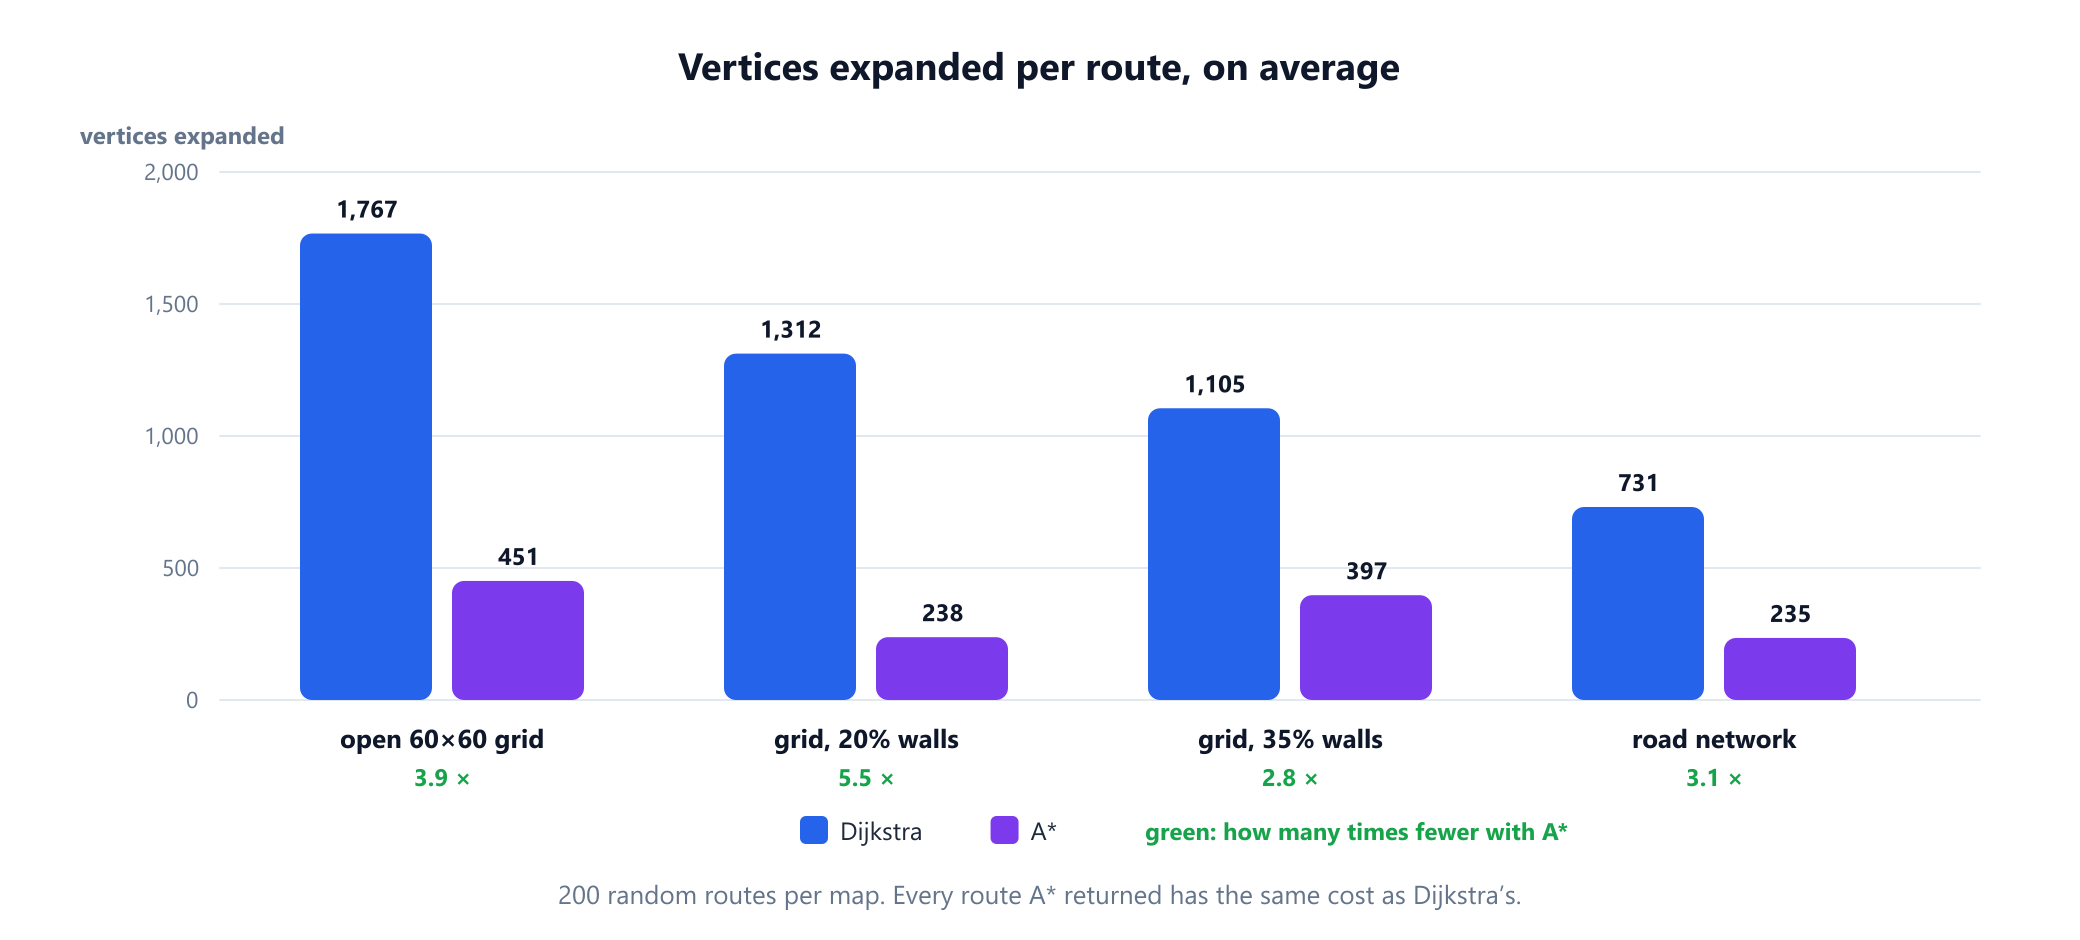
在每种地图上,A* 扩展的顶点数大约是 Dijkstra 的三分之一到五分之一,并且每条路线返回的成本都完全相同;程序每次运行都会检查这一点。墙占 20% 时节省最多(约 5.5 倍)。在空网格上节省较少,完全是因为第 7 节描述的平局,而在墙占 35% 时(2.8 倍),频繁的绕行使估计变得不那么准确。在路网中节省约为 3 倍,因为道路蜿蜒,直线距离是一个偏低的估计。
扩展更少的顶点并不自动意味着用时更少。A* 必须为它接触到的每个顶点计算 h,而且优先队列中会有更多优先级相近的条目。在这些地图上,启发式函数只是一行算术,所以节省是实实在在的。计算开销大的启发式函数可能把这一优势抵消掉。
7. 平局的隐藏代价
在没有墙的网格上,大量格子的 f 值完全相同,而 A* 处理它们的顺序决定了一切。下面的程序在 40×40 的空网格上从一角到对角运行 A*,使用三种不同的平局打破规则。
import heapq

def expansions(n, tie):
    """在 n×n 的空网格上从一角到对角运行 A*。tie(h, count) 决定相等 f 值的顺序。"""
    goal = (n - 1, n - 1)
    h = lambda v: abs(v[0] - goal[0]) + abs(v[1] - goal[1])
    g, done, count = {(0, 0): 0}, set(), 0
    heap = [(h((0, 0)), tie(h((0, 0)), 0), (0, 0))]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return len(done)
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < n and 0 <= v[1] < n and g[u] + 1 < g.get(v, float('inf')):
                g[v] = g[u] + 1
                count += 1
                heapq.heappush(heap, (g[v] + h(v), tie(h(v), count), v))

n = 40
print('oldest entry first  ', expansions(n, lambda h, c: (c,)))
print('newest entry first  ', expansions(n, lambda h, c: (-c,)))
print('closest to the goal ', expansions(n, lambda h, c: (h, c)))
# oldest entry first   1600
# newest entry first   79
# closest to the goal  79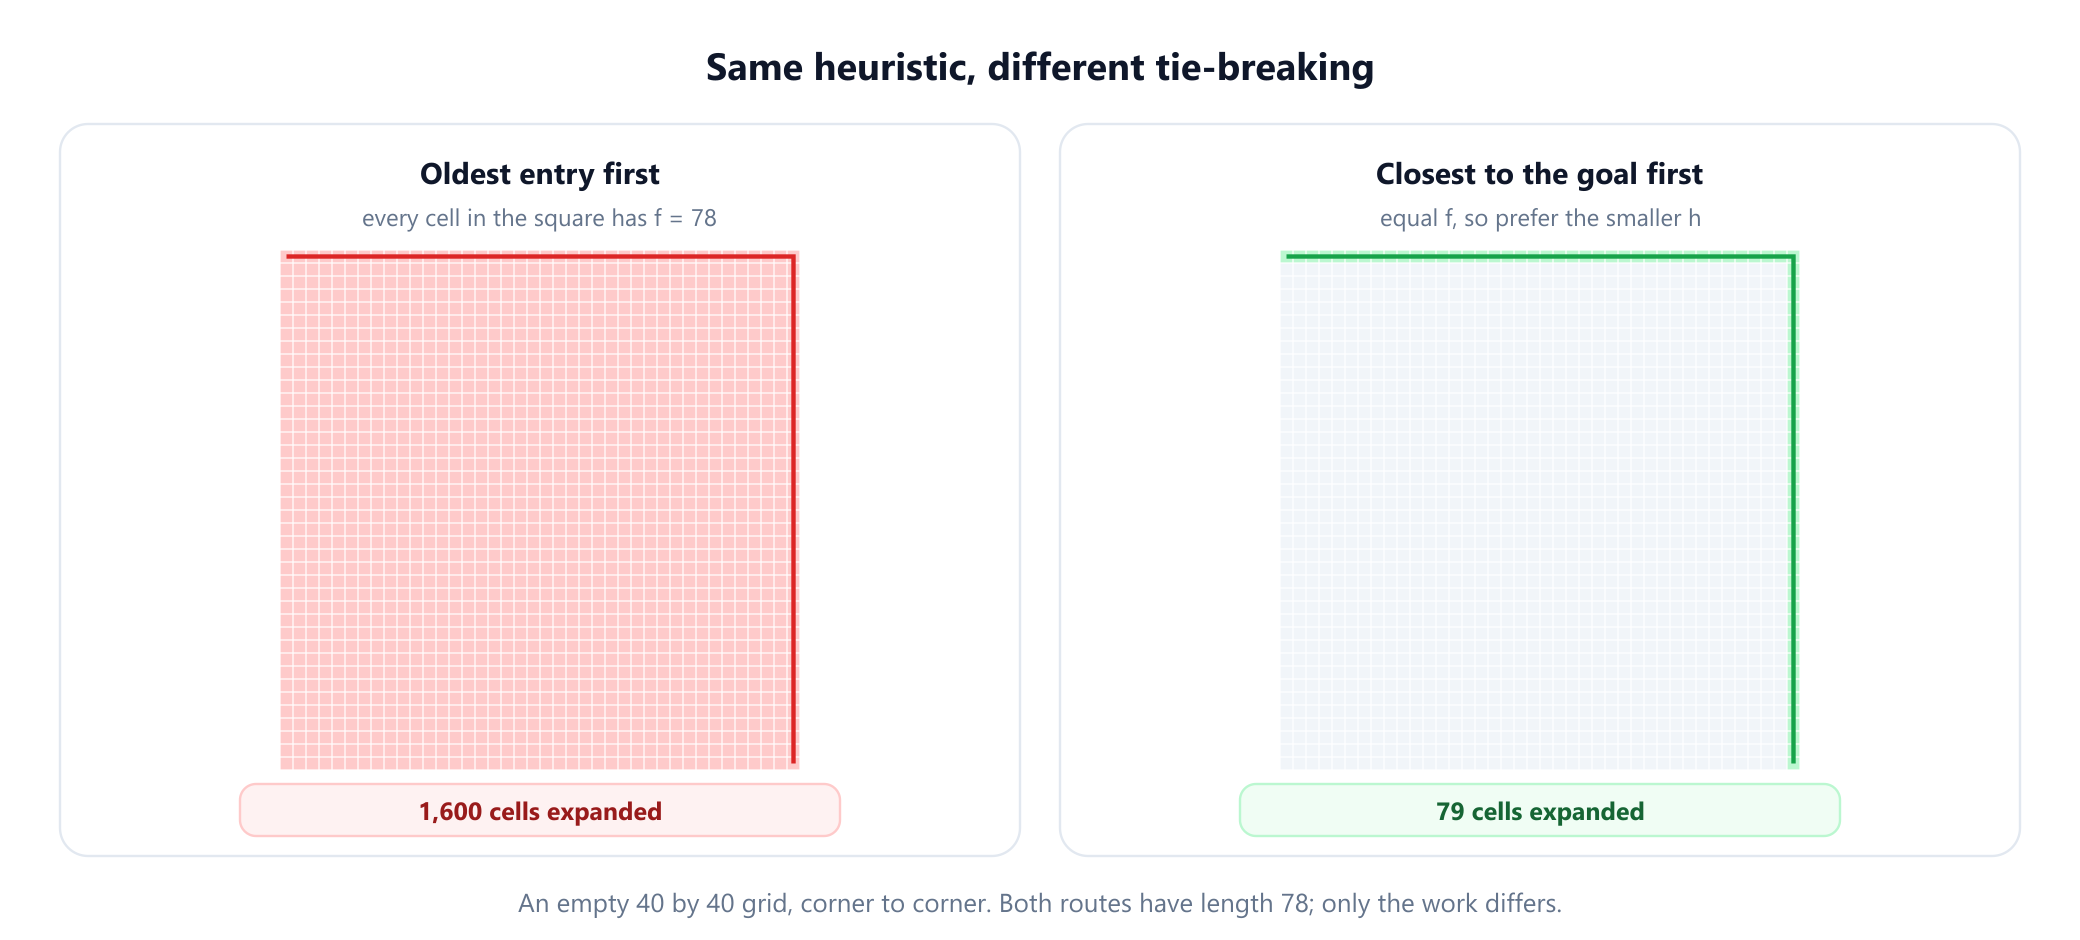
如果平局时优先选择最早入队的条目,A* 会扩展全部 1,600 个格子,并不比 Dijkstra 好。如果优先选择 h较小的格子,也就是 g较大的格子,它只扩展 79 个格子,正好是一条路线上的格子;在这里,优先选择最新入队的条目碰巧也能做到这一点。正方形中的每个格子都位于某条最短路线上,因此它们都满足 f = 78;规则只是决定是探索所有这些同样好的路线,还是专注于其中一条。比较 A* 的不同实现时,平局打破规则可能比数据结构更重要。
8. 什么时候 Dijkstra 是更好的选择
- 你需要多个目标。从一个源点运行一次 Dijkstra 就能得到到每个顶点的距离。为每个目标各运行一次 A* 会重复工作,而且瞄准某一个目标的启发式函数对其他目标毫无用处。
- 不存在有意义的估计。 A* 需要对目标有多远有所判断。在社交网络、引用图或依赖图中,没有可用来度量的坐标,而
h = 0只会把 A* 变回带有额外簿记工作的 Dijkstra。 - 目标离所有顶点都很近。如果目标就在起点附近,或者图很小,能节省的就很少。
- 答案会被重复使用。 Dijkstra 一次计算出的距离表或最短路径树,可以服务之后从同一源点发起的多次查询。
- 你想要最简单的正确代码。 Dijkstra 没有需要设计或可能出错的启发式函数。
还有些问题两者都不需要。如果每条边的代价都相同,广度优先搜索无需优先队列就能找到最短路线,详见 BFS vs DFS 指南。
9. 破坏保证的启发式函数
A* 的可信程度取决于它的启发式函数,典型的错误是使用为另一种移动方式设计的启发式函数。只能向四个方向移动时,曼哈顿距离是安全的。一旦允许斜向移动,它就会高估,因为斜走一步所覆盖的距离,它会算成两步。八方向移动的正确估计是八方向距离 (octile)。下一个程序在同一张地图上使用成本为 10 的直行移动和成本为 14 的斜向移动。
import heapq

MAP = ["........................",
       "..........#########.....",
       "..S...............#.....",
       "..................#.....",
       "..................#.....",
       "..................#..G..",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "............#######.....",
       "........................"]
STEPS = [(-1, 0, 10), (0, 1, 10), (1, 0, 10), (0, -1, 10), (-1, 1, 14), (1, 1, 14), (1, -1, 14), (-1, -1, 14)]

def search(start, goal, h):
    """八方向的 A*:直行移动成本为 10,斜向移动成本为 14。"""
    g, done, count = {start: 0}, set(), 0
    heap = [(h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return g[u], len(done)
        for dr, dc, w in STEPS:
            v = (u[0] + dr, u[1] + dc)
            if 0 <= v[0] < len(MAP) and 0 <= v[1] < len(MAP[0]) and MAP[v[0]][v[1]] != '#':
                if g[u] + w < g.get(v, float('inf')):
                    g[v] = g[u] + w
                    count += 1
                    heapq.heappush(heap, (g[v] + h(v), count, v))

S, G = (1, 19), (10, 0)                        # 从右上到左下,绕过墙
def manhattan(v):
    return 10 * (abs(v[0] - G[0]) + abs(v[1] - G[1]))
def octile(v):
    dr, dc = abs(v[0] - G[0]), abs(v[1] - G[1])
    return 10 * max(dr, dc) + 4 * min(dr, dc)

print('Dijkstra ', search(S, G, lambda v: 0))
print('octile   ', search(S, G, octile))
print('Manhattan', search(S, G, manhattan))
# Dijkstra  (234, 261)
# octile    (234, 21)
# Manhattan (288, 45)
Dijkstra 和使用八方向距离的 A* 都找到了真正的最短路线,成本为 234,而 A* 只需 21 次扩展,Dijkstra 需要 261 次。曼哈顿距离返回一条成本为 288 的路线,长了 23%,而且没有任何警告。会高估的启发式函数既快又错,因此很容易被忽视。
还有两个相关的陷阱值得了解。启发式函数可能是可采纳的,却不一致,这种情况下一个顶点可能需要被扩展多次:像这里的实现那样使用关闭集且拒绝重新打开顶点的实现,可能会返回一条并非最短的路线。此外,负权边会让两种算法都失效,这种情况请参阅 Bellman-Ford 算法。
10. 各自的应用场景
- 游戏。在网格地图和导航网格上运行 A* 是单位移动的标准做法。Daniel Harabor 和 Alban Grastien 提出的 Jump Point Search(跳点搜索)通过跳过因路线对称而变得多余的格子,加快均匀网格上的 A*。
- 机器人。 A* 正是为此而诞生的:Peter Hart、Nils Nilsson 和 Bertram Raphael 在斯坦福研究所开发了它,Shakey 机器人的 IEEE 里程碑也将它归功于该项目。
- 网络。 OSPF 等链路状态路由协议使用 Dijkstra,因为每台路由器需要到所有目的地的路由,而不是一条。
- 大陆规模的道路路线规划。普通的 Dijkstra 和普通的 A* 对整个大陆来说都太慢。已公开记录的大陆规模系统都会预处理地图。收缩层次 (contraction hierarchies) 预先添加捷径边,ALT 则把 A* 与到几个选定地标的距离结合起来,以获得更好的启发式函数。
- 谜题与规划。 A* 及其节省内存的变体 IDA*(由 Richard Korf 提出)可以解决滑块拼图之类的问题,这类问题的图大到无法存储,只能在搜索过程中生成。
内存往往才是真正的限制。两种算法都会存储到达过的每个顶点,因此在巨大的隐式图上,A* 可能早在时间耗尽之前就耗尽内存。IDA* 正是为这种情况而设计的。
11. 简史
Edsger Dijkstra 于 1959 年发表了他的算法。九年后,Hart、Nilsson 和 Raphael 在 "A Formal Basis for the Heuristic Determination of Minimum Cost Paths" 中发表了 A*,1972 年他们又发表了一则简短的更正,说明一致性在其最优性证明中的作用。Ira Pohl 在 1970 年研究了加权评估函数。Dechter 和 Pearl 在 1985 年确切阐明了 A* 在何种意义上是最优的。这两种算法常被描述为前后递进的关系,但正如第 2 节所示,A* 包含 Dijkstra 作为其特例: h = 0。
12. 常见错误
| 错误 | 为什么错 | 修正 |
|---|---|---|
| 用 A* 计算到多个目标的距离 | 启发式函数只指向一个目标,每个目标都要重复工作 | 从源点运行一次 Dijkstra |
| 允许斜向移动时仍使用曼哈顿距离 | 它会高估,在示例中返回 288 而不是 234 | 使用八方向距离 |
| 认为 A* 总是更快 | 使用 h = 0 或计算开销大的 h 时,工作量相同甚至更多 | 实际测量,并保持启发式函数计算简单 |
| 忽略平局 | 在 40×40 的开阔网格上,规则能把 1,600 次扩展变成 79 次 | 平局时优先选择较小的 h |
| 与到达目标后不停止的 Dijkstra 比较 | 完整运行会探索整个图,夸大节省的幅度 | 在目标被扩展时停止 Dijkstra |
| 把贪心最佳优先当作更快的 A* | 它没有任何保证,返回的是 46 步而不是 26 步 | 如果想要有界的折中,使用加权 A* |
| 在不一致的启发式函数下使用关闭集 | 通往已关闭顶点的更优路线会被丢弃 | 使用一致的启发式函数,或允许重新打开 |
| 在负权边上运行其中任何一种 | 两者都假设成本沿路线不会减少 | 使用 Bellman-Ford 或 Johnson 算法 |
13. 术语表
| 术语 | 含义 |
|---|---|
| g(v) | 目前找到的最佳路线的成本,路线从起点通往 v |
| h(v) | 启发式函数:从 v 到目标的成本估计 |
| f(v) | g(v) + h(v),即路线的估计总成本,该路线经过 v |
| 扩展 | 从队列中取出一个顶点并检查它的邻居 |
| 可采纳的启发式函数 | 从不高估真实剩余成本的启发式函数 |
| 一致的启发式函数 | 对每条边都满足 h(u) ≤ w + h(v) 的启发式函数 |
| 曼哈顿距离 | 两个格子之间的行数加列数;用于四方向移动时是安全的 |
| 八方向距离 (octile) | 允许斜向移动时的网格距离 |
| 加权 A* | 使用 f = g + w * h的 A*,以路线质量换取速度 |
| 贪心最佳优先搜索 | 只按 h 排序的搜索,没有任何保证 |
| 平局打破 | 对 f 值相等的顶点进行排序的规则 |
| IDA* | A* 的深度优先变体,占用内存极少 |
14. 常见问题
A* 和 Dijkstra 有什么区别?
Dijkstra 按 g 排列顶点,g 是到起点的距离。A* 按 f = g + h 排列顶点,其中 h 是到目标的剩余距离的估计。当 h = 0 时,两者是同一个算法。这个估计让 A* 能集中在目标方向上,因此它通常探索的顶点少得多,同时仍能找到最短路径。
A* 总是比 Dijkstra 快吗?
不一定。当存在好的估计时,A* 通常扩展的顶点少得多:在这里测量的随机地图上,Dijkstra 扩展的顶点数约为 A* 的 3 到 5.5 倍。如果启发式函数为零、计算缓慢,或者平局打破不当,它的工作量可能与 Dijkstra 相同甚至更多。当你需要到多个目标的距离时,单次 Dijkstra 运行也更好。
A* 总能找到最短路径吗?
只有当启发式函数是可采纳的,即从不高估真实的剩余成本时才能保证。如果它可能高估,A* 可能在没有任何警告的情况下返回一条更长的路线。从不重新打开顶点的实现还要求启发式函数是一致的,即对每条边,h(u) 最多为 w(u, v) + h(v)。
A* 就是带启发式函数的 Dijkstra 吗?
是的,从严格意义上说如此。h = 0 的 A* 就是 Dijkstra 算法,而使用一致启发式函数的 A* 的行为,与在重新赋权后的边 w(u, v) - h(u) + h(v) 上运行的 Dijkstra 完全相同,这些权重全部非负。
什么时候应该用 Dijkstra 而不是 A*?
当你需要从一个源点到多个或所有顶点的距离时,当不存在对剩余距离的有用估计时(例如社交图或依赖图),或者当最简单的正确代码最重要时,使用 Dijkstra。当你只要一条到一个目标的路线,并且能够估计距离(例如根据地图上的坐标)时,使用 A*。
网格上 A* 最好的启发式函数是什么?
取决于移动方式。四方向移动使用曼哈顿距离,允许斜向移动时使用八方向距离。在允许斜向移动时使用曼哈顿距离会高估,可能返回一条过长的路线。在开阔的网格上,平局时优先选择离目标更近的顶点也会带来很大差别。
15. 参考文献
上文中的算法、结果和归属均来自以下文献,按时间顺序排列。
- Dijkstra, E. W. (1959). "A Note on Two Problems in Connexion with Graphs." Numerische Mathematik 1,269 至 271 页。
- Hart, P. E., Nilsson, N. J. 和 Raphael, B. (1968). "A Formal Basis for the Heuristic Determination of Minimum Cost Paths." IEEE Transactions on Systems Science and Cybernetics 4(2),100 至 107 页。
- Pohl, I. (1970). "Heuristic Search Viewed as Path Finding in a Graph." Artificial Intelligence 1(3 至 4),193 至 204 页。
- Hart, P. E., Nilsson, N. J. 和 Raphael, B. (1972). "Correction to 'A Formal Basis for the Heuristic Determination of Minimum Cost Paths'." SIGART Newsletter 37,28 至 29 页。
- Pearl, J. (1984). Heuristics: Intelligent Search Strategies for Computer Problem Solving. 马萨诸塞州雷丁:Addison-Wesley。
- Dechter, R. 和 Pearl, J. (1985). "Generalized Best-First Search Strategies and the Optimality of A*." Journal of the ACM 32(3),505 至 536 页。
- Korf, R. E. (1985). "Depth-First Iterative-Deepening: An Optimal Admissible Tree Search." Artificial Intelligence 27(1),97 至 109 页。
- Moy, J. (1998). "OSPF Version 2." RFC 2328。Internet Engineering Task Force。
- Goldberg, A. V. 和 Harrelson, C. (2005). "Computing the Shortest Path: A* Search Meets Graph Theory." 载于 Proceedings of the 16th ACM-SIAM Symposium on Discrete Algorithms,156 至 165 页。
- Geisberger, R., Sanders, P., Schultes, D. 和 Delling, D. (2008). "Contraction Hierarchies: Faster and Simpler Hierarchical Routing in Road Networks." 载于 Experimental Algorithms,Lecture Notes in Computer Science 5038,319 至 333 页。
- Thayer, J. T. 和 Ruml, W. (2008). "Faster than Weighted A*: An Optimistic Approach to Bounded Suboptimal Search." 载于 Proceedings of the 18th International Conference on Automated Planning and Scheduling,355 至 362 页。
- Harabor, D. 和 Grastien, A. (2011). "Online Graph Pruning for Pathfinding on Grid Maps." 载于 Proceedings of the 25th AAAI Conference on Artificial Intelligence,1114 至 1119 页。
- Bast, H., Delling, D., Goldberg, A., Müller-Hannemann, M., Pajor, T., Sanders, P., Wagner, D. 和 Werneck, R. F. (2016). "Route Planning in Transportation Networks." 载于 Algorithm Engineering,Lecture Notes in Computer Science 9220,19 至 80 页。