
目录
1. 简短的回答
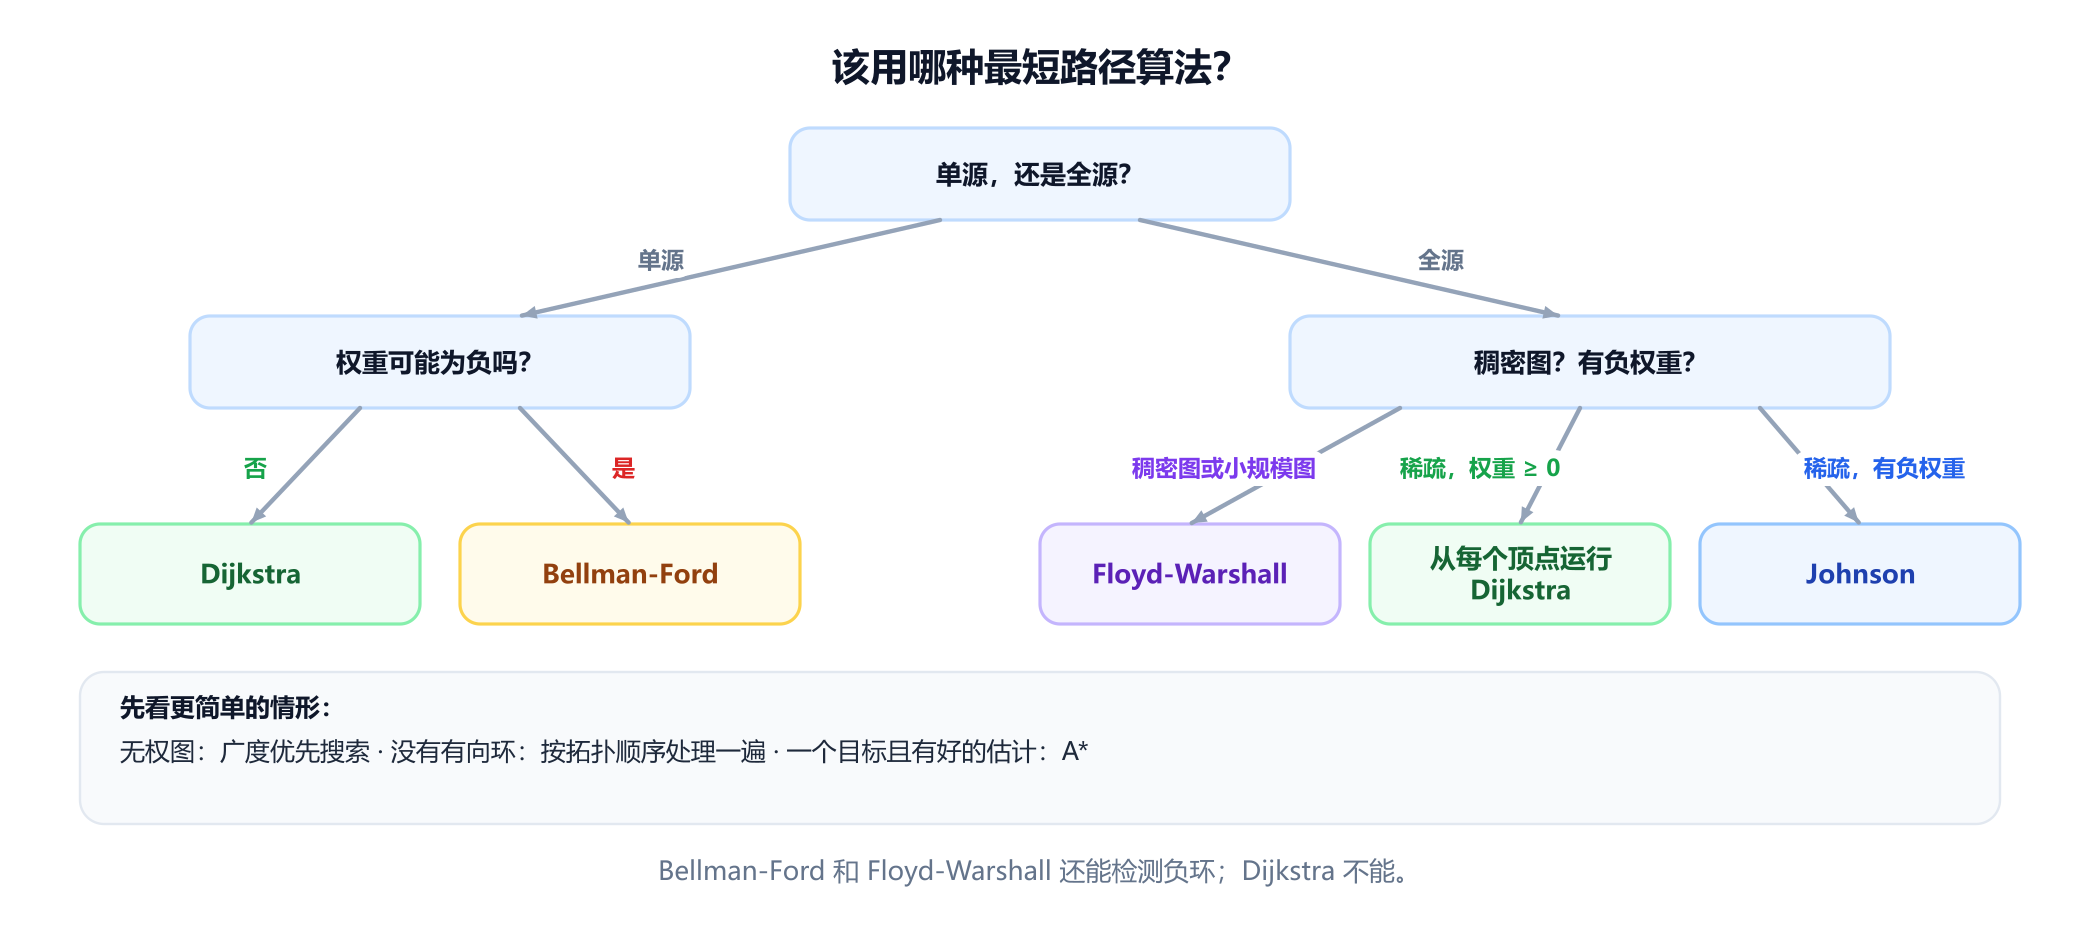
Dijkstra 算法、Bellman-Ford 算法和 Floyd-Warshall 算法都能在带权图中求最短路径,但它们在不同的条件下回答不同的问题。在它们之间做选择取决于两个问题:你需要的是从一个源点出发的距离,还是每一对顶点之间的距离,以及边的权重能否为负。
| Dijkstra | Bellman-Ford | Floyd-Warshall | |
|---|---|---|---|
| 求解内容 | 从一个源点到每个顶点 | 从一个源点到每个顶点 | 每一对顶点 |
| 负的边权 | 不支持:会给出错误答案 | 支持 | 支持 |
| 检测负环 | 否 | 是 | 是 |
| 时间 | O((V + E) log V) 使用二叉堆 | O(V E) | O(V3) |
| 内存 | O(V) | O(V) | O(V2) |
| 策略 | 贪心:确定距离最近的顶点 | 重复:松弛每一条边 | 对中转顶点做动态规划 |
| 适用场景 | 权重非负,大多数道路、网络和游戏地图都属于这种情况 | 有些权重为负,或者必须检测负环 | 需要小规模图或稠密图中的全部距离 |
这里 V 是顶点数, E 是边数。一句话概括: Dijkstra 是默认选择;当权重可能为负时,改用 Bellman-Ford;当你需要一个最多只有几百个顶点的图的完整距离表时,使用 Floyd-Warshall。当你需要在带负权边的大型稀疏图中求全源最短路径时,第 7 节的 Johnson 算法把前两种算法结合了起来。本指南的其余部分在同一个图上运行这三种算法,展示每一种在哪里胜出、在哪里失效。
2. 一个图,三种答案
贯穿全文的示例是一个小型有向图,有六个顶点、七条边和一条负权边,即 B → A,权重为 -4。可以把权重看作代价:负的代价就是返还,比如一条走上去反而付钱给你的收费公路,或者化学过程中释放能量的一个步骤。
S → A  3      S → B  6      A → C  4      B → A  -4
C → T  2      B → D  3      D → T  4

6 个顶点,7 条边,无环;源点 S
从 S 到 T 的最便宜路线是 S, B, A, C, T,代价为 6 - 4 + 4 + 2 = 8。它第一步走的是更贵的那条边,到 B,然后靠返还把多花的赚回来。下面的程序以标准教科书形式实现这三种算法,并从 S出发运行它们。
import heapq
INF = float('inf')

def graph(edges):
    adj = {}
    for u, v, w in edges:
        adj.setdefault(u, []).append((v, w))
        adj.setdefault(v, [])
    return adj

def dijkstra(adj, s):
    """贪心:确定距离最近的未确定顶点,之后不再重新访问它。"""
    dist = {v: INF for v in adj}
    dist[s] = 0
    done, heap = set(), [(0, s)]
    while heap:
        d, u = heapq.heappop(heap)
        if u in done:
            continue                      # 过期的堆条目
        done.add(u)
        for v, w in adj[u]:
            if v not in done and d + w < dist[v]:
                dist[v] = d + w
                heapq.heappush(heap, (dist[v], v))
    return dist

def bellman_ford(adj, s):
    """一轮又一轮地松弛每一条边,直到没有任何变化。"""
    dist = {v: INF for v in adj}
    dist[s] = 0
    for _ in range(len(adj) - 1):
        changed = False
        for u in adj:
            for v, w in adj[u]:
                if dist[u] + w < dist[v]:
                    dist[v] = dist[u] + w
                    changed = True
        if not changed:
            break
    return dist

def floyd_warshall(adj):
    """全源:每次多允许一个顶点作为中转站。"""
    d = {u: {v: 0 if u == v else INF for v in adj} for u in adj}
    for u in adj:
        for v, w in adj[u]:
            d[u][v] = min(d[u][v], w)
    for k in adj:
        for i in adj:
            for j in adj:
                if d[i][k] + d[k][j] < d[i][j]:
                    d[i][j] = d[i][k] + d[k][j]
    return d

G = graph([('S', 'A', 3), ('S', 'B', 6), ('A', 'C', 4), ('B', 'A', -4),
           ('C', 'T', 2), ('B', 'D', 3), ('D', 'T', 4)])
dj, bf, fw = dijkstra(G, 'S'), bellman_ford(G, 'S'), floyd_warshall(G)['S']
for v in G:
    print(v, dj[v], bf[v], fw[v], '' if dj[v] == bf[v] else '<- Dijkstra is wrong')
# S 0 0 0
# A 3 2 2 <- Dijkstra is wrong
# B 6 6 6
# C 7 6 6 <- Dijkstra is wrong
# T 9 8 8 <- Dijkstra is wrong
# D 9 9 9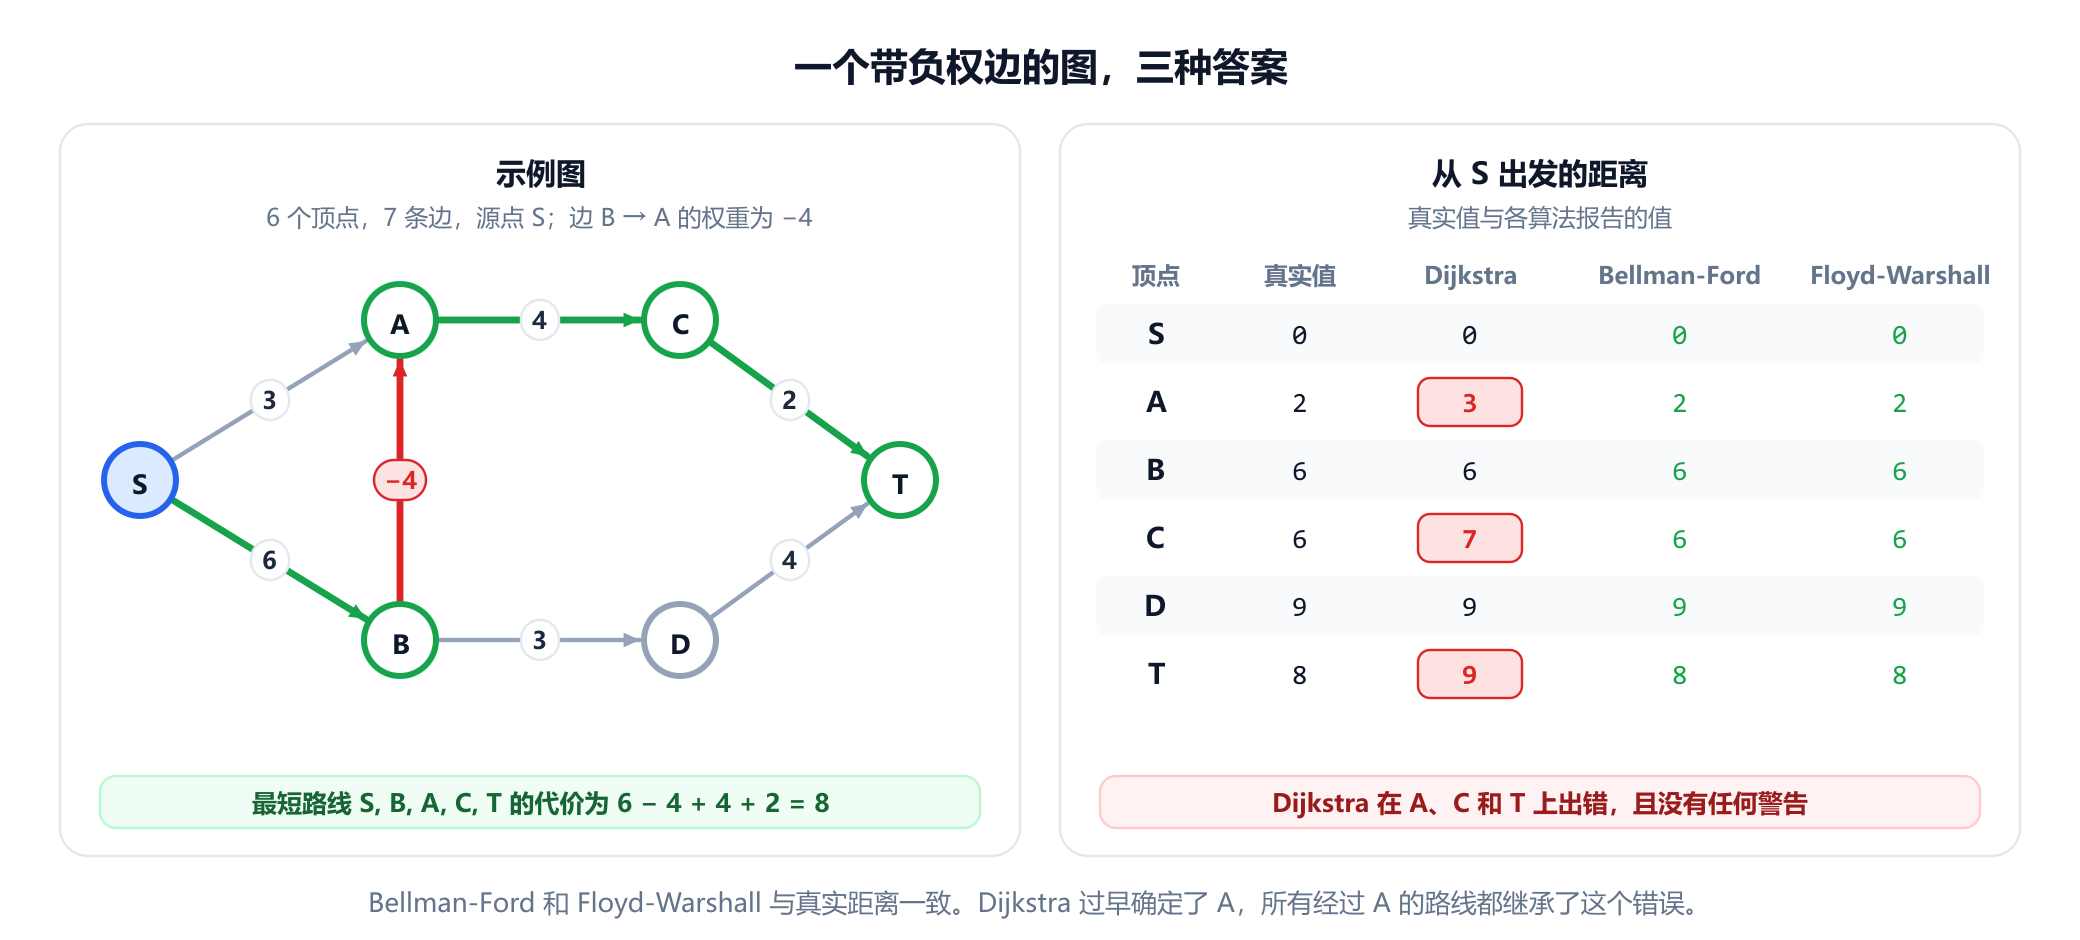
Bellman-Ford 和 Floyd-Warshall 返回真实的距离。Dijkstra 报告的是: 3 对应 A, 7 对应 C, 9 对应 T,全都偏高,而且它不会报错:错误的答案看起来和正确的答案一模一样。第 4 节解释了原因。在权重非负的图上,三者会给出相同的结果,唯一的区别是速度。
3. 每种算法做了什么
这三种算法都建立在同一个操作之上,即松弛。每个顶点 v 都带有一个暂定距离 dist[v],它的初始值为无穷大,源点则为 0。松弛边 u → v,其权重为 w,就是问经过 u 是否更便宜,如果是,就把它记录下来:
if dist[u] + w < dist[v]:
dist[v] = dist[u] + w暂定距离只会下降,而且它始终是某条真实路线的代价。这些算法的区别只在于松弛哪些边,以及按什么顺序松弛。
- Dijkstra 把尚未确定的顶点保存在优先队列中。它反复取出暂定距离最小的顶点,宣布这个距离为最终值,并松弛它的出边。每个顶点只被确定一次,每条边只被松弛一次。按照 Edsger Dijkstra 本人的说法,他在 1956 年用了大约二十分钟设计出这个算法,并于 1959 年发表。关于 Dijkstra 算法的指南逐步追踪了它的过程。
- Bellman-Ford 不做任何选择。它按任意固定的顺序松弛每一条边,然后重复。一条不含环的最短路径最多有
V - 1条边,而在第i轮之后,每条边数不超过i的最短路径都已经找到,所以V - 1轮总是足够的。这个名称结合了两个人:Richard Bellman 在 1958 年发表了按轮进行的方法,而 Lester Ford 在 1956 年的论文中给出了反复松弛边、直到无法改进为止的一般规则。Alfonso Shimbel 和 Edward Moore 在同一时期也找到了等价的方法。关于 Bellman-Ford 算法的指南证明了这个上界。 - Floyd-Warshall 一次计算出整张表。它每次多允许一个顶点作为中转站:在第
k步之后,元素[i][j]保存的是从i到j、且所有中间顶点都来自前k个顶点的最便宜路线。三重嵌套循环加一行算术。Bernard Roy 在 1959 年、Stephen Warshall 在 1962 年针对可达性发表了同样的方案,Robert Floyd 在 1962 年把它改用于最短路径。关于 Floyd-Warshall 算法的指南推导了其递推式。
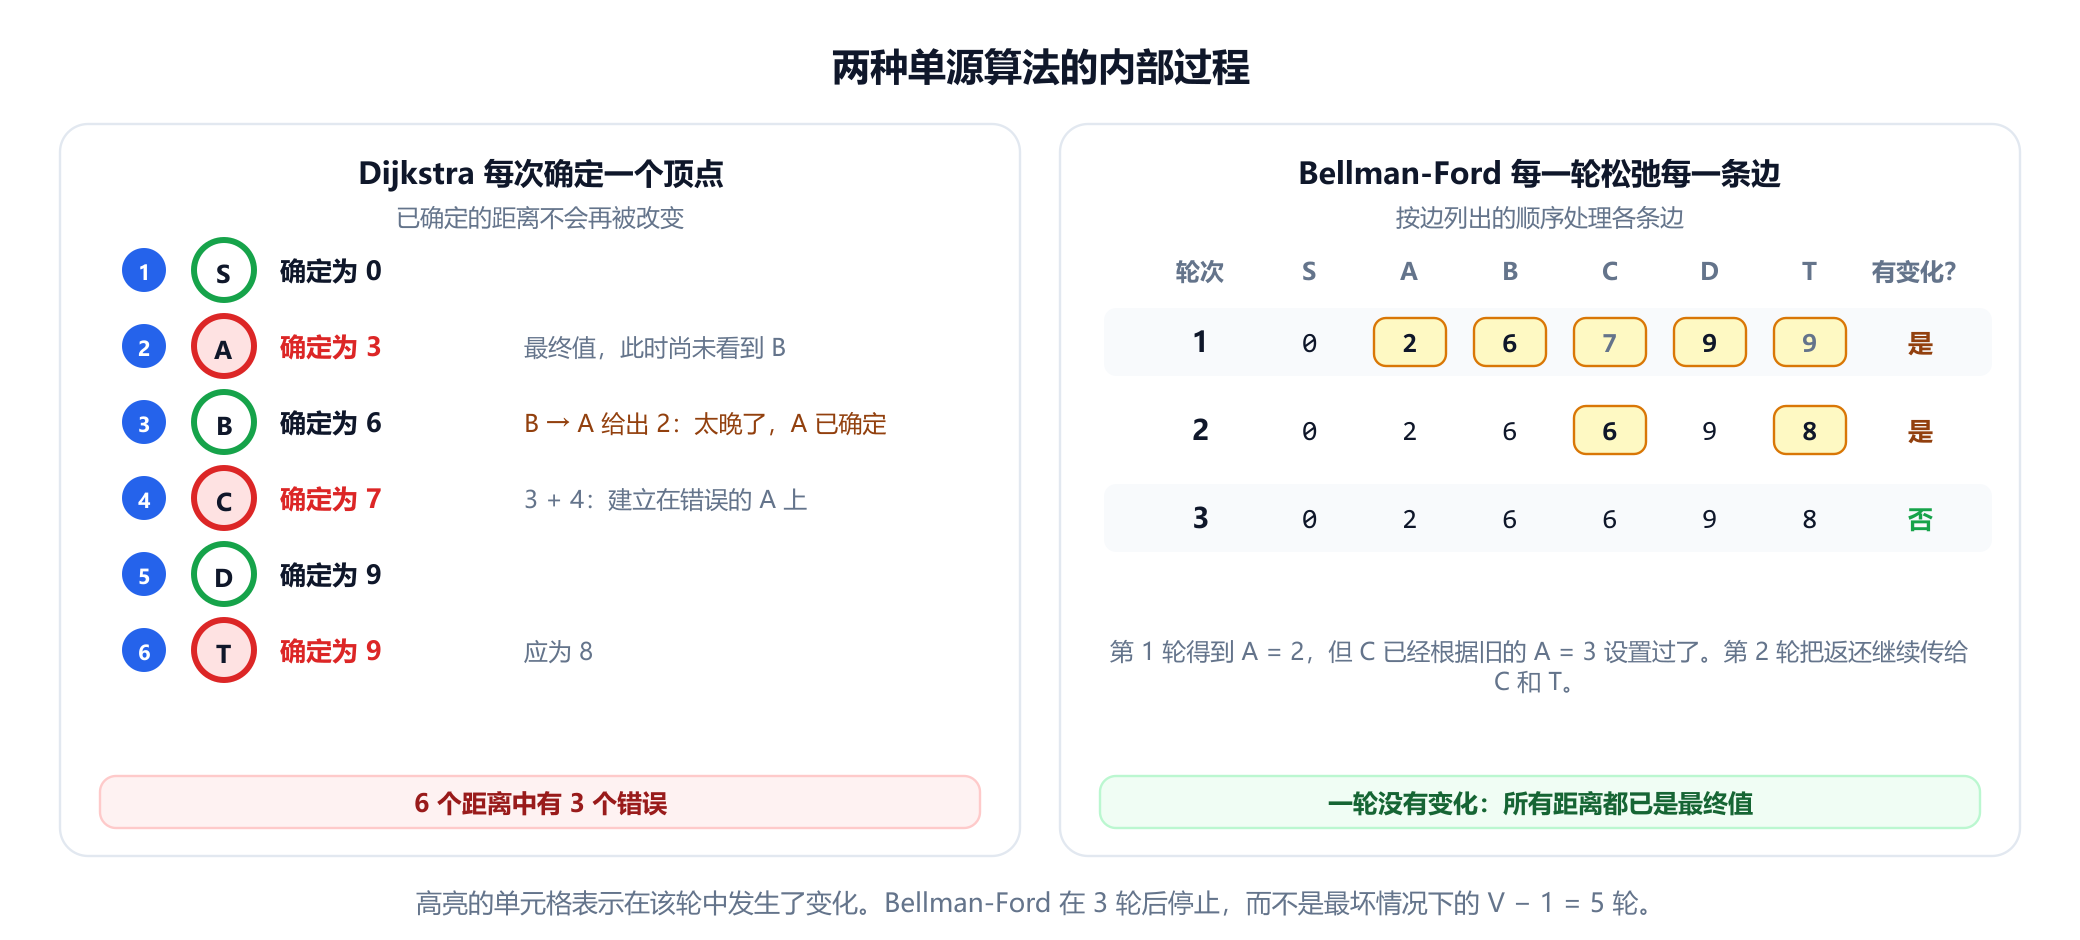
在这个示例上,Bellman-Ford 按边列出的顺序访问各条边。第一轮就已经把 A 降到 2,那是在它处理到 B的出边时,但此前它已经用旧值 3 设置了 C = 7。第二轮把这一改进继续传递下去,得到 C = 6 和 T = 8。第三轮没有任何变化,所以算法提前停止,而不必跑完全部 V - 1 = 5 轮。需要多少轮取决于边的顺序,但绝不会超过 V - 1轮。
4. Dijkstra 为什么在负权边上失效
Dijkstra 的速度来自一个承诺:一个顶点离开优先队列时,它的距离就是最终值。这个承诺依赖于一个需要非负权重的论证。假设 u 是距离最近的未确定顶点。到达 u 的任何其他路线,都必须经由某个未确定的顶点 x离开已确定的区域,而这个顶点的距离已经至少与 u一样远,路线的其余部分只会增加代价。有了负权边,路线的其余部分就可能减少代价,这个论证也就不成立了。
示例中发生的正是这种情况。Dijkstra 先将 S 确定为 0,然后将 A 确定为 3,因为 3 小于 B 的 6。当 B 被确定、它通向 A 的边给出 6 - 4 = 2时, A 已经是最终值,这个改进被丢弃了。所有建立在 A 之上的结果都继承了这个错误: C 被确定为 3 + 4 = 7,而不是 6, T 被确定为 9,而不是 8。
有两种诱人的修正方法并不奏效:
- 给每个权重加上一个常数。加 4 能使每个权重都非负,但这会为每条边多收 4,所以边数越多的路线受到的惩罚越大。在平移后的图上,Dijkstra 找到的是
S, A, C, T,其平移后的代价为 21,而真正的最短路线S, B, A, C, T的平移后代价为 24,因为它多了一条边。回到原来的权重,这条路线的代价是 9,而不是 8。第 7 节的 Johnson 算法展示了真正可行的重新赋权方法。 - 允许已确定的顶点重新打开。如果一个顶点在距离下降时可以重新进入队列,那么只要不存在负环,算法在有负权边时就是正确的。但让它快速的那个承诺没有了,而 Donald Johnson 在 1973 年证明,以这种方式修改以允许负权边的 Dijkstra 算法可能需要指数时间,大约为
n 2n步,这发生在一族有n个顶点的图上。此时,Bellman-Ford 有保证的O(V E)是更安全的选择。
在权重非负时,这些问题都不会出现,Dijkstra 是正确的,而且是三者中最快的。零权重没有问题:这个论证只要求没有任何边会使代价减少。
5. 负环
所谓负环,是指权重之和小于零的环。如果它能从源点到达,并且能到达目标,那就根本不存在最短路线:再绕这个环一圈总是更便宜。此时距离为负无穷,算法应当报告这个环,而不是一个数字。在示例中加入边 C → B,权重为 -5,那么环 B, A, C, B 的代价为 -4 + 4 - 5 = -5。
- Bellman-Ford 多做一轮就能检测到它。如果没有负环,在
V - 1轮之后就不可能再有任何改进;如果第V轮仍然降低了某个距离,就存在负环,而从发生变化的顶点沿父指针往回走,就会走到环上。 - Floyd-Warshall 在对角线上检测它。元素
[v][v]从 0 开始,只有当存在一条经过v、总权重为负的闭合路线时,它才可能变为负数。因此,负环存在当且仅当某个对角线元素最终小于零。一旦出现这种情况,其他元素就不再是有意义的距离了,Stefan Hougardy 在 2010 年证明它们可能变得指数级地大,所以最稳妥的做法是在循环内部检查对角线,一旦某个元素变为负数就立即停止。 - Dijkstra 无法检测负环。它直接假定这种情况不存在。
INF = float('inf')

def graph(edges):
    adj = {}
    for u, v, w in edges:
        adj.setdefault(u, []).append((v, w))
        adj.setdefault(v, [])
    return adj

def negative_cycle(adj):
    """从一个以代价 0 连接到每个顶点的虚拟源点运行 Bellman-Ford。
    以顶点列表的形式返回一个负环,或者返回 None。"""
    dist = {v: 0 for v in adj}
    parent = {v: None for v in adj}
    for _ in range(len(adj)):                  # 比通常多一轮
        last = None
        for u in adj:
            for v, w in adj[u]:
                if dist[u] + w < dist[v]:
                    dist[v], parent[v], last = dist[u] + w, u, v
        if last is None:
            return None                        # 一轮没有变化:不存在负环
    for _ in range(len(adj)):                  # 往回退足够多步,确保落在环上
        last = parent[last]
    cycle, v = [last], parent[last]
    while v != last:                           # 沿父指针绕环走一圈
        cycle.append(v)
        v = parent[v]
    cycle.reverse()                            # 父指针指向反方向
    return cycle + cycle[:1]

def floyd_warshall_diagonal(adj):
    """到自身的距离最终为负的顶点。"""
    d = {u: {v: 0 if u == v else INF for v in adj} for u in adj}
    for u in adj:
        for v, w in adj[u]:
            d[u][v] = min(d[u][v], w)
    for k in adj:
        for i in adj:
            for j in adj:
                if d[i][k] + d[k][j] < d[i][j]:
                    d[i][j] = d[i][k] + d[k][j]
    return [v for v in adj if d[v][v] < 0]

edges = [('S', 'A', 3), ('S', 'B', 6), ('A', 'C', 4), ('B', 'A', -4),
         ('C', 'T', 2), ('B', 'D', 3), ('D', 'T', 4)]
print(negative_cycle(graph(edges)))
# None
bad = graph(edges + [('C', 'B', -5)])          # B -> A -> C -> B 的代价为 -4 + 4 - 5 = -5
print(negative_cycle(bad))
# ['C', 'B', 'A', 'C']
print(floyd_warshall_diagonal(bad))
# ['A', 'B', 'C']
该函数从一个以代价 0 连接到每个顶点的虚拟源点开始运行 Bellman-Ford,所以它能找到图中任何位置的负环,而不只是从 S可达的负环。在原来的示例上,某一轮最终没有任何变化,于是它返回 None。加上那条额外的边后,它返回环 C, B, A, C,这是同一个环从不同起点写出的形式,而 Floyd-Warshall 在它的对角线上标出了 A、 B 和 C。在数千个随机图上的测试中,对角线标出负环的情形与负环实际存在的情形完全一致,但它并不总能标出每一个能到达负环的顶点,所以只应把它当作“是或否”的检验。
有一个陷阱让很多人中招。在无向图中,一条边可以沿两个方向行走,所以一条负权边本身就已经是一个负环: u, v, u。因此,在无向图的有向版本上运行 Bellman-Ford,只要有任何一条边为负,就会报告负环,Sedgewick 和 Wayne 的 Algorithms 一书明确指出了这个陷阱。在无向图中求带负权重的最短简单路径,需要另外一些更复杂的方法。
6. 速度:哪一个更快,在什么时候
对于单源问题,只要 Dijkstra 适用,快慢顺序就很明确:Dijkstra 使用二叉堆时为 O((V + E) log V),而 Bellman-Ford 为 O(V E)。在一个有 10,000 个顶点和 50,000 条边的图上,这大约是一百万次堆操作对比最多 5 亿次边松弛。Floyd-Warshall 不是单源方法,用它只求一个源点的距离,几乎浪费了它的全部工作。
对于全源问题,比较就没那么悬殊了,因为其他方案是从每个顶点各运行一次单源算法:
| 全源方法 | 时间 | 负权边 | 最适合 |
|---|---|---|---|
| 从每个顶点运行 Dijkstra | O(V (V + E) log V) | 否 | 稀疏图,权重非负 |
| 从每个顶点运行 Bellman-Ford | O(V2 E) | 是 | 几乎从不适用 |
| Floyd-Warshall | O(V3) | 是 | 稠密图或小规模图 |
| Johnson 算法 | O(V E + V (V + E) log V) | 是 | 带负权边的稀疏图 |
渐近界隐藏了常数,所以下面的程序统计了每种方法在两个有 100 个顶点的随机有向图上实际执行的基本步数:一个是有 300 条边的稀疏图,另一个是有 4,950 条边的稠密图,即全部可能边数的一半。对于 Dijkstra,它分别统计边检查和堆操作,因为一次堆操作大约需要 log V 步。
import heapq, random
INF = float('inf')

def random_graph(n, m, seed):
    """n 个顶点,m 条互不相同的有向边,权重为 1..100。"""
    rnd = random.Random(seed)
    pairs = rnd.sample([(u, v) for u in range(n) for v in range(n) if u != v], m)
    adj = {v: [] for v in range(n)}
    for u, v in pairs:
        adj[u].append((v, rnd.randint(1, 100)))
    return adj

def all_pairs_dijkstra(adj):
    """从每个顶点运行 Dijkstra。统计边检查次数和堆操作次数。"""
    checks = heap_ops = 0
    for s in adj:
        dist, heap = {v: INF for v in adj}, [(0, s)]
        dist[s] = 0
        while heap:
            d, u = heapq.heappop(heap)
            heap_ops += 1
            if d > dist[u]:
                continue
            for v, w in adj[u]:
                checks += 1
                if d + w < dist[v]:
                    dist[v] = d + w
                    heapq.heappush(heap, (dist[v], v))
                    heap_ops += 1
    return checks, heap_ops

def all_pairs_bellman_ford(adj):
    """从每个顶点运行 Bellman-Ford,某一轮没有变化时提前停止。"""
    m, checks = sum(len(a) for a in adj.values()), 0
    for s in adj:
        dist = {v: INF for v in adj}
        dist[s] = 0
        for _ in range(len(adj) - 1):
            changed = False
            for u in adj:
                for v, w in adj[u]:
                    if dist[u] + w < dist[v]:
                        dist[v], changed = dist[u] + w, True
            checks += m
            if not changed:
                break
    return checks

n = 100
for name, m in [('sparse', 3 * n), ('dense', n * (n - 1) // 2)]:
    adj = random_graph(n, m, seed=1)
    checks, heap_ops = all_pairs_dijkstra(adj)
    print(f'{name:6} E={m:4}  Dijkstra x V: {checks:7,} checks + {heap_ops:6,} heap ops   '
          f'Bellman-Ford x V: {all_pairs_bellman_ford(adj):9,}   Floyd-Warshall: {n ** 3:,}')
# sparse E= 300  Dijkstra x V:  27,565 checks + 21,388 heap ops   Bellman-Ford x V:   226,200   Floyd-Warshall: 1,000,000
# dense  E=4950  Dijkstra x V: 495,000 checks + 64,770 heap ops   Bellman-Ford x V: 2,712,600   Floyd-Warshall: 1,000,000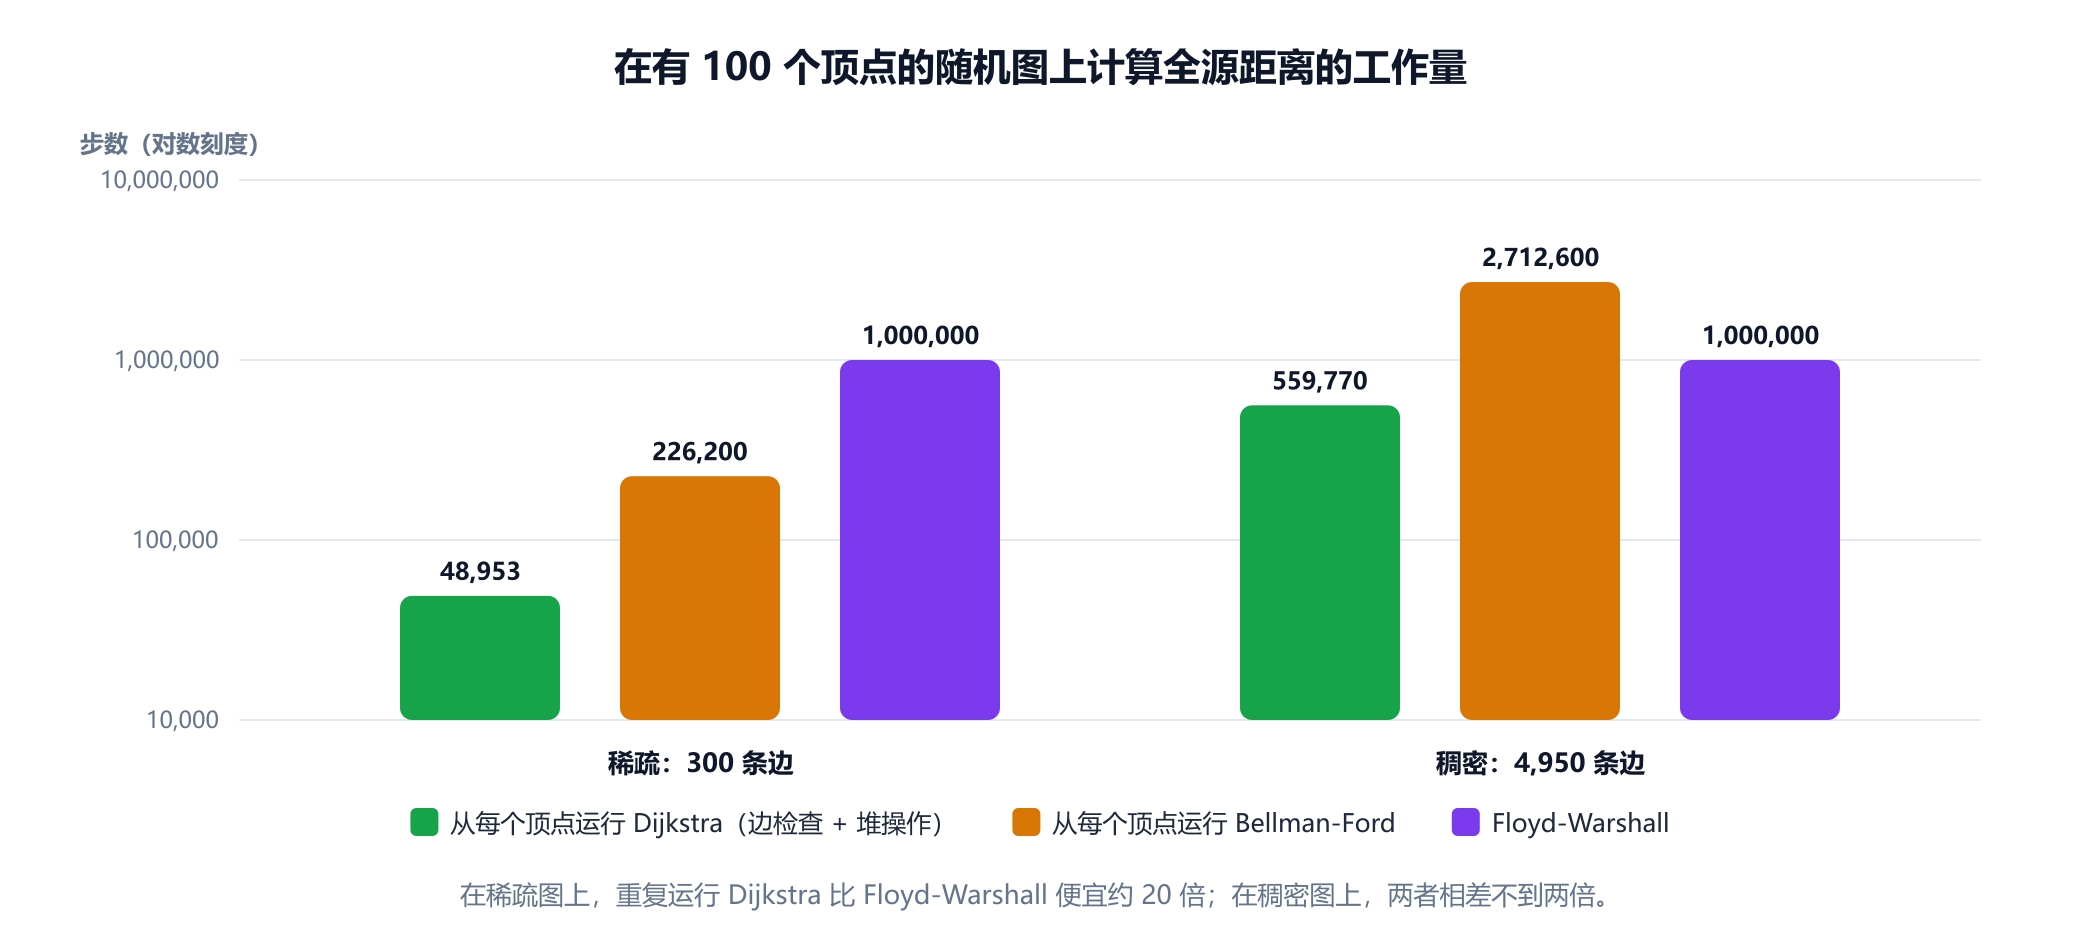
在稀疏图上,从每个顶点运行 Dijkstra 大约需要 49,000 步,而 Floyd-Warshall 固定需要 1,000,000 步,相差约 20 倍。在稠密图上,差距几乎消失;一旦把堆的每次操作的对数代价算进去,Floyd-Warshall 简单的内层循环按顺序访问内存、不需要优先队列,在实践中往往胜出。从每个顶点运行 Bellman-Ford 在两种情况下都是最慢的,即使提前停止也是如此。经验法则:在几百个顶点以下,或者当大多数顶点对之间都有边相连时,用 Floyd-Warshall,因为它简单;在大型稀疏图上,从每个顶点运行 Dijkstra 或 Johnson 算法。
7. 带负权边的全源最短路径:Johnson 算法
Donald Johnson 1977 年的算法兼得两者之长。它先运行一次 Bellman-Ford,为每个顶点计算一个数 h(v),即从一个以代价 0 连接到所有顶点的虚拟源点出发的距离。然后它把每个权重替换为
w'(u, v) = w(u, v) + h(u) - h(v)由于 h 对每条边都满足 h(v) ≤ h(u) + w(u, v),所以每个新权重都是非负的。而且沿着从 s 到 t 的任何路线,各项会依次相消,所以每条路线的代价都改变同样的量,即 h(s) - h(t)。最短路线仍然是最短的,现在就可以从每个顶点运行 Dijkstra 了。与加常数不同,这种重新赋权与路线有多少条边无关。
import heapq
INF = float('inf')

def graph(edges):
    adj = {}
    for u, v, w in edges:
        adj.setdefault(u, []).append((v, w))
        adj.setdefault(v, [])
    return adj

def dijkstra(adj, s):
    dist, heap = {v: INF for v in adj}, [(0, s)]
    dist[s] = 0
    while heap:
        d, u = heapq.heappop(heap)
        if d > dist[u]:
            continue
        for v, w in adj[u]:
            if d + w < dist[v]:
                dist[v] = d + w
                heapq.heappush(heap, (dist[v], v))
    return dist

def johnson(adj):
    """带负权边的全源最短路径:一次 Bellman-Ford,然后从每个顶点运行 Dijkstra。"""
    h = {v: 0 for v in adj}                    # 从虚拟源点出发的距离
    for _ in range(len(adj)):
        for u in adj:
            for v, w in adj[u]:
                h[v] = min(h[v], h[u] + w)
    for u in adj:
        for v, w in adj[u]:
            if h[u] + w < h[v]:
                raise ValueError('negative cycle')
    # 重新赋权:每条边都变为非负,每条路径都改变 h[s] - h[t]
    lifted = {u: [(v, w + h[u] - h[v]) for v, w in adj[u]] for u in adj}
    return {s: {t: d - h[s] + h[t] for t, d in dijkstra(lifted, s).items()} for s in adj}, lifted

G = graph([('S', 'A', 3), ('S', 'B', 6), ('A', 'C', 4), ('B', 'A', -4),
           ('C', 'T', 2), ('B', 'D', 3), ('D', 'T', 4)])
dist, lifted = johnson(G)
print({u: [(v, w) for v, w in lifted[u]] for u in ('S', 'A', 'B')})
# {'S': [('A', 7), ('B', 6)], 'A': [('C', 0)], 'B': [('A', 0), ('D', 3)]}
print(dist['S'])
# {'S': 0, 'A': 2, 'B': 6, 'C': 6, 'T': 8, 'D': 9}
print(dist['B'])
# {'S': inf, 'A': -4, 'B': 0, 'C': 0, 'T': 2, 'D': 3}
在这个示例中, h(A) = -4,其他每个顶点都得到 0。负权边 B → A 变为 0, S → A 从 3 升到 7, A → C 从 4 降到 0;在新权重上运行 Dijkstra,再用 h修正回来,就得到从每个源点出发的真实距离,包括 B 那一行及其负的元素 -4。如果 Bellman-Ford 在第一步中发现了负环,Johnson 算法就会停止并报告它。
8. 三者都不是最佳选择的情形
有些图具有某种结构,可以用更简单或更快的方法加以利用:
- 无权图。如果每条边都计为 1,广度优先搜索可以在
O(V + E)时间内求出从一个源点出发的所有距离。Dijkstra 会给出同样的答案,只是更慢。参见 BFS vs DFS。 - 无环图。在有向无环图中,按拓扑顺序处理各个顶点,并把每个顶点的出边各松弛一次。这需要
O(V + E)时间,而且适用于负权重。示例图没有环,所以这种方法只需一遍就能解决它。 - 只有权重 0 和 1。用双端队列代替优先队列:权重为 0 的边放到队首,权重为 1 的边放到队尾,这样就得到线性时间。
- 只有一个源点和一个目标,并且有好的估计。 A* 搜索在 Dijkstra 的优先级上加上对剩余距离的估计,在地图上探索的顶点要少得多。参见 A* 搜索算法。
9. 内存与路径的还原
仅有距离往往不够:你想要的是路线本身。Dijkstra 和 Bellman-Ford 为每个顶点存储一个父顶点,即最佳路线到达该顶点之前的那个顶点,而通往 t 的路线从 t开始倒着读出。这需要 O(V) 的额外内存。Floyd-Warshall 需要在距离表之外再保存一张完整的 V 乘 V 的“下一跳”表,所以它的内存为 O(V2)。对于 10,000 个顶点、每个元素 8 字节的情形,仅距离表就要占用大约 800 兆字节,下一跳表还要再占用同样多。在大型图上,通常是内存而不是时间让 Floyd-Warshall 无法使用。
10. 各自的应用场景
- Dijkstra 是凡涉及物理代价的场合的默认选择:道路导航、航班中转,以及互联网的链路状态路由协议,例如 OSPF,其中每台路由器都在一张网络地图上计算最短路径。
- Bellman-Ford 适合每个节点只知道其邻居的场景。RIP 等距离向量路由协议在整个网络中重复它的松弛步骤,每台路由器都根据邻居的表更新自己的表。它发现负环的能力被用来检测货币套利:取权重为
-log(rate),一串最终换得的钱比起初更多的交易,恰好就是一个负环。 - Floyd-Warshall 为小型图填充完整的距离表:用于聚类或旅行商问题的距离矩阵,以及传递闭包,即哪些顶点能到达哪些顶点的问题,这也是 Warshall 当年发表的版本。
11. 仍然活跃的研究领域
最短路径是算法领域最古老的问题之一,而相关的界至今仍在变化。2022 年,Aaron Bernstein、Danupon Nanongkai 和 Christian Wulff-Nilsen 证明,带负整数权重的单源最短路径问题可以在近乎线性的时间内求解,远低于 Bellman-Ford 的 O(V E)。2024 年,Bernhard Haeupler 及其合作者证明,配备经过适当设计的堆的 Dijkstra 算法,在按距离对顶点排序这一问题上是普遍最优(universally optimal)的:在每个固定的图上,它在所有边权下的最坏情况与任何算法所能达到的最好结果只差一个常数因子。而在 2025 年,Ran Duan 及其合作者针对权重非负的有向图给出了一个确定性算法,其运行时间为 O(E log2/3 V),在稀疏图上胜过 Dijkstra 的 O(E + V log V)。它之所以能突破长期以来所说的排序壁垒,是因为与 Dijkstra 不同,它并不按距离顺序输出顶点。这三篇论文都获得了最佳论文奖。在日常代码中,它们都还没有取代这三种经典算法,因为在那里简单性和较小的常数更为重要。
12. 常见错误
| 错误 | 为什么错 | 修正 |
|---|---|---|
| 在带负权边的图上运行 Dijkstra | 已确定的顶点不会被重新访问;示例中的 A、C 和 T 都算错了 | 使用 Bellman-Ford,全源问题则用 Johnson 算法 |
| 加一个常数使权重非负 | 它惩罚边数较多的路线,会改变哪条路线最短 | 像 Johnson 算法那样用势重新赋权 |
| 忽略负环 | 距离为负无穷;报告的任何数字都没有意义 | 多运行一轮 Bellman-Ford,或者检查 Floyd-Warshall 的对角线 |
| 无向图中的负权边 | 沿它走过去再走回来就是一个负环 | 把问题当作最短简单路径问题,这需要其他方法 |
| 用 Floyd-Warshall 求单个源点 | O(V3) 的工作量只为得到表中的一行 | 使用 Dijkstra 或 Bellman-Ford |
| 在巨大的稀疏图上使用 Floyd-Warshall | 大小为 V 乘 V 的表可能放不进内存 | 从你需要的源点运行 Dijkstra 或 Johnson 算法 |
使用 INF + w,而 INF 是一个固定的大整数 | 无穷大加上一个负权重看起来像真实的距离,或者会溢出 | 跳过从距离仍为无穷大的顶点出发的松弛 |
让 Bellman-Ford 恰好运行 V 轮并相信结果 | 第 V 轮是检验轮;在这一轮发生变化意味着存在负环 | 运行 V - 1 轮,然后再检查一次 |
13. 术语表
| 术语 | 含义 |
|---|---|
| 单源最短路径 | 从一个顶点到其他每个顶点的距离 |
| 全源最短路径 | 每一个有序顶点对之间的距离 |
| 松弛 | 检查经过多一条边的路线是否更便宜,如果是就记录下来 |
| 已确定的顶点 | 在 Dijkstra 算法中,距离已被宣布为最终值的顶点 |
| 负权边 | 权重小于零的边 |
| 负环 | 权重之和小于零的环 |
| 优先队列 | 总是返回最小键的数据结构;通常用二叉堆实现 |
| 势 | 为每个顶点指定的一个数 h(v),用于对边重新赋权,而不改变哪些路线是最短的 |
| 稠密图 | 所有顶点对中有很大比例由边相连的图 |
| 稀疏图 | 与 V2相比边数很少的图,边数通常是一个小的常数乘以 V |
| 传递闭包 | 记录哪些顶点能到达哪些顶点的表 |
14. 常见问题
Dijkstra、Bellman-Ford 和 Floyd-Warshall 有什么区别?
Dijkstra 和 Bellman-Ford 计算从一个源顶点到其他每个顶点的距离,而 Floyd-Warshall 计算每一对顶点之间的距离。Dijkstra 最快,但要求边权非负。Bellman-Ford 能处理负权重,并能在 O(VE) 时间内检测负环。Floyd-Warshall 也能处理负权重并检测负环,需要 O(V³) 时间和 O(V²) 内存。
为什么 Dijkstra 不适用于负权重?
一旦某个顶点成为距离最近的未确定顶点,Dijkstra 就宣布它的距离为最终值,并且再也不会重新访问它。只有当后续的边不可能降低代价时,这样做才是安全的。负权边恰恰可能做到这一点,所以 Dijkstra 可能过早地确定一个顶点,报告偏高的距离,而且没有任何警告。
Bellman-Ford 比 Dijkstra 慢吗?
是的,只要两者都适用。Bellman-Ford 的运行时间为 O(VE),而使用二叉堆的 Dijkstra 为 O((V + E) log V)。在一个有 10,000 个顶点和 50,000 条边的图上,这相当于最多 5 亿次边松弛对比大约一百万次堆操作。只有在权重可能为负或必须检测负环时,才使用 Bellman-Ford。
什么时候应该用 Floyd-Warshall,而不是从每个顶点运行 Dijkstra?
当你需要小规模图(最多几百个顶点)或稠密图(大多数顶点对之间都有边相连)中的全部顶点对距离时,以及当权重可能为负时,使用 Floyd-Warshall。在大型稀疏图上,从每个顶点运行 Dijkstra,或者在权重可能为负时使用 Johnson 算法,要快得多,占用的内存也少得多。
如何检测负环?
运行 Bellman-Ford V - 1 轮,然后再多运行一轮:如果这额外的一轮仍然降低了某个距离,就存在负环,从发生变化的顶点沿父指针往回走就会走到环上。使用 Floyd-Warshall 时,负环存在当且仅当最终距离矩阵对角线上的某个元素为负。Dijkstra 无法检测负环。
什么是 Johnson 算法?
Johnson 算法用于在带负权边的稀疏图中计算全源最短路径。它先运行一次 Bellman-Ford,为每个顶点求出一个势 h(v),再把每条边的权重重新赋为 w(u, v) + h(u) - h(v),这个值永不为负,并保持最短路径不变,然后从每个顶点运行 Dijkstra。使用二叉堆时,它的运行时间为 O(VE + V(V + E) log V)。
15. 参考文献
上文中的算法、界和归属均来自以下文献,按时间顺序排列。
- Shimbel, A. (1955). "Structure in Communication Nets." 载于 Proceedings of the Symposium on Information Networks,199 至 203 页。布鲁克林:Polytechnic Press of the Polytechnic Institute of Brooklyn。
- Ford, L. R. (1956). Network Flow Theory. 论文 P-923。圣莫尼卡:RAND Corporation。
- Bellman, R. (1958). "On a Routing Problem." Quarterly of Applied Mathematics 16(1),87 至 90 页。
- Dijkstra, E. W. (1959). "A Note on Two Problems in Connexion with Graphs." Numerische Mathematik 1,269 至 271 页。
- Moore, E. F. (1959). "The Shortest Path Through a Maze." 载于 Proceedings of an International Symposium on the Theory of Switching,285 至 292 页。马萨诸塞州剑桥:Harvard University Press。
- Roy, B. (1959). "Transitivité et connexité." Comptes Rendus de l'Académie des Sciences 249,216 至 218 页。
- Floyd, R. W. (1962). "Algorithm 97: Shortest Path." Communications of the ACM 5(6),345 页。
- Warshall, S. (1962). "A Theorem on Boolean Matrices." Journal of the ACM 9(1),11 至 12 页。
- Johnson, D. B. (1973). "A Note on Dijkstra's Shortest Path Algorithm." Journal of the ACM 20(3),385 至 388 页。
- Johnson, D. B. (1977). "Efficient Algorithms for Shortest Paths in Sparse Networks." Journal of the ACM 24(1),1 至 13 页。
- Fredman, M. L. 和 Tarjan, R. E. (1987). "Fibonacci Heaps and Their Uses in Improved Network Optimization Algorithms." Journal of the ACM 34(3),596 至 615 页。
- Moy, J. (1998). "OSPF Version 2." RFC 2328。Internet Engineering Task Force。
- Malkin, G. (1998). "RIP Version 2." RFC 2453。Internet Engineering Task Force。
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. 和 Stein, C. (2009). Introduction to Algorithms,第 3 版。马萨诸塞州剑桥:MIT Press。
- Frana, P. L. 和 Misa, T. J. (2010). "An Interview with Edsger W. Dijkstra." Communications of the ACM 53(8),41 至 47 页。
- Hougardy, S. (2010). "The Floyd-Warshall Algorithm on Graphs with Negative Cycles." Information Processing Letters 110(8 至 9),279 至 281 页。
- Sedgewick, R. 和 Wayne, K. (2011). Algorithms,第 4 版。新泽西州上萨德尔河:Addison-Wesley。
- Schrijver, A. (2012). "On the History of the Shortest Path Problem." Documenta Mathematica,Extra Volume ISMP,155 至 167 页。
- Bernstein, A., Nanongkai, D. 和 Wulff-Nilsen, C. (2022). "Negative-Weight Single-Source Shortest Paths in Near-linear Time." Proceedings of the 63rd IEEE Symposium on Foundations of Computer Science,600 至 611 页。
- Haeupler, B., Hladík, R., Rozhoň, V., Tarjan, R. E. 和 Tětek, J. (2024). "Universal Optimality of Dijkstra via Beyond-Worst-Case Heaps." Proceedings of the 65th IEEE Symposium on Foundations of Computer Science,2099 至 2130 页。
- Duan, R., Mao, J., Mao, X., Shu, X. 和 Yin, L. (2025). "Breaking the Sorting Barrier for Directed Single-Source Shortest Paths." Proceedings of the 57th ACM Symposium on Theory of Computing,36 至 44 页。