
Tabla de Contenidos
- 1. La respuesta corta
- 2. Una línea de diferencia
- 3. Un mapa, dos búsquedas
- 4. Por qué A* sigue encontrando el camino más corto
- 5. La heurística es un regulador
- 6. Cuánto ahorra A* en mapas típicos
- 7. El coste oculto de los empates
- 8. Cuándo es mejor opción Dijkstra
- 9. Heurísticas que rompen la garantía
- 10. Dónde se usa cada uno
- 11. Una breve historia
- 12. Errores comunes
- 13. Glosario
- 14. Preguntas frecuentes
- 15. Referencias
1. La respuesta corta
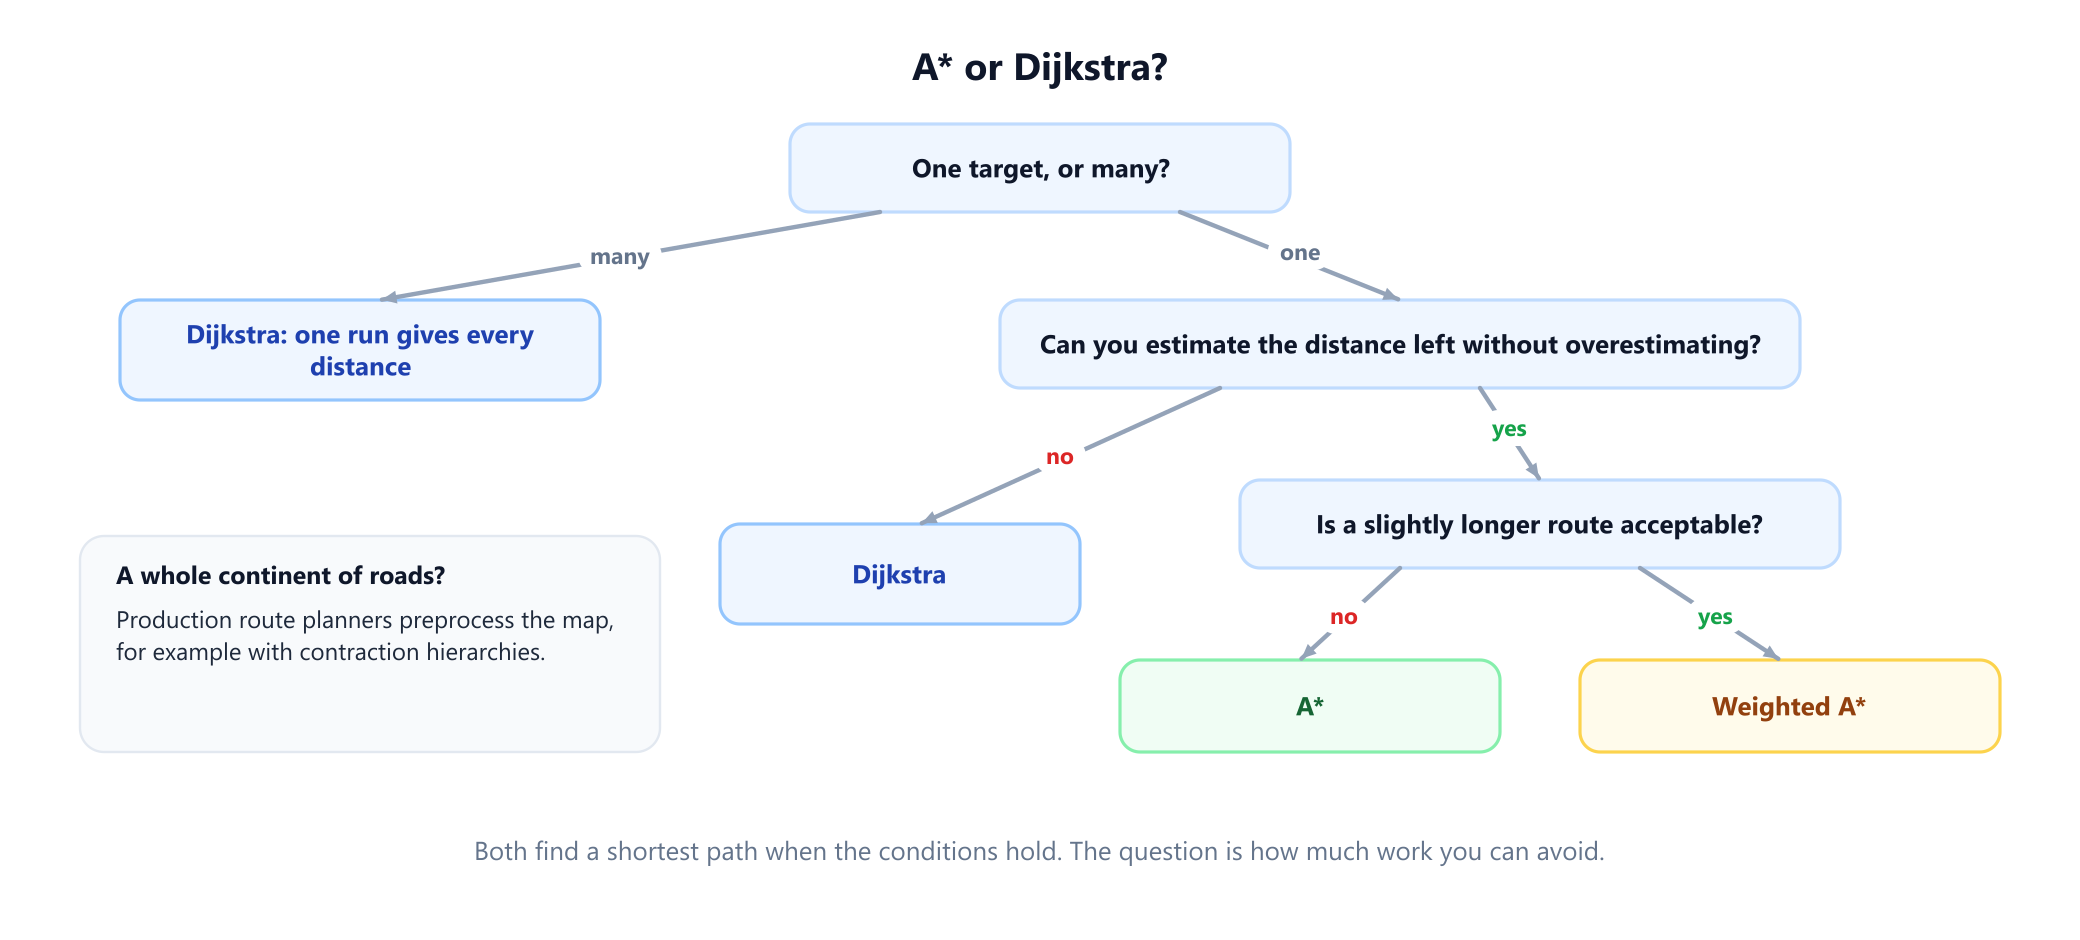
El algoritmo de Dijkstra y A* encuentran un camino más corto en un grafo ponderado con pesos de arista no negativos. La diferencia está en lo que saben. Dijkstra busca hacia fuera en todas las direcciones, porque no tiene ni idea de dónde está el objetivo. A* añade una estimación de la distancia restante, así que dedica su esfuerzo a la dirección que parece prometedora.
| Dijkstra | A* | |
|---|---|---|
| Qué responde | De un origen a todos los vértices, o a un objetivo | De un origen a un objetivo |
| Prioridad de un vértice | g: distancia desde el origen | f = g + h: distancia recorrida más distancia estimada restante |
| Necesita | Pesos de arista no negativos | Pesos de arista no negativos y una heurística h |
| Camino más corto garantizado | Sí | Sí, si h nunca sobreestima |
| Vértices explorados | Todos los que están más cerca que el objetivo | Normalmente muchos menos; cuántos depende de h |
| Peor caso en un grafo explícito | O((V + E) log V) | Lo mismo, con una heurística consistente h calculada en tiempo constante |
| Úsalo cuando | Necesitas muchos objetivos o no tienes una estimación útil | Quieres una ruta y puedes estimar la distancia |
En una frase: usa A* para una sola ruta en un mapa, donde las coordenadas te dan una buena estimación, y usa Dijkstra cuando necesites distancias a muchos lugares o cuando nada te indique hacia dónde está el objetivo. Más que rivales, son el mismo algoritmo con información distinta, como muestra la siguiente sección. Para ver cómo se compara Dijkstra con los métodos que admiten pesos negativos, consulta Dijkstra vs Bellman-Ford vs Floyd-Warshall.
2. Una línea de diferencia
Ambos algoritmos mantienen una cola de prioridad de vértices y expanden repetidamente el de menor prioridad. Llamemos g(v) al coste de la mejor ruta encontrada hasta ahora desde el inicio hasta v, y h(v) a una estimación del coste desde v hasta el objetivo, la llamada heurística.
Dijkstra:   prioridad(v) = g(v)
A*:         prioridad(v) = g(v) + h(v)
Esa es toda la diferencia. Haz h(v) = 0 para todos los vértices y A* se convierte en el algoritmo de Dijkstra. Así que toda afirmación sobre Dijkstra es una afirmación sobre A* con la heurística menos informativa posible, y todo lo que gana A* viene de h. La guía del algoritmo de Dijkstra y la guía del algoritmo de búsqueda A* explican cada uno paso a paso.
El efecto sobre la búsqueda es geométrico. Dijkstra expande los vértices por orden de distancia desde el inicio, así que su región explorada crece como un círculo. A* los expande por orden de la longitud total estimada de una ruta que pase por cada vértice, así que los vértices en la dirección equivocada reciben una prioridad alta y se quedan en la cola. El círculo se convierte en algo más parecido a una banda estrecha del inicio al objetivo.
3. Un mapa, dos búsquedas
El ejemplo que usaremos es una cuadrícula de 288 celdas con un muro en forma de copa, que bloquea 24 de ellas. Un robot parte de S y tiene que llegar a G, moviéndose una celda hacia arriba, abajo, izquierda o derecha con un coste de 1 por paso. El muro obliga a dar un rodeo: en una cuadrícula vacía G estaría a 22 pasos, pero la ruta más corta necesita 26. La heurística es la distancia Manhattan, el número de filas más el número de columnas entre una celda y el objetivo, que ignora los muros y por eso nunca puede sobreestimar.
import heapq

MAP = ["........................",
       "..........#########.....",
       "..S...............#.....",
       "..................#.....",
       "..................#.....",
       "..................#..G..",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "............#######.....",
       "........................"]

def locate(grid, ch):
    return next((r, row.index(ch)) for r, row in enumerate(grid) if ch in row)

def search(grid, start, goal, h, weight=1):
    """Búsqueda primero el mejor con f = g + weight * h. Con h = 0 es Dijkstra."""
    g = {start: 0}
    done, count = set(), 0
    heap = [(weight * h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue                                   # entrada obsoleta
        done.add(u)
        if u == goal:
            return g[u], len(done)                     # coste del camino, vértices expandidos
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < len(grid) and 0 <= v[1] < len(grid[0]) and grid[v[0]][v[1]] != '#':
                if g[u] + 1 < g.get(v, float('inf')):
                    g[v] = g[u] + 1
                    count += 1
                    heapq.heappush(heap, (g[v] + weight * h(v), count, v))
    return None

S, G = locate(MAP, 'S'), locate(MAP, 'G')
manhattan = lambda v: abs(v[0] - G[0]) + abs(v[1] - G[1])

print('Dijkstra        ', search(MAP, S, G, lambda v: 0))
# Dijkstra         (26, 232)
print('A* (Manhattan)  ', search(MAP, S, G, manhattan))
# A* (Manhattan)   (26, 149)
for w in (2, 5):
    print(f'weighted A*, w={w}', search(MAP, S, G, manhattan, weight=w))
# weighted A*, w=2 (26, 124)
# weighted A*, w=5 (26, 116)
print('greedy best-first', search(MAP, S, G, manhattan, weight=1000))
# greedy best-first (46, 108)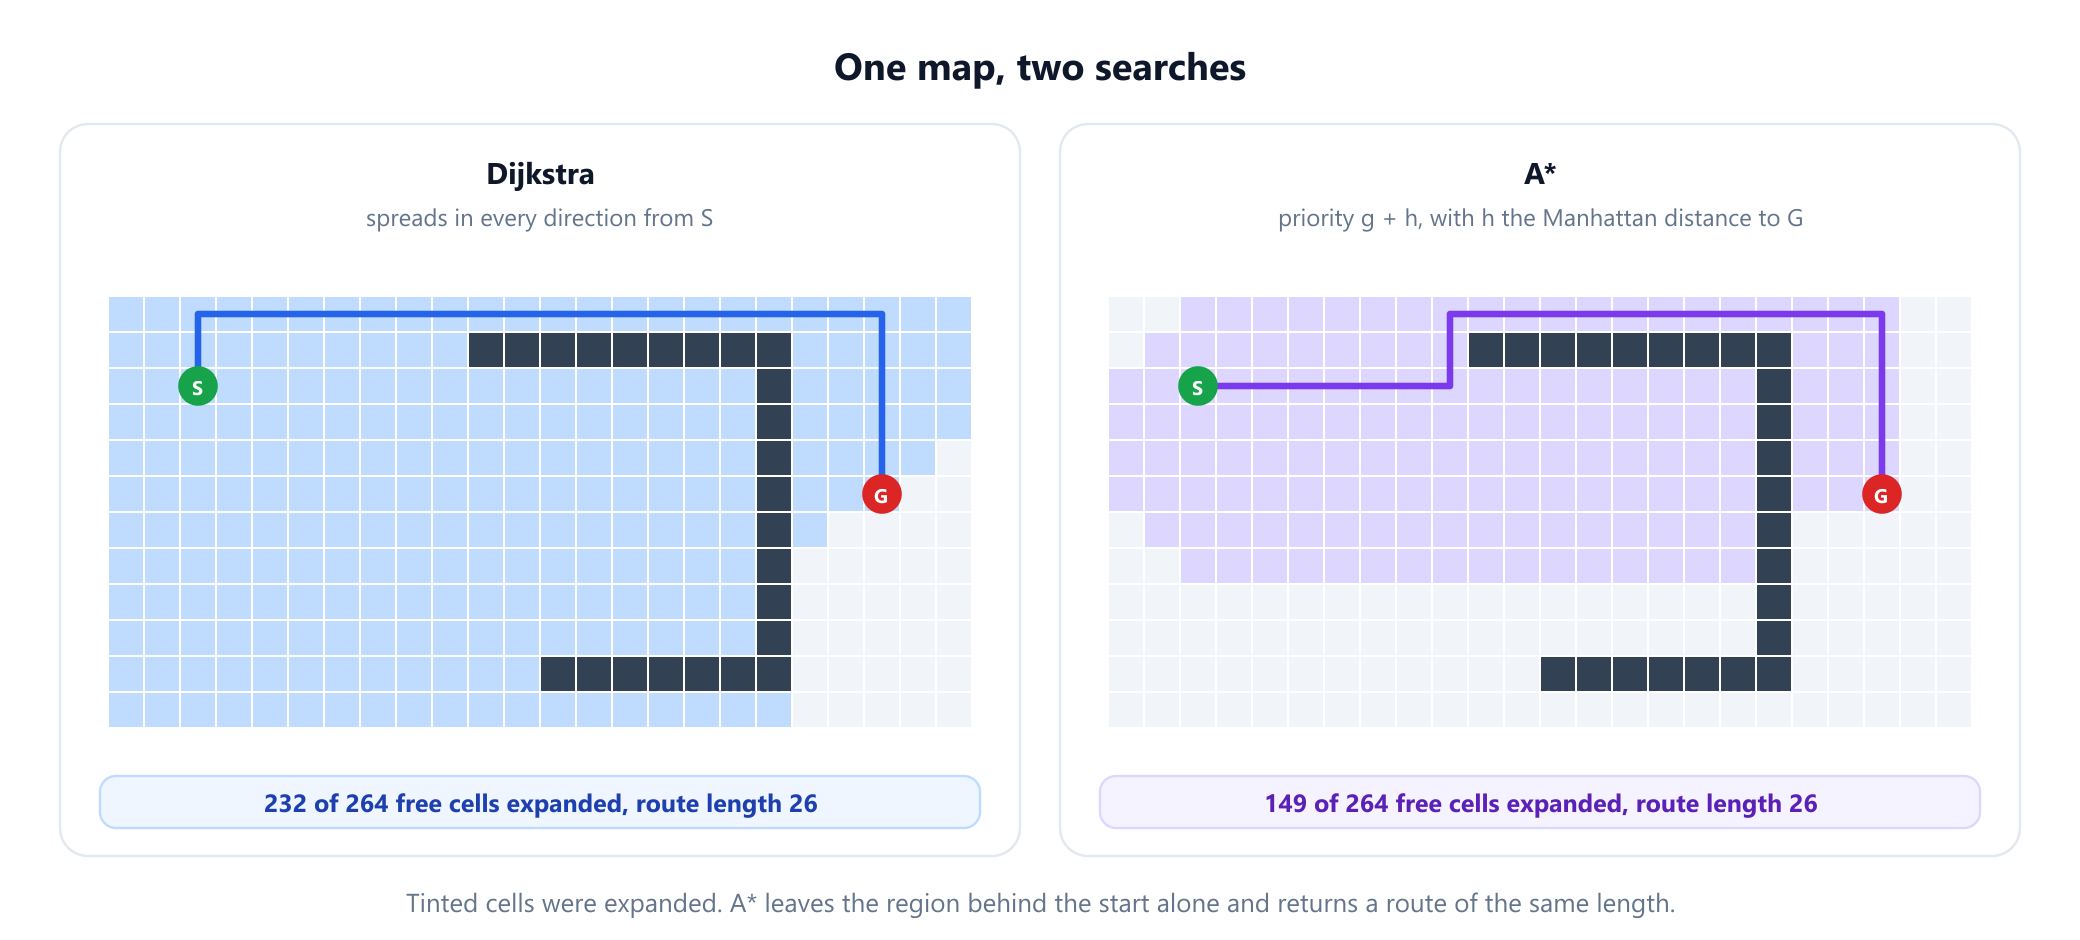
Ambos devuelven una ruta de longitud 26. Dijkstra expande 232 de las 264 celdas libres antes de llegar a G, incluidas celdas del extremo izquierdo que no llevan a ninguna parte. A* expande 149. No necesita las 232 porque ninguna celda cuyo valor f supere 26 puede estar en una ruta más corta, y A* nunca llega a ellas antes de terminar.
Ese ahorro del 36 % es modesto, porque este mapa se construyó para engañar a la heurística: dentro de la copa, la distancia Manhattan sigue prometiendo un recorrido recto a través del muro. La sección 6 mide A* en 800 rutas menos hostiles.
4. Por qué A* sigue encontrando el camino más corto
Una estimación suena arriesgada. La garantía proviene de una sola condición. Una heurística es admisible si nunca sobreestima el coste restante real. Supón que A* está a punto de terminar en el objetivo con una ruta de coste C, pero que una ruta más barata de coste C* < C sí existe. Algún vértice n de esa ruta más barata sigue esperando en la cola, y como h nunca sobreestima, f(n) = g(n) + h(n) ≤ C*. Por tanto, f(n) es menor que la prioridad del objetivo C, y A* habría expandido n antes. La ruta más barata no puede pasarse por alto.
Una condición más fuerte simplifica la implementación. Una heurística es consistente si, para cada arista de u a v con peso w, h(u) ≤ w + h(v): recorrer una arista nunca reduce la estimación en más de lo que cuesta esa arista. Con una heurística consistente, A* nunca tiene que expandir un vértice dos veces, exactamente igual que Dijkstra. De hecho, A* con una heurística consistente es el algoritmo de Dijkstra ejecutado sobre las aristas con pesos modificados w'(u, v) = w(u, v) - h(u) + h(v), todos ellos no negativos. La guía de A* en IA ofrece la demostración completa y un contraejemplo para heurísticas admisibles pero no consistentes.
En un sentido preciso, A* es además tan económico como puede serlo una búsqueda segura unidireccional. Rina Dechter y Judea Pearl demostraron en 1985 que, cuando la heurística es consistente, cualquier algoritmo que expanda vértices hacia fuera desde el inicio, use la misma heurística y tenga garantizado encontrar un camino más corto siempre que la heurística no sobreestime debe expandir todos los vértices que A* expande con seguridad, es decir, todos los vértices a los que algún camino desde el inicio llega con f por debajo del coste óptimo. Solo el tratamiento de los empates deja margen para mejorar, y las búsquedas bidireccionales quedan fuera del resultado.
5. La heurística es un regulador
Entre "no sabe nada" y "lo sabe todo" hay toda una gama de comportamientos, y el mismo código los cubre, usando un peso w en f = g + w * h. La salida del programa de la sección 3 muestra lo que ocurre en el ejemplo:
| Búsqueda | Prioridad | Celdas expandidas | Longitud de la ruta | Garantía |
|---|---|---|---|---|
| Dijkstra | g | 232 | 26 | La más corta |
| A* | g + h | 149 | 26 | La más corta |
A* ponderado, w = 2 | g + 2h | 124 | 26 | Como máximo 2 veces la más corta |
A* ponderado, w = 5 | g + 5h | 116 | 26 | Como máximo 5 veces la más corta |
| Búsqueda voraz primero el mejor | h | 108 | 46 | Ninguna |
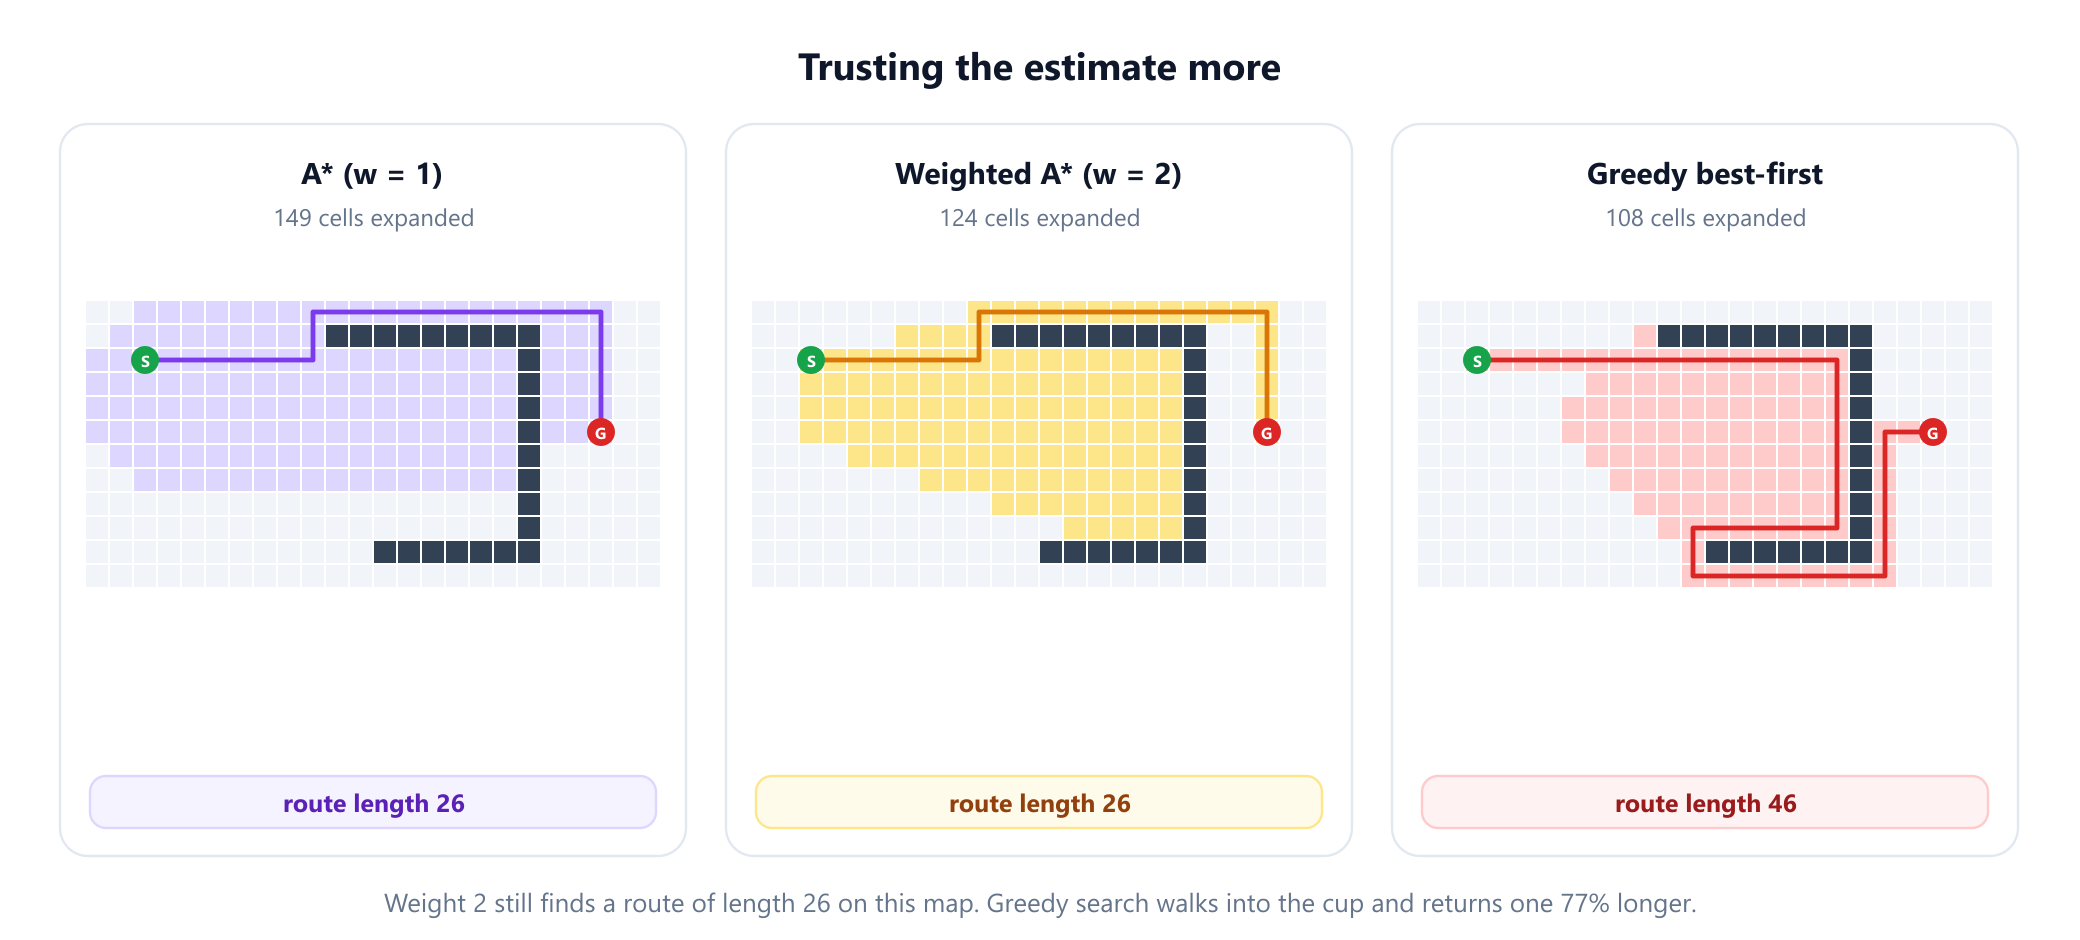
A* ponderado renuncia a la garantía de forma controlada: con una heurística consistente h, la ruta que devuelve es como máximo w veces la más corta. En este mapa, los pesos 2 y 5 aún encuentran, por casualidad, una ruta de longitud 26 con menos trabajo. La búsqueda voraz primero el mejor, que ignora g por completo, ahorra solo un poco más y se mete directamente en la copa, devolviendo una ruta de 46 pasos, un 77 % más larga de lo necesario. El trabajo que ahorra es pequeño comparado con la calidad que pierde.
En el otro extremo del regulador, una heurística perfecta, que siempre igualara el coste restante real, haría que A* fuera casi directamente al objetivo. Cuanto más se acerca a la realidad una h admisible, menos expande A*. Por eso el diseño de la heurística importa más que cualquier detalle de implementación.
6. Cuánto ahorra A* en mapas típicos
Un solo mapa demuestra poco. El siguiente programa compara las dos búsquedas en 200 rutas aleatorias sobre cada uno de cuatro tipos de mapa: cuadrículas de 60 por 60 sin muros, con un 20 % y con un 35 % de muros, y una red de carreteras de 1500 pueblos en posiciones aleatorias, cada uno unido a sus 4 vecinos más cercanos por una carretera hasta un 40 % más larga que la línea recta. En las cuadrículas la heurística es la distancia Manhattan, y en las carreteras, la distancia en línea recta. Dijkstra se detiene en cuanto llega al objetivo, lo que mantiene justa la comparación.
import heapq, math, random

def search(neighbours, start, goal, h):
    """A*; pasa h = lambda v: 0 para Dijkstra. Devuelve (coste, vértices expandidos)."""
    g, done, count = {start: 0}, set(), 0
    heap = [(h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return g[u], len(done)
        for v, w in neighbours(u):
            if g[u] + w < g.get(v, float('inf')):
                g[v] = g[u] + w
                count += 1
                heapq.heappush(heap, (g[v] + h(v), count, v))
    return None

def compare(neighbours, h_for, pairs):
    """Expansiones medias de Dijkstra y de A* sobre los pares que están conectados."""
    dij = star = runs = 0
    for s, t in pairs:
        d = search(neighbours, s, t, lambda v: 0)
        if d is None:
            continue
        a = search(neighbours, s, t, h_for(t))
        assert abs(a[0] - d[0]) < 1e-9                 # el mismo coste, siempre
        dij += d[1]; star += a[1]; runs += 1
    return dij // runs, star // runs

def grid_trial(density, rnd, n=60, trials=200):
    wall = {(r, c) for r in range(n) for c in range(n) if rnd.random() < density}
    free = [(r, c) for r in range(n) for c in range(n) if (r, c) not in wall]
    def neighbours(u):
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < n and 0 <= v[1] < n and v not in wall:
                yield v, 1
    h_for = lambda t: lambda v: abs(v[0] - t[0]) + abs(v[1] - t[1])
    return compare(neighbours, h_for, [rnd.sample(free, 2) for _ in range(trials)])

def road_trial(rnd, n=1500, trials=200):
    """Pueblos en puntos aleatorios, cada uno unido a sus 4 más cercanos; las carreteras serpentean hasta un 40 % más que la línea recta."""
    pts = [(rnd.random(), rnd.random()) for _ in range(n)]
    adj = [{} for _ in range(n)]
    for i, p in enumerate(pts):
        for j in sorted((j for j in range(n) if j != i), key=lambda j: math.dist(p, pts[j]))[:4]:
            w = math.dist(p, pts[j]) * rnd.uniform(1.0, 1.4)
            adj[i][j] = adj[j][i] = min(w, adj[i].get(j, w))
    neighbours = lambda u: adj[u].items()
    h_for = lambda t: lambda v: math.dist(pts[v], pts[t])
    return compare(neighbours, h_for, [rnd.sample(range(n), 2) for _ in range(trials)])

rnd = random.Random(1)
for density in (0.0, 0.2, 0.35):
    print(f'grid 60x60, {density:.0%} walls:', grid_trial(density, rnd))
print('road network, 1500 towns:', road_trial(rnd))
# grid 60x60, 0% walls: (1767, 451)
# grid 60x60, 20% walls: (1312, 238)
# grid 60x60, 35% walls: (1105, 397)
# road network, 1500 towns: (731, 235)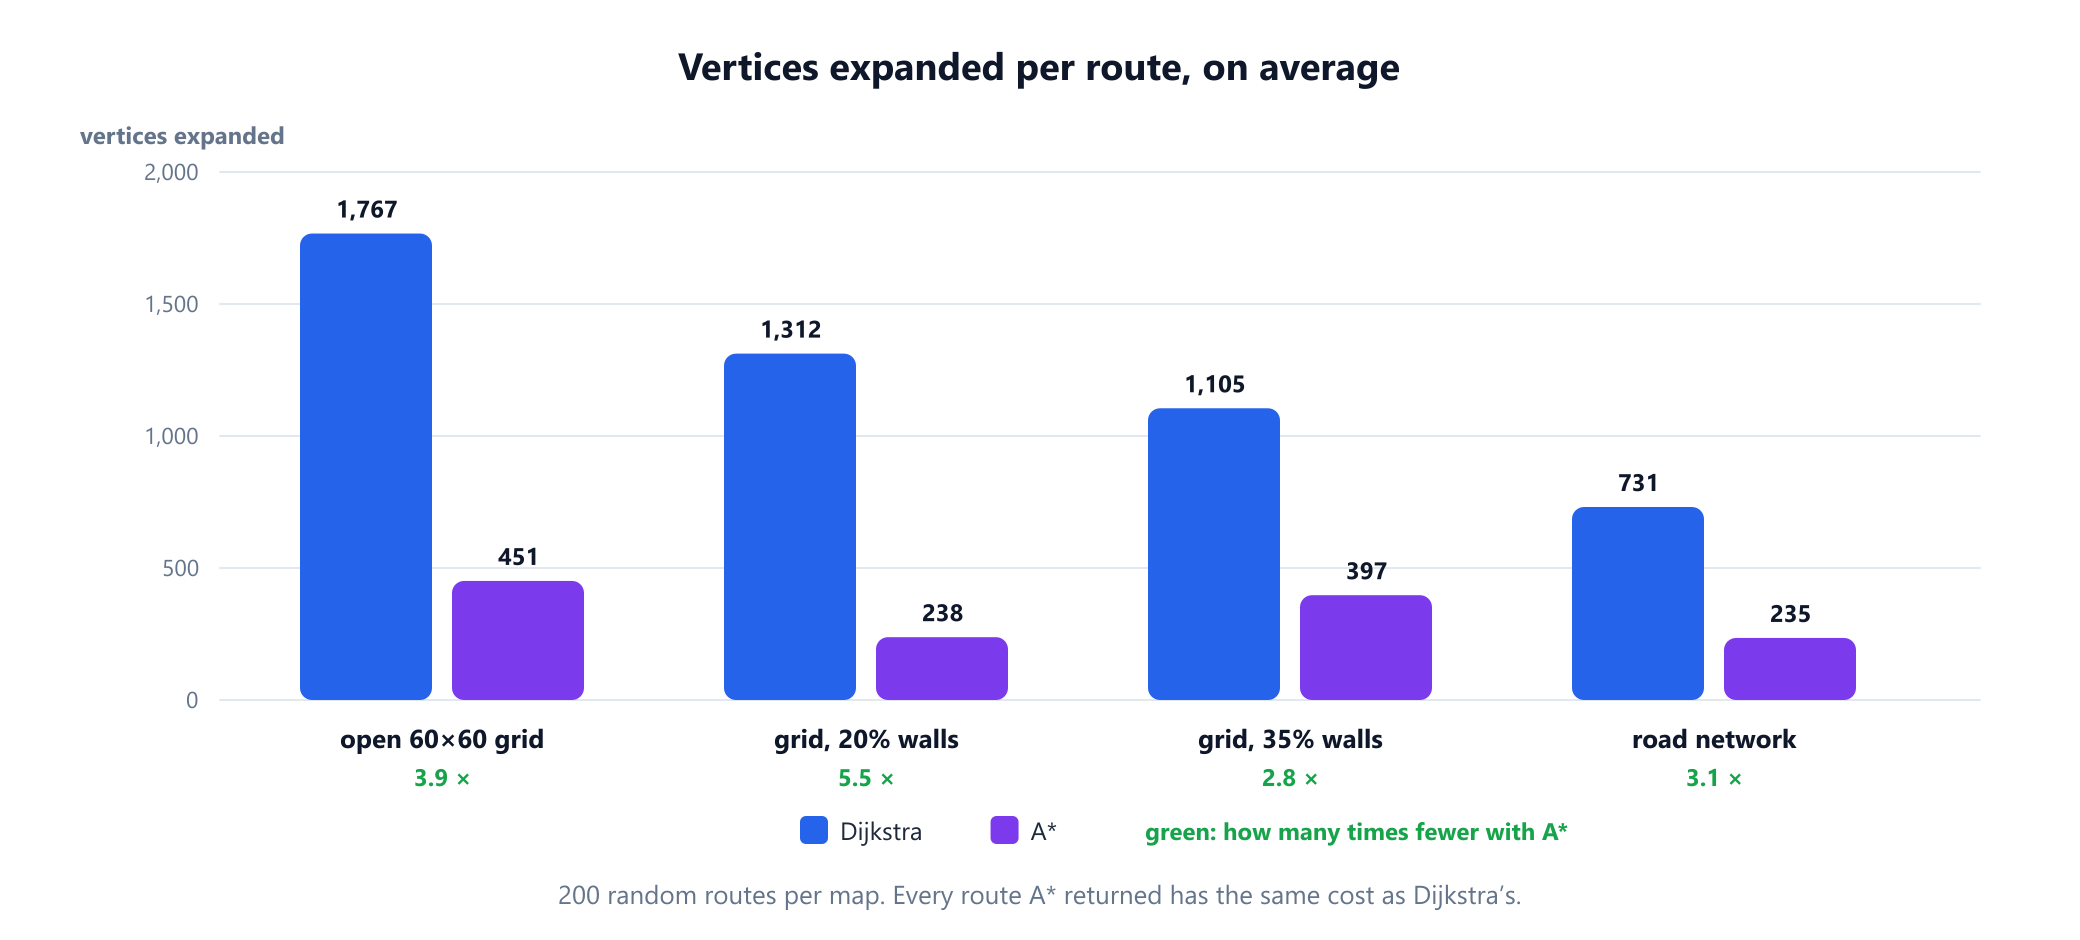
En todos los tipos de mapa, A* expandió entre un tercio y un quinto de lo que expandió Dijkstra, y devolvió exactamente el mismo coste en cada ruta; el programa lo comprueba en cada ejecución. El ahorro es mayor con un 20 % de muros (unas 5,5 veces). En la cuadrícula vacía es menor solo por los empates descritos en la sección 7, y con un 35 % de muros (2,8 veces) los frecuentes rodeos hacen menos precisa la estimación. En la red de carreteras el ahorro es de unas 3 veces, porque las carreteras serpentean y la distancia en línea recta se queda corta.
Expandir menos vértices no significa automáticamente tardar menos. A* tiene que calcular h para cada vértice que toca, y la cola de prioridad contiene más entradas con prioridades parecidas. En estos mapas la heurística es una línea de aritmética, así que el ahorro es real. Una heurística cara de calcular puede devolver la ventaja.
7. El coste oculto de los empates
En una cuadrícula sin muros, una enorme cantidad de celdas tiene exactamente el mismo valor f y el orden en que A* las toma lo decide todo. El siguiente programa ejecuta A* de esquina a esquina en una cuadrícula vacía de 40 por 40 con tres reglas de desempate distintas.
import heapq

def expansions(n, tie):
    """A* en una cuadrícula vacía de n por n, de esquina a esquina. tie(h, count) ordena los valores f iguales."""
    goal = (n - 1, n - 1)
    h = lambda v: abs(v[0] - goal[0]) + abs(v[1] - goal[1])
    g, done, count = {(0, 0): 0}, set(), 0
    heap = [(h((0, 0)), tie(h((0, 0)), 0), (0, 0))]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return len(done)
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < n and 0 <= v[1] < n and g[u] + 1 < g.get(v, float('inf')):
                g[v] = g[u] + 1
                count += 1
                heapq.heappush(heap, (g[v] + h(v), tie(h(v), count), v))

n = 40
print('oldest entry first  ', expansions(n, lambda h, c: (c,)))
print('newest entry first  ', expansions(n, lambda h, c: (-c,)))
print('closest to the goal ', expansions(n, lambda h, c: (h, c)))
# oldest entry first   1600
# newest entry first   79
# closest to the goal  79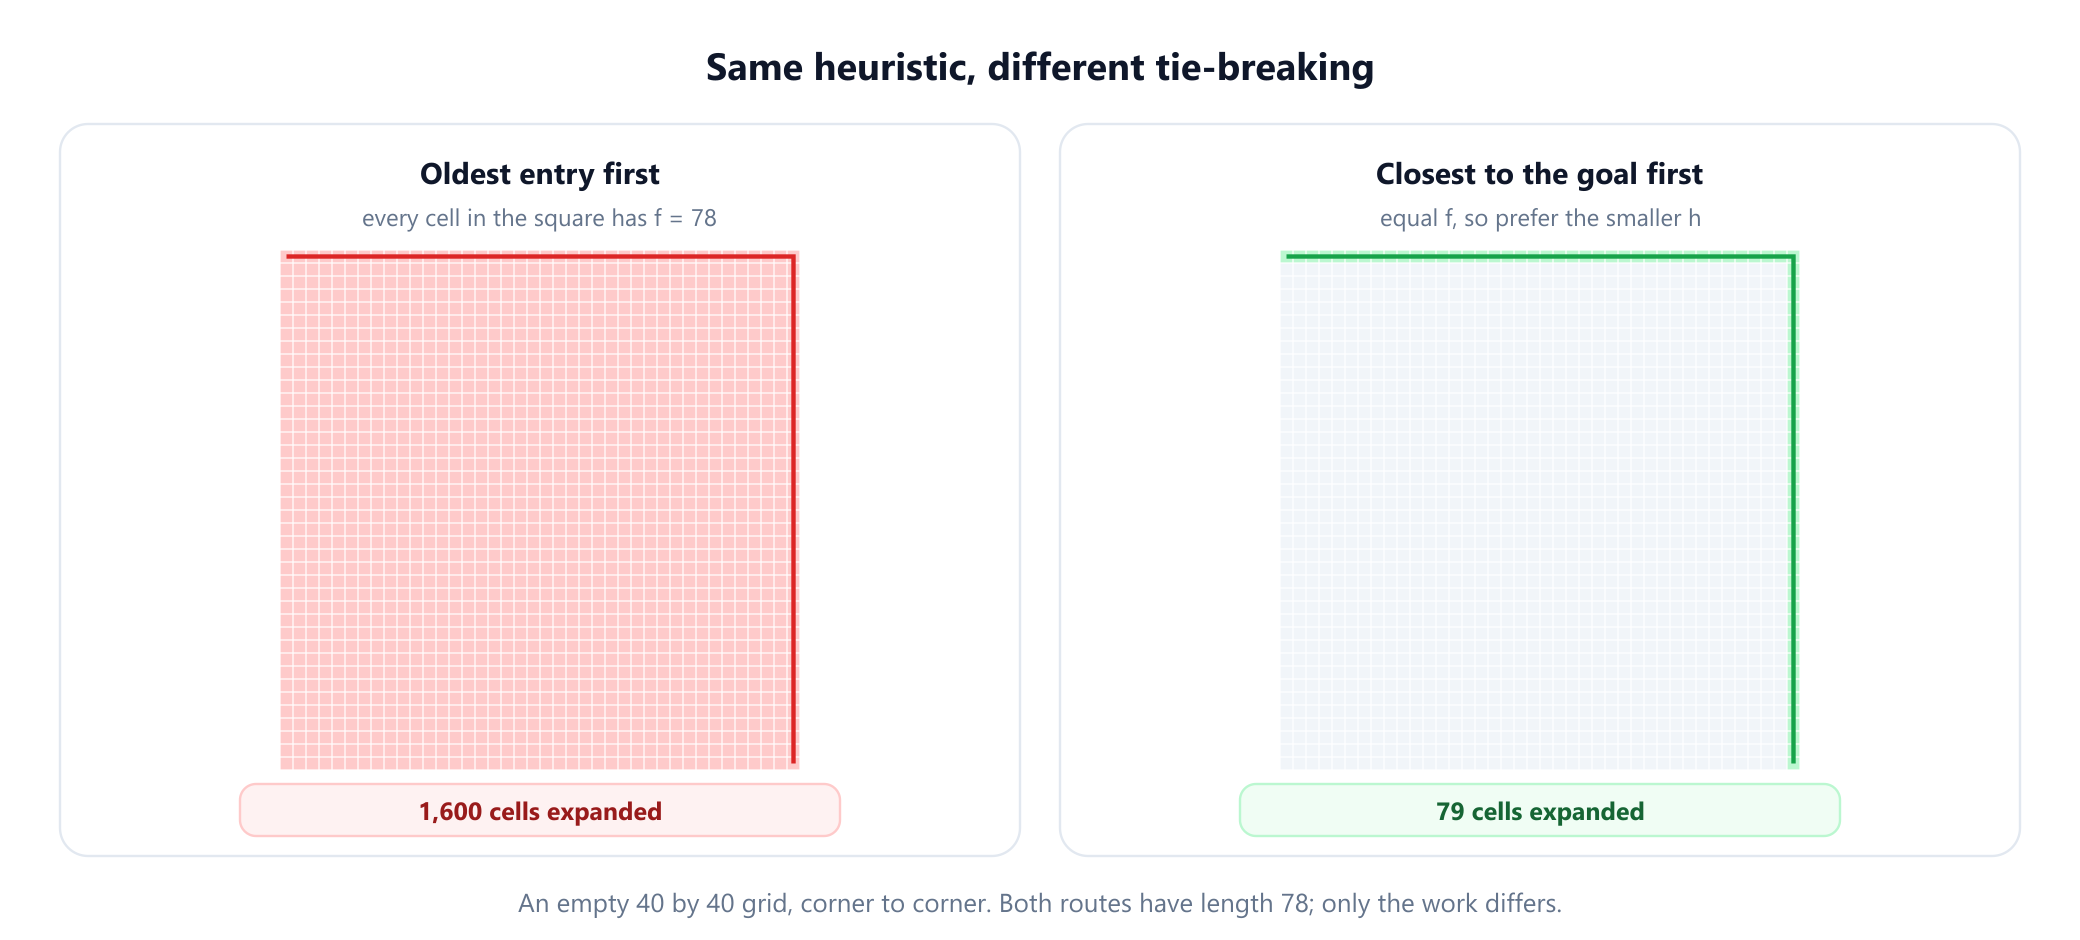
Con los empates resueltos a favor de la entrada más antigua, A* expande las 1600 celdas, sin mejorar a Dijkstra. Si prefieres la celda con menor h, que es la de mayor g, expande 79, las celdas de una única ruta; tomar primero la entrada más reciente resulta hacer lo mismo aquí. Todas las celdas del cuadrado están en alguna ruta más corta, así que todas tienen f = 78; la regla simplemente decide si explorar todas esas rutas igual de buenas o comprometerse con una. Al comparar implementaciones de A*, la regla de desempate puede importar más que la estructura de datos.
8. Cuándo es mejor opción Dijkstra
- Necesitas muchos objetivos. Una sola ejecución de Dijkstra desde un origen da la distancia a todos los vértices. Ejecutar A* una vez por objetivo repite trabajo, y una heurística orientada a un objetivo no sirve para los demás.
- No hay una estimación con sentido. A* necesita alguna noción de lo lejos que está el objetivo. En una red social, un grafo de citas o un grafo de dependencias no hay coordenadas desde las que medir, y
h = 0convierte A* de nuevo en Dijkstra, con contabilidad adicional. - El objetivo está cerca de todo. Si el objetivo está cerca del inicio o el grafo es pequeño, hay poco que ahorrar.
- La respuesta se reutiliza. Una tabla de distancias o un árbol de caminos más cortos calculados una vez con Dijkstra pueden servir para muchas consultas posteriores desde el mismo origen.
- Quieres el código correcto más simple. Dijkstra no tiene ninguna heurística que diseñar ni en la que equivocarse.
Y algunos problemas no necesitan ninguno de los dos. Si todas las aristas cuentan igual, la búsqueda en anchura encuentra rutas más cortas sin ninguna cola de prioridad, como BFS vs DFS explica.
9. Heurísticas que rompen la garantía
A* es tan fiable como su heurística, y el error clásico es usar una diseñada para otros movimientos. La distancia Manhattan es segura cuando solo puedes moverte en cuatro direcciones. Si permites movimientos diagonales, sobreestima, ya que un paso diagonal cubre lo que ella cuenta como dos. La estimación correcta para el movimiento en ocho direcciones es la distancia octil. El siguiente programa usa movimientos rectos de coste 10 y diagonales de coste 14 en el mismo mapa.
import heapq

MAP = ["........................",
       "..........#########.....",
       "..S...............#.....",
       "..................#.....",
       "..................#.....",
       "..................#..G..",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "............#######.....",
       "........................"]
STEPS = [(-1, 0, 10), (0, 1, 10), (1, 0, 10), (0, -1, 10), (-1, 1, 14), (1, 1, 14), (1, -1, 14), (-1, -1, 14)]

def search(start, goal, h):
    """A* con 8 direcciones: los movimientos rectos cuestan 10 y los diagonales 14."""
    g, done, count = {start: 0}, set(), 0
    heap = [(h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return g[u], len(done)
        for dr, dc, w in STEPS:
            v = (u[0] + dr, u[1] + dc)
            if 0 <= v[0] < len(MAP) and 0 <= v[1] < len(MAP[0]) and MAP[v[0]][v[1]] != '#':
                if g[u] + w < g.get(v, float('inf')):
                    g[v] = g[u] + w
                    count += 1
                    heapq.heappush(heap, (g[v] + h(v), count, v))

S, G = (1, 19), (10, 0)                        # de arriba a la derecha a abajo a la izquierda, rodeando el muro
def manhattan(v):
    return 10 * (abs(v[0] - G[0]) + abs(v[1] - G[1]))
def octile(v):
    dr, dc = abs(v[0] - G[0]), abs(v[1] - G[1])
    return 10 * max(dr, dc) + 4 * min(dr, dc)

print('Dijkstra ', search(S, G, lambda v: 0))
print('octile   ', search(S, G, octile))
print('Manhattan', search(S, G, manhattan))
# Dijkstra  (234, 261)
# octile    (234, 21)
# Manhattan (288, 45)
Dijkstra y A* con la distancia octil encuentran la verdadera ruta más corta, de coste 234, y A* necesita solo 21 expansiones en lugar de 261. La distancia Manhattan devuelve una ruta de coste 288, un 23 % demasiado larga, y sin avisar. Una heurística que sobreestima es rápida y errónea a la vez, lo que la hace fácil de pasar por alto.
Conviene conocer dos trampas relacionadas. Una heurística puede ser admisible y, sin embargo, inconsistente, en cuyo caso puede que un vértice deba expandirse más de una vez: una implementación con un conjunto cerrado que se niega a reabrir vértices, como las de aquí, puede entonces devolver una ruta que no es la más corta. Y los pesos de arista negativos rompen ambos algoritmos; para ellos, consulta el algoritmo de Bellman-Ford.
10. Dónde se usa cada uno
- Videojuegos. A* sobre cuadrículas y mallas de navegación es el estándar para mover unidades. Jump Point Search, de Daniel Harabor y Alban Grastien, acelera A* en cuadrículas uniformes saltándose las celdas que las rutas simétricas hacen redundantes.
- Robótica. A* se creó para esto: Peter Hart, Nils Nilsson y Bertram Raphael lo desarrollaron en el Stanford Research Institute, y el IEEE Milestone del robot Shakey atribuye su origen a ese proyecto.
- Redes. Los protocolos de enrutamiento por estado de enlace, como OSPF, usan Dijkstra, ya que cada router necesita rutas a todos los destinos y no a uno solo.
- Rutas por carretera a escala continental. Tanto Dijkstra como A*, en su forma básica, son demasiado lentos para todo un continente. Los sistemas a escala continental documentados públicamente preprocesan el mapa. Las jerarquías de contracción añaden aristas de atajo por adelantado, y ALT combina A* con distancias a unos pocos puntos de referencia elegidos para obtener una heurística mejor.
- Puzles y planificación. A* y su variante de bajo consumo de memoria IDA*, de Richard Korf, resuelven problemas como el puzle de piezas deslizantes, donde el grafo es demasiado grande para almacenarlo y se genera a medida que avanza la búsqueda.
La memoria suele ser el verdadero límite. Ambos algoritmos almacenan todos los vértices que han alcanzado, así que en grafos implícitos enormes A* puede quedarse sin memoria mucho antes de quedarse sin tiempo. Para ese caso se creó IDA*.
11. Una breve historia
Edsger Dijkstra publicó su algoritmo en 1959. Nueve años después, Hart, Nilsson y Raphael publicaron A* en "A Formal Basis for the Heuristic Determination of Minimum Cost Paths", y en 1972 publicaron una breve corrección sobre el papel de la consistencia en su demostración de optimalidad. Ira Pohl estudió funciones de evaluación ponderadas en 1970. Dechter y Pearl establecieron en 1985 exactamente en qué sentido A* es óptimo. Los dos algoritmos suelen presentarse como una progresión, pero, como mostró la sección 2, A* contiene a Dijkstra como el caso particular h = 0.
12. Errores comunes
| Error | Por qué está mal | Solución |
|---|---|---|
| Usar A* para calcular muchos objetivos | La heurística apunta a un objetivo y el trabajo se repite para cada uno | Ejecuta Dijkstra una vez desde el origen |
| Usar la distancia Manhattan con movimientos diagonales | Sobreestima, y en el ejemplo devuelve 288 en lugar de 234 | Usa la distancia octil |
| Suponer que A* siempre es más rápido | Con h = 0 o con una h costosa, hace el mismo trabajo o más | Mide, y mantén barata la heurística |
| Ignorar los empates | En una cuadrícula abierta de 40 por 40, la regla hace pasar de 1600 expansiones a 79 | Desempata a favor del menor valor de h |
| Comparar con un Dijkstra que no se detiene en el objetivo | Una ejecución completa explora todo el grafo y exagera el ahorro | Detén Dijkstra cuando expanda el objetivo |
| Tratar la búsqueda voraz primero el mejor como un A* más rápido | No tiene garantía y devolvió 46 pasos en lugar de 26 | Usa A* ponderado si quieres un compromiso acotado |
| Usar un conjunto cerrado con una heurística inconsistente | Una ruta mejor a un vértice cerrado se descarta | Usa una heurística consistente o permite reabrir |
| Ejecutar cualquiera de los dos con aristas negativas | Ambos suponen que el coste nunca disminuye a lo largo de una ruta | Usa Bellman-Ford o el algoritmo de Johnson |
13. Glosario
| Término | Significado |
|---|---|
| g(v) | El coste de la mejor ruta encontrada hasta ahora desde el inicio hasta v |
| h(v) | La heurística: una estimación del coste desde v hasta el objetivo |
| f(v) | g(v) + h(v), el coste total estimado de una ruta que pasa por v |
| Expansión | Sacar un vértice de la cola y examinar sus vecinos |
| Heurística admisible | La que nunca sobreestima el coste restante real |
| Heurística consistente | La que cumple h(u) ≤ w + h(v) para cada arista |
| Distancia Manhattan | Filas más columnas entre dos celdas; segura para el movimiento en cuatro direcciones |
| Distancia octil | La distancia en la cuadrícula cuando se permiten movimientos diagonales |
| A* ponderado | A* con f = g + w * h, que cambia calidad de la ruta por velocidad |
| Búsqueda voraz primero el mejor | Búsqueda ordenada solo por h y sin ninguna garantía |
| Desempate | La regla que ordena los vértices con valores f iguales |
| IDA* | Una variante de A* en profundidad que usa muy poca memoria |
14. Preguntas frecuentes
¿Cuál es la diferencia entre A* y Dijkstra?
Dijkstra ordena los vértices por g, la distancia desde el inicio. A* los ordena por f = g + h, donde h es una estimación de la distancia que queda hasta el objetivo. Con h = 0 los dos son el mismo algoritmo. La estimación permite a A* concentrarse en la dirección del objetivo, así que normalmente explora muchos menos vértices y aun así encuentra un camino más corto.
¿A* es siempre más rápido que Dijkstra?
No siempre. A* suele expandir muchos menos vértices cuando existe una buena estimación: entre tres y cinco veces y media menos en los mapas aleatorios medidos aquí. Con una heurística cero, con una heurística lenta de calcular o con un mal desempate, puede hacer tanto trabajo como Dijkstra o más. Una sola ejecución de Dijkstra también es mejor cuando necesitas distancias a muchos objetivos.
¿A* siempre encuentra el camino más corto?
Solo si la heurística es admisible, es decir, si nunca sobreestima el coste restante real. Si puede sobreestimar, A* puede devolver una ruta más larga sin ningún aviso. Una implementación que nunca reabre un vértice también necesita que la heurística sea consistente, es decir, que h(u) sea como máximo w(u, v) + h(v) para cada arista.
¿A* es lo mismo que Dijkstra con una heurística?
Sí, en un sentido preciso. A* con h = 0 es el algoritmo de Dijkstra, y A* con una heurística consistente se comporta exactamente como Dijkstra ejecutado sobre las aristas con pesos modificados w(u, v) - h(u) + h(v), todos ellos no negativos.
¿Cuándo debería usar Dijkstra en lugar de A*?
Usa Dijkstra cuando necesites distancias desde un origen a muchos o a todos los vértices, cuando no exista una estimación útil de la distancia restante, como en grafos sociales o de dependencias, o cuando lo más importante sea el código correcto más simple. Usa A* cuando quieras una ruta a un objetivo y puedas estimar la distancia, por ejemplo a partir de coordenadas en un mapa.
¿Cuál es la mejor heurística para A* en una cuadrícula?
Depende de los movimientos. Usa la distancia Manhattan para el movimiento en cuatro direcciones y la distancia octil cuando se permitan movimientos diagonales. Usar la distancia Manhattan con movimientos diagonales sobreestima y puede devolver una ruta demasiado larga. Desempatar a favor del vértice más cercano al objetivo también marca una gran diferencia en cuadrículas abiertas.
15. Referencias
Los algoritmos, resultados y atribuciones anteriores proceden de estas fuentes, listadas en orden cronológico.
- Dijkstra, E. W. (1959). "A Note on Two Problems in Connexion with Graphs." Numerische Mathematik 1, 269 a 271.
- Hart, P. E., Nilsson, N. J. y Raphael, B. (1968). "A Formal Basis for the Heuristic Determination of Minimum Cost Paths." IEEE Transactions on Systems Science and Cybernetics 4(2), 100 a 107.
- Pohl, I. (1970). "Heuristic Search Viewed as Path Finding in a Graph." Artificial Intelligence 1(3 a 4), 193 a 204.
- Hart, P. E., Nilsson, N. J. y Raphael, B. (1972). "Correction to 'A Formal Basis for the Heuristic Determination of Minimum Cost Paths'." SIGART Newsletter 37, 28 a 29.
- Pearl, J. (1984). Heuristics: Intelligent Search Strategies for Computer Problem Solving. Reading, MA: Addison-Wesley.
- Dechter, R. y Pearl, J. (1985). "Generalized Best-First Search Strategies and the Optimality of A*." Journal of the ACM 32(3), 505 a 536.
- Korf, R. E. (1985). "Depth-First Iterative-Deepening: An Optimal Admissible Tree Search." Artificial Intelligence 27(1), 97 a 109.
- Moy, J. (1998). "OSPF Version 2." RFC 2328. Internet Engineering Task Force.
- Goldberg, A. V. y Harrelson, C. (2005). "Computing the Shortest Path: A* Search Meets Graph Theory." En Proceedings of the 16th ACM-SIAM Symposium on Discrete Algorithms, 156 a 165.
- Geisberger, R., Sanders, P., Schultes, D. y Delling, D. (2008). "Contraction Hierarchies: Faster and Simpler Hierarchical Routing in Road Networks." En Experimental Algorithms, Lecture Notes in Computer Science 5038, 319 a 333.
- Thayer, J. T. y Ruml, W. (2008). "Faster than Weighted A*: An Optimistic Approach to Bounded Suboptimal Search." En Proceedings of the 18th International Conference on Automated Planning and Scheduling, 355 a 362.
- Harabor, D. y Grastien, A. (2011). "Online Graph Pruning for Pathfinding on Grid Maps." En Proceedings of the 25th AAAI Conference on Artificial Intelligence, 1114 a 1119.
- Bast, H., Delling, D., Goldberg, A., Müller-Hannemann, M., Pajor, T., Sanders, P., Wagner, D. y Werneck, R. F. (2016). "Route Planning in Transportation Networks." En Algorithm Engineering, Lecture Notes in Computer Science 9220, 19 a 80.
Hazlos competir en tu propio mapa
Dibuja un muro en el visualizador de A* y observa hasta dónde se extiende la búsqueda. Luego ejecuta Dijkstra en el mismo grafo y compara cuántos vértices visita cada uno.
Abrir el visualizador