
Table des Matières
- 1. La réponse courte
- 2. Une entreprise, quatre gagnants
- 3. Degré et proximité : contacts et portée
- 4. Intermédiarité : par qui passent les itinéraires
- 5. Centralité de vecteur propre : qui sont vos contacts
- 6. PageRank : suivre les liens
- 7. Culs-de-sac, boucles fermées et facteur d'amortissement
- 8. Les mesures concordent-elles ?
- 9. Grands graphes : estimer l'intermédiarité
- 10. Où ces mesures sont utilisées
- 11. Un bref historique
- 12. Erreurs fréquentes
- 13. Glossaire
- 14. Questions fréquentes
- 15. Références
1. La réponse courte
Une mesure de centralité attribue à chaque sommet d'un graphe un score qui dit à quel point il est important. Il n'existe pas de score juste unique, car « important » peut vouloir dire plusieurs choses : avoir beaucoup de connexions, être proche de tout le monde, se trouver sur les itinéraires entre les autres, ou être relié à d'autres qui sont eux-mêmes importants. Chacune de ces idées est une mesure différente, et sur un même réseau elles peuvent désigner des gagnants différents.
| Mesure | La question à laquelle elle répond | Coût | À utiliser pour |
|---|---|---|---|
| Degré | Qui a le plus de connexions directes ? | O(V + E) | Un premier aperçu rapide ; la portée immédiate |
| Proximité | Qui peut atteindre tout le monde en un minimum de pas ? | O(V(V + E)) | Propager quelque chose vite depuis un seul endroit |
| Intermédiarité | Qui se trouve sur les itinéraires entre les autres paires ? | O(VE) non pondéré | Goulots d'étranglement, intermédiaires, points de contrôle uniques |
| Vecteur propre | Qui est relié à des personnes bien connectées ? | O(E) par itération | L'influence dans les réseaux non orientés |
| PageRank | Où un surfeur aléatoire passe-t-il le plus de temps ? | O(V + E) par itération | Réseaux orientés : liens, citations |
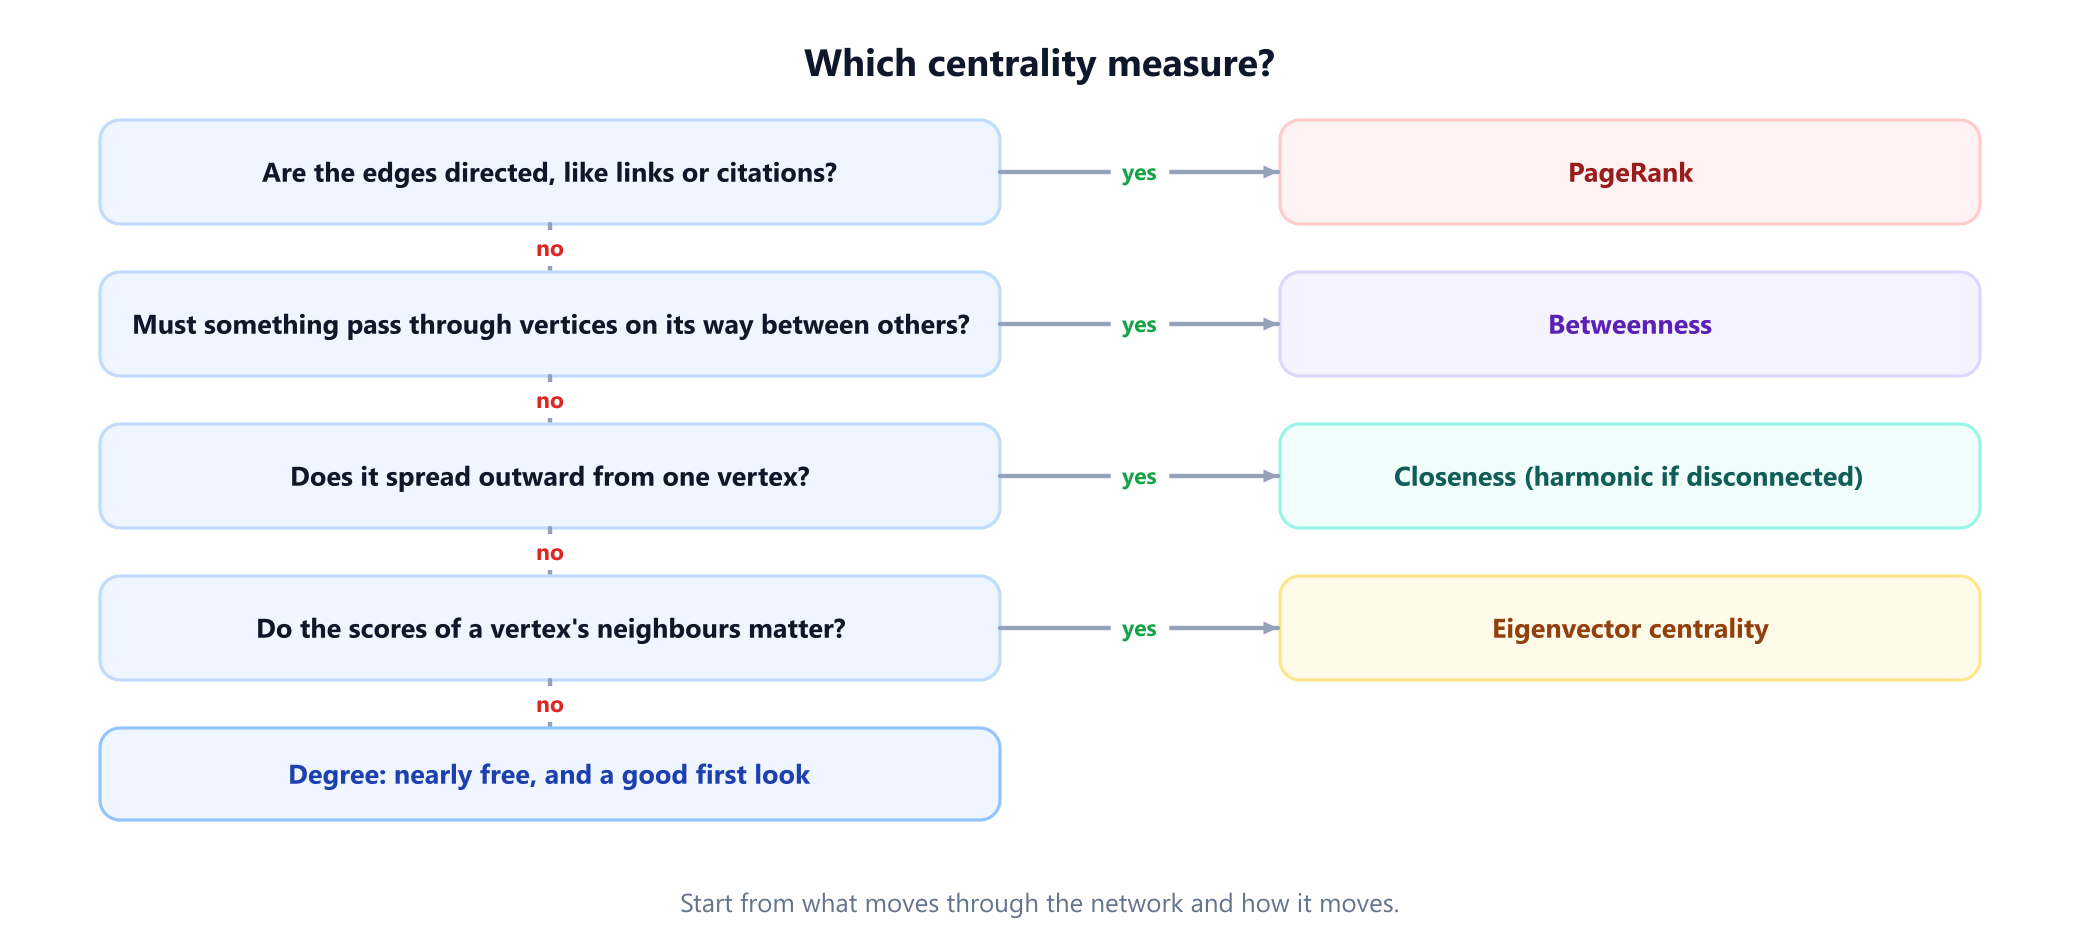
En une phrase : décidez ce qui circule dans votre réseau et comment, puis choisissez la mesure qui le modélise. Si vous voulez seulement un point de départ, calculez d'abord le degré, car il ne coûte presque rien et les autres mesures se lisent au mieux comme des corrections du degré. Le diagramme ci-dessous traduit ce conseil en quatre questions.
2. Une entreprise, quatre gagnants
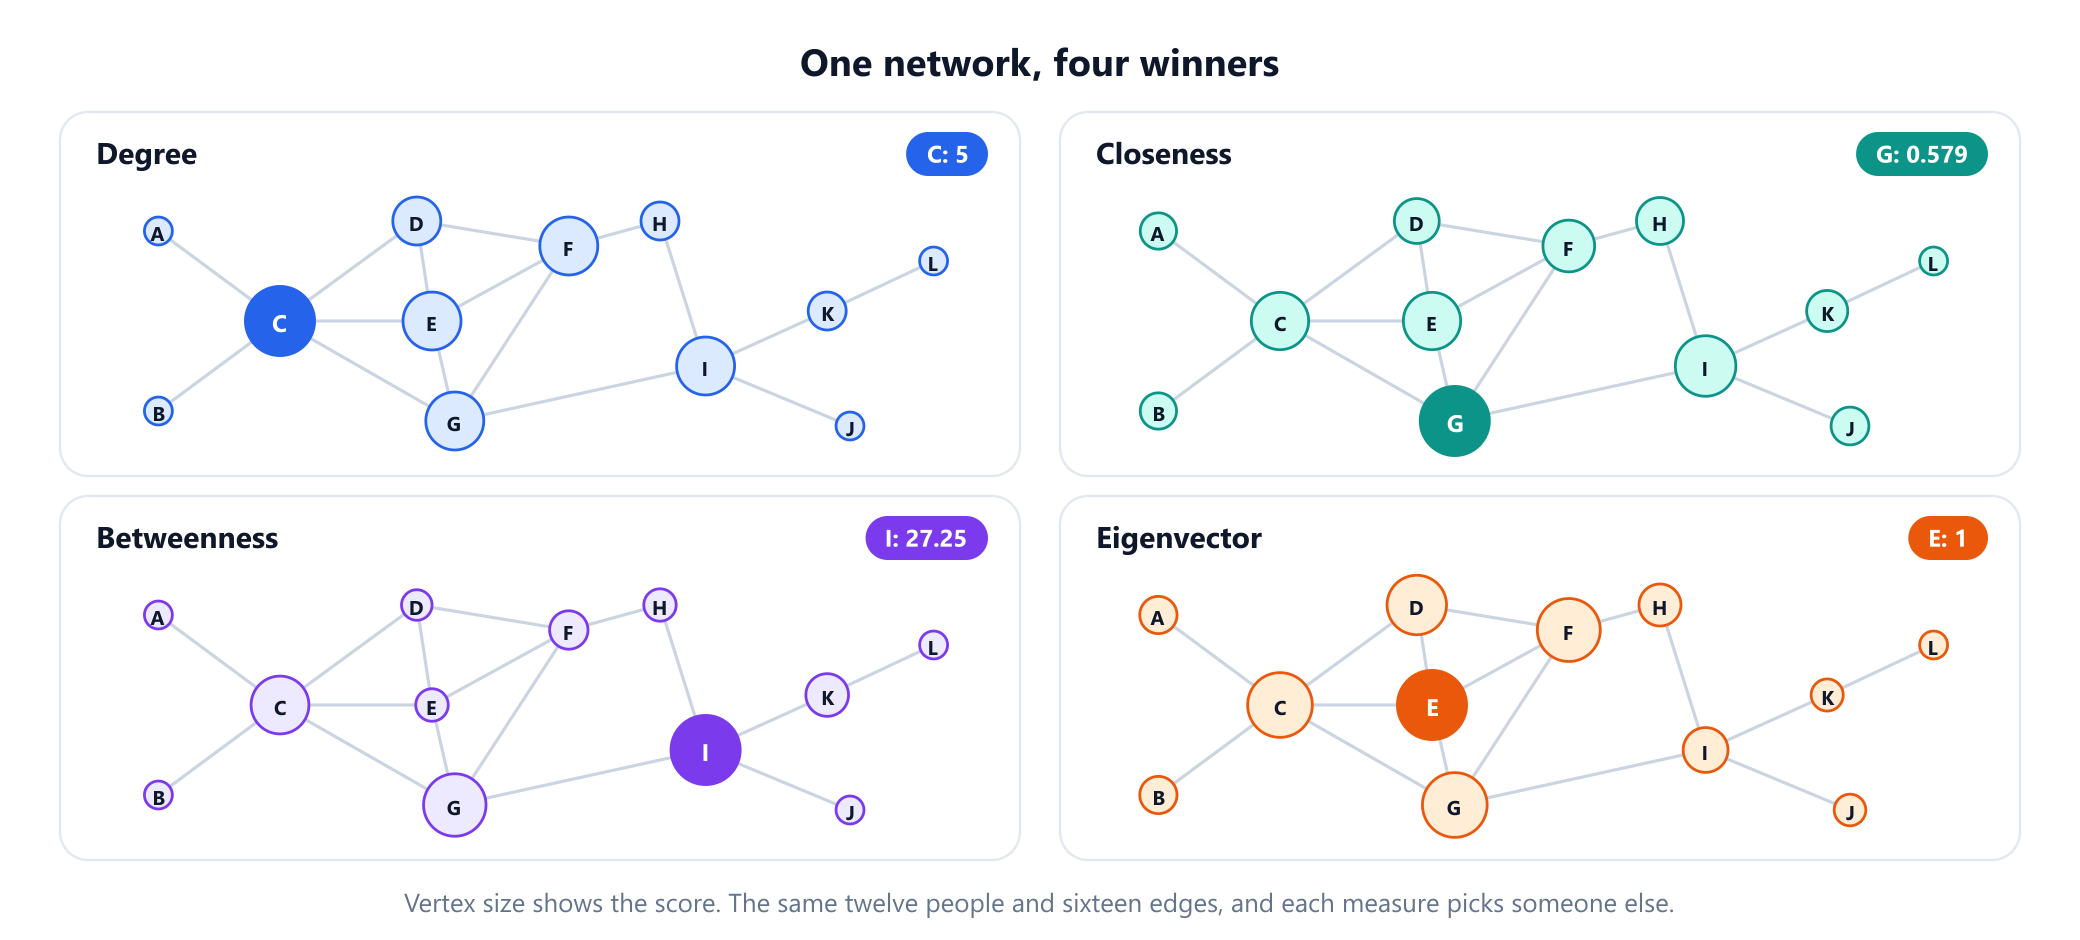
L'exemple suivi est une entreprise de douze personnes, A à L, avec une arête entre deux personnes qui travaillent directement ensemble. Le réseau compte 16 arêtes et a été trouvé par une recherche informatique d'un petit réseau sur lequel le degré, la proximité, l'intermédiarité et la centralité de vecteur propre désignent chacun une personne différente. Cela prolonge l'idée du réseau « cerf-volant » de David Krackhardt, de 1990 : dix personnes sur lesquelles le degré, la proximité et l'intermédiarité favorisent des personnes différentes.
| Personne | Degré | Proximité | Intermédiarité | Vecteur propre |
|---|---|---|---|---|
| A | 1 | 0.344 | 0 | 0.262 |
| B | 1 | 0.344 | 0 | 0.262 |
| C | 5 | 0.500 | 20.33 | 0.921 |
| D | 3 | 0.407 | 1.75 | 0.796 |
| E | 4 | 0.500 | 3.08 | 1.000 |
| F | 4 | 0.458 | 7.08 | 0.879 |
| G | 4 | 0.579 | 23.50 | 0.922 |
| H | 2 | 0.423 | 3.00 | 0.376 |
| I | 4 | 0.524 | 27.25 | 0.444 |
| J | 1 | 0.355 | 0 | 0.126 |
| K | 2 | 0.379 | 10.00 | 0.137 |
| L | 1 | 0.282 | 0 | 0.039 |
Les quatre réponses sont correctes. C a le plus de contacts, dont deux ne connaissent personne d'autre. G peut atteindre toute l'entreprise avec le moins de pas au total. I est le seul lien entre J, K et L d'une part, et le reste de l'entreprise d'autre part. Enfin, E se trouve au milieu du groupe très soudé. Remarquez à quel point les gagnants s'en sortent mal selon les mesures des autres : E n'est que sixième selon l'intermédiarité et I sixième selon la centralité de vecteur propre. Les sections 3 à 5 expliquent chaque colonne et donnent le code qui l'a produite.
3. Degré et proximité : contacts et portée
La centralité de degré est le nombre d'arêtes incidentes à un sommet, que le guide sur le degré d'un sommet traite en détail. Elle ne regarde qu'à un pas de distance, si bien qu'elle ne coûte presque rien et qu'elle ignore tout ce qui se trouve au-delà des voisins. C gagne avec 5, et sur un graphe orienté, la mesure se scinde en degré entrant et degré sortant.
La centralité de proximité prend en compte tous les sommets. Pour un sommet v d'un graphe connexe, additionnez les plus courtes distances de v à tous les autres, puis inversez le résultat pour qu'un score plus élevé signifie plus proche : (n - 1) / somme des distances. Les distances viennent d'un parcours en largeur lancé depuis chaque sommet. Le programme ci-dessous est enregistré sous le nom people.py, car les programmes suivants l'importent.
from collections import deque

# Qui travaille directement avec qui dans une entreprise de douze personnes.
PEOPLE = 'AC BC CD CE CG DE DF EF EG FG FH GI HI IJ IK KL'.split()

def graph(edges):
    adj = {}
    for a, b in edges:
        adj.setdefault(a, []).append(b)
        adj.setdefault(b, []).append(a)
    return adj

def distances(adj, source):
    """Parcours en largeur : nombre de pas depuis source vers tout ce qui est atteignable."""
    dist, queue = {source: 0}, deque([source])
    while queue:
        v = queue.popleft()
        for w in adj[v]:
            if w not in dist:
                dist[w] = dist[v] + 1
                queue.append(w)
    return dist

def degree(adj):
    return {v: len(adj[v]) for v in adj}

def closeness(adj):
    """(sommets atteignables) / (somme des distances jusqu'à eux) : trompeur si adj n'est pas connexe."""
    result = {}
    for v in adj:
        dist = distances(adj, v)
        result[v] = (len(dist) - 1) / sum(dist.values()) if len(dist) > 1 else 0.0
    return result

def harmonic(adj):
    """Moyenne de 1 / distance sur tous les autres sommets ; un sommet inatteignable ajoute 0."""
    n = len(adj)
    return {v: sum(1 / d for d in distances(adj, v).values() if d) / (n - 1) for v in adj}

def winner(score):
    return max(sorted(score), key=score.get)

if __name__ == '__main__':
    adj = graph(PEOPLE)
    d, c, h = degree(adj), closeness(adj), harmonic(adj)
    print('most contacts: ', winner(d), d[winner(d)])
    print('closest to all:', winner(c), round(c[winner(c)], 3))
    # Ajouter deux prestataires qui ne travaillent qu'entre eux.
    split = graph(PEOPLE + ['XY'])
    c2, h2 = closeness(split), harmonic(split)
    print('naive closeness, X:', round(c2['X'], 3), ' G:', round(c2['G'], 3))
    print('harmonic,        X:', round(h2['X'], 3), ' G:', round(h2['G'], 3))
# most contacts:  C 5
# closest to all: G 0.579
# naive closeness, X: 1.0  G: 0.579
# harmonic,        X: 0.077  G: 0.564
G atteint les onze autres personnes en 19 pas au total, sa proximité vaut donc 11 / 19 = 0,579.
Les deux dernières lignes de la sortie montrent le piège classique. La proximité suppose que tout le monde peut atteindre tout le monde. Ajoutez deux prestataires, X et Y, qui ne travaillent qu'entre eux, et le contournement habituel, qui fait la somme sur les seuls sommets atteignables, donne à X un score parfait de 1,0, bien au-dessus de G, simplement parce que sa minuscule composante ne fait qu'un pas de large. La centralité harmonique corrige cela en faisant la moyenne de 1 / distance sur tous les autres sommets, de sorte qu'un sommet inatteignable contribue pour 0. Elle donne à X seulement 0,077 et laisse G à 0,564. La mesure a été proposée pour la première fois par Massimo Marchiori et Vito Latora en 2000, et l'étude de 2014 de Paolo Boldi et Sebastiano Vigna sur les propriétés qu'une mesure de centralité devrait vérifier a montré qu'elle était la seule des mesures testées à satisfaire leurs trois axiomes. Utilisez-la dès qu'un graphe peut être non connexe ; le guide sur les composantes connexes montre comment le vérifier.
4. Intermédiarité : par qui passent les itinéraires
La centralité d'intermédiarité pose une autre question : si chacun envoyait un message à tous les autres par des plus courts itinéraires, combien de ces messages passeraient par v ? Pour chaque paire s, t ne contenant pas v, elle prend la fraction des plus courts chemins s-t qui passent par v, et additionne ces fractions. Les fractions comptent : dans un carré S, X, T, Y, il existe deux itinéraires aussi courts l'un que l'autre de S à T, donc X et Y reçoivent chacun un demi-point de cette paire.
Calculé directement, cela prend un temps O(V³) ou pire. En 2001, Ulrik Brandes a montré comment le faire en O(VE) sur un graphe non pondéré, en lançant un parcours en largeur par source puis en remontant depuis le sommet le plus éloigné. L'idée clé est que le crédit que chaque sommet transmet vers le haut se déduit du crédit des sommets situés en dessous de lui, au lieu d'être recalculé pour chaque cible.
from collections import deque
from people import PEOPLE, graph

def betweenness(adj, sources=None):
    """Algorithme de Brandes pour un graphe non orienté et non pondéré.

    sources=None utilise tous les sommets et donne la valeur exacte. Une liste de sources donne une estimation."""
    sources = list(adj) if sources is None else sources
    score = dict.fromkeys(adj, 0.0)
    for s in sources:
        # Phase 1 : BFS depuis s, en comptant les plus courts chemins (sigma) et en notant les prédécesseurs.
        order, preds, sigma, dist = [], {v: [] for v in adj}, dict.fromkeys(adj, 0), {s: 0}
        sigma[s] = 1
        queue = deque([s])
        while queue:
            v = queue.popleft()
            order.append(v)
            for w in adj[v]:
                if w not in dist:
                    dist[w] = dist[v] + 1
                    queue.append(w)
                if dist[w] == dist[v] + 1:
                    sigma[w] += sigma[v]
                    preds[w].append(v)
        # Phase 2 : remonter depuis le sommet le plus éloigné, en transmettant le crédit aux prédécesseurs.
        delta = dict.fromkeys(adj, 0.0)
        for w in reversed(order):
            for v in preds[w]:
                delta[v] += sigma[v] / sigma[w] * (1 + delta[w])
            if w != s:
                score[w] += delta[w]
    scale = len(adj) / len(sources) / 2          # chaque paire est vue depuis ses deux extrémités
    return {v: x * scale for v, x in score.items()}

if __name__ == '__main__':
    b = betweenness(graph(PEOPLE))
    for v in sorted(b, key=b.get, reverse=True)[:5]:
        print(v, round(b[v], 2))
    print(betweenness(graph('SX XT SY YT'.split())))   # deux itinéraires égaux de S à T
# I 27.25
# G 23.5
# C 20.33
# K 10.0
# F 7.08
# {'S': 0.5, 'X': 0.5, 'T': 0.5, 'Y': 0.5}
L'ensemble des parcours compte chaque paire deux fois, une fois depuis chaque extrémité, c'est pourquoi le programme divise par 2 sur un graphe non orienté. Sur un graphe pondéré, Dijkstra remplace le parcours en largeur et le temps devient O(VE + V² log V).
I obtient 27,25 sur un maximum possible de 55, le nombre de paires qui ne contiennent pas I, si bien qu'environ la moitié des plus courts itinéraires entre les autres paires passent par lui. Sur ces 27,25 points, 26 viennent de paires impliquant J, K ou L, qui n'ont pas d'autre issue. I n'a que quatre contacts, autant que E, F et G, et c'est exactement ce que le degré ne peut pas montrer.
5. Centralité de vecteur propre : qui sont vos contacts
Le degré compte les contacts comme s'ils se valaient tous. La centralité de vecteur propre considère qu'un contact vaut autant que son propre score, si bien que le score d'un sommet est proportionnel à la somme des scores de ses voisins : x = (1 / λ) A x, où A est la matrice d'adjacence. Ainsi, x est un vecteur propre de A. Sur un graphe non orienté connexe, le théorème de Perron-Frobenius garantit qu'il existe exactement un vecteur propre dont toutes les composantes sont positives, à un facteur d'échelle près, associé à la plus grande valeur propre, et c'est lui le score. Phillip Bonacich en a fait un outil standard de l'analyse des réseaux en 1972, bien que John Seeley ait utilisé un score semblable sur des données sociométriques en 1949.
La façon standard de le calculer est la méthode de la puissance : partir de scores égaux, remplacer chacun par la somme de ceux des voisins, remettre à l'échelle, et recommencer.
from people import PEOPLE, graph

def eigenvector(adj, shift=1.0, steps=2000):
    """Méthode de la puissance sur A + shift * I, mise à l'échelle pour que le score maximal vaille 1."""
    x = dict.fromkeys(adj, 1.0)
    for _ in range(steps):
        y = {v: shift * x[v] + sum(x[u] for u in adj[v]) for v in adj}
        top = max(y.values())
        x = {v: y[v] / top for v in y}
    return x

if __name__ == '__main__':
    e = eigenvector(graph(PEOPLE))
    for v in sorted(e, key=e.get, reverse=True)[:4]:
        print(v, round(e[v], 3))
    # Sans shift, un graphe biparti peut faire sauter l'itération indéfiniment.
    path = graph('AB BC CD'.split())
    x = {'A': 1.0, 'B': 0.0, 'C': 0.0, 'D': 0.0}
    for step in range(1, 52):
        y = {v: sum(x[u] for u in path[v]) for v in path}
        top = max(y.values())
        x = {v: y[v] / top for v in y}
        if step >= 50:
            print('step', step, {v: round(x[v], 3) for v in sorted(x)})
    print('with the shift', {v: round(s, 3) for v, s in sorted(eigenvector(path).items())})
# E 1.0
# G 0.922
# C 0.921
# F 0.879
# step 50 {'A': 0.618, 'B': 0.0, 'C': 1.0, 'D': 0.0}
# step 51 {'A': 0.0, 'B': 1.0, 'C': 0.0, 'D': 0.618}
# with the shift {'A': 0.618, 'B': 1.0, 'C': 1.0, 'D': 0.618}
E gagne alors que C a plus de contacts et que G est plus proche de tout le monde. Les scores des quatre contacts de E totalisent 3,519. Ceux des quatre contacts de G ne totalisent que 3,244, car l'un d'eux est I, qui n'obtient que 0,444 et mène vers la périphérie de l'entreprise.
La sortie montre aussi pourquoi le code ajoute shift. Sur un graphe biparti, A possède une valeur propre de même valeur absolue et de signe opposé, si bien que la méthode de la puissance simple peut ne jamais se stabiliser : sur un chemin de quatre sommets, en partant d'un seul sommet, les scores sautent indéfiniment entre deux états, la moitié d'entre eux valant 0 à chaque étape. Itérer avec A + I augmente chaque valeur propre de 1, supprime l'égalité et laisse les vecteurs propres inchangés. Le guide sur la théorie spectrale des graphes explique ce que révèlent les autres valeurs propres.
Sur les graphes orientés, la mesure ne fonctionne plus : un sommet vers lequel personne ne pointe obtient 0, tout comme tout ce vers quoi lui seul pointe. La mesure de Leo Katz, de 1953, évite ce problème : elle compte toutes les marches qui arrivent à un sommet, une marche de longueur k étant pondérée par α^k. Sous sa forme moderne, elle s'écrit x = α Aᵀ x + 1, avec α inférieur à 1 / λ, ce qui revient à donner à chaque sommet une petite part de score gratuite. PageRank apporte une modification de plus.
6. PageRank : suivre les liens
PageRank, publié par Sergey Brin et Larry Page en 1998, a été conçu pour le Web, où un lien d'une page vers une autre est un vote pour celle-ci. La mesure de Katz y a un défaut : une page qui pointe vers mille autres transmet son score entier à chacune. PageRank oblige chaque page à répartir son score entre ses liens sortants.
L'image habituelle est celle d'un surfeur aléatoire. À chaque étape, le surfeur suit un lien au hasard depuis la page courante avec une probabilité d, le facteur d'amortissement, et sinon saute vers une page choisie uniformément au hasard. Le rang d'une page est la fraction du temps qu'il y passe à long terme. Dans la forme normalisée, où la somme de tous les rangs vaut 1 :
rang(p) = (1 - d) / n + d * somme de rang(q) / degré_sortant(q), sur les pages q qui pointent vers pL'exemple est un web de huit pages. Chaque page peut atteindre toutes les autres, donc aucune n'est isolée. Brin et Page ont indiqué qu'ils fixaient habituellement d à 0,85, et le programme fait de même.
# Huit pages web et les pages vers lesquelles chacune pointe.
WEB = {'A': 'CH', 'B': 'CDEH', 'C': 'A', 'D': 'C', 'E': 'D', 'F': 'BDG', 'G': 'D', 'H': 'AF'}

def pagerank(links, d=0.85, tol=1e-10):
    """Méthode de la puissance. Une page sans lien sortant partage son rang avec toutes les pages."""
    pages = sorted(links)
    n = len(pages)
    rank = dict.fromkeys(pages, 1 / n)
    steps = 0
    while True:
        dangling = sum(rank[p] for p in pages if not links[p])
        new = dict.fromkeys(pages, (1 - d) / n + d * dangling / n)
        for p in pages:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        change = sum(abs(new[p] - rank[p]) for p in pages)
        rank, steps = new, steps + 1
        if change < tol:
            return rank, steps

if __name__ == '__main__':
    rank, steps = pagerank(WEB)
    inlinks = {p: sum(p in out for out in WEB.values()) for p in WEB}
    for p in sorted(rank, key=rank.get, reverse=True):
        print(p, 'in-links', inlinks[p], ' rank', round(rank[p], 3))
    print('iterations', steps, ' total', round(sum(rank.values()), 6))
# A in-links 2  rank 0.293
# C in-links 3  rank 0.247
# H in-links 2  rank 0.152
# D in-links 4  rank 0.111
# F in-links 1  rank 0.084
# B in-links 1  rank 0.042
# G in-links 1  rank 0.042
# E in-links 1  rank 0.028
# iterations 70  total 1.0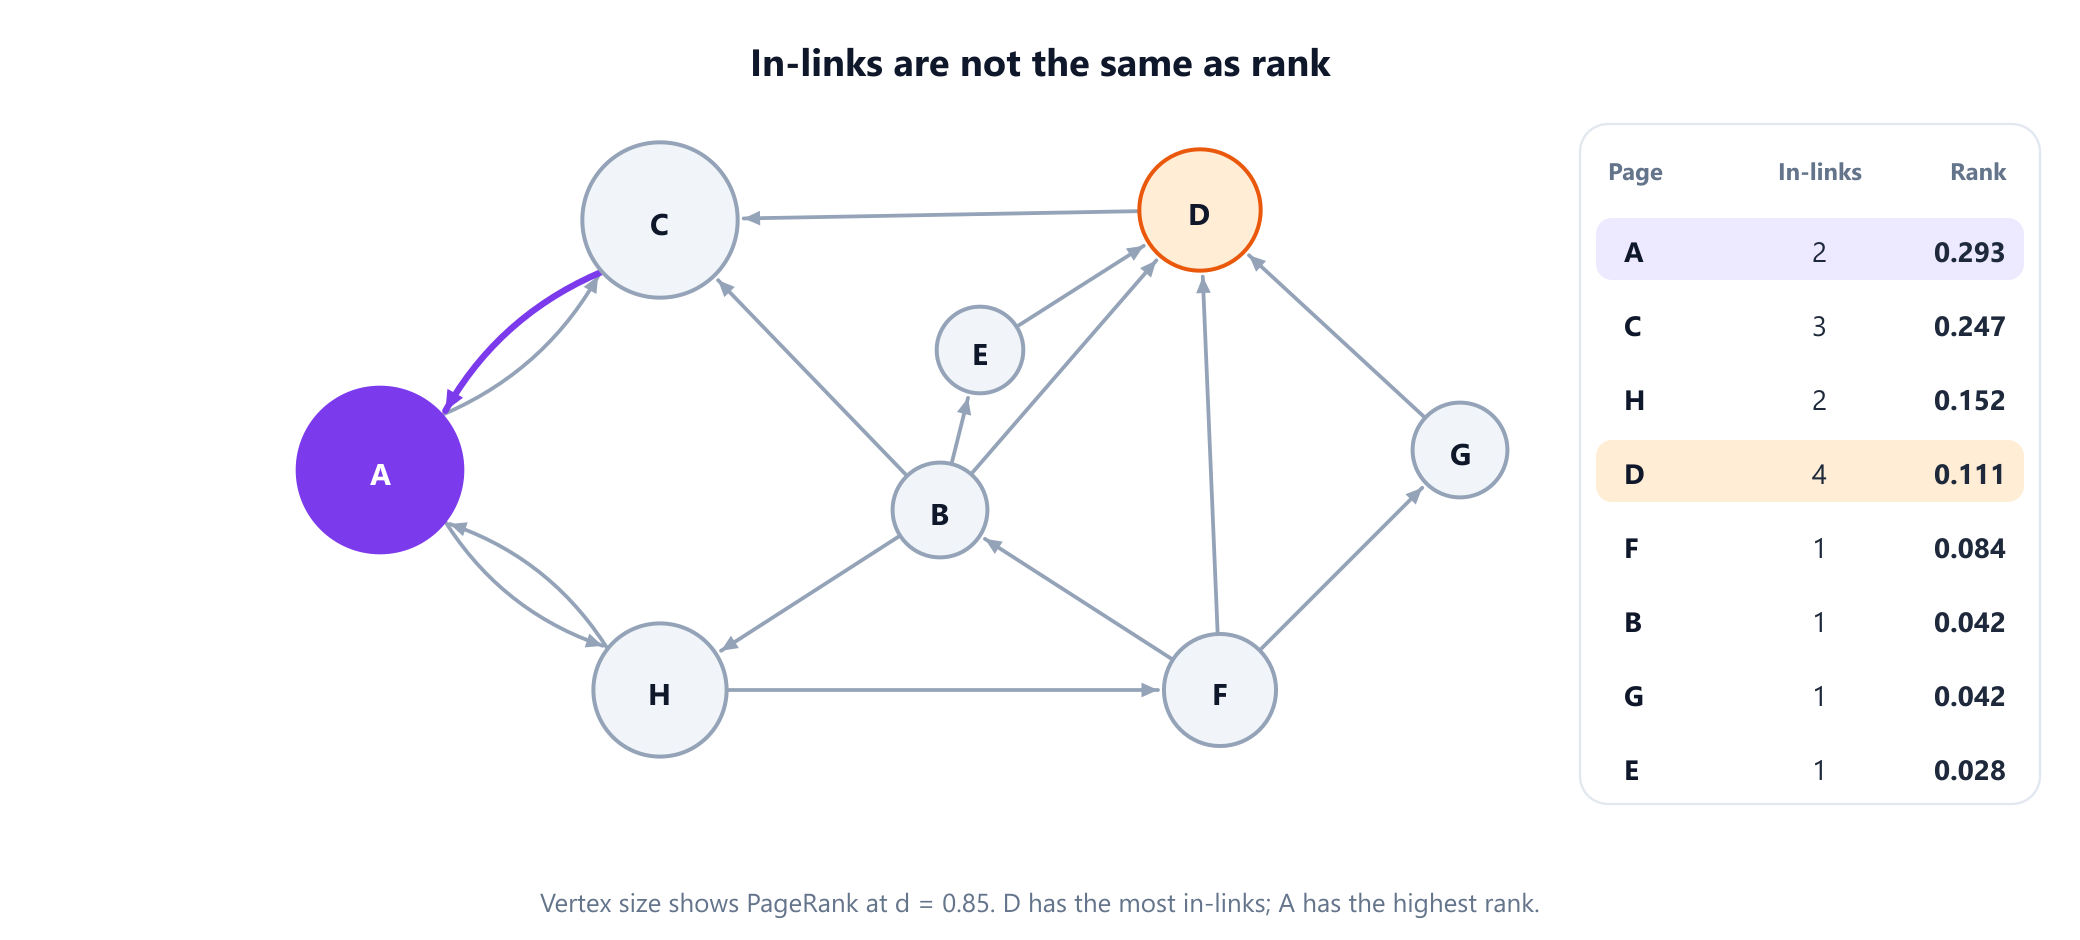
D a le plus de liens entrants, quatre, mais ils viennent de pages qui ont peu de rang à donner, et B et F répartissent le leur entre plusieurs liens. D transmet ensuite tout son rang à C, et C transmet tout son rang à A. Ainsi, A, avec seulement deux liens entrants, termine première avec 0,293, et A et C détiennent ensemble 54 % du total. Sur un graphe non orienté, le tableau est beaucoup plus simple : avec d = 1 sur un graphe connexe non biparti, PageRank est exactement proportionnel au degré. PageRank est avant tout une mesure pour les graphes orientés, et le guide sur les graphes orientés et non orientés explique pourquoi la distinction compte.
7. Culs-de-sac, boucles fermées et facteur d'amortissement
Le facteur d'amortissement n'est pas décoratif. Deux sortes de pages cassent le processus simple « suivre un lien », et le programme suivant casse le web de l'exemple de ces deux façons.
from pagerank import WEB, pagerank

def leaky(links, d=0.85, steps=200):
    """La mise à jour des manuels, sans traitement des culs-de-sac."""
    n = len(links)
    rank = dict.fromkeys(links, 1 / n)
    for _ in range(steps):
        new = dict.fromkeys(links, (1 - d) / n)
        for p in links:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        rank = new
    return rank

if __name__ == '__main__':
    dead_end = {**WEB, 'A': ''}                    # A ne pointe plus nulle part
    print('dead end, naive update:   total', round(sum(leaky(dead_end).values()), 3))
    print('dead end, handled:        total', round(sum(pagerank(dead_end)[0].values()), 3))
    closed = {**WEB, 'A': 'C'}                     # A et C ne pointent plus que l'un vers l'autre
    for d in (0.85, 0.999):
        rank = pagerank(closed, d=d, tol=1e-9)[0]
        print(f'closed loop, d = {d}: A + C hold', round(rank['A'] + rank['C'], 3))
# dead end, naive update:   total 0.403
# dead end, handled:        total 1.0
# closed loop, d = 0.85: A + C hold 0.791
# closed loop, d = 0.999: A + C hold 0.998
Un cul-de-sac est une page sans lien sortant. La mise à jour des manuels n'a nulle part où envoyer son rang, si bien que du rang fuit hors du système : avec A transformée en cul-de-sac, le total tombe de 1 à 0,403. La correction, utilisée dans la fonction pagerank ci-dessus, consiste à répartir le rang d'un cul-de-sac entre toutes les pages, comme si le surfeur sautait au hasard depuis cet endroit.
Une boucle fermée est un groupe de pages qui ne pointent que les unes vers les autres. Une fois que le surfeur y est entré, seul le saut aléatoire l'en fait sortir. Faites pointer A uniquement vers C et la paire détient 79,1 % de tout le rang à d = 0,85, et 99,8 % à d = 0,999. Plus d est petit, moins une boucle peut absorber.
Un grand d se paie en vitesse. La variation des rangs diminue au moins d'un facteur d à chaque étape, ce qui concorde avec le résultat de Taher Haveliwala et Sepandar Kamvar selon lequel la deuxième valeur propre de la matrice de PageRank vaut au plus d en valeur absolue. Le programme suivant le mesure sur un web de 1 000 pages réparties en 20 sites.
import random

def web(sites, size, rnd):
    """Les pages pointent surtout à l'intérieur de leur propre site ; environ une page sur dix pointe vers un autre site."""
    links = {}
    for s in range(sites):
        for i in range(size):
            out = {s * size + rnd.randrange(size) for _ in range(5)}
            if rnd.random() < 0.1:
                out.add(rnd.randrange(sites * size))
            links[s * size + i] = sorted(out - {s * size + i})
    return links

def steps_needed(links, d, tol=1e-6):
    n = len(links)
    rank, step = dict.fromkeys(links, 1 / n), 0
    while True:
        lost = sum(rank[p] for p in links if not links[p])
        new = dict.fromkeys(links, (1 - d) / n + d * lost / n)
        for p in links:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        change = sum(abs(new[p] - rank[p]) for p in links)
        rank, step = new, step + 1
        if change < tol:
            return step

if __name__ == '__main__':
    links = web(20, 50, random.Random(5))
    for d in (0.5, 0.85, 0.95, 0.99):
        print('d =', d, ' iterations:', steps_needed(links, d))
# d = 0.5  iterations: 13
# d = 0.85  iterations: 53
# d = 0.95  iterations: 149
# d = 0.99  iterations: 607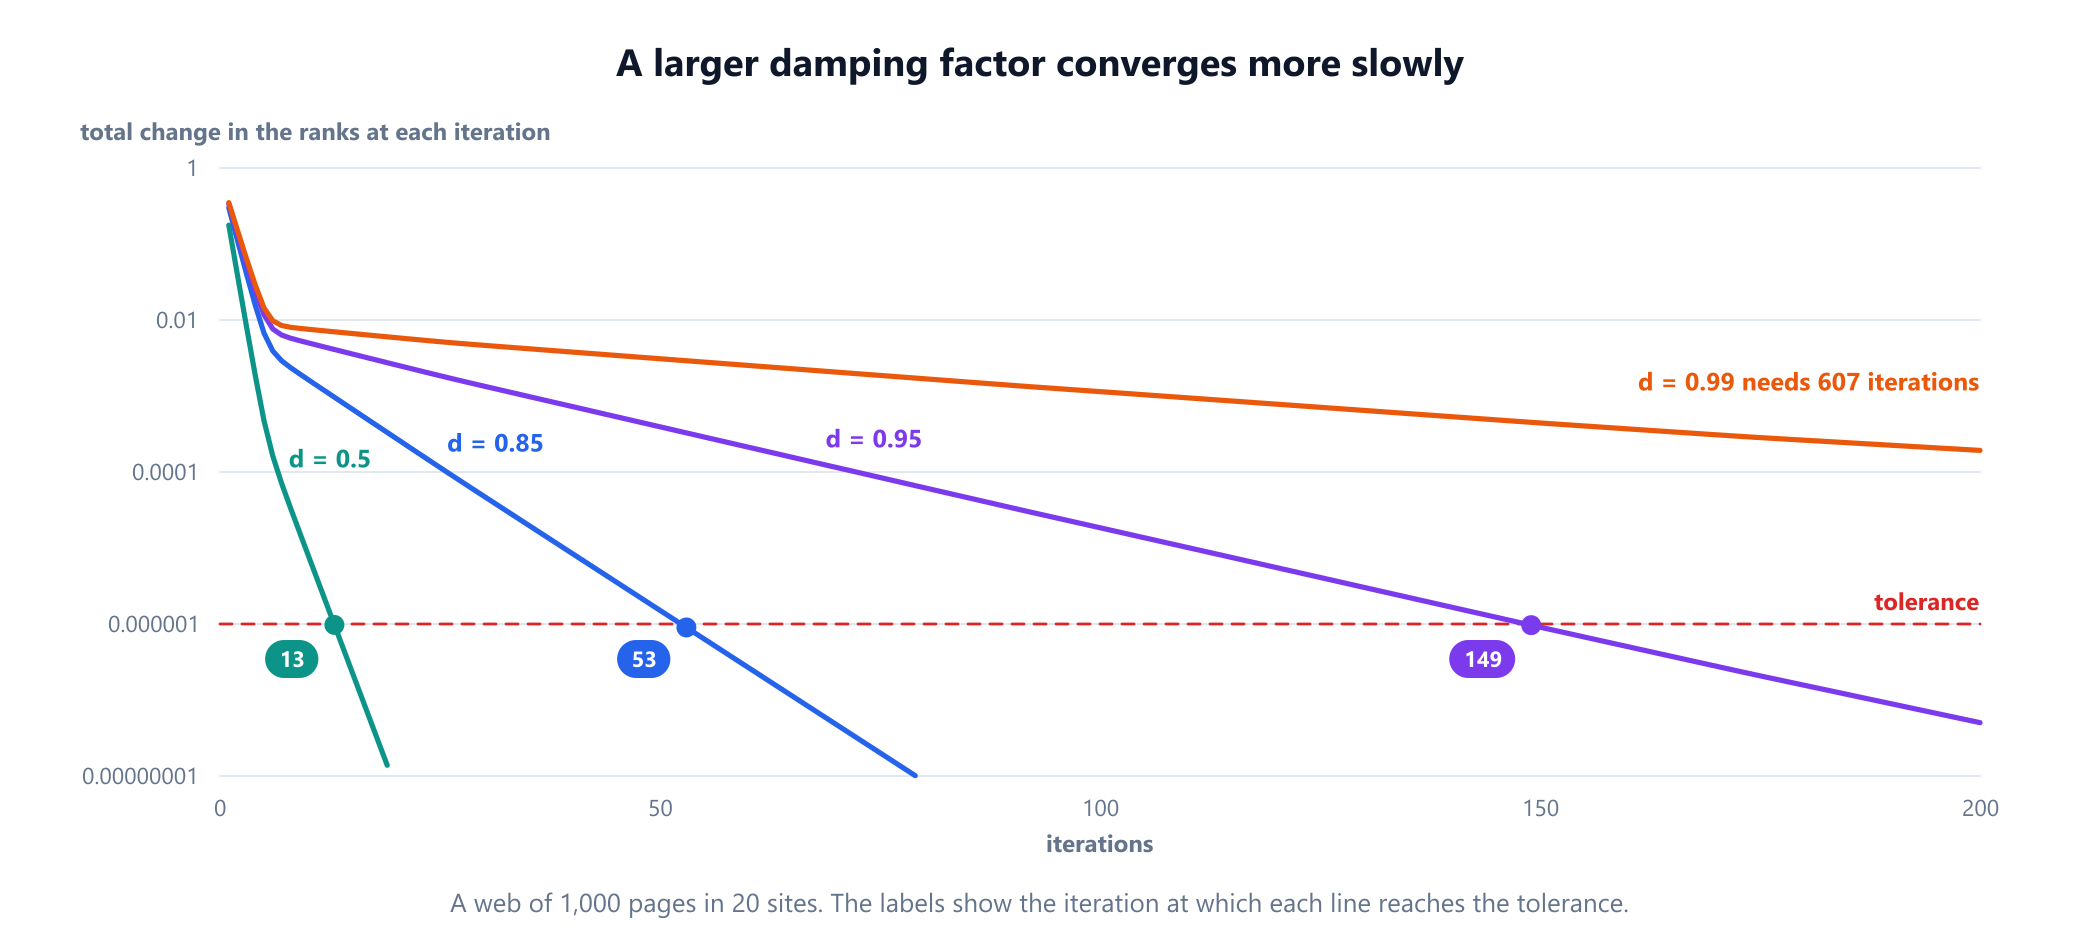
8. Les mesures concordent-elles ?
Si les mesures désignaient généralement les mêmes sommets, on pourrait toujours utiliser la moins coûteuse. Le programme suivant construit trois sortes de réseaux de 400 sommets chacun, puis demande combien des 20 premiers sommets selon l'intermédiarité figurent aussi parmi les 20 premiers selon chacune des autres mesures.
import random
from people import degree, closeness
from brandes import betweenness
from eigen import eigenvector

def link(adj, a, b):
    if a != b and b not in adj[a]:
        adj[a].append(b)
        adj[b].append(a)

def hubs(n, m, rnd):
    """Attachement préférentiel : les nouveaux venus privilégient les sommets qui ont déjà beaucoup d'arêtes."""
    adj = {v: [] for v in range(n)}
    pool = list(range(m))
    for v in range(m, n):
        for t in set(rnd.choice(pool) for _ in range(m)):
            link(adj, v, t)
            pool += [v, t]
    return adj

def two_groups(n, rnd):
    """Deux moitiés denses reliées par seulement six arêtes."""
    adj = {v: [] for v in range(n)}
    half = n // 2
    for a in range(n):
        for b in range(a + 1, n):
            if (a < half) == (b < half) and rnd.random() < 0.05:
                link(adj, a, b)
    for _ in range(6):
        link(adj, rnd.randrange(half), rnd.randrange(half, n))
    return adj

def ring(n, rnd):
    """Chaque sommet relié à ses 3 plus proches voisins de chaque côté ; 5 % des arêtes recâblées."""
    adj = {v: [] for v in range(n)}
    for v in range(n):
        for k in (1, 2, 3):
            link(adj, v, rnd.randrange(n) if rnd.random() < 0.05 else (v + k) % n)
    return adj

def top(score, k=20):
    return set(sorted(score, key=lambda v: (-score[v], v))[:k])

if __name__ == '__main__':
    rnd = random.Random(11)
    print('top 20 by betweenness also in the top 20 by:  degree, closeness, eigenvector')
    for name, adj in (('hubs', hubs(400, 2, rnd)), ('two groups', two_groups(400, rnd)), ('ring', ring(400, rnd))):
        b = top(betweenness(adj))
        print(f'{name:11}', len(b & top(degree(adj))), len(b & top(closeness(adj))), len(b & top(eigenvector(adj, steps=4000))))
# top 20 by betweenness also in the top 20 by:  degree, closeness, eigenvector
# hubs        18 13 14
# two groups  8 17 4
# ring        6 9 1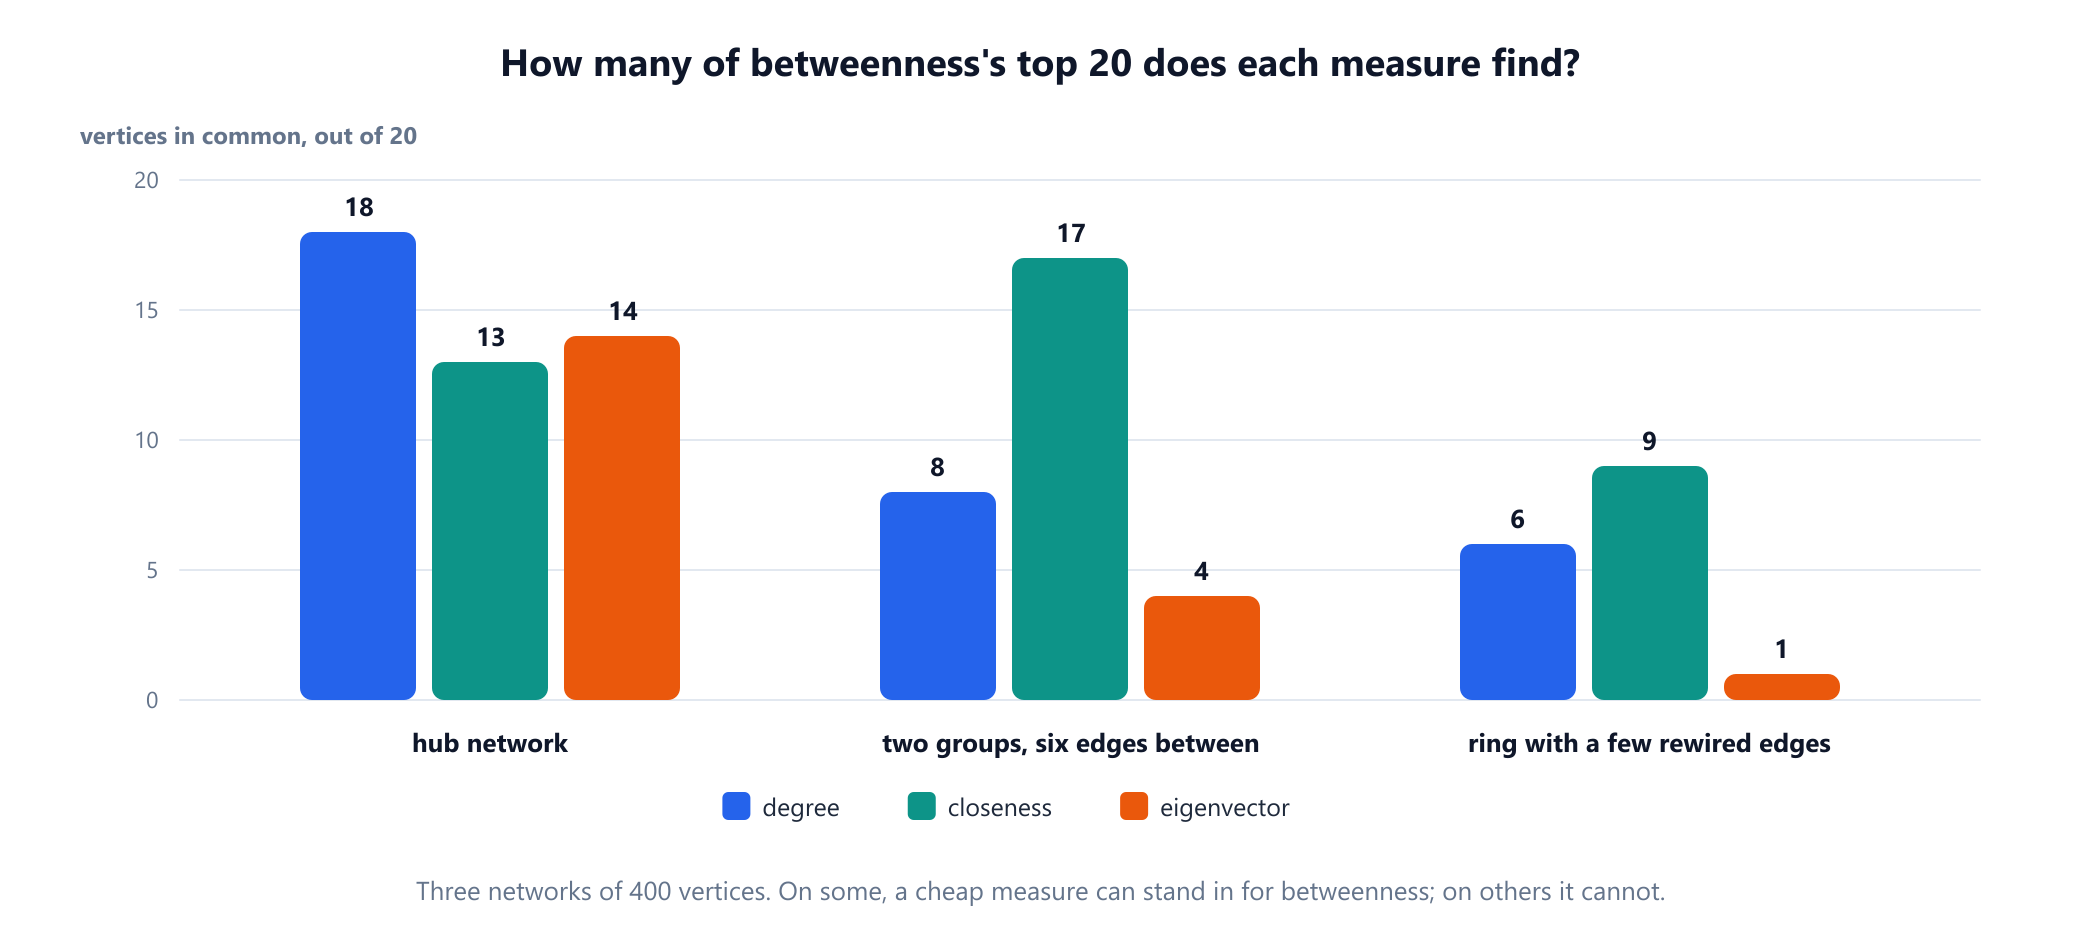
Sur le réseau à hubs, où quelques sommets concentrent la plupart des arêtes, le degré en trouve 18 sur 20, si bien que payer pour l'intermédiarité n'apporte pas grand-chose. Sur les deux groupes reliés par six arêtes, le degré n'en trouve que 8 et la centralité de vecteur propre seulement 4, car ses 20 premiers sommets se trouvent tous dans le même groupe : elle se concentre sur une moitié et ne voit pas l'autre. Sur l'anneau, où la structure est surtout locale, les mesures choisissent en grande partie des sommets différents. Avant de vous fier à un substitut peu coûteux, testez-le sur un échantillon de votre propre réseau.
9. Grands graphes : estimer l'intermédiarité
L'intermédiarité exacte demande un parcours par sommet, ce qui est hors de portée sur des graphes de centaines de millions de sommets. Le raccourci standard, étudié par Brandes et Christian Pich en 2007, consiste à lancer le parcours depuis un échantillon aléatoire de sommets sources et à extrapoler le résultat. L'argument sources du programme de la section 4 fait déjà cela.
import random
from brandes import betweenness
from agree import hubs, top

if __name__ == '__main__':
    rnd = random.Random(3)
    adj = hubs(1000, 3, rnd)
    exact = betweenness(adj)
    best = top(exact, 10)
    print('sources  work  top 10 found  mean error of the top 10   (average of 10 runs)')
    for k in (10, 50, 100, 250, 500):
        found = error = 0
        for _ in range(10):
            estimate = betweenness(adj, rnd.sample(sorted(adj), k))
            found += len(best & top(estimate, 10))
            error += sum(abs(estimate[v] - exact[v]) / exact[v] for v in best) / 10
        print(f'{k:7} {k / 10:4.0f}% {found / 10:13.1f} {error / 10:12.1%}')
# sources  work  top 10 found  mean error of the top 10   (average of 10 runs)
#      10    1%           6.2        36.8%
#      50    5%           8.1        17.3%
#     100   10%           9.4        13.4%
#     250   25%           9.1         8.6%
#     500   50%           9.4         4.0%
Sur ce réseau de 1 000 sommets, 10 % du travail retrouve en moyenne 9,4 des 10 vrais premiers sommets, avec une erreur typique d'environ 13 % sur leurs scores. L'échantillonnage est efficace pour trouver le haut du classement, et beaucoup moins précis sur les scores eux-mêmes. Un échantillon de 1 % est trop petit et n'en trouve que 6,2. Le degré, à l'inverse, reste peu coûteux quelle que soit la taille, et la centralité de vecteur propre comme PageRank n'exigent qu'un nombre limité de passes sur les arêtes, c'est pourquoi elles passent à l'échelle de graphes de la taille du Web.
10. Où ces mesures sont utilisées
- Recherche sur le Web. PageRank était une pièce centrale du premier moteur de recherche de Google, combiné à d'autres signaux comme le texte des pages et des liens.
- Biologie. Hawoong Jeong et ses collègues ont rapporté en 2001 que, dans le réseau de protéines de la levure, les protéines très connectées ont plus de chances d'être essentielles à la survie. Le guide sur la théorie des graphes en biologie étudie les hubs et les goulots d'étranglement.
- Détection de communautés. La méthode de Michelle Girvan et Mark Newman, de 2002, retire de façon répétée l'arête d'intermédiarité la plus élevée et recalcule l'intermédiarité après chaque retrait, car ce sont les arêtes entre groupes qui portent le plus d'itinéraires.
- Sécurité. L'intermédiarité désigne les hôtes par lesquels passent le plus de chemins d'attaque, c'est-à-dire l'endroit où une seule correction aide le plus ; voir la théorie des graphes en cybersécurité.
- Apprentissage automatique. Les scores de centralité sont des caractéristiques d'entrée courantes pour les sommets, et les réseaux de neurones en graphe apprennent des quantités apparentées à partir des données.
11. Un bref historique
La centralité est née de l'étude des petits groupes. Alex Bavelas a introduit l'idée en 1948, et les expériences de son Group Networks Laboratory au MIT, rapportées dans son article de 1950, l'ont reliée à l'efficacité avec laquelle de petits groupes résolvaient des problèmes. Gert Sabidussi a donné un traitement mathématique de la proximité en 1966. L'indice de statut de Leo Katz est paru en 1953, et la mesure de vecteur propre de Phillip Bonacich en 1972. Jac Anthonisse, dans un rapport non publié de 1971, et Linton Freeman, en 1977, ont défini l'intermédiarité indépendamment l'un de l'autre, et l'article de Freeman de 1979 a organisé le degré, la proximité et l'intermédiarité dans le cadre encore enseigné aujourd'hui. PageRank a suivi en 1998, et l'histoire retracée par Massimo Franceschet en 2011 fait remonter ses idées à la bibliométrie, à la sociométrie et à l'économétrie, jusqu'au modèle entrées-sorties de Wassily Leontief de 1941 et à l'indice sociométrique de John Seeley de 1949. L'algorithme de Brandes de 2001 a rendu l'intermédiarité praticable sur de grands réseaux.
12. Erreurs fréquentes
| Erreur | Pourquoi c'est faux | Correction |
|---|---|---|
| Chercher « le » sommet le plus important | Sur l'exemple, quatre mesures désignent quatre personnes | Décider d'abord ce qui circule dans le réseau |
| Confondre liens entrants et rang | D a le plus de liens entrants et n'est que quatrième | Utiliser PageRank quand la provenance d'un lien compte |
| La proximité sur un graphe non connexe | Deux prestataires isolés ont obtenu 1,0 | Utiliser la centralité harmonique |
| Oublier de diviser par deux l'intermédiarité non orientée | Chaque paire est comptée depuis ses deux extrémités | Diviser par 2 |
| Prendre la force d'une relation pour une distance | Les mesures fondées sur les plus courts chemins traitent une relation forte comme une relation longue | Convertir d'abord les poids en distances, par exemple 1 / w |
| Comparer des scores bruts entre graphes | L'intermédiarité croît avec la taille du graphe | Normaliser, ou comparer des classements |
| La méthode de la puissance simple sur un graphe biparti | Les scores peuvent osciller indéfiniment | Itérer avec A + I |
| Ignorer les culs-de-sac dans PageRank | Le rang total a fui jusqu'à 0,403 | Répartir le rang d'un cul-de-sac entre toutes les pages |
13. Glossaire
| Terme | Signification |
|---|---|
| Centralité | Un score de l'importance d'un sommet, selon une définition donnée |
| Centralité de degré | Le nombre d'arêtes incidentes à un sommet |
| Centralité de proximité | (n - 1) divisé par la somme des distances à tous les autres sommets |
| Centralité harmonique | La moyenne de 1 / distance sur tous les autres sommets |
| Centralité d'intermédiarité | La somme, sur les paires, de la fraction des plus courts chemins qui passent par un sommet |
| Centralité de vecteur propre | Un score proportionnel à la somme des scores des voisins |
| Centralité de Katz | La centralité de vecteur propre avec une petite constante ajoutée pour chaque sommet |
| PageRank | La part du temps qu'un surfeur aléatoire passe sur une page à long terme |
| Facteur d'amortissement | La probabilité d que le surfeur suive un lien plutôt que de sauter |
| Cul-de-sac | Une page sans lien sortant |
| Méthode de la puissance | Multiplier de façon répétée par une matrice et remettre à l'échelle, pour trouver son vecteur propre principal |
| Algorithme de Brandes | L'intermédiarité exacte en O(VE) sur un graphe non pondéré |
14. Questions fréquentes
Qu'est-ce que la centralité en théorie des graphes ?
La centralité désigne tout score qui indique l'importance d'un sommet dans un graphe. Des définitions différentes saisissent des formes d'importance différentes : le nombre de connexions directes, la distance à tous les autres, la part des plus courts itinéraires qui passent par le sommet, ou l'importance de ses voisins. Sur un même graphe, ces définitions peuvent désigner des sommets différents.
Quelle est la différence entre la centralité de degré, de proximité et d'intermédiarité ?
Le degré compte les connexions directes d'un sommet. La proximité mesure le peu de pas qu'il lui faut pour atteindre tous les autres sommets. L'intermédiarité mesure combien des plus courts itinéraires entre les autres paires passent par le sommet. Une personne peut avoir peu de contacts et obtenir pourtant le meilleur score d'intermédiarité en étant le seul lien entre deux groupes.
Quelle est la différence entre PageRank et la centralité de vecteur propre ?
Les deux attribuent à un sommet un score fondé sur les scores des sommets qui lui sont reliés. PageRank est conçu pour les graphes orientés : chaque page répartit son rang entre ses liens sortants, et un facteur d'amortissement ajoute un saut aléatoire, si bien que les pages sans lien entrant et les groupes fermés de pages ne peuvent pas le mettre en défaut. La centralité de vecteur propre s'utilise surtout sur des graphes non orientés connexes.
Quelle mesure de centralité faut-il utiliser ?
Cela dépend de ce qui circule dans le réseau. Utilisez PageRank pour des liens orientés ou des citations, l'intermédiarité quand quelque chose doit passer par des sommets pour aller des uns aux autres, la proximité ou la centralité harmonique quand quelque chose se propage vers l'extérieur depuis un seul endroit, la centralité de vecteur propre quand la qualité des voisins compte, et le degré quand vous voulez une première réponse rapide.
Comment calcule-t-on la centralité d'intermédiarité ?
L'algorithme de Brandes lance un parcours en largeur depuis chaque sommet en comptant les plus courts chemins, puis remonte depuis le sommet le plus éloigné en transmettant du crédit aux prédécesseurs. Il prend un temps O(VE) sur un graphe non pondéré. Sur de très grands graphes, le lancer depuis un échantillon aléatoire de sources puis extrapoler donne une bonne estimation des premiers sommets.
Qu'est-ce que le facteur d'amortissement dans PageRank ?
Le facteur d'amortissement d est la probabilité que le surfeur aléatoire suive un lien plutôt que de sauter vers une page au hasard. Brin et Page ont indiqué le fixer habituellement à 0,85. Un d plus grand suit plus fidèlement la structure des liens, mais demande plus d'itérations et laisse les groupes fermés de pages absorber davantage de rang.
15. Références
Les algorithmes, résultats et attributions ci-dessus proviennent des sources suivantes, classées par ordre chronologique.
- Bavelas, A. (1948). "A Mathematical Model for Group Structures." Human Organization 7(3), 16 à 30.
- Seeley, J. R. (1949). "The Net of Reciprocal Influence: A Problem in Treating Sociometric Data." Canadian Journal of Psychology 3(4), 234 à 240.
- Bavelas, A. (1950). "Communication Patterns in Task-Oriented Groups." Journal of the Acoustical Society of America 22(6), 725 à 730.
- Katz, L. (1953). "A New Status Index Derived from Sociometric Analysis." Psychometrika 18(1), 39 à 43.
- Sabidussi, G. (1966). "The Centrality Index of a Graph." Psychometrika 31(4), 581 à 603.
- Anthonisse, J. M. (1971). "The Rush in a Directed Graph." Report BN 9/71, Stichting Mathematisch Centrum, Amsterdam.
- Bonacich, P. (1972). "Factoring and Weighting Approaches to Status Scores and Clique Identification." Journal of Mathematical Sociology 2(1), 113 à 120.
- Freeman, L. C. (1977). "A Set of Measures of Centrality Based on Betweenness." Sociometry 40(1), 35 à 41.
- Freeman, L. C. (1979). "Centrality in Social Networks: Conceptual Clarification." Social Networks 1(3), 215 à 239.
- Krackhardt, D. (1990). "Assessing the Political Landscape: Structure, Cognition, and Power in Organizations." Administrative Science Quarterly 35(2), 342 à 369.
- Brin, S. et Page, L. (1998). "The Anatomy of a Large-Scale Hypertextual Web Search Engine." Computer Networks and ISDN Systems 30(1 à 7), 107 à 117.
- Marchiori, M. et Latora, V. (2000). "Harmony in the Small-World." Physica A 285(3 à 4), 539 à 546.
- Brandes, U. (2001). "A Faster Algorithm for Betweenness Centrality." Journal of Mathematical Sociology 25(2), 163 à 177.
- Jeong, H., Mason, S. P., Barabási, A.-L. et Oltvai, Z. N. (2001). "Lethality and Centrality in Protein Networks." Nature 411, 41 à 42.
- Girvan, M. et Newman, M. E. J. (2002). "Community Structure in Social and Biological Networks." Proceedings of the National Academy of Sciences 99(12), 7821 à 7826.
- Haveliwala, T. H. et Kamvar, S. D. (2003). "The Second Eigenvalue of the Google Matrix." Technical Report, Stanford University.
- Brandes, U. et Pich, C. (2007). "Centrality Estimation in Large Networks." International Journal of Bifurcation and Chaos 17(7), 2303 à 2318.
- Franceschet, M. (2011). "PageRank: Standing on the Shoulders of Giants." Communications of the ACM 54(6), 92 à 101.
- Boldi, P. et Vigna, S. (2014). "Axioms for Centrality." Internet Mathematics 10(3 à 4), 222 à 262.
Voyez le parcours derrière les scores
La proximité et l'intermédiarité commencent toutes deux par un parcours en largeur depuis chaque sommet. Dessinez un petit réseau dans le visualiseur et lancez le parcours depuis deux sommets différents pour voir pourquoi l'un atteint tout le monde plus vite.
Ouvrir le visualiseur