
Inhaltsverzeichnis
- 1. Die kurze Antwort
- 2. Ein Unternehmen, vier Sieger
- 3. Grad und Nähe: Kontakte und Reichweite
- 4. Betweenness: durch wen die Wege laufen
- 5. Eigenvektorzentralität: wer Ihre Kontakte sind
- 6. PageRank: den Links folgen
- 7. Sackgassen, geschlossene Schleifen und der Dämpfungsfaktor
- 8. Stimmen die Maße überein?
- 9. Große Graphen: Betweenness schätzen
- 10. Wo diese Maße eingesetzt werden
- 11. Eine kurze Geschichte
- 12. Häufige Fehler
- 13. Glossar
- 14. Häufig gestellte Fragen
- 15. Quellen
1. Die kurze Antwort
Ein Zentralitätsmaß gibt jedem Knoten eines Graphen einen Wert dafür, wie wichtig er ist. Es gibt keinen einzig richtigen Wert, denn „wichtig“ kann mehreres bedeuten: viele Verbindungen haben, allen nahe sein, auf den Wegen zwischen anderen Personen liegen oder mit anderen verbunden sein, die selbst wichtig sind. Jede dieser Ideen ist ein eigenes Maß, und auf demselben Netzwerk können sie verschiedene Sieger benennen.
| Maß | Die Frage, die es beantwortet | Kosten | Geeignet für |
|---|---|---|---|
| Grad | Wer hat die meisten direkten Verbindungen? | O(V + E) | Ein schneller erster Blick; unmittelbare Reichweite |
| Nähe | Wer erreicht alle in den wenigsten Schritten? | O(V(V + E)) | Etwas schnell von einem Ort aus verbreiten |
| Betweenness | Wer liegt auf den Wegen zwischen anderen Paaren? | O(VE) ungewichtet | Engpässe, Vermittler, einzelne Kontrollpunkte |
| Eigenvektor | Wer ist mit gut vernetzten Personen verbunden? | O(E) pro Iteration | Einfluss in ungerichteten Netzwerken |
| PageRank | Wo verbringt ein zufälliger Surfer die meiste Zeit? | O(V + E) pro Iteration | Gerichtete Netzwerke: Links, Zitate |
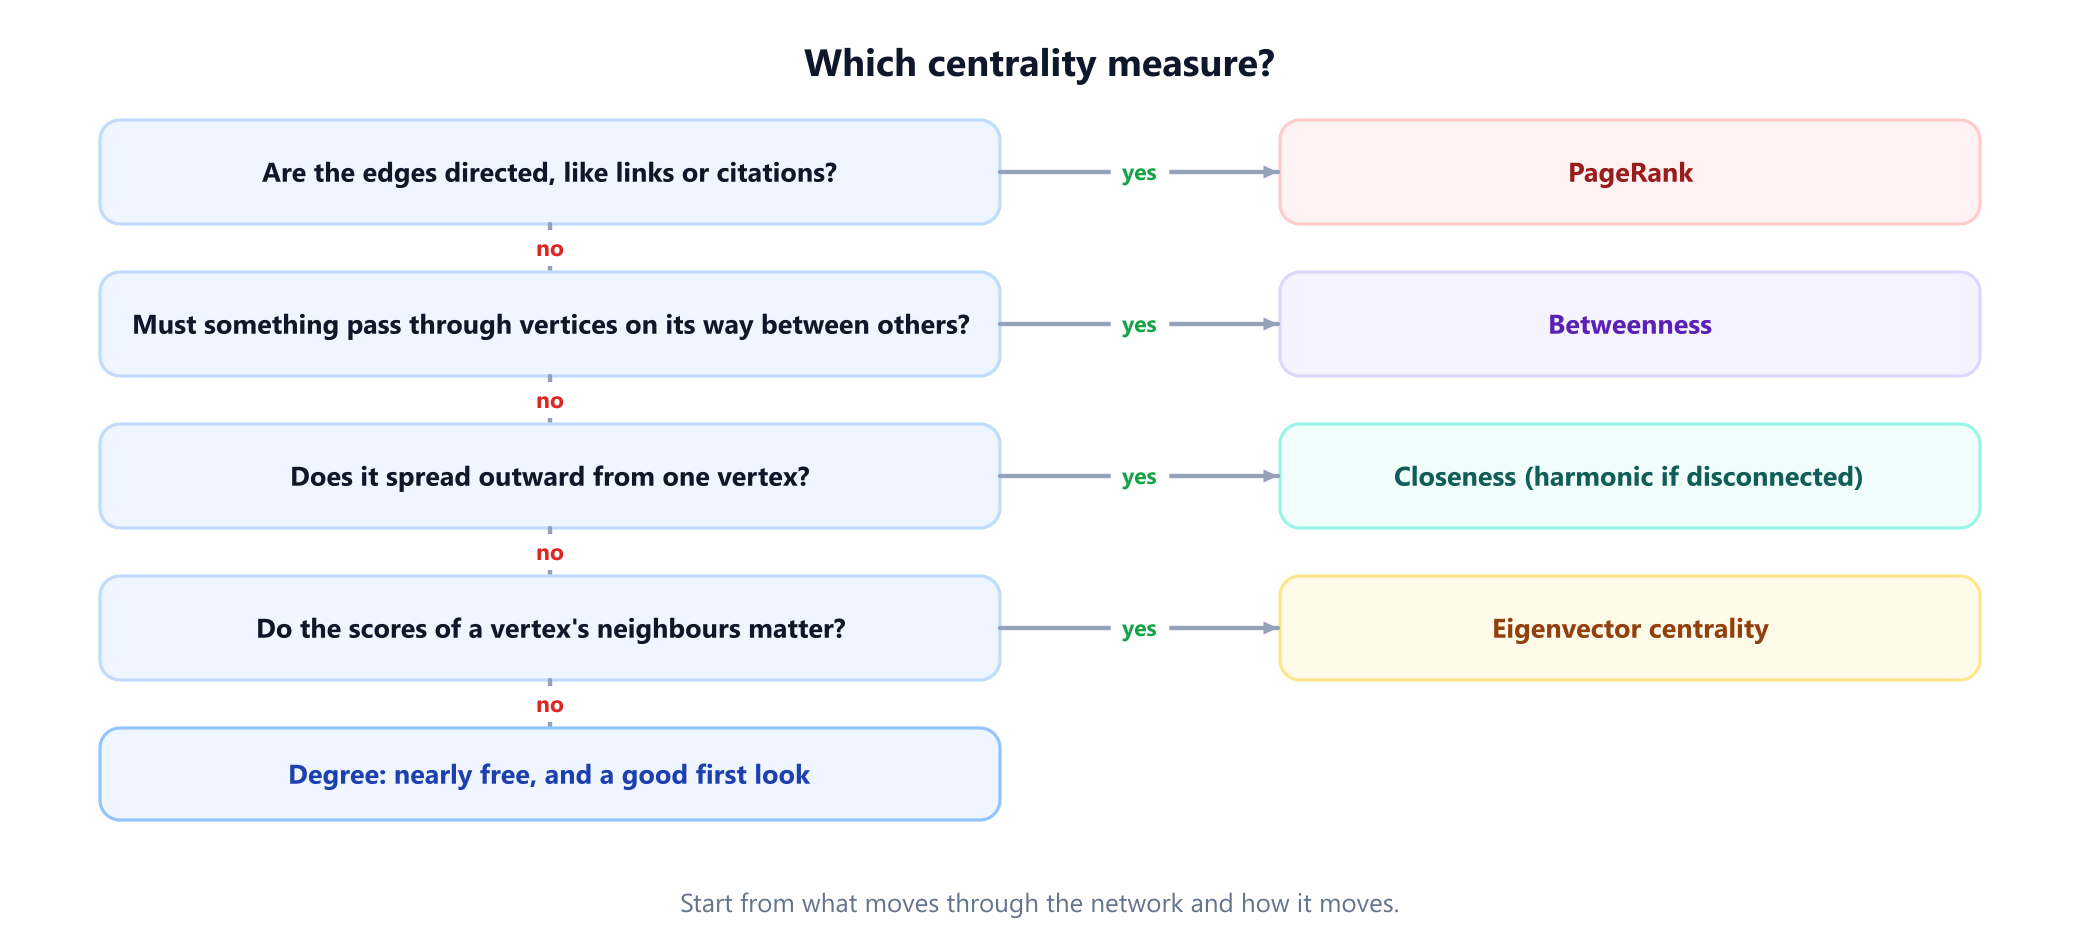
In einem Satz: Entscheiden Sie, was durch Ihr Netzwerk wandert und wie, und wählen Sie dann das Maß, das genau das modelliert. Wenn Sie nur einen Ausgangspunkt suchen, berechnen Sie zuerst den Grad, denn er ist fast kostenlos, und die anderen Maße liest man am besten als Korrekturen daran. Das folgende Diagramm fasst diesen Rat in vier Fragen.
2. Ein Unternehmen, vier Sieger
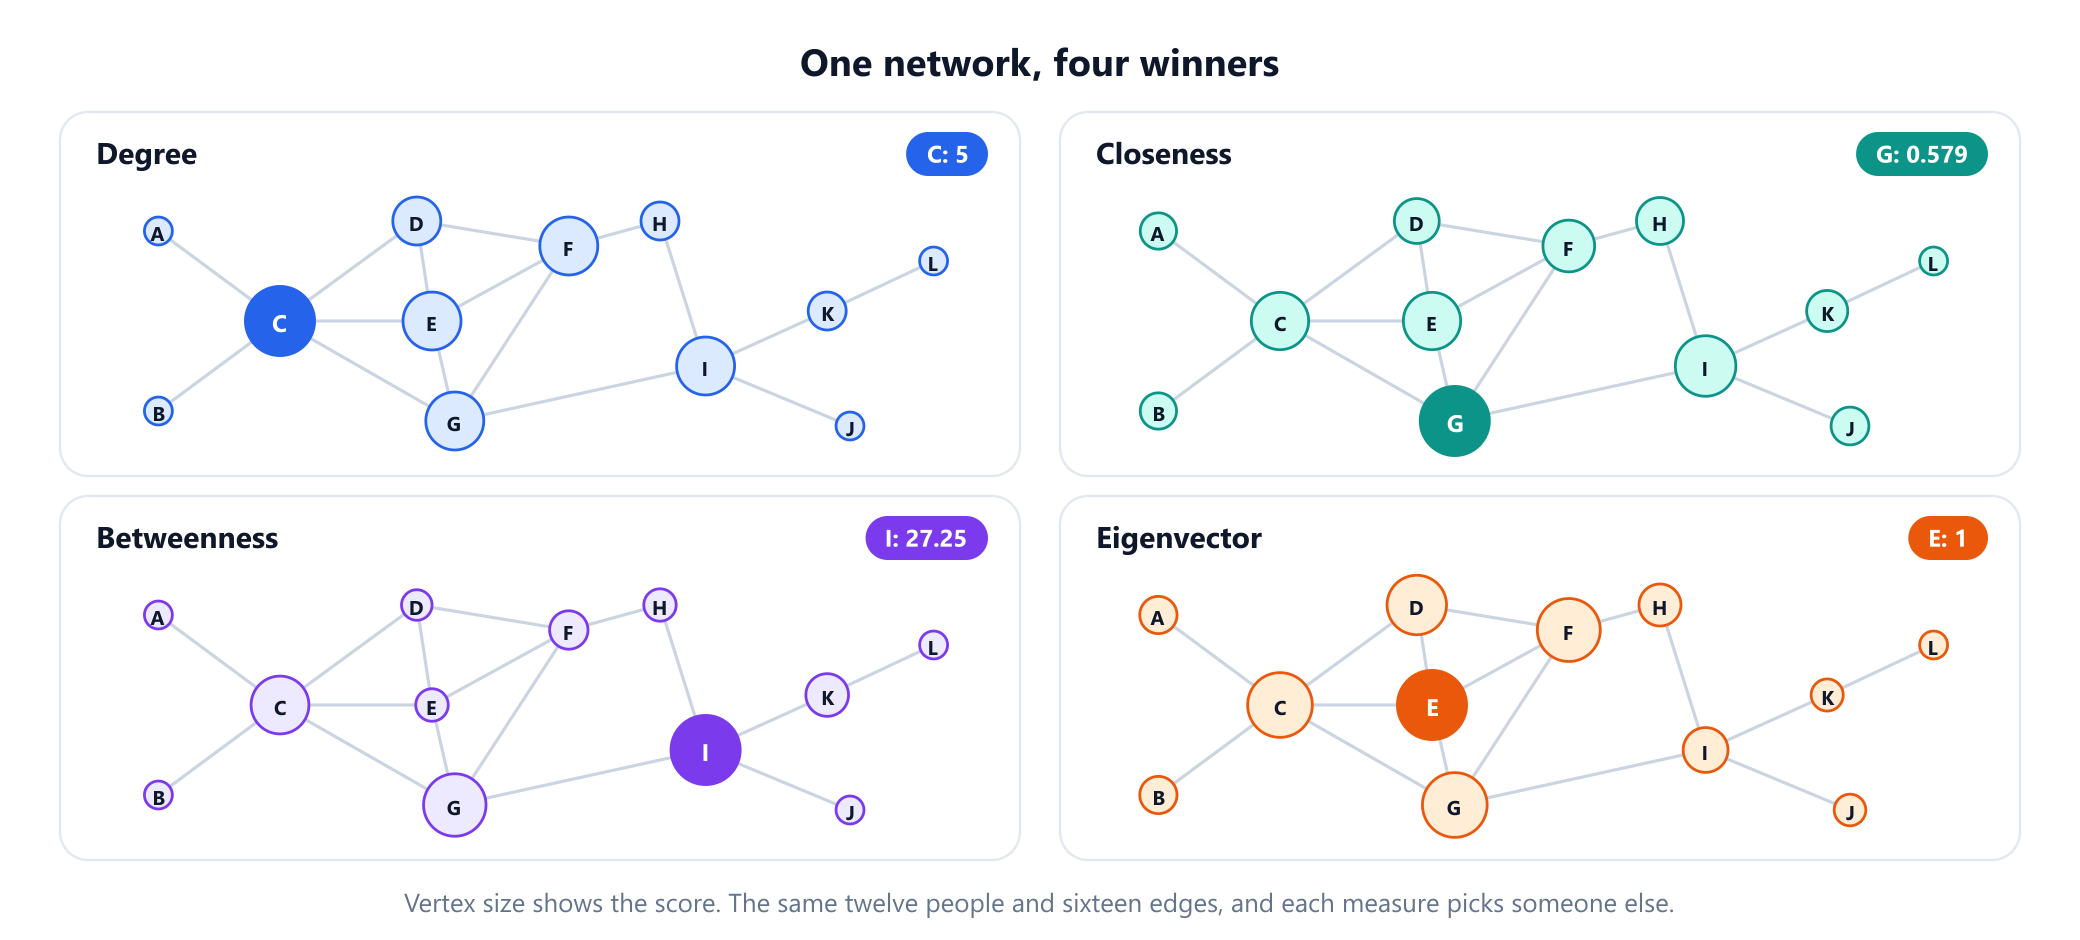
Das durchgehende Beispiel ist ein Unternehmen mit zwölf Personen, A bis L, mit einer Kante zwischen zwei Personen, die direkt zusammenarbeiten. Es hat 16 Kanten und wurde durch eine Computersuche nach einem kleinen Netzwerk gefunden, auf dem Grad-, Nähe-, Betweenness- und Eigenvektorzentralität jeweils eine andere Person wählen. Das erweitert die Idee von David Krackhardts „Kite“-Netzwerk von 1990, zehn Personen, bei denen Grad, Nähe und Betweenness verschiedene Personen bevorzugen.
| Person | Grad | Nähe | Betweenness | Eigenvektor |
|---|---|---|---|---|
| A | 1 | 0.344 | 0 | 0.262 |
| B | 1 | 0.344 | 0 | 0.262 |
| C | 5 | 0.500 | 20.33 | 0.921 |
| D | 3 | 0.407 | 1.75 | 0.796 |
| E | 4 | 0.500 | 3.08 | 1.000 |
| F | 4 | 0.458 | 7.08 | 0.879 |
| G | 4 | 0.579 | 23.50 | 0.922 |
| H | 2 | 0.423 | 3.00 | 0.376 |
| I | 4 | 0.524 | 27.25 | 0.444 |
| J | 1 | 0.355 | 0 | 0.126 |
| K | 2 | 0.379 | 10.00 | 0.137 |
| L | 1 | 0.282 | 0 | 0.039 |
Alle vier Antworten sind richtig. C hat die meisten Kontakte, von denen zwei sonst niemanden kennen. G erreicht das ganze Unternehmen mit den wenigsten Schritten insgesamt. I ist die einzige Verbindung zwischen J, K und L und dem Rest des Unternehmens. Und E sitzt in der Mitte der eng verbundenen Gruppe. Beachten Sie, wie schlecht die Sieger bei den Maßen der anderen abschneiden: E liegt bei der Betweenness nur auf Platz sechs und I liegt bei der Eigenvektorzentralität ebenfalls nur auf Platz sechs. Die Abschnitte 3 bis 5 erklären jede Spalte und zeigen den Code, der sie erzeugt hat.
3. Grad und Nähe: Kontakte und Reichweite
Gradzentralität ist die Anzahl der Kanten an einem Knoten, die der Leitfaden zum Knotengrad ausführlich behandelt. Sie schaut nur einen Schritt weit, kostet also fast nichts und übersieht alles jenseits der Nachbarn. C gewinnt mit 5, und auf einem gerichteten Graphen zerfällt sie in Eingangsgrad und Ausgangsgrad.
Nähezentralität betrachtet jeden Knoten. Für einen Knoten v in einem zusammenhängenden Graphen addiert man die kürzesten Distanzen von v zu allen anderen und kehrt das Ergebnis dann um, sodass ein höherer Wert größere Nähe bedeutet: (n - 1) / Summe der Distanzen. Die Distanzen liefert eine Breitensuche von jedem Knoten aus. Das folgende Programm wird als people.py gespeichert, weil spätere Programme es importieren.
from collections import deque

# Wer in einem Unternehmen mit zwölf Personen direkt mit wem zusammenarbeitet.
PEOPLE = 'AC BC CD CE CG DE DF EF EG FG FH GI HI IJ IK KL'.split()

def graph(edges):
    adj = {}
    for a, b in edges:
        adj.setdefault(a, []).append(b)
        adj.setdefault(b, []).append(a)
    return adj

def distances(adj, source):
    """Breitensuche: Anzahl der Schritte von source zu allem, was erreichbar ist."""
    dist, queue = {source: 0}, deque([source])
    while queue:
        v = queue.popleft()
        for w in adj[v]:
            if w not in dist:
                dist[w] = dist[v] + 1
                queue.append(w)
    return dist

def degree(adj):
    return {v: len(adj[v]) for v in adj}

def closeness(adj):
    """(erreichbare Knoten) / (Summe der Distanzen zu ihnen): irreführend, wenn adj unzusammenhängend ist."""
    result = {}
    for v in adj:
        dist = distances(adj, v)
        result[v] = (len(dist) - 1) / sum(dist.values()) if len(dist) > 1 else 0.0
    return result

def harmonic(adj):
    """Mittelwert von 1 / Distanz über alle anderen Knoten; ein unerreichbarer Knoten trägt 0 bei."""
    n = len(adj)
    return {v: sum(1 / d for d in distances(adj, v).values() if d) / (n - 1) for v in adj}

def winner(score):
    return max(sorted(score), key=score.get)

if __name__ == '__main__':
    adj = graph(PEOPLE)
    d, c, h = degree(adj), closeness(adj), harmonic(adj)
    print('most contacts: ', winner(d), d[winner(d)])
    print('closest to all:', winner(c), round(c[winner(c)], 3))
    # Zwei Freiberufler hinzufügen, die nur miteinander arbeiten.
    split = graph(PEOPLE + ['XY'])
    c2, h2 = closeness(split), harmonic(split)
    print('naive closeness, X:', round(c2['X'], 3), ' G:', round(c2['G'], 3))
    print('harmonic,        X:', round(h2['X'], 3), ' G:', round(h2['G'], 3))
# most contacts:  C 5
# closest to all: G 0.579
# naive closeness, X: 1.0  G: 0.579
# harmonic,        X: 0.077  G: 0.564
G erreicht die anderen elf Personen in insgesamt 19 Schritten, die Nähezentralität beträgt also 11 / 19 = 0,579.
Die letzten beiden Ausgabezeilen zeigen die typische Falle. Nähezentralität setzt voraus, dass jeder jeden erreichen kann. Fügen Sie zwei Freiberufler hinzu, X und Y, die nur miteinander arbeiten, und der übliche Behelf, nur über die erreichbaren Knoten zu summieren, gibt X einen perfekten Wert von 1,0, weit über G, nur weil die winzige Komponente von X einen Schritt breit ist. Harmonische Zentralität behebt das, indem sie 1 / Distanz über alle anderen Knoten mittelt, sodass ein unerreichbarer Knoten 0 beiträgt. Sie gibt X nur 0,077 und lässt G bei 0,564. Das Maß wurde erstmals im Jahr 2000 von Massimo Marchiori und Vito Latora vorgeschlagen, und die Studie von Paolo Boldi und Sebastiano Vigna aus dem Jahr 2014 darüber, was ein Zentralitätsmaß erfüllen sollte, fand es als einziges der getesteten Maße, das alle drei ihrer Axiome erfüllt. Verwenden Sie es immer dann, wenn ein Graph unzusammenhängend sein kann; der Leitfaden zu Zusammenhangskomponenten zeigt, wie man das prüft.
4. Betweenness: durch wen die Wege laufen
Betweenness-Zentralität stellt eine andere Frage: Wenn jeder jedem anderen eine Nachricht entlang kürzester Wege schickte, wie viele dieser Nachrichten würden durch v laufen? Für jedes Paar s, t ohne v nimmt sie den Anteil der kürzesten s-t Wege, die durch v laufen, und summiert diese Anteile. Die Anteile sind wichtig: In einem Quadrat S, X, T, Y gibt es zwei gleich kurze Wege von S nach T, also bekommen X und Y von diesem Paar je einen halben Punkt.
Direkt gezählt braucht das O(V³) Zeit oder mehr. 2001 zeigte Ulrik Brandes, wie es in O(VE) auf einem ungewichteten Graphen geht, indem man pro Quelle eine Breitensuche ausführt und dann vom am weitesten entfernten Knoten zurückläuft. Der Schlüssel ist, dass sich der Beitrag, den jeder Knoten nach oben weitergibt, aus den Beiträgen der Knoten unter ihm berechnen lässt, statt für jedes Ziel neu berechnet zu werden.
from collections import deque
from people import PEOPLE, graph

def betweenness(adj, sources=None):
    """Algorithmus von Brandes für einen ungerichteten, ungewichteten Graphen.

    sources=None verwendet jeden Knoten und ist exakt. Eine Liste von Quellen liefert eine Schätzung."""
    sources = list(adj) if sources is None else sources
    score = dict.fromkeys(adj, 0.0)
    for s in sources:
        # Phase 1: BFS von s aus, zählt kürzeste Wege (sigma) und merkt sich Vorgänger.
        order, preds, sigma, dist = [], {v: [] for v in adj}, dict.fromkeys(adj, 0), {s: 0}
        sigma[s] = 1
        queue = deque([s])
        while queue:
            v = queue.popleft()
            order.append(v)
            for w in adj[v]:
                if w not in dist:
                    dist[w] = dist[v] + 1
                    queue.append(w)
                if dist[w] == dist[v] + 1:
                    sigma[w] += sigma[v]
                    preds[w].append(v)
        # Phase 2: vom am weitesten entfernten Knoten zurücklaufen, Anteile an Vorgänger weitergeben.
        delta = dict.fromkeys(adj, 0.0)
        for w in reversed(order):
            for v in preds[w]:
                delta[v] += sigma[v] / sigma[w] * (1 + delta[w])
            if w != s:
                score[w] += delta[w]
    scale = len(adj) / len(sources) / 2          # jedes Paar wird von beiden Enden aus gesehen
    return {v: x * scale for v, x in score.items()}

if __name__ == '__main__':
    b = betweenness(graph(PEOPLE))
    for v in sorted(b, key=b.get, reverse=True)[:5]:
        print(v, round(b[v], 2))
    print(betweenness(graph('SX XT SY YT'.split())))   # zwei gleich kurze Wege von S nach T
# I 27.25
# G 23.5
# C 20.33
# K 10.0
# F 7.08
# {'S': 0.5, 'X': 0.5, 'T': 0.5, 'Y': 0.5}
Jede Suche zählt jedes Paar zweimal, einmal von jedem Ende aus, und deshalb teilt das Programm auf einem ungerichteten Graphen durch 2. Auf einem gewichteten Graphen ersetzt Dijkstra die Breitensuche, und die Laufzeit wird zu O(VE + V² log V).
I erzielt 27,25 von möglichen 55 Punkten, der Anzahl der Paare ohne I, also läuft etwa die Hälfte der kürzesten Wege zwischen anderen Paaren durch diesen Knoten. Von diesen 27,25 Punkten stammen 26 aus Paaren mit J, K oder L, die keinen anderen Weg nach draußen haben. I hat nur vier Kontakte, genauso viele wie E, F und G. Genau das kann der Grad nicht zeigen.
5. Eigenvektorzentralität: wer Ihre Kontakte sind
Der Grad zählt Kontakte, als wären alle gleich viel wert. Eigenvektorzentralität besagt, dass ein Kontakt so viel wert ist wie dessen eigener Wert, sodass der Wert eines Knotens proportional zur Summe der Werte seiner Nachbarn ist: x = (1 / λ) A x, wobei A die Adjazenzmatrix ist. Damit ist x ein Eigenvektor von A. Auf einem zusammenhängenden ungerichteten Graphen garantiert der Satz von Perron-Frobenius, dass es bis auf Skalierung genau einen Eigenvektor mit lauter positiven Einträgen gibt, der zum größten Eigenwert gehört, und dieser ist der Wert. Phillip Bonacich machte das Maß 1972 zu einem Standardwerkzeug der Netzwerkanalyse, obwohl John Seeley schon 1949 einen ähnlichen Wert auf soziometrische Daten angewendet hatte.
Der übliche Weg, sie zu berechnen, ist die Potenzmethode: mit gleichen Werten beginnen, jeden Wert durch die Summe seiner Nachbarn ersetzen, neu skalieren und wiederholen.
from people import PEOPLE, graph

def eigenvector(adj, shift=1.0, steps=2000):
    """Potenzmethode auf A + shift * I, so skaliert, dass der höchste Wert 1 ist."""
    x = dict.fromkeys(adj, 1.0)
    for _ in range(steps):
        y = {v: shift * x[v] + sum(x[u] for u in adj[v]) for v in adj}
        top = max(y.values())
        x = {v: y[v] / top for v in y}
    return x

if __name__ == '__main__':
    e = eigenvector(graph(PEOPLE))
    for v in sorted(e, key=e.get, reverse=True)[:4]:
        print(v, round(e[v], 3))
    # Ohne shift kann ein bipartiter Graph die Iteration für immer springen lassen.
    path = graph('AB BC CD'.split())
    x = {'A': 1.0, 'B': 0.0, 'C': 0.0, 'D': 0.0}
    for step in range(1, 52):
        y = {v: sum(x[u] for u in path[v]) for v in path}
        top = max(y.values())
        x = {v: y[v] / top for v in y}
        if step >= 50:
            print('step', step, {v: round(x[v], 3) for v in sorted(x)})
    print('with the shift', {v: round(s, 3) for v, s in sorted(eigenvector(path).items())})
# E 1.0
# G 0.922
# C 0.921
# F 0.879
# step 50 {'A': 0.618, 'B': 0.0, 'C': 1.0, 'D': 0.0}
# step 51 {'A': 0.0, 'B': 1.0, 'C': 0.0, 'D': 0.618}
# with the shift {'A': 0.618, 'B': 1.0, 'C': 1.0, 'D': 0.618}
E gewinnt, obwohl C mehr Kontakte hat und G näher an allen ist. Die Werte der vier Kontakte von E ergeben zusammen 3,519. Die vier von G kommen nur auf 3,244, weil einer davon I ist, ein Kontakt mit nur 0,444, der hinaus an den Rand des Unternehmens führt.
Die Ausgabe zeigt auch, warum der Code shift addiert. Ein Sonderfall ist der bipartite Graph, A hat dort einen Eigenwert gleicher Größe mit entgegengesetztem Vorzeichen, sodass die reine Potenzmethode womöglich nie zur Ruhe kommt: Auf einem Weg aus vier Knoten, gestartet von einem einzelnen Knoten, springen die Werte für immer zwischen zwei Zuständen hin und her, wobei in jedem Schritt die Hälfte von ihnen 0 ist. Die Iteration mit A + I verschiebt jeden Eigenwert um 1 nach oben, beseitigt den Gleichstand und lässt die Eigenvektoren unverändert. Der Leitfaden zur spektralen Graphentheorie behandelt, was die übrigen Eigenwerte verraten.
Auf gerichteten Graphen versagt das Maß: Ein Knoten, auf den niemand zeigt, erhält 0, und ebenso alles, worauf nur er zeigt. Das Maß von Leo Katz aus dem Jahr 1953 vermeidet dieses Problem: Es zählt jeden Kantenzug, der in einen Knoten führt, wobei ein Kantenzug der Länge k mit α^k gewichtet wird. In moderner Form lautet es x = α Aᵀ x + 1, wobei α unter 1 / λ liegt, was darauf hinausläuft, jedem Knoten einen kleinen Grundwert zu schenken. PageRank nimmt noch eine weitere Änderung vor.
6. PageRank: den Links folgen
PageRank, 1998 von Sergey Brin und Larry Page veröffentlicht, wurde für das Web entworfen, in dem ein Link von einer Seite eine Stimme für eine andere Seite ist. Katz' Maß hat dort einen Fehler: Eine Seite, die auf tausend andere verlinkt, gibt jeder von ihnen ihren vollen Wert weiter. Bei PageRank teilt jede Seite ihren Wert auf ihre ausgehenden Links auf.
Das übliche Bild ist ein zufälliger Surfer. In jedem Schritt folgt der Surfer mit Wahrscheinlichkeit d, dem Dämpfungsfaktor, einem zufälligen Link der aktuellen Seite und springt andernfalls zu einer gleichverteilt zufällig gewählten Seite. Der Rang einer Seite ist der Anteil der Zeit, den der Surfer auf lange Sicht auf ihr verbringt. In der normierten Form, in der alle Ränge zusammen 1 ergeben, gilt:
rank(p) = (1 - d) / n + d * Summe von rank(q) / outdegree(q), über alle Seiten q, die auf p verlinkenDas Beispiel ist ein Web aus acht Seiten. Jede Seite kann jede andere erreichen, nichts ist also abgeschnitten. Brin und Page berichteten, dass sie d meist auf 0,85 setzten, und das Programm macht es genauso.
# Acht Webseiten und die Seiten, auf die jede von ihnen verlinkt.
WEB = {'A': 'CH', 'B': 'CDEH', 'C': 'A', 'D': 'C', 'E': 'D', 'F': 'BDG', 'G': 'D', 'H': 'AF'}

def pagerank(links, d=0.85, tol=1e-10):
    """Potenzmethode. Eine Seite ohne ausgehende Links teilt ihren Rang mit jeder Seite."""
    pages = sorted(links)
    n = len(pages)
    rank = dict.fromkeys(pages, 1 / n)
    steps = 0
    while True:
        dangling = sum(rank[p] for p in pages if not links[p])
        new = dict.fromkeys(pages, (1 - d) / n + d * dangling / n)
        for p in pages:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        change = sum(abs(new[p] - rank[p]) for p in pages)
        rank, steps = new, steps + 1
        if change < tol:
            return rank, steps

if __name__ == '__main__':
    rank, steps = pagerank(WEB)
    inlinks = {p: sum(p in out for out in WEB.values()) for p in WEB}
    for p in sorted(rank, key=rank.get, reverse=True):
        print(p, 'in-links', inlinks[p], ' rank', round(rank[p], 3))
    print('iterations', steps, ' total', round(sum(rank.values()), 6))
# A in-links 2  rank 0.293
# C in-links 3  rank 0.247
# H in-links 2  rank 0.152
# D in-links 4  rank 0.111
# F in-links 1  rank 0.084
# B in-links 1  rank 0.042
# G in-links 1  rank 0.042
# E in-links 1  rank 0.028
# iterations 70  total 1.0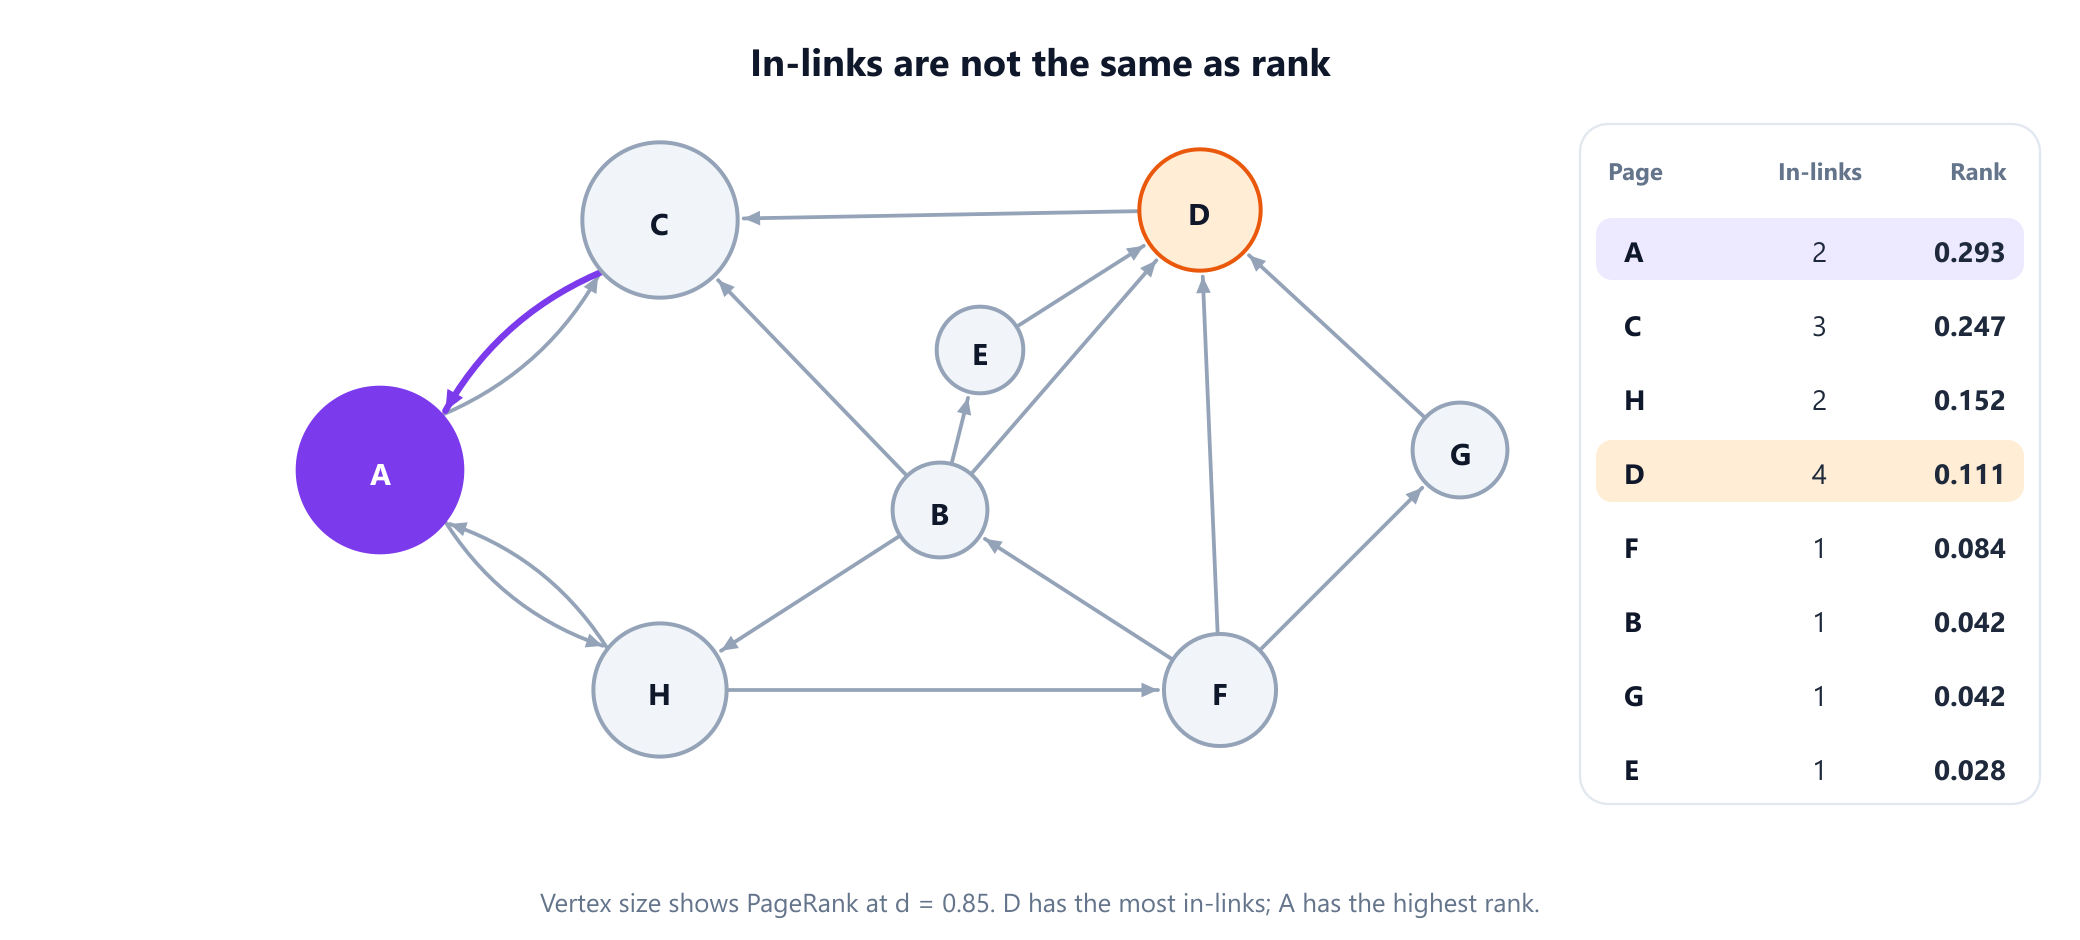
D hat die meisten eingehenden Links, vier, doch sie kommen von Seiten mit wenig Rang zum Weitergeben, und B und F verteilen ihren auf mehrere Links. D gibt dann ihren gesamten Rang an C weiter, und C gibt ihren gesamten Rang an A weiter. So landet A, mit nur zwei eingehenden Links, mit 0,293 auf Platz eins, und A und C halten zusammen 54 % der Summe. Auf einem ungerichteten Graphen ist das Bild viel einfacher: Mit d = 1 auf einem zusammenhängenden, nicht bipartiten Graphen ist PageRank genau proportional zum Grad. PageRank ist vor allem ein Maß für gerichtete Graphen, und der Leitfaden zu gerichteten und ungerichteten Graphen erklärt, warum die Unterscheidung wichtig ist.
7. Sackgassen, geschlossene Schleifen und der Dämpfungsfaktor
Der Dämpfungsfaktor ist keine Dekoration. Zwei Arten von Seiten bringen den einfachen Prozess „einem Link folgen“ zum Scheitern, und das nächste Programm beschädigt das Beispiel-Web auf beide Weisen.
from pagerank import WEB, pagerank

def leaky(links, d=0.85, steps=200):
    """Die Lehrbuch-Aktualisierung ohne Behandlung von Sackgassen."""
    n = len(links)
    rank = dict.fromkeys(links, 1 / n)
    for _ in range(steps):
        new = dict.fromkeys(links, (1 - d) / n)
        for p in links:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        rank = new
    return rank

if __name__ == '__main__':
    dead_end = {**WEB, 'A': ''}                    # A verlinkt nirgendwohin mehr
    print('dead end, naive update:   total', round(sum(leaky(dead_end).values()), 3))
    print('dead end, handled:        total', round(sum(pagerank(dead_end)[0].values()), 3))
    closed = {**WEB, 'A': 'C'}                     # A und C verlinken jetzt nur noch aufeinander
    for d in (0.85, 0.999):
        rank = pagerank(closed, d=d, tol=1e-9)[0]
        print(f'closed loop, d = {d}: A + C hold', round(rank['A'] + rank['C'], 3))
# dead end, naive update:   total 0.403
# dead end, handled:        total 1.0
# closed loop, d = 0.85: A + C hold 0.791
# closed loop, d = 0.999: A + C hold 0.998
Eine Sackgasse ist eine Seite ohne ausgehende Links. Die Lehrbuch-Aktualisierung weiß nicht, wohin sie deren Rang schicken soll, also versickert Rang aus dem System: Wird A zur Sackgasse gemacht, fällt die Summe von 1 auf 0,403. Die Lösung, die die obige Funktion pagerank verwendet, verteilt den Rang einer Sackgasse auf alle Seiten, als spränge der Surfer von dort zufällig weiter.
Eine geschlossene Schleife ist eine Gruppe von Seiten, die nur aufeinander verlinken. Ist der Surfer einmal drin, kommt er nur durch den Zufallssprung wieder heraus. Lässt man A nur auf C verlinken, hält das Paar 79,1 % des gesamten Rangs bei d = 0.85 und 99,8 % bei d = 0.999. Je kleiner d ist, desto weniger kann eine Schleife aufnehmen.
Der Preis eines großen d ist die Geschwindigkeit. Die Änderung der Ränge schrumpft mindestens um den Faktor d pro Schritt, was zum Ergebnis von Taher Haveliwala und Sepandar Kamvar passt, dass der zweite Eigenwert der PageRank-Matrix betragsmäßig höchstens d ist. Das nächste Programm misst das auf einem Web aus 1.000 Seiten, die auf 20 Websites verteilt sind.
import random

def web(sites, size, rnd):
    """Seiten verlinken meist innerhalb ihrer eigenen Website; etwa jede zehnte Seite verlinkt auf eine andere Website."""
    links = {}
    for s in range(sites):
        for i in range(size):
            out = {s * size + rnd.randrange(size) for _ in range(5)}
            if rnd.random() < 0.1:
                out.add(rnd.randrange(sites * size))
            links[s * size + i] = sorted(out - {s * size + i})
    return links

def steps_needed(links, d, tol=1e-6):
    n = len(links)
    rank, step = dict.fromkeys(links, 1 / n), 0
    while True:
        lost = sum(rank[p] for p in links if not links[p])
        new = dict.fromkeys(links, (1 - d) / n + d * lost / n)
        for p in links:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        change = sum(abs(new[p] - rank[p]) for p in links)
        rank, step = new, step + 1
        if change < tol:
            return step

if __name__ == '__main__':
    links = web(20, 50, random.Random(5))
    for d in (0.5, 0.85, 0.95, 0.99):
        print('d =', d, ' iterations:', steps_needed(links, d))
# d = 0.5  iterations: 13
# d = 0.85  iterations: 53
# d = 0.95  iterations: 149
# d = 0.99  iterations: 607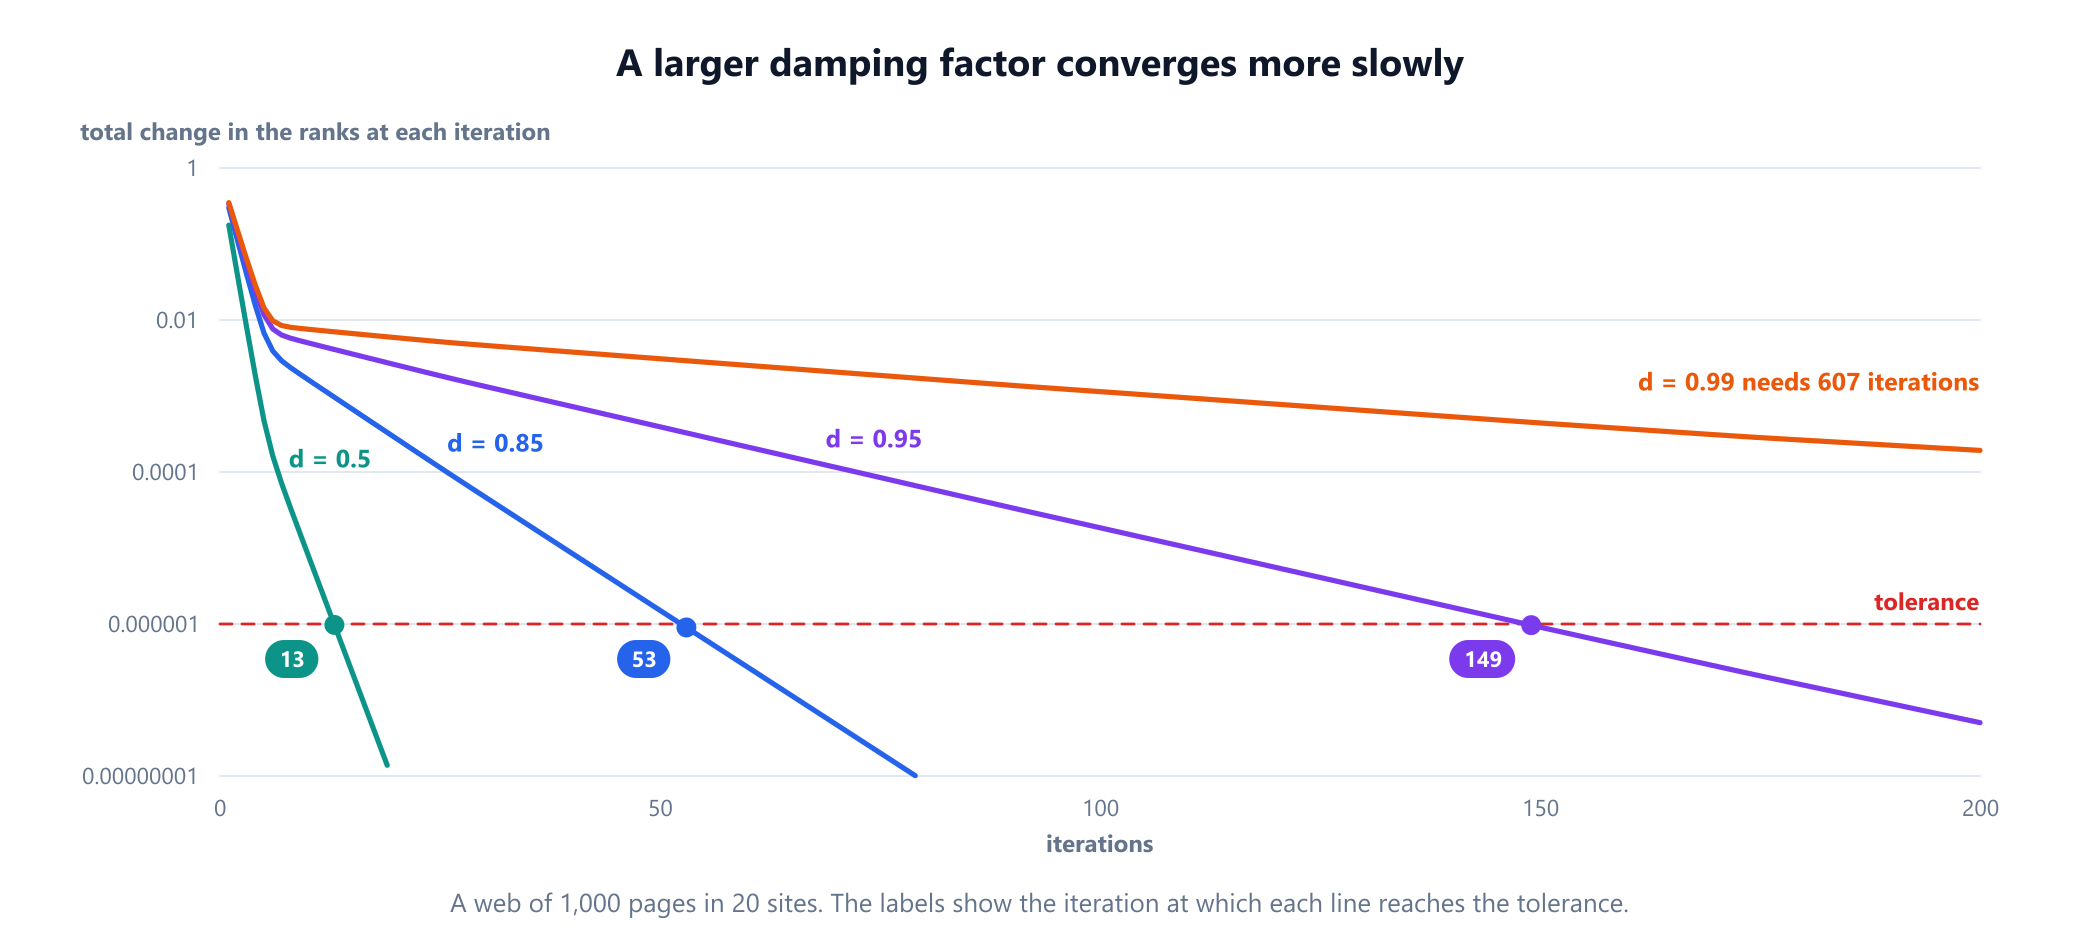
8. Stimmen die Maße überein?
Würden die Maße meist dieselben Knoten nennen, könnte man immer das günstigste verwenden. Das nächste Programm baut drei Arten von Netzwerken mit je 400 Knoten und fragt dann, wie viele der 20 Knoten mit der höchsten Betweenness auch unter den Top 20 jedes anderen Maßes sind.
import random
from people import degree, closeness
from brandes import betweenness
from eigen import eigenvector

def link(adj, a, b):
    if a != b and b not in adj[a]:
        adj[a].append(b)
        adj[b].append(a)

def hubs(n, m, rnd):
    """Bevorzugte Anbindung: Neue Knoten bevorzugen Knoten, die schon viele Kanten haben."""
    adj = {v: [] for v in range(n)}
    pool = list(range(m))
    for v in range(m, n):
        for t in set(rnd.choice(pool) for _ in range(m)):
            link(adj, v, t)
            pool += [v, t]
    return adj

def two_groups(n, rnd):
    """Zwei dichte Hälften, nur durch sechs Kanten verbunden."""
    adj = {v: [] for v in range(n)}
    half = n // 2
    for a in range(n):
        for b in range(a + 1, n):
            if (a < half) == (b < half) and rnd.random() < 0.05:
                link(adj, a, b)
    for _ in range(6):
        link(adj, rnd.randrange(half), rnd.randrange(half, n))
    return adj

def ring(n, rnd):
    """Jeder Knoten ist mit seinen 3 nächsten Nachbarn in jeder Richtung verbunden; 5 % der Kanten umverdrahtet."""
    adj = {v: [] for v in range(n)}
    for v in range(n):
        for k in (1, 2, 3):
            link(adj, v, rnd.randrange(n) if rnd.random() < 0.05 else (v + k) % n)
    return adj

def top(score, k=20):
    return set(sorted(score, key=lambda v: (-score[v], v))[:k])

if __name__ == '__main__':
    rnd = random.Random(11)
    print('top 20 by betweenness also in the top 20 by:  degree, closeness, eigenvector')
    for name, adj in (('hubs', hubs(400, 2, rnd)), ('two groups', two_groups(400, rnd)), ('ring', ring(400, rnd))):
        b = top(betweenness(adj))
        print(f'{name:11}', len(b & top(degree(adj))), len(b & top(closeness(adj))), len(b & top(eigenvector(adj, steps=4000))))
# top 20 by betweenness also in the top 20 by:  degree, closeness, eigenvector
# hubs        18 13 14
# two groups  8 17 4
# ring        6 9 1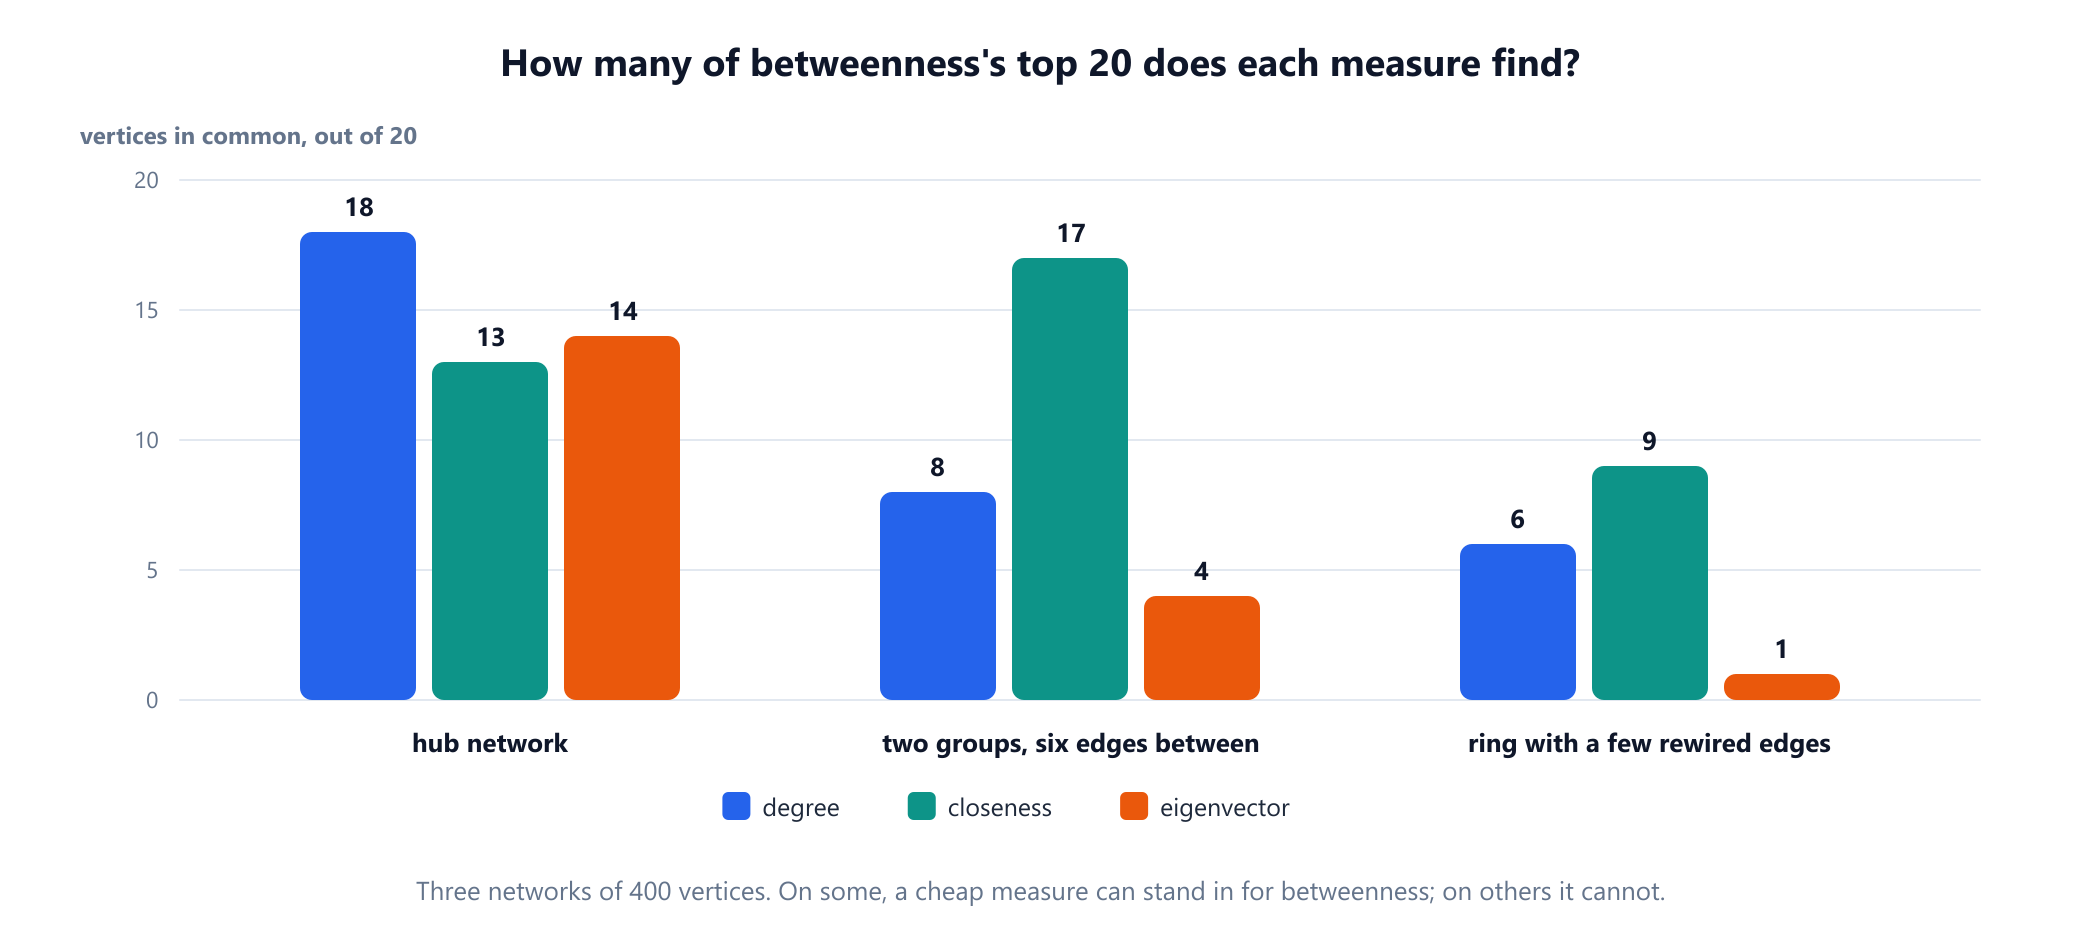
Im Hub-Netzwerk, in dem wenige Knoten die meisten Kanten auf sich vereinen, findet der Grad 18 der 20, sodass sich der Aufwand für Betweenness kaum lohnt. Bei den zwei durch sechs Kanten verbundenen Gruppen findet der Grad nur 8 und die Eigenvektorzentralität nur 4, weil alle ihre 20 Spitzenknoten in derselben Gruppe liegen: Sie konzentriert sich auf eine Hälfte und sieht die andere nicht. Auf dem Ring, wo die Struktur größtenteils lokal ist, wählen die Maße weitgehend verschiedene Knoten. Bevor Sie sich auf einen günstigen Ersatz verlassen, testen Sie ihn an einer Stichprobe Ihres eigenen Netzwerks.
9. Große Graphen: Betweenness schätzen
Exakte Betweenness braucht eine Suche pro Knoten, was auf Graphen mit Hunderten Millionen Knoten außer Reichweite ist. Die übliche Abkürzung, 2007 von Brandes und Christian Pich untersucht, besteht darin, die Suche von einer zufälligen Stichprobe von Quellknoten aus zu starten und das Ergebnis hochzuskalieren. Das Argument sources des Programms aus Abschnitt 4 macht das bereits.
import random
from brandes import betweenness
from agree import hubs, top

if __name__ == '__main__':
    rnd = random.Random(3)
    adj = hubs(1000, 3, rnd)
    exact = betweenness(adj)
    best = top(exact, 10)
    print('sources  work  top 10 found  mean error of the top 10   (average of 10 runs)')
    for k in (10, 50, 100, 250, 500):
        found = error = 0
        for _ in range(10):
            estimate = betweenness(adj, rnd.sample(sorted(adj), k))
            found += len(best & top(estimate, 10))
            error += sum(abs(estimate[v] - exact[v]) / exact[v] for v in best) / 10
        print(f'{k:7} {k / 10:4.0f}% {found / 10:13.1f} {error / 10:12.1%}')
# sources  work  top 10 found  mean error of the top 10   (average of 10 runs)
#      10    1%           6.2        36.8%
#      50    5%           8.1        17.3%
#     100   10%           9.4        13.4%
#     250   25%           9.1         8.6%
#     500   50%           9.4         4.0%
Auf diesem Netzwerk mit 1.000 Knoten findet man mit 10 % der Arbeit im Mittel 9,4 der wahren 10 Spitzenknoten, bei einem typischen Fehler von etwa 13 % in ihren Werten. Stichproben finden die Spitze der Liste zuverlässig und sind bei den Werten selbst viel ungenauer. Eine Stichprobe von 1 % ist zu klein und findet nur 6,2. Der Grad bleibt dagegen bei jeder Größe günstig, und Eigenvektorzentralität und PageRank brauchen nur eine begrenzte Zahl von Durchläufen über die Kanten, weshalb sie bis zu Graphen in der Größe des Webs skalieren.
10. Wo diese Maße eingesetzt werden
- Websuche. PageRank war ein zentraler Bestandteil der ersten Google-Suchmaschine, kombiniert mit anderen Signalen wie dem Text von Seiten und Links.
- Biologie. Hawoong Jeong und Kollegen berichteten 2001, dass im Proteinnetzwerk der Hefe stark vernetzte Proteine mit höherer Wahrscheinlichkeit überlebenswichtig sind. Der Leitfaden zur Graphentheorie in der Biologie betrachtet Hubs und Engpässe.
- Community-Erkennung. Die Methode von Michelle Girvan und Mark Newman aus dem Jahr 2002 entfernt wiederholt die Kante mit der höchsten Betweenness und berechnet die Betweenness nach jeder Entfernung neu, da Kanten zwischen Gruppen die meisten Wege tragen.
- Sicherheit. Betweenness zeigt auf die Hosts, durch die die meisten Angriffspfade laufen, und genau dort hilft eine einzelne Korrektur am meisten; siehe Graphentheorie in der Cybersicherheit.
- Maschinelles Lernen. Zentralitätswerte sind gängige Eingabemerkmale für Knoten, und Graph Neural Networks lernen verwandte Größen aus Daten.
11. Eine kurze Geschichte
Das Konzept der Zentralität entstand in der Erforschung kleiner Gruppen. Alex Bavelas führte die Idee 1948 ein, und Experimente in seinem Group Networks Laboratory am MIT, über die er in seinem Aufsatz von 1950 berichtete, verbanden sie damit, wie gut kleine Gruppen Probleme lösten. Gert Sabidussi lieferte 1966 eine mathematische Behandlung der Nähezentralität. Leo Katz' Statusindex erschien 1953 und Phillip Bonacichs Eigenvektormaß 1972. Jac Anthonisse in einem unveröffentlichten Bericht von 1971 und Linton Freeman 1977 definierten die Betweenness unabhängig voneinander, und Freemans Aufsatz von 1979 ordnete Grad, Nähe und Betweenness in den Rahmen ein, der bis heute gelehrt wird. PageRank folgte 1998, und Massimo Franceschets Geschichte von 2011 verfolgt seine Ideen über Bibliometrie, Soziometrie und Ökonometrie zurück bis zu Wassily Leontiefs Input-Output-Modell von 1941 und John Seeleys soziometrischem Index von 1949. Der Algorithmus von Brandes aus dem Jahr 2001 machte die Betweenness auf großen Netzwerken praktikabel.
12. Häufige Fehler
| Fehler | Warum es falsch ist | Abhilfe |
|---|---|---|
| Nach „dem“ wichtigsten Knoten fragen | Im Beispiel benennen vier Maße vier Personen | Zuerst entscheiden, was durch das Netzwerk wandert |
| Eingehende Links mit Rang gleichsetzen | D hat die meisten eingehenden Links und liegt auf Platz vier | PageRank verwenden, wenn die Herkunft eines Links zählt |
| Nähezentralität auf einem unzusammenhängenden Graphen | Zwei isolierte Freiberufler erhielten 1,0 | Harmonische Zentralität verwenden |
| Vergessen, ungerichtete Betweenness zu halbieren | Jedes Paar wird von beiden Enden aus gezählt | Durch 2 teilen |
| Bindungsstärke als Distanz verwenden | Kürzeste-Wege-Maße behandeln eine starke Bindung wie eine lange | Gewichte zuerst in Distanzen umrechnen, zum Beispiel 1 / w |
| Rohwerte zwischen Graphen vergleichen | Betweenness wächst mit der Größe des Graphen | Normieren oder Rangfolgen vergleichen |
| Reine Potenzmethode auf einem bipartiten Graphen | Die Werte können für immer oszillieren | Iterieren mit A + I |
| Sackgassen in PageRank ignorieren | Der Gesamtrang schrumpfte auf 0,403 | Den Rang einer Sackgasse auf alle Seiten verteilen |
13. Glossar
| Begriff | Bedeutung |
|---|---|
| Zentralität | Ein Wert dafür, wie wichtig ein Knoten ist, nach einer festgelegten Definition |
| Gradzentralität | Die Anzahl der Kanten an einem Knoten |
| Nähezentralität | (n - 1) geteilt durch die Summe der Distanzen zu allen anderen Knoten |
| Harmonische Zentralität | Der Mittelwert von 1 / Distanz über alle anderen Knoten |
| Betweenness-Zentralität | Die Summe über alle Paare des Anteils der kürzesten Wege durch einen Knoten |
| Eigenvektorzentralität | Ein Wert proportional zur Summe der Werte der Nachbarn |
| Katz-Zentralität | Eigenvektorzentralität mit einer kleinen Konstante, die für jeden Knoten addiert wird |
| PageRank | Der Anteil der Zeit, den ein zufälliger Surfer auf lange Sicht auf einer Seite verbringt |
| Dämpfungsfaktor | Die Wahrscheinlichkeit d dafür, dass der Surfer einem Link folgt, statt zu springen |
| Sackgasse | Eine Seite ohne ausgehende Links |
| Potenzmethode | Wiederholtes Multiplizieren mit einer Matrix und Neuskalieren, um ihren Haupteigenvektor zu finden |
| Algorithmus von Brandes | Exakte Betweenness in O(VE) auf einem ungewichteten Graphen |
14. Häufig gestellte Fragen
Was ist Zentralität in der Graphentheorie?
Zentralität ist jeder Wert, der angibt, wie wichtig ein Knoten innerhalb eines Graphen ist. Verschiedene Definitionen erfassen verschiedene Arten von Wichtigkeit: die Anzahl direkter Verbindungen, die Distanz zu allen anderen, den Anteil kürzester Wege, die durch den Knoten laufen, oder die Wichtigkeit seiner Nachbarn. Auf demselben Graphen können diese Definitionen verschiedene Knoten benennen.
Was ist der Unterschied zwischen Grad-, Nähe- und Betweenness-Zentralität?
Der Grad zählt die direkten Verbindungen eines Knotens. Die Nähezentralität misst, mit wie wenigen Schritten er alle anderen Knoten erreicht. Die Betweenness misst, wie viele der kürzesten Wege zwischen anderen Paaren durch den Knoten laufen. Eine Person kann wenige Kontakte haben und trotzdem die höchste Betweenness erzielen, wenn sie die einzige Verbindung zwischen zwei Gruppen ist.
Was ist der Unterschied zwischen PageRank und Eigenvektorzentralität?
Beide geben einem Knoten einen Wert, der auf den Werten der mit ihm verbundenen Knoten beruht. PageRank ist für gerichtete Graphen gedacht: Jede Seite teilt ihren Rang auf ihre ausgehenden Links auf, und ein Dämpfungsfaktor fügt einen Zufallssprung hinzu, sodass Seiten ohne eingehende Links und geschlossene Gruppen von Seiten das Verfahren nicht aus dem Tritt bringen können. Eigenvektorzentralität wird vor allem auf zusammenhängenden ungerichteten Graphen verwendet.
Welches Zentralitätsmaß sollte ich verwenden?
Das hängt davon ab, was durch das Netzwerk fließt. Verwenden Sie PageRank für gerichtete Links oder Zitate, Betweenness, wenn etwas auf dem Weg zwischen anderen durch Knoten laufen muss, Nähe- oder harmonische Zentralität, wenn sich etwas von einem Ort aus nach außen ausbreitet, Eigenvektorzentralität, wenn die Qualität der Nachbarn zählt, und den Grad, wenn Sie schnell eine erste Antwort wollen.
Wie wird Betweenness-Zentralität berechnet?
Der Algorithmus von Brandes führt von jedem Knoten aus eine Breitensuche aus, zählt dabei kürzeste Wege, läuft dann vom am weitesten entfernten Knoten zurück und gibt Anteile an die Vorgänger weiter. Er braucht O(VE) Zeit auf einem ungewichteten Graphen. Auf sehr großen Graphen liefert ein Lauf von einer zufälligen Stichprobe von Quellen aus mit anschließender Hochskalierung eine gute Schätzung der Spitzenknoten.
Was ist der Dämpfungsfaktor bei PageRank?
Der Dämpfungsfaktor d ist die Wahrscheinlichkeit, dass der zufällige Surfer einem Link folgt, statt zu einer zufälligen Seite zu springen. Brin und Page berichteten, dass sie ihn meist auf 0,85 setzten. Ein größeres d folgt der Linkstruktur genauer, braucht aber mehr Iterationen und lässt geschlossene Gruppen von Seiten mehr Rang aufsaugen.
15. Quellen
Die oben genannten Algorithmen, Ergebnisse und Zuschreibungen stammen aus diesen Quellen, in chronologischer Reihenfolge.
- Bavelas, A. (1948). "A Mathematical Model for Group Structures." Human Organization 7(3), 16 bis 30.
- Seeley, J. R. (1949). "The Net of Reciprocal Influence: A Problem in Treating Sociometric Data." Canadian Journal of Psychology 3(4), 234 bis 240.
- Bavelas, A. (1950). "Communication Patterns in Task-Oriented Groups." Journal of the Acoustical Society of America 22(6), 725 bis 730.
- Katz, L. (1953). "A New Status Index Derived from Sociometric Analysis." Psychometrika 18(1), 39 bis 43.
- Sabidussi, G. (1966). "The Centrality Index of a Graph." Psychometrika 31(4), 581 bis 603.
- Anthonisse, J. M. (1971). "The Rush in a Directed Graph." Report BN 9/71, Stichting Mathematisch Centrum, Amsterdam.
- Bonacich, P. (1972). "Factoring and Weighting Approaches to Status Scores and Clique Identification." Journal of Mathematical Sociology 2(1), 113 bis 120.
- Freeman, L. C. (1977). "A Set of Measures of Centrality Based on Betweenness." Sociometry 40(1), 35 bis 41.
- Freeman, L. C. (1979). "Centrality in Social Networks: Conceptual Clarification." Social Networks 1(3), 215 bis 239.
- Krackhardt, D. (1990). "Assessing the Political Landscape: Structure, Cognition, and Power in Organizations." Administrative Science Quarterly 35(2), 342 bis 369.
- Brin, S. und Page, L. (1998). "The Anatomy of a Large-Scale Hypertextual Web Search Engine." Computer Networks and ISDN Systems 30(1 bis 7), 107 bis 117.
- Marchiori, M. und Latora, V. (2000). "Harmony in the Small-World." Physica A 285(3 bis 4), 539 bis 546.
- Brandes, U. (2001). "A Faster Algorithm for Betweenness Centrality." Journal of Mathematical Sociology 25(2), 163 bis 177.
- Jeong, H., Mason, S. P., Barabási, A.-L. und Oltvai, Z. N. (2001). "Lethality and Centrality in Protein Networks." Nature 411, 41 bis 42.
- Girvan, M. und Newman, M. E. J. (2002). "Community Structure in Social and Biological Networks." Proceedings of the National Academy of Sciences 99(12), 7821 bis 7826.
- Haveliwala, T. H. und Kamvar, S. D. (2003). "The Second Eigenvalue of the Google Matrix." Technical Report, Stanford University.
- Brandes, U. und Pich, C. (2007). "Centrality Estimation in Large Networks." International Journal of Bifurcation and Chaos 17(7), 2303 bis 2318.
- Franceschet, M. (2011). "PageRank: Standing on the Shoulders of Giants." Communications of the ACM 54(6), 92 bis 101.
- Boldi, P. und Vigna, S. (2014). "Axioms for Centrality." Internet Mathematics 10(3 bis 4), 222 bis 262.
Sehen Sie die Suche hinter den Werten
Nähe- und Betweenness-Zentralität beginnen beide mit einer Breitensuche von jedem Knoten aus. Zeichnen Sie ein kleines Netzwerk im Visualisierer und starten Sie die Suche von zwei verschiedenen Knoten aus, um zu sehen, warum einer alle schneller erreicht.
Visualisierer öffnen