
Inhaltsverzeichnis
- 1. Warum die Biologie voller Graphen ist
- 2. Vier Graphen, vier verschiedene Fragen
- 3. Proteinnetze: Hubs, Brücken und Betweenness
- 4. Robust gegen Unfälle, anfällig für Angriffe
- 5. Module, und warum Clusterung Funktion bedeutet
- 6. Genregulation: Netzwerkmotive
- 7. Genomassemblierung: jede Kante einmal ablaufen
- 8. Sequenzalignment ist ein kürzester Pfad
- 9. Phylogenetik: ein Baum aus astronomisch vielen
- 10. Nahrungsnetze und Aussterbekaskaden
- 11. Konnektome und Epidemien
- 12. Was leicht ist, was schwer ist
- 13. Modellierungsfehler
- 14. Vom Modell zur Praxis
- 15. Häufig gestellte Fragen
- 16. Quellen
1. Warum die Biologie voller Graphen ist
Die Biologie hat den größten Teil ihrer Geschichte damit verbracht, Listen anzulegen. Eine Liste der Gene, eine Liste der Enzyme, eine Liste der Arten in einem See. Die Listen wurden lang und dann vollständig, und ihre Vervollständigung brachte etwas Unbequemes ans Licht: Jedes Teil eines Systems zu kennen, sagt bemerkenswert wenig darüber, was das System tut. Das menschliche Genom war 2003 fertig, und die Zahl der proteinkodierenden Gene lag bei etwa 20.000, nicht weit entfernt von der eines Fadenwurms mit 302 Neuronen. Die Teileliste sollte nie die Erklärung sein.
Was einen Menschen von einem Wurm und eine gesunde Zelle von einer Krebszelle unterscheidet, ist nicht, welche Komponenten existieren, sondern welche Komponenten mit welchen wechselwirken. Dieser Satz ist die Definition eines Graphen. Ein Graph ist eine Menge von Dingen zusammen mit einer Menge von Verbindungen zwischen ihnen, und sonst nichts. Sobald Sie aufschreiben, welche Proteine an welche binden, welches Gen welches einschaltet oder welche Art welche frisst, haben Sie aufgehört, eine Liste zu führen, und angefangen, einen Graphen zu zeichnen, ob Sie das Wort benutzen oder nicht.
Das ist keine Metapher und kein Präsentationsstil. Es ist wichtig, weil Graphen zwei Jahrhunderte Mathematik mitbringen. Sobald eine biologische Frage als Graphenfrage formuliert ist, stehen auf einen Schlag zahlreiche Sätze und Algorithmen zur Verfügung, und Probleme, die nach neuer Biologie auszusehen scheinen, brauchen stattdessen einen vorhandenen Algorithmus. Die Genomassemblierung, der Prozess, der Hunderte Millionen kurzer DNA-Fragmente in ein Chromosom verwandelt, ist ein Weg, der jede Kante eines Graphen genau einmal benutzt. Euler hat dieses Problem 1736 für die Brücken einer preußischen Stadt gelöst, und es ist dasselbe Problem.
Die Gewohnheit ist älter, als die meisten annehmen. Das Wort Graph in diesem Fachsinn prägte der Mathematiker James Joseph Sylvester 1878, in Anlehnung an chemische Strukturdiagramme: Moleküle, gezeichnet als Atome, die durch Bindungen verbunden sind. Die Chemie gab der Graphentheorie einen Teil ihres Vokabulars, und ein Jahrhundert später gab ihr die Molekularbiologie einige ihrer größten Datensätze.
Dieser Leitfaden arbeitet sechs biologische Systeme durch: ein Protein-Interaktionsnetz, ein Genregulationsnetz, ein Genom, das aus Reads assembliert wird, zwei Sequenzen, die aligniert werden, eine Gruppe von Arten, die auf einen Stammbaum gesetzt werden, und ein Nahrungsnetz, das nacheinander Arten verliert. Jedes bleibt klein genug, um es von Hand zu prüfen, und wird mit einem benannten Algorithmus gelöst. Jede Zahl hier stammt aus Code, der tatsächlich ausgeführt wurde, und jedes Ergebnis wurde mit einer zweiten, anderen Methode nachgerechnet, bevor es aufgeschrieben wurde.
2. Vier Graphen, vier verschiedene Fragen
Bevor man etwas baut, lohnt es sich, genau festzulegen, welche Art von Graph jedes biologische System hervorbringt, denn die Art entscheidet, welche Fragen überhaupt gestellt werden können. Vier Unterscheidungen leisten fast die ganze Arbeit.
Gerichtet oder ungerichtet. Wenn zwei Proteine binden, ist die Beziehung symmetrisch: „A bindet B“ und „B bindet A“ sind dieselbe Tatsache, also sind Protein-Interaktionsnetze ungerichtet. Wenn ein Transkriptionsfaktor ein Gen einschaltet, verläuft die Beziehung in eine Richtung, also sind Genregulationsnetze gerichtet. Das ist keine Buchhaltung. Ungerichtete Graphen haben Zusammenhangskomponenten; gerichtete Graphen haben Erreichbarkeit, Zyklen und Rückkopplung, und Rückkopplung ist der Kern der Regulation. Zu fragen, ob ein Gennetz einen Zyklus enthält, heißt zu fragen, ob es eine Rückkopplungsschleife enthält, und die Antwort verändert die Biologie.
Gewichtet oder ungewichtet. Eine Kante in einem Nahrungsnetz kann einfach existieren, oder sie kann die Biomasse tragen, die an ihr entlangfließt. Sequenzähnlichkeitsgraphen tragen an jeder Kante einen Score. Gewichte erlauben es, nach dem besten Weg zu fragen statt nur nach irgendeinem, und genau das macht das Alignment in Abschnitt 8 zu einem Kürzeste-Wege-Problem.
Statisch oder dynamisch. Fast jedes Netz in diesem Artikel ist gezeichnet, als wäre es fest. Echte Zellen sind es nicht. Eine Interaktion, die in einer Leberzelle existiert, gibt es in einem Neuron vielleicht nicht, und Interaktionen tauchen im Laufe des Zellzyklus auf und verschwinden wieder. Ein zeitlich gemitteltes Aggregat so zu behandeln, als wären alle seine Kanten gleichzeitig vorhanden, ist der häufigste Modellierungsfehler auf diesem Gebiet, und Abschnitt 13 kommt darauf zurück.
Bipartit oder nicht. Manche biologischen Daten haben zwei Arten von Knoten mit Kanten nur zwischen den Arten: Wirkstoffe und ihre Zielmoleküle, Wirte und ihre Parasiten, Gene und die Krankheiten, mit denen sie assoziiert sind. Bipartite Graphen bringen eigene Algorithmen mit, vor allem das Matching, und so werden Screens zur Wirkstoff-Umwidmung oft formuliert.
Legen Sie diese vier richtig fest, und der Rest ergibt sich. Legen Sie sie falsch fest, und Sie berechnen eine Zahl, die auf eine Weise bedeutungslos ist, vor der Sie keine Software warnen wird.
3. Proteinnetze: Hubs, Brücken und Betweenness
Ein Protein-Interaktionsnetz, kurz PPI-Netz, hat einen Knoten pro Protein und eine ungerichtete Kante überall dort, wo zwei Proteine physisch binden. Große Versionen entstehen durch Yeast-Two-Hybrid-Screens oder durch Affinitätsreinigung mit anschließender Massenspektrometrie, und die veröffentlichten Netze für Hefe und Mensch umfassen Zehntausende Kanten. Statt auf etwas Riesiges zu verweisen, verwenden wir ein kleines: zwölf Proteine und achtzehn Interaktionen, klein genug, dass sich jede Aussage unten durch Abzählen prüfen lässt.
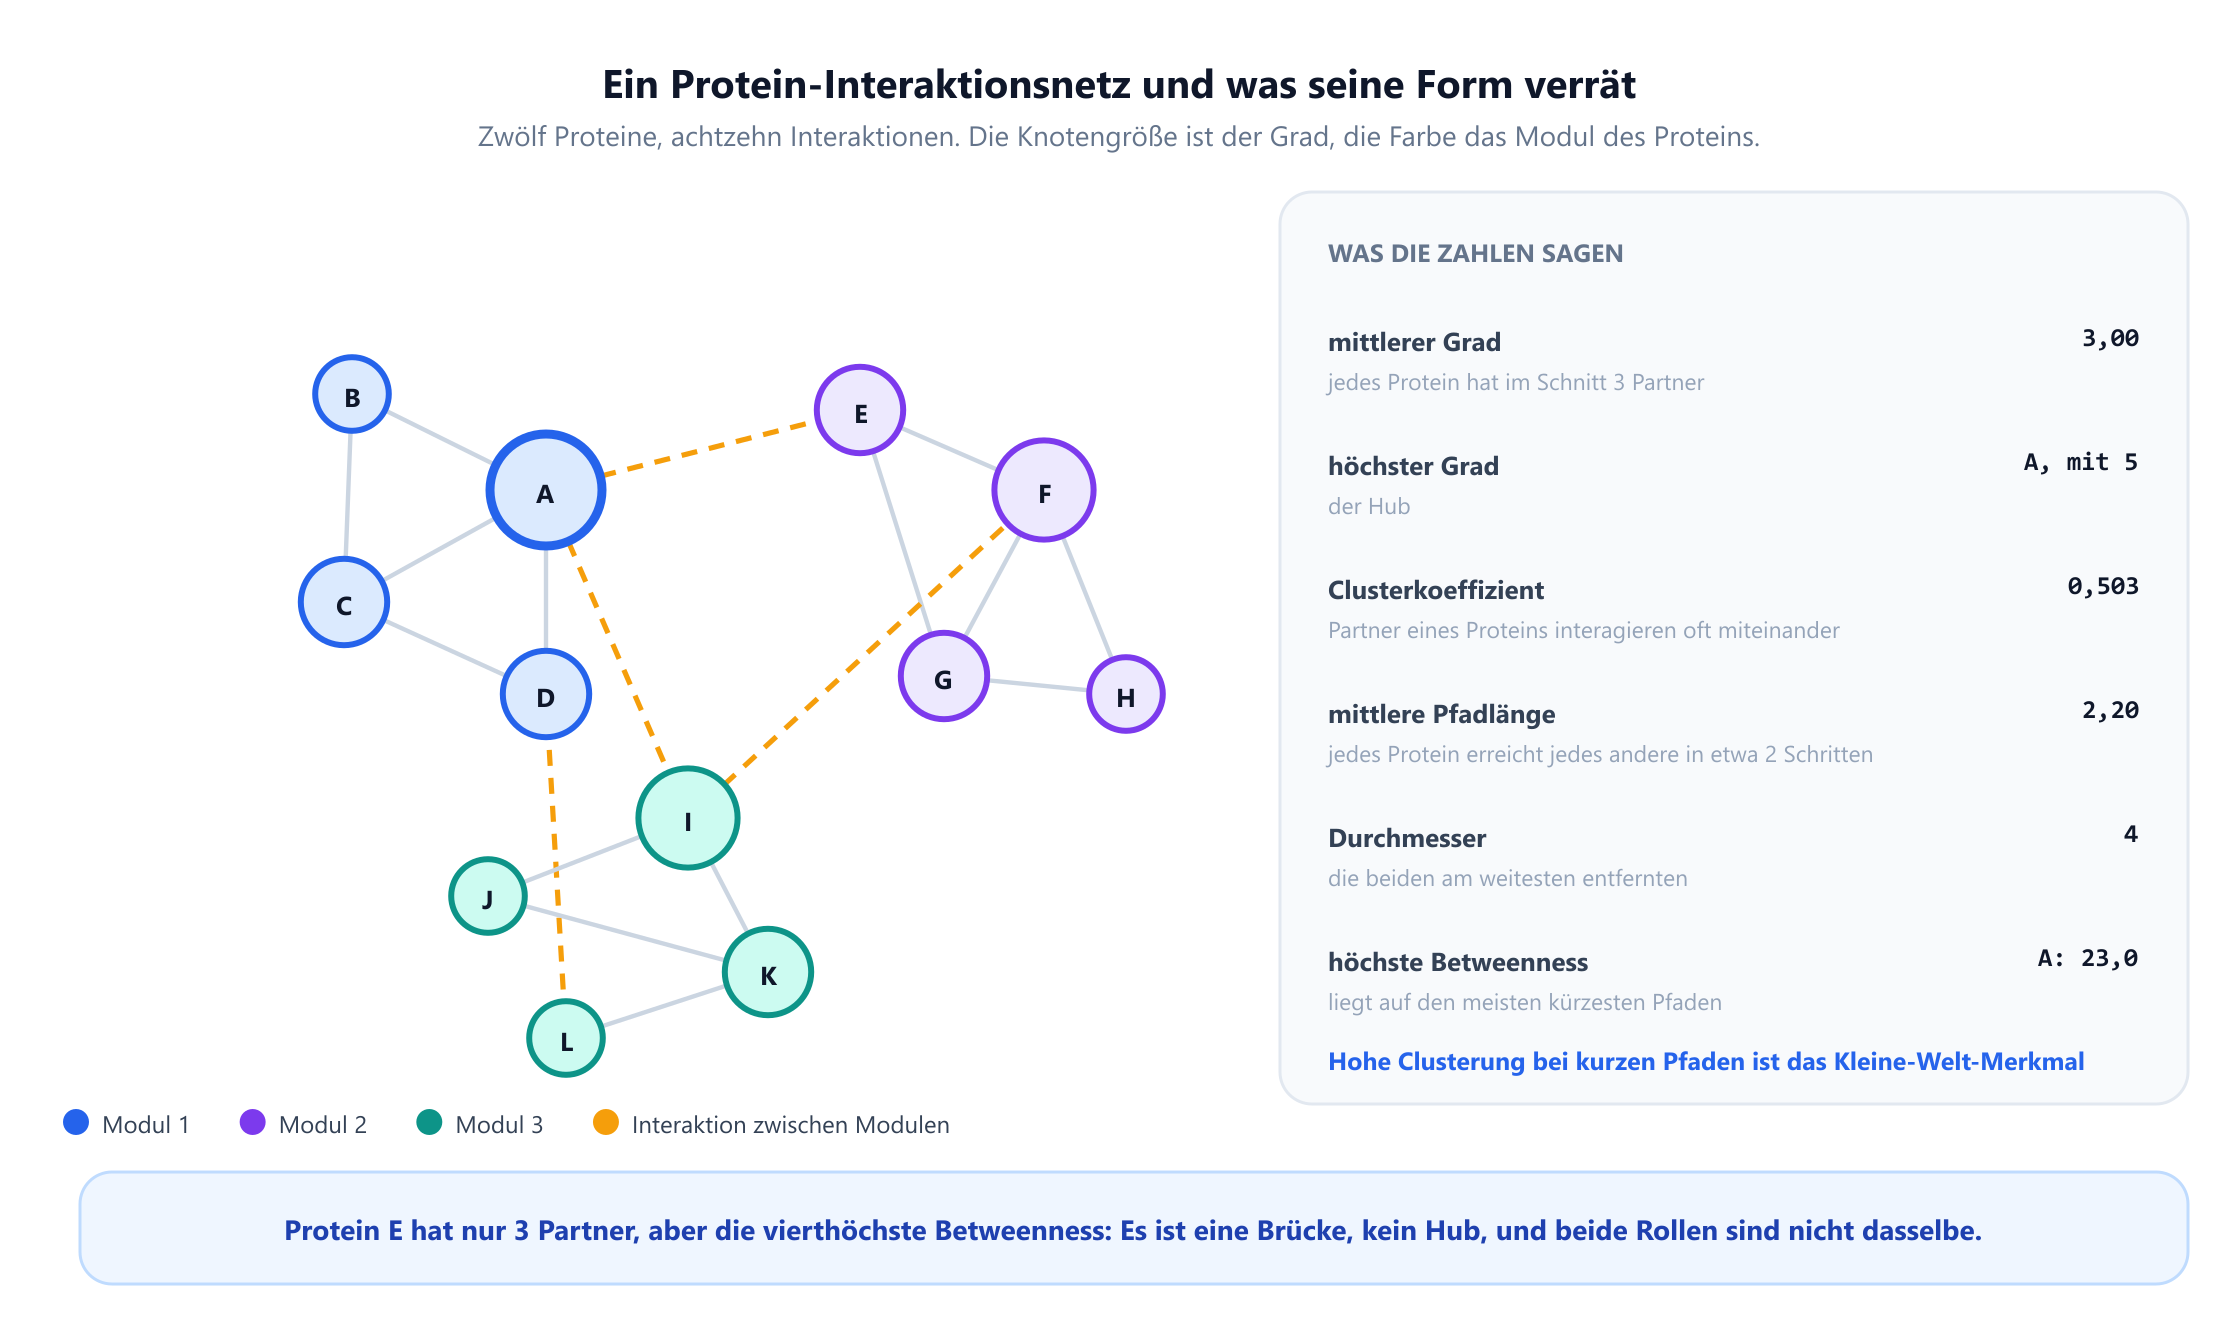
Als Erstes misst man den Grad, die Zahl der Partner eines Proteins. Hier reichen die Grade von A:5 über F und I mit 4 und eine Gruppe von fünf mit 3 bis zu einem Rest von vier mit 2, im Mittel 3,0. In echten PPI-Netzen ist diese Verteilung weit ungleicher: Die meisten Proteine haben eine Handvoll Partner, eine kleine Minderheit hat Hunderte. Netze dieser Form heißen skalenfrei, ein Begriff, den Barabasi und Oltvai in ihrem Überblicksartikel von 2004 populär machten, und die Minderheit mit hohem Grad sind die Hubs.
Hubs sind aus einem Grund wichtig, der experimentell belegt und nicht nur theoretisch begründet wurde. 2001 verglichen Jeong, Mason, Barabasi und Oltvai das PPI-Netz der Hefe mit der Deletionsbibliothek der Hefe, in der jedes Gen nacheinander ausgeschaltet und die resultierende Zelle als lebensfähig oder tot bewertet wurde. Proteine mit mehr Interaktionspartnern waren deutlich häufiger essenziell. Der Artikel heißt Lethality and centrality in protein networks, und die dort berichtete Korrelation ist der Grund, warum der Grad das Erste wurde, was man auf einem biologischen Netz berechnet.
Der Grad ist nicht die einzige Form von Wichtigkeit, und genau hier verdient sich ein kleines Beispiel seinen Platz. Betrachten Sie Protein E. Es hat drei Partner und fällt in jeder nach Grad sortierten Liste nicht auf. Berechnen Sie nun die Betweenness-Zentralität, die über alle Proteinpaare zählt, welcher Anteil der kürzesten Wege zwischen ihnen durch einen bestimmten Knoten verläuft. Freeman führte das Maß 1977 für soziale Netze ein. Auf diesem Graphen lautet die Betweenness-Rangfolge A mit 23,0, I mit 19,8, F mit 12,2 und dann E mit 9,2, vor mehreren Proteinen mit mehr Partnern.
E schneidet wegen seiner Lage gut ab, nicht wegen der Zahl seiner Nachbarn. Es ist der Eingang zum zweiten Modul, also muss der Verkehr zwischen dem ersten und dem zweiten Modul durch E hindurch. In der Sprache der Netze ist E eine Brücke und kein Hub, und die Unterscheidung hat eine biologische Lesart: Brückenproteine sind Kandidaten für Crosstalk zwischen Signalwegen, und das Entfernen eines solchen Proteins löscht weniger eine Funktion, als dass es zwei Funktionen voneinander trennt. Eine Rangfolge allein nach Grad würde es nie zutage fördern.
Zwei weitere Zahlen beschreiben den ganzen Graphen statt eines einzelnen Knotens. Die mittlere kürzeste Pfadlänge beträgt 2,197, und der Durchmesser, der längste aller kürzesten Wege, beträgt 4: Jedes Protein erreicht jedes andere in höchstens vier Schritten. Echte PPI-Netze verhalten sich in weit größerem Maßstab genauso, mit Tausenden Proteinen und einer charakteristischen Pfadlänge um 5. Das ist die Kleine-Welt-Eigenschaft, die Watts und Strogatz 1998 formalisierten, und in einer Zelle hat sie eine handfeste Folge. Eine Störung an beliebiger Stelle ist nur wenige Schritte von überall entfernt, und das ist ein großer Teil der Erklärung, warum ein auf ein einziges Protein zielendes Medikament so zuverlässig Wirkungen hervorruft, die niemand geplant hat.
4. Robust gegen Unfälle, anfällig für Angriffe
Das meistzitierte Ergebnis der Netzwerkbiologie handelt von keinem bestimmten Protein. Es handelt davon, was passiert, wenn man anfängt, sie zu löschen, und es wurde von Albert, Jeong und Barabasi im Jahr 2000 in Nature unter dem Titel Error and attack tolerance of complex networks veröffentlicht.
Das Experiment ist leicht zu beschreiben. Man nimmt ein Netz, entfernt Knoten und misst nach jeder Entfernung die Größe der größten verbleibenden Komponente. Das geschieht zweimal: einmal durch gleichmäßig zufälliges Entfernen, was Unfälle und Mutationen modelliert, und einmal durch Entfernen in absteigender Gradreihenfolge, was einen gezielten Angriff modelliert. Dann vergleicht man die Kurven.
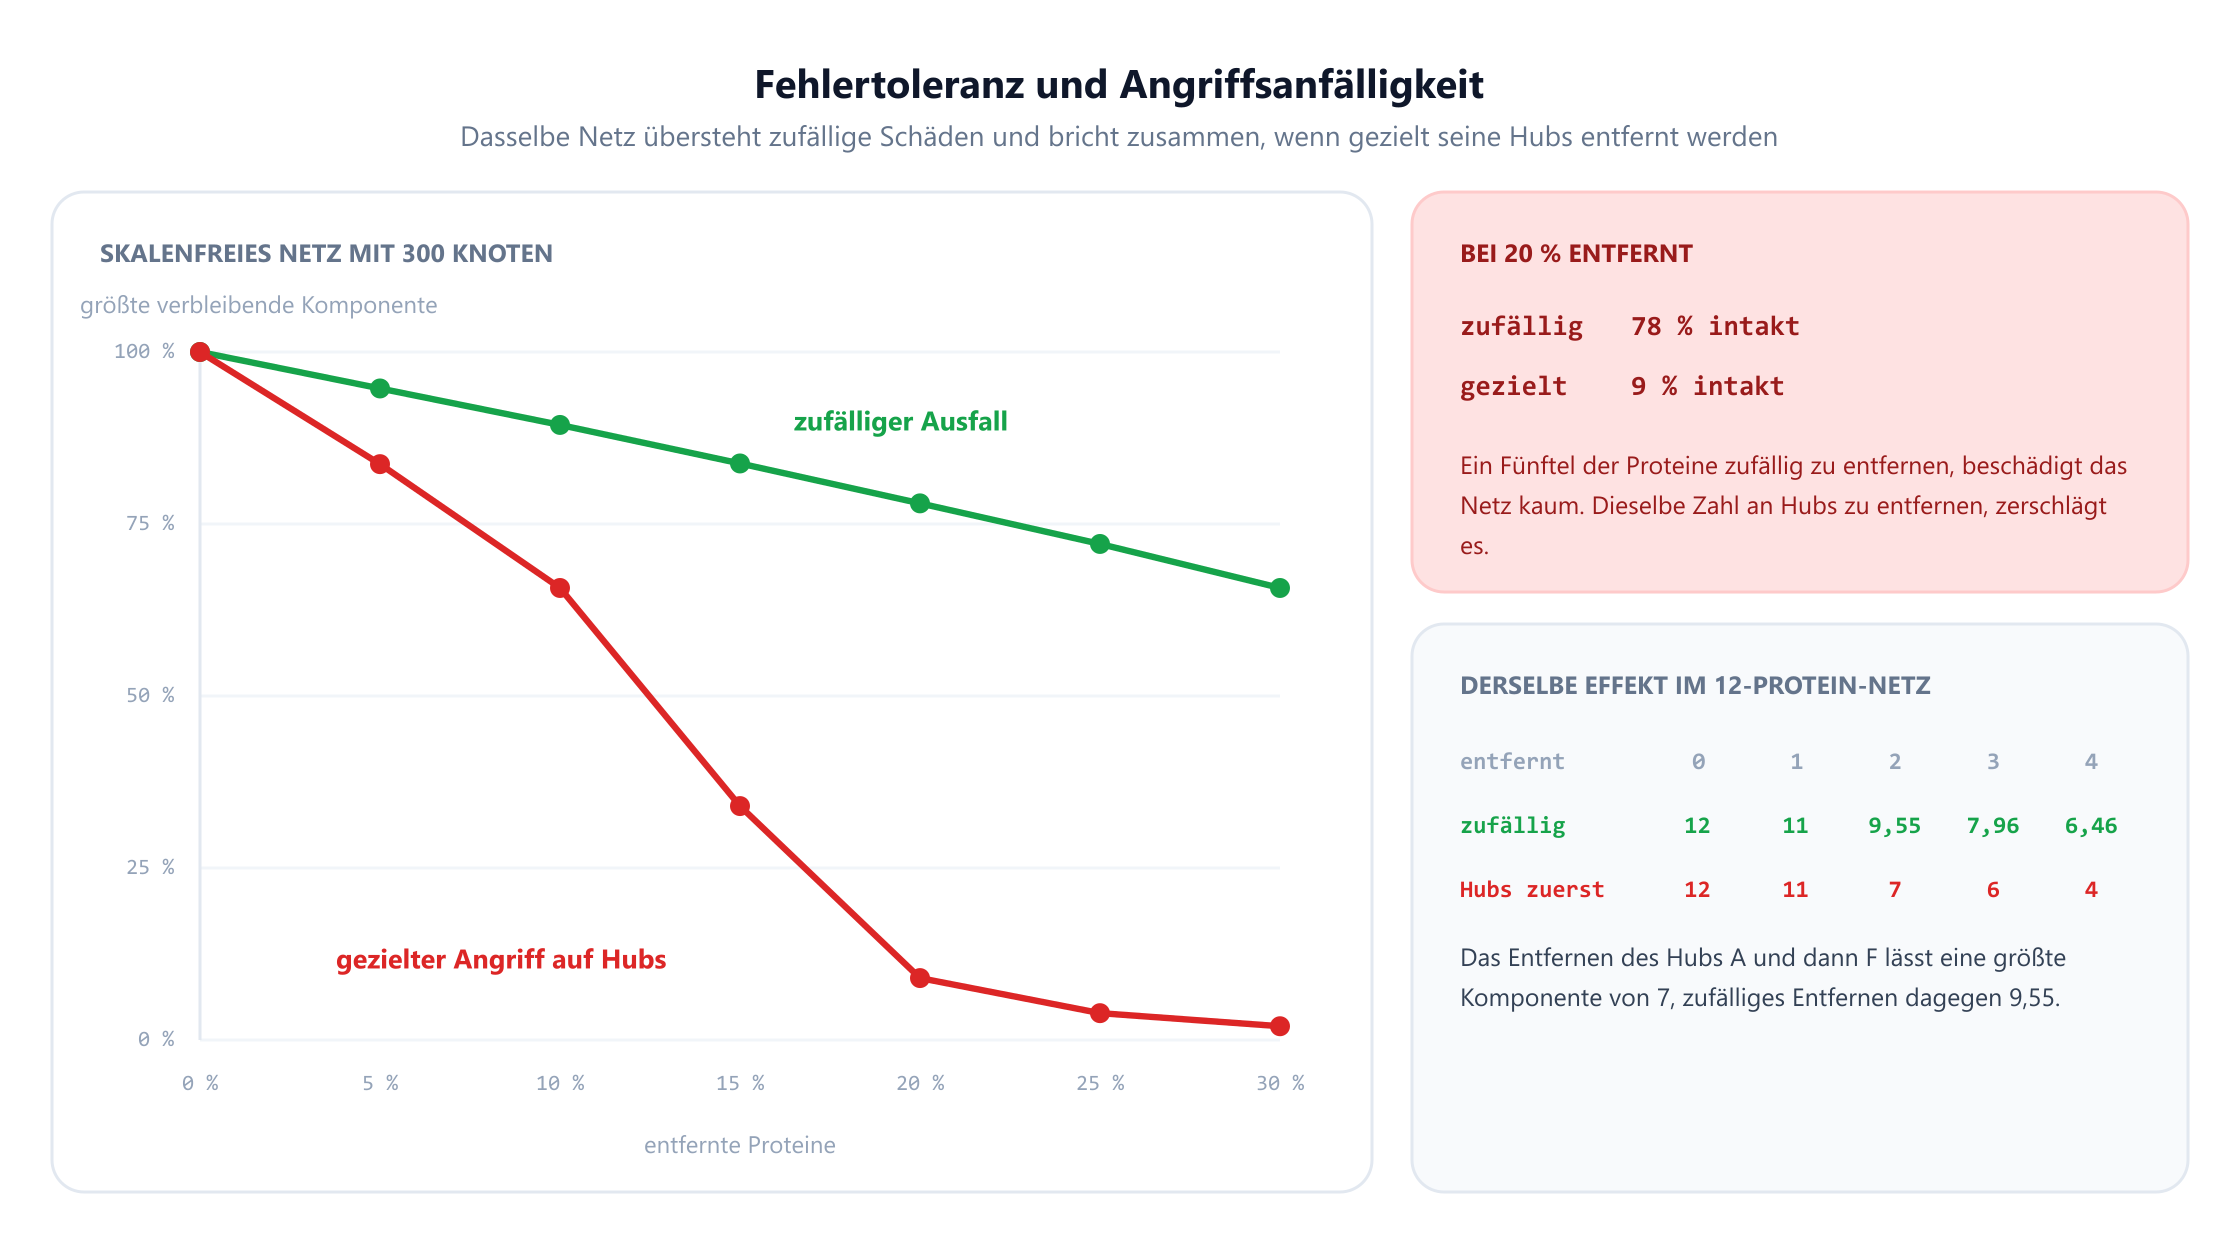
Auf einem skalenfreien Netz mit 300 Knoten, gewachsen durch bevorzugte Anlagerung, lässt das zufällige Entfernen von 20 % der Knoten 78 % des Netzes noch in einem Stück verbunden. Das Entfernen der 20 % mit dem höchsten Grad lässt 9 % übrig. Das Netz, das den ersten Angriff abschüttelte, wurde vom zweiten zerstört, und der einzige Unterschied zwischen beiden war, welche Knoten ausgewählt wurden.
Das Netz aus zwölf Proteinen zeigt dieselbe Asymmetrie in einem Maßstab, den Sie von Hand prüfen können. Zufälliges Entfernen, gemittelt über jede mögliche Auswahl, lässt größte Komponenten von 12, 11, 9,55, 7,96 und 6,46 übrig, während die Zahl der Entfernungen von null auf vier steigt. Das Entfernen der Hubs in absteigender Gradreihenfolge, hier also A, dann F, dann I, dann C, lässt 12, 11, 7, 6 und 4 übrig. Zwei gut gewählte Löschungen kosten mehr als vier zufällige.
Die Erklärung liegt in der Gradverteilung. In einem skalenfreien Netz hat die überwältigende Mehrheit der Knoten einen niedrigen Grad, also trifft eine zufällige Löschung fast sicher einen Randknoten, dessen Verlust niemanden abtrennt. Die seltenen Hubs halten alles zusammen, und das Löschen eines Hubs entfernt viele Kanten auf einmal. Robustheit gegen zufällige Schäden und Anfälligkeit für gezielte Schäden sind nicht zwei gegensätzliche Eigenschaften. Sie sind eine Eigenschaft, aus zwei Richtungen betrachtet.
Die biologischen Lesarten gehen in beide Richtungen. Auf der fragilen Seite erklärt das, warum Hub-Proteine überdurchschnittlich oft essenziell sind und warum die Onkologie zwei Jahrzehnte damit verbracht hat, die Hubs zu identifizieren, von denen ein Tumor abhängt. Auf der robusten Seite erklärt es, warum Organismen eine enorme Last zufälliger Mutationen ohne sichtbare Folgen verkraften und warum Knockouts einzelner Gene so oft gar keinen Phänotyp zeigen. Diese letzte Beobachtung frustrierte eine ganze Generation von Genetikern: Die meisten Gene sind nicht tragend, und die tragenden lassen sich an ihrer Position im Graphen erkennen.
5. Module, und warum Clusterung Funktion bedeutet
Betrachten Sie das Netz aus zwölf Proteinen noch einmal, und Sie sehen mit bloßem Auge drei Gruppen. Die Proteine A bis D sind eng miteinander verknüpft, E bis H bilden einen zweiten Cluster, I bis L einen dritten, und nur vier Kanten verlaufen zwischen den Gruppen. Hinter diesem visuellen Eindruck steht eine Zahl.
Der Clusterkoeffizient eines Knotens stellt eine bestimmte Frage: Welcher Anteil aller Paare meiner Nachbarn ist selbst verbunden? Hat ein Protein vier Partner, gibt es unter ihnen sechs Paare, und der Koeffizient ist der Anteil dieser sechs Paare, die aneinander binden. Gemittelt über alle zwölf Proteine erreicht dieses Netz 0,503, das heißt, etwa die Hälfte aller Dreiecke, die sich schließen könnten, schließt sich auch. Ein Zufallsgraph mit gleich vielen Knoten und Kanten kommt auf etwa 0,23. Echte PPI-Netze sind ähnlich stark geclustert, ebenso metabolische Netze, neuronale Netze und Nahrungsnetze.
Hohe Clusterung gibt dem Wort Modul erst seine Bedeutung. Proteine, die alle aneinander binden, erledigen meist gemeinsam eine Aufgabe: Sie bilden einen Komplex, gehören zu einem Signalweg oder werden zur selben Zeit an denselben Ort rekrutiert. Das ist die nützlichste Schlussfolgerung der angewandten Netzwerkbiologie, weil man damit ein unbekanntes Protein über seine Nachbarn annotieren kann. Sitzt ein Protein unbekannter Funktion in einem Cluster, dessen andere Mitglieder alle DNA-Reparatur betreiben, ist DNA-Reparatur die erste Hypothese, die man prüft. Ganze Pipelines beruhen auf dieser Idee, und sie sind Algorithmen zur Community-Erkennung mit biologischen Namen.
Eine Warnung gehört hierher. Ein von einem Algorithmus gefundenes Modul ist eine Hypothese, keine Entdeckung. Der Algorithmus zerlegt alles, was man ihm gibt, und liefert aus Zufallsdaten genauso bereitwillig Module.
6. Genregulation: Netzwerkmotive
Genregulationsnetze sind gerichtet. Ein Bogen von Gen X zu Gen Y bedeutet, dass das von X erzeugte Protein an den Promotor von Y bindet und verändert, wie viel Y hergestellt wird. Weil die Bögen eine Richtung haben, sind die interessanten Strukturen Flussmuster statt dichter Nachbarschaften, und 2002 veränderten zwei Arbeiten aus der Gruppe von Uri Alon, wie man sie liest.
Die Idee ist folgende. Man nimmt einen kleinen Teilgraphen, etwa drei Gene in einem bestimmten Muster verschaltet, und zählt, wie oft er im echten Netz vorkommt. Diese Zahl allein bedeutet nichts, weil manche Muster schon allein deshalb häufig sind, weil jedes Gen eine bestimmte Zahl von Bögen hat. Also erzeugt man viele randomisierte Netze mit exakt denselben Graden, indem man wiederholt die Endpunkte von Bogenpaaren vertauscht, und zählt das Muster in jedem. Liegt die echte Zahl weit draußen im Randbereich dieser Verteilung, ist das Muster ein Netzwerkmotiv: Es tritt häufiger auf, als die Grade allein erklären können, was darauf hinweist, dass die Selektion es dort platziert hat.
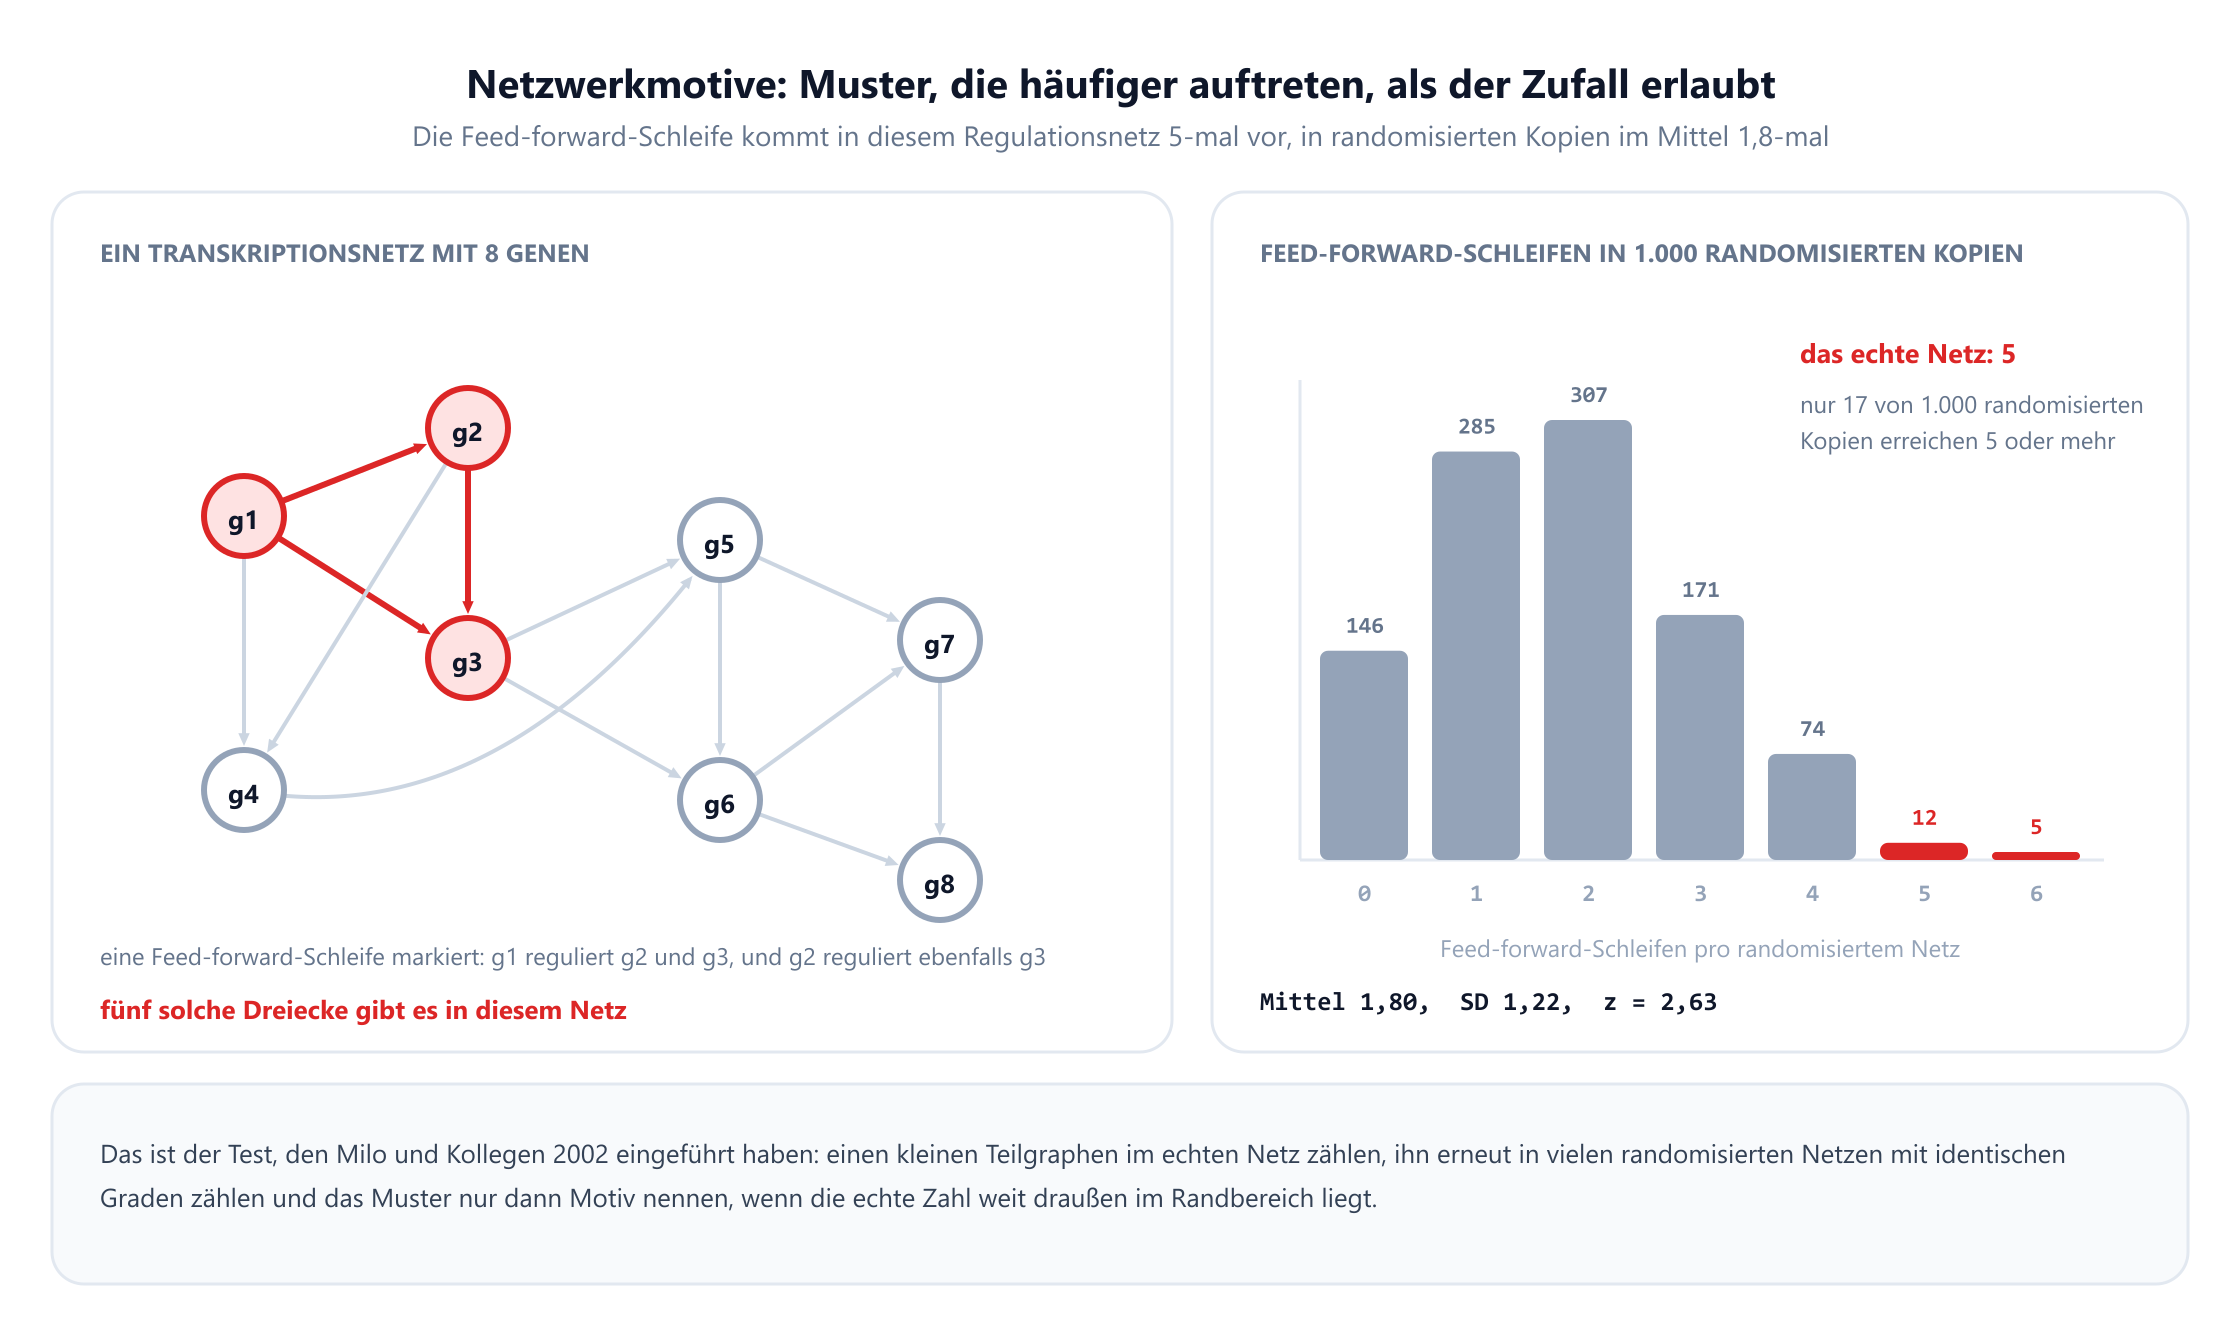
Das Muster in der Abbildung ist die Feed-forward-Schleife: Gen X reguliert Y, X reguliert Z auch direkt, und Y reguliert ebenfalls Z. Im Netz aus acht Genen kommt sie fünfmal vor. Über 1.000 gradgleiche Randomisierungen lag der Mittelwert bei 1,80 mit einer Standardabweichung von 1,22, was einen z-Wert von 2,63 ergibt, und nur 17 der 1.000 randomisierten Netze enthielten fünf oder mehr. Bei einem so kleinen Netz ist das eher ein Hinweis als ein Beweis; im echten E. coli-Transkriptionsnetz fanden Shen-Orr, Milo und Alon dasselbe Muster mit z-Werten im zweistelligen Bereich, und das ist kein Grenzfall.
Was die Feed-forward-Schleife interessant macht, ist, dass sich ihre Funktion herleiten lässt, statt geraten zu werden. In der kohärenten Variante, bei der X sowohl Y als auch Z aktiviert und Y ebenfalls Z aktiviert, schaltet Gen Z erst ein, wenn X und Y beide vorhanden sind. Da Y nach dem Auftreten von X Zeit braucht, um sich anzureichern, ignoriert Z kurze Pulse von X und reagiert nur auf anhaltende Signale. Das Motiv ist ein Persistenzdetektor, ein Rauschfilter aus drei Genen. Ändert man die Vorzeichen, erhält man stattdessen einen Pulsgenerator oder eine beschleunigte Antwort. Die Verschaltung ist der Mechanismus.
Milo und Kollegen stellten fest, dass verschiedene Netzarten durch verschiedene Motive gekennzeichnet sind: Transkriptionsnetze sind reich an Feed-forward-Schleifen, neuronale Netze an einem anderen Satz, Nahrungsnetze wiederum an einem anderen. Sie argumentierten, dass Motive die elementaren Schaltkreise sind, aus denen das Netz aufgebaut ist, und diese Sichtweise hat sich gehalten, sowohl weil die Statistik überprüfbar ist als auch weil die Schaltkreise etwas tun.
Ein methodischer Punkt reicht weit über die Biologie hinaus. Die Randomisierung muss die Grade erhalten. Vergleicht man mit einem gewöhnlichen Zufallsgraphen, sieht fast alles wie ein Motiv aus, weil echte Netze Hubs haben und zufällige nicht, und schon die Hubs allein erzeugen einen Überschuss jedes Musters aus drei Knoten. Das Nullmodell falsch zu wählen, ist die übliche Art, wie diese Analyse scheitert.
7. Genomassemblierung: jede Kante einmal ablaufen
Sequenziermaschinen können kein Chromosom lesen. Sie lesen kurze Fragmente, von etwa 100 Basen auf einem Short-Read-Gerät bis zu Zehntausenden auf einem Long-Read-Gerät, entnommen an zufälligen Positionen aus vielen Kopien des Genoms. Ein menschliches Genom kommt als Hunderte Millionen solcher Fragmente an, ohne jede Angabe, woher eines davon stammt. Die Assemblierung ist das Problem, sie wieder zusammenzusetzen, und die moderne Lösung ist ein Graph.
Die Konstruktion stammt von Pevzner, Tang und Waterman aus dem Jahr 2001, und sie ist elegant genug, um sie in zwei Sätzen zu beschreiben. Man zerlegt jeden Read in überlappende Teilzeichenketten der Länge k, sogenannte k-mere. Dann baut man einen Graphen, in dem jedes k-mer eine Kante ist, die vom Knoten, der aus seinen ersten k-1 Buchstaben besteht, zum Knoten aus seinen letzten k-1 Buchstaben verläuft. Die Sequenz zu rekonstruieren heißt nun, einen Weg zu finden, der jede Kante genau einmal benutzt, und das ist ein Eulerpfad.
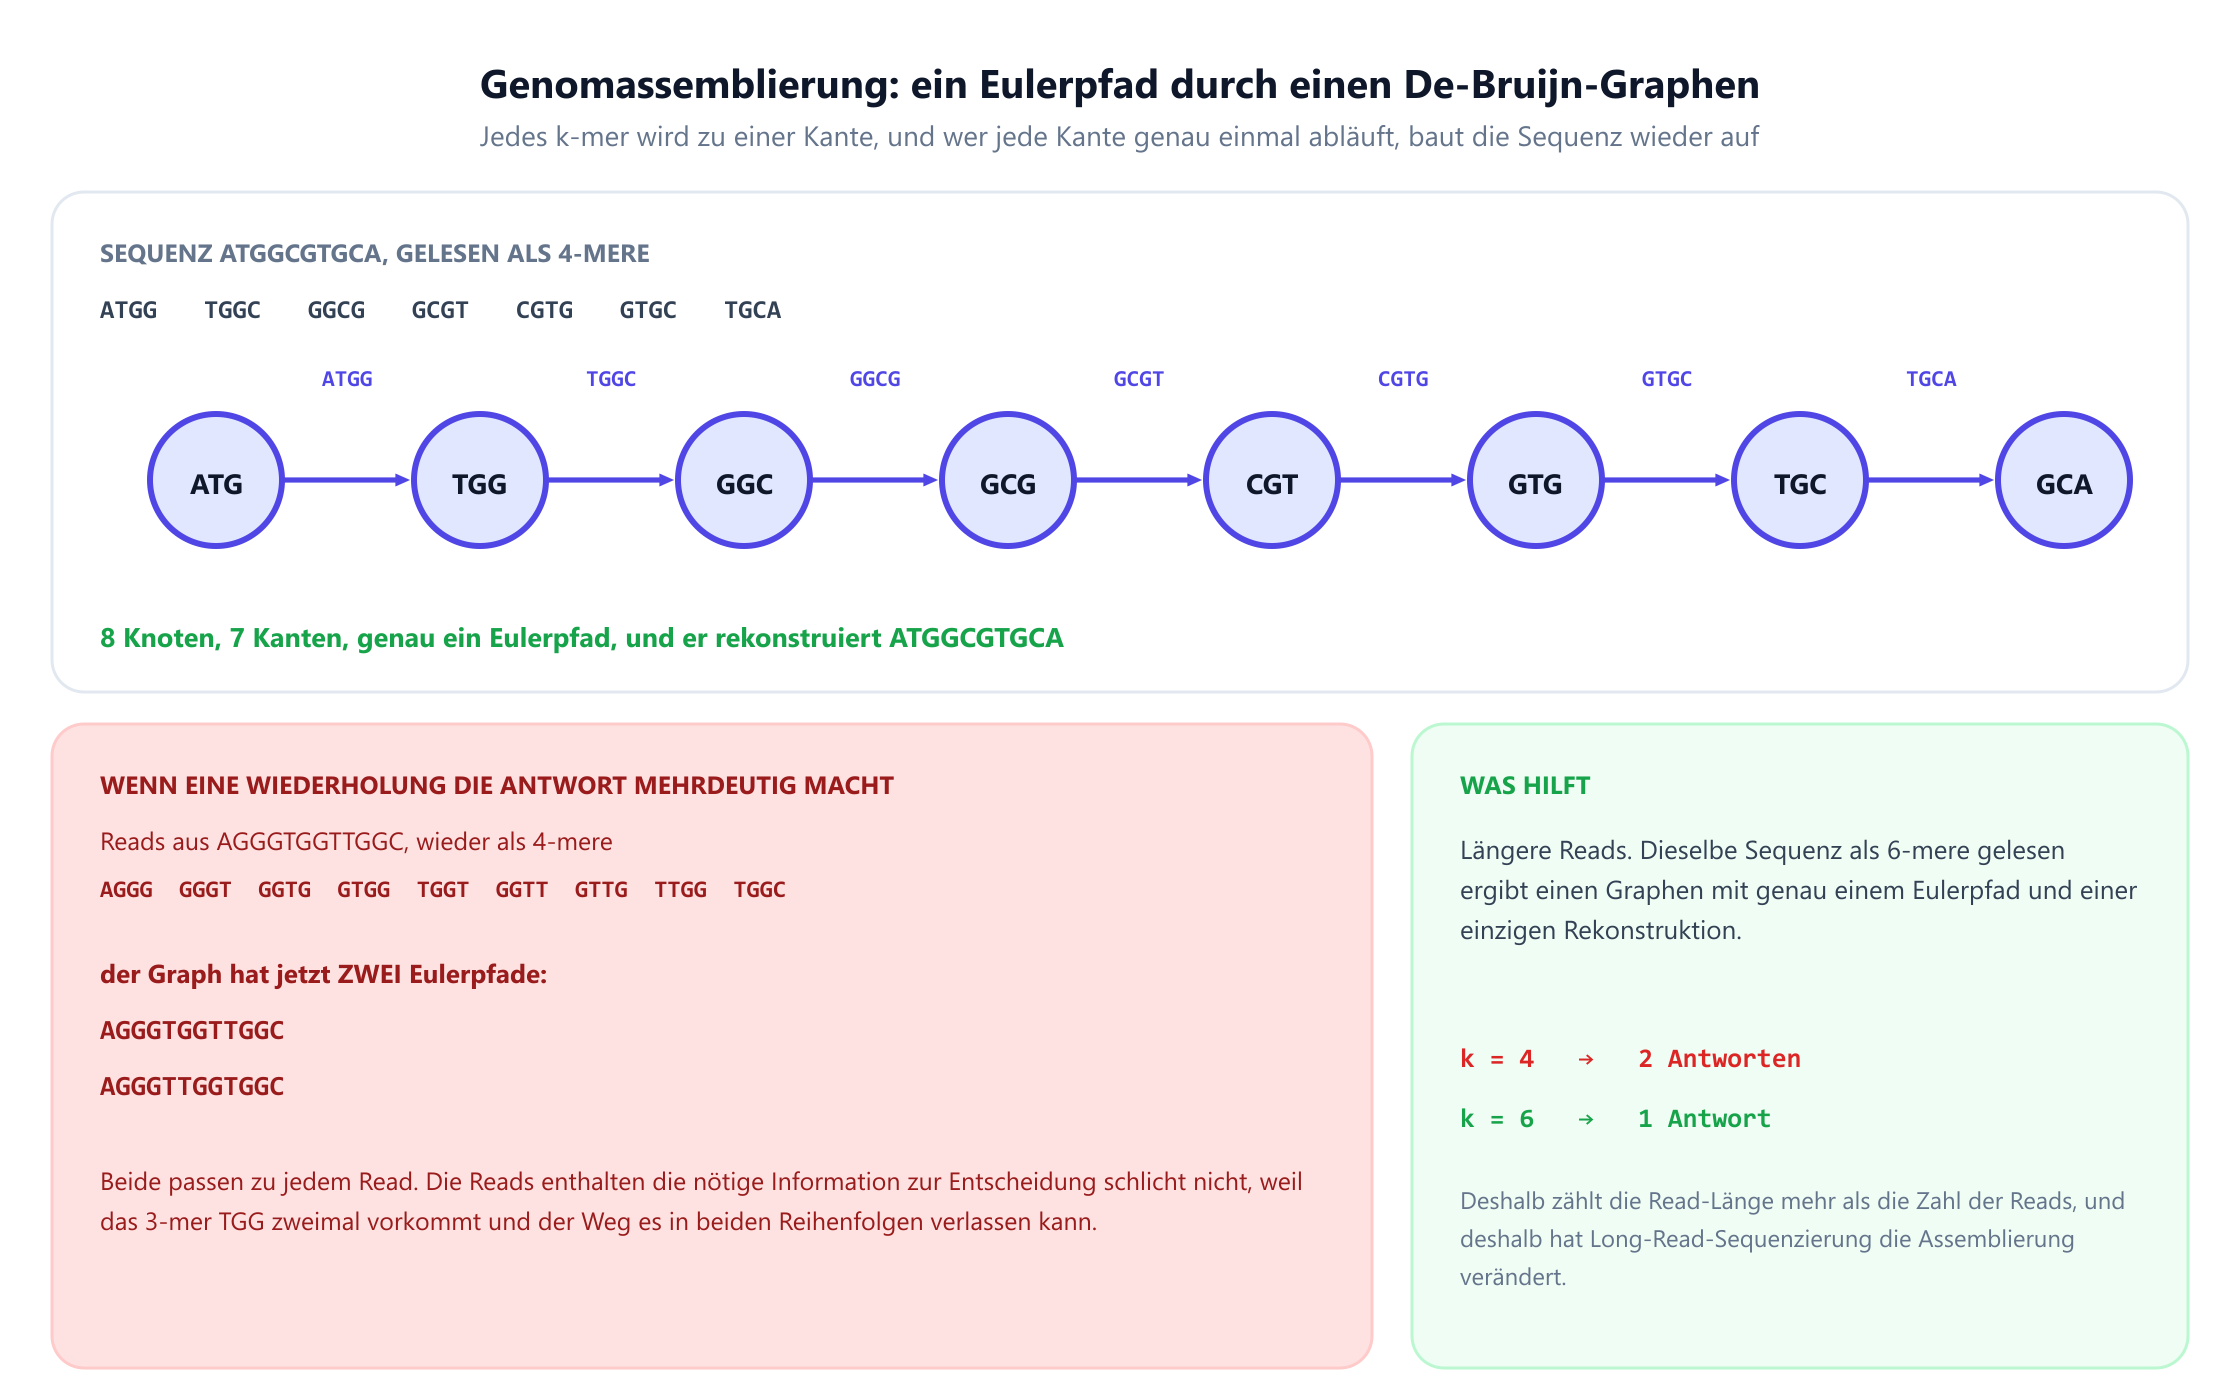
Nehmen Sie die Sequenz ATGGCGTGCA und lesen Sie sie als 4-mere. Das ergibt sieben k-mere, einen Graphen mit 8 Knoten und 7 Kanten und genau einen Eulerpfad, der die ursprüngliche Sequenz wieder ausbuchstabiert. Die Assemblierung gelang, und sie gelang, weil der Graph eine eindeutige Antwort hatte.
Nehmen Sie nun AGGGTGGTTGGC, wieder als 4-mere. Der Graph hat zwei Eulerpfade, die AGGGTGGTTGGC und AGGGTTGGTGGC ergeben. Beide passen zu jedem beobachteten Read. Das ist kein Versagen des Algorithmus, und kein besserer Algorithmus kann es beheben: Das 3-mer TGG kommt zweimal vor, der Weg erreicht diesen Knoten mehr als einmal, und die Reads enthalten keine Information darüber, in welche Richtung er ihn beim ersten Mal verlassen soll. Die Mehrdeutigkeit steckt in den Daten.
Was sie auflöst, sind längere Reads. Dieselbe Sequenz als 6-mere gelesen ergibt einen Graphen mit genau einem Eulerpfad und einer einzigen Rekonstruktion. Das ist der Grund, warum die Sequenzierbranche fünfzehn Jahre lang der Read-Länge statt der Read-Zahl nachgejagt ist, und der Grund, warum das menschliche Genom erst 2022 für vollständig erklärt wurde, lückenlos bis zu den Telomeren, mehr als zwanzig Jahre nach dem ersten Entwurf. Die fehlenden Stücke waren Wiederholungen, und Wiederholungen sind genau die Strukturen, die einen Eulerweg mehrdeutig machen.
Hier steckt ein hübsches Stück Algorithmengeschichte. Einen Eulerpfad zu finden ist leicht: lineare Zeit, mit einer Existenzbedingung, die seit Euler bekannt ist. Die naheliegend wirkende Alternative, ein Graph, in dem jeder Read ein Knoten ist und überlappende Reads verbunden werden, verlangt einen Weg, der jeden Knoten einmal besucht, und das ist ein Hamiltonpfad und NP-vollständig. Zwei Formulierungen derselben biologischen Aufgabe, eine handhabbar und eine hoffnungslos, getrennt nur durch die Entscheidung, die Reads zu Kanten statt zu Knoten zu machen.
8. Sequenzalignment ist ein kürzester Pfad
Zwei Sequenzen zu vergleichen, ist die am häufigsten ausgeführte Berechnung der Biologie. Jede BLAST-Abfrage tut es, jeder Read-Mapper tut es, und jede Behauptung, zwei Gene seien homolog, beruht darauf. Der Standardalgorithmus stammt von Needleman und Wunsch, wurde 1970 veröffentlicht und wird überall als dynamische Programmierung über einer Matrix gelehrt. Es lohnt sich zu sehen, dass die Matrix ein Graph ist.
Bauen Sie ein Gitter mit einem Knoten für jedes Positionspaar (i, j), das bedeutet „die ersten i Buchstaben der ersten Sequenz sind gegen die ersten j Buchstaben der zweiten aligniert“. Von jedem Knoten gehen drei Bögen aus: nach rechts für einen Buchstaben der zweiten Sequenz gegen eine Lücke, nach unten für einen Buchstaben der ersten Sequenz gegen eine Lücke und diagonal für das Alignieren der beiden Buchstaben. Jeder Bogen erhält Kosten, null für eine übereinstimmende Diagonale und sonst eins. Das beste Alignment ist nun der billigste Pfad von der oberen linken zur unteren rechten Ecke, und jeder Kürzeste-Wege-Algorithmus findet ihn.
Das Alignieren von GATTACA gegen GCATGCU baut einen Gittergraphen mit 64 Knoten und 161 Bögen. Needleman-Wunsch liefert eine Editierdistanz von 4. Eine Kürzeste-Wege-Suche über diesem Graphen, ganz ohne Tabelle der dynamischen Programmierung, liefert ebenfalls 4. Sie stimmen überein, weil sie dieselbe Berechnung sind: Das Gitter ist azyklisch, also heißt die Zellen der Reihe nach zu füllen genau, die Bögen in topologischer Reihenfolge zu relaxieren.
Es als Graphen zu sehen, ist kein Partytrick. Es erklärt, warum der Algorithmus für lokales Alignment von Smith und Waterman aus dem Jahr 1981 funktioniert: Einem Pfad zu erlauben, überall neu zu beginnen, heißt, einen kostenlosen Bogen von der Quelle zu jedem Knoten hinzuzufügen. Es erklärt affine Lückenstrafen, die drei Gitterebenen statt einer brauchen, weil sich der Zustand merken muss, ob eine Lücke bereits geöffnet ist. Und es erklärt, warum ein Alignment das Produkt der beiden Sequenzlängen kostet, denn das ist die Größe des Graphen, weshalb schnelle Aligner den größten Teil davon gar nicht erst aufbauen.
9. Phylogenetik: ein Baum aus astronomisch vielen
Ein phylogenetischer Baum ist ein Graph ohne Zyklen: Die Blätter sind die beobachteten Arten, die inneren Knoten Vorfahren, die man nicht beobachtet hat, und die Kantenlängen messen die evolutionäre Divergenz. Einen solchen Baum aus heutigen Sequenzen zu rekonstruieren, ist das zentrale Inferenzproblem der Evolutionsbiologie, und seine Schwierigkeit ist zuallererst ein Abzählproblem.
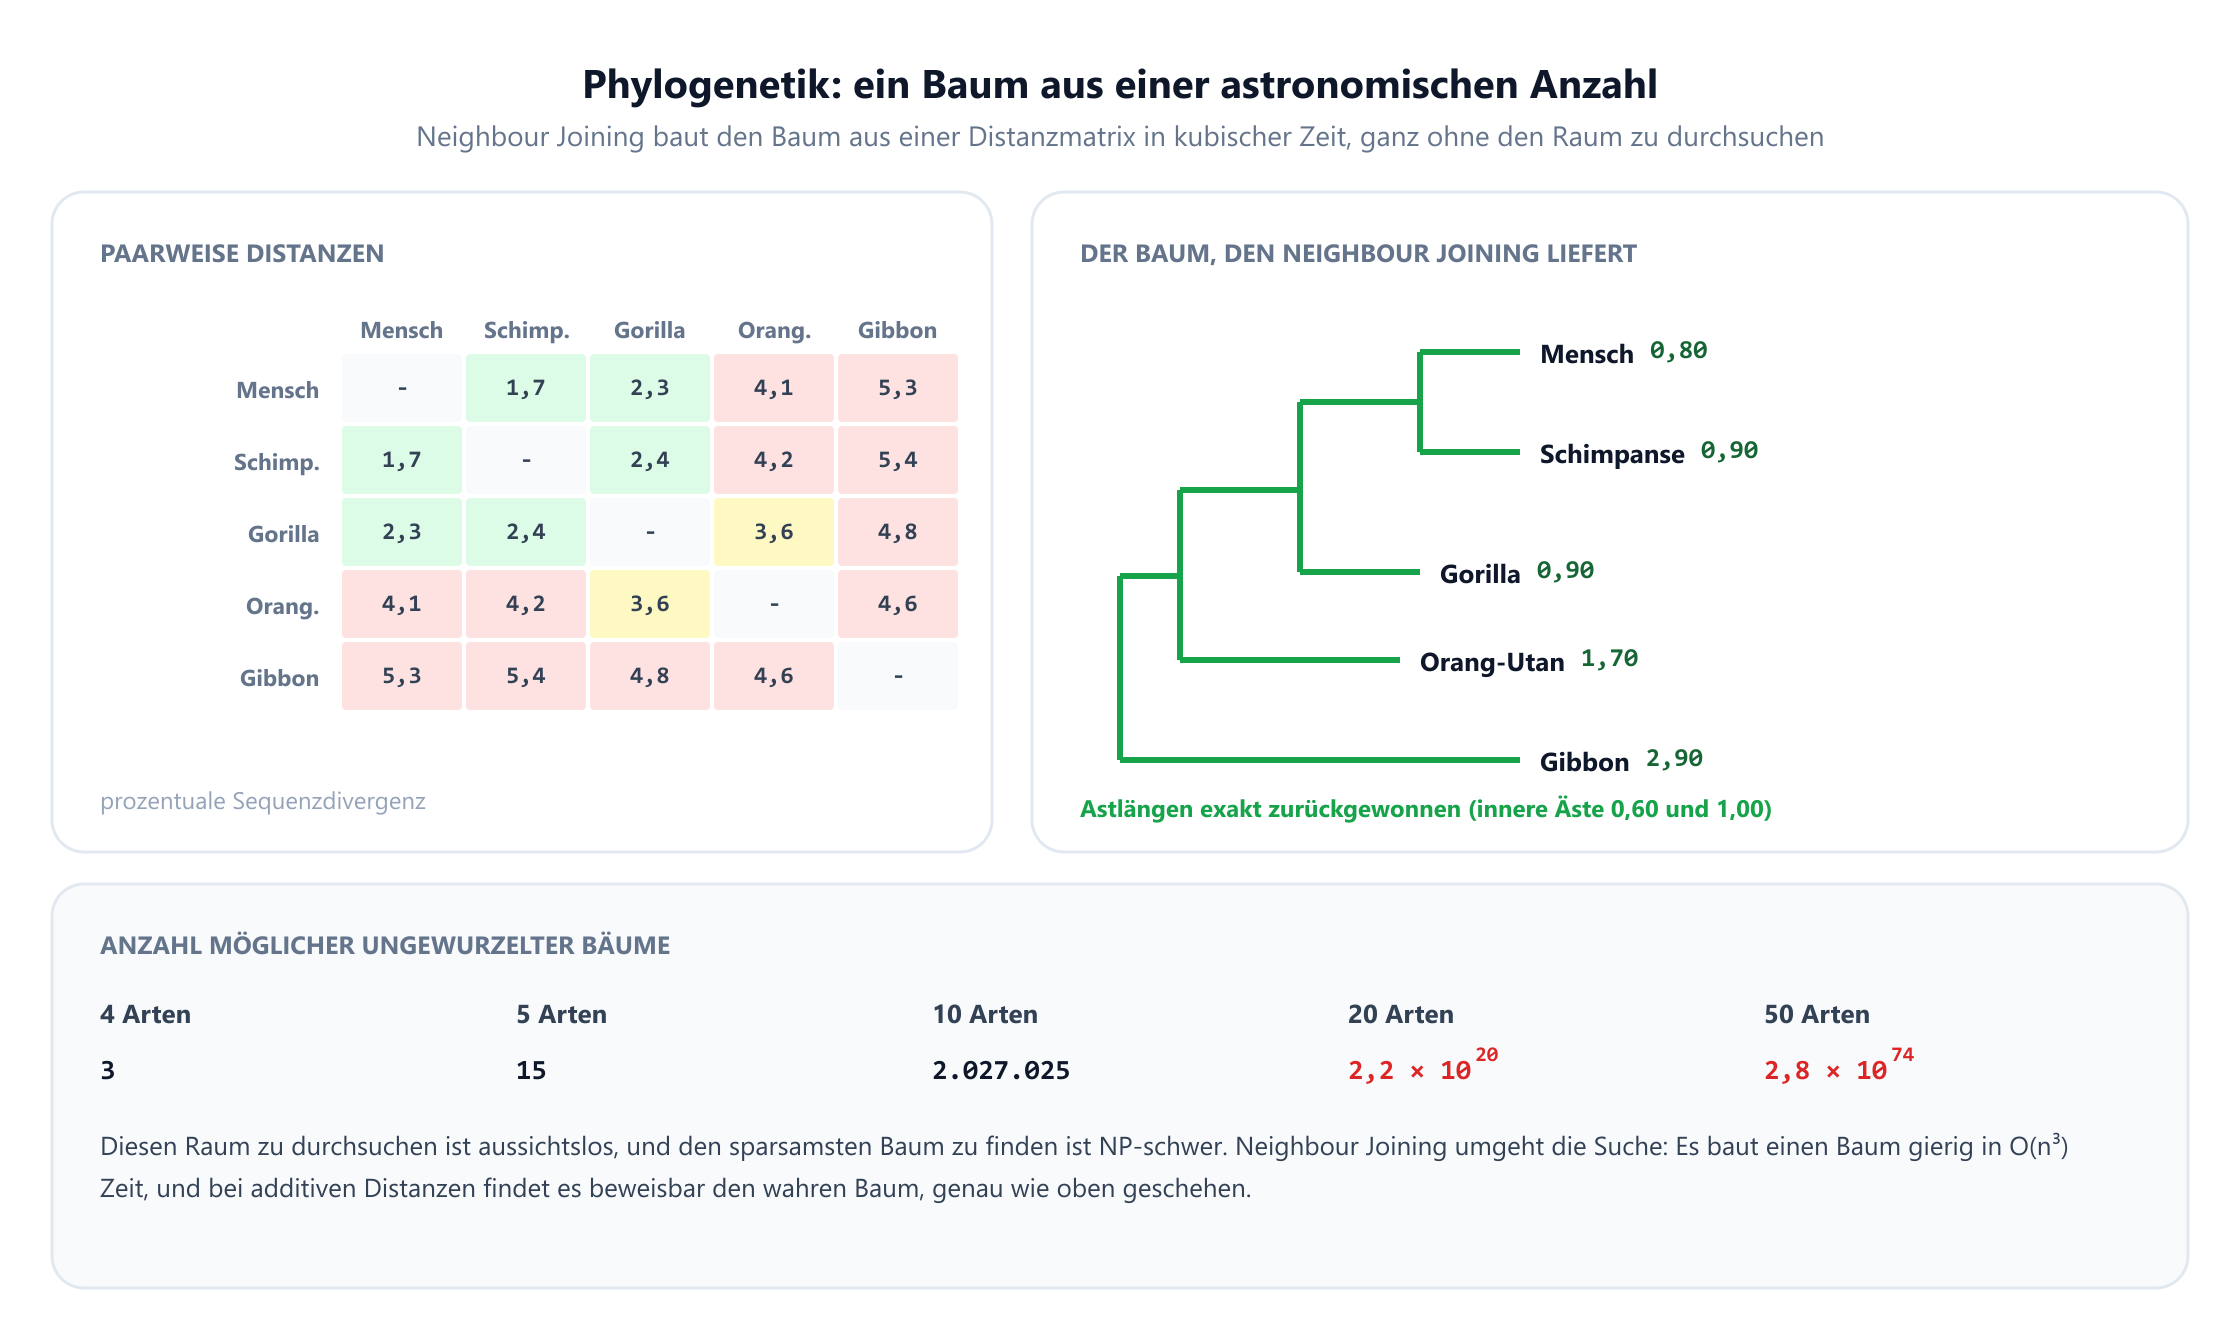
Die Zahl der verschiedenen ungewurzelten binären Bäume auf n Arten, 1978 von Felsenstein tabelliert, ist die Doppelfakultät (2n-5)!!, und sie explodiert. Vier Arten ergeben 3 Bäume. Fünf ergeben 15. Zehn ergeben 2.027.025. Zwanzig ergeben etwa 2,2 x 10²⁰. Fünfzig Arten ergeben ungefähr 2,8 x 1074, das sind mit großem Abstand mehr Bäume, als es Atome im beobachtbaren Universum gibt. Jeder davon ist eine mögliche Antwort, und phylogenetische Studien umfassen routinemäßig Hunderte von Taxa.
Eine erschöpfende Suche ist daher nicht nur langsam, sie ist dauerhaft unmöglich, und die Lage ist noch schlimmer: Das Finden des sparsamsten Baums, desjenigen mit den wenigsten evolutionären Veränderungen, wurde später als NP-schwer nachgewiesen, und die Baumsuche nach Maximum Likelihood ist nicht besser.
Saitou und Neis Neighbour Joining, 1987 veröffentlicht und eine der meistzitierten Arbeiten der gesamten Biologie, umgeht die Suche vollständig. Es nimmt eine Matrix paarweiser Distanzen, verbindet wiederholt das Paar von Taxa, das ein bestimmtes Kriterium als Nachbarn ausweist, und fasst sie zu einem Knoten zusammen, bis ein Baum übrig bleibt. Es zählt nie Alternativen auf und läuft in kubischer Zeit.
Auf der Distanzmatrix der fünf Primaten in der Abbildung verbindet es zuerst Orang-Utan mit Gibbon, dann Mensch mit Schimpanse, dann Gorilla mit der Gruppe aus Orang-Utan und Gibbon, und es gewinnt jede Astlänge exakt zurück. Diese Exaktheit ist kein Glück. Wenn die Distanzen additiv sind, also überhaupt erst aus einem Baum stammen, liefert Neighbour Joining beweisbar genau diesen Baum. Echte, aus echten Sequenzen geschätzte Distanzen sind nur annähernd additiv, weshalb die reale Phylogenetik Neighbour Joining nutzt, um schnell einen Startbaum zu erzeugen, und ihn dann unter einem Likelihood-Modell verfeinert, und weshalb derselbe Datensatz verschiedene veröffentlichte Bäume stützen kann.
10. Nahrungsnetze und Aussterbekaskaden
Wechseln Sie vom Inneren der Zelle zu einem ganzen Ökosystem, und die Mathematik bleibt dieselbe. Ein Nahrungsnetz ist ein gerichteter Graph: ein Knoten pro Art und ein Bogen von der Beute zum Räuber überall dort, wo die zweite die erste frisst. Arten ohne Beute sind basal, also Pflanzen, Algen oder Detritus, und alles andere hängt letztlich von ihnen ab.
Das Modell hier hat zwölf Arten und siebzehn Nahrungsbeziehungen, mit Algen und Detritus an der Basis und einem Otter, einem Reiher und einem Hecht an der Spitze. Das Erste, was der Graph liefert, ist die trophische Ebene, berechnet als eins plus die mittlere Ebene von allem, was eine Art frisst. Basale Arten liegen bei 1,00, Pflanzenfresser bei 2,00, und die Spitzenräuber landen auf gebrochenen Werten: der Hecht bei 4,50, der Otter bei 4,75, der Reiher bei 4,33. Gebrochene Ebenen sind kein Artefakt. Sie sind die ehrliche Antwort für einen Allesfresser, der auf mehreren Ebenen zugleich frisst.
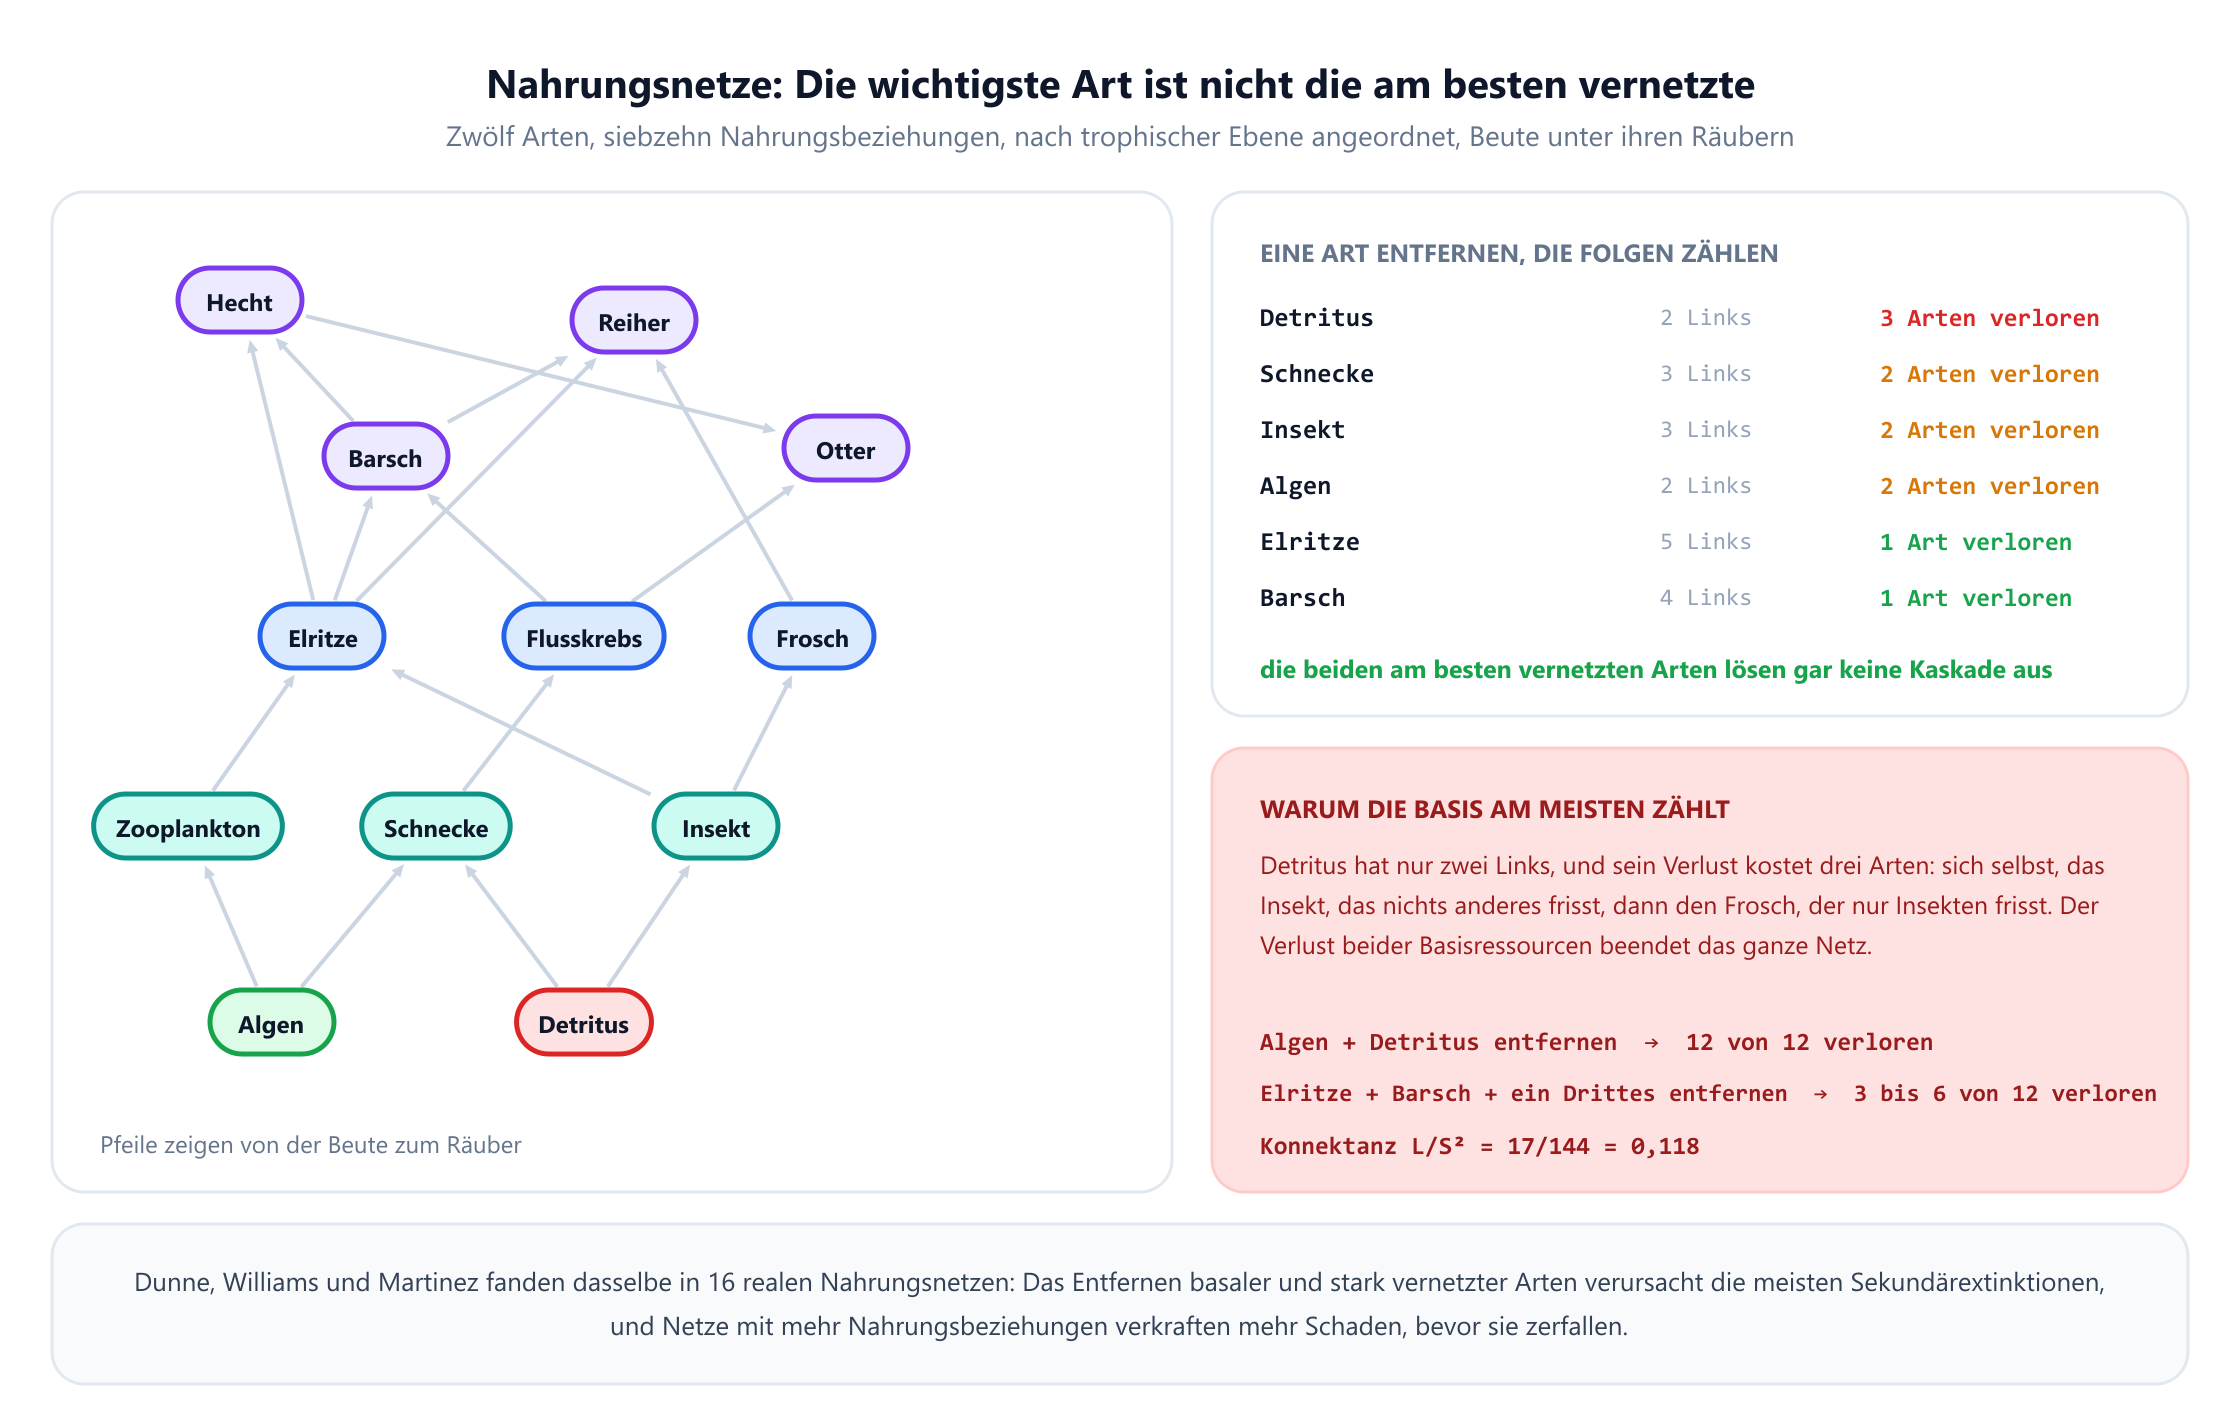
Die Frage, die für den Naturschutz zählt, ist, was nach dem Verlust einer Art geschieht. Man löscht einen Knoten, dann jede Art, die nichts mehr zu fressen hat, und wiederholt das, bis sich das Netz stabilisiert. Diese Folgeverluste sind Sekundärextinktionen, und sie sind der Grund, warum Ökosysteme schneller zusammenbrechen, als der direkte Druck auf sie vermuten ließe.
Die Ergebnisse auf diesem Netz sind auf eine bestimmte und nützliche Weise kontraintuitiv. Die Elritze ist mit fünf Nahrungsbeziehungen die am besten vernetzte Art. Entfernt man sie, stirbt sonst nichts: Jeder Räuber der Elritze frisst auch etwas anderes. Entfernt man den Reiher oder den Otter, beides Spitzenräuber, folgt wieder nichts. Entfernt man nun den Detritus, der nur zwei Links hat und für dessen Schutz niemand wirbt, dann verschwinden insgesamt drei Arten: der Detritus selbst, dann das Insekt, das nichts anderes frisst, dann der Frosch, der nur Insekten frisst. Ein Knoten mit zwei Kanten richtete mehr Schaden an als einer mit fünf.
Das Muster verallgemeinert sich. Basale Arten sind tragend, weil alles über ihnen von ihnen abhängt, während ein stark vernetzter Konsument in einem Teil des Graphen sitzt, der Ersatz bietet. Beide basalen Arten zu entfernen, Algen und Detritus, kostet alle zwölf Arten. Die am besten vernetzten zu entfernen, richtet weniger an, und die Zahl ist nicht einmal eindeutig: Elritze und Barsch führen bei den Links, doch fünf Arten teilen sich den dritten Platz, und je nachdem, welche davon hinzukommt, schwankt die Summe zwischen drei und sechs. Die beiden unscheinbaren Arten an der Basis richten mindestens den doppelten Schaden an.
Dunne, Williams und Martinez berichteten 2002 genau das für sechzehn reale Nahrungsnetze und fügten eine zweite Erkenntnis hinzu, die man sich merken sollte: Die Robustheit steigt mit der Konnektanz, der Zahl der Links geteilt durch das Quadrat der Artenzahl. Netze mit mehr Nahrungsbeziehungen verkraften mehr Schaden, bevor sie zerfallen, weil mehr Arten Alternativen haben. Das hier modellierte Netz hat eine Konnektanz von 0,118, mitten im Bereich, der für reale Netze berichtet wird.
Die praktische Lehre lautet, dass eine Naturschutz-Priorisierung nach Beliebtheit, Größe oder sogar Linkzahl die falsche Größe misst. Die Art, deren Verlust sich fortpflanzt, findet man, indem man das Entfernen auf dem Graphen simuliert, und die Antwort ist regelmäßig etwas Kleines und Ungeliebtes.
11. Konnektome und Epidemien
Zwei weitere Gebiete verdienen Erwähnung, weil beide bereits eingeführtes Werkzeug wiederverwenden.
Konnektome. Ein Nervensystem ist ein gerichteter, gewichteter Graph aus Neuronen, die durch Synapsen verbunden sind. Das erste vollständige wurde 1986 von White, Southgate, Thomson und Brenner veröffentlicht: der Fadenwurm C. elegans, 302 Neuronen und rund 7.000 Verbindungen, über mehr als ein Jahrzehnt von Hand aus elektronenmikroskopischen Aufnahmen rekonstruiert. Arbeiten am Menschen arbeiten mit gröberer Auflösung, mit Hirnregionen als Knoten und Faserbündeln oder korrelierter Aktivität als Kanten, aber die Analyse ist die aus Abschnitt 3: Grad, Clusterung, Pfadlänge, Module, Hubs.
Bullmore und Sporns legten das Programm 2009 dar, und der wiederkehrende Befund ist, dass Gehirne Kleine-Welt-Netze und modular sind, mit einem dicht vernetzten Kern aus Regionen hohen Grades, dem „Rich Club“, der einen überproportionalen Anteil des Fernverkehrs trägt. Mehrere psychiatrische und neurologische Erkrankungen zeigen sich als veränderte Graphenstatistiken. Das sind Korrelationen über Gruppen, keine Diagnosen für Einzelpersonen, und es lohnt sich zu wissen, dass ein funktionelles Konnektom stark von einer vom Analysten gewählten Korrelationsschwelle abhängt und dass sich die Statistiken verschieben, wenn sich die Schwelle verschiebt.
Epidemien. Krankheiten breiten sich über einen Kontaktgraphen aus, und seine Struktur bestimmt das Ergebnis ebenso sehr wie der Erreger. Pastor-Satorras und Vespignani bewiesen 2001 ein verblüffendes Ergebnis: Auf einem Netz mit skalenfreier Gradverteilung und unbeschränkter Varianz verschwindet die klassische Epidemieschwelle. In den gut durchmischten Modellen aus den Lehrbüchern stirbt eine Infektion mit hinreichend niedriger Übertragungsrate aus; auf einem solchen Netz nicht, weil die Hubs sie am Leben halten. Das veränderte die Impfstrategie, denn die Immunisierung von Personen mit hohem Grad, oder sogar von Bekannten zufällig gewählter Personen, die häufiger als zufällig einen hohen Grad haben, schlägt die zufällige Immunisierung mit gleich vielen Dosen.
Dieselbe Mathematik taucht in der Zellbiologie als Signalausbreitung und in der Computersicherheit als Ausbreitung von Schadsoftware wieder auf. Dem Graphen ist egal, wofür die Knoten stehen.
12. Was leicht ist, was schwer ist
Eine biologische Frage als Graphenfrage zu formulieren, macht sie nicht lösbar. Es macht die Schwierigkeit sichtbar, was nützlicher ist, und die Grenze verläuft an überraschenden Stellen.
Leicht, also in Polynomialzeit und routinemäßig im großen Maßstab. Grad, Clusterkoeffizienten und Zusammenhangskomponenten sind praktisch kostenlos. Kürzeste Wege und damit Alignments sind billig. Betweenness-Zentralität auf einem dünnen Graphen läuft dank des Algorithmus von Brandes in einer Zeit proportional zum Produkt aus Knoten- und Kantenzahl. Eulerpfade sind linear, Spannbäume und Flüsse polynomiell, und Neighbour Joining ist kubisch. Alles, was in diesem Artikel gelöst wird, gehört in diese Kategorie, und alles skaliert auf einem Laptop auf Graphen mit Millionen von Kanten.
Schwer, also NP-schwer, ohne dass ein Polynomialalgorithmus zu erwarten ist. Den sparsamsten phylogenetischen Baum finden. Die größte Menge von Arten finden, die alle miteinander interagieren, also die maximale Clique. Entscheiden, ob ein Netz ein Teilgraph eines anderen ist, was der Motivsuche nach größeren Mustern zugrunde liegt. Einen Hamiltonpfad finden, der Grund, warum die Überlappungsformulierung der Assemblierung aufgegeben wurde. Optimale Graphpartitionierung in ihrer exakten Form.
Zwei Beobachtungen machen die Grenze weniger entmutigend, als sie klingt. Erstens werden schwere Probleme in der Biologie meist mit Heuristiken angegangen, die auf den tatsächlich vorkommenden Instanzen gut funktionieren: Die Phylogenetik klettert von einem Neighbour-Joining-Start aus bergauf, und Motivsucher zählen geschickt auf, was für Muster aus drei und vier Knoten genügt. Zweitens ist der Unterschied zwischen der handhabbaren und der unlösbaren Formulierung derselben biologischen Aufgabe oft nur eine Modellierungsentscheidung, wie die Entscheidung für k-mere als Kanten bei der Assemblierung zeigt. Zu erkennen, auf welcher Seite der Linie man steht, bevor man Code schreibt, ist der größte Teil des Nutzens.
13. Modellierungsfehler
Fünf Fehler erklären die meisten falschen Schlüsse, die aus biologischen Netzen gezogen werden. Keiner davon ist exotisch, und alle stehen noch immer gedruckt.
Ein Aggregat als Momentaufnahme behandeln. Ein veröffentlichtes PPI-Netz ist die Vereinigung vieler Experimente, in verschiedenen Zelltypen, unter verschiedenen Bedingungen, über Jahrzehnte. Seine Kanten haben nie gleichzeitig existiert. Kürzeste Wege darüber zu berechnen, unterstellt, dass jede Interaktion gleichzeitig verfügbar ist, und das ist falsch. Wo bedingungsspezifische Daten existieren, filtern Sie danach; wo nicht, behandeln Sie pfadbasierte Schlüsse als Hypothesen.
Studien-Bias ignorieren. Gut untersuchte Proteine haben mehr bekannte Interaktionen, weil mehr Leute nachgesehen haben, nicht unbedingt, weil sie mehr echte Partner haben. Jede Analyse, die zu dem Schluss kommt, „die am stärksten vernetzten Proteine sind die wichtigen“, entdeckt teilweise die Publikationsgeschichte des Fachs neu. Die Probe ist, ob Ihr Ergebnis bestehen bleibt, wenn das Netz auf einen einzigen unverzerrten Screen beschränkt wird.
Mit dem falschen Nullmodell vergleichen. Das ist die Lehre der Motive aus Abschnitt 6, und sie gilt überall. Echte biologische Netze haben Hubs und Gradverteilungen mit schweren Rändern. Vergleicht man irgendeine Strukturstatistik mit einem gleichförmigen Zufallsgraphen, wirkt sie außergewöhnlich. Der Vergleich muss die Merkmale erhalten, die man nicht testet, und das heißt meist, die Gradfolge zu erhalten.
Korrelation als Kante lesen. Koexpressionsnetze verbinden Gene, deren Expressionsniveaus über Proben hinweg korrelieren. Korrelation ist keine Regulation, und der resultierende Graph ist ungerichtet, während Regulation gerichtet ist. Solche Netze sind nützlich, um Hypothesen zu erzeugen, und durchweg irreführend, wenn man sie als Mechanismus liest. Dieselbe Vorsicht gilt für funktionelle Konnektome, die aus korrelierter Hirnaktivität gebaut werden.
Die Skalenfreiheit überbewerten. Die Beobachtung, dass biologische Netze Gradverteilungen mit schweren Rändern haben, ist robust und wichtig. Die stärkere Behauptung, sie folgten einem sauberen Potenzgesetz, wurde wiederholt aus statistischen Gründen angefochten, namentlich von Broido und Clauset 2019, die strikte Potenzgesetze über Tausende empirischer Netze hinweg als selten befanden. Die nützlichen Schlüsse dieses Artikels, die Essenzialität der Hubs und die Asymmetrie zwischen Fehler und Angriff, brauchen nur den schweren Rand, nicht die genaue Funktionsform. Behaupten Sie den Rand, nicht das Gesetz.
14. Vom Modell zur Praxis
Ein kurzes Vorgehen für alle, die gleich einen dieser Graphen für echte Daten bauen wollen.
Schreiben Sie auf, was ein Knoten ist und was eine Kante bedeutet, je in einem Satz, bevor Sie Daten anfassen. Die meisten verworrenen Analysen gehen auf einen Graphen zurück, in dem die Kanten zwei verschiedene Dinge bedeuten, „bindet“ vermischt mit „ist korreliert mit“ oder „frisst“ vermischt mit „konkurriert mit“. Wenn sich der Satz schwer schreiben lässt, ist der Graph nicht fertig.
Entscheiden Sie gerichtet oder ungerichtet, gewichtet oder ungewichtet, aus biologischen Gründen. Nicht danach, was die Software als Standard setzt. Jede nachgelagerte Metrik erbt diese Wahl, und ein Betweenness-Wert, berechnet auf einem Graphen, der gerichtet hätte sein sollen, ist keine Näherung, sondern eine andere Größe.
Berechnen Sie zuerst die billigen deskriptiven Statistiken. Knoten- und Kantenzahl, Gradverteilung, Zahl der Komponenten, Clusterkoeffizient, Pfadlänge. Das dauert Sekunden und deckt Datenprobleme sofort auf: Eine unerwartete zweite Komponente bedeutet meist eine Unstimmigkeit bei den Bezeichnern, und ein verdächtig hoher mittlerer Grad meist doppelte Kanten.
Wählen Sie das Nullmodell, bevor Sie die Statistik berechnen, auf die es Ihnen ankommt. Nicht erst, nachdem Sie das Ergebnis gesehen haben.
Stören und neu berechnen. Entfernen Sie zufällig 10 % der Kanten und berechnen Sie Ihre Hauptaussage neu. Biologische Netze sind unvollständig und verrauscht, und eine Rangfolge, die sich neu sortiert, wenn ein Zehntel der Daten wegfällt, ist eine Eigenschaft der Stichprobe und nicht des Organismus.
Wenn Sie ein Gefühl für die Algorithmen hinter alldem entwickeln möchten, bevor Sie sie auf biologische Daten anwenden, lassen Sie sich mit den interaktiven Visualisierungen dieser Website die Breitensuche, den Dijkstra-Algorithmus und den Aufbau minimaler Spannbäume Schritt für Schritt auf selbst gezeichneten Graphen vorführen; das ist der schnellste Weg zu einem Gespür dafür, was diese Verfahren tatsächlich tun.
15. Häufig gestellte Fragen
Wie wird Graphentheorie in der Biologie eingesetzt?
+
Überall dort, wo biologische Objekte wechselwirken. Bindende Proteine bilden ein ungerichtetes Netz, sich gegenseitig regulierende Gene ein gerichtetes, DNA-Reads einen De-Bruijn-Graphen, dessen Eulerpfad das assemblierte Genom ist, Arten und ihre Vorfahren einen Stammbaum und Arten, die einander fressen, ein Nahrungsnetz. In jedem Fall liefert die Biologie Knoten und Kanten, und Standardalgorithmen beantworten dann die Fragen: welche Komponenten essenziell sind, welche Muster überrepräsentiert sind, welche Sequenz die Reads erklärt, welcher Baum die Distanzen erklärt und welches Aussterben eine Kaskade auslöst.
Was ist ein Hub-Protein, und warum sind Hubs wichtig?
+
Ein Hub ist ein Protein mit weit mehr Interaktionspartnern als der Durchschnitt. Hubs sind wegen eines experimentellen Ergebnisses wichtig: Jeong, Mason, Barabasi und Oltvai zeigten 2001, dass Hefeproteine mit mehr Partnern deutlich häufiger essenziell sind, die Zelle ohne sie also stirbt. Hubs erklären auch, warum sich Netze unter zufälligen und gezielten Schäden so unterschiedlich verhalten. Auf dem skalenfreien Netz in diesem Artikel lässt das zufällige Entfernen von 20 % der Proteine 78 % des Netzes verbunden, das Entfernen der 20 % mit dem höchsten Grad dagegen 9 %.
Was ist ein Netzwerkmotiv?
+
Ein kleiner Teilgraph, der in einem echten Netz häufiger vorkommt als in randomisierten Netzen mit exakt denselben Graden. Die Randomisierung ist der ganze Punkt: Der Vergleich mit einem gewöhnlichen Zufallsgraphen lässt fast jedes Muster signifikant erscheinen, weil echte Netze Hubs haben und zufällige nicht. Im Netz aus acht Genen hier kommt die Feed-forward-Schleife fünfmal vor, gegenüber einem randomisierten Mittel von 1,80 und einer Standardabweichung von 1,22, ein z-Wert von 2,63, und nur 17 von 1.000 randomisierten Kopien erreichen fünf oder mehr. Motive sind wichtig, weil sich ihre Funktion herleiten lässt: Die kohärente Feed-forward-Schleife ignoriert kurze Pulse und reagiert nur auf anhaltende Signale.
Warum ist Genomassemblierung ein Eulerpfad-Problem?
+
Wegen der Art, wie der Graph gebaut wird. Man zerlegt jeden Read in überlappende Teilzeichenketten der Länge k und macht jedes k-mer zu einer Kante vom Knoten aus seinen ersten k-1 Buchstaben zum Knoten aus seinen letzten k-1 Buchstaben. Jeden Read genau einmal zu verwenden heißt nun, jede Kante genau einmal zu verwenden, und das ist ein Eulerpfad, lösbar in linearer Zeit. Die naheliegende Alternative, jeden Read zu einem Knoten zu machen und überlappende Reads zu verbinden, verlangt, jeden Knoten einmal zu besuchen, und das ist ein Hamiltonpfad und NP-vollständig. Dieselbe biologische Aufgabe ist handhabbar oder hoffnungslos, je nachdem, ob Reads zu Kanten oder zu Knoten werden.
Warum machen Wiederholungen die Assemblierung mehrdeutig?
+
Weil eine wiederholte Sequenz den Weg mehr als einmal zum selben Knoten führt und die Reads keine Information darüber tragen, in welche Richtung er ihn zuerst verlassen soll. In diesem Artikel ergibt die Sequenz AGGGTGGTTGGC, gelesen als 4-mere, einen Graphen mit zwei Eulerpfaden, die AGGGTGGTTGGC und AGGGTTGGTGGC ergeben und beide vollständig zu jedem Read passen. Kein Algorithmus kann zwischen ihnen wählen, weil die Mehrdeutigkeit in den Daten liegt und nicht in der Methode. Dieselbe Sequenz als 6-mere gelesen ergibt genau eine Rekonstruktion, und deshalb zählt die Read-Länge mehr als die Zahl der Reads und hat Long-Read-Sequenzierung die Assemblierung verändert.
Wie viele phylogenetische Bäume gibt es, und wie finden Biologen einen?
+
Die Zahl der ungewurzelten binären Bäume auf n Arten ist die Doppelfakultät (2n-5)!!, die jede Möglichkeit einer Suche übersteigt: 3 Bäume für vier Arten, 15 für fünf, 2.027.025 für zehn, etwa 2,2 x 10^20 für zwanzig und ungefähr 2,8 x 10^74 für fünfzig. Den sparsamsten Baum zu finden ist NP-schwer. Neighbour Joining, 1987 von Saitou und Nei veröffentlicht, vermeidet die Suche ganz: Es verbindet wiederholt das nach einem bestimmten Kriterium nächste Paar und baut einen einzigen Baum in kubischer Zeit. Bei additiven Distanzen findet es beweisbar den wahren Baum, und genau das geschieht bei der Matrix der fünf Primaten in diesem Artikel, wo jede Astlänge exakt zurückgewonnen wird.
Welche Art ist in einem Nahrungsnetz am wichtigsten?
+
Nicht die am besten vernetzte. Im Netz aus zwölf Arten in diesem Artikel hat die Elritze mit fünf die meisten Nahrungsbeziehungen, und ihr Entfernen verursacht überhaupt keine Sekundärextinktionen, weil jeder ihrer Räuber auch etwas anderes frisst. Das Entfernen des Detritus, der nur zwei Links hat, kostet drei Arten: den Detritus, dann das Insekt, das nichts anderes frisst, dann den Frosch, der nur Insekten frisst. Das Entfernen beider basalen Arten kostet alle zwölf, das Entfernen der beiden am besten vernetzten plus einer beliebigen dritten zwischen drei und sechs. Wichtigkeit ist eine Eigenschaft der Position im Graphen, und man muss sie durch Simulation der Entfernung finden, nicht durch Abzählen der Links.
Sind biologische Netze wirklich skalenfrei?
+
Sie haben Gradverteilungen mit schweren Rändern, und das ist gut belegt. Die stärkere Behauptung, sie folgten einem sauberen Potenzgesetz, wurde aus statistischen Gründen angefochten, namentlich von Broido und Clauset 2019, die strikte Potenzgesetze über Tausende empirischer Netze hinweg als selten befanden. Das ist weniger wichtig, als es klingt, weil die genutzten Schlüsse nur den schweren Rand brauchen: Eine Verteilung, in der die meisten Knoten wenige Kanten und eine kleine Minderheit viele haben, genügt für die Essenzialität der Hubs und die Asymmetrie zwischen zufälligem Ausfall und gezieltem Angriff. Die sichere Position ist, den Rand zu behaupten und nicht das Gesetz.
16. Quellen
Die Arbeiten hinter den Ergebnissen dieses Artikels, in chronologischer Reihenfolge.
- Sylvester, J. J. (1878). “Chemistry and algebra.” Nature, 17, 284.
- Needleman, S. B. und Wunsch, C. D. (1970). “A general method applicable to the search for similarities in the amino acid sequence of two proteins.” Journal of Molecular Biology, 48(3), 443–453.
- Freeman, L. C. (1977). “A set of measures of centrality based upon betweenness.” Sociometry, 40(1), 35–41.
- Felsenstein, J. (1978). “The number of evolutionary trees.” Systematic Zoology, 27(1), 27–33.
- Smith, T. F. und Waterman, M. S. (1981). “Identification of common molecular subsequences.” Journal of Molecular Biology, 147(1), 195–197.
- White, J. G., Southgate, E., Thomson, J. N. und Brenner, S. (1986). “The structure of the nervous system of the nematode Caenorhabditis elegans.” Philosophical Transactions of the Royal Society B, 314(1165), 1–340.
- Saitou, N. und Nei, M. (1987). “The neighbor-joining method: a new method for reconstructing phylogenetic trees.” Molecular Biology and Evolution, 4(4), 406–425.
- Watts, D. J. und Strogatz, S. H. (1998). “Collective dynamics of small-world networks.” Nature, 393, 440–442.
- Albert, R., Jeong, H. und Barabási, A.-L. (2000). “Error and attack tolerance of complex networks.” Nature, 406, 378–382.
- Jeong, H., Tombor, B., Albert, R., Oltvai, Z. N. und Barabási, A.-L. (2000). “The large-scale organization of metabolic networks.” Nature, 407, 651–654.
- Jeong, H., Mason, S. P., Barabási, A.-L. und Oltvai, Z. N. (2001). “Lethality and centrality in protein networks.” Nature, 411, 41–42.
- Brandes, U. (2001). “A faster algorithm for betweenness centrality.” Journal of Mathematical Sociology, 25(2), 163–177.
- Pevzner, P. A., Tang, H. und Waterman, M. S. (2001). “An Eulerian path approach to DNA fragment assembly.” Proceedings of the National Academy of Sciences, 98(17), 9748–9753.
- Pastor-Satorras, R. und Vespignani, A. (2001). “Epidemic spreading in scale-free networks.” Physical Review Letters, 86(14), 3200–3203.
- Milo, R., Shen-Orr, S., Itzkovitz, S., Kashtan, N., Chklovskii, D. und Alon, U. (2002). “Network motifs: simple building blocks of complex networks.” Science, 298(5594), 824–827.
- Shen-Orr, S. S., Milo, R., Mangan, S. und Alon, U. (2002). “Network motifs in the transcriptional regulation network of Escherichia coli.” Nature Genetics, 31(1), 64–68.
- Dunne, J. A., Williams, R. J. und Martinez, N. D. (2002). “Network structure and biodiversity loss in food webs: robustness increases with connectance.” Ecology Letters, 5(4), 558–567.
- Barabási, A.-L. und Oltvai, Z. N. (2004). “Network biology: understanding the cell's functional organization.” Nature Reviews Genetics, 5(2), 101–113.
- Yildirim, M. A., Goh, K.-I., Cusick, M. E., Barabási, A.-L. und Vidal, M. (2007). “Drug-target network.” Nature Biotechnology, 25(10), 1119–1126.
- Bullmore, E. und Sporns, O. (2009). “Complex brain networks: graph theoretical analysis of structural and functional systems.” Nature Reviews Neuroscience, 10(3), 186–198.
- Compeau, P. E. C., Pevzner, P. A. und Tesler, G. (2011). “How to apply de Bruijn graphs to genome assembly.” Nature Biotechnology, 29(11), 987–991.
- Broido, A. D. und Clauset, A. (2019). “Scale-free networks are rare.” Nature Communications, 10, 1017.