
Tabla de Contenidos
- 1. Por qué la biología está llena de grafos
- 2. Cuatro grafos, cuatro preguntas distintas
- 3. Redes de proteínas: hubs, puentes e intermediación
- 4. Robusta ante accidentes, frágil ante ataques
- 5. Módulos, y por qué el agrupamiento significa función
- 6. Regulación génica: motivos de red
- 7. Ensamblaje de genomas: recorrer cada arista una vez
- 8. El alineamiento de secuencias es un camino mínimo
- 9. Filogenética: un árbol entre una cantidad astronómica
- 10. Redes tróficas y cascadas de extinción
- 11. Conectomas y epidemias
- 12. Qué es fácil y qué es difícil
- 13. Errores de modelado
- 14. Del modelo a la práctica
- 15. Preguntas frecuentes
- 16. Referencias
1. Por qué la biología está llena de grafos
La biología pasó la mayor parte de su historia haciendo listas. Una lista de genes, una lista de enzimas, una lista de las especies de un lago. Las listas se alargaron y luego se completaron, y completarlas reveló algo incómodo: conocer todas las piezas de un sistema dice notablemente poco sobre lo que hace el sistema. El genoma humano se terminó en 2003 y el número de genes codificantes de proteínas resultó ser de unos 20.000, no muy lejos del de un gusano nematodo con 302 neuronas. La lista de piezas nunca iba a ser la explicación.
Lo que separa a un humano de un gusano, y a una célula sana de una cancerosa, no es qué componentes existen, sino qué componentes interactúan con cuáles. Esa frase es la definición de un grafo. Un grafo es un conjunto de cosas junto con un conjunto de conexiones entre ellas, y nada más. En el momento en que anotas qué proteínas se unen a cuáles, qué gen activa a cuál o qué especie se come a cuál, has dejado de hacer una lista y has empezado a dibujar un grafo, uses o no esa palabra.
No es una metáfora ni un estilo de presentación. Importa porque los grafos llegan con dos siglos de matemáticas incluidas. En cuanto una pregunta biológica se formula como una pregunta sobre grafos, un gran cuerpo de teoremas y algoritmos queda disponible de golpe, y problemas que parecen necesitar biología nueva resultan necesitar un algoritmo ya existente. El ensamblaje de genomas, el proceso que convierte cientos de millones de fragmentos cortos de ADN en un cromosoma, es un recorrido que usa cada arista de un grafo exactamente una vez. Euler resolvió ese problema en 1736 para los puentes de una ciudad prusiana, y es el mismo problema.
El hábito es más antiguo de lo que se suele suponer. La palabra grafo en este sentido técnico la acuñó el matemático James Joseph Sylvester en 1878, por analogía con los diagramas de estructura química: moléculas dibujadas como átomos unidos por enlaces. La química dio a la teoría de grafos parte de su vocabulario, y un siglo después la biología molecular le dio algunos de sus mayores conjuntos de datos.
Esta guía recorre seis sistemas biológicos: una red de interacción de proteínas, una red de regulación génica, un genoma que se ensambla a partir de lecturas, un par de secuencias que se alinean, un conjunto de especies situadas en un árbol evolutivo y una red trófica que pierde especies una a una. Cada uno es lo bastante pequeño para comprobarlo a mano y se resuelve con un algoritmo con nombre. Cada número de esta página salió de código que se ejecutó, y cada resultado se recalculó con un segundo método distinto antes de escribirlo.
2. Cuatro grafos, cuatro preguntas distintas
Antes de construir nada conviene precisar qué tipo de grafo produce cada sistema biológico, porque el tipo decide qué preguntas se pueden siquiera plantear. Cuatro distinciones hacen casi todo el trabajo.
Dirigido o no dirigido. Si dos proteínas se unen, la relación es simétrica: «A se une a B» y «B se une a A» son el mismo hecho, así que las redes de interacción de proteínas son no dirigidas. Si un factor de transcripción activa un gen, la relación va en un solo sentido, así que las redes de regulación génica son dirigidas. No es contabilidad. Los grafos no dirigidos tienen componentes conexas; los dirigidos tienen alcanzabilidad, ciclos y retroalimentación, y la retroalimentación es la sustancia de la regulación. Preguntar si una red génica contiene un ciclo es preguntar si contiene un bucle de retroalimentación, y la respuesta cambia la biología.
Ponderado o no ponderado. Una arista de una red trófica puede simplemente existir, o puede llevar la biomasa que fluye por ella. Los grafos de similitud de secuencias llevan una puntuación en cada arista. Los pesos permiten preguntar por la mejor ruta en lugar de por una ruta cualquiera, y eso es lo que convierte el alineamiento en un problema de camino mínimo en la sección 8.
Estático o dinámico. Casi todas las redes de este artículo se dibujan como si fueran fijas. Las células reales no lo son. Una interacción que existe en una célula del hígado puede no existir en una neurona, y las interacciones aparecen y desaparecen a lo largo del ciclo celular. Tratar un agregado promediado en el tiempo como si todas sus aristas estuvieran presentes a la vez es el error de modelado más común en este campo, y la sección 13 vuelve sobre él.
Bipartito o no. Algunos datos biológicos tienen dos tipos de vértice con aristas solo entre tipos: fármacos y sus dianas, huéspedes y sus parásitos, genes y las enfermedades a las que se asocian. Los grafos bipartitos traen sus propios algoritmos, sobre todo el emparejamiento, y así se plantean a menudo los cribados de reposicionamiento de fármacos.
Acierta con estas cuatro y el resto viene solo. Fállalas y calcularás un número que no significa nada de una forma sobre la que ningún software te avisará.
3. Redes de proteínas: hubs, puentes e intermediación
Una red de interacción de proteínas, abreviada red PPI, tiene un vértice por proteína y una arista no dirigida allí donde dos proteínas se unen físicamente. Las versiones a gran escala se construyen con cribados de doble híbrido en levadura o con purificación por afinidad seguida de espectrometría de masas, y las redes publicadas para la levadura y el ser humano llegan a decenas de miles de aristas. En lugar de señalar algo enorme, usaremos una pequeña: doce proteínas y dieciocho interacciones, lo bastante pequeña para que cada afirmación de abajo se pueda comprobar contando.
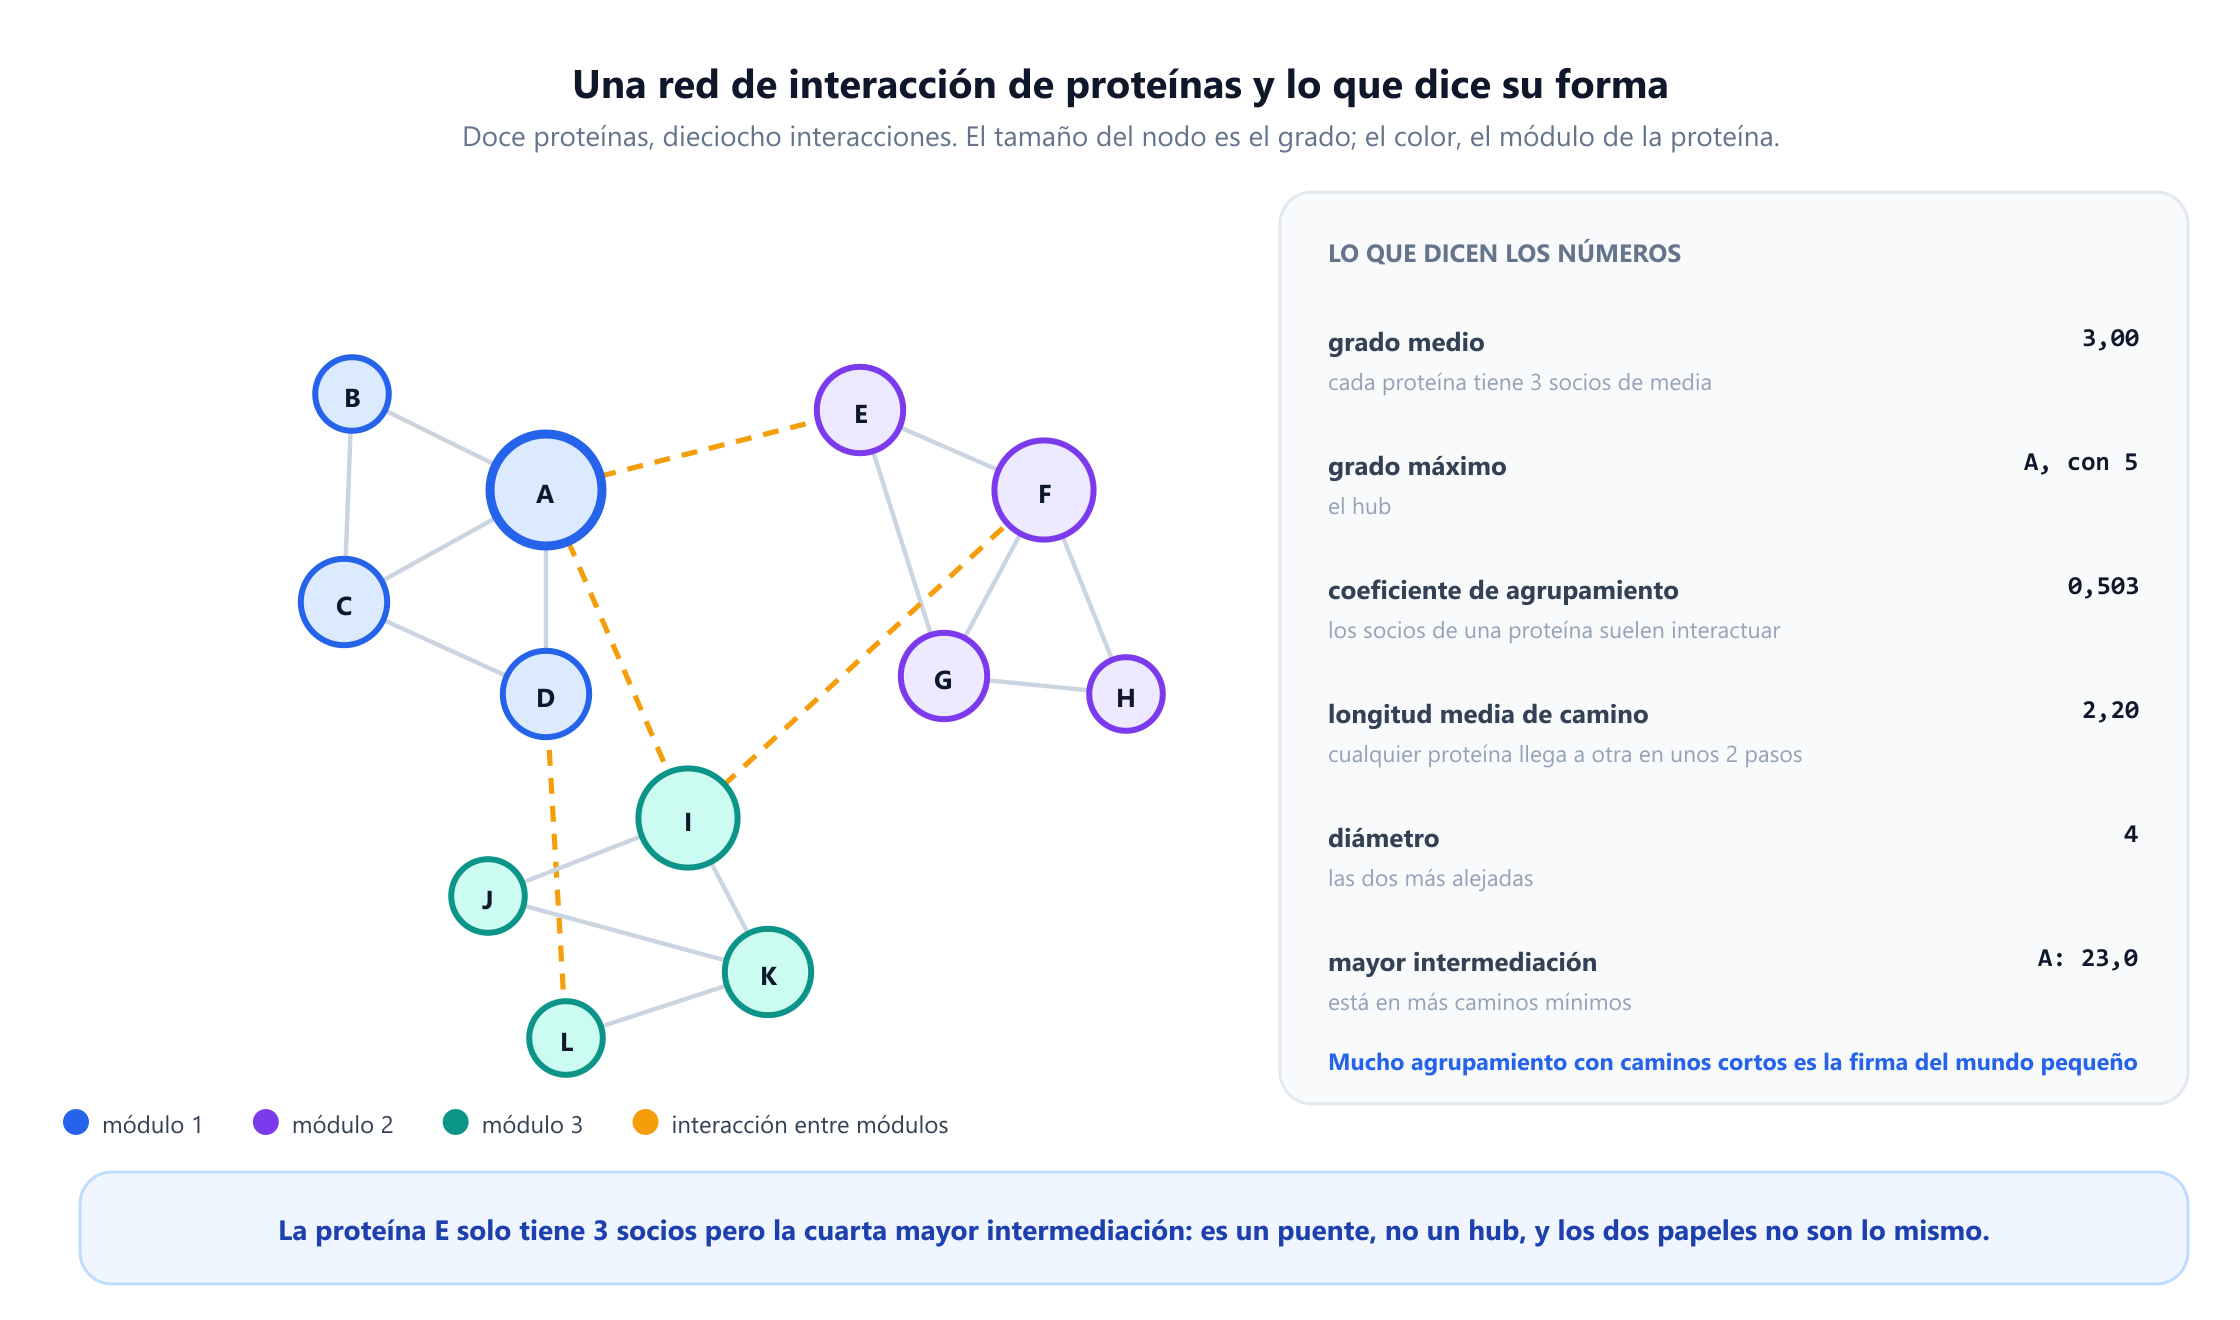
Lo primero que hay que medir es el grado, el número de socios de una proteína. Aquí los grados van de A:5, a F e I con 4, a un grupo de cinco con 3 y a una cola de cuatro con 2, con una media de 3,0. En las redes PPI reales esta distribución es mucho más desigual: la mayoría de las proteínas tiene un puñado de socios y una pequeña minoría tiene cientos. Las redes con esa forma se llaman libres de escala, un término que Barabasi y Oltvai popularizaron en su revisión de 2004, y la minoría de grado alto son los hubs.
Los hubs importan por una razón que se estableció experimentalmente y no solo con argumentos teóricos. En 2001, Jeong, Mason, Barabasi y Oltvai compararon la red PPI de la levadura con la biblioteca de deleciones de la levadura, en la que cada gen se ha inactivado por turno y la célula resultante se ha clasificado como viable o muerta. Las proteínas con más socios de interacción eran bastante más propensas a ser esenciales. El artículo se titula Lethality and centrality in protein networks, y la correlación que describió es la razón por la que el grado se convirtió en lo primero que se calcula sobre una red biológica.
El grado no es el único tipo de importancia, y aquí es donde un ejemplo pequeño se gana su sitio. Piensa en la proteína E. Tiene tres socios y en cualquier lista ordenada por grado pasa desapercibida. Ahora calcula la centralidad de intermediación, que cuenta, sobre todos los pares de proteínas, qué fracción de los caminos mínimos entre ellas pasa por un vértice dado. Freeman introdujo la medida en 1977 para redes sociales. En este grafo la clasificación por intermediación es A con 23,0, I con 19,8, F con 12,2 y luego E con 9,2, por delante de varias proteínas con más socios que ella.
E puntúa alto por dónde está, no por cuántos vecinos tiene. Es la puerta de entrada al segundo módulo, así que el tráfico entre el primer módulo y el segundo tiene que pasar por ella. En términos de redes, E es un puente y no un hub, y la distinción tiene una lectura biológica: las proteínas puente son candidatas a la comunicación cruzada entre rutas, y eliminar una no borra tanto una función como desconecta dos funciones entre sí. Una clasificación solo por grado nunca la sacaría a la luz.
Otros dos números describen el grafo entero y no un vértice concreto. La longitud media del camino mínimo es 2,197 y el diámetro, el más largo de todos los caminos mínimos, es 4: cualquier proteína llega a cualquier otra en como mucho cuatro pasos. Las redes PPI reales se comportan igual a una escala muchísimo mayor, con miles de proteínas y una longitud de camino característica en torno a 5. Es la propiedad de mundo pequeño que Watts y Strogatz formalizaron en 1998, y dentro de una célula tiene una consecuencia rotunda. Una perturbación en cualquier punto está a pocos pasos de todas partes, lo que explica en gran medida por qué un fármaco dirigido a una proteína produce con tanta fiabilidad efectos que nadie diseñó.
4. Robusta ante accidentes, frágil ante ataques
El resultado más citado de la biología de redes no trata de ninguna proteína concreta. Trata de lo que ocurre cuando empiezas a eliminarlas, y lo publicaron Albert, Jeong y Barabasi en Nature en 2000 con el título Error and attack tolerance of complex networks.
El experimento es fácil de enunciar. Toma una red, elimina vértices y, tras cada eliminación, mide el tamaño de la mayor componente superviviente. Hazlo dos veces: una eliminando vértices de forma uniforme al azar, lo que modela accidentes y mutaciones, y otra eliminándolos por orden decreciente de grado, lo que modela un ataque deliberado. Luego compara las curvas.
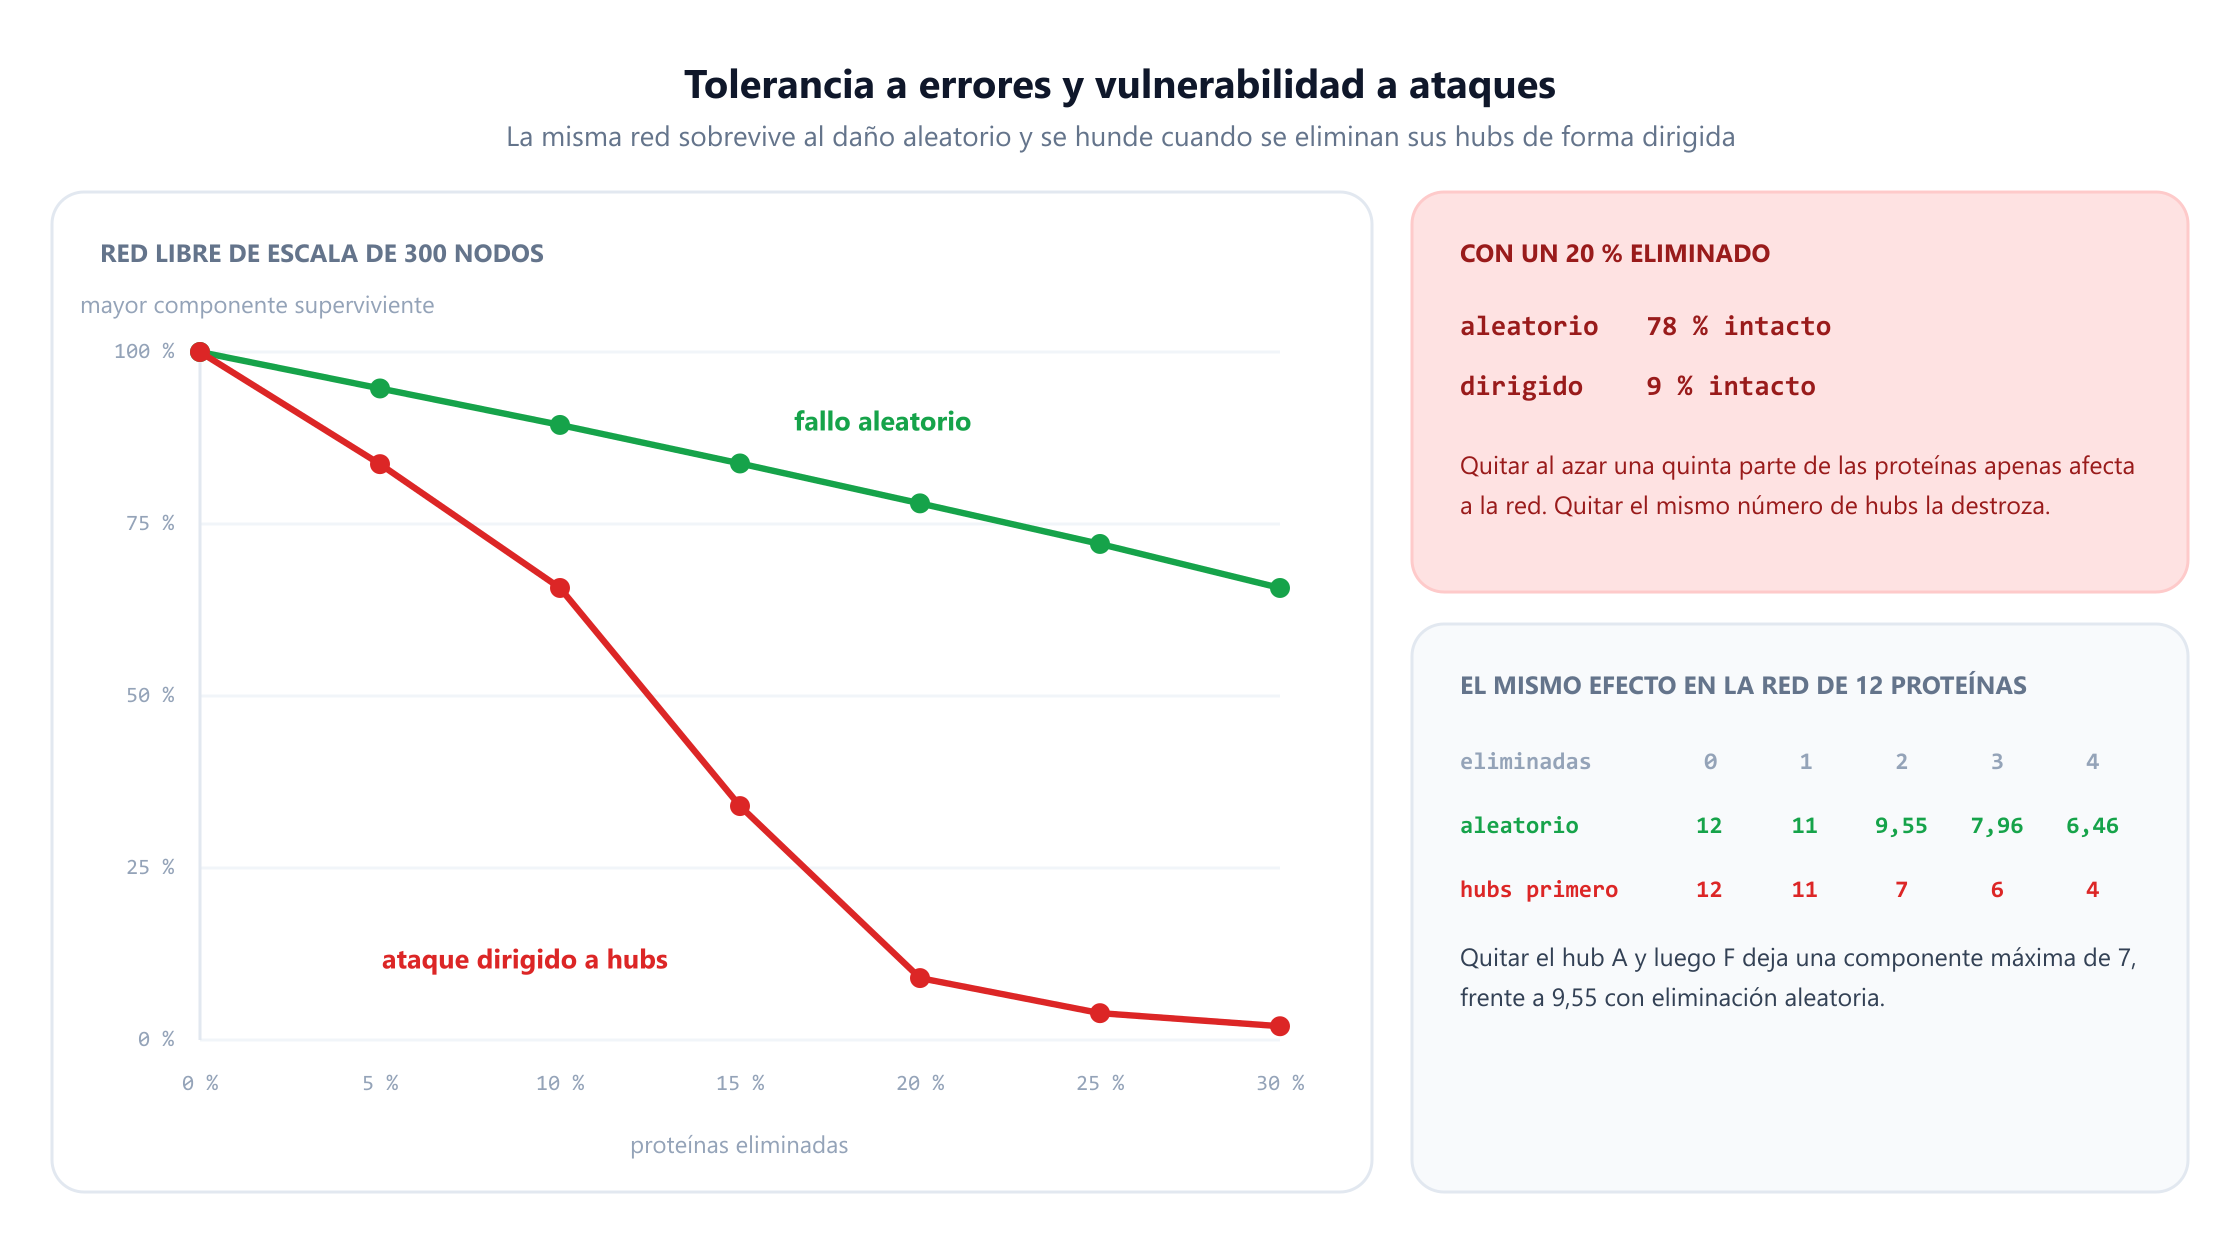
En una red libre de escala de 300 vértices generada por enlace preferencial, eliminar al azar el 20 % de los vértices deja el 78 % de la red todavía conectado en una pieza. Eliminar el 20 % con mayor grado deja el 9 %. La red que resistió el primer ataque quedó destruida por el segundo, y la única diferencia entre ambos fue qué vértices se eligieron.
La red de doce proteínas muestra la misma asimetría a una escala que puedes comprobar a mano. Eliminar proteínas al azar, promediando sobre todas las elecciones posibles, deja componentes máximas de 12, 11, 9,55, 7,96 y 6,46 a medida que el número de eliminaciones pasa de cero a cuatro. Eliminar hubs por orden decreciente de grado, que aquí significa A, luego F, luego I y luego C, deja 12, 11, 7, 6 y 4. Dos eliminaciones bien elegidas cuestan más que cuatro aleatorias.
La explicación está en la distribución de grados. En una red libre de escala la inmensa mayoría de los vértices tiene grado bajo, así que una eliminación aleatoria casi seguro acierta en un vértice periférico cuya pérdida no desconecta a nadie. Los escasos hubs lo mantienen todo unido, y eliminar uno quita muchas aristas de golpe. La robustez frente al daño aleatorio y la fragilidad frente al daño dirigido no son dos propiedades en tensión. Son una sola propiedad vista desde dos direcciones.
Las lecturas biológicas van en ambos sentidos. Por el lado frágil, explica por qué las proteínas hub están enriquecidas en esencialidad y por qué la oncología lleva dos décadas intentando identificar los hubs de los que depende un tumor. Por el lado robusto, explica por qué los organismos toleran una enorme carga de mutaciones aleatorias sin consecuencias visibles y por qué la inactivación de un solo gen tan a menudo no produce ningún fenotipo. Esa última observación frustró a una generación de genetistas: la mayoría de los genes no son estructurales, y los que sí lo son se pueden identificar por su posición en el grafo.
5. Módulos, y por qué el agrupamiento significa función
Vuelve a mirar la red de doce proteínas y verás tres grupos a simple vista. Las proteínas de la A a la D están densamente unidas entre sí, de la E a la H forman un segundo grupo, de la I a la L un tercero, y solo cuatro aristas cruzan entre grupos. Detrás de esa impresión visual hay un número.
El coeficiente de agrupamiento de un vértice plantea una pregunta concreta: de todos los pares de mis vecinos, ¿qué fracción está conectada entre sí? Si una proteína tiene cuatro socios, hay seis pares entre ellos, y el coeficiente es la fracción de esos seis pares que se unen entre sí. Promediado sobre las doce proteínas, esta red obtiene 0,503, es decir, que aproximadamente la mitad de todos los triángulos que podrían cerrarse se cierran. Un grafo aleatorio con el mismo número de vértices y aristas obtiene alrededor de 0,23. Las redes PPI reales están igual de agrupadas, y también las redes metabólicas, las redes neuronales y las redes tróficas.
Un agrupamiento alto es lo que da sentido a la palabra módulo. Las proteínas que se unen todas entre sí suelen hacer un trabajo juntas: forman un complejo, están en una misma ruta o se reclutan al mismo lugar al mismo tiempo. Es la inferencia más útil de la biología de redes aplicada, porque permite anotar una proteína desconocida a partir de sus vecinas. Si una proteína de función desconocida está en un grupo cuyos demás miembros se ocupan de la reparación del ADN, la reparación del ADN es la primera hipótesis que hay que probar. Hay flujos de trabajo enteros basados en esa idea, y son algoritmos de detección de comunidades con nombres biológicos.
Aquí corresponde una advertencia. Un módulo hallado por un algoritmo es una hipótesis, no un descubrimiento. El algoritmo divide cualquier cosa que le des, y devolverá módulos a partir de datos aleatorios con la misma alegría.
6. Regulación génica: motivos de red
Las redes de regulación génica son dirigidas. Un arco del gen X al gen Y significa que la proteína que produce X se une al promotor de Y y cambia cuánto Y se fabrica. Como los arcos tienen dirección, las estructuras interesantes son patrones de flujo más que vecindarios densos, y en 2002 dos artículos del grupo de Uri Alon cambiaron la forma de leerlos.
La idea es esta. Toma un subgrafo pequeño, digamos tres genes conectados según un patrón concreto, y cuenta cuántas veces aparece en la red real. Esa cifra sola no significa nada, porque algunos patrones son comunes solo por el número de arcos que tiene cada gen. Así que genera muchas redes aleatorizadas con exactamente los mismos grados, intercambiando repetidamente los extremos de pares de arcos, y cuenta el patrón en cada una. Si el recuento real queda muy en la cola de esa distribución, el patrón es un motivo de red: aparece más a menudo de lo que los grados por sí solos pueden explicar, lo que es indicio de que la selección lo puso ahí.
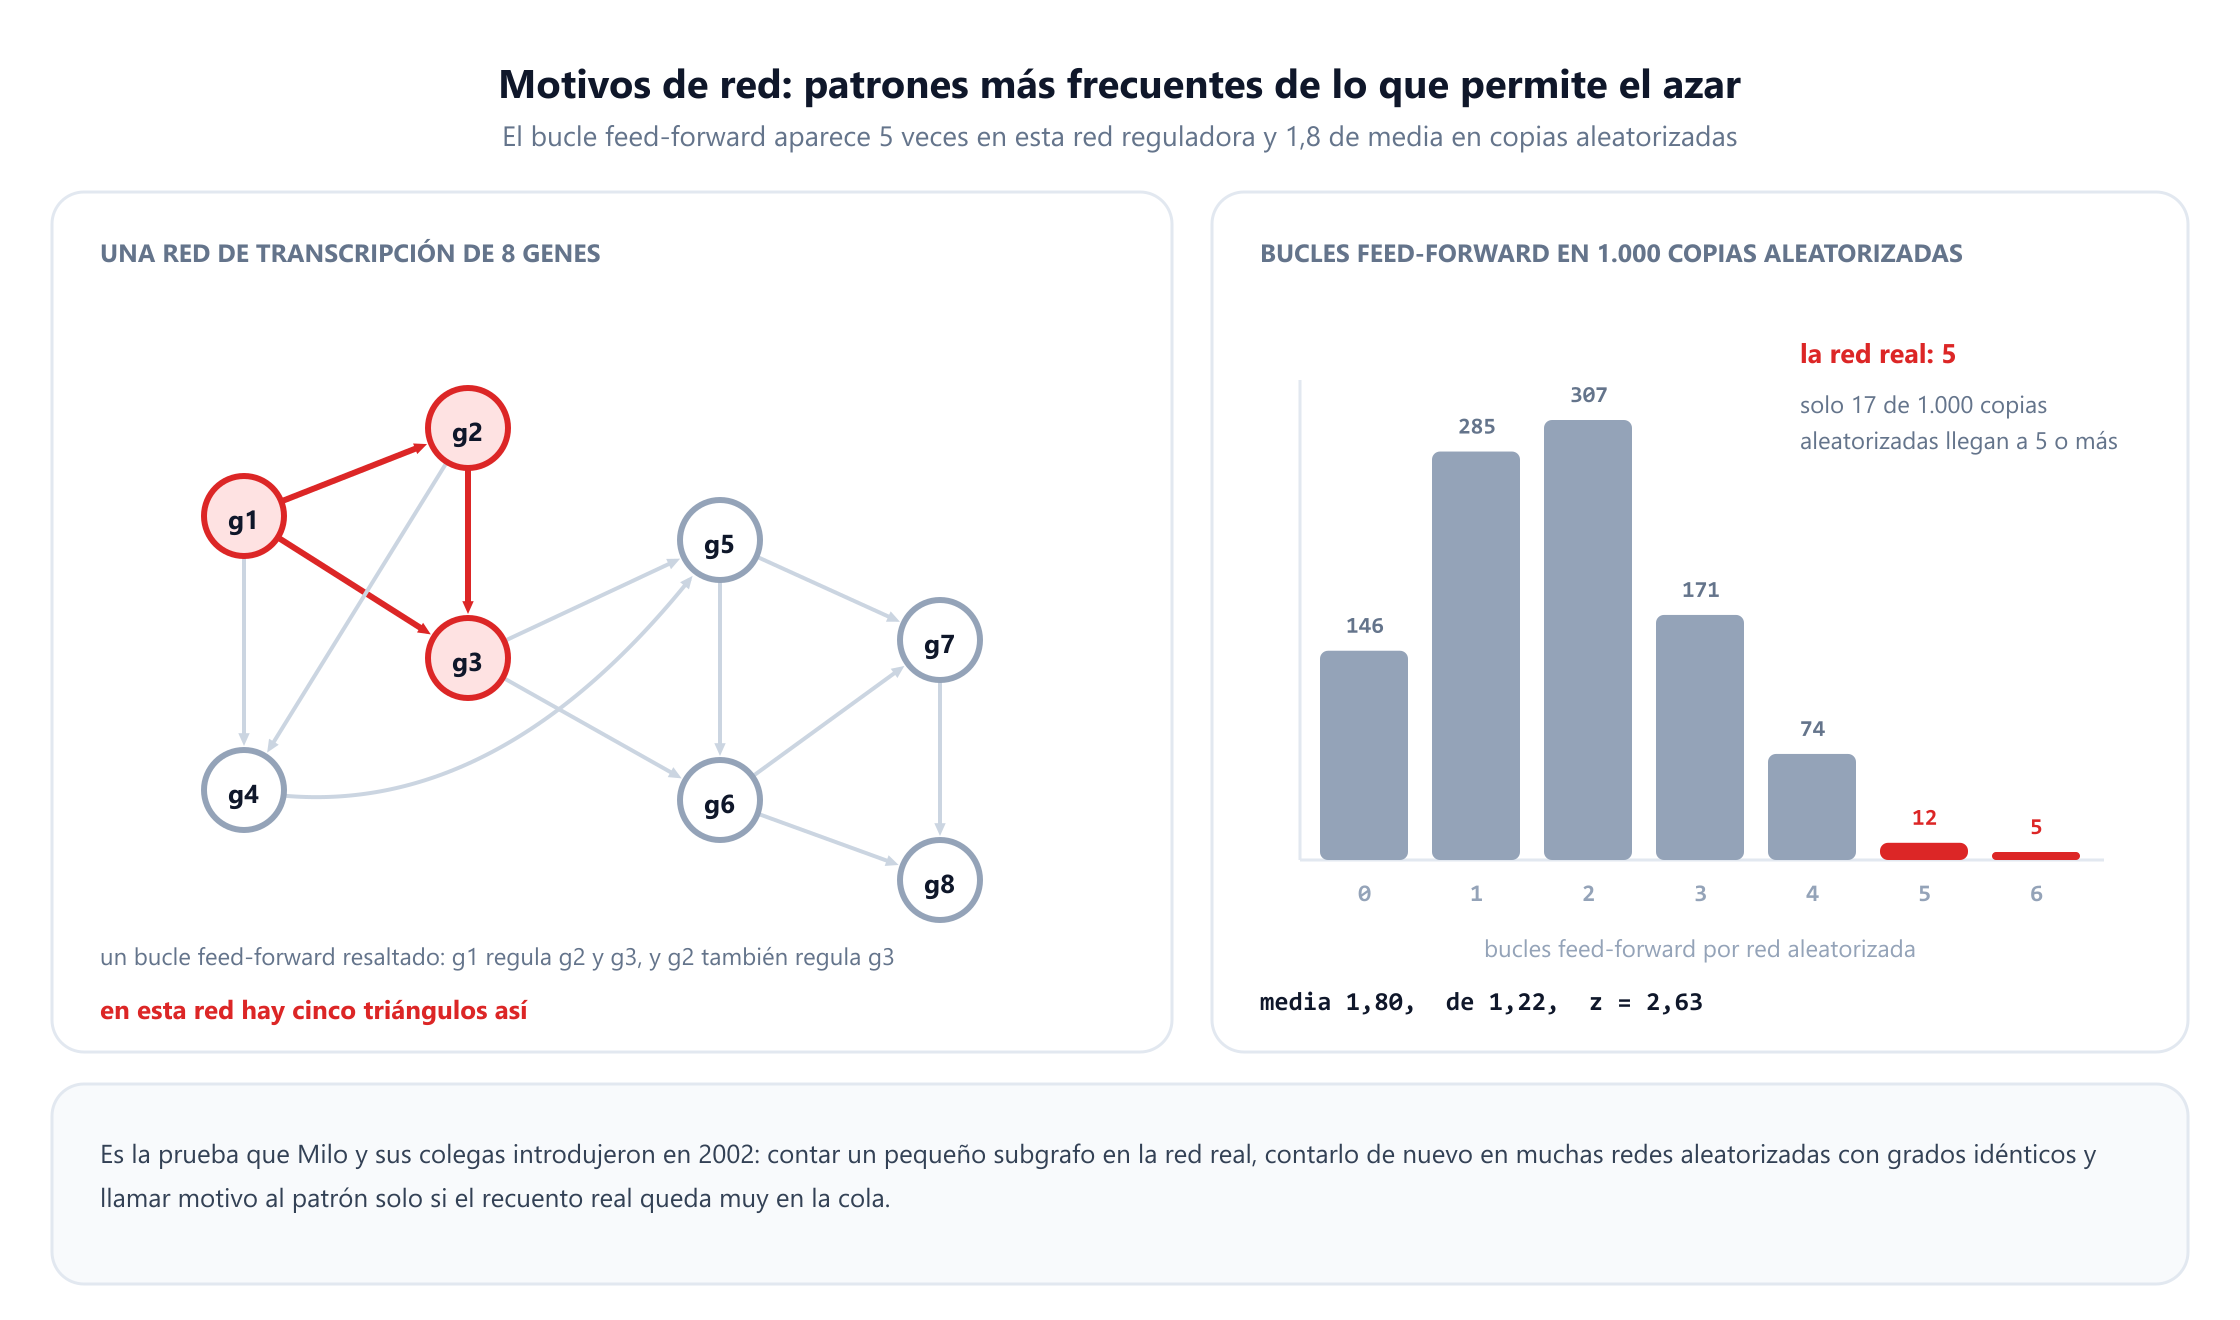
El patrón de la figura es el bucle feed-forward: el gen X regula a Y, X también regula a Z directamente, e Y regula igualmente a Z. En la red de ocho genes aparece cinco veces. En 1.000 aleatorizaciones que conservan los grados, el recuento medio fue 1,80 con una desviación estándar de 1,22, lo que da una puntuación z de 2,63, y solo 17 de las 1.000 redes aleatorizadas contenían cinco o más. En una red tan pequeña esto es sugerente más que concluyente; en la red de transcripción real de E. coli, Shen-Orr, Milo y Alon hallaron el mismo patrón con puntuaciones z de varias decenas, lo que no es un resultado dudoso.
Lo que hace interesante el bucle feed-forward es que su función se puede deducir en lugar de adivinar. En la versión coherente, en la que X activa tanto a Y como a Z e Y también activa a Z, el gen Z solo se enciende cuando X e Y están presentes. Como Y tarda en acumularse tras la aparición de X, Z ignora los pulsos breves de X y solo responde a señales sostenidas. El motivo es un detector de persistencia, un filtro de ruido hecho con tres genes. Cambia los signos y obtienes en su lugar un generador de pulsos o una respuesta acelerada. El cableado es el mecanismo.
Milo y sus colegas descubrieron que distintos tipos de red se caracterizan por motivos distintos: las redes de transcripción son ricas en bucles feed-forward, las redes neuronales en otro conjunto y las redes tróficas en otro distinto. Defendieron que los motivos son los circuitos elementales con los que se construye la red, y la idea cuajó, tanto porque la estadística es comprobable como porque los circuitos hacen algo.
Hay una lección metodológica que va mucho más allá de la biología. La aleatorización debe conservar los grados. Si comparas con un grafo aleatorio corriente, casi todo parece un motivo, porque las redes reales tienen hubs y las aleatorias no, y los hubs por sí solos generan un exceso de todos los patrones de tres nodos. Equivocarse con el modelo nulo es la forma habitual en que falla este análisis.
7. Ensamblaje de genomas: recorrer cada arista una vez
Las máquinas de secuenciación no pueden leer un cromosoma. Leen fragmentos cortos, desde unas 100 bases en un instrumento de lecturas cortas hasta decenas de miles en uno de lecturas largas, tomados en posiciones aleatorias de muchas copias del genoma. Un genoma humano llega como cientos de millones de estos fragmentos, sin ningún registro de dónde procede cada uno. El ensamblaje es el problema de volver a juntarlos, y la solución moderna es un grafo.
La construcción se debe a Pevzner, Tang y Waterman en 2001, y es lo bastante elegante para enunciarla en dos frases. Se trocea cada lectura en subcadenas solapadas de longitud k, llamadas k-meros. Luego se construye un grafo en el que cada k-mero es una arista, que va del vértice formado por sus primeras k-1 letras al vértice formado por sus últimas k-1 letras. Reconstruir la secuencia significa ahora encontrar un recorrido que use cada arista exactamente una vez, lo que es un camino euleriano.
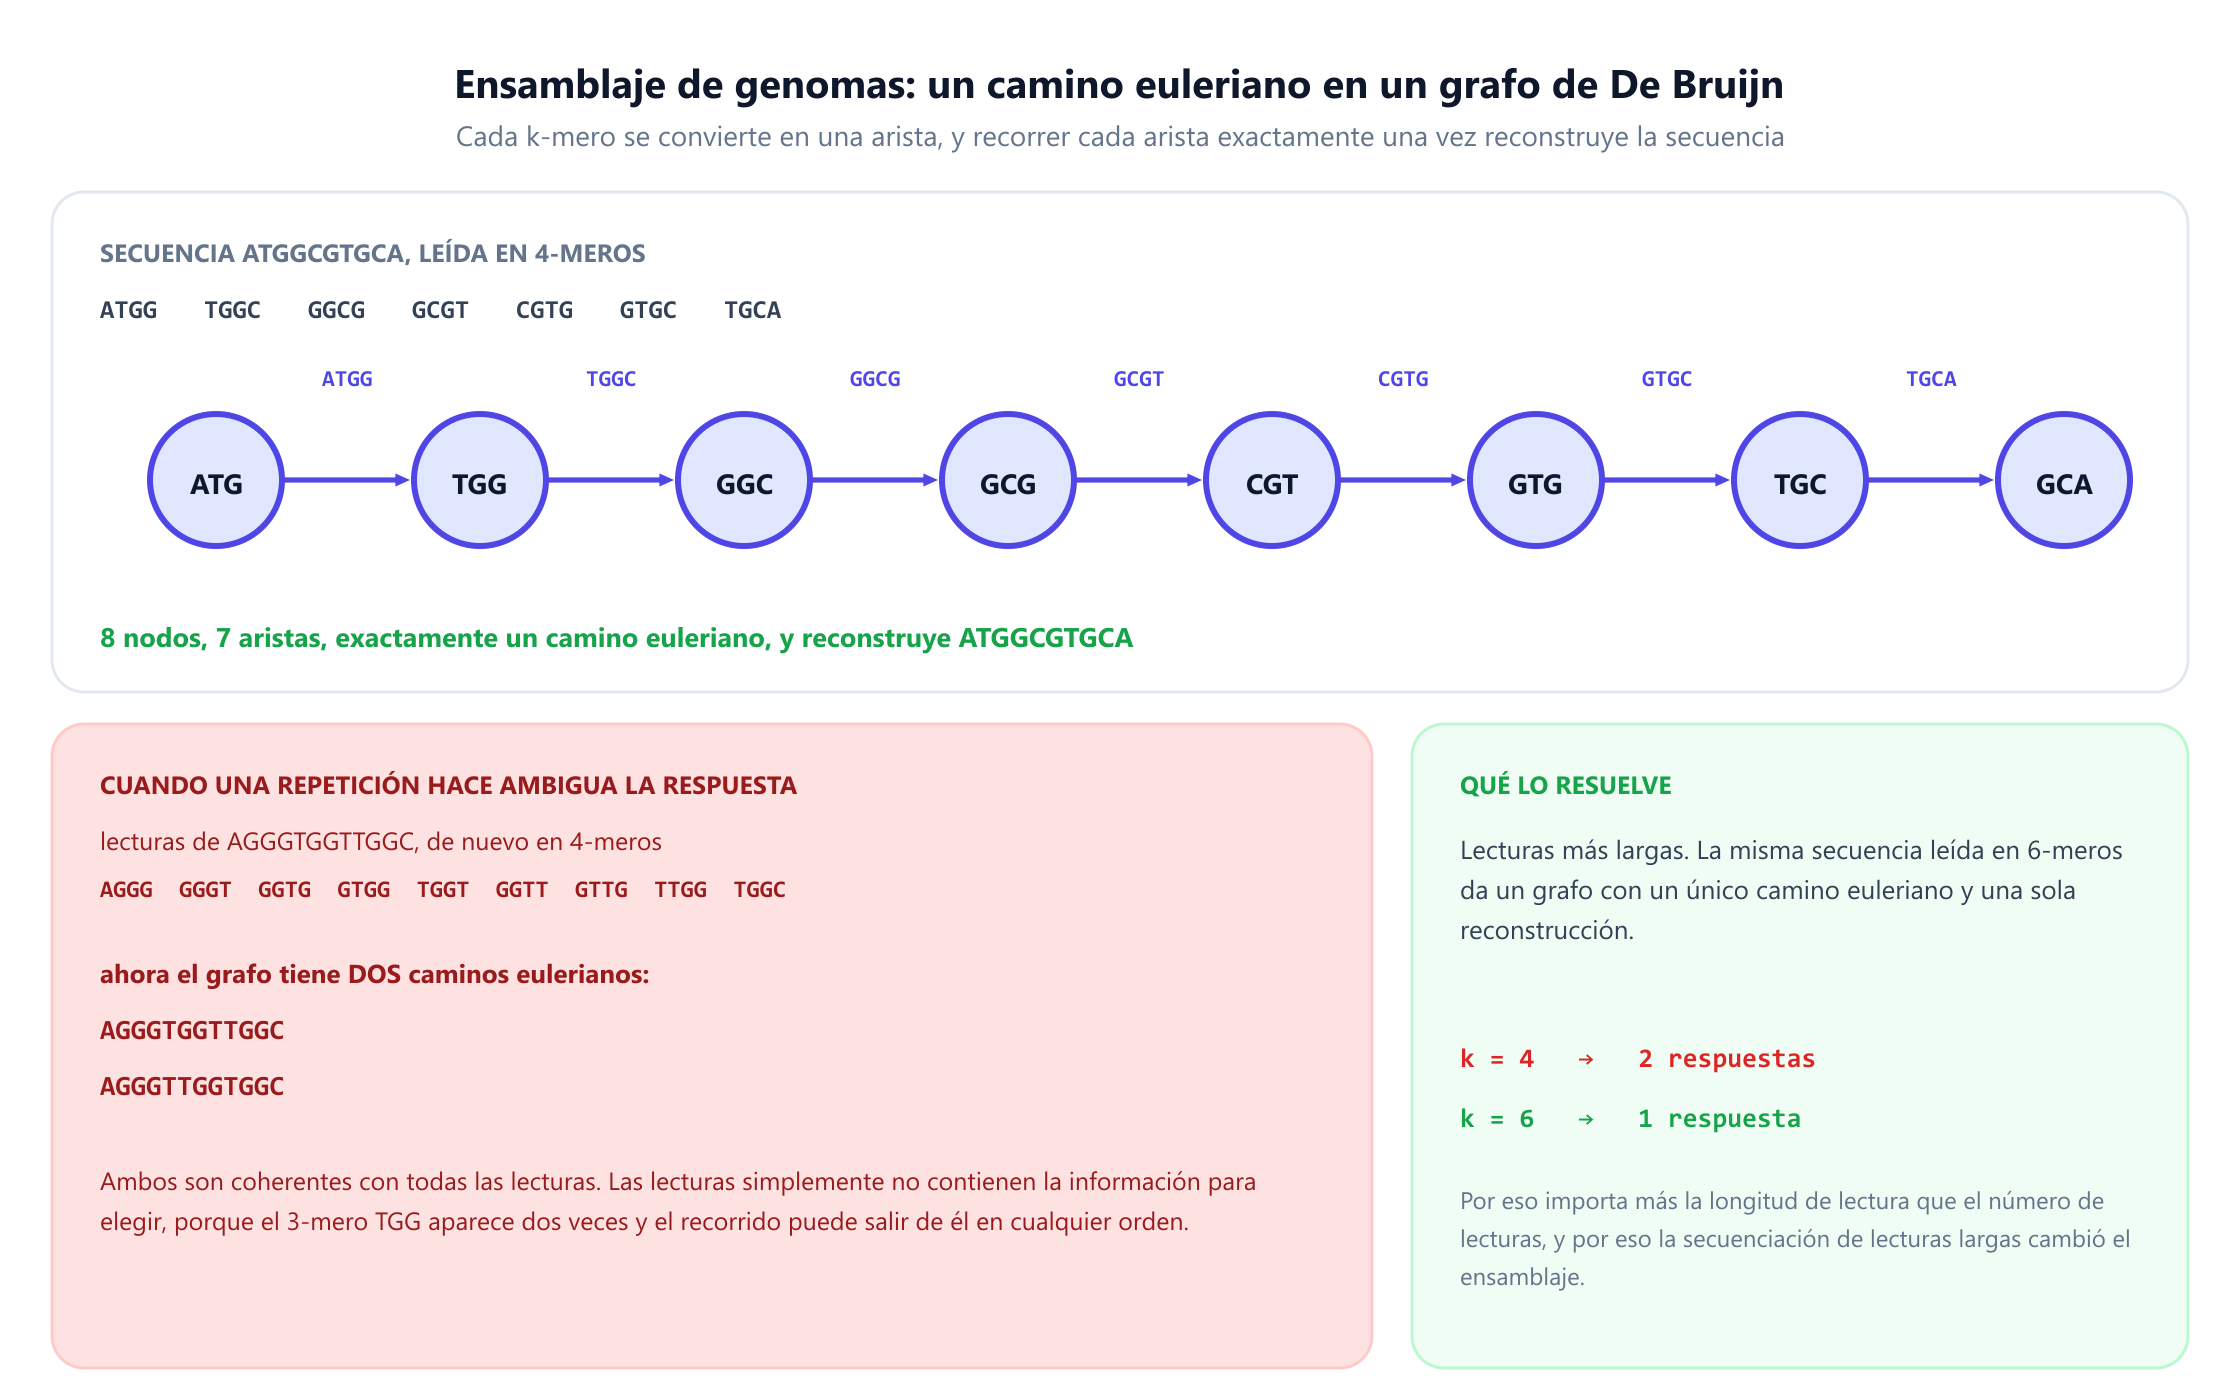
Toma la secuencia ATGGCGTGCA y léela en 4-meros. Eso da siete k-meros, un grafo con 8 vértices y 7 aristas, y exactamente un camino euleriano, que vuelve a deletrear la secuencia original. El ensamblaje funcionó, y funcionó porque el grafo tenía una respuesta única.
Ahora toma AGGGTGGTTGGC, de nuevo en 4-meros. El grafo tiene dos caminos eulerianos, que forman AGGGTGGTTGGC y AGGGTTGGTGGC. Ambos son coherentes con todas las lecturas observadas. No es un fallo del algoritmo, y ningún algoritmo mejor puede arreglarlo: el 3-mero TGG aparece dos veces, el recorrido llega a ese vértice más de una vez y las lecturas no contienen información sobre por dónde salir de él la primera vez. La ambigüedad está en los datos.
Lo que la resuelve son las lecturas más largas. Leer la misma secuencia en 6-meros produce un grafo con exactamente un camino euleriano y una sola reconstrucción. Por eso la industria de la secuenciación lleva quince años persiguiendo la longitud de lectura más que el número de lecturas, y por eso el genoma humano solo se declaró completo, sin huecos de telómero a telómero, en 2022, más de veinte años después del primer borrador. Las piezas que faltaban eran repeticiones, y las repeticiones son precisamente las estructuras que vuelven ambiguo un recorrido euleriano.
Aquí hay un precioso episodio de historia algorítmica. Encontrar un camino euleriano es fácil: tiempo lineal, con una condición de existencia conocida desde Euler. La alternativa de apariencia natural, construir un grafo en el que cada lectura es un vértice y unir las lecturas que se solapan, exige un recorrido que visite cada vértice una vez, lo que es un camino hamiltoniano y NP-completo. Dos formulaciones de una misma tarea biológica, una tratable y otra inabordable, separadas solo por la decisión de convertir las lecturas en aristas en lugar de vértices.
8. El alineamiento de secuencias es un camino mínimo
Comparar dos secuencias es el cálculo que más se ejecuta en biología. Cada consulta de BLAST lo hace, cada mapeador de lecturas lo hace y cada afirmación de que dos genes son homólogos se apoya en él. El algoritmo estándar es el de Needleman y Wunsch, publicado en 1970 y enseñado en todas partes como programación dinámica sobre una matriz. Vale la pena ver que la matriz es un grafo.
Construye una cuadrícula con un vértice por cada par de posiciones (i, j), que significa «las primeras i letras de la secuencia uno se han alineado con las primeras j letras de la secuencia dos». Desde cada vértice traza tres arcos: a la derecha, para una letra de la secuencia dos frente a un hueco; hacia abajo, para una letra de la secuencia uno frente a un hueco; y en diagonal, para alinear las dos letras. Da a cada arco un coste, cero para una diagonal que coincide y uno en los demás casos. El mejor alineamiento es ahora el camino más barato de la esquina superior izquierda a la inferior derecha, y cualquier algoritmo de camino mínimo lo encuentra.
Alinear GATTACA con GCATGCU construye un grafo en cuadrícula con 64 vértices y 161 arcos. Needleman-Wunsch devuelve una distancia de edición de 4. Una búsqueda de camino mínimo sobre ese grafo, sin ninguna tabla de programación dinámica, devuelve también 4. Coinciden porque son el mismo cálculo: la cuadrícula es acíclica, así que rellenar las celdas en orden es exactamente relajar los arcos en orden topológico.
Verlo como un grafo no es un truco de salón. Explica por qué funciona el algoritmo de alineamiento local de Smith y Waterman de 1981: permitir que un camino empiece de nuevo en cualquier punto equivale a añadir un arco de coste cero desde el origen a cada vértice. Explica las penalizaciones afines por huecos, que necesitan tres capas de cuadrícula en lugar de una porque el estado tiene que recordar si ya hay un hueco abierto. Y explica por qué el alineamiento cuesta el producto de las longitudes de ambas secuencias, ya que ese es el tamaño del grafo, y por eso los alineadores rápidos evitan construir la mayor parte.
9. Filogenética: un árbol entre una cantidad astronómica
Un árbol filogenético es un grafo sin ciclos: las hojas son las especies observadas, los vértices internos son antepasados que no se observaron y las longitudes de las aristas miden la divergencia evolutiva. Reconstruir uno a partir de secuencias actuales es el problema central de inferencia de la biología evolutiva, y su dificultad es un problema de conteo antes que cualquier otra cosa.
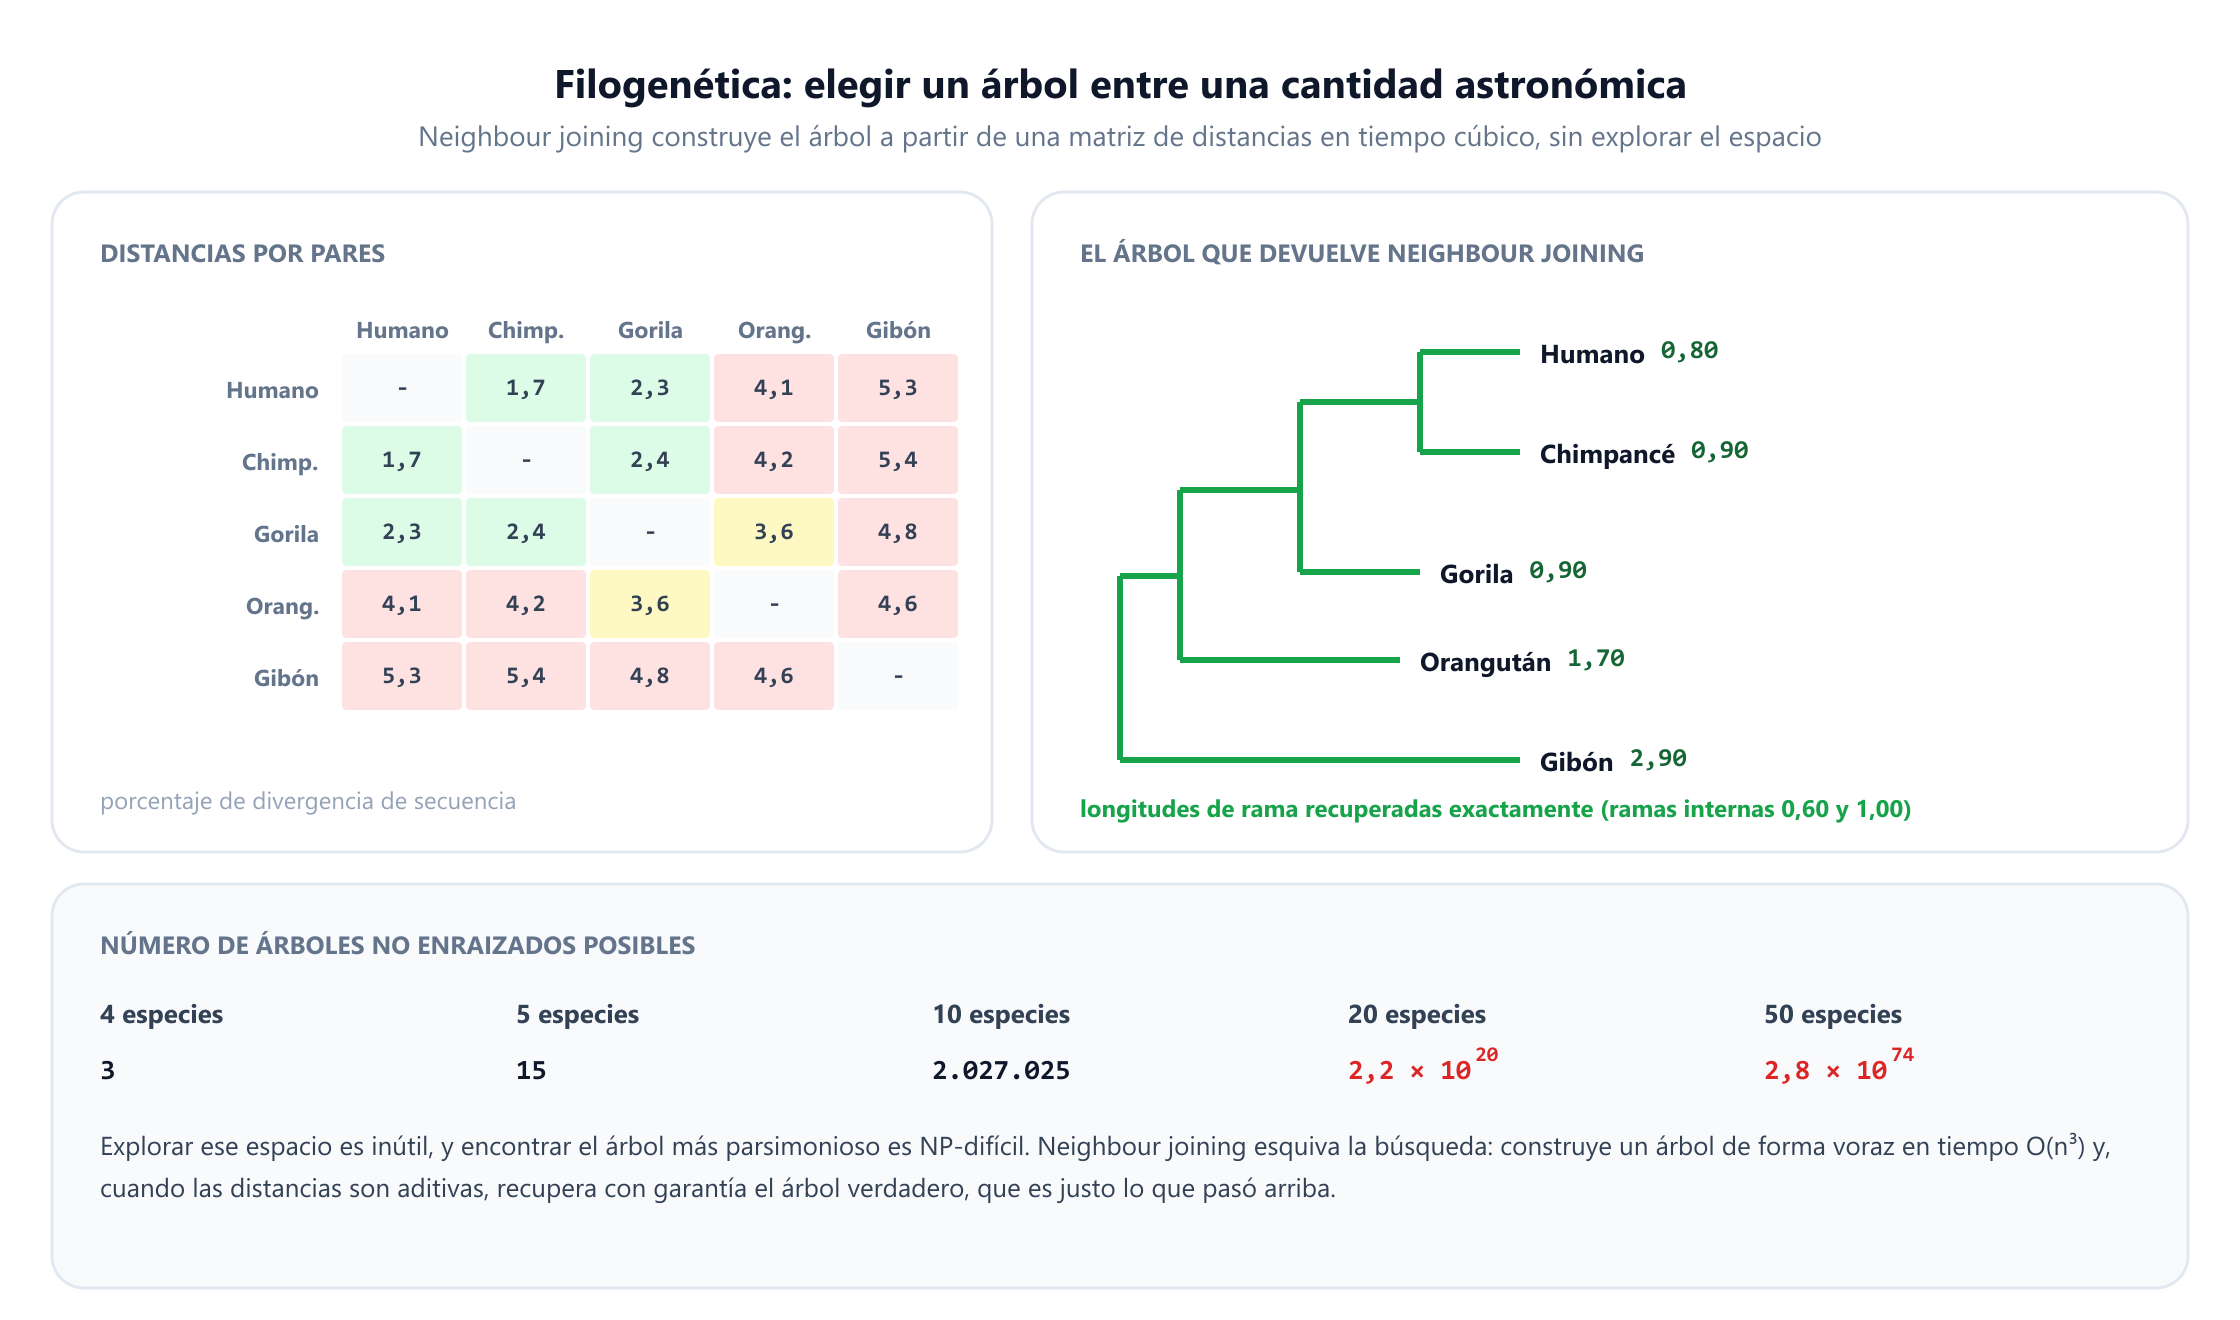
El número de árboles binarios no enraizados distintos sobre n especies, tabulado por Felsenstein en 1978, es el doble factorial (2n-5)!!, y se dispara. Cuatro especies dan 3 árboles. Cinco dan 15. Diez dan 2.027.025. Veinte dan unos 2,2 x 10²⁰. Cincuenta especies dan aproximadamente 2,8 x 1074, que son más árboles que átomos hay en el universo observable, y con mucho margen. Cada uno de ellos es una respuesta candidata, y los estudios filogenéticos suelen abarcar cientos de taxones.
La búsqueda exhaustiva no es, por tanto, solo lenta, sino imposible para siempre, y la situación es aún peor: encontrar el árbol más parsimonioso, el que requiere menos cambios evolutivos, se demostró más tarde NP-difícil, y la búsqueda de árboles por máxima verosimilitud no es mejor.
El neighbour joining de Saitou y Nei, publicado en 1987 y uno de los artículos más citados de toda la biología, esquiva por completo la búsqueda. Toma una matriz de distancias por pares, une repetidamente el par de taxones que un criterio concreto identifica como vecinos y los colapsa en un nodo, hasta que queda un árbol. Nunca enumera alternativas, y se ejecuta en tiempo cúbico.
Sobre la matriz de distancias de cinco primates de la figura, une primero el orangután con el gibón, luego el humano con el chimpancé y después el gorila con el grupo del orangután y el gibón, y recupera cada longitud de rama exactamente. Esa exactitud no es suerte. Cuando las distancias son aditivas, es decir, cuando proceden de algún árbol desde el principio, neighbour joining devuelve con garantía ese árbol. Las distancias reales estimadas a partir de secuencias reales solo son aproximadamente aditivas, por eso la filogenética real usa neighbour joining para obtener un árbol inicial rápido y luego lo refina con un modelo de verosimilitud, y por eso un mismo conjunto de datos puede respaldar árboles publicados distintos.
10. Redes tróficas y cascadas de extinción
Pasa del interior de la célula a un ecosistema entero y las matemáticas no cambian. Una red trófica es un grafo dirigido: un vértice por especie y un arco de la presa al depredador allí donde el segundo se come al primero. Las especies sin presas son basales, es decir, plantas, algas o detritos, y todo lo demás depende en última instancia de ellas.
El modelo tiene doce especies y diecisiete enlaces tróficos, con algas y detritos en la base y una nutria, una garza y un lucio en la cima. Lo primero que da el grafo es el nivel trófico, calculado como uno más el nivel medio de todo lo que come una especie. Las especies basales están en 1,00, los herbívoros en 2,00 y los depredadores superiores quedan en valores fraccionarios: el lucio en 4,50, la nutria en 4,75 y la garza en 4,33. Los niveles fraccionarios no son un artefacto. Son la respuesta honesta para un omnívoro que come en varios niveles a la vez.
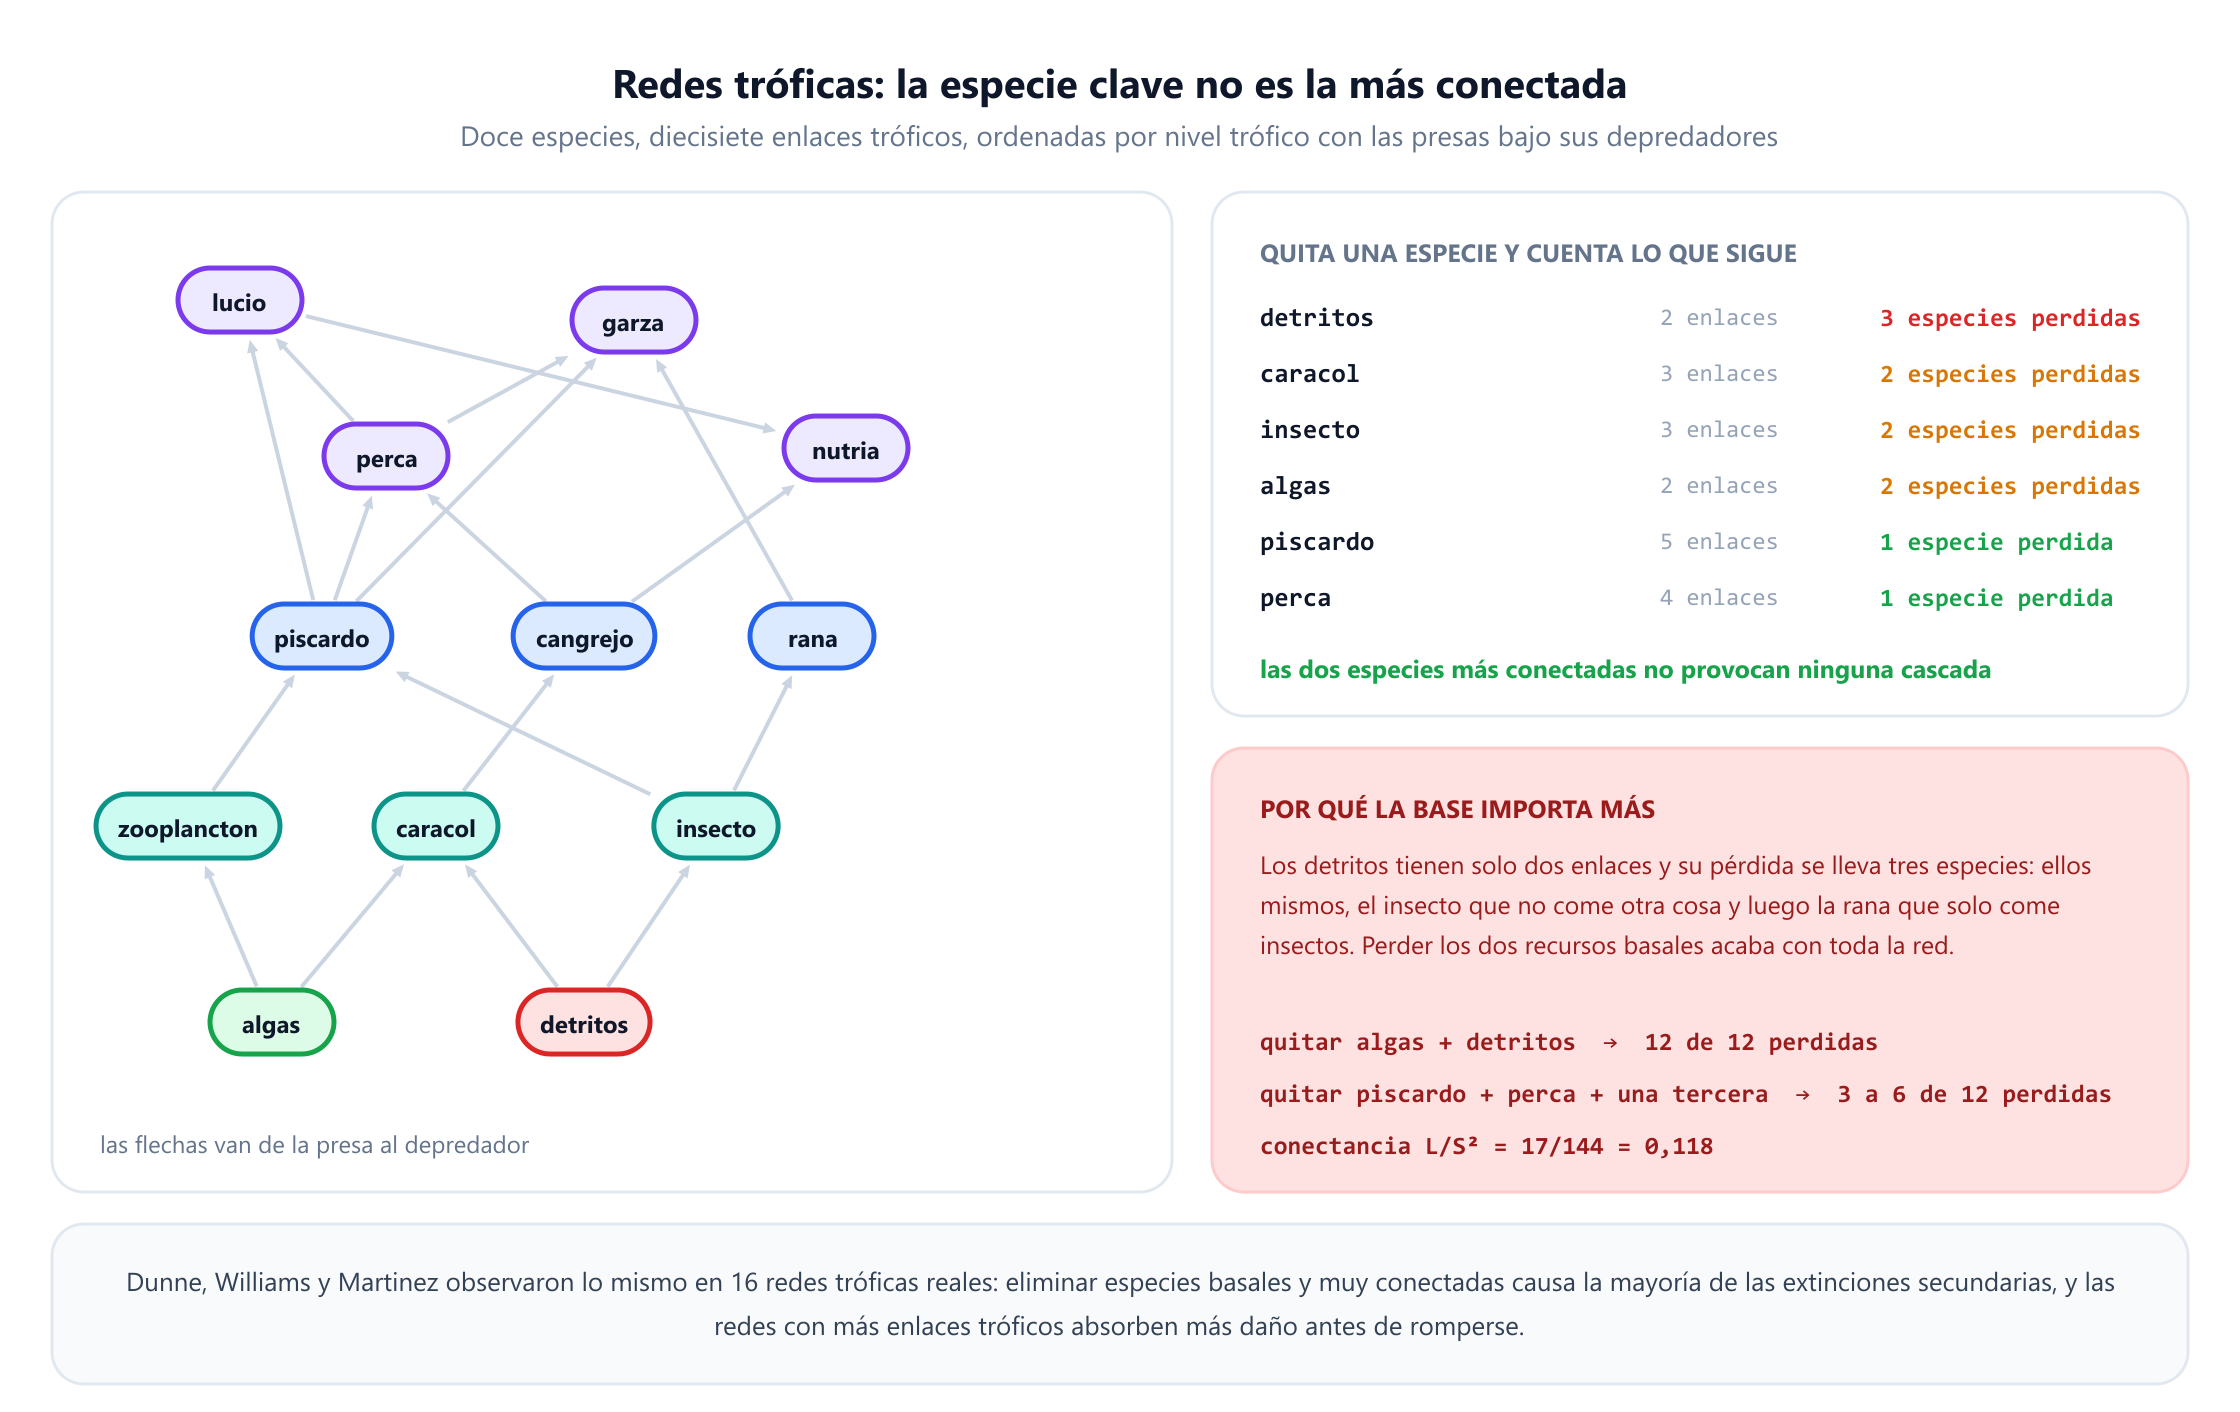
La pregunta que importa para la conservación es qué pasa después de perder una especie. Elimina un vértice, luego elimina toda especie que se quede sin nada que comer y repite hasta que la red se estabilice. Esas pérdidas derivadas son extinciones secundarias, y son la razón por la que los ecosistemas se desploman más rápido de lo que sugeriría la presión directa sobre ellos.
Los resultados en esta red son contraintuitivos de una forma concreta y útil. El piscardo es la especie mejor conectada, con cinco enlaces tróficos. Elimínalo y no muere nada más: todo lo que se comía al piscardo come también otra cosa. Elimina la garza o la nutria, ambas depredadoras superiores, y de nuevo no sigue nada. Ahora elimina los detritos, que solo tienen dos enlaces y no son algo por lo que nadie haga campaña. Desaparecen tres especies en total: los propios detritos, luego el insecto que no come otra cosa y luego la rana que solo come insectos. Un vértice con dos aristas causó más daño que uno con cinco.
El patrón se generaliza. Las especies basales son estructurales porque todo lo que está por encima depende de ellas, mientras que un consumidor muy conectado está en una parte del grafo que ofrece sustitutos. Eliminar las dos especies basales, algas y detritos, cuesta las doce especies. Eliminar las mejor conectadas hace menos daño, y la cifra ni siquiera está bien definida: el piscardo y la perca encabezan los enlaces, pero cinco especies empatan en el tercer puesto, y cuál de ellas añadas mueve el total entre tres y seis. Las dos especies poco llamativas de la base causan al menos el doble de daño.
Dunne, Williams y Martinez describieron exactamente esto en 2002 en dieciséis redes tróficas reales, y añadieron un segundo hallazgo que vale la pena retener: la robustez aumenta con la conectancia, el número de enlaces dividido entre el cuadrado del número de especies. Las redes con más enlaces tróficos absorben más daño antes de fragmentarse, porque más especies tienen alternativas. La red modelada aquí tiene una conectancia de 0,118, de lleno en el rango descrito para redes reales.
La lección práctica es que la priorización en conservación basada en el carisma, el tamaño o incluso el número de enlaces mide la magnitud equivocada. La especie cuya pérdida se propaga se encuentra simulando la eliminación en el grafo, y la respuesta suele ser algo pequeño y poco querido.
11. Conectomas y epidemias
Dos áreas más merecen mención, porque ambas reutilizan herramientas ya presentadas.
Conectomas. Un sistema nervioso es un grafo dirigido y ponderado de neuronas unidas por sinapsis. El primero completo lo publicaron White, Southgate, Thomson y Brenner en 1986: el nematodo C. elegans, 302 neuronas y unas 7.000 conexiones, reconstruido a mano a partir de micrografías electrónicas durante más de una década. El trabajo en humanos opera con menor resolución, con regiones cerebrales como vértices y haces de fibras o actividad correlacionada como aristas, pero el análisis es el de la sección 3: grado, agrupamiento, longitud de camino, módulos, hubs.
Bullmore y Sporns plantearon el programa en 2009, y el hallazgo recurrente es que los cerebros son de mundo pequeño y modulares, con un núcleo densamente interconectado de regiones de grado alto, el «club de los ricos», que lleva una parte desproporcionada del tráfico de larga distancia. Varios trastornos psiquiátricos y neurológicos aparecen como estadísticas de grafo alteradas. Son correlaciones entre grupos, no diagnósticos individuales, y conviene saber que un conectoma funcional depende mucho de un umbral de correlación elegido por el analista, y que las estadísticas se mueven cuando se mueve el umbral.
Epidemias. Las enfermedades se propagan por un grafo de contactos, y su estructura determina el resultado tanto como el patógeno. Pastor-Satorras y Vespignani demostraron en 2001 un resultado sorprendente: en una red con distribución de grados libre de escala y varianza no acotada, el umbral epidémico clásico desaparece. En los modelos de mezcla homogénea de los libros de texto, una infección con una tasa de transmisión lo bastante baja se extingue; en una red así no, porque los hubs la mantienen viva. Eso replanteó la estrategia de vacunación, ya que inmunizar a los individuos de grado alto, o incluso a conocidos de individuos elegidos al azar, que tienen grado alto con más frecuencia de lo esperable, supera a inmunizar al azar con el mismo número de dosis.
Las mismas matemáticas reaparecen en biología celular como propagación de señales y en seguridad informática como propagación de malware. Al grafo le da igual qué representan los vértices.
12. Qué es fácil y qué es difícil
Formular una pregunta biológica como una pregunta sobre grafos no la vuelve resoluble. Hace visible la dificultad, lo cual es más útil, y la frontera cae en lugares sorprendentes.
Fácil, es decir, en tiempo polinómico y rutinario a gran escala. El grado, los coeficientes de agrupamiento y las componentes conexas son prácticamente gratis. Los caminos mínimos, y por tanto el alineamiento, son baratos. La centralidad de intermediación en un grafo disperso se ejecuta en un tiempo proporcional al producto del número de vértices y aristas gracias al algoritmo de Brandes. Los caminos eulerianos son lineales, los árboles generadores y los flujos polinómicos, y neighbour joining es cúbico. Todo lo que se resuelve en este artículo está en esta categoría, y todo escala a grafos con millones de aristas en un portátil.
Difícil, es decir, NP-difícil sin que se espere un algoritmo polinómico. Encontrar el árbol filogenético más parsimonioso. Encontrar el mayor conjunto de especies que interactúan todas entre sí, que es la clique máxima. Decidir si una red es subgrafo de otra, lo que subyace a la búsqueda de motivos con patrones grandes. Encontrar un camino hamiltoniano, la razón por la que se abandonó la formulación por solapamiento del ensamblaje. La partición óptima de grafos, en su forma exacta.
Dos observaciones hacen la frontera menos desalentadora de lo que parece. Primero, los problemas difíciles en biología suelen atacarse con heurísticas que funcionan bien en los casos que de verdad se presentan: la filogenética escala colinas a partir de un árbol de neighbour joining, y los buscadores de motivos enumeran con astucia, lo que basta para patrones de tres y cuatro vértices. Segundo, la diferencia entre la formulación tratable y la intratable de una misma tarea biológica suele ser solo una decisión de modelado, como muestra en el ensamblaje la decisión de tratar los k-meros como aristas. Reconocer de qué lado de la línea estás antes de escribir código es la mayor parte del beneficio.
13. Errores de modelado
Cinco errores explican la mayoría de las conclusiones equivocadas que se sacan de las redes biológicas. Ninguno es exótico y todos siguen apareciendo en publicaciones.
Tratar un agregado como una instantánea. Una red PPI publicada es la unión de muchos experimentos, en distintos tipos celulares, en distintas condiciones y a lo largo de décadas. Sus aristas nunca coexistieron. Calcular caminos mínimos sobre ella supone que cada interacción está disponible a la vez, lo que es falso. Donde haya datos específicos de condición, filtra por ellos; donde no los haya, trata las conclusiones basadas en caminos como hipótesis.
Ignorar el sesgo de estudio. Las proteínas muy estudiadas tienen más interacciones conocidas porque más gente las ha buscado, no necesariamente porque tengan más socios reales. Cualquier análisis que concluya que «las proteínas más conectadas son las importantes» está redescubriendo en parte la historia de publicaciones del campo. La prueba es si tu resultado sobrevive cuando la red se restringe a un único cribado sin sesgo.
Comparar con el modelo nulo equivocado. Es la lección de los motivos de la sección 6 y se generaliza a todo. Las redes biológicas reales tienen hubs y distribuciones de grado de cola pesada. Compara cualquier estadística estructural con un grafo aleatorio uniforme y parecerá extraordinaria. La comparación tiene que conservar los rasgos que no estás poniendo a prueba, lo que normalmente significa conservar la secuencia de grados.
Leer una correlación como una arista. Las redes de coexpresión génica unen genes cuyos niveles de expresión se correlacionan entre muestras. La correlación no es regulación, y el grafo resultante es no dirigido mientras que la regulación es dirigida. Estas redes son útiles para generar hipótesis y sistemáticamente engañosas si se leen como mecanismo. La misma cautela se aplica a los conectomas funcionales construidos a partir de actividad cerebral correlacionada.
Sobreinterpretar lo de libre de escala. La observación de que las redes biológicas tienen distribuciones de grado de cola pesada es sólida e importante. La afirmación más fuerte, que siguen una ley de potencias limpia, se ha cuestionado repetidamente por motivos estadísticos, en particular por Broido y Clauset en 2019, que encontraron que las leyes de potencias estrictas son raras en miles de redes empíricas. Las conclusiones útiles de este artículo, la esencialidad de los hubs y la asimetría entre error y ataque, solo necesitan la cola pesada, no la forma funcional exacta. Afirma la cola, no la ley.
14. Del modelo a la práctica
Un procedimiento breve para quien esté a punto de construir uno de estos grafos con datos reales.
Escribe qué es un vértice y qué significa una arista, en una frase cada uno, antes de tocar los datos. La mayoría de los análisis confusos se remontan a un grafo en el que las aristas significan dos cosas distintas, «se une a» mezclado con «está correlacionado con», o «come» mezclado con «compite con». Si la frase cuesta escribirla, el grafo no está listo.
Decide dirigido o no dirigido, ponderado o no ponderado, por razones biológicas. No según lo que el software tenga por defecto. Cada métrica posterior hereda esta elección, y una puntuación de intermediación calculada sobre un grafo que debía ser dirigido no es una aproximación, es otra magnitud.
Calcula primero las estadísticas descriptivas baratas. Número de vértices y aristas, distribución de grados, número de componentes, coeficiente de agrupamiento, longitud de camino. Llevan segundos y detectan problemas de datos al instante: una segunda componente inesperada suele indicar identificadores que no coinciden, y un grado medio sospechosamente alto suele indicar aristas duplicadas.
Elige el modelo nulo antes de calcular la estadística que te interesa. No después de ver el resultado.
Perturba y vuelve a ejecutar. Quita al azar el 10 % de las aristas y recalcula tu conclusión principal. Las redes biológicas son incompletas y ruidosas, y una clasificación que se reordena cuando se elimina una décima parte de los datos es una propiedad de la muestra y no del organismo.
Si quieres desarrollar intuición sobre los algoritmos detrás de todo esto antes de aplicarlos a datos biológicos, los visualizadores interactivos de este sitio te permiten ejecutar la búsqueda en anchura, el algoritmo de Dijkstra y la construcción de árboles generadores mínimos paso a paso sobre grafos que tú mismo dibujas, que es la forma más rápida de hacerse una idea de lo que realmente hacen estos métodos.
15. Preguntas frecuentes
¿Cómo se usa la teoría de grafos en biología?
+
Allí donde los objetos biológicos interactúan. Las proteínas que se unen forman una red no dirigida, los genes que se regulan entre sí forman una dirigida, las lecturas de ADN forman un grafo de De Bruijn cuyo camino euleriano es el genoma ensamblado, las especies y sus antepasados forman un árbol evolutivo, y las especies que se comen unas a otras forman una red trófica. En cada caso la biología aporta los vértices y las aristas, y los algoritmos estándar responden a las preguntas: qué componentes son esenciales, qué patrones están sobrerrepresentados, qué secuencia explica las lecturas, qué árbol explica las distancias y qué extinción desencadena una cascada.
¿Qué es una proteína hub y por qué importan los hubs?
+
Un hub es una proteína con muchos más socios de interacción que la media. Importan por un resultado experimental: Jeong, Mason, Barabasi y Oltvai mostraron en 2001 que las proteínas de levadura con más socios tienen bastante más probabilidad de ser esenciales, es decir, de que la célula muera sin ellas. Los hubs también explican por qué las redes se comportan de forma tan distinta ante el daño aleatorio y el dirigido. En la red libre de escala de este artículo, eliminar al azar el 20 % de las proteínas deja conectado el 78 % de la red, mientras que eliminar el 20 % de mayor grado deja el 9 %.
¿Qué es un motivo de red?
+
Un subgrafo pequeño que aparece más a menudo en una red real que en redes aleatorizadas con exactamente los mismos grados. La aleatorización es la clave: comparar con un grafo aleatorio corriente hace que casi cualquier patrón parezca significativo, porque las redes reales tienen hubs y las aleatorias no. En la red de ocho genes de este artículo, el bucle feed-forward aparece cinco veces frente a una media aleatorizada de 1,80 y una desviación estándar de 1,22, una puntuación z de 2,63, y solo 17 de 1.000 copias aleatorizadas llegan a cinco o más. Los motivos importan porque su función se puede deducir: el bucle feed-forward coherente ignora los pulsos breves y solo responde a señales sostenidas.
¿Por qué el ensamblaje de genomas es un problema de camino euleriano?
+
Por cómo se construye el grafo. Se trocea cada lectura en subcadenas solapadas de longitud k y luego cada k-mero se convierte en una arista que va del vértice formado por sus primeras k-1 letras al vértice formado por sus últimas k-1 letras. Usar cada lectura exactamente una vez pasa a significar usar cada arista exactamente una vez, lo que es un camino euleriano, y eso se resuelve en tiempo lineal. La alternativa natural, convertir cada lectura en un vértice y unir las lecturas que se solapan, exige visitar cada vértice una vez, lo que es un camino hamiltoniano y NP-completo. La misma tarea biológica es tratable o inabordable según las lecturas se conviertan en aristas o en vértices.
¿Por qué las repeticiones vuelven ambiguo el ensamblaje?
+
Porque una secuencia repetida hace que el recorrido llegue al mismo vértice más de una vez, y las lecturas no contienen información sobre por dónde salir de él primero. En este artículo, la secuencia AGGGTGGTTGGC leída en 4-meros produce un grafo con dos caminos eulerianos, que forman AGGGTGGTTGGC y AGGGTTGGTGGC, ambos totalmente coherentes con todas las lecturas. Ningún algoritmo puede elegir entre ellos, porque la ambigüedad está en los datos y no en el método. Leer la misma secuencia en 6-meros da exactamente una reconstrucción, y por eso la longitud de lectura importa más que el número de lecturas y la secuenciación de lecturas largas cambió el ensamblaje.
¿Cuántos árboles filogenéticos hay y cómo encuentran uno los biólogos?
+
El número de árboles binarios no enraizados sobre n especies es el doble factorial (2n-5)!!, que crece más allá de cualquier posibilidad de búsqueda: 3 árboles para cuatro especies, 15 para cinco, 2.027.025 para diez, unos 2,2 x 10^20 para veinte y aproximadamente 2,8 x 10^74 para cincuenta. Encontrar el árbol más parsimonioso es NP-difícil. Neighbour joining, publicado por Saitou y Nei en 1987, evita buscar: une repetidamente el par más cercano según un criterio concreto y construye un único árbol en tiempo cúbico. Cuando las distancias son aditivas recupera con garantía el árbol verdadero, que es exactamente lo que ocurre con la matriz de cinco primates de este artículo, donde cada longitud de rama se recupera exactamente.
¿Qué especie importa más en una red trófica?
+
No la mejor conectada. En la red de doce especies de este artículo, el piscardo tiene más enlaces tróficos, cinco, y eliminarlo no causa ninguna extinción secundaria, porque todo lo que se lo comía come también otra cosa. Eliminar los detritos, que solo tienen dos enlaces, cuesta tres especies: los detritos, luego el insecto que no come otra cosa y luego la rana que solo come insectos. Eliminar las dos especies basales hace perder las doce, mientras que eliminar las dos mejor conectadas más una tercera cualquiera hace perder entre tres y seis. La importancia es una propiedad de la posición en el grafo, y hay que encontrarla simulando la eliminación, no contando enlaces.
¿Son de verdad libres de escala las redes biológicas?
+
Tienen distribuciones de grado de cola pesada, y eso está bien establecido. La afirmación más fuerte de que siguen una ley de potencias limpia se ha cuestionado por motivos estadísticos, en particular por Broido y Clauset en 2019, que encontraron que las leyes de potencias estrictas son raras en miles de redes empíricas. Esto importa menos de lo que parece, porque las conclusiones que se usan solo necesitan la cola pesada: una distribución en la que la mayoría de los vértices tiene pocas aristas y una pequeña minoría tiene muchas basta para producir la esencialidad de los hubs y la asimetría entre fallo aleatorio y ataque dirigido. La postura segura es afirmar la cola y no la ley.
16. Referencias
Los artículos que respaldan los resultados de este artículo, en orden cronológico.
- Sylvester, J. J. (1878). “Chemistry and algebra.” Nature, 17, 284.
- Needleman, S. B. y Wunsch, C. D. (1970). “A general method applicable to the search for similarities in the amino acid sequence of two proteins.” Journal of Molecular Biology, 48(3), 443–453.
- Freeman, L. C. (1977). “A set of measures of centrality based upon betweenness.” Sociometry, 40(1), 35–41.
- Felsenstein, J. (1978). “The number of evolutionary trees.” Systematic Zoology, 27(1), 27–33.
- Smith, T. F. y Waterman, M. S. (1981). “Identification of common molecular subsequences.” Journal of Molecular Biology, 147(1), 195–197.
- White, J. G., Southgate, E., Thomson, J. N. y Brenner, S. (1986). “The structure of the nervous system of the nematode Caenorhabditis elegans.” Philosophical Transactions of the Royal Society B, 314(1165), 1–340.
- Saitou, N. y Nei, M. (1987). “The neighbor-joining method: a new method for reconstructing phylogenetic trees.” Molecular Biology and Evolution, 4(4), 406–425.
- Watts, D. J. y Strogatz, S. H. (1998). “Collective dynamics of small-world networks.” Nature, 393, 440–442.
- Albert, R., Jeong, H. y Barabási, A.-L. (2000). “Error and attack tolerance of complex networks.” Nature, 406, 378–382.
- Jeong, H., Tombor, B., Albert, R., Oltvai, Z. N. y Barabási, A.-L. (2000). “The large-scale organization of metabolic networks.” Nature, 407, 651–654.
- Jeong, H., Mason, S. P., Barabási, A.-L. y Oltvai, Z. N. (2001). “Lethality and centrality in protein networks.” Nature, 411, 41–42.
- Brandes, U. (2001). “A faster algorithm for betweenness centrality.” Journal of Mathematical Sociology, 25(2), 163–177.
- Pevzner, P. A., Tang, H. y Waterman, M. S. (2001). “An Eulerian path approach to DNA fragment assembly.” Proceedings of the National Academy of Sciences, 98(17), 9748–9753.
- Pastor-Satorras, R. y Vespignani, A. (2001). “Epidemic spreading in scale-free networks.” Physical Review Letters, 86(14), 3200–3203.
- Milo, R., Shen-Orr, S., Itzkovitz, S., Kashtan, N., Chklovskii, D. y Alon, U. (2002). “Network motifs: simple building blocks of complex networks.” Science, 298(5594), 824–827.
- Shen-Orr, S. S., Milo, R., Mangan, S. y Alon, U. (2002). “Network motifs in the transcriptional regulation network of Escherichia coli.” Nature Genetics, 31(1), 64–68.
- Dunne, J. A., Williams, R. J. y Martinez, N. D. (2002). “Network structure and biodiversity loss in food webs: robustness increases with connectance.” Ecology Letters, 5(4), 558–567.
- Barabási, A.-L. y Oltvai, Z. N. (2004). “Network biology: understanding the cell's functional organization.” Nature Reviews Genetics, 5(2), 101–113.
- Yildirim, M. A., Goh, K.-I., Cusick, M. E., Barabási, A.-L. y Vidal, M. (2007). “Drug-target network.” Nature Biotechnology, 25(10), 1119–1126.
- Bullmore, E. y Sporns, O. (2009). “Complex brain networks: graph theoretical analysis of structural and functional systems.” Nature Reviews Neuroscience, 10(3), 186–198.
- Compeau, P. E. C., Pevzner, P. A. y Tesler, G. (2011). “How to apply de Bruijn graphs to genome assembly.” Nature Biotechnology, 29(11), 987–991.
- Broido, A. D. y Clauset, A. (2019). “Scale-free networks are rare.” Nature Communications, 10, 1017.