
Table des Matières
- 1. Pourquoi la biologie est pleine de graphes
- 2. Quatre graphes, quatre questions différentes
- 3. Réseaux de protéines : hubs, ponts et intermédiarité
- 4. Robuste aux accidents, fragile face aux attaques
- 5. Les modules, et pourquoi le clustering signifie une fonction
- 6. Régulation génique : les motifs de réseau
- 7. Assemblage de génome : parcourir chaque arête une fois
- 8. L'alignement de séquences est un plus court chemin
- 9. Phylogénétique : un arbre parmi un nombre astronomique
- 10. Réseaux trophiques et cascades d'extinction
- 11. Connectomes et épidémies
- 12. Ce qui est facile, ce qui est difficile
- 13. Erreurs de modélisation
- 14. Du modèle à la pratique
- 15. Questions fréquentes
- 16. Références
1. Pourquoi la biologie est pleine de graphes
La biologie a passé l'essentiel de son histoire à dresser des listes. Une liste de gènes, une liste d'enzymes, une liste des espèces d'un lac. Les listes se sont allongées, puis complétées, et les compléter a révélé quelque chose de dérangeant : connaître chaque pièce d'un système dit remarquablement peu de choses sur ce que fait le système. Le génome humain a été achevé en 2003 et le nombre de gènes codant des protéines s'est révélé d'environ 20 000, pas très loin de celui d'un ver nématode doté de 302 neurones. La liste des pièces n'allait jamais être l'explication.
Ce qui distingue un humain d'un ver, et une cellule saine d'une cellule cancéreuse, ce n'est pas quels composants existent, mais quels composants interagissent avec lesquels. Cette phrase est la définition d'un graphe. Un graphe est un ensemble de choses accompagné d'un ensemble de connexions entre elles, et rien d'autre. Dès que vous notez quelles protéines se lient à lesquelles, quel gène en active un autre ou quelle espèce en mange une autre, vous avez cessé de dresser une liste pour commencer à dessiner un graphe, que vous employiez le mot ou non.
Ce n'est ni une métaphore ni un style de présentation. C'est important parce que les graphes arrivent avec deux siècles de mathématiques. Dès qu'une question biologique est formulée comme une question de graphes, un vaste corpus de théorèmes et d'algorithmes devient disponible d'un coup, et des problèmes qui semblent exiger une biologie nouvelle se révèlent exiger plutôt un algorithme existant. L'assemblage de génome, le processus qui transforme des centaines de millions de courts fragments d'ADN en chromosome, est un parcours qui emprunte chaque arête d'un graphe exactement une fois. Euler a réglé ce problème en 1736 pour les ponts d'une ville prussienne, et c'est le même problème.
L'habitude est plus ancienne qu'on ne le croit. Le mot graphe dans ce sens technique a été forgé par le mathématicien James Joseph Sylvester en 1878, par analogie avec les schémas de structure chimique : des molécules dessinées comme des atomes reliés par des liaisons. La chimie a donné à la théorie des graphes une partie de son vocabulaire, et un siècle plus tard la biologie moléculaire lui a donné certains de ses plus grands jeux de données.
Ce guide passe en revue six systèmes biologiques : un réseau d'interactions protéiques, un réseau de régulation génique, un génome assemblé à partir de lectures, une paire de séquences en cours d'alignement, un ensemble d'espèces placées sur un arbre évolutif et un réseau trophique qui perd ses espèces une à une. Chacun reste assez petit pour être vérifié à la main et se résout avec un algorithme connu. Chaque nombre de cette page est sorti d'un code réellement exécuté, et chaque résultat a été recalculé par une seconde méthode, différente, avant d'être écrit.
2. Quatre graphes, quatre questions différentes
Avant de construire quoi que ce soit, il vaut la peine de préciser quel type de graphe produit chaque système biologique, car le type décide quelles questions peuvent même être posées. Quatre distinctions font presque tout le travail.
Orienté ou non orienté. Si deux protéines se lient, la relation est symétrique : « A se lie à B » et « B se lie à A » sont le même fait, donc les réseaux d'interactions protéiques sont non orientés. Si un facteur de transcription active un gène, la relation va dans un seul sens, donc les réseaux de régulation génique sont orientés. Ce n'est pas de la comptabilité. Les graphes non orientés ont des composantes connexes ; les graphes orientés ont l'accessibilité, les cycles et la rétroaction, et la rétroaction est la substance même de la régulation. Demander si un réseau génique contient un cycle, c'est demander s'il contient une boucle de rétroaction, et la réponse change la biologie.
Pondéré ou non pondéré. Une arête de réseau trophique peut simplement exister, ou porter la biomasse qui circule le long d'elle. Les graphes de similarité de séquences portent un score sur chaque arête. Les poids permettent de demander le meilleur chemin plutôt que n'importe lequel, et c'est ce qui fait de l'alignement un problème de plus court chemin à la section 8.
Statique ou dynamique. Presque tous les réseaux de cet article sont dessinés comme s'ils étaient figés. Les vraies cellules ne le sont pas. Une interaction présente dans une cellule du foie peut ne pas exister dans un neurone, et les interactions apparaissent et disparaissent au fil du cycle cellulaire. Traiter un agrégat moyenné dans le temps comme si toutes ses arêtes étaient présentes simultanément est l'erreur de modélisation la plus courante du domaine, et la section 13 y revient.
Biparti ou non. Certaines données biologiques comportent deux types de sommets avec des arêtes seulement entre types : médicaments et cibles, hôtes et parasites, gènes et maladies associées. Les graphes bipartis apportent leurs propres algorithmes, avant tout le couplage, et c'est souvent ainsi que sont formulés les criblages de repositionnement de médicaments.
Réglez correctement ces quatre points et le reste suit. Trompez-vous et vous calculerez un nombre dépourvu de sens d'une façon contre laquelle aucun logiciel ne vous mettra en garde.
3. Réseaux de protéines : hubs, ponts et intermédiarité
Un réseau d'interactions protéiques, abrégé réseau PPI, compte un sommet par protéine et une arête non orientée partout où deux protéines se lient physiquement. Les versions à grande échelle sont construites par criblage double hybride chez la levure ou par purification d'affinité suivie de spectrométrie de masse, et les réseaux publiés pour la levure et l'humain comptent des dizaines de milliers d'arêtes. Plutôt que d'évoquer quelque chose d'énorme, nous en utiliserons un petit : douze protéines et dix-huit interactions, assez petit pour que chaque affirmation ci-dessous se vérifie en comptant.
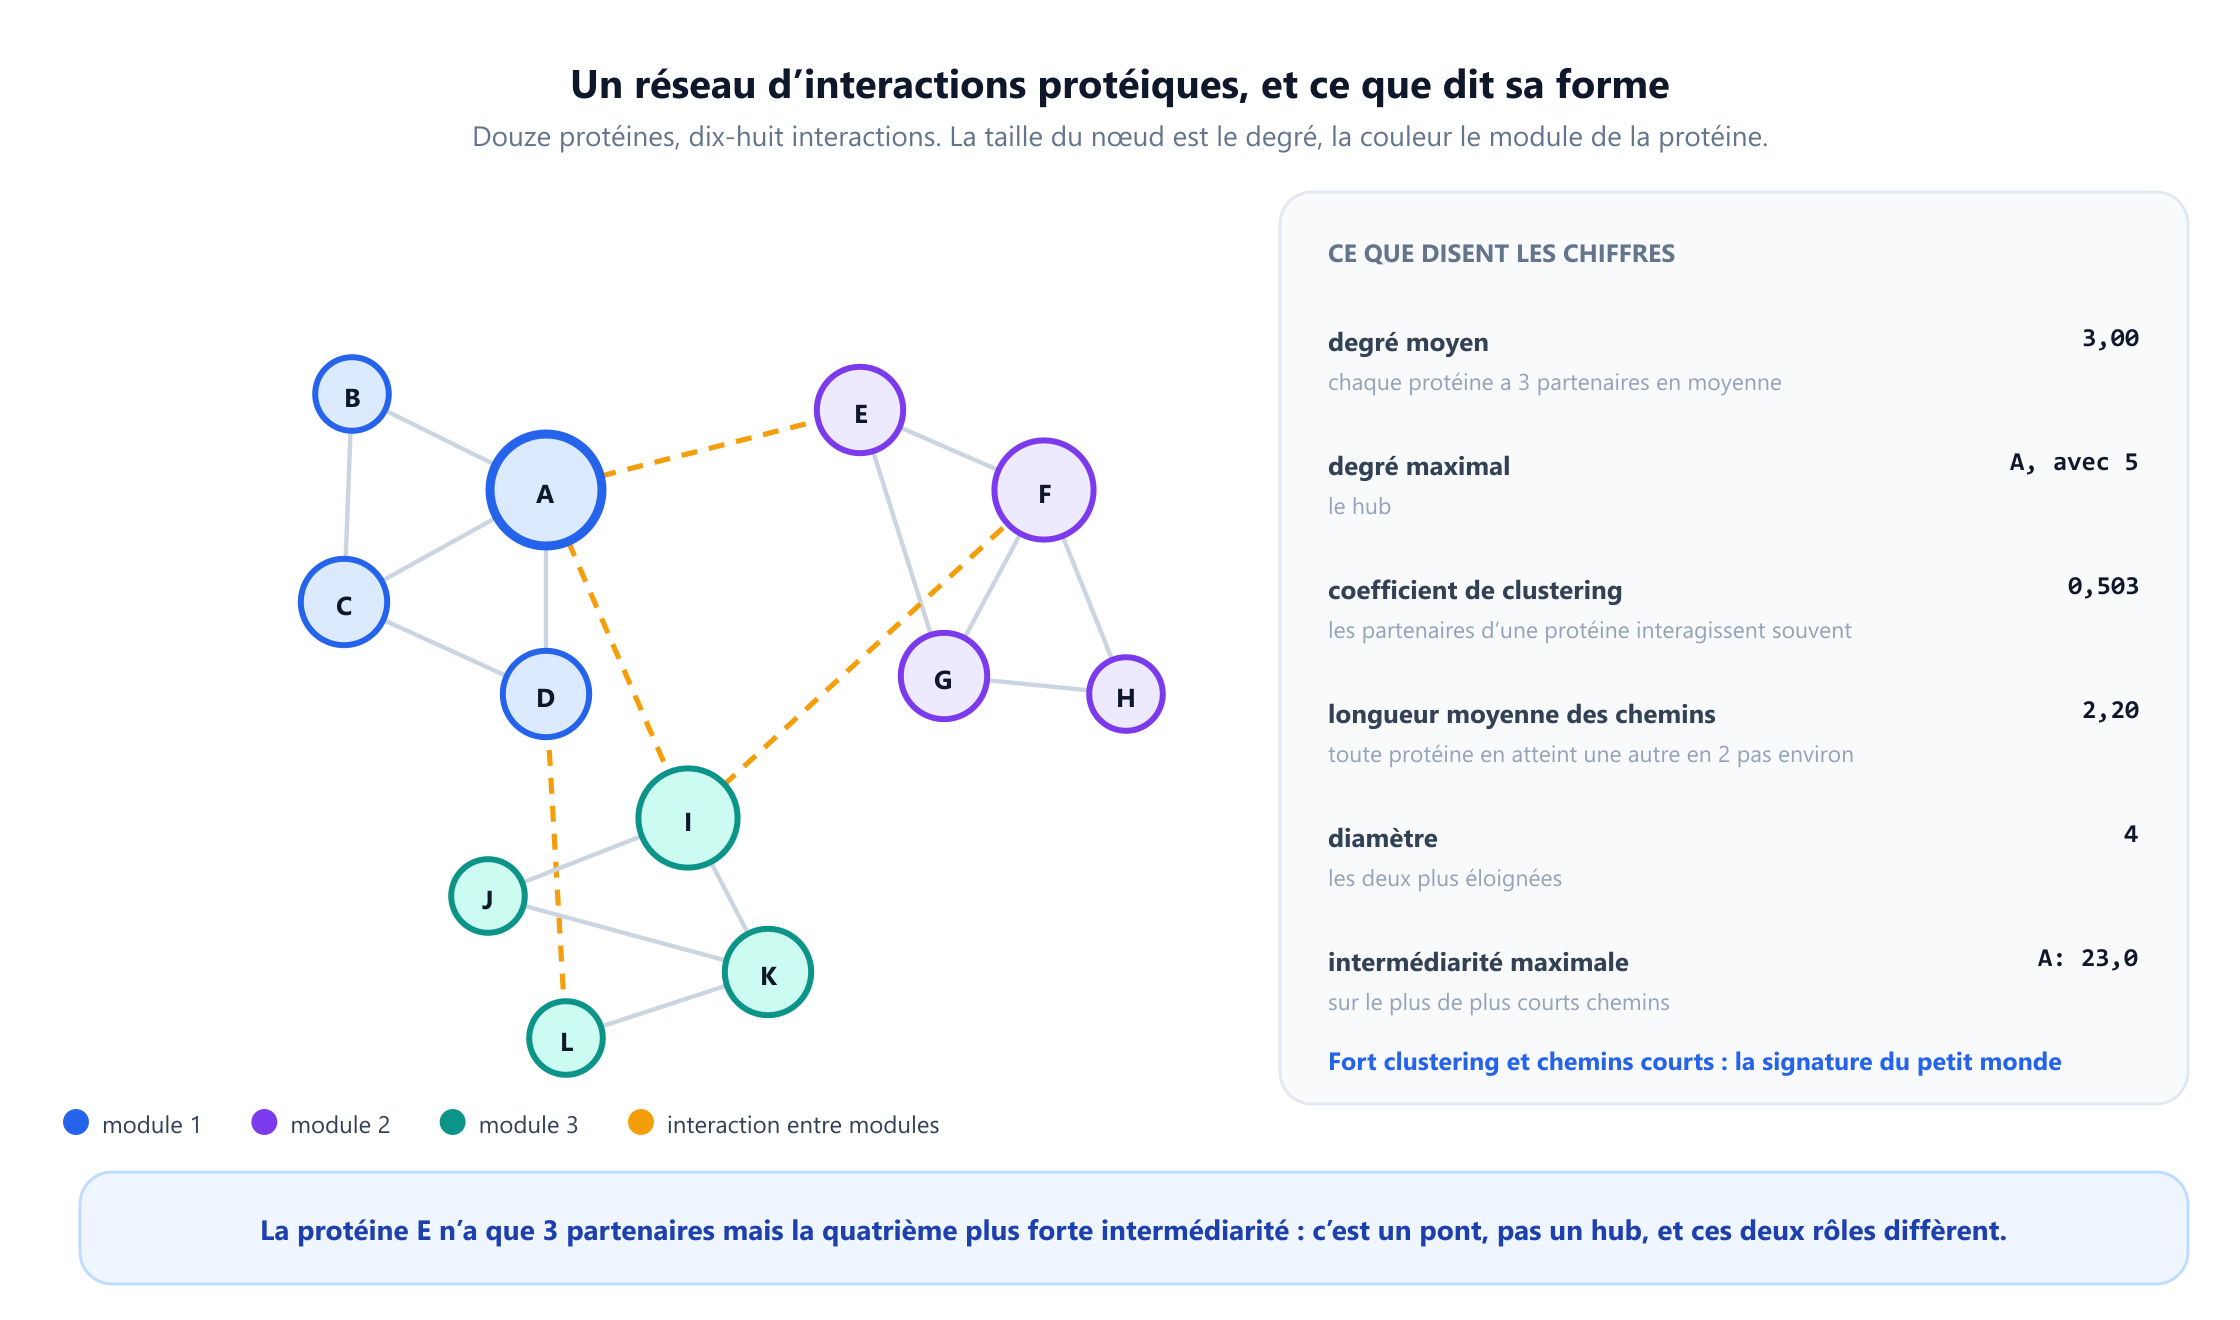
La première chose à mesurer est le degré, le nombre de partenaires d'une protéine. Ici, les degrés vont de A:5, à F et I avec 4, à un groupe de cinq avec 3 et à une queue de quatre avec 2, pour une moyenne de 3,0. Dans les vrais réseaux PPI, cette distribution est bien plus inégale : la plupart des protéines ont une poignée de partenaires et une petite minorité en a des centaines. Les réseaux de cette forme sont dits sans échelle, un terme popularisé par Barabasi et Oltvai dans leur revue de 2004, et la minorité de haut degré, ce sont les hubs.
Les hubs comptent pour une raison établie expérimentalement plutôt que par un argument théorique. En 2001, Jeong, Mason, Barabasi et Oltvai ont comparé le réseau PPI de la levure à la bibliothèque de délétions de la levure, dans laquelle chaque gène a été inactivé à tour de rôle et la cellule obtenue classée viable ou morte. Les protéines ayant plus de partenaires d'interaction étaient nettement plus souvent essentielles. L'article s'intitule Lethality and centrality in protein networks, et la corrélation qu'il rapporte explique pourquoi le degré est devenu la première chose que l'on calcule sur un réseau biologique.
Le degré n'est pas la seule forme d'importance, et c'est là qu'un petit exemple mérite sa place. Considérez la protéine E. Elle a trois partenaires et, dans toute liste triée par degré, elle passe inaperçue. Calculez maintenant la centralité d'intermédiarité, qui compte, sur toutes les paires de protéines, quelle fraction des plus courts chemins entre elles passe par un sommet donné. Freeman a introduit cette mesure en 1977 pour les réseaux sociaux. Sur ce graphe, le classement par intermédiarité est A à 23,0, I à 19,8, F à 12,2, puis E à 9,2, devant plusieurs protéines qui ont plus de partenaires qu'elle.
E obtient un score élevé grâce à sa position, pas au nombre de ses voisins. C'est la porte d'entrée du deuxième module, donc le trafic entre le premier module et le deuxième doit passer par elle. En termes de réseaux, E est un pont et non un hub, et la distinction a une lecture biologique : les protéines ponts sont des candidates à la communication croisée entre voies, et en retirer une supprime moins une fonction qu'elle ne sépare deux fonctions l'une de l'autre. Un classement par degré seul ne la ferait jamais ressortir.
Deux autres nombres décrivent le graphe entier plutôt qu'un sommet isolé. La longueur moyenne des plus courts chemins vaut 2,197 et le diamètre, le plus long de tous les plus courts chemins, vaut 4 : toute protéine en atteint une autre en au plus quatre pas. Les vrais réseaux PPI se comportent de la même façon à bien plus grande échelle, avec des milliers de protéines et une longueur de chemin caractéristique autour de 5. C'est la propriété de petit monde formalisée par Watts et Strogatz en 1998, et à l'intérieur d'une cellule elle a une conséquence brutale. Une perturbation n'importe où se trouve à quelques pas de partout, ce qui explique en grande partie pourquoi un médicament visant une seule protéine produit si régulièrement des effets que personne n'avait prévus.
4. Robuste aux accidents, fragile face aux attaques
Le résultat le plus cité de la biologie des réseaux ne porte sur aucune protéine en particulier. Il porte sur ce qui se passe quand on commence à les supprimer, et il a été publié par Albert, Jeong et Barabasi dans Nature en 2000 sous le titre Error and attack tolerance of complex networks.
L'expérience est simple à énoncer. Prenez un réseau, retirez des sommets et, après chaque retrait, mesurez la taille de la plus grande composante restante. Faites-le deux fois : une fois en retirant des sommets uniformément au hasard, ce qui modélise les accidents et les mutations, et une fois en les retirant par ordre décroissant de degré, ce qui modélise une attaque délibérée. Puis comparez les courbes.
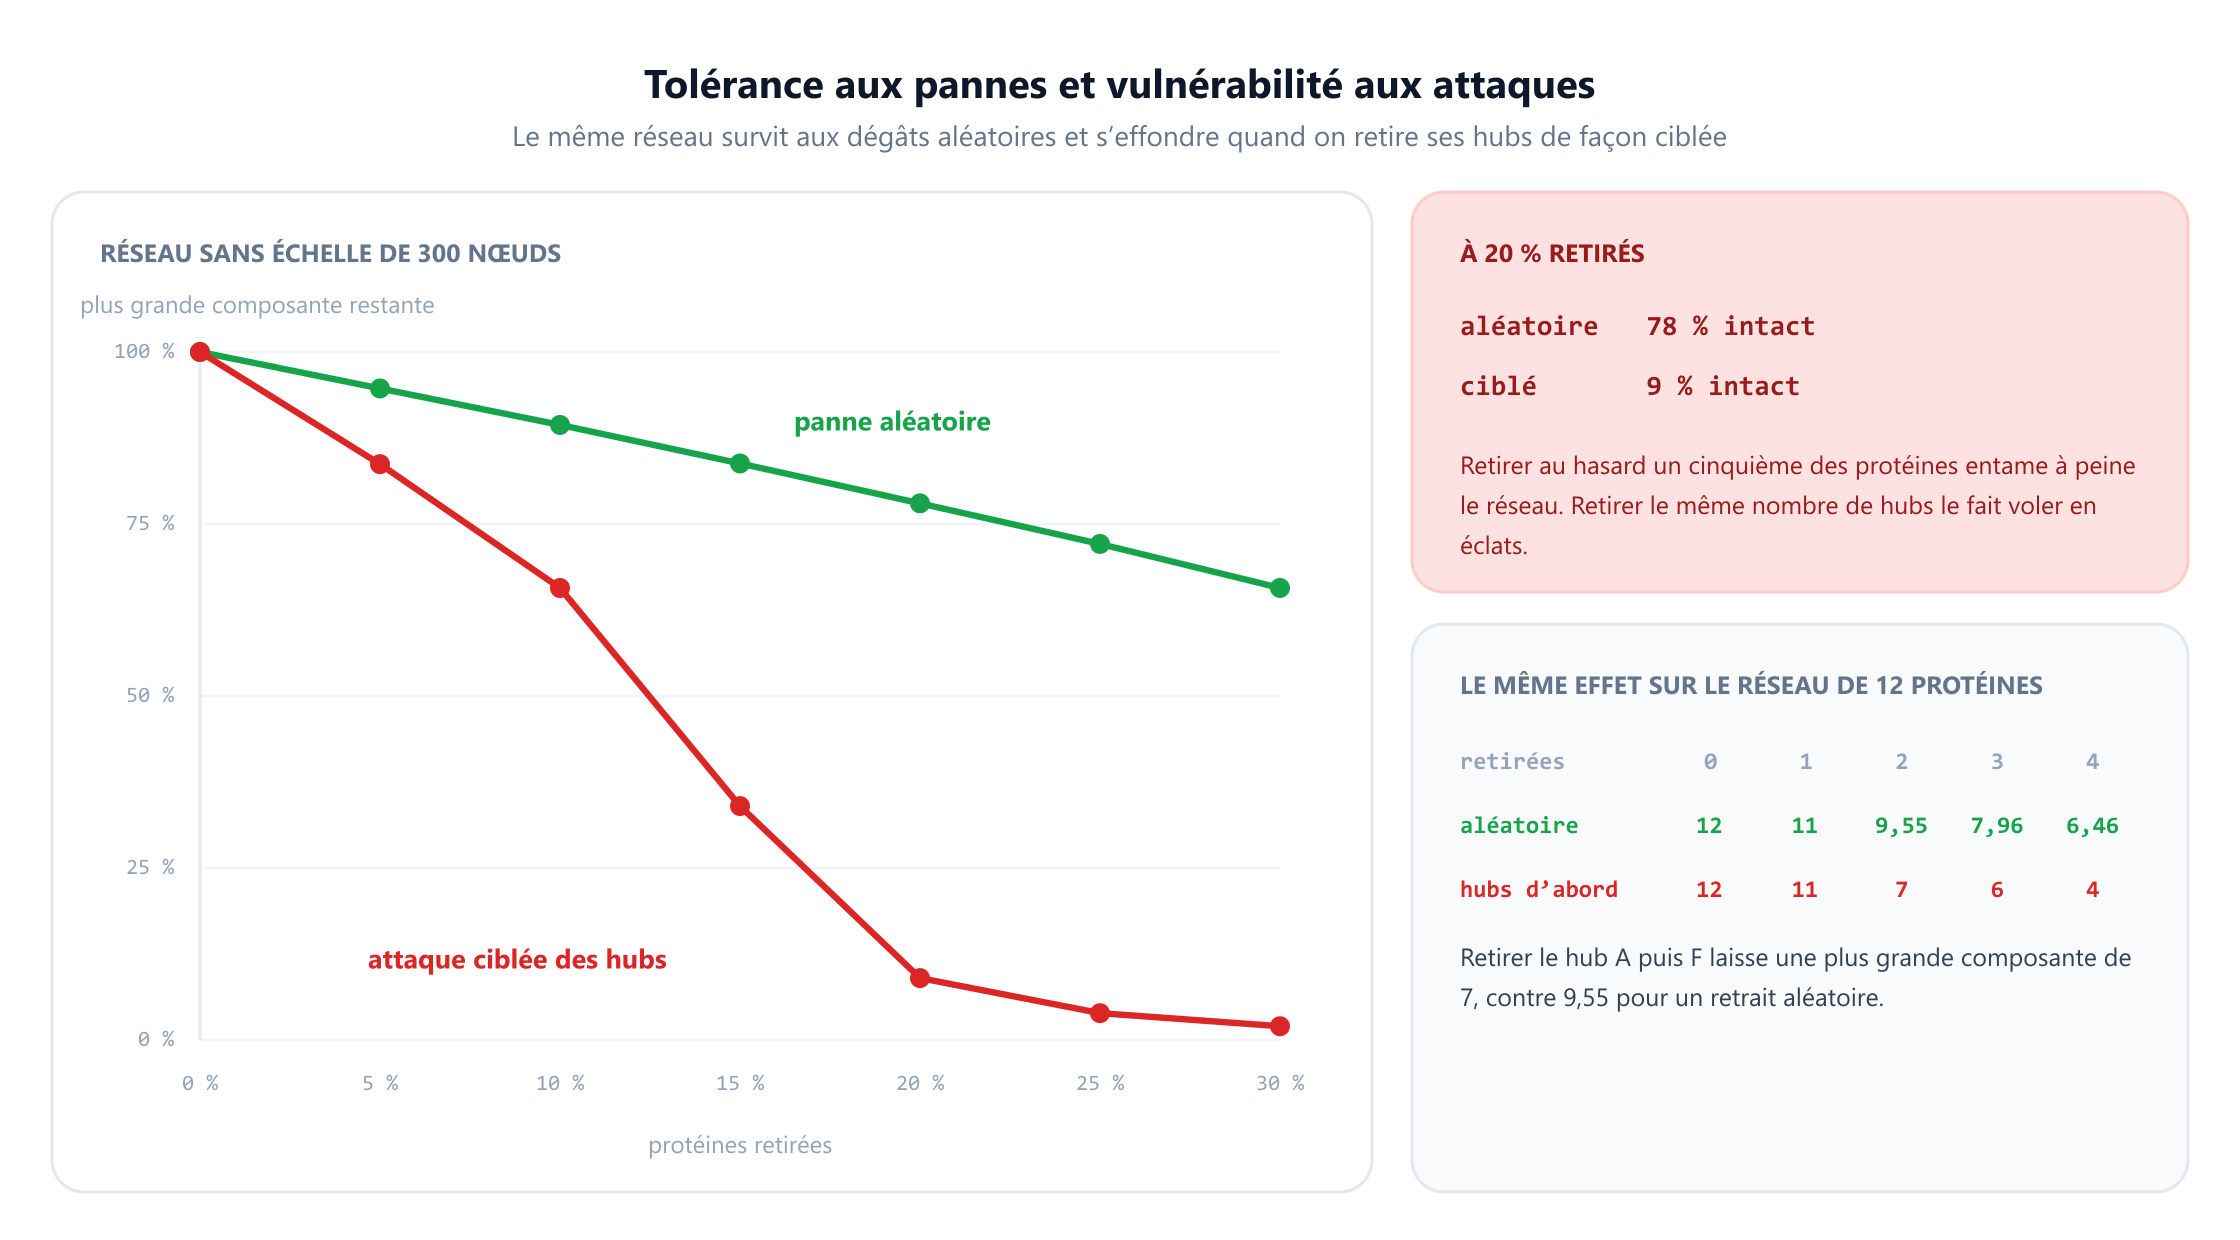
Sur un réseau sans échelle de 300 sommets construit par attachement préférentiel, retirer au hasard 20 % des sommets laisse 78 % du réseau encore connecté d'un seul tenant. Retirer les 20 % de plus haut degré en laisse 9 %. Le réseau qui avait encaissé la première attaque a été détruit par la seconde, et la seule différence entre les deux était le choix des sommets.
Le réseau de douze protéines montre la même asymétrie à une échelle que vous pouvez vérifier à la main. Retirer des protéines au hasard, en moyenne sur tous les choix possibles, laisse des plus grandes composantes de 12, 11, 9,55, 7,96 et 6,46 quand le nombre de retraits passe de zéro à quatre. Retirer les hubs par ordre décroissant de degré, c'est-à-dire ici A, puis F, puis I, puis C, laisse 12, 11, 7, 6 et 4. Deux suppressions bien choisies coûtent plus que quatre suppressions aléatoires.
L'explication tient à la distribution des degrés. Dans un réseau sans échelle, l'immense majorité des sommets a un degré faible, donc un retrait aléatoire touche presque sûrement un sommet périphérique dont la perte ne déconnecte personne. Les rares hubs maintiennent tout l'ensemble, et en supprimer un retire beaucoup d'arêtes d'un coup. La robustesse face aux dégâts aléatoires et la fragilité face aux dégâts ciblés ne sont pas deux propriétés en tension. C'est une seule propriété vue sous deux angles.
Les lectures biologiques vont dans les deux sens. Côté fragilité, cela explique pourquoi les protéines hubs sont surreprésentées parmi les protéines essentielles, et pourquoi l'oncologie a passé deux décennies à chercher les hubs dont dépend une tumeur. Côté robustesse, cela explique pourquoi les organismes tolèrent une énorme charge de mutations aléatoires sans conséquence visible, et pourquoi l'inactivation d'un seul gène ne produit si souvent aucun phénotype. Cette dernière observation a frustré toute une génération de généticiens : la plupart des gènes ne sont pas porteurs, et ceux qui le sont peuvent être repérés par leur position dans le graphe.
5. Les modules, et pourquoi le clustering signifie une fonction
Regardez à nouveau le réseau de douze protéines et vous verrez trois groupes à l'œil nu. Les protéines A à D sont étroitement liées entre elles, E à H forment un deuxième groupe, I à L un troisième, et seules quatre arêtes relient les groupes. Derrière cette impression visuelle se cache un nombre.
Le coefficient de clustering d'un sommet pose une question précise : parmi toutes les paires de mes voisins, quelle fraction est elle-même connectée ? Si une protéine a quatre partenaires, il existe six paires parmi eux, et le coefficient est la fraction de ces six paires qui se lient entre elles. En moyenne sur les douze protéines, ce réseau obtient 0,503, c'est-à-dire qu'environ la moitié des triangles qui pourraient se fermer se ferment. Un graphe aléatoire avec le même nombre de sommets et d'arêtes obtient environ 0,23. Les vrais réseaux PPI sont aussi fortement groupés, tout comme les réseaux métaboliques, les réseaux neuronaux et les réseaux trophiques.
C'est un fort clustering qui donne son sens au mot module. Des protéines qui se lient toutes entre elles accomplissent généralement une tâche ensemble : elles forment un complexe, appartiennent à une même voie ou sont recrutées au même endroit au même moment. C'est l'inférence la plus utile de la biologie des réseaux appliquée, car elle permet d'annoter une protéine inconnue à partir de ses voisines. Si une protéine de fonction inconnue se trouve dans un groupe dont tous les autres membres s'occupent de la réparation de l'ADN, la réparation de l'ADN est la première hypothèse à tester. Des chaînes de traitement entières reposent sur cette idée, et ce sont des algorithmes de détection de communautés affublés de noms biologiques.
Une mise en garde s'impose ici. Un module trouvé par un algorithme est une hypothèse, pas une découverte. L'algorithme partitionne tout ce qu'on lui donne, et il renverra tout aussi volontiers des modules à partir de données aléatoires.
6. Régulation génique : les motifs de réseau
Les réseaux de régulation génique sont orientés. Un arc du gène X vers le gène Y signifie que la protéine produite par X se lie au promoteur de Y et modifie la quantité de Y produite. Comme les arcs ont un sens, les structures intéressantes sont des schémas de flux plutôt que des voisinages denses, et en 2002 deux articles du groupe d'Uri Alon ont changé la façon de les lire.
L'idée est la suivante. Prenez un petit sous-graphe, par exemple trois gènes câblés selon un schéma donné, et comptez combien de fois il apparaît dans le vrai réseau. Ce compte seul ne veut rien dire, car certains schémas sont fréquents simplement en raison du nombre d'arcs de chaque gène. Générez donc de nombreux réseaux randomisés avec exactement les mêmes degrés, en échangeant à répétition les extrémités de paires d'arcs, et comptez le schéma dans chacun. Si le compte réel se situe loin dans la queue de cette distribution, le schéma est un motif de réseau : il apparaît plus souvent que les degrés seuls ne peuvent l'expliquer, ce qui indique que la sélection l'a placé là.
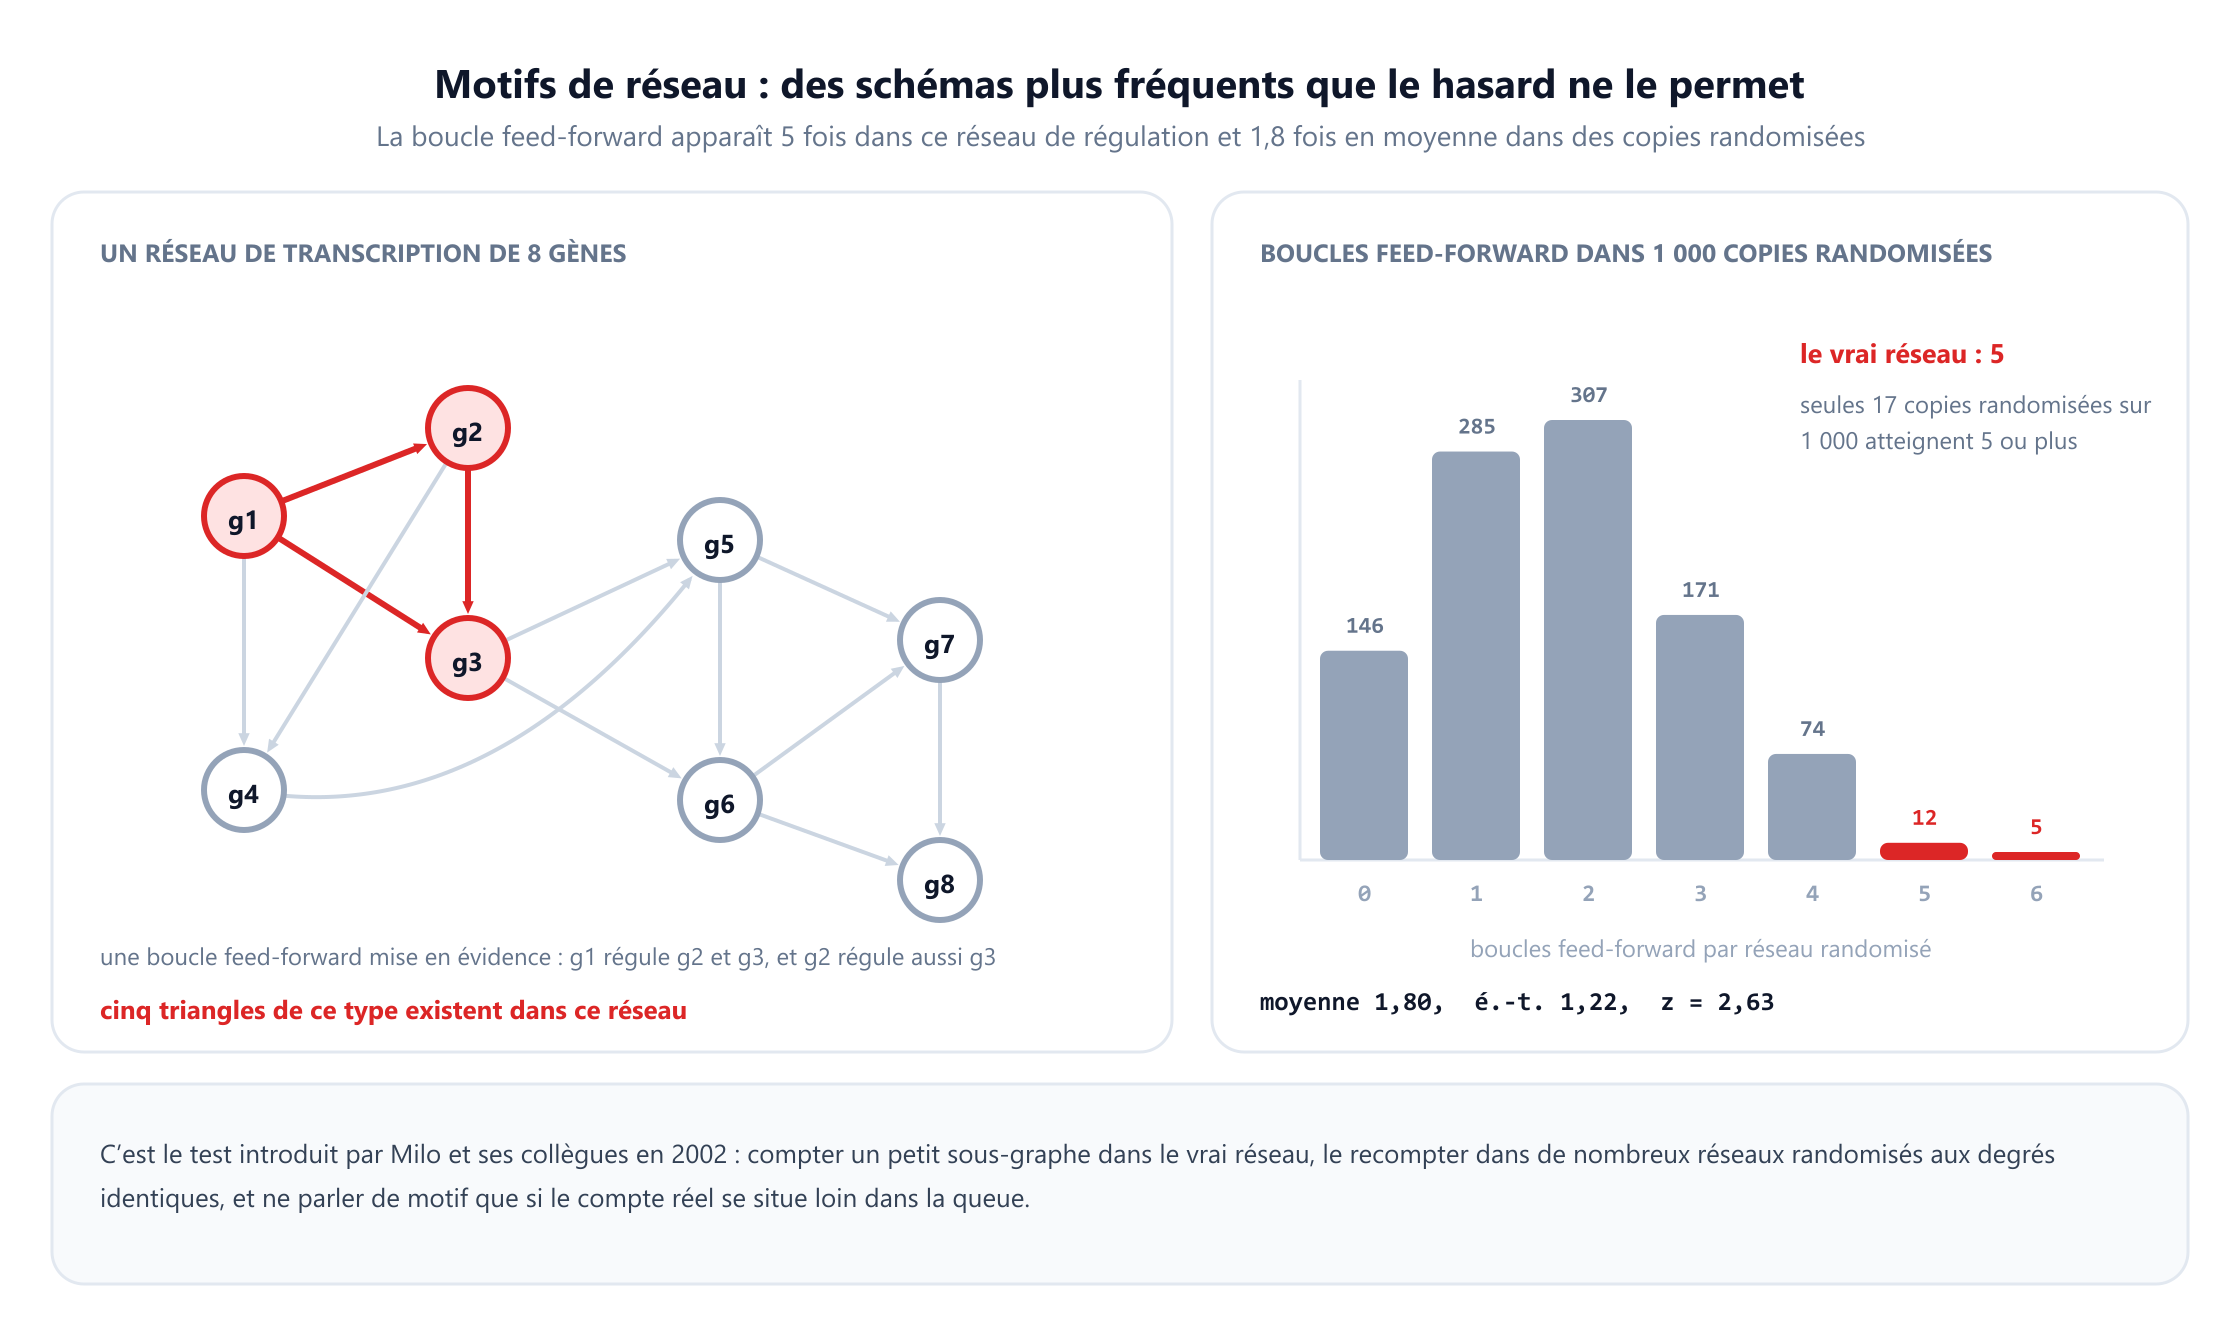
Le schéma de la figure est la boucle feed-forward : le gène X régule Y, X régule aussi Z directement, et Y régule également Z. Dans le réseau de huit gènes présenté ici, elle apparaît cinq fois. Sur 1 000 randomisations préservant les degrés, le compte moyen était de 1,80 avec un écart-type de 1,22, soit un score z de 2,63, et seulement 17 sur 1 000 réseaux randomisés en contenaient cinq ou plus. Sur un réseau aussi petit, c'est suggestif plutôt que concluant ; dans le vrai réseau de transcription de la bactérie E. coli, Shen-Orr, Milo et Alon ont trouvé le même schéma avec des scores z de plusieurs dizaines, ce qui n'a rien d'un résultat limite.
Ce qui rend la boucle feed-forward intéressante, c'est que sa fonction peut se déduire au lieu de se deviner. Dans la version cohérente, où X active à la fois Y et Z et où Y active aussi Z, le gène Z ne s'allume que lorsque X et Y sont tous deux présents. Comme Y met du temps à s'accumuler après l'apparition de X, Z ignore les brèves impulsions de X et ne répond qu'aux signaux soutenus. Le motif est un détecteur de persistance, un filtre anti-bruit fait de trois gènes. Changez les signes et vous obtenez à la place un générateur d'impulsions ou une réponse accélérée. Le câblage est le mécanisme.
Milo et ses collègues ont constaté que différents types de réseaux se caractérisent par différents motifs : les réseaux de transcription sont riches en boucles feed-forward, les réseaux neuronaux en un autre ensemble, les réseaux trophiques en un autre encore. Ils ont soutenu que les motifs sont les circuits élémentaires à partir desquels le réseau est construit, et l'idée s'est imposée, parce que les statistiques sont vérifiables et parce que les circuits font quelque chose.
Un point de méthode vaut bien au-delà de la biologie. La randomisation doit préserver les degrés. Comparez à un graphe aléatoire ordinaire et presque tout ressemble à un motif, car les vrais réseaux ont des hubs et les réseaux aléatoires n'en ont pas, et les hubs à eux seuls produisent un excès de chaque schéma à trois nœuds. Se tromper de modèle nul est la façon habituelle dont cette analyse échoue.
7. Assemblage de génome : parcourir chaque arête une fois
Les séquenceurs ne savent pas lire un chromosome. Ils lisent de courts fragments, d'environ 100 bases sur un instrument à lectures courtes jusqu'à des dizaines de milliers sur un instrument à lectures longues, prélevés à des positions aléatoires sur de nombreuses copies du génome. Un génome humain arrive sous forme de centaines de millions de ces fragments, sans aucune trace de leur provenance. L'assemblage consiste à les remettre ensemble, et la solution moderne est un graphe.
La construction est due à Pevzner, Tang et Waterman en 2001, et elle est assez élégante pour s'énoncer en deux phrases. On découpe chaque lecture en sous-chaînes chevauchantes de longueur k, appelées k-mers. Puis on construit un graphe dans lequel chaque k-mer est une arête, allant du sommet formé par ses k-1 premières lettres au sommet formé par ses k-1 dernières lettres. Reconstruire la séquence revient désormais à trouver un parcours qui emprunte chaque arête exactement une fois, c'est-à-dire un chemin eulérien.
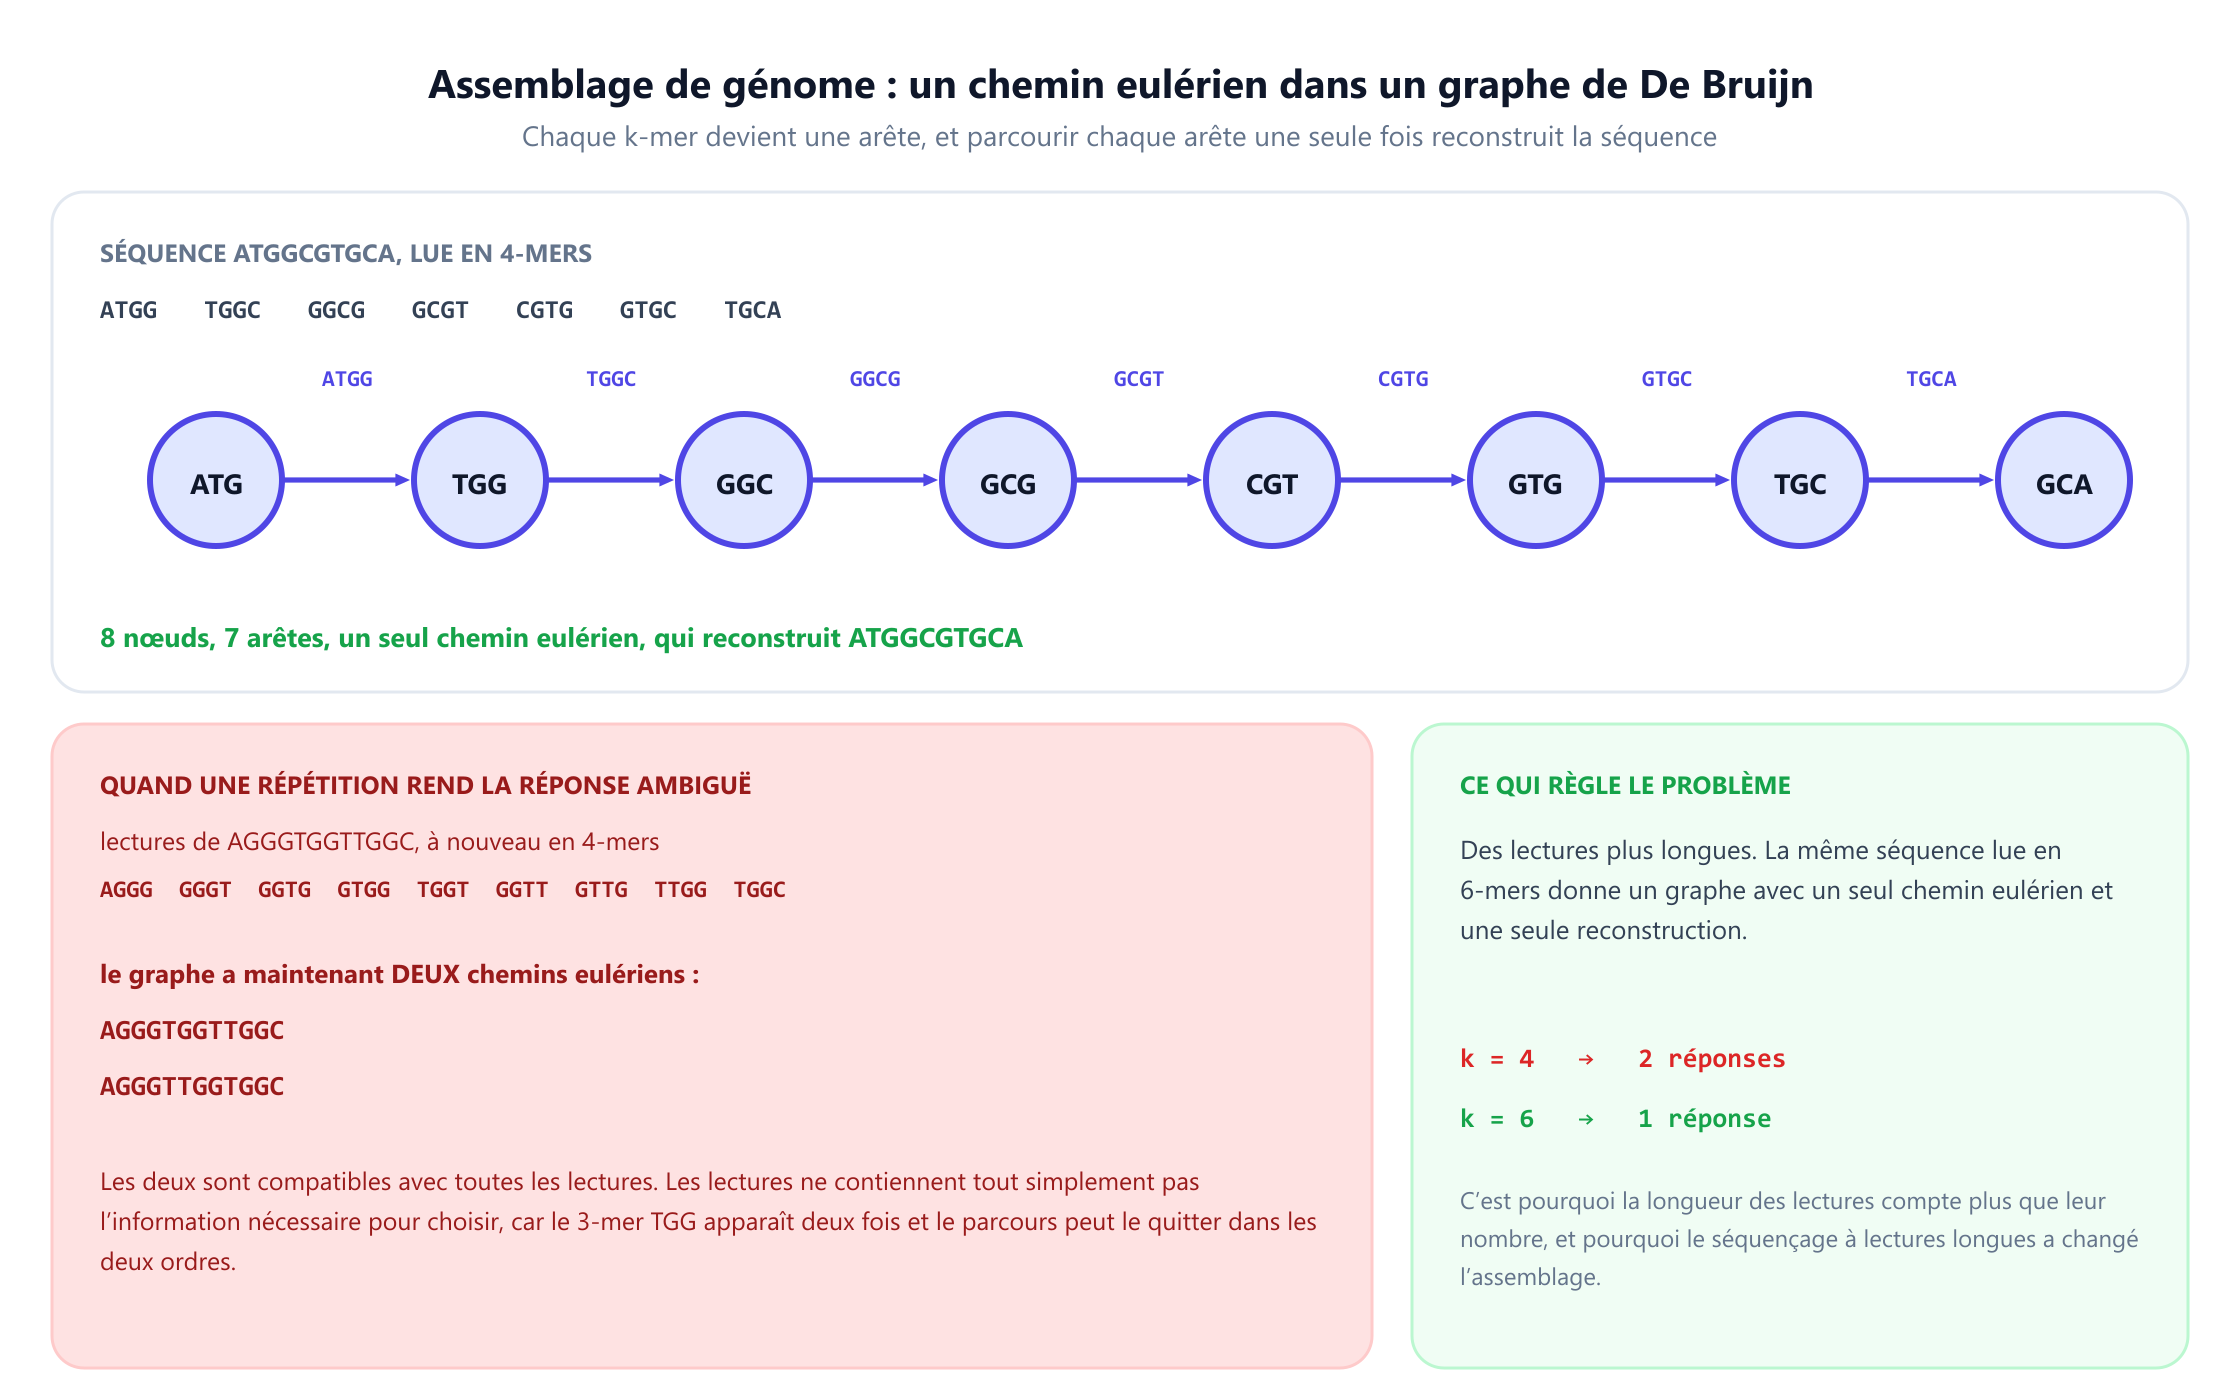
Prenez la séquence ATGGCGTGCA et lisez-la en 4-mers. Cela donne sept k-mers, un graphe à 8 sommets et 7 arêtes, et exactement un chemin eulérien, qui réécrit la séquence d'origine. L'assemblage a réussi, et il a réussi parce que le graphe avait une réponse unique.
Prenez maintenant AGGGTGGTTGGC, là encore en 4-mers. Le graphe a deux chemins eulériens, qui donnent AGGGTGGTTGGC et AGGGTTGGTGGC. Les deux sont compatibles avec chaque lecture observée. Ce n'est pas un échec de l'algorithme, et aucun meilleur algorithme ne peut y remédier : le 3-mer TGG apparaît deux fois, le parcours atteint ce sommet plus d'une fois, et les lectures ne disent rien du côté par lequel le quitter la première fois. L'ambiguïté est dans les données.
Ce qui la lève, ce sont des lectures plus longues. Lire la même séquence en 6-mers produit un graphe avec exactement un chemin eulérien et une seule reconstruction. C'est pour cela que l'industrie du séquençage court depuis quinze ans après la longueur des lectures plutôt que leur nombre, et pour cela que le génome humain n'a été déclaré complet, sans lacune d'un télomère à l'autre, qu'en 2022, plus de vingt ans après le premier brouillon. Les pièces manquantes étaient des répétitions, et les répétitions sont précisément les structures qui rendent un parcours eulérien ambigu.
Il y a là un joli morceau d'histoire algorithmique. Trouver un chemin eulérien est facile : temps linéaire, avec une condition d'existence connue depuis Euler. L'alternative d'apparence naturelle, construire un graphe dans lequel chaque lecture est un sommet et relier les lectures qui se chevauchent, exige un parcours qui visite chaque sommet une fois, c'est-à-dire un chemin hamiltonien, NP-complet. Deux formulations d'une même tâche biologique, l'une traitable et l'autre sans espoir, séparées seulement par la décision de faire des lectures des arêtes plutôt que des sommets.
8. L'alignement de séquences est un plus court chemin
Comparer deux séquences est le calcul le plus exécuté de la biologie. Chaque requête BLAST le fait, chaque outil de cartographie de lectures le fait, et chaque affirmation que deux gènes sont homologues repose sur lui. L'algorithme de référence est celui de Needleman et Wunsch, publié en 1970 et enseigné partout comme de la programmation dynamique sur une matrice. Il vaut la peine de voir que la matrice est un graphe.
Construisez une grille avec un sommet pour chaque paire de positions (i, j), qui signifie « les i premières lettres de la séquence un ont été alignées sur les j premières lettres de la séquence deux ». De chaque sommet partent trois arcs : vers la droite, pour une lettre de la séquence deux face à un trou ; vers le bas, pour une lettre de la séquence un face à un trou ; et en diagonale, pour aligner les deux lettres. Donnez à chaque arc un coût, zéro pour une diagonale qui correspond et un sinon. Le meilleur alignement est alors le chemin le moins coûteux du coin supérieur gauche au coin inférieur droit, et n'importe quel algorithme de plus court chemin le trouve.
Aligner GATTACA sur GCATGCU construit un graphe en grille de 64 sommets et 161 arcs. Needleman-Wunsch renvoie une distance d'édition de 4. Une recherche de plus court chemin sur ce graphe, sans aucune table de programmation dynamique, renvoie aussi 4. Ils concordent parce que c'est le même calcul : la grille est acyclique, donc remplir les cases dans l'ordre revient exactement à relâcher les arcs dans l'ordre topologique.
Le voir comme un graphe n'est pas un tour de passe-passe. Cela explique pourquoi l'algorithme d'alignement local de Smith et Waterman de 1981 fonctionne : permettre à un chemin de repartir de zéro n'importe où revient à ajouter un arc de coût nul de la source vers chaque sommet. Cela explique les pénalités de trous affines, qui exigent trois couches de grille au lieu d'une, parce que l'état doit se souvenir si un trou est déjà ouvert. Et cela explique pourquoi l'alignement coûte le produit des longueurs des deux séquences, puisque c'est la taille du graphe, et pourquoi les aligneurs rapides évitent d'en construire la majeure partie.
9. Phylogénétique : un arbre parmi un nombre astronomique
Un arbre phylogénétique est un graphe sans cycle : les feuilles sont les espèces observées, les sommets internes des ancêtres que l'on n'a pas observés, et les longueurs d'arêtes mesurent la divergence évolutive. En reconstruire un à partir de séquences actuelles est le problème d'inférence central de la biologie évolutive, et sa difficulté est un problème de dénombrement avant toute autre chose.
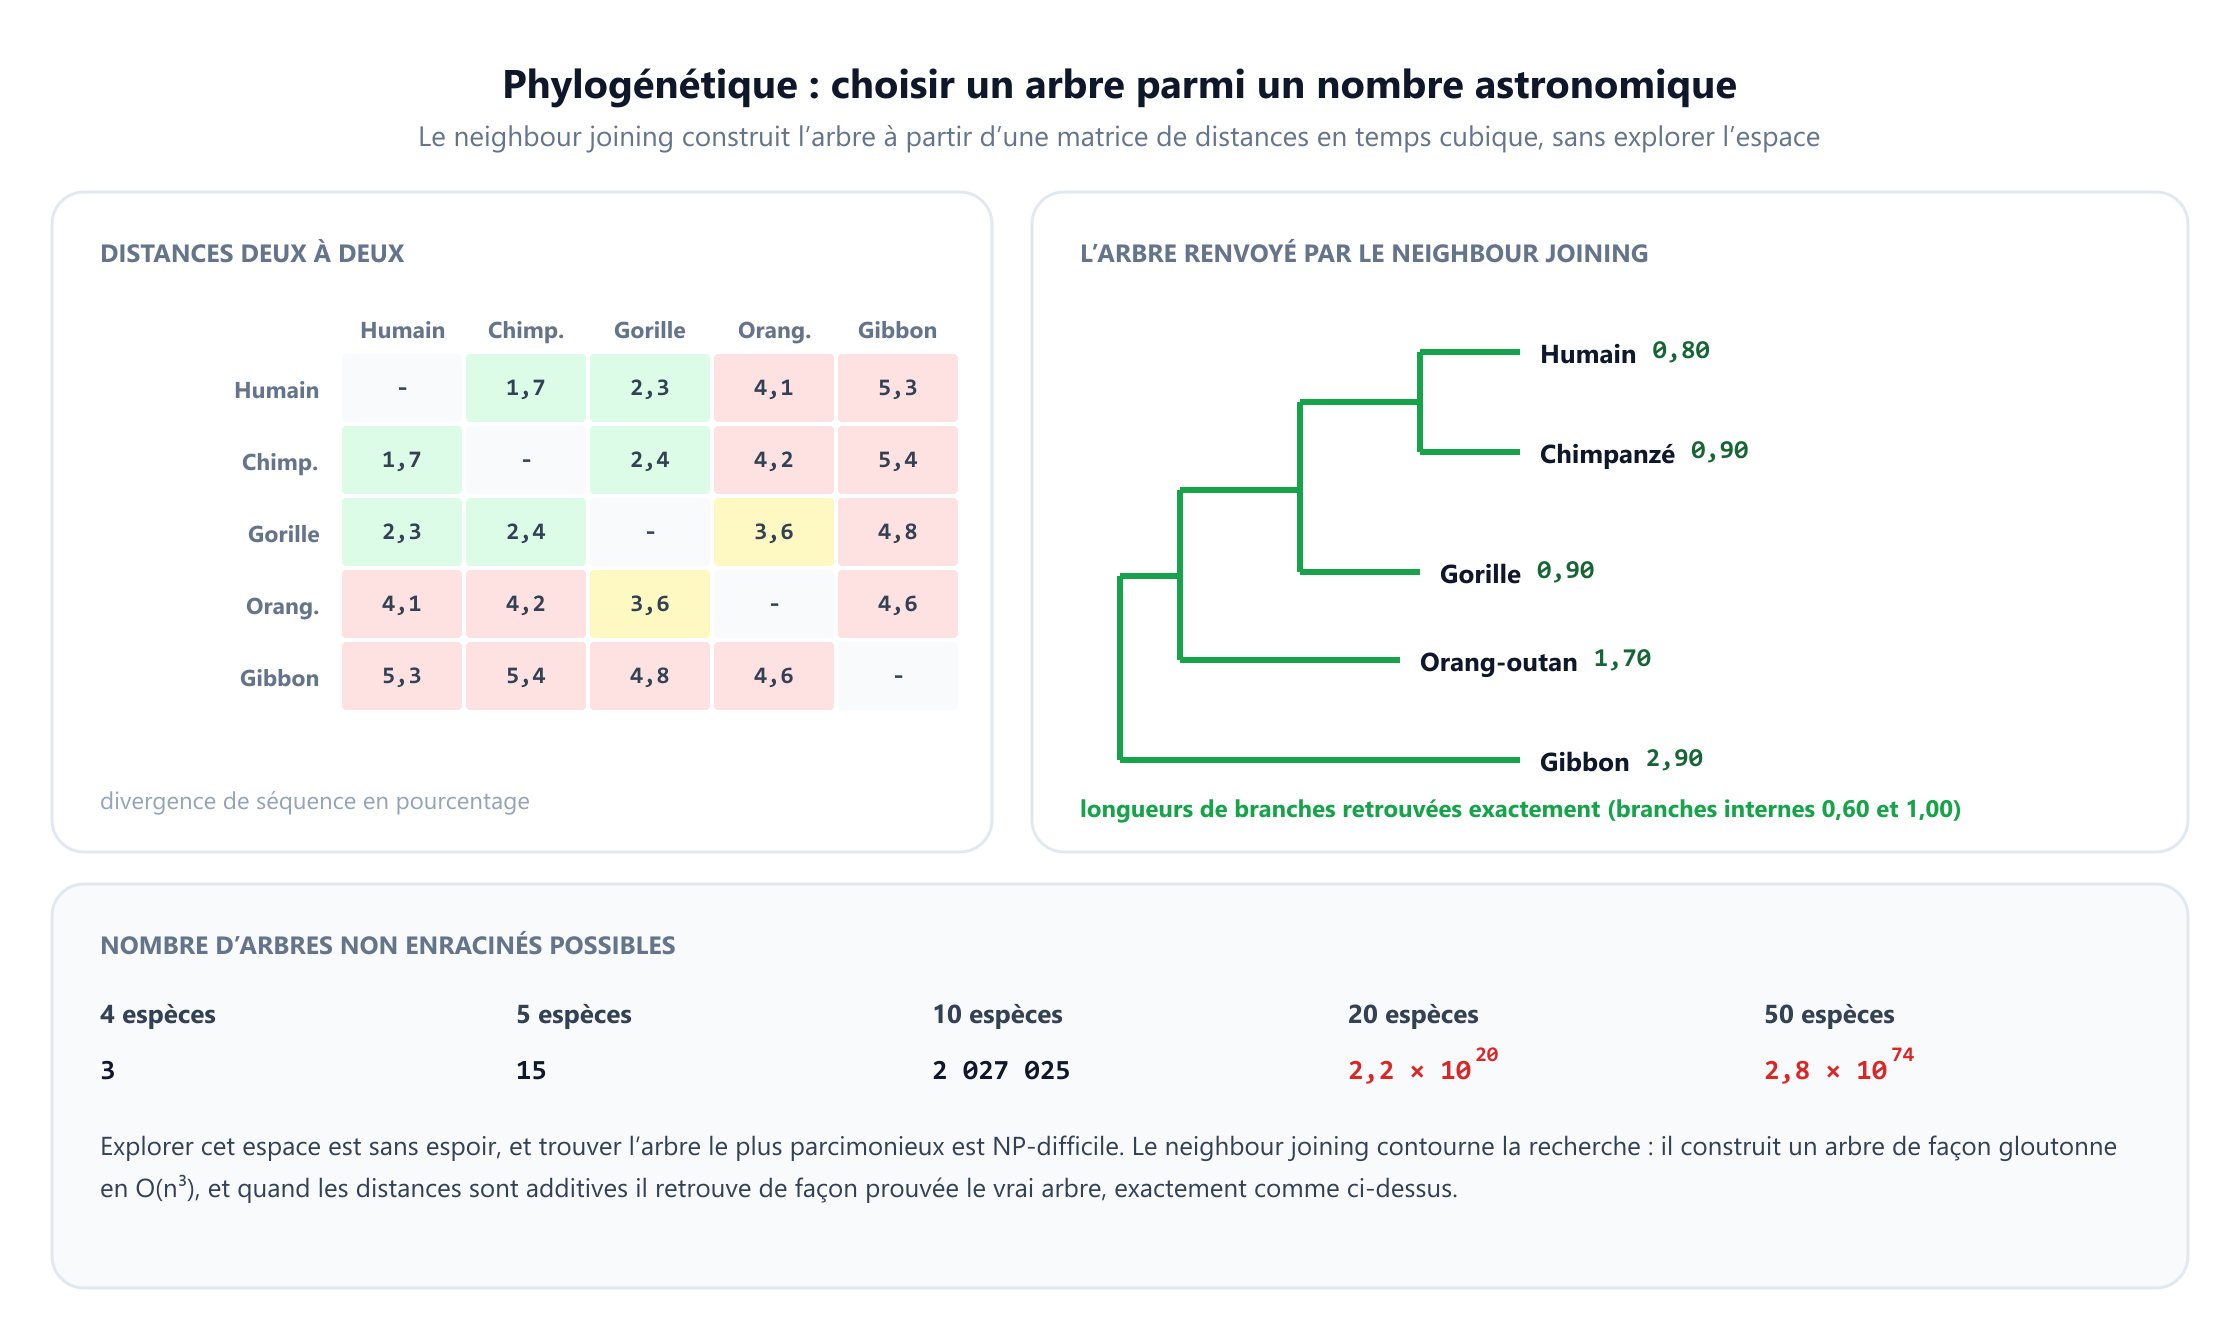
Le nombre d'arbres binaires non enracinés distincts sur n espèces, tabulé par Felsenstein en 1978, est la double factorielle (2n-5)!!, et il explose. Quatre espèces donnent 3 arbres. Cinq en donnent 15. Dix en donnent 2 027 025. Vingt en donnent environ 2,2 x 10²⁰. Cinquante espèces en donnent à peu près 2,8 x 1074, soit bien plus d'arbres qu'il n'y a d'atomes dans l'univers observable. Chacun d'eux est une réponse candidate, et les études phylogénétiques portent couramment sur des centaines de taxons.
La recherche exhaustive n'est donc pas seulement lente, elle est définitivement impossible, et la situation est pire encore : trouver l'arbre le plus parcimonieux, celui qui exige le moins de changements évolutifs, a ensuite été prouvé NP-difficile, et la recherche d'arbre par maximum de vraisemblance ne fait pas mieux.
Le neighbour joining de Saitou et Nei, publié en 1987 et parmi les articles les plus cités de toute la biologie, contourne entièrement la recherche. Il prend une matrice de distances deux à deux, joint à répétition la paire de taxons qu'un critère précis désigne comme voisins, et la fusionne en un nœud, jusqu'à ce qu'il reste un arbre. Il n'énumère jamais d'alternatives, et il tourne en temps cubique.
Sur la matrice de distances des cinq primates de la figure, il joint d'abord l'orang-outan au gibbon, puis l'humain au chimpanzé, puis le gorille au groupe orang-outan et gibbon, et il retrouve chaque longueur de branche exactement. Cette exactitude n'a rien d'un hasard. Quand les distances sont additives, c'est-à-dire qu'elles proviennent d'un arbre au départ, le neighbour joining renvoie de façon prouvée cet arbre. Les vraies distances estimées à partir de vraies séquences ne sont qu'approximativement additives, c'est pourquoi la phylogénétique réelle utilise le neighbour joining pour produire rapidement un arbre de départ qu'elle affine ensuite avec un modèle de vraisemblance, et pourquoi un même jeu de données peut appuyer différents arbres publiés.
10. Réseaux trophiques et cascades d'extinction
Passez de l'intérieur de la cellule à un écosystème entier et les mathématiques ne changent pas. Un réseau trophique est un graphe orienté : un sommet par espèce et un arc de la proie vers le prédateur partout où la seconde mange la première. Les espèces sans proie sont basales, c'est-à-dire des plantes, des algues ou des détritus, et tout le reste dépend d'elles en dernier ressort.
Le modèle compte ici douze espèces et dix-sept liens trophiques, avec les algues et les détritus à la base, et une loutre, un héron et un brochet au sommet. La première chose que donne le graphe est le niveau trophique, calculé comme un plus le niveau moyen de tout ce que mange une espèce. Les espèces basales sont à 1,00, les herbivores à 2,00, et les superprédateurs tombent sur des valeurs fractionnaires : le brochet à 4,50, la loutre à 4,75, le héron à 4,33. Les niveaux fractionnaires ne sont pas un artefact. C'est la réponse honnête pour un omnivore qui se nourrit à plusieurs niveaux à la fois.
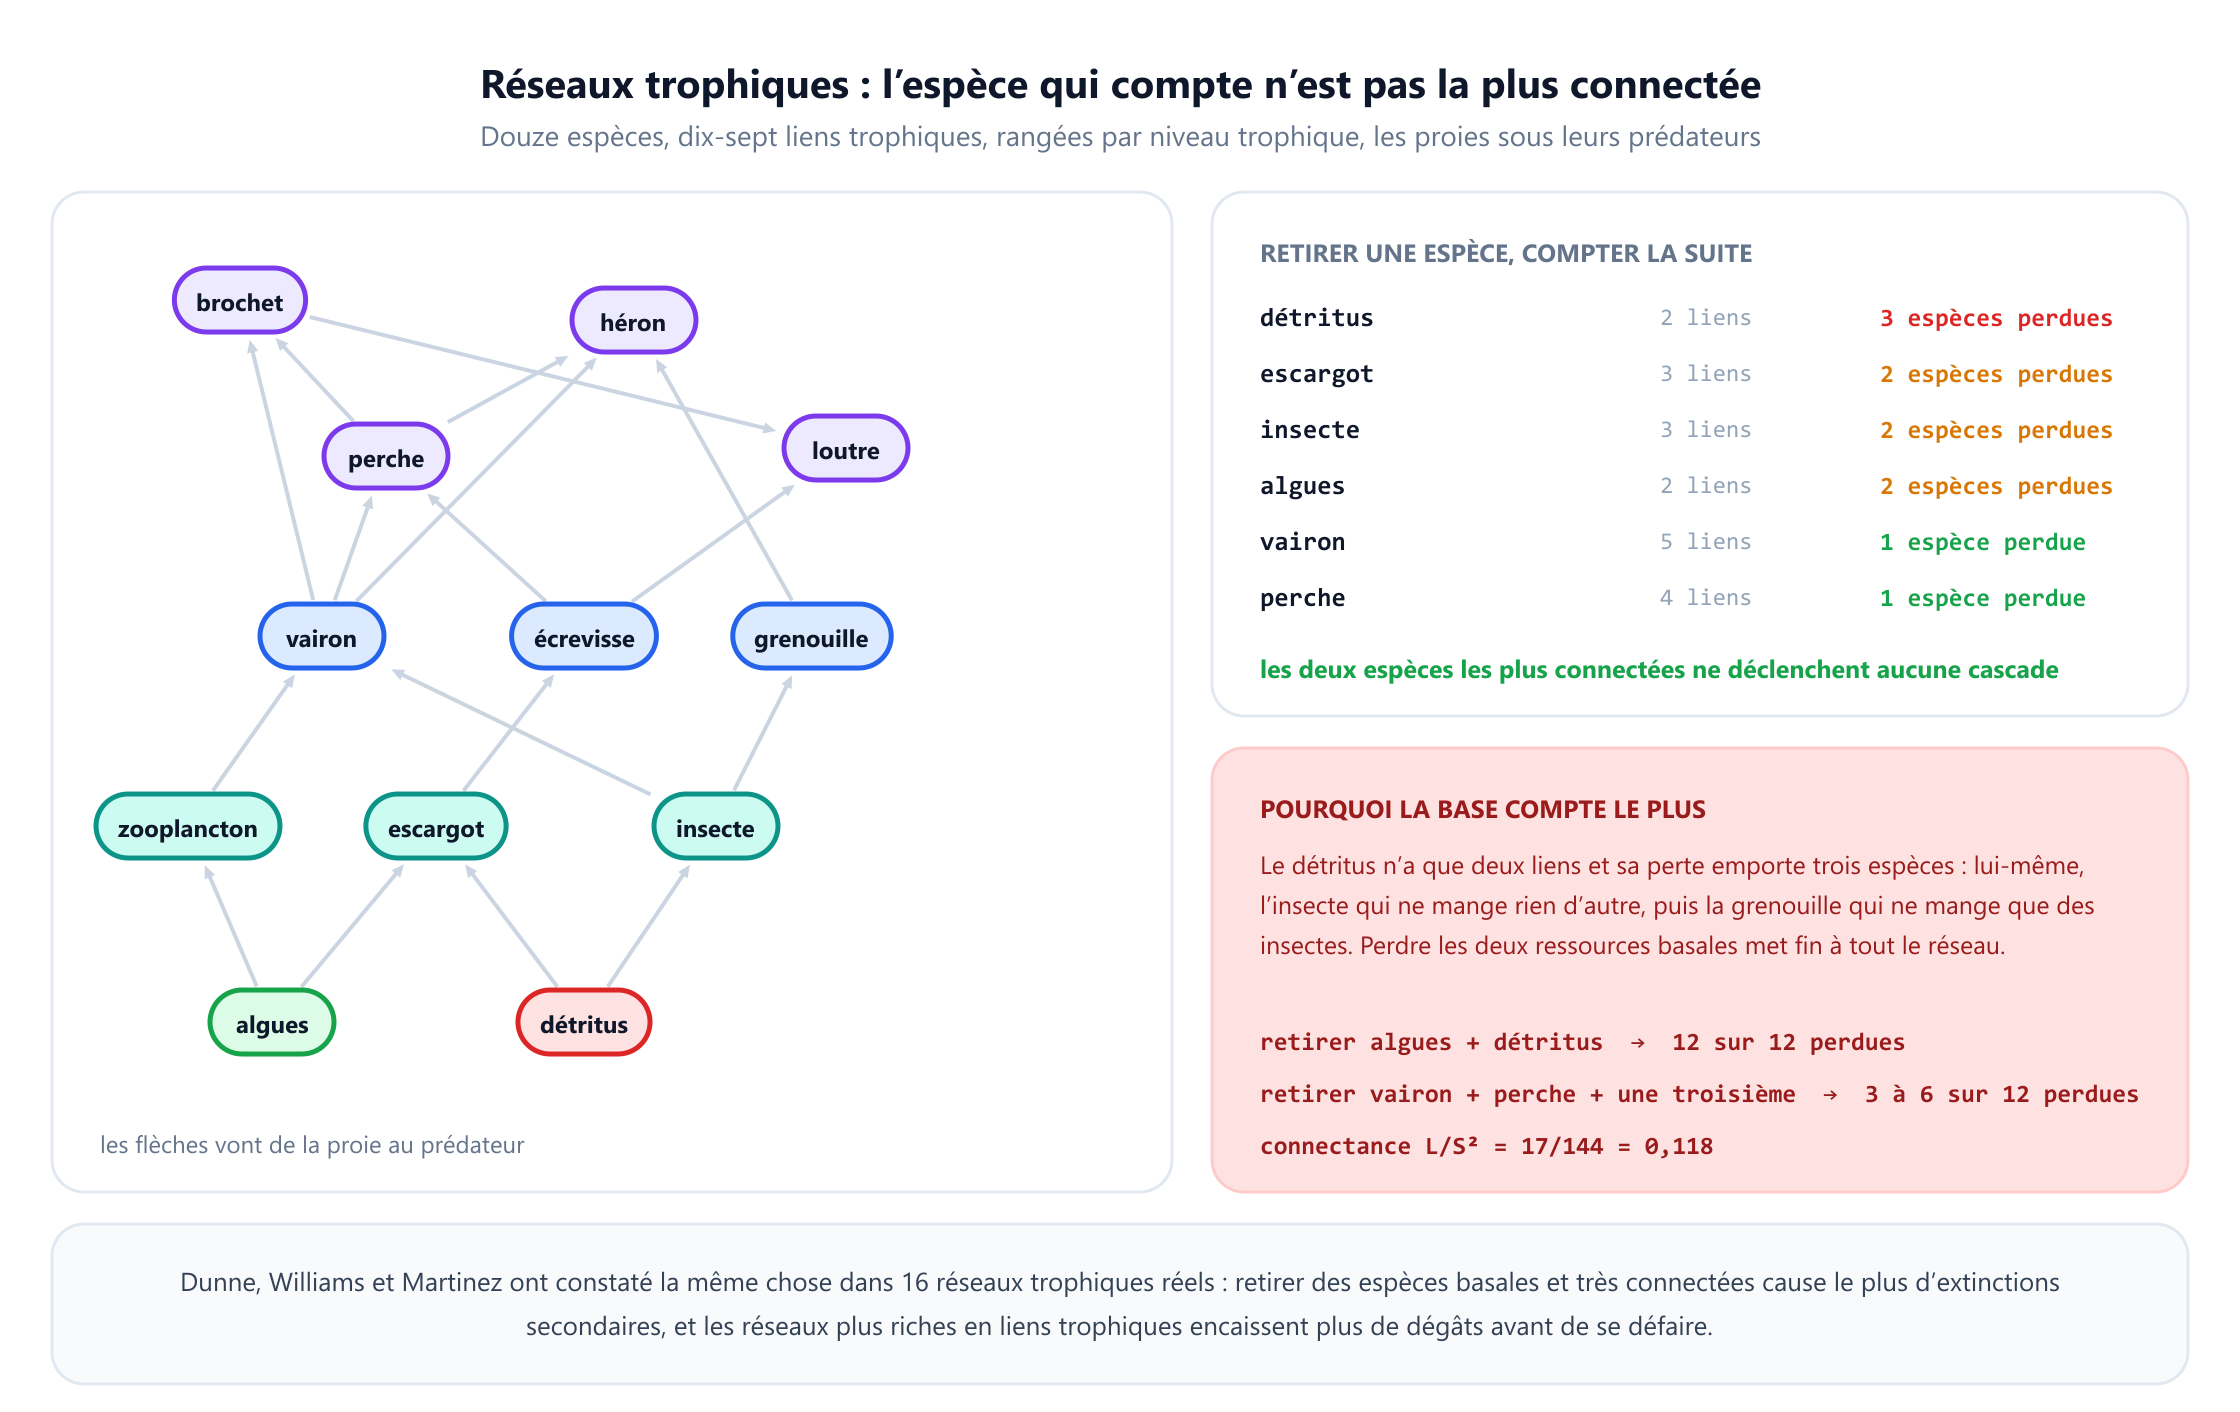
La question qui compte pour la conservation est ce qui se passe après la perte d'une espèce. Supprimez un sommet, puis toute espèce qui n'a plus rien à manger, et recommencez jusqu'à ce que le réseau se stabilise. Ces pertes en chaîne sont des extinctions secondaires, et elles expliquent pourquoi les écosystèmes s'effondrent plus vite que la pression directe qu'ils subissent ne le laisserait penser.
Les résultats sur ce réseau sont contre-intuitifs d'une manière précise et utile. Le vairon est l'espèce la mieux connectée, avec cinq liens trophiques. Retirez-le et rien d'autre ne meurt : tout ce qui mangeait le vairon mange aussi autre chose. Retirez le héron ou la loutre, deux superprédateurs, et là encore rien ne suit. Retirez maintenant les détritus, qui n'ont que deux liens et pour lesquels personne ne fait campagne. Trois espèces disparaissent au total : les détritus eux-mêmes, puis l'insecte qui ne mange rien d'autre, puis la grenouille qui ne mange que des insectes. Un sommet à deux arêtes a fait plus de dégâts qu'un sommet à cinq.
Le schéma se généralise. Les espèces basales sont porteuses parce que tout ce qui se trouve au-dessus dépend d'elles, alors qu'un consommateur très connecté se trouve dans une partie du graphe qui offre des substituts. Retirer les deux espèces basales, les algues et les détritus, coûte les douze espèces. Retirer les mieux connectées fait moins de dégâts, et le nombre n’est même pas bien défini : le vairon et la perche mènent au nombre de liens, mais cinq espèces sont à égalité pour la troisième place, et selon celle que vous ajoutez le total varie de trois à six. Les deux espèces sans relief de la base font au moins deux fois plus de dégâts.
Dunne, Williams et Martinez ont rapporté exactement cela en 2002 sur seize réseaux trophiques réels, en ajoutant un second résultat à retenir : la robustesse augmente avec la connectance, le nombre de liens divisé par le carré du nombre d'espèces. Les réseaux plus riches en liens trophiques encaissent plus de dégâts avant de se fragmenter, parce que davantage d'espèces ont des alternatives. Le réseau modélisé ici a une connectance de 0,118, en plein dans la fourchette rapportée pour les réseaux réels.
La leçon pratique est qu'un tri de conservation fondé sur le charisme, la taille ou même le nombre de liens mesure la mauvaise grandeur. L'espèce dont la perte se propage se trouve en simulant le retrait sur le graphe, et la réponse est régulièrement quelque chose de petit et de mal aimé.
11. Connectomes et épidémies
Deux autres domaines méritent d'être cités, car tous deux réutilisent des outils déjà présentés.
Connectomes. Un système nerveux est un graphe orienté et pondéré de neurones reliés par des synapses. Le premier connectome complet a été publié par White, Southgate, Thomson et Brenner en 1986 : celui du nématode C. elegans, 302 neurones et environ 7 000 connexions, reconstitué à la main à partir de micrographies électroniques pendant plus d'une décennie. Les travaux sur l'humain opèrent à une résolution plus grossière, avec des régions cérébrales comme sommets et des faisceaux de fibres ou une activité corrélée comme arêtes, mais l'analyse est celle de la section 3 : degré, clustering, longueur de chemin, modules, hubs.
Bullmore et Sporns ont exposé ce programme en 2009, et le constat récurrent est que les cerveaux sont des petits mondes modulaires, dotés d'un cœur densément interconnecté de régions de haut degré, le « rich club », qui porte une part disproportionnée du trafic à longue distance. Plusieurs troubles psychiatriques et neurologiques se manifestent par des statistiques de graphe altérées. Ce sont des corrélations entre groupes, pas des diagnostics individuels, et il est bon de savoir qu'un connectome fonctionnel dépend fortement d'un seuil de corrélation choisi par l'analyste, et que les statistiques bougent quand le seuil bouge.
Épidémies. Une maladie se propage sur un graphe de contacts, et sa structure détermine l'issue autant que le pathogène. Pastor-Satorras et Vespignani ont démontré en 2001 un résultat saisissant : sur un réseau dont la distribution des degrés est sans échelle et de variance non bornée, le seuil épidémique classique disparaît. Dans les modèles à mélange homogène des manuels, une infection dont le taux de transmission est assez faible s'éteint ; sur un tel réseau, non, car les hubs la maintiennent en vie. Cela a remanié les stratégies de vaccination, puisque immuniser les individus de haut degré, ou même les connaissances d'individus choisis au hasard, qui ont plus souvent que le hasard un degré élevé, bat l'immunisation aléatoire à nombre de doses égal.
Les mêmes mathématiques réapparaissent en biologie cellulaire sous forme de propagation de signaux et en sécurité informatique sous forme de propagation de logiciels malveillants. Le graphe se moque de ce que représentent les sommets.
12. Ce qui est facile, ce qui est difficile
Formuler une question biologique comme une question de graphes ne la rend pas soluble. Cela rend la difficulté visible, ce qui est plus utile, et la frontière passe à des endroits surprenants.
Facile, c'est-à-dire en temps polynomial et routinier à grande échelle. Le degré, les coefficients de clustering et les composantes connexes ne coûtent pratiquement rien. Les plus courts chemins, et donc l'alignement, sont bon marché. La centralité d'intermédiarité sur un graphe creux tourne en un temps proportionnel au produit du nombre de sommets et d'arêtes grâce à l'algorithme de Brandes. Les chemins eulériens sont linéaires, les arbres couvrants et les flots polynomiaux, et le neighbour joining est cubique. Tout ce qui est résolu dans cet article appartient à cette catégorie, et tout passe à l'échelle de graphes à des millions d'arêtes sur un ordinateur portable.
Difficile, c'est-à-dire NP-difficile sans algorithme polynomial en vue. Trouver l'arbre phylogénétique le plus parcimonieux. Trouver le plus grand ensemble d'espèces qui interagissent toutes entre elles, c'est-à-dire la clique maximale. Décider si un réseau est un sous-graphe d'un autre, ce qui sous-tend la recherche de motifs plus grands. Trouver un chemin hamiltonien, la raison pour laquelle la formulation de l'assemblage par chevauchement a été abandonnée. Le partitionnement optimal de graphes, dans sa forme exacte.
Deux observations rendent la frontière moins décourageante qu'elle n'en a l'air. D'abord, les problèmes difficiles en biologie sont en général attaqués par des heuristiques qui marchent bien sur les instances qui se présentent réellement : la phylogénétique progresse par ascension de colline à partir d'un départ neighbour joining, et les chercheurs de motifs énumèrent astucieusement, ce qui suffit pour des schémas à trois et quatre sommets. Ensuite, la différence entre la formulation traitable et la formulation intraitable d'une même tâche biologique n'est souvent qu'un choix de modélisation, comme le montre la décision de faire des k-mers des arêtes pour l'assemblage. Reconnaître de quel côté de la ligne on se trouve avant d'écrire du code, c'est l'essentiel du bénéfice.
13. Erreurs de modélisation
Cinq erreurs expliquent la plupart des conclusions fausses tirées des réseaux biologiques. Aucune n'est exotique, et toutes sont encore publiées.
Traiter un agrégat comme un instantané. Un réseau PPI publié est l'union de nombreuses expériences, dans différents types cellulaires, dans différentes conditions, sur des décennies. Ses arêtes n'ont jamais coexisté. Y calculer des plus courts chemins suppose que chaque interaction est disponible simultanément, ce qui est faux. Là où des données propres à une condition existent, filtrez sur elles ; sinon, traitez les conclusions fondées sur les chemins comme des hypothèses.
Ignorer le biais d'étude. Les protéines très étudiées ont plus d'interactions connues parce que plus de gens les ont cherchées, pas forcément parce qu'elles ont plus de vrais partenaires. Toute analyse concluant que « les protéines les plus connectées sont les importantes » redécouvre en partie l'historique des publications du domaine. Le test consiste à vérifier si votre résultat tient quand le réseau est restreint à un seul criblage non biaisé.
Comparer au mauvais modèle nul. C'est la leçon des motifs de la section 6, et elle se généralise partout. Les vrais réseaux biologiques ont des hubs et des distributions de degrés à queue lourde. Comparez n'importe quelle statistique structurelle à un graphe aléatoire uniforme et elle paraîtra extraordinaire. La comparaison doit préserver les caractéristiques que vous ne testez pas, ce qui signifie en général préserver la suite des degrés.
Lire une corrélation comme une arête. Les réseaux de coexpression relient des gènes dont les niveaux d'expression sont corrélés d'un échantillon à l'autre. La corrélation n'est pas la régulation, et le graphe obtenu est non orienté alors que la régulation est orientée. Ces réseaux sont utiles pour générer des hypothèses et systématiquement trompeurs quand on les lit comme un mécanisme. La même prudence vaut pour les connectomes fonctionnels construits à partir d'activité cérébrale corrélée.
Surinterpréter le caractère sans échelle. L'observation selon laquelle les réseaux biologiques ont des distributions de degrés à queue lourde est solide et importante. L'affirmation plus forte selon laquelle ils suivent une loi de puissance nette a été contestée à plusieurs reprises pour des raisons statistiques, notamment par Broido et Clauset en 2019, qui ont trouvé les lois de puissance strictes rares parmi des milliers de réseaux empiriques. Les conclusions utiles de cet article, l'essentialité des hubs et l'asymétrie entre panne et attaque, n'ont besoin que de la queue lourde, pas de la forme fonctionnelle exacte. Affirmez la queue, pas la loi.
14. Du modèle à la pratique
Une courte procédure pour qui s'apprête à construire l'un de ces graphes sur des données réelles.
Écrivez ce qu'est un sommet et ce que signifie une arête, en une phrase chacun, avant de toucher aux données. La plupart des analyses confuses remontent à un graphe dont les arêtes signifient deux choses différentes, « se lie à » mêlé à « est corrélé à », ou « mange » mêlé à « est en compétition avec ». Si la phrase est difficile à écrire, le graphe n'est pas prêt.
Décidez orienté ou non orienté, pondéré ou non pondéré, pour des raisons biologiques. Pas en fonction de ce que le logiciel propose par défaut. Chaque métrique en aval hérite de ce choix, et un score d'intermédiarité calculé sur un graphe qui aurait dû être orienté n'est pas une approximation, c'est une autre grandeur.
Calculez d'abord les statistiques descriptives bon marché. Nombre de sommets et d'arêtes, distribution des degrés, nombre de composantes, coefficient de clustering, longueur de chemin. Cela prend quelques secondes et révèle immédiatement les problèmes de données : une seconde composante inattendue signale généralement une incohérence d'identifiants, et un degré moyen étonnamment élevé des arêtes en double.
Choisissez le modèle nul avant de calculer la statistique qui vous intéresse. Pas après avoir vu le résultat.
Perturbez et relancez. Retirez 10 % des arêtes au hasard et recalculez votre conclusion principale. Les réseaux biologiques sont incomplets et bruités, et un classement qui se réordonne quand un dixième des données disparaît est une propriété de l'échantillon et non de l'organisme.
Si vous voulez vous faire une intuition des algorithmes derrière tout cela avant de les appliquer à des données biologiques, les visualiseurs interactifs de ce site vous permettent d'exécuter le parcours en largeur, l'algorithme de Dijkstra et la construction d'arbres couvrants minimaux pas à pas sur des graphes que vous dessinez vous-même, ce qui est le moyen le plus rapide de sentir ce que font réellement ces méthodes.
15. Questions fréquentes
Comment la théorie des graphes est-elle utilisée en biologie ?
+
Partout où des objets biologiques interagissent. Les protéines qui se lient forment un réseau non orienté, les gènes qui se régulent mutuellement un réseau orienté, les lectures d'ADN un graphe de De Bruijn dont le chemin eulérien est le génome assemblé, les espèces et leurs ancêtres un arbre évolutif, et les espèces qui se mangent entre elles un réseau trophique. Dans chaque cas, la biologie fournit les sommets et les arêtes, et des algorithmes classiques répondent ensuite aux questions : quels composants sont essentiels, quels schémas sont surreprésentés, quelle séquence explique les lectures, quel arbre explique les distances et quelle extinction déclenche une cascade.
Qu'est-ce qu'une protéine hub, et pourquoi les hubs comptent-ils ?
+
Un hub est une protéine qui a bien plus de partenaires d'interaction que la moyenne. Les hubs comptent en raison d'un résultat expérimental : Jeong, Mason, Barabasi et Oltvai ont montré en 2001 que les protéines de levure ayant plus de partenaires sont nettement plus souvent essentielles, c'est-à-dire que la cellule meurt sans elles. Les hubs expliquent aussi pourquoi les réseaux se comportent si différemment face aux dégâts aléatoires et aux dégâts ciblés. Sur le réseau sans échelle de cet article, retirer au hasard 20 % des protéines laisse 78 % du réseau connecté, alors que retirer les 20 % de plus haut degré n'en laisse que 9 %.
Qu'est-ce qu'un motif de réseau ?
+
Un petit sous-graphe qui apparaît plus souvent dans un vrai réseau que dans des réseaux randomisés ayant exactement les mêmes degrés. La randomisation est tout l'enjeu : comparer à un graphe aléatoire ordinaire fait paraître presque n'importe quel schéma significatif, car les vrais réseaux ont des hubs et les réseaux aléatoires n'en ont pas. Dans le réseau de huit gènes présenté ici, la boucle feed-forward apparaît cinq fois, contre une moyenne randomisée de 1,80 et un écart-type de 1,22, soit un score z de 2,63, et seules 17 copies randomisées sur 1 000 atteignent cinq ou plus. Les motifs comptent parce que leur fonction peut se déduire : la boucle feed-forward cohérente ignore les brèves impulsions et ne répond qu'aux signaux soutenus.
Pourquoi l'assemblage de génome est-il un problème de chemin eulérien ?
+
À cause de la façon dont le graphe est construit. On découpe chaque lecture en sous-chaînes chevauchantes de longueur k, puis on fait de chaque k-mer une arête allant du sommet formé par ses k-1 premières lettres au sommet formé par ses k-1 dernières lettres. Utiliser chaque lecture exactement une fois revient alors à utiliser chaque arête exactement une fois, c'est-à-dire un chemin eulérien, soluble en temps linéaire. L'alternative naturelle, faire de chaque lecture un sommet et relier les lectures qui se chevauchent, exige de visiter chaque sommet une fois, c'est-à-dire un chemin hamiltonien, NP-complet. La même tâche biologique est traitable ou sans espoir selon que les lectures deviennent des arêtes ou des sommets.
Pourquoi les répétitions rendent-elles l'assemblage ambigu ?
+
Parce qu'une séquence répétée fait arriver le parcours plusieurs fois au même sommet, et que les lectures ne disent rien du côté par lequel le quitter en premier. Dans cet article, la séquence AGGGTGGTTGGC lue en 4-mers produit un graphe à deux chemins eulériens, qui donnent AGGGTGGTTGGC et AGGGTTGGTGGC, tous deux pleinement compatibles avec chaque lecture. Aucun algorithme ne peut les départager, car l'ambiguïté est dans les données et non dans la méthode. Lire la même séquence en 6-mers donne exactement une reconstruction, c'est pourquoi la longueur des lectures compte plus que leur nombre et pourquoi le séquençage à lectures longues a changé l'assemblage.
Combien existe-t-il d'arbres phylogénétiques, et comment les biologistes en trouvent-ils un ?
+
Le nombre d'arbres binaires non enracinés sur n espèces est la double factorielle (2n-5)!!, qui dépasse toute possibilité de recherche : 3 arbres pour quatre espèces, 15 pour cinq, 2 027 025 pour dix, environ 2,2 x 10^20 pour vingt et à peu près 2,8 x 10^74 pour cinquante. Trouver l'arbre le plus parcimonieux est NP-difficile. Le neighbour joining, publié par Saitou et Nei en 1987, évite toute recherche : il joint à répétition la paire la plus proche selon un critère précis et construit un seul arbre en temps cubique. Quand les distances sont additives, il retrouve de façon prouvée le vrai arbre, et c'est exactement ce qui se passe sur la matrice des cinq primates de cet article, où chaque longueur de branche est retrouvée exactement.
Quelle espèce compte le plus dans un réseau trophique ?
+
Pas la mieux connectée. Dans le réseau de douze espèces de cet article, le vairon a le plus de liens trophiques, cinq, et le retirer ne provoque aucune extinction secondaire, parce que tout ce qui le mangeait mange aussi autre chose. Retirer les détritus, qui n'ont que deux liens, coûte trois espèces : les détritus, puis l'insecte qui ne mange rien d'autre, puis la grenouille qui ne mange que des insectes. Retirer les deux espèces basales fait perdre les douze, alors que retirer les deux espèces les mieux connectées plus une troisième quelconque en fait perdre entre trois et six. L'importance est une propriété de la position dans le graphe, et il faut la trouver en simulant le retrait plutôt qu'en comptant les liens.
Les réseaux biologiques sont-ils vraiment sans échelle ?
+
Ils ont des distributions de degrés à queue lourde, et c'est bien établi. L'affirmation plus forte selon laquelle ils suivent une loi de puissance nette a été contestée pour des raisons statistiques, notamment par Broido et Clauset en 2019, qui ont trouvé les lois de puissance strictes rares parmi des milliers de réseaux empiriques. Cela compte moins qu'il n'y paraît, car les conclusions utilisées n'ont besoin que de la queue lourde : une distribution où la plupart des sommets ont peu d'arêtes et une petite minorité en a beaucoup suffit à produire l'essentialité des hubs et l'asymétrie entre panne aléatoire et attaque ciblée. La position sûre est d'affirmer la queue et non la loi.
16. Références
Les articles à l'origine des résultats de cet article, par ordre chronologique.
- Sylvester, J. J. (1878). “Chemistry and algebra.” Nature, 17, 284.
- Needleman, S. B. et Wunsch, C. D. (1970). “A general method applicable to the search for similarities in the amino acid sequence of two proteins.” Journal of Molecular Biology, 48(3), 443–453.
- Freeman, L. C. (1977). “A set of measures of centrality based upon betweenness.” Sociometry, 40(1), 35–41.
- Felsenstein, J. (1978). “The number of evolutionary trees.” Systematic Zoology, 27(1), 27–33.
- Smith, T. F. et Waterman, M. S. (1981). “Identification of common molecular subsequences.” Journal of Molecular Biology, 147(1), 195–197.
- White, J. G., Southgate, E., Thomson, J. N. et Brenner, S. (1986). “The structure of the nervous system of the nematode Caenorhabditis elegans.” Philosophical Transactions of the Royal Society B, 314(1165), 1–340.
- Saitou, N. et Nei, M. (1987). “The neighbor-joining method: a new method for reconstructing phylogenetic trees.” Molecular Biology and Evolution, 4(4), 406–425.
- Watts, D. J. et Strogatz, S. H. (1998). “Collective dynamics of small-world networks.” Nature, 393, 440–442.
- Albert, R., Jeong, H. et Barabási, A.-L. (2000). “Error and attack tolerance of complex networks.” Nature, 406, 378–382.
- Jeong, H., Tombor, B., Albert, R., Oltvai, Z. N. et Barabási, A.-L. (2000). “The large-scale organization of metabolic networks.” Nature, 407, 651–654.
- Jeong, H., Mason, S. P., Barabási, A.-L. et Oltvai, Z. N. (2001). “Lethality and centrality in protein networks.” Nature, 411, 41–42.
- Brandes, U. (2001). “A faster algorithm for betweenness centrality.” Journal of Mathematical Sociology, 25(2), 163–177.
- Pevzner, P. A., Tang, H. et Waterman, M. S. (2001). “An Eulerian path approach to DNA fragment assembly.” Proceedings of the National Academy of Sciences, 98(17), 9748–9753.
- Pastor-Satorras, R. et Vespignani, A. (2001). “Epidemic spreading in scale-free networks.” Physical Review Letters, 86(14), 3200–3203.
- Milo, R., Shen-Orr, S., Itzkovitz, S., Kashtan, N., Chklovskii, D. et Alon, U. (2002). “Network motifs: simple building blocks of complex networks.” Science, 298(5594), 824–827.
- Shen-Orr, S. S., Milo, R., Mangan, S. et Alon, U. (2002). “Network motifs in the transcriptional regulation network of Escherichia coli.” Nature Genetics, 31(1), 64–68.
- Dunne, J. A., Williams, R. J. et Martinez, N. D. (2002). “Network structure and biodiversity loss in food webs: robustness increases with connectance.” Ecology Letters, 5(4), 558–567.
- Barabási, A.-L. et Oltvai, Z. N. (2004). “Network biology: understanding the cell's functional organization.” Nature Reviews Genetics, 5(2), 101–113.
- Yildirim, M. A., Goh, K.-I., Cusick, M. E., Barabási, A.-L. et Vidal, M. (2007). “Drug-target network.” Nature Biotechnology, 25(10), 1119–1126.
- Bullmore, E. et Sporns, O. (2009). “Complex brain networks: graph theoretical analysis of structural and functional systems.” Nature Reviews Neuroscience, 10(3), 186–198.
- Compeau, P. E. C., Pevzner, P. A. et Tesler, G. (2011). “How to apply de Bruijn graphs to genome assembly.” Nature Biotechnology, 29(11), 987–991.
- Broido, A. D. et Clauset, A. (2019). “Scale-free networks are rare.” Nature Communications, 10, 1017.