
Tabla de Contenidos
- 1. La respuesta corta
- 2. Una empresa, cuatro ganadores
- 3. Grado y cercanía: contactos y alcance
- 4. Intermediación: por quién pasan las rutas
- 5. Centralidad de vector propio: quiénes son tus contactos
- 6. PageRank: seguir los enlaces
- 7. Callejones sin salida, bucles cerrados y el factor de amortiguación
- 8. ¿Coinciden las medidas?
- 9. Grafos grandes: estimar la intermediación
- 10. Dónde se usan estas medidas
- 11. Una breve historia
- 12. Errores comunes
- 13. Glosario
- 14. Preguntas frecuentes
- 15. Referencias
1. La respuesta corta
Una medida de centralidad asigna a cada vértice de un grafo una puntuación que indica lo importante que es. No existe una única puntuación correcta, porque "importante" puede significar varias cosas distintas: tener muchas conexiones, estar cerca de todos, situarse en las rutas entre otras personas o estar conectado con otros que a su vez son importantes. Cada una de esas ideas es una medida diferente, y sobre la misma red pueden señalar ganadores distintos.
| Medida | La pregunta que responde | Coste | Úsala para |
|---|---|---|---|
| Grado | ¿Quién tiene más conexiones directas? | O(V + E) | Un primer vistazo rápido; alcance inmediato |
| Cercanía | ¿Quién llega a todos en menos pasos? | O(V(V + E)) | Difundir algo rápido desde un punto |
| Intermediación | ¿Quién está en las rutas entre otros pares? | O(VE) sin pesos | Cuellos de botella, intermediarios, puntos únicos de control |
| Vector propio | ¿Quién está conectado con personas bien conectadas? | O(E) por iteración | Influencia en redes no dirigidas |
| PageRank | ¿Dónde pasa más tiempo un navegante aleatorio? | O(V + E) por iteración | Redes dirigidas: enlaces, citas |
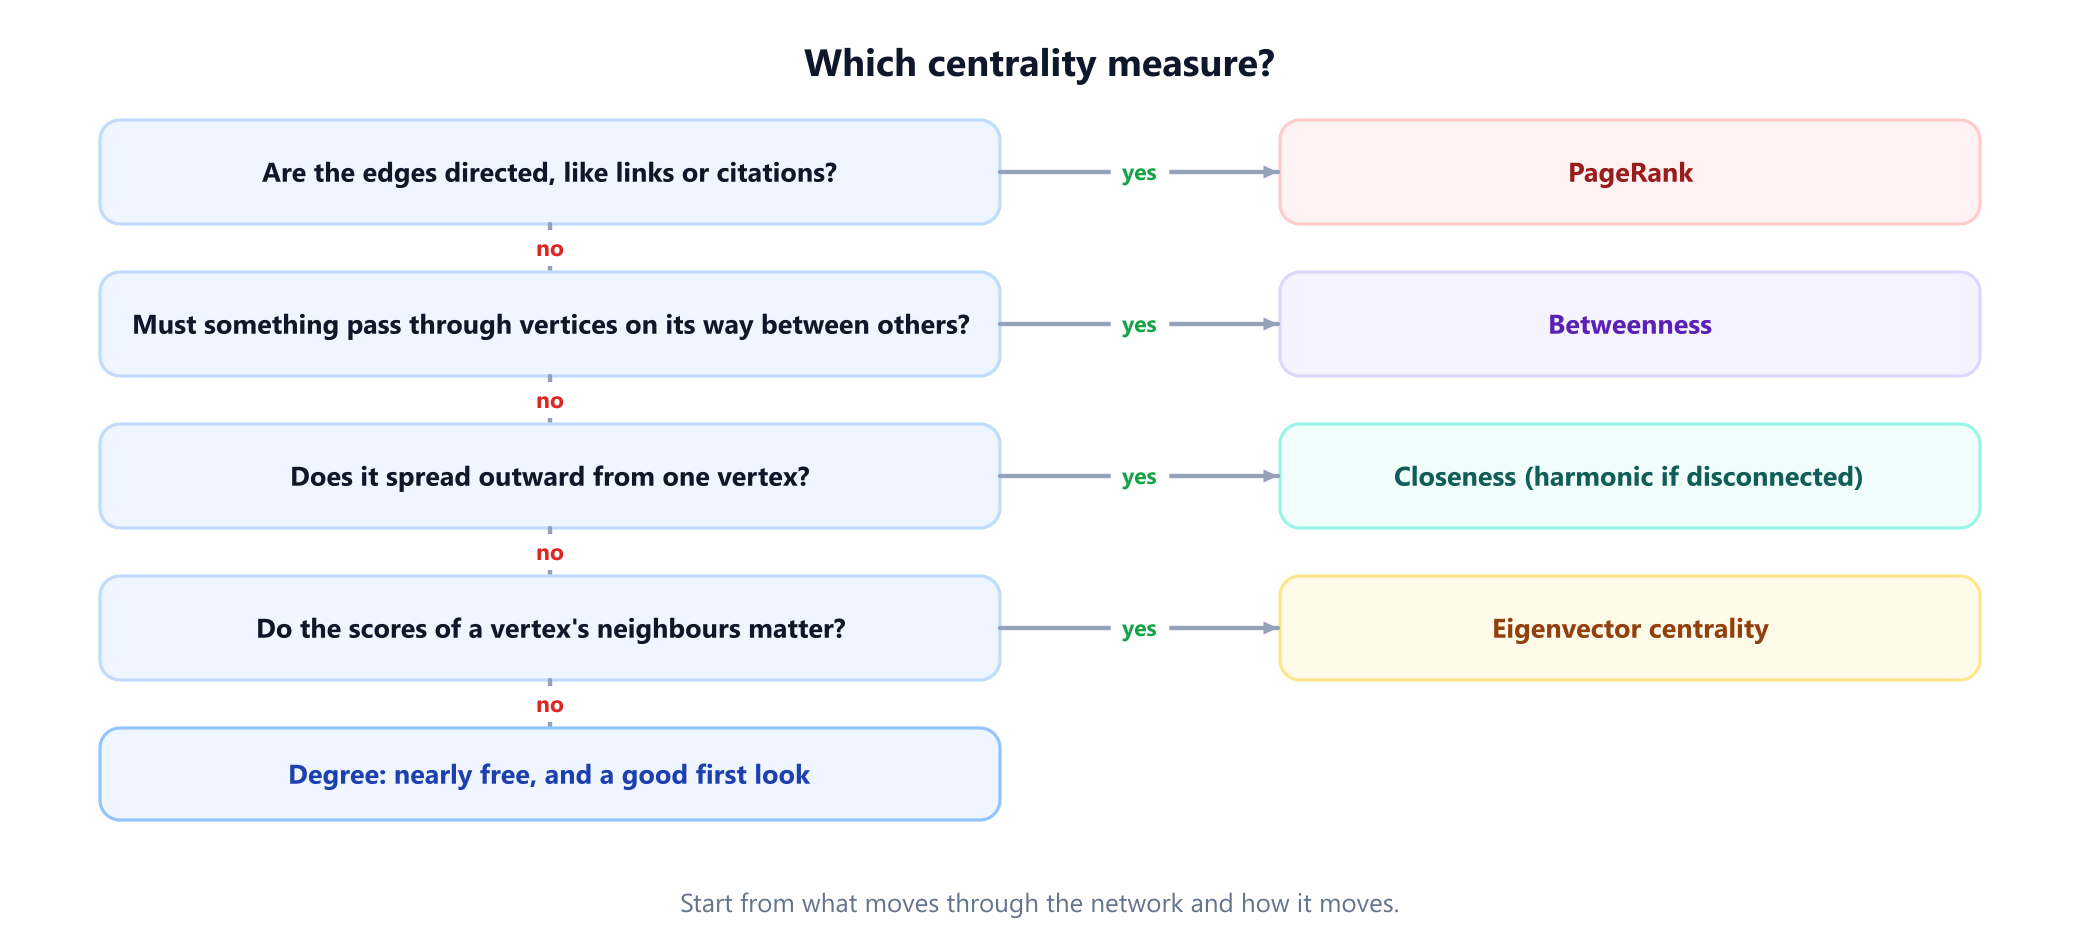
En una frase: decide qué viaja por tu red y cómo, y luego elige la medida que lo modela. Si solo quieres un punto de partida, calcula primero el grado, porque es casi gratis y las demás medidas se entienden mejor como correcciones a él. El diagrama siguiente convierte ese consejo en cuatro preguntas.
2. Una empresa, cuatro ganadores
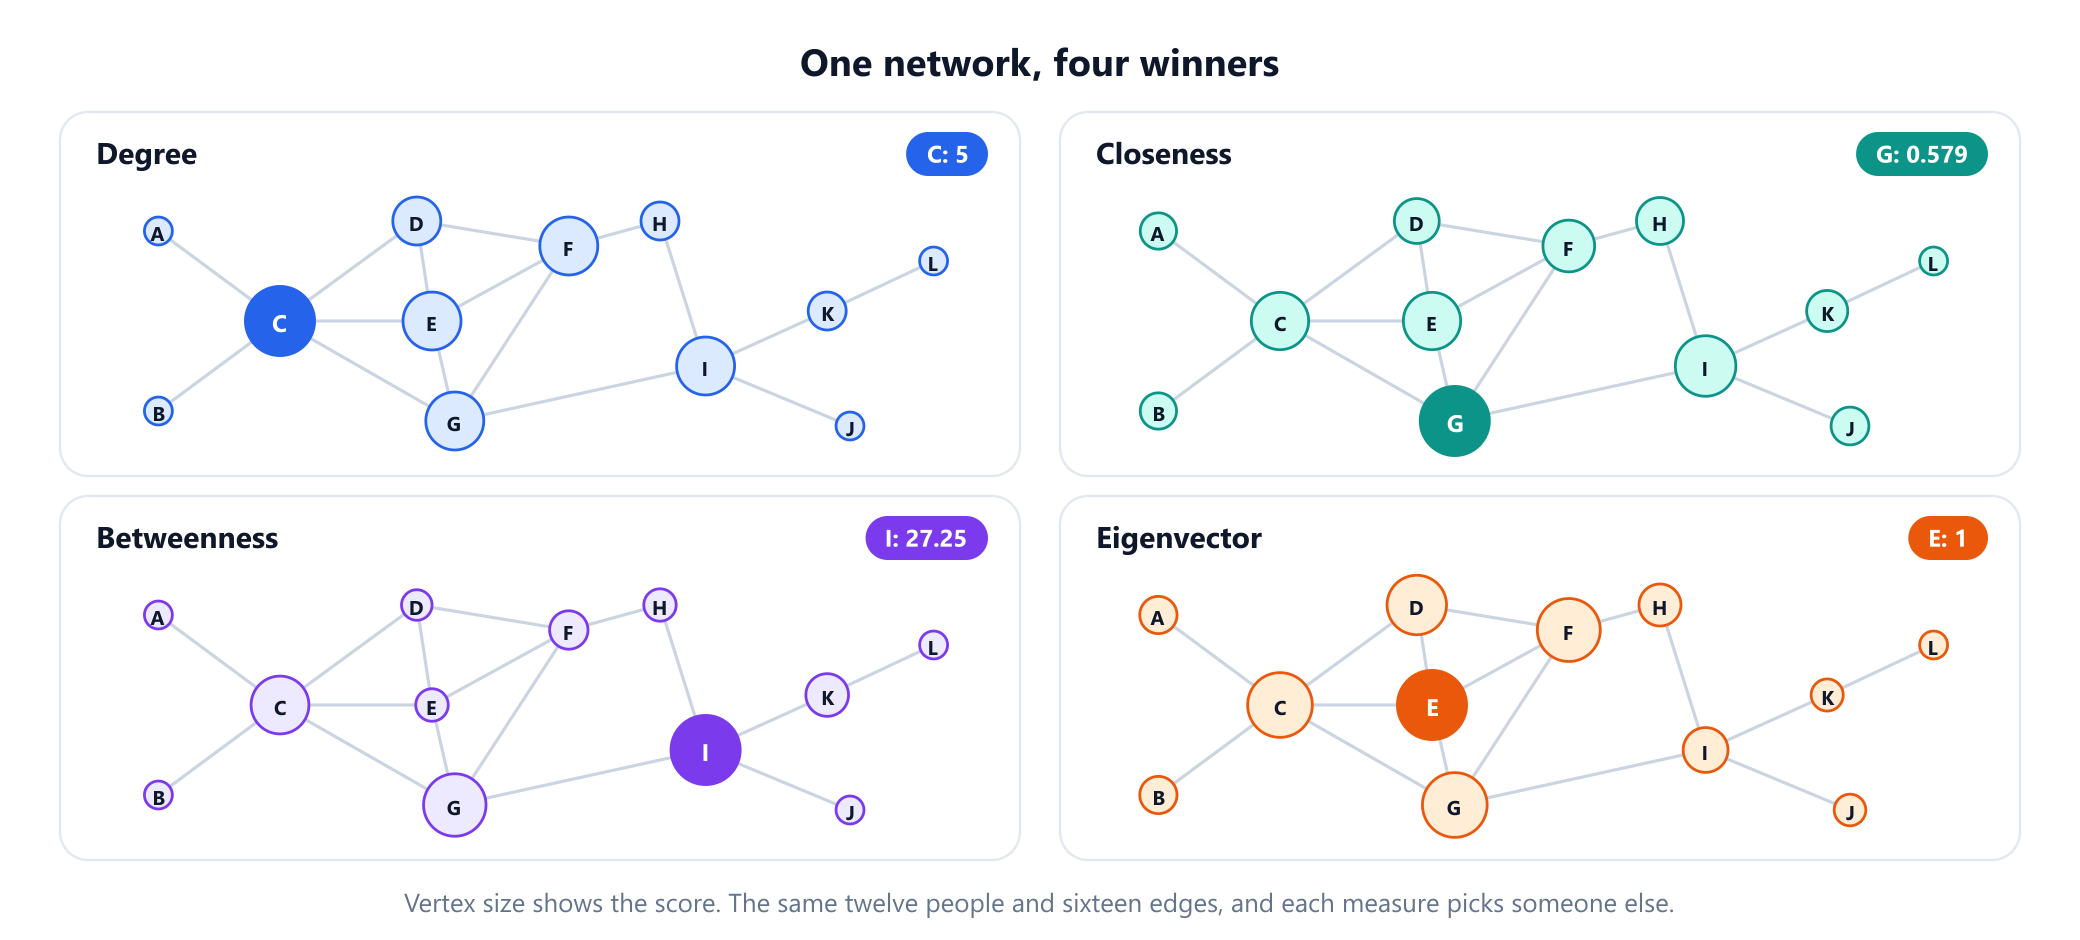
El ejemplo que usaremos es una empresa de doce personas, A a L, con una arista entre dos personas que trabajan juntas directamente. Tiene 16 aristas y se encontró mediante una búsqueda por ordenador de una red pequeña en la que el grado, la cercanía, la intermediación y la centralidad de vector propio eligen cada una a una persona distinta. Eso amplía la idea de la red "cometa" de David Krackhardt, de 1990: diez personas en las que el grado, la cercanía y la intermediación favorecen a personas distintas.
| Persona | Grado | Cercanía | Intermediación | Vector propio |
|---|---|---|---|---|
| A | 1 | 0.344 | 0 | 0.262 |
| B | 1 | 0.344 | 0 | 0.262 |
| C | 5 | 0.500 | 20.33 | 0.921 |
| D | 3 | 0.407 | 1.75 | 0.796 |
| E | 4 | 0.500 | 3.08 | 1.000 |
| F | 4 | 0.458 | 7.08 | 0.879 |
| G | 4 | 0.579 | 23.50 | 0.922 |
| H | 2 | 0.423 | 3.00 | 0.376 |
| I | 4 | 0.524 | 27.25 | 0.444 |
| J | 1 | 0.355 | 0 | 0.126 |
| K | 2 | 0.379 | 10.00 | 0.137 |
| L | 1 | 0.282 | 0 | 0.039 |
Las cuatro respuestas son correctas. C tiene más contactos, dos de los cuales no conocen a nadie más. G puede llegar a toda la empresa con el menor número total de pasos. I es el único nexo entre J, K y L y el resto de la empresa. Y E ocupa el centro del grupo más unido. Observa lo mal que les va a los ganadores en las medidas de los demás: E es sexto en intermediación e I es sexto en centralidad de vector propio. Las secciones 3 a 5 explican cada columna y dan el código que la produjo.
3. Grado y cercanía: contactos y alcance
La centralidad de grado es el número de aristas que inciden en un vértice, un tema que la guía del grado de un vértice trata en profundidad. Solo mira a un paso de distancia, así que no cuesta casi nada y pasa por alto todo lo que hay más allá de los vecinos. C gana con 5, y en un grafo dirigido se divide en grado de entrada y grado de salida.
La centralidad de cercanía tiene en cuenta todos los vértices. Para un vértice v de un grafo conexo, suma las distancias más cortas desde v a todos los demás y luego invierte el resultado para que una puntuación más alta signifique más cerca: (n - 1) / suma de distancias. Las distancias se obtienen con una búsqueda en anchura desde cada vértice. El programa siguiente se guarda como people.py, porque los programas posteriores lo importan.
from collections import deque

# Quién trabaja directamente con quién en una empresa de doce personas.
PEOPLE = 'AC BC CD CE CG DE DF EF EG FG FH GI HI IJ IK KL'.split()

def graph(edges):
    adj = {}
    for a, b in edges:
        adj.setdefault(a, []).append(b)
        adj.setdefault(b, []).append(a)
    return adj

def distances(adj, source):
    """Búsqueda en anchura: número de pasos desde source hasta todo lo que puede alcanzar."""
    dist, queue = {source: 0}, deque([source])
    while queue:
        v = queue.popleft()
        for w in adj[v]:
            if w not in dist:
                dist[w] = dist[v] + 1
                queue.append(w)
    return dist

def degree(adj):
    return {v: len(adj[v]) for v in adj}

def closeness(adj):
    """(vértices alcanzables) / (suma de distancias a ellos): engañoso si adj no es conexo."""
    result = {}
    for v in adj:
        dist = distances(adj, v)
        result[v] = (len(dist) - 1) / sum(dist.values()) if len(dist) > 1 else 0.0
    return result

def harmonic(adj):
    """Media de 1 / distancia sobre todos los demás vértices; un vértice inalcanzable suma 0."""
    n = len(adj)
    return {v: sum(1 / d for d in distances(adj, v).values() if d) / (n - 1) for v in adj}

def winner(score):
    return max(sorted(score), key=score.get)

if __name__ == '__main__':
    adj = graph(PEOPLE)
    d, c, h = degree(adj), closeness(adj), harmonic(adj)
    print('most contacts: ', winner(d), d[winner(d)])
    print('closest to all:', winner(c), round(c[winner(c)], 3))
    # Añade una pareja de contratistas que solo trabajan entre sí.
    split = graph(PEOPLE + ['XY'])
    c2, h2 = closeness(split), harmonic(split)
    print('naive closeness, X:', round(c2['X'], 3), ' G:', round(c2['G'], 3))
    print('harmonic,        X:', round(h2['X'], 3), ' G:', round(h2['G'], 3))
# most contacts:  C 5
# closest to all: G 0.579
# naive closeness, X: 1.0  G: 0.579
# harmonic,        X: 0.077  G: 0.564
G llega a las otras once personas en 19 pasos en total, así que su cercanía es 11 / 19 = 0,579.
Las dos últimas líneas de la salida muestran la trampa habitual. La cercanía supone que todos pueden llegar a todos. Añade una pareja de contratistas, X y Y, que solo trabajan entre sí, y el arreglo habitual de sumar solo sobre los vértices alcanzables da a X una puntuación perfecta de 1,0, muy por encima de G, simplemente porque su diminuta componente tiene un paso de ancho. La centralidad armónica lo corrige promediando 1 / distancia sobre todos los demás vértices, de modo que un vértice inalcanzable aporta 0. Da a X solo 0,077 y deja a G en 0,564. La medida la propusieron por primera vez Massimo Marchiori y Vito Latora en 2000, y el estudio de 2014 de Paolo Boldi y Sebastiano Vigna sobre lo que debería cumplir una medida de centralidad concluyó que es la única de las medidas que probaron que satisface sus tres axiomas. Úsala siempre que un grafo pueda ser no conexo; la guía de componentes conexas muestra cómo comprobarlo.
4. Intermediación: por quién pasan las rutas
La centralidad de intermediación plantea otra pregunta: si cada persona enviara un mensaje a todas las demás por rutas más cortas, ¿cuántos de esos mensajes pasarían por v? Para cada par s, t que no incluya v, toma la fracción de caminos más cortos s-t que pasan por v, y suma esas fracciones. Las fracciones importan: en un cuadrado S, X, T, Y, hay dos rutas igual de cortas de S a T, así que X y Y reciben medio punto cada uno por ese par.
Calculada de forma directa, requiere un tiempo O(V³) o peor. En 2001, Ulrik Brandes mostró cómo hacerlo en O(VE) en un grafo sin pesos, ejecutando una búsqueda en anchura por cada origen y recorriendo después el camino de vuelta desde el vértice más lejano. La clave es que el crédito que cada vértice pasa hacia arriba puede calcularse a partir del crédito de los vértices que tiene debajo, en lugar de recalcularse para cada destino.
from collections import deque
from people import PEOPLE, graph

def betweenness(adj, sources=None):
    """Algoritmo de Brandes para un grafo no dirigido y sin pesos.

    sources=None usa todos los vértices y es exacto. Una lista de orígenes da una estimación."""
    sources = list(adj) if sources is None else sources
    score = dict.fromkeys(adj, 0.0)
    for s in sources:
        # Fase 1: BFS desde s, contando caminos más cortos (sigma) y anotando predecesores.
        order, preds, sigma, dist = [], {v: [] for v in adj}, dict.fromkeys(adj, 0), {s: 0}
        sigma[s] = 1
        queue = deque([s])
        while queue:
            v = queue.popleft()
            order.append(v)
            for w in adj[v]:
                if w not in dist:
                    dist[w] = dist[v] + 1
                    queue.append(w)
                if dist[w] == dist[v] + 1:
                    sigma[w] += sigma[v]
                    preds[w].append(v)
        # Fase 2: volver desde el vértice más lejano, pasando crédito a los predecesores.
        delta = dict.fromkeys(adj, 0.0)
        for w in reversed(order):
            for v in preds[w]:
                delta[v] += sigma[v] / sigma[w] * (1 + delta[w])
            if w != s:
                score[w] += delta[w]
    scale = len(adj) / len(sources) / 2          # cada par se ve desde sus dos extremos
    return {v: x * scale for v, x in score.items()}

if __name__ == '__main__':
    b = betweenness(graph(PEOPLE))
    for v in sorted(b, key=b.get, reverse=True)[:5]:
        print(v, round(b[v], 2))
    print(betweenness(graph('SX XT SY YT'.split())))   # dos rutas iguales de S a T
# I 27.25
# G 23.5
# C 20.33
# K 10.0
# F 7.08
# {'S': 0.5, 'X': 0.5, 'T': 0.5, 'Y': 0.5}
Cada búsqueda cuenta cada par dos veces, una desde cada extremo, y por eso el programa divide entre 2 en un grafo no dirigido. En un grafo ponderado, Dijkstra sustituye a la búsqueda en anchura y el tiempo pasa a ser O(VE + V² log V).
I obtiene 27,25 de 55 posibles, el número de pares que no incluyen a I, así que aproximadamente la mitad de las rutas más cortas entre otros pares pasan por él. De esos 27,25 puntos, 26 proceden de pares en los que participa J, K o L, que no tienen otra salida. I solo tiene cuatro contactos, tantos como E, F y G, que es justo lo que el grado no puede mostrar.
5. Centralidad de vector propio: quiénes son tus contactos
El grado cuenta los contactos como si todos valieran lo mismo. La centralidad de vector propio dice que un contacto vale tanto como la propia puntuación de ese contacto, así que la puntuación de un vértice es proporcional a la suma de las puntuaciones de sus vecinos: x = (1 / λ) A x, donde A es la matriz de adyacencia. Eso hace que x sea un vector propio de A. En un grafo no dirigido conexo, el teorema de Perron-Frobenius garantiza que existe exactamente un vector propio con todas sus entradas positivas, salvo escalado, asociado al mayor valor propio, y esa es la puntuación. Phillip Bonacich la convirtió en una herramienta estándar del análisis de redes en 1972, aunque John Seeley ya había usado una puntuación similar con datos sociométricos en 1949.
La forma habitual de calcularla es el método de la potencia: empezar con puntuaciones iguales, sustituir cada una por la suma de las de sus vecinos, reescalar y repetir.
from people import PEOPLE, graph

def eigenvector(adj, shift=1.0, steps=2000):
    """Método de la potencia sobre A + shift * I, escalado para que la puntuación máxima sea 1."""
    x = dict.fromkeys(adj, 1.0)
    for _ in range(steps):
        y = {v: shift * x[v] + sum(x[u] for u in adj[v]) for v in adj}
        top = max(y.values())
        x = {v: y[v] / top for v in y}
    return x

if __name__ == '__main__':
    e = eigenvector(graph(PEOPLE))
    for v in sorted(e, key=e.get, reverse=True)[:4]:
        print(v, round(e[v], 3))
    # Sin el desplazamiento, un grafo bipartito puede hacer que la iteración salte para siempre.
    path = graph('AB BC CD'.split())
    x = {'A': 1.0, 'B': 0.0, 'C': 0.0, 'D': 0.0}
    for step in range(1, 52):
        y = {v: sum(x[u] for u in path[v]) for v in path}
        top = max(y.values())
        x = {v: y[v] / top for v in y}
        if step >= 50:
            print('step', step, {v: round(x[v], 3) for v in sorted(x)})
    print('with the shift', {v: round(s, 3) for v, s in sorted(eigenvector(path).items())})
# E 1.0
# G 0.922
# C 0.921
# F 0.879
# step 50 {'A': 0.618, 'B': 0.0, 'C': 1.0, 'D': 0.0}
# step 51 {'A': 0.0, 'B': 1.0, 'C': 0.0, 'D': 0.618}
# with the shift {'A': 0.618, 'B': 1.0, 'C': 1.0, 'D': 0.618}
E gana aunque C tenga más contactos y G esté más cerca de todos. Las puntuaciones de los cuatro contactos de E suman 3,519. Los cuatro de G suman solo 3,244, porque uno de ellos es I, que solo obtiene 0,444 y lleva hacia el borde de la empresa.
La salida también muestra por qué el código añade shift. En un grafo bipartito, A tiene un valor propio del mismo valor absoluto y signo contrario, así que el método de la potencia simple puede no estabilizarse nunca: en un camino de cuatro vértices, partiendo de un único vértice, las puntuaciones saltan entre dos estados para siempre, con la mitad de ellas a 0 en cada paso. Iterar con A + I desplaza todos los valores propios 1 hacia arriba, elimina el empate y deja los vectores propios sin cambios. La guía de teoría espectral de grafos explica qué te dicen los demás valores propios.
En los grafos dirigidos la medida falla: un vértice al que nadie apunta obtiene 0, y lo mismo ocurre con todo aquello a lo que solo él apunta. La medida de Leo Katz, de 1953, evita ese problema: cuenta todos los paseos que llegan a un vértice, y un paseo de longitud k se pondera con α^k. En su forma moderna se escribe x = α Aᵀ x + 1, con α menor que 1 / λ, lo que equivale a dar a cada vértice una pequeña cantidad de puntuación gratuita. PageRank introduce un cambio más.
6. PageRank: seguir los enlaces
PageRank, publicado por Sergey Brin y Larry Page en 1998, se diseñó para la web, donde un enlace de una página es un voto a favor de otra página. La medida de Katz tiene ahí un defecto: una página que enlaza a otras mil transmite su puntuación completa a cada una de ellas. PageRank hace que cada página reparta su puntuación entre sus enlaces salientes.
La imagen habitual es la de un navegante aleatorio. En cada paso, el navegante sigue un enlace al azar de la página actual con probabilidad d, el factor de amortiguación, y en caso contrario salta a una página elegida uniformemente al azar. El rango de una página es la fracción del tiempo que pasa en ella a largo plazo. En la forma normalizada, en la que todos los rangos suman 1:
rank(p) = (1 - d) / n + d * suma de rank(q) / outdegree(q), sobre las páginas q que enlazan a pEl ejemplo es una web de ocho páginas. Cada página puede llegar a todas las demás, así que ninguna queda aislada. Brin y Page contaron que solían fijar d en 0,85, y el programa hace lo mismo.
# Ocho páginas web y las páginas a las que enlaza cada una.
WEB = {'A': 'CH', 'B': 'CDEH', 'C': 'A', 'D': 'C', 'E': 'D', 'F': 'BDG', 'G': 'D', 'H': 'AF'}

def pagerank(links, d=0.85, tol=1e-10):
    """Método de la potencia. Una página sin enlaces salientes reparte su rango con todas las páginas."""
    pages = sorted(links)
    n = len(pages)
    rank = dict.fromkeys(pages, 1 / n)
    steps = 0
    while True:
        dangling = sum(rank[p] for p in pages if not links[p])
        new = dict.fromkeys(pages, (1 - d) / n + d * dangling / n)
        for p in pages:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        change = sum(abs(new[p] - rank[p]) for p in pages)
        rank, steps = new, steps + 1
        if change < tol:
            return rank, steps

if __name__ == '__main__':
    rank, steps = pagerank(WEB)
    inlinks = {p: sum(p in out for out in WEB.values()) for p in WEB}
    for p in sorted(rank, key=rank.get, reverse=True):
        print(p, 'in-links', inlinks[p], ' rank', round(rank[p], 3))
    print('iterations', steps, ' total', round(sum(rank.values()), 6))
# A in-links 2  rank 0.293
# C in-links 3  rank 0.247
# H in-links 2  rank 0.152
# D in-links 4  rank 0.111
# F in-links 1  rank 0.084
# B in-links 1  rank 0.042
# G in-links 1  rank 0.042
# E in-links 1  rank 0.028
# iterations 70  total 1.0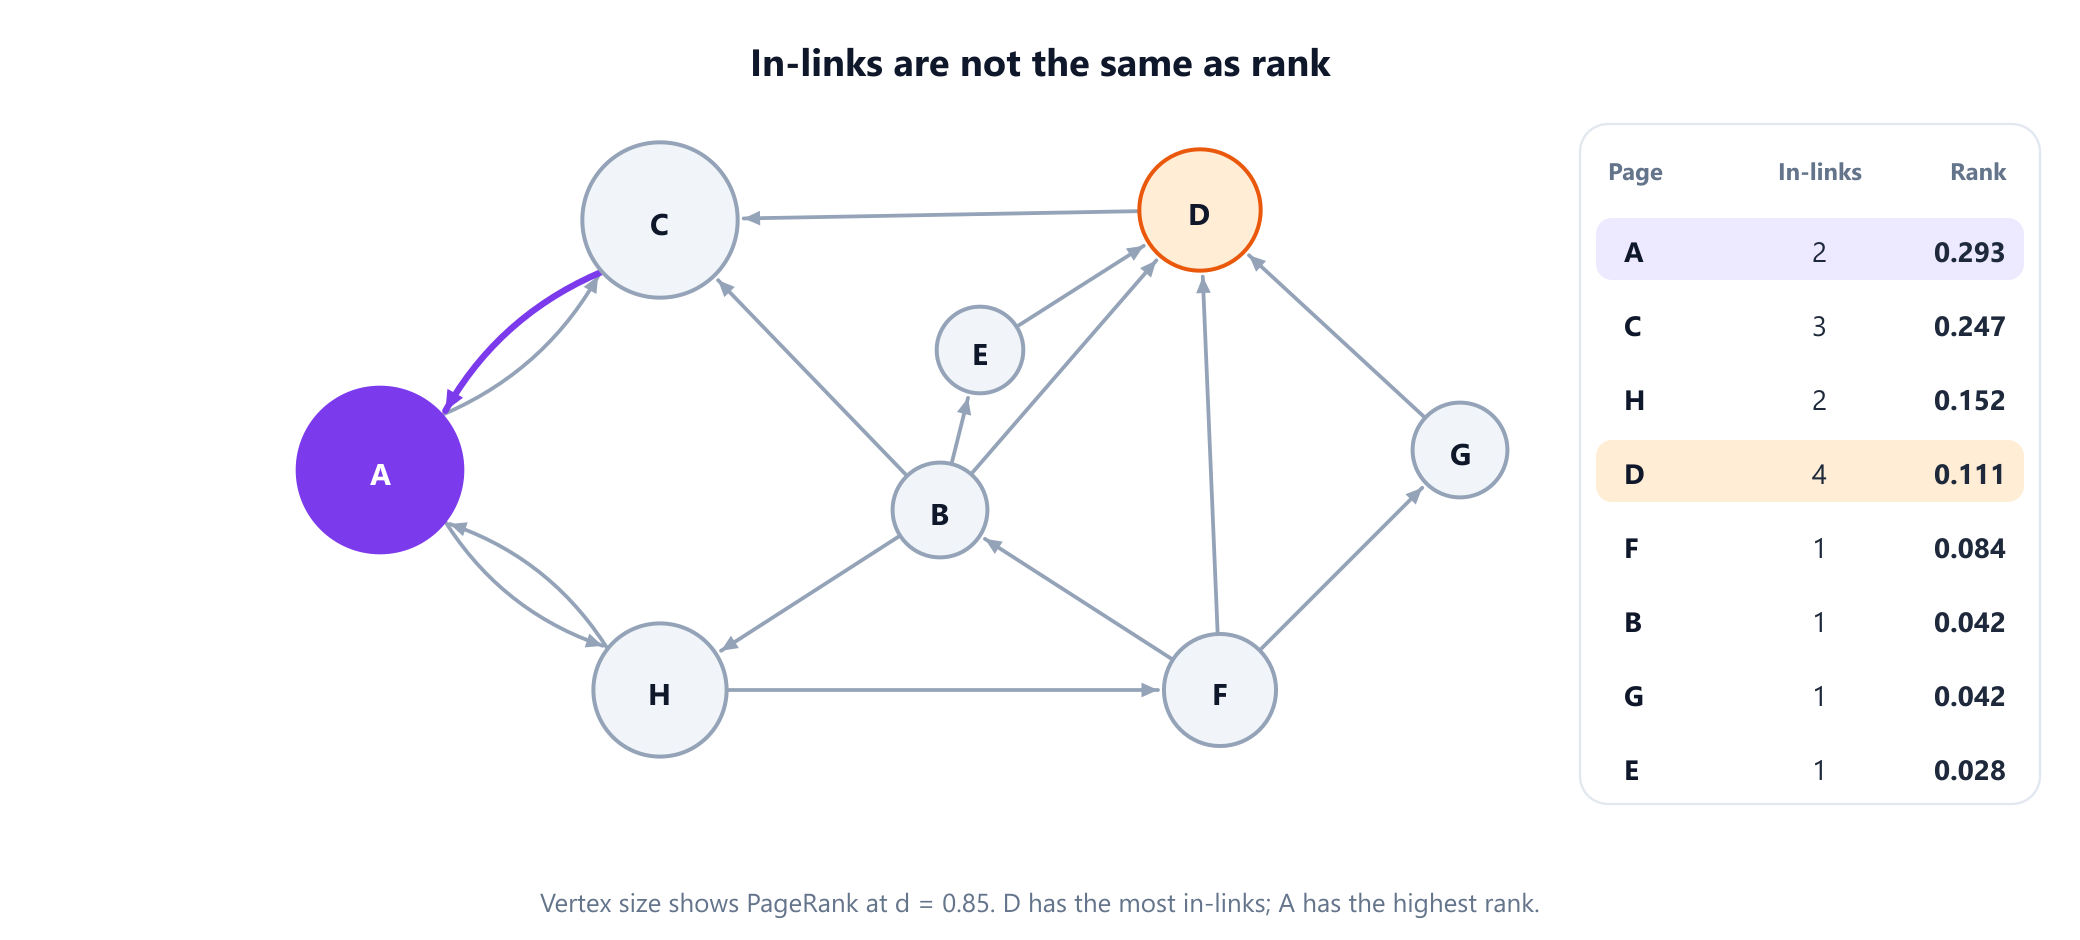
D tiene más enlaces entrantes, cuatro, pero proceden de páginas con poco rango que dar, y B y F reparten el suyo entre varios enlaces. D transmite después todo su rango a C, y C transmite todo su rango a A. Así, A, con solo dos enlaces entrantes, termina primera con 0,293, y A y C concentran juntas el 54 % del total. En un grafo no dirigido, el panorama es mucho más sencillo: con d = 1 en un grafo conexo no bipartito, PageRank es exactamente proporcional al grado. PageRank es sobre todo una medida para grafos dirigidos, y la guía de grafos dirigidos y no dirigidos explica por qué importa la distinción.
7. Callejones sin salida, bucles cerrados y el factor de amortiguación
El factor de amortiguación no es un adorno. Dos tipos de página rompen el proceso simple de "seguir un enlace", y el siguiente programa rompe la web del ejemplo de las dos maneras.
from pagerank import WEB, pagerank

def leaky(links, d=0.85, steps=200):
    """La actualización de libro de texto, sin tratar los callejones sin salida."""
    n = len(links)
    rank = dict.fromkeys(links, 1 / n)
    for _ in range(steps):
        new = dict.fromkeys(links, (1 - d) / n)
        for p in links:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        rank = new
    return rank

if __name__ == '__main__':
    dead_end = {**WEB, 'A': ''}                    # A ya no enlaza a ninguna parte
    print('dead end, naive update:   total', round(sum(leaky(dead_end).values()), 3))
    print('dead end, handled:        total', round(sum(pagerank(dead_end)[0].values()), 3))
    closed = {**WEB, 'A': 'C'}                     # A y C ahora solo enlazan entre sí
    for d in (0.85, 0.999):
        rank = pagerank(closed, d=d, tol=1e-9)[0]
        print(f'closed loop, d = {d}: A + C hold', round(rank['A'] + rank['C'], 3))
# dead end, naive update:   total 0.403
# dead end, handled:        total 1.0
# closed loop, d = 0.85: A + C hold 0.791
# closed loop, d = 0.999: A + C hold 0.998
Un callejón sin salida es una página sin enlaces salientes. La actualización de libro de texto no tiene adónde enviar su rango, así que el rango se escapa del sistema: con A convertida en un callejón sin salida, el total cae de 1 a 0,403. La solución, usada en la función pagerank de arriba, es repartir el rango de un callejón sin salida entre todas las páginas, como si el navegante saltara al azar desde allí.
Un bucle cerrado es un grupo de páginas que solo enlazan entre sí. Una vez que el navegante entra, solo el salto aleatorio lo saca. Haz que A enlace solo a C y la pareja concentra el 79,1 % de todo el rango con d = 0.85, y el 99,8 % con d = 0.999. Cuanto menor es d, menos puede absorber un bucle.
El precio de un valor grande de d es la velocidad. El cambio en los rangos se reduce al menos en un factor d en cada paso, lo que coincide con el resultado de Taher Haveliwala y Sepandar Kamvar según el cual el segundo valor propio de la matriz de PageRank es como máximo d en valor absoluto. El siguiente programa lo mide en una web de 1000 páginas agrupadas en 20 sitios.
import random

def web(sites, size, rnd):
    """Las páginas enlazan sobre todo dentro de su propio sitio; una de cada diez, más o menos, enlaza a otro sitio."""
    links = {}
    for s in range(sites):
        for i in range(size):
            out = {s * size + rnd.randrange(size) for _ in range(5)}
            if rnd.random() < 0.1:
                out.add(rnd.randrange(sites * size))
            links[s * size + i] = sorted(out - {s * size + i})
    return links

def steps_needed(links, d, tol=1e-6):
    n = len(links)
    rank, step = dict.fromkeys(links, 1 / n), 0
    while True:
        lost = sum(rank[p] for p in links if not links[p])
        new = dict.fromkeys(links, (1 - d) / n + d * lost / n)
        for p in links:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        change = sum(abs(new[p] - rank[p]) for p in links)
        rank, step = new, step + 1
        if change < tol:
            return step

if __name__ == '__main__':
    links = web(20, 50, random.Random(5))
    for d in (0.5, 0.85, 0.95, 0.99):
        print('d =', d, ' iterations:', steps_needed(links, d))
# d = 0.5  iterations: 13
# d = 0.85  iterations: 53
# d = 0.95  iterations: 149
# d = 0.99  iterations: 607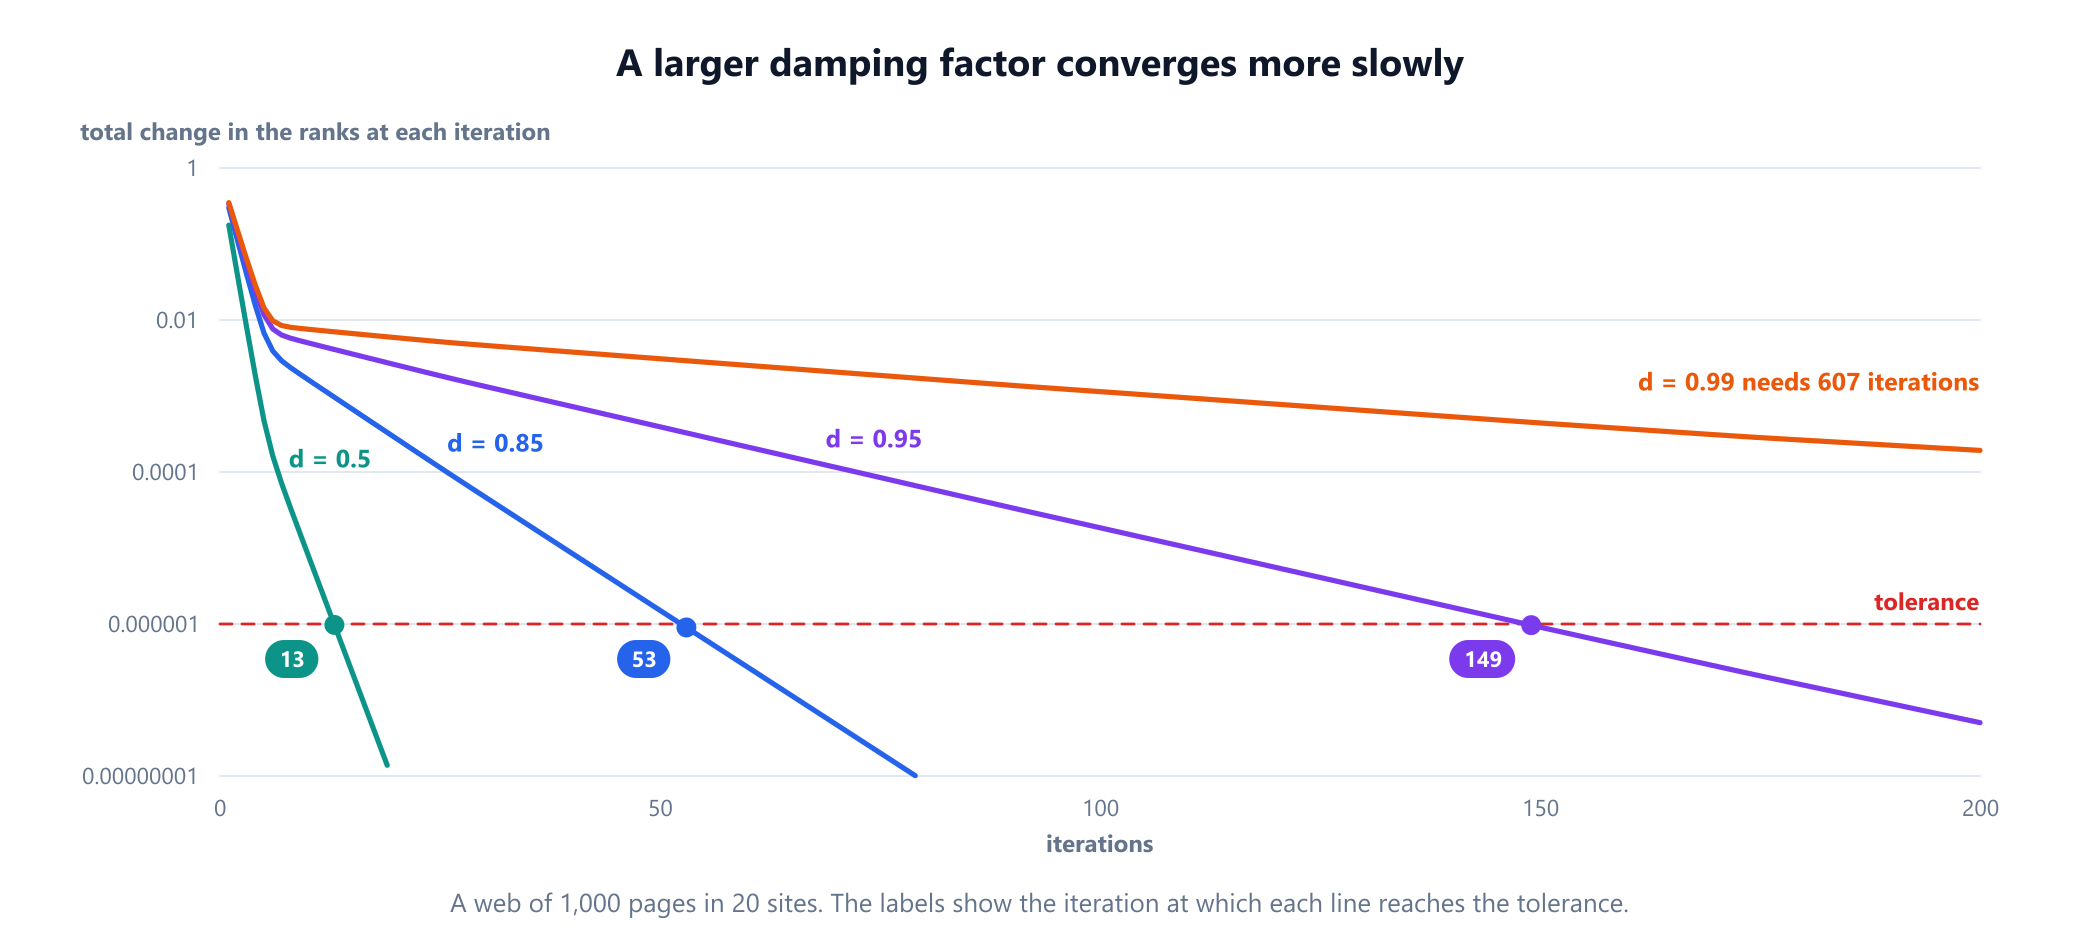
8. ¿Coinciden las medidas?
Si las medidas solieran señalar los mismos vértices, siempre podrías usar la más barata. El siguiente programa construye tres tipos de red con 400 vértices cada una y luego pregunta cuántos de los 20 primeros vértices por intermediación están también entre los 20 primeros según cada una de las otras medidas.
import random
from people import degree, closeness
from brandes import betweenness
from eigen import eigenvector

def link(adj, a, b):
    if a != b and b not in adj[a]:
        adj[a].append(b)
        adj[b].append(a)

def hubs(n, m, rnd):
    """Conexión preferencial: los recién llegados prefieren vértices que ya tienen muchas aristas."""
    adj = {v: [] for v in range(n)}
    pool = list(range(m))
    for v in range(m, n):
        for t in set(rnd.choice(pool) for _ in range(m)):
            link(adj, v, t)
            pool += [v, t]
    return adj

def two_groups(n, rnd):
    """Dos mitades densas unidas solo por seis aristas."""
    adj = {v: [] for v in range(n)}
    half = n // 2
    for a in range(n):
        for b in range(a + 1, n):
            if (a < half) == (b < half) and rnd.random() < 0.05:
                link(adj, a, b)
    for _ in range(6):
        link(adj, rnd.randrange(half), rnd.randrange(half, n))
    return adj

def ring(n, rnd):
    """Cada vértice unido a sus 3 vecinos más cercanos en cada sentido; 5 % de aristas recableadas."""
    adj = {v: [] for v in range(n)}
    for v in range(n):
        for k in (1, 2, 3):
            link(adj, v, rnd.randrange(n) if rnd.random() < 0.05 else (v + k) % n)
    return adj

def top(score, k=20):
    return set(sorted(score, key=lambda v: (-score[v], v))[:k])

if __name__ == '__main__':
    rnd = random.Random(11)
    print('top 20 by betweenness also in the top 20 by:  degree, closeness, eigenvector')
    for name, adj in (('hubs', hubs(400, 2, rnd)), ('two groups', two_groups(400, rnd)), ('ring', ring(400, rnd))):
        b = top(betweenness(adj))
        print(f'{name:11}', len(b & top(degree(adj))), len(b & top(closeness(adj))), len(b & top(eigenvector(adj, steps=4000))))
# top 20 by betweenness also in the top 20 by:  degree, closeness, eigenvector
# hubs        18 13 14
# two groups  8 17 4
# ring        6 9 1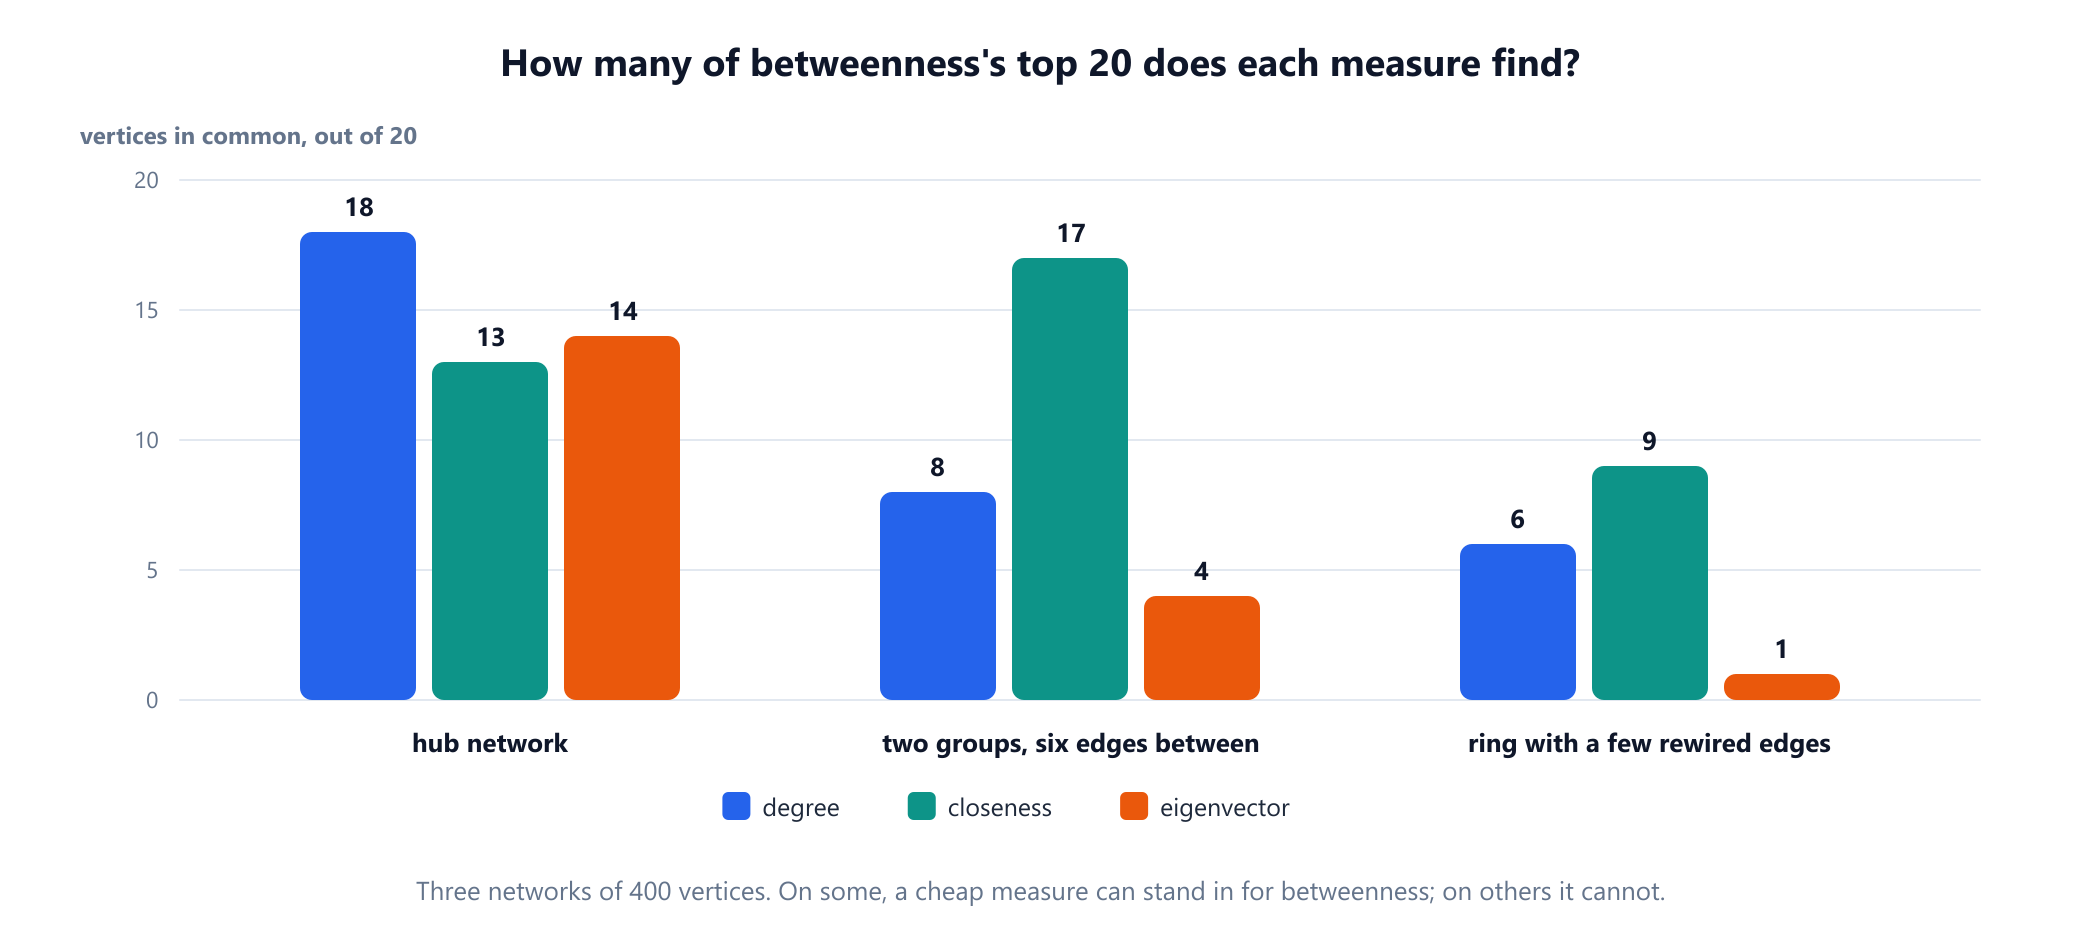
En la red de hubs, donde unos pocos vértices acaparan la mayoría de las aristas, el grado encuentra 18 de los 20, así que pagar por la intermediación aporta poco. En los dos grupos unidos por seis aristas, el grado solo encuentra 8 y la centralidad de vector propio solo 4, porque sus 20 primeros vértices están todos en el mismo grupo: se concentra en una mitad y no puede ver la otra. En el anillo, donde la estructura es sobre todo local, las medidas eligen en gran parte vértices distintos. Antes de confiar en un sustituto barato, pruébalo en una muestra de tu propia red.
9. Grafos grandes: estimar la intermediación
La intermediación exacta necesita una búsqueda por vértice, algo inalcanzable en grafos con cientos de millones de vértices. El atajo habitual, estudiado por Brandes y Christian Pich en 2007, consiste en ejecutar la búsqueda desde una muestra aleatoria de vértices de origen y escalar el resultado. El argumento sources del programa de la sección 4 ya lo hace.
import random
from brandes import betweenness
from agree import hubs, top

if __name__ == '__main__':
    rnd = random.Random(3)
    adj = hubs(1000, 3, rnd)
    exact = betweenness(adj)
    best = top(exact, 10)
    print('sources  work  top 10 found  mean error of the top 10   (average of 10 runs)')
    for k in (10, 50, 100, 250, 500):
        found = error = 0
        for _ in range(10):
            estimate = betweenness(adj, rnd.sample(sorted(adj), k))
            found += len(best & top(estimate, 10))
            error += sum(abs(estimate[v] - exact[v]) / exact[v] for v in best) / 10
        print(f'{k:7} {k / 10:4.0f}% {found / 10:13.1f} {error / 10:12.1%}')
# sources  work  top 10 found  mean error of the top 10   (average of 10 runs)
#      10    1%           6.2        36.8%
#      50    5%           8.1        17.3%
#     100   10%           9.4        13.4%
#     250   25%           9.1         8.6%
#     500   50%           9.4         4.0%
En esta red de 1000 vértices, el 10 % del trabajo encuentra de media 9,4 de los 10 primeros vértices reales, con un error típico de alrededor del 13 % en sus puntuaciones. El muestreo sirve para encontrar la parte alta de la lista, y es mucho menos exacto con las puntuaciones en sí. Una muestra del 1 % es demasiado pequeña: solo encuentra 6,2. El grado, en cambio, sigue siendo barato a cualquier tamaño, y la centralidad de vector propio y PageRank solo necesitan un número limitado de pasadas sobre las aristas, y por eso escalan a grafos del tamaño de la web.
10. Dónde se usan estas medidas
- Búsqueda web. PageRank fue una parte central del primer motor de búsqueda de Google, combinado con otras señales como el texto de las páginas y de los enlaces.
- Biología. Hawoong Jeong y sus colegas informaron en 2001 de que, en la red de proteínas de la levadura, las proteínas muy conectadas tienen más probabilidades de ser esenciales para la supervivencia. La guía de teoría de grafos en biología estudia los hubs y los cuellos de botella.
- Detección de comunidades. El método de Michelle Girvan y Mark Newman, de 2002, elimina repetidamente la arista con mayor intermediación y vuelve a calcular la intermediación tras cada eliminación, ya que las aristas entre grupos llevan la mayoría de las rutas.
- Seguridad. La intermediación señala los equipos por los que pasan más caminos de ataque, que es donde una sola corrección ayuda más; consulta teoría de grafos en ciberseguridad.
- Aprendizaje automático. Las puntuaciones de centralidad son características de entrada habituales para los vértices, y las redes neuronales de grafos aprenden cantidades relacionadas a partir de los datos.
11. Una breve historia
La centralidad nació en el estudio de los grupos pequeños. Alex Bavelas introdujo la idea en 1948, y los experimentos de su Group Networks Laboratory del MIT, publicados en su artículo de 1950, la relacionaron con lo bien que los grupos pequeños resolvían problemas. Gert Sabidussi dio un tratamiento matemático de la cercanía en 1966. El índice de estatus de Leo Katz apareció en 1953, y la medida de vector propio de Phillip Bonacich en 1972. Jac Anthonisse, en un informe inédito de 1971, y Linton Freeman, en 1977, definieron la intermediación de forma independiente, y el artículo de Freeman de 1979 organizó el grado, la cercanía y la intermediación en el marco que todavía se enseña hoy. PageRank llegó en 1998, y la historia de Massimo Franceschet de 2011 rastrea sus ideas hacia atrás a través de la bibliometría, la sociometría y la econometría, hasta el modelo insumo-producto de Wassily Leontief de 1941 y el índice sociométrico de John Seeley de 1949. El algoritmo de Brandes de 2001 hizo práctica la intermediación en redes grandes.
12. Errores comunes
| Error | Por qué está mal | Solución |
|---|---|---|
| Pedir "el" vértice más importante | En el ejemplo, cuatro medidas señalan a cuatro personas | Decide primero qué viaja por la red |
| Tratar los enlaces entrantes como rango | D tiene más enlaces entrantes y queda cuarta | Usa PageRank cuando importa el origen de un enlace |
| Cercanía en un grafo no conexo | Una pareja de contratistas aislados obtuvo 1,0 | Usa la centralidad armónica |
| Olvidar dividir entre 2 la intermediación no dirigida | Cada par se cuenta desde ambos extremos | Divide entre 2 |
| Usar la fuerza del vínculo como distancia | Las medidas de caminos más cortos tratan un vínculo fuerte como uno largo | Convierte primero los pesos en distancias, por ejemplo 1 / w |
| Comparar puntuaciones brutas entre grafos | La intermediación crece con el tamaño del grafo | Normaliza, o compara posiciones |
| Método de la potencia simple en un grafo bipartito | Las puntuaciones pueden oscilar para siempre | Itera con A + I |
| Ignorar los callejones sin salida en PageRank | El rango total se redujo a 0,403 | Reparte el rango de un callejón sin salida entre todas las páginas |
13. Glosario
| Término | Significado |
|---|---|
| Centralidad | Una puntuación de lo importante que es un vértice, según una definición explícita |
| Centralidad de grado | El número de aristas que inciden en un vértice |
| Centralidad de cercanía | (n - 1) dividido entre la suma de las distancias a todos los demás vértices |
| Centralidad armónica | La media de 1 / distancia sobre todos los demás vértices |
| Centralidad de intermediación | La suma, sobre todos los pares, de la fracción de caminos más cortos que pasan por un vértice |
| Centralidad de vector propio | Una puntuación proporcional a la suma de las puntuaciones de los vecinos |
| Centralidad de Katz | Centralidad de vector propio con una pequeña constante añadida para cada vértice |
| PageRank | La fracción del tiempo que un navegante aleatorio pasa en una página a largo plazo |
| Factor de amortiguación | La probabilidad d de que el navegante siga un enlace en lugar de saltar |
| Callejón sin salida | Una página sin enlaces salientes |
| Método de la potencia | Multiplicar repetidamente por una matriz y reescalar, para encontrar su vector propio principal |
| Algoritmo de Brandes | Intermediación exacta en O(VE) en un grafo sin pesos |
14. Preguntas frecuentes
¿Qué es la centralidad en teoría de grafos?
La centralidad es cualquier puntuación que indica lo importante que es un vértice dentro de un grafo. Distintas definiciones capturan distintos tipos de importancia: el número de conexiones directas, la distancia a todos los demás, la proporción de rutas más cortas que pasan por el vértice o la importancia de sus vecinos. Sobre el mismo grafo, estas definiciones pueden señalar vértices distintos.
¿Cuál es la diferencia entre la centralidad de grado, de cercanía y de intermediación?
El grado cuenta las conexiones directas de un vértice. La cercanía mide con qué pocos pasos se llega a todos los demás vértices. La intermediación mide cuántas de las rutas más cortas entre otros pares pasan por el vértice. Una persona puede tener pocos contactos y aun así obtener la mayor intermediación por ser el único nexo entre dos grupos.
¿Cuál es la diferencia entre PageRank y la centralidad de vector propio?
Ambas dan a un vértice una puntuación basada en las puntuaciones de los vértices conectados a él. PageRank está diseñado para grafos dirigidos: cada página reparte su rango entre sus enlaces salientes, y un factor de amortiguación añade un salto aleatorio, de modo que ni las páginas sin enlaces entrantes ni los grupos cerrados de páginas pueden romperlo. La centralidad de vector propio se usa sobre todo en grafos no dirigidos conexos.
¿Qué medida de centralidad debería usar?
Depende de lo que se mueve por la red. Usa PageRank para enlaces dirigidos o citas, la intermediación cuando algo debe pasar por los vértices en su camino entre otros, la cercanía o la centralidad armónica cuando algo se difunde hacia fuera desde un punto, la centralidad de vector propio cuando importa la calidad de los vecinos, y el grado cuando quieras una primera respuesta rápida.
¿Cómo se calcula la centralidad de intermediación?
El algoritmo de Brandes ejecuta una búsqueda en anchura desde cada vértice, contando caminos más cortos, y luego recorre el camino de vuelta desde el vértice más lejano y pasa crédito a los predecesores. Requiere un tiempo O(VE) en un grafo sin pesos. En grafos muy grandes, ejecutarlo desde una muestra aleatoria de orígenes y escalar el resultado da una buena estimación de los vértices principales.
¿Qué es el factor de amortiguación en PageRank?
El factor de amortiguación d es la probabilidad de que el navegante aleatorio siga un enlace en lugar de saltar a una página al azar. Brin y Page contaron que solían fijarlo en 0,85. Un d mayor sigue más de cerca la estructura de enlaces, pero necesita más iteraciones y permite que los grupos cerrados de páginas absorban más rango.
15. Referencias
Los algoritmos, resultados y atribuciones anteriores proceden de estas fuentes, listadas en orden cronológico.
- Bavelas, A. (1948). "A Mathematical Model for Group Structures." Human Organization 7(3), 16 a 30.
- Seeley, J. R. (1949). "The Net of Reciprocal Influence: A Problem in Treating Sociometric Data." Canadian Journal of Psychology 3(4), 234 a 240.
- Bavelas, A. (1950). "Communication Patterns in Task-Oriented Groups." Journal of the Acoustical Society of America 22(6), 725 a 730.
- Katz, L. (1953). "A New Status Index Derived from Sociometric Analysis." Psychometrika 18(1), 39 a 43.
- Sabidussi, G. (1966). "The Centrality Index of a Graph." Psychometrika 31(4), 581 a 603.
- Anthonisse, J. M. (1971). "The Rush in a Directed Graph." Informe BN 9/71, Stichting Mathematisch Centrum, Ámsterdam.
- Bonacich, P. (1972). "Factoring and Weighting Approaches to Status Scores and Clique Identification." Journal of Mathematical Sociology 2(1), 113 a 120.
- Freeman, L. C. (1977). "A Set of Measures of Centrality Based on Betweenness." Sociometry 40(1), 35 a 41.
- Freeman, L. C. (1979). "Centrality in Social Networks: Conceptual Clarification." Social Networks 1(3), 215 a 239.
- Krackhardt, D. (1990). "Assessing the Political Landscape: Structure, Cognition, and Power in Organizations." Administrative Science Quarterly 35(2), 342 a 369.
- Brin, S. y Page, L. (1998). "The Anatomy of a Large-Scale Hypertextual Web Search Engine." Computer Networks and ISDN Systems 30(1 a 7), 107 a 117.
- Marchiori, M. y Latora, V. (2000). "Harmony in the Small-World." Physica A 285(3 a 4), 539 a 546.
- Brandes, U. (2001). "A Faster Algorithm for Betweenness Centrality." Journal of Mathematical Sociology 25(2), 163 a 177.
- Jeong, H., Mason, S. P., Barabási, A.-L. y Oltvai, Z. N. (2001). "Lethality and Centrality in Protein Networks." Nature 411, 41 a 42.
- Girvan, M. y Newman, M. E. J. (2002). "Community Structure in Social and Biological Networks." Proceedings of the National Academy of Sciences 99(12), 7821 a 7826.
- Haveliwala, T. H. y Kamvar, S. D. (2003). "The Second Eigenvalue of the Google Matrix." Informe técnico, Stanford University.
- Brandes, U. y Pich, C. (2007). "Centrality Estimation in Large Networks." International Journal of Bifurcation and Chaos 17(7), 2303 a 2318.
- Franceschet, M. (2011). "PageRank: Standing on the Shoulders of Giants." Communications of the ACM 54(6), 92 a 101.
- Boldi, P. y Vigna, S. (2014). "Axioms for Centrality." Internet Mathematics 10(3 a 4), 222 a 262.
Mira la búsqueda que hay detrás de las puntuaciones
La cercanía y la intermediación empiezan con una búsqueda en anchura desde cada vértice. Dibuja una red pequeña en el visualizador y ejecuta la búsqueda desde dos vértices distintos para ver por qué uno llega antes a todos.
Abrir el visualizador