
Table des Matières
- 1. La réponse courte
- 2. Quinze amis, trois groupes
- 3. Modularité : évaluer une partition
- 4. Girvan-Newman : couper les ponts entre les groupes
- 5. Louvain : faire croître les groupes de bas en haut
- 6. Propagation de labels : rapide, et différente à chaque fois
- 7. La limite de résolution
- 8. Un vrai test : le club de karaté de Zachary
- 9. Quand les groupes se brouillent : un banc d'essai mesuré
- 10. Où la détection de communautés est utilisée
- 11. Un bref historique
- 12. Erreurs fréquentes
- 13. Glossaire
- 14. Questions fréquentes
- 15. Références
1. La réponse courte
La détection de communautés répartit les sommets d'un réseau en groupes qui ont beaucoup d'arêtes à l'intérieur et peu d'arêtes entre eux. C'est le clustering appliqué aux graphes : cercles d'amis dans un réseau social, équipes dans un journal d'e-mails, complexes protéiques dans une cellule, thèmes dans un réseau de citations. Il n'existe pas de réponse correcte unique, si bien que chaque méthode repose sur une définition de ce qu'est un bon groupe, et la plupart des méthodes répandues utilisent la même, appelée modularité.
| Méthode | Idée | Coût | Même résultat à chaque exécution ? | Point de vigilance |
|---|---|---|---|---|
| Girvan-Newman | Supprimer les arêtes qui portent le plus de plus courts chemins | Environ O(m²n) | Oui | Trop lent au-delà de quelques milliers de sommets |
| Louvain | Déplacer des sommets pour augmenter la modularité, puis fusionner les groupes et recommencer | Presque linéaire en pratique | Oui, pour un ordre des sommets fixé | La limite de résolution ; des groupes mal connectés |
| Propagation de labels | Chaque sommet adopte le label le plus fréquent parmi ses voisins | Environ O(m) par passage | Non | Des réponses différentes d'une exécution à l'autre |
| Maximisation exacte de la modularité | Examiner toutes les partitions possibles | Exponentiel | Oui | Seulement pour de très petits réseaux |
En une phrase : utilisez Louvain, ou son successeur Leiden, par défaut, utilisez la propagation de labels quand la vitesse compte plus que la stabilité, réservez Girvan-Newman aux petits réseaux dont vous voulez voir toute la hiérarchie de partitions, et regardez toujours les groupes obtenus au lieu de vous fier à un seul score. Ici, n est le nombre de sommets et m le nombre d'arêtes.
2. Quinze amis, trois groupes
L'exemple suivi est un groupe de quinze amis, A à O, avec une arête entre deux personnes qui s'écrivent chaque semaine. Il y a 26 arêtes. Le réseau a été construit pour contenir trois cercles de cinq amis, A à E, F à J et K à O, reliés par cinq arêtes, puis vérifié par ordinateur pour que les méthodes ci-dessous se comportent de façon instructive.
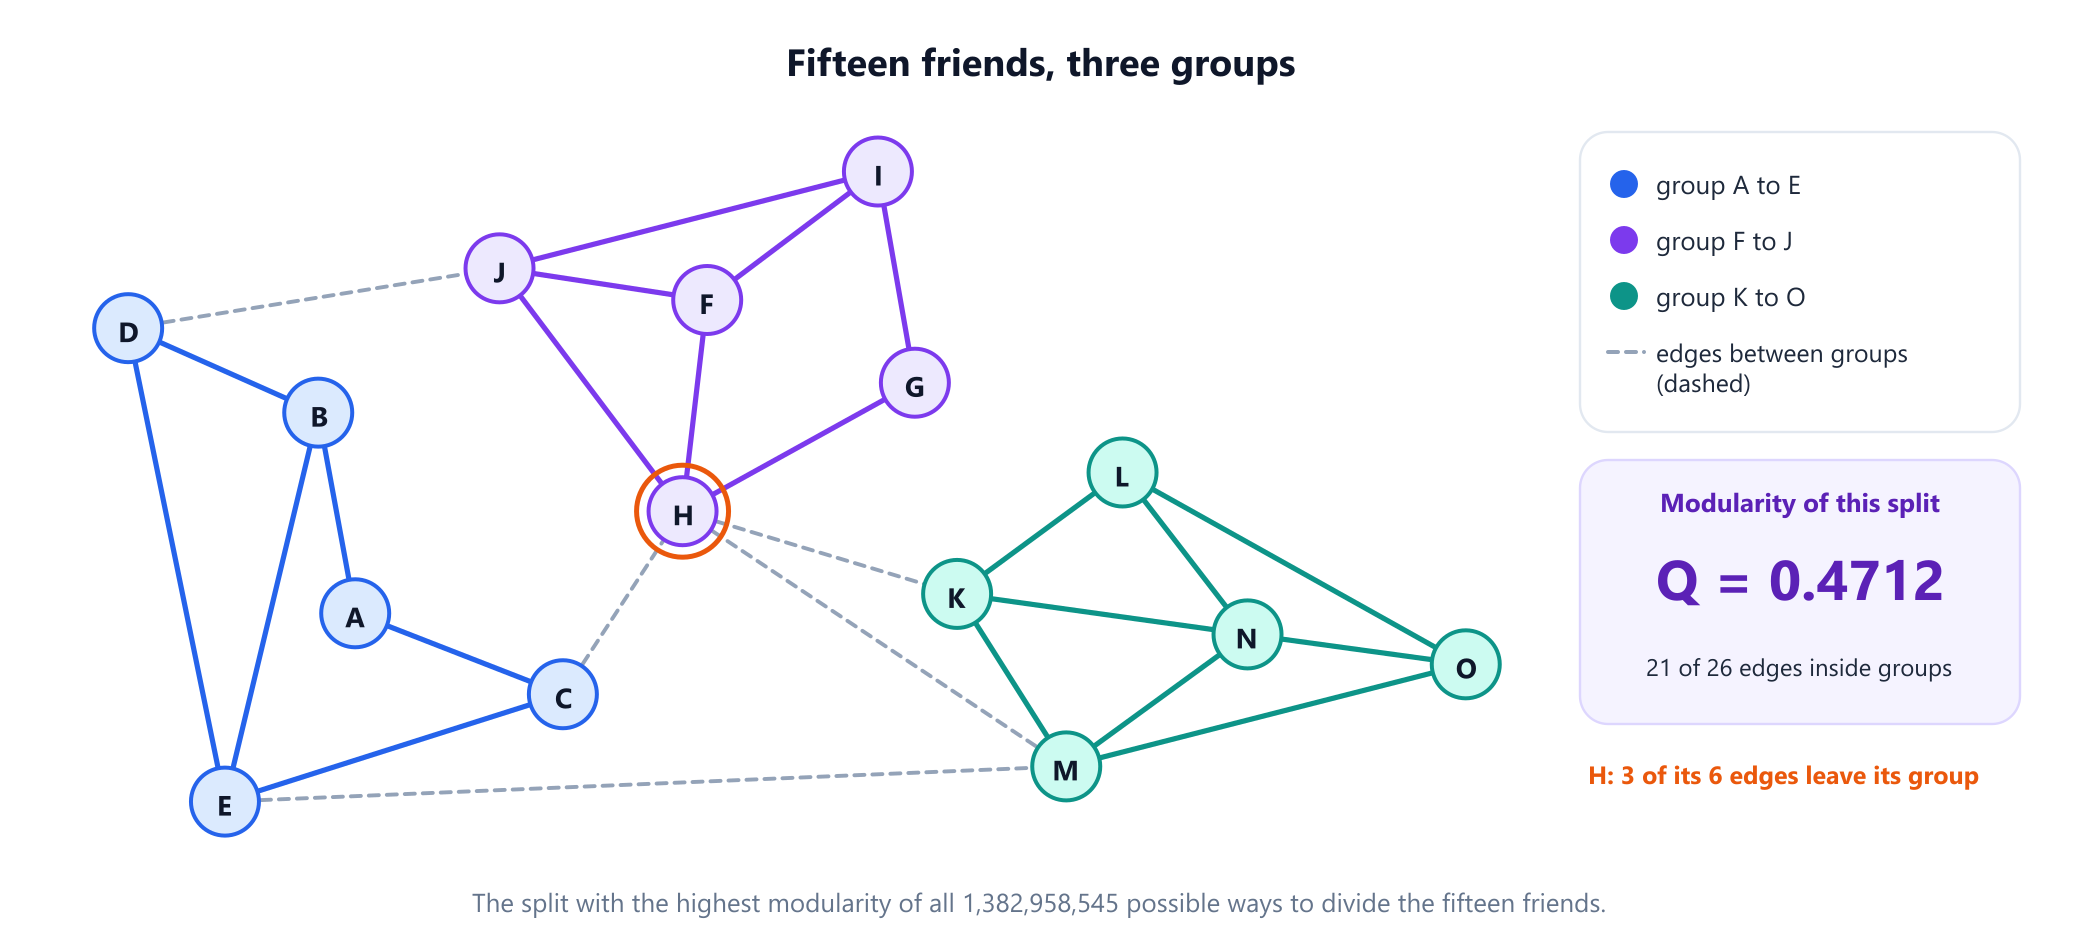
La plupart des gens dessineraient à l'œil les mêmes trois cercles. Une personne est moins évidente : H a six contacts, trois dans son propre groupe et trois à l'extérieur, dont deux dans le groupe K à O. Toute méthode doit décider à quel groupe H appartient, et la suite de ce guide utilise cette décision comme test.
3. Modularité : évaluer une partition
Pour comparer des partitions, il faut un score. Compter les arêtes à l'intérieur des groupes ne suffit pas, car mettre tout le monde dans un seul groupe place toutes les arêtes à l'intérieur. La modularité, introduite par Mark Newman et Michelle Girvan en 2004, retranche ce que le hasard seul donnerait :
Q = somme sur les groupes de [ (arêtes internes au groupe) / m - ( (degré total du groupe) / 2m )² ]Le second terme est la part des arêtes que l'on attendrait à l'intérieur du groupe si chaque sommet gardait son degré mais que les arêtes étaient câblées au hasard. Un groupe ne gagne des points que pour les arêtes qu'il possède au-delà de cette attente. Le programme ci-dessous calcule Q pour cinq façons de répartir les amis.
# Quinze amis ; une arête relie deux personnes qui s'écrivent chaque semaine.
FRIENDS = 'AB AC BD BE CE CH DE DJ EM FH FI FJ GH GI HJ HK HM IJ KL KM KN LN LO MN MO NO'.split()

def graph(edges):
    """Les arêtes s'écrivent 'AB' pour des lettres simples ou '12-34' pour des nombres."""
    adj = {}
    for e in edges:
        a, b = e.split('-') if '-' in e else e
        adj.setdefault(a, set()).add(b)
        adj.setdefault(b, set()).add(a)
    return adj

def modularity(adj, groups):
    """Q = somme sur les groupes de (part des arêtes internes) - (part du degré) au carré."""
    m = sum(len(nbrs) for nbrs in adj.values()) / 2
    q = 0.0
    for g in groups:
        inside = sum(1 for v in g for u in adj[v] if u in g) / 2
        degree = sum(len(adj[v]) for v in g)
        q += inside / m - (degree / (2 * m)) ** 2
    return q

def show(groups):
    return ' '.join(sorted(''.join(sorted(g)) for g in groups))

if __name__ == '__main__':
    adj = graph(FRIENDS)
    for name, groups in [('three groups', [set('ABCDE'), set('FGHIJ'), set('KLMNO')]),
                         ('H moved to K', [set('ABCDE'), set('FGIJ'), set('HKLMNO')]),
                         ('two groups', [set('ABCDE'), set('FGHIJKLMNO')]),
                         ('everyone together', [set(adj)]),
                         ('everyone alone', [{v} for v in adj])]:
        print(f'{name:18} Q = {modularity(adj, groups):7.4f}')
# three groups       Q =  0.4712
# H moved to K       Q =  0.4016
# two groups         Q =  0.2951
# everyone together  Q =  0.0000
# everyone alone     Q = -0.0725
Les trois cercles obtiennent 0,4712. En chiffres : 21 des 26 arêtes, soit 81 %, se trouvent à l'intérieur d'un groupe, alors qu'un câblage aléatoire avec les mêmes degrés en placerait 33,65 % à l'intérieur, et 0,8077 - 0,3365 = 0,4712. Tout le monde dans un seul groupe obtient exactement 0, car ce n'est pas mieux que le hasard, et chacun seul obtient moins de zéro. Déplacer H vers le groupe de droite fait baisser le score à 0,4016 ; selon cette mesure, H appartient donc au groupe de F à J.
0,4712 est-il le meilleur score possible ? Un réseau de 15 sommets peut être partitionné de 1 382 958 545 façons différentes, bien trop pour les énumérer une à une, mais une programmation dynamique sur les 32 768 sous-ensembles de sommets trouve le maximum exactement. La meilleure partition est celle des trois cercles, avec Q = 0,4712. Sur de grands réseaux, aucune vérification de ce genre n'est possible : Ulrik Brandes et ses collègues ont prouvé en 2008 que trouver la partition de modularité maximale est NP-difficile, c'est pourquoi toutes les méthodes pratiques sont des heuristiques.
4. Girvan-Newman : couper les ponts entre les groupes
La méthode de Michelle Girvan et Mark Newman, de 2002, procède de haut en bas. Une arête qui relie deux groupes porte beaucoup de plus courts chemins, car tout itinéraire d'un groupe à l'autre doit l'emprunter, elle ou l'une des rares autres du même genre. C'est ce qu'on appelle l'intermédiarité des arêtes ; elle se calcule avec le même parcours en largeur que la centralité d'intermédiarité. La méthode supprime l'arête d'intermédiarité la plus élevée, recalcule et recommence. Chaque fois que le réseau se scinde en davantage de morceaux, elle enregistre la partition et sa modularité.
from collections import deque
from modularity import FRIENDS, graph, modularity, show

def edge_betweenness(adj):
    """Algorithme de Brandes, qui crédite les arêtes au lieu des sommets."""
    score = {}
    for s in adj:
        order, preds, sigma, dist = [], {v: [] for v in adj}, dict.fromkeys(adj, 0), {s: 0}
        sigma[s] = 1
        queue = deque([s])
        while queue:
            v = queue.popleft()
            order.append(v)
            for w in adj[v]:
                if w not in dist:
                    dist[w] = dist[v] + 1
                    queue.append(w)
                if dist[w] == dist[v] + 1:
                    sigma[w] += sigma[v]
                    preds[w].append(v)
        delta = dict.fromkeys(adj, 0.0)
        for w in reversed(order):
            for v in preds[w]:
                credit = sigma[v] / sigma[w] * (1 + delta[w])
                edge = tuple(sorted((v, w)))
                score[edge] = score.get(edge, 0) + credit / 2   # chaque paire est vue depuis ses deux extrémités
                delta[v] += credit
    return score

def components(adj):
    seen, parts = set(), []
    for s in sorted(adj):
        if s not in seen:
            part, stack = set(), [s]
            while stack:
                v = stack.pop()
                if v not in part:
                    part.add(v)
                    stack.extend(adj[v])
            seen |= part
            parts.append(part)
    return parts

def girvan_newman(adj, verbose=False):
    """Supprimer l'arête d'intermédiarité la plus élevée, recalculer, recommencer ; garder chaque partition."""
    work = {v: set(nbrs) for v, nbrs in adj.items()}
    splits = {1: [set(adj)]}
    while any(work.values()):
        score = edge_betweenness(work)
        a, b = max(sorted(score), key=score.get)
        work[a].discard(b)
        work[b].discard(a)
        parts = components(work)
        if len(parts) not in splits:
            splits[len(parts)] = parts
            if verbose:
                print(f'cut {a}{b}: {len(parts):2} groups  Q = {modularity(adj, parts):.4f}')
    best = max(splits.values(), key=lambda p: modularity(adj, p))
    return best, splits

if __name__ == '__main__':
    adj = graph(FRIENDS)
    best, splits = girvan_newman(adj, verbose=True)
    print('best:', show(best), round(modularity(adj, best), 4))
# cut DJ:  2 groups  Q = 0.2951
# cut HM:  3 groups  Q = 0.4712
# cut CE:  4 groups  Q = 0.4312
# cut GI:  5 groups  Q = 0.3780
# cut KM:  6 groups  Q = 0.3070
# cut HJ:  7 groups  Q = 0.2744
# cut LO:  8 groups  Q = 0.2241
# cut AC:  9 groups  Q = 0.1901
# cut BE: 10 groups  Q = 0.1287
# cut DE: 11 groups  Q = 0.0991
# cut FJ: 12 groups  Q = 0.0377
# cut IJ: 13 groups  Q = 0.0081
# cut MO: 14 groups  Q = -0.0429
# cut NO: 15 groups  Q = -0.0725
# best: ABCDE FGHIJ KLMNO 0.4712
La première arête à disparaître est D-J, qui isole déjà le groupe de gauche : deux morceaux, Q = 0,2951. Ensuite, H-M tombe et le groupe de droite se détache : trois morceaux, Q = 0,4712. Au-delà, les coupes commencent à briser de vrais groupes, et la modularité ne fait que baisser, jusqu'à -0,0725 quand chaque sommet est seul. Garder la partition de score maximal redonne les trois cercles.
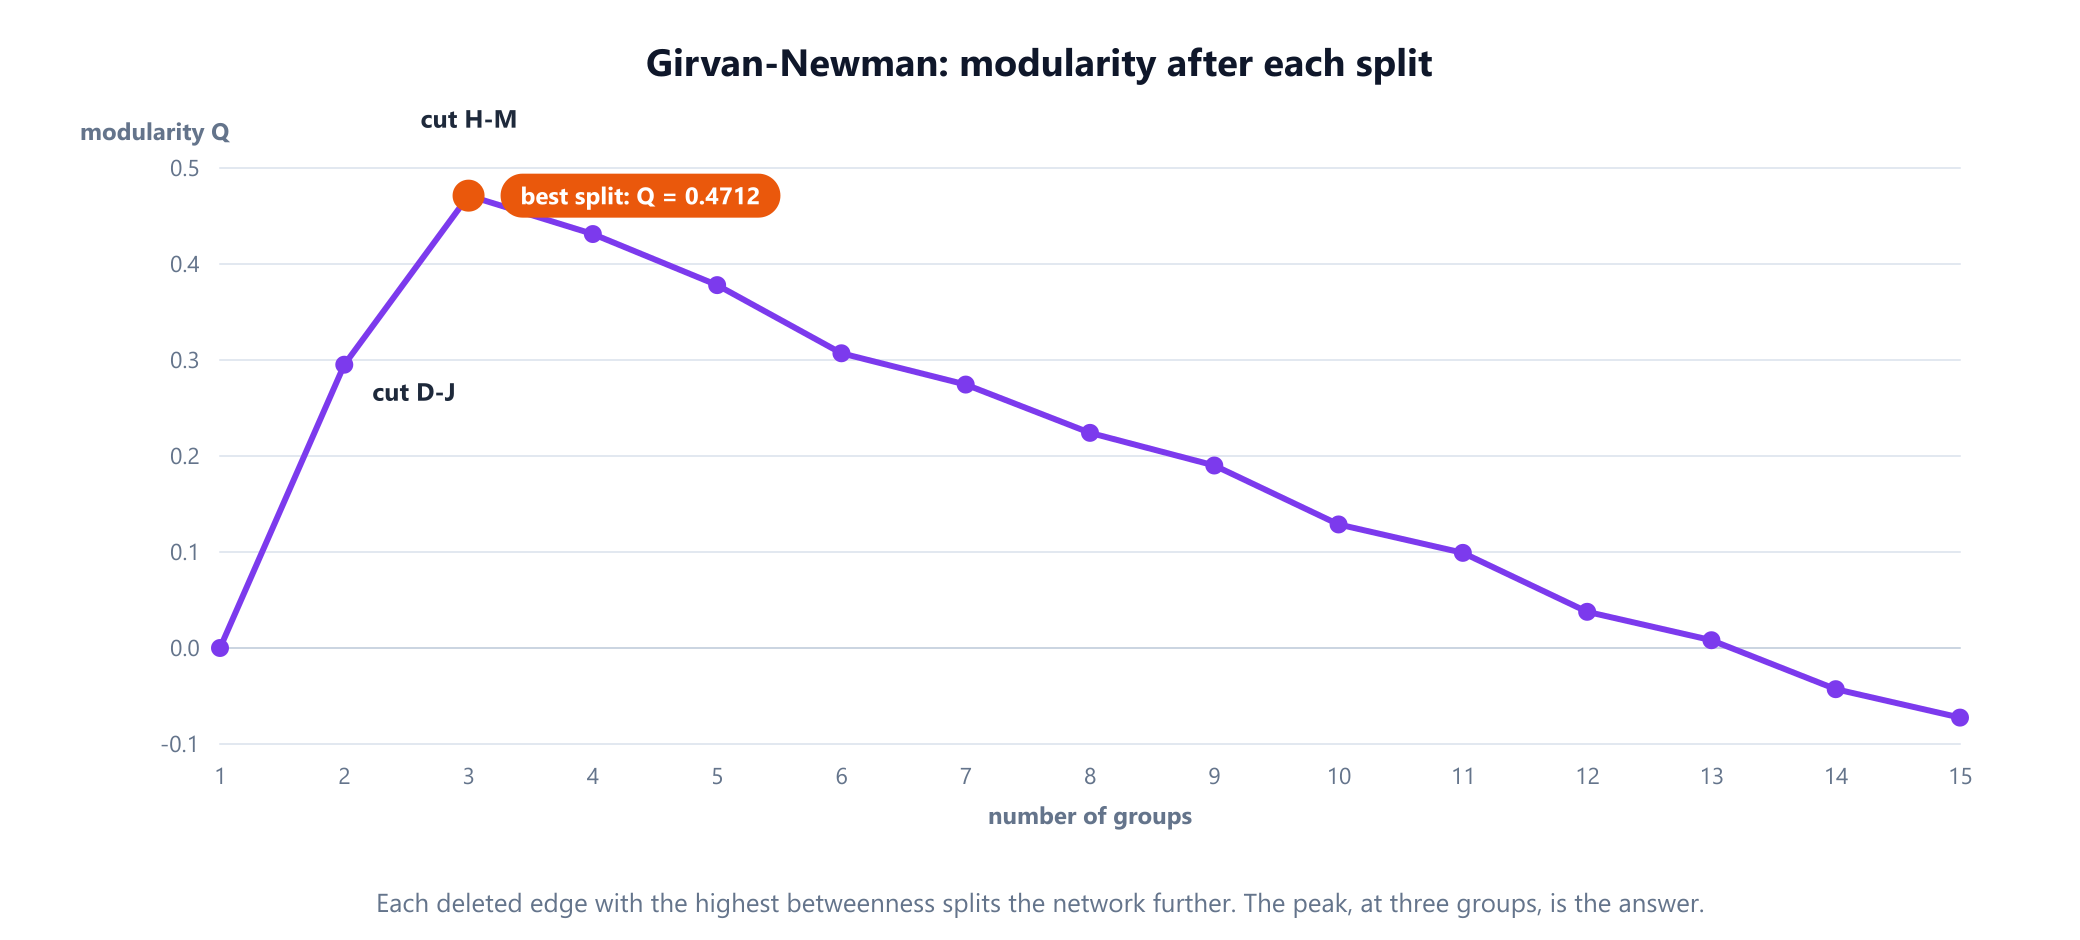
Le point faible est le coût. Chaque tour recalcule l'intermédiarité de toutes les arêtes, ce qui coûte O(mn) en temps, et il y a jusqu'à m tours, si bien que la méthode complète prend environ O(m²n). C'est raisonnable pour quelques centaines d'arêtes et sans espoir pour quelques millions.
5. Louvain : faire croître les groupes de bas en haut
La méthode de Louvain, publiée en 2008 par Vincent Blondel, Jean-Loup Guillaume, Renaud Lambiotte et Etienne Lefebvre à l'Université catholique de Louvain, maximise la modularité de façon gloutonne, en deux phases qui se répètent :
- Déplacements locaux. Commencer avec chaque sommet dans son propre groupe. Visiter les sommets un par un et déplacer chacun vers le groupe voisin qui augmente le plus la modularité, si un déplacement l'augmente. Recommencer jusqu'à ce qu'aucun déplacement d'un seul sommet n'aide plus.
- Agrégation. Fusionner chaque groupe en un seul sommet. Les arêtes internes au groupe deviennent une boucle sur le nouveau sommet, et les arêtes entre groupes s'additionnent.
Relancer ensuite la phase 1 sur le réseau réduit. Le gain d'un déplacement se calcule à partir d'une poignée de sommes, sans recalculer Q depuis le début, et c'est ce qui rend la méthode rapide.
from modularity import FRIENDS, graph, modularity, show

def louvain(adj, verbose=False):
    """Louvain : déplacer des sommets un à un tant que Q augmente, puis fusionner chaque groupe en un sommet."""
    w = {v: {u: 1 for u in adj[v]} for v in adj}       # w[v][v] contient les arêtes internes d'un sommet fusionné
    members = {v: {v} for v in adj}
    m2 = sum(len(nbrs) for nbrs in adj.values())        # deux fois le nombre d'arêtes
    level = 0
    while True:
        k = {v: sum(w[v].values()) for v in w}           # degré de chaque sommet (fusionné)
        group, total = {v: v for v in w}, dict(k)        # total = somme des degrés d'un groupe
        moved = True
        while moved:
            moved = False
            for v in sorted(w):
                old = group[v]
                total[old] -= k[v]
                links = {}
                for u, x in w[v].items():
                    if u != v:
                        links[group[u]] = links.get(group[u], 0) + x
                gain = lambda g: links.get(g, 0) - total[g] * k[v] / m2
                best = old
                for g in sorted(links):
                    if gain(g) > gain(best) + 1e-12:
                        best = g
                group[v] = best
                total[best] += k[v]
                moved |= best != old
        if len(set(group.values())) == len(w):           # aucune fusion : terminé
            break
        level += 1
        merged = {}
        for v, g in group.items():
            merged.setdefault(g, {})
            for u, x in w[v].items():
                merged[g][group[u]] = merged[g].get(group[u], 0) + x
        members = {g: set().union(*(members[v] for v in w if group[v] == g)) for g in merged}
        w = merged
        if verbose:
            print(f'pass {level}: {len(w)} groups  Q = {modularity(adj, members.values()):.4f}')
    return list(members.values())

if __name__ == '__main__':
    adj = graph(FRIENDS)
    groups = louvain(adj, verbose=True)
    print('result:', show(groups))
# pass 1: 4 groups  Q = 0.4312
# pass 2: 3 groups  Q = 0.4712
# result: ABCDE FGHIJ KLMNO
La première passe se termine avec quatre groupes : les cercles du milieu et de droite sont déjà complets, mais le cercle de gauche s'est scindé en A, C et B, D, E, avec Q = 0,4312. Les déplacements de sommets seuls ne peuvent pas corriger cela, car déplacer une seule personne entre ces deux moitiés fait baisser le score. La deuxième passe déplace des groupes entiers, fusionne les deux moitiés et atteint l'optimum de 0,4712.
Louvain présente deux défauts connus. La méthode hérite de toutes les limites de la modularité, décrites à la section 7. Et ses groupes peuvent être mal connectés, voire se disloquer : un sommet qui maintenait un groupe uni peut partir lors d'une passe ultérieure et laisser le reste non connexe. En 2019, Vincent Traag, Ludo Waltman et Nees Jan van Eck ont présenté l'algorithme de Leiden ; il ajoute une étape de raffinement qui garantit des groupes connexes, et il est souvent recommandé à la place de Louvain.
6. Propagation de labels : rapide, et différente à chaque fois
La propagation de labels, proposée par Usha Nandini Raghavan, Réka Albert et Soundar Kumara en 2007, ne calcule pas du tout la modularité. Chaque sommet commence avec son propre label. Dans un ordre aléatoire, chaque sommet adopte le label le plus fréquent parmi ses voisins, en départageant les égalités au hasard. Les groupes denses se fixent vite sur un label unique, et le processus s'arrête quand chaque sommet porte déjà l'un des labels les plus fréquents chez ses voisins. Chaque passage coûte O(m) en temps, et quelques passages suffisent généralement.
import random
from collections import Counter
from modularity import FRIENDS, graph, show

def label_propagation(adj, seed):
    """Chacun part de son propre label et adopte sans cesse le plus fréquent autour de lui."""
    rnd = random.Random(seed)
    label = {v: v for v in adj}
    for _ in range(1000):
        order = sorted(adj)
        rnd.shuffle(order)
        changed = False
        for v in order:
            if not adj[v]:
                continue
            count = Counter(label[u] for u in adj[v])
            top = max(count.values())
            best = sorted(l for l, c in count.items() if c == top)
            if label[v] not in best:                  # garder son label s'il fait partie des meilleurs
                label[v] = rnd.choice(best)
                changed = True
        if not changed:
            break
    groups = {}
    for v, l in label.items():
        groups.setdefault(l, set()).add(v)
    return list(groups.values())

if __name__ == '__main__':
    adj = graph(FRIENDS)
    results = Counter(show(label_propagation(adj, seed)) for seed in range(1000))
    print('different results in 1000 runs:', len(results))
    for groups, n in results.most_common(4):
        print(f'{n:4}  {groups}')
# different results in 1000 runs: 49
#  387  ABCDE FGHIJ KLMNO
#  275  AC BDE FGHIJ KLMNO
#   46  ABCDE FIJ GHKLMNO
#   35  AB CE DFGHIJ KLMNO
Le hasard compte. Sur 1 000 exécutions avec les quinze amis, la propagation de labels a produit 49 réponses différentes. Elle a trouvé les trois cercles 387 fois. La deuxième réponse la plus fréquente, obtenue 275 fois, scinde le cercle de gauche en A, C et B, D, E, le même état intermédiaire que celui atteint par la première passe de Louvain. D'autres exécutions ont fait passer G et H dans le groupe de droite, ou ont fusionné deux cercles.
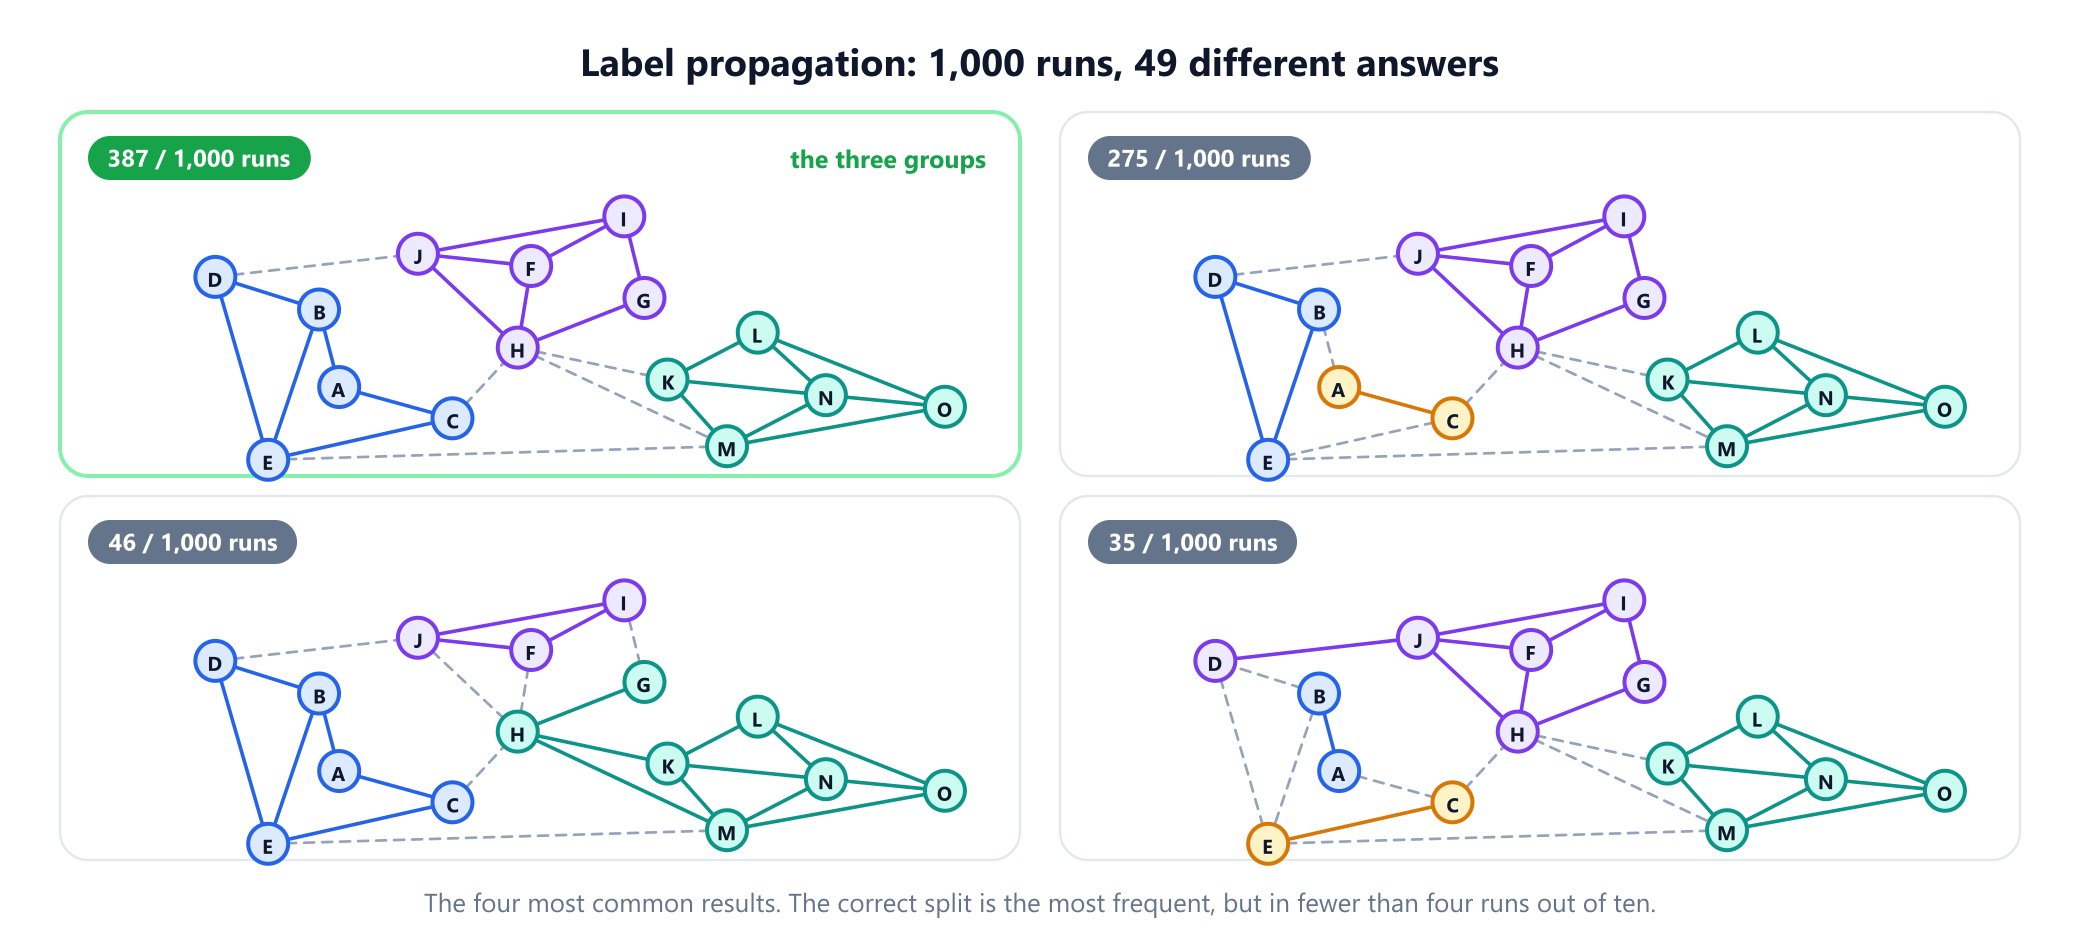
Il n'y a là aucun bug : chacun de ces résultats est un état d'arrêt valide. Si vous utilisez la propagation de labels, lancez-la plusieurs fois et gardez le résultat de meilleure modularité, ou comparez la fréquence à laquelle chaque paire de sommets se retrouve ensemble.
7. La limite de résolution
La modularité a un angle mort qu'aucun algorithme ne peut corriger, car il se trouve dans le score lui-même. Santo Fortunato et Marc Barthélemy ont montré en 2007 que, dans un grand réseau, maximiser la modularité peut fusionner de petits groupes manifestement séparés. La cause est le terme des arêtes attendues : il diminue à mesure que le réseau grandit, si bien que fusionner deux petits groupes ne coûte presque rien, tandis que l'unique arête qui les relie compte comme un gain.
L'exemple classique est un anneau de cliques : des groupes de personnes qui se connaissent toutes, chacun relié au suivant par une seule arête. Le programme suivant construit 30 groupes de cinq et évalue deux partitions.
from modularity import modularity
from louvain import louvain

def ring_of_cliques(n, size):
    """n groupes complets de `size` personnes, chacun relié au suivant par une seule arête."""
    adj = {v: set() for v in range(n * size)}
    for c in range(n):
        people = range(c * size, (c + 1) * size)
        for a in people:
            adj[a] |= set(people) - {a}
        a, b = c * size, ((c + 1) % n) * size + 1
        adj[a].add(b)
        adj[b].add(a)
    return adj

if __name__ == '__main__':
    n, size = 30, 5
    adj = ring_of_cliques(n, size)
    cliques = [set(range(c * size, (c + 1) * size)) for c in range(n)]
    pairs = [cliques[i] | cliques[i + 1] for i in range(0, n, 2)]
    print('one group per clique:   Q =', round(modularity(adj, cliques), 4))
    print('cliques merged in pairs: Q =', round(modularity(adj, pairs), 4))
    found = louvain(adj)
    whole = all(any(g == set().union(*[c for c in cliques if c <= g]) for _ in [0]) for g in found)
    print('Louvain:', len(found), 'groups, Q =', round(modularity(adj, found), 4),
          ', every group a union of whole cliques:', whole)
# one group per clique:   Q = 0.8758
# cliques merged in pairs: Q = 0.8879
# Louvain: 15 groups, Q = 0.8879 , every group a union of whole cliques: True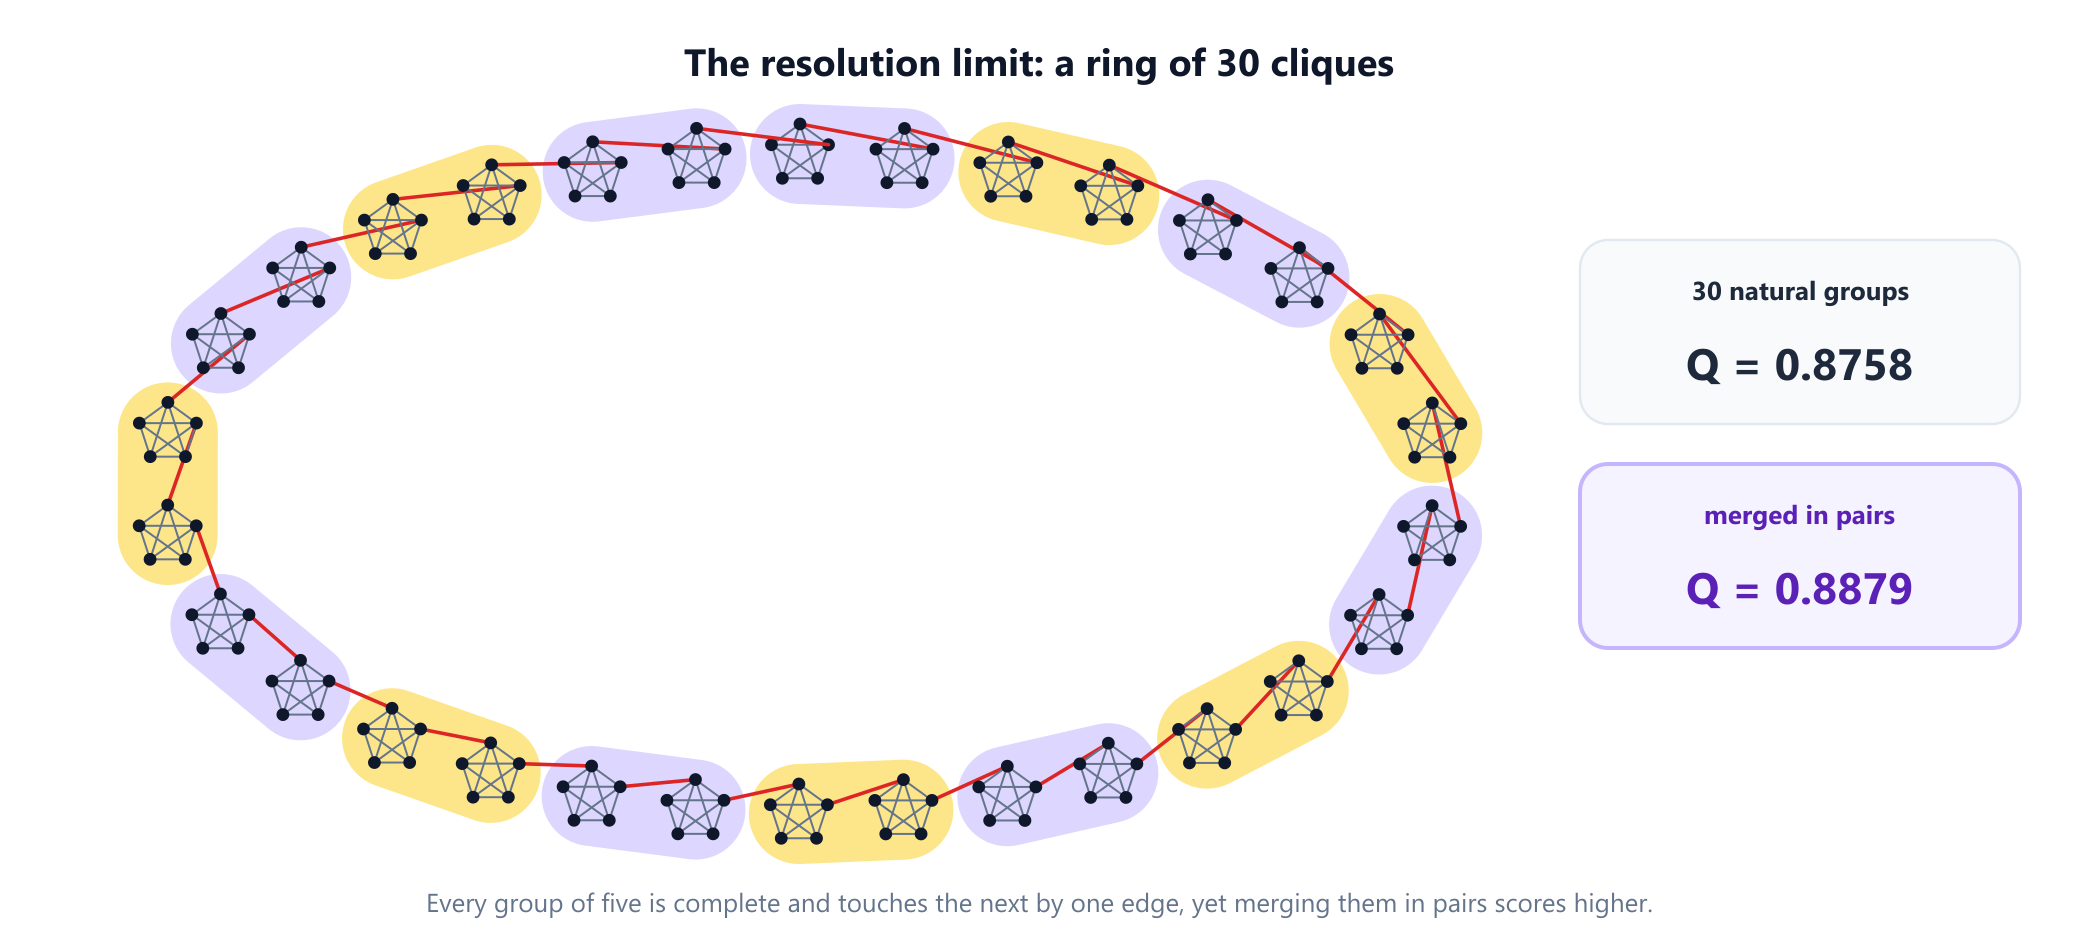
Garder les 30 groupes séparés donne 0,8758. Les fusionner par paires donne 0,8879, si bien que même un maximiseur parfait de la modularité ne renverrait jamais les 30 groupes naturels, et Louvain les fusionne bien par paires : le résultat compte 15 groupes. Le paramètre de résolution γ de Jörg Reichardt et Stefan Bornholdt multiplie le terme des arêtes attendues ; des valeurs supérieures à 1 favorisent des groupes plus petits et des valeurs inférieures à 1 des groupes plus grands. Il déplace la limite sans la supprimer, si bien qu'il vaut la peine de comparer la taille des groupes trouvés avec ce que l'on sait du réseau.
8. Un vrai test : le club de karaté de Zachary
Dans les années 1970, l'anthropologue Wayne Zachary a relevé les amitiés entre les 34 membres d'un club de karaté universitaire, pendant qu'un conflit entre l'instructeur et l'administrateur du club le divisait en deux. Son article de 1977 recensait 78 amitiés, et comme la partition réelle est connue, ce réseau est devenu le premier test standard de la détection de communautés. Le programme suivant lance les trois méthodes et les compare au camp rejoint par chaque membre, en utilisant les labels distribués avec la bibliothèque NetworkX. Ceux-ci indiquent le club que chaque membre a rejoint après la scission. Les données de factions de Zachary placent le membre 9 du côté de l'administrateur, bien qu'il ait rejoint le club de l'instructeur, si bien que les études qui comparent aux factions, comme l'ont fait Girvan et Newman, ne comptent que le membre 3 comme mal placé.
from collections import Counter
from modularity import graph, modularity
from girvan_newman import girvan_newman
from louvain import louvain
from lpa import label_propagation

# Club de karaté de Zachary (1977) : 34 membres, 78 amitiés, et le camp choisi par chaque membre
# lors de la scission du club (H = club de l'instructeur, O = celui de l'administrateur), membres 1 à 34.
CLUB = ('1-2 1-3 1-4 1-5 1-6 1-7 1-8 1-9 1-11 1-12 1-13 1-14 1-18 1-20 1-22 1-32 2-3 2-4 2-8 '
        '2-14 2-18 2-20 2-22 2-31 3-4 3-8 3-9 3-10 3-14 3-28 3-29 3-33 4-8 4-13 4-14 5-7 5-11 '
        '6-7 6-11 6-17 7-17 9-31 9-33 9-34 10-34 14-34 15-33 15-34 16-33 16-34 19-33 19-34 '
        '20-34 21-33 21-34 23-33 23-34 24-26 24-28 24-30 24-33 24-34 25-26 25-28 25-32 26-32 '
        '27-30 27-34 28-34 29-32 29-34 30-33 30-34 31-33 31-34 32-33 32-34 33-34').split()
SIDE = dict(zip([str(i) for i in range(1, 35)], 'HHHHHHHHHOHHHHOOHHOHOHOOOOOOOOOOOO'))

def wrong(groups):
    """Membres placés dans un groupe dont la majorité a choisi l'autre camp."""
    bad = []
    for g in groups:
        majority = Counter(SIDE[v] for v in g).most_common(1)[0][0]
        bad += sorted((v for v in g if SIDE[v] != majority), key=int)
    return bad

if __name__ == '__main__':
    adj = graph(CLUB)
    best, splits = girvan_newman(adj)
    print('Girvan-Newman, first split:', [len(g) for g in splits[2]], 'misplaced:', wrong(splits[2]))
    print('Girvan-Newman, best Q:', len(best), 'groups, Q =', round(modularity(adj, best), 4))
    groups = louvain(adj)
    print('Louvain:', len(groups), 'groups, Q =', round(modularity(adj, groups), 4),
          'sizes', sorted(len(g) for g in groups))
    runs = Counter(len(label_propagation(adj, s)) for s in range(1000))
    print('label propagation, groups found in 1000 runs:', dict(sorted(runs.items())))
# Girvan-Newman, first split: [15, 19] misplaced: ['3', '9']
# Girvan-Newman, best Q: 5 groups, Q = 0.4013
# Louvain: 4 groups, Q = 0.4188 sizes [5, 6, 11, 12]
# label propagation, groups found in 1000 runs: {1: 6, 2: 218, 3: 369, 4: 295, 5: 104, 6: 8}
La première partition produite par Girvan-Newman divise le club en 15 et 19 membres et place mal deux personnes, les membres 3 et 9 ; tous deux ont des amis des deux côtés. Sa meilleure modularité est atteinte plus tard, à cinq groupes, avec Q = 0,4013. Louvain trouve quatre groupes avec Q = 0,4188, très proche de 0,4198, le maximum prouvé pour ce réseau, et chacun de ses quatre groupes se trouve d'un seul côté de la partition réelle, à l'exception des membres 9 et 10. La propagation de labels varie encore : sur 1 000 exécutions, elle a trouvé entre un et six groupes, le plus souvent trois.
La leçon est que la « vraie » réponse d'un réseau réel dépend de la question. Le club s'est scindé en deux, mais la modularité préfère quatre groupes, parce que chacune des deux factions contient des cercles plus soudés. Aucune des deux réponses n'est fausse ; elles répondent à des questions différentes.
9. Quand les groupes se brouillent : un banc d'essai mesuré
Pour mesurer la précision, il faut des réseaux aux groupes connus. Le banc d'essai de Girvan et Newman, de 2002, compte 128 sommets répartis en quatre groupes de 32. Chaque sommet a environ 16 arêtes, dont en moyenne z_out mènent vers d'autres groupes. Plus z_out est grand, plus les groupes sont difficiles à distinguer. La précision se mesure avec l'information mutuelle normalisée (NMI), un score de 0 à 1 qui ne vaut 1 que si les groupes trouvés coïncident exactement avec les groupes implantés, proposé à cette fin par Leon Danon et ses collègues en 2005.
import math, random
from louvain import louvain
from lpa import label_propagation

def planted(rnd, z_out, groups=4, size=32, degree=16):
    """Test de Girvan et Newman : 4 groupes de 32, chaque sommet ayant environ z_out arêtes qui sortent de son groupe."""
    n = groups * size
    adj = {v: set() for v in range(n)}
    p_in, p_out = (degree - z_out) / (size - 1), z_out / (n - size)
    for a in range(n):
        for b in range(a + 1, n):
            if rnd.random() < (p_in if a // size == b // size else p_out):
                adj[a].add(b)
                adj[b].add(a)
    return adj

def nmi(found, size=32):
    """Information mutuelle normalisée entre les groupes trouvés et les groupes implantés (1 = identiques)."""
    n = sum(len(g) for g in found)
    planted = {}
    for g in found:
        for v in g:
            planted.setdefault(v // size, []).append(v)
    h = lambda parts: -sum(len(p) / n * math.log(len(p) / n) for p in parts)
    mutual = 0.0
    for g in found:
        for p in planted.values():
            k = len(g & set(p))
            if k:
                mutual += k / n * math.log(k * n / (len(g) * len(p)))
    hf, hp = h(found), h(list(planted.values()))
    return 1.0 if hf + hp == 0 else 2 * mutual / (hf + hp)

if __name__ == '__main__':
    rnd = random.Random(7)
    print('edges out   Louvain   label propagation   (average NMI over 10 networks)')
    for z_out in range(1, 10):
        a = b = 0.0
        for _ in range(10):
            adj = planted(rnd, z_out)
            a += nmi(louvain(adj)) / 10
            b += nmi(label_propagation(adj, rnd.randrange(10**6))) / 10
        print(f'{z_out:9} {a:9.2f} {b:12.2f}')
# edges out   Louvain   label propagation   (average NMI over 10 networks)
#         1      1.00         1.00
#         2      1.00         1.00
#         3      1.00         1.00
#         4      1.00         0.90
#         5      0.99         0.85
#         6      0.97         0.35
#         7      0.80         0.10
#         8      0.50         0.02
#         9      0.20         0.00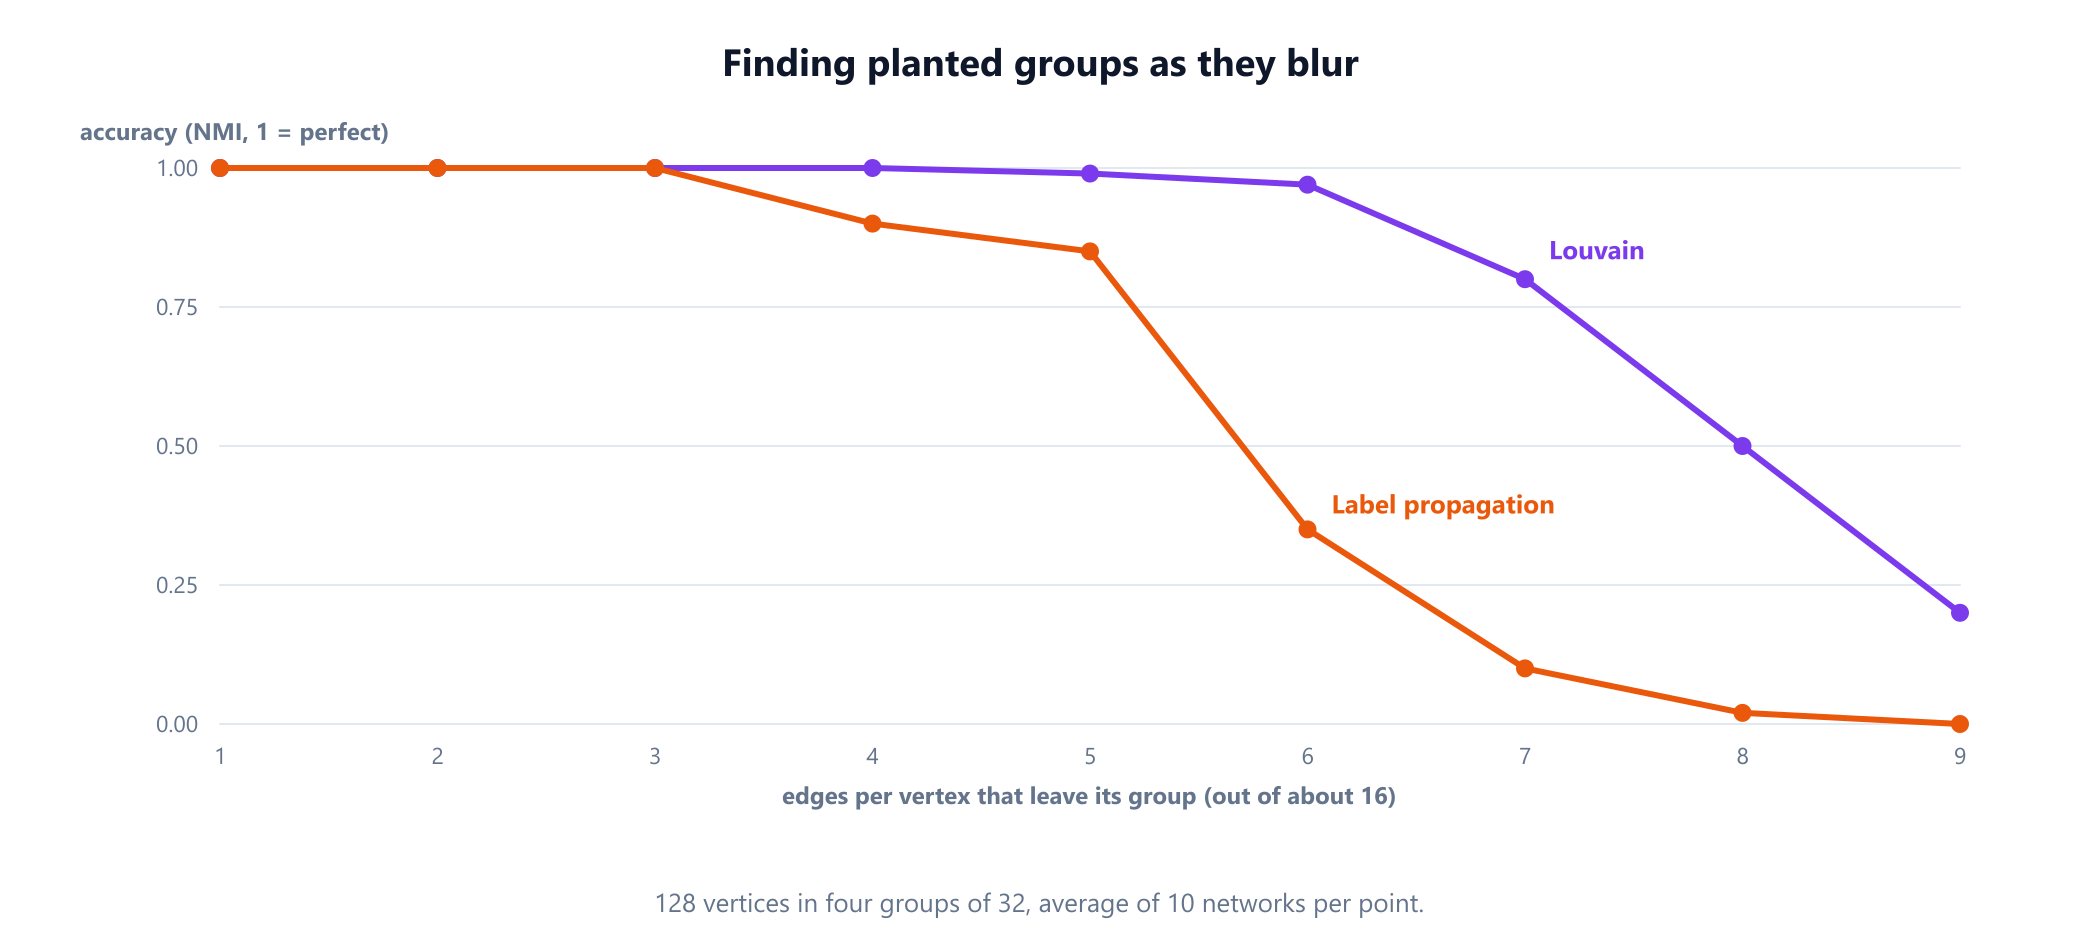
Les deux méthodes sont parfaites tant que les groupes sont nets. Dès 4 arêtes sortantes sur 16, la propagation de labels commence à faillir, et à 6 son score s'est effondré à 0,35 alors que Louvain obtient encore 0,97. À 8, la moitié des arêtes de chaque sommet sortent de son groupe, bien que l'intérieur d'un groupe reste 3,1 fois plus dense que l'espace entre les groupes, et même Louvain tombe à 0,50. À z_out = 12, les groupes ne seraient pas plus denses à l'intérieur qu'à l'extérieur. En réalité, ils deviennent impossibles à retrouver plus tôt : Aurelien Decelle et ses collègues ont montré en 2011 que, dans de grands réseaux construits de cette façon, aucune méthode ne peut faire mieux que le hasard dès que z_out dépasse environ 9.
10. Où la détection de communautés est utilisée
- Réseaux sociaux. Trouver des cercles d'amis, de collègues ou de centres d'intérêt, et les personnes qui font le pont entre eux, souvent avec les mesures de centralité.
- Biologie. Les groupes des réseaux d'interactions protéiques correspondent souvent à des complexes ou à des voies biologiques ; le guide sur la théorie des graphes en biologie traite de ces réseaux.
- Recommandation et marketing. Les utilisateurs qui forment une communauté ont tendance à partager des centres d'intérêt, ce qui aide à suggérer du contenu et à segmenter les audiences.
- Fraude et sécurité. Des comptes qui effectuent surtout des transactions entre eux peuvent former un groupe très soudé qui se démarque du comportement normal.
- Logiciel. Les groupes d'un graphe de dépendances suggèrent des frontières naturelles entre modules, et les arêtes entre groupes montrent les couplages qui méritent d'être examinés.
11. Un bref historique
Partitionner des graphes est une idée ancienne : l'heuristique de Brian Kernighan et Shen Lin, de 1970, découpait un graphe en parties de tailles données en coupant le moins d'arêtes possible, un problème né du placement de circuits électroniques sur des cartes. La détection de communautés au sens actuel, où le nombre et la taille des groupes ne sont pas fixés à l'avance, a pris son essor avec l'article de Girvan et Newman de 2002, qui a aussi popularisé le club de karaté de Zachary comme test. Newman et Girvan ont défini la modularité en 2004, et la même année, Aaron Clauset, Newman et Cristopher Moore ont publié une méthode gloutonne rapide pour la maximiser. La propagation de labels a suivi en 2007, la même année que la limite de résolution, puis la méthode de Louvain en 2008. L'étude de synthèse de Santo Fortunato de 2010 est une référence standard, et l'algorithme de Leiden de 2019 a corrigé les groupes non connexes de Louvain.
12. Erreurs fréquentes
| Erreur | Pourquoi c'est faux | Correction |
|---|---|---|
| Se fier à une seule exécution de la propagation de labels | Sur l'exemple, 1 000 exécutions ont donné 49 réponses différentes | La lancer plusieurs fois, ou utiliser Louvain ou Leiden |
Prendre le Q le plus élevé pour la vérité | La limite de résolution fusionne les petits groupes | Vérifier la taille des groupes ; essayer un paramètre de résolution |
Comparer Q entre des réseaux différents | Ses valeurs typiques dépendent de la taille et de la densité | Comparer des partitions d'un même réseau |
| Voir un groupe unique contenant tout le monde comme un échec | Un réseau peut n'avoir aucune structure en communautés | Comparer avec un réseau aléatoire de mêmes degrés |
| Lancer Girvan-Newman sur un grand graphe | Cela coûte environ O(m²n) en temps | Utiliser Louvain ou Leiden |
| Ignorer les groupes non connexes de Louvain | Un groupe peut se disloquer lors des passes suivantes | Utiliser Leiden, ou scinder les groupes en morceaux connexes |
| S'attendre à ce que chaque sommet appartienne à un seul groupe | On appartient à la fois à des cercles familiaux, professionnels et sportifs | Utiliser une méthode à recouvrement quand cela compte |
13. Glossaire
| Terme | Signification |
|---|---|
| Communauté | Un groupe de sommets avec beaucoup d'arêtes internes et peu vers le reste |
| Partition | Une répartition des sommets en groupes, chaque sommet dans exactement un groupe |
| Modularité | La part des arêtes internes aux groupes moins la part attendue par le hasard |
| Intermédiarité des arêtes | Le nombre de plus courts chemins entre paires de sommets qui empruntent une arête |
| Girvan-Newman | Supprimer de façon répétée l'arête d'intermédiarité la plus élevée |
| Méthode de Louvain | Des déplacements locaux qui augmentent la modularité, puis la fusion des groupes, en boucle |
| Algorithme de Leiden | Un raffinement de Louvain qui garantit des groupes connexes |
| Propagation de labels | Chaque sommet adopte de façon répétée le label le plus fréquent chez ses voisins |
| Limite de résolution | La tendance de la modularité à fusionner les petits groupes dans les grands réseaux |
| Paramètre de résolution | Un poids γ sur le terme des arêtes attendues, qui déplace la taille de groupe privilégiée |
| Clique | Un groupe dans lequel deux sommets quelconques sont reliés |
| NMI | Information mutuelle normalisée, égale à 1 quand deux partitions sont identiques |
14. Questions fréquentes
Qu'est-ce que la détection de communautés dans les graphes ?
La détection de communautés consiste à répartir les sommets d'un réseau en groupes qui ont beaucoup d'arêtes à l'intérieur et peu d'arêtes entre eux. C'est la version du clustering pour les graphes. Les usages typiques sont de trouver des cercles d'amis dans les réseaux sociaux, des équipes dans des données de communication, des complexes dans les réseaux de protéines et des thèmes apparentés dans les graphes de citations ou du Web.
Qu'est-ce que la modularité ?
La modularité, généralement notée Q, évalue une partition d'un réseau en groupes. C'est la part des arêtes qui tombent à l'intérieur des groupes moins la part attendue si les mêmes sommets gardaient leur degré mais que les arêtes étaient placées au hasard. Des valeurs proches de 0 signifient pas mieux que le hasard ; des groupes bien séparés obtiennent typiquement entre environ 0,3 et 0,7.
Qu'est-ce que l'algorithme de Louvain ?
La méthode de Louvain, publiée par Blondel et ses collègues en 2008, maximise la modularité en deux phases répétées. D'abord, chaque sommet passe dans le groupe voisin qui augmente le plus la modularité, jusqu'à ce qu'aucun déplacement n'aide plus. Ensuite, chaque groupe est fusionné en un seul sommet et le processus recommence sur le réseau réduit. Elle est assez rapide pour des réseaux de millions d'arêtes.
Quelle est la différence entre Louvain et Girvan-Newman ?
Girvan-Newman procède de haut en bas : la méthode supprime de façon répétée l'arête d'intermédiarité la plus élevée, celle qui a le plus de chances de se trouver entre deux groupes, et garde la partition de meilleure modularité. Louvain procède de bas en haut, en fusionnant des sommets en groupes tant que la modularité augmente. Girvan-Newman prend un temps d'environ O(m au carré fois n), ce qui la réserve aux petits réseaux ; Louvain passe à l'échelle de très grands réseaux.
La propagation de labels est-elle fiable ?
La propagation de labels est très rapide, mais son résultat dépend de choix aléatoires. Sur l'exemple de 15 personnes de ce guide, 1 000 exécutions ont produit 49 réponses différentes et n'ont trouvé les trois vrais groupes que 387 fois. Lancez-la plusieurs fois et comparez, ou utilisez une méthode fondée sur la modularité quand la stabilité des résultats compte.
Qu'est-ce que la limite de résolution de la modularité ?
Fortunato et Barthélemy ont montré en 2007 que maximiser la modularité peut fusionner de petits groupes clairement séparés quand le réseau est grand. Sur un anneau de 30 groupes de cinq personnes, fusionner les groupes voisins par paires obtient un meilleur score que les garder séparés. Un paramètre de résolution, ou des méthodes qui ne reposent pas sur la modularité, permettent d'y remédier.
15. Références
Les algorithmes, résultats et attributions ci-dessus proviennent des sources suivantes, classées par ordre chronologique.
- Kernighan, B. W. et Lin, S. (1970). "An Efficient Heuristic Procedure for Partitioning Graphs." Bell System Technical Journal 49(2), 291 à 307.
- Zachary, W. W. (1977). "An Information Flow Model for Conflict and Fission in Small Groups." Journal of Anthropological Research 33(4), 452 à 473.
- Girvan, M. et Newman, M. E. J. (2002). "Community Structure in Social and Biological Networks." Proceedings of the National Academy of Sciences 99(12), 7821 à 7826.
- Newman, M. E. J. et Girvan, M. (2004). "Finding and Evaluating Community Structure in Networks." Physical Review E 69, 026113.
- Clauset, A., Newman, M. E. J. et Moore, C. (2004). "Finding Community Structure in Very Large Networks." Physical Review E 70, 066111.
- Danon, L., Díaz-Guilera, A., Duch, J. et Arenas, A. (2005). "Comparing Community Structure Identification." Journal of Statistical Mechanics: Theory and Experiment, P09008.
- Reichardt, J. et Bornholdt, S. (2006). "Statistical Mechanics of Community Detection." Physical Review E 74, 016110.
- Fortunato, S. et Barthélemy, M. (2007). "Resolution Limit in Community Detection." Proceedings of the National Academy of Sciences 104(1), 36 à 41.
- Raghavan, U. N., Albert, R. et Kumara, S. (2007). "Near Linear Time Algorithm to Detect Community Structures in Large-Scale Networks." Physical Review E 76, 036106.
- Brandes, U., Delling, D., Gaertler, M., Görke, R., Hoefer, M., Nikoloski, Z. et Wagner, D. (2008). "On Modularity Clustering." IEEE Transactions on Knowledge and Data Engineering 20(2), 172 à 188.
- Agarwal, G. et Kempe, D. (2008). "Modularity-Maximizing Graph Communities via Mathematical Programming." European Physical Journal B 66(3), 409 à 418.
- Blondel, V. D., Guillaume, J.-L., Lambiotte, R. et Lefebvre, E. (2008). "Fast Unfolding of Communities in Large Networks." Journal of Statistical Mechanics: Theory and Experiment, P10008.
- Fortunato, S. (2010). "Community Detection in Graphs." Physics Reports 486(3 à 5), 75 à 174.
- Decelle, A., Krzakala, F., Moore, C. et Zdeborová, L. (2011). "Asymptotic Analysis of the Stochastic Block Model for Modular Networks and Its Algorithmic Applications." Physical Review E 84(6), 066106.
- Traag, V. A., Waltman, L. et van Eck, N. J. (2019). "From Louvain to Leiden: Guaranteeing Well-Connected Communities." Scientific Reports 9, 5233.
Voyez le parcours derrière l'intermédiarité des arêtes
Girvan-Newman classe les arêtes avec un parcours en largeur depuis chaque sommet. Dessinez deux groupes reliés par une seule arête dans le visualiseur et lancez le parcours des deux côtés pour voir pourquoi cette arête porte tous les itinéraires entre eux.
Ouvrir le visualiseur