
目录
1. 简短的答案
社区发现把网络的顶点分成若干群组,使群组内部的边多、群组之间的边少。它是图上的聚类:社交网络中的朋友圈、电子邮件记录中的团队、细胞中的蛋白质复合物、引文网络中的主题。不存在唯一正确的答案,因此每种方法都建立在对“好的群组”的某种定义之上,而大多数流行的方法都使用同一个定义,称为模块度。
| 方法 | 思路 | 代价 | 每次运行结果都相同吗? | 注意事项 |
|---|---|---|---|---|
| Girvan-Newman | 删除承载最短路径最多的边 | 约 O(m²n) | 是 | 超过几千个顶点就太慢 |
| Louvain | 移动顶点以提高模块度,然后合并群组并重复 | 实践中接近线性 | 是,在顶点顺序固定时 | 分辨率极限;连通性差的群组 |
| 标签传播 | 每个顶点采用其邻居中最常见的标签 | 约 O(m) 每轮扫描 | 否 | 不同的运行给出不同的答案 |
| 精确的模块度最大化 | 搜索所有可能的划分 | 指数级 | 是 | 只适用于极小的网络 |
一句话概括:默认使用 Louvain,或其后继者 Leiden;速度比稳定性更重要时,使用标签传播;想看到完整的划分层次时,把 Girvan-Newman 用在小网络上;并且始终要查看得到的群组,而不是只相信一个分数。这里, n 是顶点数, m 是边数。
2. 十五个朋友,三个群组
贯穿全文的示例是一群十五个朋友,从 A 到 O,每周互发消息的两个人之间有一条边。共有 26 条边。这个网络被构造成包含三个各有五个朋友的圈子: A 到 E、 F 到 J 和 K 到 O,圈子之间由五条边相连;网络还经过计算机检验,使下面的各种方法表现出有启发性的行为。
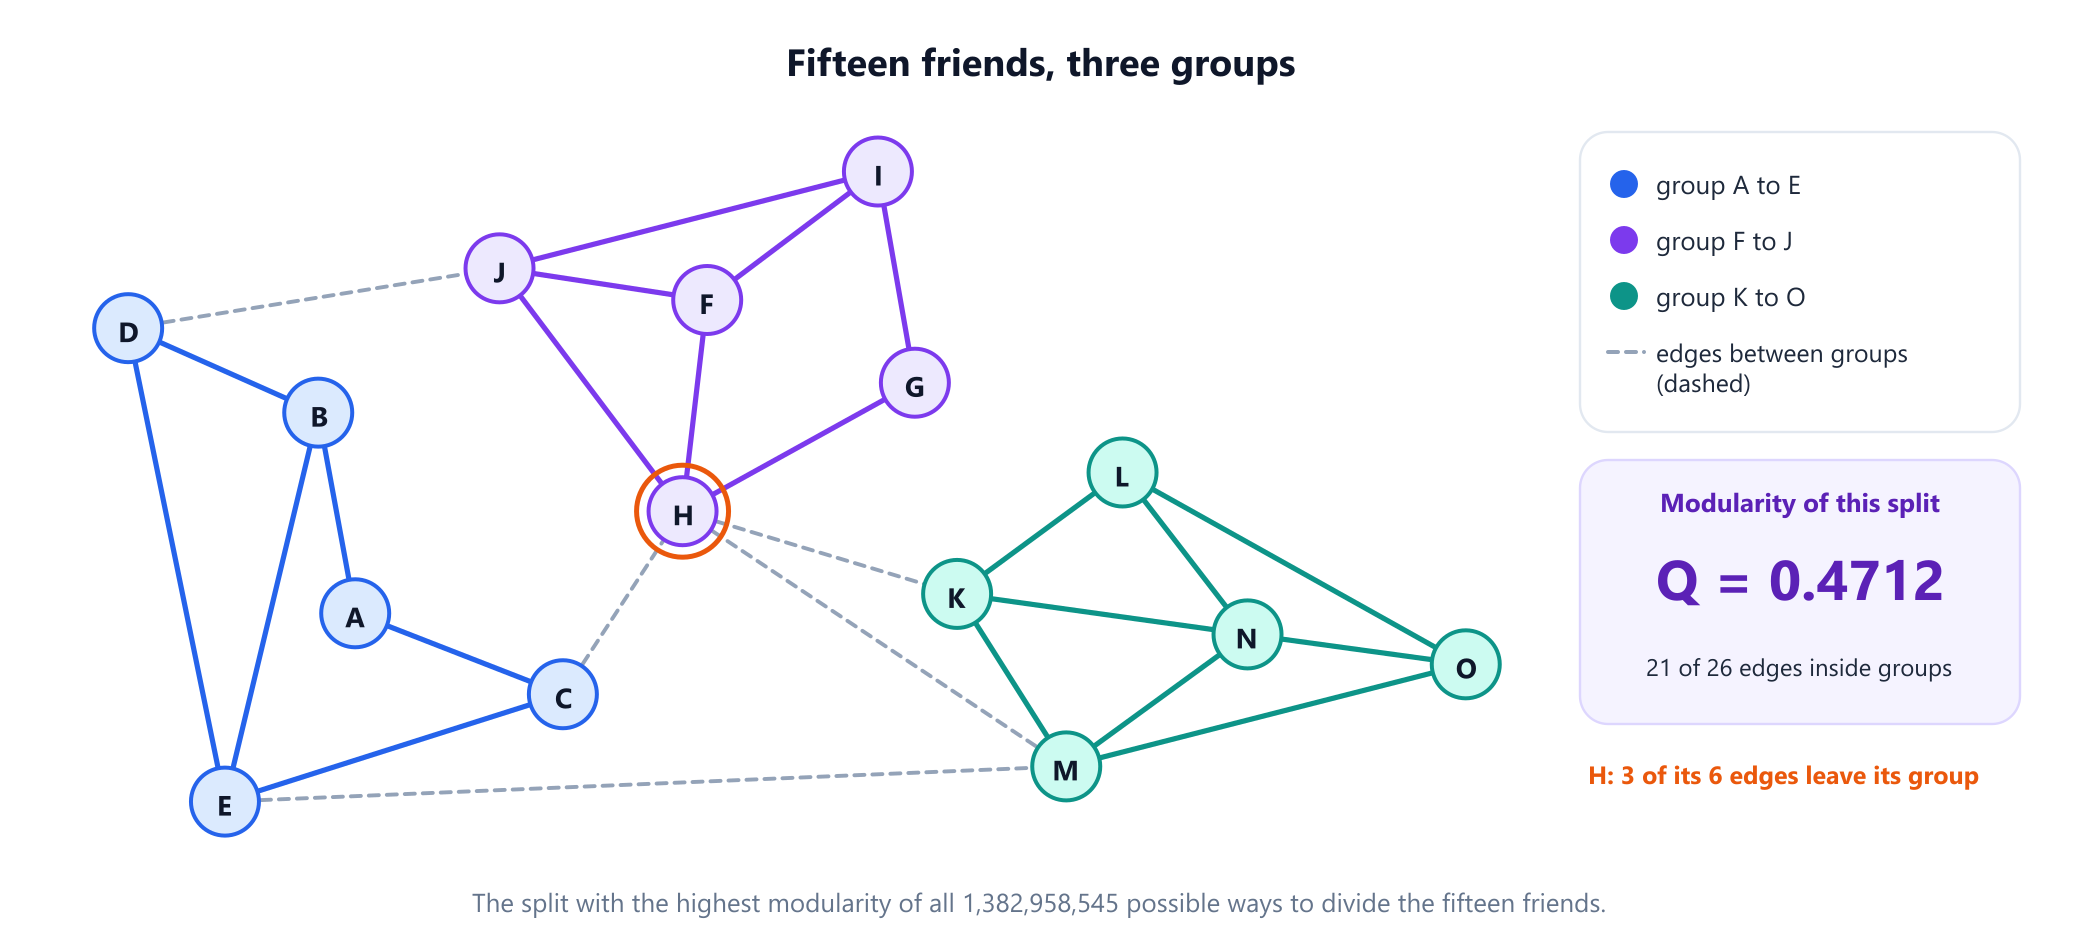
大多数人用肉眼也会画出同样的三个圈子。只有一个人不太明确: H 有六个联系人,三个在自己的群组里,三个在外面,其中两个在群组 K 到 O中。任何方法都必须决定 H 属于哪里,本指南其余部分就用这个决定作为检验。
3. 模块度:为划分打分
要比较不同的划分,就需要一个分数。只统计群组内部的边是不够的,因为把所有人放进一个群组,每条边就都在内部了。模块度(由 Mark Newman 和 Michelle Girvan 于 2004 年提出)减去了单凭偶然就会得到的部分:
Q = 对所有群组求和 [ (群组内部的边数) / m - ( (群组的总度数) / 2m )² ]第二项是:如果每个顶点保持自己的度,而边被随机连接,预期落在群组内部的边所占的份额。一个群组只有超出这一期望的那些边才能得分。下面的程序计算五种划分朋友的方式各自的 Q 值。
# 十五个朋友;每周互发消息的两个人之间有一条边。
FRIENDS = 'AB AC BD BE CE CH DE DJ EM FH FI FJ GH GI HJ HK HM IJ KL KM KN LN LO MN MO NO'.split()

def graph(edges):
    """单字母顶点的边写作 'AB',数字顶点的边写作 '12-34'。"""
    adj = {}
    for e in edges:
        a, b = e.split('-') if '-' in e else e
        adj.setdefault(a, set()).add(b)
        adj.setdefault(b, set()).add(a)
    return adj

def modularity(adj, groups):
    """Q = 对所有群组求和:(内部边所占份额) - (度所占份额) 的平方。"""
    m = sum(len(nbrs) for nbrs in adj.values()) / 2
    q = 0.0
    for g in groups:
        inside = sum(1 for v in g for u in adj[v] if u in g) / 2
        degree = sum(len(adj[v]) for v in g)
        q += inside / m - (degree / (2 * m)) ** 2
    return q

def show(groups):
    return ' '.join(sorted(''.join(sorted(g)) for g in groups))

if __name__ == '__main__':
    adj = graph(FRIENDS)
    for name, groups in [('three groups', [set('ABCDE'), set('FGHIJ'), set('KLMNO')]),
                         ('H moved to K', [set('ABCDE'), set('FGIJ'), set('HKLMNO')]),
                         ('two groups', [set('ABCDE'), set('FGHIJKLMNO')]),
                         ('everyone together', [set(adj)]),
                         ('everyone alone', [{v} for v in adj])]:
        print(f'{name:18} Q = {modularity(adj, groups):7.4f}')
# three groups       Q =  0.4712
# H moved to K       Q =  0.4016
# two groups         Q =  0.2951
# everyone together  Q =  0.0000
# everyone alone     Q = -0.0725
三个圈子的得分是 0.4712。用数字来说:26 条边中有 21 条,即 81%,位于群组内部,而度数相同的随机连接只会把 33.65% 的边放在内部,0.8077 - 0.3365 = 0.4712。所有人在一个群组中的得分恰好是 0,因为它并不比随机好,而每人单独一组的得分低于零。把 H 移到右边的群组,得分会降到 0.4016,因此按这一度量, H 属于 F 到 J那一组。
0.4712 是可能的最佳值吗?一个有 15 个顶点的网络共有 1,382,958,545 种不同的划分方式,多到无法逐一列出,但对顶点的 32,768 个子集运行动态规划,可以精确地求出最大值。最佳划分就是这三个圈子,其 Q = 0.4712。在大型网络上无法做这样的检查:Ulrik Brandes 及其同事在 2008 年证明,寻找模块度最大的划分是 NP 困难的,这就是每种实用方法都是启发式方法的原因。
4. Girvan-Newman:切断群组之间的桥
Michelle Girvan 和 Mark Newman 2002 年的方法自上而下地工作。连接两个群组的边承载着许多最短路径,因为从一个群组到另一个群组的每条路线都必须经过它,或经过少数几条与它类似的边。这就是该边的边介数,它用与介数中心性相同的广度优先搜索来计算。该方法删除介数最高的边,重新计算,然后重复。每当网络分裂出更多的部分,它就记录下这个划分及其模块度。
from collections import deque
from modularity import FRIENDS, graph, modularity, show

def edge_betweenness(adj):
    """Brandes 算法,把贡献记给边而不是顶点。"""
    score = {}
    for s in adj:
        order, preds, sigma, dist = [], {v: [] for v in adj}, dict.fromkeys(adj, 0), {s: 0}
        sigma[s] = 1
        queue = deque([s])
        while queue:
            v = queue.popleft()
            order.append(v)
            for w in adj[v]:
                if w not in dist:
                    dist[w] = dist[v] + 1
                    queue.append(w)
                if dist[w] == dist[v] + 1:
                    sigma[w] += sigma[v]
                    preds[w].append(v)
        delta = dict.fromkeys(adj, 0.0)
        for w in reversed(order):
            for v in preds[w]:
                credit = sigma[v] / sigma[w] * (1 + delta[w])
                edge = tuple(sorted((v, w)))
                score[edge] = score.get(edge, 0) + credit / 2   # 每一对都从两端各计算一次
                delta[v] += credit
    return score

def components(adj):
    seen, parts = set(), []
    for s in sorted(adj):
        if s not in seen:
            part, stack = set(), [s]
            while stack:
                v = stack.pop()
                if v not in part:
                    part.add(v)
                    stack.extend(adj[v])
            seen |= part
            parts.append(part)
    return parts

def girvan_newman(adj, verbose=False):
    """删除介数最高的边,重新计算,重复;保留每一个划分。"""
    work = {v: set(nbrs) for v, nbrs in adj.items()}
    splits = {1: [set(adj)]}
    while any(work.values()):
        score = edge_betweenness(work)
        a, b = max(sorted(score), key=score.get)
        work[a].discard(b)
        work[b].discard(a)
        parts = components(work)
        if len(parts) not in splits:
            splits[len(parts)] = parts
            if verbose:
                print(f'cut {a}{b}: {len(parts):2} groups  Q = {modularity(adj, parts):.4f}')
    best = max(splits.values(), key=lambda p: modularity(adj, p))
    return best, splits

if __name__ == '__main__':
    adj = graph(FRIENDS)
    best, splits = girvan_newman(adj, verbose=True)
    print('best:', show(best), round(modularity(adj, best), 4))
# cut DJ:  2 groups  Q = 0.2951
# cut HM:  3 groups  Q = 0.4712
# cut CE:  4 groups  Q = 0.4312
# cut GI:  5 groups  Q = 0.3780
# cut KM:  6 groups  Q = 0.3070
# cut HJ:  7 groups  Q = 0.2744
# cut LO:  8 groups  Q = 0.2241
# cut AC:  9 groups  Q = 0.1901
# cut BE: 10 groups  Q = 0.1287
# cut DE: 11 groups  Q = 0.0991
# cut FJ: 12 groups  Q = 0.0377
# cut IJ: 13 groups  Q = 0.0081
# cut MO: 14 groups  Q = -0.0429
# cut NO: 15 groups  Q = -0.0725
# best: ABCDE FGHIJ KLMNO 0.4712
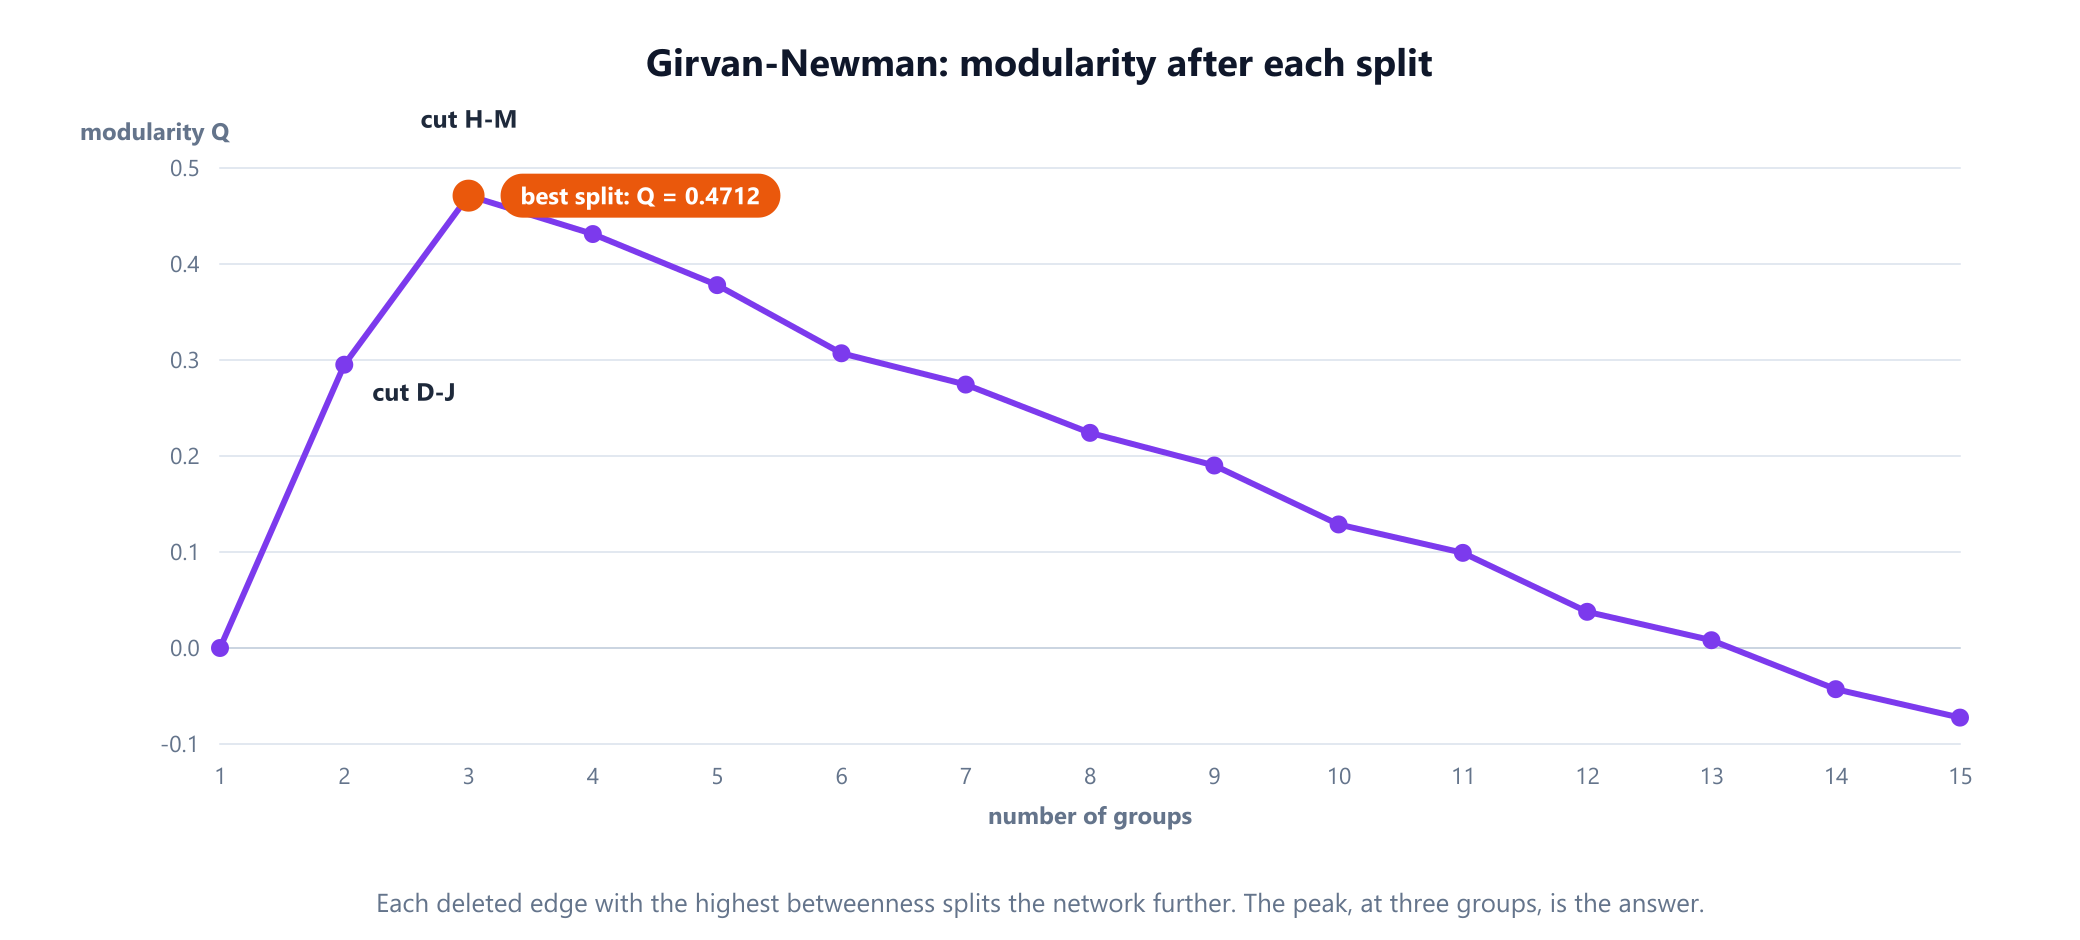
第一条被删除的边是 D-J,它已经把左边的群组分离出来:两部分, Q = 0.2951。接着 H-M 被删除,右边的群组也脱离出来:三部分, Q = 0.4712。此后的切割开始把真正的群组拆散,模块度只会下降,直到每个顶点单独一组时降到 -0.0725。保留得分最高的划分,又得到了这三个圈子。
缺点在于代价。每一轮都要为每条边重新计算介数,这需要 O(mn) 的时间,而且最多有 m 轮,所以整个方法大约需要 O(m²n)的时间。几百条边没有问题,几百万条边就毫无希望了。
5. Louvain:自下而上地扩大群组
本节介绍的 Louvain 方法(由 Vincent Blondel、Jean-Loup Guillaume、Renaud Lambiotte 和 Etienne Lefebvre 于 2008 年在鲁汶天主教大学 (Université catholique de Louvain) 发表)以贪心方式最大化模块度,分为两个反复进行的阶段:
- 局部移动。开始时每个顶点各自成为一个群组。逐个访问顶点,把每个顶点移到能使模块度提高最多的相邻群组,前提是存在这样的移动。重复,直到任何单个移动都无济于事。
- 聚合。把每个群组合并成一个顶点。群组内部的边成为新顶点上的自环,群组之间的边则累加起来。
然后在更小的网络上再次运行第 1 阶段。一次移动的增益可以由少数几个求和算出,而不必从头重新计算 Q,这正是该方法速度快的原因。
from modularity import FRIENDS, graph, modularity, show

def louvain(adj, verbose=False):
    """Louvain:只要 Q 上升就移动单个顶点,然后把每个群组合并成一个顶点。"""
    w = {v: {u: 1 for u in adj[v]} for v in adj}       # w[v][v] 保存合并顶点内部的边
    members = {v: {v} for v in adj}
    m2 = sum(len(nbrs) for nbrs in adj.values())        # 边数的两倍
    level = 0
    while True:
        k = {v: sum(w[v].values()) for v in w}           # 每个(合并后的)顶点的度
        group, total = {v: v for v in w}, dict(k)        # total = 一个群组中各顶点度的总和
        moved = True
        while moved:
            moved = False
            for v in sorted(w):
                old = group[v]
                total[old] -= k[v]
                links = {}
                for u, x in w[v].items():
                    if u != v:
                        links[group[u]] = links.get(group[u], 0) + x
                gain = lambda g: links.get(g, 0) - total[g] * k[v] / m2
                best = old
                for g in sorted(links):
                    if gain(g) > gain(best) + 1e-12:
                        best = g
                group[v] = best
                total[best] += k[v]
                moved |= best != old
        if len(set(group.values())) == len(w):           # 没有发生合并:结束
            break
        level += 1
        merged = {}
        for v, g in group.items():
            merged.setdefault(g, {})
            for u, x in w[v].items():
                merged[g][group[u]] = merged[g].get(group[u], 0) + x
        members = {g: set().union(*(members[v] for v in w if group[v] == g)) for g in merged}
        w = merged
        if verbose:
            print(f'pass {level}: {len(w)} groups  Q = {modularity(adj, members.values()):.4f}')
    return list(members.values())

if __name__ == '__main__':
    adj = graph(FRIENDS)
    groups = louvain(adj, verbose=True)
    print('result:', show(groups))
# pass 1: 4 groups  Q = 0.4312
# pass 2: 3 groups  Q = 0.4712
# result: ABCDE FGHIJ KLMNO
第一轮结束时有四个群组:中间和右边的圈子已经完整,但左边的圈子分裂成了 A、 C 与 B、 D、 E两部分,此时 Q = 0.4312。仅靠顶点移动无法修正这一点,因为把任何一个人在这两半之间移动都会降低得分。第二轮移动的是整个群组,它合并了这两半,达到最优值 0.4712。
Louvain 有两个已知缺陷。它继承了模块度的所有局限,见第 7 节。而且它的群组可能连通性很差,甚至会分裂:一个把群组维系在一起的顶点可能在后面的一轮中移走,使其余部分不再连通。Vincent Traag、Ludo Waltman 和 Nees Jan van Eck 2019 年的 Leiden 算法增加了一个保证群组连通的细化步骤,常被推荐用来代替 Louvain。
6. 标签传播:快速,但每次结果都不同
标签传播(由 Usha Nandini Raghavan、Réka Albert 和 Soundar Kumara 于 2007 年提出)完全不计算模块度。每个顶点开始时都有自己的标签。按随机顺序,每个顶点采用其邻居中最常见的标签,平局时随机选择。稠密的群组很快会统一到一个标签上,当每个顶点已经持有一个最常见的标签时,过程停止。每轮扫描需要 O(m) 的时间,而且通常只需要少数几轮。
import random
from collections import Counter
from modularity import FRIENDS, graph, show

def label_propagation(adj, seed):
    """每个人从自己的标签开始,不断采用邻居中最常见的标签。"""
    rnd = random.Random(seed)
    label = {v: v for v in adj}
    for _ in range(1000):
        order = sorted(adj)
        rnd.shuffle(order)
        changed = False
        for v in order:
            if not adj[v]:
                continue
            count = Counter(label[u] for u in adj[v])
            top = max(count.values())
            best = sorted(l for l, c in count.items() if c == top)
            if label[v] not in best:                  # 如果自己的标签在最佳之列,就保留它
                label[v] = rnd.choice(best)
                changed = True
        if not changed:
            break
    groups = {}
    for v, l in label.items():
        groups.setdefault(l, set()).add(v)
    return list(groups.values())

if __name__ == '__main__':
    adj = graph(FRIENDS)
    results = Counter(show(label_propagation(adj, seed)) for seed in range(1000))
    print('different results in 1000 runs:', len(results))
    for groups, n in results.most_common(4):
        print(f'{n:4}  {groups}')
# different results in 1000 runs: 49
#  387  ABCDE FGHIJ KLMNO
#  275  AC BDE FGHIJ KLMNO
#   46  ABCDE FIJ GHKLMNO
#   35  AB CE DFGHIJ KLMNO
随机性很重要。在十五个朋友上运行 1,000 次,标签传播产生了 49 种不同的答案。它找到三个圈子 387 次。第二常见的答案出现了 275 次,它把左边的圈子分成 A、 C 与 B、 D、 E两部分,这正是 Louvain 第一轮到达的那个中间状态。其他运行则把 G 和 H 拉进了右边的群组,或者合并了两个圈子。
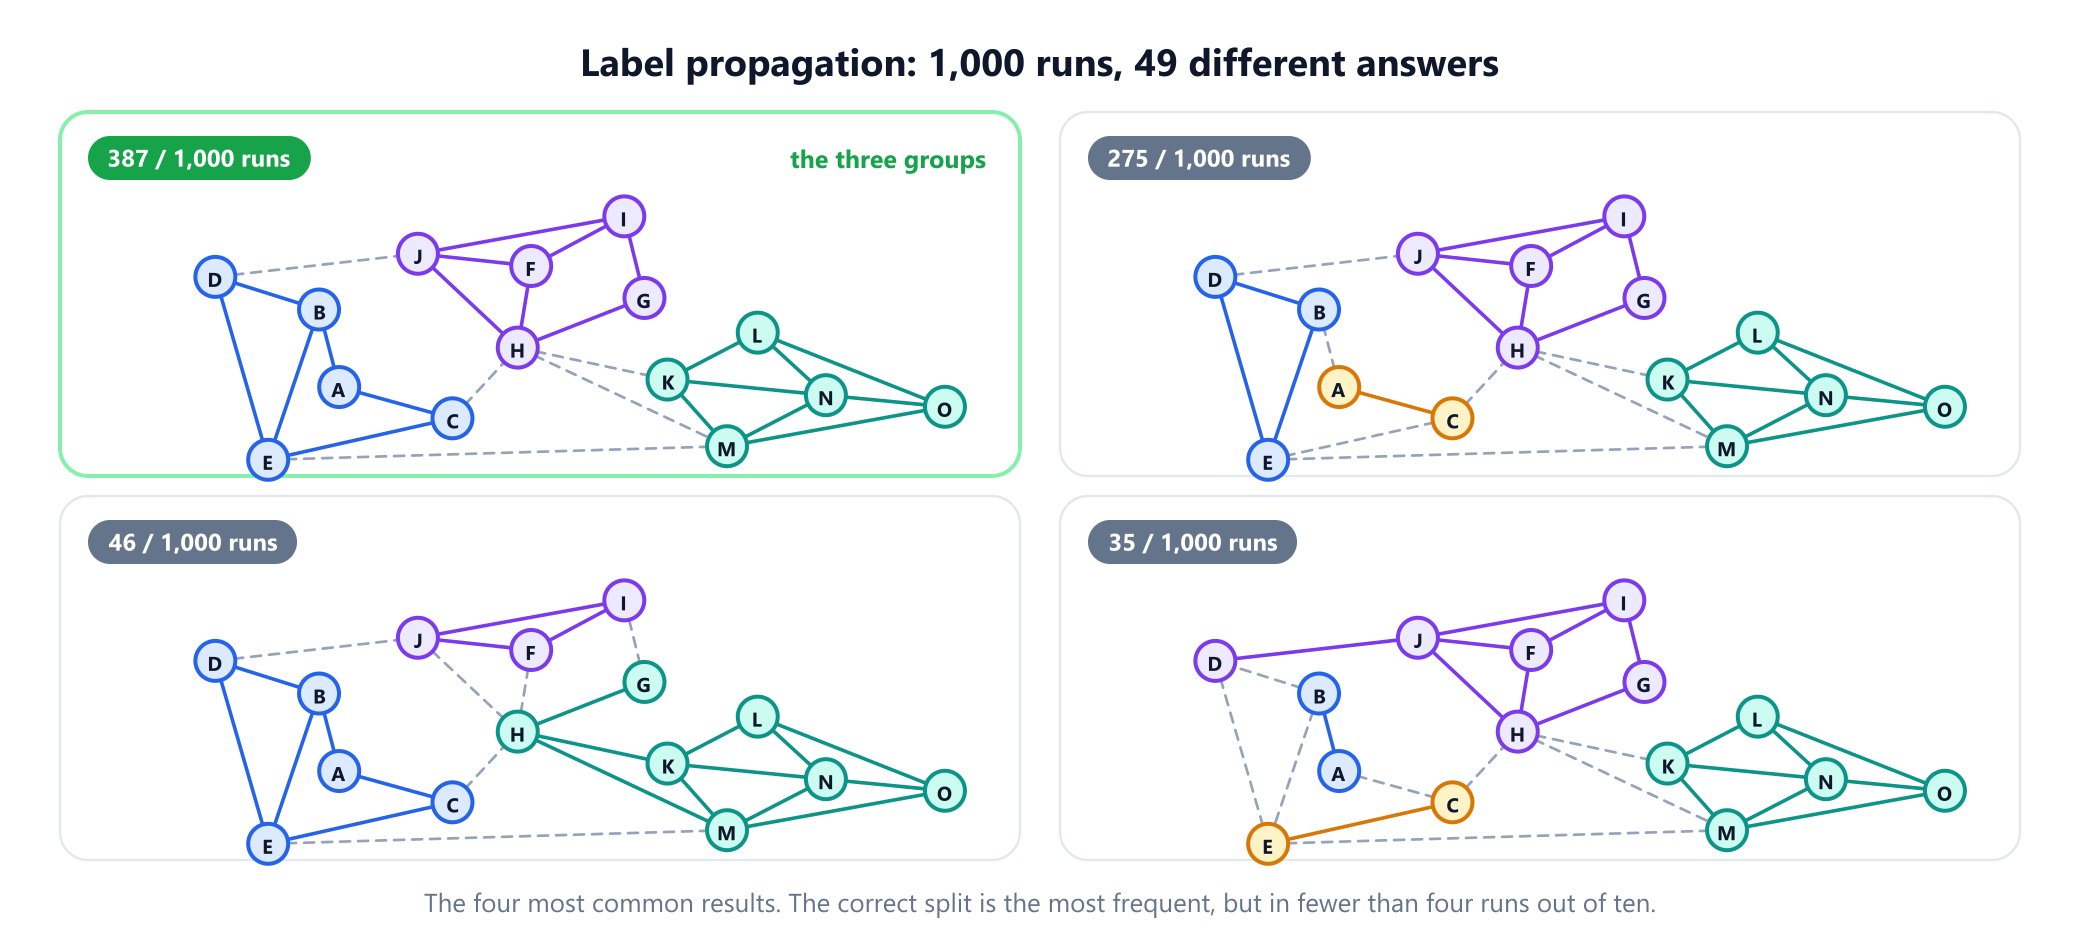
这里没有任何程序错误:其中每一个结果都是合法的停止状态。如果使用标签传播,就要运行几次,保留模块度最高的结果,或者比较每一对顶点有多少次被分到一起。
7. 分辨率极限
模块度有一个任何算法都无法修正的盲点,因为它存在于分数本身之中。Santo Fortunato 和 Marc Barthélemy 在 2007 年证明,在大型网络中,最大化模块度可能会合并明显分开的小群组。原因在于期望边数项:它随网络增大而缩小,因此合并两个小群组几乎没有代价,而它们之间的那一条边却算作收益。
标准示例是团环:由互相都认识的人组成的群组,每个群组用一条边与下一个相连。下一个程序构建 30 个五人群组,并为两种划分打分。
from modularity import modularity
from louvain import louvain

def ring_of_cliques(n, size):
    """n 个各有 `size` 个人的完全群组,每个群组用一条边与下一个相连。"""
    adj = {v: set() for v in range(n * size)}
    for c in range(n):
        people = range(c * size, (c + 1) * size)
        for a in people:
            adj[a] |= set(people) - {a}
        a, b = c * size, ((c + 1) % n) * size + 1
        adj[a].add(b)
        adj[b].add(a)
    return adj

if __name__ == '__main__':
    n, size = 30, 5
    adj = ring_of_cliques(n, size)
    cliques = [set(range(c * size, (c + 1) * size)) for c in range(n)]
    pairs = [cliques[i] | cliques[i + 1] for i in range(0, n, 2)]
    print('one group per clique:   Q =', round(modularity(adj, cliques), 4))
    print('cliques merged in pairs: Q =', round(modularity(adj, pairs), 4))
    found = louvain(adj)
    whole = all(any(g == set().union(*[c for c in cliques if c <= g]) for _ in [0]) for g in found)
    print('Louvain:', len(found), 'groups, Q =', round(modularity(adj, found), 4),
          ', every group a union of whole cliques:', whole)
# one group per clique:   Q = 0.8758
# cliques merged in pairs: Q = 0.8879
# Louvain: 15 groups, Q = 0.8879 , every group a union of whole cliques: True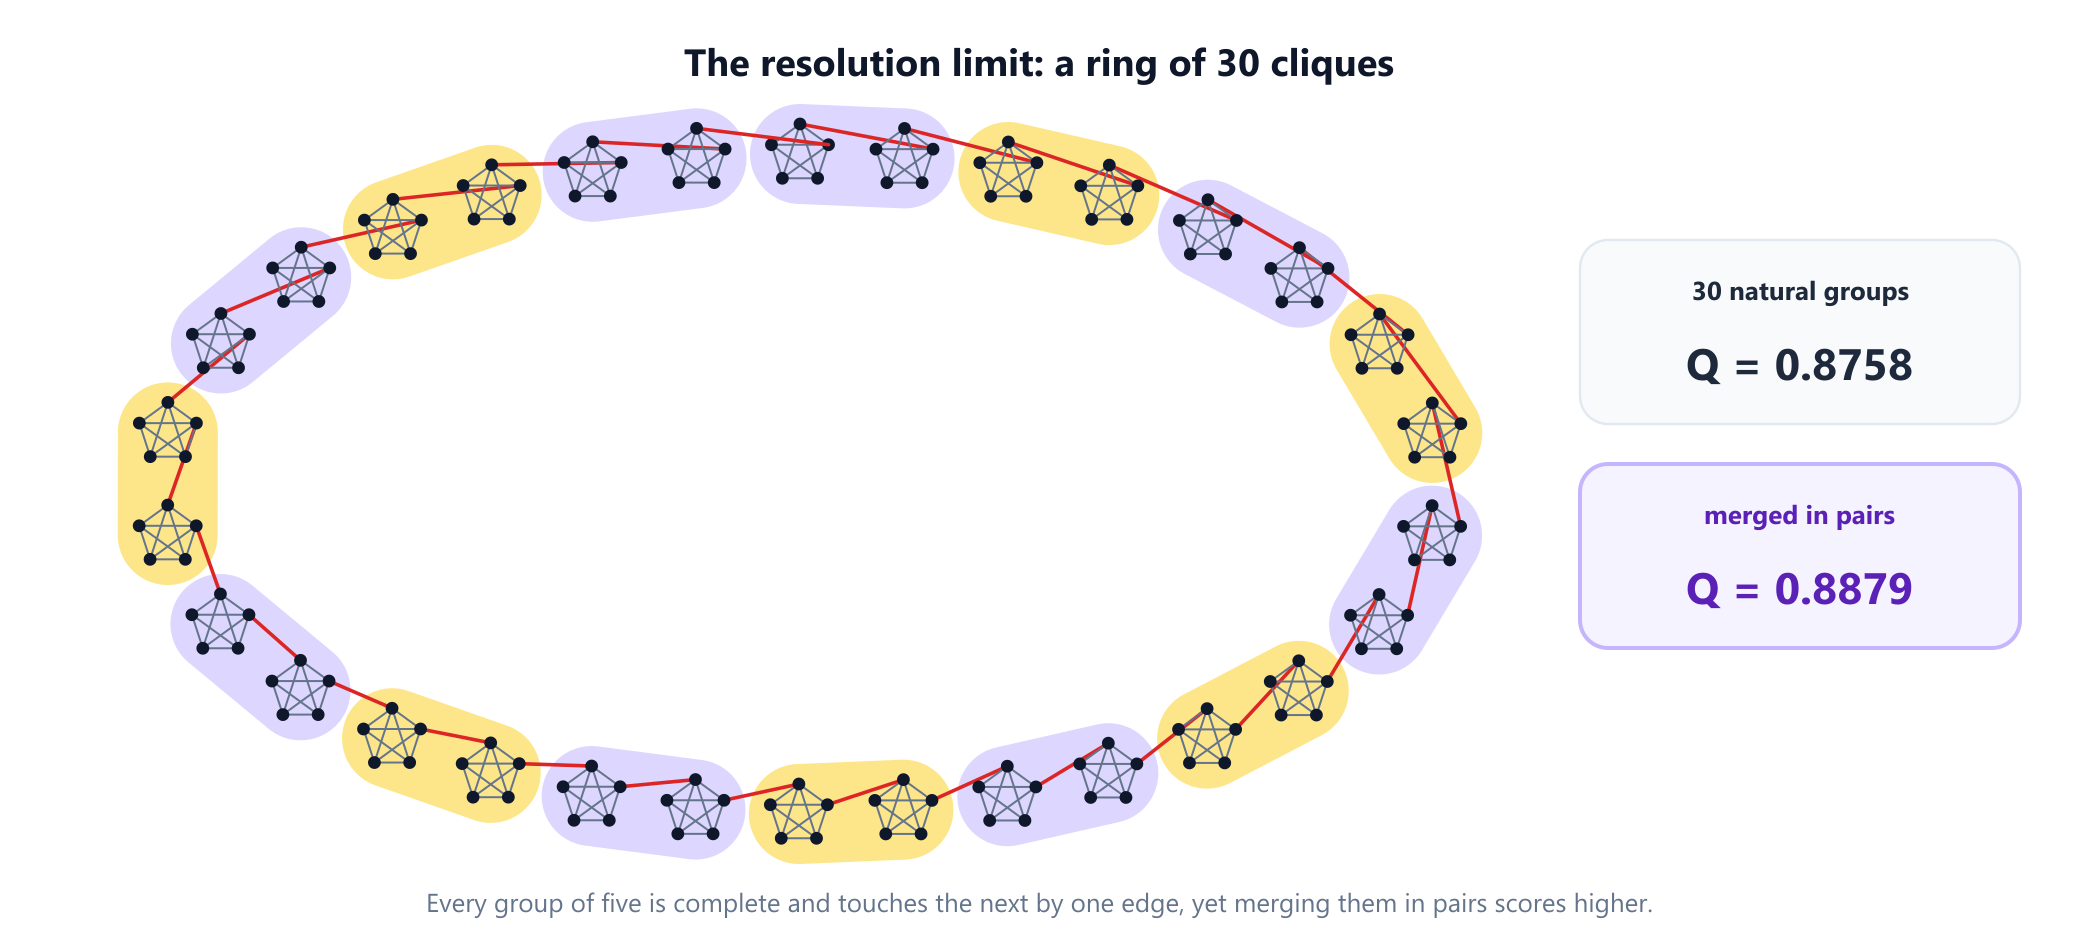
让 30 个群组保持分开,得分为 0.8758。把它们两两合并,得分为 0.8879,因此即使是完美的模块度最大化方法也永远不会返回这 30 个自然群组,而 Louvain 正是把它们两两合并:它返回 15 个群组。Jörg Reichardt 和 Stefan Bornholdt 的分辨率参数 γ 乘在期望边数项上;大于 1 的值偏向更小的群组,小于 1 的值偏向更大的群组。它只是移动了这一极限,而没有消除它,因此值得把找到的群组的大小与你对网络的了解作对照。
8. 真实的检验:Zachary 空手道俱乐部
20 世纪 70 年代,人类学家 Wayne Zachary 记录了一所大学空手道俱乐部 34 名成员之间的友谊,当时教练与俱乐部管理者之间的纠纷使俱乐部一分为二。他 1977 年的论文列出了 78 段友谊,而且由于真实的分裂情况是已知的,这个网络成了社区发现的标准首个检验。下一个程序运行全部三种方法,并用随 NetworkX 库分发的标签,把结果与每名成员加入的一方作比较。这些标签记录的是每名成员在分裂后加入的俱乐部。Zachary 的派系数据把成员 9 归入管理者一方,尽管他加入了教练的俱乐部,因此按派系打分的研究(例如 Girvan 和 Newman 的研究)只把成员 3 算作错放。
from collections import Counter
from modularity import graph, modularity
from girvan_newman import girvan_newman
from louvain import louvain
from lpa import label_propagation

# Zachary 的空手道俱乐部(1977):34 名成员,78 段友谊,以及俱乐部分裂时
# 每名成员站的一方(H = 教练的俱乐部,O = 管理者的俱乐部),成员编号 1 到 34。
CLUB = ('1-2 1-3 1-4 1-5 1-6 1-7 1-8 1-9 1-11 1-12 1-13 1-14 1-18 1-20 1-22 1-32 2-3 2-4 2-8 '
        '2-14 2-18 2-20 2-22 2-31 3-4 3-8 3-9 3-10 3-14 3-28 3-29 3-33 4-8 4-13 4-14 5-7 5-11 '
        '6-7 6-11 6-17 7-17 9-31 9-33 9-34 10-34 14-34 15-33 15-34 16-33 16-34 19-33 19-34 '
        '20-34 21-33 21-34 23-33 23-34 24-26 24-28 24-30 24-33 24-34 25-26 25-28 25-32 26-32 '
        '27-30 27-34 28-34 29-32 29-34 30-33 30-34 31-33 31-34 32-33 32-34 33-34').split()
SIDE = dict(zip([str(i) for i in range(1, 35)], 'HHHHHHHHHOHHHHOOHHOHOHOOOOOOOOOOOO'))

def wrong(groups):
    """被放进某个群组、而该群组的多数成员站在另一方的成员。"""
    bad = []
    for g in groups:
        majority = Counter(SIDE[v] for v in g).most_common(1)[0][0]
        bad += sorted((v for v in g if SIDE[v] != majority), key=int)
    return bad

if __name__ == '__main__':
    adj = graph(CLUB)
    best, splits = girvan_newman(adj)
    print('Girvan-Newman, first split:', [len(g) for g in splits[2]], 'misplaced:', wrong(splits[2]))
    print('Girvan-Newman, best Q:', len(best), 'groups, Q =', round(modularity(adj, best), 4))
    groups = louvain(adj)
    print('Louvain:', len(groups), 'groups, Q =', round(modularity(adj, groups), 4),
          'sizes', sorted(len(g) for g in groups))
    runs = Counter(len(label_propagation(adj, s)) for s in range(1000))
    print('label propagation, groups found in 1000 runs:', dict(sorted(runs.items())))
# Girvan-Newman, first split: [15, 19] misplaced: ['3', '9']
# Girvan-Newman, best Q: 5 groups, Q = 0.4013
# Louvain: 4 groups, Q = 0.4188 sizes [5, 6, 11, 12]
# label propagation, groups found in 1000 runs: {1: 6, 2: 218, 3: 369, 4: 295, 5: 104, 6: 8}
Girvan-Newman 做出的第一次划分把俱乐部分成 15 名和 19 名成员,并错放了两个人,即成员 3 和 9;他们两人在两边都有朋友。它的最佳模块度在后面才达到,此时有五个群组, Q = 0.4013。Louvain 找到四个群组, Q = 0.4188,非常接近这个网络已被证明的最大值 0.4198,而且除成员 9 和 10 之外,它的四个群组都各自位于真实分裂的同一侧。标签传播的结果又一次各不相同:在 1,000 次运行中,它找到的群组从一个到六个不等,最常见的是三个。
教训是,真实网络的“真实”答案取决于所问的问题。俱乐部分裂成了两部分,但模块度偏向四个群组,因为两个派系各自都包含更紧密的圈子。两个答案都没有错;它们回答的是不同的问题。
9. 当群组变得模糊:一次实测的基准测试
要衡量准确度,就需要群组已知的网络。Girvan 和 Newman 2002 年的基准测试有 128 个顶点,分为四个各有 32 个顶点的群组。每个顶点约有 16 条边,其中平均有 z_out 条通向其他群组。 z_out越大,群组就越难辨认。准确度用归一化互信息(NMI)来衡量,这是一个从 0 到 1 的分数,只有当找到的群组与预置的群组完全一致时才等于 1;Leon Danon 及其同事在 2005 年提出把它用于这一目的。
import math, random
from louvain import louvain
from lpa import label_propagation

def planted(rnd, z_out, groups=4, size=32, degree=16):
    """Girvan 和 Newman 的测试:4 个各有 32 个顶点的群组,每个顶点约有 z_out 条边离开它的群组。"""
    n = groups * size
    adj = {v: set() for v in range(n)}
    p_in, p_out = (degree - z_out) / (size - 1), z_out / (n - size)
    for a in range(n):
        for b in range(a + 1, n):
            if rnd.random() < (p_in if a // size == b // size else p_out):
                adj[a].add(b)
                adj[b].add(a)
    return adj

def nmi(found, size=32):
    """找到的群组与预置群组之间的归一化互信息(1 = 完全相同)。"""
    n = sum(len(g) for g in found)
    planted = {}
    for g in found:
        for v in g:
            planted.setdefault(v // size, []).append(v)
    h = lambda parts: -sum(len(p) / n * math.log(len(p) / n) for p in parts)
    mutual = 0.0
    for g in found:
        for p in planted.values():
            k = len(g & set(p))
            if k:
                mutual += k / n * math.log(k * n / (len(g) * len(p)))
    hf, hp = h(found), h(list(planted.values()))
    return 1.0 if hf + hp == 0 else 2 * mutual / (hf + hp)

if __name__ == '__main__':
    rnd = random.Random(7)
    print('edges out   Louvain   label propagation   (average NMI over 10 networks)')
    for z_out in range(1, 10):
        a = b = 0.0
        for _ in range(10):
            adj = planted(rnd, z_out)
            a += nmi(louvain(adj)) / 10
            b += nmi(label_propagation(adj, rnd.randrange(10**6))) / 10
        print(f'{z_out:9} {a:9.2f} {b:12.2f}')
# edges out   Louvain   label propagation   (average NMI over 10 networks)
#         1      1.00         1.00
#         2      1.00         1.00
#         3      1.00         1.00
#         4      1.00         0.90
#         5      0.99         0.85
#         6      0.97         0.35
#         7      0.80         0.10
#         8      0.50         0.02
#         9      0.20         0.00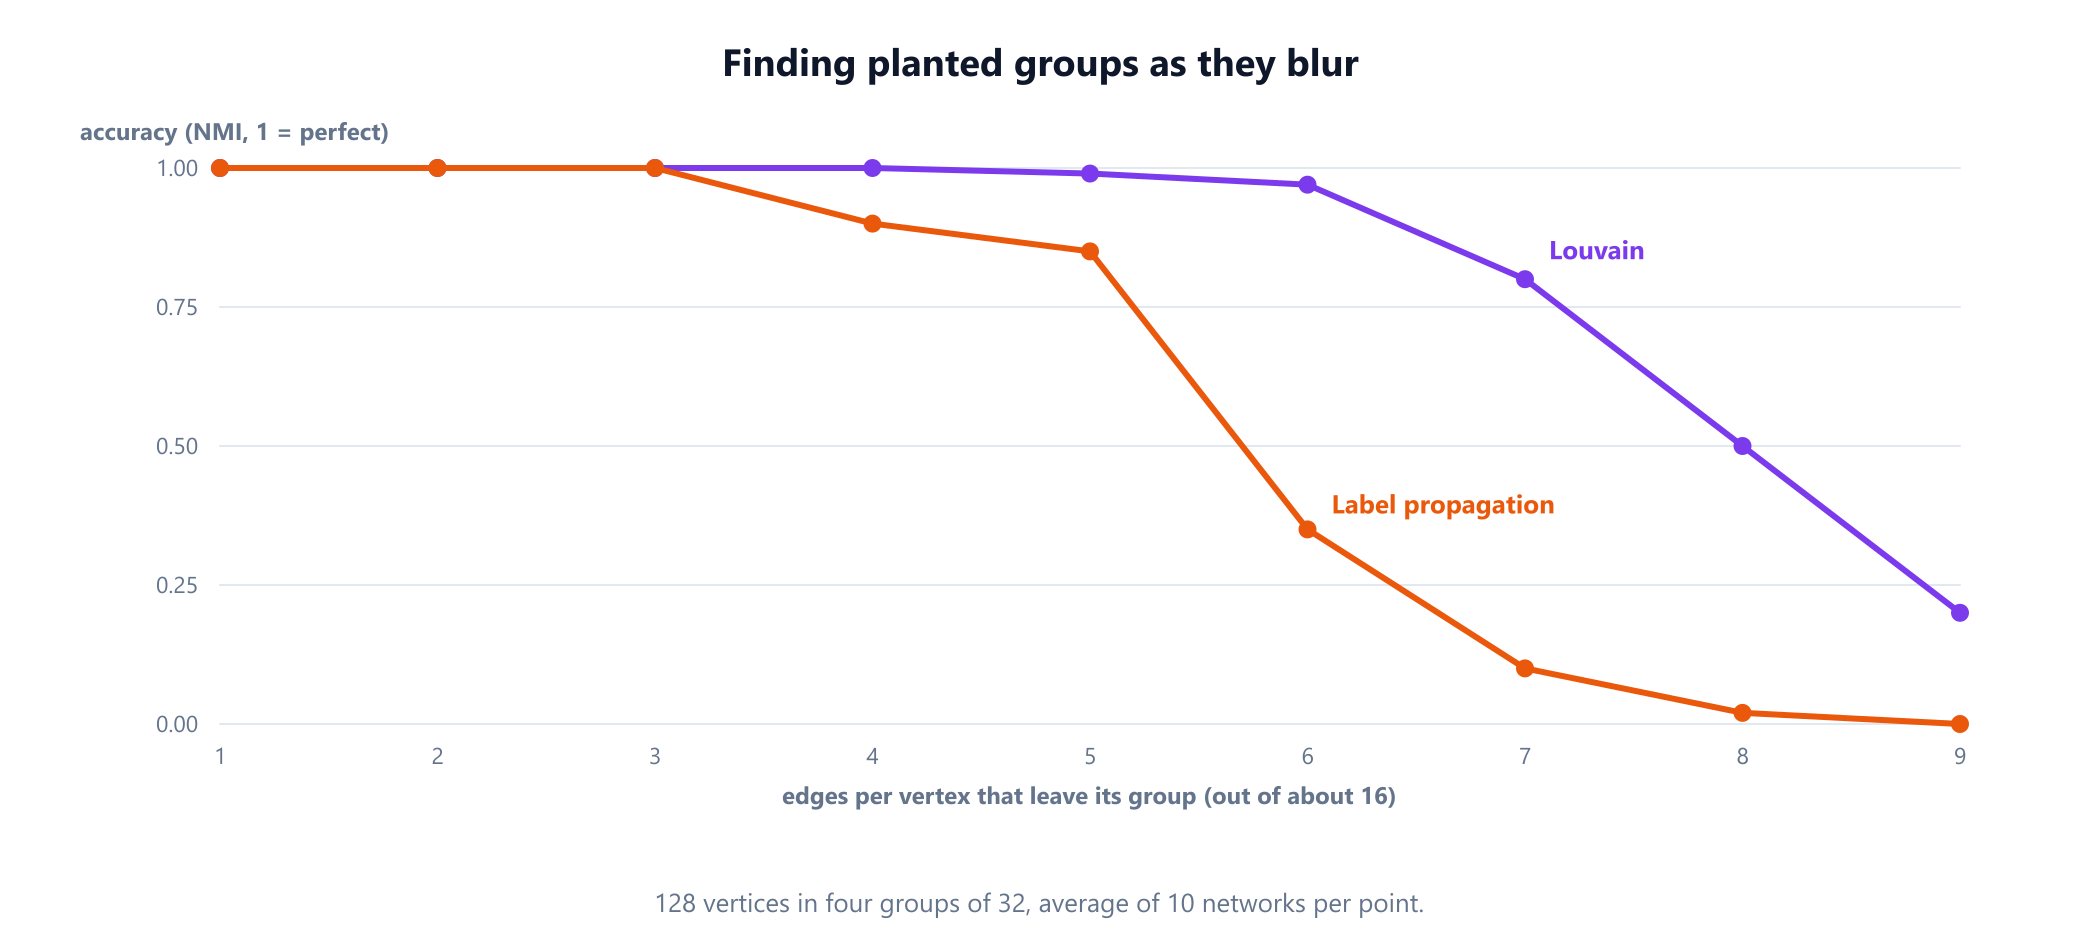
群组清晰时,两种方法都完美无缺。从 16 条边中有 4 条向外开始,标签传播开始出错,到 6 条时它的分数已崩溃到 0.35,而 Louvain 仍有 0.97。到 8 条时,每个顶点有一半的边离开其群组,尽管群组内部仍比群组之间稠密 3.1 倍,连 Louvain 也降到了 0.50。在 z_out = 12 时,群组内部将不会比外部更稠密。实际上,群组在更早的时候就已无法恢复:Aurelien Decelle 及其同事在 2011 年证明,在以这种方式构建的大型网络中,一旦 z_out 超过约 9,任何方法都不可能比随机猜测做得更好。
10. 社区发现的应用场景
- 社交网络。找出朋友圈、同事圈或兴趣群组,以及在这些圈子之间架起桥梁的人,通常与中心性度量结合使用。
- 生物学。蛋白质相互作用网络中的群组往往对应于复合物或通路;关于图论在生物学中的应用的指南介绍了这些网络。
- 推荐与营销。构成一个社区的用户往往有共同的兴趣,这有助于推荐内容和细分受众。
- 欺诈与安全。主要彼此之间进行交易的账户可能形成一个紧密的群组,与正常行为截然不同。
- 软件。依赖图中的群组提示了自然的模块边界,而群组之间的边则指出了值得审查的耦合。
11. 简史
把图分割成若干部分是个老问题:Brian Kernighan 和 Shen Lin 1970 年的启发式方法把图分成给定大小的部分,同时切断尽可能少的边,这个问题源于在电路板上布置电子电路。今天意义上的社区发现,即群组的数量和大小都不预先给定,是随着 Girvan 和 Newman 2002 年的论文兴起的,这篇论文也使 Zachary 空手道俱乐部作为检验而广为流行。Newman 和 Girvan 在 2004 年定义了模块度,同一年 Aaron Clauset、Newman 和 Cristopher Moore 发表了一种最大化模块度的快速贪心方法。标签传播在 2007 年出现,与分辨率极限同年,Louvain 方法则在 2008 年出现。Santo Fortunato 2010 年的综述是一篇标准的概览,而 2019 年的 Leiden 算法修正了 Louvain 中群组不连通的问题。
12. 常见错误
| 错误 | 为什么错 | 修正 |
|---|---|---|
| 只相信标签传播的一次运行 | 在示例中,1,000 次运行给出了 49 种不同的答案 | 运行几次,或者使用 Louvain 或 Leiden |
把最高的 Q 当作真相 | 分辨率极限会合并小群组 | 检查群组大小;尝试分辨率参数 |
在不同网络之间比较 Q 值 | 它的典型值取决于规模和密度 | 比较同一网络的不同划分 |
| 把所有人都在一个群组中视为失败 | 网络可能根本没有社区结构 | 与度数相同的随机网络作比较 |
| 在大图上运行 Girvan-Newman | 它大约需要 O(m²n) 的时间 | 使用 Louvain 或 Leiden |
| 忽视 Louvain 产生的不连通群组 | 一个群组可能在后面的轮次中分裂 | 使用 Leiden,或把群组拆分成连通的部分 |
| 期望每个顶点只属于一个群组 | 人们同时属于家庭、工作和运动的圈子 | 在这一点重要时,使用允许重叠的方法 |
13. 术语表
| 术语 | 含义 |
|---|---|
| 社区 | 一组顶点,内部的边多,与其余部分之间的边少 |
| 划分 | 把顶点分成若干群组,每个顶点恰好属于一个群组 |
| 模块度 | 群组内部的边所占的份额,减去随机情况下的期望份额 |
| 边介数 | 顶点对之间的最短路径中有多少条经过一条边 |
| Girvan-Newman | 反复删除介数最高的边 |
| Louvain 方法 | 提高模块度的局部移动,然后合并群组,反复进行 |
| Leiden 算法 | Louvain 的一种改进,保证群组连通 |
| 标签传播 | 每个顶点反复采用其邻居中最常见的标签 |
| 分辨率极限 | 模块度在大型网络中合并小群组的倾向 |
| 分辨率参数 | 期望边数项上的一个权重 γ,它会改变偏好的群组大小 |
| 团 | 任意两个顶点都相连的一组顶点 |
| NMI | 归一化互信息,两个划分完全相同时为 1 |
14. 常见问题
图中的社区发现是什么?
社区发现是指把网络的顶点分成若干群组,使群组内部的边多、群组之间的边少。它是聚类在图上的版本。典型用途包括在社交网络中寻找朋友圈,在通信数据中寻找团队,在蛋白质网络中寻找复合物,以及在引文图或网页图中寻找相关的主题。
什么是模块度?
模块度通常记作 Q,用来为把网络分成群组的划分打分。它等于落在群组内部的边所占的份额,减去在相同顶点保持各自的度、而边随机放置时预期的份额。接近 0 的值表示不比随机好;分得很清楚的群组通常得分在约 0.3 到 0.7 之间。
什么是 Louvain 算法?
Louvain 方法由 Blondel 及其同事于 2008 年发表,它通过两个反复进行的阶段来最大化模块度。首先,每个顶点移到能使模块度提高最多的相邻群组,直到任何移动都无济于事。然后把每个群组合并成一个顶点,在更小的网络上重复这一过程。它的速度足以处理有数百万条边的网络。
Louvain 和 Girvan-Newman 有什么区别?
Girvan-Newman 自上而下地工作:它反复删除介数最高的边,也就是最可能位于群组之间的边,并保留模块度最好的划分。Louvain 自下而上地工作,在模块度上升时把顶点合并成群组。Girvan-Newman 大约需要 O(m 的平方乘以 n) 的时间,因此只限于小网络;Louvain 则能扩展到非常大的网络。
标签传播可靠吗?
标签传播非常快,但其结果取决于随机选择。在本指南的 15 人示例中,1,000 次运行产生了 49 种不同的答案,只有 387 次找到了三个真实的群组。要运行几次并加以比较,或者在需要稳定的结果时使用基于模块度的方法。
模块度的分辨率极限是什么?
Fortunato 和 Barthélemy 在 2007 年证明,当网络很大时,最大化模块度可能会合并明显分开的小群组。在由 30 个五人群组组成的环上,把相邻群组两两合并的得分高于让它们保持分开。分辨率参数,或者不依赖模块度的方法,可以解决这一问题。
15. 参考文献
上文中的算法、结果和归属均来自以下文献,按时间顺序排列。
- Kernighan, B. W. 和 Lin, S. (1970). "An Efficient Heuristic Procedure for Partitioning Graphs." Bell System Technical Journal 49(2),291 至 307 页。
- Zachary, W. W. (1977). "An Information Flow Model for Conflict and Fission in Small Groups." Journal of Anthropological Research 33(4),452 至 473 页。
- Girvan, M. 和 Newman, M. E. J. (2002). "Community Structure in Social and Biological Networks." Proceedings of the National Academy of Sciences 99(12),7821 至 7826 页。
- Newman, M. E. J. 和 Girvan, M. (2004). "Finding and Evaluating Community Structure in Networks." Physical Review E 69,026113。
- Clauset, A., Newman, M. E. J. 和 Moore, C. (2004). "Finding Community Structure in Very Large Networks." Physical Review E 70,066111。
- Danon, L., Díaz-Guilera, A., Duch, J. 和 Arenas, A. (2005). "Comparing Community Structure Identification." Journal of Statistical Mechanics: Theory and Experiment,P09008。
- Reichardt, J. 和 Bornholdt, S. (2006). "Statistical Mechanics of Community Detection." Physical Review E 74,016110。
- Fortunato, S. 和 Barthélemy, M. (2007). "Resolution Limit in Community Detection." Proceedings of the National Academy of Sciences 104(1),36 至 41 页。
- Raghavan, U. N., Albert, R. 和 Kumara, S. (2007). "Near Linear Time Algorithm to Detect Community Structures in Large-Scale Networks." Physical Review E 76,036106。
- Brandes, U., Delling, D., Gaertler, M., Görke, R., Hoefer, M., Nikoloski, Z. 和 Wagner, D. (2008). "On Modularity Clustering." IEEE Transactions on Knowledge and Data Engineering 20(2),172 至 188 页。
- Agarwal, G. 和 Kempe, D. (2008). "Modularity-Maximizing Graph Communities via Mathematical Programming." European Physical Journal B 66(3),409 至 418 页。
- Blondel, V. D., Guillaume, J.-L., Lambiotte, R. 和 Lefebvre, E. (2008). "Fast Unfolding of Communities in Large Networks." Journal of Statistical Mechanics: Theory and Experiment,P10008。
- Fortunato, S. (2010). "Community Detection in Graphs." Physics Reports 486(3 至 5),75 至 174 页。
- Decelle, A., Krzakala, F., Moore, C. 和 Zdeborová, L. (2011). "Asymptotic Analysis of the Stochastic Block Model for Modular Networks and Its Algorithmic Applications." Physical Review E 84(6),066106。
- Traag, V. A., Waltman, L. 和 van Eck, N. J. (2019). "From Louvain to Leiden: Guaranteeing Well-Connected Communities." Scientific Reports 9,5233。
看看边介数背后的搜索
Girvan-Newman 从每个顶点各运行一次广度优先搜索,以此给边排序。在可视化工具中画两个由一条边相连的群组,从两侧运行搜索,看看为什么这条边承载着它们之间的每一条路线。
打开可视化工具