
Tabla de Contenidos
- 1. La respuesta corta
- 2. Quince amigos, tres grupos
- 3. Modularidad: puntuar una partición
- 4. Girvan-Newman: cortar los puentes entre grupos
- 5. Louvain: hacer crecer los grupos de abajo arriba
- 6. Propagación de etiquetas: rápida y distinta cada vez
- 7. El límite de resolución
- 8. Una prueba real: el club de kárate de Zachary
- 9. Cuando los grupos se difuminan: un banco de pruebas medido
- 10. Dónde se usa la detección de comunidades
- 11. Una breve historia
- 12. Errores comunes
- 13. Glosario
- 14. Preguntas frecuentes
- 15. Referencias
1. La respuesta corta
La detección de comunidades divide los vértices de una red en grupos con muchas aristas dentro y pocas aristas entre ellos. Es el agrupamiento (clustering) aplicado a grafos: círculos de amigos en una red social, equipos en un registro de correos, complejos de proteínas en una célula, temas en una red de citas. No hay una única respuesta correcta, así que todo método descansa en una definición de lo que es un buen grupo, y la mayoría de los métodos populares usan la misma, llamada modularidad.
| Método | Idea | Coste | ¿Mismo resultado en cada ejecución? | Cuidado con |
|---|---|---|---|---|
| Girvan-Newman | Borrar las aristas por las que pasan más caminos más cortos | Aproximadamente O(m²n) | Sí | Demasiado lento por encima de unos pocos miles de vértices |
| Louvain | Mover vértices para subir la modularidad, después fusionar grupos y repetir | Casi lineal en la práctica | Sí, para un orden fijo de los vértices | El límite de resolución; grupos mal conectados |
| Propagación de etiquetas | Cada vértice adopta la etiqueta más común entre sus vecinos | Aproximadamente O(m) por barrido | No | Respuestas distintas en ejecuciones distintas |
| Maximización exacta de la modularidad | Buscar entre todas las particiones posibles | Exponencial | Sí | Solo para redes diminutas |
En una frase: usa Louvain, o su sucesor Leiden, como opción por defecto, usa la propagación de etiquetas cuando la velocidad importe más que la estabilidad, reserva Girvan-Newman para redes pequeñas en las que quieras ver toda la jerarquía de particiones, y mira siempre los grupos que obtienes en lugar de fiarte de una sola puntuación. Aquí, n es el número de vértices y m el número de aristas.
2. Quince amigos, tres grupos
El ejemplo que recorre la guía es un grupo de quince amigos, de A a O, con una arista entre dos personas que se envían mensajes cada semana. Hay 26 aristas. La red se construyó para contener tres círculos de cinco amigos, de A a E, F a J y K a O, unidos por cinco aristas, y después se comprobó por ordenador para que los métodos de abajo se comporten de forma instructiva.
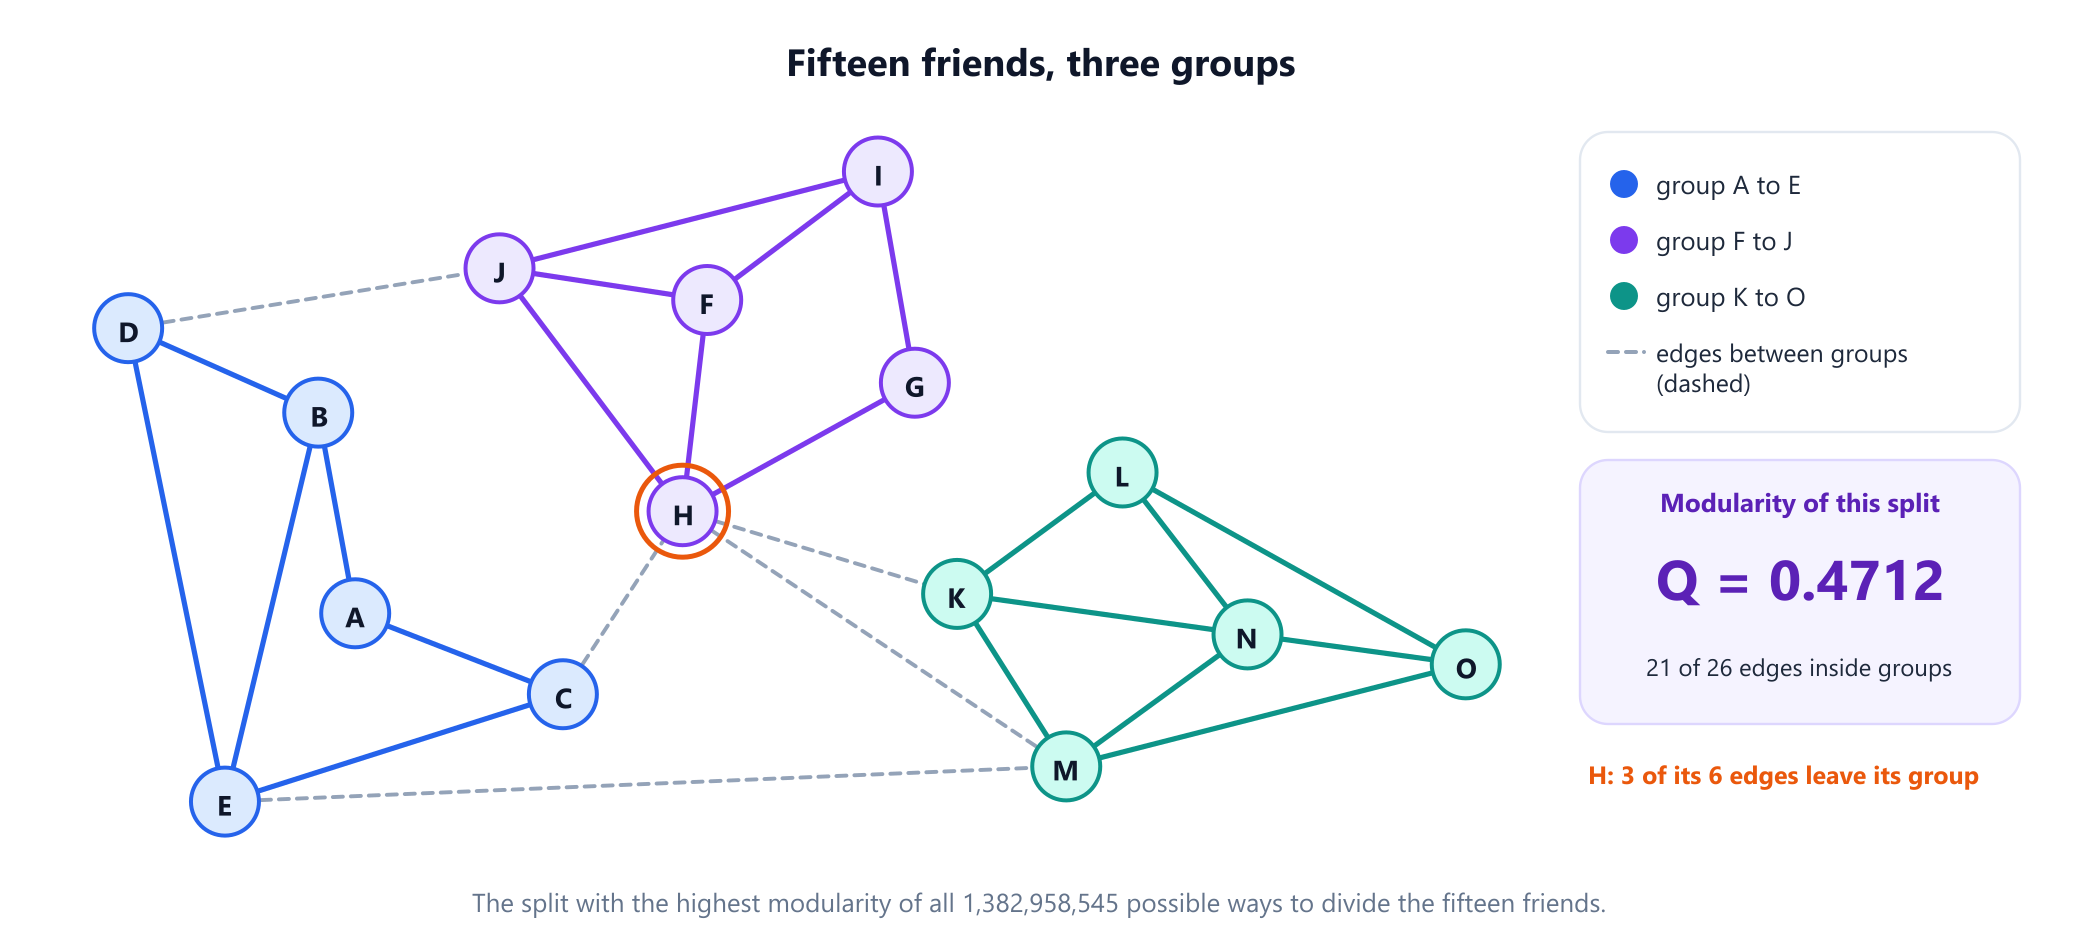
La mayoría de la gente dibujaría a ojo los mismos tres círculos. Hay una persona menos clara: H tiene seis contactos, tres en su propio grupo y tres fuera, incluidos dos en el grupo de K a O. Cualquier método tiene que decidir dónde colocar a H, y el resto de esta guía usa esa decisión como prueba.
3. Modularidad: puntuar una partición
Para comparar particiones hace falta una puntuación. Contar las aristas dentro de los grupos no basta, porque poner a todo el mundo en un solo grupo deja todas las aristas dentro. La modularidad, introducida por Mark Newman y Michelle Girvan en 2004, resta lo que daría el azar por sí solo:
Q = suma sobre los grupos de [ (aristas dentro del grupo) / m - ( (grado total del grupo) / 2m )² ]El segundo término es la fracción de aristas que cabría esperar dentro del grupo si cada vértice conservara su grado pero las aristas se conectaran al azar. Un grupo solo suma puntos por las aristas que tiene por encima de esa expectativa. El programa de abajo calcula Q para cinco formas de dividir a los amigos.
# Quince amigos; una arista une a dos personas que se envían mensajes cada semana.
FRIENDS = 'AB AC BD BE CE CH DE DJ EM FH FI FJ GH GI HJ HK HM IJ KL KM KN LN LO MN MO NO'.split()

def graph(edges):
    """Las aristas son 'AB' para letras sueltas o '12-34' para números."""
    adj = {}
    for e in edges:
        a, b = e.split('-') if '-' in e else e
        adj.setdefault(a, set()).add(b)
        adj.setdefault(b, set()).add(a)
    return adj

def modularity(adj, groups):
    """Q = suma sobre los grupos de (fracción de aristas dentro) - (fracción del grado) al cuadrado."""
    m = sum(len(nbrs) for nbrs in adj.values()) / 2
    q = 0.0
    for g in groups:
        inside = sum(1 for v in g for u in adj[v] if u in g) / 2
        degree = sum(len(adj[v]) for v in g)
        q += inside / m - (degree / (2 * m)) ** 2
    return q

def show(groups):
    return ' '.join(sorted(''.join(sorted(g)) for g in groups))

if __name__ == '__main__':
    adj = graph(FRIENDS)
    for name, groups in [('three groups', [set('ABCDE'), set('FGHIJ'), set('KLMNO')]),
                         ('H moved to K', [set('ABCDE'), set('FGIJ'), set('HKLMNO')]),
                         ('two groups', [set('ABCDE'), set('FGHIJKLMNO')]),
                         ('everyone together', [set(adj)]),
                         ('everyone alone', [{v} for v in adj])]:
        print(f'{name:18} Q = {modularity(adj, groups):7.4f}')
# three groups       Q =  0.4712
# H moved to K       Q =  0.4016
# two groups         Q =  0.2951
# everyone together  Q =  0.0000
# everyone alone     Q = -0.0725
Los tres círculos obtienen 0,4712. En números: 21 de las 26 aristas, el 81 %, quedan dentro de un grupo, mientras que un cableado aleatorio con los mismos grados pondría dentro el 33,65 %, y 0,8077 - 0,3365 = 0,4712. Poner a todos en un solo grupo da exactamente 0, porque no es mejor que el azar, y dejar a cada uno solo da menos de cero. Mover a H al grupo de la derecha baja la puntuación a 0,4016, así que, según esta medida, H pertenece al grupo de F a J.
¿Es 0,4712 lo mejor posible? Una red de 15 vértices se puede dividir de 1.382.958.545 formas distintas, demasiadas para enumerarlas una a una, pero un algoritmo de programación dinámica sobre los 32.768 subconjuntos de vértices encuentra el máximo de forma exacta. La mejor partición son los tres círculos, con Q = 0,4712. En redes grandes no es posible una comprobación así: Ulrik Brandes y sus colegas demostraron en 2008 que encontrar la partición de máxima modularidad es NP-difícil, y por eso todo método práctico es heurístico.
4. Girvan-Newman: cortar los puentes entre grupos
El método de Michelle Girvan y Mark Newman de 2002 trabaja de arriba abajo. Una arista que conecta dos grupos lleva muchos caminos más cortos, porque toda ruta de un grupo al otro tiene que usarla a ella o a una de las pocas que se le parecen. Eso es lo que mide la intermediación de aristas, que se calcula con la misma búsqueda en anchura que la centralidad de intermediación. El método borra la arista con la mayor intermediación, recalcula y repite. Cada vez que la red se rompe en más partes, registra la partición y su modularidad.
from collections import deque
from modularity import FRIENDS, graph, modularity, show

def edge_betweenness(adj):
    """Algoritmo de Brandes, que reparte el crédito entre aristas en lugar de vértices."""
    score = {}
    for s in adj:
        order, preds, sigma, dist = [], {v: [] for v in adj}, dict.fromkeys(adj, 0), {s: 0}
        sigma[s] = 1
        queue = deque([s])
        while queue:
            v = queue.popleft()
            order.append(v)
            for w in adj[v]:
                if w not in dist:
                    dist[w] = dist[v] + 1
                    queue.append(w)
                if dist[w] == dist[v] + 1:
                    sigma[w] += sigma[v]
                    preds[w].append(v)
        delta = dict.fromkeys(adj, 0.0)
        for w in reversed(order):
            for v in preds[w]:
                credit = sigma[v] / sigma[w] * (1 + delta[w])
                edge = tuple(sorted((v, w)))
                score[edge] = score.get(edge, 0) + credit / 2   # cada par se ve desde ambos extremos
                delta[v] += credit
    return score

def components(adj):
    seen, parts = set(), []
    for s in sorted(adj):
        if s not in seen:
            part, stack = set(), [s]
            while stack:
                v = stack.pop()
                if v not in part:
                    part.add(v)
                    stack.extend(adj[v])
            seen |= part
            parts.append(part)
    return parts

def girvan_newman(adj, verbose=False):
    """Borra la arista de mayor intermediación, recalcula, repite; guarda cada partición."""
    work = {v: set(nbrs) for v, nbrs in adj.items()}
    splits = {1: [set(adj)]}
    while any(work.values()):
        score = edge_betweenness(work)
        a, b = max(sorted(score), key=score.get)
        work[a].discard(b)
        work[b].discard(a)
        parts = components(work)
        if len(parts) not in splits:
            splits[len(parts)] = parts
            if verbose:
                print(f'cut {a}{b}: {len(parts):2} groups  Q = {modularity(adj, parts):.4f}')
    best = max(splits.values(), key=lambda p: modularity(adj, p))
    return best, splits

if __name__ == '__main__':
    adj = graph(FRIENDS)
    best, splits = girvan_newman(adj, verbose=True)
    print('best:', show(best), round(modularity(adj, best), 4))
# cut DJ:  2 groups  Q = 0.2951
# cut HM:  3 groups  Q = 0.4712
# cut CE:  4 groups  Q = 0.4312
# cut GI:  5 groups  Q = 0.3780
# cut KM:  6 groups  Q = 0.3070
# cut HJ:  7 groups  Q = 0.2744
# cut LO:  8 groups  Q = 0.2241
# cut AC:  9 groups  Q = 0.1901
# cut BE: 10 groups  Q = 0.1287
# cut DE: 11 groups  Q = 0.0991
# cut FJ: 12 groups  Q = 0.0377
# cut IJ: 13 groups  Q = 0.0081
# cut MO: 14 groups  Q = -0.0429
# cut NO: 15 groups  Q = -0.0725
# best: ABCDE FGHIJ KLMNO 0.4712
La primera arista en caer es D-J, que ya separa el grupo de la izquierda: dos partes, Q = 0,2951. Después cae H-M y el grupo de la derecha queda suelto: tres partes, Q = 0,4712. A partir de ahí los cortes empiezan a romper grupos reales y la modularidad solo baja, hasta -0,0725 cuando cada vértice queda solo. Quedarse con la partición de mayor puntuación vuelve a dar los tres círculos.
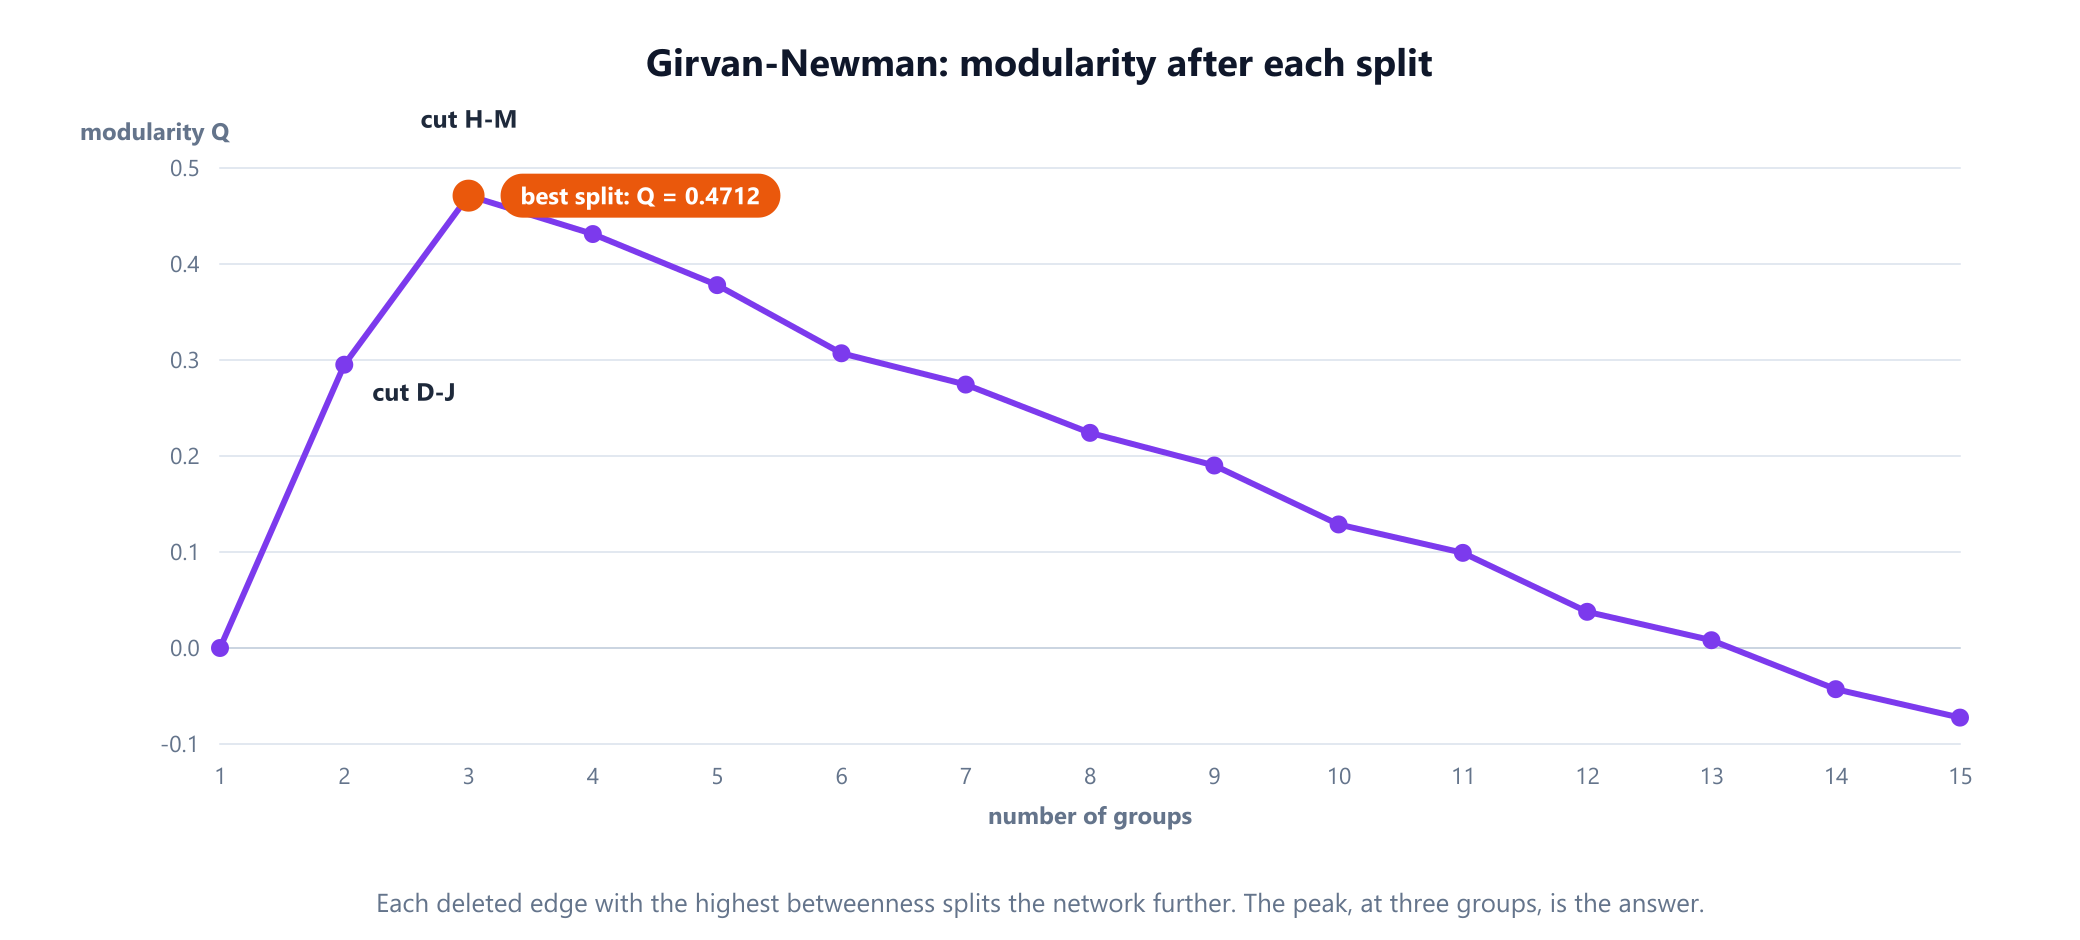
El punto débil es el coste. Cada ronda recalcula la intermediación de todas las aristas, lo que lleva O(mn) de tiempo, y hay hasta m rondas, así que el método completo tarda aproximadamente O(m²n). Eso va bien para unos cientos de aristas y es inviable para unos millones.
5. Louvain: hacer crecer los grupos de abajo arriba
El método de Louvain, publicado en 2008 por Vincent Blondel, Jean-Loup Guillaume, Renaud Lambiotte y Etienne Lefebvre en la Université catholique de Louvain, maximiza la modularidad de forma voraz en dos fases que se repiten:
- Movimientos locales. Se empieza con cada vértice en su propio grupo. Se visitan los vértices uno a uno y cada uno se mueve al grupo vecino que más aumente la modularidad, si algún movimiento la aumenta. Se repite hasta que ningún movimiento individual ayude.
- Agregación. Cada grupo se fusiona en un único vértice. Las aristas dentro del grupo se convierten en un bucle sobre el nuevo vértice, y las aristas entre grupos se suman.
Después se vuelve a ejecutar la fase 1 sobre la red más pequeña. La ganancia de un movimiento se puede calcular a partir de unas pocas sumas, sin recalcular Q desde cero, y eso es lo que hace rápido el método.
from modularity import FRIENDS, graph, modularity, show

def louvain(adj, verbose=False):
    """Louvain: mueve vértices sueltos mientras Q sube y luego fusiona cada grupo en un vértice."""
    w = {v: {u: 1 for u in adj[v]} for v in adj}       # w[v][v] guarda las aristas dentro de un vértice fusionado
    members = {v: {v} for v in adj}
    m2 = sum(len(nbrs) for nbrs in adj.values())        # el doble del número de aristas
    level = 0
    while True:
        k = {v: sum(w[v].values()) for v in w}           # grado de cada vértice (fusionado)
        group, total = {v: v for v in w}, dict(k)        # total = suma de los grados de un grupo
        moved = True
        while moved:
            moved = False
            for v in sorted(w):
                old = group[v]
                total[old] -= k[v]
                links = {}
                for u, x in w[v].items():
                    if u != v:
                        links[group[u]] = links.get(group[u], 0) + x
                gain = lambda g: links.get(g, 0) - total[g] * k[v] / m2
                best = old
                for g in sorted(links):
                    if gain(g) > gain(best) + 1e-12:
                        best = g
                group[v] = best
                total[best] += k[v]
                moved |= best != old
        if len(set(group.values())) == len(w):           # no se fusionó nada: terminado
            break
        level += 1
        merged = {}
        for v, g in group.items():
            merged.setdefault(g, {})
            for u, x in w[v].items():
                merged[g][group[u]] = merged[g].get(group[u], 0) + x
        members = {g: set().union(*(members[v] for v in w if group[v] == g)) for g in merged}
        w = merged
        if verbose:
            print(f'pass {level}: {len(w)} groups  Q = {modularity(adj, members.values()):.4f}')
    return list(members.values())

if __name__ == '__main__':
    adj = graph(FRIENDS)
    groups = louvain(adj, verbose=True)
    print('result:', show(groups))
# pass 1: 4 groups  Q = 0.4312
# pass 2: 3 groups  Q = 0.4712
# result: ABCDE FGHIJ KLMNO
La primera pasada termina con cuatro grupos: los círculos del centro y de la derecha ya están completos, pero el círculo de la izquierda se ha dividido en A, C y B, D, E, con Q = 0,4312. Los movimientos de vértices por sí solos no pueden arreglarlo, porque mover a cualquier persona sola entre esas dos mitades baja la puntuación. La segunda pasada mueve grupos enteros, fusiona las dos mitades y alcanza el óptimo de 0,4712.
Louvain tiene dos defectos conocidos. Hereda todos los límites de la modularidad, descritos en la sección 7. Y sus grupos pueden estar mal conectados, o incluso romperse: un vértice que mantenía unido un grupo puede irse en una pasada posterior y dejar desconectado al resto. El algoritmo de Leiden de Vincent Traag, Ludo Waltman y Nees Jan van Eck, de 2019, añade un paso de refinamiento que garantiza grupos conexos, y a menudo se recomienda en lugar de Louvain.
6. Propagación de etiquetas: rápida y distinta cada vez
La propagación de etiquetas, propuesta por Usha Nandini Raghavan, Réka Albert y Soundar Kumara en 2007, no calcula la modularidad en absoluto. Cada vértice empieza con su propia etiqueta. En orden aleatorio, cada vértice adopta la etiqueta más común entre sus vecinos y deshace los empates al azar. Los grupos densos se asientan pronto en una sola etiqueta, y el proceso se detiene cuando cada vértice ya tiene una de las etiquetas más comunes a su alrededor. Cada barrido lleva O(m) de tiempo, y normalmente hacen falta pocos barridos.
import random
from collections import Counter
from modularity import FRIENDS, graph, show

def label_propagation(adj, seed):
    """Cada uno empieza con su propia etiqueta y va adoptando la más común a su alrededor."""
    rnd = random.Random(seed)
    label = {v: v for v in adj}
    for _ in range(1000):
        order = sorted(adj)
        rnd.shuffle(order)
        changed = False
        for v in order:
            if not adj[v]:
                continue
            count = Counter(label[u] for u in adj[v])
            top = max(count.values())
            best = sorted(l for l, c in count.items() if c == top)
            if label[v] not in best:                  # conserva tu etiqueta si está entre las mejores
                label[v] = rnd.choice(best)
                changed = True
        if not changed:
            break
    groups = {}
    for v, l in label.items():
        groups.setdefault(l, set()).add(v)
    return list(groups.values())

if __name__ == '__main__':
    adj = graph(FRIENDS)
    results = Counter(show(label_propagation(adj, seed)) for seed in range(1000))
    print('different results in 1000 runs:', len(results))
    for groups, n in results.most_common(4):
        print(f'{n:4}  {groups}')
# different results in 1000 runs: 49
#  387  ABCDE FGHIJ KLMNO
#  275  AC BDE FGHIJ KLMNO
#   46  ABCDE FIJ GHKLMNO
#   35  AB CE DFGHIJ KLMNO
La aleatoriedad importa. En 1.000 ejecuciones sobre los quince amigos, la propagación de etiquetas produjo 49 respuestas distintas. Encontró los tres círculos 387 veces. La segunda respuesta más común, hallada 275 veces, divide el círculo de la izquierda en A, C y B, D, E, el mismo estado intermedio al que llegó la primera pasada de Louvain. Otras ejecuciones llevaron a G y H al grupo de la derecha, o fusionaron dos círculos.
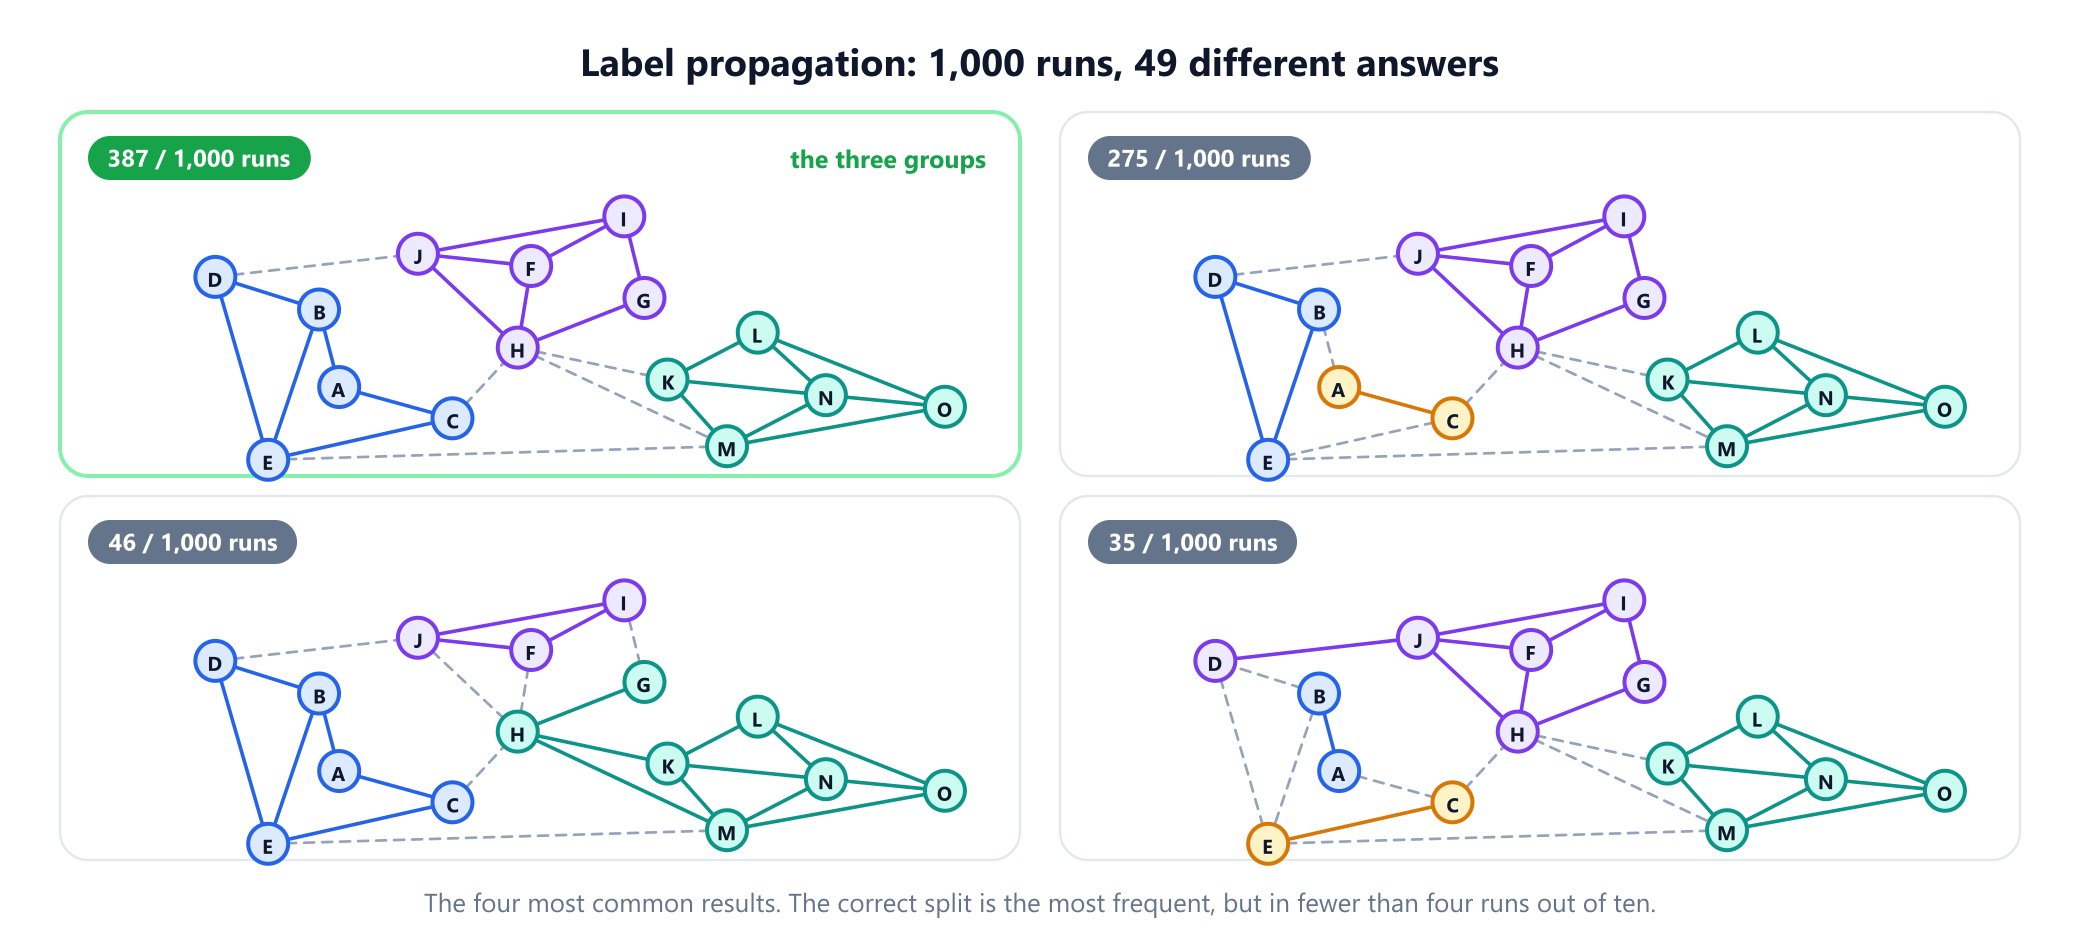
Nada de esto es un fallo del programa: cada uno de esos resultados es un estado de parada válido. Si usas la propagación de etiquetas, ejecútala varias veces y quédate con el resultado de mejor modularidad, o compara con qué frecuencia acaba junto cada par de vértices.
7. El límite de resolución
La modularidad tiene un punto ciego que ningún algoritmo puede arreglar, porque está en la propia puntuación. Santo Fortunato y Marc Barthélemy demostraron en 2007 que, en una red grande, maximizar la modularidad puede fusionar grupos pequeños que están claramente separados. La causa es el término de aristas esperadas: se encoge a medida que crece la red, así que fusionar dos grupos pequeños no cuesta casi nada, mientras que la única arista entre ellos cuenta como ganancia.
El ejemplo clásico es un anillo de cliques: grupos de personas que se conocen todas entre sí, cada uno unido al siguiente por una sola arista. El siguiente programa construye 30 grupos de cinco y puntúa dos particiones.
from modularity import modularity
from louvain import louvain

def ring_of_cliques(n, size):
    """n grupos completos de `size` personas, cada uno unido al siguiente por una sola arista."""
    adj = {v: set() for v in range(n * size)}
    for c in range(n):
        people = range(c * size, (c + 1) * size)
        for a in people:
            adj[a] |= set(people) - {a}
        a, b = c * size, ((c + 1) % n) * size + 1
        adj[a].add(b)
        adj[b].add(a)
    return adj

if __name__ == '__main__':
    n, size = 30, 5
    adj = ring_of_cliques(n, size)
    cliques = [set(range(c * size, (c + 1) * size)) for c in range(n)]
    pairs = [cliques[i] | cliques[i + 1] for i in range(0, n, 2)]
    print('one group per clique:   Q =', round(modularity(adj, cliques), 4))
    print('cliques merged in pairs: Q =', round(modularity(adj, pairs), 4))
    found = louvain(adj)
    whole = all(any(g == set().union(*[c for c in cliques if c <= g]) for _ in [0]) for g in found)
    print('Louvain:', len(found), 'groups, Q =', round(modularity(adj, found), 4),
          ', every group a union of whole cliques:', whole)
# one group per clique:   Q = 0.8758
# cliques merged in pairs: Q = 0.8879
# Louvain: 15 groups, Q = 0.8879 , every group a union of whole cliques: True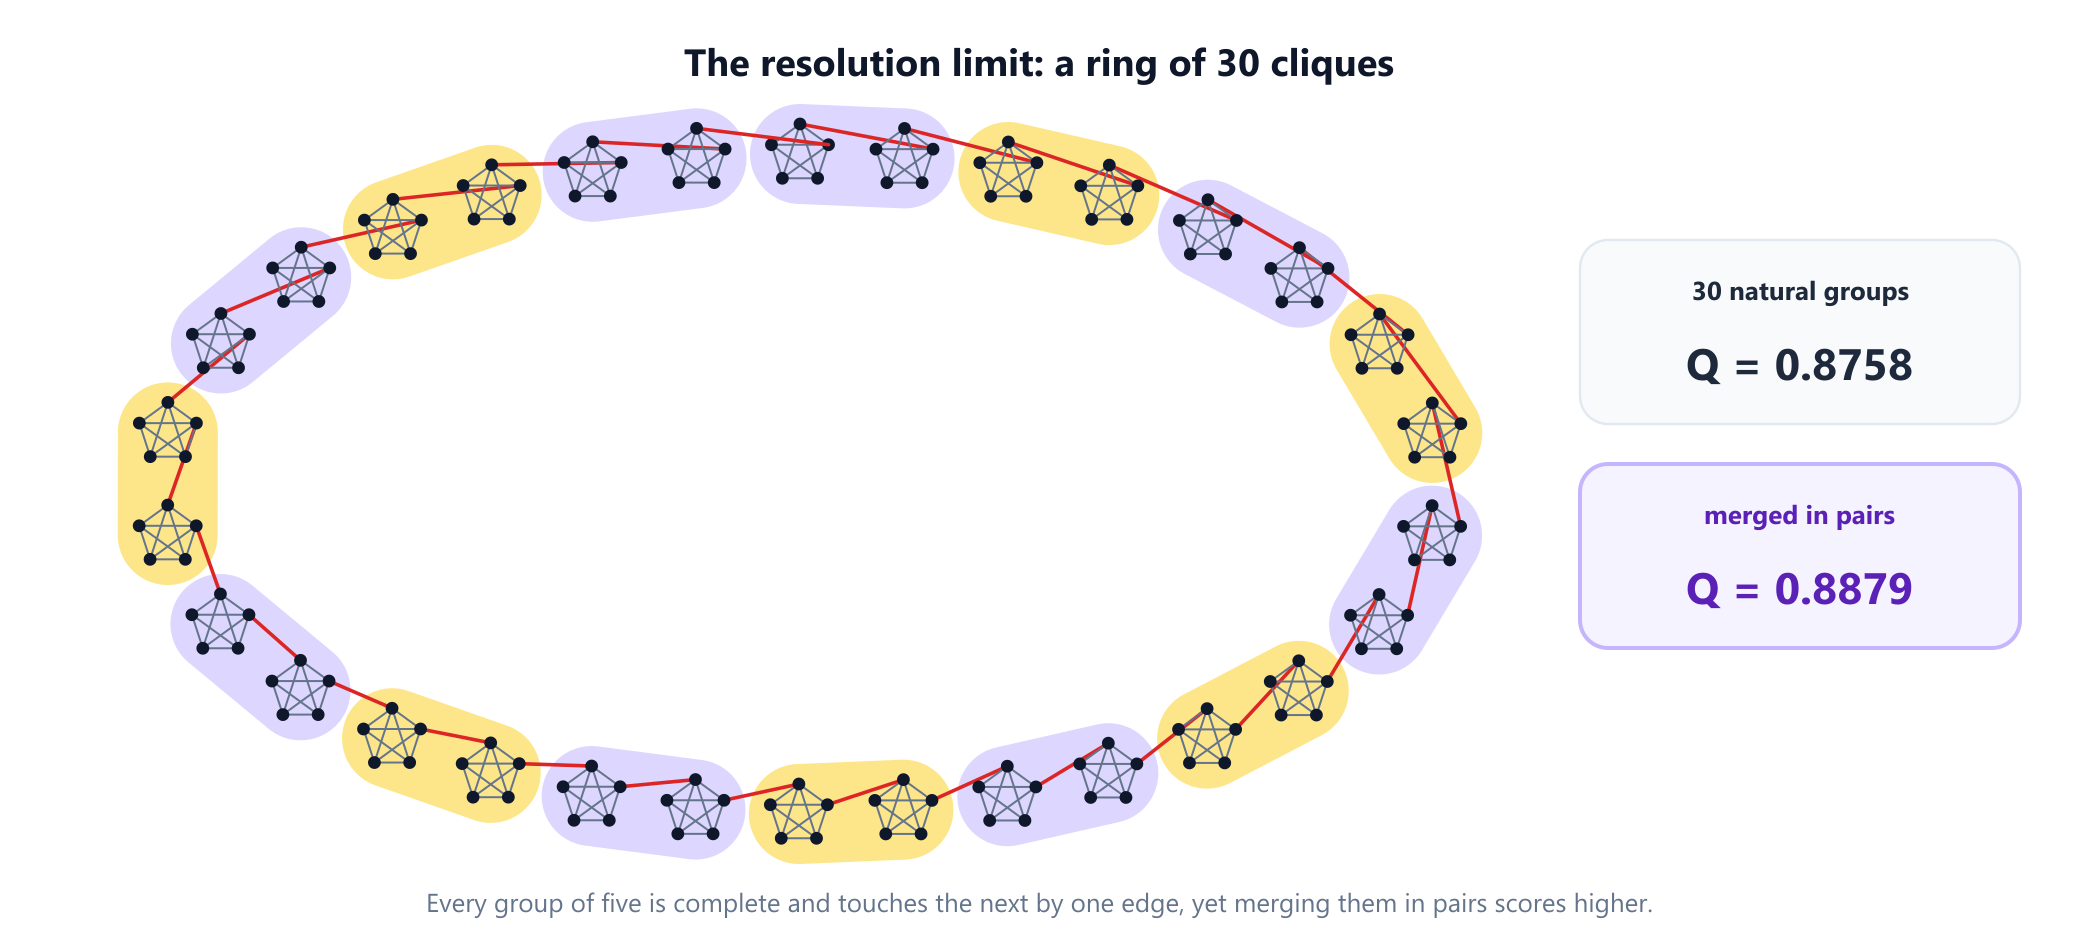
Mantener separados los 30 grupos da 0,8758. Fusionarlos por parejas da 0,8879, así que ni siquiera un maximizador perfecto de la modularidad devolvería nunca los 30 grupos naturales, y Louvain los fusiona por parejas: devuelve 15 grupos. El parámetro de resolución γ de Jörg Reichardt y Stefan Bornholdt multiplica el término de aristas esperadas; los valores mayores que 1 favorecen grupos más pequeños y los menores que 1, grupos más grandes. Desplaza el límite en lugar de eliminarlo, así que conviene comparar el tamaño de los grupos que encuentras con lo que sabes de la red.
8. Una prueba real: el club de kárate de Zachary
En los años setenta, el antropólogo Wayne Zachary registró las amistades entre 34 miembros de un club universitario de kárate mientras una disputa entre el instructor y el administrador del club lo partía en dos. Su artículo de 1977 enumeraba 78 amistades, y como se conoce la partición real, la red se convirtió en la primera prueba estándar de la detección de comunidades. El siguiente programa ejecuta los tres métodos y los compara con el bando al que se unió cada miembro, usando las etiquetas que se distribuyen con la biblioteca NetworkX. Estas registran el club al que se unió cada miembro tras la escisión. Los datos de facciones de Zachary sitúan al miembro 9 en el bando del administrador, aunque se unió al club del instructor, así que los estudios que puntúan frente a las facciones, como hicieron Girvan y Newman, cuentan solo al miembro 3 como mal colocado.
from collections import Counter
from modularity import graph, modularity
from girvan_newman import girvan_newman
from louvain import louvain
from lpa import label_propagation

# Club de kárate de Zachary (1977): 34 miembros, 78 amistades y el bando que tomó cada miembro
# cuando el club se partió (H = el club del instructor, O = el del administrador), miembros 1 a 34.
CLUB = ('1-2 1-3 1-4 1-5 1-6 1-7 1-8 1-9 1-11 1-12 1-13 1-14 1-18 1-20 1-22 1-32 2-3 2-4 2-8 '
        '2-14 2-18 2-20 2-22 2-31 3-4 3-8 3-9 3-10 3-14 3-28 3-29 3-33 4-8 4-13 4-14 5-7 5-11 '
        '6-7 6-11 6-17 7-17 9-31 9-33 9-34 10-34 14-34 15-33 15-34 16-33 16-34 19-33 19-34 '
        '20-34 21-33 21-34 23-33 23-34 24-26 24-28 24-30 24-33 24-34 25-26 25-28 25-32 26-32 '
        '27-30 27-34 28-34 29-32 29-34 30-33 30-34 31-33 31-34 32-33 32-34 33-34').split()
SIDE = dict(zip([str(i) for i in range(1, 35)], 'HHHHHHHHHOHHHHOOHHOHOHOOOOOOOOOOOO'))

def wrong(groups):
    """Miembros colocados en un grupo cuya mayoría tomó el otro bando."""
    bad = []
    for g in groups:
        majority = Counter(SIDE[v] for v in g).most_common(1)[0][0]
        bad += sorted((v for v in g if SIDE[v] != majority), key=int)
    return bad

if __name__ == '__main__':
    adj = graph(CLUB)
    best, splits = girvan_newman(adj)
    print('Girvan-Newman, first split:', [len(g) for g in splits[2]], 'misplaced:', wrong(splits[2]))
    print('Girvan-Newman, best Q:', len(best), 'groups, Q =', round(modularity(adj, best), 4))
    groups = louvain(adj)
    print('Louvain:', len(groups), 'groups, Q =', round(modularity(adj, groups), 4),
          'sizes', sorted(len(g) for g in groups))
    runs = Counter(len(label_propagation(adj, s)) for s in range(1000))
    print('label propagation, groups found in 1000 runs:', dict(sorted(runs.items())))
# Girvan-Newman, first split: [15, 19] misplaced: ['3', '9']
# Girvan-Newman, best Q: 5 groups, Q = 0.4013
# Louvain: 4 groups, Q = 0.4188 sizes [5, 6, 11, 12]
# label propagation, groups found in 1000 runs: {1: 6, 2: 218, 3: 369, 4: 295, 5: 104, 6: 8}
La primera partición que hace Girvan-Newman divide el club en 15 y 19 miembros y coloca mal a dos personas, los miembros 3 y 9; ambos tienen amigos en los dos bandos. Su mejor modularidad llega más tarde, con cinco grupos y Q = 0,4013. Louvain encuentra cuatro grupos con Q = 0,4188, muy cerca de 0,4198, el máximo demostrado para esta red, y cada uno de sus cuatro grupos queda en un solo lado de la partición real salvo los miembros 9 y 10. La propagación de etiquetas vuelve a variar: en 1.000 ejecuciones encontró entre uno y seis grupos, tres con mayor frecuencia.
La lección es que la respuesta "verdadera" de una red real depende de la pregunta. El club se partió en dos, pero la modularidad prefiere cuatro grupos, porque cada una de las dos facciones contiene círculos más estrechos. Ninguna respuesta está mal; responden a preguntas distintas.
9. Cuando los grupos se difuminan: un banco de pruebas medido
Para medir la precisión hacen falta redes con grupos conocidos. El banco de pruebas de Girvan y Newman de 2002 tiene 128 vértices en cuatro grupos de 32. Cada vértice tiene unas 16 aristas, de las que en promedio z_out van a otros grupos. Cuanto mayor es z_out, más difícil es ver los grupos. La precisión se mide con la información mutua normalizada (NMI), una puntuación de 0 a 1 que vale 1 solo cuando los grupos encontrados coinciden exactamente con los plantados, tal como propusieron para este fin Leon Danon y sus colegas en 2005.
import math, random
from louvain import louvain
from lpa import label_propagation

def planted(rnd, z_out, groups=4, size=32, degree=16):
    """Prueba de Girvan y Newman: 4 grupos de 32, cada vértice con unas z_out aristas que salen de su grupo."""
    n = groups * size
    adj = {v: set() for v in range(n)}
    p_in, p_out = (degree - z_out) / (size - 1), z_out / (n - size)
    for a in range(n):
        for b in range(a + 1, n):
            if rnd.random() < (p_in if a // size == b // size else p_out):
                adj[a].add(b)
                adj[b].add(a)
    return adj

def nmi(found, size=32):
    """Información mutua normalizada entre los grupos encontrados y los plantados (1 = idénticos)."""
    n = sum(len(g) for g in found)
    planted = {}
    for g in found:
        for v in g:
            planted.setdefault(v // size, []).append(v)
    h = lambda parts: -sum(len(p) / n * math.log(len(p) / n) for p in parts)
    mutual = 0.0
    for g in found:
        for p in planted.values():
            k = len(g & set(p))
            if k:
                mutual += k / n * math.log(k * n / (len(g) * len(p)))
    hf, hp = h(found), h(list(planted.values()))
    return 1.0 if hf + hp == 0 else 2 * mutual / (hf + hp)

if __name__ == '__main__':
    rnd = random.Random(7)
    print('edges out   Louvain   label propagation   (average NMI over 10 networks)')
    for z_out in range(1, 10):
        a = b = 0.0
        for _ in range(10):
            adj = planted(rnd, z_out)
            a += nmi(louvain(adj)) / 10
            b += nmi(label_propagation(adj, rnd.randrange(10**6))) / 10
        print(f'{z_out:9} {a:9.2f} {b:12.2f}')
# edges out   Louvain   label propagation   (average NMI over 10 networks)
#         1      1.00         1.00
#         2      1.00         1.00
#         3      1.00         1.00
#         4      1.00         0.90
#         5      0.99         0.85
#         6      0.97         0.35
#         7      0.80         0.10
#         8      0.50         0.02
#         9      0.20         0.00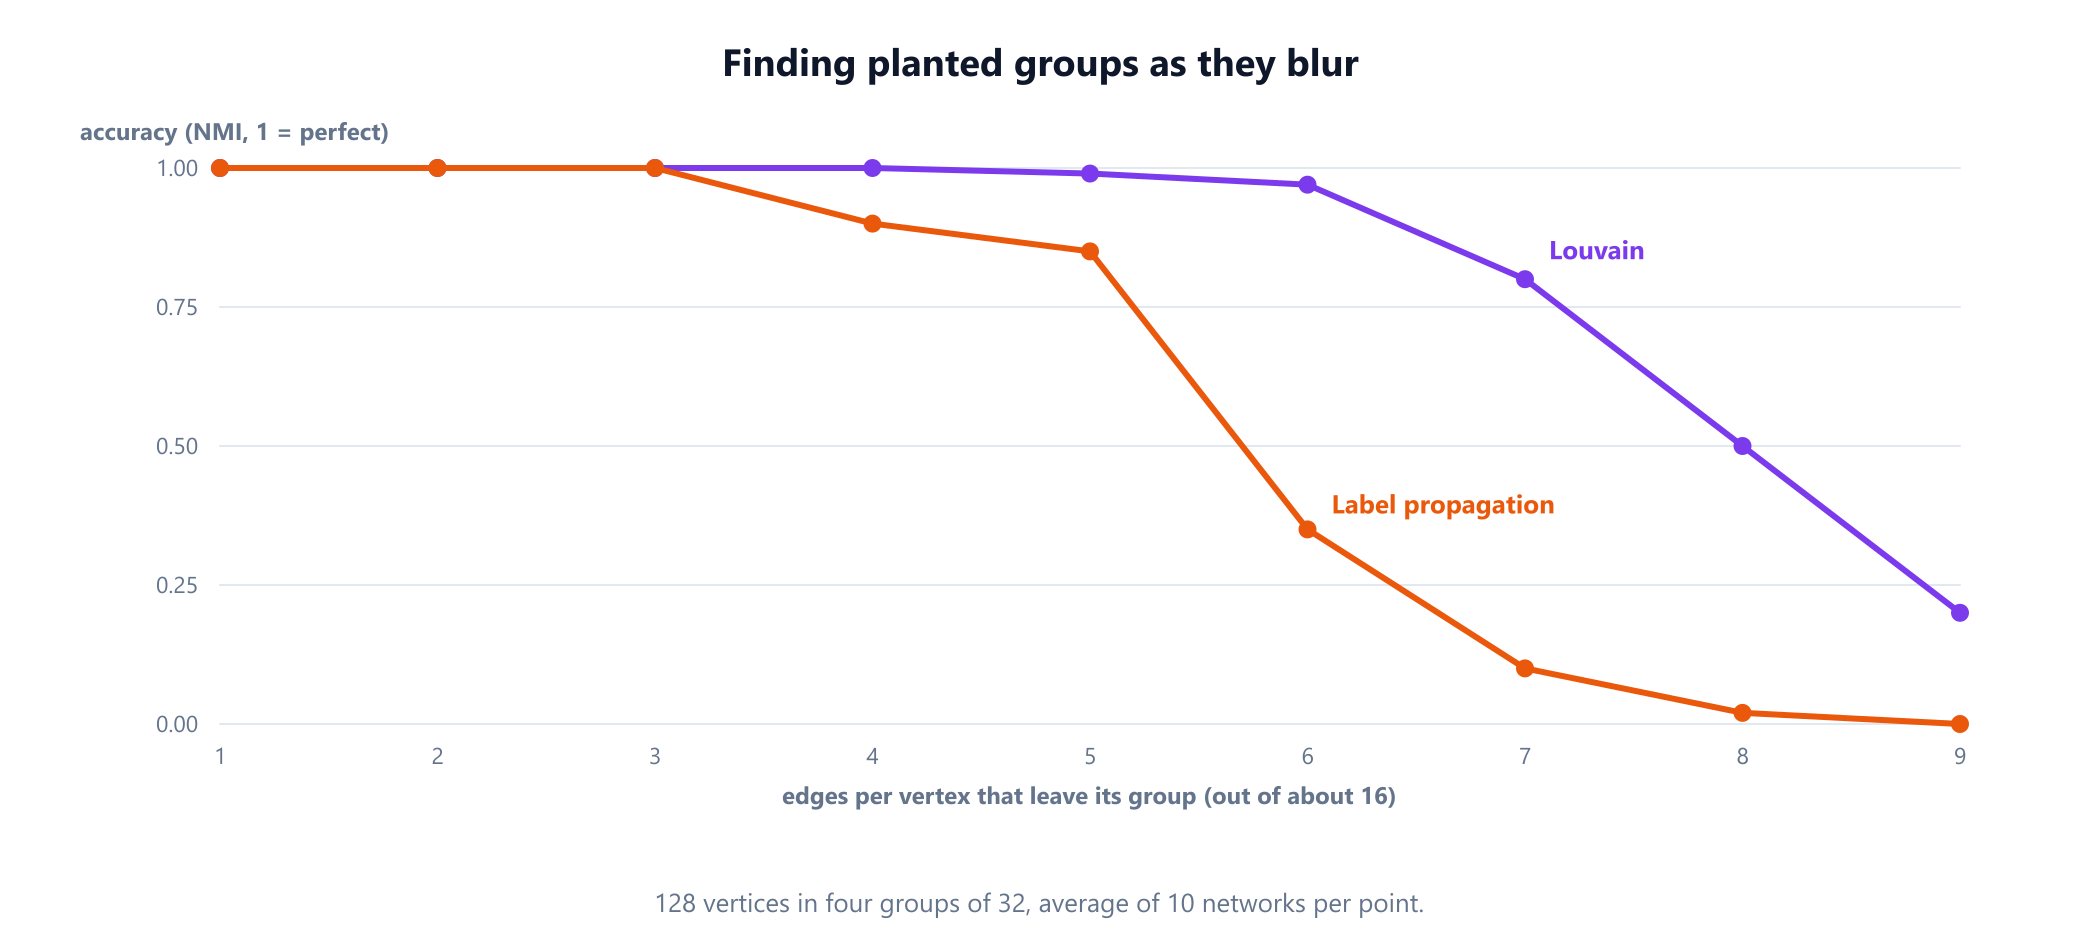
Ambos métodos son perfectos mientras los grupos están claros. A partir de 4 aristas salientes de 16, la propagación de etiquetas empieza a fallar, y en 6 su puntuación se ha desplomado a 0,35 mientras Louvain aún obtiene 0,97. En 8, la mitad de las aristas de cada vértice salen de su grupo, aunque el interior de un grupo sigue siendo 3,1 veces más denso que el espacio entre grupos, e incluso Louvain baja a 0,50. Con z_out = 12 los grupos no serían más densos por dentro que por fuera. De hecho, se vuelven imposibles de recuperar antes: Aurelien Decelle y sus colegas demostraron en 2011 que, en redes grandes construidas así, ningún método puede hacerlo mejor que el azar en cuanto z_out supera aproximadamente 9.
10. Dónde se usa la detección de comunidades
- Redes sociales. Encontrar círculos de amigos, compañeros de trabajo o grupos de interés, y a las personas que hacen de puente entre ellos, a menudo junto con las medidas de centralidad.
- Biología. Los grupos en las redes de interacción de proteínas suelen corresponder a complejos o vías biológicas; la guía de teoría de grafos en biología trata estas redes.
- Recomendación y marketing. Los usuarios que forman una comunidad tienden a compartir intereses, lo que ayuda a sugerir contenido y a segmentar audiencias.
- Fraude y seguridad. Las cuentas que hacen transacciones sobre todo entre sí pueden formar un grupo muy unido que destaca frente al comportamiento normal.
- Software. Los grupos de un grafo de dependencias sugieren límites naturales entre módulos, y las aristas entre grupos muestran los acoplamientos que vale la pena revisar.
11. Una breve historia
Dividir grafos en partes es algo antiguo: la heurística de Brian Kernighan y Shen Lin de 1970 dividía un grafo en partes de tamaños dados cortando el menor número posible de aristas, un problema que surgió al colocar circuitos electrónicos en placas de circuito. La detección de comunidades en el sentido actual, en la que el número y el tamaño de los grupos no se dan de antemano, despegó con el artículo de Girvan y Newman de 2002, que además popularizó el club de kárate de Zachary como prueba. Newman y Girvan definieron la modularidad en 2004, y ese mismo año Aaron Clauset, Newman y Cristopher Moore publicaron un método voraz rápido para maximizarla. La propagación de etiquetas llegó en 2007, el mismo año que el límite de resolución, y el método de Louvain en 2008. La revisión de Santo Fortunato de 2010 es una visión general de referencia, y el algoritmo de Leiden de 2019 corrigió los grupos desconectados de Louvain.
12. Errores comunes
| Error | Por qué está mal | Solución |
|---|---|---|
| Fiarse de una sola ejecución de la propagación de etiquetas | En el ejemplo, 1.000 ejecuciones dieron 49 respuestas distintas | Ejecútala varias veces, o usa Louvain o Leiden |
Tomar el Q más alto por la verdad | El límite de resolución fusiona grupos pequeños | Comprueba el tamaño de los grupos; prueba un parámetro de resolución |
Comparar Q entre redes distintas | Sus valores típicos dependen del tamaño y la densidad | Compara particiones de la misma red |
| Considerar un fallo que todos queden en un solo grupo | Puede que una red no tenga ninguna estructura de comunidades | Compara con una red aleatoria con los mismos grados |
| Ejecutar Girvan-Newman sobre un grafo grande | Tarda aproximadamente O(m²n) de tiempo | Usa Louvain o Leiden |
| Ignorar los grupos desconectados de Louvain | Un grupo puede romperse en pasadas posteriores | Usa Leiden, o divide los grupos en partes conexas |
| Esperar que cada vértice pertenezca a un solo grupo | Las personas pertenecen a la vez a círculos de familia, trabajo y deporte | Usa un método con solapamiento cuando eso importe |
13. Glosario
| Término | Significado |
|---|---|
| Comunidad | Un grupo de vértices con muchas aristas dentro y pocas hacia el resto |
| Partición | Una división de los vértices en grupos, con cada vértice en exactamente uno |
| Modularidad | La fracción de aristas dentro de los grupos menos la fracción esperada por azar |
| Intermediación de aristas | Cuántos caminos más cortos entre pares de vértices usan una arista |
| Girvan-Newman | Borrar repetidamente la arista con la mayor intermediación |
| Método de Louvain | Movimientos locales que suben la modularidad y luego fusión de grupos, repetidos |
| Algoritmo de Leiden | Un refinamiento de Louvain que garantiza grupos conexos |
| Propagación de etiquetas | Cada vértice adopta repetidamente la etiqueta más común entre sus vecinos |
| Límite de resolución | La tendencia de la modularidad a fusionar grupos pequeños en redes grandes |
| Parámetro de resolución | Un peso γ sobre el término de aristas esperadas que desplaza el tamaño de grupo preferido |
| Clique | Un grupo en el que cada dos vértices están unidos |
| NMI | Información mutua normalizada, 1 cuando dos particiones son idénticas |
14. Preguntas frecuentes
¿Qué es la detección de comunidades en grafos?
La detección de comunidades consiste en dividir los vértices de una red en grupos con muchas aristas dentro y pocas aristas entre ellos. Es la versión para grafos del agrupamiento (clustering). Usos típicos son encontrar círculos de amigos en redes sociales, equipos en datos de comunicación, complejos en redes de proteínas y temas relacionados en grafos de citas o de la web.
¿Qué es la modularidad?
La modularidad, que suele escribirse Q, puntúa una partición de una red en grupos. Es la fracción de aristas que caen dentro de los grupos menos la fracción que cabría esperar si los mismos vértices conservaran sus grados pero las aristas se colocaran al azar. Los valores cercanos a 0 significan que no es mejor que el azar; los grupos bien separados suelen obtener entre 0,3 y 0,7 aproximadamente.
¿Qué es el algoritmo de Louvain?
El método de Louvain, publicado por Blondel y sus colegas en 2008, maximiza la modularidad en dos fases que se repiten. Primero, cada vértice se mueve al grupo vecino que más aumenta la modularidad, hasta que ningún movimiento ayuda. Después, cada grupo se fusiona en un único vértice y el proceso se repite sobre la red más pequeña. Es lo bastante rápido para redes con millones de aristas.
¿Cuál es la diferencia entre Louvain y Girvan-Newman?
Girvan-Newman trabaja de arriba abajo: borra repetidamente la arista con la mayor intermediación, la que con más probabilidad va entre grupos, y se queda con la partición de mejor modularidad. Louvain trabaja de abajo arriba, fusionando vértices en grupos mientras la modularidad sube. Girvan-Newman tarda un tiempo de aproximadamente O(m al cuadrado por n), así que se limita a redes pequeñas; Louvain escala a redes muy grandes.
¿Es fiable la propagación de etiquetas?
La propagación de etiquetas es muy rápida, pero su resultado depende de elecciones aleatorias. En el ejemplo de 15 personas de esta guía, 1.000 ejecuciones produjeron 49 respuestas distintas y solo encontraron los tres grupos reales 387 veces. Ejecútala varias veces y compara, o usa un método de modularidad cuando importe que los resultados sean estables.
¿Qué es el límite de resolución de la modularidad?
Fortunato y Barthélemy demostraron en 2007 que maximizar la modularidad puede fusionar grupos pequeños y claramente separados cuando la red es grande. En un anillo de 30 grupos de cinco personas, fusionar los grupos vecinos por parejas puntúa más que mantenerlos separados. Un parámetro de resolución, o los métodos que no dependen de la modularidad, pueden resolverlo.
15. Referencias
Los algoritmos, resultados y atribuciones anteriores proceden de estas fuentes, listadas en orden cronológico.
- Kernighan, B. W. y Lin, S. (1970). "An Efficient Heuristic Procedure for Partitioning Graphs." Bell System Technical Journal 49(2), 291 a 307.
- Zachary, W. W. (1977). "An Information Flow Model for Conflict and Fission in Small Groups." Journal of Anthropological Research 33(4), 452 a 473.
- Girvan, M. y Newman, M. E. J. (2002). "Community Structure in Social and Biological Networks." Proceedings of the National Academy of Sciences 99(12), 7821 a 7826.
- Newman, M. E. J. y Girvan, M. (2004). "Finding and Evaluating Community Structure in Networks." Physical Review E 69, 026113.
- Clauset, A., Newman, M. E. J. y Moore, C. (2004). "Finding Community Structure in Very Large Networks." Physical Review E 70, 066111.
- Danon, L., Díaz-Guilera, A., Duch, J. y Arenas, A. (2005). "Comparing Community Structure Identification." Journal of Statistical Mechanics: Theory and Experiment, P09008.
- Reichardt, J. y Bornholdt, S. (2006). "Statistical Mechanics of Community Detection." Physical Review E 74, 016110.
- Fortunato, S. y Barthélemy, M. (2007). "Resolution Limit in Community Detection." Proceedings of the National Academy of Sciences 104(1), 36 a 41.
- Raghavan, U. N., Albert, R. y Kumara, S. (2007). "Near Linear Time Algorithm to Detect Community Structures in Large-Scale Networks." Physical Review E 76, 036106.
- Brandes, U., Delling, D., Gaertler, M., Görke, R., Hoefer, M., Nikoloski, Z. y Wagner, D. (2008). "On Modularity Clustering." IEEE Transactions on Knowledge and Data Engineering 20(2), 172 a 188.
- Agarwal, G. y Kempe, D. (2008). "Modularity-Maximizing Graph Communities via Mathematical Programming." European Physical Journal B 66(3), 409 a 418.
- Blondel, V. D., Guillaume, J.-L., Lambiotte, R. y Lefebvre, E. (2008). "Fast Unfolding of Communities in Large Networks." Journal of Statistical Mechanics: Theory and Experiment, P10008.
- Fortunato, S. (2010). "Community Detection in Graphs." Physics Reports 486(3 a 5), 75 a 174.
- Decelle, A., Krzakala, F., Moore, C. y Zdeborová, L. (2011). "Asymptotic Analysis of the Stochastic Block Model for Modular Networks and Its Algorithmic Applications." Physical Review E 84(6), 066106.
- Traag, V. A., Waltman, L. y van Eck, N. J. (2019). "From Louvain to Leiden: Guaranteeing Well-Connected Communities." Scientific Reports 9, 5233.
Mira la búsqueda que hay detrás de la intermediación de aristas
Girvan-Newman clasifica las aristas con una búsqueda en anchura desde cada vértice. Dibuja en el visualizador dos grupos unidos por una sola arista y lanza la búsqueda desde ambos lados para ver por qué esa arista lleva todas las rutas entre ellos.
Abrir el visualizador