
Tabla de Contenidos
- 1. Qué evalúa realmente una pregunta de DFS
- 2. La plantilla, recursiva e iterativa
- 3. Detección de ciclos en un grafo dirigido
- 4. Detección de ciclos en un grafo no dirigido
- 5. Ordenación topológica por postorden
- 6. Clone graph
- 7. Todos los caminos: DFS como backtracking
- 8. Word search en una cuadrícula
- 9. Componentes fuertemente conexas
- 10. Puentes y puntos de articulación
- 11. Complejidad, y la pregunta de la profundidad de recursión
- 12. Errores que suspenden la entrevista
- 13. Preguntas frecuentes
- 14. Referencias
1. Qué evalúa realmente una pregunta de DFS
Las preguntas de DFS no tratan del recorrido. Cualquier candidato sabe recorrer un grafo. Lo que se comprueba es si conoces la contabilidad que DFS ofrece y BFS no: el orden en que terminan los vértices, si un vértice sigue en la pila y hasta dónde puede volver un subárbol.
Ese es todo el tema. La detección de ciclos, la ordenación topológica, las componentes fuertemente conexas, los puentes y los puntos de articulación son todos un recorrido más un array extra. Si una pregunta trata de orden, dependencias, ciclos o de qué se rompe si se quita esto, es una pregunta de DFS. Si pide el mínimo de algo, es una pregunta de BFS.
Las ocho de abajo son las que se repiten, cada una con el problema, la solución, el seguimiento y el error que te cuesta la oferta. Cada ejemplo resuelto se ejecutó con un script.
2. La plantilla, recursiva e iterativa
El DFS recursivo son cuatro líneas, y deberías poder escribirlo sin pensar.
def dfs(u, adj, seen):
    seen.add(u)
    for v in adj[u]:
        if v not in seen:
            dfs(v, adj, seen)
La versión iterativa es donde los candidatos tropiezan, porque la traducción obvia es sutilmente distinta de la recursiva.
def dfs_iter(src, adj):
    seen, stack = set(), [src]
    while stack:
        u = stack.pop()
        if u in seen:            # un vértice puede apilarse varias veces
            continue
        seen.add(u)
        for v in adj[u]:
            if v not in seen:
                stack.append(v)
Dos cosas en las que fijarse, y que conviene decir en voz alta.
- Comprueba
seenal desapilar, no solo al apilar. A diferencia de BFS, el mismo vértice puede estar en la pila más de una vez, apilado por varios vecinos antes de que se expanda ninguno. Sin la comprobación al desapilar obtienes visitas duplicadas. - El orden de visita difiere del de la versión recursiva. Los vecinos apilados en orden ascendente se desapilan en orden descendente, así que el DFS iterativo explora primero el último vecino. Apílalos al revés para que coincida. Una trampa muy popular.
Lo más difícil: la versión iterativa simple no tiene postorden. Sabe cuándo se descubre un vértice, pero nunca cuándo termina su subárbol, y el tiempo de finalización es exactamente lo que necesitan las secciones 5, 9 y 10. Para recuperarlo, apila cada vértice dos veces o lleva un índice de hijo en el marco. Merece la pena decir que aquí la recursión no es solo cosmética.
La técnica es antigua: es la regla de Trémaux para recorrer un laberinto, recogida por Lucas en 1882.
3. Detección de ciclos en un grafo dirigido
La pregunta. ¿Contiene un grafo dirigido un ciclo? Se formula como detección de interbloqueos, bucles de dependencias de compilación o «¿se puede completar este plan de cursos?».
La respuesta incorrecta es un único conjunto visited: llegar a un vértice ya visto no significa un ciclo; puede ser una segunda ruta hacia una parte ya terminada del grafo. La respuesta correcta usa tres colores: blanco sin descubrir, gris descubierto pero todavía en la pila de recursión, negro terminado.
WHITE, GREY, BLACK = 0, 1, 2

def has_cycle(adj, n):
    colour = [WHITE] * n

    def visit(u):
        colour[u] = GREY
        for v in adj[u]:
            if colour[v] == GREY:      # arista de retroceso: v es un ancestro
                return True
            if colour[v] == WHITE and visit(v):
                return True
        colour[u] = BLACK              # solo ahora termina u
        return False

    return any(colour[s] == WHITE and visit(s) for s in range(n))
Una arista hacia un vértice gris es una arista de retroceso, y un grafo dirigido tiene un ciclo si y solo si un DFS encuentra una arista de retroceso. Una arista hacia un vértice negro es inofensiva. Esa equivalencia, y la clasificación de las aristas en cuatro tipos a la que pertenece, es el tratamiento estándar de Cormen, Leiserson, Rivest y Stein.
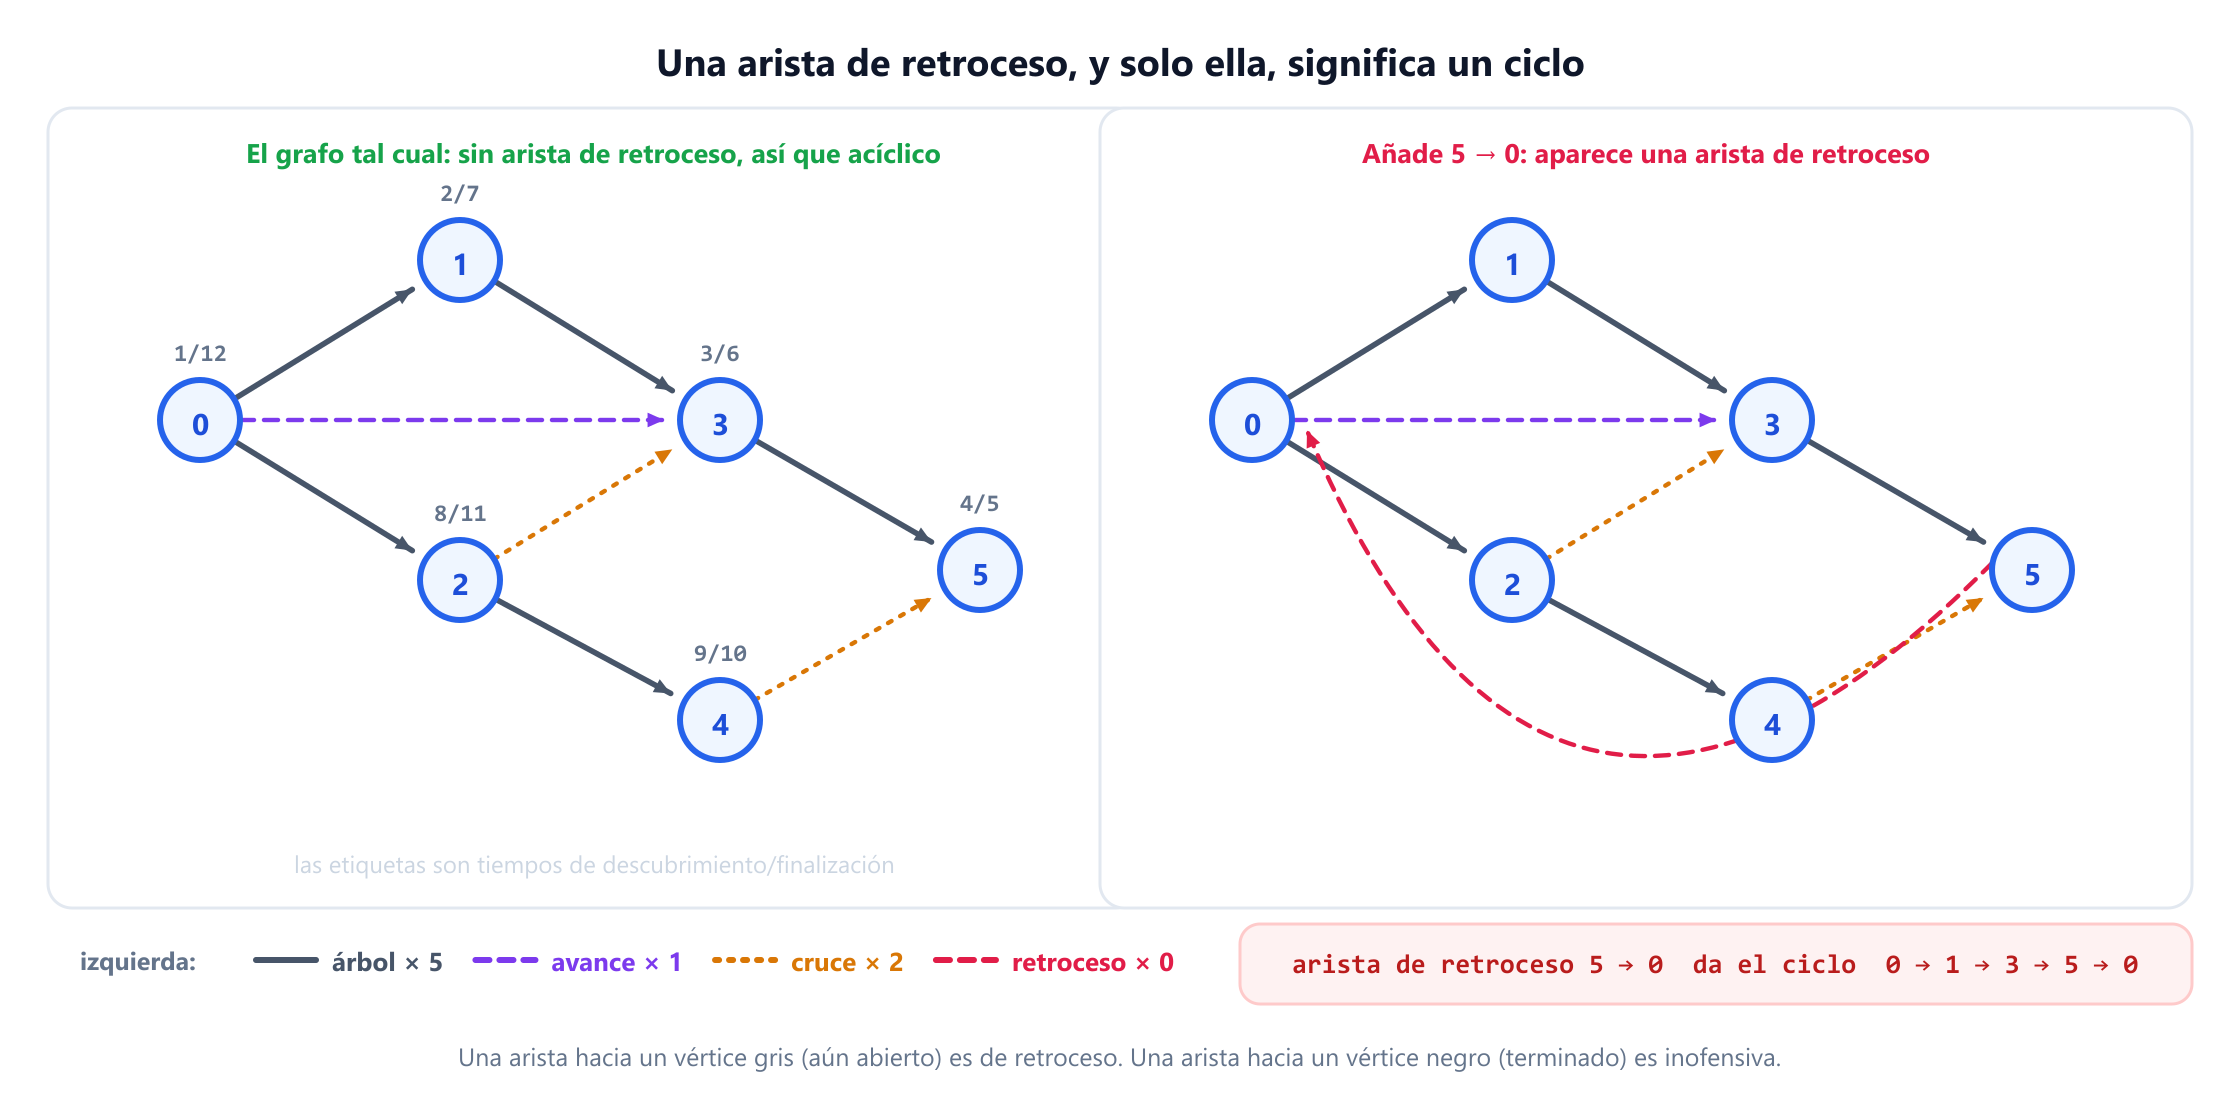
En el grafo de ejemplo, un DFS desde el vértice 0 clasifica sus 8 arcos como 5 aristas de árbol, 1 de avance y 2 de cruce, sin ninguna de retroceso, así que es acíclico. Añade el arco 5 → 0 y aparece exactamente una arista de retroceso.
El seguimiento: imprime el ciclo, no solo un booleano. La arista de retroceso te lo da: si es u → v, sigue los punteros al padre desde u hasta v y cierra el bucle. Aquí la arista de retroceso es 5 → 0 y el ciclo es 0 → 1 → 3 → 5 → 0. Un array de padres cuesta una línea y convierte un sí o no en el diagnóstico que una herramienta de compilación real tiene que dar.
La trampa. Poner colour[u] = BLACK en el sitio equivocado, o no ponerlo. Si dejas grises los vértices terminados, cada segunda ruta hacia ellos parece un ciclo, y das falsos positivos en cualquier DAG con un rombo, como el grafo de ejemplo.
4. Detección de ciclos en un grafo no dirigido
La pregunta. El mismo problema, grafo no dirigido. Parece la pregunta anterior y no lo es.
Tres colores aquí están mal. Cada arista no dirigida se puede recorrer en ambos sentidos, así que al pasar de u a v, la arista de vuelta a u parece una arista hacia un vértice gris, y cada arista informa de un ciclo. En su lugar, ignora la arista por la que llegaste.
def has_cycle_undirected(adj, n):
    seen = [False] * n

    def visit(u, parent):
        seen[u] = True
        for v in adj[u]:
            if not seen[v]:
                if visit(v, u): return True
            elif v != parent:          # un vecino ya visto que no es el padre
                return True
        return False

    return any(not seen[s] and visit(s, -1) for s in range(n))
Sin la guarda v != parent, un grafo formado por la única arista 0-1 informa de un ciclo. Con ella, un árbol de 4 vértices no informa de ninguno, correctamente, y un triángulo de uno, también correctamente. Esos son los tres casos de prueba que hay que comprobar en la pizarra, y comprobarlos sin que te lo pidan causa muy buena impresión.
El seguimiento: ¿aristas paralelas? Entonces v != parent no basta: dos aristas distintas entre u y v forman realmente un ciclo de longitud 2, y la comprobación del padre se traga la segunda. Guarda la arista por la que entraste, no el vértice. Consulta grafos simples vs multigrafos.
La trampa. Un grafo no conexo. El bucle exterior sobre cada vértice no visitado no es opcional, y una solución que solo empieza en el vértice 0 pasa todos los casos de prueba conexos.
5. Ordenación topológica por postorden
La pregunta. Ordena los vértices de un DAG de modo que cada arco apunte hacia delante. La respuesta con BFS es el pelado por grado de entrada de Kahn; la respuesta con DFS es más corta y es la que busca una pregunta de DFS.
Ejecuta DFS, añade cada vértice cuando termina e invierte la lista. Ese es todo el algoritmo, y la razón cabe en una frase: un vértice termina solo después de todo lo alcanzable desde él, así que termina después que sus sucesores, y al invertir queda delante de ellos.
def topological_sort(adj, n):
    colour = [0] * n           # 0 blanco, 1 gris, 2 negro
    order = []

    def visit(u):
        colour[u] = 1
        for v in adj[u]:
            if colour[v] == 1: raise ValueError("cycle")
            if colour[v] == 0: visit(v)
        colour[u] = 2
        order.append(u)        # postorden: DESPUÉS de los hijos

    for s in range(n):
        if colour[s] == 0: visit(s)
    return order[::-1]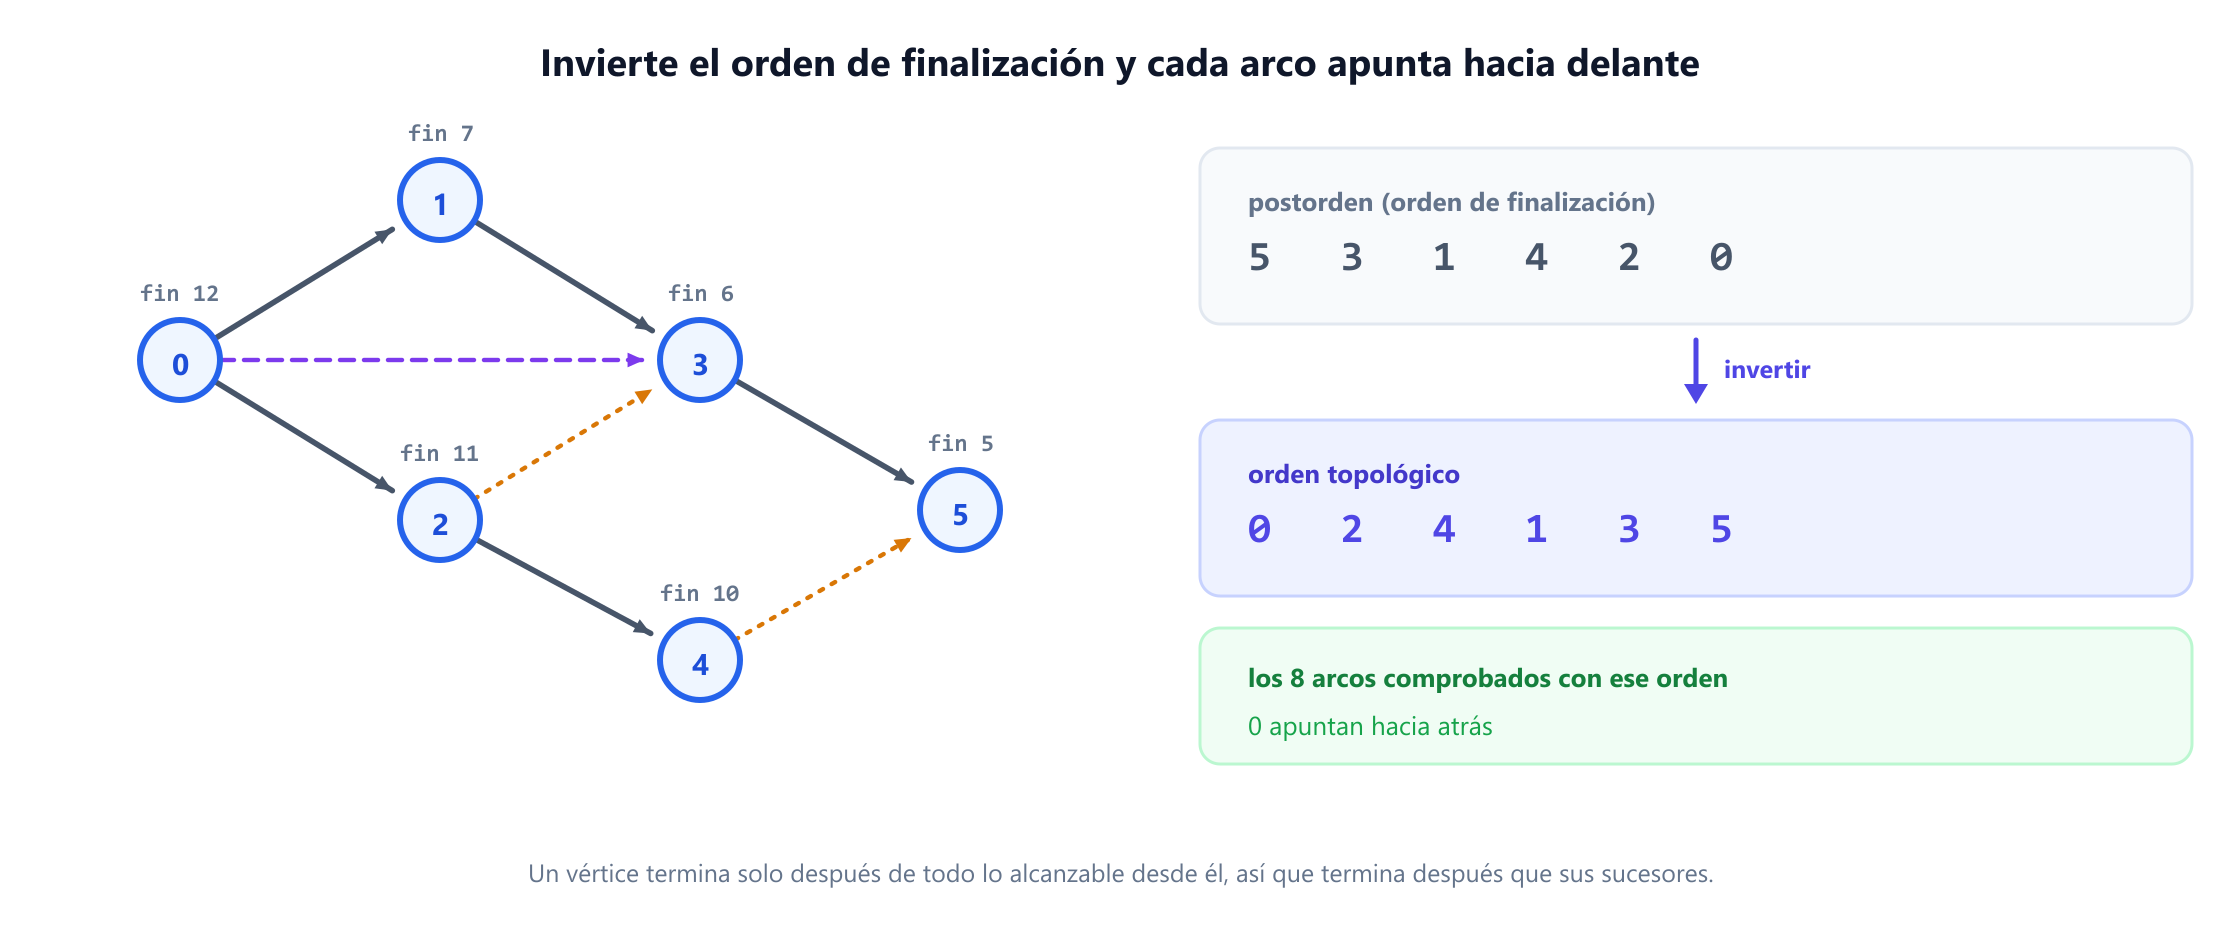
En el DAG de ejemplo, el postorden es 5, 3, 1, 4, 2, 0; al invertirlo se obtiene 0, 2, 4, 1, 3, 5, y los ocho arcos apuntan hacia delante. Di que es un orden topológico, no el único: un DAG suele tener muchos.
El seguimiento: ¿cómo detectas aquí un ciclo? Con la comprobación del gris de la sección 3. Ese es su atractivo: un solo recorrido ordena el DAG y a la vez rechaza lo que no es un DAG, mientras que Kahn necesita un conteo aparte al final. La formulación con DFS es de Tarjan.
La trampa. Añadir en preorden, cuando se descubre el vértice en lugar de cuando termina. El resultado parece plausible, está mal y en grafos pequeños a menudo coincide con un orden válido, así que sobrevive a pruebas superficiales.
6. Clone graph
La pregunta. Dada una referencia a un nodo de un grafo no dirigido conexo, devuelve una copia profunda.
La única dificultad son los ciclos: una copia recursiva ingenua entra en un bucle infinito. La solución es un mapa del nodo original a su copia, que también sirve de conjunto de visitados, y hay que escribirlo antes de la recursión.
def clone_graph(node, made=None):
    if node is None: return None
    if made is None: made = {}
    if node in made:
        return made[node]
    copy = Node(node.val)
    made[node] = copy              # registrar ANTES de la recursión
    for nb in node.neighbors:
        copy.neighbors.append(clone_graph(nb, made))
    return copy
Registrar la copia antes de las llamadas recursivas es toda la pregunta. Si lo haces después, un ciclo te devuelve al punto de partida antes de que exista la entrada, y la recursión sigue hasta que muere la pila. Es la misma forma que memoizar cualquier estructura autorreferencial.
El seguimiento: ¿iterativo o BFS? Ambos funcionan, con un mapa idéntico. Di que lo que lo hace correcto es el mapa, no el orden del recorrido. Es O(V + E) en ambos casos.
7. Todos los caminos: DFS como backtracking
La pregunta. Enumera todos los caminos de un origen a un destino en un DAG. Variantes: todos los caminos de la raíz a una hoja, suma de camino, permutaciones.
Esta es la familia en la que DFS deja de ser un recorrido de grafo y se convierte en backtracking, y la diferencia es una línea: deshaces tu elección al salir.
def all_paths(adj, src, dst):
    out, path = [], []

    def walk(u):
        path.append(u)
        if u == dst:
            out.append(path[:])    # COPIA, no la lista viva
        else:
            for v in adj[u]:
                walk(v)
        path.pop()                 # el paso de backtracking

    walk(src)
    return out
En el DAG de ejemplo hay exactamente 4 caminos de 0 a 5: 0→1→3→5, 0→2→3→5, 0→2→4→5 y 0→3→5.
Dos detalles sostienen la respuesta. Añade una copia, path[:], ya que path se modifica después y la referencia te da una lista de listas vacías idénticas. Y no hay conjunto de visitados: enumeras caminos, no vértices, así que un vértice aparece legítimamente en muchos caminos. El path.pop() mantiene el estado correcto sin él.
El seguimiento: ¿complejidad? No es O(V + E). Un DAG puede tener un número exponencial de caminos, así que listarlos es exponencial en la salida; la respuesta honesta es O(V × 2V). Decir lineal aquí revela que no has pensado en cuál es la salida. Si solo te preguntan cuántos caminos existen, es otro problema: cuéntalos con programación dinámica sobre el orden topológico, en O(V + E).
La trampa. Añadir un conjunto de visitados porque «DFS siempre tiene uno». En un grafo cíclico sí excluyes los vértices que ya están en el camino actual, pero eso es el camino, no un conjunto global, y un conjunto global devuelve en silencio un subconjunto de las respuestas.
8. Word search en una cuadrícula
La pregunta. Dada una cuadrícula de letras y una palabra, decide si la palabra se puede formar moviéndote entre celdas adyacentes en horizontal o vertical, sin usar ninguna celda dos veces.
Esto es backtracking sobre un grafo de cuadrícula implícito, y la cláusula «ninguna celda dos veces» es lo que obliga a deshacer.
def exist(board, word):
    R, C = len(board), len(board[0])

    def walk(r, c, i):
        if i == len(word): return True
        if not (0 <= r < R and 0 <= c < C): return False
        if board[r][c] != word[i]: return False

        board[r][c] = '#'                      # marcar, para que el camino no la reutilice
        found = any(walk(r + dr, c + dc, i + 1)
                    for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)))
        board[r][c] = word[i]                  # DESHACER al salir
        return found

    return any(walk(r, c, 0) for r in range(R) for c in range(C))
La marca debe restaurarse: una celda bloqueada por un intento fallido tiene que estar disponible para otro inicio, y olvidarlo da una función que solo tiene éxito cuando el primer camino probado resulta funcionar. Sobrescribir el tablero en lugar de mantener un conjunto de visitados es un truco legítimo, pero dilo, porque modifica la entrada de quien llama.
El seguimiento: complejidad. O(R × C × 3L) para una palabra de longitud L: cada celda es un posible inicio, y después del primer paso nunca vuelves por donde viniste, así que cada paso posterior tiene como mucho 3 opciones, no 4. Ese 3 es el detalle que indica que lo has pensado.
9. Componentes fuertemente conexas
La pregunta. Divide un grafo dirigido en conjuntos maximales de vértices mutuamente alcanzables. Aparece como «encuentra dependencias circulares» o como preprocesamiento antes de un algoritmo sobre DAG.
Hay dos respuestas con DFS y deberías saber cuál estás escribiendo.
Kosaraju-Sharir hace dos pasadas y es mucho más fácil de acertar bajo presión. Haz un DFS del grafo registrando el orden de finalización y luego un DFS del grafo invertido tomando los vértices en orden de finalización decreciente; cada árbol de la segunda pasada es una componente.
def kosaraju(adj, radj, n):
    seen, order = [False] * n, []
    def pass1(u):
        seen[u] = True
        for v in adj[u]:
            if not seen[v]: pass1(v)
        order.append(u)                  # orden de finalización
    for s in range(n):
        if not seen[s]: pass1(s)

    comp, c = [-1] * n, 0
    def pass2(u):
        comp[u] = c
        for v in radj[u]:
            if comp[v] == -1: pass2(v)
    for u in reversed(order):            # tiempo de finalización decreciente
        if comp[u] == -1:
            pass2(u); c += 1
    return comp, c
En un grafo de dos triángulos, 0→1→2→0 y 3→4→5→3, unidos por el único arco 2→3, esto devuelve exactamente dos componentes, {0,1,2} y {3,4,5}. La alcanzabilidad lo confirma: 0 alcanza a 3 y 3 no alcanza a 0.
El algoritmo de Tarjan lo hace en una sola pasada con una pila y un valor low-link: más rápido en la práctica, mucho más fácil de estropear en una pizarra. Ambos son O(V + E), y ambos tienen un visualizador aquí. El artículo de Tarjan de 1972 dio el método de una pasada; la versión de dos pasadas se atribuye a Kosaraju y la publicó por primera vez Sharir en 1981.
A fondo: la guía de componentes fuertemente conexas sigue ambos algoritmos sobre un mismo grafo y muestra los errores que pasan las pruebas pequeñas.
El seguimiento: ¿por qué funciona el grafo invertido? Invertir cada arco deja las componentes sin cambios, porque la alcanzabilidad mutua es simétrica. El vértice con el mayor tiempo de finalización está en una componente fuente de la condensación, y la inversión convierte una fuente en un sumidero, así que un DFS iniciado ahí no puede salir de ella.
10. Puentes y puntos de articulación
La pregunta. ¿Qué aristas, si se eliminan, desconectan el grafo? ¿Qué vértices? Se plantea como puntos únicos de fallo o conexiones críticas en un clúster.
Esta es la pregunta estándar de DFS más profunda, y es una sola idea: junto al tiempo de descubrimiento de cada vértice, registra low[u], el menor tiempo de descubrimiento alcanzable desde el subárbol de u usando como mucho una arista que no sea de árbol.
def bridges(adj, n):
    disc, low = [-1] * n, [-1] * n
    out, clock = [], 0

    def visit(u, parent):
        nonlocal clock
        disc[u] = low[u] = clock; clock += 1
        for v in adj[u]:
            if v == parent:
                parent = -2                 # saltar UNA copia de la arista al padre
                continue
            if disc[v] == -1:
                visit(v, u)
                low[u] = min(low[u], low[v])
                if low[v] > disc[u]:
                    out.append((u, v))      # nada bajo v llega a u o más arriba
            else:
                low[u] = min(low[u], disc[v])

    for s in range(n):
        if disc[s] == -1: visit(s, -1)
    return out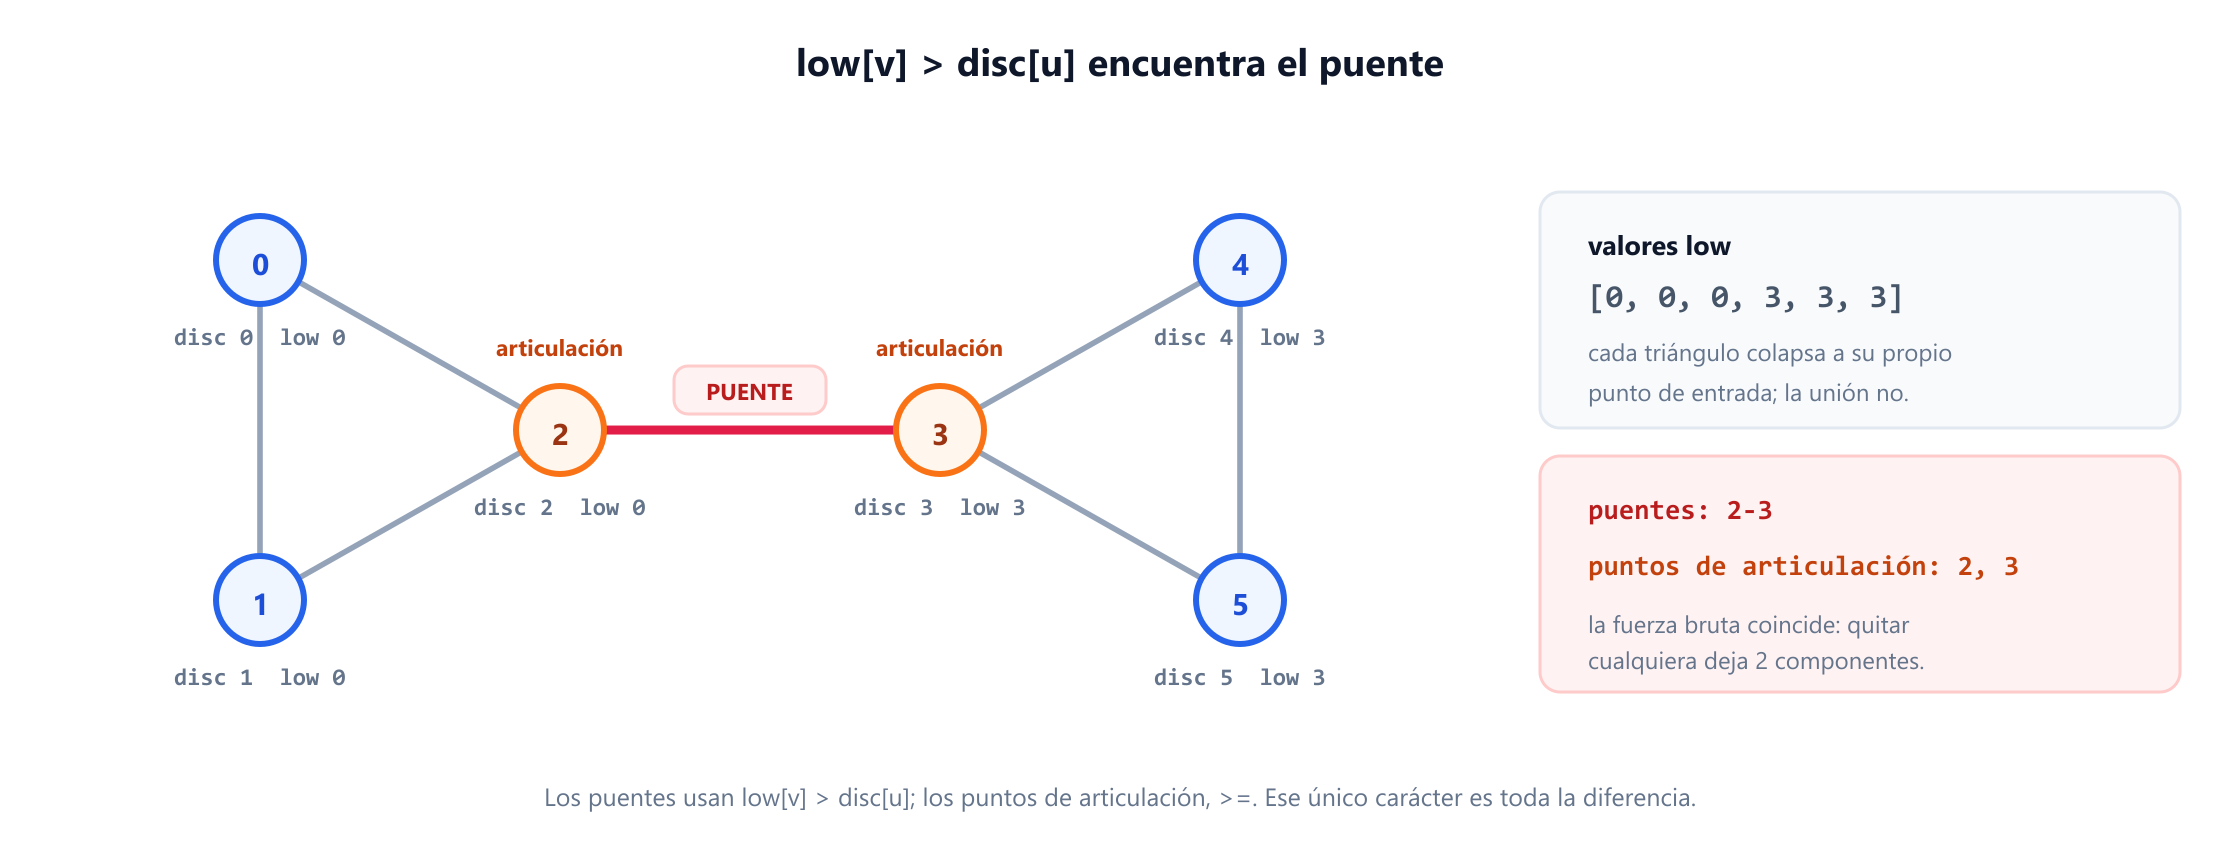
low[v] > disc[u] dice que el subárbol bajo v no tiene forma de volver a u ni más arriba, así que u-v es la única ruta y quitarla divide el grafo. En el grafo de dos triángulos, los tiempos de descubrimiento van de 0 a 5 y los valores low son 0, 0, 0, 3, 3, 3. El único puente es 2-3; los puntos de articulación son 2 y 3. La fuerza bruta coincide: quitar esa arista, o cualquiera de esos dos vértices, deja 2 componentes, y ninguna otra eliminación individual desconecta nada.
Los puntos de articulación usan el mismo recorrido con dos reglas: un vértice no raíz u lo es si algún hijo v cumple low[v] >= disc[u], y la raíz lo es si tiene más de un hijo en el DFS. Fíjate en >= frente al > de los puentes. Ese único carácter separa las dos respuestas, y confundirlos es el error más habitual aquí.
La trampa. La comprobación del padre. if v == parent: continue sin la guarda de un solo uso está mal en un multigrafo: dos aristas paralelas hacia el padre significan que el par no es un puente, y saltarse ambas lo oculta. Guarda el índice de la arista, o sáltate solo la primera aparición como arriba. El algoritmo es de Hopcroft y Tarjan, de 1973, y hay un visualizador para él.
11. Complejidad, y la pregunta de la profundidad de recursión
Cada algoritmo anterior es un recorrido, así que la cota de tiempo apenas cambia. La pregunta interesante está en el espacio.
| Problema | Tiempo | Espacio | La razón que debes dar |
|---|---|---|---|
| DFS, lista de adyacencia | O(V + E) | O(V) | Cada vértice se visita una vez, cada arista se examina una vez por dirección |
| Detección de ciclos dirigida | O(V + E) | O(V) | Un array de colores sobre el mismo recorrido |
| Ordenación topológica | O(V + E) | O(V) | Lista en postorden más la pila de recursión |
| CFC de Kosaraju-Sharir | O(V + E) | O(V + E) | Dos recorridos, y el grafo invertido es una segunda copia |
| Puentes, puntos de articulación | O(V + E) | O(V) | Dos arrays de enteros, disc y low |
Word search, longitud de palabra L | O(R × C × 3L) | O(L) | Cada celda es un inicio; 3 opciones siguientes tras el primer paso |
| Todos los caminos | O(V × 2V) | O(V) | La propia salida puede ser exponencial |
La pregunta de la profundidad de recursión aparece en casi todas las entrevistas de DFS, así que ten la respuesta preparada. DFS se anida tan hondo como el camino más largo que sigue, que en un grafo camino es V. El límite por defecto de CPython es 1000, así que unos pocos miles de vértices en línea lo hacen fallar, y una cuadrícula de 1000 por 1000 celdas de tierra puede anidarse un millón de niveles.
La solución es la versión iterativa de la sección 2, no sys.setrecursionlimit, que solo convierte una excepción limpia en un desbordamiento de pila real. Dilo explícitamente. El espacio O(V) es esa pila, y la comparación honesta con BFS es que DFS guarda un camino de la raíz a una hoja mientras que BFS guarda una capa entera: ninguno es siempre menor, depende de si el grafo es profundo o ancho. Aho, Hopcroft y Ullman dan el análisis agregado; Sedgewick y Wayne, el tratamiento claro más breve.
12. Errores que suspenden la entrevista
Ordenados por frecuencia; los tres primeros explican la mayoría de las soluciones rechazadas.
- Un solo conjunto de visitados para la detección de ciclos dirigida. Volver a ver un vértice no es un ciclo. El gris (en la pila) debe distinguirse del negro (terminado), o todo DAG con dos rutas hacia un vértice informará de uno.
- Usar tres colores para detectar ciclos no dirigidos. El error contrario. Cada arista parece de retroceso a menos que te saltes aquella por la que llegaste.
- Usar recursión con entradas que pueden ser grandes. Una cuadrícula de un millón de celdas se anida un millón de niveles. Ofrece la versión iterativa antes de que te la pidan.
- Construir el orden topológico en preorden. Tiene que ser postorden, añadiendo cuando el vértice termina, y luego invertido. El preorden produce algo que parece una respuesta y no lo es.
- Olvidar deshacer en el backtracking. El
path.pop(), o restaurar la celda de la cuadrícula. Sin ello, la primera rama fallida envenena todas las posteriores. - Guardar la lista viva en lugar de una copia.
out.append(path)da una lista de referencias a una única lista modificada. Tiene que serpath[:]. - Confundir
>y>=en la prueba low-link.low[v] > disc[u]es un puente,>=es un punto de articulación. Un carácter de diferencia. - Omitir el bucle exterior sobre las componentes. La detección de ciclos, el conteo de componentes y las CFC necesitan relanzar DFS desde cada vértice no visitado.
- No preguntar por la entrada. ¿Dirigido o no dirigido? ¿Conexo? ¿Bucles o aristas paralelas? Cada respuesta cambia el código, y la observación de Skiena se cumple: los problemas se ganan en el modelado.
El hábito que evita la mayoría de estos errores: antes de escribir, nombra el array extra. Color, padre, orden de finalización o low-link. Las preguntas de DFS se distinguen unas de otras por ese array, no por el recorrido, y nombrarlo primero hace mecánico el resto. McDowell defiende lo mismo en general; aquí es inusualmente literal.
13. Preguntas frecuentes
¿Cuándo debo usar DFS en lugar de BFS?
+
Cuando la pregunta trata de orden, dependencias, ciclos o qué se rompe si se quita algo. Todo eso requiere saber cuándo termina un vértice o si sigue en la pila, y solo DFS te lo da. Si pide el mínimo de algo, usa BFS: DFS encuentra un camino, no el más corto.
¿Por qué necesito tres colores para detectar ciclos dirigidos?
+
Porque un simple conjunto de visitados no distingue un ancestro de un vértice terminado. Gris significa que sigue en la pila de recursión, así que una arista hacia un vértice gris cierra un bucle y es un ciclo real. Negro significa terminado, y una arista hacia un vértice negro es solo una segunda ruta hacia una parte ya explorada del grafo, algo legal en un DAG.
¿Por qué invertir el postorden de DFS da una ordenación topológica?
+
Porque un vértice termina solo después de todo lo alcanzable desde él, así que siempre termina después que sus sucesores. Invertir el orden de finalización coloca, por tanto, cada vértice antes de todo aquello a lo que apunta, que es la condición topológica. Añade en postorden, cuando el vértice termina, no cuando se descubre.
¿Qué es un valor low-link?
+
Para un vértice u es el menor tiempo de descubrimiento alcanzable desde el subárbol de u usando aristas de árbol más como mucho una arista que no sea de árbol. Responde a «¿puede algo por debajo de u volver por encima de u sin la arista hacia su padre?». Si no, esa arista es un puente. Es el único array extra que convierte un DFS normal en un algoritmo para puentes, puntos de articulación y las componentes fuertemente conexas de Tarjan.
¿Hasta qué profundidad puede llegar un DFS recursivo antes de romperse?
+
Tan hondo como el camino más largo que sigue, que en un grafo camino es el número de vértices. El límite por defecto de CPython es 1000, así que unos pocos miles de vértices en línea lo hacen fallar, y una cuadrícula de 1000 por 1000 celdas de tierra se anida un millón de niveles. Reescríbelo de forma iterativa en lugar de subir el límite, lo que solo convierte una excepción limpia en un desbordamiento de pila real.
¿Es el DFS iterativo lo mismo que el DFS recursivo con una pila?
+
No del todo. La versión simple con pila visita los vecinos en orden inverso, así que apílalos al revés para que coincida, y debe comprobar el conjunto de visitados al desapilar además de al apilar, ya que un vértice puede estar varias veces en la pila. Y lo más importante: no tiene postorden, así que la ordenación topológica, las componentes fuertemente conexas y los algoritmos low-link necesitan una versión que apile cada vértice dos veces o lleve un índice de hijo.
¿Necesito un conjunto de visitados al enumerar todos los caminos?
+
No, y añadirlo es un error común. Enumeras caminos, no vértices, así que el mismo vértice aparece legítimamente en muchos caminos, y un conjunto de visitados global devuelve en silencio solo algunos. Lo que necesitas es el camino actual, deshecho con un pop al salir. En un grafo cíclico excluyes los vértices que ya están en ese camino, lo cual no es un conjunto global.
14. Referencias
Los artículos que introdujeron estas técnicas y los libros que las analizan, en orden cronológico.
- Lucas, É. (1882). Récréations Mathématiques, volumen 1. Gauthier-Villars. (Recoge la regla sistemática de Trémaux para recorrer laberintos, la descripción más antigua de la búsqueda en profundidad.)
- Tarjan, R. E. (1972). “Depth-first search and linear graph algorithms.” SIAM Journal on Computing, 1(2), 146–160.
- Hopcroft, J. y Tarjan, R. E. (1973). “Algorithm 447: efficient algorithms for graph manipulation.” Communications of the ACM, 16(6), 372–378.
- Aho, A. V., Hopcroft, J. E. y Ullman, J. D. (1974). The Design and Analysis of Computer Algorithms. Addison-Wesley.
- Tarjan, R. E. (1976). “Edge-disjoint spanning trees and depth-first search.” Acta Informatica, 6(2), 171–185.
- Sharir, M. (1981). “A strong-connectivity algorithm and its applications in data flow analysis.” Computers & Mathematics with Applications, 7(1), 67–72.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. y Stein, C. (2009). Introduction to Algorithms, 3.ª edición, sección 22.3. MIT Press.
- Sedgewick, R. y Wayne, K. (2011). Algorithms, 4.ª edición, secciones 4.1 a 4.2. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6.ª edición. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3.ª edición, capítulo 5. Springer.