
Inhaltsverzeichnis
- 1. Was eine DFS-Frage wirklich prüft
- 2. Die Vorlage, rekursiv und iterativ
- 3. Zykelerkennung in einem gerichteten Graphen
- 4. Zykelerkennung in einem ungerichteten Graphen
- 5. Topologische Sortierung per Postorder
- 6. Clone Graph
- 7. Alle Pfade: DFS als Backtracking
- 8. Word Search auf einem Gitter
- 9. Starke Zusammenhangskomponenten
- 10. Brücken und Artikulationspunkte
- 11. Komplexität und die Frage nach der Rekursionstiefe
- 12. Fehler, an denen das Interview scheitert
- 13. Häufig gestellte Fragen
- 14. Literatur
1. Was eine DFS-Frage wirklich prüft
Bei DFS-Fragen geht es nicht um das Durchlaufen. Jeder Kandidat kann einen Graphen ablaufen. Geprüft wird, ob Sie die Buchführung kennen, die DFS bietet und BFS nicht: die Reihenfolge, in der Knoten abgeschlossen werden, ob ein Knoten noch auf dem Stack liegt und wie weit ein Teilbaum zurückreichen kann.
Das ist das ganze Thema. Zykelerkennung, topologische Sortierung, starke Zusammenhangskomponenten, Brücken und Artikulationspunkte sind alle eine Traversierung plus ein zusätzliches Array. Fragt eine Aufgabe nach Reihenfolge, Abhängigkeiten, Zyklen oder danach, was kaputtgeht, wenn man dies entfernt, ist es eine DFS-Frage. Fragt sie nach der geringsten Anzahl von irgendetwas, ist es eine BFS-Frage.
Die acht folgenden Fragen sind die, die immer wiederkehren, jeweils mit Problem, Lösung, Nachfrage und dem Fehler, der das Angebot kostet. Jedes Rechenbeispiel wurde per Skript ausgeführt.
2. Die Vorlage, rekursiv und iterativ
Rekursive DFS sind vier Zeilen, und Sie sollten sie ohne Nachdenken schreiben können.
def dfs(u, adj, seen):
    seen.add(u)
    for v in adj[u]:
        if v not in seen:
            dfs(v, adj, seen)
Bei der iterativen Version rutschen Kandidaten aus, weil die naheliegende Übersetzung sich subtil von der rekursiven unterscheidet.
def dfs_iter(src, adj):
    seen, stack = set(), [src]
    while stack:
        u = stack.pop()
        if u in seen:            # ein Knoten kann mehrmals abgelegt werden
            continue
        seen.add(u)
        for v in adj[u]:
            if v not in seen:
                stack.append(v)
Zwei Dinge sollten Sie bemerken und laut aussprechen.
- Prüfen Sie
seenbeim Entnehmen, nicht nur beim Ablegen. Anders als bei BFS kann derselbe Knoten mehrmals auf dem Stack liegen, von mehreren Nachbarn abgelegt, bevor einer davon expandiert wird. Ohne die Prüfung beim Entnehmen besuchen Sie Knoten doppelt. - Die Besuchsreihenfolge unterscheidet sich von der rekursiven Version. In aufsteigender Reihenfolge abgelegte Nachbarn werden in absteigender Reihenfolge entnommen, also erkundet iterative DFS den letzten Nachbarn zuerst. Legen Sie sie umgekehrt ab, damit es übereinstimmt. Eine beliebte Stolperfalle.
Der schwierigere Punkt: Die einfache iterative Version hat keine Postorder. Sie weiß, wann ein Knoten entdeckt wird, aber nie, wann sein Teilbaum abgeschlossen ist, und die Abschlusszeit ist genau das, was die Abschnitte 5, 9 und 10 brauchen. Um sie zurückzugewinnen, legen Sie jeden Knoten zweimal ab oder führen einen Kindindex im Frame mit. Zu wissen, dass die Rekursion hier nicht bloß kosmetisch ist, lohnt sich auszusprechen.
Die Technik ist alt: Es ist Trémaux' Regel zum Durchqueren eines Labyrinths, festgehalten von Lucas 1882.
3. Zykelerkennung in einem gerichteten Graphen
Die Frage. Enthält ein gerichteter Graph einen Zyklus? Formuliert als Deadlock-Erkennung, zyklische Build-Abhängigkeiten oder „kann dieser Kursplan abgeschlossen werden“.
Die falsche Antwort ist eine einzige Menge visited: Einen gesehenen Knoten erneut zu erreichen, bedeutet keinen Zyklus, es kann ein zweiter Weg in einen abgeschlossenen Teil des Graphen sein. Die richtige Antwort verwendet drei Farben: weiß für unentdeckt, grau für entdeckt, aber noch auf dem Rekursionsstack, schwarz für abgeschlossen.
WHITE, GREY, BLACK = 0, 1, 2

def has_cycle(adj, n):
    colour = [WHITE] * n

    def visit(u):
        colour[u] = GREY
        for v in adj[u]:
            if colour[v] == GREY:      # Rückwärtskante: v ist ein Vorfahr
                return True
            if colour[v] == WHITE and visit(v):
                return True
        colour[u] = BLACK              # erst jetzt ist u abgeschlossen
        return False

    return any(colour[s] == WHITE and visit(s) for s in range(n))
Eine Kante zu einem grauen Knoten ist eine Rückwärtskante, und ein gerichteter Graph hat genau dann einen Zyklus, wenn eine DFS eine Rückwärtskante findet. Eine Kante zu einem schwarzen Knoten ist harmlos. Diese Äquivalenz und die Einteilung der Kanten in vier Arten, zu der sie gehört, sind die Standarddarstellung bei Cormen, Leiserson, Rivest und Stein.
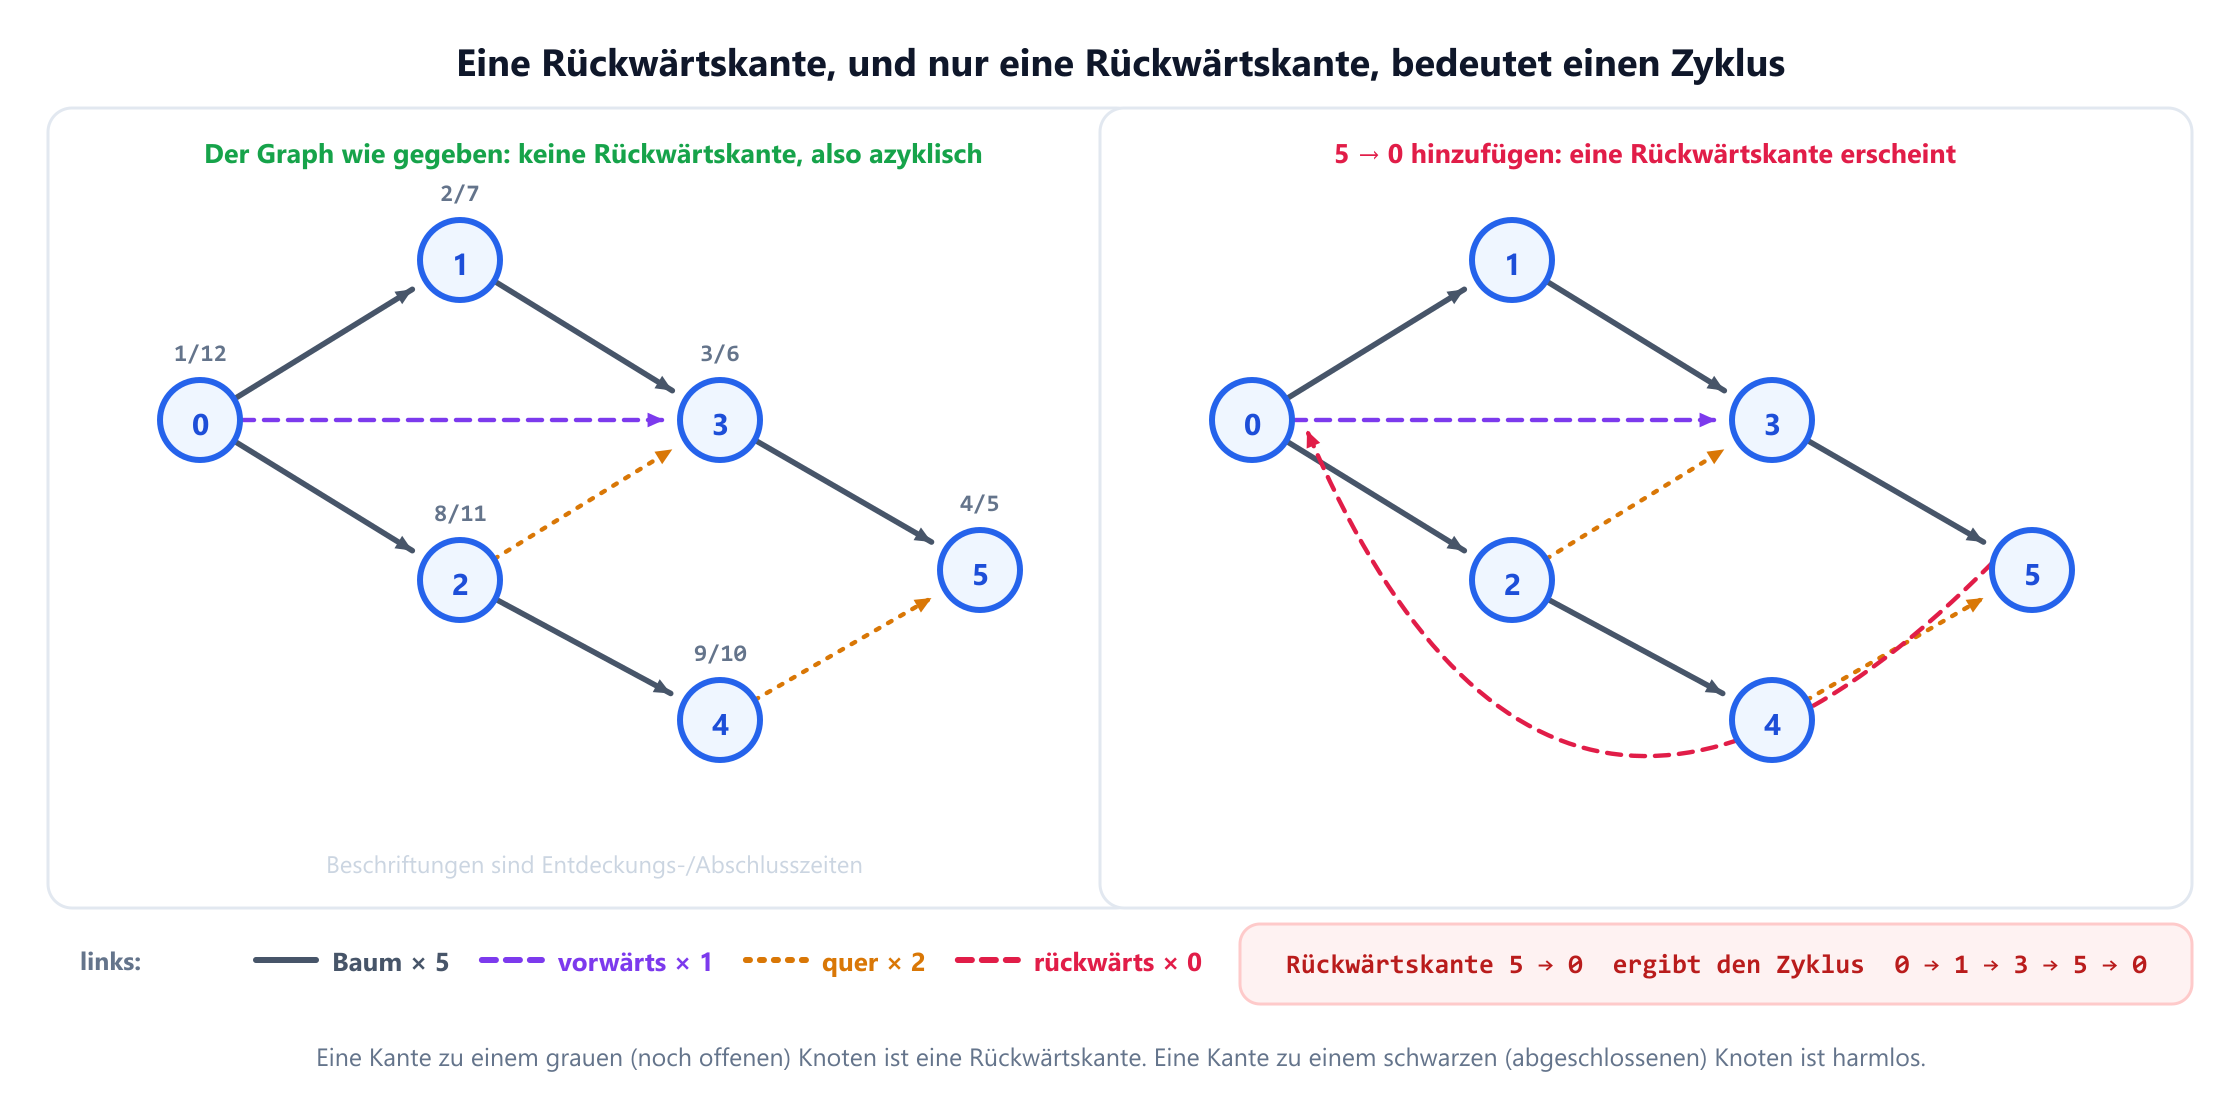
Auf dem laufenden Graphen klassifiziert DFS ab Knoten 0 seine 8 Bögen als 5 Baumkanten, 1 Vorwärtskante und 2 Querkanten, ohne Rückwärtskante, also ist er azyklisch. Fügen Sie den einzelnen Bogen 5 → 0 hinzu, und es erscheint genau eine Rückwärtskante.
Die Nachfrage: Geben Sie den Zyklus aus, nicht nur einen Wahrheitswert. Die Rückwärtskante liefert ihn: Ist sie u → v, folgen Sie den Elternzeigern von u hinauf bis v und schließen den Kreis. Hier ist die Rückwärtskante 5 → 0 und der Zyklus 0 → 1 → 3 → 5 → 0. Ein Elternarray kostet eine Zeile und macht aus einem Ja/Nein die Diagnose, die ein echtes Build-Werkzeug melden muss.
Die Falle. Das Setzen von colour[u] = BLACK an der falschen Stelle oder gar nicht. Bleiben abgeschlossene Knoten grau, sieht jeder zweite Weg zu ihnen wie ein Zyklus aus, und Sie melden Fehlalarme bei jedem DAG mit einer Raute, wie ihn der laufende Graph enthält.
4. Zykelerkennung in einem ungerichteten Graphen
Die Frage. Dasselbe Problem, ungerichteter Graph. Es sieht aus wie die vorige Frage, ist es aber nicht.
Drei Farben sind hier falsch. Jede ungerichtete Kante ist in beide Richtungen begehbar, also sieht nach dem Schritt von u nach v die Kante zurück zu u wie eine Kante zu einem grauen Knoten aus, und jede Kante meldet einen Zyklus. Stattdessen: Ignorieren Sie die Kante, über die Sie gekommen sind.
def has_cycle_undirected(adj, n):
    seen = [False] * n

    def visit(u, parent):
        seen[u] = True
        for v in adj[u]:
            if not seen[v]:
                if visit(v, u): return True
            elif v != parent:          # ein gesehener Nachbar, nicht der Elternknoten
                return True
        return False

    return any(not seen[s] and visit(s, -1) for s in range(n))
Ohne die Schutzbedingung v != parent meldet ein Graph aus der einzelnen Kante 0-1 einen Zyklus. Mit ihr meldet ein Baum mit 4 Knoten korrekt keinen und ein Dreieck korrekt einen. Das sind die drei Testfälle, die Sie am Whiteboard prüfen sollten, und sie ungefragt zu prüfen, macht einen sehr guten Eindruck.
Die Nachfrage: Mehrfachkanten? Dann reicht v != parent nicht: Zwei verschiedene Kanten zwischen u und v bilden tatsächlich einen Zyklus der Länge 2, und die Elternprüfung verschluckt die zweite. Merken Sie sich die Kante, über die Sie gekommen sind, nicht den Knoten. Siehe einfache Graphen vs. Multigraphen.
Die Falle. Ein nicht zusammenhängender Graph. Die äußere Schleife über jeden unbesuchten Knoten ist nicht optional, und eine Lösung, die nur bei Knoten 0 beginnt, besteht jeden zusammenhängenden Testfall.
5. Topologische Sortierung per Postorder
Die Frage. Ordnen Sie die Knoten eines DAG so, dass jeder Bogen nach vorn zeigt. Die BFS-Antwort ist Kahns Abschälen nach Eingangsgrad; die DFS-Antwort ist kürzer und genau das, was eine DFS-Frage will.
DFS ausführen, jeden Knoten bei seinem Abschluss anhängen, die Liste umkehren. Das ist der ganze Algorithmus, und die Begründung ist ein Satz: Ein Knoten wird erst abgeschlossen, nachdem alles von ihm Erreichbare abgeschlossen ist, also wird er später abgeschlossen als seine Nachfolger, und das Umkehren stellt ihn vor sie.
def topological_sort(adj, n):
    colour = [0] * n           # 0 weiß, 1 grau, 2 schwarz
    order = []

    def visit(u):
        colour[u] = 1
        for v in adj[u]:
            if colour[v] == 1: raise ValueError("cycle")
            if colour[v] == 0: visit(v)
        colour[u] = 2
        order.append(u)        # Postorder: NACH den Kindern

    for s in range(n):
        if colour[s] == 0: visit(s)
    return order[::-1]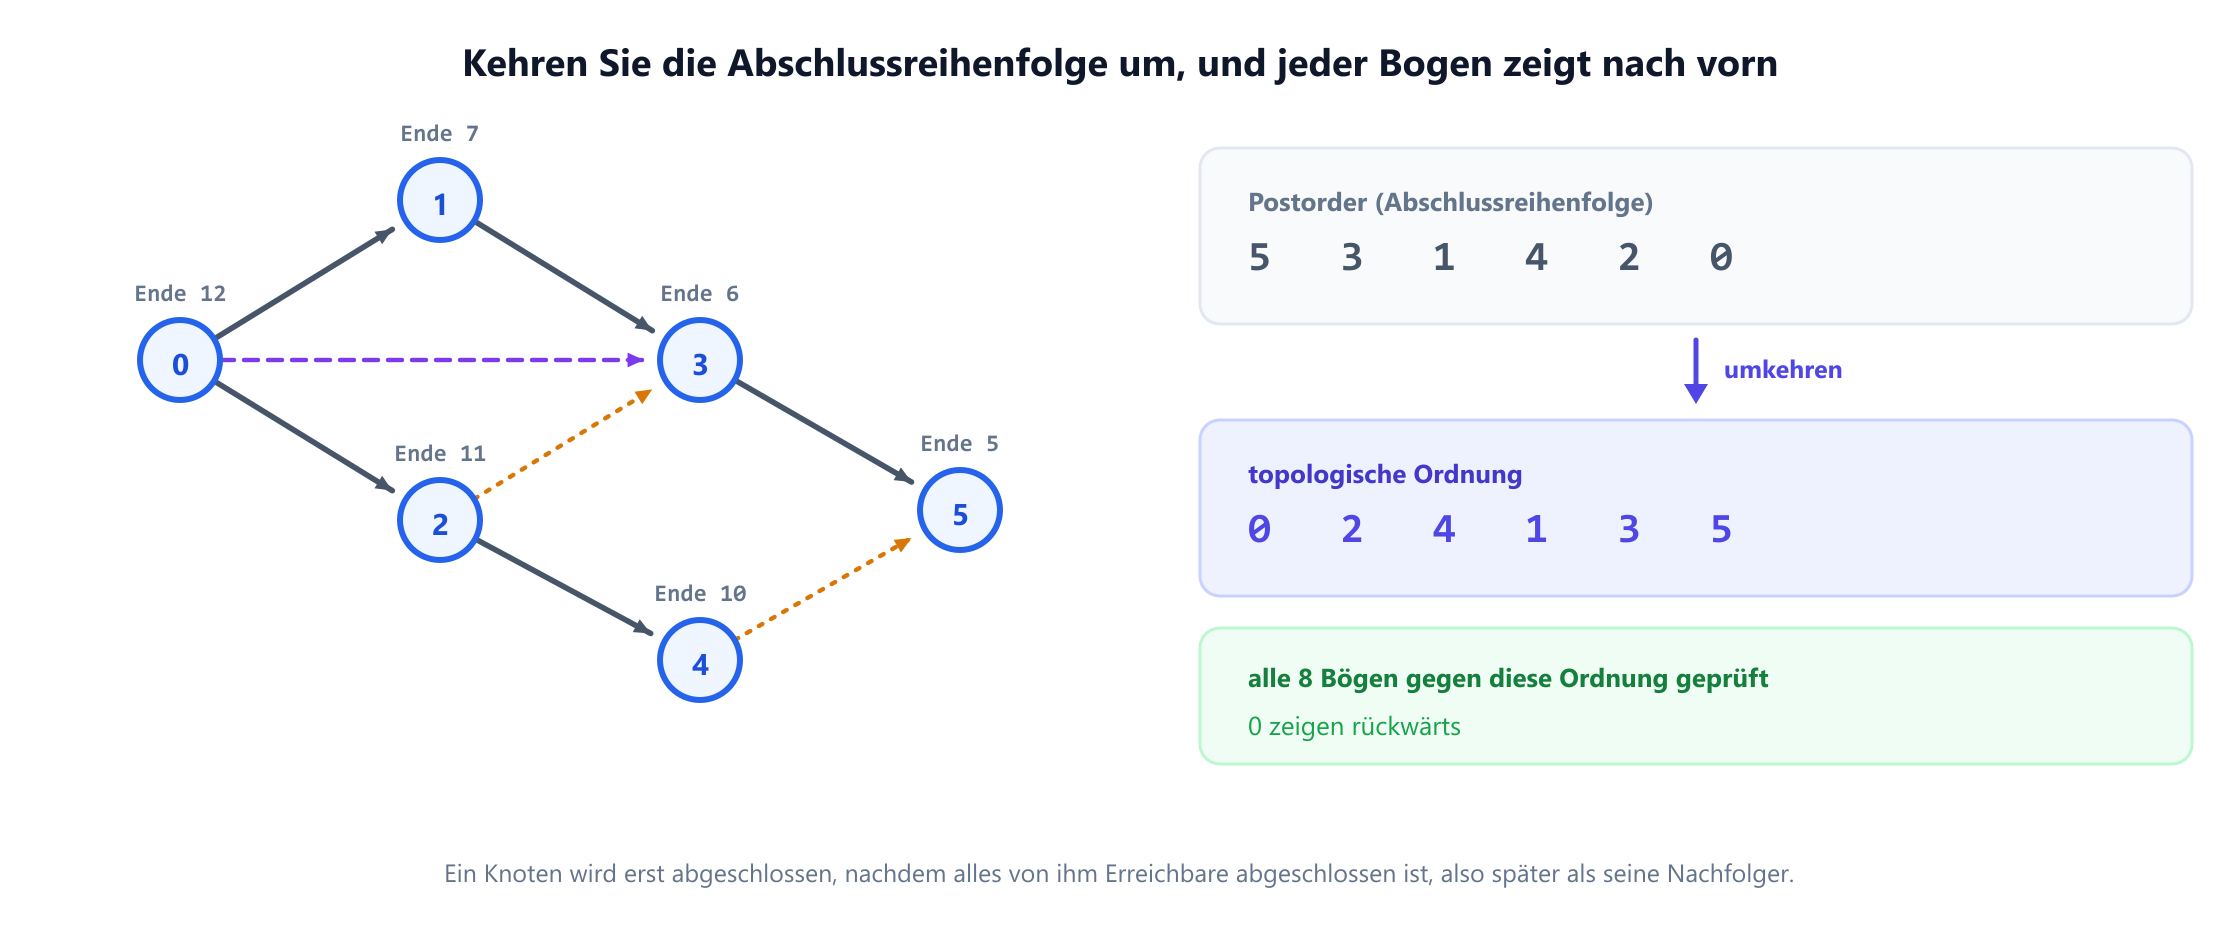
Auf dem laufenden DAG ist die Postorder 5, 3, 1, 4, 2, 0; umgekehrt ergibt sich 0, 2, 4, 1, 3, 5, und alle acht Bögen zeigen darin nach vorn. Sagen Sie, dass es eine topologische Ordnung ist, nicht die einzige: Ein DAG hat meist viele.
Die Nachfrage: Wie erkennen Sie hier einen Zyklus? Mit der Grau-Prüfung aus Abschnitt 3. Das ist der Reiz: Eine Traversierung ordnet den DAG und weist zugleich einen Nicht-DAG zurück, während Kahn am Ende eine separate Zählung braucht. Die DFS-Formulierung stammt von Tarjan.
Die Falle. Anhängen in Preorder, also beim Entdecken des Knotens statt bei seinem Abschluss. Das Ergebnis sieht plausibel aus, ist falsch und stimmt auf kleinen Graphen oft mit einer gültigen Ordnung überein, sodass es oberflächliche Tests übersteht.
6. Clone Graph
Die Frage. Gegeben eine Referenz auf einen Knoten in einem zusammenhängenden ungerichteten Graphen: Geben Sie eine tiefe Kopie zurück.
Die einzige Schwierigkeit sind Zyklen: Eine naive rekursive Kopie läuft endlos. Die Lösung ist eine Abbildung vom Originalknoten auf seine Kopie, die zugleich als Besucht-Menge dient, und sie muss vor der Rekursion geschrieben werden.
def clone_graph(node, made=None):
    if node is None: return None
    if made is None: made = {}
    if node in made:
        return made[node]
    copy = Node(node.val)
    made[node] = copy              # VOR der Rekursion registrieren
    for nb in node.neighbors:
        copy.neighbors.append(clone_graph(nb, made))
    return copy
Die Kopie vor den rekursiven Aufrufen zu registrieren, ist die ganze Frage. Tun Sie es danach, schickt Sie ein Zyklus erneut herum, bevor der Eintrag existiert, und die Rekursion läuft, bis der Stack stirbt. Es ist dieselbe Form wie das Memoisieren jeder selbstreferenziellen Struktur.
Die Nachfrage: iterativ oder BFS? Beides funktioniert, mit identischer Abbildung. Sagen Sie, dass die Abbildung und nicht die Traversierungsreihenfolge die Korrektheit ausmacht. In beiden Fällen O(V + E).
7. Alle Pfade: DFS als Backtracking
Die Frage. Listen Sie jeden Pfad von einer Quelle zu einem Ziel in einem DAG auf. Varianten: alle Pfade von der Wurzel zu einem Blatt, Pfadsumme, Permutationen.
Das ist die Familie, in der DFS aufhört, eine Graphtraversierung zu sein, und zum Backtracking wird, und der Unterschied ist eine Zeile: Sie machen Ihre Wahl auf dem Rückweg rückgängig.
def all_paths(adj, src, dst):
    out, path = [], []

    def walk(u):
        path.append(u)
        if u == dst:
            out.append(path[:])    # KOPIE, nicht die lebende Liste
        else:
            for v in adj[u]:
                walk(v)
        path.pop()                 # der Backtracking-Schritt

    walk(src)
    return out
Auf dem laufenden DAG gibt es genau 4 Pfade von 0 nach 5: 0→1→3→5, 0→2→3→5, 0→2→4→5 und 0→3→5.
Zwei Details tragen die Antwort. Hängen Sie eine Kopie an, path[:], denn path wird danach verändert, und die Referenz liefert eine Liste identischer leerer Listen. Und es gibt keine Besucht-Menge: Sie zählen Pfade auf, nicht Knoten, also kommt ein Knoten zu Recht in vielen Pfaden vor. Das path.pop() hält den Zustand auch ohne sie korrekt.
Die Nachfrage: Komplexität? Nicht O(V + E). Ein DAG kann exponentiell viele Pfade haben, also ist ihr Auflisten exponentiell in der Ausgabe; die ehrliche Antwort ist O(V × 2V). Hier linear zu sagen, verrät, dass Sie nicht darüber nachgedacht haben, was die Ausgabe ist. Wird nur gefragt, wie viele Pfade es gibt, ist das ein anderes Problem: Zählen Sie mit dynamischer Programmierung über die topologische Ordnung, in O(V + E).
Die Falle. Eine Besucht-Menge hinzufügen, weil „DFS immer eine hat“. Auf einem zyklischen Graphen schließen Sie Knoten aus, die bereits auf dem aktuellen Pfad liegen, aber das ist der Pfad, keine globale Menge, und eine globale Menge liefert stillschweigend nur einen Teil der Antworten.
8. Word Search auf einem Gitter
Die Frage. Gegeben ein Buchstabengitter und ein Wort: Entscheiden Sie, ob sich das Wort buchstabieren lässt, indem man zwischen orthogonal benachbarten Zellen wechselt und keine Zelle zweimal nutzt.
Das ist Backtracking auf einem impliziten Gittergraphen, und die Klausel „keine Zelle zweimal“ erzwingt das Rückgängigmachen.
def exist(board, word):
    R, C = len(board), len(board[0])

    def walk(r, c, i):
        if i == len(word): return True
        if not (0 <= r < R and 0 <= c < C): return False
        if board[r][c] != word[i]: return False

        board[r][c] = '#'                      # markieren, damit der Pfad sie nicht erneut nutzt
        found = any(walk(r + dr, c + dc, i + 1)
                    for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)))
        board[r][c] = word[i]                  # auf dem Rückweg RÜCKGÄNGIG machen
        return found

    return any(walk(r, c, 0) for r in range(R) for c in range(C))
Die Markierung muss wiederhergestellt werden: Eine Zelle, die ein gescheiterter Versuch blockiert hat, muss für einen anderen Start verfügbar sein, und wer das vergisst, erhält eine Funktion, die nur dann Erfolg hat, wenn der zuerst probierte Pfad zufällig funktioniert. Das Brett zu überschreiben, statt eine Besucht-Menge zu führen, ist ein legitimer Trick, aber sagen Sie es, denn es verändert die Eingabe des Aufrufers.
Die Nachfrage: Komplexität. O(R × C × 3L) für ein Wort der Länge L: Jede Zelle ist ein möglicher Start, und nach dem ersten Schritt gehen Sie nie den Weg zurück, den Sie gekommen sind, also hat jeder weitere Schritt höchstens 3 Möglichkeiten, nicht 4. Diese 3 ist das Detail, das zeigt, dass Sie nachgedacht haben.
9. Starke Zusammenhangskomponenten
Die Frage. Zerlegen Sie einen gerichteten Graphen in maximale Mengen wechselseitig erreichbarer Knoten. Taucht auf als „finde zirkuläre Abhängigkeiten“ oder als Vorverarbeitung vor einem DAG-Algorithmus.
Es gibt zwei DFS-Antworten, und Sie sollten wissen, welche Sie schreiben.
Kosaraju-Sharir besteht aus zwei Durchläufen und ist unter Druck viel leichter richtig hinzubekommen. DFS auf dem Graphen mit Aufzeichnung der Abschlussreihenfolge, dann DFS auf dem umgekehrten Graphen, wobei die Knoten in absteigender Abschlussreihenfolge genommen werden; jeder Baum des zweiten Durchlaufs ist eine Komponente.
def kosaraju(adj, radj, n):
    seen, order = [False] * n, []
    def pass1(u):
        seen[u] = True
        for v in adj[u]:
            if not seen[v]: pass1(v)
        order.append(u)                  # Abschlussreihenfolge
    for s in range(n):
        if not seen[s]: pass1(s)

    comp, c = [-1] * n, 0
    def pass2(u):
        comp[u] = c
        for v in radj[u]:
            if comp[v] == -1: pass2(v)
    for u in reversed(order):            # absteigende Abschlusszeit
        if comp[u] == -1:
            pass2(u); c += 1
    return comp, c
Auf einem Graphen aus zwei Dreiecken, 0→1→2→0 und 3→4→5→3, verbunden durch den einzelnen Bogen 2→3, liefert das genau zwei Komponenten, {0,1,2} und {3,4,5}. Die Erreichbarkeit bestätigt es: 0 erreicht 3, und 3 erreicht 0 nicht.
Tarjans Algorithmus erledigt es in einem Durchlauf mit einem Stack und einem Low-Link-Wert: in der Praxis schneller, am Whiteboard viel leichter zu verpfuschen. Beide sind O(V + E), und für beide gibt es hier einen Visualisierer. Tarjans Arbeit von 1972 lieferte das Verfahren mit einem Durchlauf; die Version mit zwei Durchläufen wird Kosaraju zugeschrieben und wurde zuerst 1981 von Sharir veröffentlicht.
Vertiefung: Der Leitfaden zu starken Zusammenhangskomponenten verfolgt beide Algorithmen auf einem Graphen und zeigt die Fehler, die kleine Tests bestehen.
Die Nachfrage: Warum funktioniert der umgekehrte Graph? Das Umkehren jedes Bogens lässt die Komponenten unverändert, da wechselseitige Erreichbarkeit symmetrisch ist. Der Knoten mit der höchsten Abschlusszeit liegt in einer Komponente der Kondensation, die eine Quelle ist, und die Umkehrung macht eine Quelle zu einer Senke, sodass eine dort gestartete DFS sie nicht verlassen kann.
10. Brücken und Artikulationspunkte
Die Frage. Welche Kanten trennen den Graphen, wenn man sie entfernt? Welche Knoten? Formuliert als Single Points of Failure oder kritische Verbindungen in einem Cluster.
Das ist die tiefste Standardfrage zu DFS, und sie beruht auf einer Idee: Führen Sie neben der Entdeckungszeit jedes Knotens low[u] mit, die kleinste Entdeckungszeit, die vom Teilbaum von u aus mit höchstens einer Nicht-Baumkante erreichbar ist.
def bridges(adj, n):
    disc, low = [-1] * n, [-1] * n
    out, clock = [], 0

    def visit(u, parent):
        nonlocal clock
        disc[u] = low[u] = clock; clock += 1
        for v in adj[u]:
            if v == parent:
                parent = -2                 # EINE Kopie der Elternkante überspringen
                continue
            if disc[v] == -1:
                visit(v, u)
                low[u] = min(low[u], low[v])
                if low[v] > disc[u]:
                    out.append((u, v))      # nichts unter v erreicht u oder höher
            else:
                low[u] = min(low[u], disc[v])

    for s in range(n):
        if disc[s] == -1: visit(s, -1)
    return out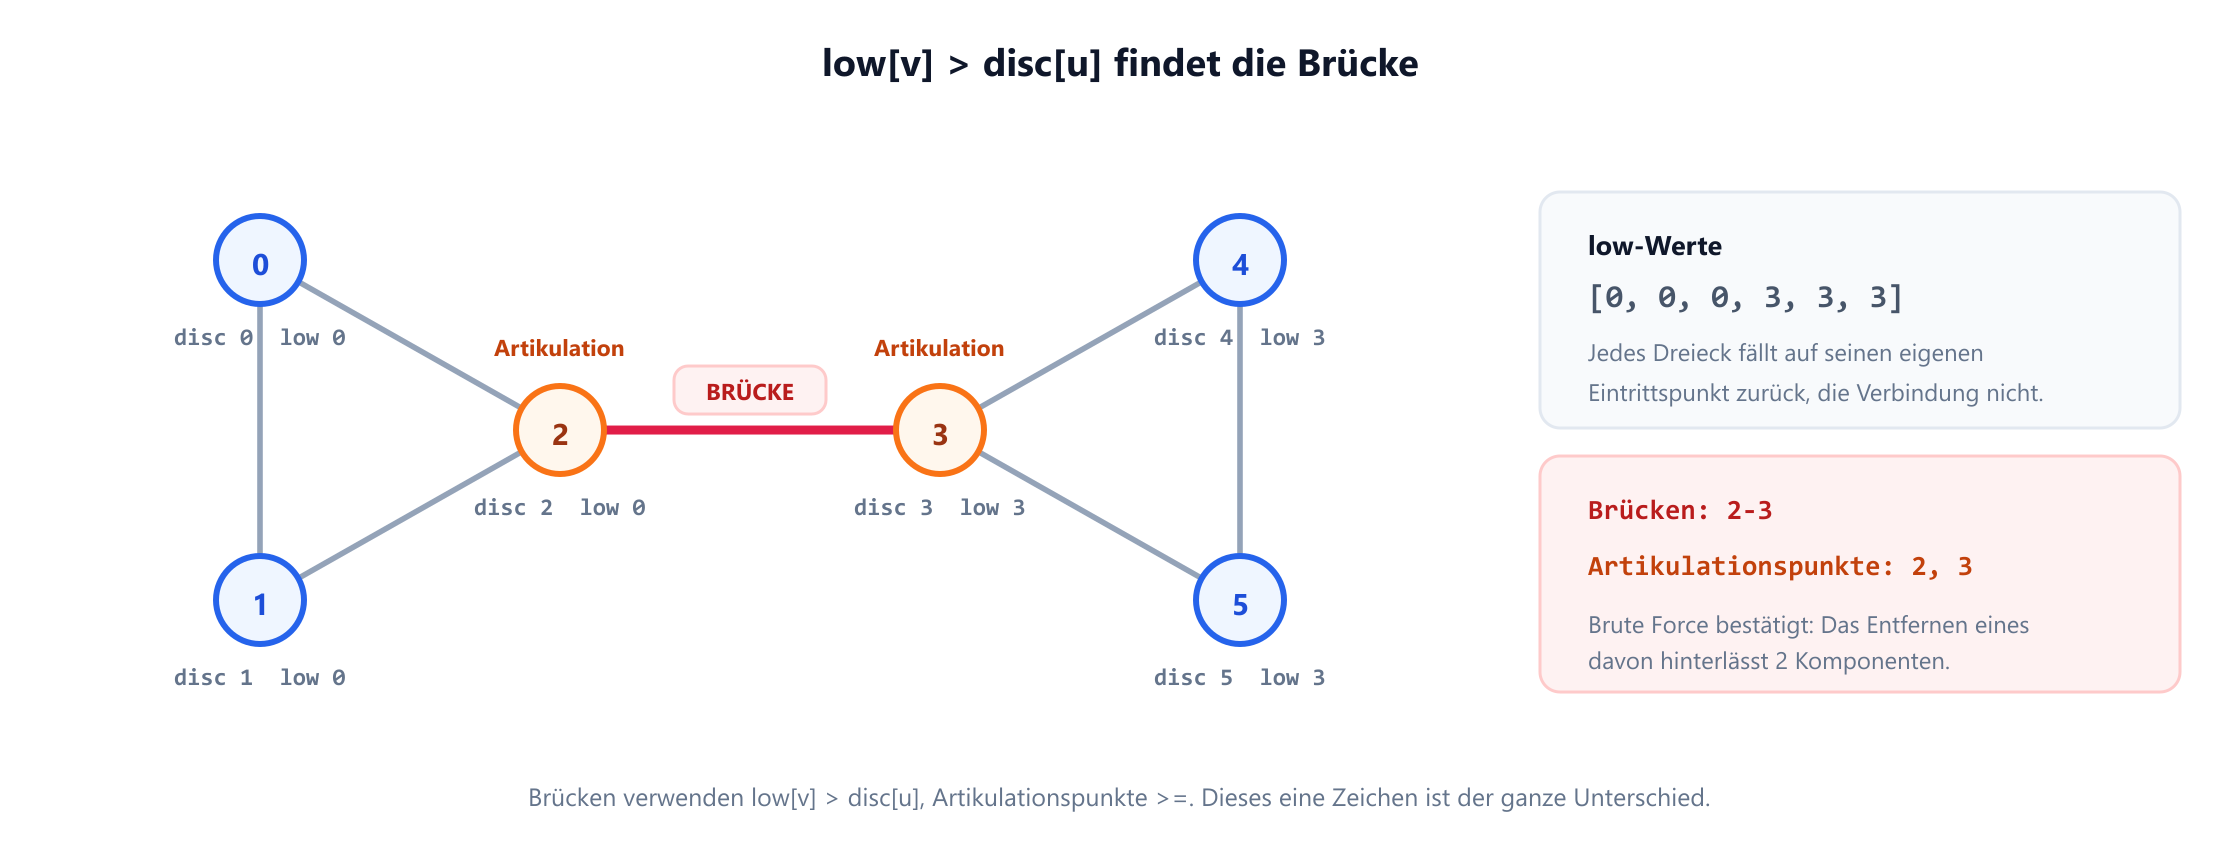
low[v] > disc[u] besagt, dass der Teilbaum unter v keinen Weg zurück zu u oder höher hat, also ist u-v der einzige Weg, und sein Entfernen teilt den Graphen. Auf dem Graphen aus zwei Dreiecken laufen die Entdeckungszeiten von 0 bis 5, und die low-Werte sind 0, 0, 0, 3, 3, 3. Die einzige Brücke ist 2-3; die Artikulationspunkte sind 2 und 3. Brute Force bestätigt: Das Entfernen dieser Kante oder eines der beiden Knoten hinterlässt 2 Komponenten, und kein anderes einzelnes Entfernen trennt irgendetwas.
Artikulationspunkte verwenden dieselbe Traversierung mit zwei Regeln: Ein Nicht-Wurzelknoten u ist einer, wenn ein Kind v die Bedingung low[v] >= disc[u] erfüllt, und die Wurzel ist einer, wenn sie mehr als ein DFS-Kind hat. Beachten Sie >= gegenüber > bei Brücken. Dieses eine Zeichen trennt die beiden Antworten, und sie zu verwechseln, ist hier der häufigste Fehler.
Die Falle. Die Elternprüfung. if v == parent: continue ohne den einmaligen Schutz ist auf einem Multigraphen falsch: Zwei parallele Kanten zum Elternknoten bedeuten, dass das Paar keine Brücke ist, und beide zu überspringen, verdeckt das. Merken Sie sich den Kantenindex oder überspringen Sie wie oben nur das erste Vorkommen. Der Algorithmus stammt von Hopcroft und Tarjan, 1973, und es gibt einen Visualisierer dafür.
11. Komplexität und die Frage nach der Rekursionstiefe
Jeder Algorithmus oben ist eine Traversierung, also bewegt sich die Zeitschranke kaum. Die interessante Frage liegt beim Speicher.
| Problem | Zeit | Speicher | Die Begründung |
|---|---|---|---|
| DFS, Adjazenzliste | O(V + E) | O(V) | Jeder Knoten einmal besucht, jede Kante einmal pro Richtung geprüft |
| Zykelerkennung, gerichtet | O(V + E) | O(V) | Ein Farbarray über dieselbe Traversierung |
| Topologische Sortierung | O(V + E) | O(V) | Postorder-Liste plus Rekursionsstack |
| SZK nach Kosaraju-Sharir | O(V + E) | O(V + E) | Zwei Traversierungen, und der umgekehrte Graph ist eine zweite Kopie |
| Brücken, Artikulationspunkte | O(V + E) | O(V) | Zwei Integer-Arrays, disc und low |
Word Search, Wortlänge L | O(R × C × 3L) | O(L) | Jede Zelle ein Start; 3 Folgemöglichkeiten nach dem ersten Schritt |
| Alle Pfade | O(V × 2V) | O(V) | Die Ausgabe selbst kann exponentiell sein |
Die Frage nach der Rekursionstiefe kommt in fast jedem DFS-Interview, halten Sie die Antwort also bereit. DFS rekursiert so tief wie der längste Pfad, dem sie folgt, und auf einem Pfadgraphen ist das V. Das Standardlimit von CPython ist 1000, also bringen ein paar tausend Knoten in einer Reihe es zum Absturz, und ein Gitter aus 1000 mal 1000 Landzellen kann eine Million Ebenen tief rekursieren.
Die Lösung ist die iterative Version aus Abschnitt 2, nicht sys.setrecursionlimit, das nur eine saubere Exception in einen echten Stacküberlauf verwandelt. Sagen Sie das ausdrücklich. Der Speicherbedarf O(V) ist dieser Stack, und der ehrliche Vergleich mit BFS lautet: DFS hält einen Pfad von der Wurzel zu einem Blatt, BFS eine ganze Schicht. Keiner ist durchweg kleiner, es hängt davon ab, ob der Graph tief oder breit ist. Aho, Hopcroft und Ullman liefern die Gesamtanalyse, Sedgewick und Wayne die kürzeste klare Darstellung.
12. Fehler, an denen das Interview scheitert
Sortiert nach Häufigkeit; die ersten drei erklären die meisten abgelehnten Lösungen.
- Eine einzige Besucht-Menge für gerichtete Zykelerkennung. Einen Knoten erneut zu sehen, ist kein Zyklus. Grau (auf dem Stack) muss sich von schwarz (abgeschlossen) unterscheiden, sonst meldet jeder DAG mit zwei Wegen zu einem Knoten einen.
- Drei Farben für ungerichtete Zykelerkennung verwenden. Der umgekehrte Fehler. Jede Kante sieht wie eine Rückwärtskante aus, wenn Sie nicht die überspringen, über die Sie gekommen sind.
- Rekursion auf Eingaben, die groß sein können. Ein Gitter mit einer Million Zellen rekursiert eine Million Ebenen tief. Bieten Sie die iterative Version an, bevor man Sie fragt.
- Die topologische Ordnung in Preorder aufbauen. Es muss Postorder sein, angehängt beim Abschluss des Knotens und dann umgekehrt. Preorder erzeugt etwas, das wie eine Antwort aussieht und keine ist.
- Beim Backtracking das Rückgängigmachen vergessen. Das
path.pop()oder das Wiederherstellen der Gitterzelle. Ohne es vergiftet der erste gescheiterte Zweig jeden späteren. - Die lebende Liste statt einer Kopie speichern.
out.append(path)liefert eine Liste von Referenzen auf eine einzige veränderte Liste. Es musspath[:]sein. - Verwechseln von
>und>=im Low-Link-Test.low[v] > disc[u]ist eine Brücke,>=ein Artikulationspunkt. Ein Zeichen Unterschied. - Die äußere Schleife über die Komponenten weglassen. Zykelerkennung, Komponentenzählung und SZK brauchen alle eine DFS, die von jedem unbesuchten Knoten neu startet.
- Nicht nach der Eingabe fragen. Gerichtet oder ungerichtet? Zusammenhängend? Schleifen oder Mehrfachkanten? Jede Antwort ändert den Code, und Skienas Punkt gilt: Probleme werden in der Modellierung gewonnen.
Die Gewohnheit, die die meisten davon verhindert: Benennen Sie vor dem Schreiben das zusätzliche Array. Farbe, Elternknoten, Abschlussreihenfolge oder Low-Link. DFS-Fragen unterscheiden sich durch dieses Array, nicht durch die Traversierung, und es zuerst zu benennen, macht den Rest mechanisch. McDowell argumentiert allgemein genauso; hier ist es ungewöhnlich wörtlich zu nehmen.
13. Häufig gestellte Fragen
Wann sollte ich zu DFS statt zu BFS greifen?
+
Wenn es um Reihenfolge, Abhängigkeiten, Zyklen oder darum geht, was kaputtgeht, wenn etwas entfernt wird. All das erfordert zu wissen, wann ein Knoten abgeschlossen ist oder ob er noch auf dem Stack liegt, und nur DFS liefert das. Fragt die Aufgabe nach der geringsten Anzahl von irgendetwas, nehmen Sie BFS: DFS findet einen Pfad, nicht den kürzesten.
Warum brauche ich für gerichtete Zykelerkennung drei Farben?
+
Weil eine einfache Besucht-Menge einen Vorfahren nicht von einem abgeschlossenen Knoten unterscheiden kann. Grau bedeutet noch auf dem Rekursionsstack, also schließt eine Kante zu einem grauen Knoten eine Schleife und ist ein echter Zyklus. Schwarz bedeutet abgeschlossen, und eine Kante zu einem schwarzen Knoten ist nur ein zweiter Weg in einen bereits erkundeten Teil des Graphen, was in einem DAG erlaubt ist.
Warum ergibt die umgekehrte DFS-Postorder eine topologische Sortierung?
+
Weil ein Knoten erst abgeschlossen wird, nachdem alles von ihm Erreichbare abgeschlossen ist, also immer später als seine Nachfolger. Die umgekehrte Abschlussreihenfolge stellt daher jeden Knoten vor alles, worauf er zeigt, und das ist die topologische Bedingung. Hängen Sie in Postorder an, also beim Abschluss des Knotens, nicht bei seiner Entdeckung.
Was ist ein Low-Link-Wert?
+
Für einen Knoten u ist es die kleinste Entdeckungszeit, die vom Teilbaum von u aus über Baumkanten plus höchstens eine Nicht-Baumkante erreichbar ist. Er beantwortet die Frage „kann irgendetwas unter u ohne die Kante zu seinem Elternknoten wieder über u gelangen“. Wenn nicht, ist diese Kante eine Brücke. Er ist das eine zusätzliche Array, das aus einer gewöhnlichen DFS einen Algorithmus für Brücken, Artikulationspunkte und Tarjans starke Zusammenhangskomponenten macht.
Wie tief kann rekursive DFS gehen, bevor sie abstürzt?
+
So tief wie der längste Pfad, dem sie folgt, und auf einem Pfadgraphen ist das die Anzahl der Knoten. Das Standardlimit von CPython ist 1000, also bringen ein paar tausend Knoten in einer Reihe sie zum Absturz, und ein Gitter aus 1000 mal 1000 Landzellen rekursiert eine Million Ebenen tief. Schreiben Sie sie iterativ um, statt das Limit zu erhöhen, was nur eine saubere Exception in einen echten Stacküberlauf verwandelt.
Ist iterative DFS dasselbe wie rekursive DFS mit einem Stack?
+
Nicht ganz. Die einfache Stack-Version besucht Nachbarn in umgekehrter Reihenfolge, also legen Sie sie umgekehrt ab, damit es übereinstimmt, und sie muss die Besucht-Menge beim Entnehmen wie beim Ablegen prüfen, da ein Knoten mehrmals auf dem Stack liegen kann. Wichtiger noch: Sie hat keine Postorder, also brauchen topologische Sortierung, starke Zusammenhangskomponenten und Low-Link-Algorithmen eine Version, die jeden Knoten zweimal ablegt oder einen Kindindex mitführt.
Brauche ich eine Besucht-Menge, wenn ich alle Pfade aufzähle?
+
Nein, und eine hinzuzufügen, ist ein häufiger Fehler. Sie zählen Pfade statt Knoten auf, also kommt derselbe Knoten zu Recht in vielen Pfaden vor, und eine globale Besucht-Menge liefert stillschweigend nur einige davon. Was Sie brauchen, ist der aktuelle Pfad, auf dem Rückweg mit einem pop rückgängig gemacht. Auf einem zyklischen Graphen schließen Sie Knoten aus, die bereits auf diesem Pfad liegen, und das ist keine globale Menge.
14. Literatur
Die Arbeiten, die diese Techniken eingeführt haben, und die Lehrbücher, die sie analysieren, in chronologischer Reihenfolge.
- Lucas, É. (1882). Récréations Mathématiques, Band 1. Gauthier-Villars. (Hält Trémaux' systematische Regel zum Durchqueren von Labyrinthen fest, die früheste Beschreibung der Tiefensuche.)
- Tarjan, R. E. (1972). “Depth-first search and linear graph algorithms.” SIAM Journal on Computing, 1(2), 146–160.
- Hopcroft, J. und Tarjan, R. E. (1973). “Algorithm 447: efficient algorithms for graph manipulation.” Communications of the ACM, 16(6), 372–378.
- Aho, A. V., Hopcroft, J. E. und Ullman, J. D. (1974). The Design and Analysis of Computer Algorithms. Addison-Wesley.
- Tarjan, R. E. (1976). “Edge-disjoint spanning trees and depth-first search.” Acta Informatica, 6(2), 171–185.
- Sharir, M. (1981). “A strong-connectivity algorithm and its applications in data flow analysis.” Computers & Mathematics with Applications, 7(1), 67–72.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. und Stein, C. (2009). Introduction to Algorithms, 3. Auflage, Abschnitt 22.3. MIT Press.
- Sedgewick, R. und Wayne, K. (2011). Algorithms, 4. Auflage, Abschnitte 4.1 bis 4.2. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6. Auflage. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3. Auflage, Kapitel 5. Springer.