
Inhaltsverzeichnis
- 1. Was eine BFS-Frage wirklich prüft
- 2. Die Vorlage, die Sie auswendig schreiben
- 3. Kürzester Weg in einem ungewichteten Graphen
- 4. Anzahl der Inseln
- 5. Faule Orangen: Multi-Source-BFS
- 6. Word Ladder: implizite Graphen und Treffen in der Mitte
- 7. Level-Order-Traversierung eines Binärbaums
- 8. 0-1-BFS: wenn BFS Dijkstra schlägt
- 9. Ist der Graph bipartit?
- 10. Course Schedule: topologische Sortierung mit BFS
- 11. Die Komplexitätsantworten, die Interviewer erwarten
- 12. Fehler, an denen das Interview scheitert
- 13. Häufig gestellte Fragen
- 14. Literatur
1. Was eine BFS-Frage wirklich prüft
Kaum jemand soll „BFS implementieren“. Sie bekommen ein Problem, das nicht nach einem Graphen aussieht, und das Interview fragt drei Dinge: Können Sie den Graphen sehen, wissen Sie, dass BFS das Werkzeug ist, und können Sie es ohne Fehler schreiben?
Das Signal ist das Wort wenigste oder ein Synonym: minimale Schritte, kürzeste Umwandlung, früheste Minute, nächster Ausgang. BFS beantwortet diese Fragen, und zwar nur dann, wenn jeder Schritt gleich viel kostet. Diese Bedingung ist das ganze Spiel: Kosten alle Schritte gleich viel, liefert BFS das exakte Minimum in O(V + E); tun sie das nicht, ist BFS schlicht falsch, und genau zu diesem Fehler soll die Frage verleiten.
Die acht folgenden Fragen sind die, die immer wiederkehren. Jede wird so präsentiert, wie sie abläuft: das Problem, die Lösung, die Nachfrage, die der Interviewer als Nächstes stellt, und der Fehler, der das Angebot kostet. Jedes Rechenbeispiel wurde per Skript ausgeführt.
2. Die Vorlage, die Sie auswendig schreiben
Eine Vorlage deckt jede Frage hier ab. Sie sollten sie in zwei Minuten ohne Nachdenken hinschreiben können, denn die Interviewzeit gehört der Modellierung, nicht dem Tippen.
from collections import deque

def bfs(start, neighbours):
    dist = {start: 0}
    q = deque([start])
    while q:
        u = q.popleft()
        for v in neighbours(u):
            if v not in dist:          # beim EINREIHEN markieren, nie beim Entnehmen
                dist[v] = dist[u] + 1
                q.append(v)
    return dist
Vier Details trennen einen sauberen Durchlauf von einem wackligen.
- Markieren Sie beim Einreihen als besucht, nicht beim Entnehmen. Markieren beim Entnehmen lässt einen Knoten einmal pro eingehender Frontkante einreihen, und die Warteschlange wächst auf
O(E). Die Abstände bleiben korrekt, also besteht der Code die Tests und fällt im Review durch. - Verwenden Sie eine echte Warteschlange.
deque.popleft()istO(1);list.pop(0)istO(n)und macht einen linearen Algorithmus stillschweigend quadratisch. - Die Abstandstabelle dient zugleich als Besucht-Menge. Zwei Strukturen, wo eine genügt, sind zwei Gelegenheiten, eine Aktualisierung zu vergessen.
neighboursist eine Funktion, keine Datenstruktur. Genau deshalb lösen dieselben acht Zeilen unverändert ein Gitter, ein Worträtsel und einen Zustandsraum. Die meisten Interviewgraphen werden nie explizit aufgebaut, ein Punkt, der ausführlich behandelt wird unter Graphdarstellung.
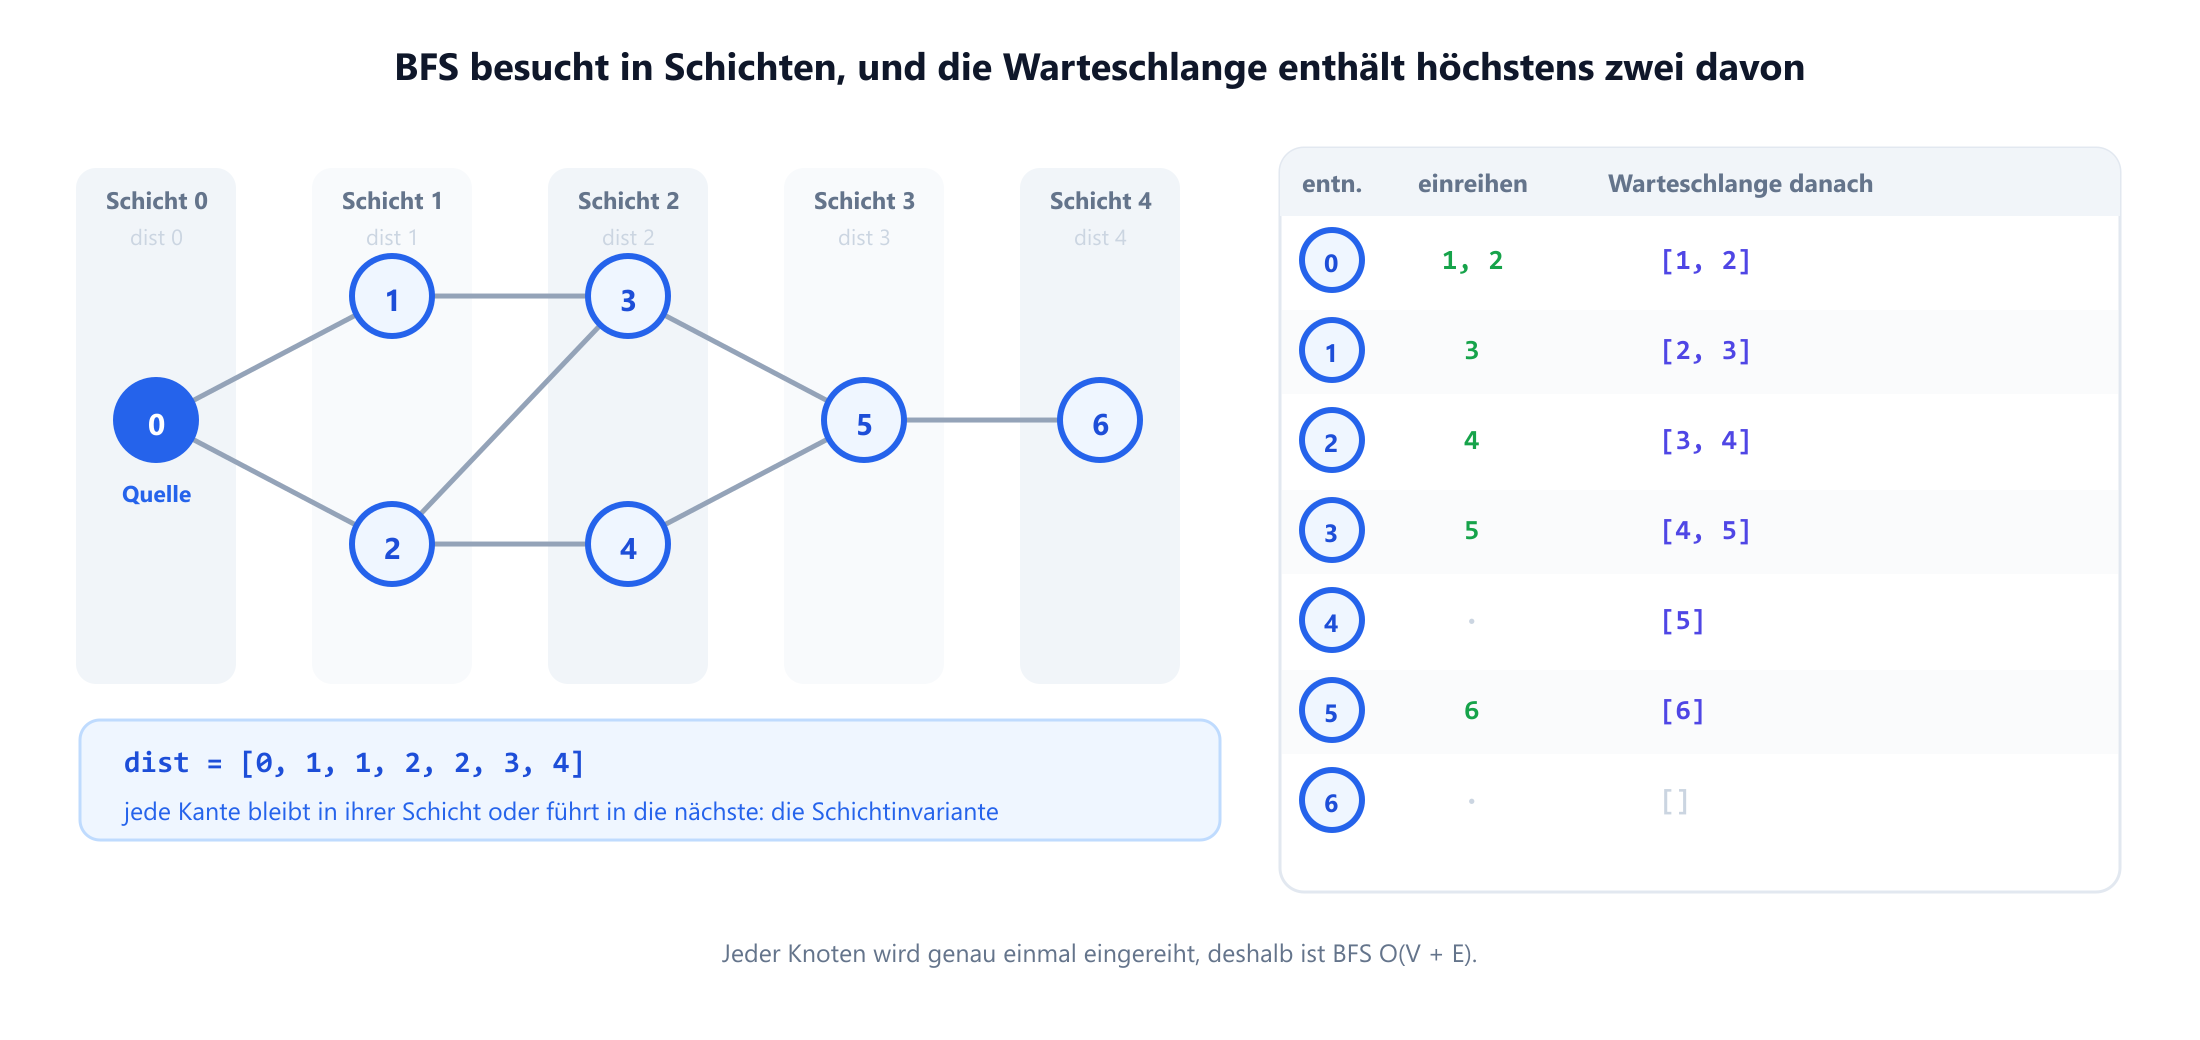
Die Eigenschaft, die das alles trägt, ist die Schichtinvariante: Jede Kante verbindet Knoten derselben Schicht oder benachbarter Schichten und überspringt nie eine. Alle acht Kanten oben erfüllen sie, und sie ist der Grund, warum BFS jeden Knoten beim ersten Erreichen über einen kürzesten Weg erreicht. Sagen Sie das laut: „BFS findet den kürzesten Weg“ ohne Begründung klingt auswendig gelernt.
3. Kürzester Weg in einem ungewichteten Graphen
Die Frage. Gegeben ein ungewichteter Graph und zwei Knoten: Geben Sie die Länge des kürzesten Weges und den Weg selbst zurück.
Der Grundfall. Die einzige Ergänzung zur Vorlage ist ein Elternzeiger.
def shortest_path(adj, src, dst):
    dist, parent = {src: 0}, {src: None}
    q = deque([src])
    while q:
        u = q.popleft()
        if u == dst:                     # früher Abbruch: beim ENTNEHMEN stoppen
            break
        for v in adj[u]:
            if v not in dist:
                dist[v] = dist[u] + 1
                parent[v] = u
                q.append(v)
    if dst not in dist:
        return None
    path, cur = [], dst
    while cur is not None:
        path.append(cur)
        cur = parent[cur]
    return dist[dst], path[::-1]
Auf dem Graphen der Abbildung liefert das den Abstand 4 und den Weg 0 → 1 → 3 → 5 → 6. Sagen Sie ungefragt, dass es ein kürzester Weg ist, nicht der kürzeste: 0 → 2 → 3 → 5 → 6 ist genauso kurz, und welchen Sie erhalten, hängt von der Reihenfolge der Adjazenzlisten ab.
Die Nachfrage: Können Sie früh abbrechen? Ja, und die Feinheit liegt darin, wo. Das Ziel beim Entnehmen zu prüfen, ist immer korrekt. Beim Einreihen zu prüfen, funktioniert bei einfacher BFS ebenfalls und spart eine Schicht, ist aber nicht mehr korrekt, sobald Gewichte ins Spiel kommen. Die Prüfung beim Entnehmen ist also die Gewohnheit, die sich lohnt. Der schlimmste Fall bleibt unverändert bei O(V + E).
Die Falle. Wenn der Interviewer sagt „jetzt haben die Kanten Gewichte“, flicken Sie nicht an BFS herum. Wechseln Sie zum Dijkstra-Algorithmus oder, wenn die Gewichte nur 0 und 1 sind, zum Deque-Trick aus Abschnitt 8. Wer BFS Knoten mehrfach besuchen lässt, um mit Gewichten klarzukommen, schreibt versehentlich einen langsamen, fehlerhaften Bellman-Ford.
4. Anzahl der Inseln
Die Frage. Gegeben ein Gitter aus '1' (Land) und '0' (Wasser): Zählen Sie die zusammenhängenden Landgruppen. Diagonalen verbinden nicht.
Es gibt keinen expliziten Graphen, und genau darum geht es. Knoten sind Landzellen, Kanten sind gemeinsame Seiten. Eine Zelle hat also höchstens vier Nachbarn, und Sie bauen nie eine Adjazenzstruktur auf.
def num_islands(grid):
    if not grid: return 0
    R, C = len(grid), len(grid[0])
    seen, count = set(), 0
    for i in range(R):
        for j in range(C):
            if grid[i][j] != '1' or (i, j) in seen:
                continue
            count += 1
            seen.add((i, j))
            q = deque([(i, j)])
            while q:
                r, c = q.popleft()
                for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
                    a, b = r + dr, c + dc
                    if 0 <= a < R and 0 <= b < C \
                       and grid[a][b] == '1' and (a, b) not in seen:
                        seen.add((a, b))
                        q.append((a, b))
    return count
Jede Zelle wird höchstens einmal eingereiht und verursacht konstanten Aufwand, also ist das O(R × C) Zeit. Der Speicher besteht aus Besucht-Menge und Warteschlange, im schlimmsten Fall ebenfalls O(R × C), nämlich wenn das Gitter vollständig aus Land besteht.
Die Nachfrage: BFS oder DFS? Beides funktioniert, denn Sie beschriften Komponenten, statt Abstände zu messen. Bevorzugen Sie BFS aus einem praktischen Grund: Rekursive DFS auf einem Gitter mit 106 Zellen massiven Landes rekursiert eine Million Ebenen tief und sprengt den Stack. Wenn Sie DFS wählen, sagen Sie, dass Sie sie iterativ schreiben würden; dieser Satz ist oft der ganze Sinn der Nachfrage. Der Vergleich steht unter BFS vs. DFS.
Die Falle. Das Eingabegitter zu verändern, also '0' über Land zu schreiben, statt eine Besucht-Menge zu führen, ist eine legitime Optimierung, aber sagen Sie, dass Sie es tun. Die Daten des Aufrufers stillschweigend zu zerstören, ist ein Fehler im Code-Review und keine Raffinesse.
5. Faule Orangen: Multi-Source-BFS
Die Frage. Ein Gitter enthält leere Zellen (0), frische Orangen (1) und faule (2). Jede Minute macht jede faule Orange die orthogonal benachbarten frischen Orangen faul. Geben Sie die Anzahl der Minuten zurück, bis keine frische mehr übrig ist, oder -1, falls das nie passiert.
Diese Frage trennt diejenigen, die BFS auswendig gelernt haben, von denen, die es verstehen. Der Instinkt ist, von jeder faulen Orange aus eine BFS zu starten und die Ergebnisse zu kombinieren, was kompliziert und langsam ist. Die Antwort lautet: alle faulen Orangen vor Beginn der Schleife in die Warteschlange legen. BFS breitet dann eine gemeinsame Wellenfront aus, und jede Zelle wird zuerst von der nächstgelegenen Quelle erreicht.
def oranges_rotting(grid):
    R, C = len(grid), len(grid[0])
    q, fresh = deque(), 0
    for i in range(R):
        for j in range(C):
            if grid[i][j] == 2: q.append((i, j, 0))
            elif grid[i][j] == 1: fresh += 1

    minutes = 0
    while q:
        r, c, t = q.popleft()
        minutes = max(minutes, t)
        for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
            a, b = r + dr, c + dc
            if 0 <= a < R and 0 <= b < C and grid[a][b] == 1:
                grid[a][b] = 2                  # beim Einreihen markieren
                fresh -= 1
                q.append((a, b, t + 1))
    return -1 if fresh else minutes
Durchgerechnet auf diesem Gitter:
2 1 1 0          Minute des Verfaulens:      0  1  2  .
1 1 0 2                                      1  2  .  0
0 1 1 1                                      .  3  2  1

zwei Quellen, 7 frische Orangen, 0 übrig, Antwort = 3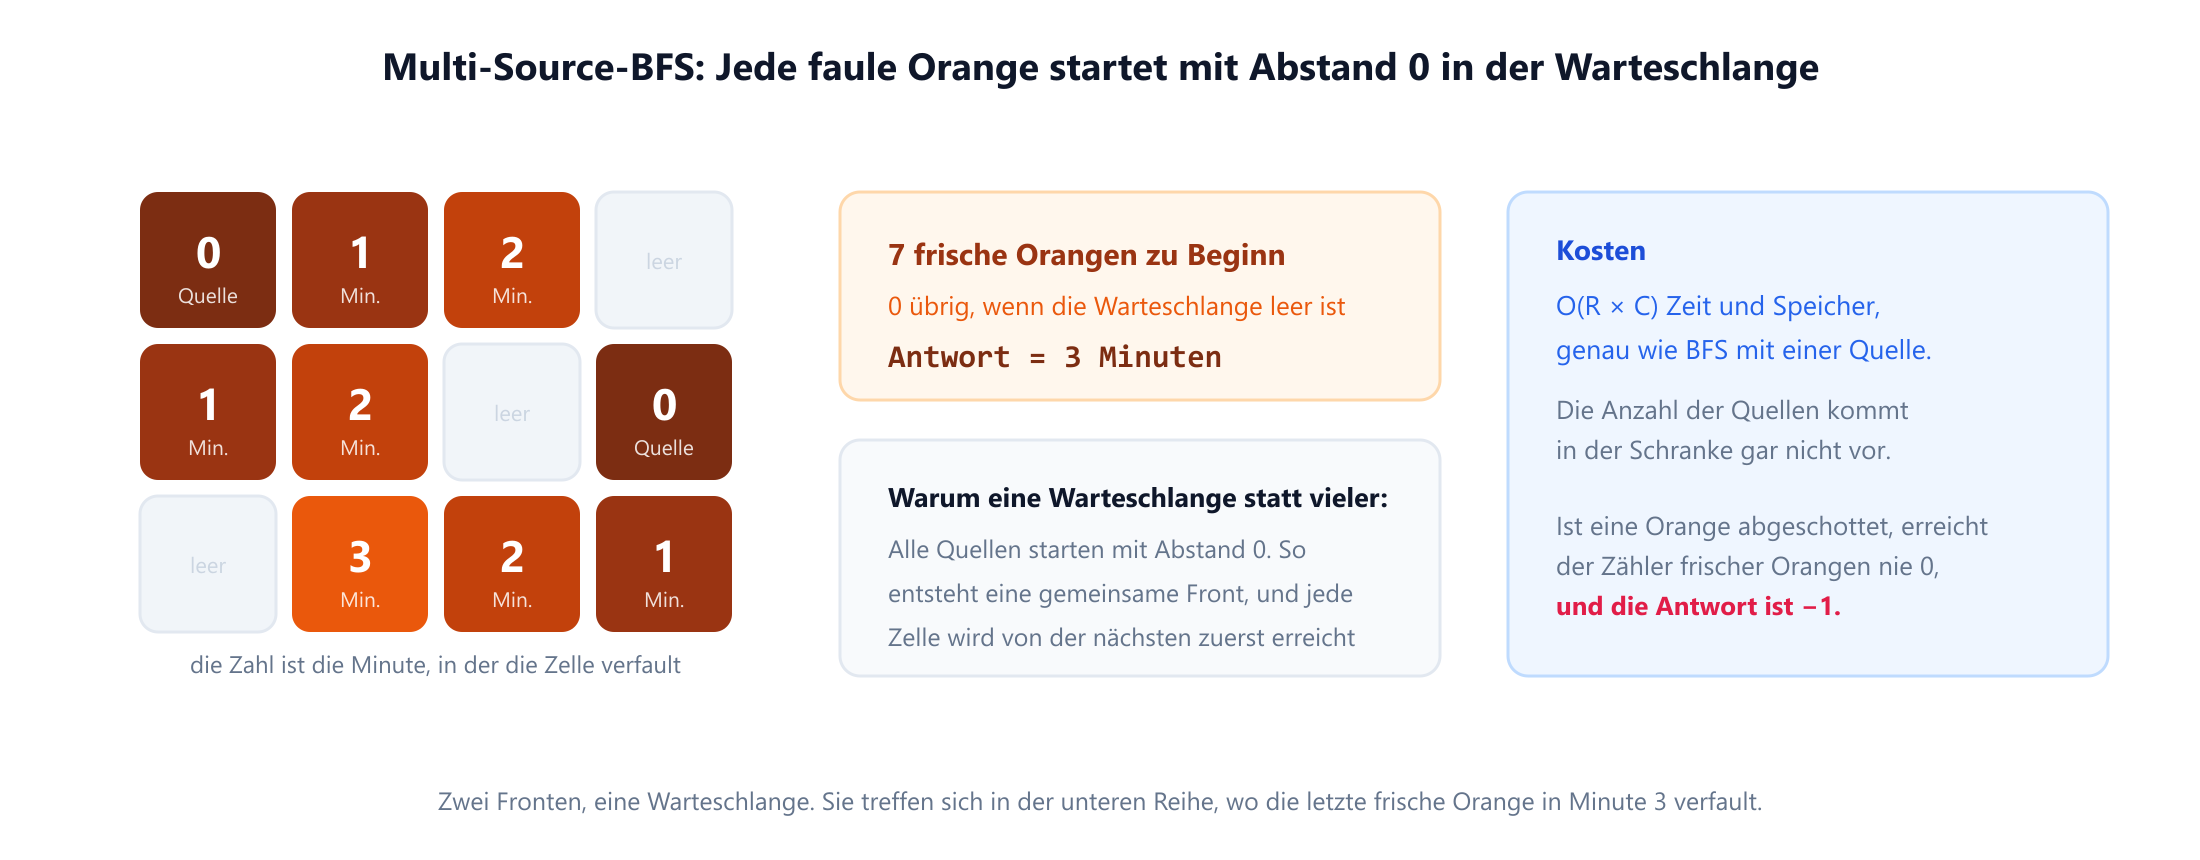
Die Komplexität ist O(R × C), unabhängig von der Anzahl der Quellen. Dass Multi-Source-BFS genauso viel kostet wie BFS mit einer Quelle, ist die Einsicht, die geprüft wird.
Die Nachfrage: Was, wenn eine Orange nie verfaulen kann? Das ist der Fall -1, und der Grund, warum der Zähler fresh existiert. Erkennen Sie ihn nicht, indem Sie besuchte Zellen mit der Gittergröße vergleichen: Leere Zellen sind keine Orangen, und die Rechnung geht schief. Zählen Sie die frischen Orangen vorab, dekrementieren Sie bei jedem Verfaulen und prüfen Sie den Rest. Leeren Sie die beiden Zellen neben der Orange unten links, dann ist sie abgeschottet, eine bleibt frisch und die Antwort ist -1.
Die Falle. Das leere Gitter. Null frische und null faule Orangen sollten 0 ergeben, und ein Off-by-one-Fehler, der 1 liefert, ist die häufigste falsche Einreichung.
6. Word Ladder: implizite Graphen und Treffen in der Mitte
Die Frage. Gegeben ein Startwort, ein Zielwort und ein Wörterbuch: Finden Sie die Länge der kürzesten Kette, bei der jeder Schritt genau einen Buchstaben ändert und jedes Zwischenwort im Wörterbuch steht.
Der Graph hat einen Knoten pro Wörterbuchwort und eine Kante zwischen Wörtern, die sich an einer Position unterscheiden. Ihn explizit aufzubauen kostet O(N2 L) Zeit, und das ist die langsame Lösung, die die meisten Kandidaten zuerst schreiben. Die schnelle baut ihn nie auf: Sie erzeugt Nachbarn bei Bedarf, indem sie an jeder der L Positionen alle 26 Buchstaben ausprobiert und gegen eine Hash-Menge prüft, genau wie der Code unten. Eine Ersetzung pro Position erzeugt das Wort selbst, und die Besucht-Prüfung verwirft es. Bei Wörtern mit zehn Buchstaben sind das 260 Abfragen pro Knoten, unabhängig von der Größe des Wörterbuchs.
def ladder_length(begin, end, word_list):
    words = set(word_list)
    if end not in words: return 0
    q, dist = deque([begin]), {begin: 1}
    while q:
        w = q.popleft()
        if w == end: return dist[w]
        for i in range(len(w)):
            for ch in "abcdefghijklmnopqrstuvwxyz":
                nxt = w[:i] + ch + w[i+1:]
                if nxt in words and nxt not in dist:
                    dist[nxt] = dist[w] + 1
                    q.append(nxt)
    return 0
Die Nachfrage: Machen Sie es schneller. Die erwartete Antwort ist bidirektionale BFS, 1971 von Pohl eingeführt: gleichzeitig vorwärts vom Start und rückwärts vom Ziel suchen, immer die kleinere Front expandieren und anhalten, wenn sie sich treffen. Eine einseitige Suche bis zur Tiefe d mit Verzweigungsfaktor b berührt etwa bd Knoten; zwei Suchen der Tiefe d/2 berühren 2bd/2. Das halbiert den Exponenten, statt nur einen konstanten Faktor zu sparen.
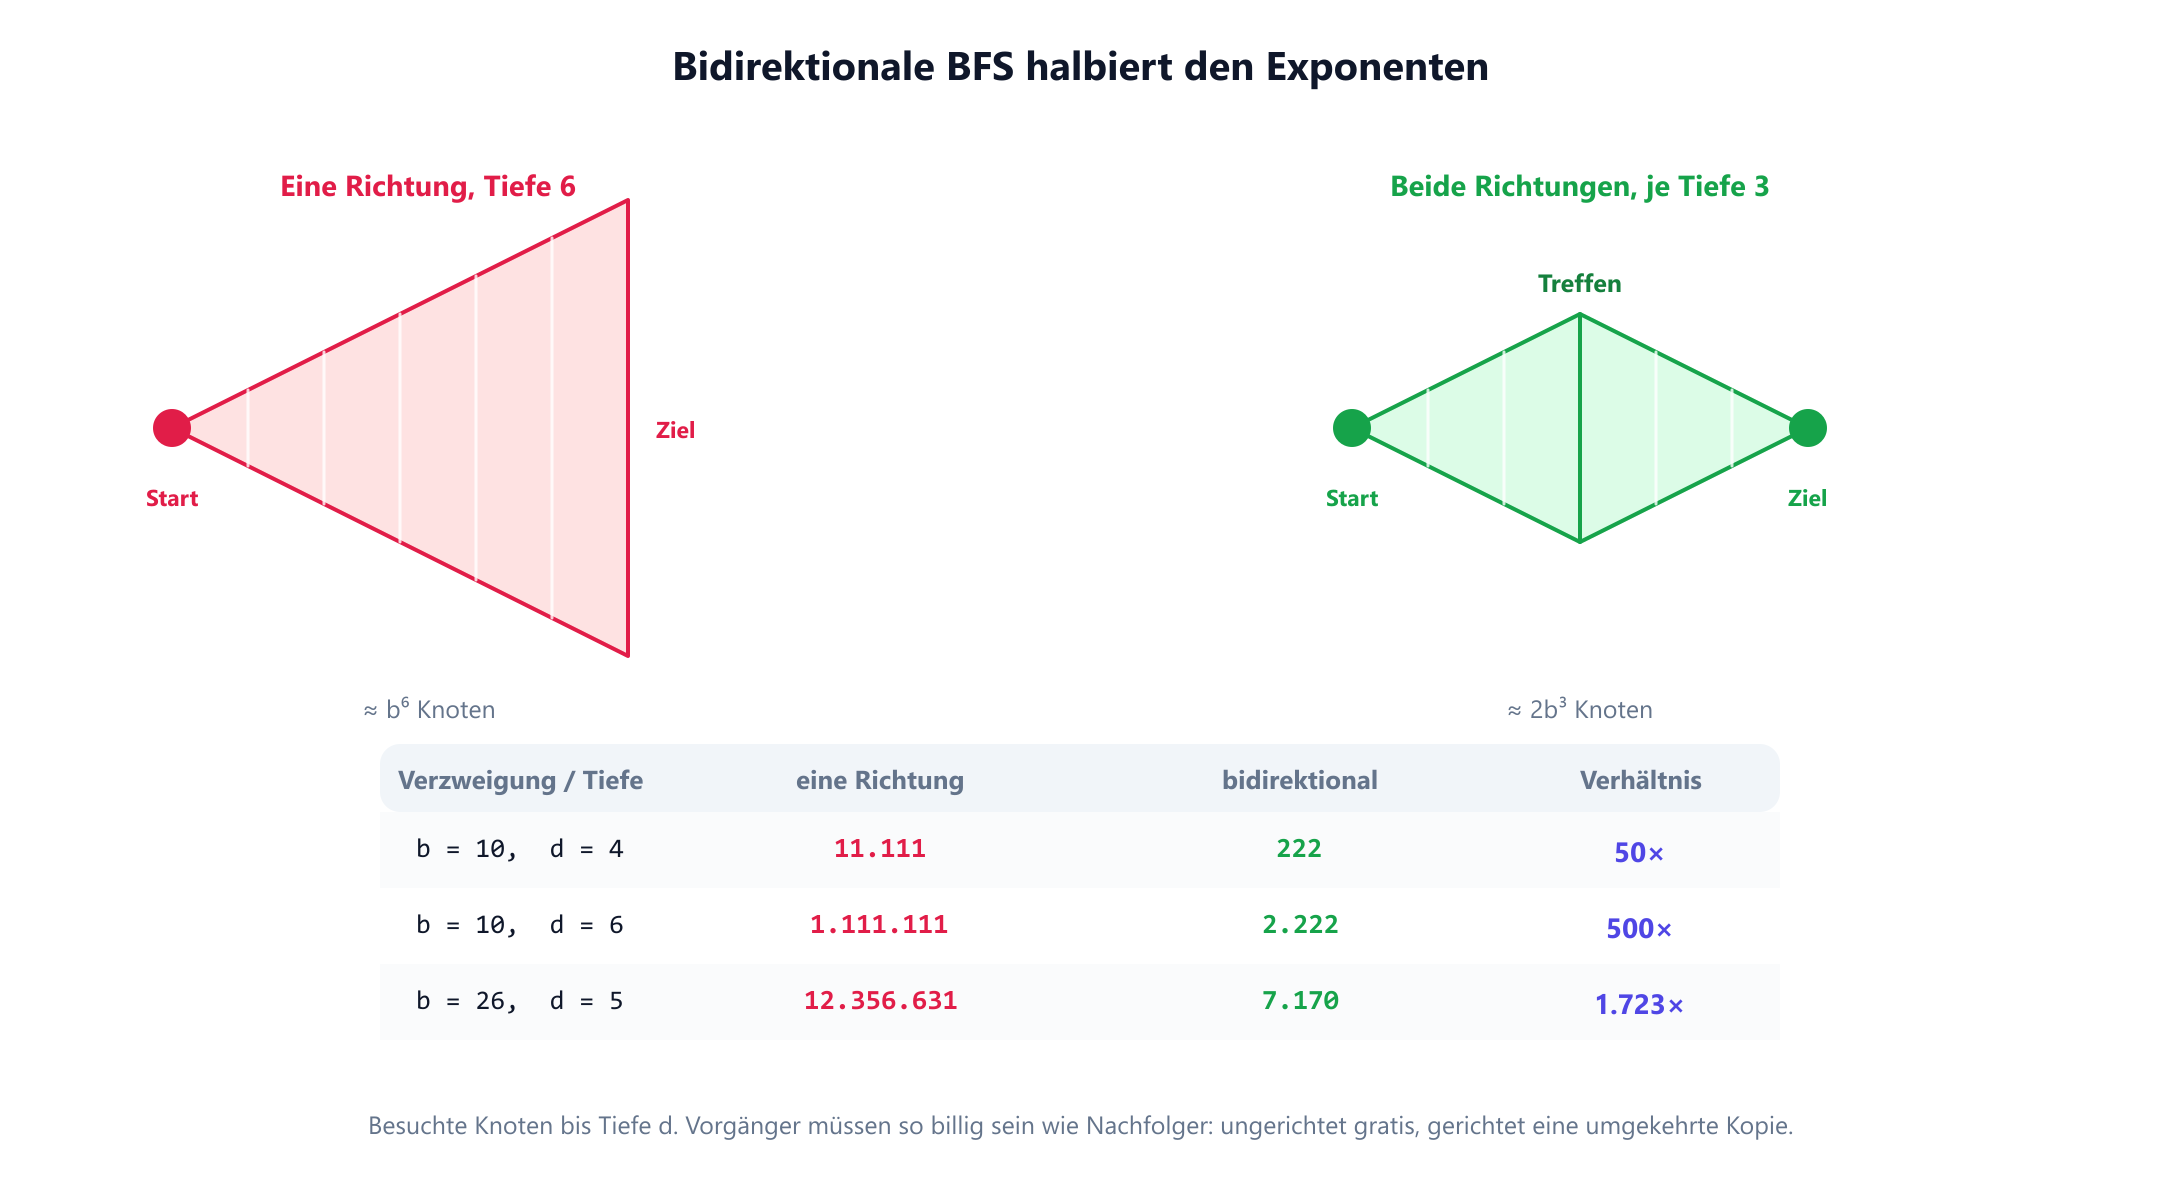
Je tiefer die Antwort liegt, desto mehr bringt das.
Die Falle. Bidirektionale BFS braucht Vorgänger genauso billig wie Nachfolger: hier gratis, da die Relation symmetrisch ist, auf einem gerichteten Graphen aber eine umgekehrte Kopie. Auch der Treffpunkt verlangt Sorgfalt. Die Antwort ist die Summe der beiden Tiefen, und sofort anzuhalten, wenn ein Knoten in beiden Besucht-Mengen auftaucht, ist nur korrekt, wenn Sie jeweils eine ganze Schicht expandieren.
7. Level-Order-Traversierung eines Binärbaums
Die Frage. Geben Sie die Werte eines Binärbaums nach Tiefe gruppiert zurück, eine Liste pro Ebene.
Die einzige neue Idee ist, jeweils eine ganze Schicht zu verarbeiten, und der Trick besteht darin, die Länge der Warteschlange vor der inneren Schleife festzuhalten.
def level_order(root):
    if not root: return []
    out, q = [], deque([root])
    while q:
        level = []
        for _ in range(len(q)):        # ZUERST die Schichtgröße festhalten
            node = q.popleft()
            level.append(node.val)
            if node.left:  q.append(node.left)
            if node.right: q.append(node.right)
        out.append(level)
    return out
Dass len(q) im Aufruf von range erfasst wird, lässt das Ganze funktionieren: Die Schleife läuft genau so oft, wie Knoten auf der Ebene waren, obwohl die Warteschlange währenddessen wächst. Die Länge innerhalb der Schleife zu lesen, verschmilzt Ebenen stillschweigend, und das ist hier der klassische Fehler.
Ein Baum braucht keine Besucht-Menge: keine Zyklen, ein Elternknoten pro Knoten. Sagen Sie, dass Sie sie weglassen, weil die Eingabe ein Baum ist, denn sie auf einem Graphen stillschweigend wegzulassen, führt zu einer Endlosschleife.
Die Nachfragen. Zickzack-Reihenfolge kehrt level auf ungeraden Tiefen um, statt rückwärts einzureihen. Die Ansicht von rechts ist das letzte Element jeder Ebene. Die minimale Tiefe ist die Tiefe des ersten entnommenen Blattes, und hier schlägt BFS die DFS tatsächlich, die den ganzen Baum durchsuchen muss.
8. 0-1-BFS: wenn BFS Dijkstra schlägt
Die Frage. Jede Kante hat Gewicht 0 oder 1; finden Sie den kürzesten Abstand von einer Quelle. Varianten tauchen als Gitter auf, in dem manche Züge kostenlos sind, oder als „minimale Anzahl einzureißender Wände“.
Dijkstra löst das in O(E log V) und wird akzeptiert. Die Antwort, auf die es ankommt, läuft in O(V + E): Verwenden Sie eine doppelseitige Warteschlange und legen Sie einen relaxierten Knoten über eine Kante mit Gewicht 0 nach vorne und über eine Kante mit Gewicht 1 nach hinten. Die Deque enthält dann höchstens zwei verschiedene Abstandswerte gleichzeitig, und das ist genau die Ordnung, die eine Prioritätswarteschlange geliefert hat.
def zero_one_bfs(adj, src, n):        # adj[u] = [(v, w), ...] mit w in {0, 1}
    dist = [float('inf')] * n
    dist[src] = 0
    dq = deque([src])
    while dq:
        u = dq.popleft()
        for v, w in adj[u]:
            if dist[u] + w < dist[v]:
                dist[v] = dist[u] + w
                if w == 0: dq.appendleft(v)
                else:      dq.append(v)
    return dist
Auf einem Graphen mit den Kanten 0-1 (Gewicht 1), 0-2 (0), 2-3 (1), 1-3 (0), 3-4 (1) und 2-4 (1) liefert das 0, 1, 0, 1, 1, in exakter Übereinstimmung mit Dijkstra. Einfache BFS liefert 0, 1, 1, 2, 2, falsch für drei der fünf Knoten, weil sie Kanten zählt, statt Gewichte zu summieren. Dieser Kontrast zeigt am klarsten, was BFS tatsächlich optimiert.
Die Technik gehört zur Familie der Label-Correcting-Verfahren, deren allgemeine Form Bertsekas 1993 formuliert hat. Ein struktureller Unterschied zur gewöhnlichen BFS ist wichtig: Ein Knoten kann mehr als einmal relaxiert werden, also ist die Schutzbedingung ein Abstandsvergleich und keine Besucht-Prüfung.
Die Falle. Der Fehler: if v not in visited statt if dist[u] + w < dist[v]. Die Besucht-Prüfung lässt den ersten Ankömmling gewinnen, und über eine Kante mit Gewicht 0 muss der erste Ankömmling nicht der beste sein. Der Code läuft trotzdem und liefert plausible Zahlen.
9. Ist der Graph bipartit?
Die Frage. Lassen sich die Knoten so in zwei Mengen aufteilen, dass jede Kante zwischen ihnen verläuft? Im Interview formuliert als „teilen Sie diese Leute so auf, dass keine zwei Feinde in derselben Gruppe sind“ oder „ist dieser Graph 2-färbbar“.
Färben Sie die Quelle mit 0, jeden Nachbarn mit der entgegengesetzten Farbe, und brechen Sie ab, sobald Sie auf einen Nachbarn treffen, der bereits Ihre eigene Farbe trägt.
def is_bipartite(adj, n):
    colour = [-1] * n
    for s in range(n):
        if colour[s] != -1: continue      # eine neue Komponente
        colour[s] = 0
        q = deque([s])
        while q:
            u = q.popleft()
            for v in adj[u]:
                if colour[v] == -1:
                    colour[v] = 1 - colour[u]
                    q.append(v)
                elif colour[v] == colour[u]:
                    return False
    return True
Die saubere Erklärung: Die Farbe ist die Parität der BFS-Schicht. Ein Konflikt bedeutet, dass eine Kante zwei Knoten derselben Schicht verbindet und damit einen Zyklus ungerader Länge schließt, und ein Graph ist genau dann bipartit, wenn er keinen ungeraden Zyklus hat. Der 4-Zyklus ist bipartit, der 5-Zyklus nicht, und der Algorithmus bestätigt beides.
Die Falle, an der mehr Einreichungen scheitern als an jeder anderen: die äußere Schleife for s in range(n). Ein nicht zusammenhängender Graph verlangt, BFS von jedem ungefärbten Knoten neu zu starten. Eine Lösung, die nur bei Knoten 0 beginnt, besteht jeden zusammenhängenden Test und scheitert, sobald es zwei Komponenten gibt. Komponenten zählen und Zyklen erkennen brauchen dieselbe Schleife.
10. Course Schedule: topologische Sortierung mit BFS
Die Frage. Gegeben n Kurse und eine Liste von Voraussetzungspaaren: Können alle Kurse belegt werden? Die Nachfrage verlangt eine gültige Reihenfolge.
Das ist Zykelerkennung auf einem gerichteten Graphen, und die BFS-Antwort ist Kahns Algorithmus (1962): Wiederholt einen Knoten ohne verbleibende Voraussetzungen nehmen, ihn entfernen und den Eingangsgrad seiner Nachfolger verringern.
def find_order(n, prerequisites):
    adj = [[] for _ in range(n)]
    indeg = [0] * n
    for course, prereq in prerequisites:
        adj[prereq].append(course)
        indeg[course] += 1

    q = deque(i for i in range(n) if indeg[i] == 0)
    order = []
    while q:
        u = q.popleft()
        order.append(u)
        for v in adj[u]:
            indeg[v] -= 1
            if indeg[v] == 0:
                q.append(v)
    return order if len(order) == n else []    # zu kurz == Zyklus
Mit 6 Kursen und den Voraussetzungen 1←0, 2←0, 3←1, 3←2, 4←3, 5←4 plant das alle sechs als 0, 1, 2, 3, 4, 5. Mit der zyklischen Menge 1←0, 2←1, 0←2 plant es keinen: Jeder Knoten beginnt mit Eingangsgrad 1, also ist die anfängliche Warteschlange leer. Ein Test deckt beide Fälle ab, und er ist der Kern der Antwort: Ist die Ausgabe kürzer als n, bilden die übrigen Knoten einen Zyklus.
Die Falle. Die Kantenrichtung umzudrehen. Das Paar [a, b] bedeutet „um a zu belegen, zuerst b belegen“, also verläuft die Kante b → a, und es ist der Eingangsgrad von a, der steigt. Drehen Sie sie um, erhalten Sie eine gültige topologische Ordnung des umgekehrten Graphen: Sie sieht richtig aus, besteht die Zykelprüfung und ist falsch. Sprechen Sie die Richtung laut aus, bevor Sie die Schleife schreiben. Ausführlicher behandelt unter Topologische Sortierung.
Das Gegenstück mit Tiefensuche, mit Zykelerkennung, topologischer Sortierung, starken Zusammenhangskomponenten und Brücken, finden Sie unter DFS-Interviewfragen.
11. Die Komplexitätsantworten, die Interviewer erwarten
Die Hälfte eines BFS-Interviews ist Analyse. Was Sie sagen sollten, und warum:
| Problemform | Zeit | Speicher | Die Begründung |
|---|---|---|---|
| Graph, Adjazenzliste | O(V + E) | O(V) | Jeder Knoten wird einmal eingereiht, jede Kante zweimal geprüft |
| Graph, Adjazenzmatrix | O(V2) | O(V) | Die Nachbarn eines Knotens zu finden, durchläuft eine ganze Zeile |
Gitter, R × C | O(R × C) | O(R × C) | V = RC und E < 2RC, also ist V + E linear in der Zellenzahl |
| Gitter mit mehreren Quellen | O(R × C) | O(R × C) | Unverändert: Quellen säen nur dieselbe einzelne Wellenfront |
Word Ladder, N Wörter der Länge L | O(N × L2 × 26) | O(N × L) | 26L Kandidaten pro Wort, jeder O(L) zum Bauen und Hashen |
Bidirektional, Verzweigung b, Tiefe d | O(bd/2) | O(bd/2) | Zwei Suchen halber Tiefe, also halbiert sich der Exponent |
| 0-1 BFS | O(V + E) | O(V) | Eine Deque ersetzt den Heap, also kein Faktor log. |
Zwei Punkte lohnen sich, wenn Sie sie von selbst ansprechen. Der Speicherbedarf O(V) ist kein Nebeneffekt: BFS hält eine ganze Schicht, und auf einem breiten Graphen ist das der Großteil der Knotenmenge. Das ist der eigentliche Grund, auf tiefen, schmalen Graphen DFS zu bevorzugen, und eine bessere Antwort als „DFS braucht weniger Speicher“, was nicht immer stimmt. Und der Kantenterm ist E im gerichteten, aber 2E im ungerichteten Fall. Cormen, Leiserson, Rivest und Stein liefern die vollständige Analyse, Sedgewick und Wayne die klarste kurze.
BFS wurde zweimal veröffentlicht, bevor es einen Namen hatte: von Moore 1959 für den kürzesten Weg durch ein Labyrinth und von Lee 1961 für das Routing von Leiterplatten. Lees Version ist buchstäblich die Gitter-BFS aus den Abschnitten 4 und 5, weshalb Wegsuche auf Gittern bis heute manchmal Lee-Algorithmus genannt wird.
Sobald die Kanten unterschiedliche Gewichte tragen, wird aus der Warteschlange eine Prioritätswarteschlange; diese Probleme werden durchgearbeitet unter Dijkstra-Interviewfragen.
12. Fehler, an denen das Interview scheitert
Sortiert nach Häufigkeit, nicht nach Schwere. Die ersten drei erklären die meisten abgelehnten Lösungen.
- Beim Entnehmen statt beim Einreihen als besucht markieren. Die Abstände bleiben korrekt, also bestehen die Tests, aber die Warteschlange wächst auf
O(E), und auf einem dichten Graphen ist das der Unterschied zwischen Bestehen und Zeitüberschreitung. - Eine Liste als Warteschlange verwenden.
list.pop(0)und JavaScriptsshift()sindO(n). Verwenden Siecollections.dequeoder in einer Sprache ohne so etwas einen Indexzeiger in ein Array. - Die äußere Schleife über die Komponenten vergessen. Bipartitheitstest, Komponentenzählung und Zykelerkennung starten BFS alle von jedem unbesuchten Knoten neu. Nur bei Knoten 0 zu starten, besteht jeden zusammenhängenden Test und scheitert am ersten nicht zusammenhängenden.
- Auf einem gewichteten Graphen zu BFS greifen. BFS minimiert die Anzahl der Kanten, nicht das Gesamtgewicht. Wenn sich zwei Kanten in ihren Kosten unterscheiden, brauchen Sie Dijkstra oder 0-1-BFS, falls die Gewichte nur 0 und 1 sind.
- Die Länge der Warteschlange innerhalb der Schichtschleife lesen. Bei der Level-Order-Traversierung muss
for _ in range(len(q))die Länge vor der Schleife festhalten, sonst verschmelzen die Ebenen. - Nicht nach der Eingabe fragen. Gerichtet? Zusammenhängend? Schleifen oder Mehrfachkanten? Sind Gitterdiagonalen Nachbarn? Kann der Start gleich dem Ziel sein? Jede dieser Antworten ändert den Code, und Skienas Punkt gilt: Probleme werden in der Modellierung gewonnen, nicht in der Traversierung.
- Die Angabe
O(V + E)ohne Nennung der Darstellung. Die Schranke gehört zur Adjazenzliste. Auf einer Matrix ist derselbe CodeO(V2).
Eine Gewohnheit schlägt alles oben Genannte. Sagen Sie vor dem Schreiben laut, was die Knoten sind, was die Kanten sind und was ein Schritt kostet. Kostet jeder Schritt gleich viel, ist BFS korrekt; wenn nicht, sind Sie der Falle entgangen. McDowell macht denselben Punkt allgemein, und er trifft Graphen am härtesten, weil der Graph so oft verborgen ist.
13. Häufig gestellte Fragen
Woran erkenne ich, dass ein Problem BFS und nicht DFS verlangt?
+
Achten Sie auf das Wort „wenigste“ oder ein Synonym: minimale Schritte, kürzeste Umwandlung, früheste Minute, nächster Ausgang. BFS beantwortet diese Fragen exakt, sofern jeder Schritt gleich viel kostet. Fragt die Aufgabe nur nach Erreichbarkeit oder Zusammenhangskomponenten, funktioniert jede der beiden Traversierungen, und BFS vermeidet tiefe Rekursion bei großen Eingaben.
Warum muss ich einen Knoten beim Einreihen als besucht markieren?
+
Weil ein Knoten zwischen Einreihen und Entnehmen von anderen Knoten derselben Front erneut entdeckt werden kann. Markieren beim Entnehmen lässt ihn einmal pro eingehender Kante einreihen, sodass die Warteschlange O(E) statt O(V) Einträge enthält. Die Abstände stimmen trotzdem, und genau deshalb übersieht man den Fehler leicht.
Was ist Multi-Source-BFS, und wann brauche ich sie?
+
Sie legen vor Beginn der Schleife jede Quelle mit Abstand null in die Warteschlange. BFS breitet eine gemeinsame Wellenfront aus, sodass jede Zelle zuerst von der nächstgelegenen Quelle erreicht wird. Das kostet genauso viel wie BFS mit einer Quelle, O(V + E). Faule Orangen und Probleme mit dem nächsten Ausgang sind die Standardbeispiele.
Kann BFS jemals gewichtete Kanten verarbeiten?
+
Nur wenn jedes Gewicht 0 oder 1 ist. Dann liefert eine doppelseitige Warteschlange, die über eine Kante mit Gewicht null vorne und über eine Kante mit Gewicht eins hinten einfügt, die richtige Antwort in O(V + E) ohne logarithmischen Faktor. Für alle anderen Gewichte ist BFS schlicht falsch, weil sie die Anzahl der Kanten statt des Gesamtgewichts minimiert, und Sie brauchen Dijkstra.
Wie viel schneller ist bidirektionale BFS?
+
Sie halbiert den Exponenten, statt durch eine Konstante zu teilen, und macht aus etwa b hoch d ungefähr 2 mal b hoch d halbe. Bei Verzweigungsfaktor 10 und Tiefe 6 sind das 1.111.111 Knoten gegenüber etwa 2.222, ein Faktor von 500. Sie braucht Vorgänger so billig wie Nachfolger: im ungerichteten Fall gratis, im gerichteten eine umgekehrte Kopie.
Welche Komplexität sollte ich für eine Gitter-BFS angeben?
+
O(R mal C) für Zeit und Speicher. Die Begründung: Das Gitter ist ein Graph mit R mal C Knoten und weniger als 2 R C Kanten, also ist V plus E linear in der Zellenzahl. Der Speicher besteht aus Besucht-Menge und Warteschlange, die einen großen Teil des Gitters gleichzeitig enthalten kann.
Brauche ich eine Besucht-Menge, wenn ich BFS auf einem Baum ausführe?
+
Nein. Ein Baum hat keine Zyklen, und jeder Knoten hat einen Elternknoten, also wird kein Knoten zweimal erreicht, und die Menge würde nie etwas abweisen. Sagen Sie, warum Sie sie weglassen, statt sie stillschweigend wegzulassen: Dieselbe Auslassung auf einem allgemeinen Graphen ist eine Endlosschleife, und der Interviewer kann nicht erkennen, was Sie meinten.
14. Literatur
Die Arbeiten, die diese Techniken eingeführt haben, und die Lehrbücher, die sie analysieren, in chronologischer Reihenfolge.
- Moore, E. F. (1959). “The shortest path through a maze.” Proceedings of an International Symposium on the Theory of Switching, Harvard University Press, 285–292.
- Lee, C. Y. (1961). “An algorithm for path connections and its applications.” IRE Transactions on Electronic Computers, EC-10(3), 346–365.
- Kahn, A. B. (1962). “Topological sorting of large networks.” Communications of the ACM, 5(11), 558–562.
- Pohl, I. (1971). “Bi-directional search.” In Machine Intelligence 6, Edinburgh University Press, 127–140.
- Bertsekas, D. P. (1993). “A simple and fast label correcting algorithm for shortest paths.” Networks, 23(8), 703–709.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. und Stein, C. (2009). Introduction to Algorithms, 3. Auflage, Abschnitt 22.2. MIT Press.
- Sedgewick, R. und Wayne, K. (2011). Algorithms, 4. Auflage, Abschnitt 4.1. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6. Auflage. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3. Auflage, Kapitel 5. Springer.