
Tabla de Contenidos
- 1. Qué evalúa realmente una pregunta de BFS
- 2. La plantilla que debes escribir de memoria
- 3. Camino más corto en un grafo no ponderado
- 4. Número de islas
- 5. Naranjas podridas: BFS multiorigen
- 6. Word ladder: grafos implícitos y encuentro en el medio
- 7. Recorrido por niveles de un árbol binario
- 8. BFS 0-1: cuando BFS supera a Dijkstra
- 9. ¿Es bipartito el grafo?
- 10. Course schedule: ordenación topológica con BFS
- 11. Las respuestas de complejidad que esperan los entrevistadores
- 12. Errores que suspenden la entrevista
- 13. Preguntas frecuentes
- 14. Referencias
1. Qué evalúa realmente una pregunta de BFS
Casi nadie tiene que «implementar BFS». Te dan un problema que no parece un grafo, y la entrevista pregunta tres cosas: ¿sabes ver el grafo, sabes que BFS es la herramienta y puedes escribirlo sin errores?
La señal es la palabra mínimo, o cualquier sinónimo: menos pasos, transformación más corta, primer minuto, salida más cercana. BFS responde a eso, y solo cuando cada paso cuesta lo mismo. Esa condición lo es todo: cuando los pasos cuestan lo mismo, BFS da el mínimo exacto en O(V + E); cuando no, simplemente se equivoca, y recurrir a BFS es justo el error alrededor del cual se construyó la pregunta.
Las ocho de abajo son las que se repiten. Cada una se presenta tal como sucede: el problema, la solución, la pregunta de seguimiento que hace después el entrevistador y el error que te cuesta la oferta. Cada ejemplo resuelto se ejecutó con un script.
2. La plantilla que debes escribir de memoria
Una sola plantilla cubre todas las preguntas de aquí. Deberías poder escribirla en dos minutos sin pensar, porque el tiempo de la entrevista es para modelar, no para teclear.
from collections import deque

def bfs(start, neighbours):
    dist = {start: 0}
    q = deque([start])
    while q:
        u = q.popleft()
        for v in neighbours(u):
            if v not in dist:          # marcar AL ENCOLAR, nunca al desencolar
                dist[v] = dist[u] + 1
                q.append(v)
    return dist
Cuatro detalles separan una ejecución limpia de una tambaleante.
- Marca como visitado al encolar, no al desencolar. Marcar al desencolar permite que un vértice se encole una vez por cada arista de la frontera que llega a él, y la cola crece hasta
O(E). Las distancias siguen siendo correctas, así que pasa las pruebas y suspende la revisión. - Usa una cola de verdad.
deque.popleft()esO(1);list.pop(0)esO(n)y convierte en silencio un algoritmo lineal en cuadrático. - El mapa de distancias sirve también como conjunto de visitados. Dos estructuras donde basta una son dos oportunidades de olvidar una actualización.
neighbourses una función, no una estructura de datos. Eso es lo que permite que las mismas ocho líneas resuelvan sin cambios una cuadrícula, un juego de palabras y un espacio de estados. La mayoría de los grafos de entrevista nunca llegan a materializarse, algo que se desarrolla en representación de grafos.
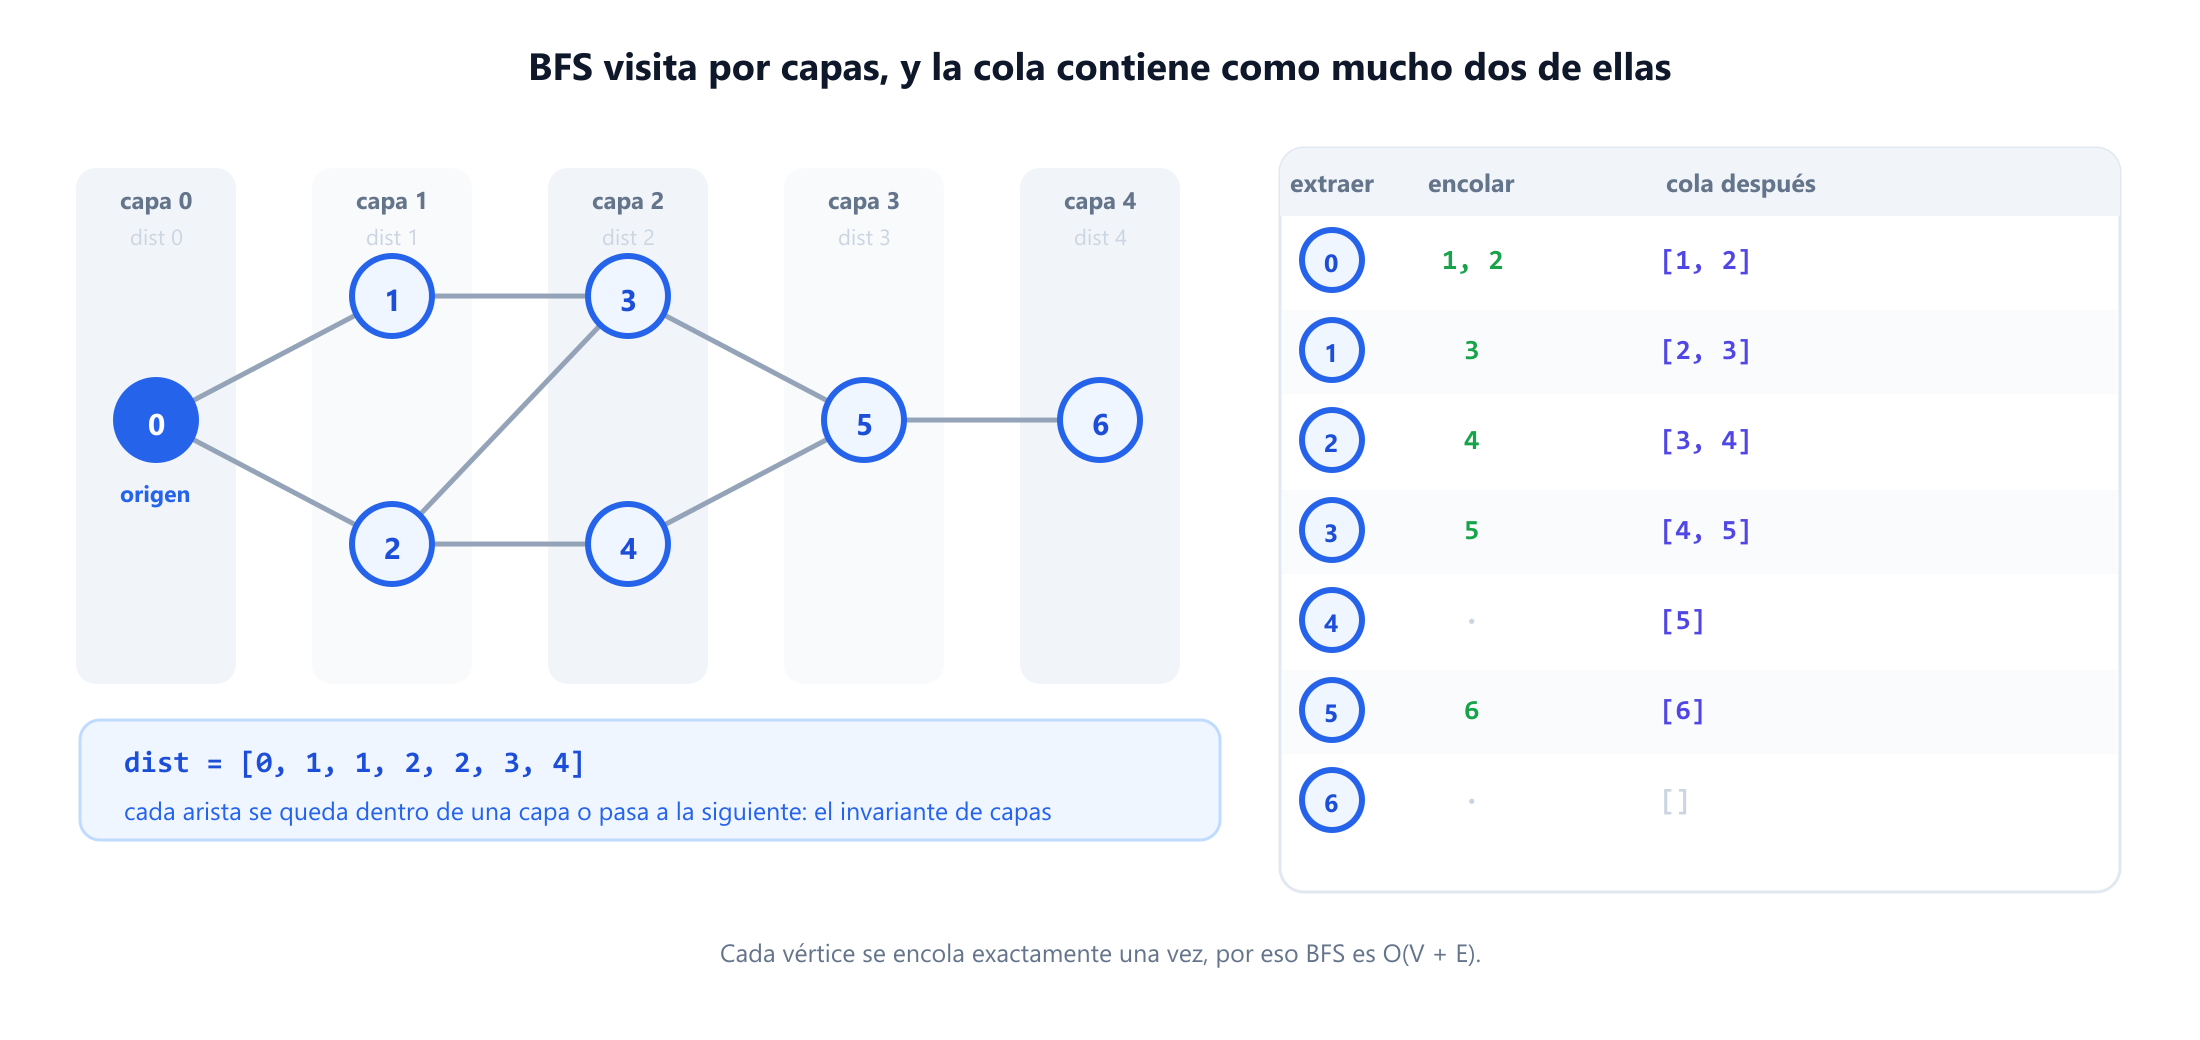
La propiedad que hace que esto funcione es el invariante de capas: cada arista une vértices de la misma capa o de capas consecutivas, sin saltarse ninguna. Las ocho aristas de arriba lo cumplen, y es la razón por la que la primera vez que BFS alcanza un vértice lo hace por un camino más corto. Dilo en voz alta: «BFS encuentra el camino más corto» sin una razón suena memorizado.
3. Camino más corto en un grafo no ponderado
La pregunta. Dado un grafo no ponderado y dos vértices, devuelve la longitud del camino más corto y el propio camino.
El caso base. Lo único que se añade a la plantilla es un puntero al padre.
def shortest_path(adj, src, dst):
    dist, parent = {src: 0}, {src: None}
    q = deque([src])
    while q:
        u = q.popleft()
        if u == dst:                     # salida anticipada: parar al EXTRAER
            break
        for v in adj[u]:
            if v not in dist:
                dist[v] = dist[u] + 1
                parent[v] = u
                q.append(v)
    if dst not in dist:
        return None
    path, cur = [], dst
    while cur is not None:
        path.append(cur)
        cur = parent[cur]
    return dist[dst], path[::-1]
En el grafo de la figura, esto devuelve la distancia 4 y el camino 0 → 1 → 3 → 5 → 6. Di sin que te lo pidan que es un camino más corto, no el único: 0 → 2 → 3 → 5 → 6 es igual de corto, y cuál obtienes depende del orden de adyacencia.
El seguimiento: ¿puedes salir antes? Sí, y la sutileza está en dónde. Comprobar el objetivo al extraer siempre es correcto. Comprobarlo al encolar también funciona en el BFS simple y ahorra una capa, pero deja de ser correcto en cuanto aparecen pesos, así que la comprobación al extraer es el hábito que vale la pena tener. El peor caso sigue siendo O(V + E).
La trampa. Cuando el entrevistador diga «ahora las aristas tienen pesos», no parchees BFS. Cambia al algoritmo de Dijkstra, o al truco de la deque de la sección 8 si los pesos son solo 0 y 1. Los candidatos que hacen que BFS vuelva a visitar vértices para lidiar con pesos están escribiendo, sin querer, un Bellman-Ford lento y con errores.
4. Número de islas
La pregunta. Dada una cuadrícula de '1' (tierra) y '0' (agua), cuenta los grupos conectados de tierra. Las diagonales no conectan.
No hay un grafo explícito, y esa es la clave. Los vértices son celdas de tierra y las aristas son lados compartidos, así que una celda tiene como mucho cuatro vecinos y nunca construyes una estructura de adyacencia.
def num_islands(grid):
    if not grid: return 0
    R, C = len(grid), len(grid[0])
    seen, count = set(), 0
    for i in range(R):
        for j in range(C):
            if grid[i][j] != '1' or (i, j) in seen:
                continue
            count += 1
            seen.add((i, j))
            q = deque([(i, j)])
            while q:
                r, c = q.popleft()
                for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
                    a, b = r + dr, c + dc
                    if 0 <= a < R and 0 <= b < C \
                       and grid[a][b] == '1' and (a, b) not in seen:
                        seen.add((a, b))
                        q.append((a, b))
    return count
Cada celda se encola como mucho una vez y hace trabajo constante, así que esto es O(R × C) en tiempo. El espacio es el conjunto de visitados más la cola, también O(R × C) en el peor caso, cuando toda la cuadrícula es tierra.
El seguimiento: ¿BFS o DFS? Cualquiera sirve, porque estás etiquetando componentes, no midiendo distancias. Prefiere BFS por una razón práctica: un DFS recursivo sobre una cuadrícula de 106 celdas de tierra maciza se anida un millón de niveles y desborda la pila. Si eliges DFS, di que lo escribirías de forma iterativa; esa frase suele ser todo el sentido del seguimiento. La comparación está en BFS vs DFS.
La trampa. Modificar la cuadrícula de entrada, escribiendo '0' sobre la tierra en lugar de mantener un conjunto de visitados, es una optimización legítima, pero dilo. Destruir en silencio los datos de quien llama es un fallo de revisión de código, no una genialidad.
5. Naranjas podridas: BFS multiorigen
La pregunta. Una cuadrícula contiene celdas vacías (0), naranjas frescas (1) y podridas (2). Cada minuto, cada naranja podrida pudre las naranjas frescas adyacentes en horizontal o vertical. Devuelve el número de minutos hasta que no quede ninguna fresca, o -1 si eso nunca ocurre.
Esta pregunta separa a quienes memorizaron BFS de quienes lo entienden. El instinto es lanzar un BFS desde cada naranja podrida y combinar los resultados, lo cual es complicado y lento. La respuesta es meter todas las naranjas podridas en la cola antes de que empiece el bucle. BFS expande entonces un único frente de onda compartido, y a cada celda llega primero el origen más cercano.
def oranges_rotting(grid):
    R, C = len(grid), len(grid[0])
    q, fresh = deque(), 0
    for i in range(R):
        for j in range(C):
            if grid[i][j] == 2: q.append((i, j, 0))
            elif grid[i][j] == 1: fresh += 1

    minutes = 0
    while q:
        r, c, t = q.popleft()
        minutes = max(minutes, t)
        for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
            a, b = r + dr, c + dc
            if 0 <= a < R and 0 <= b < C and grid[a][b] == 1:
                grid[a][b] = 2                  # marcar al encolar
                fresh -= 1
                q.append((a, b, t + 1))
    return -1 if fresh else minutes
Resuelto sobre esta cuadrícula:
2 1 1 0          minuto en que se pudre:     0  1  2  .
1 1 0 2                                      1  2  .  0
0 1 1 1                                      .  3  2  1

dos orígenes, 7 naranjas frescas, 0 restantes, respuesta = 3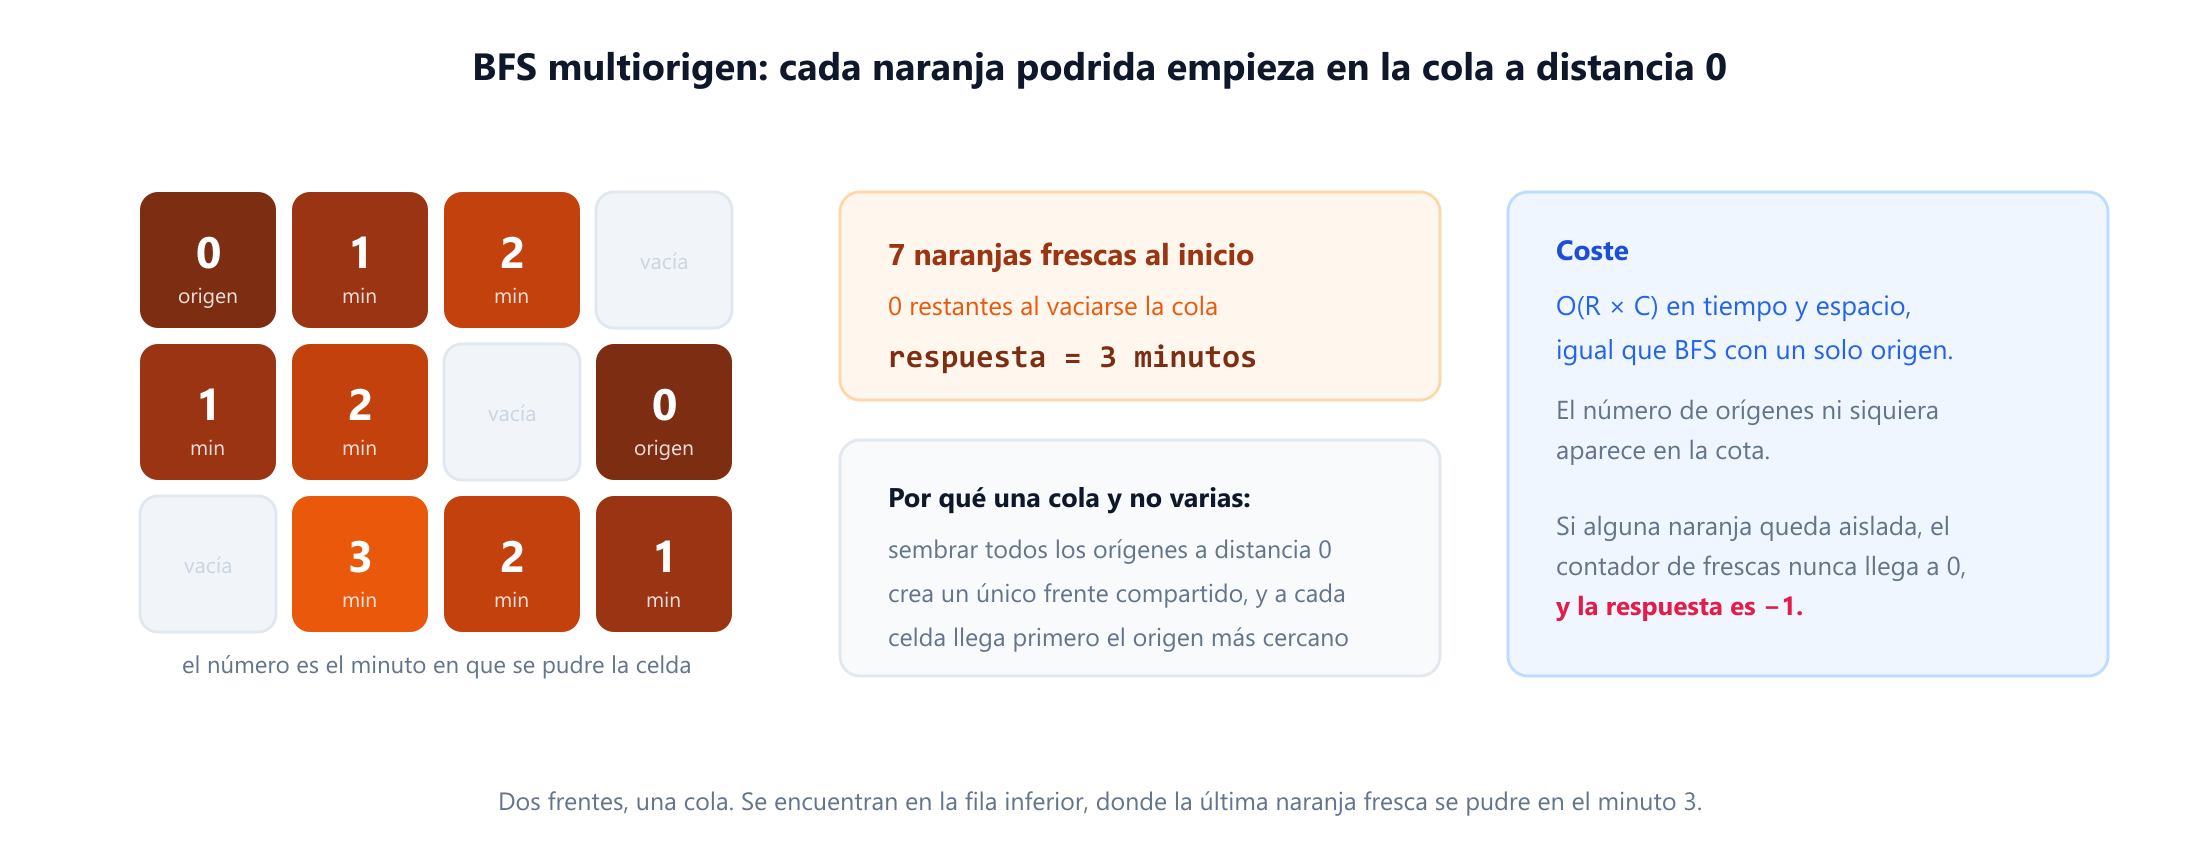
La complejidad es O(R × C), sin importar el número de orígenes. Que el BFS multiorigen cueste lo mismo que el de un solo origen es precisamente lo que se evalúa.
El seguimiento: ¿y si una naranja no puede pudrirse nunca? Ese es el caso -1, y la razón de que exista el contador fresh. No lo detectes comparando las celdas visitadas con el tamaño de la cuadrícula: las celdas vacías no son naranjas y la aritmética falla. Cuenta las frescas al principio, resta una en cada pudrición y comprueba lo que queda. Vacía las dos celdas junto a la naranja de abajo a la izquierda y quedará aislada, así que una sigue fresca y la respuesta es -1.
La trampa. La cuadrícula vacía. Cero frescas y cero podridas deberían devolver 0, y un error por uno que devuelve 1 es el envío incorrecto más habitual.
6. Word ladder: grafos implícitos y encuentro en el medio
La pregunta. Dadas una palabra inicial, una palabra final y un diccionario, encuentra la longitud de la cadena más corta en la que cada paso cambia exactamente una letra y cada palabra intermedia está en el diccionario.
El grafo tiene un vértice por palabra del diccionario y una arista entre palabras que difieren en una posición. Construirlo explícitamente cuesta O(N2 L) de tiempo, y esa es la solución lenta que la mayoría de los candidatos escribe primero. La rápida nunca lo construye: genera los vecinos bajo demanda probando las 26 letras en cada una de las L posiciones y consultando un conjunto hash, exactamente como hace el código de abajo. Una sustitución por posición regenera la propia palabra y la comprobación de visitados la descarta. Para palabras de diez letras son 260 consultas por vértice, sin importar el tamaño del diccionario.
def ladder_length(begin, end, word_list):
    words = set(word_list)
    if end not in words: return 0
    q, dist = deque([begin]), {begin: 1}
    while q:
        w = q.popleft()
        if w == end: return dist[w]
        for i in range(len(w)):
            for ch in "abcdefghijklmnopqrstuvwxyz":
                nxt = w[:i] + ch + w[i+1:]
                if nxt in words and nxt not in dist:
                    dist[nxt] = dist[w] + 1
                    q.append(nxt)
    return 0
El seguimiento: hazlo más rápido. La respuesta esperada es la BFS bidireccional, introducida por Pohl en 1971: buscar a la vez hacia delante desde el inicio y hacia atrás desde el final, expandiendo siempre la frontera más pequeña, y parar cuando se encuentran. Una búsqueda unidireccional hasta la profundidad d con factor de ramificación b toca unos bd vértices; dos búsquedas de profundidad d/2 tocan 2bd/2. Eso reduce el exponente a la mitad, no es un factor constante.
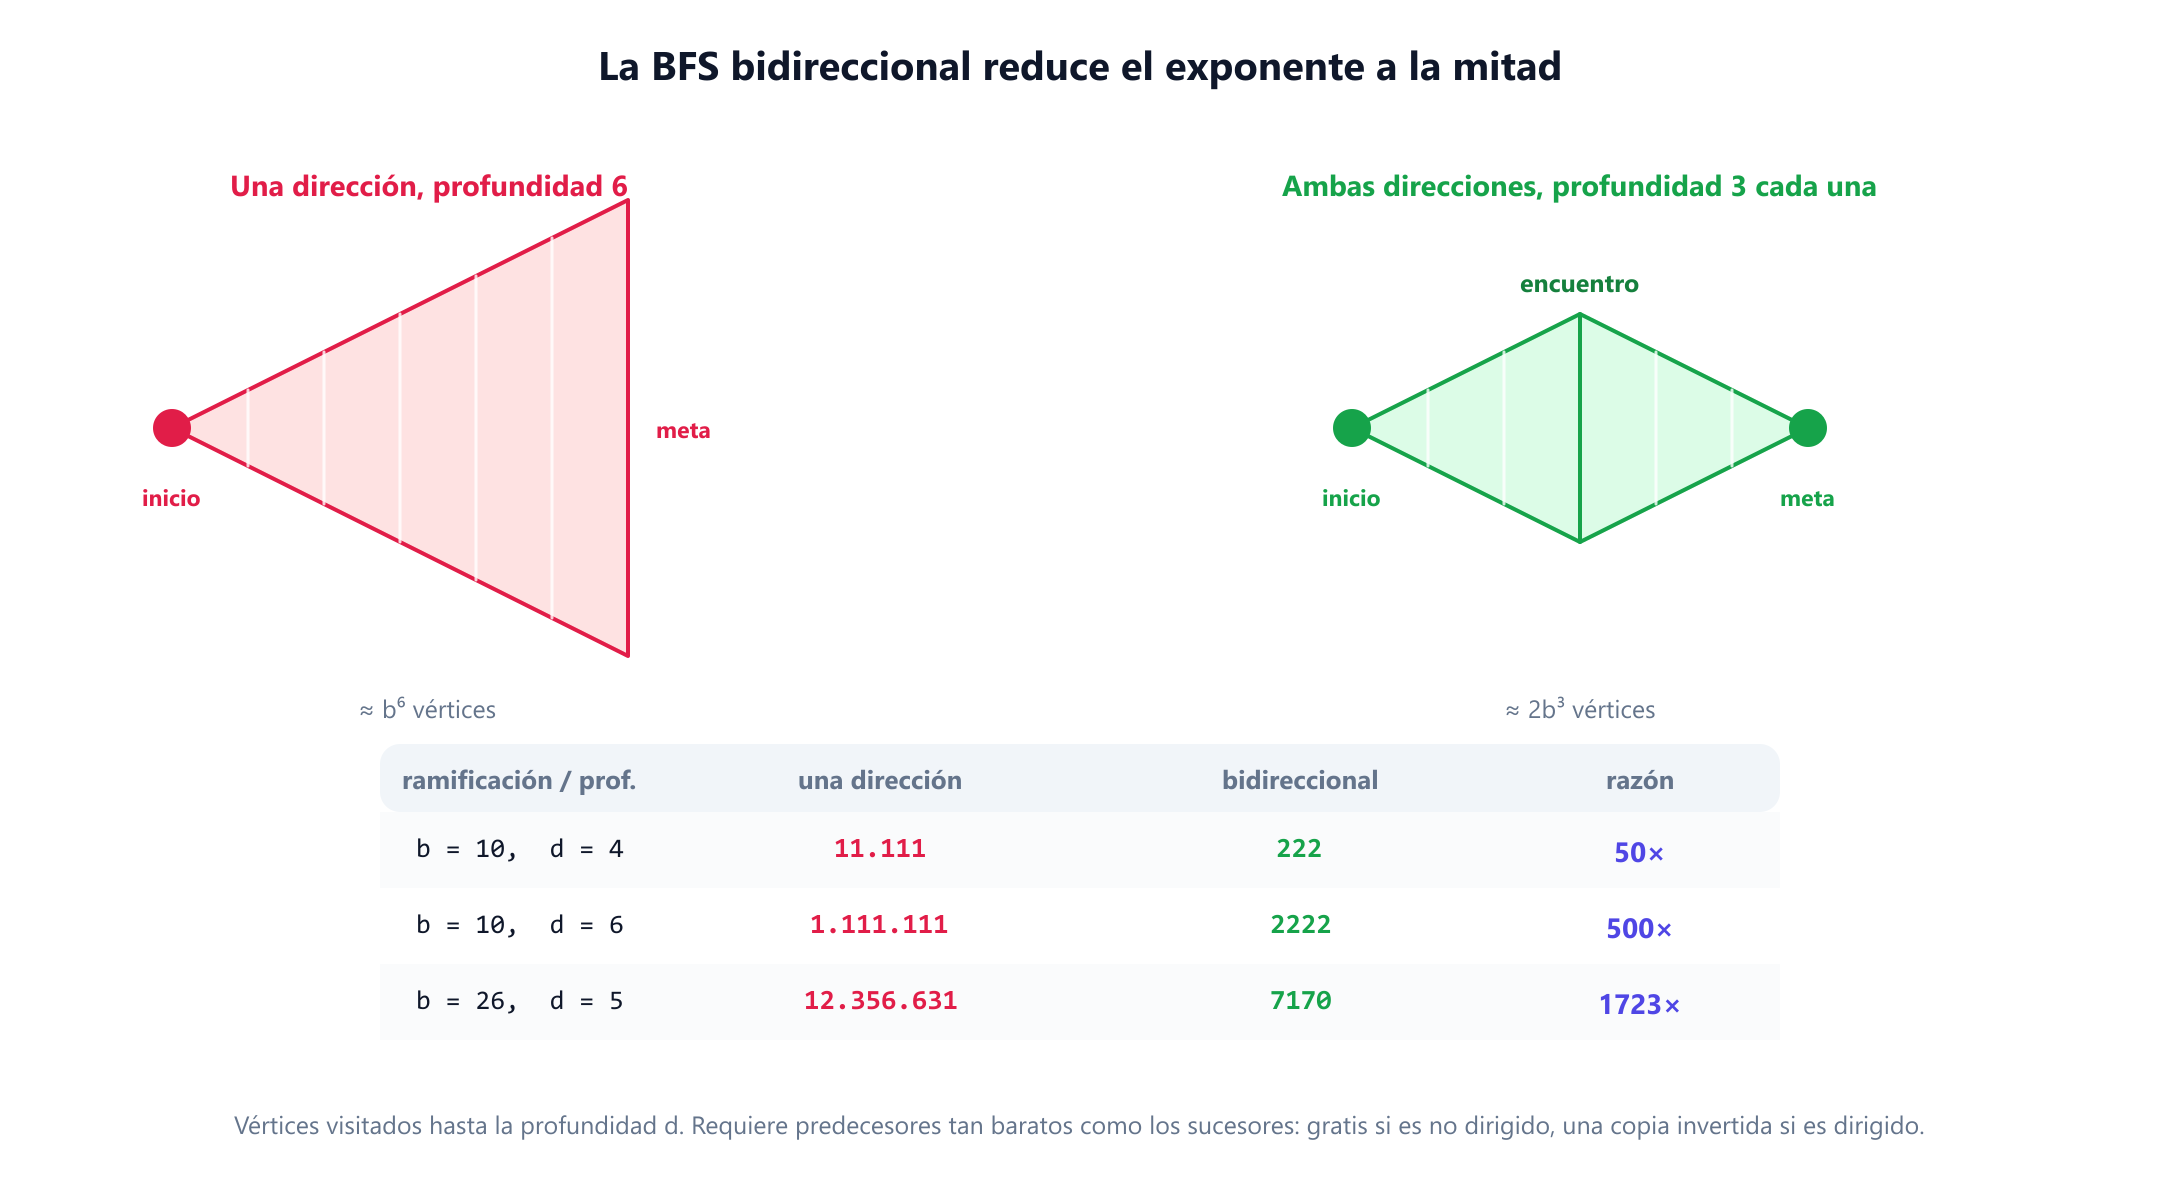
Cuanto más profunda está la respuesta, más se gana.
La trampa. La BFS bidireccional necesita obtener los predecesores tan barato como los sucesores: gratis aquí, porque la relación es simétrica, pero con una copia invertida en un grafo dirigido. El punto de encuentro también requiere cuidado. La respuesta es la suma de las dos profundidades, y parar en el instante en que un vértice aparece en ambos conjuntos de visitados solo es válido si expandes una capa entera cada vez.
7. Recorrido por niveles de un árbol binario
La pregunta. Devuelve los valores de un árbol binario agrupados por profundidad, una lista por nivel.
La única idea nueva es procesar una capa entera cada vez, y el truco consiste en guardar la longitud de la cola antes del bucle interior.
def level_order(root):
    if not root: return []
    out, q = [], deque([root])
    while q:
        level = []
        for _ in range(len(q)):        # guardar PRIMERO el tamaño de la capa
            node = q.popleft()
            level.append(node.val)
            if node.left:  q.append(node.left)
            if node.right: q.append(node.right)
        out.append(level)
    return out
Capturar len(q) en la llamada a range es lo que hace que funcione: el bucle se ejecuta exactamente tantas veces como nodos había en el nivel, aunque la cola crezca mientras tanto. Leer la longitud dentro del bucle fusiona niveles en silencio, y ese es el error clásico aquí.
Un árbol no necesita conjunto de visitados: no hay ciclos y cada nodo tiene un solo padre. Di que lo omites porque la entrada es un árbol, ya que omitirlo en silencio en un grafo provoca un bucle infinito.
Los seguimientos. El orden en zigzag invierte level en las profundidades impares, en lugar de encolar al revés. La vista lateral derecha es el último elemento de cada nivel. La profundidad mínima es la profundidad de la primera hoja extraída, y aquí BFS supera de verdad a DFS, que tiene que explorar todo el árbol.
8. BFS 0-1: cuando BFS supera a Dijkstra
La pregunta. Cada arista tiene peso 0 o 1; encuentra la distancia más corta desde un origen. Hay variantes con una cuadrícula en la que algunos movimientos son gratis, o del tipo «mínimo de muros que hay que derribar».
Dijkstra lo resuelve en O(E log V) y se acepta. La respuesta que buscan se ejecuta en O(V + E): usa una cola doble, metiendo un vértice relajado al principio si llega por una arista de peso 0 y al final si llega por una de peso 1. Así la deque contiene como mucho dos valores de distancia distintos a la vez, que es exactamente el orden que proporcionaba la cola de prioridad.
def zero_one_bfs(adj, src, n):        # adj[u] = [(v, w), ...] con w en {0, 1}
    dist = [float('inf')] * n
    dist[src] = 0
    dq = deque([src])
    while dq:
        u = dq.popleft()
        for v, w in adj[u]:
            if dist[u] + w < dist[v]:
                dist[v] = dist[u] + w
                if w == 0: dq.appendleft(v)
                else:      dq.append(v)
    return dist
En un grafo con las aristas 0-1 (peso 1), 0-2 (0), 2-3 (1), 1-3 (0), 3-4 (1) y 2-4 (1), esto devuelve 0, 1, 0, 1, 1, coincidiendo exactamente con Dijkstra. El BFS simple devuelve 0, 1, 1, 2, 2, incorrecto para tres de los cinco vértices, porque cuenta aristas en lugar de sumar pesos. Ese contraste es la forma más clara de mostrar qué optimiza realmente BFS.
La técnica pertenece a la familia de los algoritmos de corrección de etiquetas, cuya forma general expuso Bertsekas en 1993. Hay una diferencia estructural con el BFS normal que importa: un vértice puede relajarse más de una vez, así que la guarda es una comparación de distancias, no una comprobación de visitados.
La trampa. Escribir if v not in visited en lugar de if dist[u] + w < dist[v]. La comprobación de visitados deja ganar a la primera llegada, y a través de una arista de peso 0 la primera llegada no tiene por qué ser la mejor. El código sigue ejecutándose y devuelve números plausibles.
9. ¿Es bipartito el grafo?
La pregunta. ¿Se pueden repartir los vértices en dos conjuntos de modo que cada arista vaya de uno a otro? En las entrevistas se formula como «separa a estas personas para que no haya dos enemigos en el mismo grupo» o «¿se puede colorear este grafo con 2 colores?».
Colorea el origen con 0, cada vecino con el color opuesto, y falla si alguna vez encuentras un vecino que ya tiene tu mismo color.
def is_bipartite(adj, n):
    colour = [-1] * n
    for s in range(n):
        if colour[s] != -1: continue      # una nueva componente
        colour[s] = 0
        q = deque([s])
        while q:
            u = q.popleft()
            for v in adj[u]:
                if colour[v] == -1:
                    colour[v] = 1 - colour[u]
                    q.append(v)
                elif colour[v] == colour[u]:
                    return False
    return True
La explicación limpia: el color es la paridad de la capa de BFS. Un conflicto significa que una arista une dos vértices de la misma capa, cerrando un ciclo de longitud impar, y un grafo es bipartito exactamente cuando no tiene ciclos impares. El ciclo de 4 es bipartito, el de 5 no, y el algoritmo confirma ambos.
La trampa, y suspende más envíos que ninguna otra: el bucle exterior for s in range(n). Un grafo no conexo exige relanzar BFS desde cada vértice sin colorear, así que una solución que solo empieza en el vértice 0 pasa todas las pruebas conexas y falla en cuanto hay dos componentes. Contar componentes y detectar ciclos necesitan el mismo bucle.
10. Course schedule: ordenación topológica con BFS
La pregunta. Dados n cursos y una lista de pares de prerrequisitos, ¿se pueden cursar todos? El seguimiento pide un orden válido.
Es detección de ciclos en un grafo dirigido, y la respuesta con BFS es el algoritmo de Kahn (1962): tomar repetidamente un vértice sin prerrequisitos pendientes, eliminarlo y restar uno al grado de entrada de sus sucesores.
def find_order(n, prerequisites):
    adj = [[] for _ in range(n)]
    indeg = [0] * n
    for course, prereq in prerequisites:
        adj[prereq].append(course)
        indeg[course] += 1

    q = deque(i for i in range(n) if indeg[i] == 0)
    order = []
    while q:
        u = q.popleft()
        order.append(u)
        for v in adj[u]:
            indeg[v] -= 1
            if indeg[v] == 0:
                q.append(v)
    return order if len(order) == n else []    # corta == ciclo
Con 6 cursos y los prerrequisitos 1←0, 2←0, 3←1, 3←2, 4←3, 5←4 esto planifica los seis como 0, 1, 2, 3, 4, 5. Con el conjunto cíclico 1←0, 2←1, 0←2 no planifica ninguno: todos los vértices empiezan con grado de entrada 1, así que la cola inicial está vacía. Una sola prueba cubre ambos casos, y es el núcleo de la respuesta: si la salida es más corta que n, los vértices sobrantes forman un ciclo.
La trampa. Invertir la dirección de las aristas. El par [a, b] significa «para cursar a, cursa antes b», así que la arista va b → a y lo que aumenta es el grado de entrada de a. Si la inviertes obtienes un orden topológico válido del grafo invertido: parece correcto, pasa la comprobación de ciclos y está mal. Di la dirección en voz alta antes de escribir el bucle. Se trata con más detalle en ordenación topológica.
La contrapartida en profundidad, con detección de ciclos, ordenación topológica, componentes fuertemente conexas y puentes, está en preguntas de entrevista sobre DFS.
11. Las respuestas de complejidad que esperan los entrevistadores
La mitad de una entrevista de BFS es análisis. Qué decir, y por qué:
| Tipo de problema | Tiempo | Espacio | La razón que debes dar |
|---|---|---|---|
| Grafo, lista de adyacencia | O(V + E) | O(V) | Cada vértice se encola una vez, cada arista se examina dos veces |
| Grafo, matriz de adyacencia | O(V2) | O(V) | Encontrar los vecinos de un vértice recorre una fila entera |
Cuadrícula, R × C | O(R × C) | O(R × C) | V = RC y E < 2RC, así que V + E es lineal en el número de celdas |
| Cuadrícula multiorigen | O(R × C) | O(R × C) | Sin cambios: los orígenes solo siembran el mismo frente único |
Word ladder, N palabras de longitud L | O(N × L2 × 26) | O(N × L) | 26L candidatos por palabra, cada uno O(L) para construirlo y calcular su hash |
Bidireccional, ramificación b, profundidad d | O(bd/2) | O(bd/2) | Dos búsquedas de media profundidad, así que el exponente se reduce a la mitad |
| 0-1 BFS | O(V + E) | O(V) | Una deque sustituye al montículo, así que sin factor log. |
Hay dos puntos que conviene mencionar sin que te los pidan. El espacio O(V) no es casual: BFS guarda una capa entera, que en un grafo ancho es la mayor parte de los vértices. Esa es la verdadera razón para preferir DFS en grafos profundos y estrechos, y una respuesta mejor que «DFS usa menos memoria», que no siempre es cierto. Y el término de aristas es E en dirigido pero 2E en no dirigido. Cormen, Leiserson, Rivest y Stein dan el análisis completo; Sedgewick y Wayne, el más claro en pocas palabras.
BFS se publicó dos veces antes de tener nombre: Moore en 1959 para el camino más corto a través de un laberinto y Lee en 1961 para el trazado de placas de circuito. La versión de Lee es literalmente el BFS en cuadrícula de las secciones 4 y 5, y por eso la búsqueda de caminos en cuadrículas todavía se llama a veces algoritmo de Lee.
Cuando las aristas tienen pesos distintos, la cola se convierte en una cola de prioridad; esos problemas se resuelven en preguntas de entrevista sobre Dijkstra.
12. Errores que suspenden la entrevista
Ordenados por frecuencia, no por gravedad. Los tres primeros explican la mayoría de las soluciones rechazadas.
- Marcar como visitado al desencolar en lugar de al encolar. Las distancias siguen siendo correctas y las pruebas pasan, pero la cola crece hasta
O(E), que en un grafo denso es la diferencia entre aprobar y agotar el tiempo. - Usar una lista como cola.
list.pop(0)y elshift()de JavaScript sonO(n). Usacollections.deque, o un índice que avance por un array en un lenguaje que no la tenga. - Olvidar el bucle exterior sobre las componentes. La comprobación de bipartición, el conteo de componentes y la detección de ciclos relanzan BFS desde cada vértice no visitado. Empezar solo en el vértice 0 pasa todas las pruebas conexas y falla en la primera no conexa.
- Recurrir a BFS en un grafo ponderado. BFS minimiza el número de aristas, no el peso total. Si dos aristas tienen costes distintos, necesitas Dijkstra, o BFS 0-1 cuando los pesos son solo 0 y 1.
- Leer la longitud de la cola dentro del bucle de la capa. En el recorrido por niveles,
for _ in range(len(q))debe fijar la longitud antes del bucle, o los niveles se fusionan. - No preguntar por la entrada. ¿Dirigido? ¿Conexo? ¿Bucles o aristas paralelas? ¿Las diagonales de la cuadrícula son vecinas? ¿Puede el inicio ser igual a la meta? Cada respuesta cambia el código, y la observación de Skiena se cumple: los problemas se ganan en el modelado, no en el recorrido.
- Anunciar
O(V + E)sin decir qué representación. La cota corresponde a la lista de adyacencia. Con una matriz, el mismo código esO(V2).
Un hábito vale más que todo lo anterior. Antes de escribir código, di en voz alta qué son los vértices, qué son las aristas y cuánto cuesta un paso. Si todos los pasos cuestan lo mismo, BFS es correcto; si no, has evitado la trampa. McDowell dice lo mismo en general, y donde más muerde es en los grafos, porque el grafo suele estar oculto.
13. Preguntas frecuentes
¿Cómo sé si un problema pide BFS y no DFS?
+
Busca la palabra mínimo o un sinónimo: menos pasos, transformación más corta, primer minuto, salida más cercana. BFS responde a eso con exactitud, siempre que cada paso cueste lo mismo. Si la pregunta solo trata de alcanzabilidad o componentes conexas, cualquiera de los dos recorridos sirve, y BFS evita la recursión profunda en entradas grandes.
¿Por qué debo marcar un vértice como visitado al encolarlo?
+
Porque entre que se encola y se desencola, otros vértices de la misma frontera pueden volver a descubrirlo. Marcarlo al desencolar permite encolarlo una vez por arista entrante, de modo que la cola contiene O(E) entradas en lugar de O(V). Las distancias siguen saliendo bien, y por eso el error es fácil de pasar por alto.
¿Qué es el BFS multiorigen y cuándo lo necesito?
+
Metes todos los orígenes en la cola antes de que empiece el bucle, todos a distancia cero. BFS expande un único frente de onda compartido, así que a cada celda llega primero el origen más cercano. Cuesta lo mismo que el BFS de un solo origen, O(V + E). Las naranjas podridas y los problemas de la salida más cercana son los ejemplos estándar.
¿Puede BFS manejar alguna vez aristas ponderadas?
+
Solo cuando todos los pesos son 0 o 1. Entonces una cola doble, metiendo al principio por una arista de peso cero y al final por una de peso uno, da la respuesta correcta en O(V + E) sin factor logarítmico. Para cualquier otro peso BFS simplemente se equivoca, porque minimiza el número de aristas en lugar del peso total, y necesitas Dijkstra.
¿Cuánto más rápido es el BFS bidireccional?
+
Reduce el exponente a la mitad en lugar de dividir por una constante: convierte aproximadamente b elevado a d en 2 por b elevado a d medios. Con factor de ramificación 10 y profundidad 6 son 1.111.111 vértices frente a unos 2222, un factor de 500. Necesita que los predecesores sean tan baratos como los sucesores: gratis en no dirigido, una copia invertida en dirigido.
¿Qué complejidad debo dar para un BFS en cuadrícula?
+
O(R por C) tanto en tiempo como en espacio. La razón que hay que dar es que la cuadrícula es un grafo con R por C vértices y menos de 2 R C aristas, así que V más E es lineal en el número de celdas. El espacio es el conjunto de visitados más la cola, que puede contener una gran parte de la cuadrícula a la vez.
¿Necesito un conjunto de visitados al ejecutar BFS sobre un árbol?
+
No. Un árbol no tiene ciclos y cada nodo tiene un solo padre, así que ningún nodo se alcanza dos veces y el conjunto nunca rechazaría nada. Di por qué lo omites en lugar de omitirlo en silencio: la misma omisión en un grafo general es un bucle infinito, y el entrevistador no puede saber a cuál te referías.
14. Referencias
Los artículos que introdujeron estas técnicas y los libros que las analizan, en orden cronológico.
- Moore, E. F. (1959). “The shortest path through a maze.” Proceedings of an International Symposium on the Theory of Switching, Harvard University Press, 285–292.
- Lee, C. Y. (1961). “An algorithm for path connections and its applications.” IRE Transactions on Electronic Computers, EC-10(3), 346–365.
- Kahn, A. B. (1962). “Topological sorting of large networks.” Communications of the ACM, 5(11), 558–562.
- Pohl, I. (1971). “Bi-directional search.” In Machine Intelligence 6, Edinburgh University Press, 127–140.
- Bertsekas, D. P. (1993). “A simple and fast label correcting algorithm for shortest paths.” Networks, 23(8), 703–709.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. y Stein, C. (2009). Introduction to Algorithms, 3.ª edición, sección 22.2. MIT Press.
- Sedgewick, R. y Wayne, K. (2011). Algorithms, 4.ª edición, sección 4.1. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6.ª edición. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3.ª edición, capítulo 5. Springer.