
Inhaltsverzeichnis
- 1. Was eine Union-Find-Frage wirklich prüft
- 2. Die Vorlage und die zwei Zeilen, auf die es ankommt
- 3. Zusammenhangskomponenten zählen
- 4. Redundant Connection: die Kante, die einen Zyklus schließt
- 5. Islands II: warum BFS verliert, wenn sich das Gitter ändert
- 6. Accounts Merge: wenn die Elemente keine Ganzzahlen sind
- 7. Most Stones Removed: wählen, was vereinigt wird
- 8. Evaluate Division: gewichtetes Union-Find
- 9. Gleichheitsgleichungen: die Reihenfolge der Verarbeitung
- 10. Kruskal: Union-Find in einem Spannbaum
- 11. Die Antworten zur Komplexität
- 12. Fehler, an denen das Interview scheitert
- 13. Häufig gestellte Fragen
- 14. Quellen
1. Was eine Union-Find-Frage wirklich prüft
Union-Find ist eines der seltenen Interviewthemen, bei denen die Implementierung nicht die Schwierigkeit ist. Fünfzehn Zeilen, zwei Optimierungen, keine Randfälle, über die man streiten müsste. Das wissen die Interviewer, und deshalb liegt die eigentliche Frage ganz woanders.
Sie prüfen drei Dinge. Erkennen Sie eine Zusammenhangsfrage? Alles, was als „sind diese beiden in derselben Gruppe“, „wie viele Gruppen gibt es“ oder „welche Änderung verschmilzt zwei Gruppen“ formuliert ist, ist Union-Find, auch wenn die Wörter Konten, Steine, Gleichungen oder Kabel lauten. Wissen Sie, wann es eine Traversierung schlägt? Einen einzelnen statischen Graphen durchlaufen BFS oder DFS genauso schnell; Union-Find gewinnt, wenn die Kanten einzeln eintreffen und die Antwort nach jeder gebraucht wird. Können Sie die Elemente wählen? Hier sitzen die schweren Fragen, und hier verbringt Abschnitt 7 seine Zeit.
Die acht Aufgaben unten sind die, die immer wiederkehren, jeweils mit der Lösung, der Nachfrage und dem Fehler, der das Angebot kostet. Jedes durchgerechnete Beispiel auf dieser Seite wurde per Skript ausgeführt. Wenn Sie die Datenstruktur selbst von Grund auf hergeleitet statt nur zusammengefasst haben möchten, finden Sie das im Leitfaden zu Union-Find.
2. Die Vorlage und die zwei Zeilen, auf die es ankommt
Schreiben Sie das, ohne nachzudenken. Zwei Optimierungen, je eine Zeile, und Interviewer fragen nach beiden mit Namen.
class DSU:
    def __init__(self, n):
        self.parent = list(range(n))
        self.size = [1] * n
        self.count = n                       # Anzahl der Komponenten, gratis

    def find(self, x):
        root = x
        while self.parent[root] != root:
            root = self.parent[root]
        while self.parent[x] != root:        # PFADKOMPRESSION: den Weg abflachen
            self.parent[x], x = root, self.parent[x]
        return root

    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False                     # schon verbunden: nichts zu verschmelzen
        if self.size[ra] < self.size[rb]:    # UNION NACH GRÖSSE: kleiner Baum unter den großen
            ra, rb = rb, ra
        self.parent[rb] = ra
        self.size[ra] += self.size[rb]
        self.count -= 1
        return True
Drei Details, die Sie beim Tippen laut aussprechen sollten. union liefert einen Wahrheitswert, und dieser Rückgabewert beantwortet die Hälfte der Fragen auf dieser Seite: False bedeutet, dass die beiden schon verbunden waren, also schließt die gerade versuchte Kante einen Zyklus. count wird von den Verschmelzungen mitgeführt, sodass das Zählen der Komponenten nie einen zweiten Durchlauf braucht. Und das find oben ist iterativ, was bei einer Kette von hunderttausend Elementen wichtig ist, an der die rekursive Version am Aufrufstapel stirbt.
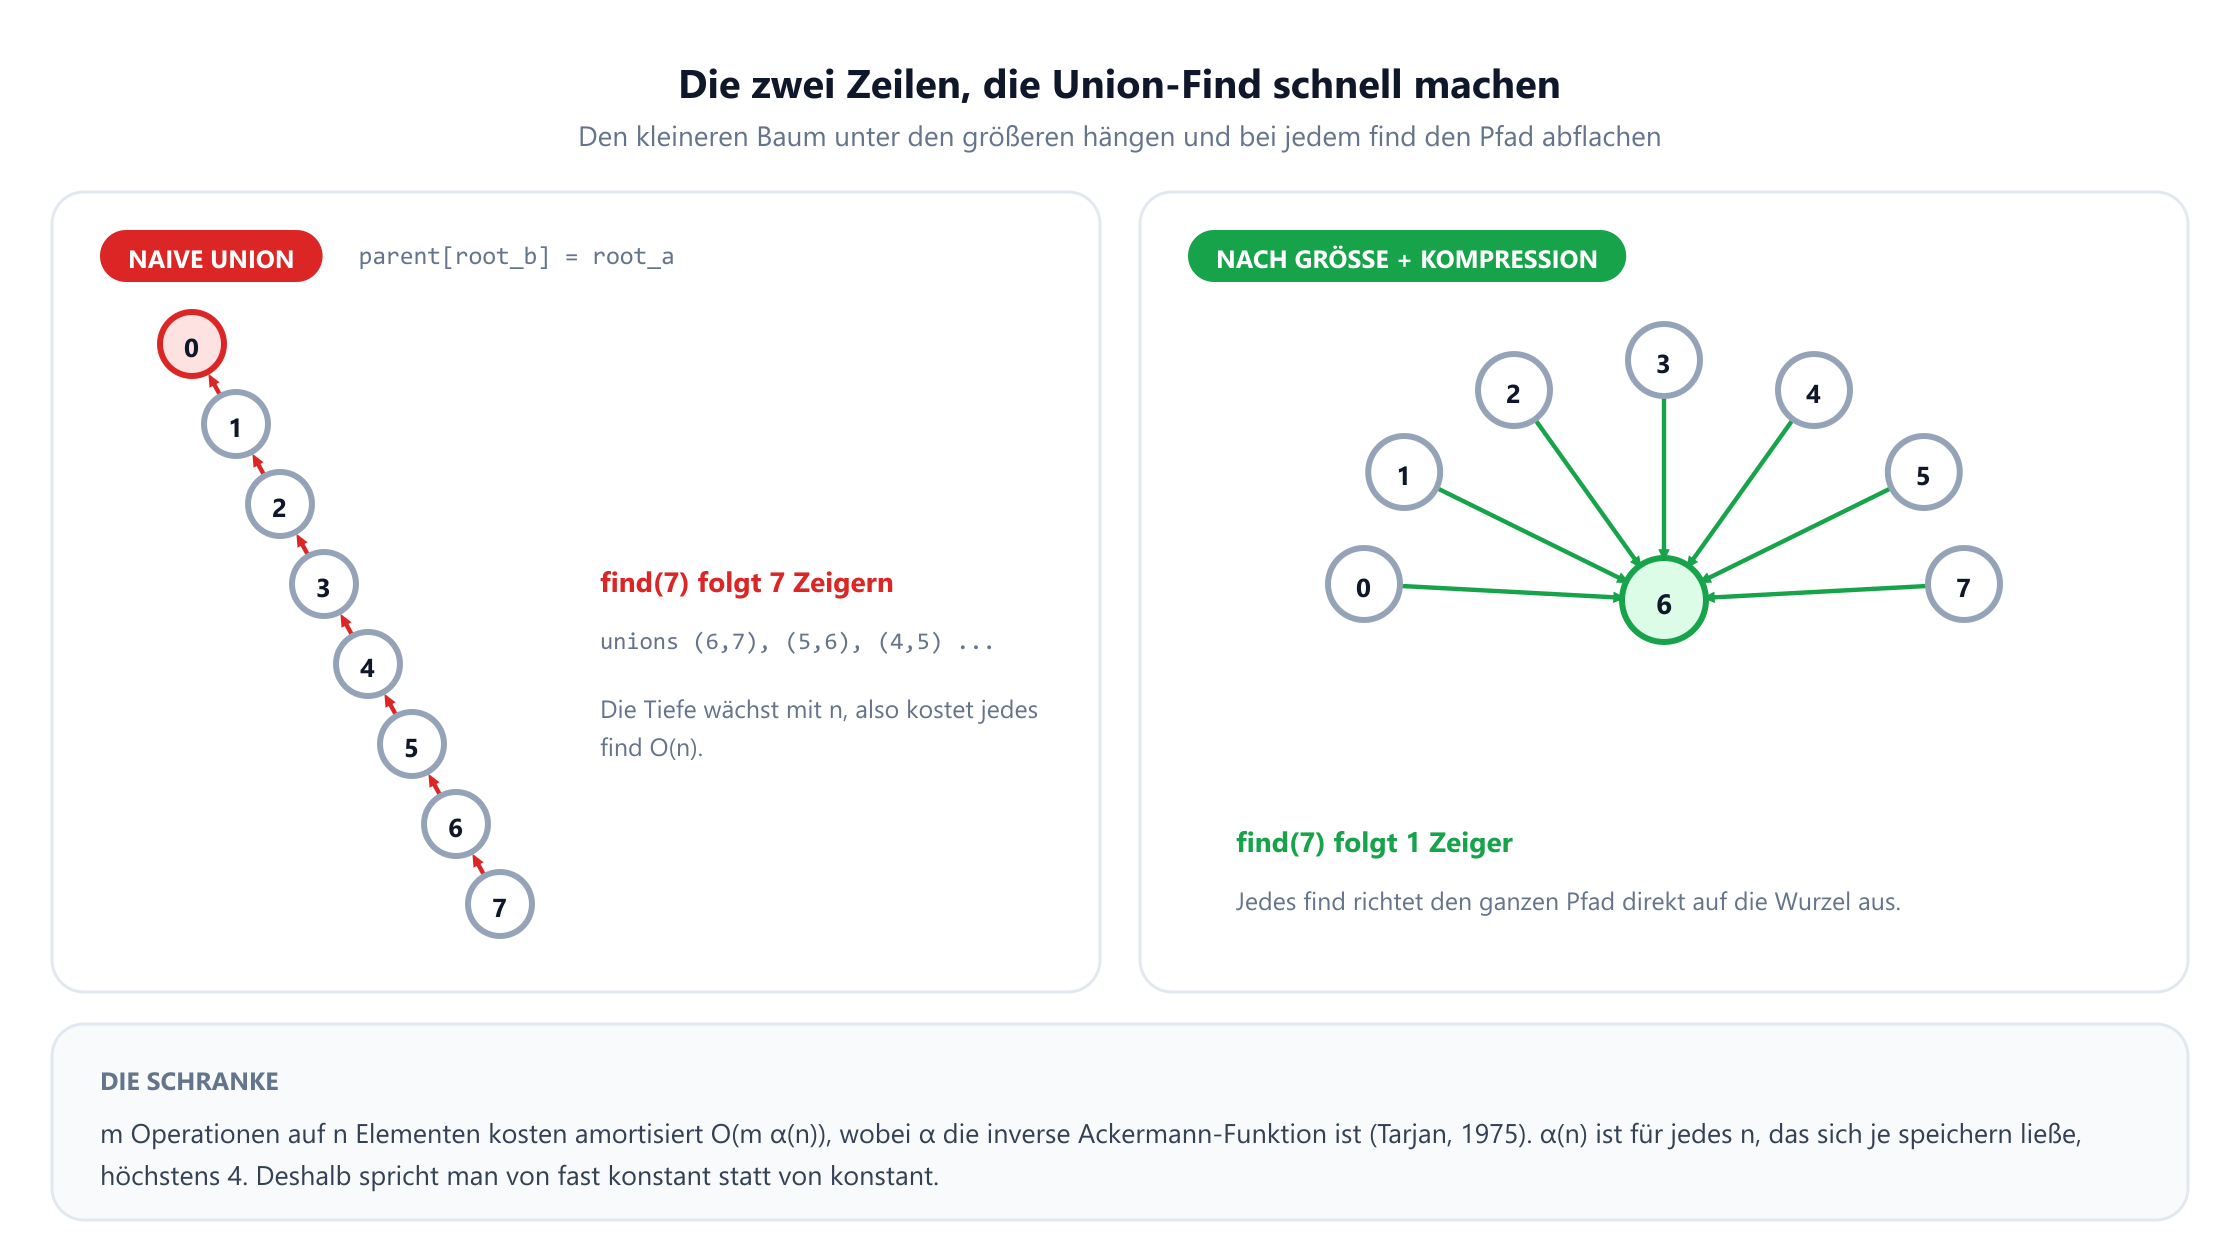
parent[rb] = ra schreiben, ohne die Größen zu prüfen.Warum beide Optimierungen? Union nach Größe allein begrenzt die Tiefe auf O(log n), weil ein Baum nur höher wird, wenn zwei gleich große Bäume verschmelzen. Pfadkompression allein liefert ebenfalls amortisiert O(log n). Zusammen ergeben sie amortisiert O(α(n)) pro Operation, siehe Abschnitt 11. Wenn Sie sich nur eine merken können, merken Sie sich die Pfadkompression: Sie ist eine Zeile und leistet in der Praxis den Großteil der Arbeit.
Ein Implementierungshinweis, den Sie von sich aus anbringen sollten: Union nach Rang und Union nach Größe sind austauschbar im Hinblick auf die Schranke. Der Rang speichert eine obere Schranke für die Höhe, die Größe speichert die Zahl der Elemente. Die Größe ist im Interview nützlicher, weil die Hälfte der Nachfragen nach der Größe der entstandenen Komponente fragt, und die haben Sie dann schon.
3. Zusammenhangskomponenten zählen
Die Frage. Gegeben sind n Knoten und eine Liste ungerichteter Kanten. Wie viele Zusammenhangskomponenten gibt es? Die klassische Formulierung ist LeetCode 323, und Number of Provinces ist dieselbe Frage mit einer Adjazenzmatrix.
Mit der Vorlage oben bleibt kein Algorithmus mehr zu schreiben.
def count_components(n, edges):
    dsu = DSU(n)
    for a, b in edges:
        dsu.union(a, b)
    return dsu.count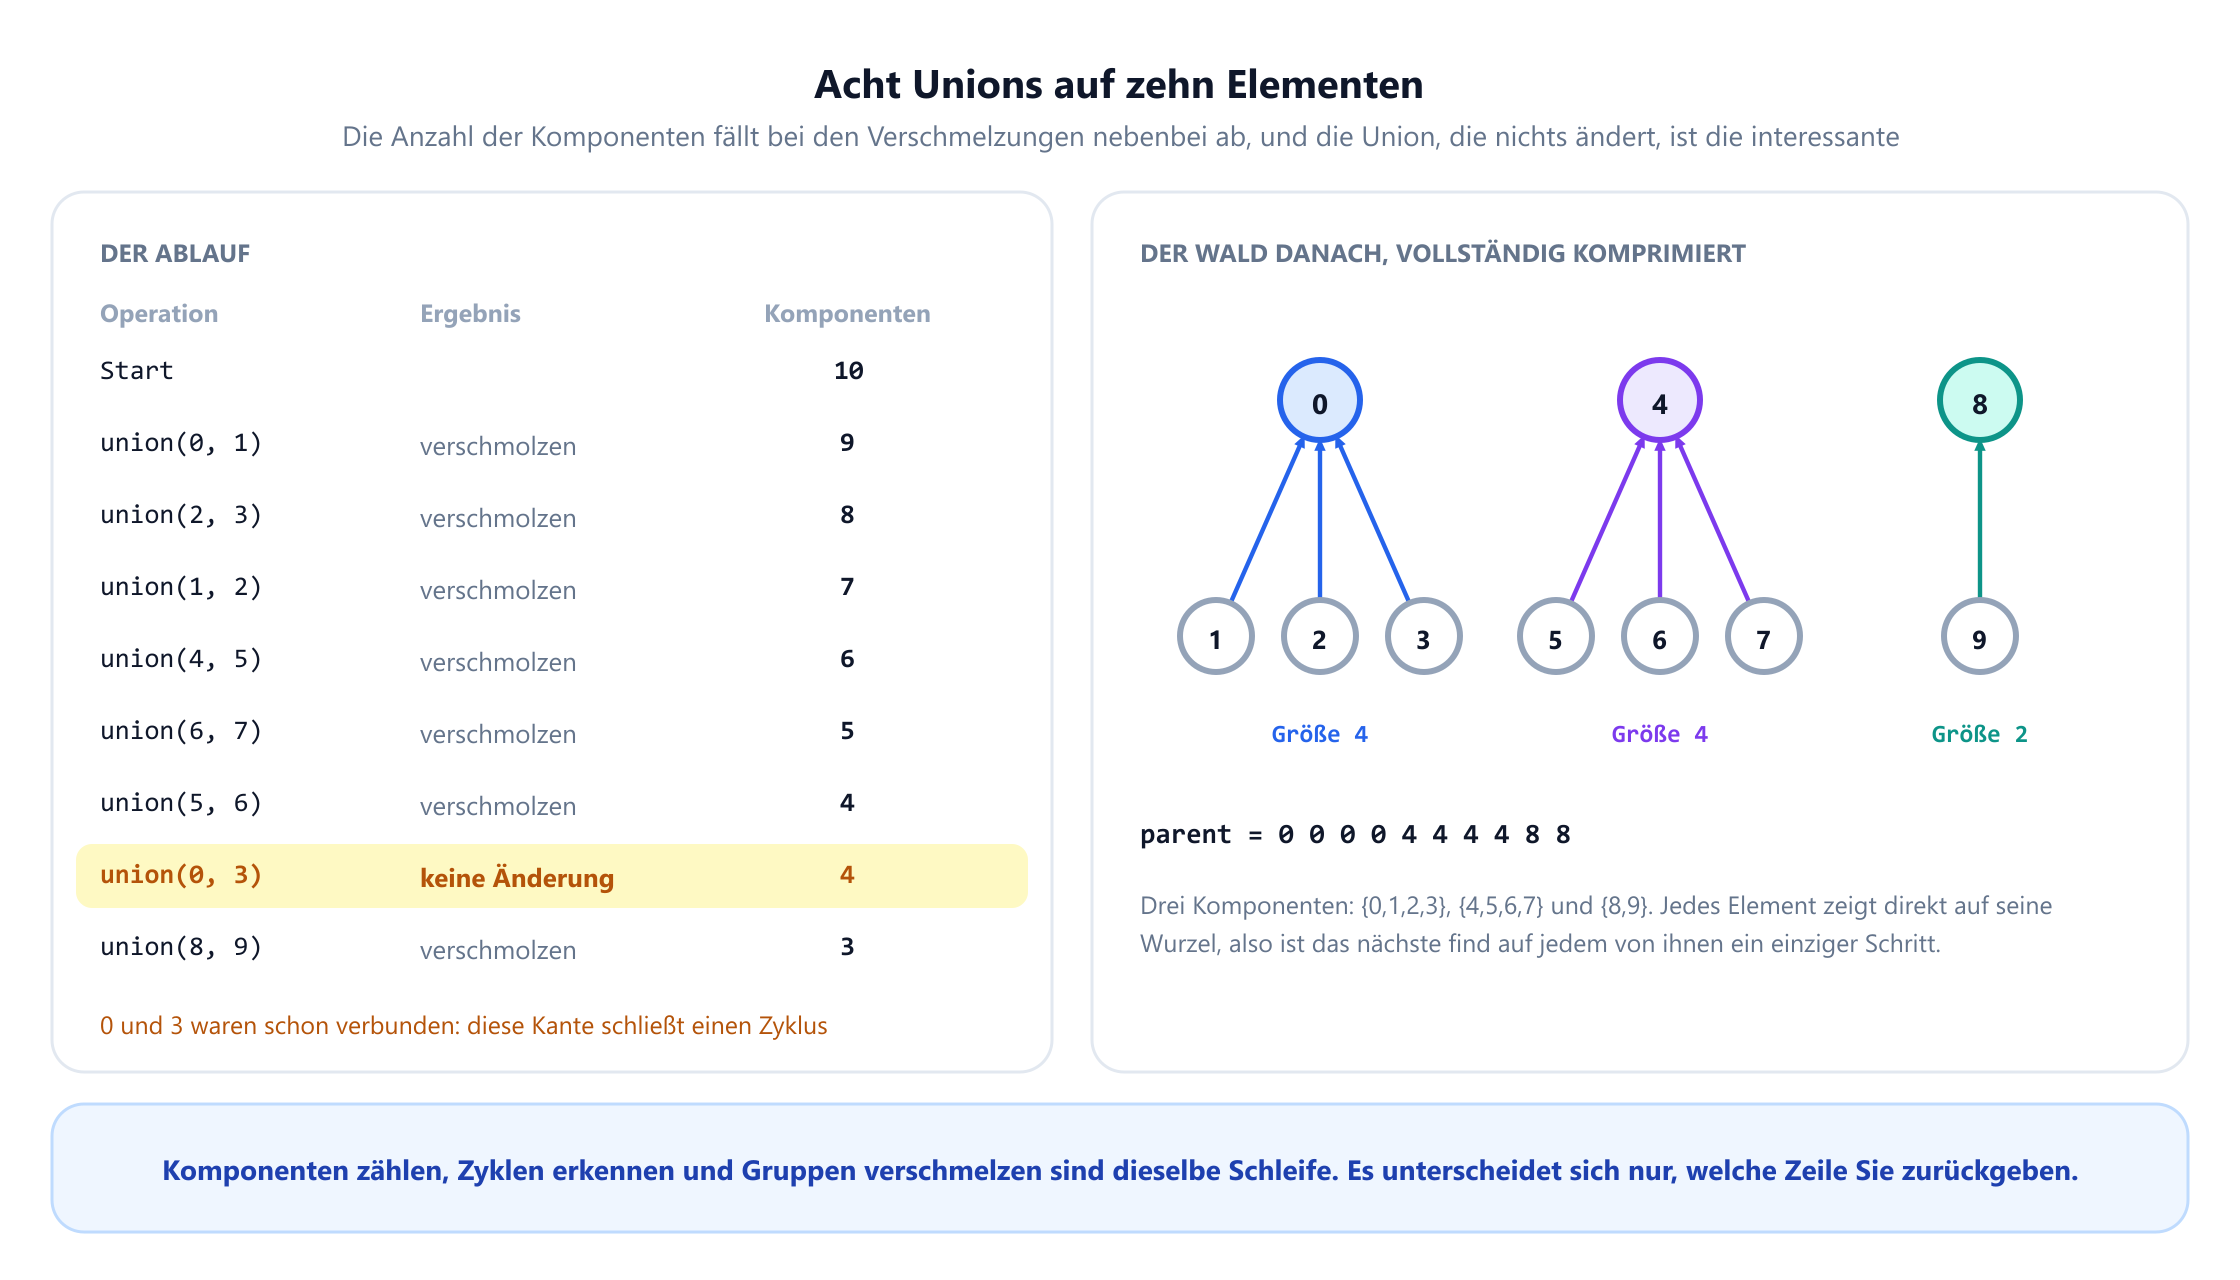
Im durchgehenden Beispiel lassen zehn Elemente und die acht Unions (0,1) (2,3) (1,2) (4,5) (6,7) (5,6) (0,3) (8,9) am Ende drei Komponenten übrig: {0,1,2,3}, {4,5,6,7} und {8,9}, mit den Größen 4, 4 und 2. Sieben Unions haben verschmolzen; union(0, 3) nicht, weil 0 und 3 zu diesem Zeitpunkt schon im selben Baum lagen.
Führen Sie danach auf jedem Element ein find aus, und die Struktur endet als parent = 0 0 0 0 4 4 4 4 8 8: Jedes Element zeigt direkt auf die Wurzel seiner Komponente, also ist jede spätere Abfrage ein einziger Schritt. Diese Abflachung ist die Pfadkompression, die sich bezahlt macht.
Die Nachfrage: Warum nicht einfach DFS? Auf einem statischen Graphen: ja, bitte. Beide sind linear, und DFS braucht keine zusätzliche Struktur, also ist der Griff zu Union-Find bei einer festen Kantenliste eher ein kleines Warnsignal als ein Pluspunkt. Die ehrliche Antwort lautet, dass Union-Find seinen Platz verdient, wenn die Kanten nach und nach eintreffen, wenn Sie die Antwort nach jedem Eintreffen brauchen oder wenn der Graph zu groß ist, um ihn als Adjazenzliste zu halten, die Paare aber vorbeiströmen. Wer das ungefragt sagt, hebt sich von Kandidaten ab, die nur auf das Wort „Komponenten“ anspringen.
Die Falle. Zurückgeben von len(set(parent)), was die verschiedenen Werte von parent zählt, ohne je find aufzurufen. Vor der Kompression enthält das Elternarray Zwischenknoten, keine Wurzeln, also fällt die Zahl zu hoch aus. Führen Sie count in union mit, und die Frage stellt sich gar nicht.
4. Redundant Connection: die Kante, die einen Zyklus schließt
Die Frage. Ein Baum auf n Knoten hat eine zusätzliche Kante bekommen. Finden Sie die Kante, die entfernt werden kann, und wenn mehrere in Frage kommen, geben Sie die zurück, die in der Eingabe zuletzt steht.
Das ist der Wahrheitswert, den union zurückgibt, und sonst nichts.
def find_redundant(edges):
    dsu = DSU(len(edges) + 1)
    for a, b in edges:
        if not dsu.union(a, b):          # a und b waren schon verbunden
            return [a, b]                # also schließt diese Kante einen Zyklus
Verarbeiten Sie die Kanten der Reihe nach, und die erste, bei der union den Wert False liefert, ist die Antwort. Sie ist automatisch auch die letzte solche Kante der Eingabe, denn ein Baum plus eine Kante hat genau einen Zyklus, also scheitert genau eine Kante. Bei [[1,2],[2,3],[3,4],[1,4],[1,5]] ist die Antwort [1,4], und beim Dreieck [[1,2],[1,3],[2,3]] ist sie [2,3].
Die Nachfrage: Und wenn der Graph gerichtet ist? Das ist Redundant Connection II, und es ist ein wirklich schwereres Problem, keine Variante. Eine gerichtete Version kann auf zwei Arten scheitern: ein Knoten mit zwei Eltern oder ein Zyklus, und beides kann gleichzeitig auftreten. Die Technik: den Knoten mit Eingangsgrad zwei finden, probeweise jede seiner beiden Kandidatenkanten entfernen und mit Union-Find prüfen, ob der Rest einen gültigen Wurzelbaum bildet. Zu wissen, dass der gerichtete Fall in Unterfälle zerfällt, genügt; Interviewer lassen Sie ihn selten ausschreiben.
Die Falle. Verwenden von DSU(n), wenn die Knoten von 1 bis n nummeriert sind. Jeder Union-Find-Fehler dieser Art ist ein Off-by-one bei der Arraygröße, und er zeigt sich als Indexfehler beim allerletzten Knoten statt als falsche Antwort. Reservieren Sie n + 1 und ignorieren Sie Platz null.
5. Islands II: warum BFS verliert, wenn sich das Gitter ändert
Die Frage. Ein leeres m × n Gitter aus Wasser. Land wird Zelle für Zelle hinzugefügt. Geben Sie nach jedem Hinzufügen an, wie viele Inseln es gibt.
Diese Frage rechtfertigt die ganze Datenstruktur, behandeln Sie sie also als diejenige, die sitzen muss. Inseln auf einem festen Gitter zu zählen ist ein Flood Fill und kostet O(mn). Das nach jeder der k Ergänzungen zu tun, kostet O(k × mn), was quadratisch ist und in ein Timeout läuft. Union-Find macht aus jeder Ergänzung einen konstanten Arbeitsaufwand, weil hinzugefügtes Land Inseln nur verschmelzen kann, niemals trennen.
def num_islands2(m, n, positions):
    dsu, seen, out, count = {}, set(), [], 0
    for r, c in positions:
        if (r, c) in seen:               # eine wiederholte Position ändert nichts
            out.append(count)
            continue
        seen.add((r, c))
        dsu[(r, c)] = (r, c)             # eine neue Insel aus einer Zelle
        count += 1
        for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
            nb = (r + dr, c + dc)
            if nb in seen and union(dsu, (r, c), nb):
                count -= 1               # mit einem Nachbarn verschmolzen
        out.append(count)
    return out
Jede neue Zelle beginnt als eigene Insel und verschmilzt dann mit höchstens vier Nachbarn, also kostet jeder Schritt O(α) und der ganze Lauf O(k α(mn)). Auf einem 3-mal-3-Gitter mit Land bei (0,0), (0,1), (1,2), (2,1) lauten die Antworten 1, 1, 2, 3: Die zweite Zelle schließt sich der ersten an, die nächsten beiden sind isoliert. Fügen Sie (1,1) als fünften Zug hinzu, berührt es alle drei, und die Folge endet mit 1, 1, 2, 3, 1.
Die Nachfrage: Und wenn Land auch entfernt werden kann? Sagen Sie klar, dass Union-Find kein Löschen unterstützt, weil sich eine Verschmelzung nicht rückgängig machen lässt, sobald die Pfade komprimiert sind. Die eigentlichen Antworten: die Operationen offline in umgekehrter Reihenfolge verarbeiten, sodass Löschungen zu Hinzufügungen werden, oder ein Union-Find mit Rollback verwenden, das einen Rückgängig-Stapel führt und deshalb auf Pfadkompression verzichtet, zugunsten von Union nach Rang allein mit O(log n). „Offline-Umkehrung“ zu nennen, reicht meistens.
Die Falle. Vergessen, dass dieselbe Position zweimal in der Eingabe vorkommen kann. Land dort hinzuzufügen, wo schon Land ist, darf die Zahl nicht erhöhen, und die Absicherung ist eine Zeile. Es ist auch der einzige versteckte Testfall dieser Aufgabe.
6. Accounts Merge: wenn die Elemente keine Ganzzahlen sind
Die Frage. Jedes Konto ist ein Name gefolgt von einer Liste von E-Mails. Zwei Konten gehören derselben Person, wenn sie irgendeine E-Mail teilen. Führen Sie sie zusammen und geben Sie die E-Mails jeder Person sortiert zurück.
Die Struktur ist trivialerweise Union-Find. Was die Frage wirklich prüft, ist die Verdrahtung: Ihre Elemente sind Zeichenketten, und das arraybasierte DSU braucht Ganzzahlen.
ids = {}
for account in accounts:
    for mail in account[1:]:
        if mail not in ids:
            ids[mail] = len(ids)         # jeder E-Mail eine fortlaufende Zahl geben
        owner[mail] = account[0]

dsu = DSU(len(ids))
for account in accounts:
    first = ids[account[1]]
    for mail in account[2:]:
        dsu.union(first, ids[mail])      # jede Mail mit der ersten verketten
Vereinigen Sie jede E-Mail eines Kontos mit der ersten E-Mail dieses Kontos, was genügt, um das ganze Konto zu einer Komponente zu machen, gruppieren Sie dann die E-Mails nach Wurzel und sortieren Sie jede Gruppe. Das Zusammenführen von John [a, b], John [c, b], Mary [m] und einem zweiten John [z] ergibt drei Personen: John mit a, b, c, Mary mit m und einen anderen John nur mit z.
Diese letzte Gruppe ist der Sinn der Frage. Der Name ist nicht die Identität. Zwei Konten mit demselben Namen und ohne gemeinsame E-Mail sind zwei verschiedene Personen, und wer nach Namen vereinigt, bekommt eine plausible falsche Antwort, die die Beispieleingabe absichtlich abfangen soll.
Die Nachfrage: Ginge es ohne die ID-Zuordnung? Ja, indem Sie parent als Wörterbuch speichern, dessen Schlüssel die Zeichenkette selbst ist, was pro Zugriff einen Hash statt eines Arrayindex kostet. Das ist sauberer zu schreiben und langsamer in der Ausführung, und zu sagen, welchen Kompromiss Sie eingehen, ist das, was bewertet wird. In einer Sprache ohne Wörterbücher im heißen Pfad oder wenn dieselbe Struktur millionenfach wiederverwendet wird, gewinnt die dichte Ganzzahlzuordnung.
Die Falle. Den Namen über die E-Mail der Wurzel nachzuschlagen, statt eine Zuordnung von E-Mail zu Name zu führen. Nach der Kompression kann die Wurzel jede E-Mail der Gruppe sein, und wenn Sie den Namen an einer bestimmten festgemacht haben, hängen Sie an ein zusammengeführtes Konto den falschen Namen.
7. Most Stones Removed: wählen, was vereinigt wird
Die Frage. Steine liegen auf einem Gitter. Sie dürfen einen Stein entfernen, wenn er eine Zeile oder Spalte mit einem anderen verbliebenen Stein teilt. Wie viele können Sie höchstens entfernen?
Zwei Einsichten, und die zweite macht daraus eine gute Interviewfrage.
Erstens: Aus jeder zusammenhängenden Gruppe von Steinen können Sie alle bis auf einen entfernen. Entfernen Sie sie in umgekehrter Reihenfolge zum Aufbau eines Spannbaums der Gruppe, Blätter zuerst, und der letzte verbliebene Stein hält die Gruppe bei jedem Schritt gültig. Die Antwort ist also Steine insgesamt - Anzahl der Komponenten, und das ganze Problem reduziert sich auf das Zählen von Komponenten.
Zweitens, und das ist der Teil, der unter Druck schwerfällt: Vereinigen Sie nicht die Steine. Vereinigen Sie die Zeilen und die Spalten.
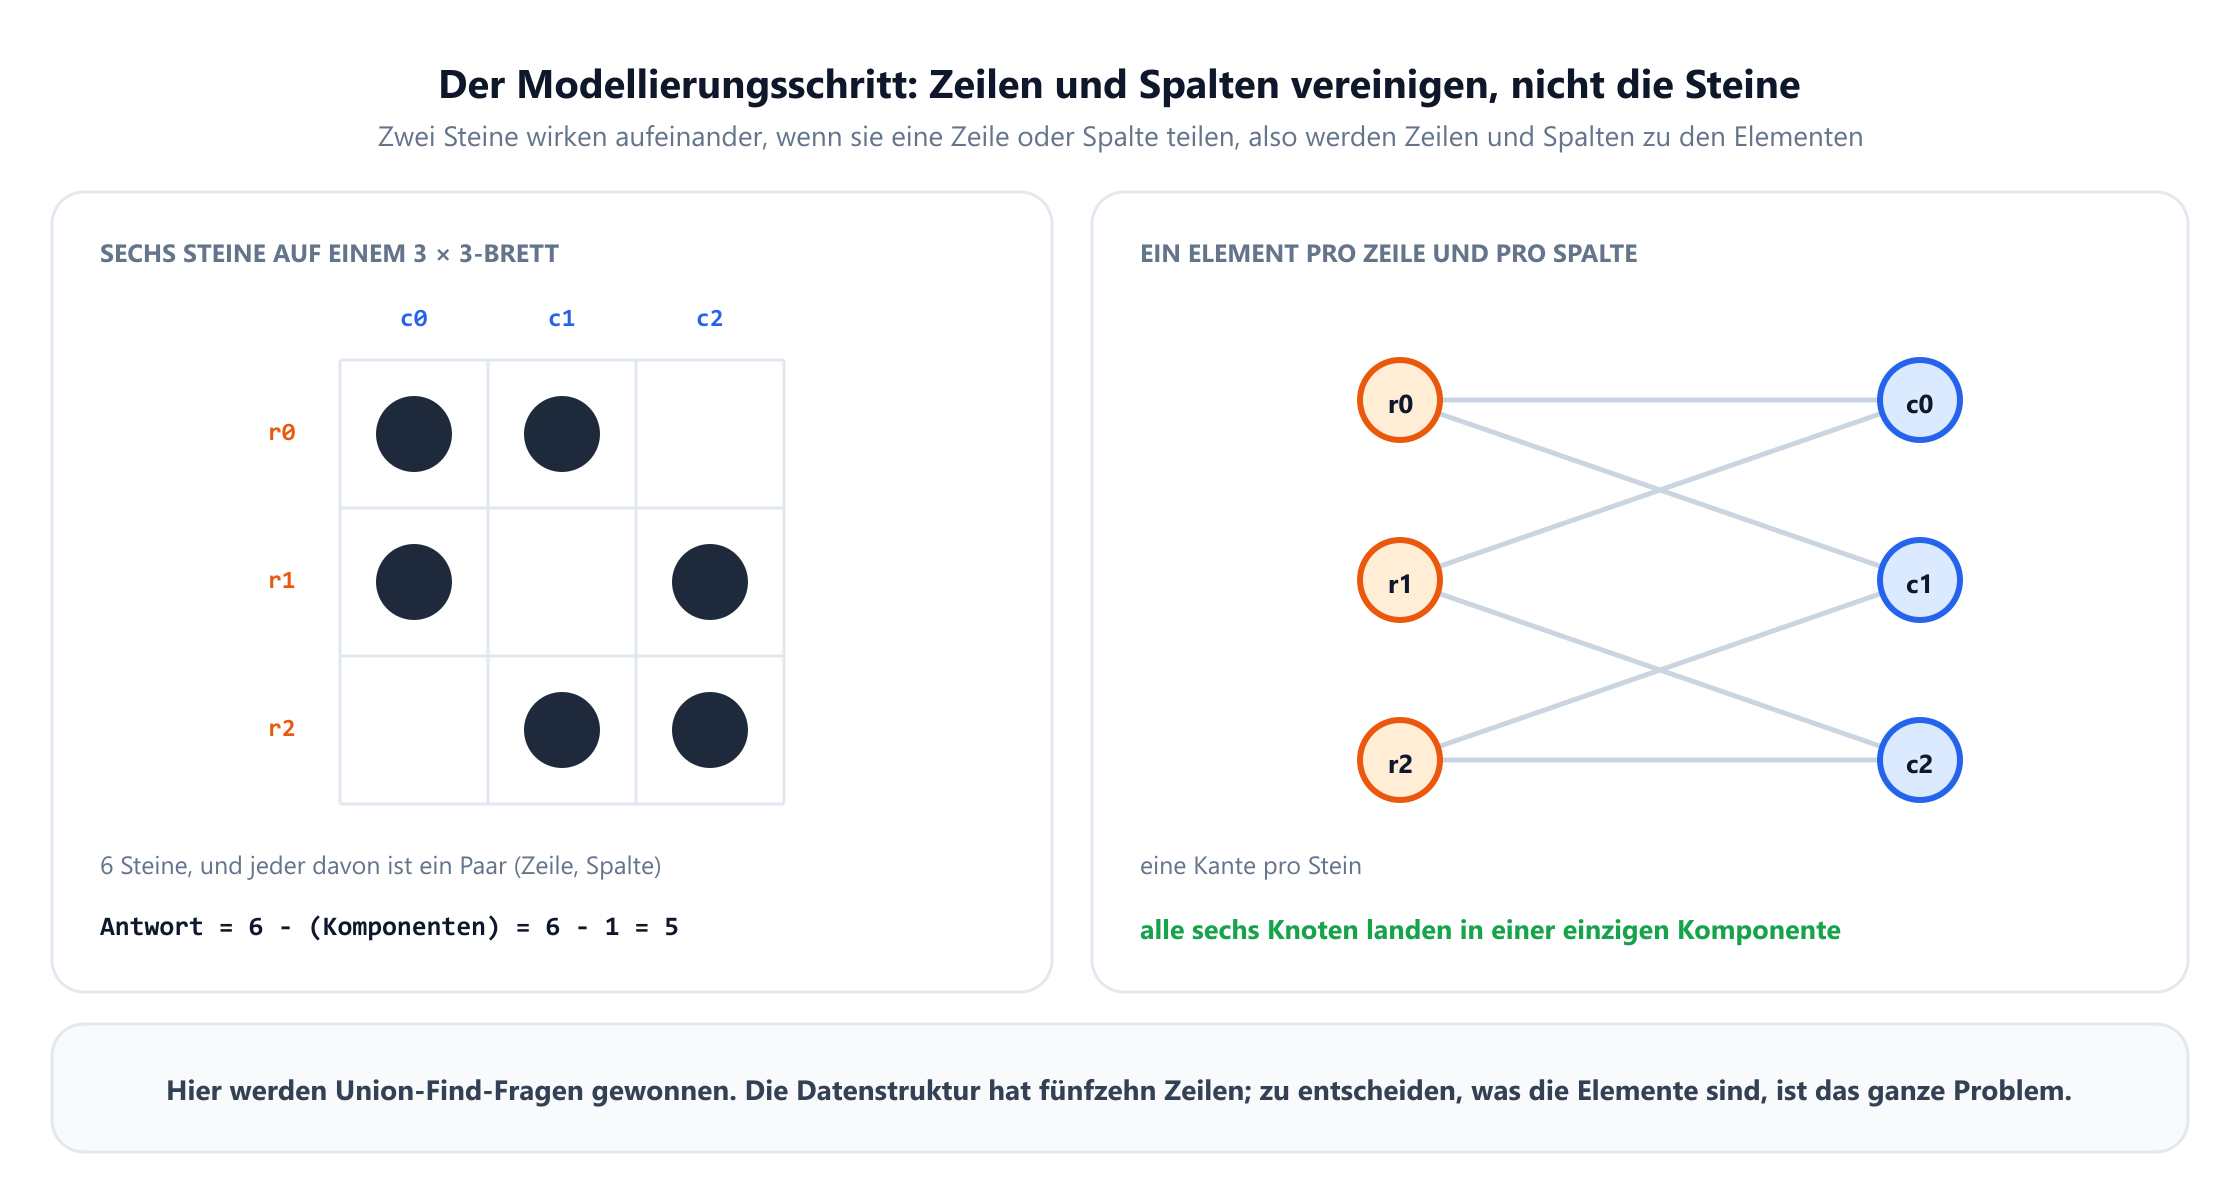
Jeder Stein bei (r, c) wird zu einem einzigen union(Zeile r, Spalte c). Zwei Steine sind genau dann verbunden, wenn sie eine Zeile oder Spalte teilen oder durch eine Kette solcher Steine verknüpft sind, und das ist genau die Relation, die die Aufgabe beschreibt. Außerdem wird so ein paarweiser Vergleich in O(k2) zu einem Verfahren in O(k α). Beim Beispiel mit sechs Steinen fällt das ganze Brett zu einer Komponente zusammen, und die Antwort ist 5. Bei [[0,0],[0,2],[1,1],[2,0],[2,2]] gibt es zwei Komponenten, und die Antwort ist 3.
Die Nachfrage: Wie verhindern Sie, dass Zeilen und Spalten kollidieren? Sie leben in derselben Struktur, also müssen Zeile 2 und Spalte 2 verschiedene Elemente sein. Verschieben Sie die Spalten um eine Konstante, die größer ist als jeder Zeilenindex, üblich ist c + 10001 bei den angegebenen Grenzen, oder verwenden Sie ein Wörterbuch mit den Schlüsseln ("r", r) und ("c", c). Die Kollision anzusprechen, bevor der Interviewer es tut, ist bei dieser Aufgabe viel wert.
Die Falle. Komponenten über alle existierenden Zeilen und Spalten zu zählen statt nur über die, die tatsächlich einen Stein enthalten. Leere Zeilen sind isolierte Elemente, jede erhöht die Komponentenzahl, und die Antwort fällt zu klein aus. Legen Sie ein Element erst an, wenn ein Stein es zum ersten Mal braucht.
8. Evaluate Division: gewichtetes Union-Find
Die Frage. Gegeben sind Gleichungen wie a / b = 2.0 und b / c = 3.0, und es sollen Anfragen wie a / c beantwortet werden, wobei -1 zurückkommt, wenn sich die Antwort nicht bestimmen lässt.
Die meisten Kandidaten bauen einen Graphen und lassen eine DFS laufen, die die Kantengewichte entlang des Pfads multipliziert, und das ist eine völlig gute Antwort. Die stärkere Antwort ist gewichtetes Union-Find: Neben jedem Elternzeiger wird das Verhältnis des Werts des Kindes zum Wert des Elternknotens gespeichert. Dann liefert find sowohl die Wurzel als auch das bis dorthin aufmultiplizierte Verhältnis, und jede Anfrage ist eine einzige Division.
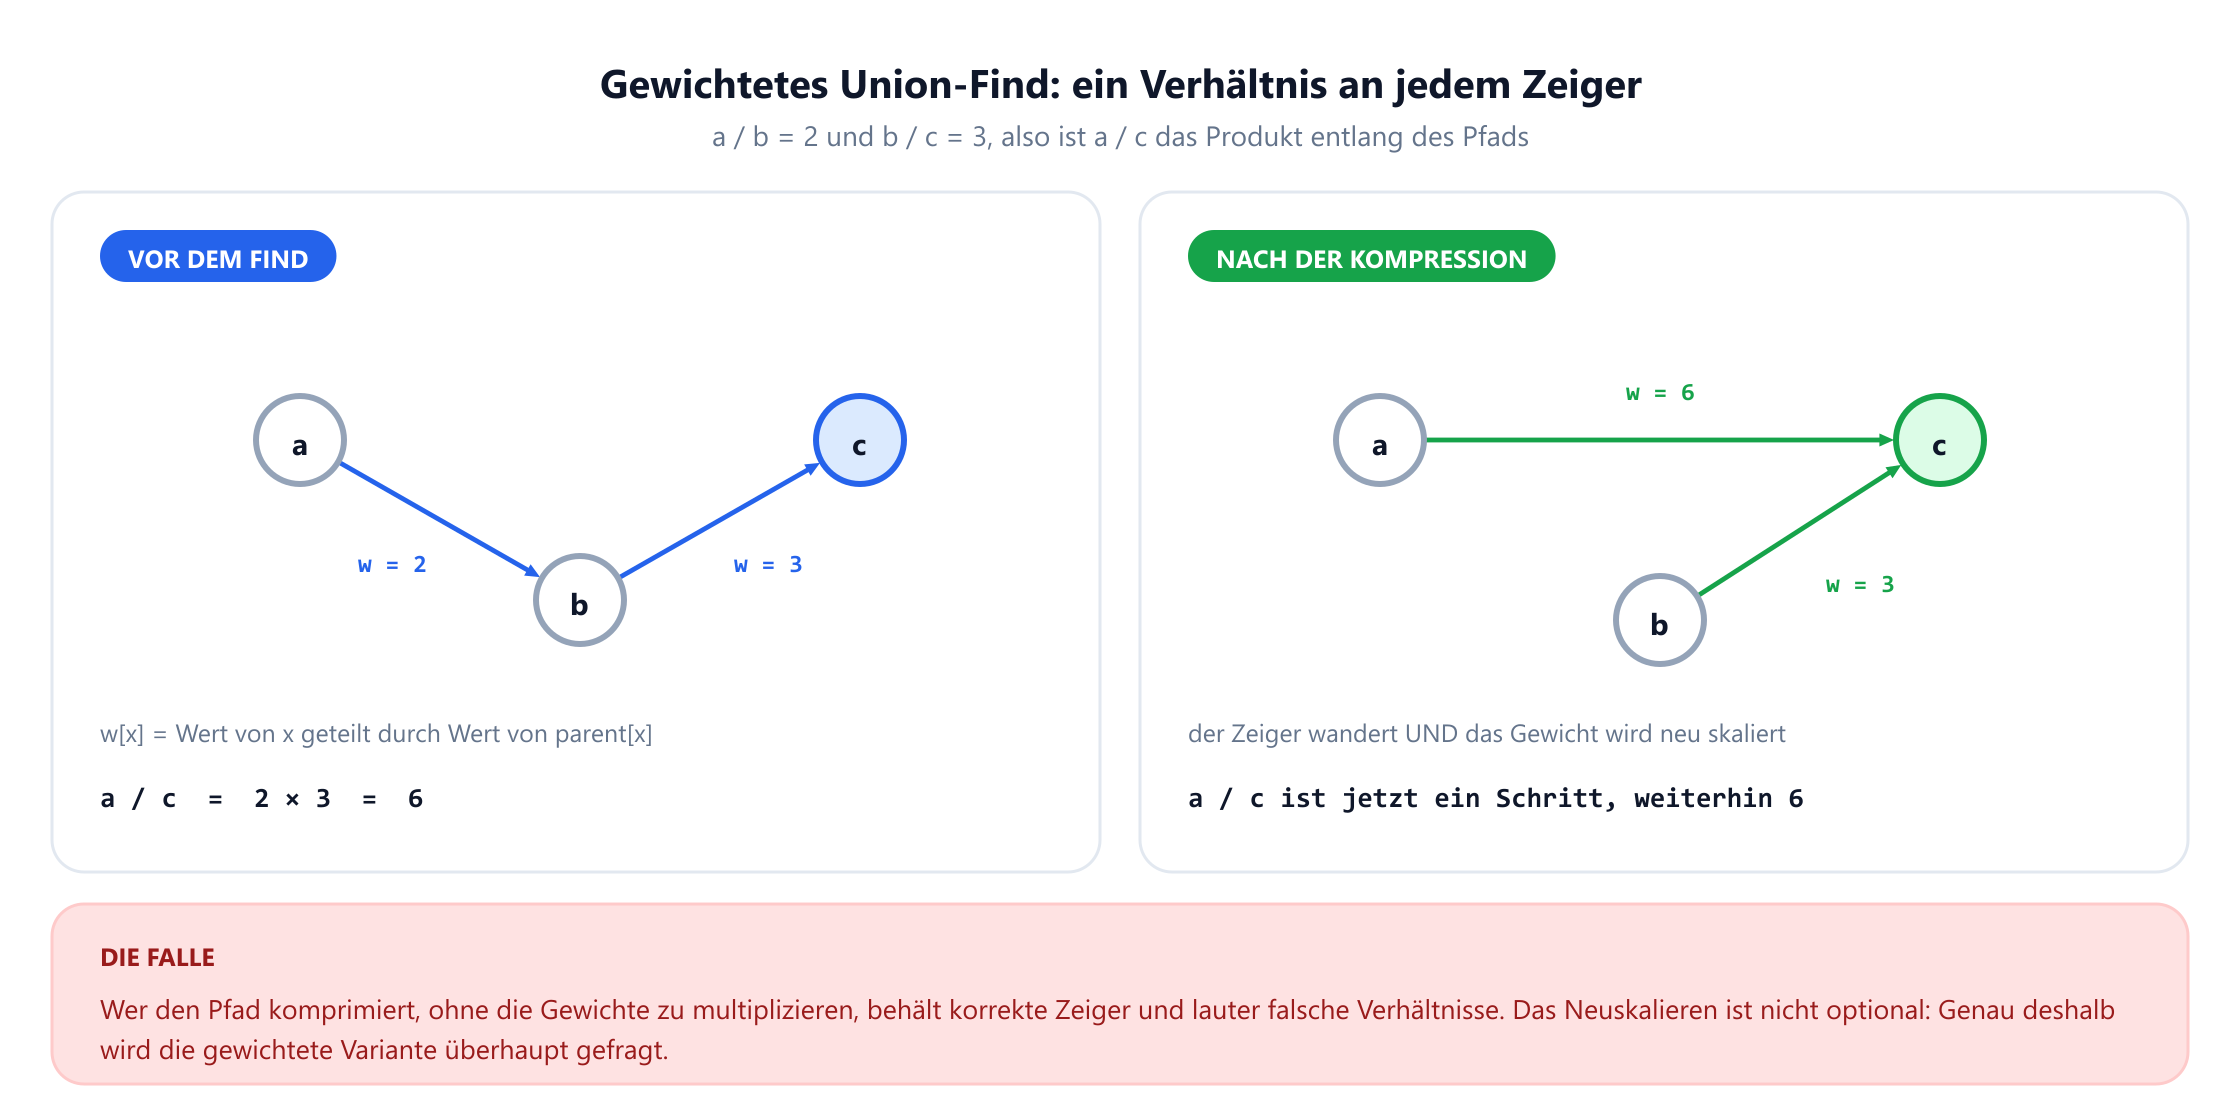
def find(x):                              # liefert (Wurzel, Wert von x / Wert der Wurzel)
    if parent[x] == x:
        return x, 1.0
    root, wp = find(parent[x])
    weight[x] *= wp                       # beim Abflachen des Pfads neu skalieren
    parent[x] = root
    return root, weight[x]
Mit a / b = 2 und b / c = 3 ergeben die Anfragen a / c = 6, b / a = 0.5, c / a = 1/6, a / a = 1 und -1 für alles, was ein nie aufgetretenes Symbol enthält, weshalb x / x in der Standardaufgabe -1 ergibt und nicht 1. Dieser letzte Fall ist ein bewusster Trick, und er erwischt alle, die gleiche Argumente als Sonderfall behandeln, bevor sie prüfen, ob das Symbol existiert.
Die Nachfrage: Wie erkennen Sie einen Widerspruch? Wenn union(a, b, v) feststellt, dass a und b schon eine Wurzel teilen, wird nicht verschmolzen; vergleichen Sie stattdessen das implizierte Verhältnis mit v. Eine Abweichung jenseits der Gleitkommatoleranz bedeutet, dass die Eingabe widersprüchlich ist. Dieselbe Struktur mit Addition statt Multiplikation beantwortet „ist diese Menge von Abstandsbedingungen erfüllbar“, und so taucht die Technik in Planungsaufgaben auf.
Die Falle. Den Pfad zu komprimieren, ohne das Gewicht zu aktualisieren, also genau der Fehler, vor dem die Abbildung warnt. Die Zeiger bleiben korrekt, jede spätere Anfrage liefert stillschweigend eine falsche Zahl, und der Fehler übersteht jeden Test, der nur den Zusammenhang prüft.
9. Gleichheitsgleichungen: die Reihenfolge der Verarbeitung
Die Frage. Gegeben sind Gleichungen wie "a==b" und "b!=c" über einzelne Kleinbuchstaben. Entscheiden Sie, ob alle gleichzeitig wahr sein können.
Die Lösung sind vier Zeilen und eine Idee: zwei Durchläufe, Gleichheiten zuerst.
dsu = DSU(26)
for e in equations:
    if e[1] == '=':
        dsu.union(ord(e[0]) - 97, ord(e[3]) - 97)
for e in equations:
    if e[1] == '!':
        if dsu.find(ord(e[0]) - 97) == dsu.find(ord(e[3]) - 97):
            return False
return True
Gleichheit ist eine Äquivalenzrelation und zerlegt die Buchstaben daher in Gruppen, die denselben Wert haben müssen. Ungleichheit ist keine Äquivalenzrelation und lässt sich überhaupt nicht vereinigen; sie kann nur gegen die fertige Zerlegung geprüft werden. Verarbeiten Sie beide in einem verzahnten Durchlauf, hängt die Antwort von der Eingabereihenfolge ab, und genau diesen Fehler soll die Frage aufdecken: ["a!=b", "a==b"] würde akzeptiert, weil die Ungleichheit vor der Union geprüft wird, die ihr widerspricht.
Überprüfte Ausgaben: ["a==b","b!=a"] ist False, ["a==b","b==c","a==c"] ist True, ["a==b","b!=c","c==a"] ist False, und die einzelne Gleichung ["a!=a"] ist False, weil ein Buchstabe immer sich selbst gleich ist.
Die Nachfrage: Und wenn die Variablen keine einzelnen Buchstaben wären? Genau die ID-Zuordnung aus Abschnitt 6: jeden Namen auf eine dichte Ganzzahl abbilden oder das Elternwörterbuch mit dem Namen schlüsseln. Sonst ändert sich nichts, und darauf hinzuweisen ist gut, weil es zeigt, dass Sie die Struktur getrennt von der Kodierung sehen.
Die Falle. Das DSU über die vorkommenden Buchstaben anzulegen statt über alle 26. Es funktioniert, und es kostet Sie die zwei Minuten, in denen Sie eine Zuordnung für ein Alphabet bauen, das ohnehin dicht und winzig ist. Lesen Sie die Randbedingungen, bevor Sie generischen Code schreiben.
10. Kruskal: Union-Find in einem Spannbaum
Die Frage. Verbinden Sie alle Punkte mit minimalen Gesamtkosten, wobei die Kosten zwischen zwei Punkten ihre Manhattan-Distanz sind. Das ist LeetCode 1584, und es ist ein minimaler Spannbaum mit Hut.
Union-Find ist hier nicht die Antwort, sondern das Bauteil, das die Antwort funktionieren lässt. Der Algorithmus von Kruskal sortiert jede Kandidatenkante nach Gewicht und nimmt eine Kante genau dann an, wenn sie zwei verschiedene Komponenten verbindet, und das ist der Wahrheitswert, den union zurückgibt.
edges.sort()                              # nach Gewicht
dsu, total, used = DSU(n), 0, 0
for w, a, b in edges:
    if dsu.union(a, b):                   # nur wenn sie zwei Komponenten verbindet
        total += w
        used += 1
        if used == n - 1:                 # ein Spannbaum hat n-1 Kanten
            break
Bei den fünf Punkten [[0,0],[2,2],[3,10],[5,2],[7,0]] gibt es 10 Kandidatenkanten, Kruskal behält vier davon mit den Gewichten 3, 4, 4 und 9, und die Summe ist 20. Der frühe Abbruch bei n - 1 Kanten zählt bei dichten Eingaben, wo die Kandidatenliste O(n2) groß ist und das meiste davon nie gebraucht wird.
Die Nachfrage: Prim oder Kruskal hier? Für einen vollständigen Graphen auf n Punkten baut und sortiert Kruskal n(n-1)/2 Kanten, also O(n2 log n), während Prim mit einem Array-Durchlauf in O(n2) läuft und die Kantenliste nie aufbaut. Bei einer dichten Instanz ist Prim die bessere Antwort, und zu wissen, dass Kruskal der Algorithmus für dünne Graphen ist, ist der Sinn der Frage. Der Kompromiss wird durchgerechnet in minimalen Spannbäumen und im Algorithmus von Kruskal.
Die Falle. Das Gewicht zu addieren, bevor die Union geprüft wird, sodass abgelehnte Kanten trotzdem zur Summe beitragen. Das ergibt eine Zahl, die beim Beispiel nah genug wirkt und bei allem anderen falsch ist.
11. Die Antworten zur Komplexität
Das ist das eine Thema, bei dem die ehrliche Antwort etwas unbequem ist, und Interviewer fragen gerade deshalb.
| Variante | Amortisiert pro Operation | Quelle |
|---|---|---|
| Keine Optimierung | O(n) | Die Kette in der Abbildung oben |
| Nur Union nach Größe oder Rang | O(log n) | Die Tiefe verdoppelt sich nur bei gleich großen Verschmelzungen |
| Nur Pfadkompression | O(log n) | Tarjan und van Leeuwen, 1984 |
| Beides zusammen | O(α(n)) | Tarjan, 1975 |
| Jede zeigerbasierte Struktur | Ω(α(n)) | Fredman und Saks, 1989 |
α ist die inverse Ackermann-Funktion, und sie wächst so langsam, dass α(n) ≤ 4 für jedes n gilt, das sich in irgendeinem physischen Computer speichern ließe. Die praktische Antwort lautet also „effektiv konstant“, und die korrekte Antwort lautet „O(α(n)) amortisiert, was nicht dasselbe ist wie O(1)“. Der Unterschied ist real: Fredman und Saks haben 1989 bewiesen, dass keine Struktur dieser Art es besser kann, das α ist also kein Artefakt der Analyse.
Zwei weitere Zahlen, die Sie parat haben sollten. Der Speicherbedarf ist O(n), zwei Ganzzahlarrays. Und die Amortisierung gilt pro Folge, nicht pro Aufruf: Ein einzelnes find kann immer noch einen langen Pfad ablaufen, beschränkt ist die Summe über m Operationen. Interviewer bohren da manchmal nach, und „amortisiert, nicht Worst Case pro Operation“ ist die Formulierung, die sie hören wollen.
Zur Kontrolle, wie flach die Bäume wirklich werden: Nach 200.000 zufälligen Unions über 100.000 Elemente und einem find auf jedem Element ist der tiefste Baum der Struktur ein Zeiger tief. Jedes Element zeigt direkt auf seine Wurzel.
12. Fehler, an denen das Interview scheitert
Geordnet nach Häufigkeit; die ersten drei erklären die meisten abgelehnten Lösungen.
- Elemente statt Wurzeln vergleichen.
if a == b, woif find(a) == find(b)gemeint war. Es kompiliert, es läuft, und es beantwortet eine andere Frage. - Union nach Größe weglassen. Pfadkompression allein besteht meistens, also übersteht das die Tests und bricht dann bei feindseliger Eingabe ein. Beide Optimierungen sind je eine Zeile; schreiben Sie beide.
- Rekursives
findbei tiefer Eingabe. Hunderttausend verkettete Unions sind hunderttausend Stackframes. Schreiben Sie die iterative Version, oder begründen Sie, warum die Rekursionstiefe hier sicher ist. - Off-by-one bei der Arraygröße. Knoten mit den Nummern 1 bis n brauchen
DSU(n + 1). Das ist der häufigste Absturz bei diesen Aufgaben. - Das Falsche vereinigen. Steine statt Zeilen und Spalten, Konten statt E-Mails, Namen statt Identitäten. Wenn die paarweise Version quadratisch aussieht, sind meist die Elemente falsch gewählt.
- Gleichheiten und Ungleichheiten verzahnen. Bedingungen, die verschmelzen, müssen alle angewendet sein, bevor irgendeine Bedingung geprüft wird, die nur kontrolliert. Zwei Durchläufe, immer.
- Vergessen, dass Union-Find nicht löschen kann. Wenn die Aufgabe Kanten entfernt, sagen Sie das sofort und bieten Sie Offline-Umkehrung oder eine Rollback-Struktur an. Löschen in eine komprimierte Struktur hineinzuflicken ist eine Sackgasse.
- Die Komponentenzahl nicht mitführen. Sie nach jeder Operation mit einer Schleife über
findneu zu berechnen, macht aus einer linearen Lösung eine quadratische, und genau diese Schwäche soll Islands II aufdecken. - O(1) nennen. Es ist
O(α(n))amortisiert. Sagen Sie „effektiv konstant, formal inverse Ackermann-Funktion“, und die Nachfrage erledigt sich.
Die Gewohnheit, die die meisten dieser Fehler verhindert: Sagen Sie, bevor Sie irgendetwas schreiben, wofür ein Element steht und was es bedeutet, dass zwei davon in derselben Menge liegen. Wenn Sie nicht beide Hälften dieses Satzes zu Ende bringen können, haben Sie das Problem noch nicht modelliert, und die fünfzehn Zeilen werden Sie nicht retten.
13. Häufig gestellte Fragen
Was ist Union-Find, einfach erklärt?
+
Eine Struktur, die festhält, welche Elemente zur selben Gruppe gehören, mit zwei Operationen: find, das fragt, in welcher Gruppe ein Element ist, und union, das zwei Gruppen verschmilzt. Jede Gruppe wird als Baum aus Elternzeigern gespeichert und durch dessen Wurzel identifiziert, also liegen zwei Elemente genau dann in derselben Gruppe, wenn sie dieselbe Wurzel haben. Man nennt sie auch Disjoint Set Union oder DSU.
Wann sollte ich Union-Find statt BFS oder DFS verwenden?
+
Nehmen Sie eine Traversierung, wenn der Graph fest ist und Sie ihn einmal durchlaufen, denn beide Ansätze sind linear und eine Traversierung braucht keine zusätzliche Struktur. Nehmen Sie Union-Find, wenn Kanten nach und nach eintreffen und die Antwort nach jeder gebraucht wird, wenn die Aufgabe Gruppen immer nur verschmilzt und nie trennt oder wenn Sie den Wahrheitswert „waren diese schon verbunden“ als Teil eines anderen Algorithmus brauchen, wie es der Algorithmus von Kruskal tut. Union-Find braucht außerdem überhaupt keine Adjazenzliste, was wichtig ist, wenn die Paare vorbeiströmen, statt in den Speicher zu passen.
Ist Union-Find wirklich O(1)?
+
Nein, und das sollten Sie richtig beantworten. Mit Union nach Größe oder Rang plus Pfadkompression kosten m Operationen auf n Elementen amortisiert O(m mal alpha von n), wobei alpha die inverse Ackermann-Funktion ist. Alpha von n ist für jedes n, das sich physisch speichern ließe, höchstens 4, das praktische Verhalten ist also konstant, aber die Schranke ist nicht O(1), und der Unterschied ist keine Formalität: Fredman und Saks haben 1989 bewiesen, dass keine Struktur dieser Art alpha unterbieten kann. Sagen Sie „effektiv konstant, formal inverse Ackermann-Funktion, amortisiert statt Worst Case pro Aufruf“.
Union nach Rang oder Union nach Größe?
+
Beides, denn beide liefern dieselbe asymptotische Schranke. Der Rang speichert eine obere Schranke für die Höhe eines Baums, die Größe, wie viele Elemente er enthält. Im Interview ist die Größe meist die bessere Wahl, weil ein großer Teil der Nachfragen nach der Größe der verschmolzenen Komponente fragt, und mit Union nach Größe haben Sie diese Zahl gratis. Was Sie auch wählen: Hängen Sie den kleineren Baum unter den größeren, nie umgekehrt.
Kann Union-Find Löschungen verarbeiten?
+
Nicht direkt. Sind die Pfade einmal komprimiert, gibt es keine Aufzeichnung, wie die Bäume zusammengesetzt wurden, also lässt sich eine Verschmelzung nicht rückgängig machen. Es gibt zwei Standardantworten. Verarbeiten Sie die Operationen offline in umgekehrter Reihenfolge, wodurch jede Löschung zu einer Hinzufügung wird und gewöhnliches Union-Find rückwärts laufen kann. Oder verwenden Sie ein Union-Find mit Rollback, das einen Rückgängig-Stapel der Änderungen jeder Union führt und deshalb auf Pfadkompression verzichten muss, sodass nur Union nach Rang mit O(log n) pro Operation bleibt.
Wie verwende ich Union-Find, wenn die Elemente Zeichenketten sind?
+
Zwei Möglichkeiten. Geben Sie jeder verschiedenen Zeichenkette beim ersten Auftreten eine dichte Ganzzahl und verwenden Sie die gewöhnliche arraybasierte Struktur, die schneller ist und die Sie wollen, wenn die Struktur in einer heißen Schleife steckt. Oder speichern Sie die Elternzuordnung als Wörterbuch, dessen Schlüssel die Zeichenkette selbst ist, was kürzer zu schreiben ist und pro Zugriff einen Hash-Lookup kostet. Beides ist korrekt; zu sagen, welchen Kompromiss Sie eingehen, ist das, worauf der Interviewer hört.
Welche Interviewaufgaben sind Union-Find?
+
Number of Connected Components, Number of Provinces, Redundant Connection, Number of Islands II, Accounts Merge, Most Stones Removed, Evaluate Division, Satisfiability of Equality Equations, Min Cost to Connect All Points, Graph Valid Tree, Smallest String With Swaps und Regions Cut By Slashes. Das Erkennungszeichen ist eine Frage danach, ob zwei Dinge zur selben Gruppe gehören, oder eine Anzahl von Gruppen, die einen Strom von Verschmelzungen überstehen muss.
14. Quellen
Die Arbeiten, die diese Techniken eingeführt haben, und die Lehrbücher, die sie analysieren, in chronologischer Reihenfolge.
- Kruskal, J. B. (1956). “On the shortest spanning subtree of a graph and the traveling salesman problem.” Proceedings of the American Mathematical Society, 7(1), 48–50.
- Galler, B. A. und Fischer, M. J. (1964). “An improved equivalence algorithm.” Communications of the ACM, 7(5), 301–303.
- Hopcroft, J. E. und Ullman, J. D. (1973). “Set merging algorithms.” SIAM Journal on Computing, 2(4), 294–303.
- Tarjan, R. E. (1975). “Efficiency of a good but not linear set union algorithm.” Journal of the ACM, 22(2), 215–225.
- Tarjan, R. E. und van Leeuwen, J. (1984). “Worst-case analysis of set union algorithms.” Journal of the ACM, 31(2), 245–281.
- Fredman, M. und Saks, M. (1989). “The cell probe complexity of dynamic data structures.” Proceedings of the 21st Annual ACM Symposium on Theory of Computing, 345–354.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. und Stein, C. (2009). Introduction to Algorithms, 3. Auflage, Kapitel 21. MIT Press.
- Sedgewick, R. und Wayne, K. (2011). Algorithms, 4. Auflage, Abschnitt 1.5. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6. Auflage. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3. Auflage, Kapitel 8. Springer.