
目录
1. 并查集题真正考察什么
并查集是少有的实现本身并不难的面试题目。十五行代码、两个优化,没有什么值得争论的边界情况。面试官很清楚这一点,所以题目的难点完全设在别处。
它们考察三件事。你能认出连通性问题吗?凡是表述为“这两个是否在同一组”“一共有多少组”或“哪个改变会合并两个组”的问题,都是并查集,哪怕题目里说的是账户、石头、方程还是电缆。你知道它什么时候胜过遍历吗?对单张静态图, BFS 或 DFS 一次扫描同样快;当边一条一条到达、每到一条都需要答案时,并查集才占优。你会选择元素吗?难题就藏在这里,第 7 节也主要讨论这一点。
下面八道题是反复出现的题目,每道都给出解法、追问以及让你丢掉 offer 的错误。本页每个详解示例都用脚本运行过。如果你想看从零推导这个数据结构,而不是简要回顾,请参阅并查集指南。
2. 模板,以及关键的两行
要能不假思索地写出来。两个优化,各占一行,面试官会点名问这两个。
class DSU:
    def __init__(self, n):
        self.parent = list(range(n))
        self.size = [1] * n
        self.count = n                       # 连通分量数,顺手得到

    def find(self, x):
        root = x
        while self.parent[root] != root:
            root = self.parent[root]
        while self.parent[x] != root:        # 路径压缩:把走过的路径拉平
            self.parent[x], x = root, self.parent[x]
        return root

    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False                     # 已经在一起:无需合并
        if self.size[ra] < self.size[rb]:    # 按大小合并:小树挂到大树下
            ra, rb = rb, ra
        self.parent[rb] = ra
        self.size[ra] += self.size[rb]
        self.count -= 1
        return True
有三个细节要一边写一边说出来。 union 返回一个布尔值,这个返回值回答了本页一半的问题: False 表示两者已经连通,也就是说你刚尝试的那条边闭合了一个环。 count 由合并操作维护,所以统计分量永远不需要第二遍扫描。另外,上面的 find 是迭代的,这在十万个元素组成的链上很重要,递归版本会在调用栈上崩溃。
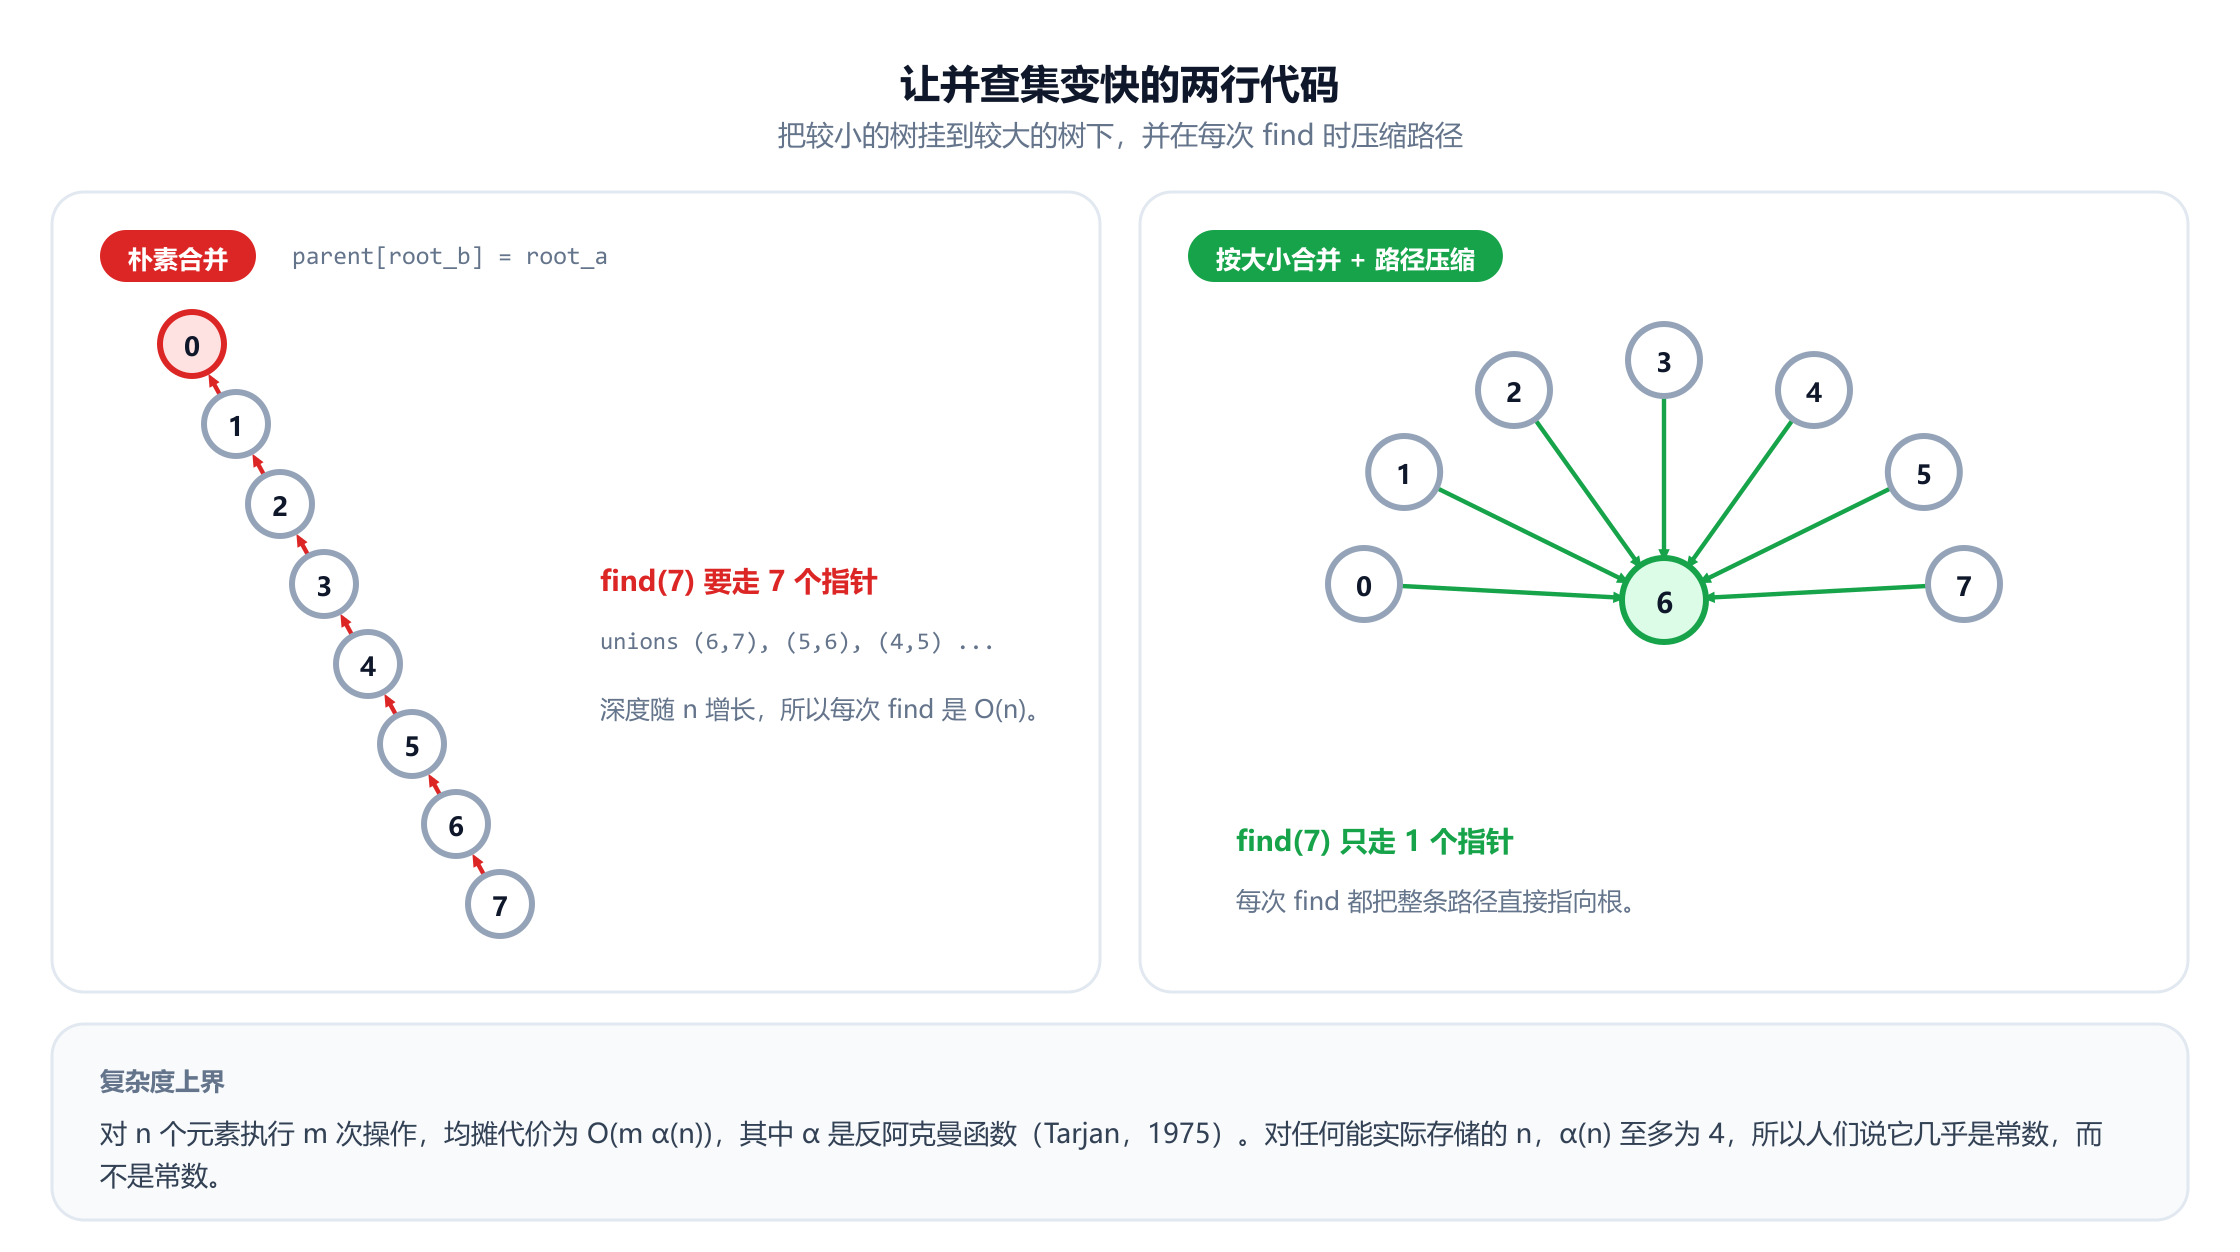
parent[rb] = ra 却不检查大小时得到的结果。为什么两个优化都要?只按大小合并就能把深度限制在 O(log n),因为只有两棵大小相同的树合并时树才会变高。只用路径压缩,均摊也是 O(log n)。两者结合,每次操作均摊 O(α(n)),这是第 11 节的内容。如果只能记住一个,就记住路径压缩:它只有一行,而且在实践中完成了大部分工作。
有一条实现上的说明值得主动提出:按秩合并和按大小合并可以互换,复杂度上界相同。秩存储的是高度的上界,大小存储的是元素个数。面试中大小更有用,因为一半的追问都会问合并后分量的大小,而你已经有了这个数。
3. 统计连通分量
题目。给定 n 个节点和一个无向边列表,共有多少个连通分量?经典表述是 LeetCode 323,省份数量是同一道题,只是用邻接矩阵给出。
有了上面的模板,就没有算法需要写了。
def count_components(n, edges):
    dsu = DSU(n)
    for a, b in edges:
        dsu.union(a, b)
    return dsu.count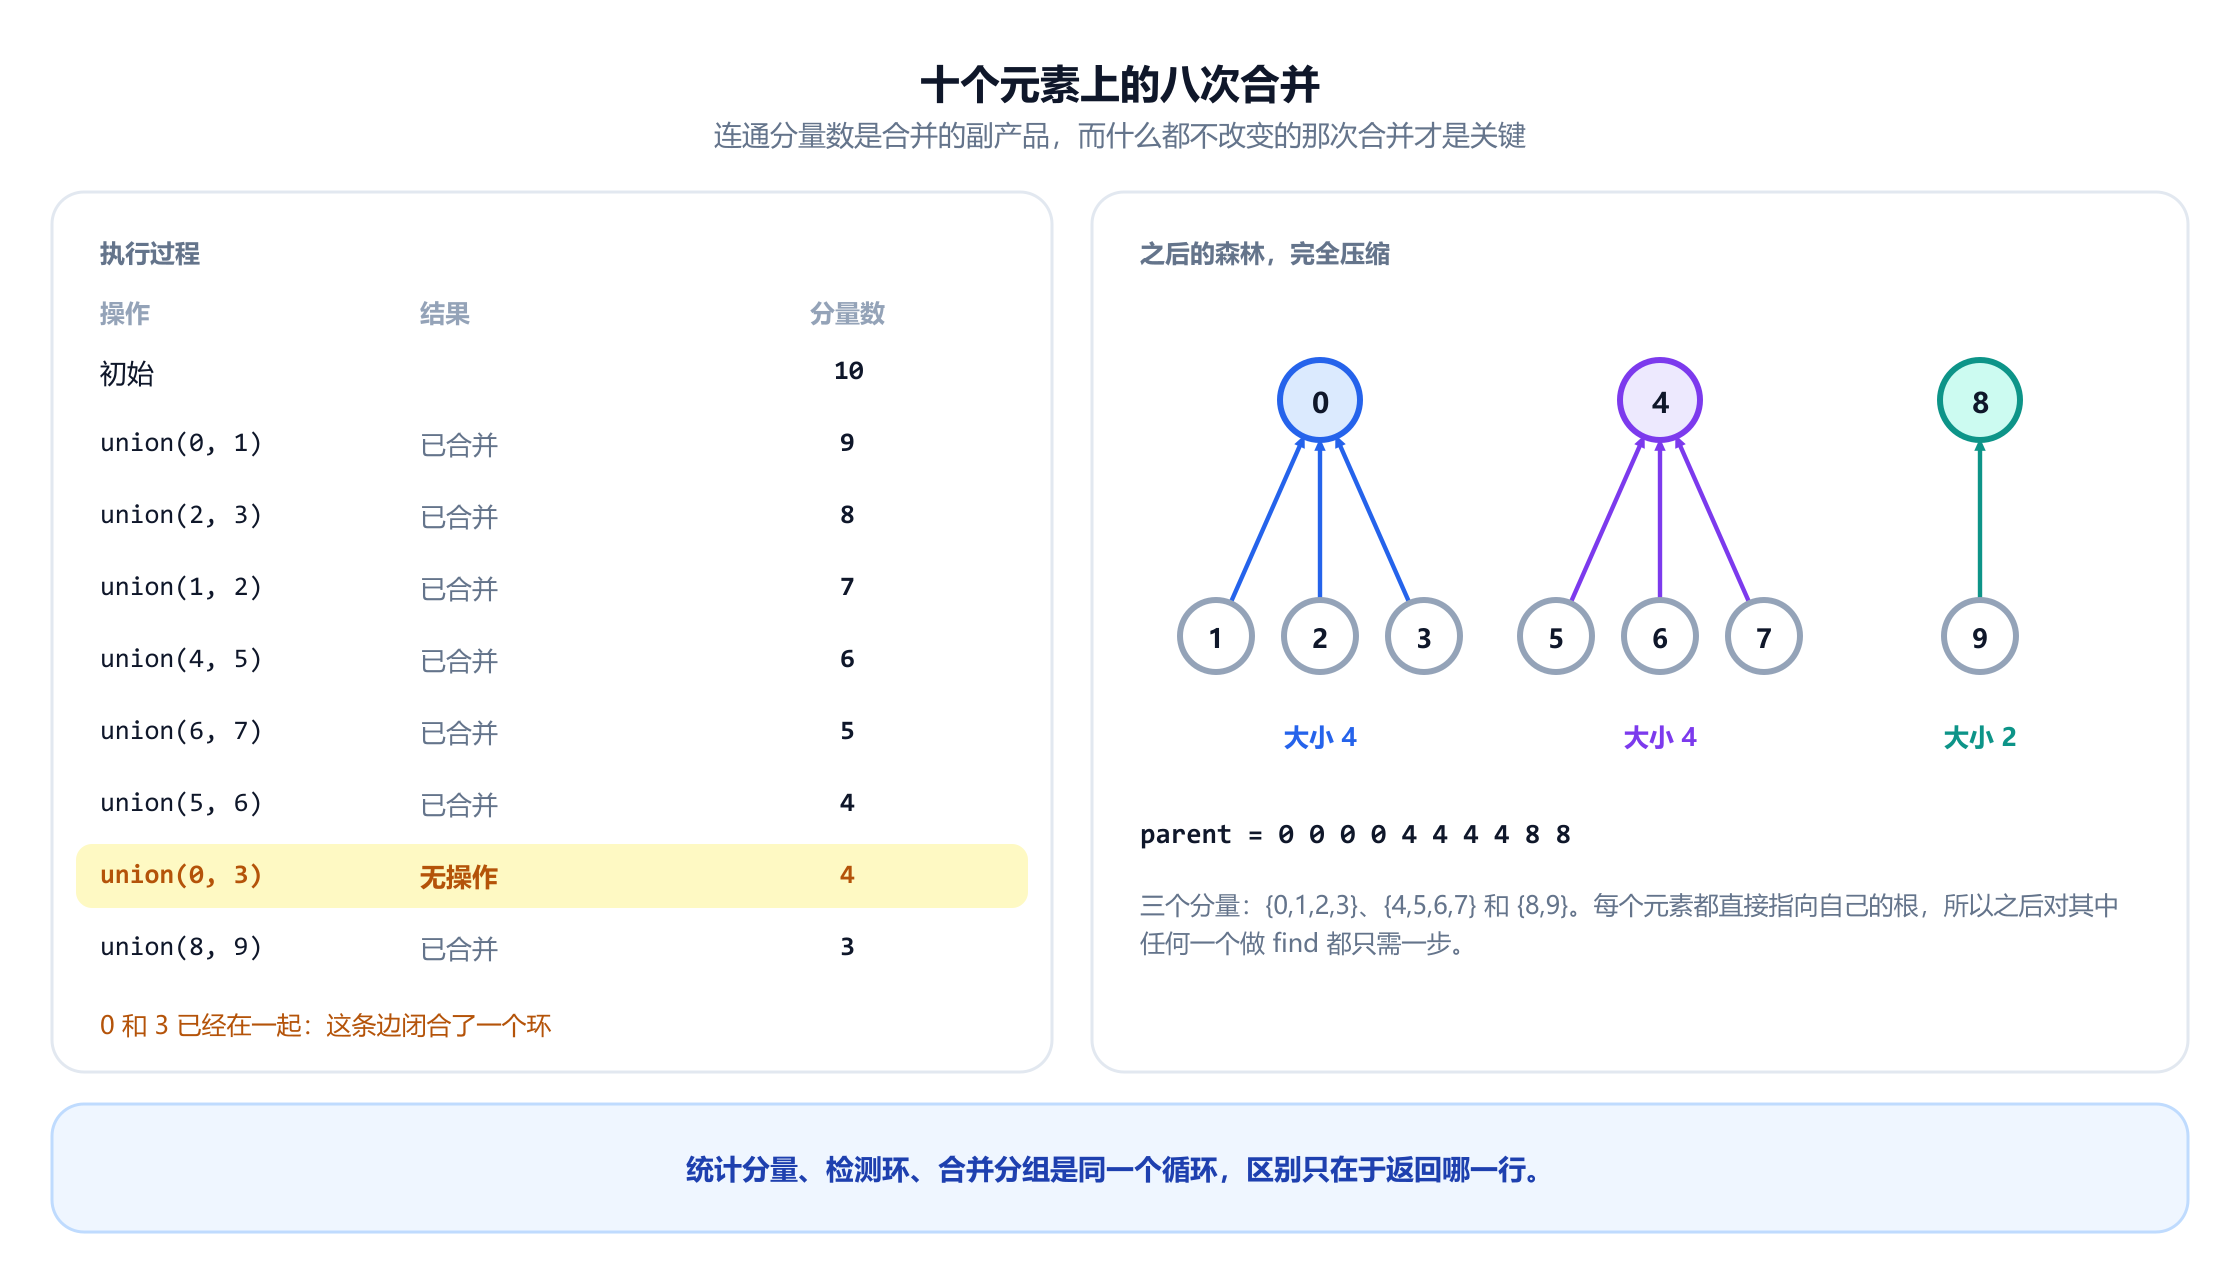
在示例中,十个元素经过八次合并 (0,1) (2,3) (1,2) (4,5) (6,7) (5,6) (0,3) (8,9) 后剩下三个分量: {0,1,2,3}、 {4,5,6,7} 和 {8,9},大小分别为 4、4 和 2。七次合并成功; union(0, 3) 没有,因为那时 0 和 3 已经在同一棵树里了。
之后对每个元素执行一次 find,结构最终变为 parent = 0 0 0 0 4 4 4 4 8 8:每个元素都直接指向其分量的根,所以之后的每次查询都只需一步。这种扁平化就是路径压缩带来的回报。
追问:为什么不直接用 DFS?对静态图,那就用 DFS。两者都是线性的,而 DFS 不需要额外的结构,所以对固定边列表动用并查集与其说是加分项,不如说是个小小的警示信号。诚实的回答是:当边随时间到达、每次到达后都需要答案,或者图太大无法存成邻接表而数据对是以流的形式经过时,并查集才有它的用武之地。主动说出这一点,能让你区别于那些一看到“分量”二字就套模板的候选人。
陷阱。返回 len(set(parent)),它统计的是 parent 中不同值的个数,却从未调用 find。在压缩之前,父数组里存的是中间节点而不是根,所以数出来会偏大。维护好 count,在 union 中随合并更新它,这个问题就不会出现。
4. 冗余连接:闭合环的那条边
题目。一棵有 n 个节点的树被多加了一条边。找出可以删除的那条边;如果有多条符合条件,返回输入中最后出现的那条。
这就是 union返回的布尔值,别无其他。
def find_redundant(edges):
    dsu = DSU(len(edges) + 1)
    for a, b in edges:
        if not dsu.union(a, b):          # a 和 b 已经连通
            return [a, b]                # 所以这条边闭合了一个环
按顺序处理各条边,第一条使 union 返回 False 的边就是答案。它也自动是输入中最后一条这样的边,因为树加一条边恰好有一个环,所以恰好有一条边会失败。在 [[1,2],[2,3],[3,4],[1,4],[1,5]] 上答案是 [1,4],在三角形 [[1,2],[1,3],[2,3]] 上答案是 [2,3]。
追问:如果图是有向的呢?那是冗余连接 II,它确实是一道更难的题,而不是一个变体。有向版本可能以两种方式出问题:某个节点有两个父节点,或者存在环,而且两者可能同时出现。技巧是找到入度为二的节点,依次尝试删除它的两条候选边,再用并查集检验剩下的部分是否构成合法的有根树。知道有向情况要分情形讨论就够了,面试官很少会让你把它写出来。
陷阱。在节点编号为 1 到 n 时使用 DSU(n)。这类并查集错误都是数组大小差一,而且它表现为最后一个节点上的索引越界,而不是错误答案。应当分配 n + 1 并忽略第 0 个位置。
5. 岛屿数量 II:网格变化时 BFS 为何落败
题目。一个空的 m × n 网格,全是水。每次添加一个格子的陆地。每次添加后,报告共有多少个岛屿。
正是这道题证明了整个数据结构的价值,所以要把它当作必须答对的那道题。在固定网格上数岛屿是一次洪水填充,代价是 O(mn)。在 k 次添加中每次都这样做,代价是 O(k × mn),这是平方级的,会超时。并查集把每次添加变成常数量的工作,因为添加陆地只可能合并岛屿,永远不会把岛屿拆开。
def num_islands2(m, n, positions):
    dsu, seen, out, count = {}, set(), [], 0
    for r, c in positions:
        if (r, c) in seen:               # 重复的位置不产生变化
            out.append(count)
            continue
        seen.add((r, c))
        dsu[(r, c)] = (r, c)             # 一个只有一格的新岛屿
        count += 1
        for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
            nb = (r + dr, c + dc)
            if nb in seen and union(dsu, (r, c), nb):
                count -= 1               # 与邻居合并
        out.append(count)
    return out
每个新格子一开始是一个独立的岛屿,然后最多和四个邻居合并,所以每一步的代价是 O(α),整个过程是 O(k α(mn))。在 3 乘 3 的网格上依次在 (0,0), (0,1), (1,2), (2,1) 添加陆地,答案是 1, 1, 2, 3:第二个格子并入第一个,接下来两个是孤立的。第五步再添加 (1,1),它同时接触这三个岛屿,所以序列以 1, 1, 2, 3, 1结束。
追问:如果陆地也可以被移除呢?要明确说出并查集不支持删除,因为路径压缩之后无法撤销一次合并。真正的答案是离线倒序处理操作,把删除变成添加;或者使用可回滚的并查集,它维护一个撤销栈,因此放弃路径压缩,只保留按秩合并,代价为 O(log n)。说出“离线倒序”通常就够了。
陷阱。忘了同一个位置可能在输入中出现两次。在已有陆地的地方再添加陆地不能让计数增加,而防护只需一行。这也是这道题唯一的隐藏测试用例。
6. 账户合并:当元素不是整数时
题目。每个账户是一个名字加一串邮箱。两个账户只要共享任意一个邮箱,就属于同一个人。把它们合并,并返回每个人排好序的邮箱。
结构上这显然就是并查集。这道题真正考的是管道工作:你的元素是字符串,而基于数组的并查集需要整数。
ids = {}
for account in accounts:
    for mail in account[1:]:
        if mail not in ids:
            ids[mail] = len(ids)         # 给每个邮箱分配一个连续整数
        owner[mail] = account[0]

dsu = DSU(len(ids))
for account in accounts:
    first = ids[account[1]]
    for mail in account[2:]:
dsu.union(first, ids[mail]) # 把每个邮箱连到第一个把一个账户中的每个邮箱与该账户的第一个邮箱合并,这就足以让整个账户成为一个分量,然后按根把邮箱分组并对每组排序。合并 John [a, b]、 John [c, b]、 Mary [m] 和第二个 John [z] 得到三个人:John 拥有 a, b, c,Mary 拥有 m,另一个 John 只拥有 z。
最后这一组才是这道题的重点。名字不是身份。两个同名但没有共享邮箱的账户是两个不同的人,按名字合并的候选人会得到一个看似合理的错误答案,而样例输入正是故意设计来抓这个错误的。
追问:能不能不做编号映射?可以,把 parent 存成以字符串本身为键的字典,每次访问的代价是一次哈希而不是一次数组下标。这样写起来更简洁,运行起来更慢,而说清楚你在做哪种取舍才是得分点。在热点路径上没有字典的语言里,或者同一结构要被重用数百万次时,稠密整数映射更胜一筹。
陷阱。通过根的邮箱去查名字,而不是维护一个从邮箱到名字的映射。压缩之后,根可能是组里的任何一个邮箱,如果你把名字记在某个特定邮箱上,就会给合并后的账户配上错误的名字。
7. 移除石头:选择合并什么
题目。石头放在网格上。如果一块石头与另一块仍在的石头同行或同列,就可以移除它。最多能移除多少块?
两个洞见,而第二个才让它成为一道好的面试题。
第一,任何一个连通的石头组都可以移除到只剩一块。按照构建该组生成树的逆序移除,先移除叶子,最后剩下的那块石头能保证每一步都合法。所以答案是 石头总数 - 分量数,整个问题就归结为统计分量。
第二,这也是在压力下最难想到的部分:不要合并石头。要合并行和列。
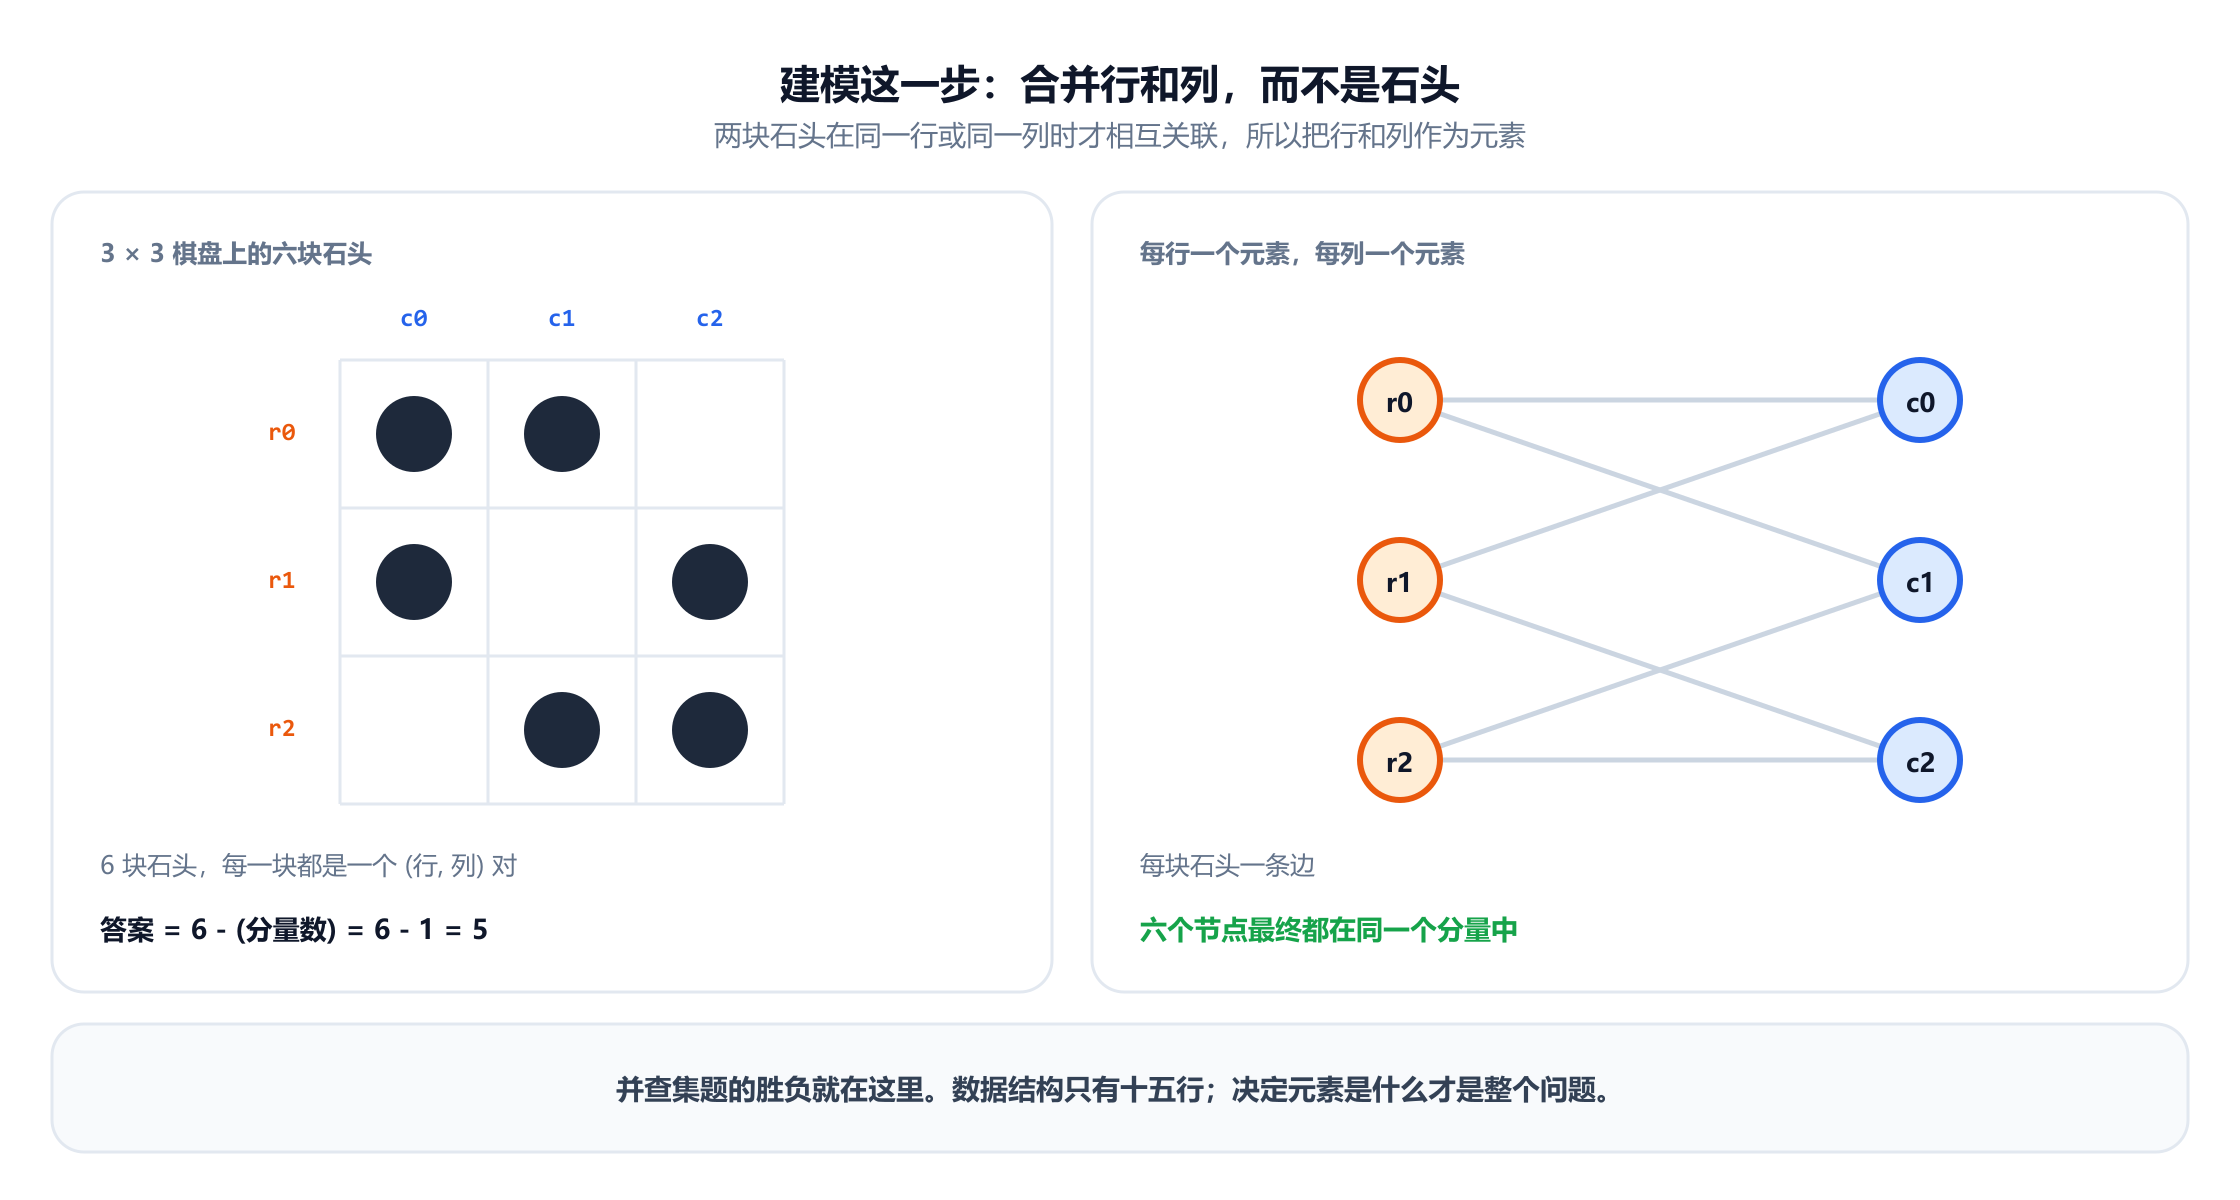
位于 (r, c) 的每块石头都变成一次 union(第 r 行, 第 c 列)。两块石头恰好在同行或同列,或者通过一串这样的石头相连时才会连通,这正是题目描述的关系。它还把一个 O(k2) 的两两比较变成了 O(k α)的过程。在六块石头的例子中,整个棋盘塌缩成一个分量,答案是 5。在 [[0,0],[0,2],[1,1],[2,0],[2,2]] 上有两个分量,答案是 3。
追问:如何避免行和列冲突?它们在同一个结构里,所以 第 2 行 和 第 2 列 必须是不同的元素。把列加上一个比任何行下标都大的常数作为偏移,按题目给出的范围通常是 c + 10001,或者使用以 ("r", r) 和 ("c", c)为键的字典。在面试官提出之前主动说出这种冲突,在这道题上很加分。
陷阱。在所有存在的行和列上统计分量,而不是只统计真正放有石头的行和列。空行是孤立元素,每一个都会让分量数虚增,于是答案偏小。只在某块石头第一次需要时才创建元素。
8. 除法求值:带权并查集
题目。给定诸如 a / b = 2.0 和 b / c = 3.0 的方程,要求回答诸如 a / c的查询,当答案无法确定时返回 -1。
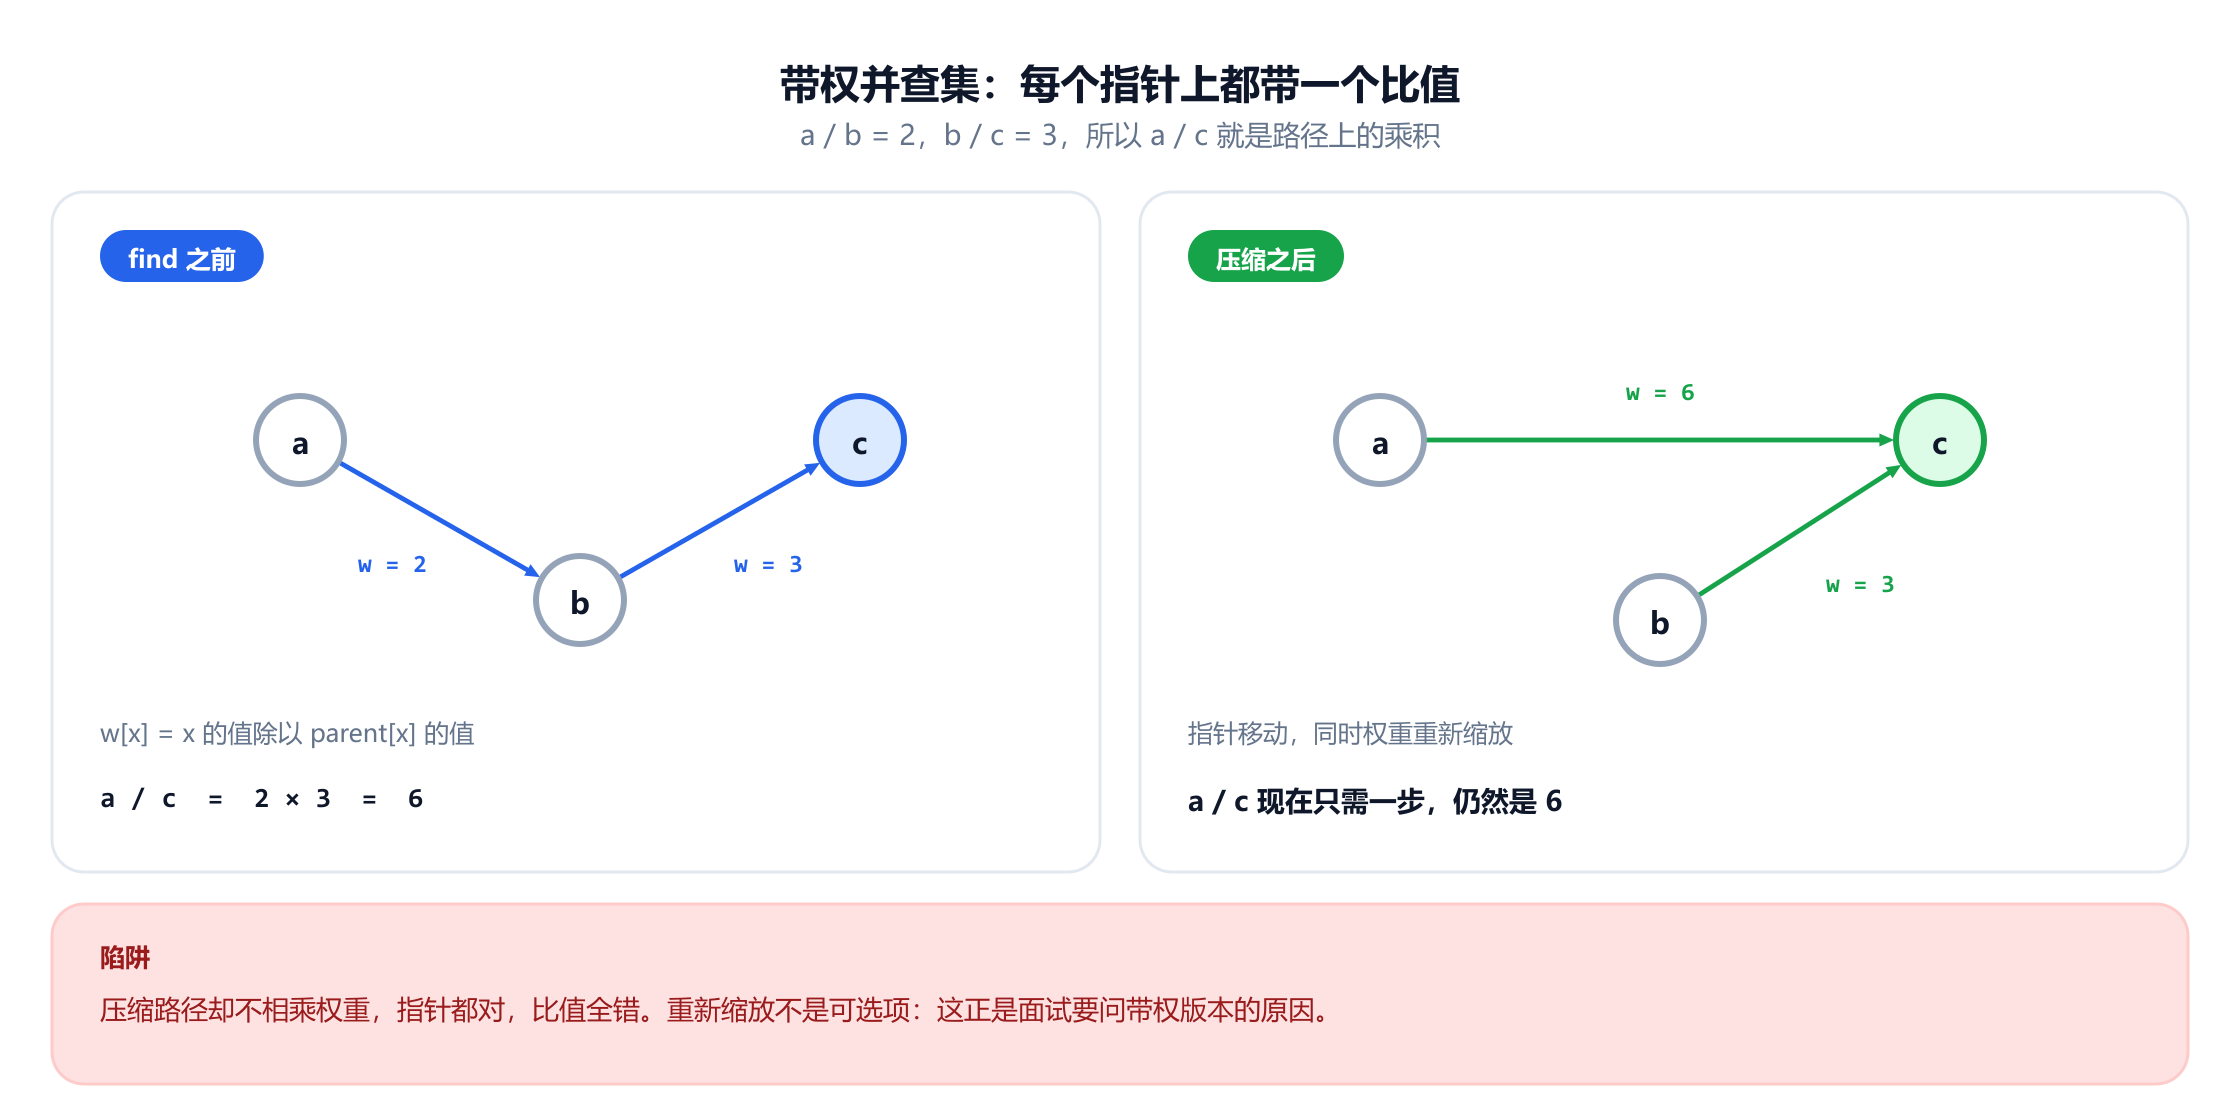
大多数候选人会建图并运行 DFS,沿路径把边权相乘,这是一个完全合格的答案。更强的答案是带权并查集:在每个父指针旁边,存储子节点的值与父节点的值之比。这样 find 会同时返回根以及到根的累积比值,任何查询都只是一次除法。
def find(x):                              # 返回 (根, x 的值 / 根的值)
    if parent[x] == x:
        return x, 1.0
    root, wp = find(parent[x])
    weight[x] *= wp                       # 压缩路径的同时重新缩放
    parent[x] = root
    return root, weight[x]
在 a / b = 2 和 b / c = 3的条件下,查询结果为 a / c = 6、 b / a = 0.5、 c / a = 1/6、 a / a = 1,以及对任何涉及未出现过的符号的查询返回 -1,这就是为什么在标准题目中 x / x 的结果是 -1 而不是 1。最后这个情况是一个故意设置的陷阱,它会抓住那些在检查符号是否存在之前就把相同参数当作特例处理的人。
追问:如何检测矛盾?如果 union(a, b, v) 发现 a 和 b 已经有共同的根,就不要合并,而是把推出的比值与 v 进行比较。超出浮点误差范围的差异意味着输入不一致。把乘法换成加法,同样的结构就能回答“这组偏移约束是否可满足”,这项技术在调度问题中就是以这种形式出现的。
陷阱。压缩路径时不更新权重,也就是图中警告的那个错误。指针保持正确,之后的每次查询都会悄悄返回错误的数字,而且这个错误能躲过任何只检查连通性的测试。
9. 等式方程:处理的顺序
题目。给定诸如 "a==b" 和 "b!=c" 这样的关于单个小写字母的方程,判断它们能否同时成立。
解法是四行代码加一个思路:两遍处理,先处理等式。
dsu = DSU(26)
for e in equations:
    if e[1] == '=':
        dsu.union(ord(e[0]) - 97, ord(e[3]) - 97)
for e in equations:
    if e[1] == '!':
        if dsu.find(ord(e[0]) - 97) == dsu.find(ord(e[3]) - 97):
            return False
return True
相等是等价关系,因此它把字母划分成若干必须取相同值的组。不等不是等价关系,根本不能合并,只能拿来对照已完成的划分进行检查。如果在一遍中交错处理两者,答案就会依赖输入顺序,而这正是这道题要抓的错误: ["a!=b", "a==b"] 会被接受,因为不等式在与它矛盾的那次合并之前就被检查了。
验证过的输出: ["a==b","b!=a"] 为 False, ["a==b","b==c","a==c"] 为 True, ["a==b","b!=c","c==a"] 为 False,而单个方程 ["a!=a"] 为 False,因为一个字母总是等于它自己。
追问:如果变量不是单个字母呢?正是第 6 节中的编号映射:把每个名字哈希成一个稠密整数,或者以名字作为父字典的键。其他什么都不用改,指出这一点很好,因为它表明你把结构和编码看作两回事。
陷阱。只为出现的字母分配并查集,而不是为全部 26 个字母分配。这样也能运行,但会让你花两分钟为一个本来就稠密又很小的字母表构建映射。写通用代码之前先读约束条件。
10. Kruskal:生成树中的并查集
题目。以最小总代价连接所有点,两点之间的代价是它们的曼哈顿距离。这是 LeetCode 1584,本质上就是一棵换了个说法的最小生成树。
这里并查集不是答案,而是让答案成立的组件。Kruskal 算法把所有候选边按权重排序,当且仅当一条边连接两个不同的分量时才接受它,而这正是 union返回的布尔值。
edges.sort()                              # 按权重
dsu, total, used = DSU(n), 0, 0
for w, a, b in edges:
    if dsu.union(a, b):                   # 仅当它连接两个分量时
        total += w
        used += 1
        if used == n - 1:                 # 生成树有 n-1 条边
            break
在五个点 [[0,0],[2,2],[3,10],[5,2],[7,0]] 上有 10 条候选边,Kruskal 保留其中四条,权重为 3、4、4 和 9,总和为 20。在达到 n - 1 条边时提前退出,这在稠密输入上很重要,因为候选列表的规模是 O(n2),而其中大部分根本用不到。
追问:这里用 Prim 还是 Kruskal?对于 n 个点的完全图,Kruskal 要构建并排序 n(n-1)/2 条边,代价为 O(n2 log n),而用数组扫描的 Prim 运行时间为 O(n2),而且从不生成边列表。在稠密实例上 Prim 是更好的答案,知道 Kruskal 是适合稀疏图的算法正是这道题的重点。这一取舍在最小生成树和 Kruskal 算法中有详细分析。
陷阱。在检查合并之前就把权重加上,导致被拒绝的边也计入了总和。得到的数字在样例上看起来足够接近,在其他情况下全是错的。
11. 复杂度问题的回答
这是唯一一个诚实的回答显得有点别扭的主题,而面试官恰恰因此才问。
| 版本 | 每次操作的均摊代价 | 出处 |
|---|---|---|
| 不做任何优化 | O(n) | 上图中的那条链 |
| 只按大小或秩合并 | O(log n) | 只有等大合并时深度才会翻倍 |
| 只用路径压缩 | O(log n) | Tarjan 和 van Leeuwen,1984 |
| 两者结合 | O(α(n)) | Tarjan,1975 |
| 任何基于指针的结构 | Ω(α(n)) | Fredman 和 Saks,1989 |
α 是反阿克曼函数,它增长得极其缓慢,以至于 α(n) ≤ 4 对于每一个 n 都成立,只要它能存储在任何一台物理计算机中。所以实用的回答是“实际上是常数”,而正确的回答是“O(α(n)) 均摊,这和 O(1)不是一回事”。这个区别是真实的:Fredman 和 Saks 在 1989 年证明了这类结构都不可能做得更好,所以 α 并不是分析留下的假象。
还有两个值得记住的数字。空间是 O(n),两个整数数组。另外,均摊是针对整个操作序列,而不是针对单次调用:单次 find 仍可能走一条很长的路径,有界的是 m 次操作的总和。面试官有时会追问这一点,而“均摊,而不是每次操作的最坏情况”正是他们想听的说法。
作为对树到底有多扁的检验:在 100,000 个元素上做 200,000 次随机合并,再对每个元素执行一次 find 之后,结构中最深的树深度只有一个指针。每个元素都直接指向自己的根。
12. 导致面试失败的错误
按出现频率排序;前三条解释了大多数被拒的解答。
- 比较元素而不是比较根。
if a == b,而本意是if find(a) == find(b)。它能编译,能运行,回答的却是另一个问题。 - 省略按大小合并。单靠路径压缩通常能通过,所以这个错误能躲过测试,然后在恶意输入上性能退化。两个优化各只有一行,两个都要写。
- 在深层输入上使用递归的
find。十万次链式合并就是十万个栈帧。写迭代版本,或者说明为什么这里的递归深度是安全的。 - 数组大小差一。编号为 1 到 n 的节点需要
DSU(n + 1)。这是这类题目中最常见的崩溃原因。 - 合并了错误的东西。合并石头而不是行和列,合并账户而不是邮箱,合并名字而不是身份。当两两比较的版本看起来是平方级时,通常是元素选错了。
- 交错处理等式和不等式。所有会合并的约束,都必须在任何只做检查的约束之前应用完。永远是两遍处理。
- 忘了并查集不能删除。如果题目要删除边,立刻说出来,并提出离线倒序或可回滚结构。试图在压缩后的结构上打补丁支持删除是一条死路。
- 不维护分量数。每次操作后都用一个遍历
find的循环重新计算它,会把线性解法变成平方级解法,而这正是岛屿数量 II 专门要暴露的失败方式。 - 声称 O(1)。它是
O(α(n))均摊。说“实际上是常数,形式上是反阿克曼函数”,追问就消失了。
能避免大多数错误的习惯是:动手写之前,先说清一个元素代表什么,以及两个元素在同一集合中意味着什么。如果这句话的两半你都说不完整,说明你还没有完成建模,那十五行代码也救不了你。
13. 常见问题
用简单的话说,什么是并查集?
+
它是一种记录哪些元素属于同一组的结构,支持两种操作:find,询问一个元素属于哪个组;union,合并两个组。每个组存储为一棵由父指针构成的树,并以这棵树的根作为标识,所以两个元素当且仅当根相同时才属于同一组。它也叫不相交集合并,简称 DSU。
什么时候应该用并查集而不是 BFS 或 DFS?
+
当图是固定的、只需扫描一次时,用遍历,因为两种方法都是线性的,而遍历不需要额外结构。当边随时间到达且每条之后都需要答案、当题目只会合并分组而从不拆分,或者当你需要把“它们是否已经连通”这个布尔值用作另一个算法的一部分时(Kruskal 算法就是这样),用并查集。并查集还根本不需要邻接表存在,这在数据对以流的形式经过而无法装入内存时很重要。
并查集真的是 O(1) 吗?
+
不是,而且这一点值得答对。使用按大小或按秩合并加路径压缩时,n 个元素上的 m 次操作均摊代价为 O(m 乘以 alpha(n)),其中 alpha 是反阿克曼函数。对任何能在物理上存储的 n,alpha(n) 至多为 4,所以实际表现是常数,但上界不是 O(1),而且这个区别并非吹毛求疵:Fredman 和 Saks 在 1989 年证明了这类结构都不可能优于 alpha。要说“实际上是常数,形式上是反阿克曼函数,是均摊而不是每次调用的最坏情况”。
按秩合并还是按大小合并?
+
都可以,因为两者给出相同的渐近上界。秩存储树高的上界,大小存储树中元素的个数。面试中大小通常是更好的选择,因为很大一部分追问会问合并后分量的大小,而按大小合并时这个数是现成的。无论选哪种,都要把较小的树挂到较大的树下,绝不能反过来。
并查集能处理删除吗?
+
不能直接处理。路径一旦被压缩,就不再有树是如何拼起来的记录,所以一次合并无法撤销。有两种标准答案。离线倒序处理操作,把每次删除变成一次添加,让普通的并查集倒着运行。或者使用可回滚的并查集,它为每次合并维护一个撤销栈,因此必须放弃路径压缩,只剩按秩合并,每次操作 O(log n)。
元素是字符串时怎么使用并查集?
+
有两种选择。第一次遇到每个不同的字符串时给它分配一个稠密整数,然后使用普通的基于数组的结构,这样更快,当结构处在热点循环中时应该这样做。或者把父映射存成以字符串本身为键的字典,写起来更短,但每次访问要付出一次哈希查找的代价。两种都正确;说清楚你在做哪种取舍,才是面试官想听的。
哪些面试题是并查集题?
+
Number of Connected Components、Number of Provinces、Redundant Connection、Number of Islands II、Accounts Merge、Most Stones Removed、Evaluate Division、Satisfiability of Equality Equations、Min Cost to Connect All Points、Graph Valid Tree、Smallest String With Swaps 和 Regions Cut By Slashes。线索是询问两样东西是否属于同一组的问题,或者一个必须在一连串合并中持续维护的组数。
14. 参考文献
按时间顺序列出提出这些技术的论文以及分析它们的著作。
- Kruskal, J. B. (1956). “On the shortest spanning subtree of a graph and the traveling salesman problem.” Proceedings of the American Mathematical Society, 7(1), 48–50.
- Galler, B. A. and Fischer, M. J. (1964). “An improved equivalence algorithm.” Communications of the ACM, 7(5), 301–303.
- Hopcroft, J. E. and Ullman, J. D. (1973). “Set merging algorithms.” SIAM Journal on Computing, 2(4), 294–303.
- Tarjan, R. E. (1975). “Efficiency of a good but not linear set union algorithm.” Journal of the ACM, 22(2), 215–225.
- Tarjan, R. E. and van Leeuwen, J. (1984). “Worst-case analysis of set union algorithms.” Journal of the ACM, 31(2), 245–281.
- Fredman, M. and Saks, M. (1989). “The cell probe complexity of dynamic data structures.” Proceedings of the 21st Annual ACM Symposium on Theory of Computing, 345–354.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. and Stein, C. (2009). Introduction to Algorithms,第 3 版,第 21 章。MIT Press。
- Sedgewick, R. and Wayne, K. (2011). Algorithms,第 4 版,第 1.5 节。Addison-Wesley。
- McDowell, G. L. (2015). Cracking the Coding Interview,第 6 版。CareerCup。
- Skiena, S. S. (2020). The Algorithm Design Manual,第 3 版,第 8 章。Springer。