
Tabla de Contenidos
- 1. Qué evalúa de verdad una pregunta de union-find
- 2. La plantilla, y las dos líneas que importan
- 3. Contar componentes conexas
- 4. Redundant Connection: la arista que cierra un ciclo
- 5. Islands II: por qué BFS pierde cuando la cuadrícula cambia
- 6. Accounts Merge: cuando los elementos no son enteros
- 7. Most Stones Removed: elegir qué unir
- 8. Evaluate Division: union-find ponderado
- 9. Ecuaciones de igualdad: el orden en que las procesas
- 10. Kruskal: union-find dentro de un árbol generador
- 11. Las respuestas de complejidad
- 12. Errores que hacen fracasar la entrevista
- 13. Preguntas frecuentes
- 14. Referencias
1. Qué evalúa de verdad una pregunta de union-find
Union-find es uno de esos raros temas de entrevista en los que la implementación no es la dificultad. Quince líneas, dos optimizaciones, ningún caso límite que merezca discusión. Los entrevistadores lo saben, y por eso las preguntas se construyen en otro sitio.
Evalúan tres cosas. ¿Reconoces una pregunta de conectividad? Todo lo que se formule como «¿están estos dos en el mismo grupo?», «¿cuántos grupos hay?» o «¿qué cambio fusiona dos grupos?» es union-find, aunque las palabras sean cuentas, piedras, ecuaciones o cables. ¿Sabes cuándo supera a un recorrido? Un único grafo estático se puede recorrer con BFS o DFS igual de rápido; union-find gana cuando las aristas llegan de una en una y la respuesta hace falta después de cada una. ¿Sabes elegir los elementos? Aquí viven las preguntas difíciles, y aquí dedica su tiempo la sección 7.
Los ocho problemas de abajo son los que se repiten, cada uno con la solución, la pregunta de seguimiento y el error que te cuesta la oferta. Cada ejemplo resuelto de esta página se ejecutó con un script. Si quieres la estructura de datos derivada desde cero en lugar de un repaso, eso está en la guía de union-find.
2. La plantilla, y las dos líneas que importan
Escribe esto sin pensar. Dos optimizaciones, una línea cada una, y los entrevistadores preguntan por las dos por su nombre.
class DSU:
    def __init__(self, n):
        self.parent = list(range(n))
        self.size = [1] * n
        self.count = n                       # número de componentes, gratis

    def find(self, x):
        root = x
        while self.parent[root] != root:
            root = self.parent[root]
        while self.parent[x] != root:        # COMPRESIÓN DE CAMINOS: aplanar el recorrido
            self.parent[x], x = root, self.parent[x]
        return root

    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False                     # ya estaban juntos: nada que fusionar
        if self.size[ra] < self.size[rb]:    # UNIÓN POR TAMAÑO: árbol pequeño bajo el grande
            ra, rb = rb, ra
        self.parent[rb] = ra
        self.size[ra] += self.size[rb]
        self.count -= 1
        return True
Tres detalles que conviene decir en voz alta mientras los escribes. union devuelve un booleano, y ese valor de retorno responde a la mitad de las preguntas de esta página: False significa que los dos ya estaban conectados, es decir, que la arista que acabas de probar cierra un ciclo. count se mantiene con las fusiones, así que contar componentes nunca necesita una segunda pasada. Y el find de arriba es iterativo, lo que importa en una cadena de cien mil elementos, donde la versión recursiva muere en la pila de llamadas.
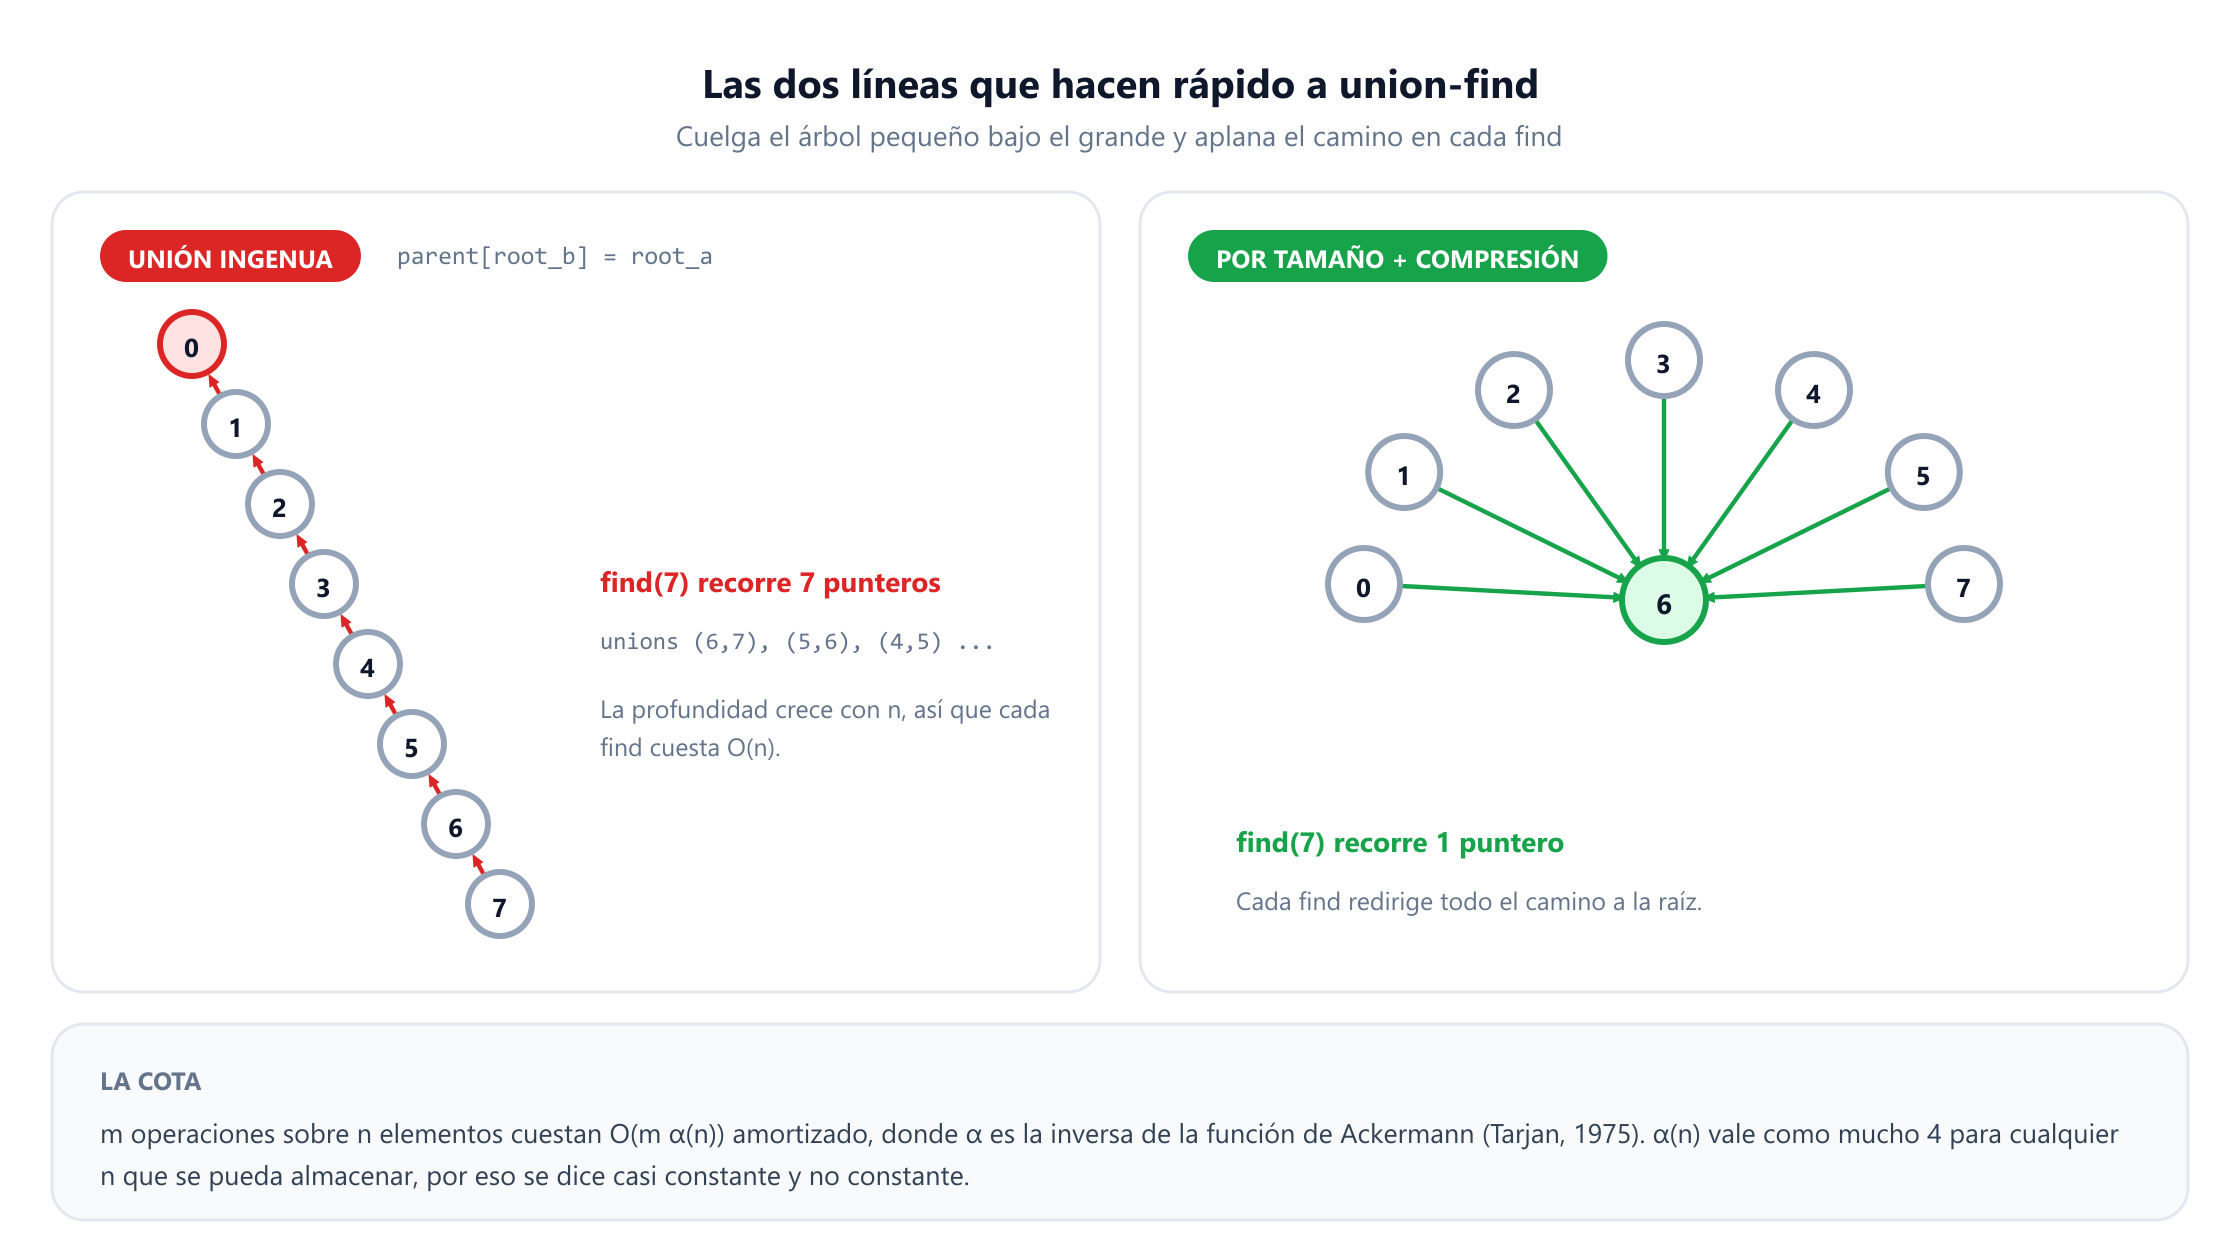
parent[rb] = ra sin comprobar los tamaños.¿Por qué las dos optimizaciones? La unión por tamaño sola acota la profundidad en O(log n), porque un árbol solo crece en altura cuando se fusionan dos árboles del mismo tamaño. La compresión de caminos sola también da O(log n) amortizado. Juntas dan O(α(n)) amortizado por operación, que es la sección 11. Si solo puedes recordar una, recuerda la compresión de caminos: es una línea y hace la mayor parte del trabajo en la práctica.
Una nota de implementación que conviene mencionar sin que te la pidan: la unión por rango y la unión por tamaño son intercambiables en cuanto a la cota. El rango guarda una cota superior de la altura y el tamaño guarda el número de elementos. El tamaño es más útil en entrevistas porque la mitad de las preguntas de seguimiento piden el tamaño de la componente resultante, y ya lo tienes.
3. Contar componentes conexas
La pregunta. Dados n nodos y una lista de aristas no dirigidas, ¿cuántas componentes conexas hay? La formulación clásica es LeetCode 323, y Number of Provinces es la misma pregunta con una matriz de adyacencia.
Con la plantilla de arriba no queda ningún algoritmo por escribir.
def count_components(n, edges):
    dsu = DSU(n)
    for a, b in edges:
        dsu.union(a, b)
    return dsu.count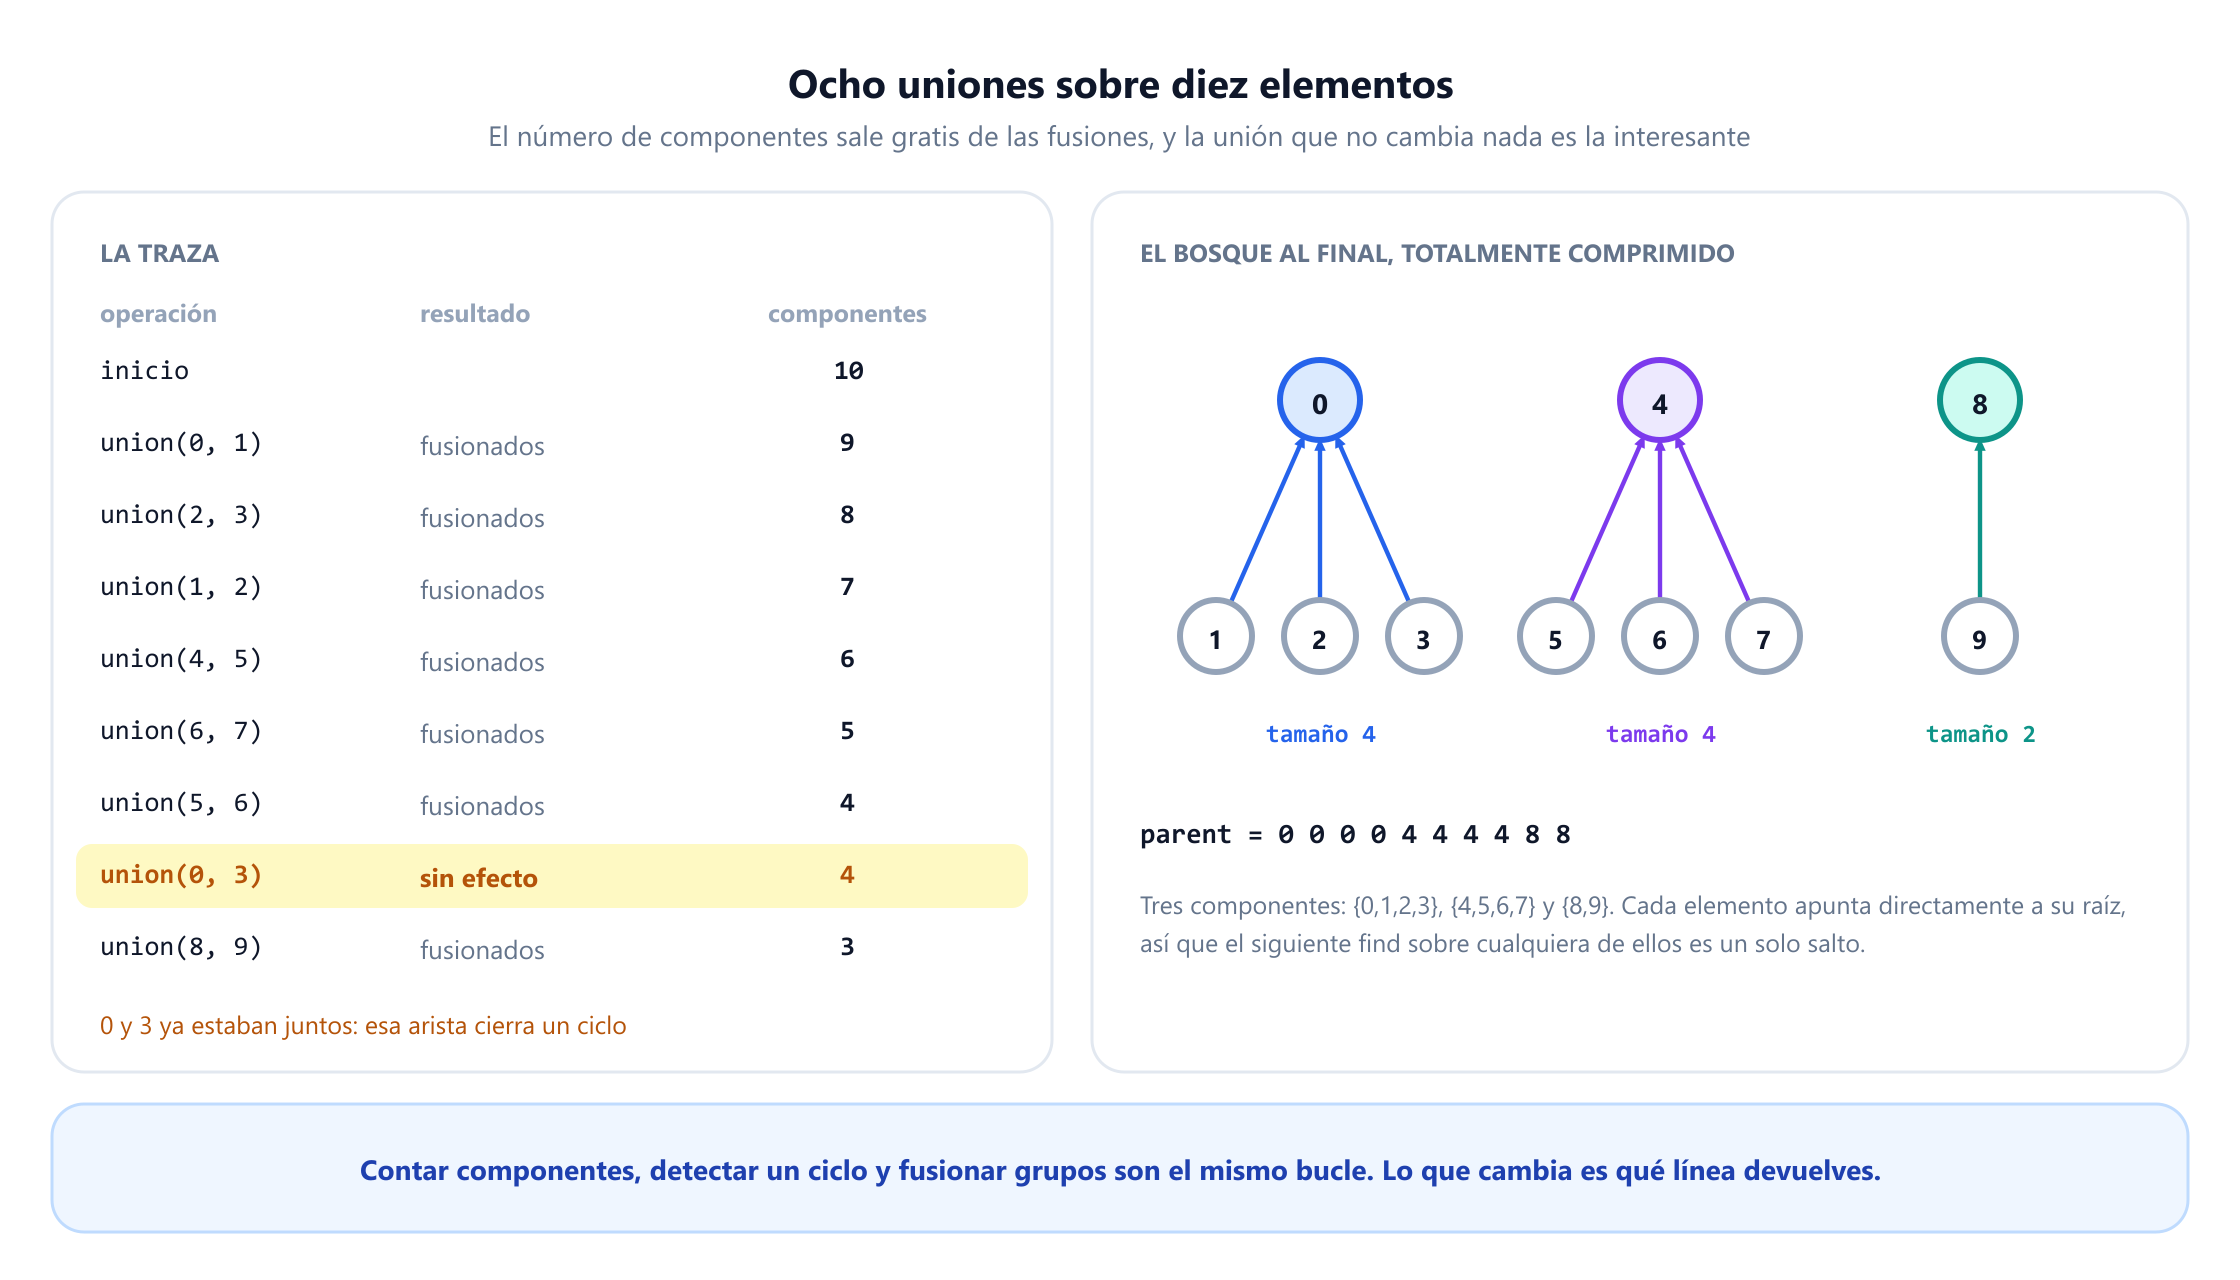
En el ejemplo, diez elementos y las ocho uniones (0,1) (2,3) (1,2) (4,5) (6,7) (5,6) (0,3) (8,9) dejan tres componentes: {0,1,2,3}, {4,5,6,7} y {8,9}, de tamaños 4, 4 y 2. Siete uniones fusionaron; union(0, 3) no, porque 0 y 3 ya estaban en el mismo árbol para entonces.
Ejecuta un find sobre cada elemento después y la estructura termina como parent = 0 0 0 0 4 4 4 4 8 8: cada elemento apunta directamente a la raíz de su componente, así que cada consulta posterior es un solo salto. Ese aplanamiento es la compresión de caminos amortizando su coste.
El seguimiento: ¿por qué no ejecutar simplemente DFS? En un grafo estático, hazlo. Ambos son lineales y DFS no necesita estructura extra, así que recurrir a union-find sobre una lista de aristas fija es una pequeña señal de alarma más que un punto a favor. La respuesta honesta es que union-find se gana su sitio cuando las aristas llegan con el tiempo, cuando necesitas la respuesta después de cada llegada, o cuando el grafo es demasiado grande para guardarlo como lista de adyacencia pero los pares pasan en flujo. Decirlo sin que te lo pidan te distingue de los candidatos que reaccionan por reflejo a la palabra «componentes».
La trampa. Devolver len(set(parent)), que cuenta los valores distintos de parent sin llamar nunca a find. Antes de la compresión el array de padres contiene nodos intermedios, no raíces, así que la cuenta sale demasiado alta. Mantén count en union y la cuestión ni se plantea.
4. Redundant Connection: la arista que cierra un ciclo
La pregunta. A un árbol de n nodos se le ha añadido una arista extra. Encuentra la arista que se puede eliminar y, si hay varias candidatas, devuelve la que aparece en último lugar en la entrada.
Esto es el booleano que devuelve union, y nada más.
def find_redundant(edges):
    dsu = DSU(len(edges) + 1)
    for a, b in edges:
        if not dsu.union(a, b):          # a y b ya estaban conectados
            return [a, b]                # así que esta arista cierra un ciclo
Procesa las aristas en orden y la primera para la que union devuelve False es la respuesta. También es automáticamente la última de ese tipo en la entrada, porque un árbol más una arista tiene exactamente un ciclo, así que falla exactamente una arista. Con [[1,2],[2,3],[3,4],[1,4],[1,5]] la respuesta es [1,4], y con el triángulo [[1,2],[1,3],[2,3]] es [2,3].
El seguimiento: ¿y si el grafo es dirigido? Eso es Redundant Connection II, y es un problema de verdad más difícil, no una variante. Una versión dirigida puede fallar de dos formas: un nodo con dos padres, o un ciclo, y puede tener ambas a la vez. La técnica es encontrar el nodo con grado de entrada dos, quitar de forma tentativa cada una de sus dos aristas candidatas y comprobar con union-find si el resto forma un árbol con raíz válido. Saber que el caso dirigido se divide en casos es suficiente; los entrevistadores rara vez te hacen escribirlo.
La trampa. Usar DSU(n) cuando los nodos están numerados de 1 a n. Todo fallo de union-find de este tipo es un error por uno en el tamaño del array, y aparece como un error de índice en el último nodo y no como una respuesta incorrecta. Reserva n + 1 e ignora la posición cero.
5. Islands II: por qué BFS pierde cuando la cuadrícula cambia
La pregunta. Una cuadrícula vacía de m × n llena de agua. Se añade tierra celda a celda. Después de cada adición, indica cuántas islas hay.
Esta es la pregunta que justifica toda la estructura de datos, así que trátala como la que tienes que clavar. Contar islas en una cuadrícula fija es un flood fill y cuesta O(mn). Hacerlo después de cada una de las k adiciones cuesta O(k × mn), que es cuadrático y excederá el tiempo. Union-find convierte cada adición en una cantidad constante de trabajo, porque añadir tierra solo puede fusionar islas, nunca separarlas.
def num_islands2(m, n, positions):
    dsu, seen, out, count = {}, set(), [], 0
    for r, c in positions:
        if (r, c) in seen:               # una posición repetida no añade nada
            out.append(count)
            continue
        seen.add((r, c))
        dsu[(r, c)] = (r, c)             # una isla nueva de una celda
        count += 1
        for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
            nb = (r + dr, c + dc)
            if nb in seen and union(dsu, (r, c), nb):
                count -= 1               # fusionada con un vecino
        out.append(count)
    return out
Cada celda nueva empieza como su propia isla y luego se fusiona con como mucho cuatro vecinas, así que cada paso cuesta O(α) y toda la ejecución O(k α(mn)). En una cuadrícula de 3 por 3 con tierra añadida en (0,0), (0,1), (1,2), (2,1) las respuestas son 1, 1, 2, 3: la segunda celda se une a la primera y las dos siguientes quedan aisladas. Añade (1,1) como quinto movimiento y toca a las tres, así que la secuencia termina en 1, 1, 2, 3, 1.
El seguimiento: ¿y si la tierra también se puede quitar? Di claramente que union-find no admite borrados, porque no hay forma de deshacer una fusión una vez comprimidos los caminos. Las respuestas reales son procesar las operaciones offline en orden inverso, convirtiendo los borrados en adiciones, o usar un union-find con rollback, que mantiene una pila de deshacer y por eso renuncia a la compresión de caminos a cambio de la unión por rango sola, con O(log n). Nombrar la «inversión offline» suele bastar.
La trampa. Olvidar que la misma posición puede aparecer dos veces en la entrada. Añadir tierra donde ya hay tierra no debe incrementar la cuenta, y la protección es una línea. Además es el único caso de prueba oculto de este problema.
6. Accounts Merge: cuando los elementos no son enteros
La pregunta. Cada cuenta es un nombre seguido de una lista de emails. Dos cuentas pertenecen a la misma persona cuando comparten algún email. Fusiónalas y devuelve los emails de cada persona, ordenados.
La estructura es union-find sin más. Lo que la pregunta evalúa de verdad es la fontanería: tus elementos son cadenas y el DSU basado en arrays necesita enteros.
ids = {}
for account in accounts:
    for mail in account[1:]:
        if mail not in ids:
            ids[mail] = len(ids)         # asignar a cada email un entero denso
        owner[mail] = account[0]

dsu = DSU(len(ids))
for account in accounts:
    first = ids[account[1]]
    for mail in account[2:]:
        dsu.union(first, ids[mail])      # encadenar cada email con el primero
Une cada email de una cuenta con el primer email de esa cuenta, lo que basta para convertir toda la cuenta en una componente; después agrupa los emails por raíz y ordena cada grupo. Fusionar John [a, b], John [c, b], Mary [m] y un segundo John [z] da tres personas: John con a, b, c, Mary con m y otro John distinto solo con z.
Ese último grupo es el sentido de la pregunta. El nombre no es la identidad. Dos cuentas con el mismo nombre y sin ningún email en común son dos personas distintas, y quien une por nombre obtiene una respuesta incorrecta pero plausible que la entrada de ejemplo está hecha a propósito para atrapar.
El seguimiento: ¿podrías evitar el mapeo de identificadores? Sí, guardando parent como un diccionario cuya clave es la propia cadena, lo que cuesta un hash por acceso en lugar de un índice de array. Es más limpio de escribir y más lento de ejecutar, y decir qué compromiso estás haciendo es lo que se evalúa. En un lenguaje sin diccionarios en el camino crítico, o cuando la misma estructura se reutiliza millones de veces, gana el mapeo a enteros densos.
La trampa. Buscar el nombre a partir del email de la raíz en lugar de mantener un mapa de email a nombre. Tras la compresión la raíz puede ser cualquier email del grupo, y si registraste el nombre asociado a uno concreto, pondrás el nombre equivocado a una cuenta fusionada.
7. Most Stones Removed: elegir qué unir
La pregunta. Hay piedras en una cuadrícula. Puedes quitar una piedra si comparte fila o columna con otra piedra que siga en el tablero. ¿Cuál es el número máximo que puedes quitar?
Dos ideas, y la segunda es la que la convierte en una buena pregunta de entrevista.
Primera: de cualquier grupo conexo de piedras puedes quitar todas menos una. Quítalas en el orden inverso al de construcción de un árbol generador del grupo, empezando por las hojas, y la última piedra en pie mantiene el grupo válido en cada paso. Así que la respuesta es piedras totales - número de componentes, y todo el problema se reduce a contar componentes.
Segunda, y esta es la parte difícil bajo presión: no unas las piedras. Une las filas y las columnas.
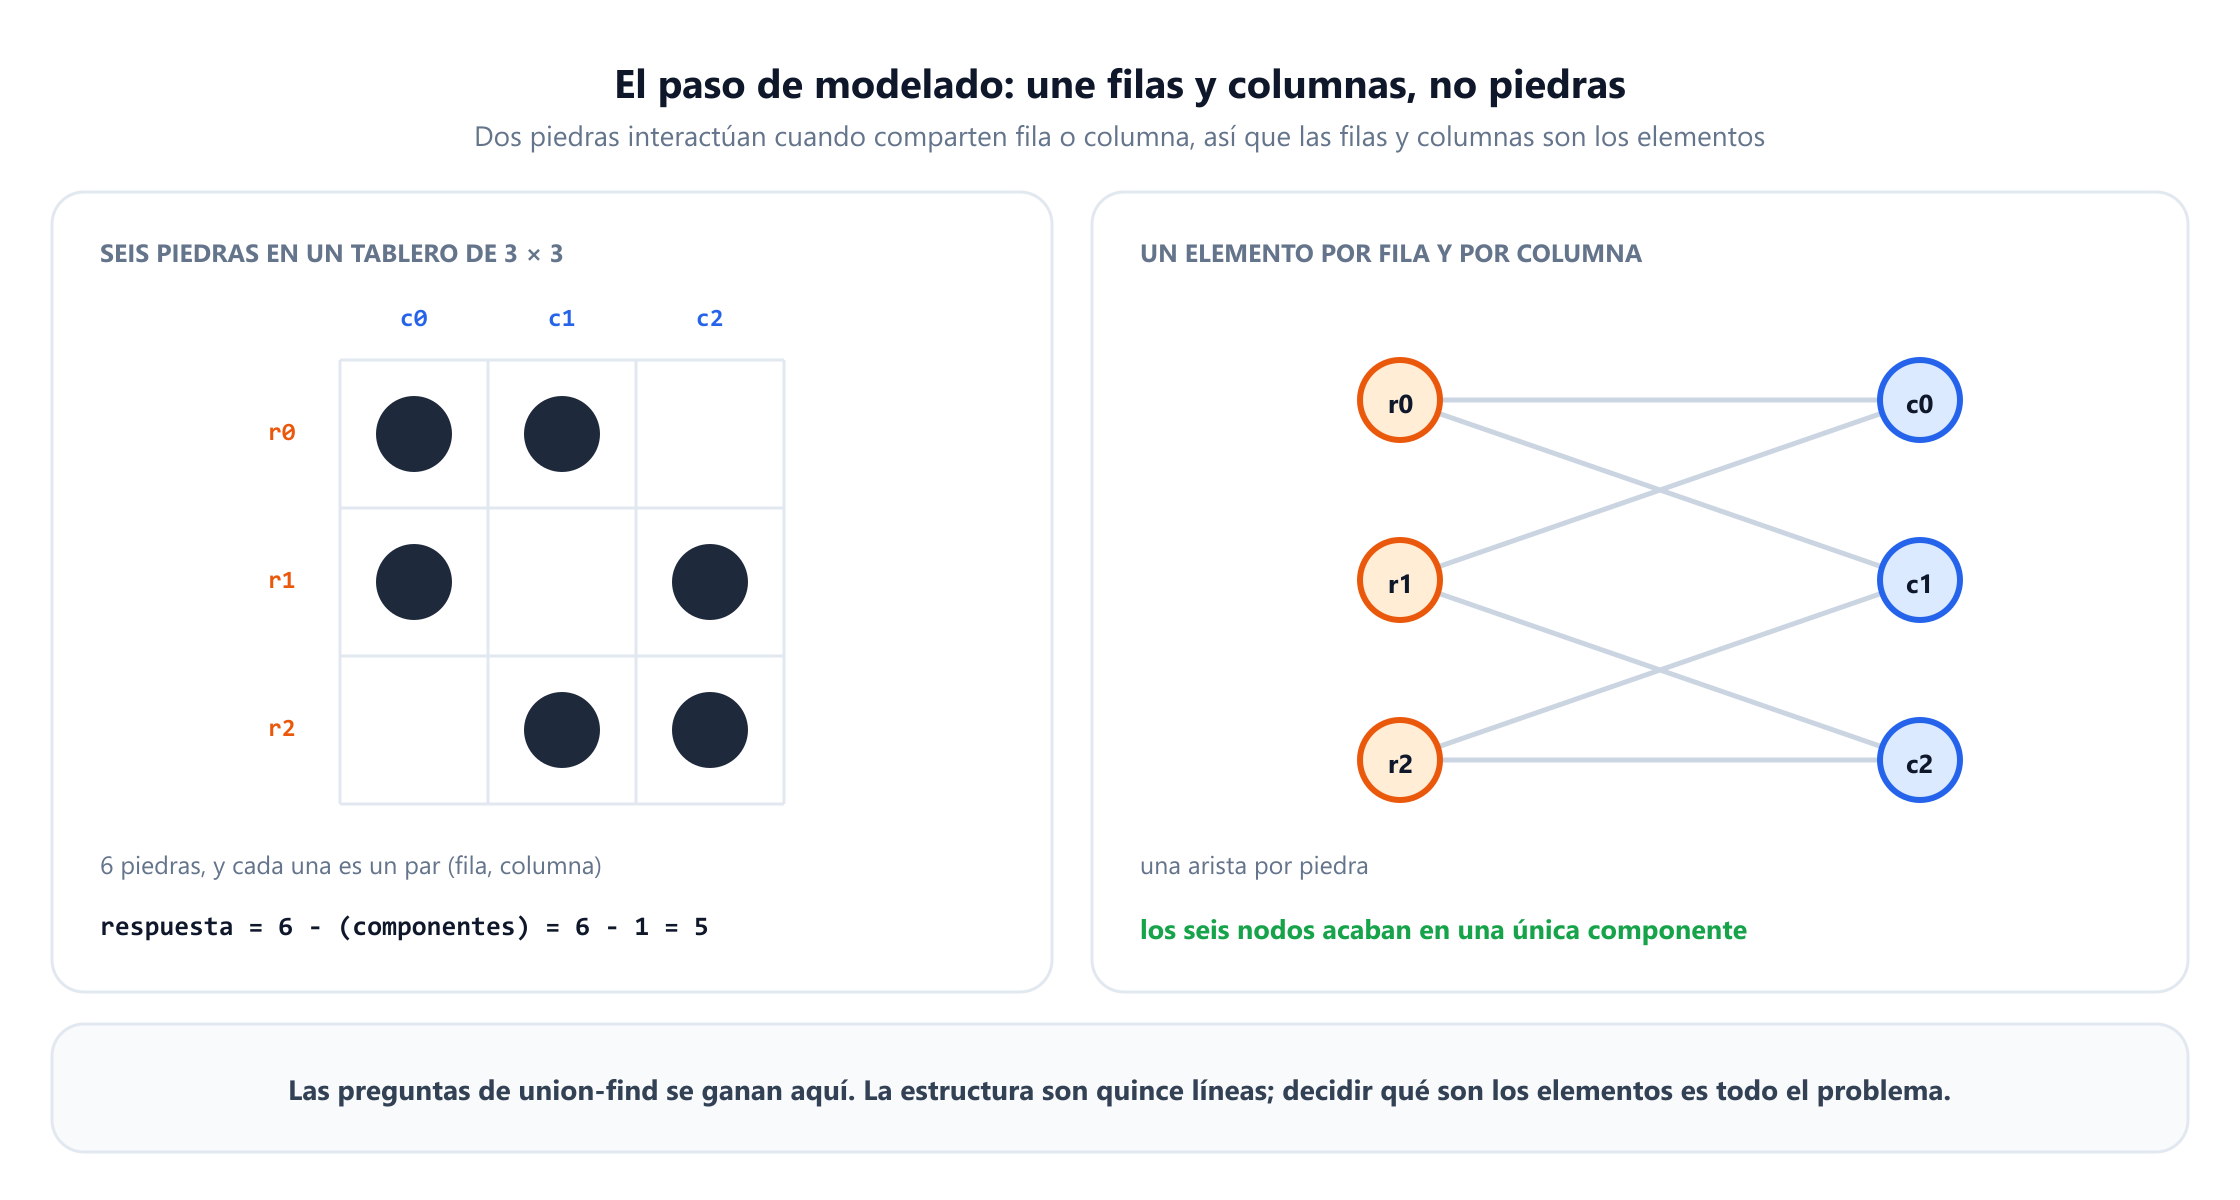
Cada piedra en (r, c) se convierte en un único union(fila r, columna c). Dos piedras acaban conectadas exactamente cuando comparten fila o columna, o están enlazadas por una cadena de piedras que lo hacen, que es la relación que describe el problema. Además convierte una comparación por pares en O(k2) en un proceso en O(k α). En el ejemplo de seis piedras todo el tablero colapsa en una componente y la respuesta es 5. Con [[0,0],[0,2],[1,1],[2,0],[2,2]] hay dos componentes y la respuesta es 3.
El seguimiento: ¿cómo evitas que filas y columnas colisionen? Viven en la misma estructura, así que la fila 2 y la columna 2 tienen que ser elementos distintos. Desplaza las columnas con una constante mayor que cualquier índice de fila, habitualmente c + 10001 para los límites del enunciado, o usa un diccionario con claves ("r", r) y ("c", c). Mencionar la colisión antes que el entrevistador vale mucho en este problema.
La trampa. Contar componentes sobre todas las filas y columnas existentes en lugar de solo las que contienen alguna piedra. Las filas vacías son elementos aislados y cada una infla el número de componentes, así que la respuesta sale demasiado pequeña. Crea un elemento solo la primera vez que una piedra lo necesite.
8. Evaluate Division: union-find ponderado
La pregunta. Te dan ecuaciones como a / b = 2.0 y b / c = 3.0 y te piden responder consultas como a / c, devolviendo -1 cuando la respuesta no se puede determinar.
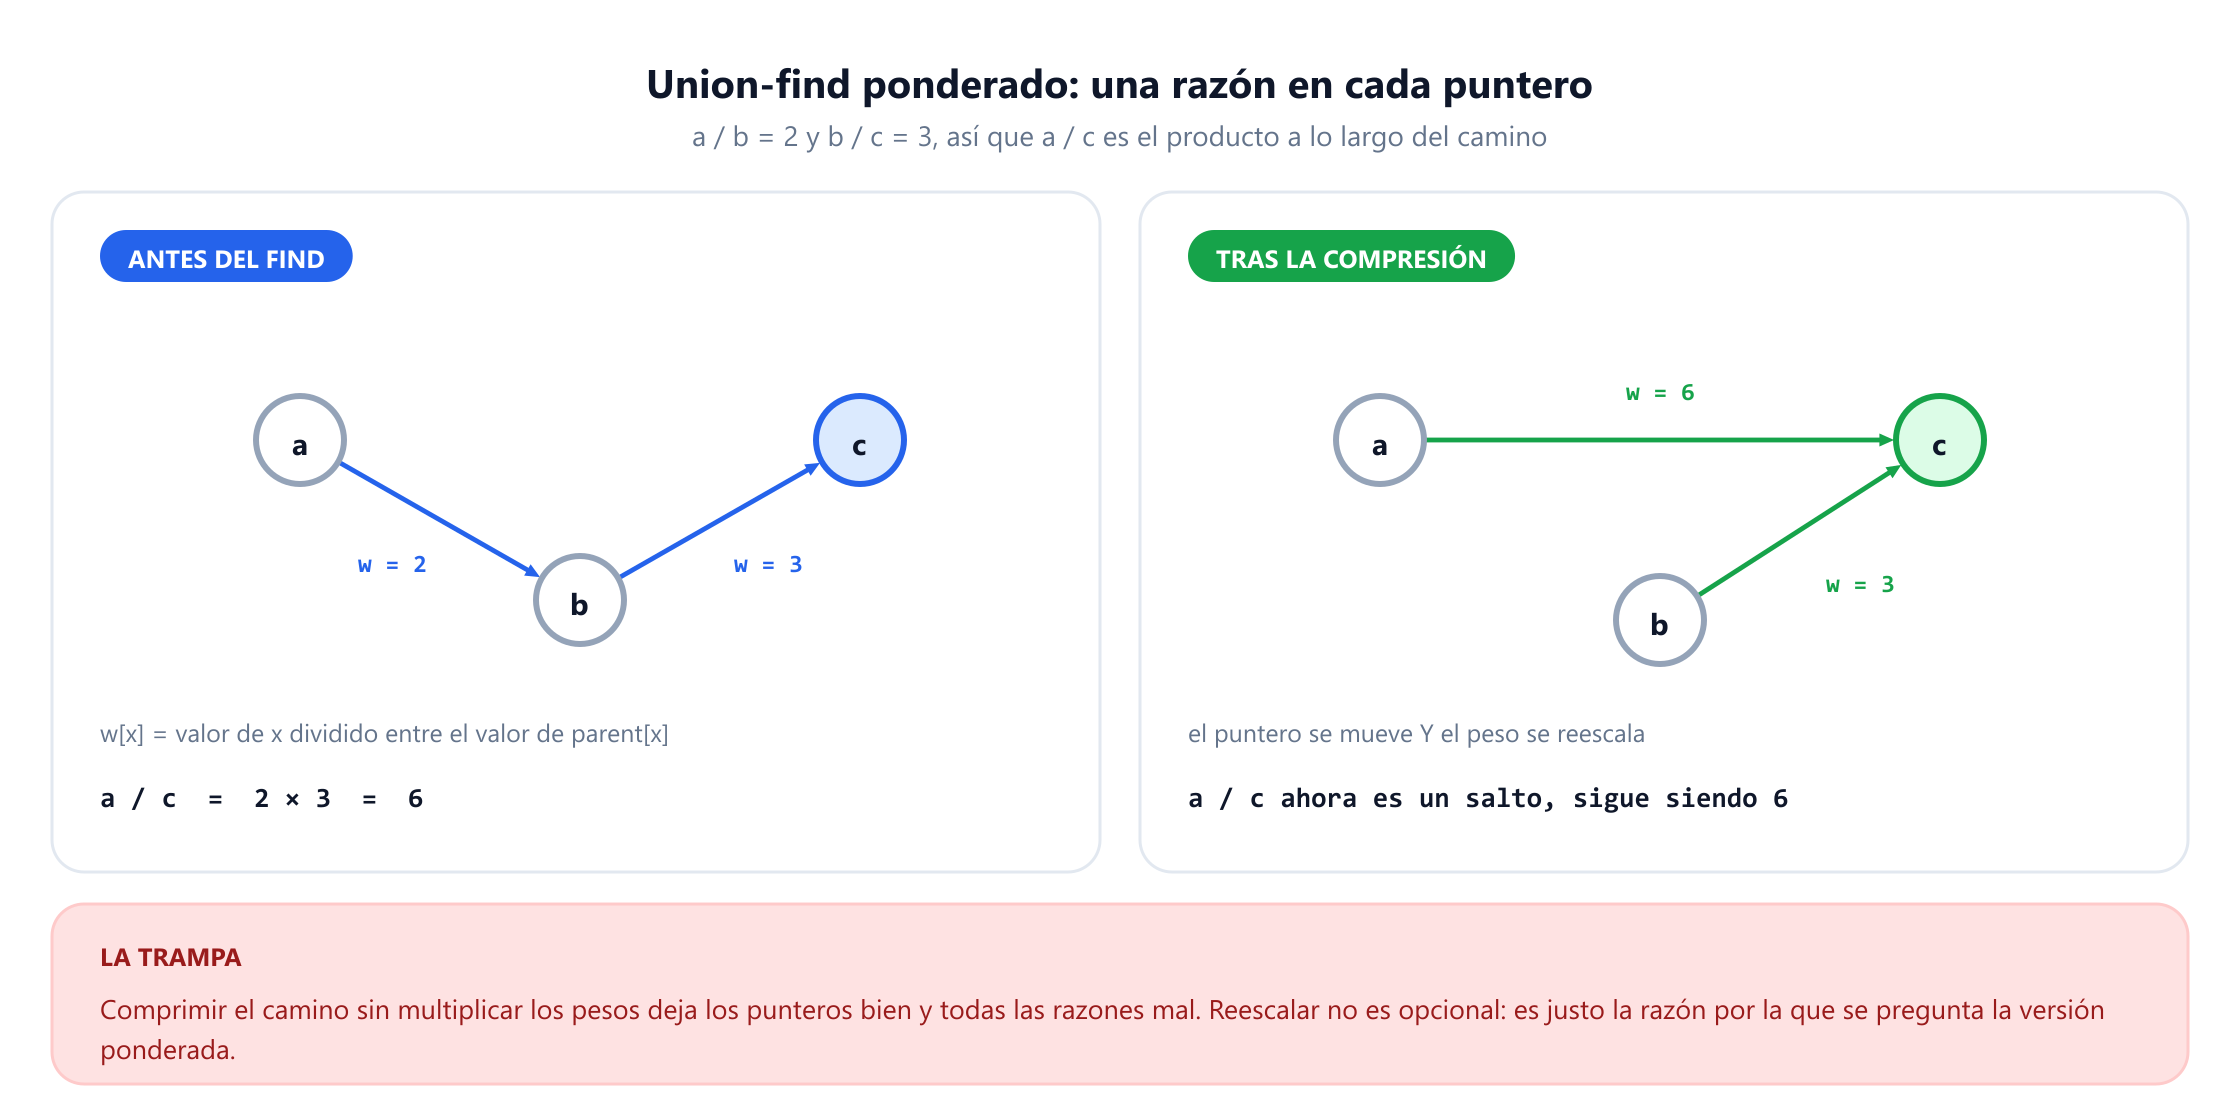
La mayoría de los candidatos construyen un grafo y ejecutan un DFS multiplicando los pesos de las aristas a lo largo del camino, lo cual es una respuesta perfectamente buena. La respuesta más sólida es union-find ponderado: guarda, junto a cada puntero al padre, la razón entre el valor del hijo y el valor del padre. Entonces find devuelve tanto la raíz como la razón acumulada hasta ella, y cualquier consulta es una sola división.
def find(x):                              # devuelve (raíz, valor de x / valor de la raíz)
    if parent[x] == x:
        return x, 1.0
    root, wp = find(parent[x])
    weight[x] *= wp                       # reescalar mientras se aplana el camino
    parent[x] = root
    return root, weight[x]
Con a / b = 2 y b / c = 3, las consultas dan a / c = 6, b / a = 0.5, c / a = 1/6, a / a = 1 y -1 para todo lo que mencione un símbolo que nunca apareció, por eso x / x es -1 y no 1 en el problema estándar. Ese último caso es una trampa deliberada y atrapa a quien trata como caso especial los argumentos iguales antes de comprobar que el símbolo existe.
El seguimiento: ¿cómo detectas una contradicción? Si union(a, b, v) descubre que a y b ya comparten raíz, no fusiones; compara en su lugar la razón implícita con v. Una discrepancia mayor que la tolerancia de coma flotante significa que la entrada es inconsistente. La misma estructura con suma en lugar de multiplicación responde a «¿es satisfacible este conjunto de restricciones de desplazamiento?», que es como aparece la técnica en problemas de planificación.
La trampa. Comprimir el camino sin actualizar el peso, que es el error del que advierte la figura. Los punteros siguen siendo correctos, cada consulta posterior devuelve en silencio un número incorrecto y el fallo sobrevive a cualquier prueba que solo compruebe la conectividad.
9. Ecuaciones de igualdad: el orden en que las procesas
La pregunta. Dadas ecuaciones como "a==b" y "b!=c" sobre letras minúsculas sueltas, decide si todas pueden ser ciertas a la vez.
La solución son cuatro líneas y una idea: dos pasadas, primero las igualdades.
dsu = DSU(26)
for e in equations:
    if e[1] == '=':
        dsu.union(ord(e[0]) - 97, ord(e[3]) - 97)
for e in equations:
    if e[1] == '!':
        if dsu.find(ord(e[0]) - 97) == dsu.find(ord(e[3]) - 97):
            return False
return True
La igualdad es una relación de equivalencia, así que divide las letras en grupos que deben tener el mismo valor. La desigualdad no es una relación de equivalencia y no se puede unir en absoluto; solo se puede comprobar contra la partición terminada. Procésalas en una sola pasada intercalada y la respuesta depende del orden de la entrada, que es justo el fallo que esta pregunta existe para detectar: ["a!=b", "a==b"] se aceptaría, porque la desigualdad se comprueba antes de la unión que la contradice.
Salidas verificadas: ["a==b","b!=a"] es False, ["a==b","b==c","a==c"] es True, ["a==b","b!=c","c==a"] es False, y la ecuación única ["a!=a"] es False porque una letra siempre es igual a sí misma.
El seguimiento: ¿y si las variables no fueran letras sueltas? Exactamente el mapeo de identificadores de la sección 6: convierte cada nombre en un entero denso con un hash, o usa el nombre como clave del diccionario de padres. No cambia nada más, y conviene señalarlo porque demuestra que ves la estructura como algo separado de la codificación.
La trampa. Crear el DSU sobre las letras que aparecen en lugar de sobre las 26. Funciona, y te cuesta los dos minutos que pasas construyendo el mapeo para un alfabeto que ya es denso y diminuto. Lee las restricciones antes de escribir código genérico.
10. Kruskal: union-find dentro de un árbol generador
La pregunta. Conecta todos los puntos con el mínimo coste total, donde el coste entre dos puntos es su distancia Manhattan. Es LeetCode 1584, y es un árbol generador mínimo disfrazado.
Union-find no es aquí la respuesta, es la pieza que hace funcionar la respuesta. El algoritmo de Kruskal ordena todas las aristas candidatas por peso y acepta una arista exactamente cuando une dos componentes distintas, que es el booleano que devuelve union.
edges.sort()                              # por peso
dsu, total, used = DSU(n), 0, 0
for w, a, b in edges:
    if dsu.union(a, b):                   # solo si conecta dos componentes
        total += w
        used += 1
        if used == n - 1:                 # un árbol generador tiene n-1 aristas
            break
Con los cinco puntos [[0,0],[2,2],[3,10],[5,2],[7,0]] hay 10 aristas candidatas, Kruskal se queda con cuatro de pesos 3, 4, 4 y 9, y el total es 20. La salida temprana al llegar a n - 1 aristas importa en entradas densas, donde la lista de candidatas es O(n2) y la mayor parte nunca se necesita.
El seguimiento: ¿Prim o Kruskal aquí? Para un grafo completo de n puntos, Kruskal construye y ordena n(n-1)/2 aristas, lo que es O(n2 log n), mientras que Prim con un recorrido de array se ejecuta en O(n2) y nunca materializa la lista de aristas. En una instancia densa Prim es la mejor respuesta, y saber que Kruskal es el algoritmo para grafos dispersos es el sentido de la pregunta. El compromiso se analiza en detalle en árboles generadores mínimos y en el algoritmo de Kruskal.
La trampa. Sumar el peso antes de comprobar la unión, de modo que las aristas rechazadas también cuentan en el total. Da un número lo bastante cercano como para parecer correcto en el ejemplo e incorrecto en todo lo demás.
11. Las respuestas de complejidad
Este es el único tema en el que la respuesta honesta resulta algo incómoda, y los entrevistadores preguntan precisamente por eso.
| Versión | Amortizado por operación | Fuente |
|---|---|---|
| Ninguna optimización | O(n) | La cadena de la figura de arriba |
| Solo unión por tamaño o rango | O(log n) | La profundidad solo se duplica en fusiones iguales |
| Solo compresión de caminos | O(log n) | Tarjan y van Leeuwen, 1984 |
| Las dos juntas | O(α(n)) | Tarjan, 1975 |
| Cualquier estructura basada en punteros | Ω(α(n)) | Fredman y Saks, 1989 |
α es la inversa de la función de Ackermann, y crece tan despacio que α(n) ≤ 4 para todo n que se pueda almacenar en cualquier ordenador físico. Así que la respuesta práctica es «en la práctica constante», y la respuesta correcta es «O(α(n)) amortizado, que no es lo mismo que O(1)». La diferencia es real: Fredman y Saks demostraron en 1989 que ninguna estructura de este tipo puede hacerlo mejor, así que la α no es un artefacto del análisis.
Dos cifras más que conviene tener a mano. El espacio es O(n), dos arrays de enteros. Y la amortización es por secuencia, no por llamada: un solo find puede seguir recorriendo un camino largo; lo que está acotado es el total sobre m operaciones. Los entrevistadores a veces aprietan ahí, y «amortizado, no peor caso por operación» es la frase que quieren oír.
Como comprobación de lo planos que quedan realmente los árboles: tras 200.000 uniones aleatorias sobre 100.000 elementos y un find sobre cada elemento, el árbol más profundo de la estructura tiene un puntero de profundidad. Cada elemento apunta directamente a su raíz.
12. Errores que hacen fracasar la entrevista
Ordenados por frecuencia; los tres primeros explican la mayoría de las soluciones rechazadas.
- Comparar elementos en lugar de raíces.
if a == bdonde se quería decirif find(a) == find(b). Compila, se ejecuta y responde a otra pregunta. - Saltarse la unión por tamaño. La compresión de caminos sola suele pasar, así que esto sobrevive a las pruebas y luego se degrada con entradas adversas. Ambas optimizaciones son una línea cada una; escribe las dos.
- Un
findrecursivo con entradas profundas. Cien mil uniones encadenadas son cien mil marcos de pila. Escribe la versión iterativa, o explica por qué la profundidad de recursión es segura aquí. - Error por uno en el tamaño del array. Los nodos numerados de 1 a n necesitan
DSU(n + 1). Es el fallo más común en estos problemas. - Unir las cosas equivocadas. Piedras en lugar de filas y columnas, cuentas en lugar de emails, nombres en lugar de identidades. Cuando la versión por pares parece cuadrática, normalmente los elementos están mal elegidos.
- Intercalar igualdades y desigualdades. Las restricciones que fusionan deben aplicarse todas antes de cualquier restricción que solo comprueba. Dos pasadas, siempre.
- Olvidar que union-find no puede borrar. Si el problema elimina aristas, dilo de inmediato y ofrece la inversión offline o una estructura con rollback. Intentar meter borrados en una estructura comprimida es un callejón sin salida.
- No mantener el número de componentes. Recalcularlo con un bucle de
finddespués de cada operación convierte una solución lineal en una cuadrática, que es exactamente el fallo que Islands II está diseñado para destapar. - Decir O(1). Es
O(α(n))amortizado. Di «en la práctica constante, formalmente inversa de Ackermann» y el seguimiento desaparece.
El hábito que evita la mayoría de estos errores: antes de escribir nada, di qué representa un elemento y qué significa que dos de ellos estén en el mismo conjunto. Si no puedes terminar las dos mitades de esa frase, todavía no has modelado el problema, y las quince líneas no te van a salvar.
13. Preguntas frecuentes
¿Qué es union-find, en pocas palabras?
+
Es una estructura que lleva la cuenta de qué elementos pertenecen al mismo grupo, con dos operaciones: find, que pregunta en qué grupo está un elemento, y union, que fusiona dos grupos. Cada grupo se guarda como un árbol de punteros al padre y se identifica por la raíz de ese árbol, así que dos elementos están en el mismo grupo exactamente cuando tienen la misma raíz. También se llama disjoint set union, o DSU.
¿Cuándo debería usar union-find en lugar de BFS o DFS?
+
Usa un recorrido cuando el grafo es fijo y lo recorres una vez, ya que ambos enfoques son lineales y un recorrido no necesita estructura extra. Usa union-find cuando las aristas llegan con el tiempo y la respuesta hace falta después de cada una, cuando el problema solo fusiona grupos y nunca los separa, o cuando quieres el booleano «¿estaban ya conectados?» como parte de otro algoritmo, que es lo que hace el algoritmo de Kruskal. Union-find tampoco necesita que exista la lista de adyacencia, lo que importa cuando los pares pasan en flujo en lugar de caber en memoria.
¿De verdad union-find es O(1)?
+
No, y conviene responderlo bien. Con unión por tamaño o por rango más compresión de caminos, m operaciones sobre n elementos cuestan O(m por alfa de n) amortizado, donde alfa es la inversa de la función de Ackermann. Alfa de n vale como mucho 4 para cualquier n que se pueda almacenar físicamente, así que el comportamiento práctico es constante, pero la cota no es O(1) y la diferencia no es un tecnicismo: Fredman y Saks demostraron en 1989 que ninguna estructura de este tipo puede bajar de alfa. Di «en la práctica constante, formalmente inversa de Ackermann, amortizado y no peor caso por llamada».
¿Unión por rango o unión por tamaño?
+
Cualquiera, porque las dos dan la misma cota asintótica. El rango guarda una cota superior de la altura de un árbol y el tamaño guarda cuántos elementos contiene. En una entrevista el tamaño suele ser la mejor opción, porque buena parte de las preguntas de seguimiento piden el tamaño de la componente fusionada, y con la unión por tamaño ya tienes ese número gratis. Elijas la que elijas, cuelga el árbol pequeño bajo el grande, nunca al revés.
¿Puede union-find manejar borrados?
+
No directamente. Una vez comprimidos los caminos no queda registro de cómo se montaron los árboles, así que una fusión no se puede deshacer. Hay dos respuestas estándar. Procesar las operaciones offline en orden inverso, lo que convierte cada borrado en una adición y permite ejecutar un union-find normal hacia atrás. O usar un union-find con rollback, que mantiene una pila de deshacer con los cambios de cada unión y por eso tiene que renunciar a la compresión de caminos, dejando solo la unión por rango con O(log n) por operación.
¿Cómo uso union-find cuando los elementos son cadenas?
+
Dos opciones. Asigna a cada cadena distinta un entero denso la primera vez que la veas y usa la estructura normal basada en arrays, que es más rápida y es lo que quieres cuando la estructura está en un bucle crítico. O guarda el mapa de padres como un diccionario cuya clave es la propia cadena, que es más corto de escribir y cuesta una búsqueda por hash en cada acceso. Las dos son correctas; decir qué compromiso estás haciendo es lo que el entrevistador quiere oír.
¿Qué problemas de entrevista son de union-find?
+
Number of Connected Components, Number of Provinces, Redundant Connection, Number of Islands II, Accounts Merge, Most Stones Removed, Evaluate Division, Satisfiability of Equality Equations, Min Cost to Connect All Points, Graph Valid Tree, Smallest String With Swaps y Regions Cut By Slashes. La pista es una pregunta sobre si dos cosas pertenecen al mismo grupo, o un recuento de grupos que tiene que sobrevivir a un flujo de fusiones.
14. Referencias
Los artículos que introdujeron estas técnicas y los textos que las analizan, en orden cronológico.
- Kruskal, J. B. (1956). “On the shortest spanning subtree of a graph and the traveling salesman problem.” Proceedings of the American Mathematical Society, 7(1), 48–50.
- Galler, B. A. y Fischer, M. J. (1964). “An improved equivalence algorithm.” Communications of the ACM, 7(5), 301–303.
- Hopcroft, J. E. y Ullman, J. D. (1973). “Set merging algorithms.” SIAM Journal on Computing, 2(4), 294–303.
- Tarjan, R. E. (1975). “Efficiency of a good but not linear set union algorithm.” Journal of the ACM, 22(2), 215–225.
- Tarjan, R. E. y van Leeuwen, J. (1984). “Worst-case analysis of set union algorithms.” Journal of the ACM, 31(2), 245–281.
- Fredman, M. y Saks, M. (1989). “The cell probe complexity of dynamic data structures.” Proceedings of the 21st Annual ACM Symposium on Theory of Computing, 345–354.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. y Stein, C. (2009). Introduction to Algorithms, 3.ª edición, capítulo 21. MIT Press.
- Sedgewick, R. y Wayne, K. (2011). Algorithms, 4.ª edición, sección 1.5. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6.ª edición. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3.ª edición, capítulo 8. Springer.