
Inhaltsverzeichnis
- 1. Die kurze Antwort
- 2. Fünfzehn Freunde, drei Gruppen
- 3. Modularität: eine Aufteilung bewerten
- 4. Girvan-Newman: die Brücken zwischen Gruppen kappen
- 5. Louvain: Gruppen von unten nach oben aufbauen
- 6. Label Propagation: schnell und jedes Mal anders
- 7. Die Auflösungsgrenze
- 8. Ein echter Test: Zacharys Karateclub
- 9. Wenn Gruppen verschwimmen: ein gemessener Benchmark
- 10. Wo Community-Erkennung eingesetzt wird
- 11. Eine kurze Geschichte
- 12. Häufige Fehler
- 13. Glossar
- 14. Häufig gestellte Fragen
- 15. Quellen
1. Die kurze Antwort
Community-Erkennung teilt die Knoten eines Netzwerks in Gruppen auf, die innen viele Kanten und untereinander wenige haben. Sie ist Clustering für Graphen: Freundeskreise in einem sozialen Netzwerk, Teams in einem E-Mail-Protokoll, Proteinkomplexe in einer Zelle, Themen in einem Zitationsnetzwerk. Es gibt keine einzige richtige Antwort, daher beruht jede Methode auf einer Definition dessen, was eine gute Gruppe ist, und die meisten verbreiteten Methoden verwenden dieselbe, die sogenannte Modularität.
| Methode | Idee | Kosten | Bei jedem Lauf dasselbe Ergebnis? | Worauf zu achten ist |
|---|---|---|---|---|
| Girvan-Newman | Die Kanten löschen, über die die meisten kürzesten Wege laufen | Etwa O(m²n) | Ja | Zu langsam ab einigen tausend Knoten |
| Louvain | Knoten verschieben, um die Modularität zu erhöhen, dann Gruppen zusammenfassen und wiederholen | In der Praxis nahezu linear | Ja, bei fester Knotenreihenfolge | Die Auflösungsgrenze; schlecht verbundene Gruppen |
| Label Propagation | Jeder Knoten übernimmt das häufigste Label unter seinen Nachbarn | Etwa O(m) pro Durchlauf | Nein | Verschiedene Antworten bei verschiedenen Läufen |
| Exakte Maximierung der Modularität | Jede mögliche Aufteilung durchsuchen | Exponentiell | Ja | Nur für winzige Netzwerke |
In einem Satz: Verwenden Sie Louvain oder seinen Nachfolger Leiden als Standard, nehmen Sie Label Propagation, wenn Geschwindigkeit wichtiger ist als Stabilität, behalten Sie Girvan-Newman für kleine Netzwerke, bei denen Sie die ganze Hierarchie der Aufteilungen sehen wollen, und schauen Sie sich immer die gefundenen Gruppen an, statt einem einzigen Wert zu vertrauen. Dabei ist n die Anzahl der Knoten und m die Anzahl der Kanten.
2. Fünfzehn Freunde, drei Gruppen
Das durchgehende Beispiel ist eine Gruppe von fünfzehn Freunden, A bis O, mit einer Kante zwischen zwei Personen, die sich jede Woche Nachrichten schreiben. Es gibt 26 Kanten. Das Netzwerk wurde so gebaut, dass es drei Kreise aus je fünf Freunden enthält, A bis E, F bis J und K bis O, die durch fünf Kanten verbunden sind, und dann per Computer geprüft, damit sich die Methoden unten auf lehrreiche Weise verhalten.
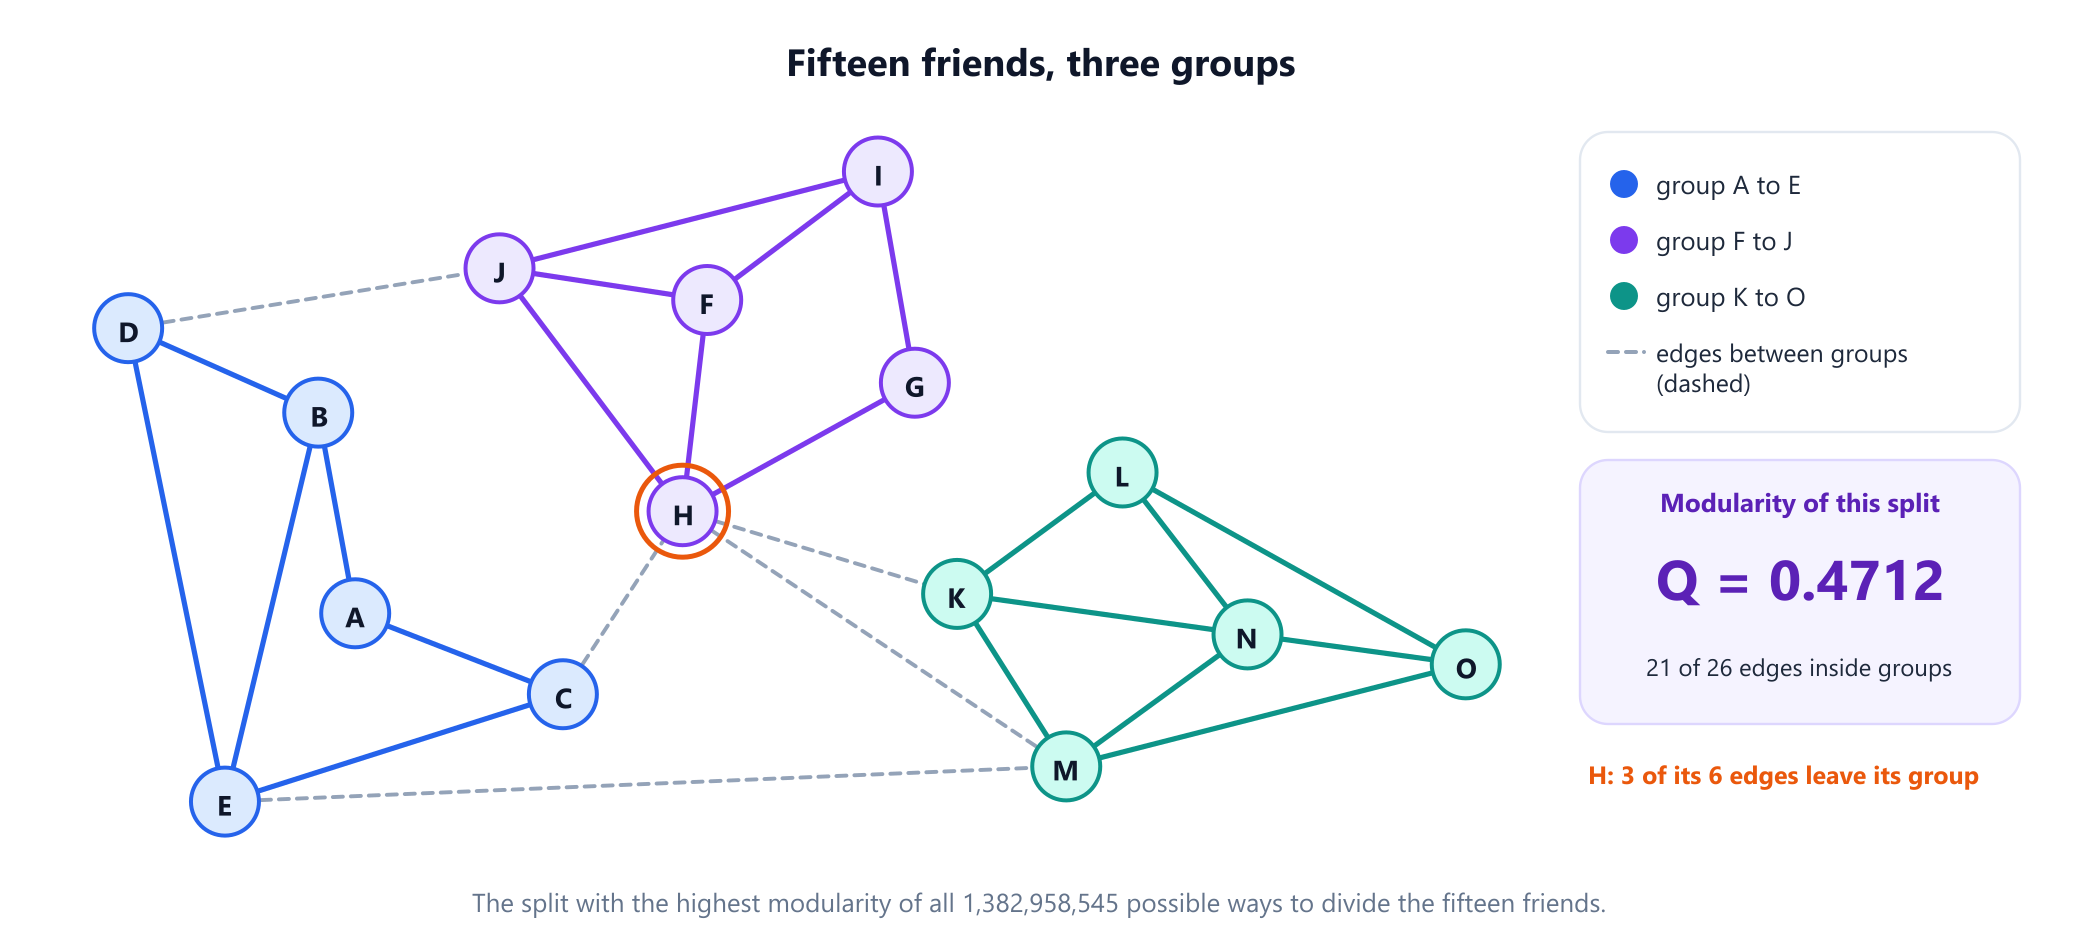
Die meisten Menschen würden mit bloßem Auge dieselben drei Kreise zeichnen. Bei einer Person ist es weniger klar: H hat sechs Kontakte, drei in der eigenen Gruppe und drei außerhalb, darunter zwei in der Gruppe K bis O. Jede Methode muss entscheiden, wohin H gehört, und der Rest dieses Leitfadens nutzt diese Entscheidung als Test.
3. Modularität: eine Aufteilung bewerten
Um Aufteilungen zu vergleichen, braucht man einen Wert. Die Kanten innerhalb der Gruppen zu zählen reicht nicht, denn wer alle in eine Gruppe steckt, legt jede Kante nach innen. Die Modularität, 2004 von Mark Newman und Michelle Girvan eingeführt, zieht ab, was der Zufall allein ergäbe:
Q = Summe über die Gruppen von [ (Kanten innerhalb der Gruppe) / m - ( (Gesamtgrad der Gruppe) / 2m )² ]Der zweite Term ist der Anteil der Kanten, den man innerhalb der Gruppe erwarten würde, wenn jeder Knoten seinen Grad behielte, die Kanten aber zufällig verdrahtet wären. Eine Gruppe bekommt nur für die Kanten Punkte, die sie über diese Erwartung hinaus hat. Das folgende Programm berechnet Q für fünf Arten, die Freunde aufzuteilen.
# Fünfzehn Freunde; eine Kante verbindet zwei Personen, die sich jede Woche Nachrichten schreiben.
FRIENDS = 'AB AC BD BE CE CH DE DJ EM FH FI FJ GH GI HJ HK HM IJ KL KM KN LN LO MN MO NO'.split()

def graph(edges):
    """Kanten sind 'AB' bei einzelnen Buchstaben oder '12-34' bei Zahlen."""
    adj = {}
    for e in edges:
        a, b = e.split('-') if '-' in e else e
        adj.setdefault(a, set()).add(b)
        adj.setdefault(b, set()).add(a)
    return adj

def modularity(adj, groups):
    """Q = Summe über die Gruppen von (Anteil der Kanten innerhalb) - (Anteil am Grad) zum Quadrat."""
    m = sum(len(nbrs) for nbrs in adj.values()) / 2
    q = 0.0
    for g in groups:
        inside = sum(1 for v in g for u in adj[v] if u in g) / 2
        degree = sum(len(adj[v]) for v in g)
        q += inside / m - (degree / (2 * m)) ** 2
    return q

def show(groups):
    return ' '.join(sorted(''.join(sorted(g)) for g in groups))

if __name__ == '__main__':
    adj = graph(FRIENDS)
    for name, groups in [('three groups', [set('ABCDE'), set('FGHIJ'), set('KLMNO')]),
                         ('H moved to K', [set('ABCDE'), set('FGIJ'), set('HKLMNO')]),
                         ('two groups', [set('ABCDE'), set('FGHIJKLMNO')]),
                         ('everyone together', [set(adj)]),
                         ('everyone alone', [{v} for v in adj])]:
        print(f'{name:18} Q = {modularity(adj, groups):7.4f}')
# three groups       Q =  0.4712
# H moved to K       Q =  0.4016
# two groups         Q =  0.2951
# everyone together  Q =  0.0000
# everyone alone     Q = -0.0725
Die drei Kreise erreichen 0,4712. In Zahlen: 21 der 26 Kanten, 81 %, liegen innerhalb einer Gruppe, während eine zufällige Verdrahtung mit denselben Graden 33,65 % nach innen legen würde, und 0,8077 - 0,3365 = 0,4712. Alle in einer Gruppe ergibt genau 0, weil das nicht besser als der Zufall ist, und jeder für sich allein ergibt einen Wert unter null. Verschiebt man H in die rechte Gruppe, sinkt der Wert auf 0,4016; nach diesem Maß gehört H also zu F bis J.
Ist 0,4712 das bestmögliche Ergebnis? Ein Netzwerk aus 15 Knoten lässt sich auf 1.382.958.545 verschiedene Arten aufteilen, zu viele, um sie einzeln aufzulisten, aber ein dynamisches Programm über die 32.768 Teilmengen der Knoten findet das Maximum exakt. Die beste Aufteilung sind die drei Kreise, mit Q = 0,4712. Auf großen Netzwerken ist eine solche Prüfung nicht möglich: Ulrik Brandes und Kollegen bewiesen 2008, dass das Finden der Aufteilung mit maximaler Modularität NP-schwer ist, und deshalb ist jede praktische Methode eine Heuristik.
4. Girvan-Newman: die Brücken zwischen Gruppen kappen
Die Methode von Michelle Girvan und Mark Newman aus dem Jahr 2002 arbeitet von oben nach unten. Über eine Kante, die zwei Gruppen verbindet, laufen viele kürzeste Wege, denn jede Route von einer Gruppe zur anderen muss sie oder eine der wenigen anderen ihrer Art benutzen. Das ist die Kanten-Betweenness der Kante, berechnet mit derselben Breitensuche wie die Betweenness-Zentralität. Die Methode löscht die Kante mit der höchsten Betweenness, berechnet neu und wiederholt das. Jedes Mal, wenn das Netzwerk in mehr Teile zerfällt, notiert sie die Aufteilung und deren Modularität.
from collections import deque
from modularity import FRIENDS, graph, modularity, show

def edge_betweenness(adj):
    """Algorithmus von Brandes, der die Punkte Kanten statt Knoten gutschreibt."""
    score = {}
    for s in adj:
        order, preds, sigma, dist = [], {v: [] for v in adj}, dict.fromkeys(adj, 0), {s: 0}
        sigma[s] = 1
        queue = deque([s])
        while queue:
            v = queue.popleft()
            order.append(v)
            for w in adj[v]:
                if w not in dist:
                    dist[w] = dist[v] + 1
                    queue.append(w)
                if dist[w] == dist[v] + 1:
                    sigma[w] += sigma[v]
                    preds[w].append(v)
        delta = dict.fromkeys(adj, 0.0)
        for w in reversed(order):
            for v in preds[w]:
                credit = sigma[v] / sigma[w] * (1 + delta[w])
                edge = tuple(sorted((v, w)))
                score[edge] = score.get(edge, 0) + credit / 2   # jedes Paar wird von beiden Enden aus gesehen
                delta[v] += credit
    return score

def components(adj):
    seen, parts = set(), []
    for s in sorted(adj):
        if s not in seen:
            part, stack = set(), [s]
            while stack:
                v = stack.pop()
                if v not in part:
                    part.add(v)
                    stack.extend(adj[v])
            seen |= part
            parts.append(part)
    return parts

def girvan_newman(adj, verbose=False):
    """Kante mit der höchsten Betweenness löschen, neu berechnen, wiederholen; jede Aufteilung behalten."""
    work = {v: set(nbrs) for v, nbrs in adj.items()}
    splits = {1: [set(adj)]}
    while any(work.values()):
        score = edge_betweenness(work)
        a, b = max(sorted(score), key=score.get)
        work[a].discard(b)
        work[b].discard(a)
        parts = components(work)
        if len(parts) not in splits:
            splits[len(parts)] = parts
            if verbose:
                print(f'cut {a}{b}: {len(parts):2} groups  Q = {modularity(adj, parts):.4f}')
    best = max(splits.values(), key=lambda p: modularity(adj, p))
    return best, splits

if __name__ == '__main__':
    adj = graph(FRIENDS)
    best, splits = girvan_newman(adj, verbose=True)
    print('best:', show(best), round(modularity(adj, best), 4))
# cut DJ:  2 groups  Q = 0.2951
# cut HM:  3 groups  Q = 0.4712
# cut CE:  4 groups  Q = 0.4312
# cut GI:  5 groups  Q = 0.3780
# cut KM:  6 groups  Q = 0.3070
# cut HJ:  7 groups  Q = 0.2744
# cut LO:  8 groups  Q = 0.2241
# cut AC:  9 groups  Q = 0.1901
# cut BE: 10 groups  Q = 0.1287
# cut DE: 11 groups  Q = 0.0991
# cut FJ: 12 groups  Q = 0.0377
# cut IJ: 13 groups  Q = 0.0081
# cut MO: 14 groups  Q = -0.0429
# cut NO: 15 groups  Q = -0.0725
# best: ABCDE FGHIJ KLMNO 0.4712
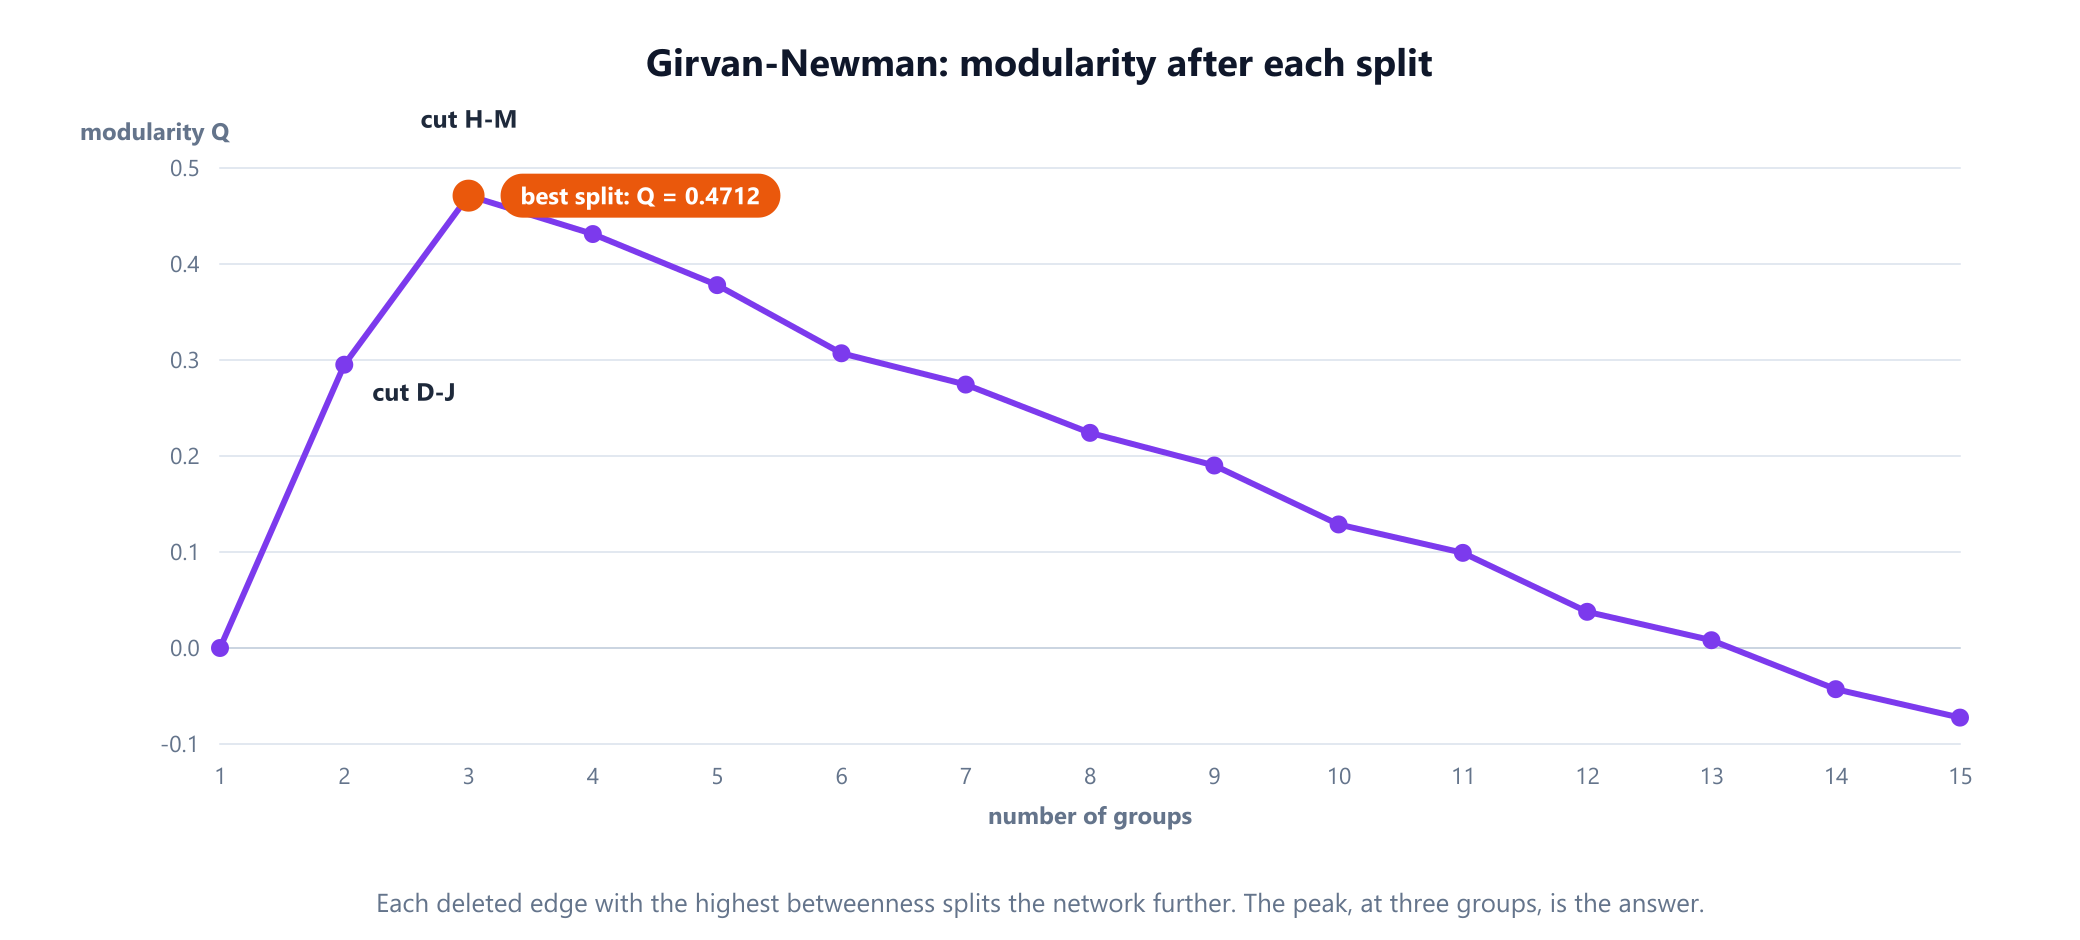
Als erste Kante fällt D-J, die bereits die linke Gruppe abtrennt: zwei Teile, Q = 0,2951. Als Nächstes fällt H-M, und die rechte Gruppe löst sich: drei Teile, Q = 0,4712. Danach zerlegen die Schnitte echte Gruppen, und die Modularität sinkt nur noch, bis auf -0,0725, wenn jeder Knoten allein steht. Behält man die Aufteilung mit dem höchsten Wert, erhält man wieder die drei Kreise.
Die Schwäche sind die Kosten. Jede Runde berechnet die Betweenness jeder Kante neu, was O(mn) Zeit braucht, und es gibt bis zu m Runden, sodass die ganze Methode etwa O(m²n) braucht. Das ist für einige hundert Kanten in Ordnung und für einige Millionen hoffnungslos.
5. Louvain: Gruppen von unten nach oben aufbauen
Die Louvain-Methode, 2008 von Vincent Blondel, Jean-Loup Guillaume, Renaud Lambiotte und Etienne Lefebvre an der Université catholique de Louvain veröffentlicht, maximiert die Modularität gierig in zwei Phasen, die sich wiederholen:
- Lokale Verschiebungen. Zu Beginn bildet jeder Knoten seine eigene Gruppe. Besuchen Sie die Knoten nacheinander und verschieben Sie jeden in die benachbarte Gruppe, die die Modularität am stärksten erhöht, sofern überhaupt eine Verschiebung das tut. Wiederholen Sie das, bis keine einzelne Verschiebung mehr hilft.
- Aggregation. Fassen Sie jede Gruppe zu einem einzigen Knoten zusammen. Kanten innerhalb der Gruppe werden zu einer Schleife am neuen Knoten, und Kanten zwischen Gruppen werden addiert.
Dann wird Phase 1 erneut auf dem kleineren Netzwerk ausgeführt. Der Gewinn einer Verschiebung lässt sich aus einer Handvoll Summen berechnen, ohne Q von Grund auf neu zu berechnen, und das macht die Methode schnell.
from modularity import FRIENDS, graph, modularity, show

def louvain(adj, verbose=False):
    """Louvain: einzelne Knoten verschieben, solange Q steigt, dann jede Gruppe zu einem Knoten zusammenfassen."""
    w = {v: {u: 1 for u in adj[v]} for v in adj}       # w[v][v] enthält die Kanten innerhalb eines zusammengefassten Knotens
    members = {v: {v} for v in adj}
    m2 = sum(len(nbrs) for nbrs in adj.values())        # doppelte Anzahl der Kanten
    level = 0
    while True:
        k = {v: sum(w[v].values()) for v in w}           # Grad jedes (zusammengefassten) Knotens
        group, total = {v: v for v in w}, dict(k)        # total = Summe der Grade in einer Gruppe
        moved = True
        while moved:
            moved = False
            for v in sorted(w):
                old = group[v]
                total[old] -= k[v]
                links = {}
                for u, x in w[v].items():
                    if u != v:
                        links[group[u]] = links.get(group[u], 0) + x
                gain = lambda g: links.get(g, 0) - total[g] * k[v] / m2
                best = old
                for g in sorted(links):
                    if gain(g) > gain(best) + 1e-12:
                        best = g
                group[v] = best
                total[best] += k[v]
                moved |= best != old
        if len(set(group.values())) == len(w):           # nichts zusammengefasst: fertig
            break
        level += 1
        merged = {}
        for v, g in group.items():
            merged.setdefault(g, {})
            for u, x in w[v].items():
                merged[g][group[u]] = merged[g].get(group[u], 0) + x
        members = {g: set().union(*(members[v] for v in w if group[v] == g)) for g in merged}
        w = merged
        if verbose:
            print(f'pass {level}: {len(w)} groups  Q = {modularity(adj, members.values()):.4f}')
    return list(members.values())

if __name__ == '__main__':
    adj = graph(FRIENDS)
    groups = louvain(adj, verbose=True)
    print('result:', show(groups))
# pass 1: 4 groups  Q = 0.4312
# pass 2: 3 groups  Q = 0.4712
# result: ABCDE FGHIJ KLMNO
Der erste Durchlauf endet mit vier Gruppen: Der mittlere und der rechte Kreis sind bereits vollständig, aber der linke Kreis teilt sich in A, C und B, D, E, mit Q = 0,4312. Verschiebungen einzelner Knoten können das nicht beheben, denn jede Verschiebung einer einzelnen Person zwischen diesen beiden Hälften senkt den Wert. Der zweite Durchlauf verschiebt ganze Gruppen, vereinigt die beiden Hälften und erreicht das Optimum von 0,4712.
Louvain hat zwei bekannte Schwächen. Es erbt jede Grenze der Modularität, die in Abschnitt 7 beschrieben wird. Und seine Gruppen können schlecht verbunden sein oder sogar zerfallen: Ein Knoten, der eine Gruppe zusammengehalten hat, kann in einem späteren Durchlauf wegwandern und den Rest unzusammenhängend zurücklassen. Der Leiden-Algorithmus von Vincent Traag, Ludo Waltman und Nees Jan van Eck aus dem Jahr 2019 fügt einen Verfeinerungsschritt hinzu, der zusammenhängende Gruppen garantiert, und wird oft an Stelle von Louvain empfohlen.
6. Label Propagation: schnell und jedes Mal anders
Label Propagation, 2007 von Usha Nandini Raghavan, Réka Albert und Soundar Kumara vorgeschlagen, berechnet überhaupt keine Modularität. Jeder Knoten beginnt mit seinem eigenen Label. In zufälliger Reihenfolge übernimmt jeder Knoten das Label, das unter seinen Nachbarn am häufigsten ist, wobei Gleichstände zufällig aufgelöst werden. Dichte Gruppen einigen sich schnell auf ein Label, und der Vorgang endet, wenn jeder Knoten bereits eines der häufigsten Labels seiner Nachbarn trägt. Jeder Durchlauf braucht O(m) Zeit, und meist sind nur wenige Durchläufe nötig.
import random
from collections import Counter
from modularity import FRIENDS, graph, show

def label_propagation(adj, seed):
    """Jeder beginnt mit dem eigenen Label und übernimmt immer wieder das häufigste in der Nachbarschaft."""
    rnd = random.Random(seed)
    label = {v: v for v in adj}
    for _ in range(1000):
        order = sorted(adj)
        rnd.shuffle(order)
        changed = False
        for v in order:
            if not adj[v]:
                continue
            count = Counter(label[u] for u in adj[v])
            top = max(count.values())
            best = sorted(l for l, c in count.items() if c == top)
            if label[v] not in best:                  # das eigene Label behalten, wenn es zu den besten gehört
                label[v] = rnd.choice(best)
                changed = True
        if not changed:
            break
    groups = {}
    for v, l in label.items():
        groups.setdefault(l, set()).add(v)
    return list(groups.values())

if __name__ == '__main__':
    adj = graph(FRIENDS)
    results = Counter(show(label_propagation(adj, seed)) for seed in range(1000))
    print('different results in 1000 runs:', len(results))
    for groups, n in results.most_common(4):
        print(f'{n:4}  {groups}')
# different results in 1000 runs: 49
#  387  ABCDE FGHIJ KLMNO
#  275  AC BDE FGHIJ KLMNO
#   46  ABCDE FIJ GHKLMNO
#   35  AB CE DFGHIJ KLMNO
Der Zufall spielt eine Rolle. In 1.000 Läufen auf dem Netzwerk der fünfzehn Freunde lieferte Label Propagation 49 verschiedene Antworten. Die drei Kreise fand sie 387-mal. Die zweithäufigste Antwort, 275-mal gefunden, teilt den linken Kreis in A, C und B, D, E, genau der Zwischenzustand, den auch der erste Durchlauf von Louvain erreichte. Andere Läufe zogen G und H in die rechte Gruppe oder vereinigten zwei Kreise.
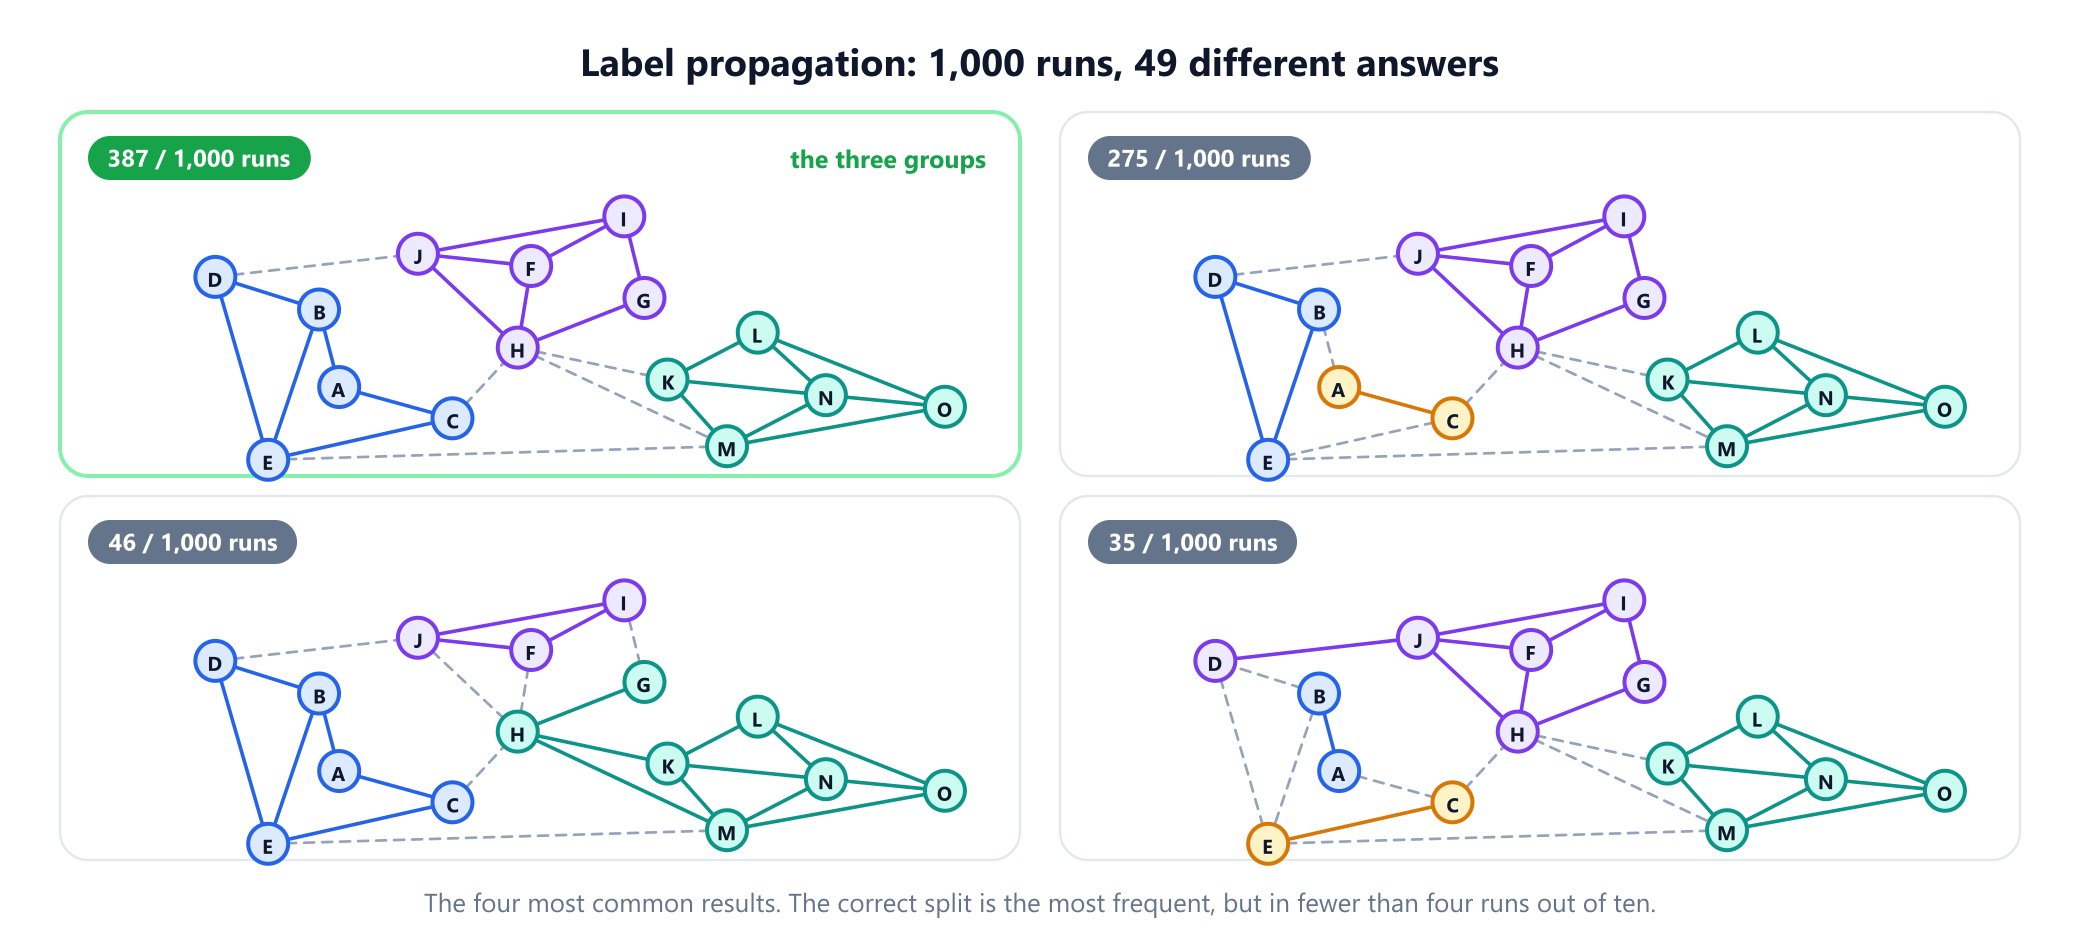
Nichts davon ist ein Programmfehler: Jedes dieser Ergebnisse ist ein gültiger Endzustand. Wenn Sie Label Propagation verwenden, führen Sie sie mehrmals aus und behalten Sie das Ergebnis mit der besten Modularität, oder vergleichen Sie, wie oft jedes Knotenpaar in derselben Gruppe landet.
7. Die Auflösungsgrenze
Die Modularität hat einen blinden Fleck, den kein Algorithmus beheben kann, weil er im Wert selbst steckt. Santo Fortunato und Marc Barthélemy zeigten 2007, dass in einem großen Netzwerk die Maximierung der Modularität kleine Gruppen zusammenlegen kann, die offensichtlich getrennt sind. Die Ursache ist der Term der erwarteten Kanten: Er schrumpft, wenn das Netzwerk wächst, sodass das Zusammenlegen zweier kleiner Gruppen fast nichts kostet, während die einzelne Kante zwischen ihnen als Gewinn zählt.
Das Standardbeispiel ist ein Ring aus Cliquen: Gruppen von Personen, die sich alle gegenseitig kennen, jede mit der nächsten durch eine einzige Kante verbunden. Das nächste Programm baut 30 Gruppen aus je fünf Personen und bewertet zwei Aufteilungen.
from modularity import modularity
from louvain import louvain

def ring_of_cliques(n, size):
    """n vollständige Gruppen aus je `size` Personen, jede mit der nächsten durch eine einzige Kante verbunden."""
    adj = {v: set() for v in range(n * size)}
    for c in range(n):
        people = range(c * size, (c + 1) * size)
        for a in people:
            adj[a] |= set(people) - {a}
        a, b = c * size, ((c + 1) % n) * size + 1
        adj[a].add(b)
        adj[b].add(a)
    return adj

if __name__ == '__main__':
    n, size = 30, 5
    adj = ring_of_cliques(n, size)
    cliques = [set(range(c * size, (c + 1) * size)) for c in range(n)]
    pairs = [cliques[i] | cliques[i + 1] for i in range(0, n, 2)]
    print('one group per clique:   Q =', round(modularity(adj, cliques), 4))
    print('cliques merged in pairs: Q =', round(modularity(adj, pairs), 4))
    found = louvain(adj)
    whole = all(any(g == set().union(*[c for c in cliques if c <= g]) for _ in [0]) for g in found)
    print('Louvain:', len(found), 'groups, Q =', round(modularity(adj, found), 4),
          ', every group a union of whole cliques:', whole)
# one group per clique:   Q = 0.8758
# cliques merged in pairs: Q = 0.8879
# Louvain: 15 groups, Q = 0.8879 , every group a union of whole cliques: True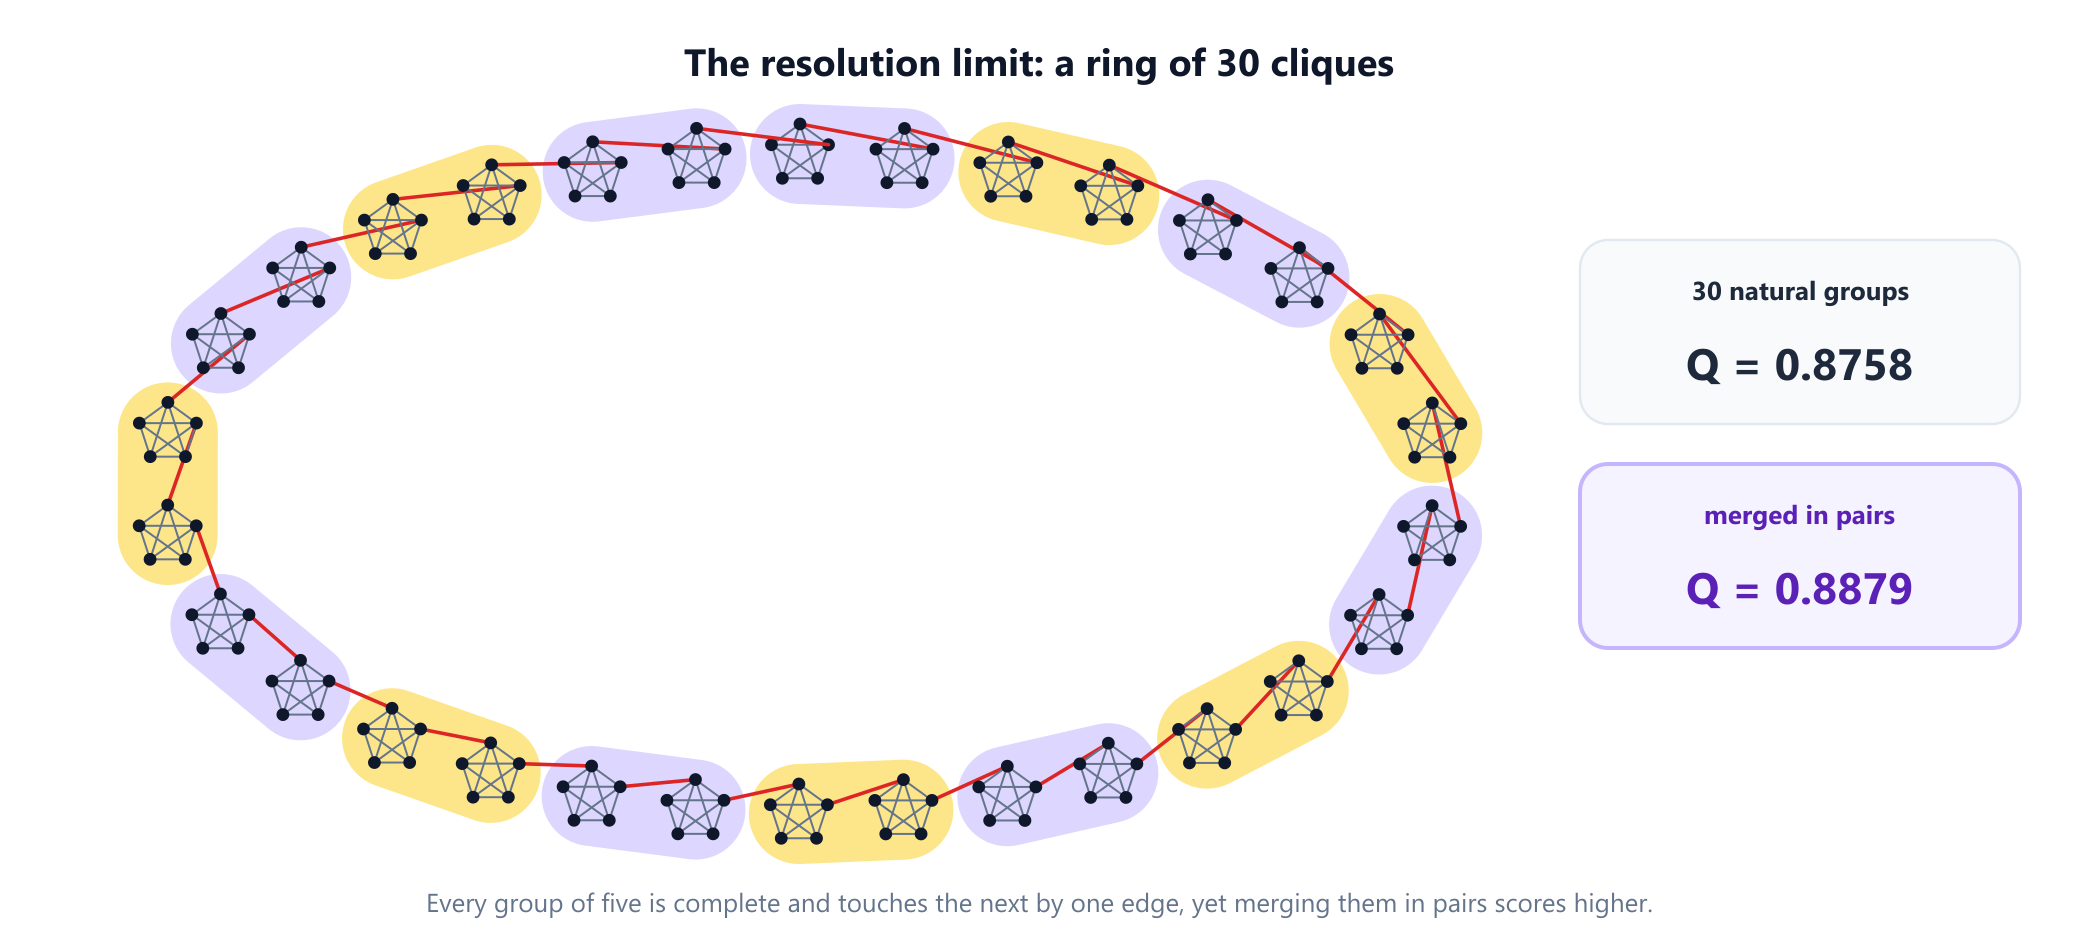
Die 30 Gruppen getrennt zu lassen ergibt 0,8758. Sie paarweise zusammenzulegen ergibt 0,8879, also würde selbst ein perfekter Modularitätsmaximierer nie die 30 natürlichen Gruppen liefern, und Louvain legt sie tatsächlich paarweise zusammen: Es liefert 15 Gruppen. Der Auflösungsparameter γ von Jörg Reichardt und Stefan Bornholdt multipliziert den Term der erwarteten Kanten; Werte über 1 begünstigen kleinere Gruppen und Werte unter 1 größere. Er verschiebt die Grenze, statt sie zu beseitigen, daher lohnt es sich, die Größe der gefundenen Gruppen mit dem abzugleichen, was Sie über das Netzwerk wissen.
8. Ein echter Test: Zacharys Karateclub
In den 1970er-Jahren erfasste der Anthropologe Wayne Zachary die Freundschaften unter 34 Mitgliedern eines Karateclubs an einer Universität, während ein Streit zwischen dem Trainer und dem Administrator des Clubs ihn in zwei Teile spaltete. Seine Arbeit von 1977 listete 78 Freundschaften auf, und weil die tatsächliche Spaltung bekannt ist, wurde das Netzwerk zum üblichen ersten Test für Community-Erkennung. Das nächste Programm führt alle drei Methoden aus und vergleicht sie mit der Seite, der sich jedes Mitglied anschloss, anhand der Labels, die mit der Bibliothek NetworkX verteilt werden. Diese halten fest, welchem Club sich jedes Mitglied nach der Spaltung anschloss. Zacharys Fraktionsdaten ordnen Mitglied 9 der Seite des Administrators zu, obwohl es dem Club des Trainers beitrat; Studien, die gegen die Fraktionen bewerten, wie Girvan und Newman es taten, zählen daher nur Mitglied 3 als falsch zugeordnet.
from collections import Counter
from modularity import graph, modularity
from girvan_newman import girvan_newman
from louvain import louvain
from lpa import label_propagation

# Zacharys Karateclub (1977): 34 Mitglieder, 78 Freundschaften und die Seite, die jedes Mitglied
# bei der Spaltung des Clubs wählte (H = Club des Trainers, O = der des Administrators), Mitglieder 1 bis 34.
CLUB = ('1-2 1-3 1-4 1-5 1-6 1-7 1-8 1-9 1-11 1-12 1-13 1-14 1-18 1-20 1-22 1-32 2-3 2-4 2-8 '
        '2-14 2-18 2-20 2-22 2-31 3-4 3-8 3-9 3-10 3-14 3-28 3-29 3-33 4-8 4-13 4-14 5-7 5-11 '
        '6-7 6-11 6-17 7-17 9-31 9-33 9-34 10-34 14-34 15-33 15-34 16-33 16-34 19-33 19-34 '
        '20-34 21-33 21-34 23-33 23-34 24-26 24-28 24-30 24-33 24-34 25-26 25-28 25-32 26-32 '
        '27-30 27-34 28-34 29-32 29-34 30-33 30-34 31-33 31-34 32-33 32-34 33-34').split()
SIDE = dict(zip([str(i) for i in range(1, 35)], 'HHHHHHHHHOHHHHOOHHOHOHOOOOOOOOOOOO'))

def wrong(groups):
    """Mitglieder in einer Gruppe, deren Mehrheit auf der anderen Seite stand."""
    bad = []
    for g in groups:
        majority = Counter(SIDE[v] for v in g).most_common(1)[0][0]
        bad += sorted((v for v in g if SIDE[v] != majority), key=int)
    return bad

if __name__ == '__main__':
    adj = graph(CLUB)
    best, splits = girvan_newman(adj)
    print('Girvan-Newman, first split:', [len(g) for g in splits[2]], 'misplaced:', wrong(splits[2]))
    print('Girvan-Newman, best Q:', len(best), 'groups, Q =', round(modularity(adj, best), 4))
    groups = louvain(adj)
    print('Louvain:', len(groups), 'groups, Q =', round(modularity(adj, groups), 4),
          'sizes', sorted(len(g) for g in groups))
    runs = Counter(len(label_propagation(adj, s)) for s in range(1000))
    print('label propagation, groups found in 1000 runs:', dict(sorted(runs.items())))
# Girvan-Newman, first split: [15, 19] misplaced: ['3', '9']
# Girvan-Newman, best Q: 5 groups, Q = 0.4013
# Louvain: 4 groups, Q = 0.4188 sizes [5, 6, 11, 12]
# label propagation, groups found in 1000 runs: {1: 6, 2: 218, 3: 369, 4: 295, 5: 104, 6: 8}
Die erste Aufteilung durch Girvan-Newman teilt den Club in 15 und 19 Mitglieder und ordnet zwei Personen falsch zu, die Mitglieder 3 und 9; beide haben Freunde auf beiden Seiten. Die beste Modularität erreicht die Methode erst später, bei fünf Gruppen mit Q = 0,4013. Louvain findet vier Gruppen mit Q = 0,4188, sehr nahe an 0,4198, dem bewiesenen Maximum für dieses Netzwerk, und jede seiner vier Gruppen liegt bis auf die Mitglieder 9 und 10 auf einer Seite der echten Spaltung. Label Propagation schwankt wieder: In 1.000 Läufen fand sie zwischen einer und sechs Gruppen, am häufigsten drei.
Die Lehre daraus: Die „wahre“ Antwort eines echten Netzwerks hängt von der Frage ab. Der Club spaltete sich in zwei Teile, aber die Modularität bevorzugt vier Gruppen, weil die beiden Fraktionen jeweils engere Kreise enthalten. Keine der beiden Antworten ist falsch; sie beantworten verschiedene Fragen.
9. Wenn Gruppen verschwimmen: ein gemessener Benchmark
Um Genauigkeit zu messen, braucht man Netzwerke mit bekannten Gruppen. Der Benchmark von Girvan und Newman aus dem Jahr 2002 hat 128 Knoten in vier Gruppen zu je 32. Jeder Knoten hat etwa 16 Kanten, von denen im Mittel z_out zu anderen Gruppen führen. Je größer z_out, desto schwerer sind die Gruppen zu erkennen. Die Genauigkeit wird mit der normalisierten Transinformation (NMI) gemessen, einem Wert von 0 bis 1, der nur dann 1 ist, wenn die gefundenen Gruppen genau den eingepflanzten entsprechen, wie 2005 von Leon Danon und Kollegen für diesen Zweck vorgeschlagen.
import math, random
from louvain import louvain
from lpa import label_propagation

def planted(rnd, z_out, groups=4, size=32, degree=16):
    """Test von Girvan und Newman: 4 Gruppen zu je 32, jeder Knoten mit etwa z_out Kanten, die seine Gruppe verlassen."""
    n = groups * size
    adj = {v: set() for v in range(n)}
    p_in, p_out = (degree - z_out) / (size - 1), z_out / (n - size)
    for a in range(n):
        for b in range(a + 1, n):
            if rnd.random() < (p_in if a // size == b // size else p_out):
                adj[a].add(b)
                adj[b].add(a)
    return adj

def nmi(found, size=32):
    """Normalisierte Transinformation zwischen den gefundenen und den eingepflanzten Gruppen (1 = identisch)."""
    n = sum(len(g) for g in found)
    planted = {}
    for g in found:
        for v in g:
            planted.setdefault(v // size, []).append(v)
    h = lambda parts: -sum(len(p) / n * math.log(len(p) / n) for p in parts)
    mutual = 0.0
    for g in found:
        for p in planted.values():
            k = len(g & set(p))
            if k:
                mutual += k / n * math.log(k * n / (len(g) * len(p)))
    hf, hp = h(found), h(list(planted.values()))
    return 1.0 if hf + hp == 0 else 2 * mutual / (hf + hp)

if __name__ == '__main__':
    rnd = random.Random(7)
    print('edges out   Louvain   label propagation   (average NMI over 10 networks)')
    for z_out in range(1, 10):
        a = b = 0.0
        for _ in range(10):
            adj = planted(rnd, z_out)
            a += nmi(louvain(adj)) / 10
            b += nmi(label_propagation(adj, rnd.randrange(10**6))) / 10
        print(f'{z_out:9} {a:9.2f} {b:12.2f}')
# edges out   Louvain   label propagation   (average NMI over 10 networks)
#         1      1.00         1.00
#         2      1.00         1.00
#         3      1.00         1.00
#         4      1.00         0.90
#         5      0.99         0.85
#         6      0.97         0.35
#         7      0.80         0.10
#         8      0.50         0.02
#         9      0.20         0.00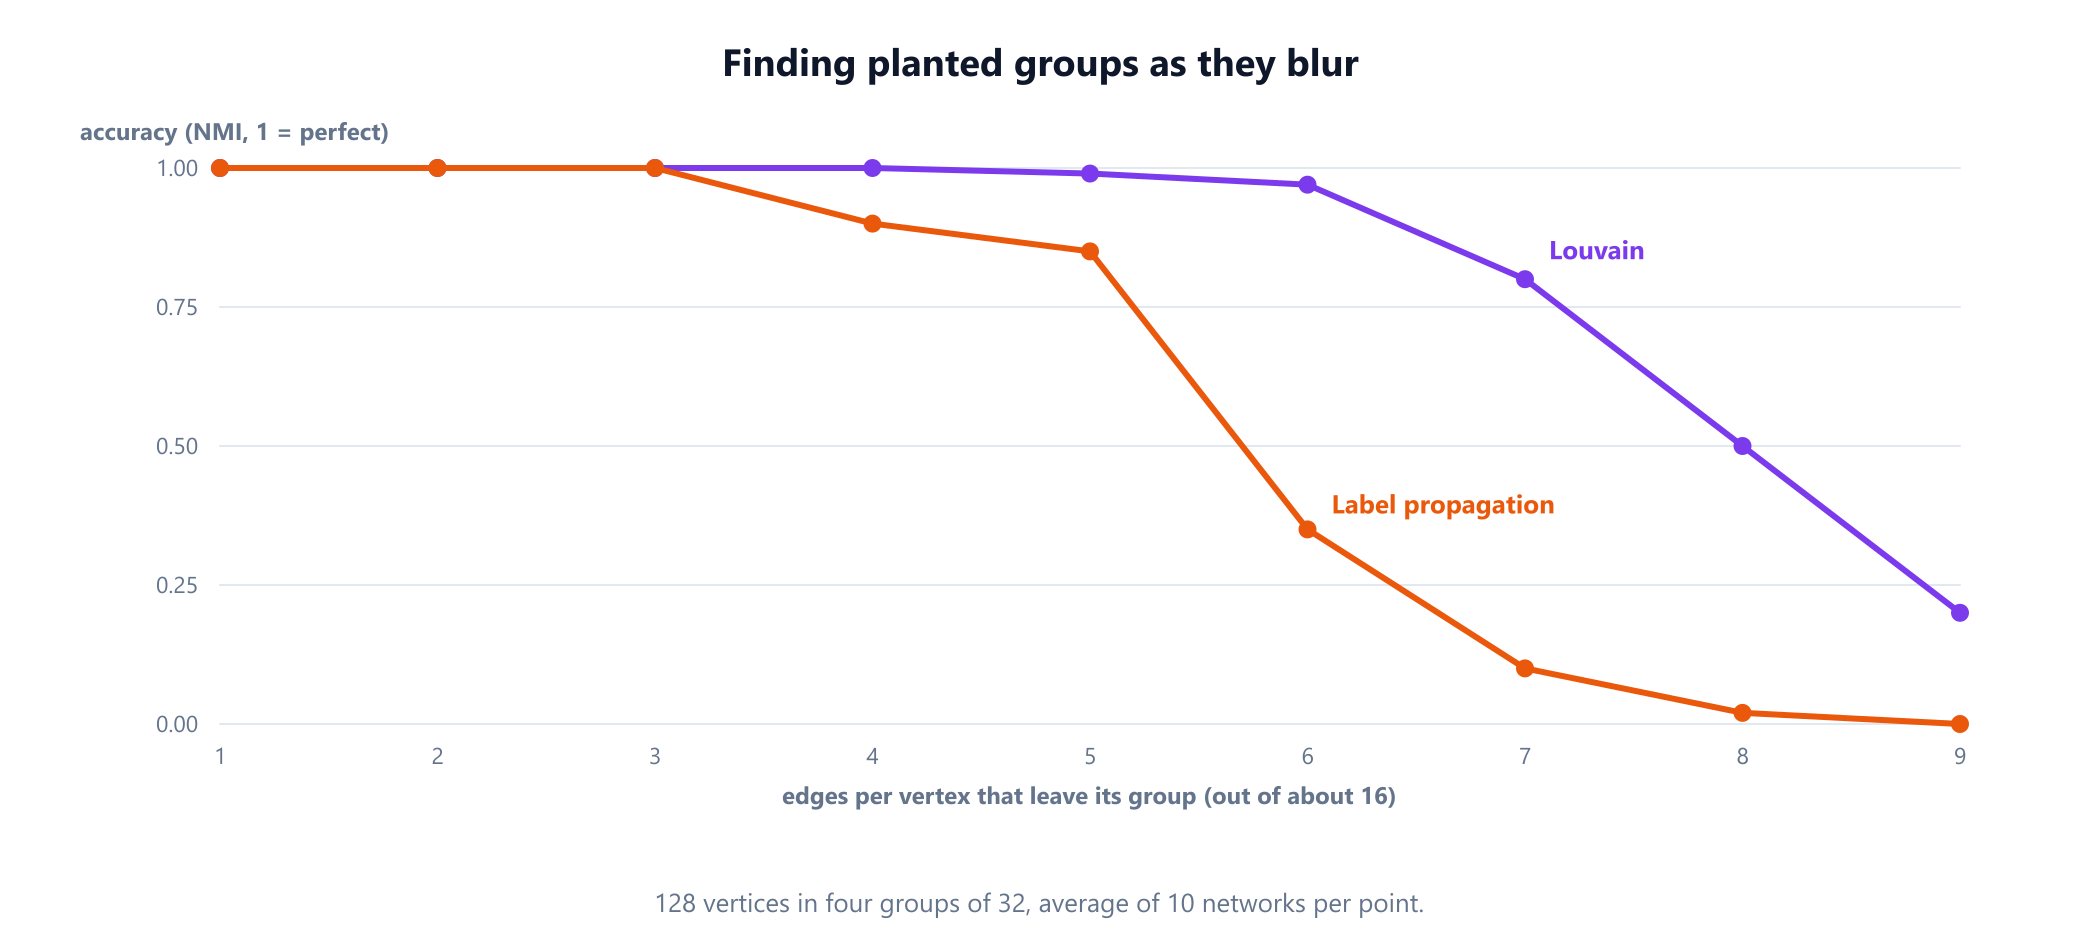
Beide Methoden sind perfekt, solange die Gruppen klar sind. Ab 4 von 16 Kanten nach außen beginnt Label Propagation zu schwächeln, und bei 6 ist ihr Wert auf 0,35 eingebrochen, während Louvain noch 0,97 erreicht. Bei 8 verlässt die Hälfte der Kanten jedes Knotens seine Gruppe, obwohl das Innere einer Gruppe immer noch 3,1-mal dichter ist als der Raum zwischen den Gruppen, und selbst Louvain ist auf 0,50 gefallen. Bei z_out = 12 wären die Gruppen innen nicht dichter als außen. Tatsächlich lassen sie sich schon früher nicht mehr wiederfinden: Aurelien Decelle und Kollegen zeigten 2011, dass in großen, auf diese Weise erzeugten Netzwerken keine Methode besser als der Zufall abschneiden kann, sobald z_out etwa 9 überschreitet.
10. Wo Community-Erkennung eingesetzt wird
- Soziale Netzwerke. Freundeskreise, Kollegen- oder Interessengruppen finden und die Personen, die sie verbinden, oft zusammen mit den Zentralitätsmaßen.
- Biologie. Gruppen in Protein-Interaktionsnetzwerken entsprechen oft Komplexen oder Stoffwechsel- und Signalwegen; der Leitfaden zur Graphentheorie in der Biologie behandelt diese Netzwerke.
- Empfehlungen und Marketing. Nutzer, die eine Community bilden, haben meist ähnliche Interessen, was hilft, Inhalte vorzuschlagen und Zielgruppen zu segmentieren.
- Betrug und Sicherheit. Konten, die überwiegend untereinander Transaktionen ausführen, können eine eng verflochtene Gruppe bilden, die sich vom normalen Verhalten abhebt.
- Software. Gruppen in einem Abhängigkeitsgraphen legen natürliche Modulgrenzen nahe, und Kanten zwischen Gruppen zeigen die Kopplungen, die eine Überprüfung lohnen.
11. Eine kurze Geschichte
Graphen in Teile zu zerlegen ist ein altes Thema: Die Heuristik von Brian Kernighan und Shen Lin aus dem Jahr 1970 teilte einen Graphen in Teile vorgegebener Größe auf und schnitt dabei so wenige Kanten wie möglich, ein Problem, das bei der Platzierung elektronischer Schaltungen auf Leiterplatten entstand. Community-Erkennung im heutigen Sinn, bei der Anzahl und Größe der Gruppen nicht vorab feststehen, kam mit der Arbeit von Girvan und Newman aus dem Jahr 2002 in Schwung, die auch Zacharys Karateclub als Test bekannt machte. Newman und Girvan definierten die Modularität 2004, und im selben Jahr veröffentlichten Aaron Clauset, Newman und Cristopher Moore eine schnelle gierige Methode, um sie zu maximieren. Label Propagation folgte 2007, im selben Jahr wie die Auflösungsgrenze, und die Louvain-Methode 2008. Santo Fortunatos Übersichtsarbeit von 2010 ist ein Standardüberblick, und der Leiden-Algorithmus von 2019 behob die unzusammenhängenden Gruppen von Louvain.
12. Häufige Fehler
| Fehler | Warum es falsch ist | Abhilfe |
|---|---|---|
| Einem einzigen Lauf von Label Propagation vertrauen | Im Beispiel ergaben 1.000 Läufe 49 verschiedene Antworten | Mehrmals ausführen oder Louvain bzw. Leiden verwenden |
Das höchste Q für die Wahrheit halten | Die Auflösungsgrenze legt kleine Gruppen zusammen | Gruppengrößen prüfen; einen Auflösungsparameter ausprobieren |
Werte von Q zwischen verschiedenen Netzwerken vergleichen | Die typischen Werte hängen von Größe und Dichte ab | Aufteilungen desselben Netzwerks vergleichen |
| Alle in einer Gruppe als Fehlschlag werten | Ein Netzwerk hat womöglich gar keine Community-Struktur | Mit einem Zufallsnetzwerk mit denselben Graden vergleichen |
| Girvan-Newman auf einem großen Graphen ausführen | Es braucht etwa O(m²n) Zeit | Louvain oder Leiden verwenden |
| Unzusammenhängende Gruppen von Louvain ignorieren | Eine Gruppe kann in späteren Durchläufen zerfallen | Leiden verwenden oder Gruppen in zusammenhängende Teile zerlegen |
| Erwarten, dass jeder Knoten zu genau einer Gruppe gehört | Menschen gehören gleichzeitig zu Familien-, Arbeits- und Sportkreisen | Eine überlappende Methode verwenden, wenn das wichtig ist |
13. Glossar
| Begriff | Bedeutung |
|---|---|
| Community | Eine Gruppe von Knoten mit vielen Kanten im Inneren und wenigen zum Rest |
| Partition | Eine Aufteilung der Knoten in Gruppen, jeder Knoten in genau einer |
| Modularität | Der Anteil der Kanten innerhalb von Gruppen abzüglich des durch Zufall erwarteten Anteils |
| Kanten-Betweenness | Wie viele kürzeste Wege zwischen Knotenpaaren über eine Kante laufen |
| Girvan-Newman | Wiederholtes Löschen der Kante mit der höchsten Betweenness |
| Louvain-Methode | Lokale Verschiebungen, die die Modularität erhöhen, dann Zusammenfassen von Gruppen, wiederholt |
| Leiden-Algorithmus | Eine Verfeinerung von Louvain, die zusammenhängende Gruppen garantiert |
| Label Propagation | Jeder Knoten übernimmt wiederholt das häufigste Label seiner Nachbarn |
| Auflösungsgrenze | Die Neigung der Modularität, in großen Netzwerken kleine Gruppen zusammenzulegen |
| Auflösungsparameter | Ein Gewicht γ auf dem Term der erwarteten Kanten, das die bevorzugte Gruppengröße verschiebt |
| Clique | Eine Gruppe, in der je zwei Knoten verbunden sind |
| NMI | Normalisierte Transinformation, 1, wenn zwei Partitionen identisch sind |
14. Häufig gestellte Fragen
Was ist Community-Erkennung in Graphen?
Community-Erkennung bedeutet, die Knoten eines Netzwerks in Gruppen aufzuteilen, die innen viele Kanten und untereinander wenige haben. Sie ist die Graphenversion des Clusterings. Typische Anwendungen sind das Finden von Freundeskreisen in sozialen Netzwerken, Teams in Kommunikationsdaten, Komplexen in Proteinnetzwerken und verwandten Themen in Zitations- oder Webgraphen.
Was ist Modularität?
Die Modularität, meist Q geschrieben, bewertet eine Aufteilung eines Netzwerks in Gruppen. Sie ist der Anteil der Kanten, die innerhalb von Gruppen liegen, abzüglich des Anteils, den man erwarten würde, wenn dieselben Knoten ihre Grade behielten, die Kanten aber zufällig platziert wären. Werte nahe 0 bedeuten nicht besser als der Zufall; gut getrennte Gruppen erreichen typischerweise Werte zwischen etwa 0,3 und 0,7.
Was ist der Louvain-Algorithmus?
Die Louvain-Methode, 2008 von Blondel und Kollegen veröffentlicht, maximiert die Modularität in zwei sich wiederholenden Phasen. Zuerst wandert jeder Knoten in die benachbarte Gruppe, die die Modularität am stärksten erhöht, bis keine Verschiebung mehr hilft. Dann wird jede Gruppe zu einem einzigen Knoten zusammengefasst, und der Vorgang wiederholt sich auf dem kleineren Netzwerk. Sie ist schnell genug für Netzwerke mit Millionen von Kanten.
Was ist der Unterschied zwischen Louvain und Girvan-Newman?
Girvan-Newman arbeitet von oben nach unten: Es löscht wiederholt die Kante mit der höchsten Betweenness, also die Kante, die am wahrscheinlichsten zwischen Gruppen verläuft, und behält die Aufteilung mit der besten Modularität. Louvain arbeitet von unten nach oben und fasst Knoten zu Gruppen zusammen, solange die Modularität steigt. Girvan-Newman braucht etwa O(m zum Quadrat mal n) Zeit und ist daher auf kleine Netzwerke beschränkt; Louvain skaliert auf sehr große.
Ist Label Propagation zuverlässig?
Label Propagation ist sehr schnell, aber ihr Ergebnis hängt von Zufallsentscheidungen ab. Im Beispiel mit 15 Personen in diesem Leitfaden lieferten 1.000 Läufe 49 verschiedene Antworten und fanden die drei echten Gruppen nur 387-mal. Führen Sie sie mehrmals aus und vergleichen Sie, oder verwenden Sie eine Modularitätsmethode, wenn stabile Ergebnisse wichtig sind.
Was ist die Auflösungsgrenze der Modularität?
Fortunato und Barthélemy zeigten 2007, dass die Maximierung der Modularität kleine, klar getrennte Gruppen zusammenlegen kann, wenn das Netzwerk groß ist. Auf einem Ring aus 30 Gruppen von je fünf Personen ergibt das paarweise Zusammenlegen benachbarter Gruppen einen höheren Wert, als sie getrennt zu lassen. Ein Auflösungsparameter oder Methoden, die nicht auf Modularität beruhen, können dem begegnen.
15. Quellen
Die oben genannten Algorithmen, Ergebnisse und Zuschreibungen stammen aus diesen Quellen, in chronologischer Reihenfolge.
- Kernighan, B. W. und Lin, S. (1970). "An Efficient Heuristic Procedure for Partitioning Graphs." Bell System Technical Journal 49(2), 291 bis 307.
- Zachary, W. W. (1977). "An Information Flow Model for Conflict and Fission in Small Groups." Journal of Anthropological Research 33(4), 452 bis 473.
- Girvan, M. und Newman, M. E. J. (2002). "Community Structure in Social and Biological Networks." Proceedings of the National Academy of Sciences 99(12), 7821 bis 7826.
- Newman, M. E. J. und Girvan, M. (2004). "Finding and Evaluating Community Structure in Networks." Physical Review E 69, 026113.
- Clauset, A., Newman, M. E. J. und Moore, C. (2004). "Finding Community Structure in Very Large Networks." Physical Review E 70, 066111.
- Danon, L., Díaz-Guilera, A., Duch, J. und Arenas, A. (2005). "Comparing Community Structure Identification." Journal of Statistical Mechanics: Theory and Experiment, P09008.
- Reichardt, J. und Bornholdt, S. (2006). "Statistical Mechanics of Community Detection." Physical Review E 74, 016110.
- Fortunato, S. und Barthélemy, M. (2007). "Resolution Limit in Community Detection." Proceedings of the National Academy of Sciences 104(1), 36 bis 41.
- Raghavan, U. N., Albert, R. und Kumara, S. (2007). "Near Linear Time Algorithm to Detect Community Structures in Large-Scale Networks." Physical Review E 76, 036106.
- Brandes, U., Delling, D., Gaertler, M., Görke, R., Hoefer, M., Nikoloski, Z. und Wagner, D. (2008). "On Modularity Clustering." IEEE Transactions on Knowledge and Data Engineering 20(2), 172 bis 188.
- Agarwal, G. und Kempe, D. (2008). "Modularity-Maximizing Graph Communities via Mathematical Programming." European Physical Journal B 66(3), 409 bis 418.
- Blondel, V. D., Guillaume, J.-L., Lambiotte, R. und Lefebvre, E. (2008). "Fast Unfolding of Communities in Large Networks." Journal of Statistical Mechanics: Theory and Experiment, P10008.
- Fortunato, S. (2010). "Community Detection in Graphs." Physics Reports 486(3 bis 5), 75 bis 174.
- Decelle, A., Krzakala, F., Moore, C. und Zdeborová, L. (2011). "Asymptotic Analysis of the Stochastic Block Model for Modular Networks and Its Algorithmic Applications." Physical Review E 84(6), 066106.
- Traag, V. A., Waltman, L. und van Eck, N. J. (2019). "From Louvain to Leiden: Guaranteeing Well-Connected Communities." Scientific Reports 9, 5233.
Sehen Sie die Suche hinter der Kanten-Betweenness
Girvan-Newman bewertet Kanten mit einer Breitensuche von jedem Knoten aus. Zeichnen Sie im Visualisierer zwei Gruppen, die durch eine einzige Kante verbunden sind, und starten Sie die Suche von beiden Seiten, um zu sehen, warum diese Kante jede Route zwischen ihnen trägt.
Visualisierer öffnen