
目录
1. 在图中行进的六个词
图论用一小组词来描述沿图的边行进:途径、迹和路径用于可以在任何地方结束的路线,而闭途径、回路和环则用于回到出发点的路线。它们只在三点上有所不同:一个顶点能否被经过两次,一条边能否被使用两次,以及路线是否在起始顶点结束。
- 一条途径是一个顶点序列
v0, v1, ..., vk,其中每两个相邻的顶点都由一条边相连。顶点和边都可以重复。途径的长度为k,即所走的步数,重复的边每使用一次就计一次。 - 一条迹是一条从不两次使用同一条边的途径。它可以不止一次地经过同一个顶点。
- 一条路径是一条从不两次经过同一个顶点的途径。一条边如果被使用两次,就会把它的两个端点再经过一次,所以路径也从不重复边。
- 一条闭途径是最后一个顶点就是第一个顶点的途径。
- 一个回路是一条闭迹:它在出发的地方结束,并且没有任何边被使用两次。
- 一个环是一条长度至少为 3 的闭途径,其中除了最后一个顶点就是第一个顶点之外,没有任何顶点重复。
这些是大多数现代图论教科书所采用的定义,但并非所有教科书都如此,第 4 节说明了主要约定在哪些地方不同。贯穿全文的示例是一个由四个三角形组成的条带,有 6 个顶点和 9 条边:
edges = {AB, AC, BC, BD, CD, CE, DE, DF, EF}      6 个顶点,9 条边

上排:          B     D     F
下排:        A     C     E

度:    A 2   B 3   C 4   D 4   E 3   F 2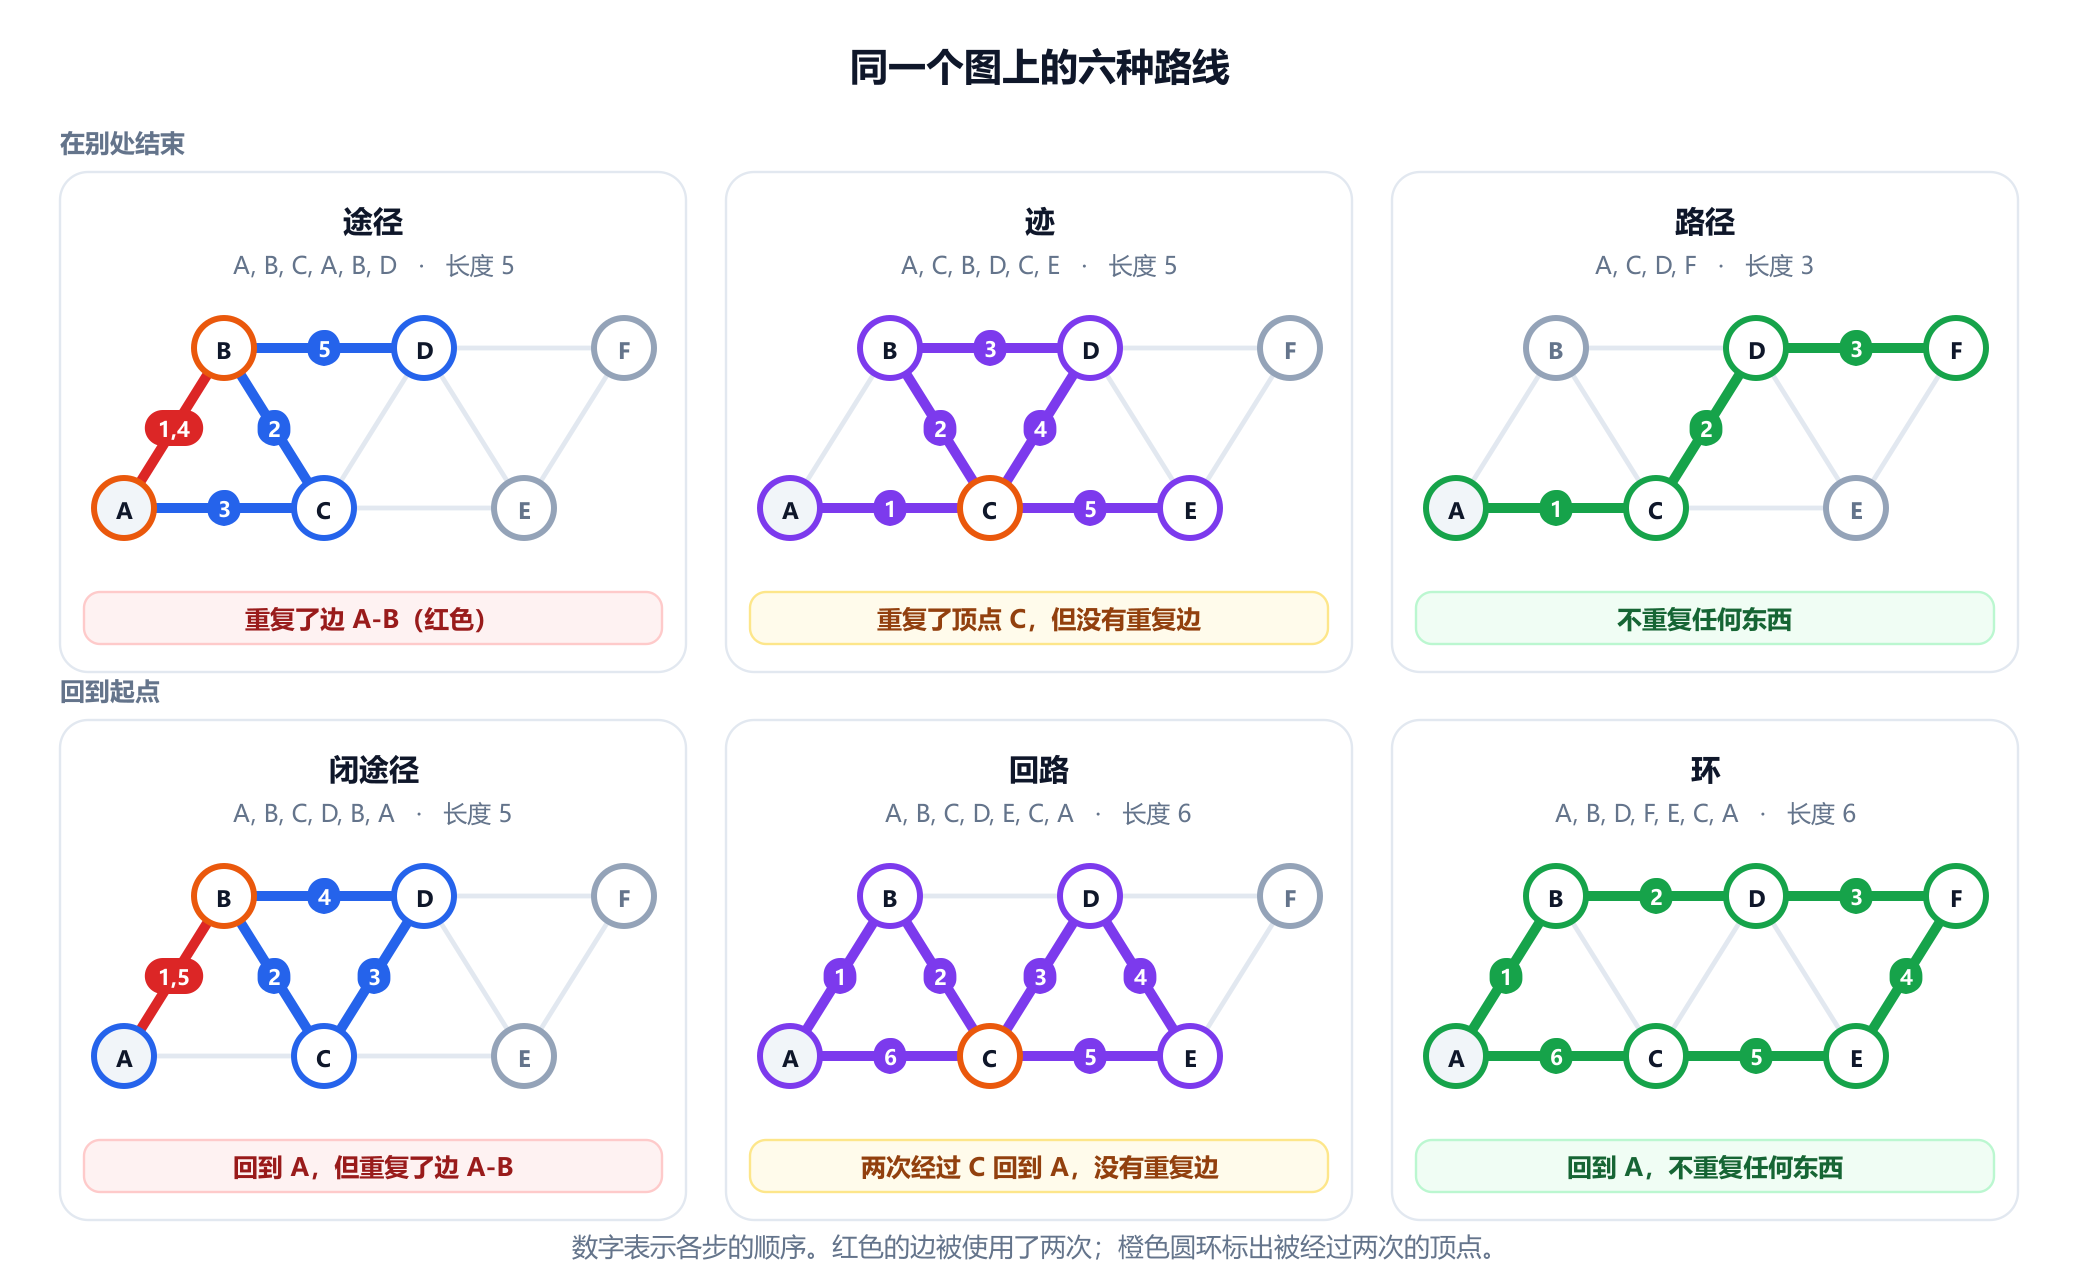
图中的每条路线都以六个名称中它所能适用的最具体的那个来称呼:
A, B, C, A, B, D是一条途径,长度为 5。它使用边A-B两次,所以它不是迹。A, C, B, D, C, E是一条迹,长度为 5。它经过C两次,所以它不是路径,但它的五条边各不相同。A, C, D, F是一条路径,长度为 3。它的四个顶点各不相同。A, B, C, D, B, A是一条闭途径,长度为 5。它回到了A,但使用了A-B两次。A, B, C, D, E, C, A是一个回路,长度为 6。它经由六条不同的边回到A,但经过了C两次。A, B, D, F, E, C, A是一个环,长度为 6。它沿着条带的外围绕行一周,不重复任何东西。
单独一个顶点,例如 A,也算数:它是一条长度为 0 的途径,也是一条长度为 0 的路径,称为平凡途径。它主要对证明和代码中的边界情形有意义,在那里“从一个顶点到它自身的路径”应当存在且长度为 0。
2. 六个概念之间的关系
这些定义是层层嵌套的。每条路径都是迹,因为一条从不重访顶点的路线不可能重复使用边;而每条迹都是途径。在闭合的一侧,每个环都是回路,每个回路都是闭途径。正如第 1 节的例子所示,这些包含关系都不能反过来。三个问题总是足以确定正确的名称,而且提问的顺序无关紧要。
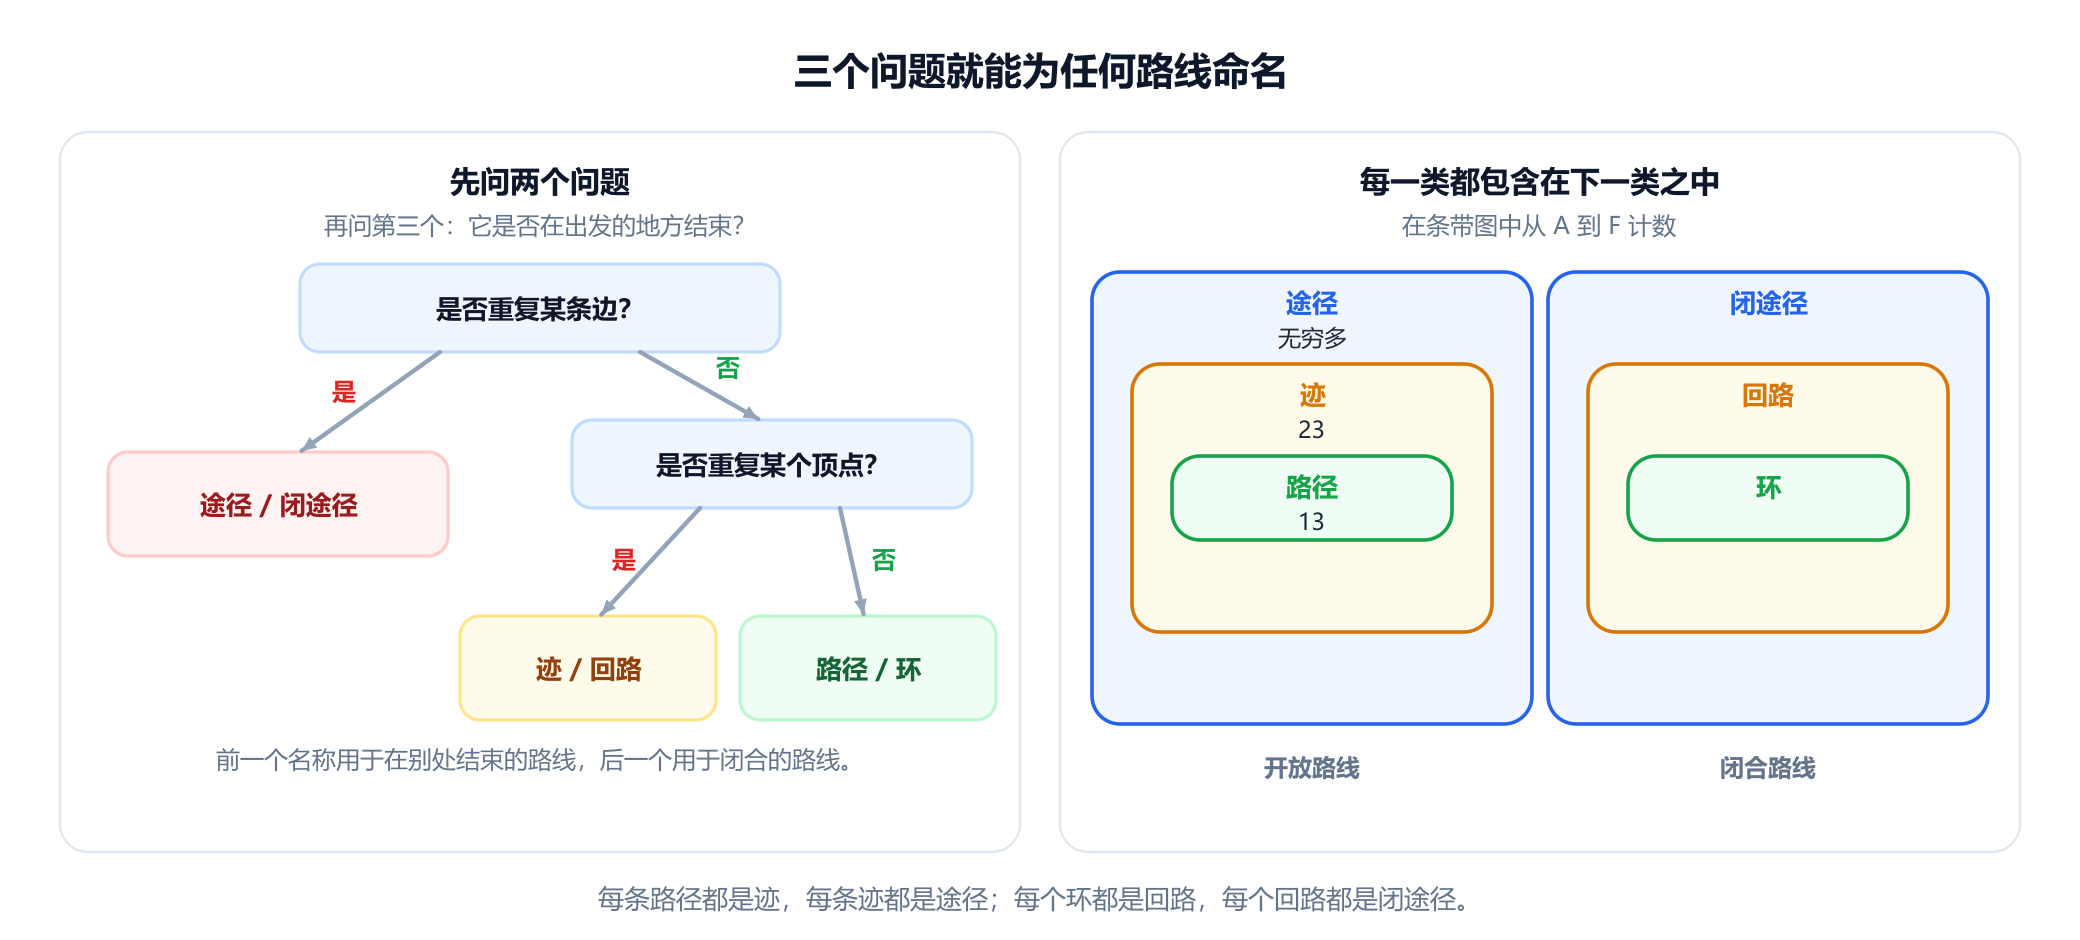
示例中的计数表明这几类路线的数目分化得有多快。从 A 到 F 恰好有 13 条路径:长度为 3 的 3 条,长度为 4 的 6 条,长度为 5 的 4 条。共有 23 条迹:即这 13 条路径,加上 10 条两次经过某个顶点的迹,例如 A, C, B, D, C, E, F。共有无穷多条途径,因为途径可以沿任何一条边来回往返任意多次。只有当长度固定时,途径的数目才是有限的,第 6 节会精确地计算它们。
有两个细节常常让初学者出错:
- 长度计的是边,而不是顶点。路径
A, C, D, F有四个顶点,长度为 3。经过k个顶点的环长度为k,因为它的最后一步回到起点。 - 一个环有多种写法。环
A, B, D, F, E, C, A可以从它 6 个顶点中的任何一个开始写,并且可以沿任一方向写,因此一个环对应 12 个序列。同样,一条路径也可以从任一端读起。通过列出序列来计数环的代码必须除以2k,否则长度为k的每个环都会被计数这么多次。
环的长度为什么至少要为 3?在简单图中,最短的闭途径,例如 A, B, A,都是沿一条边出去,再沿同一条边直接回来。这重复了一条边,所以它既不是回路也不是环。在多重图中情况就不同了:同一对顶点之间的两条平行边构成一个长度为 2 的环,而一个自环构成一个长度为 1 的环。这也是途径的正式定义除了顶点之外还要列出边的原因,写作 v0, e1, v1, e2, ..., vk:当两条平行边连接同一对顶点时,仅凭顶点的列表无法说明使用的是哪一条边。在简单图中,顶点决定了边,列出顶点就足够了。
3. 用代码检查一条路线
这些定义可以直接写成一个简短的函数。它接受一个简单图和一个顶点序列,检查每一步是否沿着一条边,然后提出第 2 节中的三个问题。
def graph(edges):
    adj = {}
    for u, v in edges:
        adj.setdefault(u, set()).add(v)
        adj.setdefault(v, set()).add(u)
    return adj

def classify(adj, seq):
    """给出顶点序列 seq 所属的最具体的途径类型。"""
    steps = list(zip(seq, seq[1:]))
    if any(v not in adj[u] for u, v in steps):
        return 'not a walk'
    closed = len(seq) > 1 and seq[0] == seq[-1]
    edges = [frozenset(step) for step in steps]
    no_repeated_edge = len(set(edges)) == len(edges)
    inner = seq[:-1] if closed else seq          # 闭途径在出发的地方结束
    no_repeated_vertex = len(set(inner)) == len(inner)
    if not closed:
        return 'path' if no_repeated_vertex else 'trail' if no_repeated_edge else 'walk'
    if no_repeated_vertex and len(edges) >= 3:
        return 'cycle'
    return 'circuit' if no_repeated_edge else 'closed walk'

strip = graph(['AB', 'AC', 'BC', 'BD', 'CD', 'CE', 'DE', 'DF', 'EF'])
for seq in ['ABCABD', 'ACBDCE', 'ACDF', 'ABCDBA', 'ABCDECA', 'ABDFECA', 'ABA', 'ABE']:
    print(seq, classify(strip, seq))
# ABCABD walk
# ACBDCE trail
# ACDF path
# ABCDBA closed walk
# ABCDECA circuit
# ABDFECA cycle
# ABA closed walk
# ABE not a walk
该函数首先拒绝 A, B, E,因为 B 和 E之间没有边。对于闭合的路线,它在比较顶点时去掉最后一个顶点,因为闭途径总是在末尾重复它的第一个顶点。检验 len(edges) >= 3 正是防止 A, B, A 被报告为环的条件:它的两个顶点不同,但它的两步使用的是同一条边。整个检查所需的时间与路线的长度成正比。
4. 教科书为何说法不一
如果你以前接触过这些词,你接触到的含义可能不同。图论同时在多个国家和领域中成长起来,它的术语从未完全统一。下表比较了几本广泛使用的英文教科书为同样四个概念所取的名称。
| 教科书 | 顶点和边都可以重复 | 没有重复边 | 没有重复顶点 | 闭合,没有重复边 |
|---|---|---|---|---|
| Ore(1962) | edge sequence | path | simple path 或 arc | cyclic path |
| Harary(1969) | walk | trail | path | closed trail |
| West(2001) | walk | trail | path | circuit |
| Bondy 和 Murty(2008) | walk | trail | path | closed trail |
| Chartrand 和 Zhang(2012) | walk | trail | path | circuit,长度至少为 3 |
| Rosen(2012) | path | simple path | 没有单独的名称 | simple circuit |
| Diestel(2017) | walk | 未命名 | path | 未命名 |
自 Harary 1969 年的著作以来,大多数图论教材在核心问题上意见一致: walk (途径)可以重复任何东西,而 path (路径)不重复任何东西。Ore 1962 年的 Theory of Graphs 展示了较早的用法,其中 path 指的是没有重复边的路线,也就是现在所说的迹。Rosen 的 Discrete Mathematics and Its Applications是离散数学入门课程的一本标准教材,它保留了这种用法的一个变体: path 指任何途径,而 simple path 则是不重复边的路线。Rosen 本人也指出了这一冲突,并把 walk、closed walk 和 trail 列为其他书所用的词;但一个从 Rosen 那里学到“path”的学生,翻开一本图论教材时,会发现同一个词的含义更为严格。
至于 circuit 和 cycle 这两个词,它们的含义最不稳定。West 以及 Chartrand 和 Zhang 用 circuit 指闭迹,与本文所说的回路相同。Ore 用 circuit 指现在所说的环,而工程师常把任何闭合的环路都称为“circuit”。有向图又增加了一层复杂性:在 Berge 最初用法语写成的经典著作中,无向图中的路线称为 chaîne (链),闭合的称为 cycle;而沿箭头方向的路线称为 chemin (路径),闭合的称为 circuit。
最稳妥的习惯是在一个词第一次出现时说明你所用的定义,或者用性质来代替含糊的词:“不重复任何顶点的路线”不会被误读。阅读时,请在第一章中寻找定义,并预期它与你上一本读过的书不同。
这种命名混乱最著名的牺牲品是欧拉路径。它恰好使用图的每条边一次,而且通常会多次经过一些顶点,所以按照本文的术语,它是一条迹,而不是路径。这个名称之所以沿用下来,是因为这个问题比这套术语更古老;如今“欧拉迹”是对同一事物更严谨的称呼。而哈密顿路径恰好经过每个顶点一次,确实是一条路径。第 8 节会再回到这两者。
5. 每条途径都包含一条路径
关于途径,最有用的事实是:要到达某处,从来不需要重复。如果存在一条从 u 到 v的途径,那么也存在一条从 u 到 v的路径,而且这条路径不比该途径长。证明就是走捷径。如果途径两次经过某个顶点 x,就删去两次经过之间的所有部分:途径仍然从 u 通向 v,而且变短了。重复这一操作,直到没有顶点重复为止。剩下的就是一条路径。
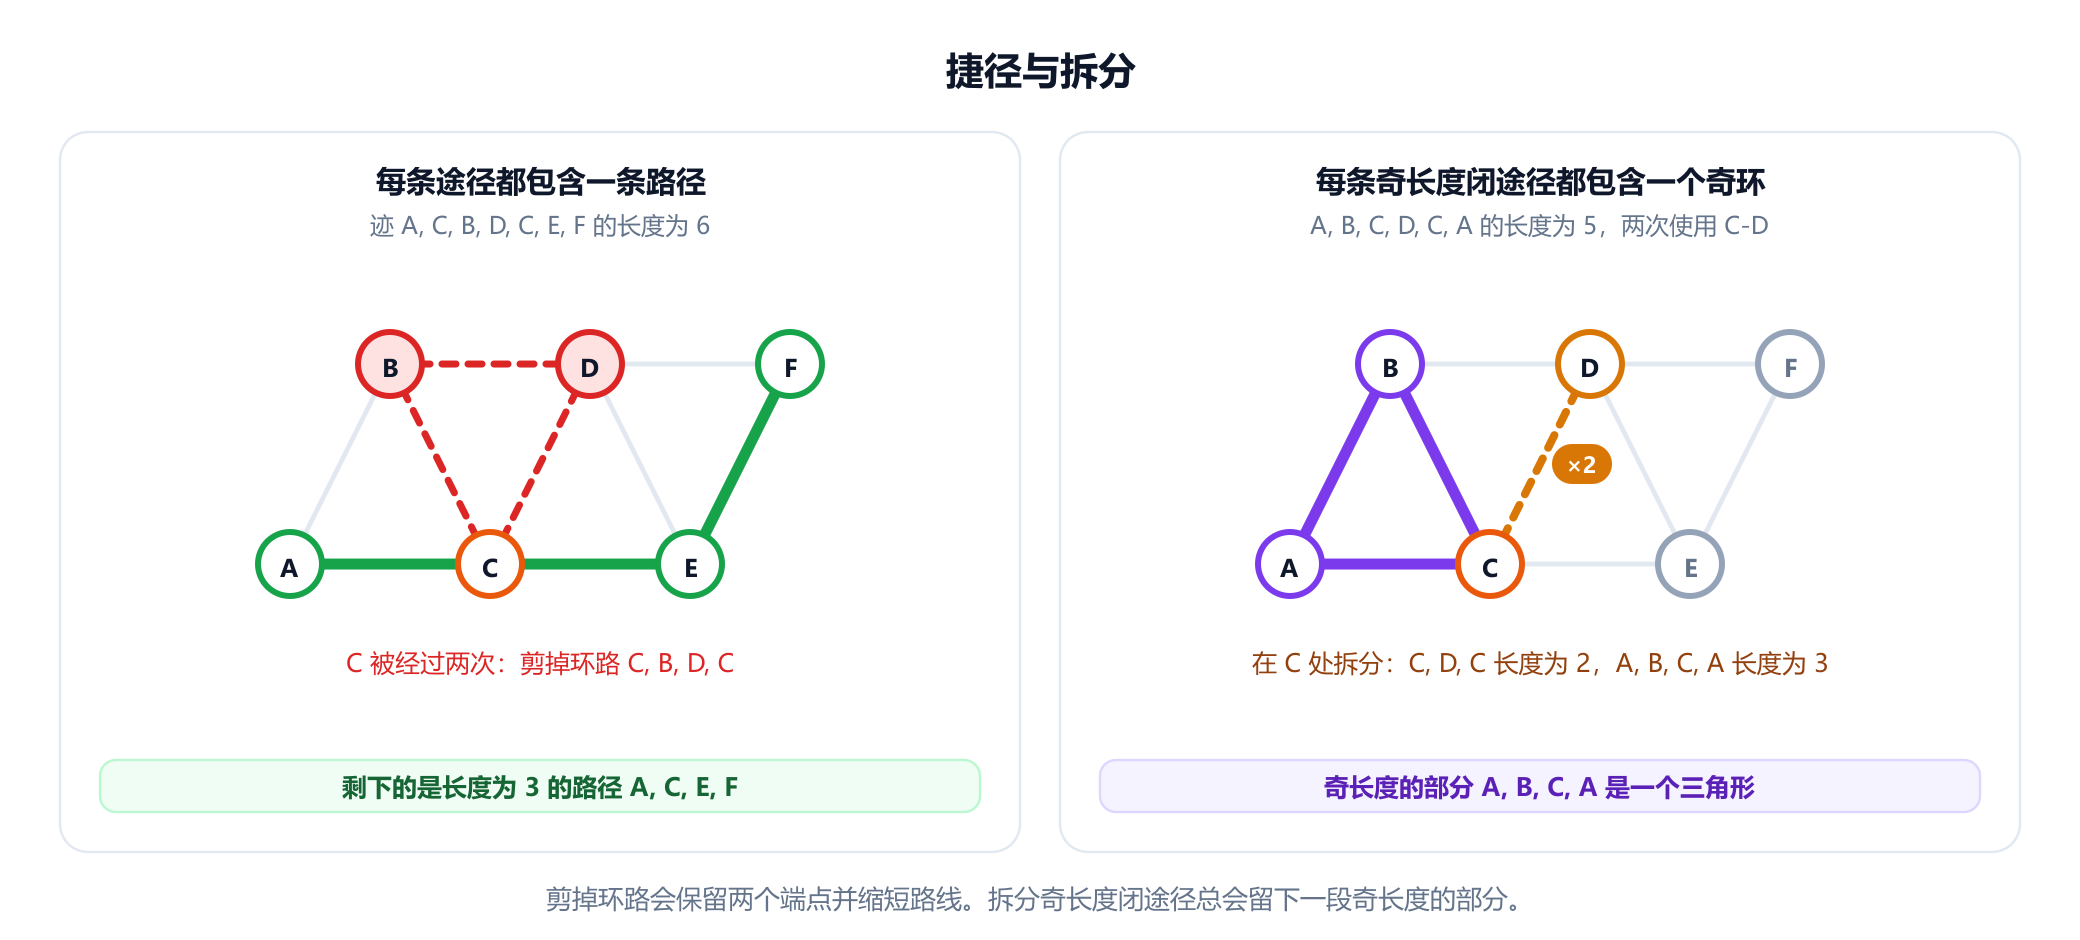
这个小引理有重大的推论:
- 连通性。 “任意两个顶点之间都有途径”与“任意两个顶点之间都有路径”是同一个意思,所以用哪个词来定义图的连通都可以。关于连通分量的指南以此为基础。
- 最短路线是路径。两个顶点之间的最短途径从不重复顶点,因为剪掉重复的部分会使它更短。这就是广度优先搜索和 Dijkstra 算法可以在途径上搜索、从不检查重复顶点,却仍然返回路径的原因。关于最短路径算法的指南介绍了这两种算法。
- 负权重会破坏这一点。当边权为负时,剪掉一段环路可能使路线变长,因为这段环路的总权重可能是负的。如果能到达一个负环,那么绕着它一圈又一圈地走,途径的代价就可以要多低有多低,最短途径也就不存在了。最短路径仍然存在,但一般而言,求出一条最短路径会变成 NP 困难问题,因为它也能求出第 7 节中的最长路径。关于 Bellman-Ford 算法的指南说明了如何检测这样的环。
闭途径需要更加小心。闭途径并不总是包含环: A, B, A 是闭合的,却不包含任何环。而一条长度为奇数的闭途径总是包含环,而且它所包含的环也是奇环。在一个重复的顶点处把闭途径拆成两条更短的闭途径。它们的长度之和等于原来的奇数长度,所以其中一条的长度是奇数。保留奇数长度的那条,重复这一过程。这个过程最终停在一条没有重复顶点的奇长度闭途径上,而由于简单图中没有长度为 1 的闭途径,这条途径就是一个长度至少为 3 的环。
这一论证是 Kőnig 定理的关键步骤:一个图是二分图当且仅当它没有长度为奇数的环。回路也可以用同样的方式拆分,拆成没有公共边的若干个环。下面的程序执行全部三种操作:它从途径中剪掉环路,在奇长度闭途径中找出奇环,并把回路拆分成若干个环。
def walk_to_path(walk):
    """剪掉每一段环路。结果是一条两端相同的路径。"""
    path, where = [], {}
    for v in walk:
        if v in where:                       # 回到 v:丢弃自上次经过以来的所有部分
            for u in path[where[v] + 1:]:
                del where[u]
            del path[where[v] + 1:]
        else:
            where[v] = len(path)
            path.append(v)
    return ''.join(path)

def split_closed_walk(walk):
    """在第一个重复的顶点处把闭途径拆成两条更短的闭途径。"""
    seen = {}
    for i, v in enumerate(walk[:-1]):
        if v in seen:
            j = seen[v]
            return walk[j:i + 1], walk[:j] + walk[i:]
        seen[v] = i
    return None                              # 没有重复:是一个环,或者是一步来回

def odd_cycle(walk):
    """长度为奇数的闭途径总是包含长度为奇数的环。"""
    while True:
        parts = split_closed_walk(walk)
        if parts is None:
            return walk
        walk = next(p for p in parts if (len(p) - 1) % 2 == 1)

def circuit_to_cycles(walk):
    """把回路拆成没有公共边的若干个环。"""
    parts = split_closed_walk(walk)
    if parts is None:
        return [walk]
    return circuit_to_cycles(parts[0]) + circuit_to_cycles(parts[1])

print(walk_to_path('ACBDCEF'))               # 长度为 6 的途径
# ACEF
print(odd_cycle('ABCDCA'))                   # 长度为 5 的闭途径,边 C-D 使用了两次
# ABCA
print(circuit_to_cycles('ABCDECA'))          # 长度为 6、两次经过 C 的回路
# ['CDEC', 'ABCA']
迹 A, C, B, D, C, E, F 两次经过 C,所以环路 C, B, D, C 被剪掉,剩下 A, C, E, F。闭途径 A, B, C, D, C, A 在 C 处被拆分为 C, D, C,长度为 2,以及 A, B, C, A,长度为 3,它就是那个奇环。回路 A, B, C, D, E, C, A 在 C 处被拆分为两个三角形 C, D, E, C 和 A, B, C, A。
回路的这种拆分是 Oswald Veblen 在 1912 年发表的一个定理的特例:一个图的边可以划分为没有公共边的若干个环,当且仅当每个顶点的度都是偶数。一个环在它经过的每个顶点处使用两条边,所以度必须是偶数;逆命题可以通过反复移除一个环得到,这样做会使每个顶点的度保持为偶数。
6. 用矩阵的幂计数途径
途径很难逐一列出,却很容易计数。把图写成它的邻接矩阵 A,其中第 u行第 v 列的元素在 u 与 v 相邻时为 1,否则为 0。关于图的表示的指南解释了这个矩阵本身。于是有一个经典的事实:第 u行、第 v 列的元素在幂 Ak 中的值,就是长度为 k、从 u 到 v的途径的条数。
原因在于矩阵乘法的规则。一条长度为 k、从 u 到 v 的途径,就是一条长度为 k - 1、从 u 到某个顶点 w的途径,再接上从 w 到 v的一步。因此这样的途径的条数,等于对所有 w 求和:(长度为 k - 1、从 u 到 w的途径条数)乘以 A[w][v],这恰好是 Ak-1 乘以 A的相应元素。对 k 用归纳法即可完成其余部分。
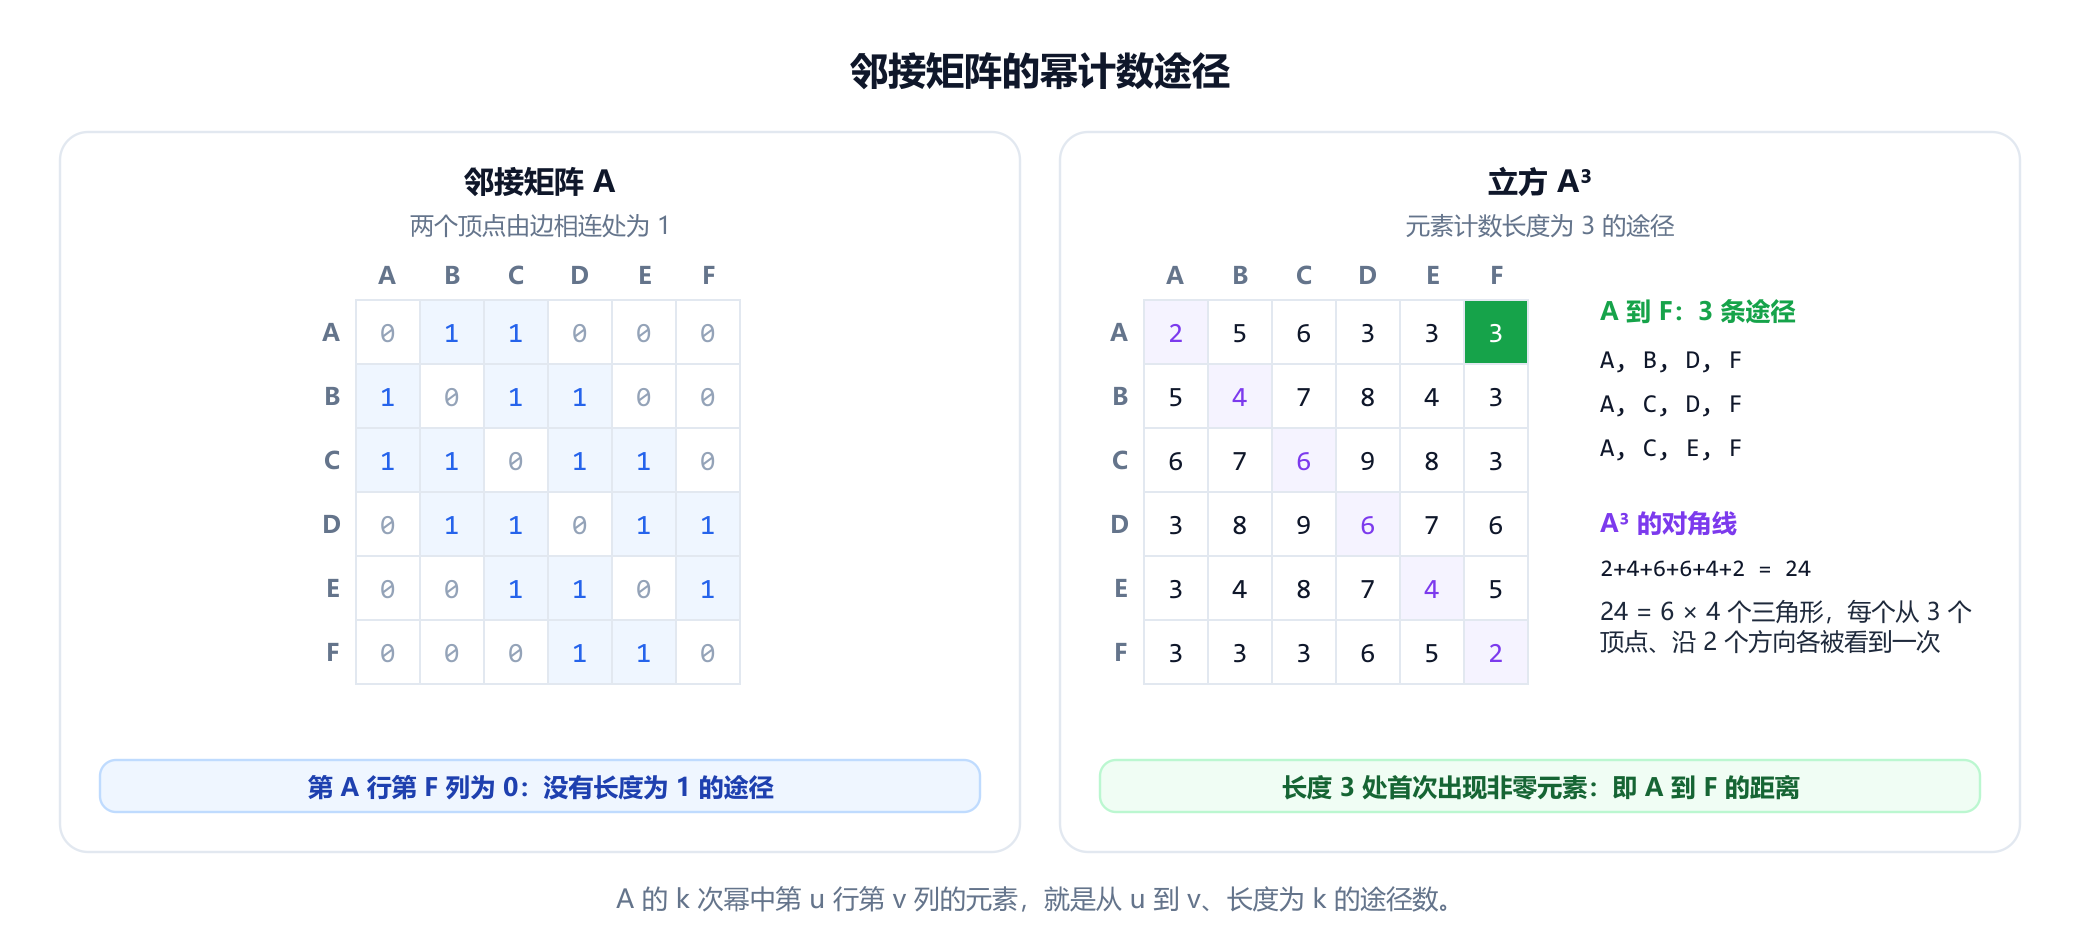
条带图同时展示了几个推论:
- 矩阵
A2的对角线就是度的列表。长度为 2 的闭途径沿一条边出去再回来,顶点处的每条边都对应一条这样的闭途径:2, 3, 4, 4, 3, 2,分别对应A到F。 A2[A][D] = 2,对应途径A, B, D和A, C, D。- 第一个出现非零元素的幂给出距离。
A1和A2在第A行、第F列的元素都是 0,而A3中的该元素是 3。所以从A到F的距离是 3,而这个长度的三条途径就是三条最短路径A, B, D, F、A, C, D, F和A, C, E, F。根据第 5 节,最短途径总是路径。 - 三角形来自
A3的对角线。简单图中长度为 3 的闭途径就是绕一个三角形走一圈。每个三角形从它的 3 个顶点中的每一个出发、沿 2 个方向中的每一个各被计数一次,所以三角形的个数等于对角线元素之和除以 6:这里是24 / 6 = 4,即三角形ABC、BCD、CDE和DEF。
def graph(edges):
    adj = {}
    for u, v in edges:
        adj.setdefault(u, set()).add(v)
        adj.setdefault(v, set()).add(u)
    return adj

def matmul(X, Y):
    return [[sum(x * y for x, y in zip(row, col)) for col in zip(*Y)] for row in X]

def walk_counts(adj, order, k):
    """邻接矩阵 k 次幂的元素 [i][j] 计数长度为 k 的途径。"""
    A = [[int(v in adj[u]) for v in order] for u in order]
    M = A
    for _ in range(k - 1):
        M = matmul(M, A)
    return M

strip = graph(['AB', 'AC', 'BC', 'BD', 'CD', 'CE', 'DE', 'DF', 'EF'])
order = 'ABCDEF'
for k in range(1, 7):
    M = walk_counts(strip, order, k)
    print(f'length {k}:  A to F {M[0][5]:3}   A back to A {M[0][0]:3}')
# length 1:  A to F   0   A back to A   0
# length 2:  A to F   0   A back to A   2
# length 3:  A to F   3   A back to A   2
# length 4:  A to F   6   A back to A  11
# length 5:  A to F  29   A back to A  24
# length 6:  A to F  78   A back to A  92
A3 = walk_counts(strip, order, 3)
print('triangles:', sum(A3[i][i] for i in range(len(order))) // 6)
# triangles: 4
从 A 到 F 的途径数随长度迅速增长,三步之内就从 3 增长到 78,但计算依然很便宜。两个 n 乘 n 矩阵的每次乘法大约需要 n3 次运算,而用反复平方法得到 Ak 大约只需 log2 k 次乘法,所以即使是长度为一百万的途径,也只需几十次矩阵乘积就能精确计数。 Ak 的对角线元素之和也等于矩阵各特征值的 k次幂之和,途径正是在这里与谱图论相遇:最大的特征值决定了长途径数目的增长速度。
7. 途径容易,路径困难
矩阵技巧对路径没有对应的方法。一般而言,两个顶点之间的路径数很难计算:Leslie Valiant 在 1979 年证明,计数两个给定顶点之间的路径是 #P 完全的,这是 NP 完全在计数问题上的对应物。目前不知道有比逐条尝试路线好得多的方法,人们也预计不存在这样的方法。下面的程序正是用这种搜索来计数路径,并以同样的方式、用边代替顶点来计数迹。
def graph(edges):
    adj = {}
    for u, v in edges:
        adj.setdefault(u, set()).add(v)
        adj.setdefault(v, set()).add(u)
    return adj

def count_paths(adj, s, t, seen=None):
    """从 s 到 t 的路径数:尝试每个未访问的邻居,然后撤销。"""
    if s == t:
        return 1
    seen = seen or {s}
    total = 0
    for w in adj[s] - seen:
        seen.add(w)
        total += count_paths(adj, w, t, seen)
        seen.remove(w)
    return total

def count_trails(adj, s, t, used=None):
    """从 s 到 t 的迹数。迹可以经过 t,之后再回到它。"""
    used = used or set()
    total = 1 if s == t else 0
    for w in adj[s]:
        e = frozenset((s, w))
        if e not in used:
            used.add(e)
            total += count_trails(adj, w, t, used)
            used.remove(e)
    return total

strip = graph(['AB', 'AC', 'BC', 'BD', 'CD', 'CE', 'DE', 'DF', 'EF'])
print(count_paths(strip, 'A', 'F'), count_trails(strip, 'A', 'F'))
# 13 23

def grid(n):
    """n 乘 n 的街道网格:顶点为 (行, 列),边连向右方和下方。"""
    return graph([((r, c), (r, c + 1)) for r in range(n) for c in range(n - 1)] +
                 [((r, c), (r + 1, c)) for r in range(n - 1) for c in range(n)])

for n in range(2, 6):
    print(n, count_paths(grid(n), (0, 0), (n - 1, n - 1)))
# 2 2
# 3 12
# 4 184
# 5 8512
在条带图上,搜索证实了第 2 节中的计数:从 A 到 F有 13 条路径和 23 条迹。网格则显示出这些数字膨胀得有多快。在每边有 2、3、4 和 5 个顶点的街道网格中,相对的两个角之间分别有 2、12、184 和 8,512 条路径,再多一行一列就有 1,262,816 条。物理学家和化学家把格点中的路径称为自回避游走,并用它们作为聚合物链的模型,即一种不能穿过自身的分子。
同样的差距也把关于单条路线的简单问题和困难问题分隔开来:
- 最短路径:容易。当边没有权重时,广度优先搜索可以在线性时间内找到一条;当权重非负时,Dijkstra 算法也可以,这要归功于第 5 节的捷径引理。
- 最长路径:困难。判定一个图是否有长度至少为给定值的路径是 NP 完全的。经过全部
n个顶点的路径长度为n - 1,所以这个问题把哈密顿路径问题作为特例包含在内。在条带图中,从A到F的最长路径长度为 5,经过全部六个顶点;之字形路线A, B, C, D, E, F就是其中一条。 - 最长途径:没有意义。途径可以重复边,所以任何有边的图都有任意长度的途径。
8. 迹、回路与 Euler
迹属于 Euler。他在 1736 年对柯尼斯堡七桥问题的解答,寻找的是恰好经过每座桥一次的途径,也就是经过多重图每条边的一条迹。这样的迹称为欧拉迹,闭合的则称为欧拉回路。Euler 的条件由 Carl Hierholzer 在一篇 1873 年发表的论文中完整证明,它是关于度的。一个连通图有欧拉回路,当且仅当每个顶点的度都是偶数;有一条非闭合的欧拉迹,当且仅当恰好有两个顶点的度是奇数,此时这条迹必须从其中一个出发,在另一个结束。
在条带图中, B 和 E 的度为 3,其余每个顶点的度都是偶数,所以有一条欧拉迹从 B 通向 E:
B, A, C, B, D, C, E, D, F, E 9 条边,每条使用一次它经过 B、 C、 D 和 E 各两次,这就是严格来说“欧拉路径”这个名称并不恰当的原因。关于欧拉路径与欧拉回路的指南详细介绍了 Hierholzer 算法。当一个图有两个以上的奇度顶点时,某些边必须走两次,而求经过每条边的代价最小的闭途径,就是中国邮递员问题。
第 5 节的 Veblen 定理是同一枚硬币的另一面。欧拉回路是经过每条边的回路,在重复的顶点处拆分它,就把边划分成没有公共边的若干个环。反过来,如果一个连通图的边可以划分成这样的环,那么它所有顶点的度都是偶数,而这些环可以在公共顶点处拼接成一条欧拉回路。
9. 环、围长与周长
条带图恰好有 10 个环:四个三角形,三个长度为 4 的环,两个长度为 5 的环和一个长度为 6 的环。
长度 3:  ABC, BCD, CDE, DEF
长度 4:  ABDC, BDEC, CDFE
长度 5:  ABDEC, BDFEC
长度 6: ABDFEC有两个数可以概括一个图的环。围长是最短环的长度,这里是 3;而周长是最长环的长度,这里是 6。经过每个顶点的环,例如 A, B, D, F, E, C, A,称为哈密顿环,所以条带图是哈密顿图。完全没有环的图是森林,连通的森林是树,树中任意两个顶点之间恰好有一条路径;关于树的指南发展了这一思想。关于图中的环的指南解释了如何用深度优先搜索检测环,以及一个图有多少个独立的环。
10. 有向途径与有向路径
在有向图中,每一步都必须顺着箭头的方向,从它的尾走到它的头。只要做这一处改动,全部六个定义就都能沿用:有向途径、有向迹、有向路径、闭有向途径、有向回路和有向环。有几件事表现得不一样:
- 长度为 2 的环是存在的。两个箭头
u → v和v → u是不同的边,所以u, v, u即使在没有平行边的图中也是一个有向环。 - 可达性是单向的。一条从
u到v的有向路径,并不说明存在一条返回的路径。在两个方向上都能互相到达的顶点构成一个强连通分量,关于强连通分量的指南说明了如何找出它们。 - 没有有向环意味着存在一种顺序。没有有向环的有向图,即 DAG,总可以排成一列,使每个箭头都指向前方。这样的排列就是拓扑排序,而在 DAG 中,甚至最长路径也能在线性时间内求出。
- 忽略箭头方向就得到半途径或半路径,它们可以逆着箭头走。如果一个有向图的顶点之间都由半路径相连,它就是弱连通的。
第 6 节的矩阵技巧对有向图同样适用,无需任何改动:第 u行、第 v 列的元素在 Ak 中的值,计数的是长度为 k、从 u 到 v的有向途径。
11. 每种路线的用途
六个词中的每一个都是某一类实际问题的恰当模型:
- 路径是任何不应绕圈的事物的路线:驾车路线、网络中传输的数据包、两个人之间的一连串引荐。根据捷径引理,每个最短路线问题都是路径问题。
- 迹与回路描述的是把每条街道、管道或电线恰好经过一次的覆盖:扫雪车、街道清扫车和邮递路线。当某些边必须重复时,问题就变成第 8 节的中国邮递员问题。
- 途径出现在一切有随机运动的地方。随机游走在每一步都移动到一个随机的邻居。George Pólya 在 1921 年证明,整数点网格上的随机游走在一维或二维中必定会回到起点,但在三维中则不然。Sergey Brin 和 Lawrence Page 在 1998 年描述的 Google 最初的 PageRank,按照一个沿链接随机浏览的用户访问网页的频率来为网页排名,而 DeepWalk 等图嵌入方法则从许多短的随机游走中学习。
- 环通常是要寻找或禁止的东西:死锁是一个由进程组成的环,其中每个进程都在等待下一个;循环导入或引用自身的电子表格公式是一个依赖关系的环;而 Kirchhoff 电压定律指出,电路网络中沿每个环的电压之和为零。
- 闭途径计数结构:矩阵
A3的对角线计数三角形,社交网络分析用它来衡量一个人的朋友彼此认识的频率。
12. 常见错误
| 错误 | 为什么错 | 修正 |
|---|---|---|
| 把任何路线都叫作“路径” | 在大多数图论教材中,路径不重复任何顶点;有些计算机科学教材则用“路径”指任何途径 | 说明你所用的定义,或者直接说出性质 |
| “欧拉路径是一条路径” | 它使用每条边一次,并且通常会重访顶点,所以它是一条迹 | 在需要精确时说“欧拉迹” |
| 把回路和环当作同一回事 | A, B, C, D, E, C, A 是一个回路,但它经过 C 两次 | 环不重复任何顶点;回路只是不重复边 |
把 A, B, A 称为环 | 它两次使用同一条边 | 在简单图中,环的长度至少为 3 |
| “每条闭途径都包含一个环” | A, B, A 是闭合的,却不包含任何环 | 只有长度为奇数的闭途径才保证包含环 |
| 按顶点数来计算长度 | A, C, D, F 有 4 个顶点,但长度为 3 | 长度计的是步数,也就是边数 |
把 Ak 当作路径的计数 | A5[A][F] = 29,但只有 4 条长度为 5 的路径从 A 通向 F | 矩阵的幂计数的是途径;路径需要搜索 |
| 对每个环的每种写法都计数一次 | 长度为 k 的环有 2k 个序列 | 除以 2k,或者固定起点和方向 |
13. 术语表
| 术语 | 含义 |
|---|---|
| 途径 | 一个顶点序列,每个顶点都由一条边与下一个相连;任何东西都可以重复 |
| 长度 | 途径的步数,重复的边每次都计入 |
| 迹 | 没有重复边的途径 |
| 路径 | 没有重复顶点的途径 |
| 闭途径 | 在起始顶点结束的途径 |
| 回路 | 闭迹:回到起点,没有重复边 |
| 环 | 长度至少为 3 的闭途径,除起点外没有重复顶点 |
| 平凡途径 | 单独一个顶点:长度为 0 的途径,也是长度为 0 的路径 |
| 距离 | 两个顶点之间最短路径的长度 |
| 围长 | 最短环的长度 |
| 周长 | 最长环的长度 |
| 欧拉迹 | 恰好使用每条边一次的迹 |
| 哈密顿路径 | 恰好经过每个顶点一次的路径 |
| 随机游走 | 每一步都移动到一个随机选择的邻居的途径 |
| 自回避游走 | 物理学家对格点中路径的称呼 |
14. 常见问题
途径、迹和路径有什么区别?
途径是由边相连的任意顶点序列,它可以重复顶点,也可以重复边。迹是从不两次使用同一条边的途径,尽管它可以重访顶点。路径是从不两次经过同一个顶点的途径,因此它也不重复边。每条路径都是迹,每条迹都是途径。
回路和环有什么区别?
两者都是闭合的:它们在出发的顶点结束。回路是闭迹,所以它从不重复边,但可以不止一次地经过同一个顶点。环除了回到起点之外完全不重复顶点,在简单图中它的长度至少为 3。每个环都是回路,但两次经过同一个顶点的“8”字形路线是回路而不是环。有些书把这两个词当作同义词使用,所以请确认所用的定义。
欧拉路径真的是路径吗?
严格意义上不是。欧拉路径恰好使用图的每条边一次,而且通常会多次经过某些顶点,所以它是迹而不是路径。这就是许多作者更喜欢“欧拉迹”这一名称的原因。哈密顿路径恰好经过每个顶点一次,它才是路径。
为什么各教科书对路径的定义不同?
图论的术语从未完全统一。自 20 世纪 60 年代以来的大多数图论书籍,例如 Harary、West、Bondy 和 Murty 以及 Diestel 的书,用 walk(途径)指可以重复任何东西的路线,用 path(路径)指不重复顶点的路线。Rosen 的 Discrete Mathematics and Its Applications 用 path 指任何途径,用 simple path 指没有重复边的路线。请务必查看书籍或论文开头给出的定义。
如何计算两个顶点之间长度为 k 的途径数?
把邻接矩阵 A 自乘到 k 次幂。A 的 k 次幂中第 u 行第 v 列的元素,就是从 u 到 v、长度为 k 的途径数。A 的平方的对角线列出了各顶点的度,而 A 的立方的对角线元素之和除以 6 就是三角形的个数。对于路径计数,目前不知道有这样的捷径,Valiant 在 1979 年证明了这个问题是 #P 完全的。
单个顶点是路径吗?
是的。单个顶点是一条长度为 0 的途径,由于没有任何东西重复,它也是一条长度为 0 的路径,称为平凡路径。它不是环,因为简单图中的环至少需要 3 条边。
15. 参考文献
以上定义、定理和归属均出自以下文献,按时间顺序排列。
- Euler, L. (1741). "Solutio problematis ad geometriam situs pertinentis." Commentarii Academiae Scientiarum Petropolitanae 8,128 至 140 页。1736 年提交。
- Hierholzer, C. (1873). "Ueber die Möglichkeit, einen Linienzug ohne Wiederholung und ohne Unterbrechung zu umfahren." Mathematische Annalen 6,30 至 32 页。
- Veblen, O. (1912). "An Application of Modular Equations in Analysis Situs." Annals of Mathematics,第 2 辑,14,86 至 94 页。
- Kőnig, D. (1916). "Über Graphen und ihre Anwendung auf Determinantentheorie und Mengenlehre." Mathematische Annalen 77,453 至 465 页。
- Pólya, G. (1921). "Über eine Aufgabe der Wahrscheinlichkeitsrechnung betreffend die Irrfahrt im Straßennetz." Mathematische Annalen 84,149 至 160 页。
- Berge, C. (1958). Théorie des graphes et ses applications. 巴黎:Dunod。
- Ore, O. (1962). Theory of Graphs. American Mathematical Society Colloquium Publications 38。罗得岛州普罗维登斯:American Mathematical Society。
- Harary, F. (1969). Graph Theory. 马萨诸塞州雷丁:Addison-Wesley。
- Garey, M. R. 和 Johnson, D. S. (1979). Computers and Intractability: A Guide to the Theory of NP-Completeness. 旧金山:W. H. Freeman。
- Valiant, L. G. (1979). "The Complexity of Enumeration and Reliability Problems." SIAM Journal on Computing 8(3),410 至 421 页。
- Biggs, N. (1993). Algebraic Graph Theory,第 2 版。剑桥:Cambridge University Press。
- Brin, S. 和 Page, L. (1998). "The Anatomy of a Large-Scale Hypertextual Web Search Engine." Computer Networks and ISDN Systems 30(1 至 7),107 至 117 页。
- West, D. B. (2001). Introduction to Graph Theory,第 2 版。新泽西州上萨德尔河:Prentice Hall。
- Bondy, J. A. 和 Murty, U. S. R. (2008). Graph Theory. Graduate Texts in Mathematics 244。伦敦:Springer。
- Chartrand, G. 和 Zhang, P. (2012). A First Course in Graph Theory. 纽约州米尼奥拉:Dover。
- Rosen, K. H. (2012). Discrete Mathematics and Its Applications,第 7 版。纽约:McGraw-Hill。
- Perozzi, B., Al-Rfou, R. 和 Skiena, S. (2014). "DeepWalk: Online Learning of Social Representations." Proceedings of the 20th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining,701 至 710 页。
- Diestel, R. (2017). Graph Theory,第 5 版。Graduate Texts in Mathematics 173。柏林:Springer。