目录
1. 途径、迹、路径与环
一个环是图中一条回到起点、途中不重复使用任何东西的路线。这听起来很简单,但“路线”可以指四种不同的东西,而关于环的大多数混淆都来自把它们弄混。它们的区别只在于什么可以重复。
- 一条途径是一个顶点序列,其中每对相邻顶点都由一条边相连。顶点和边都可以重复。它的长度是它所用边的条数,重复的边按重复次数计算。
- 一条迹是一条从不两次使用同一条边的途径。顶点仍然可以重复。
- 一条路径是一条从不两次经过同一个顶点的途径,因此它也不可能重复边。
- 终点与起点相同的途径称为闭合的途径。闭合的迹也称为回路,而环则是长度为正、且唯一重复的顶点就是其起点兼终点的闭合迹。
各教科书对这些词的用法并不统一。有的把这里所说的途径称为“路径”,有的把这里所说的环称为“回路”。即使名称不统一,概念本身是稳定的,所以在阅读一条定理时,请先确认它指的是哪一个。在简单图中,一个环至少需要三个顶点。在多重图中,一个自环是长度为 1 的环,两条平行边构成长度为 2 的环。
有一个无向图贯穿本文的大部分内容。它有八个顶点和十条边:三角形 A, B, C 位于上方,两个正方形 B, C, E, D 和 D, E, G, F 叠放在它下面,此外还有一个顶点 H 悬挂于 G。
V = {A, B, C, D, E, F, G, H}                          8 个顶点
E = {AB, BC, CA, BD, CE, DE, DF, EG, FG, GH}          10 条边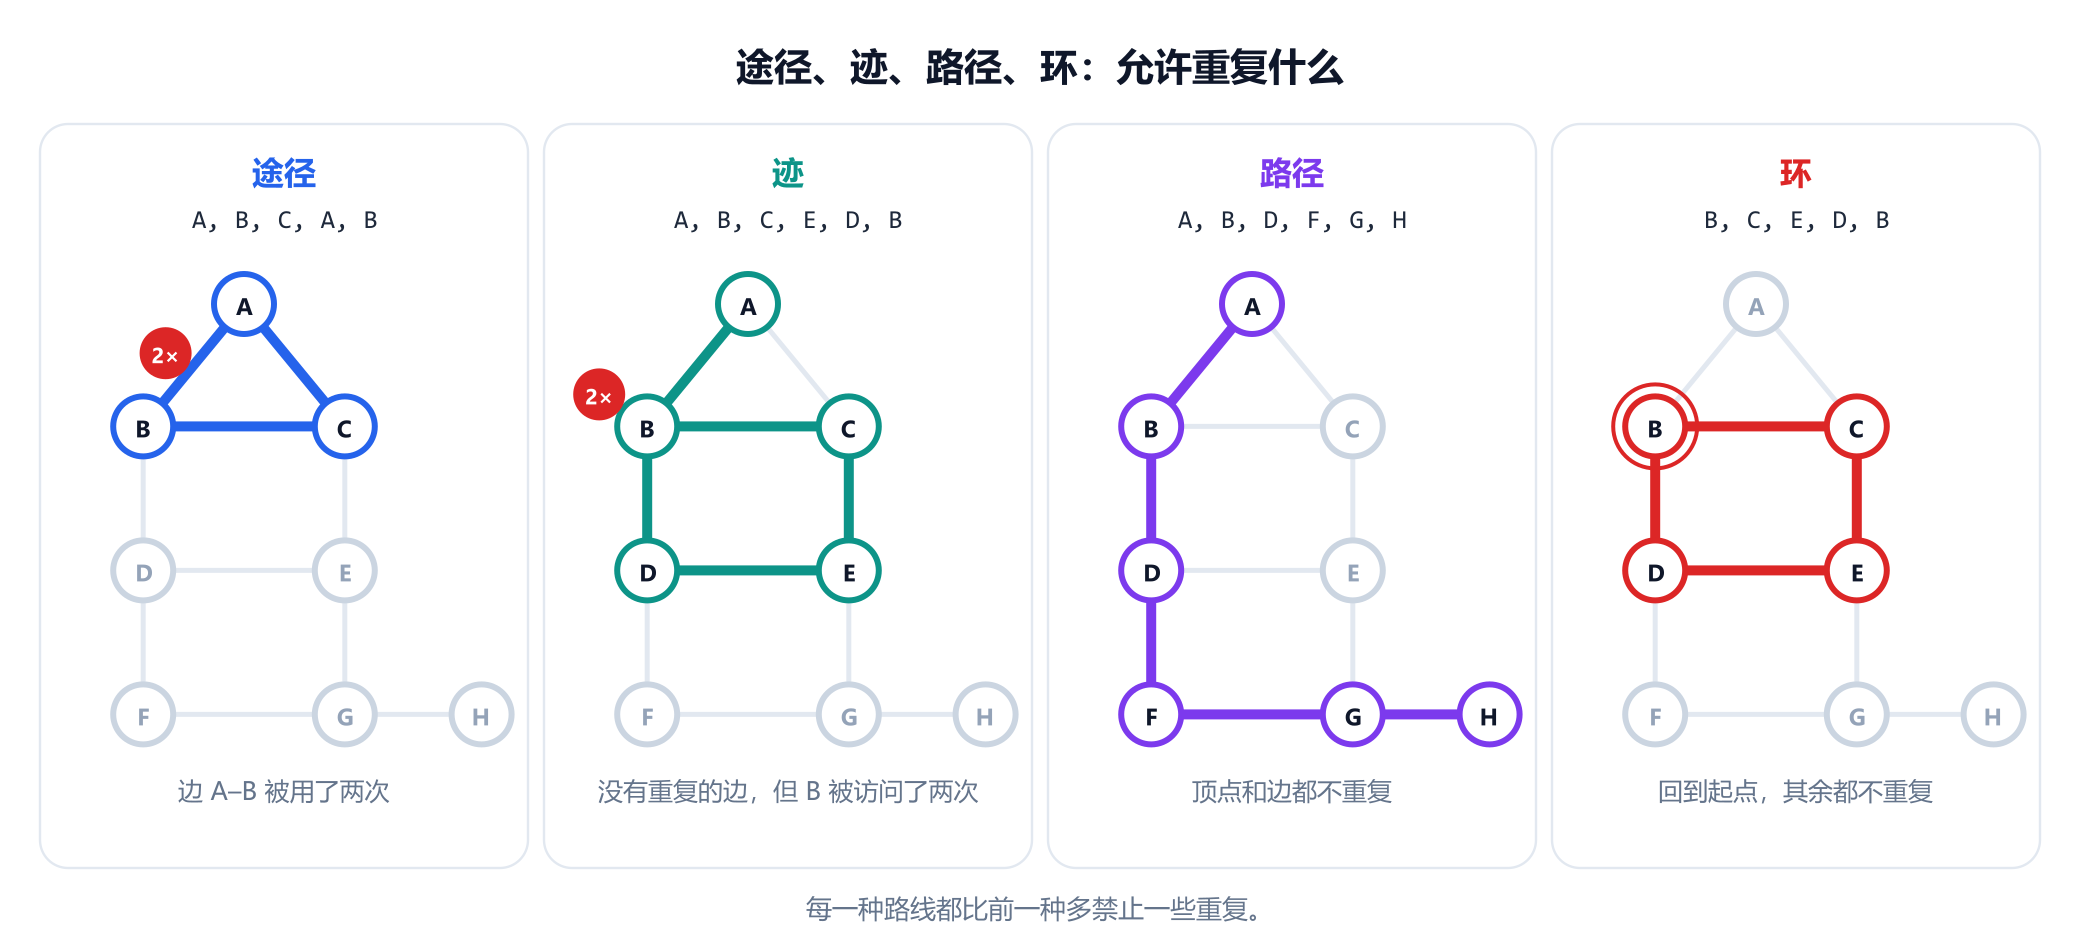
关于闭途径,有两个事实会被反复用到。第一,闭途径不一定包含环: A, B, A 是闭合的,但它只是沿一条边出去,再沿同一条边回来。第二,长度为正的闭迹一定包含环。如果它在中途重复了某个顶点,就在那里把它切成两条更短的闭迹,并对其中任意一条重复这一论证;这个过程最终停在一条没有重复顶点的闭迹上,它就是一个环。第 8 节需要同一论证的一个变体,用于长度为奇数的途径。
2. 围长、周长与无环图
图的围长是其最短环的长度,而周长是其最长环的长度。示例图共有六个环,长度分别为 3、4、4、5、6 和 7,所以它的围长是 3,周长是 7。最长的环 A, B, D, F, G, E, C经过除 H以外的每个顶点,而 H 只有一条边,因此根本不可能位于任何环上。
| 图 | 围长 | 原因 |
|---|---|---|
完全图 Kn, n ≥ 3 | 3 | 任意三个顶点构成一个三角形 |
完全二分图 Km,n, m, n ≥ 2 | 4 | 每个环都在两侧之间交替,因此长度为偶数 |
| Petersen 图 | 5 | 十个顶点,度均为 3,既没有三角形,也没有正方形 |
| 树或森林 | 无 | 根本没有环;围长通常被视为无穷大 |
没有环的图称为无环的。无环的无向图是森林,连通的森林是树。一个有 n 个顶点、 k 个连通分量的森林恰好有 n − k 条边,因此数边就给出了最快的环测试:
一个有n个顶点、m条边和k个连通分量的图含有环,当且仅当m > n − k。特别地,边数不少于顶点数的图一定有环。
示例图满足 10 > 8 − 1,所以在任何人去找之前,它就一定含有环。度条件也同样可行:如果每个顶点的度都至少为 2,图就有环,而且事实上存在长度至少为 δ + 1的环,其中 δ 是最小度。证明是经典的。取一条最长路径 v0, v1, …, vℓ。端点 v0 的每个邻居都位于这条路径上,否则这条路径还可以再延长。 v0 在路径上至少有 δ 个邻居,所以其中最远的一个至少是 vδ,连回它的那条边就闭合了一个长度至少为 δ + 1的环,这一观察见于 Dirac 1952 年的论文。这一结论已在所有至多六个顶点的图上用穷举法检验过。
在有向图中,环必须顺着箭头方向走,无环的有向图称为 DAG(有向无环图)。DAG 恰好是这样一类有向图:可以把它的顶点排成一行,使每个箭头都指向前方,这正是拓扑排序所给出的结果。注意,DAG 可以有很多边:上面的数边测试只适用于无向图。
求围长比找出某一个环更难。从每个顶点出发做一次广度优先搜索,并检查遇到的每条非树边,可以在 O(nm) 时间内求出围长。Itai 和 Rodeh 1978 年关于最小回路的论文给出了这个界,同时给出了一种更快的方法,用于找出一个至多比最短环长一条边的环。
3. 在无向图中检测环
如果只需要回答是或否,数边就能解决:求出连通分量,然后比较 m 与 n − k。但通常你想要的更多,即一个可以展示给别人看的实际的环。环是一种证书:任何人都能逐条边检查它,它证明了答案,而无须别人信任你的程序。深度优先搜索几乎可以免费地给出这样一个环。
关键事实是,对无向图做深度优先搜索时,每条边都会被归入两类之一。树边通向一个第一次见到的顶点。回边通向一个已在当前下行路径上的顶点,即当前顶点的祖先。没有其他种类,所以图有环当且仅当搜索遇到回边,而环就是这条回边加上它所跨越的那段树路径。
def find_cycle_undirected(vertices, edges):
    """按顺序返回一个环的顶点;若图是森林,则返回 None。"""
    adj = {v: [] for v in vertices}
    for i, (u, v) in enumerate(edges):
        adj[u].append((v, i))
        adj[v].append((u, i))
    parent = {}                                   # 顶点 -> (父顶点, 边编号)
    for root in vertices:                         # 每个连通分量搜索一次
        if root in parent:
            continue
        parent[root] = (None, None)
        stack = [(root, iter(adj[root]))]
        while stack:
            u, it = stack[-1]
            for v, i in it:
                if i == parent[u][1]:             # 这是来时经过的边,不是环
                    continue
                if v in parent:                   # 回边 u-v:从 u 向上走到 v
                    cycle = [u]
                    while cycle[-1] != v:
                        cycle.append(parent[cycle[-1]][0])
                    return cycle[::-1]
                parent[v] = (u, i)
                stack.append((v, iter(adj[v])))
                break
            else:
                stack.pop()
    return None

V = 'ABCDEFGH'
E = ['AB', 'BC', 'CA', 'BD', 'CE', 'DE', 'DF', 'EG', 'FG', 'GH']
print(find_cycle_undirected(V, E))
# ['A', 'B', 'C']
print(find_cycle_undirected(V, ['AB', 'BC', 'CE', 'DE', 'DF', 'FG', 'GH']))
# None
print(find_cycle_undirected('xy', ['xy', 'xy']))
# ['x', 'y']有三个细节使这段代码真正正确,而不只是差不多正确。搜索会记住来时经过的那条边并且只跳过这一条边;如果不跳过,每条边看起来都会是一个长度为 2 的环:出去后立刻原路返回。按边的身份跳过,而不是按“作为我父节点的那个邻居”跳过,能让代码在多重图上依然正确,因为在多重图中,重边确实是一个长度为 2 的环,正如第三次调用所示。外层循环为每个连通分量各启动一次搜索,因为环可能位于其中任何一个。此外,栈是显式的,所以长路径不会超出 Python 的递归上限。
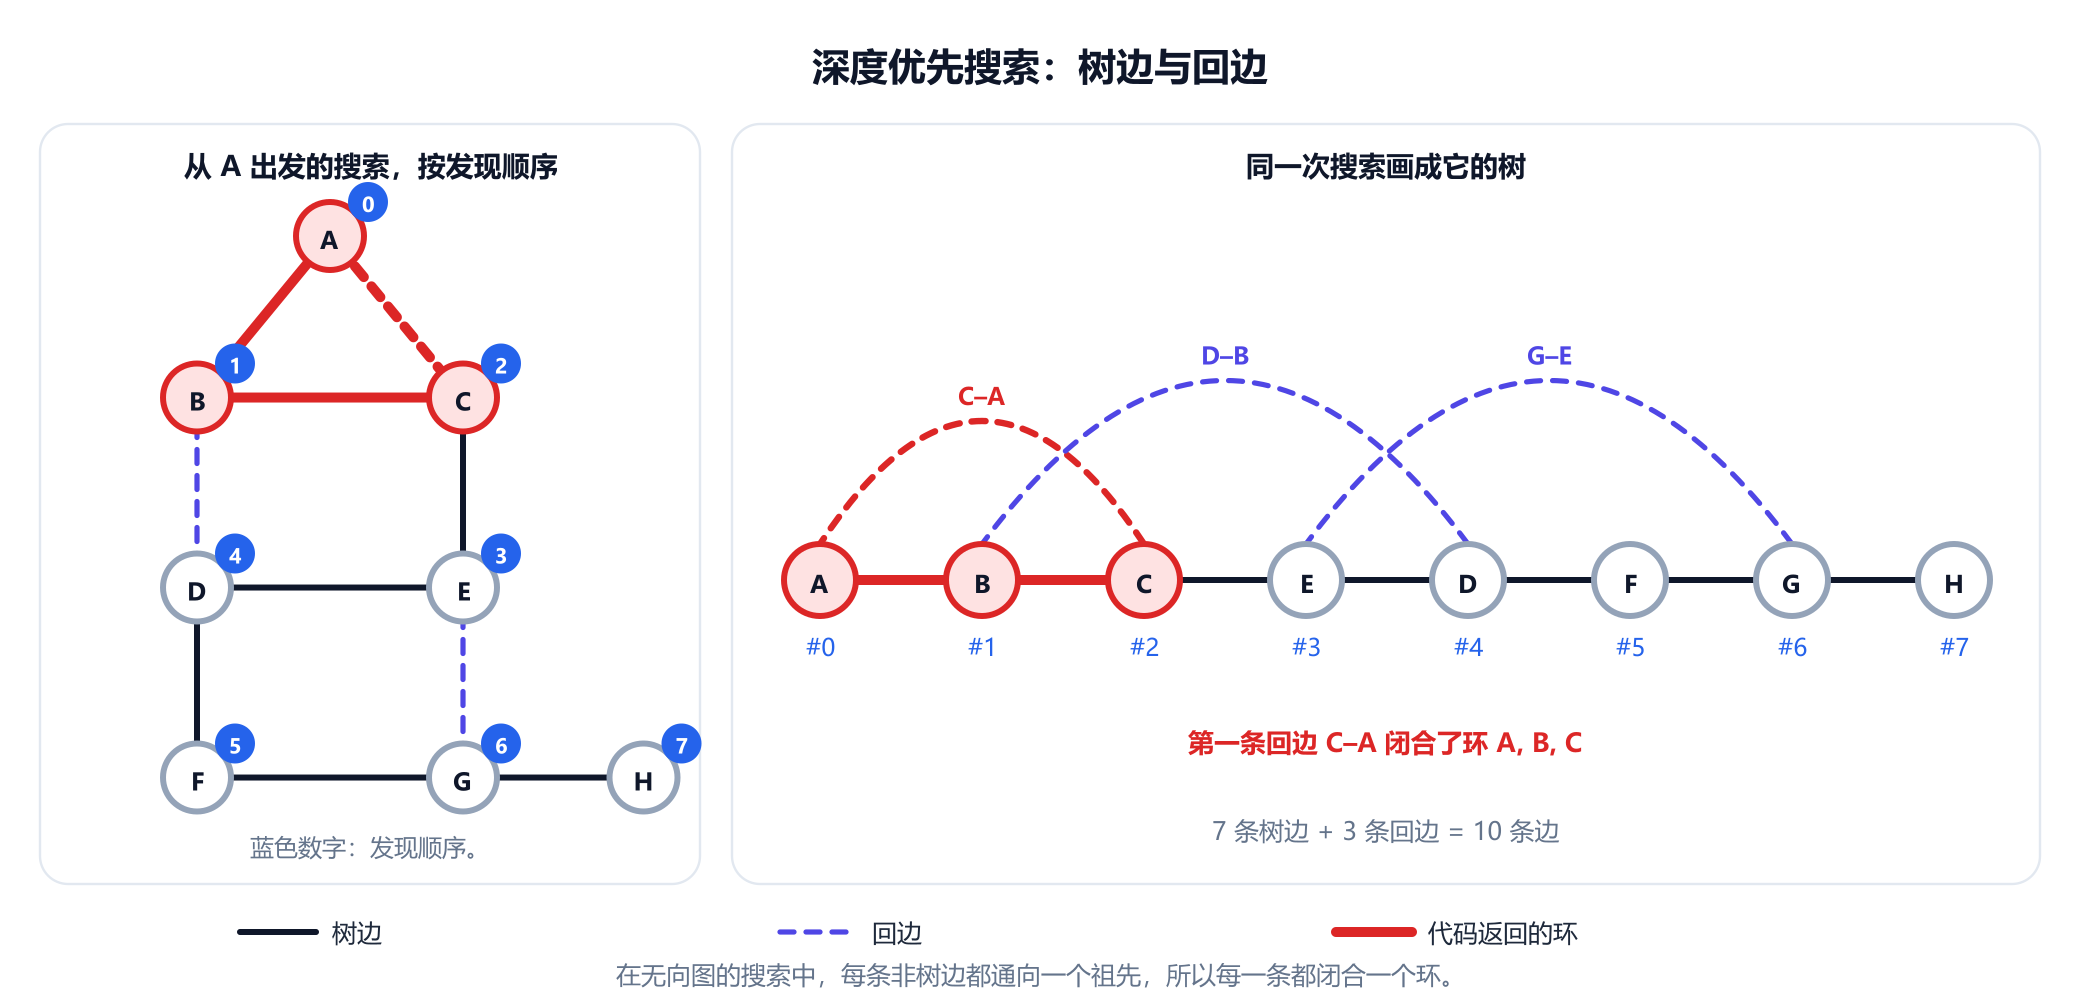
按字母顺序取邻居时,从 A 出发的搜索沿 A, B, C 向下走,并在 C 处发现一条回到 A的边。 A 已被访问过,而这条边又不是搜索来时经过的那条,所以代码从 C 沿父指针向上爬到 A 并返回这个三角形。如果继续下去,搜索会接着走 E, D, F, G, H,这是一条经过全部八个顶点的路径,并且还会找到两条回边 D–B 和 G–E。七条树边加上三条回边,恰好覆盖全部十条边。
运行时间方面还有一个令人愉快的额外收获。在遇到第一条回边之前,搜索读取的每个邻接项要么是树边,至多 n − 1 条;要么是回到父节点的边,同样至多 n − 1 条。因此,无论图有多少条边,搜索本身在找到环或结束之前最多读取 2n − 1 个邻接项。这个上界已在 4,000 个随机图上通过计数检验过。读取输入以构建邻接表仍然需要 O(V + E)的时间,但搜索本身不需要。
4. 并查集:逐条边检测环
有时边是逐条到来的,问题是哪条边最先形成环。并查集结构无须任何搜索就能回答这个问题。它把顶点分成若干组,每组对应目前已建成的一个连通分量。连接两个不同组的边会把它们合并。如果一条边的两个端点已经在同一组中,它连接的是两个原本就连通的顶点,于是它与两者之间已有的路径一起闭合成一个环。
def first_cycle_edge(vertices, edges):
    """逐条加入边;返回第一条闭合环的边,若没有则返回 None。"""
    root = {v: v for v in vertices}
    def find(x):
        while root[x] != x:
            root[x] = root[root[x]]               # 路径减半
            x = root[x]
        return x
    for u, v in edges:
        ru, rv = find(u), find(v)
        if ru == rv:                              # u 和 v 原本就已连通
            return u + v
        root[ru] = rv
    return None

print(first_cycle_edge('ABCDEFGH', ['AB', 'BD', 'DF', 'FG', 'GH', 'BC', 'CE', 'EG', 'DE', 'CA']))
# EG
按这个顺序,前五条边构成路径 A, B, D, F, G, H,接着 B–C 和 C–E 又在上面挂了两个顶点。当 E–G 到来时, E 和 G 已经有相同的根,它闭合的环是 B, C, E, G, F, D,长六条边。这正是 Kruskal 算法在把每条边加入最小生成树之前所做的检验。
并查集告诉你哪条边闭合了环,但不告诉你环在哪里。要给出环,你仍需要在目前已建成的森林中找到这两个端点之间的路径,在已接受的边上做一次简短的搜索即可。而且并查集只适用于无向图。在带有箭头 A→B、 B→C 和 A→C的有向图中,第三个箭头连接的两个顶点已在同一组中,但并不存在有向环:顺着箭头走永远回不到 A。
5. 有向图:三种颜色
在有向图中,无向图的测试会给出错误答案。设有六个任务,依赖关系如下:
A → B A → C B → D C → D C → E E → F深度优先搜索从 A 出发,到达 D 时经过的是 B。之后在探索 C时,它遇到箭头 C→D 并发现 D 已被访问过。简单的“已访问”检查会把这判定为环,但其实并没有环: A→B→D 和 A→C→D 是到达同一个地方的两条路线,而不是一条回到起点的路线。在 6,000 个随机有向图上,简单检查在 1,320 个本来无环的图中报告了环。
解决办法是不仅记住一个顶点是否被访问过,还要记住对它的搜索是否仍在进行中。每个顶点被赋予三种颜色之一:
- 白色:尚未到达。
- 灰色:已到达,但对它的搜索尚未结束。灰色顶点恰好构成从根到当前正在探索的顶点的当前路径。
- 黑色:已结束。从它可达的一切都已探索完毕,且在那里没有发现环。
有向的深度优先搜索把边分为四类:指向白色顶点的树边,指向灰色祖先的回边,指向黑色后代的前向边,以及指向另一分支中或更早一次搜索中的黑色顶点的横叉边。只有回边会闭合环,因为只有灰色顶点保证能到达当前顶点。由此得到经典定理:一个有向图有环,当且仅当深度优先搜索找到一条回边,这等同于找到一个指向灰色顶点的箭头。灰色路径本身就是证书。
WHITE, GRAY, BLACK = 0, 1, 2

def find_cycle_directed(graph):
    """以顶点列表的形式返回一个有向环;若图是 DAG,则返回 None。"""
    color = {v: WHITE for v in graph}
    for root in graph:
        if color[root] != WHITE:
            continue
        color[root] = GRAY
        path = [root]                             # 灰色顶点,按顺序排列
        stack = [iter(graph[root])]
        while stack:
            for v in stack[-1]:
                if color[v] == GRAY:              # 回边:v 在当前路径上
                    return path[path.index(v):]
                if color[v] == WHITE:
                    color[v] = GRAY
                    path.append(v)
                    stack.append(iter(graph[v]))
                    break
            else:                                 # 所有出边都已处理:结束该顶点
                color[path.pop()] = BLACK
                stack.pop()
    return None

dag = {'A': ['B', 'C'], 'B': ['D'], 'C': ['D', 'E'], 'D': [], 'E': ['F'], 'F': []}
print(find_cycle_directed(dag))
# None
dag['F'].append('C')                              # 再加一条边:F -> C
print(find_cycle_directed(dag))
# ['C', 'E', 'F']
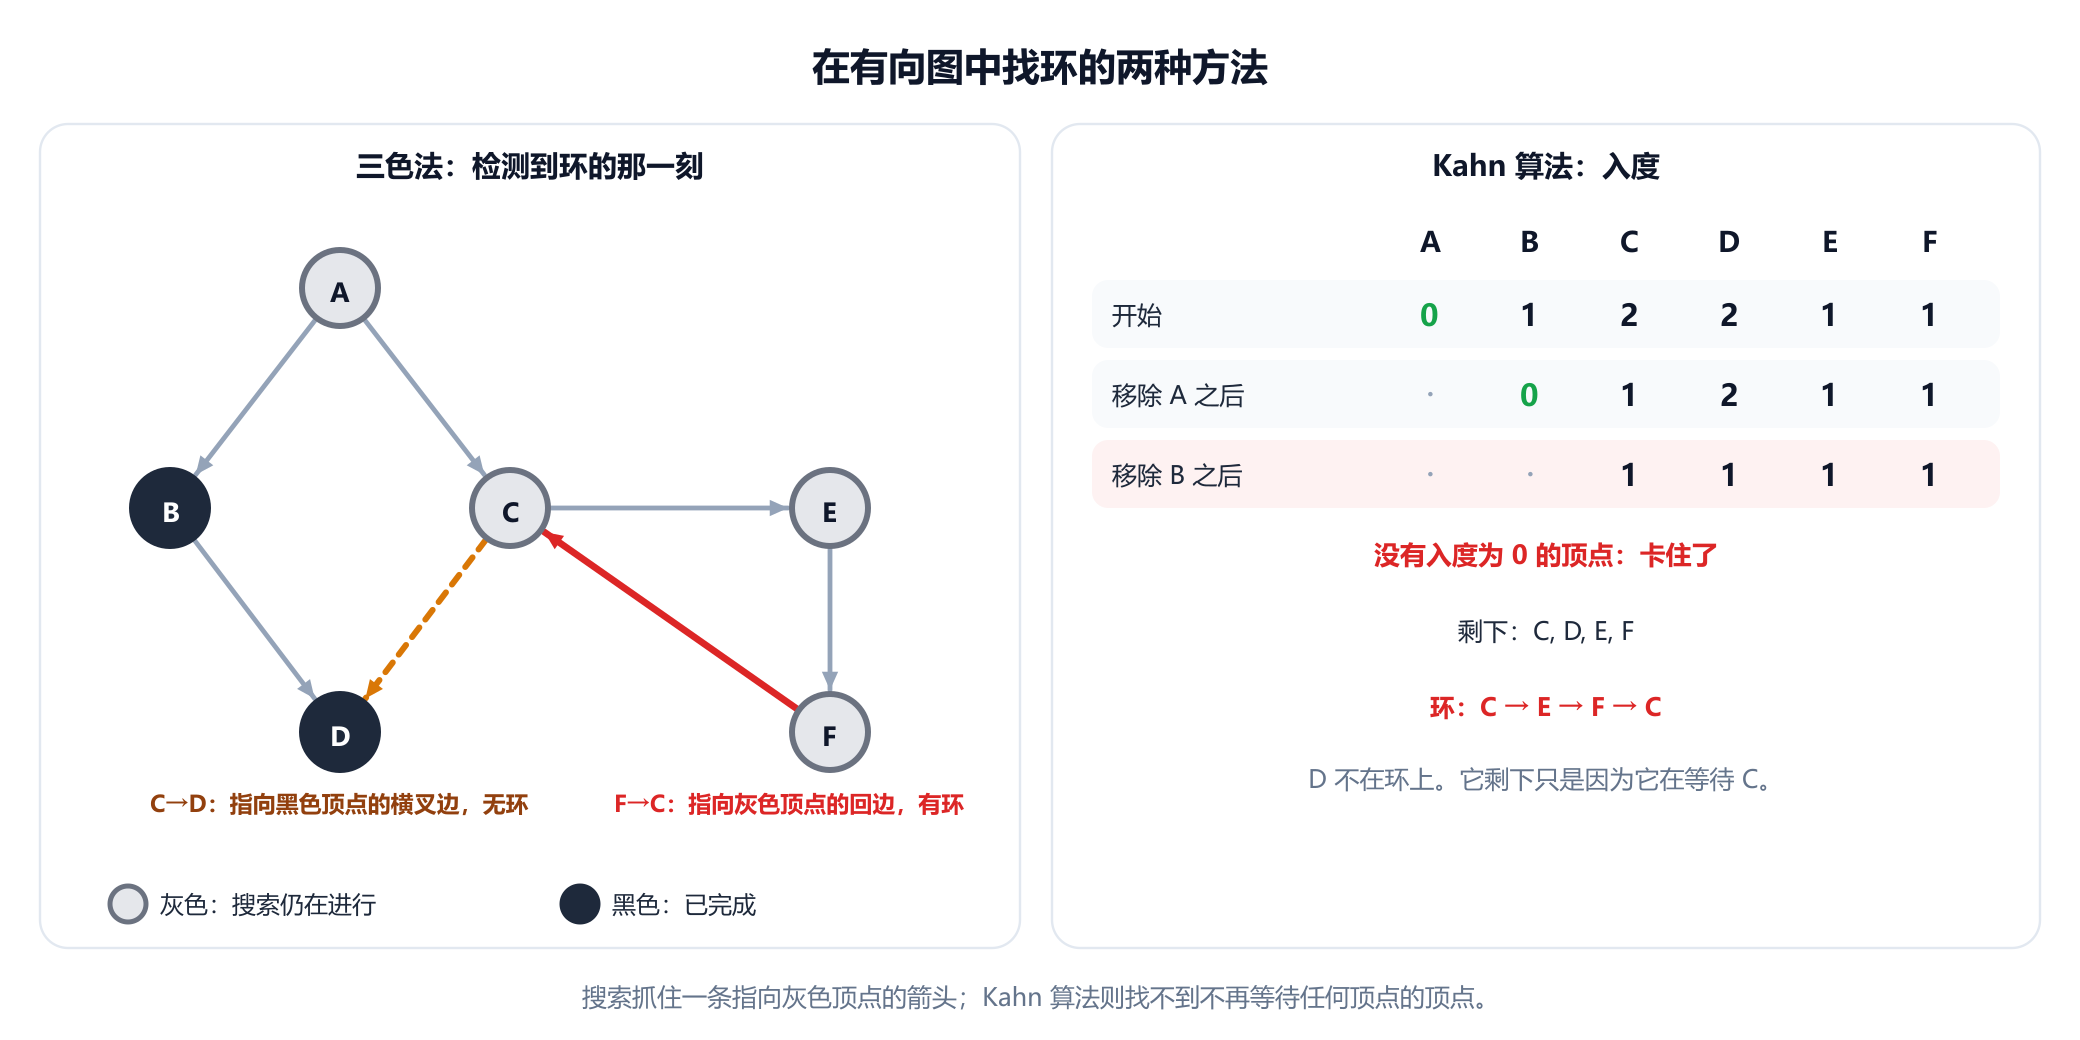
在这六个任务上, D 在 C 被探索之前就变成了黑色,所以 C→D 是一条横叉边,会被正确地忽略。再加一个箭头 F→C,情况就变了:搜索依次经过 C, E, F,它们全是灰色,而新的箭头指回 C,后者仍然是灰色。从 C 到 F 的灰色路径被作为环返回。自环 v→v 也能被处理: v 在读到它自己的箭头时是灰色的,返回的环就是 [v]。
6. Kahn 算法:卡住的拓扑排序揭示环
第二种标准方法既不需要递归,也不需要颜色。入度为 0 的顶点不依赖任何东西,因此可以安全地排在最前面。Kahn 算法发表于 1962 年,它反复移除这样的顶点,并降低其后继顶点的入度。如果所有顶点都被移除,移除顺序就是一个拓扑序,图是 DAG。如果过程提前停止,图就有环。
from collections import deque

def kahn(graph):
    """若图是 DAG,返回拓扑序;否则返回 (None, 一个环)。"""
    indeg = {v: 0 for v in graph}
    for u in graph:
        for v in graph[u]:
            indeg[v] += 1
    ready = deque(v for v in graph if indeg[v] == 0)
    order = []
    while ready:
        u = ready.popleft()
        order.append(u)
        for v in graph[u]:
            indeg[v] -= 1
            if indeg[v] == 0:
                ready.append(v)
    if len(order) == len(graph):
        return order, None
    left = {v for v in graph if indeg[v] > 0}     # 其中每个顶点在 left 中都有前驱
    pred = {v: u for u in left for v in graph[u] if v in left}
    v, seen = next(iter(sorted(left))), []
    while v not in seen:                          # 反向行走,直到有顶点重复
        seen.append(v)
        v = pred[v]
    return None, seen[seen.index(v):][::-1]

graph = {'A': ['B', 'C'], 'B': ['D'], 'C': ['D', 'E'], 'D': [], 'E': ['F'], 'F': ['C']}
print(kahn(graph))
# (None, ['E', 'F', 'C'])
graph['F'] = []
print(kahn(graph))
# (['A', 'B', 'C', 'D', 'E', 'F'], None)
为什么卡住就证明有环?每个剩下的顶点仍然至少有一个指向它的箭头,而这个箭头来自一个剩下的顶点,因为每个已移除的顶点都已经从计数中减去了它的箭头。所以从任何一个剩下的顶点出发,都可以沿箭头反向走到一个剩下的顶点,并且可以一直走下去。由于顶点个数有限,这条反向途径必定会重复某个顶点,而两次访问之间的那一段就是一个环。代码正是走了这样一条途径,并报告 E, F, C,这与之前是同一个环,只是从另一个起点读起。
有一个细节很容易出错。在示例上,Kahn 算法移除 A 和 B后便停滞不前, C、 D、 E 和 F 仍然留在原处。 D 不在任何环上;它被卡住只是因为它在等待 C。剩下的顶点是各个环加上它们下游的所有顶点,所以把剩下的集合报告为“环”是一个错误。去掉箭头 F→C 后,同样的代码会返回顺序 A, B, C, D, E, F,这是该 DAG 的九个合法顺序之一。
两种方法都在 O(V + E) 时间内运行。深度优先版本直接给你一个环,而 Kahn 版本只要拓扑序存在就会给你一个,这通常正是调度器或构建工具最初想要的。
7. 有多少个环?环空间
逐个数环很快就会失控。完全图 K4 有 7 个环, K5 有 37 个, K6 有 197 个,而 K10 有 556,014 个。把它们全部列出是可行的:Johnson 1975 年的算法能对有向图在 O((n + e)(c + 1)) 时间内完成,其中 c 为环的个数;但仅仅是输出,规模就可能是图大小的指数级。
有一种好得多的计数方式。把环看作边的集合,并用对称差来组合两个边集:保留恰好属于其中一个集合的边。在这一运算下,每个顶点度数都为偶数的子图构成二元域上的一个向量空间,称为环空间。每个环都在其中,它的维数是
图的圈数,或称环秩: m − n + k。
构造一组基很容易。任取一个生成森林,它有 n − k 条边。其余的 m − n + k 条边中,每一条都与森林恰好闭合成一个环,即它的基本环;这些环彼此独立,因为每个环都含有一条其他环都不含的边。这一思想可以追溯到 Kirchhoff,他在 1847 年用它来计算电网络中独立回路方程的个数;“圈数”这个名称是后来才有的。深度优先搜索可以直接给出这组基:修改找环程序,让它记录每一条回边,而不是在第一条处停下。
def cycle_basis(vertices, edges):
    """DFS 森林的每条非树边对应一个环:共 m - n + k 个环。"""
    adj = {v: [] for v in vertices}
    for i, (u, v) in enumerate(edges):
        adj[u].append((v, i))
        adj[v].append((u, i))
    parent, used, basis = {}, set(), []
    for root in vertices:
        if root in parent:
            continue
        parent[root] = None
        stack = [(root, iter(adj[root]))]
        while stack:
            u, it = stack[-1]
            for v, i in it:
                if i in used:                     # 树边,或已计入的回边
                    continue
                used.add(i)
                if v in parent:                   # 回边:记录它的环,继续搜索
                    cycle = [u]
                    while cycle[-1] != v:
                        cycle.append(parent[cycle[-1]])
                    basis.append(cycle[::-1])
                    continue
                parent[v] = u
                stack.append((v, iter(adj[v])))
                break
            else:
                stack.pop()
    return basis

V = 'ABCDEFGH'
E = ['AB', 'BC', 'CA', 'BD', 'CE', 'DE', 'DF', 'EG', 'FG', 'GH']
basis = cycle_basis(V, E)
print(len(basis), len(E) - len(V) + 1, basis)
# 3 3 [['A', 'B', 'C'], ['B', 'C', 'E', 'D'], ['E', 'D', 'F', 'G']]

def edges_of(cycle):
    return {''.join(sorted(p)) for p in zip(cycle, cycle[1:] + cycle[:1])}
total = edges_of(basis[0]) ^ edges_of(basis[1]) ^ edges_of(basis[2])
print(sorted(total))
# ['AB', 'AC', 'BD', 'CE', 'DF', 'EG', 'FG']
示例图有 10 − 8 + 1 = 3 个独立的环,第 3 节的搜索树给出了最自然的三个:三角形和两个正方形。求它们的对称差时,共有的边 B–C 和 D–E 相互抵消,剩下长度为 7 的外环。
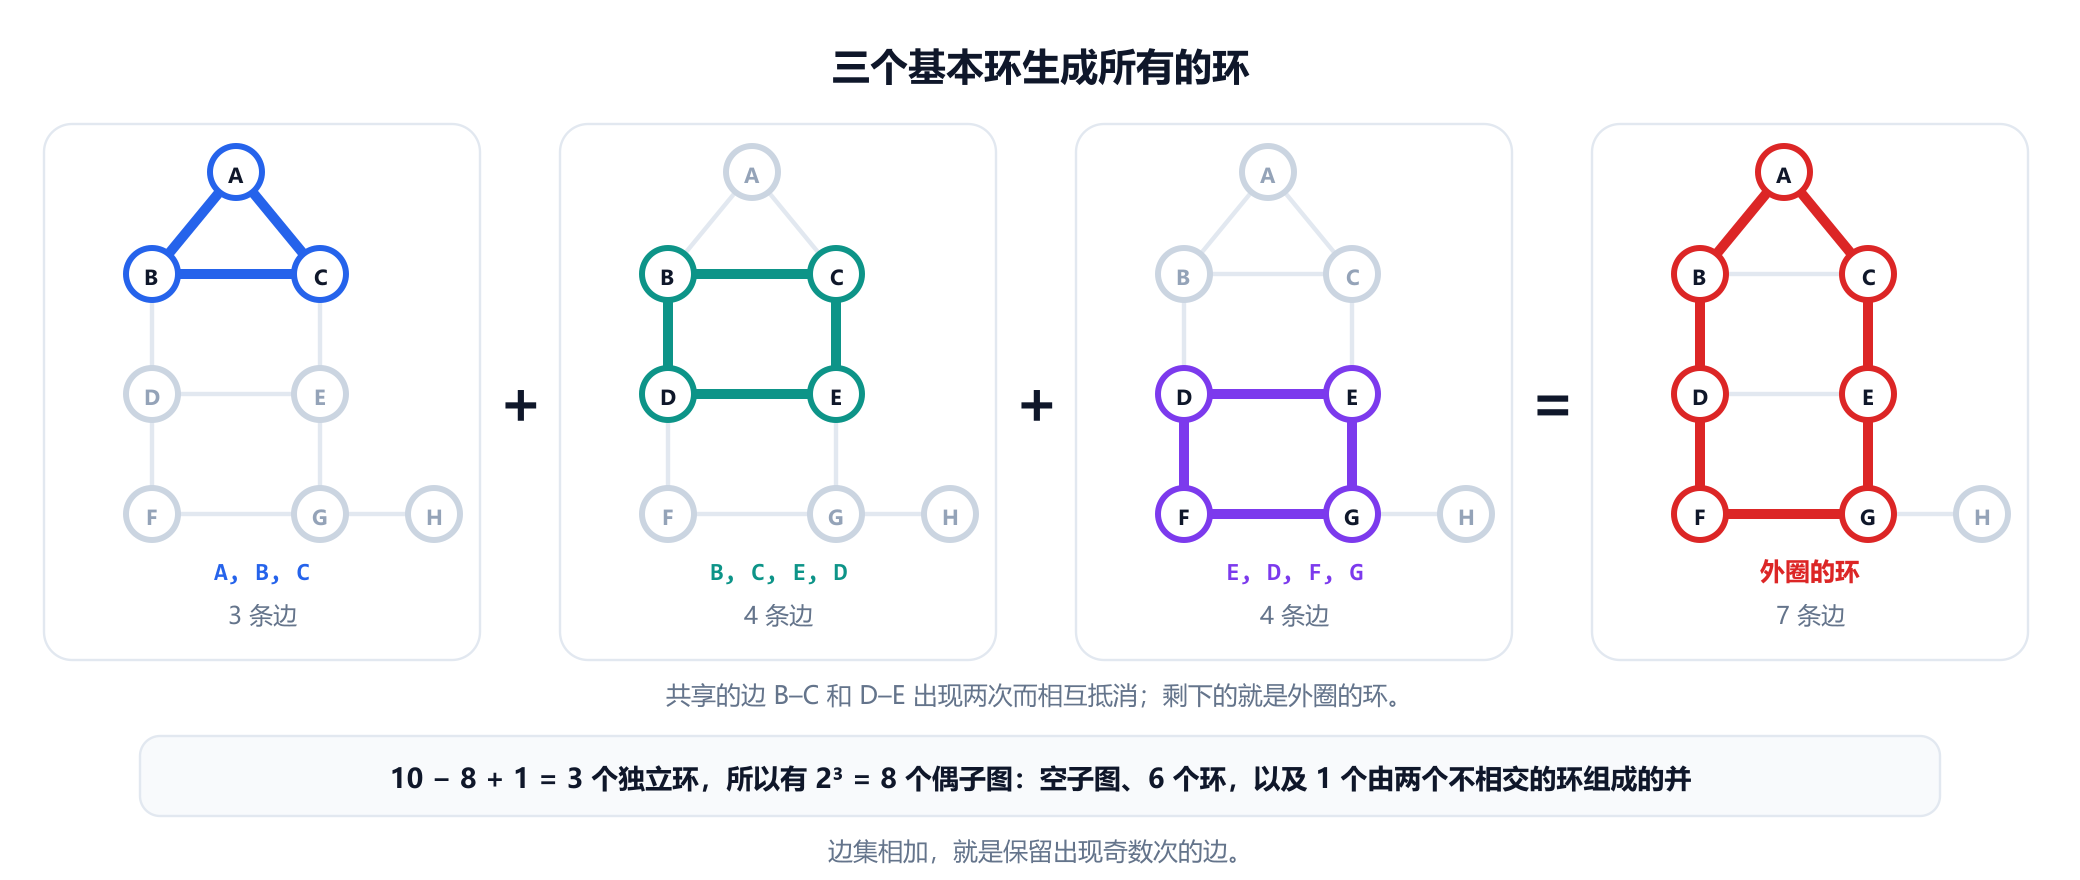
这个空间有 23 = 8 个元素,把它们全部检查一遍很有启发性。一个是空集。六个是图中的六个环。最后一个是三角形与正方形 D, E, G, F的组合:每个顶点的度都是偶数,但这两个环没有公共顶点,所以这个集合不是单个环。环空间的元素是若干边不相交的环的并,不一定是环。对于 K10 的两种计数之间差距惊人:秩为 45 − 10 + 1 = 36,而实际的环有 556,014 个。
同一个数也出现在软件工程中。McCabe 1976 年提出的圈复杂度用程序控制流图的环秩来度量程序,计算公式 E − N + 2P 适用于有 E 条边、 N 个节点和 P 个连通部分的图。多出来的 P 来自设想从每个出口到其入口再加一条边,这样程序中的每条路径都变成了一个环。
8. 奇环与二分图
环的长度与它是否存在同样重要。一个图是二分图,即它的顶点可以分成两侧、每条边都在两侧之间穿过,当且仅当它没有奇环。一个方向是显然的:环在两侧之间交替,所以经过偶数步才回到出发点。另一个方向由 Kőnig 于 1916 年证明,它依赖于下面这个引理:
每条长度为奇数的闭途径都包含一个长度为奇数的环。
取一条最短的奇长度闭途径。如果它在中途重复了某个顶点,就在那里把它切成两条更短的闭途径。它们的长度之和为奇数,所以其中一条的长度是奇数,这与所取途径最短相矛盾。因此最短的奇长度闭途径不重复任何东西,它就是一个奇环。(它的长度至少为 3,因为长度为 1 的闭途径需要一个自环。)
实践中的检验方法是用广度优先搜索进行二着色:给起始顶点着色,给每个邻居着上相反的颜色,然后寻找两个端点颜色相同的边。一旦找到这样的边,从它的两个端点沿树向上到最近公共祖先的两段树路径,加上这条边本身,就构成一个奇环,这就是不存在二着色的证书。示例图不是二分图:它的六个环中有三个是奇环,长度分别为 3、5 和 7,单凭三角形就足以看出这一点。
9. 欧拉回路与哈密顿环
两个著名问题要求找特殊的闭合路线,而它们恰好位于一道深刻鸿沟的两侧。
- 一条欧拉回路恰好使用每条边一次。它是一条闭迹,但通常不是环,因为它可能多次经过同一个顶点。Euler 1736 年关于柯尼斯堡七桥的论文表明,这时每个顶点的度都必须是偶数;Hierholzer 1873 年的论文证明了逆命题:忽略孤立顶点,一个连通图有欧拉回路当且仅当它所有顶点的度都是偶数。完整的讨论见关于欧拉路径与欧拉回路的指南。
- 一个哈密顿环恰好经过每个顶点一次。目前还不知道有类似的检验方法。判定是否存在哈密顿环是 NP 完全问题,是 Karp 1972 年列出的 21 个问题之一。存在一些充分条件,其中最著名的是 Dirac 1952 年的定理:一个有
n ≥ 3个顶点、且每个顶点的度都至少为n/2的简单图有哈密顿环。
示例图两者都不满足,原因很简单。它有六个顶点,即 B、 C、 D、 E、 G 和 H,度为奇数,所以它没有欧拉回路;而且由于奇度顶点多于两个,它连开放的欧拉迹都没有。此外, H 的度为 1,所以没有环能经过它;最好的情况是只漏掉 H的那个长度为 7 的环。带距离的哈密顿问题就是旅行商问题。
10. 带权的环:负环
一旦边带有权重,环就有一个总权重,而负环,即权重之和小于零的环,会使最短路径失去意义。沿它多绕一圈总能降低代价,因此通往从该环可达的任何顶点的途径根本没有最短长度。 Bellman-Ford 算法能检测到这种情况。在没有负环时,最短路径至多有 n − 1 条边,所以对每条边进行 n − 1 轮松弛之后,所有距离都已确定。如果第 n轮仍能改进某个值,就存在负环,而从被改进的顶点沿前驱指针回溯,就会进入这个负环。
一个巧妙的应用是货币套利。给从货币 a 到货币 b 的边赋予权重 −log r,其中 r 是汇率。一轮交易使资金乘以各汇率之积,而这个积超过 1 当且仅当权重之和为负。有利可图的回路就是负环。如果要求的是平均每条边权重最小的环,Karp 1978 年对最小环均值的刻画能在 O(nm) 时间内解决这个问题。
11. 序列中的环:龟兔赛跑
另一类环检测作用于每个顶点都恰好有一条出边的图。沿着链表的 next 指针前进,或者反复把函数 f 作用于一个值,都是在这样的图上行走。在有限集合上,这样的行走最终必然重复某个值,从那以后就会永远重复下去。这个序列看起来像希腊字母 rho,即 ρ:一段长度为 μ 的尾巴,通向一个长度为 λ的环。
存储见过的每个值可以找到重复,但所需内存与 μ + λ成正比。龟兔赛跑方法只用两个指针,别无其他。乌龟每次走一步,兔子每次走两步。一旦两者都进入环,兔子每走一次就追近一步,所以它会在一圈之内追上乌龟。Knuth 在 1969 年把这个想法归于 Robert W. Floyd,不过目前并不知道有 Floyd 描述该方法的论文。
def floyd(f, x0):
    """以 O(1) 内存求序列 x0, f(x0), f(f(x0)), ... 的尾长 mu 和环长 lam。"""
    tortoise, hare = f(x0), f(f(x0))
    while tortoise != hare:                       # 1. 在环上的某处相遇
        tortoise, hare = f(tortoise), f(f(hare))
    mu, tortoise = 0, x0
    while tortoise != hare:                       # 2. 同步前进到环的入口
        tortoise, hare = f(tortoise), f(hare)
        mu += 1
    lam, hare = 1, f(tortoise)
    while tortoise != hare:                       # 3. 绕环走一圈
        hare = f(hare)
        lam += 1
    return mu, lam

f = lambda x: (x * x + 1) % 55
print(floyd(f, 0))
# (4, 6)
seq = [0]
for _ in range(11):
    seq.append(f(seq[-1]))
print(seq)
# [0, 1, 2, 5, 26, 17, 15, 6, 37, 50, 26, 17]
对于 f(x) = x2 + 1 mod 55 从 0 开始,值依次为 0, 1, 2, 5 然后进入循环 26, 17, 15, 6, 37, 50,所以 μ = 4 且 λ = 6。两个指针在乌龟走了六步后第一次相遇。第二阶段之所以可行,是因为在相遇点,乌龟走了 t 步,兔子则走了 2t步,所以 t 是 λ的倍数。从 x0 重新出发的一个指针与留在相遇点的另一个指针,都每次走一步,因此恰好在 μ 步之后一起到达环的起点。
该方法需要 O(μ + λ) 的时间和常数内存。Brent 1980 年的变体在 2 的幂次处把乌龟瞬移到兔子的位置,通常需要对 f进行更少次的求值。两者都用于分解整数的 Pollard rho 方法,其中 f 是一个多项式映射,例如 x2 + c 模被分解的那个数。
12. 环检测的用武之地
只要箭头表示“等待”“依赖于”或“引用”,环就意味着某些东西无法完成、无法构建或无法释放。
| 领域 | 顶点与箭头 | 环意味着 |
|---|---|---|
| 操作系统与数据库 | 进程或事务,“等待对方持有的资源” | 死锁:除非有人让步,否则谁都无法继续 |
| 构建系统与包管理器 | 模块或包,“依赖于” | 不存在合法的构建顺序 |
| 电子表格 | 单元格,“公式引用了” | 没有一致取值的循环引用 |
| 内存管理 | 对象,“持有对其的引用” | 引用计数永远不会降到零,因此单纯的引用计数会泄漏这个环 |
| 金融 | 货币,权重取 −log 汇率 | 负环就是套利回路 |
死锁是教科书式的案例。Coffman、Elphick 和 Shoshani 在 1971 年列出了发生死锁必须同时满足的四个条件,其中最后一个条件循环等待,用图的语言说,就是等待中的任务之间存在一个环。系统可以通过排除其中一个条件来预防死锁,例如总是按一个固定的全局顺序获取锁,这使等待图成为 DAG。系统也可以允许死锁发生,不时地查找环,并通过中止其中一个成员来打破它。
内存管理是同一个故事的另一种形式。当指向某个对象的最后一个指针消失时,它的引用计数降为零;但两个互相指向的对象即使在其他任何东西都无法到达它们时,也会让彼此的计数保持为 1。这就是 CPython 在引用计数之外还配有一个独立回收器的原因,它的任务就是找出这类不可达的环。
13. 常见错误
| 错误 | 为什么错 | 修正 |
|---|---|---|
| 把回到父节点的边当作环 | 这样每条无向边看起来都像一个长度为 2 的环 | 跳过你来时经过的那条边 |
| 跳过的是父顶点而不是父边 | 多重图中的重边是真实的环,却被漏掉 | 按身份跳过进入时所经的那条边 |
| 在有向图上使用已访问集合 | 指向已结束顶点的横叉边和前向边会引发误报 | 使用三种颜色,并且只报告指向灰色顶点的箭头 |
| 在有向图上使用并查集 | 它忽略方向,所以 A→B、 B→C、 A→C 看起来像有环 | 使用深度优先搜索或 Kahn 算法 |
| 把 Kahn 算法剩下的顶点报告为环 | 其中包括环下游的所有顶点,例如 D | 在剩下的集合内反向行走,直到有顶点重复 |
| 只从一个顶点开始搜索 | 位于另一个连通分量中、或从起点不可达的环永远不会被发现 | 从每个未访问的顶点开始一次新的搜索 |
| 在 Python 中对长路径使用递归 | 远在内存耗尽之前,就会碰到默认 1,000 的递归上限 | 使用显式栈,如上面的代码所示 |
| 混淆回路与环 | 欧拉回路可能多次经过同一个顶点 | 确认定理所用的是哪种定义 |
14. 术语表
| 术语 | 含义 |
|---|---|
| 途径 | 由边连接起来的顶点序列;任何东西都可以重复 |
| 迹 | 没有重复边的途径 |
| 路径 | 没有重复顶点的途径 |
| 回路 | 闭迹 |
| 环 | 长度为正、唯一重复的顶点是其起点的闭迹 |
| 围长 | 最短环的长度 |
| 周长 | 最长环的长度 |
| 森林,树 | 无环图;连通的无环图 |
| DAG | 有向无环图 |
| 回边 | 在深度优先搜索中,从一个顶点指向其某个祖先的边 |
| 环空间 | 所有度数均为偶数的边集,以对称差进行组合 |
| 圈数,环秩 | m − n + k,即环空间的维数 |
| 基本环 | 一条非树边与生成森林闭合成的那个环 |
| 负环 | 总权重小于零的环 |
15. 常见问题
什么是图中的环?
环是一条从同一个顶点出发并回到该顶点的闭合路线,它至少使用一条边,且不重复其他顶点,也不重复任何边。在简单图中,环至少有三个顶点;在多重图中,自环是长度为 1 的环,两条平行边构成长度为 2 的环。没有环的图称为无环图:无向时是森林,有向时是 DAG。
如何检测无向图中的环?
运行一次只跳过来时所经那条边的深度优先搜索。如果搜索到达一个已被访问的顶点,那条边就是回边,回边加上其两端之间的树路径就是一个环。另一种方法是:有 n 个顶点、m 条边和 k 个连通分量的图有环,当且仅当 m > n − k;并查集还能报告第一条闭合环的边。所有这些方法都在 O(V + E) 时间内运行。
如何检测有向图中的环?
使用三色深度优先搜索:白色表示未访问的顶点,灰色表示搜索仍在进行中的顶点,黑色表示已结束的顶点。指向灰色顶点的箭头是回边,证明存在环;指向黑色顶点的箭头则不能证明。另一种方法是 Kahn 算法:反复移除入度为 0 的顶点,如果有些顶点永远无法被移除,图就有环。
为什么已访问集合在有向图上会给出错误答案?
在有向图中,一个顶点可以沿两条不同路线被到达两次,而不存在任何回到起点的路线,例如 A→B→D 和 A→C→D。简单的已访问检查会把第二次到达判定为环。只有指向搜索仍在进行中的顶点(即灰色顶点)的箭头,才能证明存在环。
一个图有多少个独立的环?
有 n 个顶点、m 条边和 k 个连通分量的图,其环空间的维数为 m − n + k,称为圈数或环秩。对任意生成森林,森林之外的 m − n + k 条边中,每一条都恰好闭合一个基本环,而每个环都是若干基本环的对称差。环的总数可能大得多:K10 的秩为 36,却有 556,014 个环。
并查集能检测有向图中的环吗?
不能。并查集忽略方向,所以它把箭头 A→B、B→C 和 A→C 当作三角形,并报告一个环,尽管顺着箭头走永远回不到 A。对于有向图,请使用三色深度优先搜索或 Kahn 算法。
16. 参考文献
以上定义、定理和归属均出自以下文献,按时间顺序排列。
- Euler, L. (1741). "Solutio problematis ad geometriam situs pertinentis." Commentarii academiae scientiarum Petropolitanae 8,128 至 140 页。该卷标注的年份为 1736 年。柯尼斯堡七桥问题以及欧拉回路的度条件。
- Kirchhoff, G. (1847). "Ueber die Auflösung der Gleichungen, auf welche man bei der Untersuchung der linearen Vertheilung galvanischer Ströme geführt wird." Annalen der Physik und Chemie 72(12),497 至 508 页。生成树,以及每条剩余边对应一个独立的环。
- Hierholzer, C. (1873). "Ueber die Möglichkeit, einen Linienzug ohne Wiederholung und ohne Unterbrechung zu umfahren." Mathematische Annalen 6(1),30 至 32 页。在作者去世后发表。
- Kőnig, D. (1916). "Über Graphen und ihre Anwendung auf Determinantentheorie und Mengenlehre." Mathematische Annalen 77(4),453 至 465 页。一个图是二分图当且仅当它没有奇环。
- Dirac, G. A. (1952). "Some Theorems on Abstract Graphs." Proceedings of the London Mathematical Society s3-2(1),69 至 81 页。
- Bellman, R. (1958). "On a Routing Problem." Quarterly of Applied Mathematics 16(1),87 至 90 页。
- Kahn, A. B. (1962). "Topological Sorting of Large Networks." Communications of the ACM 5(11),558 至 562 页。
- Knuth, D. E. (1969). The Art of Computer Programming, Volume 2: Seminumerical Algorithms. 马萨诸塞州雷丁:Addison-Wesley。第 3.1 节习题 6,其中将这种找环方法归于 Floyd。
- Coffman, E. G., Elphick, M. J. and Shoshani, A. (1971). "System Deadlocks." Computing Surveys 3(2),67 至 78 页。
- Tarjan, R. E. (1972). "Depth-First Search and Linear Graph Algorithms." SIAM Journal on Computing 1(2),146 至 160 页。
- Karp, R. M. (1972). "Reducibility Among Combinatorial Problems." 载于 Complexity of Computer Computations,85 至 103 页。纽约:Plenum。有向与无向哈密顿回路位列 21 个 NP 完全问题之中。
- Pollard, J. M. (1975). "A Monte Carlo Method for Factorization." BIT 15(3),331 至 334 页。
- Johnson, D. B. (1975). "Finding All the Elementary Circuits of a Directed Graph." SIAM Journal on Computing 4(1),77 至 84 页。
- McCabe, T. J. (1976). "A Complexity Measure." IEEE Transactions on Software Engineering SE-2(4),308 至 320 页。
- Itai, A. and Rodeh, M. (1978). "Finding a Minimum Circuit in a Graph." SIAM Journal on Computing 7(4),413 至 423 页。
- Karp, R. M. (1978). "A Characterization of the Minimum Cycle Mean in a Digraph." Discrete Mathematics 23(3),309 至 311 页。
- Brent, R. P. (1980). "An Improved Monte Carlo Factorization Algorithm." BIT 20(2),176 至 184 页。一种更快的找环方法。
- Diestel, R. (2017). Graph Theory,第 5 版。Graduate Texts in Mathematics 173。柏林:Springer。