
目录
1. 为什么生物学里到处都是图
生物学历史的大部分时间都在列清单。一份基因清单,一份酶清单,一份湖中物种清单。清单越来越长,后来变得完整,而完整之后揭示了一件令人不安的事:了解一个系统的每一个零件,对这个系统做什么所知甚少。人类基因组在 2003 年完成,蛋白质编码基因的数量约为 20,000 个,与一种只有 302 个神经元的线虫相差不远。零件清单从来就不会是答案。
把人和蠕虫、把健康细胞和癌细胞区分开来的,不是存在哪些组件,而是哪些组件与哪些组件相互作用。这句话本身就是图的定义。图就是一组事物,加上它们之间的一组连接,仅此而已。一旦你写下哪些蛋白质与哪些结合、哪个基因开启哪个基因、哪个物种吃哪个物种,你就不再是在列清单,而是在画一张图,无论你是否用了这个词。
这不是比喻,也不是一种表达风格。它之所以重要,是因为图自带两个世纪的数学。一旦把生物学问题表述为图的问题,大量定理和算法就同时可用了,那些看似需要新生物学的问题,结果只需要一个现成的算法。基因组组装,也就是把数亿个短 DNA 片段拼成一条染色体的过程,就是一次把图中每条边恰好走一遍的行走。欧拉在 1736 年为一座普鲁士城市的桥解决了这个问题,那正是同一个问题。
这种习惯比大多数人想象的更古老。图这个词的专业含义,是数学家 James Joseph Sylvester 在 1878 年借用化学结构图提出的:把分子画成由化学键相连的原子。化学为图论提供了部分词汇,一个世纪之后,分子生物学又为它提供了一些最大的数据集。
本指南依次讨论六个生物系统:一个蛋白质相互作用网络、一个基因调控网络、一个由读段组装而成的基因组、一对正在比对的序列、一组被放到进化树上的物种,以及一个逐个失去物种的食物网。每个系统都小到可以手工核对,并用一个有名字的算法求解。这里的每一个数字都来自实际运行过的代码,每个结果在写下之前都用另一种不同的方法重新算过。
2. 四种图,四个不同的问题
在动手构建之前,值得先弄清每个生物系统产生的是哪一种图,因为图的种类决定了哪些问题能够提出。四个区分几乎承担了全部工作。
有向还是无向。两个蛋白质结合时,关系是对称的:“A 结合 B”和“B 结合 A”是同一个事实,所以蛋白质相互作用网络是无向的。转录因子开启一个基因时,关系只朝一个方向,所以基因调控网络是有向的。这不是记账问题。无向图有连通分量;有向图有可达性、环和反馈,而反馈正是调控的实质。问一个基因网络是否含有环,就是在问它是否含有反馈回路,而答案会改变生物学结论。
加权还是不加权。食物网中的一条边可以只是存在,也可以承载沿它流动的生物量。序列相似性图在每条边上都带有一个分数。权重让你能够询问最佳路线,而不仅仅是任意一条路线,这正是第 8 节把比对变成最短路径问题的原因。
静态还是动态。本文中几乎每个网络都画得好像是固定不变的。真实的细胞并非如此。存在于肝细胞中的相互作用在神经元中可能不存在,而且相互作用会在细胞周期中出现又消失。把一个随时间平均的汇总网络当作所有边同时存在来处理,是这个领域最常见的建模错误,第 13 节还会回到这一点。
二部图还是不是。有些生物数据有两类顶点,边只存在于两类之间:药物与其靶点、宿主与其寄生物、基因与其相关疾病。二部图有自己的一套算法,首先就是匹配,药物重定位筛选常常就是这样表述的。
把这四点弄对,其余的自然就对了。弄错了,你算出的数字就会以一种任何软件都不会提醒你的方式失去意义。
3. 蛋白质网络:枢纽、桥与介数
蛋白质相互作用网络,简称 PPI 网络,每个蛋白质是一个顶点,两个蛋白质发生物理结合的地方就有一条无向边。大规模版本通过酵母双杂交筛选,或通过亲和纯化加质谱分析构建,已发表的酵母和人类网络有数万条边。与其指着一个庞然大物,我们用一个小网络:十二个蛋白质、十八个相互作用,小到下面每个结论都能靠数数来核对。
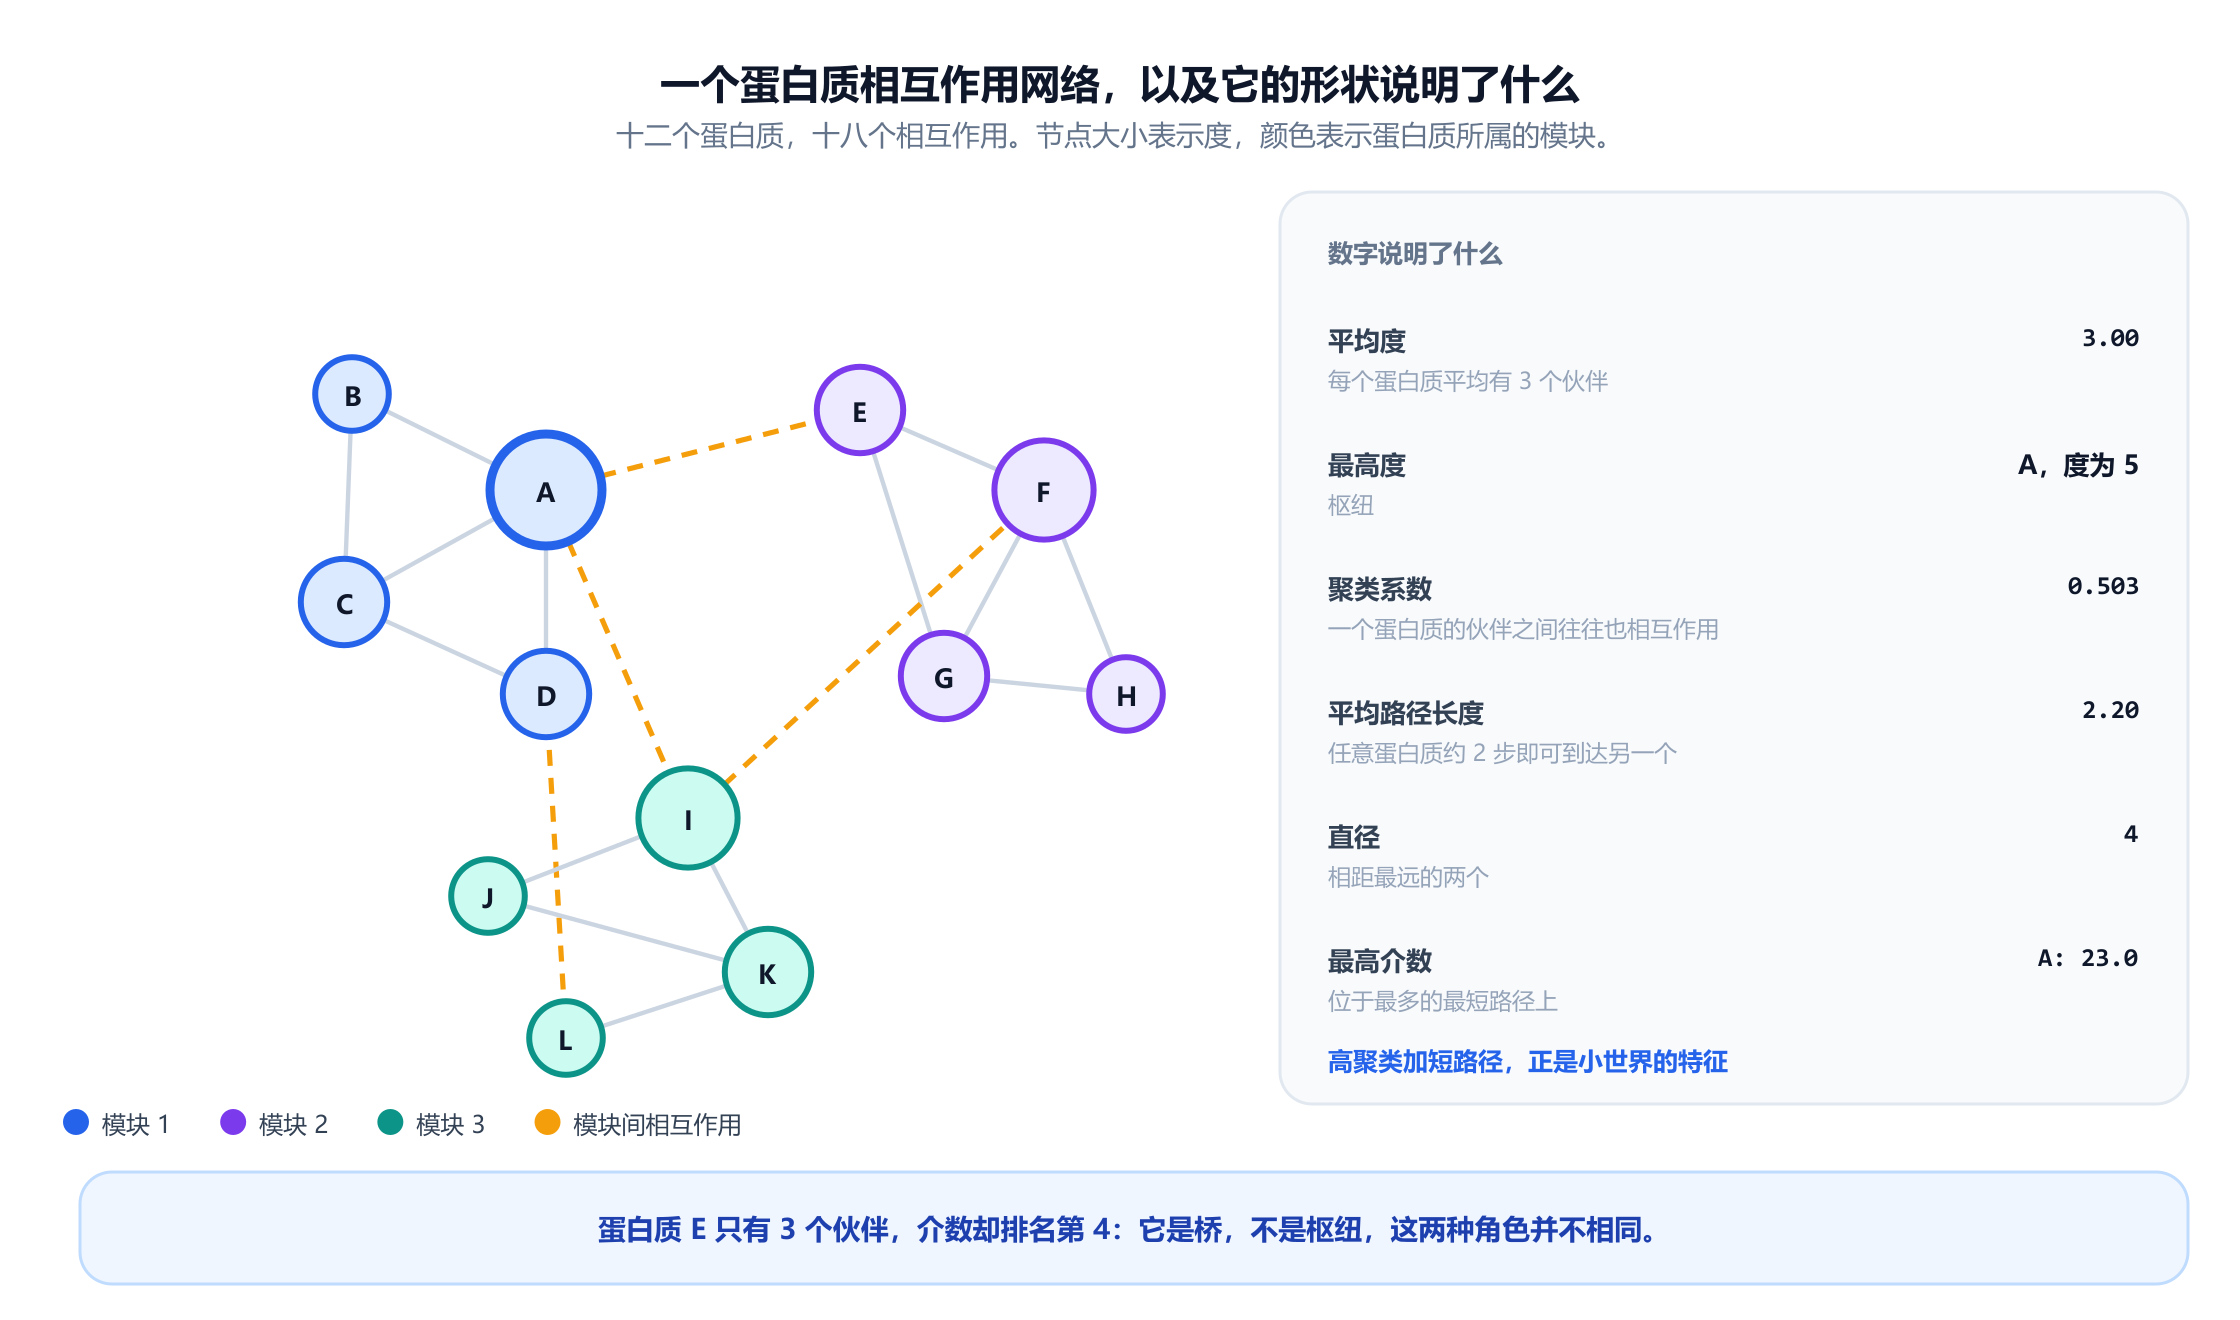
首先要测量的是度,即一个蛋白质的伙伴数。这里的度从 A:5,到各为 4 的 F 和 I,再到度为 3 的五个,最后是度为 2 的四个,平均为 3.0。在真实的 PPI 网络中,这个分布要不均匀得多:大多数蛋白质只有几个伙伴,一小部分却有数百个。具有这种形状的网络称为无标度网络,这个术语因 Barabasi 和 Oltvai 2004 年的综述而流行,而那一小部分高度数的蛋白质就是枢纽。
枢纽之所以重要,是因为一个经过实验确立、而非理论推演的原因。2001 年,Jeong、Mason、Barabasi 和 Oltvai 把酵母 PPI 网络与酵母缺失文库进行了比较,在该文库中,每个基因依次被敲除,所得细胞被判定为存活或死亡。相互作用伙伴越多的蛋白质,是必需蛋白的可能性就明显越大。这篇论文的题目是 Lethality and centrality in protein networks,它报告的相关性,正是度成为人们在生物网络上首先计算的指标的原因。
度并不是唯一的重要性,而这正是一个小例子发挥作用的地方。看看蛋白质 E。它有三个伙伴,在任何按度排序的列表中都毫不起眼。现在计算它的介数中心性,即在所有蛋白质对之间的最短路径中,经过某个顶点的比例。Freeman 在 1977 年为社会网络提出了这一指标。在这张图上,介数排名依次是 A 为 23.0,I 为 19.8,F 为 12.2,然后是 E 为 9.2,排在好几个伙伴比它多的蛋白质前面。
E 得分高是因为它所处的位置,而不是它有多少邻居。它是进入第二个模块的入口,所以第一模块和第二模块之间的流量必须经过它。用网络的术语说,E 是一座桥,而不是枢纽,这个区别有生物学上的含义:桥蛋白是不同通路之间串扰的候选者,移除它与其说是删掉一项功能,不如说是把两项功能彼此隔开。仅按度排名永远不会把它找出来。
还有两个数字描述的是整张图,而不是某个顶点。平均最短路径长度为 2.197,而直径,即所有最短路径中最长的一条,为 4:任何蛋白质最多四步就能到达任何其他蛋白质。真实的 PPI 网络在大得多的规模上表现相同,有数千个蛋白质,特征路径长度约为 5。这就是 Watts 和 Strogatz 在 1998 年形式化的小世界性质,在细胞内部它有一个直截了当的后果。任何地方的扰动离所有地方都只有几步之遥,这在很大程度上解释了为什么针对一个蛋白质的药物总能如此可靠地产生无人设计过的效应。
4. 耐得住意外,经不起攻击
网络生物学中被引用最多的结果并不是关于某个特定蛋白质的。它讲的是当你开始删除蛋白质时会发生什么,由 Albert、Jeong 和 Barabasi 发表在 Nature 上,时间是 2000 年,题为 Error and attack tolerance of complex networks。
这个实验很容易描述。取一个网络,删除顶点,每删除一个就测量最大存活连通分量的大小。做两次:一次是均匀随机地删除顶点,模拟意外和突变;另一次是按度从高到低删除,模拟蓄意攻击。然后比较两条曲线。
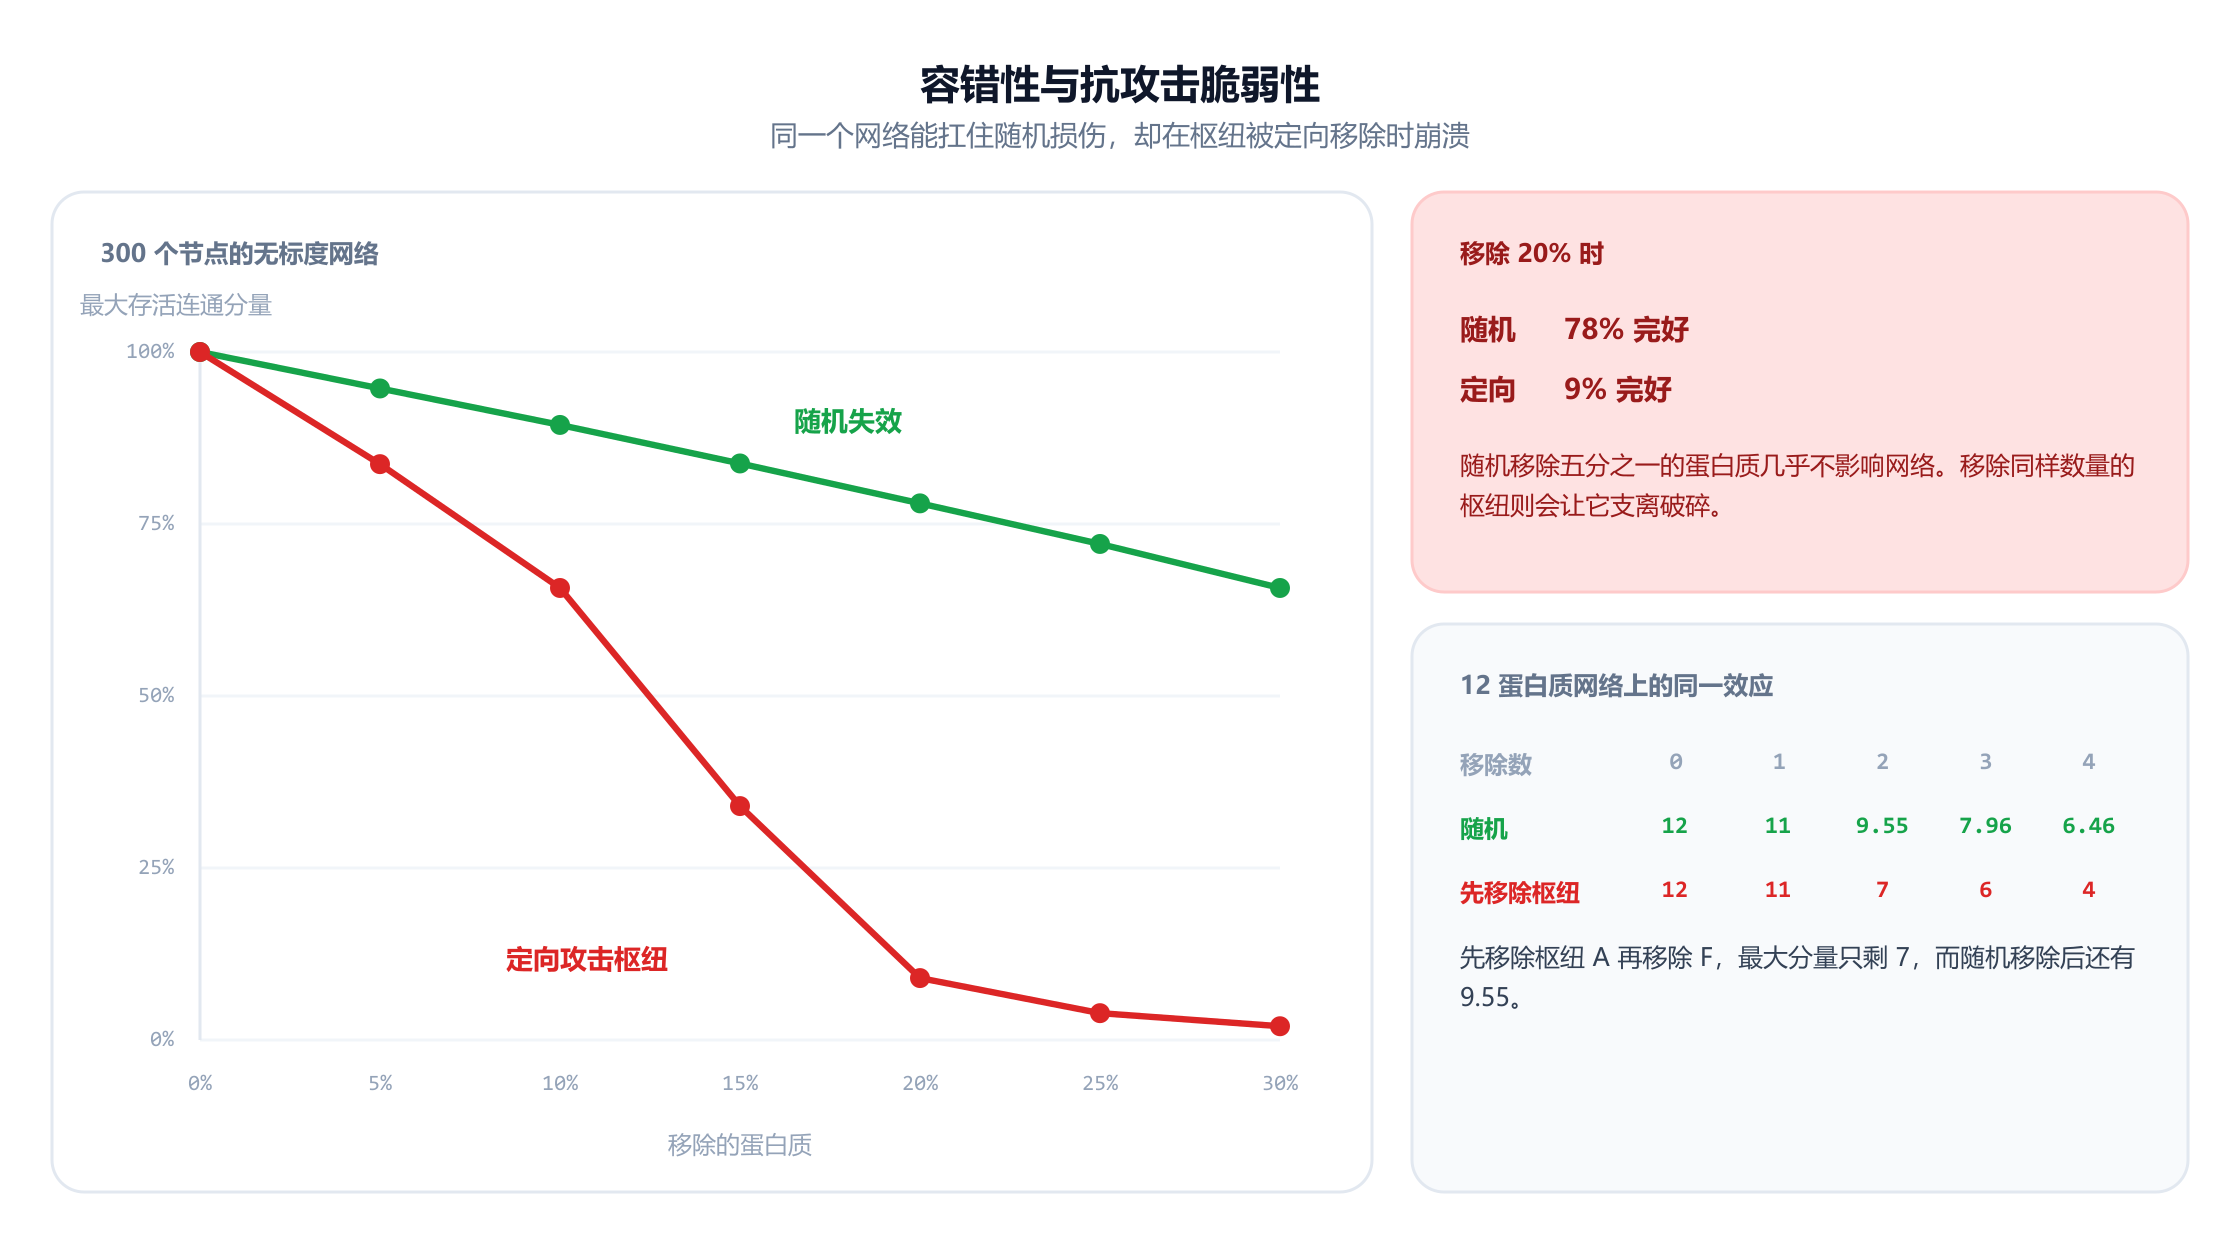
在一个由优先连接生成的 300 顶点无标度网络上,随机移除 20% 的顶点后,还剩 78% 的网络仍连成一片。移除度最高的 20% 后,只剩 9%。经受住第一种攻击的网络被第二种攻击摧毁了,两者唯一的区别在于选中了哪些顶点。
十二蛋白质网络以一个你可以手工核对的规模展示了同样的不对称。随机移除蛋白质,对所有可能的选择取平均,当移除数量从零增加到四时,最大分量依次为 12、11、9.55、7.96 和 6.46。按度从高到低移除枢纽,在这里就是先 A,再 F,再 I,再 C,结果是 12、11、7、6 和 4。两次精心挑选的删除,代价超过四次随机删除。
原因在于度分布。在无标度网络中,绝大多数顶点的度都很低,所以一次随机删除几乎必然落在一个边缘顶点上,它的消失不会切断任何人。稀少的枢纽把一切连在一起,删掉一个就会同时去掉许多条边。对随机损伤的稳健和对定向损伤的脆弱并不是两种相互矛盾的性质。它们是从两个方向看到的同一种性质。
生物学上的解读有两个方向。从脆弱的一面看,这解释了为什么枢纽蛋白中必需蛋白特别多,以及为什么肿瘤学花了二十年试图找出肿瘤所依赖的枢纽。从稳健的一面看,它解释了为什么生物体能承受大量随机突变而没有可见后果,以及为什么单基因敲除常常根本不产生表型。最后这一观察曾让一代遗传学家深感挫败:大多数基因并不承重,而那些承重的基因可以凭它们在图中的位置识别出来。
5. 模块,以及为什么聚类意味着功能
再看一眼十二蛋白质网络,你用肉眼就能看出三组。蛋白质 A 到 D 彼此紧密相连,E 到 H 构成第二个簇,I 到 L 构成第三个,组与组之间只有四条边。这种视觉印象背后有一个数字。
一个顶点的聚类系数问的是一个具体问题:在我的所有邻居对中,有多大比例彼此也相连?如果一个蛋白质有四个伙伴,它们之间有六对,系数就是这六对中相互结合的比例。对全部十二个蛋白质取平均,这个网络的得分是 0.503,意思是大约一半可能闭合的三角形确实闭合了。具有相同顶点数和边数的随机图得分约为 0.23。真实的 PPI 网络同样高度聚类,代谢网络、神经网络和食物网也是如此。
正是高聚类让模块这个词有了意义。彼此都结合的蛋白质往往一起完成一项工作:它们组成一个复合体,处在同一条通路中,或同时被招募到同一个地方。这是应用网络生物学中最有用的推断,因为它让你能根据邻居来注释一个未知蛋白质。如果一个功能未知的蛋白质位于一个其他成员都负责 DNA 修复的簇中,DNA 修复就是首先要检验的假设。整套分析流程都建立在这个想法之上,它们其实就是贴上了生物学名称的社区检测算法。
这里需要一句提醒。算法找到的模块是一个假设,而不是一项发现。算法会划分你给它的任何东西,面对随机数据它同样乐于返回模块。
6. 基因调控:网络模体
基因调控网络是有向的。从基因 X 到基因 Y 的一条弧,意味着 X 产生的蛋白质结合到 Y 的启动子上,改变 Y 的产量。由于弧有方向,有意思的结构是流动的模式,而不是稠密的邻域。2002 年,Uri Alon 课题组的两篇论文改变了人们解读它们的方式。
思路是这样的。取一个小子图,比如三个按特定模式连接的基因,统计它在真实网络中出现的次数。这个次数本身毫无意义,因为有些模式之所以常见,纯粹是因为每个基因有多少条弧。所以要生成许多度完全相同的随机化网络,方法是反复交换成对弧的端点,再在每个网络中统计这个模式。如果真实计数远落在这个分布的尾部,这个模式就是一个网络模体:它出现的频率超出了单凭度所能解释的范围,这表明是自然选择把它放在那里的。
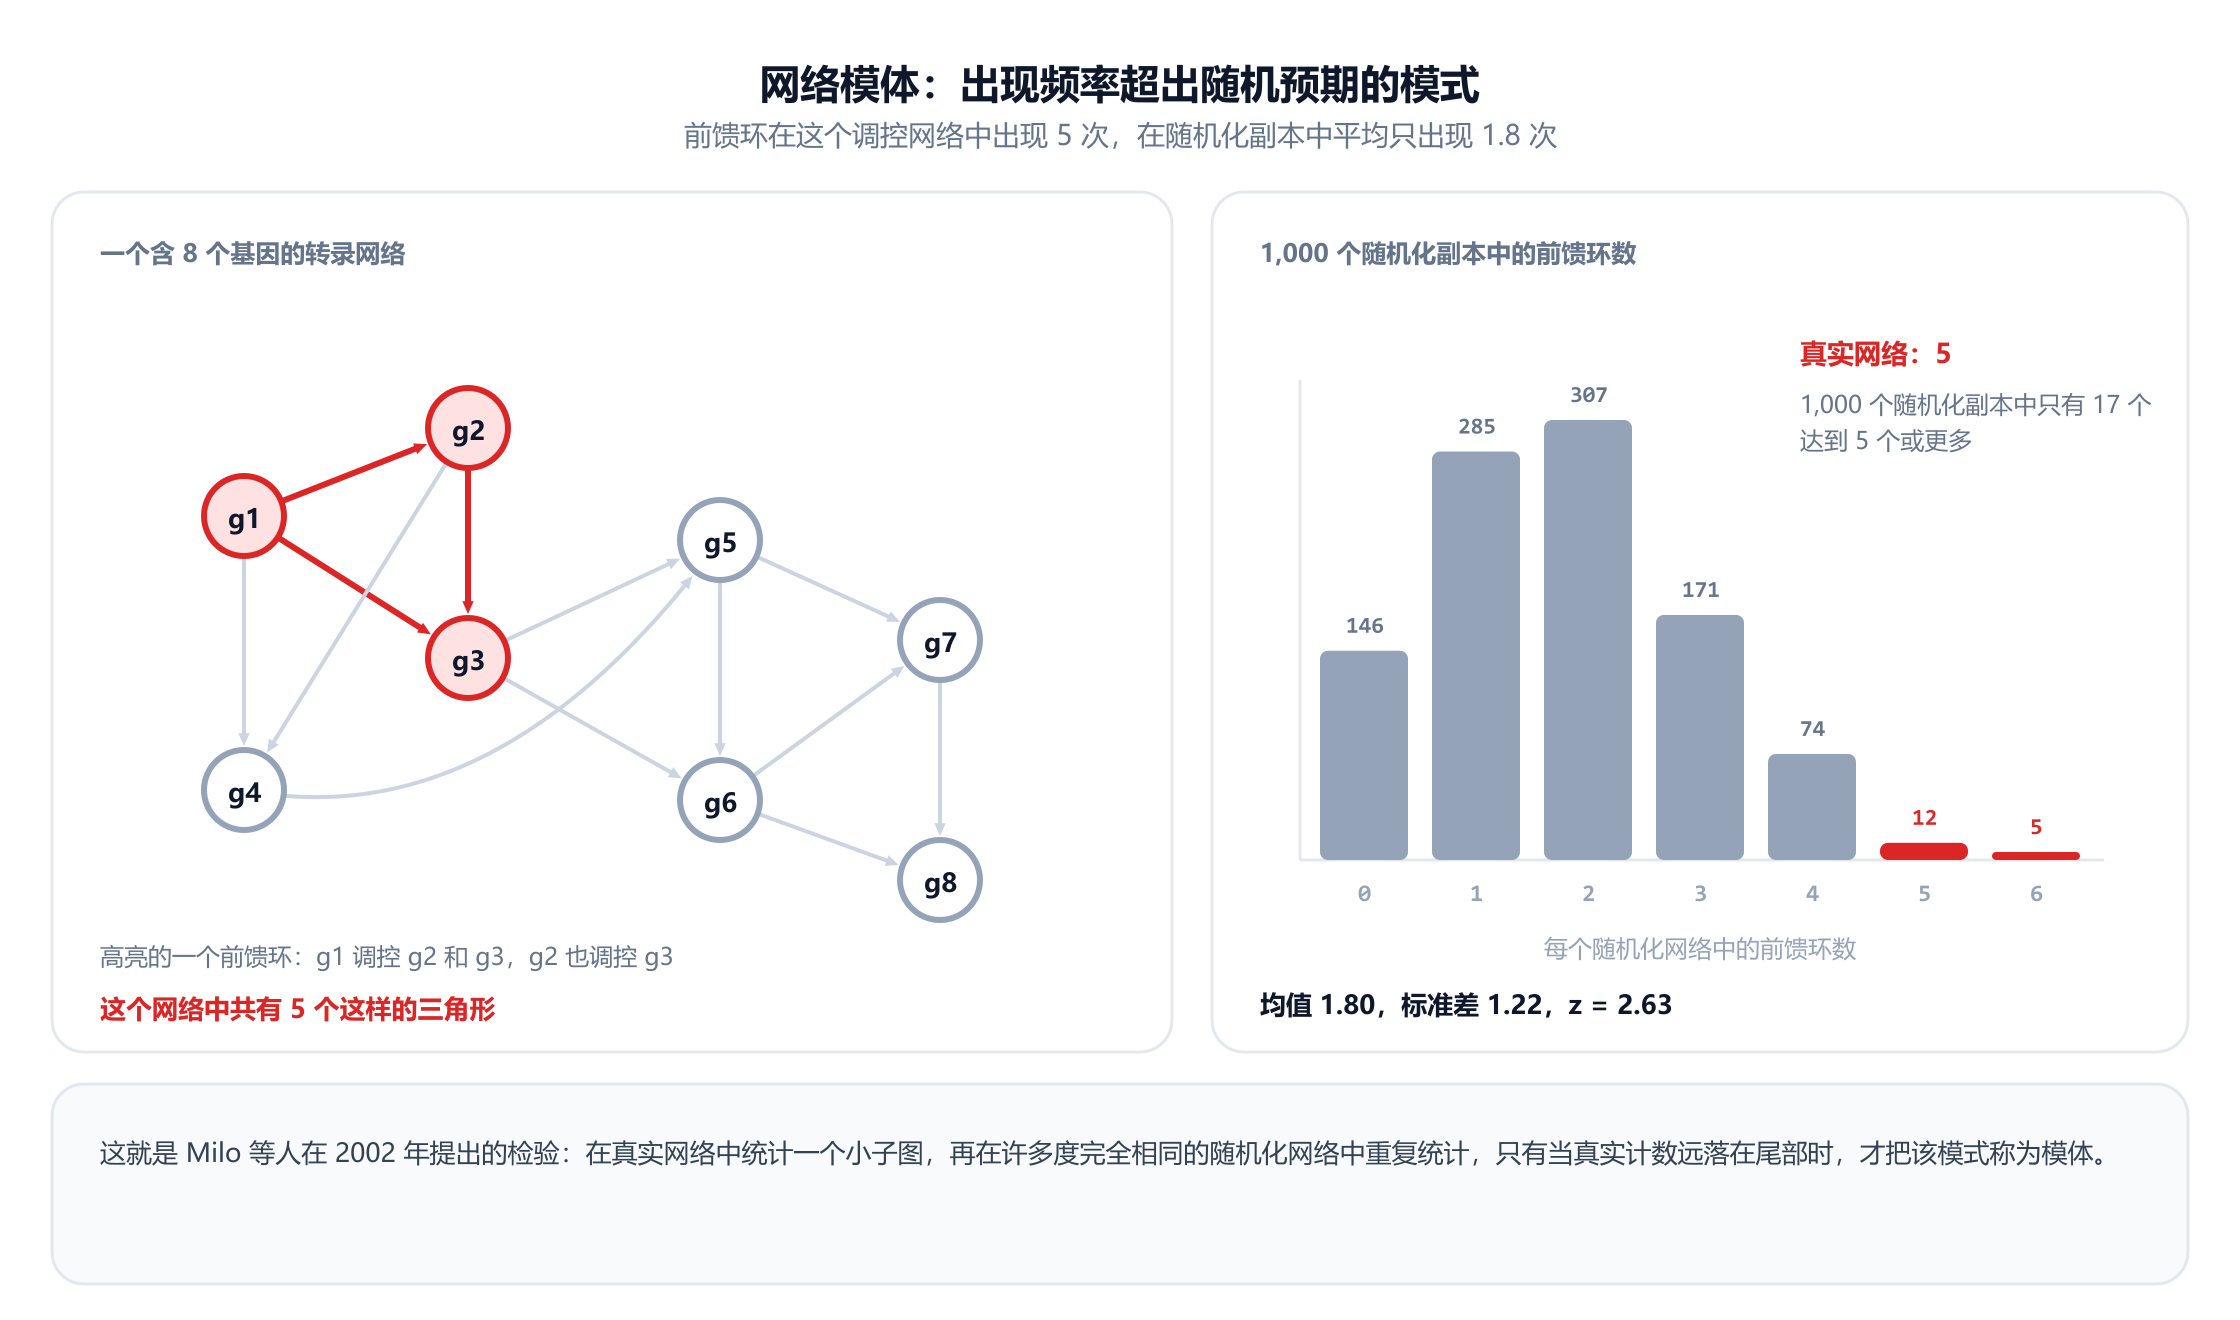
图中的模式是前馈环:基因 X 调控 Y,X 也直接调控 Z,而 Y 同样调控 Z。在这里的八基因网络中,它出现了五次。在 1,000 次保持度不变的随机化中,平均计数为 1.80,标准差为 1.22,得出 z 分数为 2.63,只有 1,000 个中的 17 个随机化网络含有五个或更多。在这么小的网络上,这只是提示而非定论;在真实的 E. coli 转录网络中,Shen-Orr、Milo 和 Alon 发现同样的模式 z 分数达到几十,这绝不是一个模棱两可的结果。
前馈环值得关注,是因为它的功能可以推导出来,而不必靠猜。在相干版本中,X 同时激活 Y 和 Z,Y 也激活 Z,基因 Z 只有在 X 和 Y 都存在时才会开启。由于 X 出现后 Y 需要时间积累,Z 会忽略 X 的短暂脉冲,只对持续的信号做出响应。这个模体是一个持续性检测器,一个由三个基因构成的噪声滤波器。改变正负号,你得到的就是脉冲发生器或加速响应。连接方式就是机制。
Milo 等人发现,不同类型的网络以不同的模体为特征:转录网络富含前馈环,神经网络富含另一组模体,食物网又是另一组。他们认为模体是构建网络的基本电路,这一框架延续至今,既因为统计可以核验,也因为这些电路确实在做事。
有一个方法论要点的意义远远超出生物学。随机化必须保持度不变。如果与普通随机图比较,几乎一切看起来都像模体,因为真实网络有枢纽而随机网络没有,单是枢纽就会让每一种三节点模式都偏多。选错零模型,是这种分析最常见的失败方式。
7. 基因组组装:每条边恰好走一次
测序仪无法读出一整条染色体。它们读取短片段,从短读长仪器上的约 100 个碱基,到长读长仪器上的数万个碱基,这些片段从基因组的许多拷贝中的随机位置取样。一个人类基因组以数亿个这样的片段的形式到来,没有任何关于每个片段来自何处的记录。组装就是把它们重新拼起来的问题,而现代的解决方案是一张图。
这种构造由 Pevzner、Tang 和 Waterman 在 2001 年提出,它优雅到两句话就能说清。把每个读段切成长度为 k 的重叠子串,称为 k-mer。然后构建一张图,其中每个 k-mer 是一条边,从由它前 k-1 个字母组成的顶点,指向由它后 k-1 个字母组成的顶点。重建序列现在就意味着找到一条把每条边恰好使用一次的行走,这就是欧拉路径。
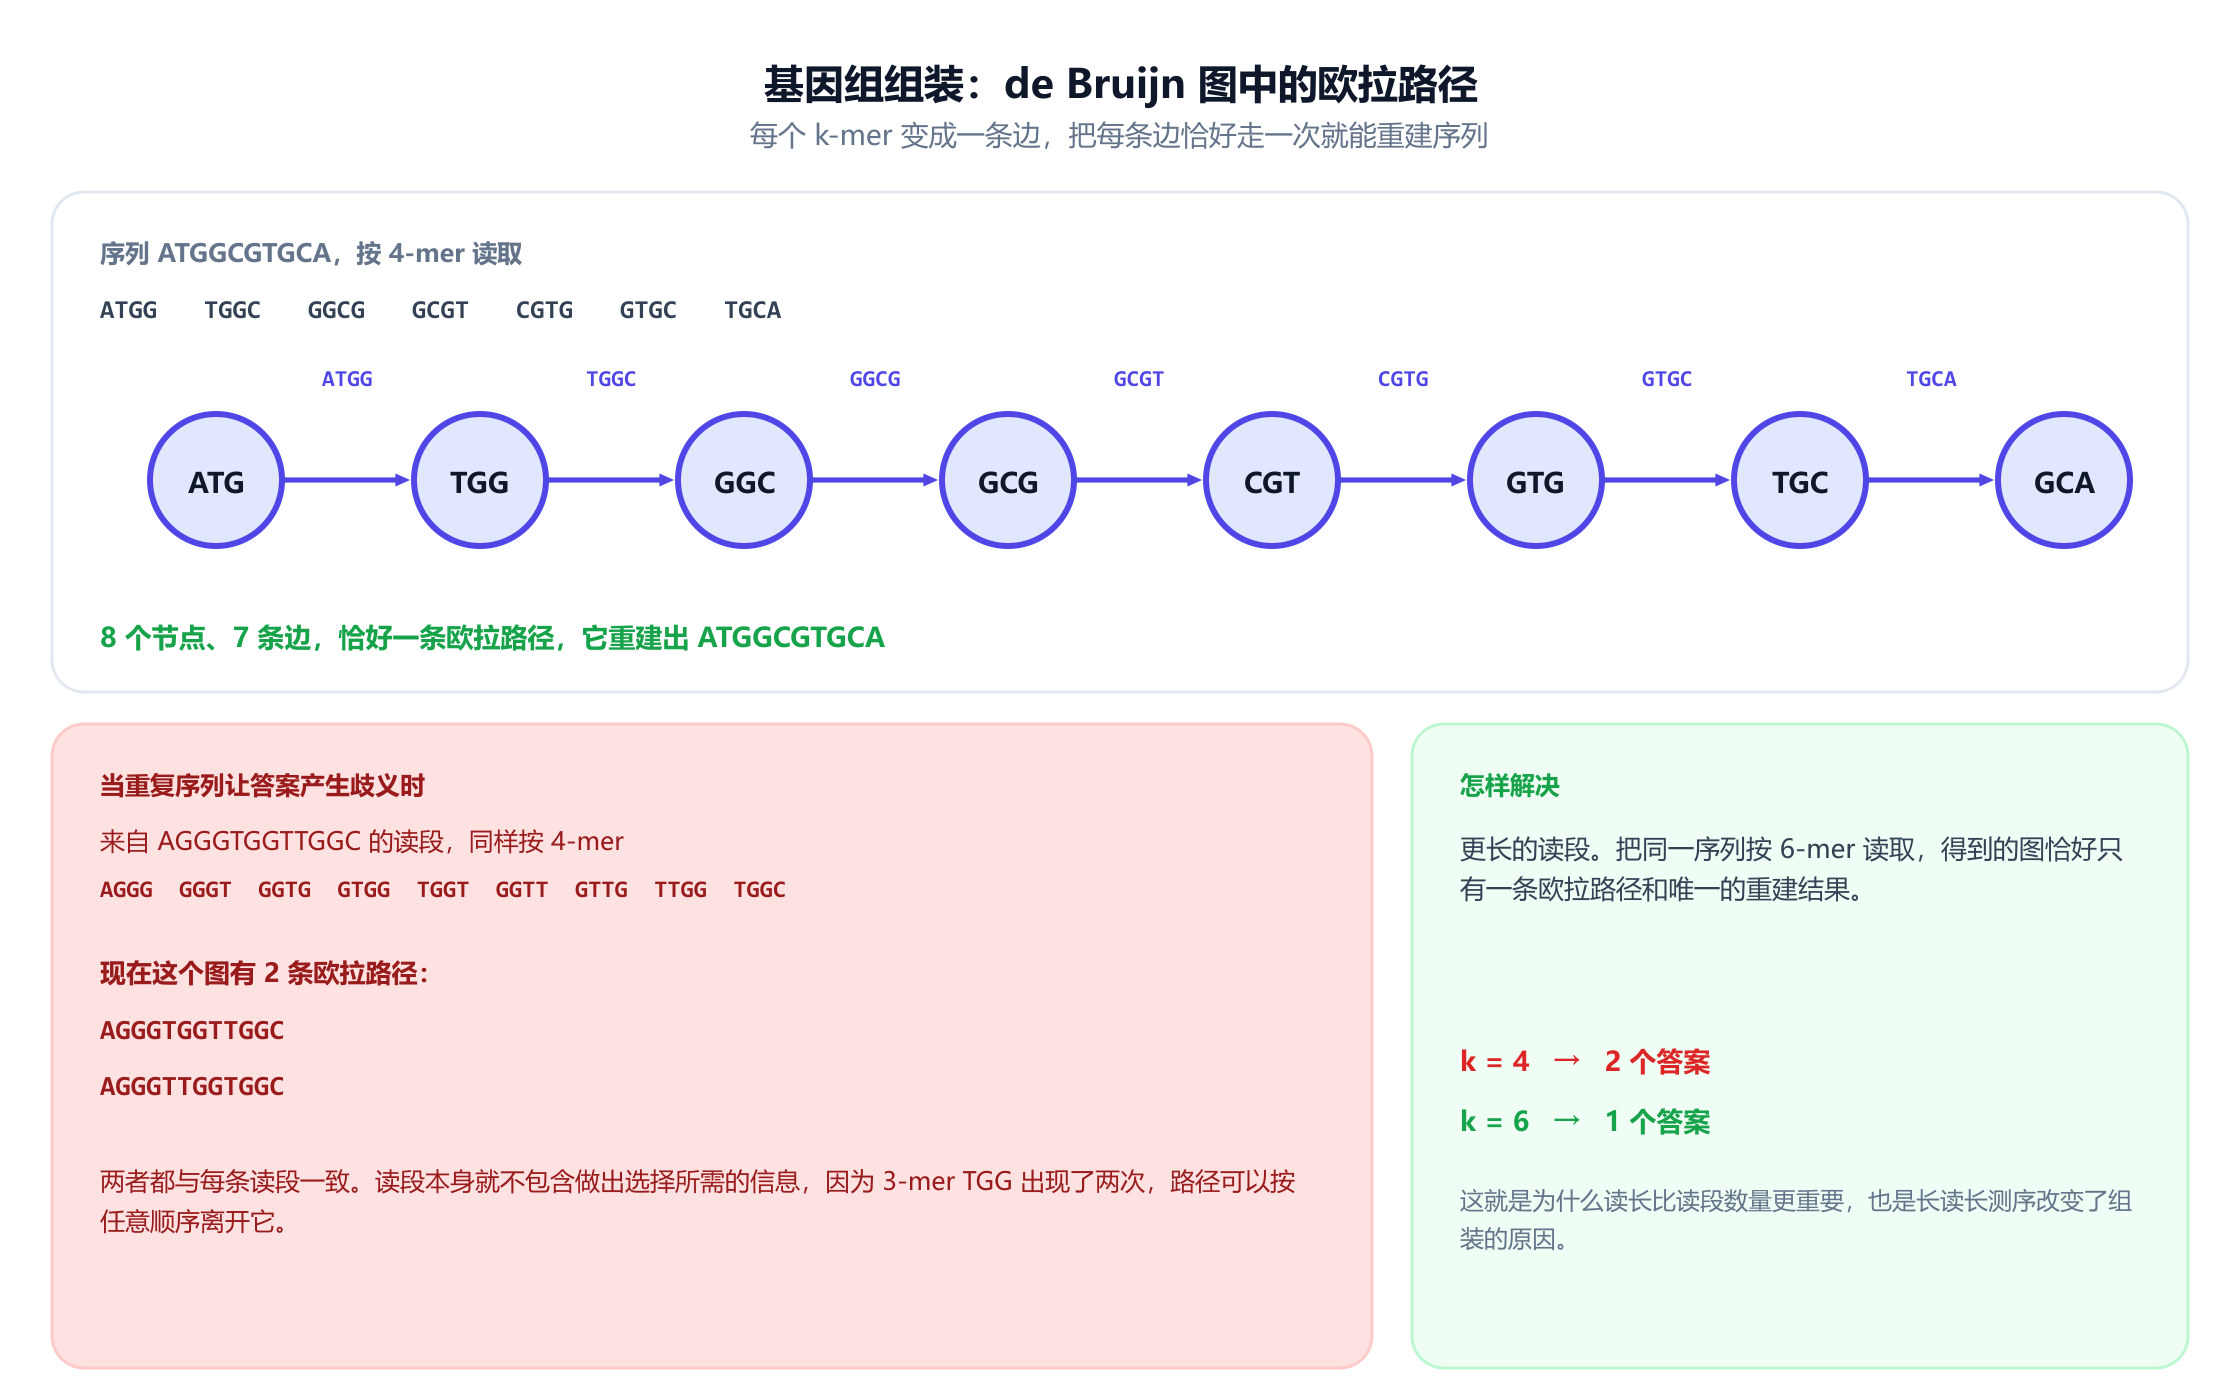
取序列 ATGGCGTGCA,按 4-mer 读取。这得到七个 k-mer、一张有 8 个顶点和 7 条边的图,以及恰好一条欧拉路径,它把原始序列重新拼写出来。组装成功了,而它成功是因为这张图有唯一的答案。
现在取 AGGGTGGTTGGC,同样按 4-mer 读取。这张图有两条欧拉路径,分别拼出 AGGGTGGTTGGC 和 AGGGTTGGTGGC。两者都与观测到的每条读段一致。这不是算法的失败,也没有更好的算法能解决它:3-mer TGG 出现了两次,行走不止一次到达这个顶点,而读段中没有任何信息说明第一次该从哪个方向离开。歧义存在于数据之中。
解决它的是更长的读段。按 6-mer 读取同一序列,得到的图恰好只有一条欧拉路径和唯一的重建结果。这就是测序行业十五年来一直追求读长而非读段数量的原因,也是人类基因组直到 2022 年才被宣布完整、从端粒到端粒没有缺口的原因,距离第一份草图已经过去了二十多年。缺失的片段都是重复序列,而重复序列恰恰是让欧拉行走产生歧义的结构。
这里有一段精彩的算法史。寻找欧拉路径很容易:线性时间,存在条件自欧拉时代就已知道。看似自然的另一种做法,是构建一张图,让每个读段成为一个顶点,并把重叠的读段连起来,这就需要一条访问每个顶点恰好一次的行走,也就是哈密顿路径,属于 NP 完全问题。同一个生物学任务的两种表述,一种可解,一种无望,区别只在于把读段当作边还是当作顶点。
8. 序列比对是一条最短路径
比较两条序列是生物学中运行次数最多的计算。每次 BLAST 查询都在做它,每个读段比对工具都在做它,每一个关于两个基因同源的论断都建立在它之上。标准算法是 Needleman 和 Wunsch 的算法,发表于 1970 年,到处都被当作矩阵上的动态规划来讲授。值得看清的是,这个矩阵就是一张图。
建一个网格,每对位置 (i, j)对应一个顶点,含义是“序列一的前 i 个字母已与序列二的前 j 个字母完成比对”。从每个顶点引出三条弧:向右,表示序列二的一个字母对一个空位;向下,表示序列一的一个字母对一个空位;对角线,表示两个字母对齐。给每条弧一个代价,匹配的对角线为零,其余为一。最佳比对现在就是从左上角到右下角代价最小的路径,任何最短路径算法都能找到它。
将 GATTACA 与 GCATGCU 比对,会构建一个有 64 个顶点和 161 条弧的网格图。Needleman-Wunsch 返回的编辑距离为 4。在这张图上做最短路径搜索,完全不用动态规划表,结果同样是 4。两者一致,因为它们是同一个计算:网格是无环的,所以按顺序填表恰好就是按拓扑序松弛各条弧。
把它看成图并不是花招。它解释了 Smith 和 Waterman 1981 年的局部比对算法为何有效:允许路径在任何地方重新开始,就等于从源点向每个顶点添加一条零代价的弧。它解释了仿射空位罚分,这需要三层网格而不是一层,因为状态必须记住空位是否已经打开。它还解释了为什么比对的代价是两条序列长度的乘积,因为那就是图的大小,这也是快速比对工具会避免构建其中大部分的原因。
9. 系统发育:从天文数字般的候选中选出一棵树
系统发育树是一张没有环的图:叶子是观察到的物种,内部顶点是未被观察到的祖先,边长衡量进化上的分歧。从现存序列重建这样一棵树,是进化生物学的核心推断问题,而它的难度首先是一个计数问题。
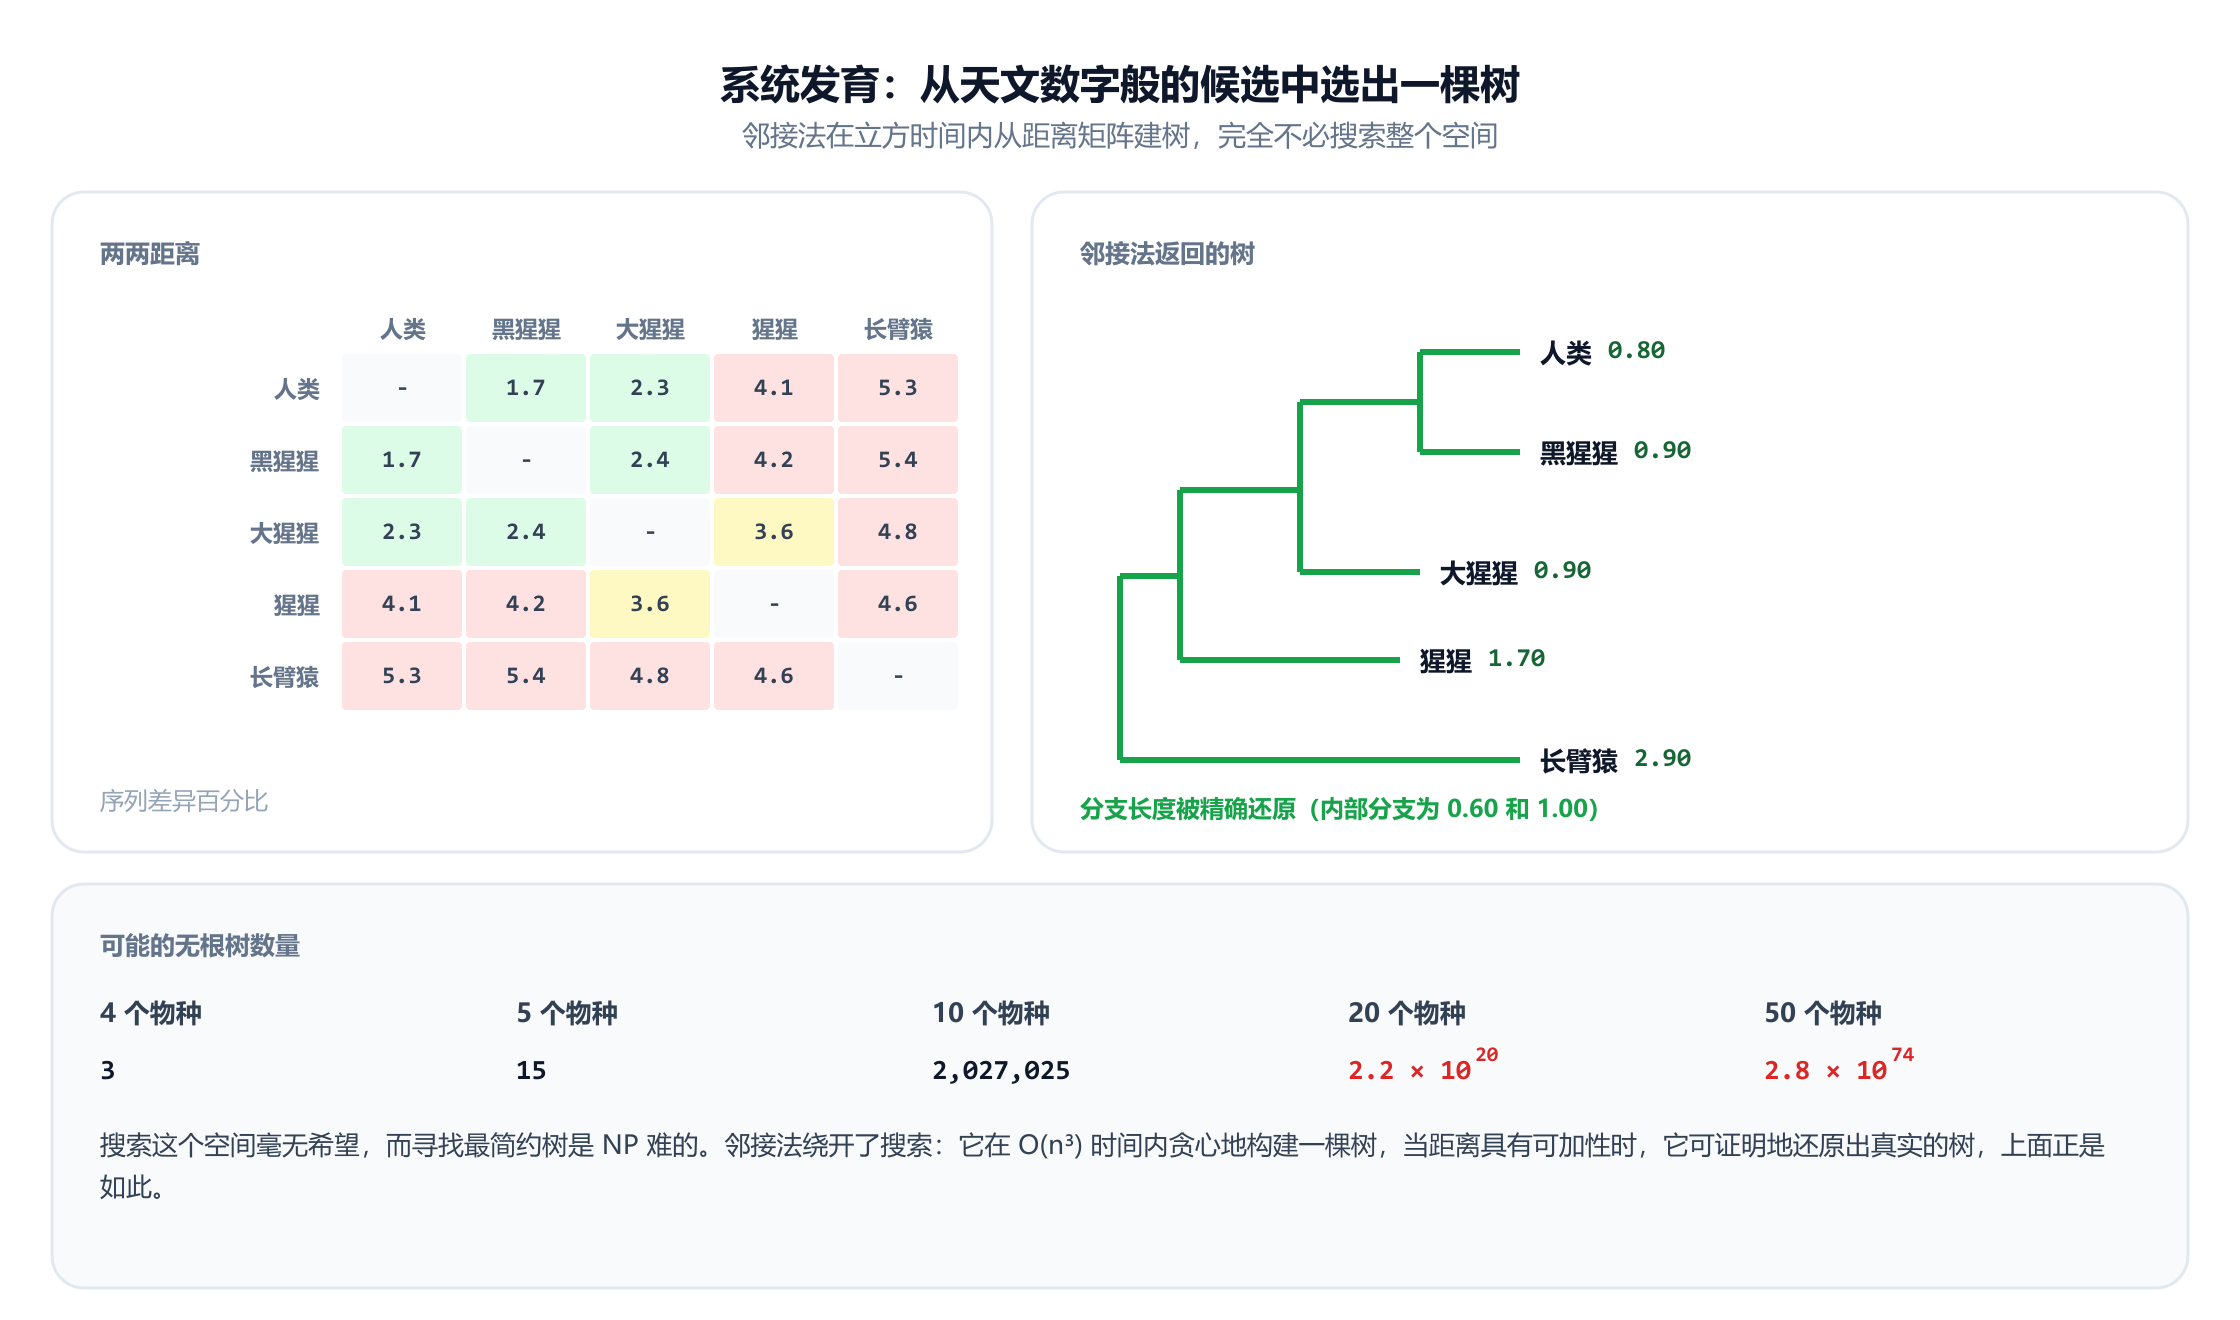
n 个物种上不同的无根二叉树的数量,由 Felsenstein 在 1978 年列表给出,是双阶乘 (2n-5)!!,它会爆炸式增长。四个物种有 3 棵树。五个有 15 棵。十个有 2,027,025 棵。二十个约有 2.2 x 10²⁰ 棵。五十个物种大约有 2.8 x 1074 棵,比可观测宇宙中的原子还多得多。其中每一棵都是候选答案,而系统发育研究通常涉及数百个分类单元。
因此穷举搜索不只是慢,而是永远不可能,情况还更糟:寻找最简约树,也就是所需进化变化最少的那棵树,后来被证明是 NP 难的,最大似然树搜索也好不到哪里去。
Saitou 和 Nei 的邻接法发表于 1987 年,是整个生物学中被引用最多的论文之一,它完全绕开了搜索。它接受一个两两距离矩阵,反复把按特定准则判定为邻居的那对分类单元连接起来,合并成一个节点,直到剩下一棵树。它从不枚举备选方案,运行时间是立方级的。
在图中五种灵长类动物的距离矩阵上,它先把猩猩与长臂猿连接,再把人类与黑猩猩连接,然后把大猩猩与猩猩和长臂猿组连接,并且精确还原了每一个分支长度。这种精确不是运气。当距离是可加的,也就是说它们本来就来自某棵树时,邻接法可证明地会返回那棵树。从真实序列估计的真实距离只是近似可加,这就是为什么实际的系统发育研究用邻接法快速得到一棵起始树,再在似然模型下加以优化,也是为什么同一个数据集可能支持不同的已发表树。
10. 食物网与灭绝级联
从细胞内部转到整个生态系统,数学并没有改变。食物网是一张有向图:每个物种一个顶点,只要后者吃前者,就有一条从被捕食者指向捕食者的弧。没有猎物的物种是基础物种,也就是植物、藻类或碎屑,其他一切最终都依赖它们。
这里的模型有十二个物种和十七条取食关系,底层是藻类和碎屑,顶层是水獭、苍鹭和狗鱼。这张图给出的第一样东西是营养级,计算方法是一加上该物种所吃的所有东西的平均营养级。基础物种位于 1.00,食草动物位于 2.00,顶级捕食者则落在分数值上:狗鱼 4.50,水獭 4.75,苍鹭 4.33。分数营养级不是计算的假象。对一个同时在多个营养级上取食的杂食动物来说,这才是诚实的答案。
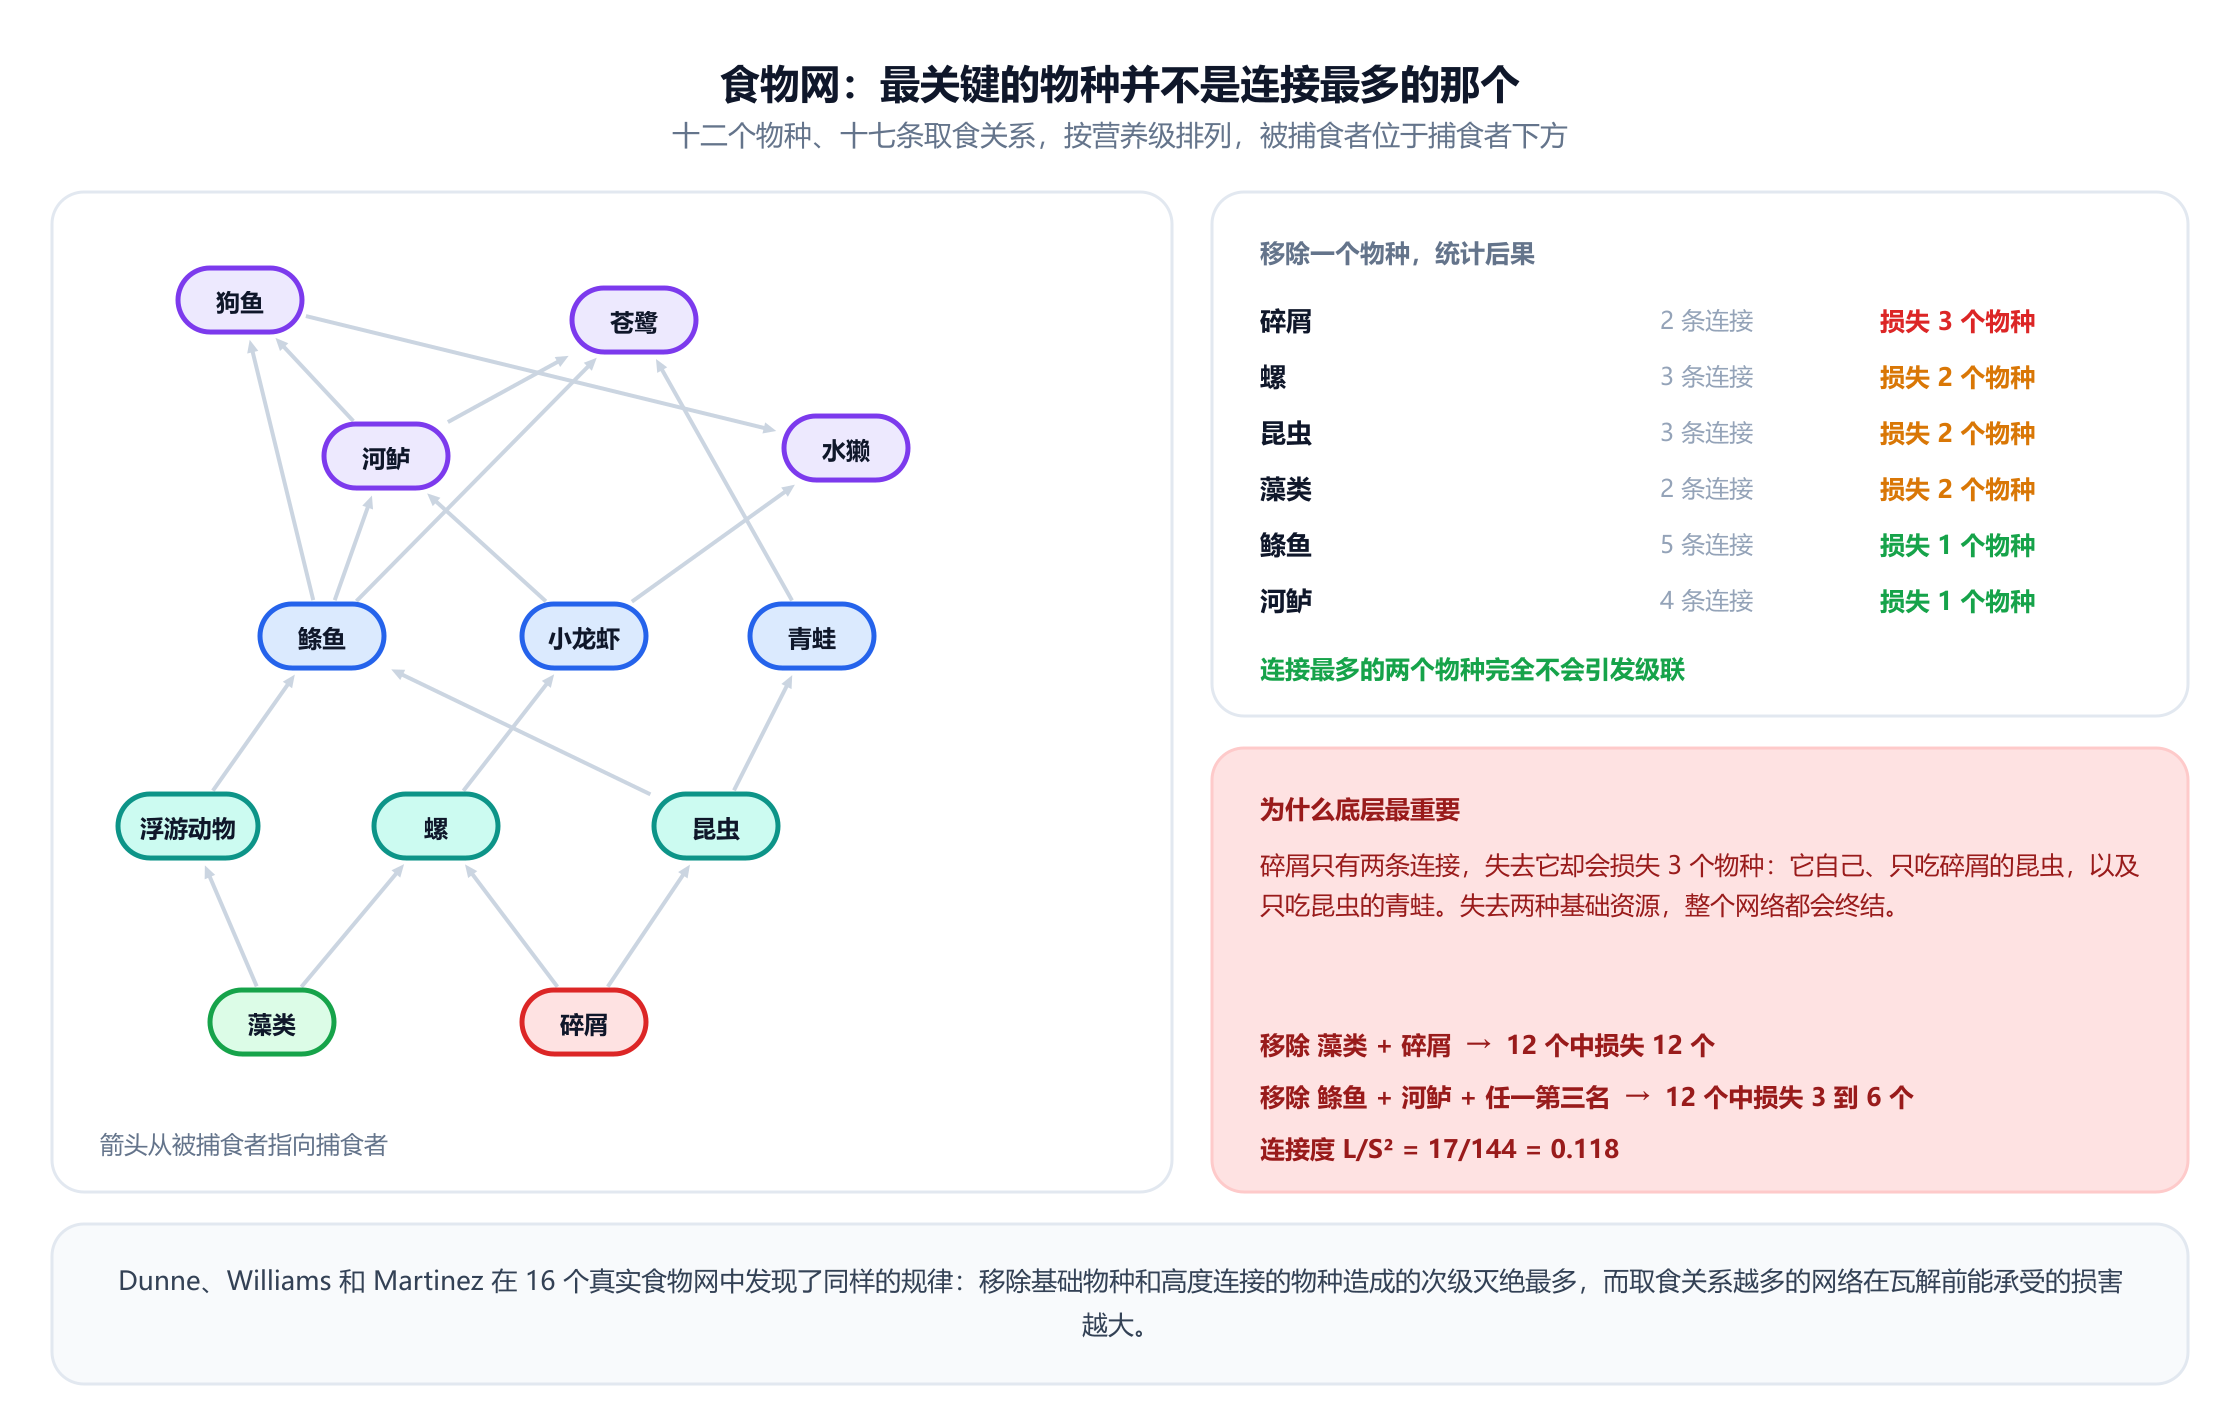
对保护工作真正重要的问题是:一个物种消失之后会发生什么。删除一个顶点,再删除所有因此无物可吃的物种,重复这一过程直到网络稳定。这些后续损失就是次级灭绝,它们正是生态系统崩溃速度快于其直接压力所暗示的原因。
这个网络上的结果以一种具体而有用的方式违反直觉。鲦鱼有五条取食关系,是连接最多的物种。移除它,别的都不会死:所有吃鲦鱼的物种也吃别的东西。移除苍鹭或水獭这两种顶级捕食者,同样没有后续损失。现在移除碎屑,它只有两条连接,也没有人为它发起保护运动。总共有三个物种消失:碎屑本身,然后是只吃碎屑的昆虫,再然后是只吃昆虫的青蛙。一个只有两条边的顶点,造成的破坏比有五条边的顶点还大。
这个规律可以推广。基础物种之所以承重,是因为它们之上的一切都依赖它们,而一个连接众多的消费者处在图中能提供替代的部分。移除两种基础物种,藻类和碎屑,会损失全部十二个物种。移除连接最多的物种造成的损失反而更小,而且这个数字甚至并不确定:鲦鱼和河鲈在连接数上领先,但有五个物种并列第三,加上其中哪一个,总数就在三到六之间变动。基部那两个毫不起眼的物种,造成的破坏至少是它的两倍。
Dunne、Williams 和 Martinez 在 2002 年对十六个真实食物网报告了完全相同的结论,并补充了第二个值得记住的发现:稳健性随连接度的增加而增强,连接度是连接数除以物种数的平方。取食关系更多的网络在瓦解前能承受更多损害,因为更多物种有替代选择。这里建模的网络连接度为 0.118,正好落在真实食物网的报告范围之内。
实践上的教训是,依据魅力、体型甚至连接数来决定保护优先级,衡量的都是错误的量。损失会向外蔓延的物种,要通过在图上模拟移除才能找到,而答案往往是某种微小而不讨喜的东西。
11. 连接组与流行病
还有两个领域值得一提,因为它们都重复使用了前面介绍过的工具。
连接组。神经系统是一张由突触连接神经元构成的有向加权图。第一个完整的连接组由 White、Southgate、Thomson 和 Brenner 在 1986 年发表:线虫 C. elegans,302 个神经元,约 7,000 个连接,用十多年时间根据电子显微照片手工重建而成。人类研究的分辨率要粗得多,以脑区为顶点,以纤维束或相关活动为边,但分析方法就是第 3 节的那一套:度、聚类、路径长度、模块、枢纽。
Bullmore 和 Sporns 在 2009 年阐述了这一研究方向,反复出现的发现是,大脑是小世界且模块化的,有一个由高度数脑区紧密互连构成的核心,即“富人俱乐部”,承担了不成比例的长距离信息流。多种精神和神经疾病表现为图统计量的改变。这些是群体层面的相关性,而不是对个人的诊断,而且值得知道的是,功能连接组在很大程度上取决于分析者选定的相关阈值,阈值一变,统计量也会跟着变。
流行病。疾病沿接触图传播,而图的结构对结果的决定作用不亚于病原体本身。Pastor-Satorras 和 Vespignani 在 2001 年证明了一个惊人的结果:在度分布无标度且方差无界的网络上,经典的流行病阈值消失了。在教科书中那些均匀混合的模型里,传播率足够低的感染会自行消亡;在这样的网络上却不会,因为枢纽让它一直存活。这改变了疫苗接种策略,因为给高度数个体接种,甚至给随机选中个体的熟人接种(他们成为高度数个体的概率高于随机),在剂量相同的情况下胜过随机接种。
同样的数学在细胞生物学中以信号传播的形式重现,在计算机安全中以恶意软件传播的形式重现。图并不在乎顶点代表什么。
12. 什么容易,什么困难
把一个生物学问题表述成图的问题,并不会让它变得可解。它让困难变得可见,这更有用,而难易的边界往往出现在出人意料的地方。
容易,指多项式时间,大规模计算也是家常便饭。度、聚类系数和连通分量几乎不费成本。最短路径以及比对都很便宜。借助 Brandes 算法,稀疏图上的介数中心性运行时间与顶点数和边数的乘积成正比。欧拉路径是线性的,生成树和网络流是多项式的,邻接法是立方级的。本文解决的所有问题都属于这一类,而且都能在一台笔记本电脑上扩展到有数百万条边的图。
困难,指 NP 难,预计不存在多项式算法。寻找最简约的系统发育树。寻找彼此全部相互作用的最大物种集合,也就是最大团。判断一个网络是否是另一个网络的子图,这是更大模式模体搜索的基础。寻找哈密顿路径,这正是组装的重叠表述被放弃的原因。精确形式的最优图划分。
有两点观察让这条边界不像听起来那么令人沮丧。第一,生物学中的困难问题通常用启发式方法处理,它们在实际出现的实例上效果很好:系统发育从邻接法的起点出发做爬山搜索,模体搜索工具则巧妙地枚举,对三节点和四节点的模式已经足够。第二,同一生物学任务的可解表述与不可解表述之间的差别,往往只是一个建模选择,组装中把 k-mer 当作边的决定就是例证。在写代码之前认清自己站在边界的哪一侧,就是最大的收获。
13. 建模错误
从生物网络得出的错误结论,大多源于五个错误。它们没有一个是罕见的,而且至今仍见诸出版物。
把汇总网络当作快照。已发表的 PPI 网络是许多实验的并集,来自不同的细胞类型、不同的条件、跨越数十年。它的边从未同时存在过。在它上面计算最短路径,就等于假设每个相互作用都同时可用,而这是错误的。有条件特异数据时,按条件过滤;没有时,把基于路径的结论当作假设。
忽视研究偏倚。被充分研究的蛋白质有更多已知相互作用,是因为有更多人去找,而不一定是因为它们有更多真实伙伴。任何得出“连接最多的蛋白质就是重要蛋白质”这一结论的分析,在一定程度上只是重新发现了这个领域的发表史。检验方法是看你的结果在网络被限制到单个无偏筛选时是否依然成立。
与错误的零模型比较。这是第 6 节模体部分的教训,它适用于一切场合。真实的生物网络有枢纽和重尾的度分布。把任何结构统计量与均匀随机图比较,它都会显得非同寻常。比较必须保留你不检验的那些特征,这通常意味着保留度序列。
把相关性当作边。基因共表达网络把在样本间表达水平相关的基因连接起来。相关不是调控,而且所得的图是无向的,而调控是有向的。这类网络适合用来产生假设,但若当作机制来解读则会一再误导。同样的谨慎也适用于由相关脑活动构建的功能连接组。
过度解读无标度的说法。生物网络具有重尾度分布,这一观察稳健而重要。更强的说法,即它们服从干净的幂律,已多次因统计原因受到质疑,尤其是 Broido 和 Clauset 在 2019 年发现,在数千个经验网络中严格的幂律很少见。本文中有用的结论,即枢纽的必需性以及失效与攻击之间的不对称,只需要重尾,而不需要确切的函数形式。主张重尾,而不是主张幂律。
14. 从模型到实践
给准备在真实数据上构建这类图的人的一个简短流程。
在接触数据之前,用一句话写下顶点是什么,再用一句话写下边的含义。大多数混乱的分析都可以追溯到一张边有两种不同含义的图,比如“结合”混进了“相关”,或“吃”混进了“竞争”。如果这句话很难写,说明这张图还没准备好。
根据生物学理由决定有向还是无向、加权还是不加权。而不是根据软件的默认设置。下游的每个指标都继承这一选择,在本应有向的图上算出的介数分数不是近似值,而是另一个量。
先计算便宜的描述性统计量。顶点数和边数、度分布、分量数、聚类系数、路径长度。这些只需几秒钟,就能立即发现数据问题:意外出现的第二个分量通常意味着标识符不匹配,可疑的高平均度通常意味着边重复了。
在计算你关心的统计量之前选好零模型。而不是在看到结果之后。
扰动后重新运行。随机删掉 10% 的边,重新计算你的核心结论。生物网络既不完整又有噪声,一个在去掉十分之一数据后就重新洗牌的排名,是样本的性质,而不是生物体的性质。
如果你想在把这些算法应用到生物数据之前先建立直觉,本站的交互式可视化工具可以让你在自己画的图上逐步运行广度优先搜索、 Dijkstra 算法和最小生成树构建,这是最快体会这些方法实际在做什么的方式。
15. 常见问题
图论在生物学中是如何使用的?
+
只要生物对象之间存在相互作用,就用得上。相互结合的蛋白质构成无向网络,彼此调控的基因构成有向网络,DNA 读段构成 de Bruijn 图,其欧拉路径就是组装好的基因组,物种及其祖先构成进化树,互相捕食的物种构成食物网。在每种情况下,生物学提供顶点和边,标准算法随后回答这些问题:哪些组件是必需的,哪些模式被过度代表,哪条序列能解释读段,哪棵树能解释距离,以及哪次灭绝会引发级联。
什么是枢纽蛋白,枢纽为什么重要?
+
枢纽是相互作用伙伴远多于平均水平的蛋白质。它们之所以重要,源于一项实验结果:Jeong、Mason、Barabasi 和 Oltvai 在 2001 年表明,伙伴越多的酵母蛋白质越有可能是必需的,也就是说没有它们细胞就会死亡。枢纽还解释了为什么网络在随机损伤和定向损伤下表现如此不同。在本文的无标度网络上,随机移除 20% 的蛋白质后仍有 78% 的网络保持连通,而移除度最高的 20% 后只剩 9%。
什么是网络模体?
+
一种在真实网络中出现的频率高于度完全相同的随机化网络的小子图。随机化正是关键:与普通随机图比较,几乎任何模式都会显得显著,因为真实网络有枢纽而随机网络没有。在这里的八基因网络中,前馈环出现了五次,而随机化均值为 1.80、标准差为 1.22,z 分数为 2.63,1,000 个随机化副本中只有 17 个达到五个或更多。模体之所以重要,是因为它们的功能可以推导出来:相干前馈环会忽略短暂脉冲,只对持续信号做出响应。
为什么基因组组装是一个欧拉路径问题?
+
这取决于图的构建方式。把每个读段切成长度为 k 的重叠子串,再让每个 k-mer 成为一条边,从由其前 k-1 个字母组成的顶点指向由其后 k-1 个字母组成的顶点。于是,把每个读段恰好使用一次,就等于把每条边恰好使用一次,这就是欧拉路径,可以在线性时间内求解。自然的另一种做法,是让每个读段成为顶点并把重叠的读段连起来,这就需要把每个顶点恰好访问一次,也就是哈密顿路径,属于 NP 完全问题。同一个生物学任务是可解还是无望,只取决于读段变成了边还是顶点。
为什么重复序列会让组装产生歧义?
+
因为重复序列会让行走不止一次到达同一个顶点,而读段中没有任何信息说明应该先从哪条路离开。在本文中,序列 AGGGTGGTTGGC 按 4-mer 读取后得到的图有两条欧拉路径,分别拼出 AGGGTGGTTGGC 和 AGGGTTGGTGGC,两者都与每条读段完全一致。没有任何算法能在两者之间做出选择,因为歧义在数据中,而不在方法中。按 6-mer 读取同一序列则恰好只有一个重建结果,这就是为什么读长比读段数量更重要,也是长读长测序改变了组装的原因。
系统发育树有多少棵,生物学家如何找到其中一棵?
+
n 个物种上的无根二叉树数量是双阶乘 (2n-5)!!,它的增长超出了任何搜索的可能:四个物种 3 棵,五个 15 棵,十个 2,027,025 棵,二十个约 2.2 x 10^20 棵,五十个约 2.8 x 10^74 棵。寻找最简约树是 NP 难的。Saitou 和 Nei 在 1987 年发表的邻接法完全避开了搜索:它按特定准则反复连接最近的一对,在立方时间内构建出唯一一棵树。当距离具有可加性时,它可证明地还原出真实的树,本文中五种灵长类动物的矩阵正是如此,每个分支长度都被精确还原。
食物网中哪个物种最重要?
+
不是连接最多的那个。在本文的十二物种食物网中,鲦鱼的取食关系最多,有五条,但移除它根本不会造成次级灭绝,因为所有吃它的物种也吃别的东西。移除只有两条连接的碎屑则会损失三个物种:碎屑本身,然后是只吃碎屑的昆虫,再然后是只吃昆虫的青蛙。移除两种基础物种会损失全部十二个,而移除连接最多的两个物种再加上任意第三个,会损失三到六个。重要性是图中位置的属性,必须通过模拟移除来发现,而不是靠数连接。
生物网络真的是无标度的吗?
+
它们具有重尾的度分布,这一点已被充分证实。更强的说法,即它们服从干净的幂律,已因统计原因受到质疑,尤其是 Broido 和 Clauset 在 2019 年发现,在数千个经验网络中严格的幂律很少见。这比听起来的影响要小,因为实际用到的结论只需要重尾:只要大多数顶点边很少、一小部分顶点边很多,就足以产生枢纽的必需性,以及随机失效与定向攻击之间的不对称。稳妥的立场是主张重尾,而不是主张幂律。
16. 参考文献
本文结果所依据的论文,按时间顺序排列。
- Sylvester, J. J. (1878). “Chemistry and algebra.” Nature, 17, 284.
- Needleman, S. B. and Wunsch, C. D. (1970). “A general method applicable to the search for similarities in the amino acid sequence of two proteins.” Journal of Molecular Biology, 48(3), 443–453.
- Freeman, L. C. (1977). “A set of measures of centrality based upon betweenness.” Sociometry, 40(1), 35–41.
- Felsenstein, J. (1978). “The number of evolutionary trees.” Systematic Zoology, 27(1), 27–33.
- Smith, T. F. and Waterman, M. S. (1981). “Identification of common molecular subsequences.” Journal of Molecular Biology, 147(1), 195–197.
- White, J. G., Southgate, E., Thomson, J. N. and Brenner, S. (1986). “The structure of the nervous system of the nematode Caenorhabditis elegans.” Philosophical Transactions of the Royal Society B, 314(1165), 1–340.
- Saitou, N. and Nei, M. (1987). “The neighbor-joining method: a new method for reconstructing phylogenetic trees.” Molecular Biology and Evolution, 4(4), 406–425.
- Watts, D. J. and Strogatz, S. H. (1998). “Collective dynamics of small-world networks.” Nature, 393, 440–442.
- Albert, R., Jeong, H. and Barabási, A.-L. (2000). “Error and attack tolerance of complex networks.” Nature, 406, 378–382.
- Jeong, H., Tombor, B., Albert, R., Oltvai, Z. N. and Barabási, A.-L. (2000). “The large-scale organization of metabolic networks.” Nature, 407, 651–654.
- Jeong, H., Mason, S. P., Barabási, A.-L. and Oltvai, Z. N. (2001). “Lethality and centrality in protein networks.” Nature, 411, 41–42.
- Brandes, U. (2001). “A faster algorithm for betweenness centrality.” Journal of Mathematical Sociology, 25(2), 163–177.
- Pevzner, P. A., Tang, H. and Waterman, M. S. (2001). “An Eulerian path approach to DNA fragment assembly.” Proceedings of the National Academy of Sciences, 98(17), 9748–9753.
- Pastor-Satorras, R. and Vespignani, A. (2001). “Epidemic spreading in scale-free networks.” Physical Review Letters, 86(14), 3200–3203.
- Milo, R., Shen-Orr, S., Itzkovitz, S., Kashtan, N., Chklovskii, D. and Alon, U. (2002). “Network motifs: simple building blocks of complex networks.” Science, 298(5594), 824–827.
- Shen-Orr, S. S., Milo, R., Mangan, S. and Alon, U. (2002). “Network motifs in the transcriptional regulation network of Escherichia coli.” Nature Genetics, 31(1), 64–68.
- Dunne, J. A., Williams, R. J. and Martinez, N. D. (2002). “Network structure and biodiversity loss in food webs: robustness increases with connectance.” Ecology Letters, 5(4), 558–567.
- Barabási, A.-L. and Oltvai, Z. N. (2004). “Network biology: understanding the cell's functional organization.” Nature Reviews Genetics, 5(2), 101–113.
- Yildirim, M. A., Goh, K.-I., Cusick, M. E., Barabási, A.-L. and Vidal, M. (2007). “Drug-target network.” Nature Biotechnology, 25(10), 1119–1126.
- Bullmore, E. and Sporns, O. (2009). “Complex brain networks: graph theoretical analysis of structural and functional systems.” Nature Reviews Neuroscience, 10(3), 186–198.
- Compeau, P. E. C., Pevzner, P. A. and Tesler, G. (2011). “How to apply de Bruijn graphs to genome assembly.” Nature Biotechnology, 29(11), 987–991.
- Broido, A. D. and Clauset, A. (2019). “Scale-free networks are rare.” Nature Communications, 10, 1017.