
目录
1. 简短的答案
一种中心性度量为图中的每个顶点给出一个分数,表示它有多重要。不存在唯一正确的分数,因为“重要”可以有几种不同的含义:拥有许多连接,离所有人都近,位于其他人之间的路线上,或者与本身就重要的人相连。每一种想法都是一种不同的度量,在同一个网络上它们可能选出不同的赢家。
| 度量 | 它回答的问题 | 代价 | 适用场景 |
|---|---|---|---|
| 度 | 谁的直接连接最多? | O(V + E) | 快速的初步观察;直接的可达范围 |
| 接近中心性 | 谁能用最少的步数到达所有人? | O(V(V + E)) | 从一处快速传播某种东西 |
| 介数 | 谁位于其他顶点对之间的路线上? | O(VE) 无权图 | 瓶颈、中间人、单一控制点 |
| 特征向量 | 谁与人脉广的人相连? | O(E) 每次迭代 | 无向网络上的影响力 |
| PageRank | 随机浏览者在哪里停留的时间最长? | O(V + E) 每次迭代 | 有向网络:链接、引用 |
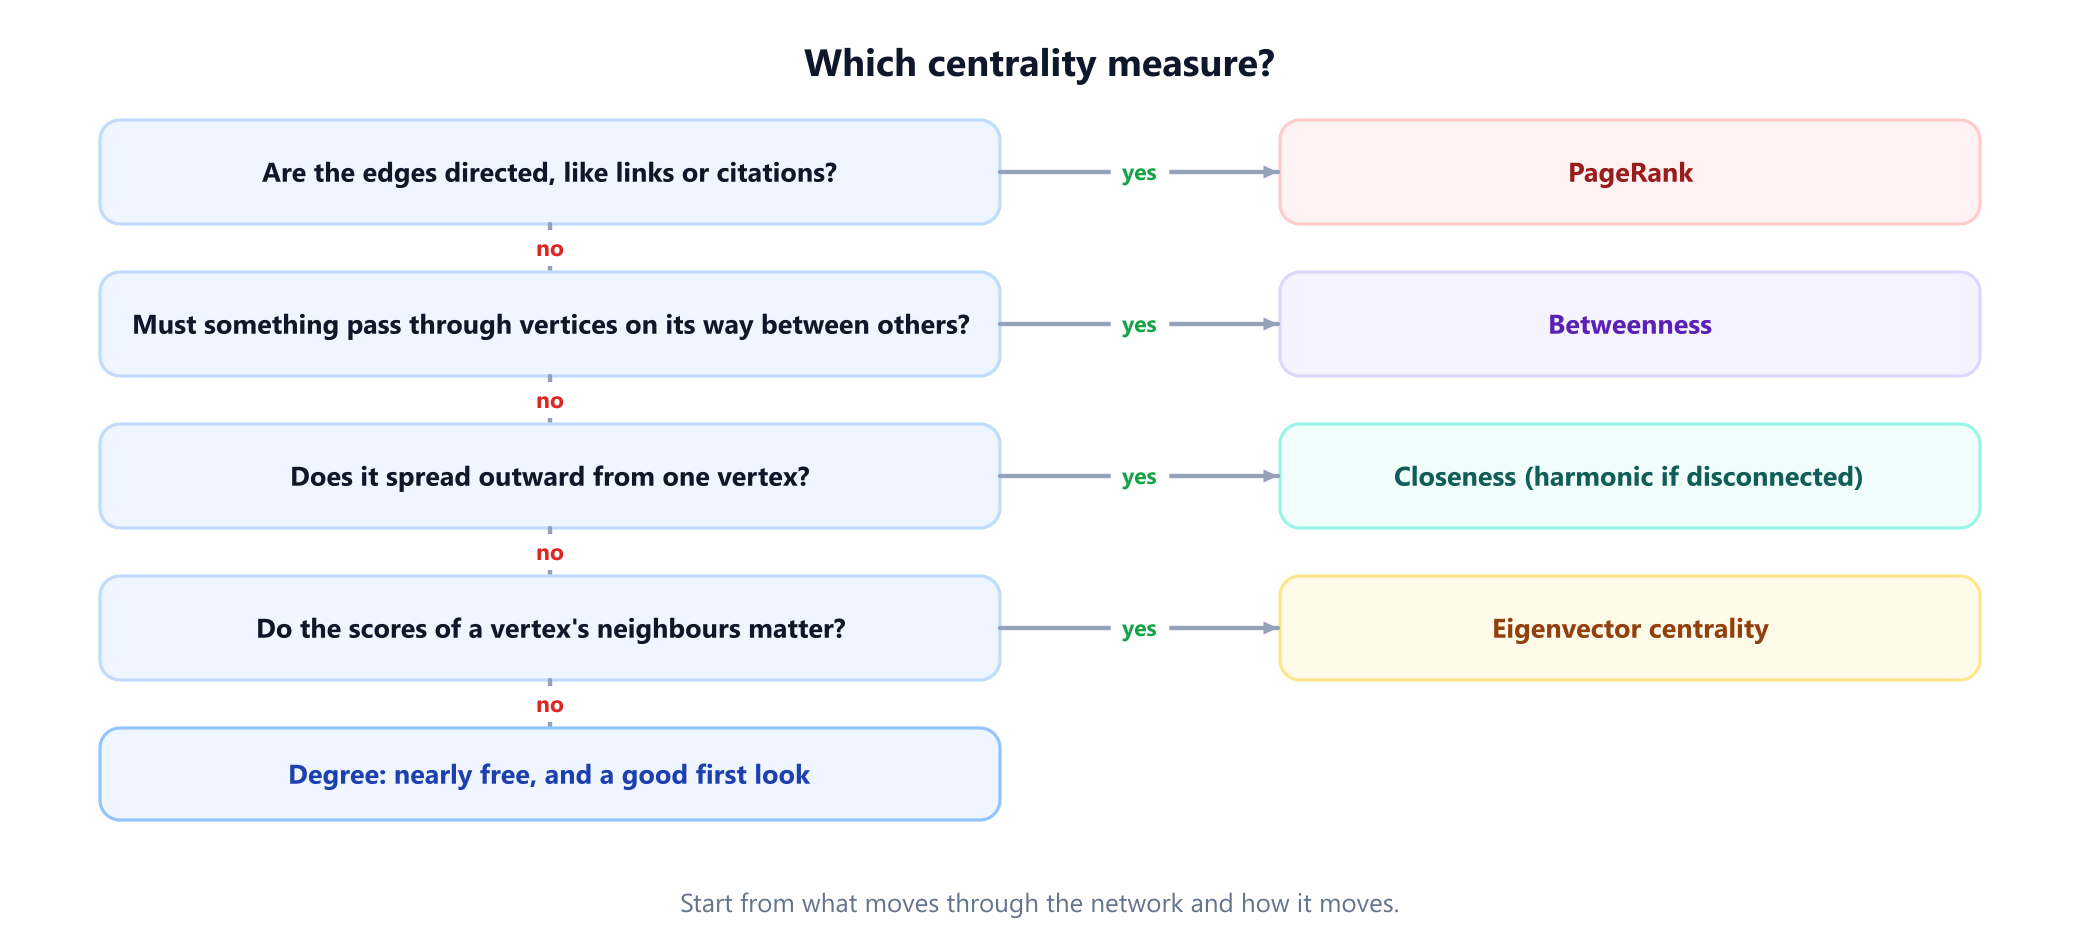
一句话概括:先确定什么东西在你的网络中流动以及如何流动,再选择能对其建模的度量。如果你只想要一个起点,先计算度,因为它几乎不花成本,而其他度量最好理解为对它的修正。下面的判定图把这条建议变成了四个问题。
2. 一家公司,四个赢家
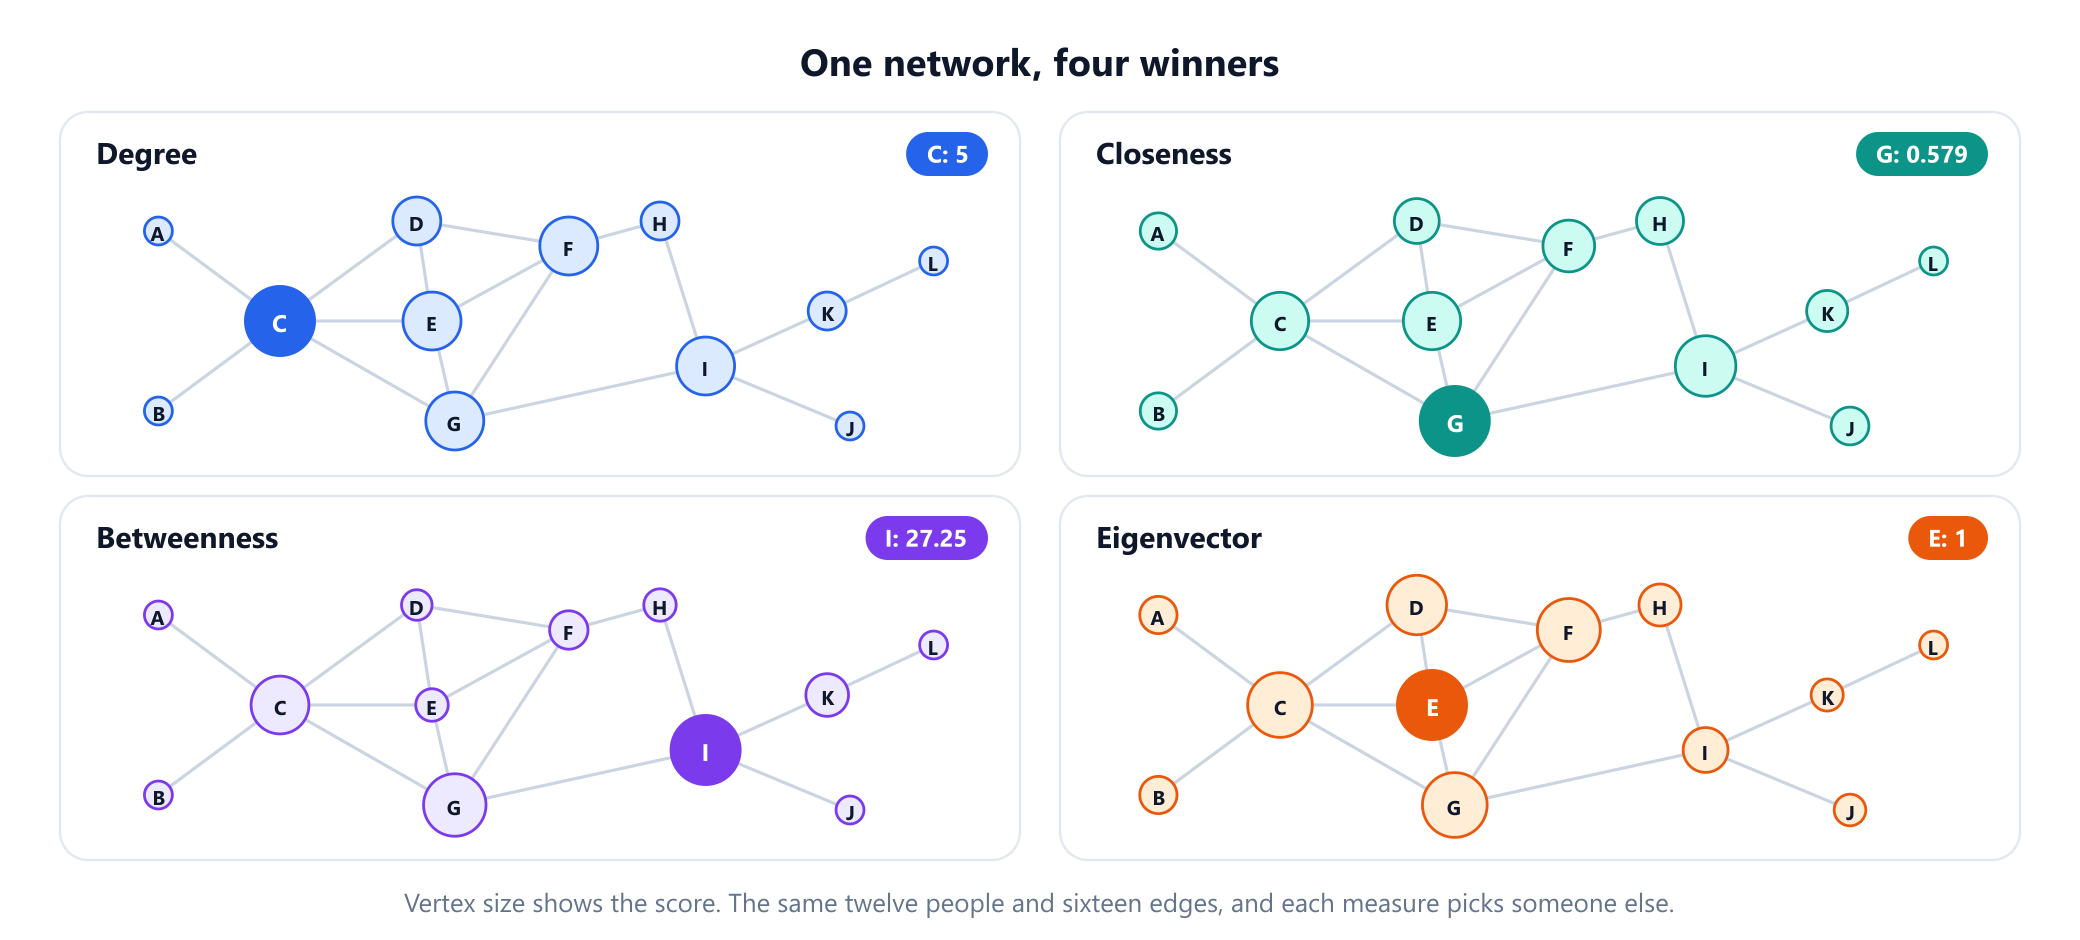
贯穿全文的示例是一家有十二个人的公司,成员从 A 到 L,两个人如果直接共事,他们之间就有一条边。它有 16 条边,是通过计算机搜索找到的:要求在这个小网络上,度、接近中心性、介数和特征向量中心性各自选出不同的人。这扩展了 David Krackhardt 1990 年“风筝”网络的思路,那是一个十人网络,度、接近中心性和介数在上面偏向不同的人。
| 人员 | 度 | 接近中心性 | 介数 | 特征向量 |
|---|---|---|---|---|
| A | 1 | 0.344 | 0 | 0.262 |
| B | 1 | 0.344 | 0 | 0.262 |
| C | 5 | 0.500 | 20.33 | 0.921 |
| D | 3 | 0.407 | 1.75 | 0.796 |
| E | 4 | 0.500 | 3.08 | 1.000 |
| F | 4 | 0.458 | 7.08 | 0.879 |
| G | 4 | 0.579 | 23.50 | 0.922 |
| H | 2 | 0.423 | 3.00 | 0.376 |
| I | 4 | 0.524 | 27.25 | 0.444 |
| J | 1 | 0.355 | 0 | 0.126 |
| K | 2 | 0.379 | 10.00 | 0.137 |
| L | 1 | 0.282 | 0 | 0.039 |
四个答案都是正确的。 C 的联系人最多,其中两人不认识其他任何人。 G 能以最少的总步数到达整个公司。 I 是 J、 K 和 L 与公司其余部分之间唯一的纽带。而 E 位于紧密团体的中心。注意每个赢家在其他度量上的表现有多差: E 的介数排第六,而 I 的特征向量中心性排第六。第 3 节到第 5 节解释每一列,并给出生成它的代码。
3. 度与接近中心性:联系人与可达范围
度中心性是与一个顶点相连的边数,关于顶点的度的指南对此有深入讲解。它只看一步之内,所以几乎不花成本,但会忽略邻居之外的一切。 C 以 5 获胜;在有向图上,它分为入度和出度。
接近中心性考察每一个顶点。对于连通图中的顶点 v,把从 v 到其他所有顶点的最短距离加起来,再取倒数,使得分越高表示越近: (n - 1) / 距离之和。距离由从每个顶点出发的广度优先搜索得到。下面的程序保存为 people.py,因为后面的程序会导入它。
from collections import deque

# 十二人公司中谁与谁直接共事。
PEOPLE = 'AC BC CD CE CG DE DF EF EG FG FH GI HI IJ IK KL'.split()

def graph(edges):
    adj = {}
    for a, b in edges:
        adj.setdefault(a, []).append(b)
        adj.setdefault(b, []).append(a)
    return adj

def distances(adj, source):
    """广度优先搜索:从 source 到它能到达的每个顶点的步数。"""
    dist, queue = {source: 0}, deque([source])
    while queue:
        v = queue.popleft()
        for w in adj[v]:
            if w not in dist:
                dist[w] = dist[v] + 1
                queue.append(w)
    return dist

def degree(adj):
    return {v: len(adj[v]) for v in adj}

def closeness(adj):
    """(可达顶点数) / (到它们的距离之和):若 adj 不连通,结果会产生误导。"""
    result = {}
    for v in adj:
        dist = distances(adj, v)
        result[v] = (len(dist) - 1) / sum(dist.values()) if len(dist) > 1 else 0.0
    return result

def harmonic(adj):
    """对所有其他顶点取 1 / 距离 的平均值;不可达的顶点贡献 0。"""
    n = len(adj)
    return {v: sum(1 / d for d in distances(adj, v).values() if d) / (n - 1) for v in adj}

def winner(score):
    return max(sorted(score), key=score.get)

if __name__ == '__main__':
    adj = graph(PEOPLE)
    d, c, h = degree(adj), closeness(adj), harmonic(adj)
    print('most contacts: ', winner(d), d[winner(d)])
    print('closest to all:', winner(c), round(c[winner(c)], 3))
    # 加入一对只彼此合作的外包人员。
    split = graph(PEOPLE + ['XY'])
    c2, h2 = closeness(split), harmonic(split)
    print('naive closeness, X:', round(c2['X'], 3), ' G:', round(c2['G'], 3))
    print('harmonic,        X:', round(h2['X'], 3), ' G:', round(h2['G'], 3))
# most contacts:  C 5
# closest to all: G 0.579
# naive closeness, X: 1.0  G: 0.579
# harmonic,        X: 0.077  G: 0.564
G 到其他十一个人总共需要 19 步,所以它的接近中心性是 11 / 19 = 0.579。
输出的最后两行展示了标准陷阱。接近中心性假设每个人都能到达每个人。加入一对外包人员 X 和 Y,他们只彼此合作,那么常见的变通做法,即只对可达顶点求和,会给 X 打出 1.0 的满分,远高于 G,仅仅因为它所在的小连通分量只有一步宽。调和中心性解决了这个问题:它对所有其他顶点取 1 / 距离 的平均值,因此不可达的顶点贡献 0。它只给 X 0.077 分,而 G 仍保持在 0.564。这一度量最早由 Massimo Marchiori 和 Vito Latora 于 2000 年提出;Paolo Boldi 和 Sebastiano Vigna 在 2014 年研究了中心性度量应满足哪些条件,发现在他们测试的度量中,只有它满足全部三条公理。只要图可能不连通,就使用它;关于连通分量的指南说明了如何检查。
4. 介数:路线经过谁
介数中心性提出的是另一个问题:如果每个人都沿最短路线给其他每个人发送一条消息,其中有多少条会经过 v?对每一对顶点 s、 t (不包括 v),计算所有最短 s-t 路径中经过 v的路径所占的比例,再把这些比例加起来。比例很重要:在正方形 S、 X、 T、 Y中,从 S 到 T有两条同样短的路线,因此 X 和 Y 从这一对中各得半分。
如果直接计数,这需要 O(V³) 甚至更多的时间。2001 年,Ulrik Brandes 展示了如何在无权图上以 O(VE) 的时间完成:从每个源点运行一次广度优先搜索,然后从最远的顶点往回走。关键在于,每个顶点向上传递的贡献可以由它下方各顶点的贡献算出,而不必为每个目标重新计算。
from collections import deque
from people import PEOPLE, graph

def betweenness(adj, sources=None):
    """适用于无向无权图的 Brandes 算法。

    sources=None 时使用每个顶点,结果精确。传入源点列表则得到估计值。"""
    sources = list(adj) if sources is None else sources
    score = dict.fromkeys(adj, 0.0)
    for s in sources:
        # 第 1 阶段:从 s 运行 BFS,统计最短路径数 (sigma) 并记录前驱。
        order, preds, sigma, dist = [], {v: [] for v in adj}, dict.fromkeys(adj, 0), {s: 0}
        sigma[s] = 1
        queue = deque([s])
        while queue:
            v = queue.popleft()
            order.append(v)
            for w in adj[v]:
                if w not in dist:
                    dist[w] = dist[v] + 1
                    queue.append(w)
                if dist[w] == dist[v] + 1:
                    sigma[w] += sigma[v]
                    preds[w].append(v)
        # 第 2 阶段:从最远的顶点往回走,把贡献传给前驱。
        delta = dict.fromkeys(adj, 0.0)
        for w in reversed(order):
            for v in preds[w]:
                delta[v] += sigma[v] / sigma[w] * (1 + delta[w])
            if w != s:
                score[w] += delta[w]
    scale = len(adj) / len(sources) / 2          # 每一对都会从两端各被看到一次
    return {v: x * scale for v, x in score.items()}

if __name__ == '__main__':
    b = betweenness(graph(PEOPLE))
    for v in sorted(b, key=b.get, reverse=True)[:5]:
        print(v, round(b[v], 2))
    print(betweenness(graph('SX XT SY YT'.split())))   # 从 S 到 T 有两条等长路线
# I 27.25
# G 23.5
# C 20.33
# K 10.0
# F 7.08
# {'S': 0.5, 'X': 0.5, 'T': 0.5, 'Y': 0.5}
每次搜索都会把每一对计算两次,两端各一次,这就是程序在无向图上除以 2 的原因。在带权图上,用 Dijkstra 代替广度优先搜索,时间变为 O(VE + V² log V)。
I 在最多可能的 55 分中得到 27.25 分,55 是不包含 I的顶点对的数量,因此其他顶点对之间约有一半的最短路线经过它。在这 27.25 分中,有 26 分来自涉及 J、 K 或 L的顶点对,他们没有别的出路。 I 只有四个联系人,与 E、 F 和 G一样多,这正是度看不出来的。
5. 特征向量中心性:你的联系人是谁
度把所有联系人都看作同等重要。特征向量中心性则认为一个联系人的价值等于这个联系人自身的得分,因此一个顶点的得分与其邻居得分之和成正比: x = (1 / λ) A x,其中 A 是邻接矩阵。这使得 x 成为 A的一个特征向量。在连通的无向图上,Perron-Frobenius 定理保证,在相差一个缩放因子的意义下,恰好存在一个所有分量都为正的特征向量,它对应最大的特征值,这就是得分。Phillip Bonacich 在 1972 年使它成为网络分析的标准工具,不过 John Seeley 早在 1949 年就在社会测量数据上用过类似的得分。
计算它的标准方法是幂迭代:从相等的得分开始,把每个得分替换为其邻居得分之和,重新缩放,然后重复。
from people import PEOPLE, graph

def eigenvector(adj, shift=1.0, steps=2000):
    """在 A + shift * I 上做幂迭代,缩放使最高得分为 1。"""
    x = dict.fromkeys(adj, 1.0)
    for _ in range(steps):
        y = {v: shift * x[v] + sum(x[u] for u in adj[v]) for v in adj}
        top = max(y.values())
        x = {v: y[v] / top for v in y}
    return x

if __name__ == '__main__':
    e = eigenvector(graph(PEOPLE))
    for v in sorted(e, key=e.get, reverse=True)[:4]:
        print(v, round(e[v], 3))
    # 没有 shift 时,二分图可能让迭代永远来回跳动。
    path = graph('AB BC CD'.split())
    x = {'A': 1.0, 'B': 0.0, 'C': 0.0, 'D': 0.0}
    for step in range(1, 52):
        y = {v: sum(x[u] for u in path[v]) for v in path}
        top = max(y.values())
        x = {v: y[v] / top for v in y}
        if step >= 50:
            print('step', step, {v: round(x[v], 3) for v in sorted(x)})
    print('with the shift', {v: round(s, 3) for v, s in sorted(eigenvector(path).items())})
# E 1.0
# G 0.922
# C 0.921
# F 0.879
# step 50 {'A': 0.618, 'B': 0.0, 'C': 1.0, 'D': 0.0}
# step 51 {'A': 0.0, 'B': 1.0, 'C': 0.0, 'D': 0.618}
# with the shift {'A': 0.618, 'B': 1.0, 'C': 1.0, 'D': 0.618}
E 获胜,尽管 C 的联系人更多,而 G 离所有人都更近。 E的四个联系人得分之和为 3.519。 G的四个联系人加起来只有 3.244,因为其中一个是 I,它只得 0.444 分,并且通向公司的边缘。
输出还说明了代码为什么要加上 shift。在二分图上, A 有一个大小相等、符号相反的特征值,所以普通的幂迭代可能永远不会稳定下来:在一条有四个顶点的路径上,从单个顶点出发,得分会在两种状态之间永远跳动,每一步都有一半的得分为 0。用 A + I 迭代会把每个特征值都增加 1,消除这种并列,同时保持特征向量不变。关于谱图理论的指南介绍了其他特征值能告诉你什么。
在有向图上,这一度量会失效:没有任何顶点指向的顶点得分为 0,只被它指向的那些顶点也同样得 0。Leo Katz 1953 年的度量避免了这个问题:它统计进入一个顶点的每一条途径,长度为 k 的途径按 α^k加权。用现代形式写出来是 x = α Aᵀ x + 1,其中 α 小于 1 / λ,这相当于给每个顶点一小份免费的得分。PageRank 又做了进一步的改变。
6. PageRank:沿着链接走
PageRank由 Sergey Brin 和 Larry Page 于 1998 年发表,是为万维网设计的;在万维网中,一个页面上的链接就是对另一个页面的投票。Katz 的度量在这里有一个缺陷:一个链接到一千个其他页面的页面会把它的全部得分传给其中每一个。PageRank 让每个页面把自己的得分分摊给它的各条出链。
通常的图景是一个随机浏览者。每一步,浏览者以概率 d(即阻尼系数)沿当前页面上随机的一条链接前进,否则就跳到一个均匀随机选出的页面。一个页面的排名值是长期来看停留在它上面的时间比例。在所有排名值之和为 1 的归一化形式中:
rank(p) = (1 - d) / n + d * rank(q) / outdegree(q) 之和,q 取遍所有链接到 p 的页面示例是一个由八个页面组成的网络。每个页面都能到达其他所有页面,因此没有页面被隔断。Brin 和 Page 报告说,他们通常把 d 设为 0.85,程序也这样做。
# 八个网页,以及每个网页链接到的页面。
WEB = {'A': 'CH', 'B': 'CDEH', 'C': 'A', 'D': 'C', 'E': 'D', 'F': 'BDG', 'G': 'D', 'H': 'AF'}

def pagerank(links, d=0.85, tol=1e-10):
    """幂迭代。没有出链的页面把它的排名值分给每个页面。"""
    pages = sorted(links)
    n = len(pages)
    rank = dict.fromkeys(pages, 1 / n)
    steps = 0
    while True:
        dangling = sum(rank[p] for p in pages if not links[p])
        new = dict.fromkeys(pages, (1 - d) / n + d * dangling / n)
        for p in pages:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        change = sum(abs(new[p] - rank[p]) for p in pages)
        rank, steps = new, steps + 1
        if change < tol:
            return rank, steps

if __name__ == '__main__':
    rank, steps = pagerank(WEB)
    inlinks = {p: sum(p in out for out in WEB.values()) for p in WEB}
    for p in sorted(rank, key=rank.get, reverse=True):
        print(p, 'in-links', inlinks[p], ' rank', round(rank[p], 3))
    print('iterations', steps, ' total', round(sum(rank.values()), 6))
# A in-links 2  rank 0.293
# C in-links 3  rank 0.247
# H in-links 2  rank 0.152
# D in-links 4  rank 0.111
# F in-links 1  rank 0.084
# B in-links 1  rank 0.042
# G in-links 1  rank 0.042
# E in-links 1  rank 0.028
# iterations 70  total 1.0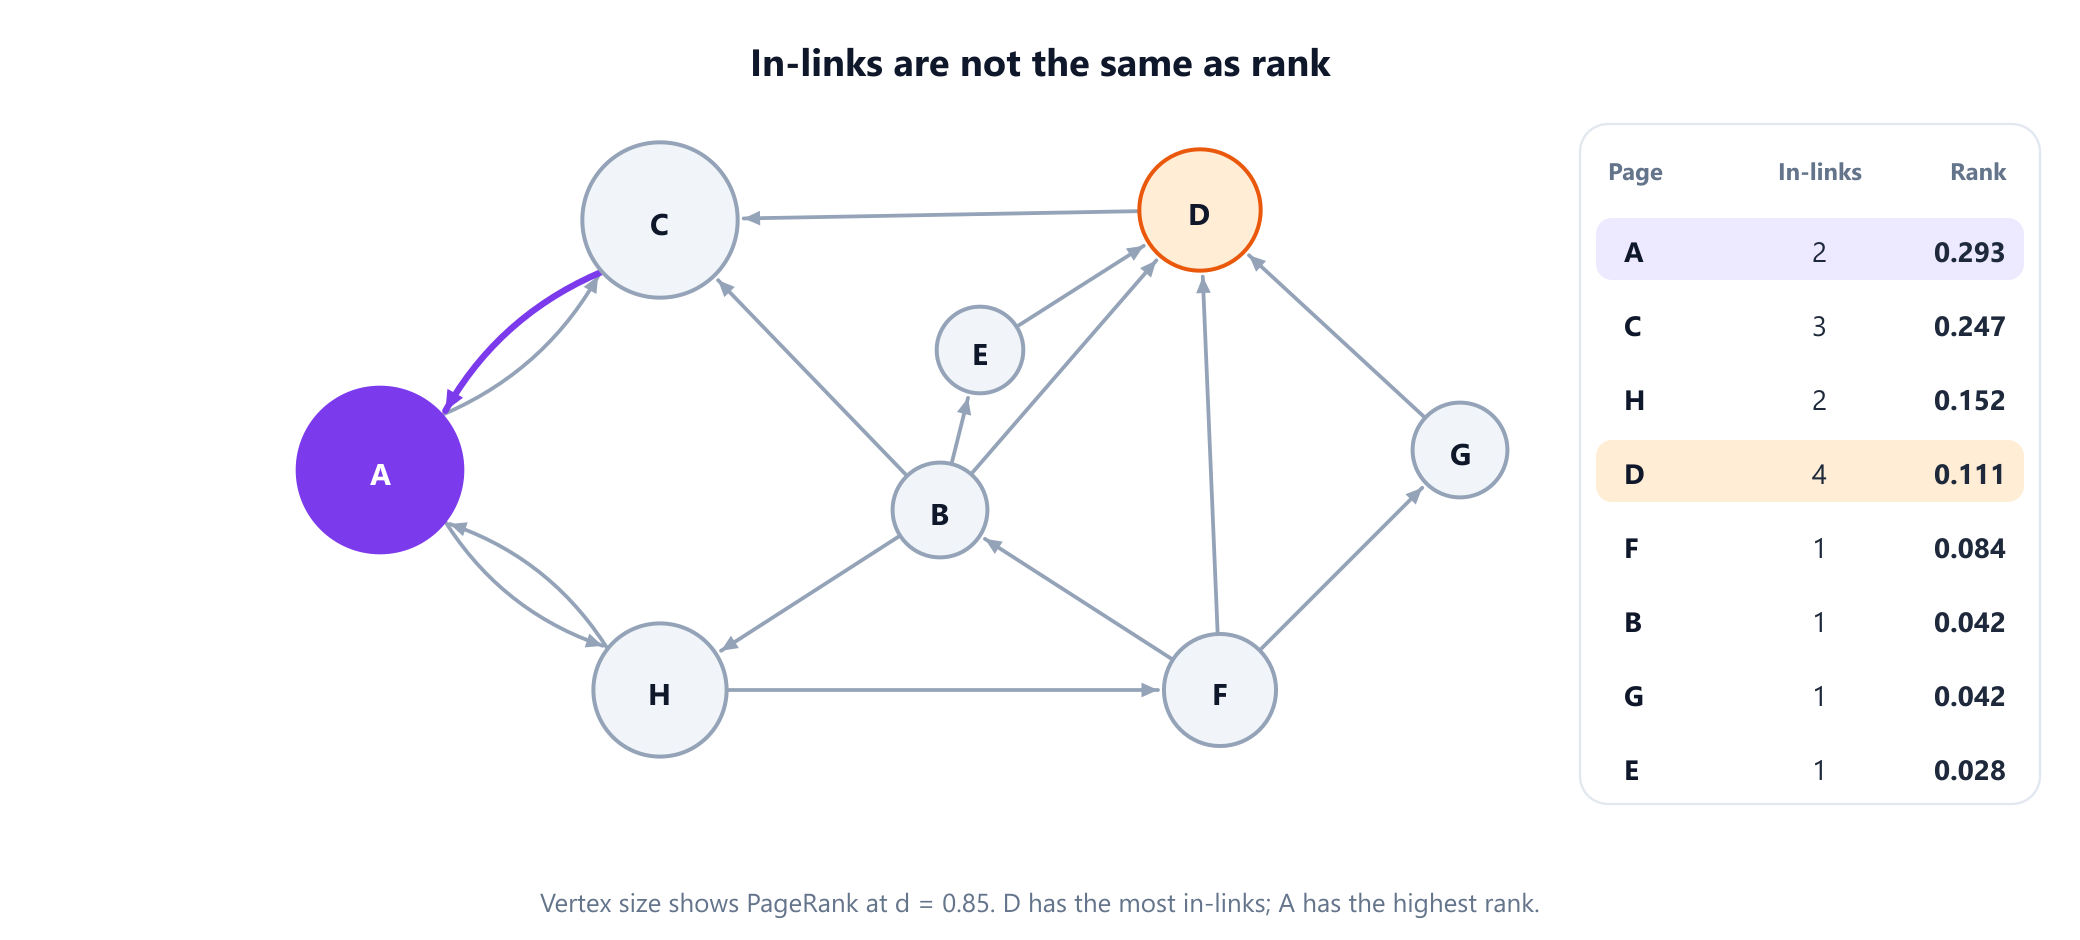
D 的入链最多,共四条,但这些链接来自几乎没有排名值可给的页面,而 B 和 F 又把自己的排名值分给了好几条链接。 D 随后把自己的全部排名值传给 C,而 C 又把自己的全部排名值传给 A。所以 A虽然只有两条入链,却以 0.293 排第一,并且 A 和 C 合计占总量的 54%。在无向图上,情况要简单得多:在连通的非二分图上取 d = 1 时,PageRank 与度严格成正比。PageRank 主要是一种用于有向图的度量,关于有向图与无向图的指南解释了这一区别为何重要。
7. 死胡同、封闭回路与阻尼系数
阻尼系数不是装饰。有两类页面会破坏单纯的“沿链接前进”过程,下一个程序用这两种方式分别破坏示例网络。
from pagerank import WEB, pagerank

def leaky(links, d=0.85, steps=200):
    """教科书式的更新,不处理死胡同。"""
    n = len(links)
    rank = dict.fromkeys(links, 1 / n)
    for _ in range(steps):
        new = dict.fromkeys(links, (1 - d) / n)
        for p in links:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        rank = new
    return rank

if __name__ == '__main__':
    dead_end = {**WEB, 'A': ''}                    # A 不再链接到任何页面
    print('dead end, naive update:   total', round(sum(leaky(dead_end).values()), 3))
    print('dead end, handled:        total', round(sum(pagerank(dead_end)[0].values()), 3))
    closed = {**WEB, 'A': 'C'}                     # A 和 C 现在只互相链接
    for d in (0.85, 0.999):
        rank = pagerank(closed, d=d, tol=1e-9)[0]
        print(f'closed loop, d = {d}: A + C hold', round(rank['A'] + rank['C'], 3))
# dead end, naive update:   total 0.403
# dead end, handled:        total 1.0
# closed loop, d = 0.85: A + C hold 0.791
# closed loop, d = 0.999: A + C hold 0.998所谓死胡同,是指没有出链的页面。教科书式的更新无处发送它的排名值,于是排名值从系统中漏掉:把 A 变成死胡同后,总量从 1 降到 0.403。修正方法已用在上面的 pagerank 函数中:把死胡同的排名值分给所有页面,就像浏览者从那里随机跳转一样。
所谓封闭回路,是指只互相链接的一组页面。浏览者一旦进入,只有随机跳转才能让它离开。让 A 只链接到 C,这一对页面在 d = 0.85时占据全部排名值的 79.1%,在 d = 0.999时占 99.8%。 d 越小,回路能吸收的就越少。
较大的 d 的代价是速度。排名值的变化量每一步至少缩小到原来的 d 倍,这与 Taher Haveliwala 和 Sepandar Kamvar 的结果一致:PageRank 矩阵第二特征值的绝对值至多为 d。下一个程序在一个由 1,000 个页面组成、分为 20 个网站的网络上测量这一点。
import random

def web(sites, size, rnd):
    """页面大多链接到自己网站内部;大约十分之一的页面会链接到另一个网站。"""
    links = {}
    for s in range(sites):
        for i in range(size):
            out = {s * size + rnd.randrange(size) for _ in range(5)}
            if rnd.random() < 0.1:
                out.add(rnd.randrange(sites * size))
            links[s * size + i] = sorted(out - {s * size + i})
    return links

def steps_needed(links, d, tol=1e-6):
    n = len(links)
    rank, step = dict.fromkeys(links, 1 / n), 0
    while True:
        lost = sum(rank[p] for p in links if not links[p])
        new = dict.fromkeys(links, (1 - d) / n + d * lost / n)
        for p in links:
            for q in links[p]:
                new[q] += d * rank[p] / len(links[p])
        change = sum(abs(new[p] - rank[p]) for p in links)
        rank, step = new, step + 1
        if change < tol:
            return step

if __name__ == '__main__':
    links = web(20, 50, random.Random(5))
    for d in (0.5, 0.85, 0.95, 0.99):
        print('d =', d, ' iterations:', steps_needed(links, d))
# d = 0.5  iterations: 13
# d = 0.85  iterations: 53
# d = 0.95  iterations: 149
# d = 0.99  iterations: 607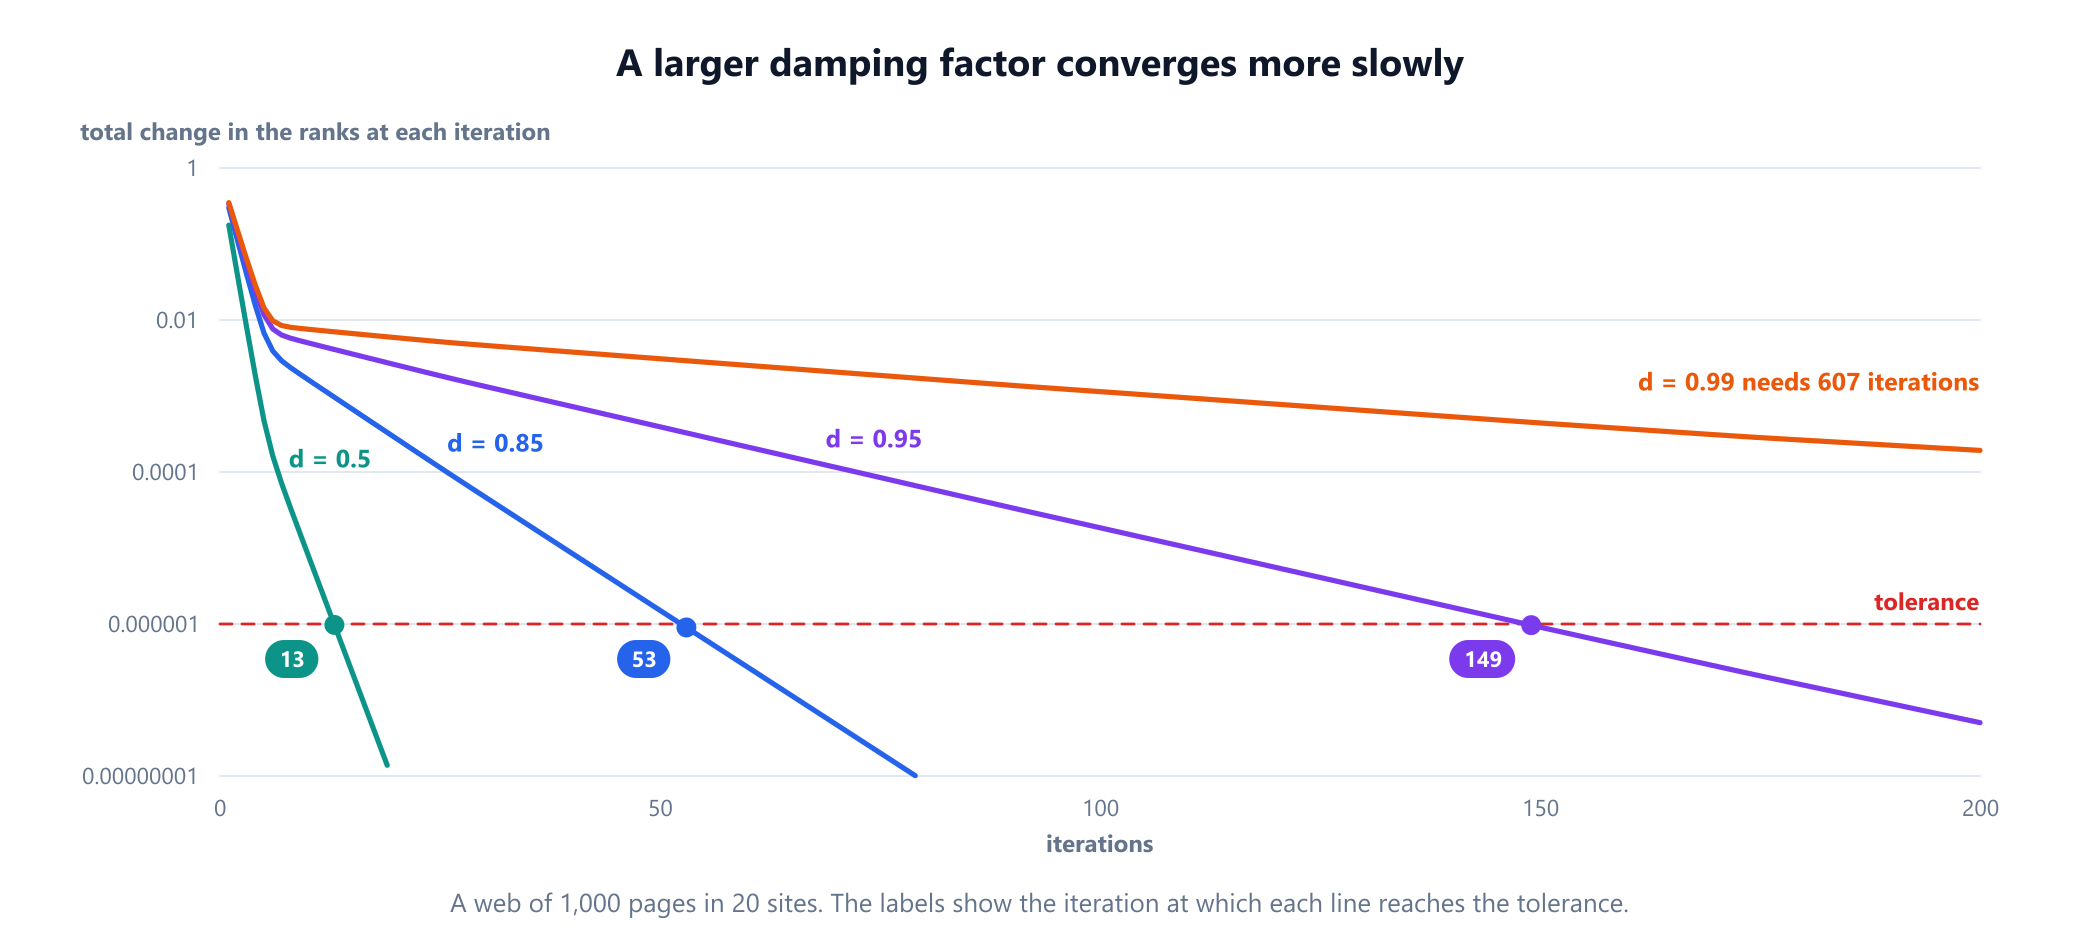
8. 这些度量一致吗?
如果这些度量通常选出相同的顶点,你就总可以使用最便宜的那个。下一个程序构建三种各有 400 个顶点的网络,然后考察按介数排名的前 20 个顶点中,有多少个同时也在按其他各度量排名的前 20 名里。
import random
from people import degree, closeness
from brandes import betweenness
from eigen import eigenvector

def link(adj, a, b):
    if a != b and b not in adj[a]:
        adj[a].append(b)
        adj[b].append(a)

def hubs(n, m, rnd):
    """优先连接:新加入的顶点偏好已经有很多边的顶点。"""
    adj = {v: [] for v in range(n)}
    pool = list(range(m))
    for v in range(m, n):
        for t in set(rnd.choice(pool) for _ in range(m)):
            link(adj, v, t)
            pool += [v, t]
    return adj

def two_groups(n, rnd):
    """两个稠密的半部分,只由六条边相连。"""
    adj = {v: [] for v in range(n)}
    half = n // 2
    for a in range(n):
        for b in range(a + 1, n):
            if (a < half) == (b < half) and rnd.random() < 0.05:
                link(adj, a, b)
    for _ in range(6):
        link(adj, rnd.randrange(half), rnd.randrange(half, n))
    return adj

def ring(n, rnd):
    """每个顶点在两个方向上各与最近的 3 个邻居相连;5% 的边被重连。"""
    adj = {v: [] for v in range(n)}
    for v in range(n):
        for k in (1, 2, 3):
            link(adj, v, rnd.randrange(n) if rnd.random() < 0.05 else (v + k) % n)
    return adj

def top(score, k=20):
    return set(sorted(score, key=lambda v: (-score[v], v))[:k])

if __name__ == '__main__':
    rnd = random.Random(11)
    print('top 20 by betweenness also in the top 20 by:  degree, closeness, eigenvector')
    for name, adj in (('hubs', hubs(400, 2, rnd)), ('two groups', two_groups(400, rnd)), ('ring', ring(400, rnd))):
        b = top(betweenness(adj))
        print(f'{name:11}', len(b & top(degree(adj))), len(b & top(closeness(adj))), len(b & top(eigenvector(adj, steps=4000))))
# top 20 by betweenness also in the top 20 by:  degree, closeness, eigenvector
# hubs        18 13 14
# two groups  8 17 4
# ring        6 9 1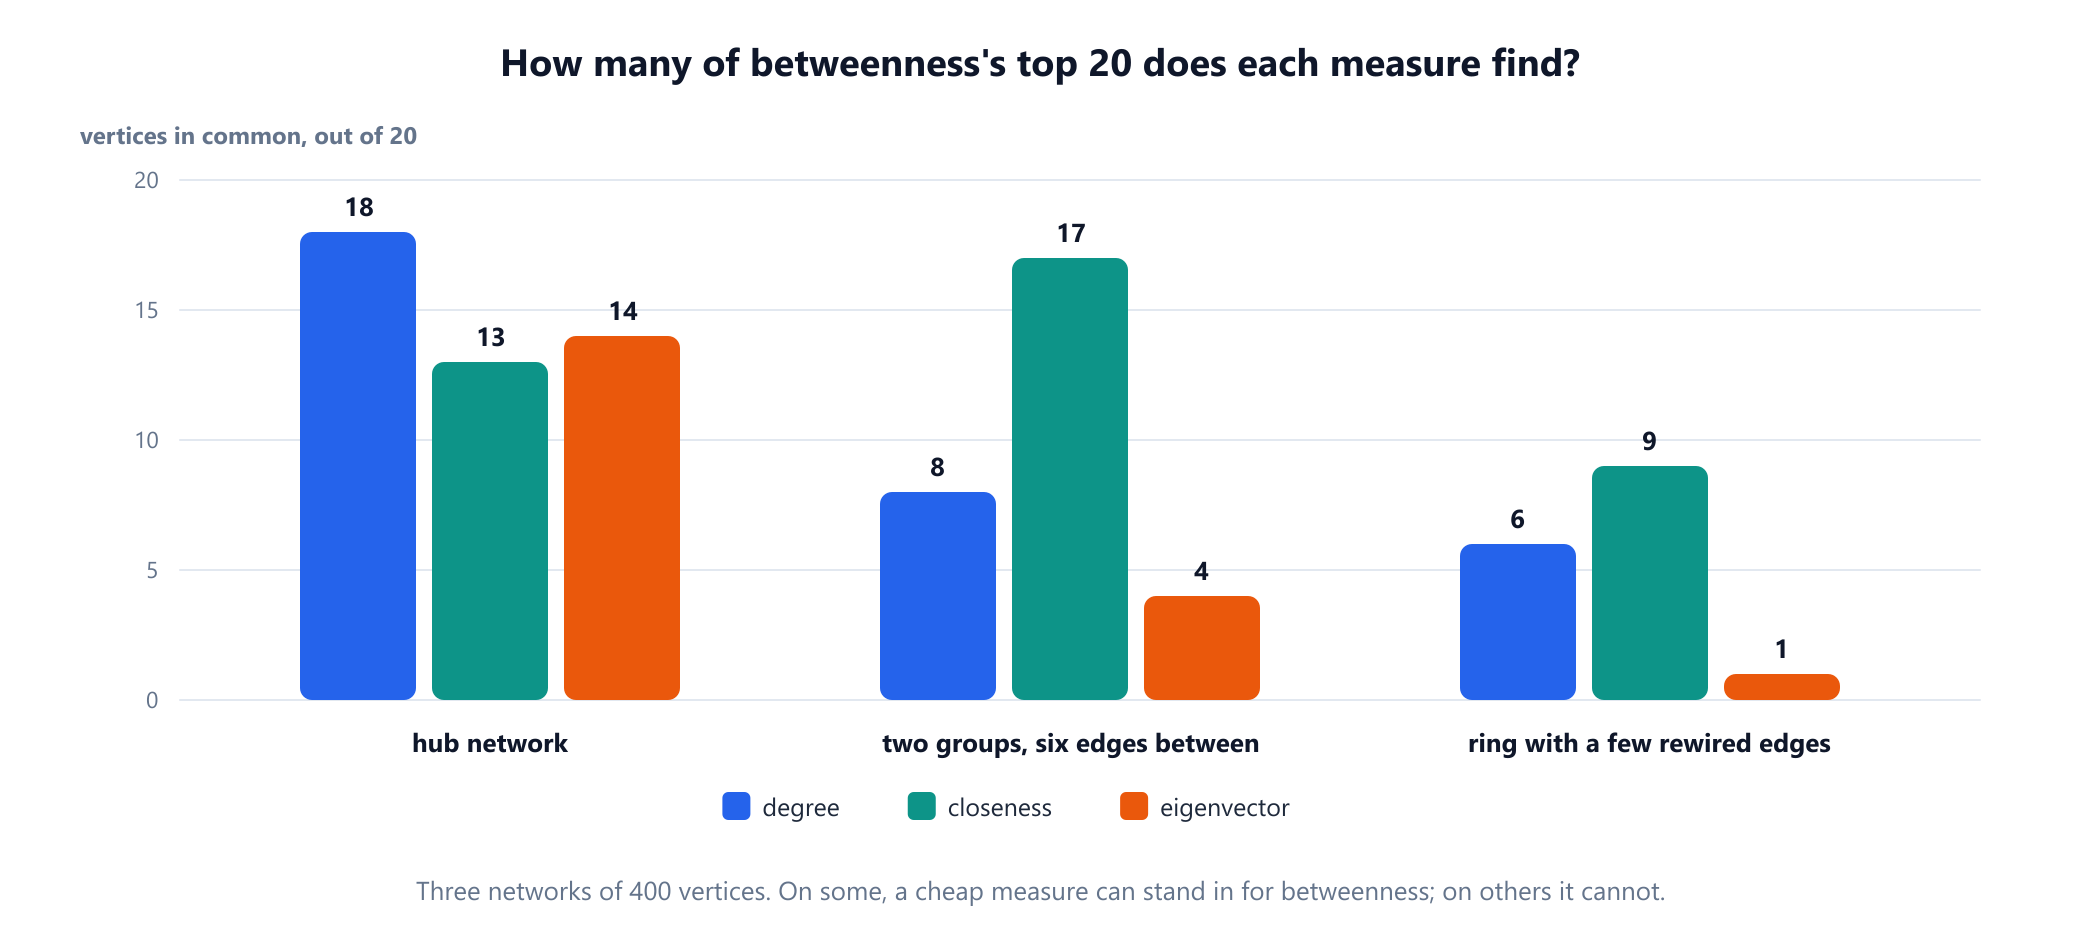
在枢纽网络上,少数顶点集中了大部分边,度找到了 20 个中的 18 个,因此为介数付出的代价换来的收获很少。在由六条边相连的两个群组上,度只找到 8 个,特征向量中心性只找到 4 个,因为它的前 20 个顶点全都位于同一个群组中:它集中在一半上,看不到另一半。在环上,结构大多是局部的,各度量基本上选出了不同的顶点。在依赖一个廉价的替代品之前,先在你自己网络的一个样本上测试它。
9. 大图:估计介数
精确的介数需要从每个顶点各运行一次搜索,在有数亿个顶点的图上这是做不到的。Brandes 和 Christian Pich 在 2007 年研究过的标准捷径,是从随机抽样的一部分源点运行搜索,再把结果按比例放大。第 4 节程序的 sources 参数已经实现了这一点。
import random
from brandes import betweenness
from agree import hubs, top

if __name__ == '__main__':
    rnd = random.Random(3)
    adj = hubs(1000, 3, rnd)
    exact = betweenness(adj)
    best = top(exact, 10)
    print('sources  work  top 10 found  mean error of the top 10   (average of 10 runs)')
    for k in (10, 50, 100, 250, 500):
        found = error = 0
        for _ in range(10):
            estimate = betweenness(adj, rnd.sample(sorted(adj), k))
            found += len(best & top(estimate, 10))
            error += sum(abs(estimate[v] - exact[v]) / exact[v] for v in best) / 10
        print(f'{k:7} {k / 10:4.0f}% {found / 10:13.1f} {error / 10:12.1%}')
# sources  work  top 10 found  mean error of the top 10   (average of 10 runs)
#      10    1%           6.2        36.8%
#      50    5%           8.1        17.3%
#     100   10%           9.4        13.4%
#     250   25%           9.1         8.6%
#     500   50%           9.4         4.0%
在这个有 1,000 个顶点的网络上,10% 的工作量平均能找到真正前 10 名中的 9.4 个,它们得分的典型误差约为 13%。抽样擅长找出排名靠前的顶点,而对得分本身的估计则远没有那么精确。1% 的样本太小,只能找到 6.2 个。相比之下,度在任何规模下都很便宜,而特征向量中心性和 PageRank 只需对边做有限次遍历,这就是它们能扩展到万维网规模的图的原因。
10. 这些度量的应用场景
- 网络搜索。 PageRank 是最初的 Google 搜索引擎的核心组成部分,并与页面和链接的文本等其他信号结合使用。
- 生物学。 Hawoong Jeong 及其同事在 2001 年报告,在酵母的蛋白质网络中,连接度高的蛋白质更可能是生存所必需的。关于图论在生物学中的应用的指南探讨了枢纽与瓶颈。
- 社区发现。 Michelle Girvan 和 Mark Newman 2002 年的方法反复删除介数最高的边,并在每次删除后重新计算介数,因为群组之间的边承载的路线最多。
- 安全。介数指向最多攻击路径所经过的主机,在那里做一次修复的帮助最大;参见图论在网络安全中的应用。
- 机器学习。中心性得分是常见的顶点输入特征,而图神经网络则从数据中学习相关的量。
11. 简史
中心性起源于对小群体的研究。Alex Bavelas 在 1948 年提出了这一思想;他在 MIT 的群体网络实验室 (Group Networks Laboratory) 所做的实验报告于他 1950 年的论文中,这些实验把中心性与小群体解决问题的效果联系起来。Gert Sabidussi 在 1966 年对接近中心性作了数学处理。Leo Katz 的地位指数发表于 1953 年,Phillip Bonacich 的特征向量度量发表于 1972 年。Jac Anthonisse 在 1971 年一份未发表的报告中、Linton Freeman 在 1977 年,各自独立地定义了介数,而 Freeman 1979 年的论文把度、接近中心性和介数组织成至今仍在讲授的框架。PageRank 于 1998 年问世;Massimo Franceschet 2011 年的历史综述把它的思想追溯到文献计量学、社会测量学和计量经济学,最远可追溯到 Wassily Leontief 1941 年的投入产出模型和 John Seeley 1949 年的社会测量指数。Brandes 2001 年的算法使介数在大型网络上变得实用。
12. 常见错误
| 错误 | 为什么错 | 修正 |
|---|---|---|
| 寻找“唯一”最重要的顶点 | 在示例中,四种度量选出了四个人 | 先确定什么在网络中流动 |
| 把入链数当作排名值 | D 入链最多,却排第四 | 当链接的来源重要时,使用 PageRank |
| 在非连通图上使用接近中心性 | 一对孤立的外包人员得到 1.0 分 | 使用调和中心性 |
| 忘记把无向图的介数减半 | 每一对都从两端各计算了一次 | 除以 2 |
| 把联系强度当作距离 | 基于最短路径的度量会把强联系当作长距离 | 先把权重转换为距离,例如 1 / w |
| 在不同的图之间比较原始得分 | 介数随图的规模增长 | 先归一化,或比较名次 |
| 在二分图上使用普通幂迭代 | 得分可能永远振荡 | 迭代时使用 A + I |
| 在 PageRank 中忽略死胡同 | 总排名值流失到只剩 0.403 | 把死胡同的排名值分给所有页面 |
13. 术语表
| 术语 | 含义 |
|---|---|
| 中心性 | 在明确的定义下,衡量一个顶点有多重要的分数 |
| 度中心性 | 与一个顶点相连的边数 |
| 接近中心性 | (n - 1) 除以到所有其他顶点的距离之和 |
| 调和中心性 | 对所有其他顶点取 1 / 距离 的平均值 |
| 介数中心性 | 对所有顶点对求和,每一对贡献经过该顶点的最短路径所占的比例 |
| 特征向量中心性 | 与邻居得分之和成正比的分数 |
| Katz 中心性 | 给每个顶点加上一个小常数的特征向量中心性 |
| PageRank | 随机浏览者长期停留在一个页面上的时间比例 |
| 阻尼系数 | 概率 d,表示浏览者沿链接前进而不是随机跳转 |
| 死胡同 | 没有出链的页面 |
| 幂迭代 | 反复乘以一个矩阵并重新缩放,以求出它的主特征向量 |
| Brandes 算法 | 在无权图上以 O(VE) 的时间精确计算介数 |
14. 常见问题
图论中的中心性是什么?
中心性是任何一种说明顶点在图中有多重要的分数。不同的定义刻画不同类型的重要性:直接连接的数量、到其他所有顶点的距离、经过该顶点的最短路线所占的份额,或者其邻居的重要性。在同一个图上,这些定义可能选出不同的顶点。
度中心性、接近中心性和介数中心性有什么区别?
度统计一个顶点的直接连接数。接近中心性衡量只需多少步就能到达所有其他顶点。介数衡量其他顶点对之间的最短路线中有多少经过该顶点。一个人可能联系人很少,却因为是两个群组之间唯一的纽带而在介数上得分最高。
PageRank 和特征向量中心性有什么区别?
两者都根据与一个顶点相连的顶点的得分来给它打分。PageRank 是为有向图设计的:每个页面把自己的排名值分给它的各条出链,阻尼系数加入了随机跳转,因此没有入链的页面和封闭的页面群组都不会让它失效。特征向量中心性主要用于连通的无向图。
应该使用哪种中心性度量?
取决于什么在网络中流动。有向链接或引用使用 PageRank;某种东西在其他顶点之间传递时必须经过顶点,使用介数;某种东西从一处向外扩散,使用接近中心性或调和中心性;邻居的质量重要时,使用特征向量中心性;想要快速得到初步答案时,使用度。
介数中心性如何计算?
Brandes 算法从每个顶点运行一次广度优先搜索并统计最短路径数,然后从最远的顶点往回走,把贡献传给前驱。在无权图上它需要 O(VE) 时间。在非常大的图上,从随机抽样的源点运行它并按比例放大,就能很好地估计排名靠前的顶点。
PageRank 中的阻尼系数是什么?
阻尼系数 d 是随机浏览者沿链接前进、而不是跳到随机页面的概率。Brin 和 Page 报告说,他们通常把它设为 0.85。d 越大,就越紧密地跟随链接结构,但需要更多迭代,而且会让封闭的页面群组吸收更多排名值。
15. 参考文献
上文中的算法、结果和归属均来自以下文献,按时间顺序排列。
- Bavelas, A. (1948). "A Mathematical Model for Group Structures." Human Organization 7(3),16 至 30 页。
- Seeley, J. R. (1949). "The Net of Reciprocal Influence: A Problem in Treating Sociometric Data." Canadian Journal of Psychology 3(4),234 至 240 页。
- Bavelas, A. (1950). "Communication Patterns in Task-Oriented Groups." Journal of the Acoustical Society of America 22(6),725 至 730 页。
- Katz, L. (1953). "A New Status Index Derived from Sociometric Analysis." Psychometrika 18(1),39 至 43 页。
- Sabidussi, G. (1966). "The Centrality Index of a Graph." Psychometrika 31(4),581 至 603 页。
- Anthonisse, J. M. (1971). "The Rush in a Directed Graph." 报告 BN 9/71。阿姆斯特丹:Stichting Mathematisch Centrum。
- Bonacich, P. (1972). "Factoring and Weighting Approaches to Status Scores and Clique Identification." Journal of Mathematical Sociology 2(1),113 至 120 页。
- Freeman, L. C. (1977). "A Set of Measures of Centrality Based on Betweenness." Sociometry 40(1),35 至 41 页。
- Freeman, L. C. (1979). "Centrality in Social Networks: Conceptual Clarification." Social Networks 1(3),215 至 239 页。
- Krackhardt, D. (1990). "Assessing the Political Landscape: Structure, Cognition, and Power in Organizations." Administrative Science Quarterly 35(2),342 至 369 页。
- Brin, S. 和 Page, L. (1998). "The Anatomy of a Large-Scale Hypertextual Web Search Engine." Computer Networks and ISDN Systems 30(1 至 7),107 至 117 页。
- Marchiori, M. 和 Latora, V. (2000). "Harmony in the Small-World." Physica A 285(3 至 4),539 至 546 页。
- Brandes, U. (2001). "A Faster Algorithm for Betweenness Centrality." Journal of Mathematical Sociology 25(2),163 至 177 页。
- Jeong, H., Mason, S. P., Barabási, A.-L. 和 Oltvai, Z. N. (2001). "Lethality and Centrality in Protein Networks." Nature 411,41 至 42 页。
- Girvan, M. 和 Newman, M. E. J. (2002). "Community Structure in Social and Biological Networks." Proceedings of the National Academy of Sciences 99(12),7821 至 7826 页。
- Haveliwala, T. H. 和 Kamvar, S. D. (2003). "The Second Eigenvalue of the Google Matrix." 技术报告。Stanford University。
- Brandes, U. 和 Pich, C. (2007). "Centrality Estimation in Large Networks." International Journal of Bifurcation and Chaos 17(7),2303 至 2318 页。
- Franceschet, M. (2011). "PageRank: Standing on the Shoulders of Giants." Communications of the ACM 54(6),92 至 101 页。
- Boldi, P. 和 Vigna, S. (2014). "Axioms for Centrality." Internet Mathematics 10(3 至 4),222 至 262 页。