
目录
1. DFS 题目真正考察的是什么
DFS 题目考的不是遍历。任何候选人都能走遍一个图。真正要检查的是,你是否了解 DFS 能提供而 BFS 提供不了的那些簿记信息:顶点完成的顺序、某个顶点是否仍在栈上,以及一棵子树能向上回溯多远。
这就是全部内容。环检测、拓扑排序、强连通分量、桥和割点,都只是一次遍历加一个额外的数组。如果一道题问的是顺序、依赖、环,或者删掉这个会坏掉什么,那就是 DFS 题。如果它问的是某样东西的最少数量,那就是一道 BFS 题。
下面八道是反复出现的题目,每道都附有问题、解答、追问,以及让你丢掉 offer 的错误。每个示例都经过脚本实际运行验证。
2. 模板:递归版与迭代版
递归 DFS 只有四行,你应该能不假思索地写出来。
def dfs(u, adj, seen):
    seen.add(u)
    for v in adj[u]:
        if v not in seen:
            dfs(v, adj, seen)
迭代版才是候选人容易出错的地方,因为最直接的改写和递归版有细微差别。
def dfs_iter(src, adj):
    seen, stack = set(), [src]
    while stack:
        u = stack.pop()
        if u in seen:            # 一个顶点可能被压栈多次
            continue
        seen.add(u)
        for v in adj[u]:
            if v not in seen:
                stack.append(v)
有两点需要注意,并且要说出来。
- 出栈时检查
seen,而不只是入栈时检查。与 BFS 不同,同一个顶点可能在栈上出现不止一次:在其中任何一个被展开之前,它可能已被多个邻居压入。省略出栈时的检查,就会出现重复访问。 - 访问顺序与递归版不同。按升序压入的邻居会按降序弹出,所以迭代 DFS 会先探索最后一个邻居。把它们反向压栈,才能与递归版一致。这是面试官最爱的陷阱之一。
更难的一点是:普通的迭代版本没有后序。它知道顶点何时被发现,却永远不知道它的子树何时完成,而完成时间恰恰是第 5、 9 和 10 节所需要的。要恢复它,可以把每个顶点压栈两次,或在栈帧中记录子节点下标。能说明这里的递归并不只是形式上的差别,会给你加分。
这项技术由来已久:它就是 Trémaux 走迷宫的规则,由 Lucas 在 1882 年记录下来。
3. 有向图中的环检测
题目。一个有向图是否包含环?常见说法是死锁检测、构建依赖循环,或者“这个课程计划能否完成”。
错误答案是只用一个 visited 集合:到达一个已见过的顶点并不意味着有环,它可能只是进入图中已完成部分的第二条路线。正确答案使用三种颜色:白色表示未发现,灰色表示已发现但仍在递归栈上,黑色表示已完成。
WHITE, GREY, BLACK = 0, 1, 2

def has_cycle(adj, n):
    colour = [WHITE] * n

    def visit(u):
        colour[u] = GREY
        for v in adj[u]:
            if colour[v] == GREY:      # 回边:v 是祖先
                return True
            if colour[v] == WHITE and visit(v):
                return True
        colour[u] = BLACK              # 直到此时 u 才完成
        return False

return any(colour[s] == WHITE and visit(s) for s in range(n))指向灰色顶点的边是一条回边,一个有向图有环当且仅当 DFS 找到一条回边。指向黑色顶点的边是无害的。这个等价关系,以及它所属的四类边的划分,是 Cormen、Leiserson、Rivest 和 Stein 书中的标准处理方式。
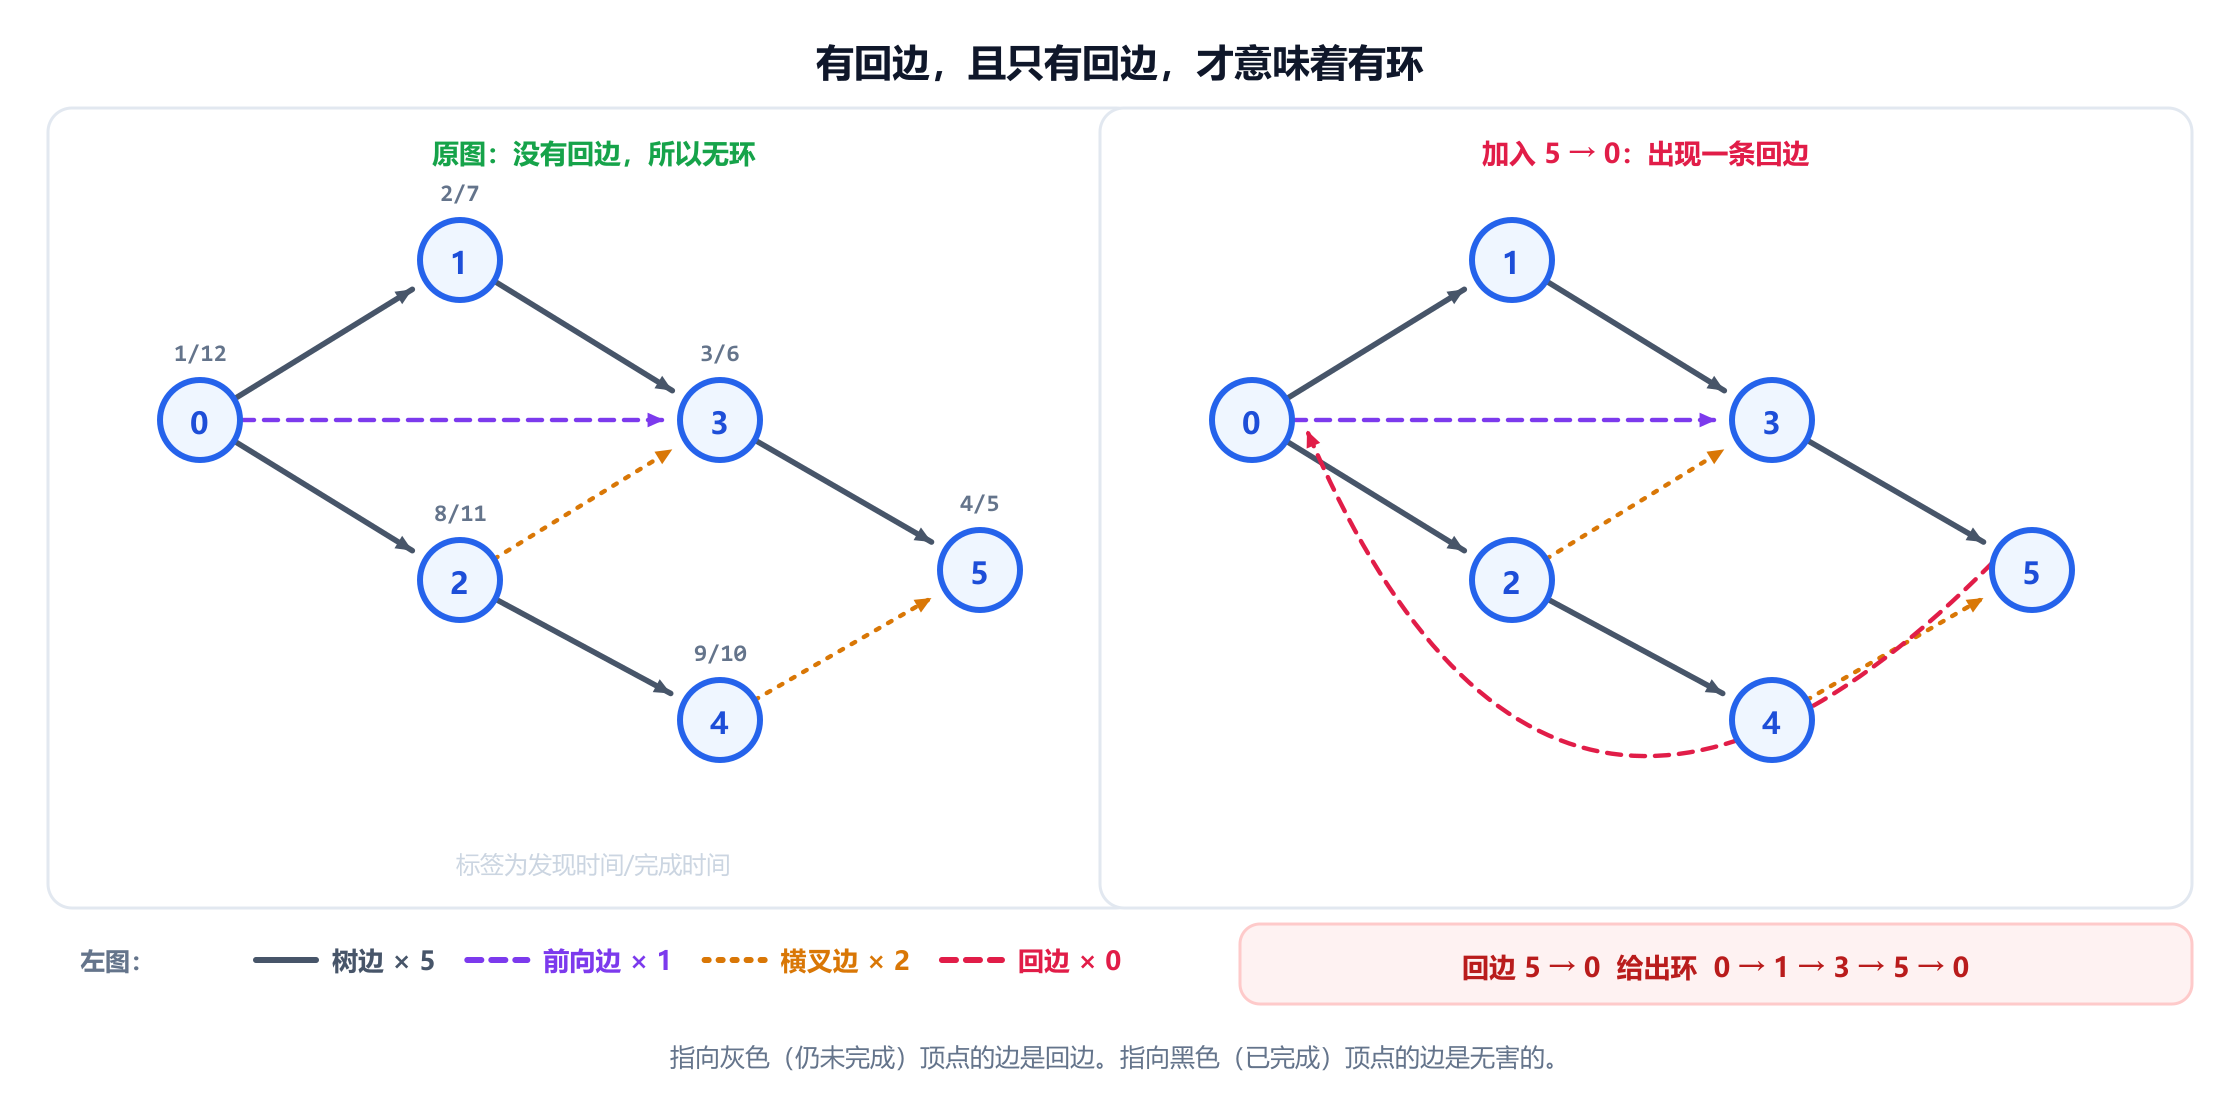
在示例图上,从顶点 0 开始的 DFS 把它的 8 条弧分为 5 条树边、1 条前向边和 2 条横叉边,没有回边,所以它是无环的。加入一条弧 5 → 0,恰好会出现一条回边。
追问:输出环本身,而不只是一个布尔值。回边会直接给出它:如果回边是 u → v,就从 u 沿父指针向上走到 v,再闭合成环。这里的回边是 5 → 0,环是 0 → 1 → 3 → 5 → 0。一个父数组只需一行代码,就能把是或否变成真正的构建工具必须报告的诊断信息。
陷阱。把 colour[u] = BLACK 放错位置,或者根本不写。让已完成的顶点保持灰色,那么每条通向它们的第二条路线都会看起来像环,于是在任何含有菱形结构的 DAG 上(示例图就有)都会报告误报。
4. 无向图中的环检测
题目。同样的问题,换成无向图。它看起来像上一题,但并不是。
三色法在这里是错的。每条无向边都可以双向通行,所以从 u 走到 v之后,回到 u 的那条边看起来就像指向灰色顶点的边,于是每条边都会报告有环。正确的做法是忽略你来时经过的那条边。
def has_cycle_undirected(adj, n):
    seen = [False] * n

    def visit(u, parent):
        seen[u] = True
        for v in adj[u]:
            if not seen[v]:
                if visit(v, u): return True
            elif v != parent:          # 已访问且不是父节点的邻居
                return True
        return False

    return any(not seen[s] and visit(s, -1) for s in range(n))
没有 v != parent 这个守卫条件,只含一条边 0-1 的图也会报告有环。有了它,4 个顶点的树会正确地报告无环,三角形会正确地报告有环。这就是要在白板上检查的三个测试用例,主动检查它们会给人留下很好的印象。
追问:有平行边怎么办?那么 v != parent 就不够了: u 和 v 之间的两条不同的边确实构成长度为 2 的环,而父节点检查会吞掉第二条。要记录你进入时经过的那条边,而不是顶点。参见简单图与多重图。
陷阱。不连通的图。遍历每个未访问顶点的外层循环不是可选的,只从顶点 0 开始的解法能通过所有连通的测试用例。
5. 按后序做拓扑排序
题目。对一个 DAG 的顶点排序,使每条弧都指向前方。BFS 的答案是 Kahn 的按入度剥离法;DFS 的答案更短,也正是 DFS 题目想要的。
运行 DFS,在每个顶点完成时把它追加到列表,最后反转列表。这就是整个算法,理由只需一句话:一个顶点只有在它能到达的所有顶点都完成之后才会完成,所以它比它的后继更晚完成,反转之后它就排在它们前面。
def topological_sort(adj, n):
    colour = [0] * n           # 0 白,1 灰,2 黑
    order = []

    def visit(u):
        colour[u] = 1
        for v in adj[u]:
            if colour[v] == 1: raise ValueError("cycle")
            if colour[v] == 0: visit(v)
        colour[u] = 2
        order.append(u)        # 后序:在子节点之后

    for s in range(n):
        if colour[s] == 0: visit(s)
    return order[::-1]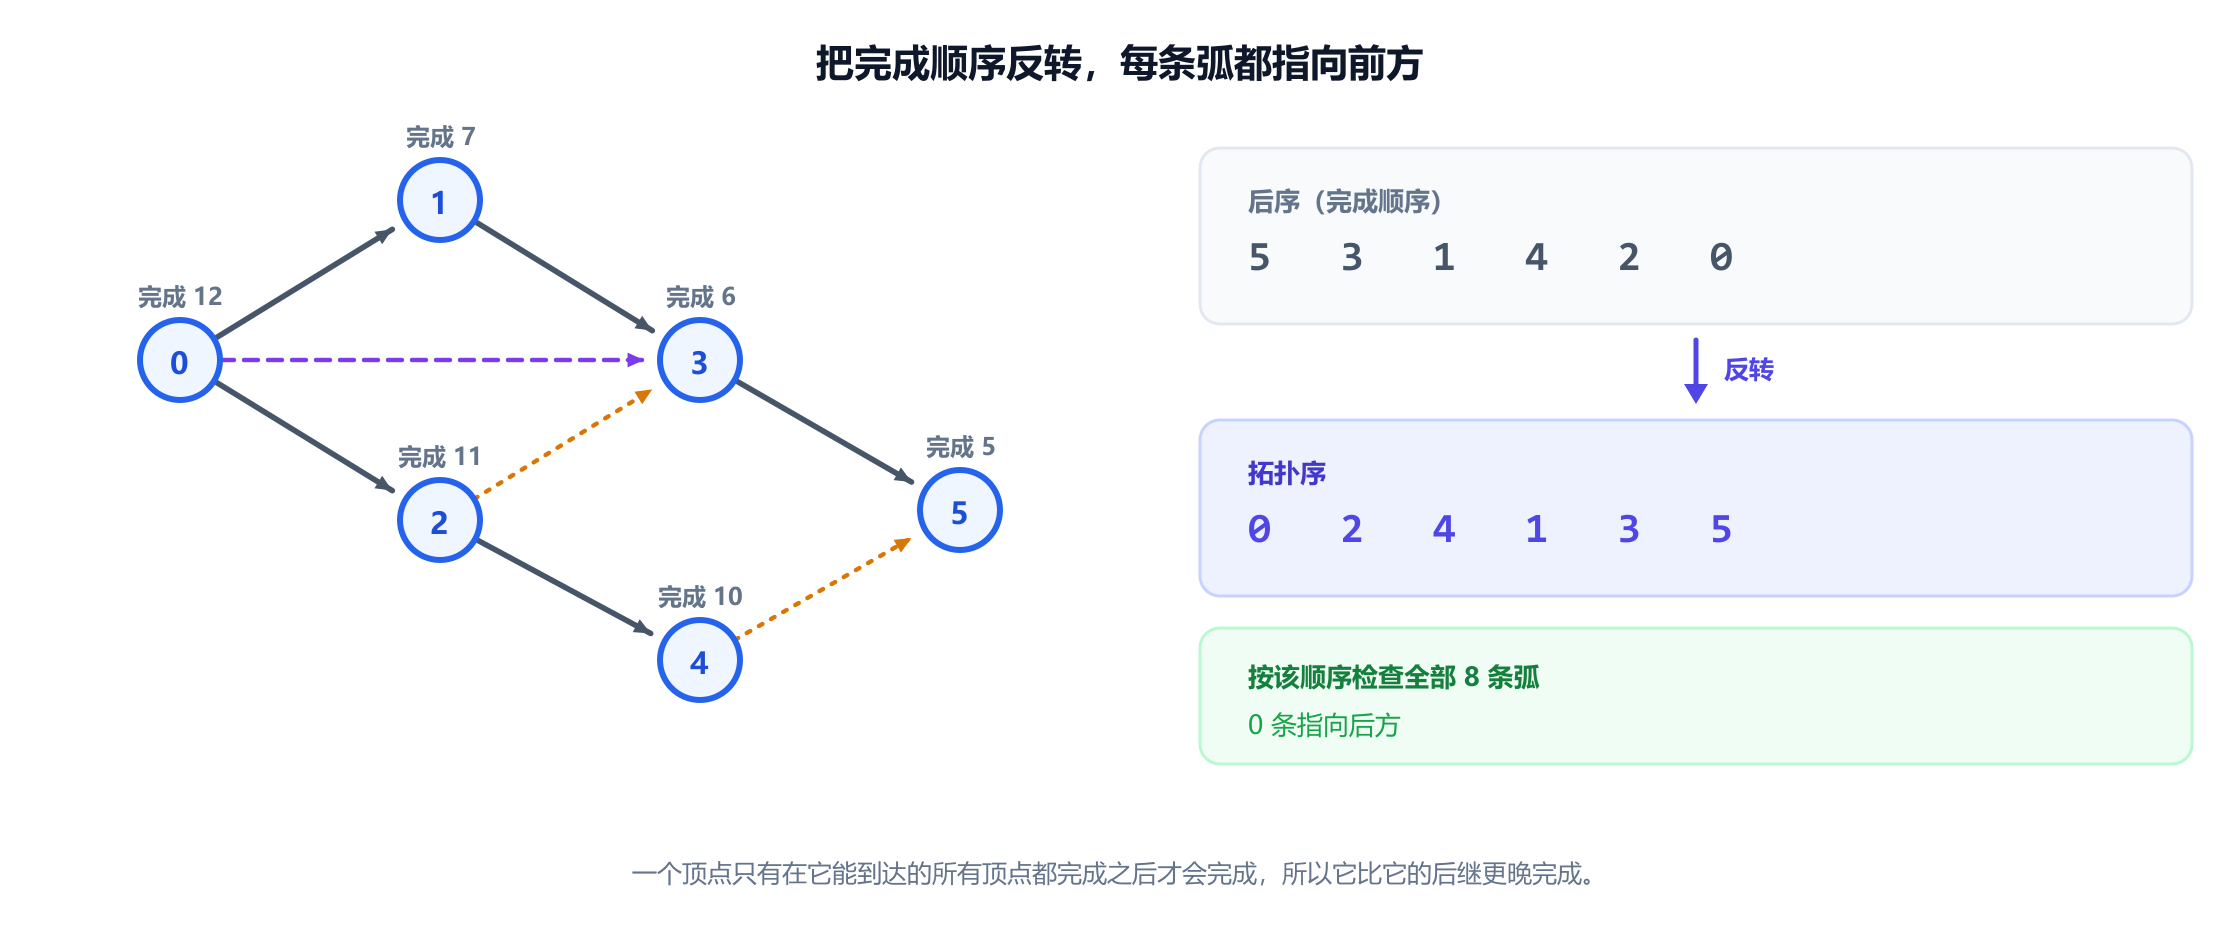
在示例 DAG 上,后序是 5, 3, 1, 4, 2, 0;反转后得到 0, 2, 4, 1, 3, 5,八条弧在其中全都指向前方。要说明这是一个拓扑序,而不是唯一的拓扑序:一个 DAG 通常有很多个。
追问:在这里怎样检测环?用第 3 节中的灰色检查。这正是它的魅力所在:一次遍历既能对 DAG 排序,又能拒绝非 DAG,而 Kahn 算法需要在最后单独计数。DFS 的这种表述来自 Tarjan。
陷阱。按前序追加,也就是在顶点被发现时而不是完成时追加。结果看起来合理,其实是错的,而且在小图上它常常恰好与某个合法顺序一致,所以能躲过草率的测试。
6. 克隆图
题目。给定一个连通无向图中某个节点的引用,返回图的深拷贝。
唯一的难点是环:朴素的递归复制会无限循环。解决办法是用一个从原节点到其副本的映射,它同时充当已访问集合,而且必须在递归之前写入。
def clone_graph(node, made=None):
    if node is None: return None
    if made is None: made = {}
    if node in made:
        return made[node]
    copy = Node(node.val)
    made[node] = copy              # 在递归之前登记
    for nb in node.neighbors:
        copy.neighbors.append(clone_graph(nb, made))
    return copy
在递归调用之前登记副本,就是这道题的全部。如果在之后登记,环会在条目存在之前把你再次带回来,递归一直进行到栈崩溃。这和对任何自引用结构做记忆化是同一个套路。
追问:迭代版还是 BFS?两者都可以,映射完全相同。要说明让它正确的是映射,而不是遍历顺序。两种方式都是 O(V + E)。
7. 所有路径:作为回溯的 DFS
题目。列出 DAG 中从源点到目标的每一条路径。变体:所有从根到叶的路径、路径和、全排列。
在这一类问题中,DFS 不再只是图遍历,而变成了回溯,区别只有一行:在返回时撤销你的选择。
def all_paths(adj, src, dst):
    out, path = [], []

    def walk(u):
        path.append(u)
        if u == dst:
            out.append(path[:])    # 副本,而不是活动列表
        else:
            for v in adj[u]:
                walk(v)
        path.pop()                 # 回溯这一步

    walk(src)
    return out
在示例 DAG 上,从 0 到 5 恰好有 4 条路径: 0→1→3→5、 0→2→3→5、 0→2→4→5 和 0→3→5。
有两个细节决定了答案。追加副本,即 path[:],因为 path 之后会被修改,而追加引用只会得到一个由相同空列表组成的列表。另外,这里没有已访问集合:你枚举的是路径而不是顶点,所以同一个顶点可以合法地出现在多条路径中。 path.pop() 不需要已访问集合也能保持状态正确。
追问:复杂度是多少?不是 O(V + E)。一个 DAG 可能有指数条路径,所以把它们全部列出来在输出规模上就是指数级的;诚实的答案是 O(V × 2V)。在这里说线性,会暴露你没有想过输出是什么。如果只问存在多少条路径,那是另一个问题:按拓扑序做动态规划计数,时间为 O(V + E)。
陷阱。因为“DFS 总有一个已访问集合”就加上一个。在有环图上,你确实要排除已在当前路径上的顶点,但那是路径本身,不是全局集合,而全局集合会悄悄只返回部分答案。
8. 网格上的单词搜索
题目。给定一个字母网格和一个单词,判断能否通过在上下左右相邻的格子之间移动拼出这个单词,且每个格子只能用一次。
这是在隐式网格图上的回溯,而“每个格子只能用一次”这个条件迫使你撤销标记。
def exist(board, word):
    R, C = len(board), len(board[0])

    def walk(r, c, i):
        if i == len(word): return True
        if not (0 <= r < R and 0 <= c < C): return False
        if board[r][c] != word[i]: return False

        board[r][c] = '#'                      # 做标记,使路径不能重复使用它
        found = any(walk(r + dr, c + dc, i + 1)
                    for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)))
        board[r][c] = word[i]                  # 返回时撤销
        return found

    return any(walk(r, c, 0) for r in range(R) for c in range(C))
标记必须恢复:被一次失败尝试占用的格子必须留给另一个起点使用,忘记这一点,函数就只有在第一次尝试的路径恰好成功时才会成功。直接覆写棋盘而不维护已访问集合是合理的技巧,但要说出来,因为它会修改调用方的输入。
追问:复杂度。 O(R × C × 3L),其中单词长度为 L:每个格子都可能是起点,而在第一步之后你永远不会沿来路返回,所以之后的每一步最多有 3 个选择,而不是 4 个。这个 3 就是表明你认真思考过的细节。
9. 强连通分量
题目。把一个有向图划分为若干个相互可达顶点的极大集合。它会以“找出循环依赖”的形式出现,或者作为 DAG 算法之前的预处理。
DFS 有两种解法,你应该清楚自己写的是哪一种。
Kosaraju-Sharir 需要两遍,在压力下更容易写对。先对原图做 DFS 并记录完成顺序,再按完成时间递减的顺序对反向图做 DFS;第二遍中的每棵树就是一个分量。
def kosaraju(adj, radj, n):
    seen, order = [False] * n, []
    def pass1(u):
        seen[u] = True
        for v in adj[u]:
            if not seen[v]: pass1(v)
        order.append(u)                  # 完成顺序
    for s in range(n):
        if not seen[s]: pass1(s)

    comp, c = [-1] * n, 0
    def pass2(u):
        comp[u] = c
        for v in radj[u]:
            if comp[v] == -1: pass2(v)
    for u in reversed(order):            # 完成时间递减
        if comp[u] == -1:
            pass2(u); c += 1
    return comp, c
在由两个三角形 0→1→2→0 和 3→4→5→3组成、并由单条弧 2→3相连的图上,它恰好返回两个分量: {0,1,2} 和 {3,4,5}。可达性验证了这一点:0 能到达 3,而 3 不能到达 0。
Tarjan 算法借助一个栈和 low-link 值一遍完成:实践中更快,但在白板上更容易写错。两者都是 O(V + E),并且本站都有可视化工具。Tarjan 1972 年的论文给出了单遍方法;两遍的版本归功于 Kosaraju,并由 Sharir 在 1981 年首次发表。
深入阅读:强连通分量指南在同一个图上追踪了两种算法,并展示了那些能通过小测试的 bug。
追问:为什么反向图有效?反转每条弧不会改变分量,因为相互可达是对称的。完成时间最大的顶点位于缩点图的一个源分量中,而反转会把源变成汇,所以从那里开始的 DFS 无法离开它。
10. 桥和割点
题目。删除哪些边会使图不连通?删除哪些顶点会?常见说法是单点故障,或者集群中的关键连接。
这是最深的一道标准 DFS 题,但它只有一个想法:除了每个顶点的发现时间,还要记录 low[u],即从 u的子树出发、最多使用一条非树边所能到达的最小发现时间。
def bridges(adj, n):
    disc, low = [-1] * n, [-1] * n
    out, clock = [], 0

    def visit(u, parent):
        nonlocal clock
        disc[u] = low[u] = clock; clock += 1
        for v in adj[u]:
            if v == parent:
                parent = -2                 # 只跳过一条父边
                continue
            if disc[v] == -1:
                visit(v, u)
                low[u] = min(low[u], low[v])
                if low[v] > disc[u]:
                    out.append((u, v))      # v 之下没有顶点能到达 u 或更高
            else:
                low[u] = min(low[u], disc[v])

    for s in range(n):
        if disc[s] == -1: visit(s, -1)
    return out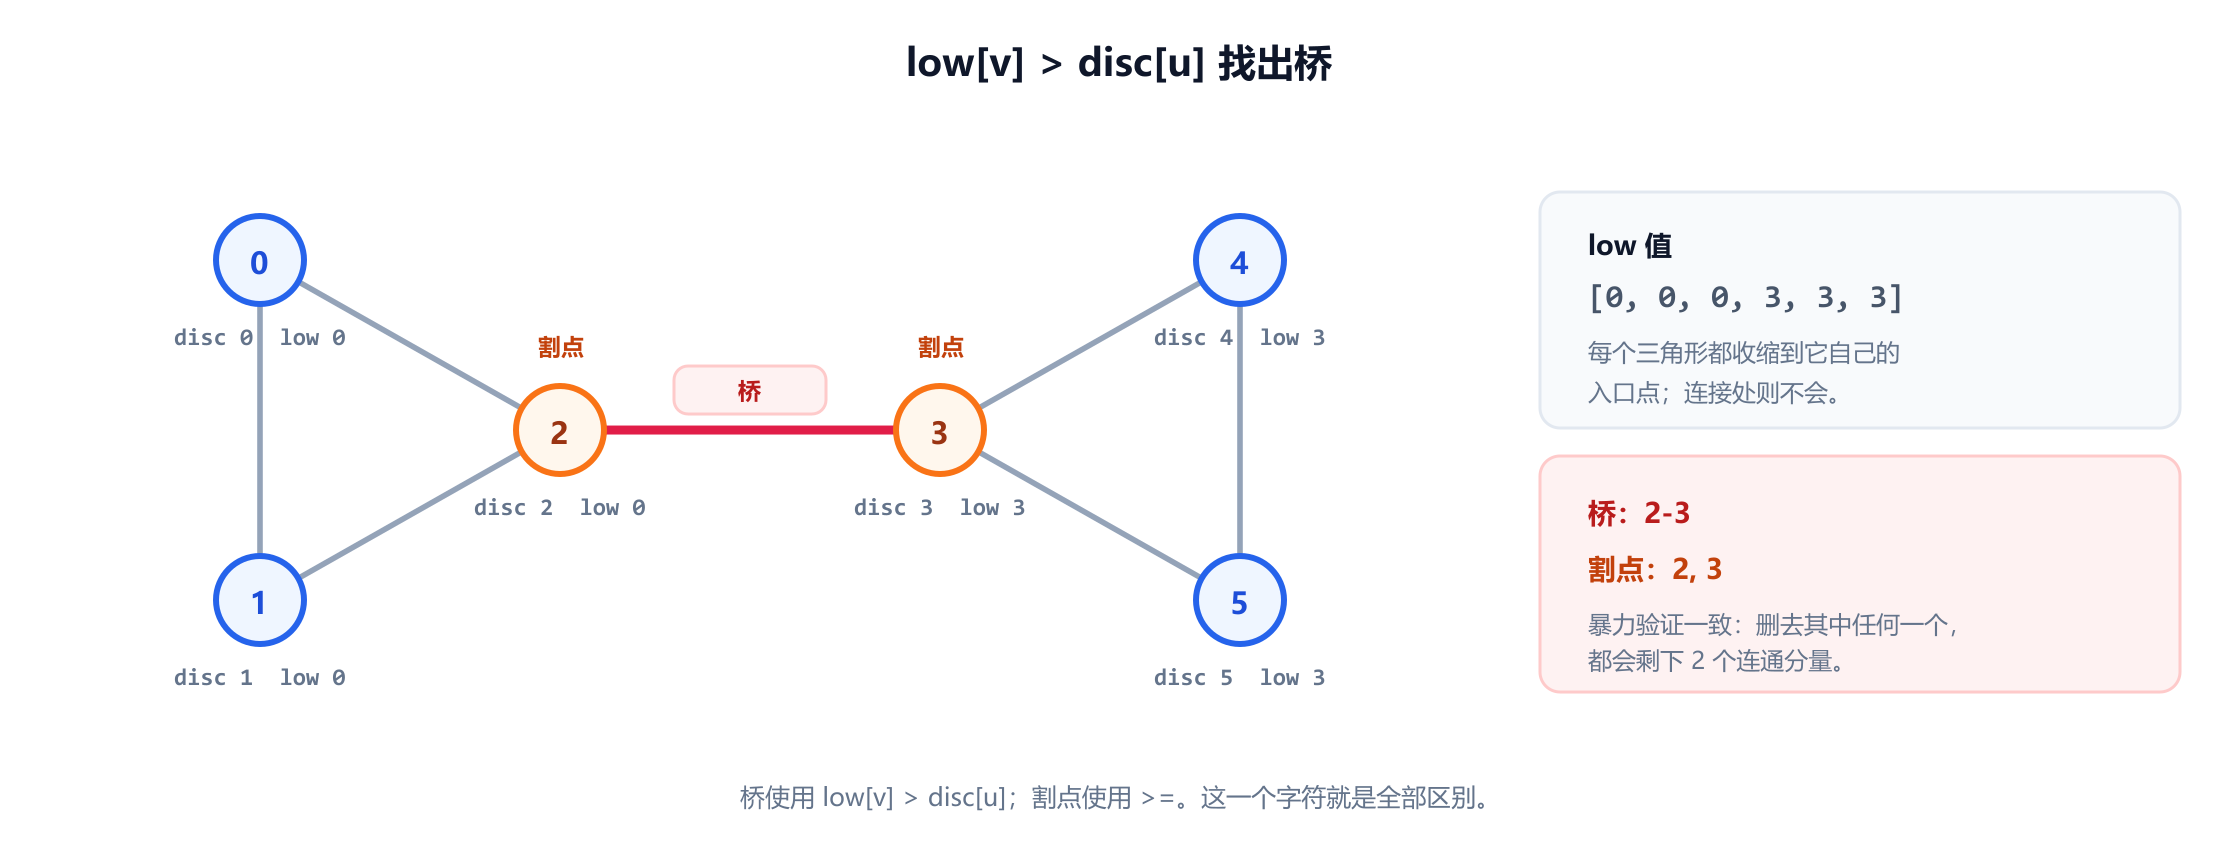
low[v] > disc[u] 表示 v 下面的子树无法回到 u 或更高的位置,所以 u-v 是唯一的路线,删掉它就会把图分开。在两个三角形的图上,发现时间从 0 到 5,low 值为 0, 0, 0, 3, 3, 3。唯一的桥是 2-3;割点是 2 和 3。暴力验证一致:删掉那条边或其中任一顶点,都会剩下 2 个连通分量,而其他任何单个删除都不会使图不连通。
割点使用同样的遍历,规则有两条:非根顶点 u 是割点,当且仅当它的某个子节点 v 满足 low[v] >= disc[u];根是割点,当且仅当它有不止一个 DFS 子节点。注意这里是 >=,而桥用的是 >。这一个字符就区分了两个答案,把它们搞混是这里最常见的错误。
陷阱。父节点检查。 if v == parent: continue 如果没有“只跳过一次”的守卫,在多重图上就是错的:到父节点的两条平行边意味着这对顶点之间不是桥,而把两条都跳过就会掩盖这一点。要记录边的下标,或者像上面那样只跳过第一次出现。该算法由 Hopcroft 和 Tarjan 于 1973 年提出,本站也有它的可视化工具。
11. 复杂度,以及递归深度问题
上面的每个算法都只是一次遍历,所以时间界几乎不变。有意思的问题在空间上。
| 问题 | 时间 | 空间 | 应给出的理由 |
|---|---|---|---|
| DFS,邻接表 | O(V + E) | O(V) | 每个顶点访问一次,每条边每个方向检查一次 |
| 有向图环检测 | O(V + E) | O(V) | 在同一次遍历上加一个颜色数组 |
| 拓扑排序 | O(V + E) | O(V) | 后序列表加上递归栈 |
| Kosaraju-Sharir 强连通分量 | O(V + E) | O(V + E) | 两次遍历,而反向图是第二份副本 |
| 桥、割点 | O(V + E) | O(V) | 两个整数数组, disc 和 low |
单词搜索,单词长度 L | O(R × C × 3L) | O(L) | 每个格子都是起点;第一步之后有 3 个后续选择 |
| 所有路径 | O(V × 2V) | O(V) | 输出本身就可能是指数级的 |
几乎每场 DFS 面试都会问到递归深度问题,所以要提前准备好答案。 DFS 的递归深度等于它所走的最长路径,在路径图上就是 V。CPython 的默认上限是 1000,所以几千个排成一条线的顶点就会让它崩溃,而一个 1000 乘 1000 的陆地网格可能递归一百万层。
解决办法是用第 2 节中的迭代版本,而不是 sys.setrecursionlimit,后者只会把一个干净的异常变成真正的栈溢出。要明确说出这一点。 O(V) 的空间就是这个栈,而与 BFS 的诚实比较是:DFS 保存一条从根到叶的路径,而 BFS 保存一整层;两者没有谁总是更小,这取决于图是深还是宽。Aho、Hopcroft 和 Ullman 给出了总体分析;Sedgewick 和 Wayne 给出了最简短清晰的讲解。
12. 导致面试失败的错误
按出现频率排序;前三个错误占了大多数被拒的解答。
- 在有向图环检测中只用一个已访问集合。再次看到一个顶点并不意味着有环。灰色(在栈上)必须与黑色(已完成)区分开,否则任何有两条路线到达同一顶点的 DAG 都会报告有环。
- 在无向图环检测中使用三色法。相反的错误。除非跳过你来时经过的那条边,否则每条边看起来都像回边。
- 在可能很大的输入上使用递归。一百万个格子的网格会递归一百万层。在被问到之前就主动给出迭代版本。
- 用前序构建拓扑序。必须用后序,在顶点完成时追加,然后反转。前序得到的东西看起来像答案,但并不是。
- 在回溯中忘记撤销。也就是
path.pop(),或者恢复网格单元格。没有它,第一个失败的分支会污染之后所有的分支。 - 存储的是活动列表而不是副本。
out.append(path)得到的是一个指向同一个被修改列表的引用列表。必须写成path[:]。 - 混淆 low-link 检查中的
>和>=。low[v] > disc[u]表示桥,>=表示割点。只差一个字符。 - 省略遍历所有连通分量的外层循环。环检测、连通分量计数和强连通分量,都需要从每个未访问的顶点重新启动 DFS。
- 不询问输入的情况。有向还是无向?连通吗?有自环或平行边吗?每个答案都会改变代码,Skiena 的观点在这里成立:问题是在建模中赢下来的。
能避免大多数这些错误的习惯是:写代码之前,先说出那个额外的数组是什么。颜色、父节点、完成顺序,还是 low-link。DFS 题目之间的区别在于这个数组,而不在于遍历,先把它说出来,剩下的就是机械工作。McDowell 在一般意义上也提出过同样的观点;在这里它几乎是字面意义上成立的。
13. 常见问题
什么时候应该用 DFS 而不是 BFS?
+
当问题涉及顺序、依赖、环,或者删掉某样东西后会坏掉什么时。这些都需要知道一个顶点何时完成,或者它是否仍在栈上,而只有 DFS 能提供这些。如果题目问某样东西的最少数量,就用 BFS:DFS 找到的是一条路径,而不是最短的那条。
为什么有向图环检测需要三种颜色?
+
因为一个普通的已访问集合无法区分祖先和已完成的顶点。灰色表示仍在递归栈上,所以指向灰色顶点的边会闭合一个回路,是真正的环。黑色表示已完成,指向黑色顶点的边只是进入图中已探索部分的第二条路线,这在 DAG 中是允许的。
为什么反转 DFS 后序就能得到拓扑排序?
+
因为一个顶点只有在它能到达的所有顶点都完成之后才会完成,所以它总是比它的后继更晚完成。因此,反转完成顺序会把每个顶点放在它所指向的所有顶点之前,这正是拓扑条件。要按后序追加,也就是在顶点完成时追加,而不是在它被发现时。
什么是 low-link 值?
+
对于顶点 u,它是从 u 的子树出发、使用树边加上最多一条非树边所能到达的最小发现时间。它回答的是“u 下面的任何顶点能否不经过 u 到其父节点的边而回到 u 之上”。如果不能,这条边就是桥。它就是那个把普通 DFS 变成求桥、割点以及 Tarjan 强连通分量算法的额外数组。
递归 DFS 最多能递归多深才会崩溃?
+
和它所走的最长路径一样深,在路径图上就是顶点数。CPython 的默认上限是 1000,所以几千个排成一条线的顶点就会让它崩溃,而一个 1000 乘 1000 的陆地网格会递归一百万层。应该把它改写成迭代版,而不是提高上限,后者只会把一个干净的异常变成真正的栈溢出。
迭代 DFS 和用栈实现的递归 DFS 一样吗?
+
不完全一样。简单的栈版本会按相反顺序访问邻居,所以要反向压栈才能一致;而且它必须在出栈和入栈时都检查已访问集合,因为一个顶点可能在栈上出现多次。更重要的是,它没有后序,所以拓扑排序、强连通分量和 low-link 算法需要一个把每个顶点压栈两次或记录子节点下标的版本。
枚举所有路径时需要已访问集合吗?
+
不需要,而且加上它是一个常见 bug。你枚举的是路径而不是顶点,所以同一个顶点可以合法地出现在多条路径中,而全局的已访问集合会悄悄只返回其中一部分。你需要的是当前路径,并在返回时用一次 pop 撤销。在有环图上,你要排除已在这条路径上的顶点,而这并不是一个全局集合。
14. 参考文献
提出这些技术的论文以及分析它们的教材,按时间顺序排列。
- Lucas, É. (1882). Récréations Mathématiques,第 1 卷。Gauthier-Villars。(记录了 Trémaux 走迷宫的系统规则,这是对深度优先搜索最早的描述。)
- Tarjan, R. E. (1972). “Depth-first search and linear graph algorithms.” SIAM Journal on Computing, 1(2), 146–160.
- Hopcroft, J. and Tarjan, R. E. (1973). “Algorithm 447: efficient algorithms for graph manipulation.” Communications of the ACM, 16(6), 372–378.
- Aho, A. V., Hopcroft, J. E. and Ullman, J. D. (1974). The Design and Analysis of Computer Algorithms. Addison-Wesley.
- Tarjan, R. E. (1976). “Edge-disjoint spanning trees and depth-first search.” Acta Informatica, 6(2), 171–185.
- Sharir, M. (1981). “A strong-connectivity algorithm and its applications in data flow analysis.” Computers & Mathematics with Applications, 7(1), 67–72.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. and Stein, C. (2009). Introduction to Algorithms,第 3 版,第 22.3 节。MIT Press。
- Sedgewick, R. and Wayne, K. (2011). Algorithms,第 4 版,第 4.1 至 4.2 节。Addison-Wesley。
- McDowell, G. L. (2015). Cracking the Coding Interview,第 6 版。CareerCup。
- Skiena, S. S. (2020). The Algorithm Design Manual,第 3 版,第 5 章。Springer。