
Table des Matières
- 1. Ce qu'une question union-find évalue vraiment
- 2. Le modèle, et les deux lignes qui comptent
- 3. Compter les composantes connexes
- 4. Redundant Connection : l'arête qui ferme un cycle
- 5. Islands II : pourquoi BFS perd quand la grille change
- 6. Accounts Merge : quand les éléments ne sont pas des entiers
- 7. Most Stones Removed : choisir ce que l'on unit
- 8. Evaluate Division : union-find pondéré
- 9. Équations d'égalité : l'ordre de traitement
- 10. Kruskal : union-find dans un arbre couvrant
- 11. Les réponses sur la complexité
- 12. Les erreurs qui font échouer l'entretien
- 13. Questions fréquentes
- 14. Références
1. Ce qu'une question union-find évalue vraiment
Union-find est l'un des rares sujets d'entretien où l'implémentation n'est pas la difficulté. Quinze lignes, deux optimisations, aucun cas limite qui mérite débat. Les recruteurs le savent, et c'est pourquoi les questions se jouent ailleurs.
Elles évaluent trois choses. Reconnaissez-vous une question de connexité ? Tout ce qui est formulé comme « ces deux-là sont-ils dans le même groupe », « combien y a-t-il de groupes » ou « quel changement fusionne deux groupes » relève d'union-find, même quand les mots sont comptes, pierres, équations ou câbles. Savez-vous quand il bat un parcours ? Un seul graphe statique se parcourt par BFS ou DFS tout aussi vite ; union-find gagne quand les arêtes arrivent une à une et que la réponse est nécessaire après chacune. Savez-vous choisir les éléments ? C'est là que se trouvent les questions difficiles, et c'est là que la section 7 passe son temps.
Les huit problèmes ci-dessous sont ceux qui reviennent, chacun avec la solution, la relance et l'erreur qui coûte l'offre. Chaque exemple détaillé de cette page a été exécuté par script. Si vous voulez la structure de données dérivée de zéro plutôt qu'un rappel, elle se trouve dans le guide consacré à union-find.
2. Le modèle, et les deux lignes qui comptent
Écrivez ceci sans réfléchir. Deux optimisations, une ligne chacune, et les recruteurs demandent les deux par leur nom.
class DSU:
    def __init__(self, n):
        self.parent = list(range(n))
        self.size = [1] * n
        self.count = n                       # nombre de composantes, gratuit

    def find(self, x):
        root = x
        while self.parent[root] != root:
            root = self.parent[root]
        while self.parent[x] != root:        # COMPRESSION DE CHEMIN : aplatir le parcours
            self.parent[x], x = root, self.parent[x]
        return root

    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False                     # déjà réunis : rien à fusionner
        if self.size[ra] < self.size[rb]:    # UNION PAR TAILLE : petit arbre sous le grand
            ra, rb = rb, ra
        self.parent[rb] = ra
        self.size[ra] += self.size[rb]
        self.count -= 1
        return True
Trois détails à dire à voix haute pendant que vous les tapez. union renvoie un booléen, et cette valeur de retour répond à la moitié des questions de cette page : False signifie que les deux étaient déjà connectés, donc que l'arête que vous venez d'essayer ferme un cycle. count est tenu à jour par les fusions, si bien que compter les composantes n'exige jamais de seconde passe. Et le find ci-dessus est itératif, ce qui compte sur une chaîne de cent mille éléments, où la version récursive meurt sur la pile d'appels.
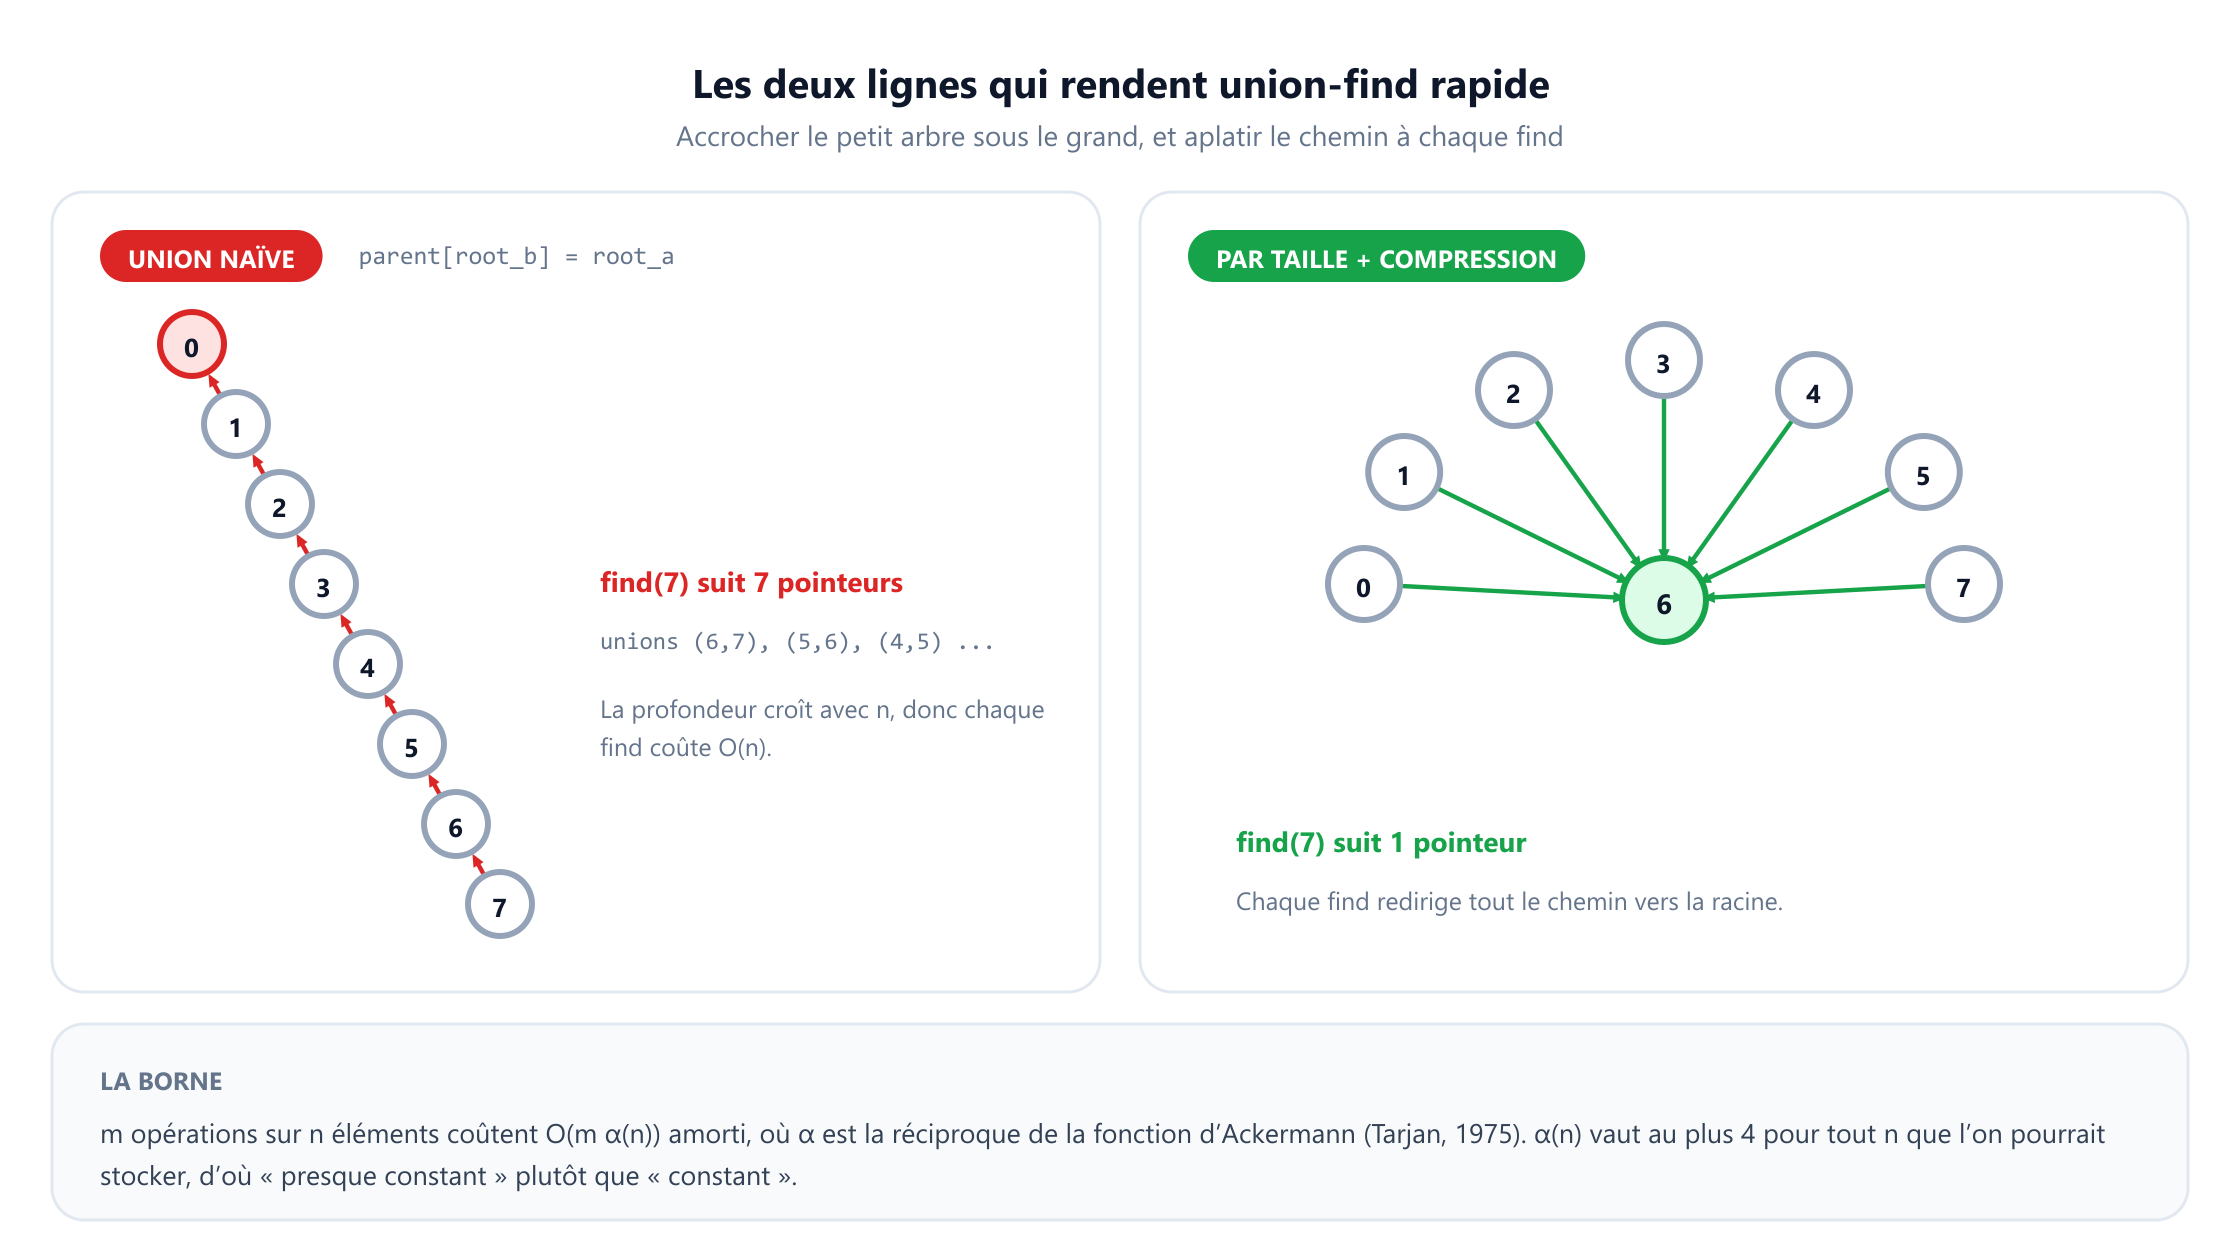
parent[rb] = ra sans vérifier les tailles.Pourquoi les deux optimisations ? L'union par taille seule borne la profondeur à O(log n), car un arbre ne grandit que lorsque deux arbres de même taille fusionnent. La compression de chemin seule donne aussi O(log n) en amorti. Ensemble, elles donnent O(α(n)) en amorti par opération, c'est la section 11. Si vous ne devez en retenir qu'une, retenez la compression de chemin : c'est une ligne et elle fait l'essentiel du travail en pratique.
Une remarque d'implémentation à glisser spontanément : l'union par rang et l'union par taille sont interchangeables pour la borne. Le rang stocke un majorant de la hauteur, la taille stocke le nombre d'éléments. La taille est plus utile en entretien, car la moitié des relances demandent la taille de la composante obtenue, et vous l'avez déjà.
3. Compter les composantes connexes
La question. Étant donnés n nœuds et une liste d'arêtes non orientées, combien y a-t-il de composantes connexes ? La formulation classique est LeetCode 323, et Number of Provinces est la même question avec une matrice d'adjacence.
Avec le modèle ci-dessus, il ne reste aucun algorithme à écrire.
def count_components(n, edges):
    dsu = DSU(n)
    for a, b in edges:
        dsu.union(a, b)
    return dsu.count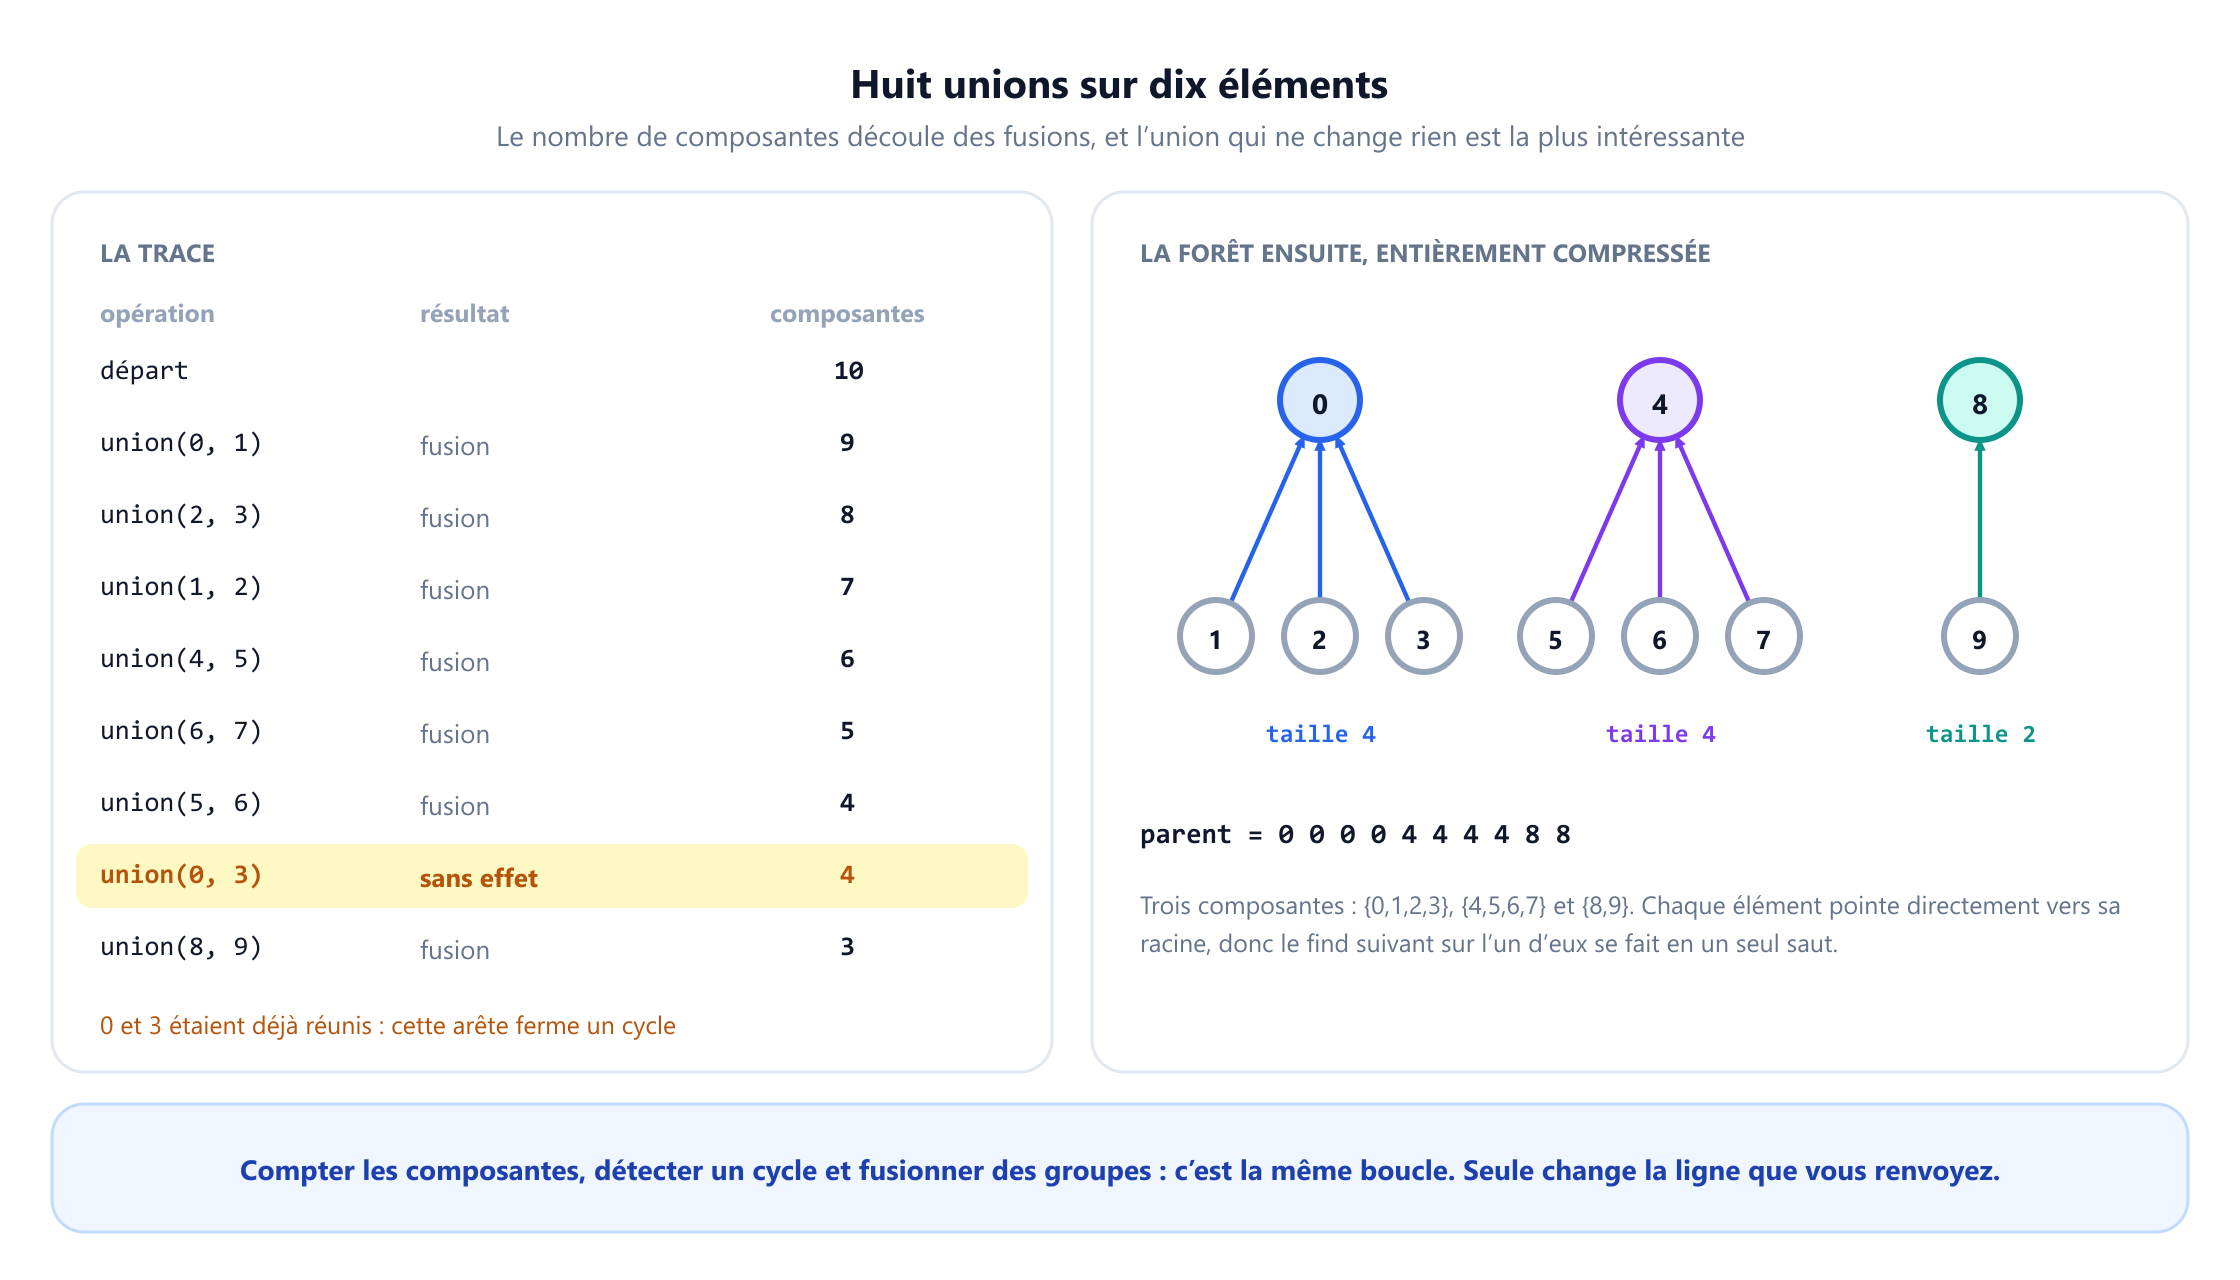
Sur l'exemple, dix éléments et les huit unions (0,1) (2,3) (1,2) (4,5) (6,7) (5,6) (0,3) (8,9) laissent trois composantes : {0,1,2,3}, {4,5,6,7} et {8,9}, de tailles 4, 4 et 2. Sept unions ont fusionné ; union(0, 3) non, car 0 et 3 étaient déjà dans le même arbre à ce moment-là.
Lancez ensuite un find sur chaque élément et la structure se termine en parent = 0 0 0 0 4 4 4 4 8 8 : chaque élément pointe directement vers la racine de sa composante, donc chaque requête ultérieure se fait en un seul saut. Cet aplatissement, c'est la compression de chemin qui se rembourse.
La relance : pourquoi ne pas simplement lancer un DFS ? Sur un graphe statique, faites-le. Les deux sont linéaires et le DFS n'a besoin d'aucune structure supplémentaire, donc sortir union-find sur une liste d'arêtes fixe est plutôt un petit signal d'alerte qu'un atout. La réponse honnête est qu'union-find mérite sa place quand les arêtes arrivent au fil du temps, quand il faut la réponse après chaque arrivée, ou quand le graphe est trop grand pour tenir en liste d'adjacence mais que les paires défilent en flux. Le dire sans qu'on vous le demande vous distingue des candidats qui réagissent par réflexe au mot « composantes ».
Le piège. Renvoyer len(set(parent)), qui compte les valeurs distinctes de parent sans jamais appeler find. Avant compression, le tableau des parents contient des nœuds intermédiaires et non des racines, donc le compte sort trop élevé. Tenez à jour count dans union et la question ne se pose plus.
4. Redundant Connection : l'arête qui ferme un cycle
La question. Un arbre à n nœuds a reçu une arête de trop. Trouvez l'arête que l'on peut retirer, et si plusieurs conviennent, renvoyez celle qui apparaît en dernier dans l'entrée.
C'est le booléen renvoyé par union, et rien d'autre.
def find_redundant(edges):
    dsu = DSU(len(edges) + 1)
    for a, b in edges:
        if not dsu.union(a, b):          # a et b étaient déjà connectés
            return [a, b]                # donc cette arête ferme un cycle
Traitez les arêtes dans l'ordre : la première pour laquelle union renvoie False est la réponse. C'est aussi automatiquement la dernière de ce type dans l'entrée, car un arbre plus une arête a exactement un cycle, donc exactement une arête échoue. Sur [[1,2],[2,3],[3,4],[1,4],[1,5]] la réponse est [1,4], et sur le triangle [[1,2],[1,3],[2,3]] c'est [2,3].
La relance : et si le graphe est orienté ? C'est Redundant Connection II, et c'est un problème réellement plus difficile, pas une variante. Une version orientée peut échouer de deux façons : un nœud avec deux parents, ou un cycle, et elle peut présenter les deux à la fois. La technique consiste à trouver le nœud de degré entrant deux, à retirer à titre d'essai chacune de ses deux arêtes candidates, et à vérifier avec union-find si le reste forme un arbre enraciné valide. Savoir que le cas orienté se découpe en sous-cas suffit ; les recruteurs vous le font rarement écrire.
Le piège. Utiliser DSU(n) quand les nœuds sont numérotés de 1 à n. Tous les bugs union-find de cette famille sont un décalage de un sur la taille du tableau, et ils se manifestent par une erreur d'indice sur le tout dernier nœud plutôt que par une mauvaise réponse. Allouez n + 1 et ignorez la case zéro.
5. Islands II : pourquoi BFS perd quand la grille change
La question. Une grille m × n vide, remplie d'eau. On ajoute de la terre une cellule à la fois. Après chaque ajout, indiquez combien d'îles existent.
C'est la question qui justifie toute la structure de données, alors traitez-la comme celle qu'il faut réussir. Compter les îles d'une grille fixe est un flood fill, et cela coûte O(mn). Le refaire après chacun des k ajouts coûte O(k × mn), ce qui est quadratique et dépassera le temps imparti. Union-find ramène chaque ajout à une quantité de travail constante, car ajouter de la terre ne peut que fusionner des îles, jamais les séparer.
def num_islands2(m, n, positions):
    dsu, seen, out, count = {}, set(), [], 0
    for r, c in positions:
        if (r, c) in seen:               # une position répétée n'ajoute rien
            out.append(count)
            continue
        seen.add((r, c))
        dsu[(r, c)] = (r, c)             # une nouvelle île d'une cellule
        count += 1
        for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
            nb = (r + dr, c + dc)
            if nb in seen and union(dsu, (r, c), nb):
                count -= 1               # fusionnée avec un voisin
        out.append(count)
    return out
Chaque nouvelle cellule commence comme sa propre île, puis fusionne avec au plus quatre voisines, donc chaque étape coûte O(α) et l'exécution complète O(k α(mn)). Sur une grille 3 par 3 avec de la terre ajoutée en (0,0), (0,1), (1,2), (2,1) les réponses sont 1, 1, 2, 3 : la deuxième cellule rejoint la première, puis les deux suivantes sont isolées. Ajoutez (1,1) comme cinquième coup : elle touche les trois, et la suite se termine par 1, 1, 2, 3, 1.
La relance : et si l'on peut aussi retirer de la terre ? Dites clairement qu'union-find ne gère pas la suppression, car il est impossible de défaire une fusion une fois les chemins compressés. Les vraies réponses sont de traiter les opérations hors ligne en sens inverse, ce qui transforme les suppressions en ajouts, ou d'utiliser un union-find avec retour arrière, qui garde une pile d'annulation et renonce donc à la compression de chemin au profit de l'union par rang seule, en O(log n). Citer « l'inversion hors ligne » suffit généralement.
Le piège. Oublier que la même position peut apparaître deux fois dans l'entrée. Ajouter de la terre là où il y en a déjà ne doit pas incrémenter le compte, et la garde tient en une ligne. C'est d'ailleurs le seul cas de test caché de ce problème.
6. Accounts Merge : quand les éléments ne sont pas des entiers
La question. Chaque compte est un nom suivi d'une liste d'e-mails. Deux comptes appartiennent à la même personne dès qu'ils partagent un e-mail. Fusionnez-les et renvoyez les e-mails de chaque personne, triés.
La structure est trivialement union-find. Ce que la question évalue vraiment, c'est la plomberie : vos éléments sont des chaînes, et le DSU à base de tableaux a besoin d'entiers.
ids = {}
for account in accounts:
    for mail in account[1:]:
        if mail not in ids:
            ids[mail] = len(ids)         # attribuer à chaque e-mail un entier dense
        owner[mail] = account[0]

dsu = DSU(len(ids))
for account in accounts:
    first = ids[account[1]]
    for mail in account[2:]:
        dsu.union(first, ids[mail])      # relier chaque e-mail au premier
Unissez chaque e-mail d'un compte au premier e-mail de ce compte, ce qui suffit à faire de tout le compte une seule composante, puis regroupez les e-mails par racine et triez chaque groupe. Fusionner John [a, b], John [c, b], Mary [m] et un second John [z] donne trois personnes : John avec a, b, c, Mary avec m, et un autre John avec seulement z.
Ce dernier groupe est tout l'intérêt de la question. Le nom n'est pas l'identité. Deux comptes portant le même nom sans e-mail commun sont deux personnes différentes, et un candidat qui unit par le nom obtient une réponse fausse mais plausible que l'exemple d'entrée est justement conçu pour piéger.
La relance : pourriez-vous éviter la correspondance vers des identifiants ? Oui, en stockant parent comme un dictionnaire indexé par la chaîne elle-même, ce qui coûte un hachage par accès au lieu d'un indice de tableau. C'est plus propre à écrire et plus lent à exécuter, et dire quel compromis vous faites est ce qui est noté. Dans un langage sans dictionnaires dans le chemin critique, ou quand la même structure est réutilisée des millions de fois, la correspondance vers des entiers denses l'emporte.
Le piège. Retrouver le nom à partir de l'e-mail de la racine au lieu de garder une table e-mail vers nom. Après compression, la racine peut être n'importe quel e-mail du groupe, et si vous avez associé le nom à un e-mail précis, vous attacherez le mauvais nom à un compte fusionné.
7. Most Stones Removed : choisir ce que l'on unit
La question. Des pierres sont posées sur une grille. Vous pouvez retirer une pierre si elle partage une ligne ou une colonne avec une autre pierre restante. Quel est le nombre maximal de pierres que vous pouvez retirer ?
Deux idées, et c'est la seconde qui en fait une bonne question d'entretien.
D'abord, dans tout groupe connexe de pierres, on peut toutes les retirer sauf une. Retirez-les dans l'ordre inverse de la construction d'un arbre couvrant du groupe, feuilles d'abord, et la dernière pierre debout garde le groupe valide à chaque étape. La réponse est donc nombre de pierres - nombre de composantes, et tout le problème se ramène à compter des composantes.
Ensuite, et c'est la partie difficile sous pression : n'unissez pas les pierres. Unissez les lignes et les colonnes.
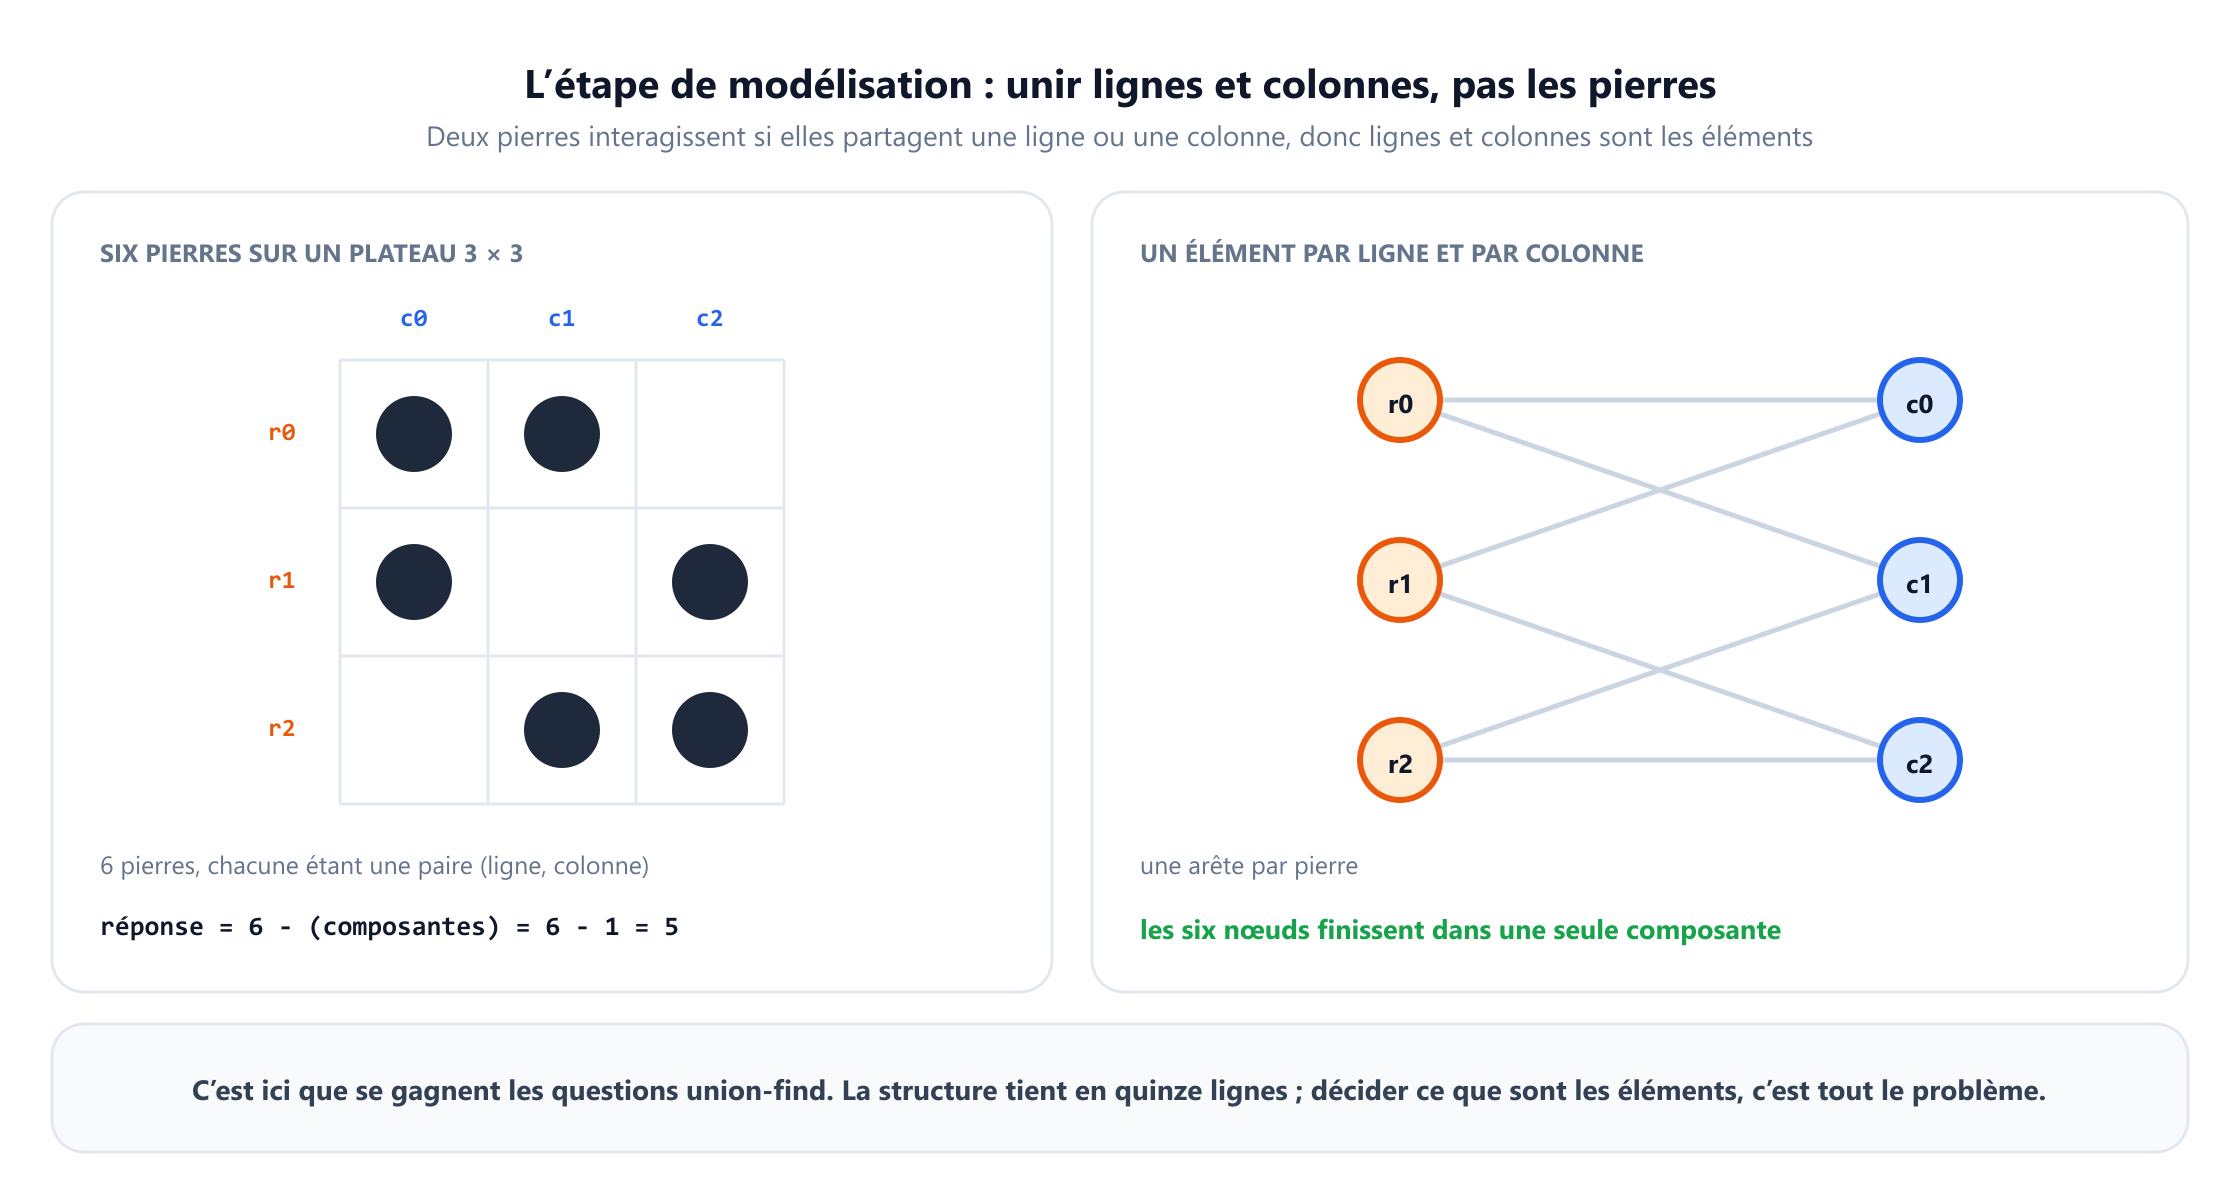
Chaque pierre en (r, c) devient un seul union(ligne r, colonne c). Deux pierres se retrouvent connectées exactement quand elles partagent une ligne ou une colonne, ou sont reliées par une chaîne de pierres qui le font, ce qui est la relation décrite par le problème. Cela transforme aussi une comparaison deux à deux en O(k2) en un traitement en O(k α). Sur l'exemple à six pierres, tout le plateau s'effondre en une composante et la réponse est 5. Sur [[0,0],[0,2],[1,1],[2,0],[2,2]] il y a deux composantes et la réponse est 3.
La relance : comment éviter que lignes et colonnes entrent en collision ? Elles vivent dans la même structure, donc la ligne 2 et la colonne 2 doivent être des éléments différents. Décalez les colonnes d'une constante supérieure à tout indice de ligne, couramment c + 10001 pour les limites de l'énoncé, ou utilisez un dictionnaire indexé par ("r", r) et ("c", c). Évoquer la collision avant le recruteur vaut cher sur ce problème.
Le piège. Compter les composantes sur toutes les lignes et colonnes existantes plutôt que sur celles qui contiennent réellement une pierre. Les lignes vides sont des éléments isolés, chacune gonfle le nombre de composantes, et la réponse sort trop petite. Ne créez un élément que la première fois qu'une pierre en a besoin.
8. Evaluate Division : union-find pondéré
La question. On vous donne des équations comme a / b = 2.0 et b / c = 3.0, et l'on vous demande de répondre à des requêtes comme a / c, en renvoyant -1 quand la réponse ne peut pas être déterminée.
La plupart des candidats construisent un graphe et lancent un DFS qui multiplie les poids des arêtes le long du chemin, ce qui est une réponse tout à fait correcte. La réponse plus forte est l'union-find pondéré : stocker, à côté de chaque pointeur vers le parent, le rapport entre la valeur de l'enfant et celle du parent. Alors find renvoie à la fois la racine et le rapport accumulé jusqu'à elle, et toute requête se réduit à une division.
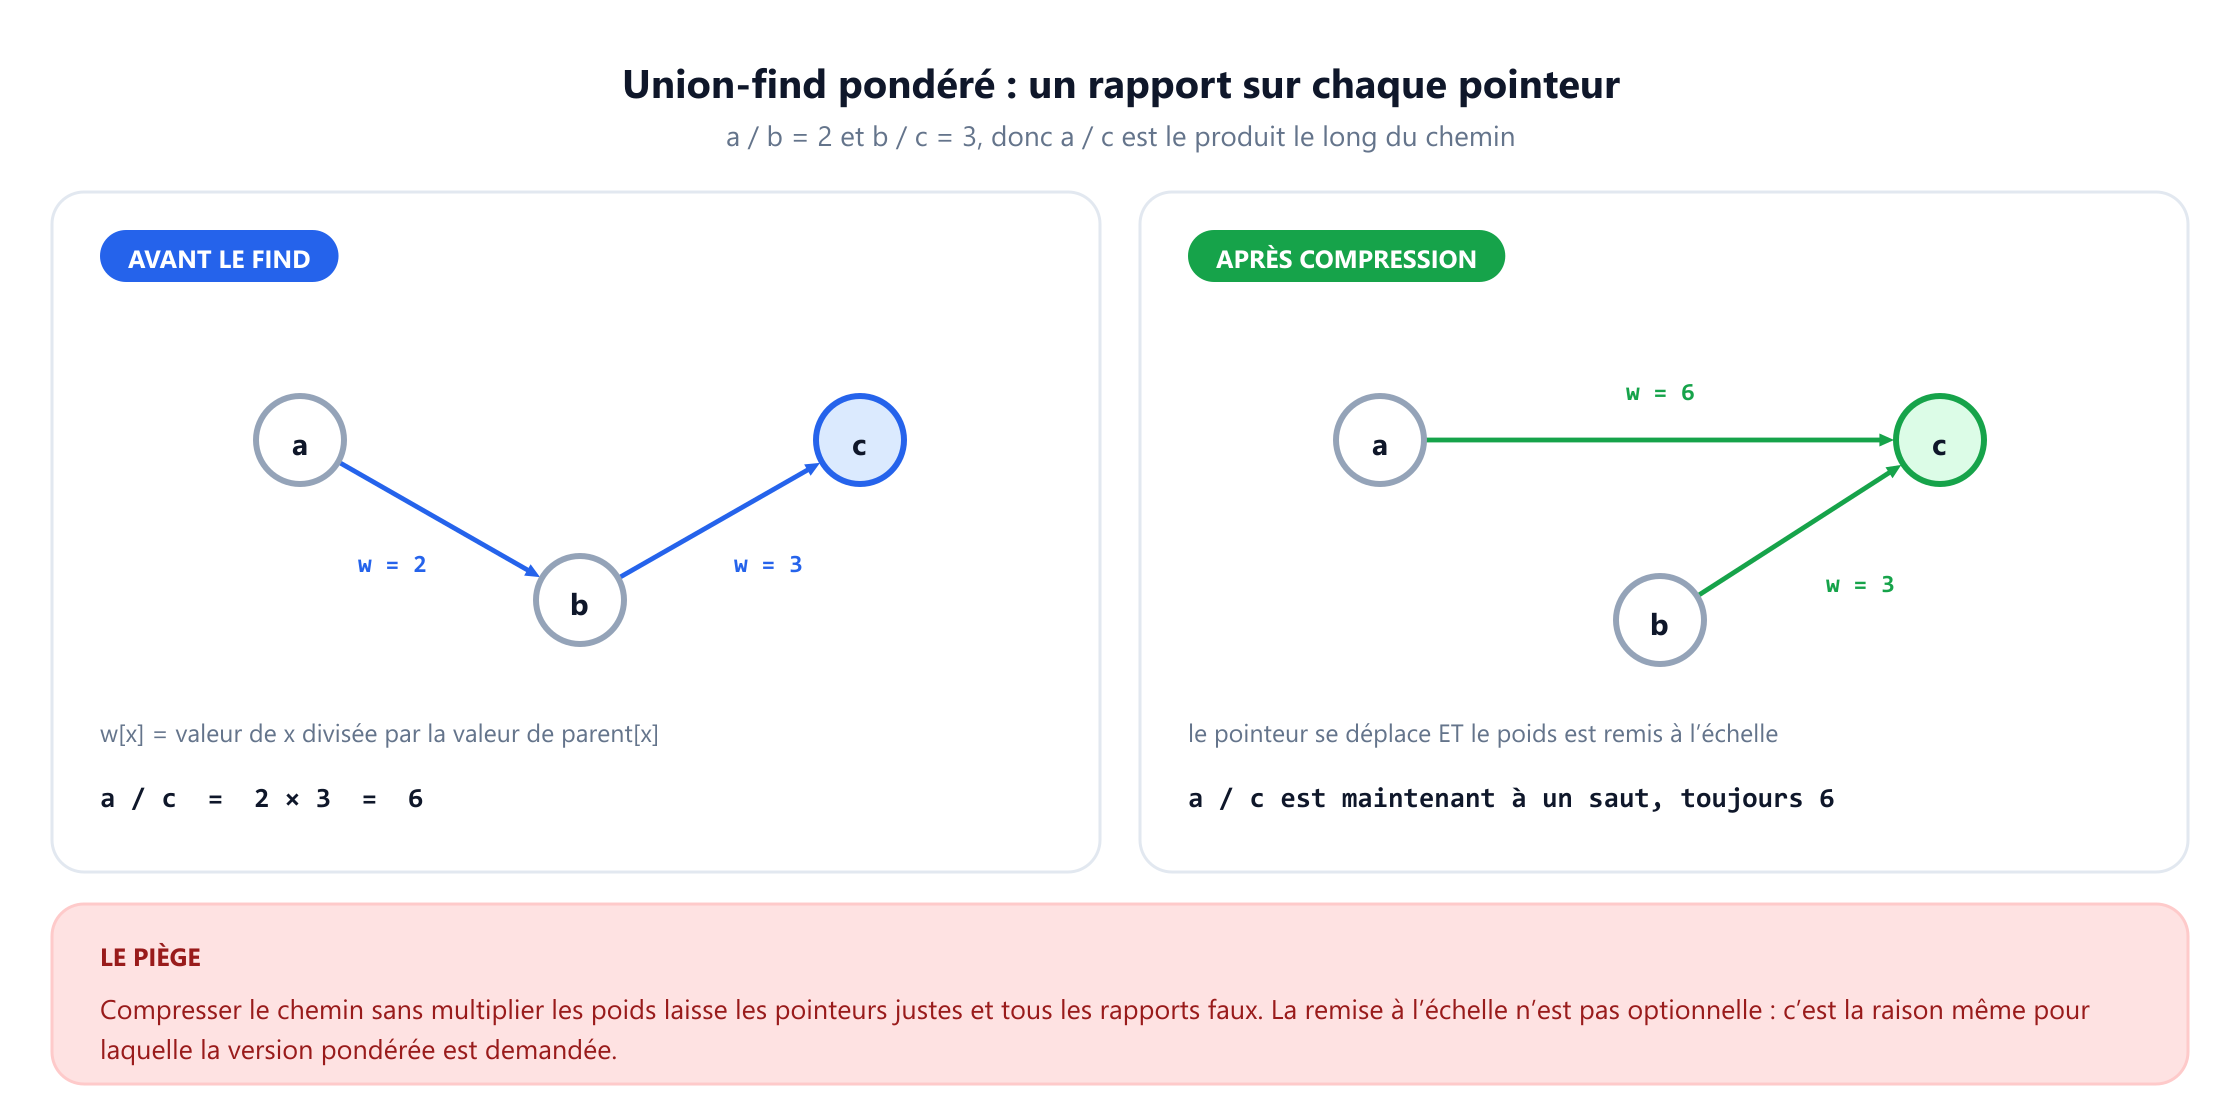
def find(x):                              # renvoie (racine, valeur de x / valeur de la racine)
    if parent[x] == x:
        return x, 1.0
    root, wp = find(parent[x])
    weight[x] *= wp                       # remettre à l'échelle pendant l'aplatissement
    parent[x] = root
    return root, weight[x]
Avec a / b = 2 et b / c = 3, les requêtes donnent a / c = 6, b / a = 0.5, c / a = 1/6, a / a = 1, et -1 pour tout ce qui mentionne un symbole jamais apparu, et c'est pourquoi x / x vaut -1 et non 1 dans le problème standard. Ce dernier cas est un piège délibéré, et il attrape ceux qui traitent à part les arguments égaux avant de vérifier que le symbole existe.
La relance : comment détecter une contradiction ? Si union(a, b, v) constate que a et b partagent déjà une racine, ne fusionnez pas ; comparez plutôt le rapport implicite à v. Un écart au-delà de la tolérance des flottants signifie que l'entrée est incohérente. La même structure, avec une addition au lieu d'une multiplication, répond à « cet ensemble de contraintes de décalage est-il satisfiable », et c'est sous cette forme que la technique apparaît dans les problèmes d'ordonnancement.
Le piège. Compresser le chemin sans mettre à jour le poids, c'est-à-dire l'erreur contre laquelle la figure met en garde. Les pointeurs restent justes, chaque requête suivante renvoie en silence un mauvais nombre, et le bug survit à tout test qui ne vérifie que la connexité.
9. Équations d'égalité : l'ordre de traitement
La question. Étant données des équations comme "a==b" et "b!=c" sur des lettres minuscules isolées, déterminez si elles peuvent toutes être vraies en même temps.
La solution tient en quatre lignes et une idée : deux passes, les égalités d'abord.
dsu = DSU(26)
for e in equations:
    if e[1] == '=':
        dsu.union(ord(e[0]) - 97, ord(e[3]) - 97)
for e in equations:
    if e[1] == '!':
        if dsu.find(ord(e[0]) - 97) == dsu.find(ord(e[3]) - 97):
            return False
return True
L'égalité est une relation d'équivalence, elle partitionne donc les lettres en groupes qui doivent avoir la même valeur. L'inégalité n'est pas une relation d'équivalence et ne peut pas du tout être unie ; elle ne peut être que vérifiée contre la partition terminée. Traitez-les en une seule passe entremêlée et la réponse dépend de l'ordre de l'entrée, ce qui est précisément le bug que cette question veut débusquer : ["a!=b", "a==b"] serait accepté, car l'inégalité est testée avant l'union qui la contredit.
Sorties vérifiées : ["a==b","b!=a"] donne False, ["a==b","b==c","a==c"] donne True, ["a==b","b!=c","c==a"] donne False, et l'équation seule ["a!=a"] donne False, car une lettre est toujours égale à elle-même.
La relance : et si les variables n'étaient pas des lettres isolées ? Exactement la correspondance vers des identifiants de la section 6 : associer chaque nom à un entier dense, ou indexer le dictionnaire des parents par le nom. Rien d'autre ne change, et c'est bon à souligner, car cela montre que vous voyez la structure séparément de l'encodage.
Le piège. Allouer le DSU sur les lettres présentes plutôt que sur les 26. Cela fonctionne, et vous coûte les deux minutes passées à construire une correspondance pour un alphabet déjà dense et minuscule. Lisez les contraintes avant d'écrire du code générique.
10. Kruskal : union-find dans un arbre couvrant
La question. Reliez tous les points pour un coût total minimal, le coût entre deux points étant leur distance de Manhattan. C'est LeetCode 1584, et c'est un arbre couvrant minimal déguisé.
Ici, union-find n'est pas la réponse, c'est la pièce qui fait fonctionner la réponse. L'algorithme de Kruskal trie toutes les arêtes candidates par poids et accepte une arête exactement quand elle relie deux composantes différentes, ce qui est le booléen renvoyé par union.
edges.sort()                              # par poids
dsu, total, used = DSU(n), 0, 0
for w, a, b in edges:
    if dsu.union(a, b):                   # seulement si elle relie deux composantes
        total += w
        used += 1
        if used == n - 1:                 # un arbre couvrant a n-1 arêtes
            break
Sur les cinq points [[0,0],[2,2],[3,10],[5,2],[7,0]] il y a 10 arêtes candidates, Kruskal en garde quatre, de poids 3, 4, 4 et 9, et le total vaut 20. La sortie anticipée à n - 1 arêtes compte sur les entrées denses, où la liste des candidates est en O(n2) et où l'essentiel n'est jamais utilisé.
La relance : Prim ou Kruskal ici ? Pour un graphe complet sur n points, Kruskal construit et trie n(n-1)/2 arêtes, soit O(n2 log n), alors que Prim avec un parcours de tableau tourne en O(n2) et ne matérialise jamais la liste d'arêtes. Sur une instance dense, Prim est la meilleure réponse, et savoir que Kruskal est l'algorithme des graphes creux est tout l'objet de la question. Le compromis est détaillé dans les arbres couvrants minimaux et dans l'algorithme de Kruskal.
Le piège. Ajouter le poids avant de tester l'union, si bien que les arêtes rejetées contribuent quand même au total. Cela donne un nombre assez proche pour sembler juste sur l'exemple, et faux sur tout le reste.
11. Les réponses sur la complexité
C'est le seul sujet où la réponse honnête est un peu inconfortable, et les recruteurs la demandent précisément pour cette raison.
| Version | Amorti par opération | Source |
|---|---|---|
| Aucune optimisation | O(n) | La chaîne de la figure ci-dessus |
| Union par taille ou rang seule | O(log n) | La profondeur ne double que lors de fusions égales |
| Compression de chemin seule | O(log n) | Tarjan et van Leeuwen, 1984 |
| Les deux ensemble | O(α(n)) | Tarjan, 1975 |
| Toute structure à pointeurs | Ω(α(n)) | Fredman et Saks, 1989 |
α est la réciproque de la fonction d'Ackermann, et elle croît si lentement que α(n) ≤ 4 pour tout n qui pourrait être stocké dans un ordinateur physique. La réponse pratique est donc « en pratique constant », et la réponse correcte est « O(α(n)) en amorti, ce qui n'est pas la même chose que O(1) ». La différence est réelle : Fredman et Saks ont prouvé en 1989 qu'aucune structure de ce type ne peut faire mieux, donc le α n'est pas un artefact de l'analyse.
Deux autres chiffres à avoir en tête. L'espace est en O(n), deux tableaux d'entiers. Et l'amortissement porte sur la séquence, pas sur l'appel : un seul find peut encore parcourir un long chemin, c'est le total sur m opérations qui est borné. Les recruteurs insistent parfois sur ce point, et « amorti, pas pire cas par opération » est la formule qu'ils attendent.
Pour vérifier à quel point les arbres deviennent plats : après 200 000 unions aléatoires sur 100 000 éléments et un find sur chaque élément, l'arbre le plus profond de la structure a pour profondeur un seul pointeur. Chaque élément pointe directement vers sa racine.
12. Les erreurs qui font échouer l'entretien
Classées par fréquence ; les trois premières expliquent la plupart des solutions rejetées.
- Comparer des éléments au lieu des racines.
if a == blà où l'on voulaitif find(a) == find(b). Cela compile, cela tourne, et cela répond à une autre question. - Oublier l'union par taille. La compression de chemin seule passe généralement, donc l'erreur survit aux tests puis se dégrade sur une entrée hostile. Les deux optimisations tiennent chacune en une ligne ; écrivez les deux.
- Un
findrécursif sur une entrée profonde. Cent mille unions chaînées, ce sont cent mille cadres de pile. Écrivez la version itérative, ou expliquez pourquoi la profondeur de récursion est sans danger ici. - Décalage de un sur la taille du tableau. Des nœuds numérotés de 1 à n exigent
DSU(n + 1). C'est le plantage le plus courant dans ces problèmes. - Unir les mauvaises choses. Des pierres au lieu des lignes et colonnes, des comptes au lieu des e-mails, des noms au lieu des identités. Quand la version deux à deux paraît quadratique, ce sont généralement les éléments qui sont mal choisis.
- Entremêler égalités et inégalités. Les contraintes qui fusionnent doivent toutes être appliquées avant toute contrainte qui se contente de vérifier. Deux passes, toujours.
- Oublier qu'union-find ne sait pas supprimer. Si le problème retire des arêtes, dites-le tout de suite et proposez l'inversion hors ligne ou une structure avec retour arrière. Essayer de greffer la suppression sur une structure compressée est une impasse.
- Ne pas tenir à jour le nombre de composantes. Le recalculer avec une boucle de
findaprès chaque opération transforme une solution linéaire en solution quadratique, exactement le travers qu'Islands II est conçu pour révéler. - Annoncer O(1). C'est
O(α(n))en amorti. Dites « en pratique constant, formellement réciproque d'Ackermann » et la relance disparaît.
L'habitude qui évite la plupart de ces erreurs : avant d'écrire quoi que ce soit, dites ce que représente un élément et ce que signifie que deux éléments soient dans le même ensemble. Si vous ne pouvez pas terminer les deux moitiés de cette phrase, vous n'avez pas encore modélisé le problème, et les quinze lignes ne vous sauveront pas.
13. Questions fréquentes
Qu'est-ce qu'union-find, en termes simples ?
+
C'est une structure qui sait quels éléments appartiennent au même groupe, avec deux opérations : find, qui demande dans quel groupe se trouve un élément, et union, qui fusionne deux groupes. Chaque groupe est stocké comme un arbre de pointeurs vers le parent et identifié par la racine de cet arbre, donc deux éléments sont dans le même groupe exactement quand ils ont la même racine. On l'appelle aussi disjoint set union, ou DSU.
Quand utiliser union-find plutôt que BFS ou DFS ?
+
Utilisez un parcours quand le graphe est fixe et que vous le balayez une fois, puisque les deux approches sont linéaires et qu'un parcours n'a besoin d'aucune structure supplémentaire. Utilisez union-find quand les arêtes arrivent au fil du temps et que la réponse est nécessaire après chacune, quand le problème ne fait que fusionner des groupes sans jamais les séparer, ou quand vous voulez le booléen « étaient-ils déjà connectés » à l'intérieur d'un autre algorithme, ce que fait l'algorithme de Kruskal. Union-find n'a pas non plus besoin que la liste d'adjacence existe, ce qui compte quand les paires défilent en flux au lieu de tenir en mémoire.
Union-find est-il vraiment en O(1) ?
+
Non, et il vaut la peine de bien répondre. Avec l'union par taille ou par rang plus la compression de chemin, m opérations sur n éléments coûtent O(m fois alpha de n) en amorti, où alpha est la réciproque de la fonction d'Ackermann. Alpha de n vaut au plus 4 pour tout n qui pourrait être physiquement stocké, donc le comportement pratique est constant, mais la borne n'est pas O(1) et la différence n'est pas un détail : Fredman et Saks ont prouvé en 1989 qu'aucune structure de ce type ne peut battre alpha. Dites « en pratique constant, formellement réciproque d'Ackermann, amorti et non pire cas par appel ».
Union par rang ou union par taille ?
+
L'une ou l'autre, puisque les deux donnent la même borne asymptotique. Le rang stocke un majorant de la hauteur d'un arbre et la taille stocke le nombre d'éléments qu'il contient. En entretien, la taille est généralement le meilleur choix, car une bonne part des relances demandent la taille de la composante fusionnée, et avec l'union par taille vous avez ce nombre gratuitement. Quel que soit votre choix, accrochez le petit arbre sous le grand, jamais l'inverse.
Union-find gère-t-il les suppressions ?
+
Pas directement. Une fois les chemins compressés, il ne reste aucune trace de la façon dont les arbres ont été assemblés, donc une fusion ne peut pas être défaite. Il existe deux réponses classiques. Traiter les opérations hors ligne en sens inverse, ce qui transforme chaque suppression en ajout et permet de faire tourner un union-find ordinaire à rebours. Ou utiliser un union-find avec retour arrière, qui garde une pile d'annulation des modifications faites par chaque union et doit donc renoncer à la compression de chemin, ne laissant que l'union par rang en O(log n) par opération.
Comment utiliser union-find quand les éléments sont des chaînes ?
+
Deux options. Attribuer à chaque chaîne distincte un entier dense la première fois que vous la voyez et utiliser la structure ordinaire à base de tableaux, plus rapide, et c'est ce que vous voulez quand la structure est dans une boucle critique. Ou stocker la table des parents comme un dictionnaire indexé par la chaîne elle-même, plus court à écrire, au prix d'une recherche par hachage à chaque accès. Les deux sont correctes ; dire quel compromis vous faites est ce que le recruteur veut entendre.
Quels problèmes d'entretien relèvent d'union-find ?
+
Number of Connected Components, Number of Provinces, Redundant Connection, Number of Islands II, Accounts Merge, Most Stones Removed, Evaluate Division, Satisfiability of Equality Equations, Min Cost to Connect All Points, Graph Valid Tree, Smallest String With Swaps et Regions Cut By Slashes. L'indice est une question sur l'appartenance de deux choses au même groupe, ou un nombre de groupes qui doit survivre à un flux de fusions.
14. Références
Les articles qui ont introduit ces techniques et les ouvrages qui les analysent, par ordre chronologique.
- Kruskal, J. B. (1956). “On the shortest spanning subtree of a graph and the traveling salesman problem.” Proceedings of the American Mathematical Society, 7(1), 48–50.
- Galler, B. A. et Fischer, M. J. (1964). “An improved equivalence algorithm.” Communications of the ACM, 7(5), 301–303.
- Hopcroft, J. E. et Ullman, J. D. (1973). “Set merging algorithms.” SIAM Journal on Computing, 2(4), 294–303.
- Tarjan, R. E. (1975). “Efficiency of a good but not linear set union algorithm.” Journal of the ACM, 22(2), 215–225.
- Tarjan, R. E. et van Leeuwen, J. (1984). “Worst-case analysis of set union algorithms.” Journal of the ACM, 31(2), 245–281.
- Fredman, M. et Saks, M. (1989). “The cell probe complexity of dynamic data structures.” Proceedings of the 21st Annual ACM Symposium on Theory of Computing, 345–354.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. et Stein, C. (2009). Introduction to Algorithms, 3e édition, chapitre 21. MIT Press.
- Sedgewick, R. et Wayne, K. (2011). Algorithms, 4e édition, section 1.5. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6e édition. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3e édition, chapitre 8. Springer.