
Table des Matières
- 1. Ce qu'une question sur le DFS évalue vraiment
- 2. Le modèle, récursif et itératif
- 3. Détection de cycles dans un graphe orienté
- 4. Détection de cycles dans un graphe non orienté
- 5. Tri topologique par post-ordre
- 6. Clone graph
- 7. Tous les chemins : le DFS comme backtracking
- 8. Word search sur une grille
- 9. Composantes fortement connexes
- 10. Ponts et points d'articulation
- 11. Complexité, et la question de la profondeur de récursion
- 12. Les erreurs qui font échouer l'entretien
- 13. Questions fréquentes
- 14. Références
1. Ce qu'une question sur le DFS évalue vraiment
Les questions sur le DFS ne portent pas sur le parcours. N'importe quel candidat sait parcourir un graphe. Ce qu'on vérifie, c'est si vous connaissez les informations de suivi que le DFS rend disponibles et que le BFS n'offre pas : l'ordre dans lequel les sommets se terminent, le fait qu'un sommet soit encore sur la pile, et jusqu'où un sous-arbre peut remonter.
C'est tout le sujet. Détection de cycles, tri topologique, composantes fortement connexes, ponts et points d'articulation : tous se ramènent à un parcours plus un tableau supplémentaire. Si une question porte sur l'ordre, les dépendances, les cycles ou sur ce qui casse si l'on retire ceci, c'est une question de DFS. Si elle demande le moins de quelque chose, c'est une question de BFS.
Les huit ci-dessous sont celles qui reviennent, chacune avec le problème, la solution, la relance et l'erreur qui coûte l'offre. Chaque exemple détaillé a été exécuté par script.
2. Le modèle, récursif et itératif
Le DFS récursif tient en quatre lignes, et vous devez pouvoir l'écrire sans réfléchir.
def dfs(u, adj, seen):
    seen.add(u)
    for v in adj[u]:
        if v not in seen:
            dfs(v, adj, seen)
C'est sur la version itérative que les candidats trébuchent, car la traduction évidente diffère subtilement de la version récursive.
def dfs_iter(src, adj):
    seen, stack = set(), [src]
    while stack:
        u = stack.pop()
        if u in seen:            # un sommet peut être empilé plusieurs fois
            continue
        seen.add(u)
        for v in adj[u]:
            if v not in seen:
                stack.append(v)
Deux points à remarquer, et à dire à voix haute.
- Testez
seenau dépilement, pas seulement à l'empilement. Contrairement au BFS, le même sommet peut se trouver plusieurs fois sur la pile, empilé par plusieurs voisins avant qu'aucun ne soit développé. Sans le test au dépilement, vous obtenez des visites en double. - L'ordre de visite diffère de la version récursive. Des voisins empilés par ordre croissant sont dépilés par ordre décroissant : le DFS itératif explore donc d'abord le dernier voisin. Empilez-les à l'envers pour obtenir le même ordre. Un piège très apprécié des recruteurs.
Le point le plus délicat : la version itérative simple n'a pas de post-ordre. Elle sait quand un sommet est découvert, jamais quand son sous-arbre se termine, et le temps de fin est exactement ce dont ont besoin les sections 5, 9 et 10. Pour le retrouver, empilez chaque sommet deux fois ou gardez un indice d'enfant dans le cadre. Savoir que la récursion n'est pas qu'une question de forme ici mérite d'être dit.
La technique est ancienne : c'est la règle de Trémaux pour parcourir un labyrinthe, consignée par Lucas en 1882.
3. Détection de cycles dans un graphe orienté
La question. Un graphe orienté contient-il un cycle ? Formulé comme détection d'interblocage, boucles de dépendances de compilation ou « ce programme de cours peut-il être suivi jusqu'au bout ? ».
La mauvaise réponse est un unique ensemble visited : atteindre un sommet déjà vu ne signifie pas un cycle, ce peut être une seconde route vers une partie déjà terminée du graphe. La bonne réponse utilise trois couleurs : blanc pour non découvert, gris pour découvert mais encore sur la pile de récursion, noir pour terminé.
WHITE, GREY, BLACK = 0, 1, 2

def has_cycle(adj, n):
    colour = [WHITE] * n

    def visit(u):
        colour[u] = GREY
        for v in adj[u]:
            if colour[v] == GREY:      # arc arrière : v est un ancêtre
                return True
            if colour[v] == WHITE and visit(v):
                return True
        colour[u] = BLACK              # ce n'est qu'ici que u est terminé
        return False

    return any(colour[s] == WHITE and visit(s) for s in range(n))
Un arc vers un sommet gris est un arc arrière, et un graphe orienté a un cycle si et seulement si un DFS trouve un arc arrière. Un arc vers un sommet noir est sans danger. Cette équivalence, et la classification des arcs en quatre types dont elle fait partie, est le traitement standard de Cormen, Leiserson, Rivest et Stein.
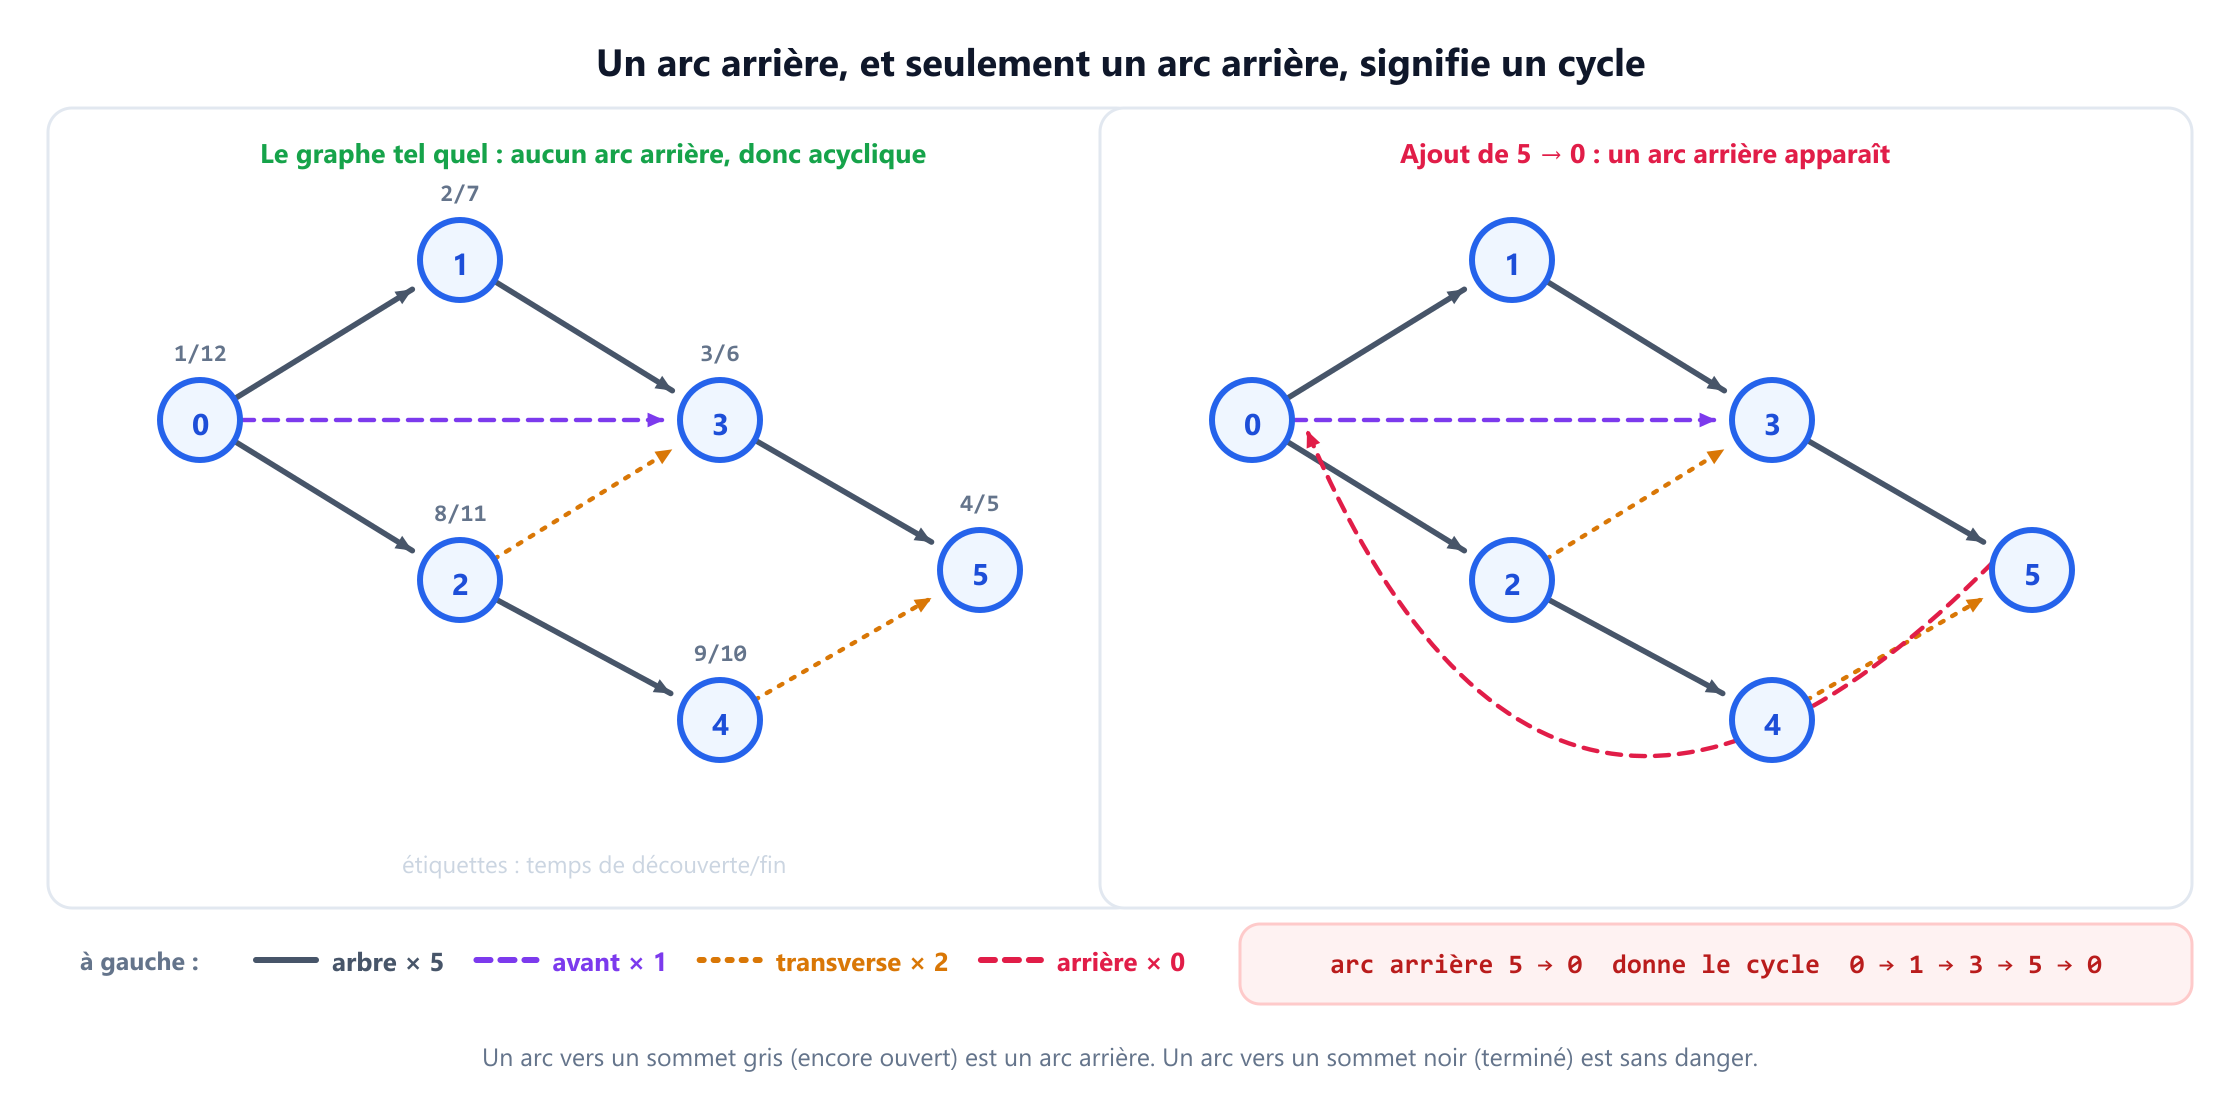
Sur le graphe d'exemple, un DFS depuis le sommet 0 classe ses 8 arcs en 5 arcs d'arbre, 1 arc avant et 2 arcs transverses, sans arc arrière, il est donc acyclique. Ajoutez le seul arc 5 → 0 et exactement un arc arrière apparaît.
La relance : affichez le cycle, pas seulement un booléen. L'arc arrière vous le donne : s'il s'agit de u → v, remontez les pointeurs parents de u jusqu'à v et fermez la boucle. Ici, l'arc arrière est 5 → 0 et le cycle est 0 → 1 → 3 → 5 → 0. Un tableau de parents coûte une ligne et transforme un oui ou non en diagnostic, celui qu'un vrai outil de compilation doit fournir.
Le piège. Placer colour[u] = BLACK au mauvais endroit, ou l'oublier. Laissez les sommets terminés en gris et chaque seconde route vers eux ressemble à un cycle : vous signalez de faux positifs sur tout DAG contenant un losange, comme le graphe d'exemple.
4. Détection de cycles dans un graphe non orienté
La question. Même problème, graphe non orienté. Il ressemble à la question précédente, et ce n'en est pas une variante.
Les trois couleurs sont fausses ici. Chaque arête non orientée se parcourt dans les deux sens : en passant de u à v, l'arête qui revient vers u ressemble à une arête vers un sommet gris, et chaque arête signale un cycle. Il faut plutôt ignorer l'arête par laquelle vous êtes arrivé.
def has_cycle_undirected(adj, n):
    seen = [False] * n

    def visit(u, parent):
        seen[u] = True
        for v in adj[u]:
            if not seen[v]:
                if visit(v, u): return True
            elif v != parent:          # un voisin déjà vu, autre que le parent
                return True
        return False

    return any(not seen[s] and visit(s, -1) for s in range(n))
Sans la garde v != parent, un graphe réduit à la seule arête 0-1 signale un cycle. Avec elle, un arbre à 4 sommets n'en signale correctement aucun et un triangle en signale correctement un. Ce sont les trois cas de test à vérifier au tableau, et les vérifier spontanément fait très bonne impression.
La relance : et les arêtes multiples ? Alors v != parent ne suffit plus : deux arêtes distinctes entre u et v forment réellement un cycle de longueur 2, et le test du parent avale la seconde. Mémorisez l'arête par laquelle vous êtes entré, pas le sommet. Voir graphes simples vs multigraphes.
Le piège. Un graphe non connexe. La boucle extérieure sur chaque sommet non visité n'est pas facultative, et une solution qui ne part que du sommet 0 passe tous les cas de test connexes.
5. Tri topologique par post-ordre
La question. Ordonnez les sommets d'un DAG de sorte que chaque arc pointe vers l'avant. La réponse par BFS est l'épluchage par degré entrant de Kahn ; la réponse par DFS est plus courte, et c'est celle qu'attend une question sur le DFS.
Lancez un DFS, ajoutez chaque sommet quand il se termine, inversez la liste. C'est tout l'algorithme, et la raison tient en une phrase : un sommet ne se termine qu'après tout ce qui est accessible depuis lui, il se termine donc après ses successeurs, et l'inversion le place devant eux.
def topological_sort(adj, n):
    colour = [0] * n           # 0 blanc, 1 gris, 2 noir
    order = []

    def visit(u):
        colour[u] = 1
        for v in adj[u]:
            if colour[v] == 1: raise ValueError("cycle")
            if colour[v] == 0: visit(v)
        colour[u] = 2
        order.append(u)        # post-ordre : APRÈS les enfants

    for s in range(n):
        if colour[s] == 0: visit(s)
    return order[::-1]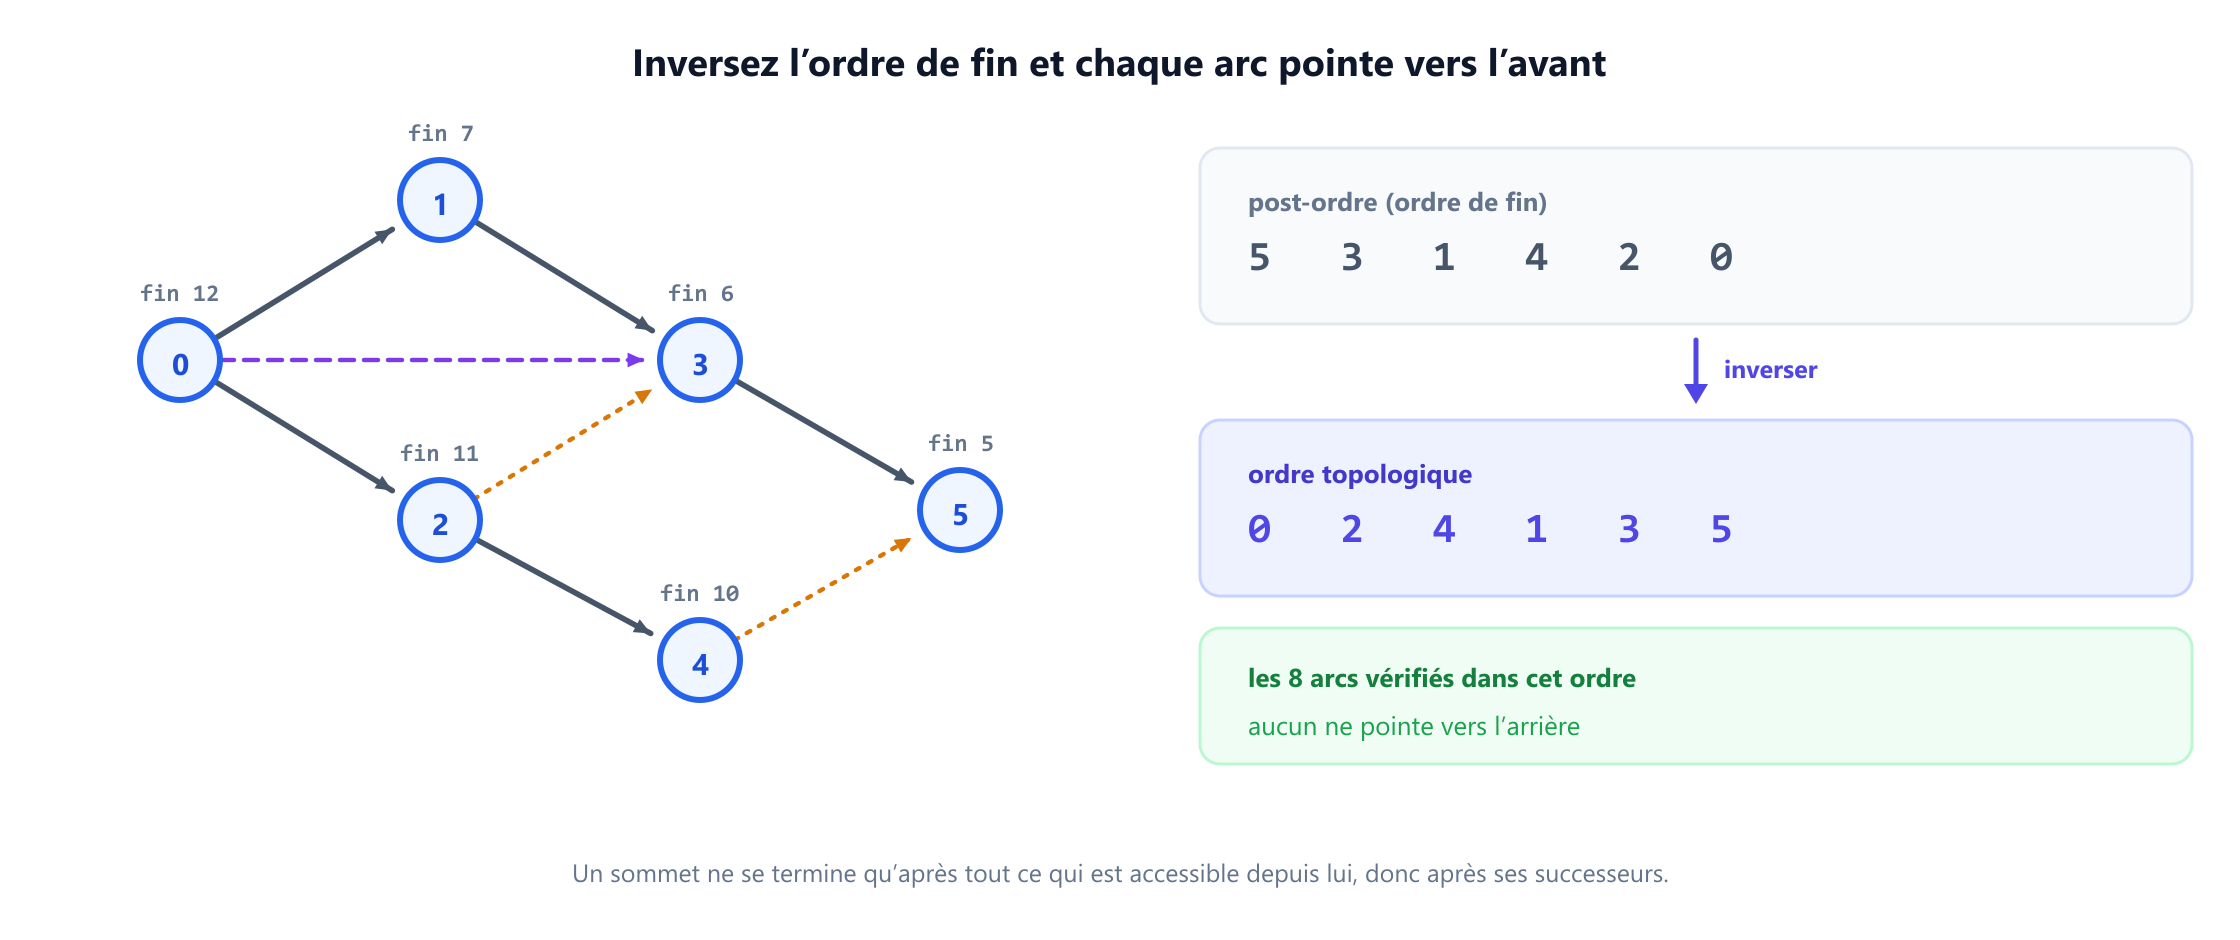
Sur le DAG d'exemple, le post-ordre est 5, 3, 1, 4, 2, 0 ; l'inverser donne 0, 2, 4, 1, 3, 5, et les huit arcs y pointent tous vers l'avant. Précisez qu'il s'agit d'un ordre topologique, et non du seul : un DAG en a généralement plusieurs.
La relance : comment détecter un cycle ici ? Avec le test du gris de la section 3. C'est tout l'intérêt : un seul parcours ordonne le DAG et rejette en même temps ce qui n'en est pas un, là où Kahn a besoin d'un comptage séparé à la fin. La formulation par DFS est due à Tarjan.
Le piège. Ajouter en pré-ordre, quand le sommet est découvert plutôt que quand il se termine. Le résultat semble plausible, il est faux, et sur de petits graphes il coïncide souvent avec un ordre valide, si bien qu'il survit à des tests superficiels.
6. Clone graph
La question. Étant donné une référence vers un nœud d'un graphe non orienté connexe, renvoyez une copie profonde.
La seule difficulté, ce sont les cycles : une copie récursive naïve boucle indéfiniment. La solution est une table qui associe chaque nœud d'origine à sa copie, qui sert aussi d'ensemble des visités, et elle doit être remplie avant la récursion.
def clone_graph(node, made=None):
    if node is None: return None
    if made is None: made = {}
    if node in made:
        return made[node]
    copy = Node(node.val)
    made[node] = copy              # enregistrer AVANT la récursion
    for nb in node.neighbors:
        copy.neighbors.append(clone_graph(nb, made))
    return copy
Enregistrer la copie avant les appels récursifs, c'est toute la question. Faites-le après, et un cycle vous ramène au point de départ avant que l'entrée existe : la récursion continue jusqu'à ce que la pile meure. C'est la même forme que la mémoïsation de toute structure autoréférentielle.
La relance : en itératif, ou en BFS ? Les deux fonctionnent, avec une table identique. Dites que c'est la table, et non l'ordre de parcours, qui rend la solution correcte. Le coût est de O(V + E) dans les deux cas.
7. Tous les chemins : le DFS comme backtracking
La question. Listez tous les chemins d'une source à une cible dans un DAG. Variantes : tous les chemins de la racine aux feuilles, somme de chemin, permutations.
C'est la famille où le DFS cesse d'être un parcours de graphe pour devenir du backtracking, et la différence tient en une ligne : vous annulez votre choix en repartant.
def all_paths(adj, src, dst):
    out, path = [], []

    def walk(u):
        path.append(u)
        if u == dst:
            out.append(path[:])    # COPIE, pas la liste vivante
        else:
            for v in adj[u]:
                walk(v)
        path.pop()                 # l'étape de backtracking

    walk(src)
    return out
Sur le DAG d'exemple, il y a exactement 4 chemins de 0 à 5 : 0→1→3→5, 0→2→3→5, 0→2→4→5 et 0→3→5.
Deux détails portent la réponse. Ajoutez une copie, path[:], car path est modifiée ensuite, et la référence vous donne une liste de listes vides identiques. Et il n'y a pas d'ensemble des visités : vous énumérez des chemins, pas des sommets, donc un sommet apparaît légitimement dans de nombreux chemins. Le path.pop() maintient l'état correct sans lui.
La relance : la complexité ? Pas O(V + E). Un DAG peut avoir un nombre exponentiel de chemins, donc les lister est exponentiel en la taille de la sortie ; la réponse honnête est O(V × 2V). Dire linéaire ici révèle que vous n'avez pas réfléchi à ce qu'est la sortie. Si l'on demande seulement combien de chemins existent, c'est un autre problème : comptez par programmation dynamique sur l'ordre topologique, en O(V + E).
Le piège. Ajouter un ensemble des visités parce que « le DFS en a toujours un ». Sur un graphe cyclique, vous excluez bien les sommets déjà présents sur le chemin courant, mais c'est le chemin, pas un ensemble global, et un ensemble global renvoie silencieusement un sous-ensemble des réponses.
8. Word search sur une grille
La question. Étant donné une grille de lettres et un mot, déterminez si le mot peut être formé en passant d'une case à une case adjacente horizontalement ou verticalement, sans utiliser deux fois la même case.
C'est du backtracking sur un graphe de grille implicite, et la clause « jamais deux fois la même case » est ce qui impose l'annulation.
def exist(board, word):
    R, C = len(board), len(board[0])

    def walk(r, c, i):
        if i == len(word): return True
        if not (0 <= r < R and 0 <= c < C): return False
        if board[r][c] != word[i]: return False

        board[r][c] = '#'                      # marquer, pour que le chemin ne la réutilise pas
        found = any(walk(r + dr, c + dc, i + 1)
                    for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)))
        board[r][c] = word[i]                  # ANNULER en repartant
        return found

    return any(walk(r, c, 0) for r in range(R) for c in range(C))
Le marqueur doit être restauré : une case bloquée par une tentative ratée doit rester disponible pour un autre départ, et l'oublier donne une fonction qui ne réussit que si le premier chemin essayé fonctionne par chance. Écraser le plateau au lieu de tenir un ensemble des visités est une astuce légitime, mais dites-le, car cela modifie l'entrée de l'appelant.
La relance : la complexité. O(R × C × 3L) pour un mot de longueur L : chaque case est un départ possible, et après le premier pas vous ne revenez jamais par où vous êtes venu, donc chaque pas suivant offre au plus 3 choix, pas 4. Ce 3 est le détail qui montre que vous y avez réfléchi.
9. Composantes fortement connexes
La question. Partitionnez un graphe orienté en ensembles maximaux de sommets mutuellement accessibles. Cela apparaît sous la forme « trouvez les dépendances circulaires », ou comme prétraitement avant un algorithme sur DAG.
Il existe deux réponses par DFS, et vous devez savoir laquelle vous écrivez.
Kosaraju-Sharir se fait en deux passes et il est bien plus facile de le réussir sous pression. Faites un DFS du graphe en notant l'ordre de fin, puis un DFS du graphe inversé en prenant les sommets par ordre de fin décroissant ; chaque arbre de la seconde passe est une composante.
def kosaraju(adj, radj, n):
    seen, order = [False] * n, []
    def pass1(u):
        seen[u] = True
        for v in adj[u]:
            if not seen[v]: pass1(v)
        order.append(u)                  # ordre de fin
    for s in range(n):
        if not seen[s]: pass1(s)

    comp, c = [-1] * n, 0
    def pass2(u):
        comp[u] = c
        for v in radj[u]:
            if comp[v] == -1: pass2(v)
    for u in reversed(order):            # temps de fin décroissant
        if comp[u] == -1:
            pass2(u); c += 1
    return comp, c
Sur un graphe de deux triangles, 0→1→2→0 et 3→4→5→3, reliés par le seul arc 2→3, cela renvoie exactement deux composantes, {0,1,2} et {3,4,5}. L'accessibilité le confirme : 0 atteint 3, et 3 n'atteint pas 0.
L'algorithme de Tarjan le fait en une seule passe avec une pile et une valeur low-link : plus rapide en pratique, bien plus facile à rater au tableau. Les deux sont en O(V + E), et chacun a un visualiseur ici. L'article de Tarjan de 1972 a donné la méthode en une passe ; la version en deux passes est attribuée à Kosaraju et a été publiée pour la première fois par Sharir en 1981.
Pour approfondir : le guide des composantes fortement connexes déroule les deux algorithmes sur un même graphe et montre les bogues qui passent les petits tests.
La relance : pourquoi le graphe inversé fonctionne-t-il ? Inverser chaque arc laisse les composantes inchangées, puisque l'accessibilité mutuelle est symétrique. Le sommet de plus grand temps de fin se trouve dans une composante source de la condensation, et l'inversion transforme une source en puits : un DFS lancé depuis là ne peut donc pas en sortir.
10. Ponts et points d'articulation
La question. Quelles arêtes, si on les retire, déconnectent le graphe ? Quels sommets ? Formulé comme points de défaillance uniques, ou connexions critiques dans un cluster.
C'est la question standard la plus profonde sur le DFS, et elle repose sur une seule idée : en plus du temps de découverte de chaque sommet, suivez low[u], le plus petit temps de découverte accessible depuis le sous-arbre de u en utilisant au plus une arête hors de l'arbre.
def bridges(adj, n):
    disc, low = [-1] * n, [-1] * n
    out, clock = [], 0

    def visit(u, parent):
        nonlocal clock
        disc[u] = low[u] = clock; clock += 1
        for v in adj[u]:
            if v == parent:
                parent = -2                 # ignorer UNE copie de l'arête du parent
                continue
            if disc[v] == -1:
                visit(v, u)
                low[u] = min(low[u], low[v])
                if low[v] > disc[u]:
                    out.append((u, v))      # rien sous v n'atteint u ou plus haut
            else:
                low[u] = min(low[u], disc[v])

    for s in range(n):
        if disc[s] == -1: visit(s, -1)
    return out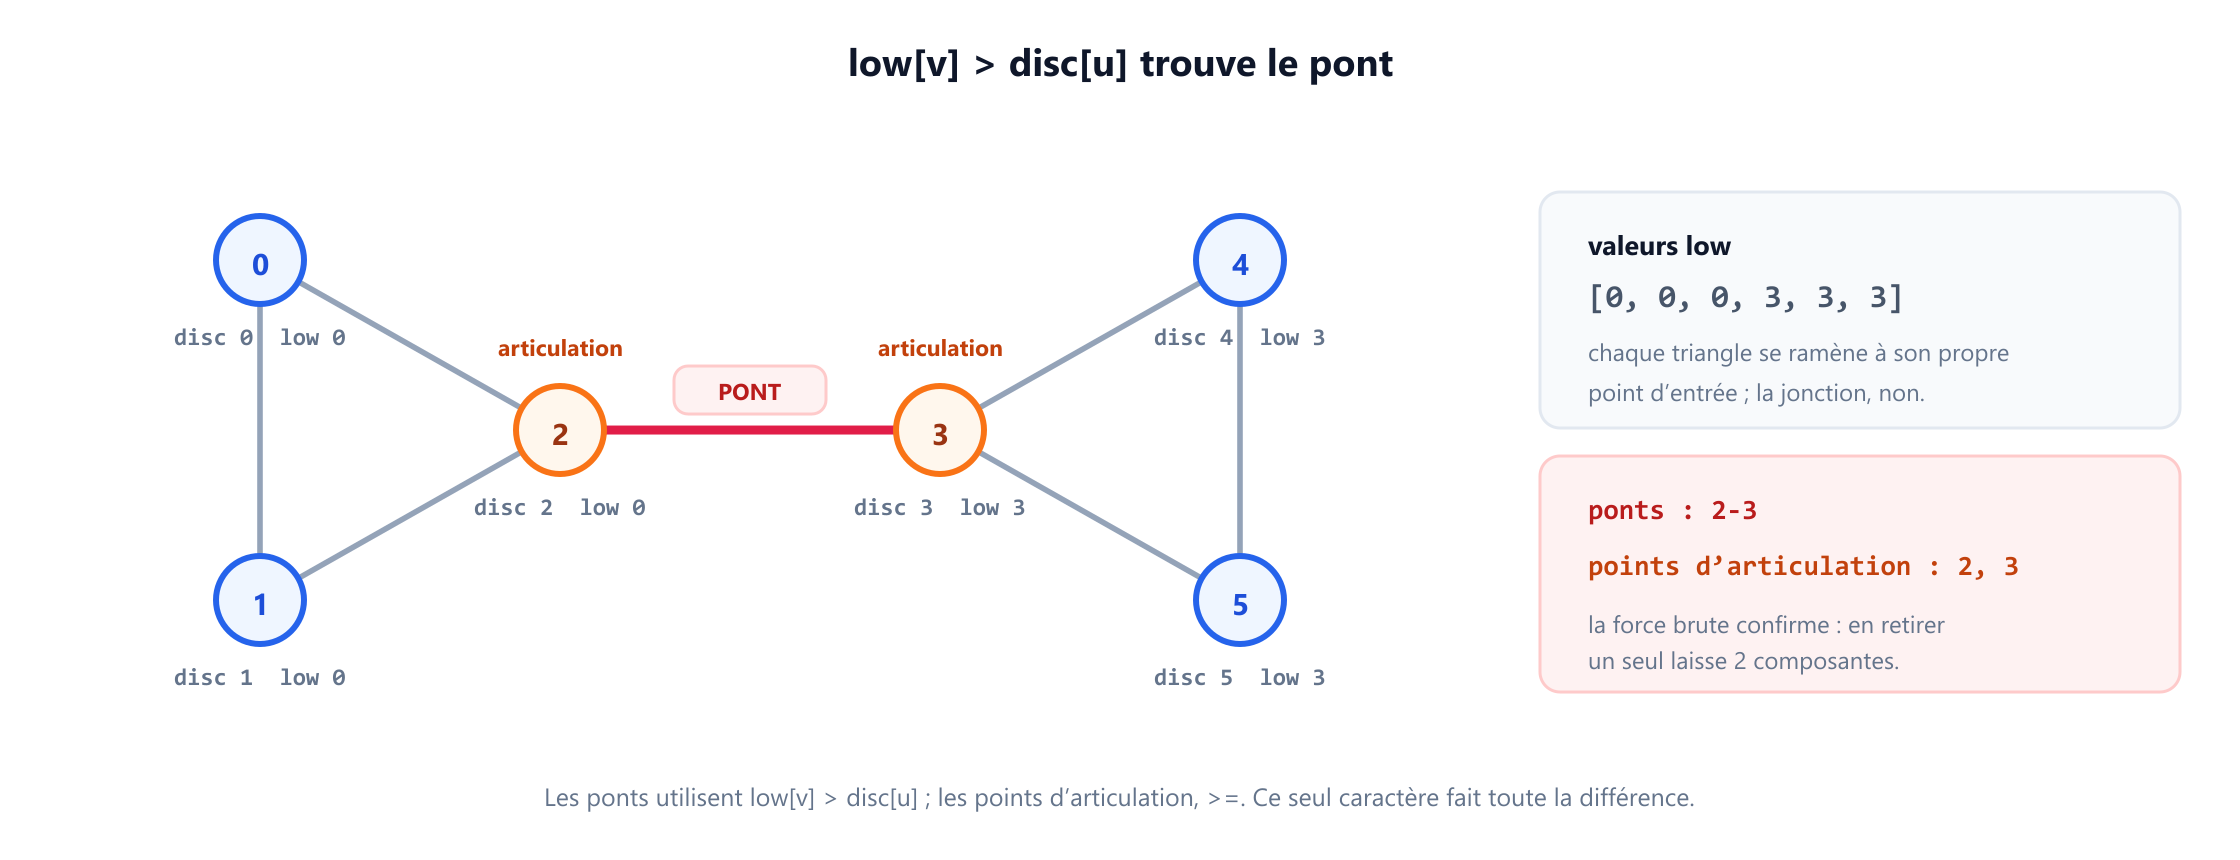
low[v] > disc[u] signifie que le sous-arbre sous v n'a aucun moyen de revenir à u ou plus haut, donc u-v est la seule route et la retirer coupe le graphe. Sur le graphe à deux triangles, les temps de découverte vont de 0 à 5 et les valeurs low sont 0, 0, 0, 3, 3, 3. Le seul pont est 2-3 ; les points d'articulation sont 2 et 3. La force brute confirme : retirer cette arête, ou l'un de ces deux sommets, laisse 2 composantes, et aucun autre retrait isolé ne déconnecte quoi que ce soit.
Les points d'articulation utilisent le même parcours avec deux règles : un sommet non racine u en est un si un enfant v vérifie low[v] >= disc[u], et la racine en est un si elle a plus d'un enfant dans le DFS. Notez le >= contre le > des ponts. Ce seul caractère sépare les deux réponses, et les confondre est l'erreur la plus courante ici.
Le piège. Le test du parent. if v == parent: continue sans garde à usage unique est faux sur un multigraphe : deux arêtes parallèles vers le parent signifient que la paire n'est pas un pont, et les ignorer toutes les deux le masque. Mémorisez l'indice de l'arête, ou n'ignorez que la première occurrence comme ci-dessus. L'algorithme est dû à Hopcroft et Tarjan, en 1973, et il existe un visualiseur pour lui.
11. Complexité, et la question de la profondeur de récursion
Chaque algorithme ci-dessus est un seul parcours, donc la borne en temps bouge à peine. C'est dans l'espace que se trouve la question intéressante.
| Problème | Temps | Espace | La justification à donner |
|---|---|---|---|
| DFS, liste d'adjacence | O(V + E) | O(V) | Chaque sommet visité une fois, chaque arête examinée une fois par sens |
| Détection de cycles orientée | O(V + E) | O(V) | Un tableau de couleurs sur le même parcours |
| Tri topologique | O(V + E) | O(V) | Liste en post-ordre plus la pile de récursion |
| CFC de Kosaraju-Sharir | O(V + E) | O(V + E) | Deux parcours, et le graphe inversé est une seconde copie |
| Ponts, points d'articulation | O(V + E) | O(V) | Deux tableaux d'entiers, disc et low |
Word search, longueur du mot L | O(R × C × 3L) | O(L) | Chaque case est un départ ; 3 choix suivants après le premier pas |
| Tous les chemins | O(V × 2V) | O(V) | La sortie elle-même peut être exponentielle |
La question de la profondeur de récursion est posée dans presque tous les entretiens sur le DFS : ayez la réponse prête. Le DFS descend aussi profond que le plus long chemin qu'il suit, ce qui sur un graphe chemin vaut V. La limite par défaut de CPython est 1000, donc quelques milliers de sommets en ligne le font planter, et une grille de 1000 sur 1000 cases de terre peut descendre à un million de niveaux.
La solution est la version itérative de la section 2, pas sys.setrecursionlimit, qui ne fait que transformer une exception propre en véritable débordement de pile. Dites-le explicitement. L'espace en O(V) correspond à cette pile, et la comparaison honnête avec le BFS est que le DFS garde un chemin de la racine à une feuille alors que le BFS garde une couche entière : aucun n'est toujours plus petit, cela dépend de la profondeur ou de la largeur du graphe. Aho, Hopcroft et Ullman donnent l'analyse globale ; Sedgewick et Wayne, le traitement clair le plus court.
12. Les erreurs qui font échouer l'entretien
Classées par fréquence ; les trois premières expliquent la plupart des solutions rejetées.
- Un seul ensemble des visités pour la détection de cycles orientée. Revoir un sommet n'est pas un cycle. Le gris (sur la pile) doit se distinguer du noir (terminé), sinon tout DAG offrant deux routes vers un sommet en signale un.
- Utiliser trois couleurs pour la détection de cycles non orientée. L'erreur inverse. Chaque arête ressemble à une arête arrière si vous ne sautez pas celle par laquelle vous êtes arrivé.
- Utiliser la récursion sur des entrées qui peuvent être grandes. Une grille d'un million de cases descend à un million de niveaux. Proposez la version itérative avant qu'on vous la demande.
- Construire l'ordre topologique en pré-ordre. Il faut le post-ordre, en ajoutant le sommet quand il se termine, puis inverser. Le pré-ordre produit quelque chose qui ressemble à une réponse et n'en est pas une.
- Oublier d'annuler dans le backtracking. Le
path.pop(), ou la restauration de la case de la grille. Sans cela, la première branche ratée empoisonne toutes les suivantes. - Stocker la liste vivante au lieu d'une copie.
out.append(path)donne une liste de références vers une seule liste modifiée. Il fautpath[:]. - Confondre
>et>=dans le test low-link.low[v] > disc[u]désigne un pont,>=un point d'articulation. Un caractère d'écart. - Omettre la boucle extérieure sur les composantes. La détection de cycles, le comptage des composantes et les CFC exigent tous de relancer le DFS depuis chaque sommet non visité.
- Ne pas poser de questions sur l'entrée. Orienté ou non ? Connexe ? Boucles ou arêtes multiples ? Chaque réponse change le code, et la remarque de Skiena tient : les problèmes se gagnent dans la modélisation.
L'habitude qui évite la plupart de ces erreurs : avant d'écrire, nommez le tableau supplémentaire. Couleur, parent, ordre de fin ou low-link. Les questions sur le DFS se distinguent par ce tableau, pas par le parcours, et le nommer d'abord rend le reste mécanique. McDowell défend la même idée en général ; ici, elle est d'une littéralité inhabituelle.
13. Questions fréquentes
Quand faut-il choisir le DFS plutôt que le BFS ?
+
Quand la question porte sur l'ordre, les dépendances, les cycles ou ce qui casse si l'on retire quelque chose. Tout cela exige de savoir quand un sommet se termine, ou s'il est encore sur la pile, et seul le DFS le fournit. Si elle demande le moins de quelque chose, utilisez le BFS : le DFS trouve un chemin, pas le plus court.
Pourquoi faut-il trois couleurs pour la détection de cycles orientée ?
+
Parce qu'un simple ensemble des visités ne distingue pas un ancêtre d'un sommet terminé. Gris signifie encore sur la pile de récursion : un arc vers un sommet gris ferme une boucle et constitue un vrai cycle. Noir signifie terminé, et un arc vers un sommet noir n'est qu'une seconde route vers une partie déjà explorée du graphe, ce qui est permis dans un DAG.
Pourquoi inverser le post-ordre du DFS donne-t-il un tri topologique ?
+
Parce qu'un sommet ne se termine qu'après tout ce qui est accessible depuis lui, il se termine donc toujours après ses successeurs. Inverser l'ordre de fin place ainsi chaque sommet devant tout ce vers quoi il pointe, ce qui est la condition topologique. Ajoutez en post-ordre, quand le sommet se termine, pas quand il est découvert.
Qu'est-ce qu'une valeur low-link ?
+
Pour un sommet u, c'est le plus petit temps de découverte accessible depuis le sous-arbre de u en utilisant des arêtes d'arbre plus au plus une arête hors de l'arbre. Elle répond à la question « quelque chose sous u peut-il remonter au-dessus de u sans l'arête vers son parent ? ». Sinon, cette arête est un pont. C'est l'unique tableau supplémentaire qui transforme un DFS ordinaire en algorithme pour les ponts, les points d'articulation et les composantes fortement connexes de Tarjan.
Jusqu'à quelle profondeur un DFS récursif peut-il aller avant de casser ?
+
Aussi profond que le plus long chemin qu'il suit, ce qui sur un graphe chemin correspond au nombre de sommets. La limite par défaut de CPython est 1000, donc quelques milliers de sommets en ligne le font planter, et une grille de 1000 sur 1000 cases de terre descend à un million de niveaux. Réécrivez-le en itératif plutôt que de relever la limite, ce qui ne fait que transformer une exception propre en véritable débordement de pile.
Le DFS itératif est-il identique au DFS récursif avec une pile ?
+
Pas tout à fait. La version simple avec pile visite les voisins dans l'ordre inverse, empilez-les donc à l'envers pour obtenir le même ordre, et elle doit tester l'ensemble des visités au dépilement comme à l'empilement, puisqu'un sommet peut se trouver plusieurs fois sur la pile. Surtout, elle n'a pas de post-ordre : le tri topologique, les composantes fortement connexes et les algorithmes low-link exigent une version qui empile chaque sommet deux fois ou suit un indice d'enfant.
Ai-je besoin d'un ensemble des visités pour énumérer tous les chemins ?
+
Non, et en ajouter un est un bogue courant. Vous énumérez des chemins plutôt que des sommets, donc le même sommet apparaît légitimement dans de nombreux chemins, et un ensemble des visités global n'en renvoie silencieusement qu'une partie. Ce qu'il vous faut, c'est le chemin courant, annulé par un pop en repartant. Sur un graphe cyclique, vous excluez les sommets déjà présents sur ce chemin, ce qui n'est pas un ensemble global.
14. Références
Les articles qui ont introduit ces techniques et les ouvrages qui les analysent, par ordre chronologique.
- Lucas, É. (1882). Récréations Mathématiques, volume 1. Gauthier-Villars. (Consigne la règle systématique de Trémaux pour parcourir les labyrinthes, la plus ancienne description du parcours en profondeur.)
- Tarjan, R. E. (1972). “Depth-first search and linear graph algorithms.” SIAM Journal on Computing, 1(2), 146–160.
- Hopcroft, J. et Tarjan, R. E. (1973). “Algorithm 447: efficient algorithms for graph manipulation.” Communications of the ACM, 16(6), 372–378.
- Aho, A. V., Hopcroft, J. E. et Ullman, J. D. (1974). The Design and Analysis of Computer Algorithms. Addison-Wesley.
- Tarjan, R. E. (1976). “Edge-disjoint spanning trees and depth-first search.” Acta Informatica, 6(2), 171–185.
- Sharir, M. (1981). “A strong-connectivity algorithm and its applications in data flow analysis.” Computers & Mathematics with Applications, 7(1), 67–72.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. et Stein, C. (2009). Introduction to Algorithms, 3e édition, section 22.3. MIT Press.
- Sedgewick, R. et Wayne, K. (2011). Algorithms, 4e édition, sections 4.1 à 4.2. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6e édition. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3e édition, chapitre 5. Springer.