
目录
1. 拓扑排序题真正考察什么
题目里几乎从不出现“拓扑排序”这几个字。你拿到的是带先修要求的课程、构建目标、任务清单、一份菜谱,或者一本外星语字典,而面试官关注的是三件事。
你能看出这是一张图吗?凡是表述为“X 必须在 Y 之前”的内容都是一条有向边,而答案就是顶点的一个排列。你能把弧的方向定对吗?这是最常见的失败,没有之一。它写出的代码能运行,也能返回一个顺序,只不过是反的。你知道环检测和排序是同一个计算吗? “能否排出日程”和“给我一份日程”是同一个算法,只是 return 语句不同。
在此之后,所有变体都是同一次扫描,只是额外携带了某样东西:层号、工期、计数器,或第二张图。一旦模板成了本能,这些题目真正有意思的部分就是建模,而不是代码。算法本身的原理见拓扑排序指南;本页讨论的是面试中真正会问到的八道题。
下面每个详解示例都在写成文字之前用脚本运行过。
2. 两个模板,以及各自的适用场合
值得掌握的实现恰好有两种,面试官两种都会接受。写你能不假思索写出的那种,同时要能说明为什么有时会想用另一种。
Kahn 算法出自他 1962 年的论文,是迭代版本。统计每个顶点还剩多少先修条件,把计数为零的放进队列,然后逐个输出。
from collections import deque

def kahn(n, edges):                  # edges 存放 (u, v),表示 u 在 v 之前
    adj = [[] for _ in range(n)]
    indeg = [0] * n
    for u, v in edges:
        adj[u].append(v)
        indeg[v] += 1                # 统计指向 v 的弧
    q = deque(v for v in range(n) if indeg[v] == 0)
    order = []
    while q:
        u = q.popleft()
        order.append(u)
        for v in adj[u]:
            indeg[v] -= 1            # u 已完成,v 少等一个
            if indeg[v] == 0:
                q.append(v)
    return order if len(order) == n else []      # 输出不足说明有环
最后一行承担了全部的环检测。如果有些顶点的入度始终降不到零,说明它们在互相等待,而 len(order) < n 就是证据。注意这里完全没有 visited 集合:入度计数器本身就保证了每个顶点恰好输出一次。
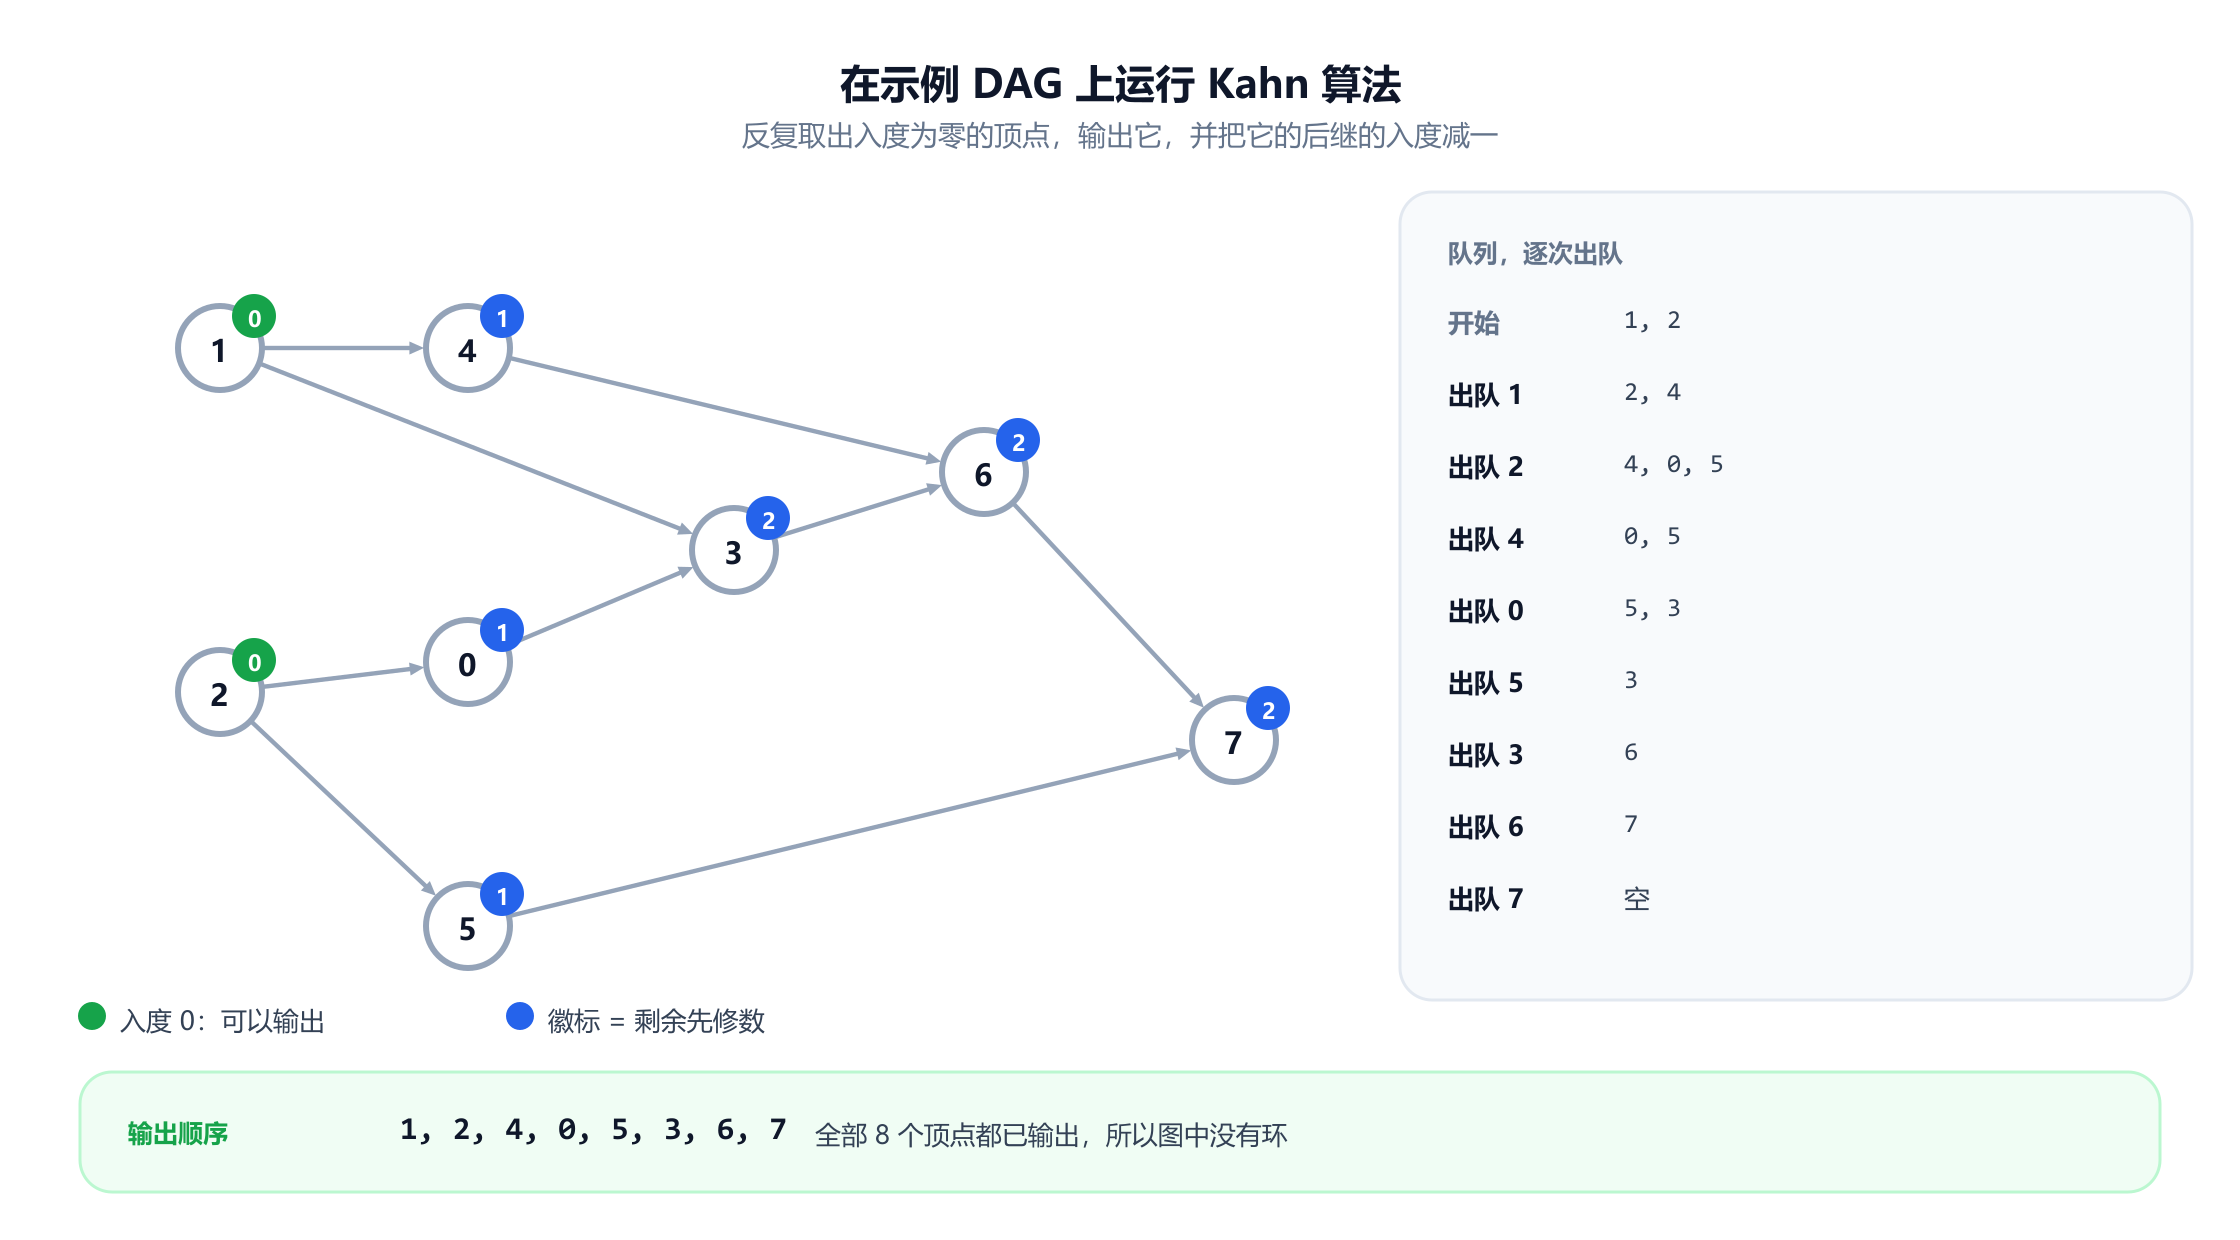
在这张图上,队列初始为 [1, 2],输出顺序为 1, 2, 4, 0, 5, 3, 6, 7。八个顶点全部输出,所以没有环。
DFS 版本是另一个模板。运行深度优先搜索,在每个顶点结束时把它加入列表,最后反转。面试官追问的微妙之处在于着色。
WHITE, GREY, BLACK = 0, 1, 2      # 未访问、在栈上、已完成

def dfs_topo(n, adj):
    colour = [WHITE] * n
    out = []
    def visit(u):
        colour[u] = GREY
        for v in adj[u]:
            if colour[v] == GREY:          # 回边:找到了环
                return False
            if colour[v] == WHITE and not visit(v):
                return False
        colour[u] = BLACK
        out.append(u)                      # 在退出时加入,而不是进入时
        return True
    for v in range(n):
        if colour[v] == WHITE and not visit(v):
            return []
    return out[::-1]                       # 逆后序
三种颜色,而不是一个 visited 集合。一个普通的 visited 集合无法区分指回当前递归栈的弧(即环)与指向已完成分支的弧(不是环)。在面试中说出这句话,关于环检测的追问就已经有了答案。
该用哪个?如果题目需要层级、计数、字典序,或任何适合按波次处理源点的东西,用 Kahn。如果你本来就因为别的原因在写深度优先搜索,或者需要逆后序来做强连通分量,用 DFS。两者都是 O(V + E)。唯一的实际区别是:递归 DFS 需要与最长链成正比的栈深度,面对十万个任务串成一条链的恶意输入,它会触到 Python 的默认递归上限,而 Kahn 不会。
3. 课程表:能否修完所有课程?
题目。共有 n 门课程,以及一个二元组列表 [a, b],含义是“要修课程 a,必须先修课程 b”。你能修完所有课程吗?
建模这一步就是整道题,也是大多数候选人失分的地方。二元组 [a, b] 表示 b 在 a 之前,所以弧的方向是 b → a,递增的是 indeg[a]。弄反了仍然会得到另一张图的合法拓扑排序:程序不会崩溃,只是在任何非对称的测试用例上悄无声息地给出错误答案。
def can_finish(n, prerequisites):
    edges = [(b, a) for a, b in prerequisites]   # b 在 a 之前
    return len(kahn(n, edges)) == n
就这些:运行排序,比较计数。要明确说出来:当且仅当先修关系图无环时存在可行日程,因为环就是一组互相等待的课程。
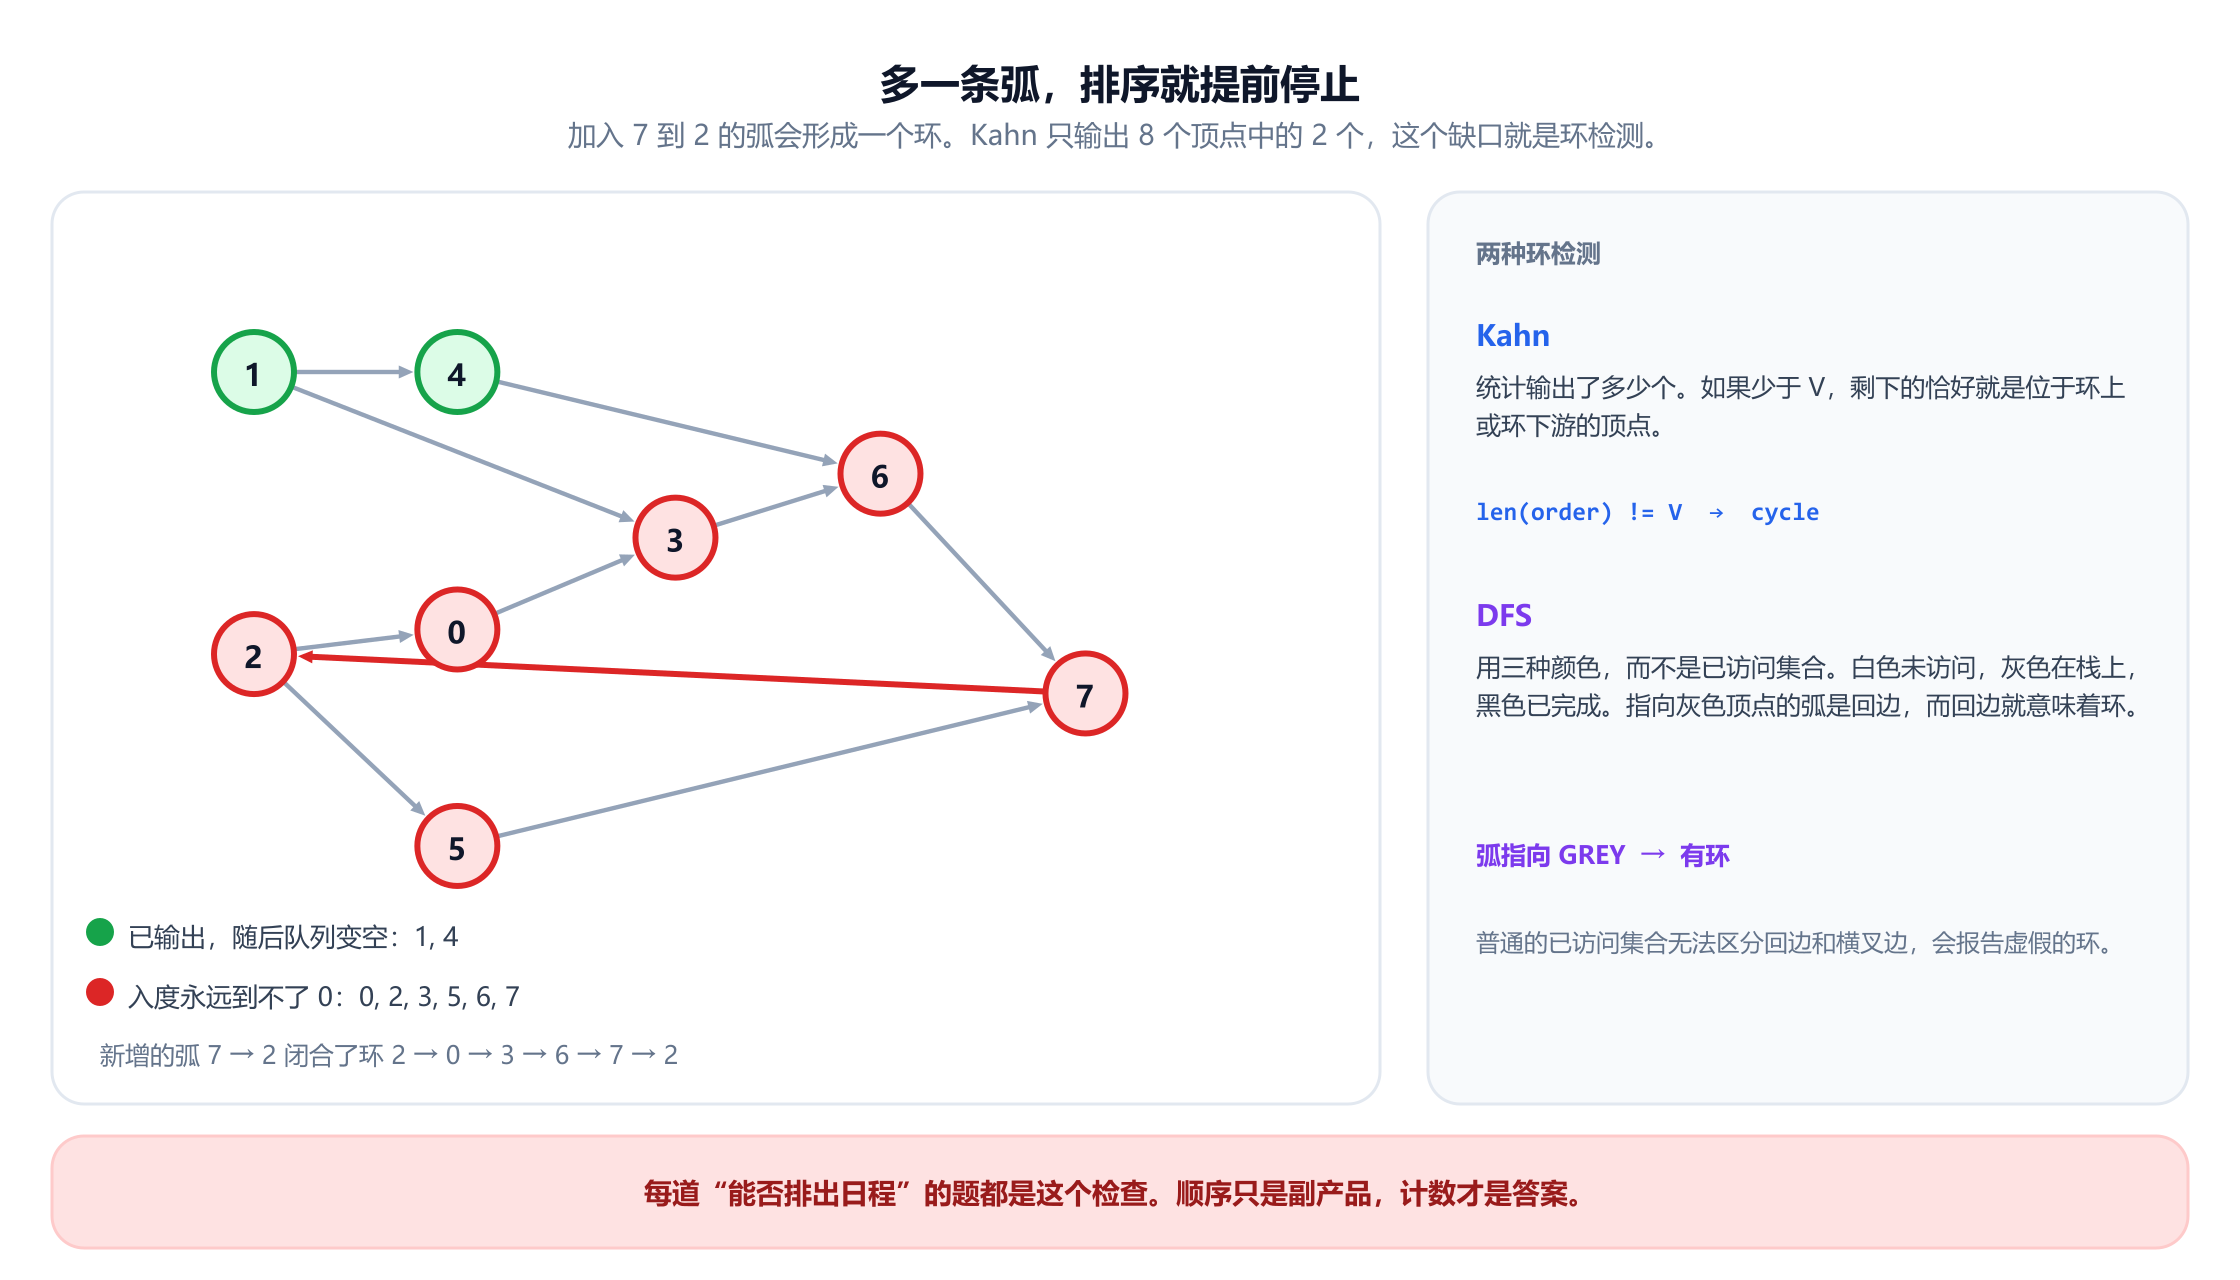
在示例图中加入弧 7 → 2,队列开始时只有顶点 1,输出 1 和 4 后就空了。有六个顶点卡住,恰好是环 2 → 0 → 3 → 6 → 7 → 2 以及位于其下游的顶点 5。
追问:哪些课程有问题?入度不为零的剩余顶点就是位于环上或环下游的顶点,这通常就是想要的答案。如果面试官坚持要环本身,而不是被它阻塞的所有顶点,你需要 DFS 版本:遇到灰色顶点时,从该顶点开始的当前递归栈就是那个环。
陷阱。把弧弄反。动手之前先把二元组念出来:“a 依赖 b,所以 b 在前”,并用一个两元素的例子和面试官确认方向。
4. 课程表 II:返回一个顺序
题目。输入相同,但要返回一个合法顺序,若不存在则返回空列表。
这就是原封不动的 kahn,这也是这两道题通常连着问的原因。唯一的新想法是你应当主动提出的一点:顺序并不唯一,判题程序接受任何合法顺序。
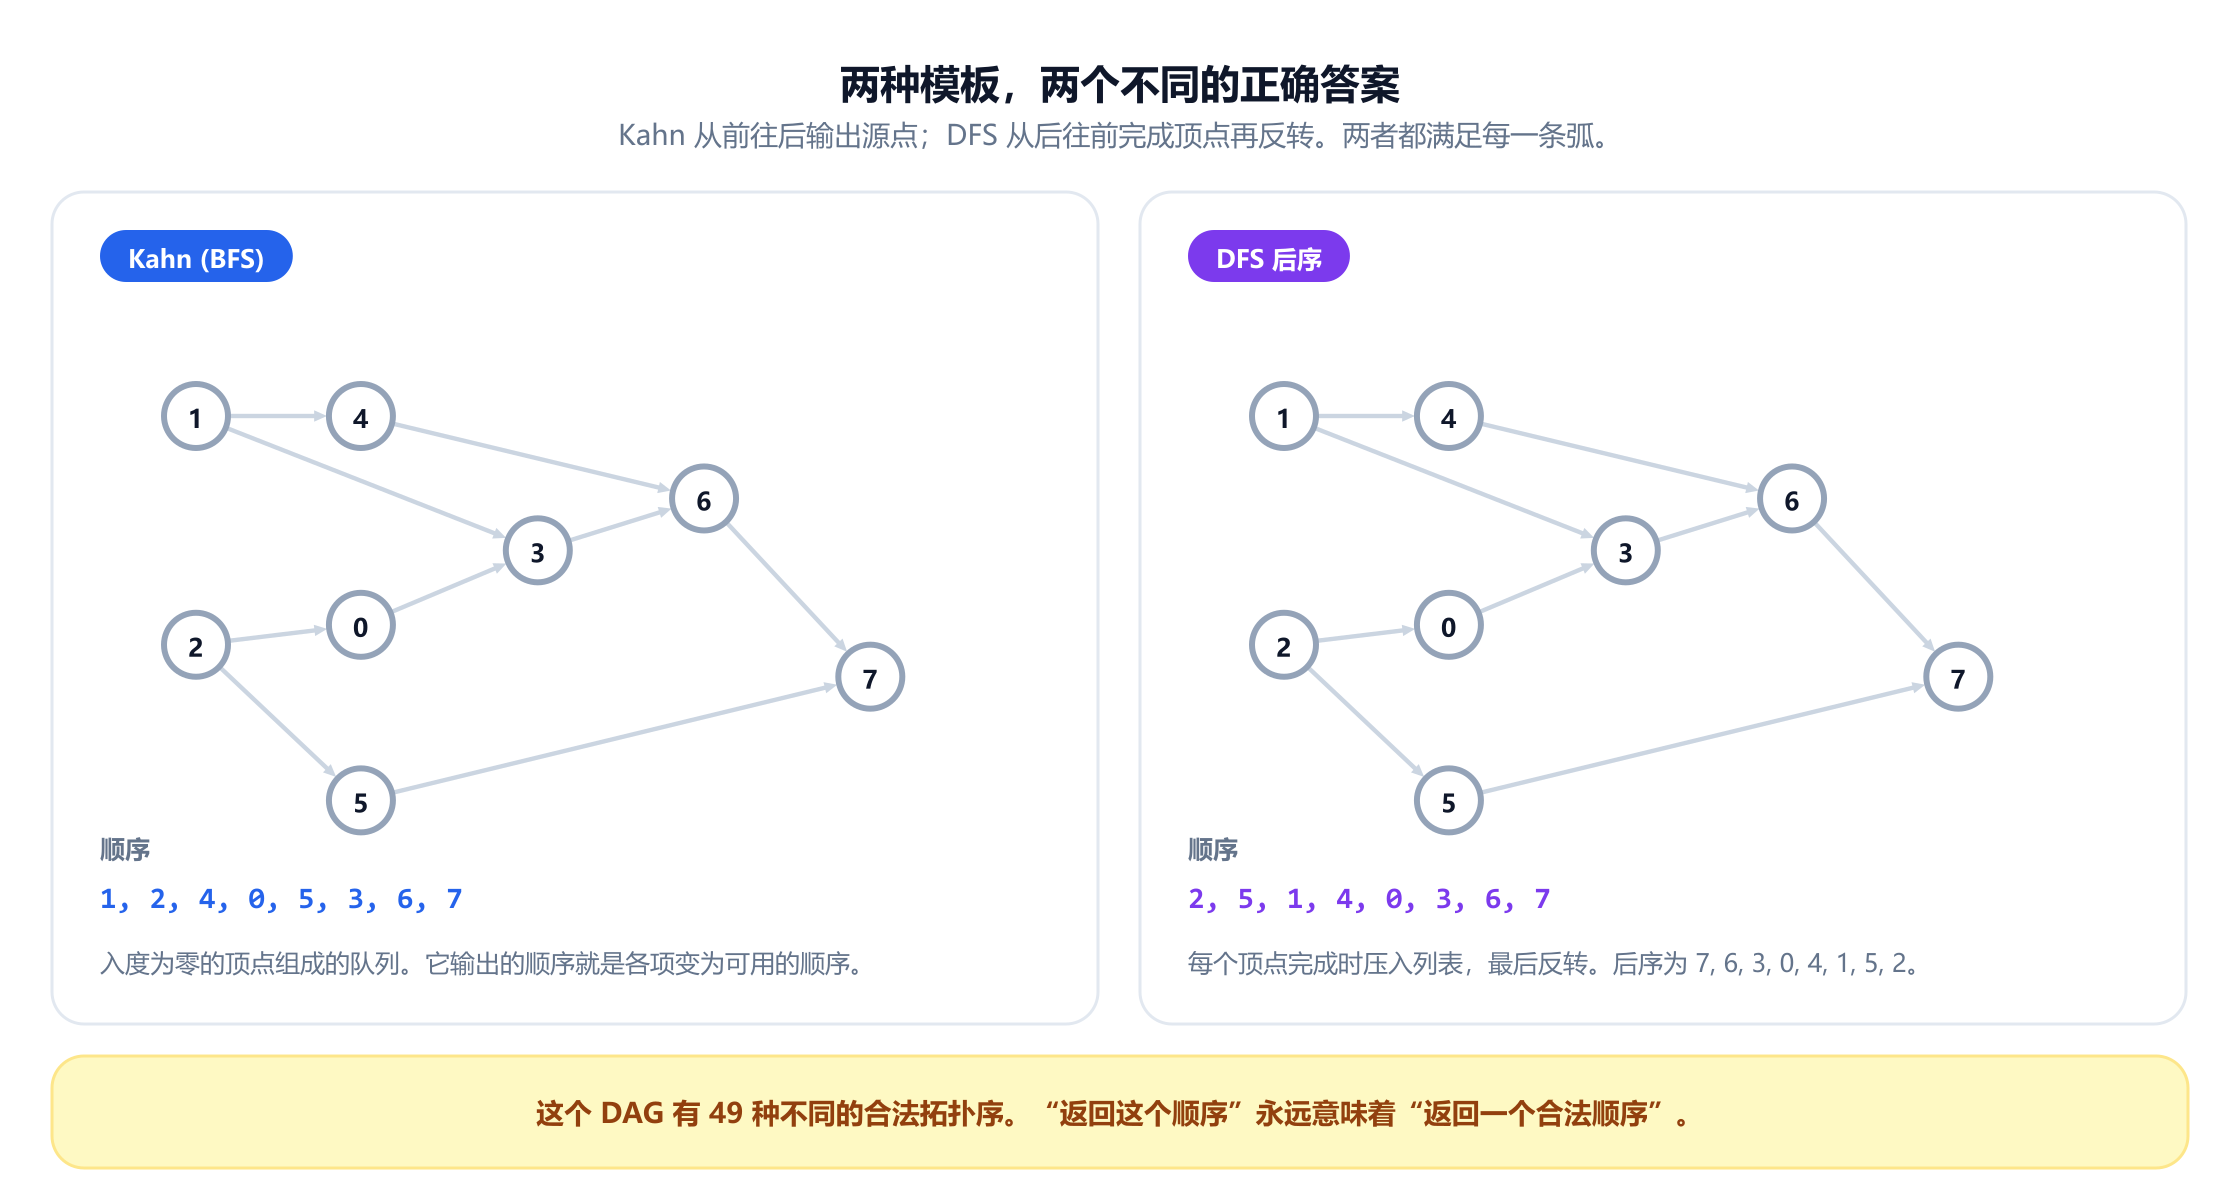
Kahn 返回 1, 2, 4, 0, 5, 3, 6, 7,DFS 返回 2, 5, 1, 4, 0, 3, 6, 7。两者没有谁更正确,穷举计数表明这张图共有 49 个不同的合法顺序。如果你的解法被拿去和唯一的标准答案比对,出问题的是测试,而不是解法。
追问:返回字典序最小的顺序。把队列换成最小堆。每一步都弹出当前可用的最小顶点,而不是最先入队的顶点,这样就能贪心地在每个位置上固定尽可能小的值。代价从 O(V + E) 变为 O(V + E log V),能说清这个权衡正是这道追问的全部意义。在示例图上,最小的顺序是 1, 2, 0, 3, 4, 5, 6, 7。
陷阱。返回 order 时不做长度检查。遇到有环的输入,你会交出一份看起来完全合理的部分日程,所有含环的自动测试都会失败,而你本地跑的正常用例却能通过。
5. 外星人字典:还原字母表
题目。给定一组按未知字母表排好序的单词。还原一个与该排序一致的字母顺序,若不存在则报告。
在注意到“已排序”告诉了你什么之前,这里没有任何东西像一张图。比较两个相邻的单词,找到它们第一个不同的位置,你恰好得到一条信息:第一个单词在该位置的字母排在第二个单词在该位置的字母之前。第一个差异之后的内容不提供任何信息。然后对字母做拓扑排序。
def alien_order(words):
    adj = {c: set() for w in words for c in w}
    indeg = {c: 0 for c in adj}
    for w1, w2 in zip(words, words[1:]):
        if len(w1) > len(w2) and w1.startswith(w2):
            return ""                       # "abc" 排在 "ab" 之前是不可能的
        for a, b in zip(w1, w2):
            if a != b:
                if b not in adj[a]:         # 重复的边不要计两次
                    adj[a].add(b)
                    indeg[b] += 1
                break                       # 只有第一个差异有效
... # 然后对字母运行 Kahn六行里有三个细节,面试官三个都会检查。只比较相邻的单词对。比较每一对单词会加入输入并不支持的边。只看第一个不同的位置,然后 break。前缀规则:如果某个单词是前一个单词的真前缀,输入自相矛盾,答案是空字符串,根本不必建图。
在经典输入 ["wrt", "wrf", "er", "ett", "rftt"] 上,比较得到 t → f、 w → e、 r → t 和 e → r,排序返回 "wertf"。在 ["abc", "ab"] 上,前缀规则触发,返回 ""。在 ["z", "x", "z"] 上,边 z → x 和 x → z 构成环,所以长度检查同样返回 ""。
追问:你返回的字母表是唯一的吗?这就是第 7 节中的唯一性问题:当且仅当每一步队列中都只有一个字母时,顺序才是确定的。任何没有出现在比较中的字母都可以自由浮动,它的位置是任意的。
陷阱。只用出现在比较中的字母来建图,而不是用所有单词中的全部字母。从未参与比较的字母仍然必须出现在输出中,漏掉它们正是会被隐藏测试而不是你自己的测试抓到的错误。
6. 并行课程:最少需要几个学期
题目。只要每门课的先修课都已修完,同一学期可以修任意多门课。最少需要几个学期?
答案是 DAG 的层数,而一个顶点的层号等于其所有前驱中最大层号加一。在同一次扫描中携带这个数即可。
def min_semesters(n, edges):
    order = kahn(n, edges)
    if len(order) != n:
        return -1                          # 有环:永远修不完
    level = [1] * n
    for u in order:                        # u 的每个前驱都已确定
        for v in adj[u]:
            level[v] = max(level[v], level[u] + 1)
    return max(level)
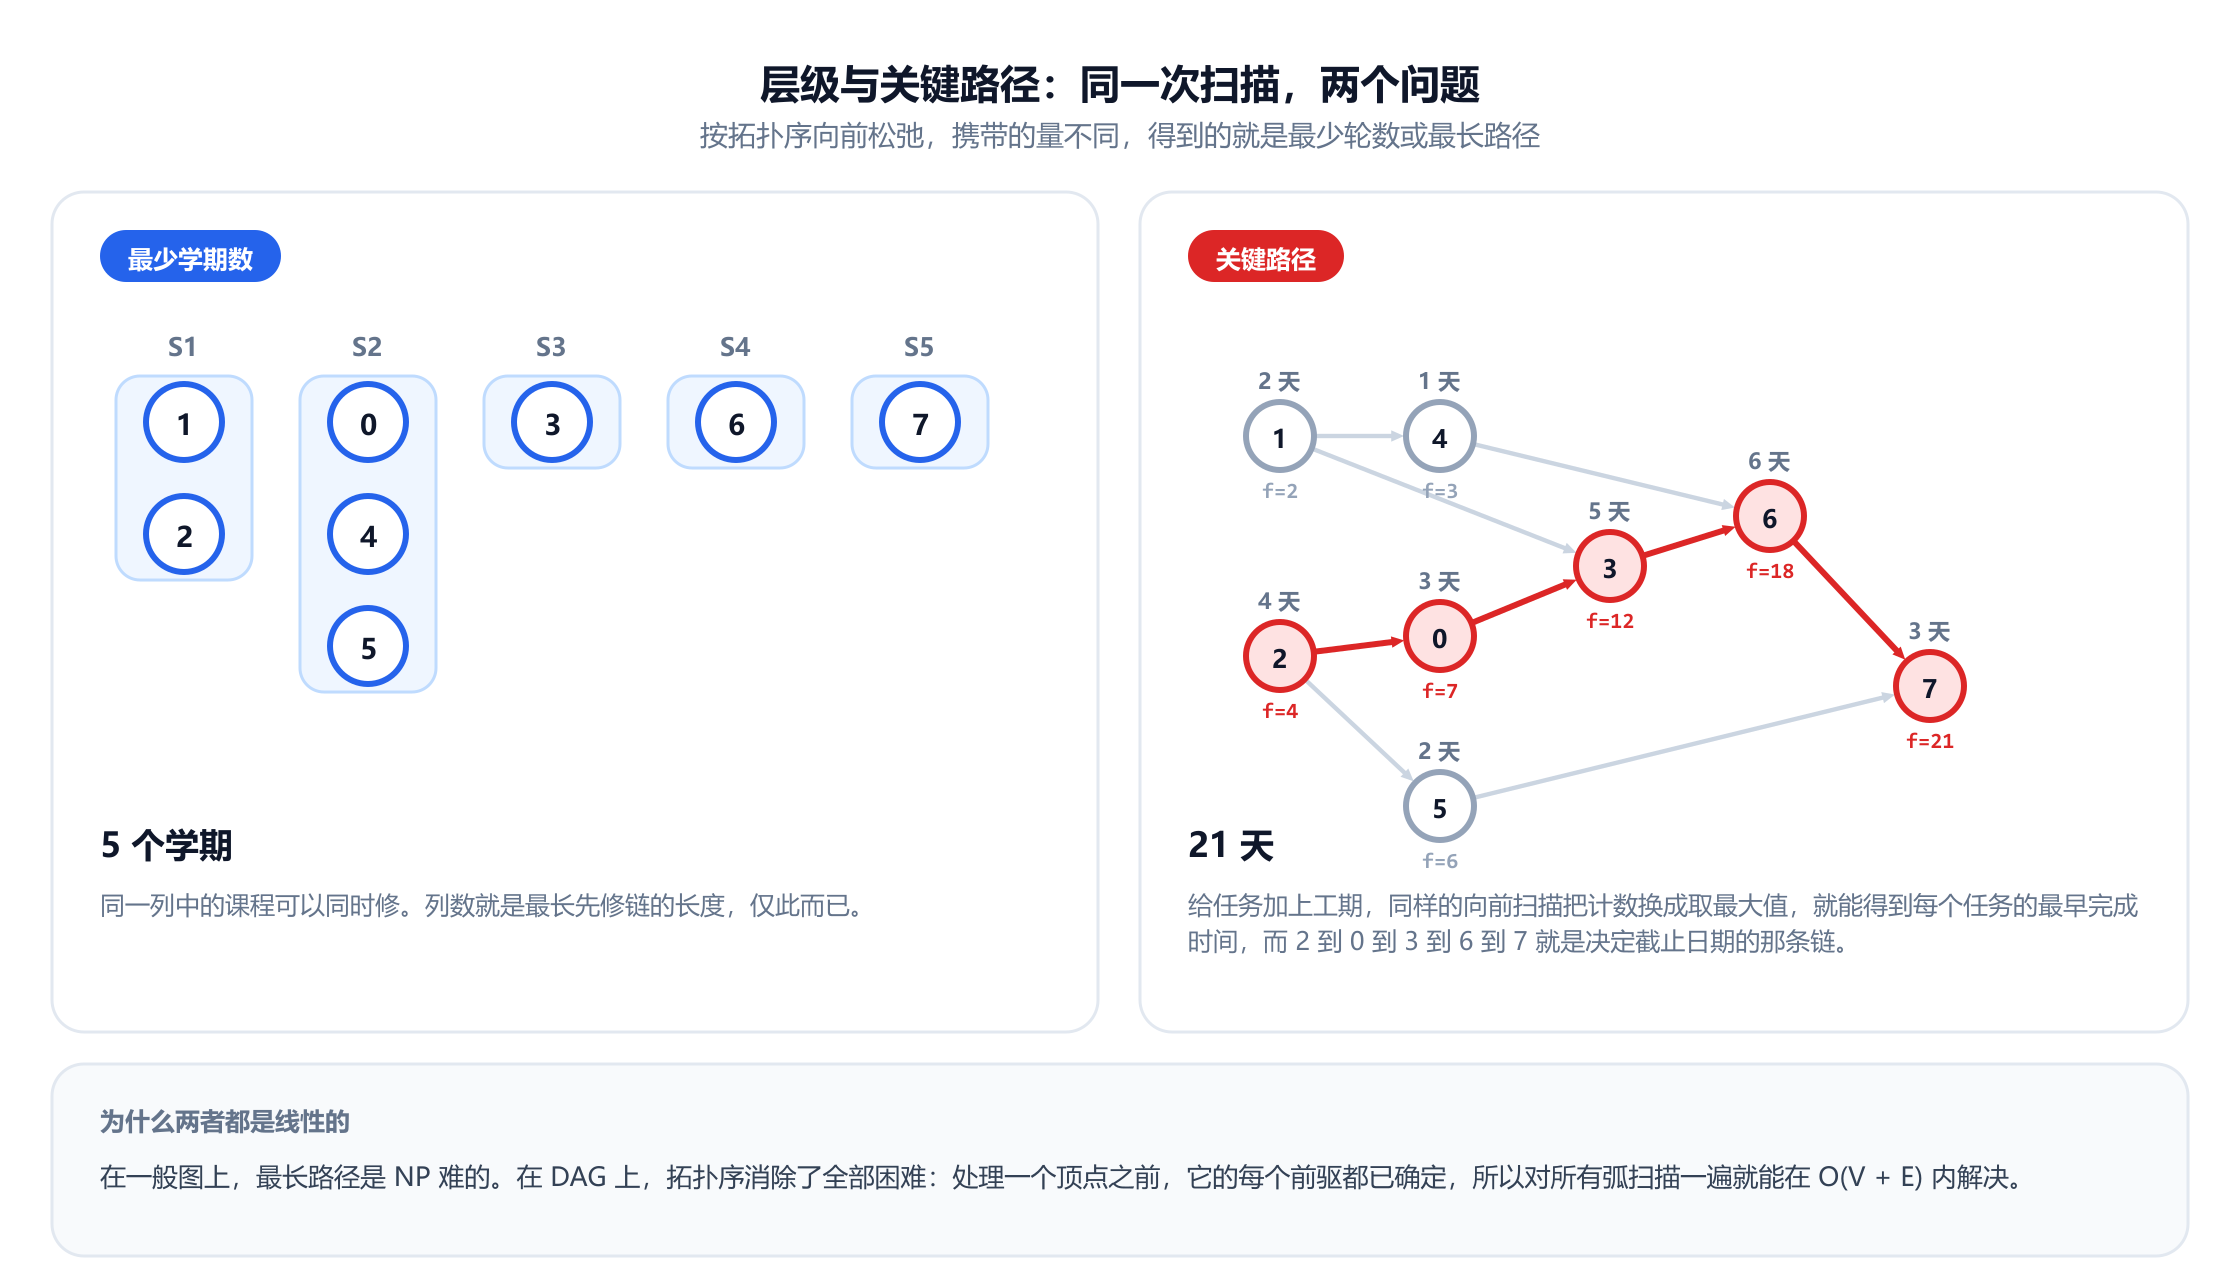
由于循环按拓扑序进行, u 的每个前驱都在 u 被读取之前完成了贡献,正是这一性质使得一趟扫描就足够。在示例图上,各层依次是 {1, 2},然后是 {0, 4, 5},然后是 {3},然后是 {6},然后是 {7},所以答案是 5 个学期。
追问:如果每学期最多只能修 k 门课呢?简单的答案就此失效。不限并行度时问题是线性的,因为贪心地修完所有可修课程就是最优的;一旦限制宽度,它就变成 k 台机器上带优先约束的调度问题,一般情况下是 NP 难的。两台相同机器、单位工期任务是经典的可解情形,由 Coffman 和 Graham 在 1972 年解决。认识到这道追问改变了复杂度类别,而不是试图修补循环,才是面试官想看到的。
陷阱。像从源点出发的普通 BFS 那样,在顶点第一次被访问时就分配层号。一个顶点必须等待它最慢的前驱,所以层号是最大值,而不是首次到达的值。按波次的 BFS 变体只有在你一次弹出整整一层、并且在入度降到零之前从不查看顶点时才正确。
7. 顺序唯一吗?序列重建
题目。给定一个 DAG,判断它是否恰好只有一个合法拓扑序。常见的包装是序列重建:给你一个序列和一组子序列,问该序列是否是唯一与它们一致的序列。
检查只需在 Kahn 的循环里加一行。
    while q:
        if len(q) > 1:
            return False              # 存在选择,所以顺序不确定
        u = q.popleft()
        ...
如果队列某时同时有两个顶点,两者都可用,哪个都可以排在下一位,所以至少存在两个合法顺序。如果每一步队列中恰好只有一个顶点,就从未做过选择,顺序是确定的。
还有一种等价的说法,很能加分:当且仅当顺序中相邻的顶点之间都有弧相连时,顺序才唯一,也就是说,拓扑序是这个 DAG 的一条哈密顿路径。两种说法都可以在 O(V + E)内检查,而引用哈密顿路径的说法能表明你理解唯一性为什么是一种结构性质,而不是队列的偶然结果。
在示例图上,八次出队时的队列大小依次是 2, 2, 3, 2, 2, 1, 1, 1。第一步就已经可以在 1 和 2 之间选择,所以顺序不唯一,这与第 4 节中统计出的 49 个合法顺序相吻合。在链 0 → 1 → 2 → 3 上,队列大小是 1, 1, 1, 1,顺序是确定的。
追问:序列重建本身。用每个子序列中相邻的元素对建图,运行上面的检查,并且额外确认输出的顺序等于给定的序列。两个条件缺一不可:一个唯一但不同于给定序列的顺序,答案仍然是“否”。
陷阱。只在开始时检查一次队列大小。一张图可能以单一源点开始,三步之后才出现分叉,所以必须在每次迭代中比较。值得了解的是,“每一层恰好只有一个顶点”是一个等价的检查,因为确定的顺序会使各层构成一条严格的链;所以按层推理并没有错,只是需要多扫一遍来计算层号。
8. 最长路径与关键路径
题目。每个任务需要已知的天数,并且只有在其先修任务完成后才能开始。项目何时完成,哪些任务决定了完成时间?
这是最长路径问题,在一般图上是 NP 难的。在 DAG 上它是线性的,原因就在于拓扑序:一个顶点的每个前驱都在该顶点被读取之前就已确定,所以一次正向扫描即可解决。
def critical_path(n, edges, dur):
    order = kahn(n, edges)
    finish = list(dur)                     # 无阻塞时的最早完成时间
    prev = [-1] * n
    for u in order:
        for v in adj[u]:
            if finish[u] + dur[v] > finish[v]:
                finish[v] = finish[u] + dur[v]
                prev[v] = u                # 记下是谁造成了延迟
    end = max(range(n), key=lambda v: finish[v])
    path = []
    while end != -1:
        path.append(end); end = prev[end]
    return max(finish), path[::-1]
给示例图的顶点 0 到 7 赋予工期 3, 2, 4, 5, 1, 2, 6, 3,最早完成时间为 7, 2, 4, 12, 3, 6, 18, 21。项目需要 21 天,关键路径是 2 → 0 → 3 → 6 → 7,其工期之和恰好为 21。这条链就是项目经理所说的“关键路径”:其中任何一个任务延误一天,整个项目就延误一天,而任务 5 有富余时间,可以拖延好几天而不被察觉。这是 Kelley 和 Walker 1959 年提出的方法,把名字说出来不需要任何代价。
追问:改求最短路径。把比较改为 <,就得到了 DAG 上的单源最短路径,复杂度为 O(V + E),而且支持负权,这是 Dijkstra 做不到的。只要面试官在无环图上提到负权边,答案就是它,而不是 Bellman-Ford。一般情况可以对照最短路径算法。
陷阱。按错误的顺序松弛。按顶点编号从 0 到 n-1 迭代,而不是按拓扑序,得到的值取决于编号方式:在这张图上会悄无声息地得到 17 而不是 21,因为顶点 0 在顶点 2 对它做出贡献之前就被读取了。拓扑序的全部意义就在于让一趟扫描足够。
9. 最终安全状态:对反向图排序
题目。如果从一个节点出发的每条路径都能到达终端节点,因而永远不会困在环里,这个节点就是安全的。按升序返回所有安全节点。
按正向来表述会很别扭。把每条弧反向,它就变成了拓扑排序:先移除出度为零的节点,也就是终端节点,每当某个节点剩余的出度降到零,说明它的所有后继都是安全的,那么它也是安全的。
def safe_nodes(graph):
    n = len(graph)
    rev = [[] for _ in range(n)]
    outdeg = [len(graph[u]) for u in range(n)]
    for u in range(n):
        for v in graph[u]:
            rev[v].append(u)
    q = deque(v for v in range(n) if outdeg[v] == 0)   # 终端节点
    safe = []
    while q:
        u = q.popleft()
        safe.append(u)
        for p in rev[u]:
            outdeg[p] -= 1
            if outdeg[p] == 0:
                q.append(p)
    return sorted(safe)
这就是把入度换成出度、弧反向之后的 Kahn 算法,值得明确说出来,因为这表明你能识破伪装、认出模板。在标准示例 [[1,2], [2,3], [5], [0,5], [5], [], []] 上,答案是 [2, 4, 5, 6]:节点 5 和 6 是终端节点,2 和 4 只通向它们,而 0、1 和 3 位于环 0 → 1 → 3 → 0上。
追问:改用 DFS 来做。还是三种颜色。如果一个节点没有任何出弧能到达灰色顶点,它就是安全的,并且可以按节点记忆化结果,使整体保持线性。面试官通常两种都想听,因为反向图的版本是候选人很少能自己想到的。
陷阱。回答“不在环上的节点”。按这种理解,节点 3 自身不在任何环上,但它有一条指向经过 0 的环的弧,所以它不安全。安全性关乎从该节点出发的每一条路径,而不是节点本身。
10. 按组排序项目:两层同时排序
题目。项目属于不同的组,某些项目必须排在另一些之前,并且同一组的项目在输出中必须连续。返回一个合法顺序或空列表。
这是较难的变体,而关键思路很朴素:运行两次拓扑排序。一次针对组,只要一个组中的项目必须排在另一个组中的项目之前,就在两组之间加一条弧;另一次针对每个组内部的项目。然后按组的顺序把各组拼接起来,每组内部填入已排序好的项目。
唯一麻烦的是未分组的项目。组号为 -1 的项目不受任何分组约束,所以给每个这样的项目单独分配一个新组。把它们全放进同一个组是经典的错误答案:这会强迫毫无关系的项目连续排列,可能让本来有解的实例变得无解。
任何一次排序失败都意味着整个实例无解,所以长度检查要做两次。两趟加起来复杂度仍为 O(V + E),因为每个项目和每条依赖只被处理常数次。
追问:一门课是另一门课的先修课吗?这是课程表 IV,它问的是可达性而不是顺序。按拓扑序处理顶点,把每个顶点的可达集合并入其后继,用位集实现: O(V × E / 64) 在实践中很快,而正是拓扑序保证了一个集合在被向前传递之前已经完整。
陷阱。对组排序时忘了一个组可能通过两个分属不同组的项目与自身形成环。只有当两个组不同时,才根据项目依赖在组图中建弧,否则你会造出自环,让排序无缘无故地失败。
11. 复杂度问题的回答
把这些准备好,因为它们会被原样问到,而答案很短。
| 变体 | 时间 | 空间 | 原因 |
|---|---|---|---|
| Kahn 或 DFS | O(V + E) | O(V + E) | 每个顶点输出一次,每条弧松弛一次 |
| 字典序最小 | O(V + E log V) | O(V + E) | 队列变成堆 |
| 层级或最长路径 | O(V + E) | O(V + E) | 在同一次扫描中多携带一个数组 |
| 唯一性检查 | O(V + E) | O(V + E) | 每次出队比较一次 |
| 所有顶点对之间的可达性 | O(V × E / 64) | O(V2 / 64) | 按拓扑序做位集并 |
有两点要主动补充。第一,图通常不是以邻接表的形式给你的:它以二元组列表的形式出现,而建表本身也需要 O(V + E),所以给出忽略建图的复杂度是错的。第二,拓扑排序不是比较排序,不受 O(n log n)的下界限制:它之所以是线性的,正是因为输入已经提供了顺序约束,而不需要你去发现它们。
递归的 DFS 版本在最坏情况下还需要 O(V) 的栈深度,这是实实在在的限制,而不是理论上的。一条 100 000 个任务的链远在耗尽内存之前,就会耗尽 Python 默认 1 000 的递归上限。
12. 导致面试失败的错误
按出现频率排序;前两条解释了大多数被拒的解答。
- 把弧建反。课程表中的二元组
[a, b]表示 b 在 a 之前。弄反之后代码仍会返回一个顺序,只不过是镜像问题的顺序。动手前先把二元组念出来。 - 漏掉
len(order) == V检查。没有它,有环的输入会产生一份看似正确的部分日程。计数才是环检测,顺序只是副产品。 - 在 DFS 版本中使用 visited 集合。两种状态无法区分回边与指向已完成分支的边,于是你会漏掉环,或者凭空造出环。每次都用三种颜色。
- 丢掉没有边的顶点。只根据二元组列表建图,会悄悄丢掉所有既没有先修课也没有后续课的课程。要从题目给出的顶点数出发。
- 在首次到达时分配层号。一个顶点要等待最慢的前驱,所以它的层号是所有前驱上的最大值,而不是最先到达它的那个值。
- 不按拓扑序松弛。最长路径和最短路径的扫描之所以正确,完全是因为读取一个顶点时它的每个前驱都已确定。按顶点编号迭代会悄无声息地返回一个更小的数。
- 重复依赖被计数两次。如果输入中的二元组可能重复,要么在统计入度之前去重,要么每条存储的弧只递减一次。一处计了重复、另一处没计,会让某个顶点永远卡在入度为一。
- 声称顺序是唯一的。它很少是唯一的,这样断言只会招来你没准备好的追问。说“一个合法顺序”,如果对方需要,再提出唯一性检查。
- 不询问输入的情况。依赖会重复吗?一门课会依赖它自己吗?顶点编号是连续整数还是任意字符串?每一个答案都会改变你写下的前十行代码。
能避免大多数错误的习惯是:动手写之前,先说清弧的方向,以及排序提前停止时答案是什么。如果不能用一句话把两者说清楚,你就还没准备好开始写。
13. 常见问题
用简单的话说,什么是拓扑排序?
+
它是有向图顶点的一种排列,其中每条弧都指向前方,因此任何东西都不会出现在它所依赖的东西之前。课程排在先修课之后,构建目标排在其输入之后,任务排在阻塞它的任务之后。当且仅当图中没有有向环时它才存在,求出它需要 O(V + E) 的时间。
Kahn 还是 DFS:面试中应该写哪个?
+
写你能不假思索写出的那个,因为两者都是 O(V + E),也都会被接受。Kahn 是更好的默认选择:它是迭代的,因此没有递归上限;它的环检测是一次长度比较,而不是关于颜色的论证;而且它能自然地扩展到层级、用堆求字典序,以及任何按波次处理的问题。当你在题目的其他部分已经需要深度优先搜索,或者需要逆后序来做强连通分量时,选择 DFS。
如何用拓扑排序检测环?
+
用 Kahn 时,统计输出了多少:如果输出的顶点少于 V 个,剩下的顶点入度始终没有降到零,它们恰好是位于环上或环下游的顶点。用 DFS 时,把顶点染成白、灰、黑三色,灰色表示当前在递归栈上;指向灰色顶点的弧是回边,而回边就是环。两种状态的 visited 集合做不到这种区分,会报告并不存在的环。
拓扑序是唯一的吗?
+
几乎从来不是。本文通篇使用的八顶点图有 49 个合法顺序。当且仅当 Kahn 的队列在每一步都只有一个顶点时,顺序才唯一,这等价于顺序中相邻的顶点之间都有弧相连,即该顺序是 DAG 的一条哈密顿路径。如果题目期望一个特定答案,通常要求的是字典序最小的顺序,把队列换成最小堆即可得到。
无向图可以做拓扑排序吗?
+
不可以,而且这个问题值得认真回答,因为它有时是在考你。无向边在两个端点之间不施加任何顺序,所以没有什么可排的。如果题目给你一张无向图却要求一个顺序,要么方向隐含在题目的某处,需要你找出来,要么预期的是另一种技巧,比如求最小高度树时的剥叶子法。
为什么最长路径在 DAG 上很容易,在一般图上却很难?
+
因为拓扑序让你可以一次性确定每个顶点。一个顶点的每个前驱在该顶点被读取之前都已得到最终值,所以一趟正向扫描就足够,复杂度为 O(V + E)。在有环的图上不存在这样的顺序,路径又不能重复经过顶点,最长简单路径问题是 NP 难的。这就是为什么项目调度这种带工期的最长路径问题,在实践中可以在线性时间内算出。
哪些面试题实际上是拓扑排序?
+
课程表 I 和 II、外星人字典、并行课程、序列重建、找到最终的安全状态、按组排序项目、课程表 IV、完成所有任务的最少时间,以及任何关于构建顺序、任务调度或依赖解析的问题。线索是“必须在……之前”这样的表述,或者输入是一组两个元素地位不对称的二元组。
14. 参考文献
按时间顺序列出提出这些技术的论文以及分析它们的著作。
- Kelley, J. E. and Walker, M. R. (1959). “Critical-path planning and scheduling.” Proceedings of the Eastern Joint Computer Conference, 160–173.
- Kahn, A. B. (1962). “Topological sorting of large networks.” Communications of the ACM, 5(11), 558–562.
- Knuth, D. E. (1968). The Art of Computer Programming, Volume 1: Fundamental Algorithms,第 2.2.3 节。Addison-Wesley。
- Coffman, E. G. and Graham, R. L. (1972). “Optimal scheduling for two-processor systems.” Acta Informatica, 1(3), 200–213.
- Tarjan, R. E. (1972). “Depth-first search and linear graph algorithms.” SIAM Journal on Computing, 1(2), 146–160.
- Tarjan, R. E. (1976). “Edge-disjoint spanning trees and depth-first search.” Acta Informatica, 6(2), 171–185.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. and Stein, C. (2009). Introduction to Algorithms,第 3 版,第 22.4 节。MIT Press。
- Sedgewick, R. and Wayne, K. (2011). Algorithms,第 4 版,第 4.2 节。Addison-Wesley。
- McDowell, G. L. (2015). Cracking the Coding Interview,第 6 版。CareerCup。
- Skiena, S. S. (2020). The Algorithm Design Manual,第 3 版,第 5.10 节。Springer。