
Table des Matières
- 1. Ce qu'une question de tri topologique évalue vraiment
- 2. Les deux modèles, et quand chacun l'emporte
- 3. Course schedule : peut-on terminer tous les cours ?
- 4. Course schedule II : renvoyer un ordre
- 5. Alien dictionary : retrouver un alphabet
- 6. Cours en parallèle : le nombre minimal de semestres
- 7. L'ordre est-il unique ? Reconstruction de séquence
- 8. Le plus long chemin, et le chemin critique
- 9. États finalement sûrs : trier le graphe inversé
- 10. Trier des éléments par groupe : deux niveaux à la fois
- 11. Les réponses sur la complexité
- 12. Les erreurs qui font échouer l'entretien
- 13. Questions fréquentes
- 14. Références
1. Ce qu'une question de tri topologique évalue vraiment
Les mots « tri topologique » n'apparaissent presque jamais dans la question. On vous donne des cours avec des prérequis, des cibles de compilation, des listes de tâches, une recette ou un dictionnaire dans un alphabet extraterrestre, et l'entretien guette trois choses.
Voyez-vous le graphe ? Tout ce qui est formulé comme « X doit venir avant Y » est une arête orientée, et la réponse est un ordre des sommets. Orientez-vous les arcs dans le bon sens ? C'est de loin l'échec le plus courant, et il produit du code qui tourne, renvoie un ordre, et à l'envers. Savez-vous que la détection de cycle et le tri sont le même calcul ? « Peut-on planifier ceci ? » et « donnez-moi un planning » sont un seul algorithme avec deux instructions return différentes.
Ensuite, toutes les variantes sont le même balayage transportant quelque chose en plus : un numéro de niveau, une durée, un compteur, un second graphe. Une fois le modèle automatique, la partie intéressante de chacun de ces problèmes est la modélisation, pas le code. La mécanique elle-même est traitée dans le guide du tri topologique ; cette page porte sur les huit questions réellement posées.
Chaque exemple détaillé ci-dessous a été exécuté par script avant d'être rédigé.
2. Les deux modèles, et quand chacun l'emporte
Il existe exactement deux implémentations à connaître, et un recruteur acceptera l'une ou l'autre. Écrivez celle que vous produisez sans hésiter, et soyez capable de dire pourquoi vous pourriez vouloir l'autre.
L'algorithme de Kahn, issu de son article de 1962, est la version itérative. Comptez combien de prérequis il reste à chaque sommet, gardez ceux à zéro dans une file, et émettez-les.
from collections import deque

def kahn(n, edges):                  # edges contient (u, v) : u vient avant v
    adj = [[] for _ in range(n)]
    indeg = [0] * n
    for u, v in edges:
        adj[u].append(v)
        indeg[v] += 1                # compter les arcs VERS v
    q = deque(v for v in range(n) if indeg[v] == 0)
    order = []
    while q:
        u = q.popleft()
        order.append(u)
        for v in adj[u]:
            indeg[v] -= 1            # u est fini, v en attend un de moins
            if indeg[v] == 0:
                q.append(v)
    return order if len(order) == n else []      # sortie trop courte : un cycle
La dernière ligne porte tout le test de cycle. Si certains sommets n'atteignent jamais un degré entrant nul, ils s'attendent mutuellement, et len(order) < n en est la preuve. Notez qu'il n'y a aucun ensemble visited nulle part : le compteur de degré entrant garantit déjà que chaque sommet est émis exactement une fois.
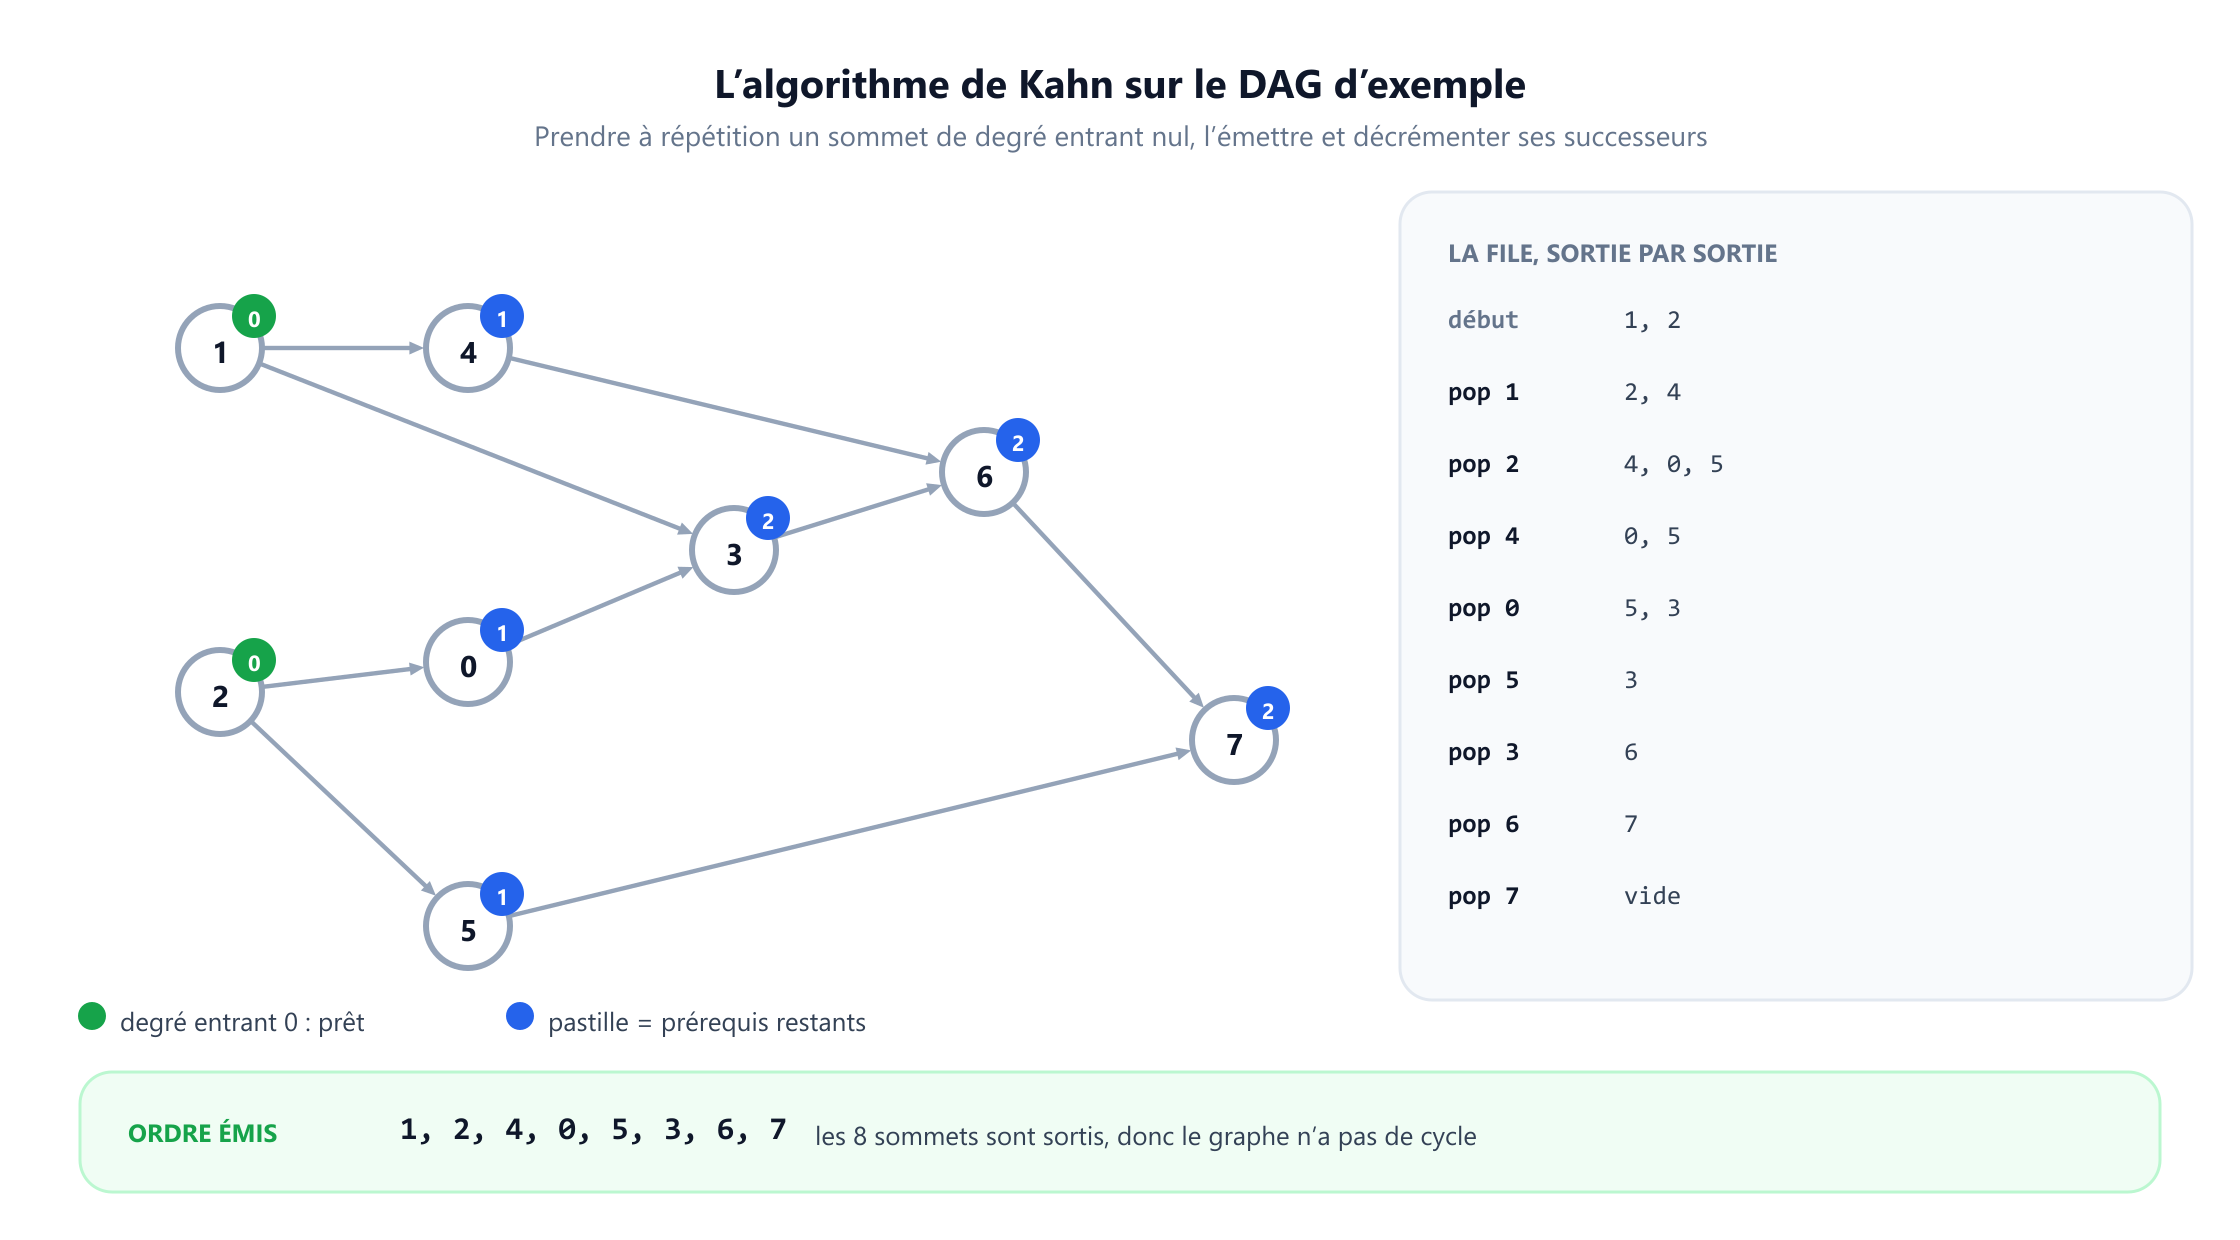
Sur ce graphe, la file commence par [1, 2], et l'ordre émis est 1, 2, 4, 0, 5, 3, 6, 7. Les huit sommets sortent, donc il n'y a pas de cycle.
La version DFS est l'autre modèle. Lancez un parcours en profondeur et ajoutez chaque sommet à une liste quand il se termine, puis inversez. La subtilité que sondent les recruteurs est le coloriage.
WHITE, GREY, BLACK = 0, 1, 2      # non vu, sur la pile, terminé

def dfs_topo(n, adj):
    colour = [WHITE] * n
    out = []
    def visit(u):
        colour[u] = GREY
        for v in adj[u]:
            if colour[v] == GREY:          # arc arrière : un cycle trouvé
                return False
            if colour[v] == WHITE and not visit(v):
                return False
        colour[u] = BLACK
        out.append(u)                      # ajouter en SORTANT, pas en entrant
        return True
    for v in range(n):
        if colour[v] == WHITE and not visit(v):
            return []
    return out[::-1]                       # post-ordre inversé
Trois couleurs, pas un ensemble des visités. Un simple ensemble visited ne peut pas distinguer un arc qui revient dans la pile de récursion courante, c'est-à-dire un cycle, d'un arc vers une branche déjà terminée, qui n'en est pas un. Dites cette phrase en entretien et la relance sur la détection de cycle a déjà sa réponse.
Lequel utiliser ? Kahn si le problème demande des niveaux, des comptes, l'ordre lexicographique ou tout ce qui gagne à traiter les sources par vagues. Le DFS si vous écrivez déjà un parcours en profondeur pour une autre raison, ou si vous voulez le post-ordre inversé pour une passe de composantes fortement connexes. Les deux sont en O(V + E). La seule différence pratique : le DFS récursif a besoin d'une profondeur de pile proportionnelle à la plus longue chaîne, ce qui, sur une entrée hostile de cent mille tâches chaînées, atteindra la limite de récursion par défaut de Python, alors que Kahn non.
3. Course schedule : peut-on terminer tous les cours ?
La question. Il y a n cours et une liste de paires [a, b] signifiant « pour suivre le cours a, il faut d'abord suivre le cours b ». Pouvez-vous tous les terminer ?
L'étape de modélisation est toute la question, et c'est là que la plupart des candidats la perdent. La paire [a, b] dit b avant a, donc l'arc va b → a, et c'est indeg[a] qui augmente. L'inverser produit quand même un tri topologique valide d'un autre graphe : rien ne plante, et la réponse est silencieusement fausse sur tout cas de test asymétrique.
def can_finish(n, prerequisites):
    edges = [(b, a) for a, b in prerequisites]   # b avant a
    return len(kahn(n, edges)) == n
C'est tout : lancez le tri, comparez le compte. Dites à voix haute qu'un planning existe exactement quand le graphe des prérequis est acyclique, car un cycle est un ensemble de cours qui s'attendent chacun les uns les autres.
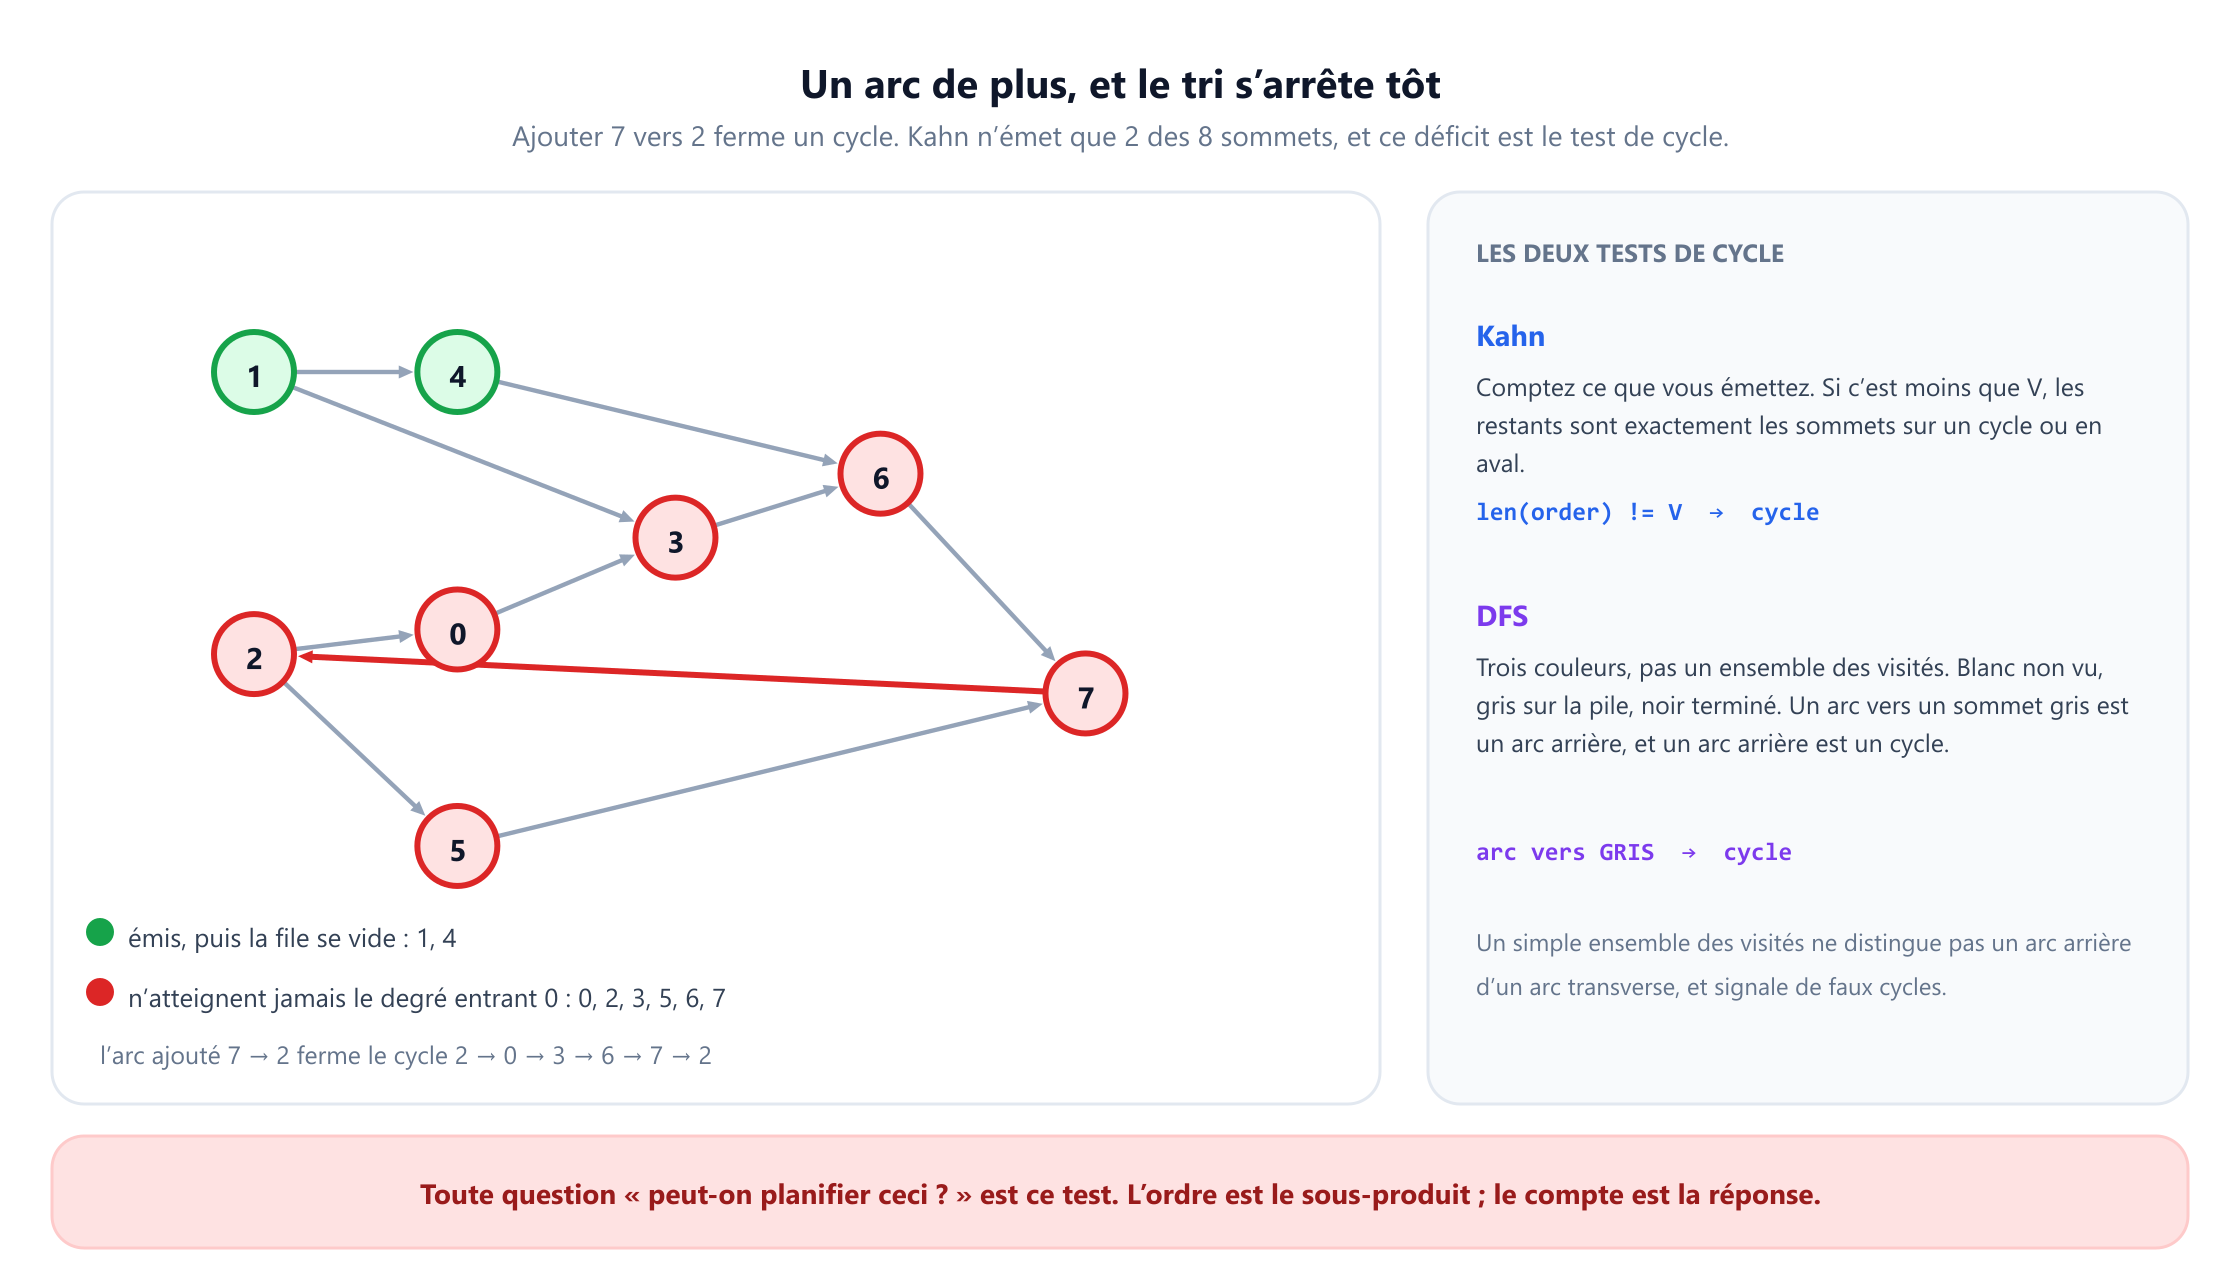
Ajoutez l'arc 7 → 2 au graphe d'exemple et la file commence avec le seul sommet 1, émet 1 et 4, puis se vide. Six sommets restent bloqués, et ce sont précisément le cycle 2 → 0 → 3 → 6 → 7 → 2 et le sommet 5, situé en aval.
La relance : quels cours posent problème ? Les restants de degré entrant non nul sont les sommets sur un cycle ou en aval, ce qui est généralement la réponse attendue. Si l'on insiste sur le cycle lui-même plutôt que sur tout ce qu'il bloque, il vous faut la version DFS : quand vous rencontrez un sommet gris, la pile de récursion courante à partir de ce sommet est le cycle.
Le piège. Inverser les arcs. Lisez la paire à voix haute comme « a dépend de b, donc b vient d'abord » avant de taper, et confirmez le sens avec le recruteur sur un exemple à deux éléments.
4. Course schedule II : renvoyer un ordre
La question. Même entrée, mais renvoyez un ordre valide, ou une liste vide s'il n'en existe aucun.
C'est kahn sans changement, ce qui explique que les deux questions soient généralement posées à la suite. La seule idée nouvelle est une idée que vous devez avancer spontanément : l'ordre n'est pas unique, et le correcteur accepte n'importe quel ordre valide.
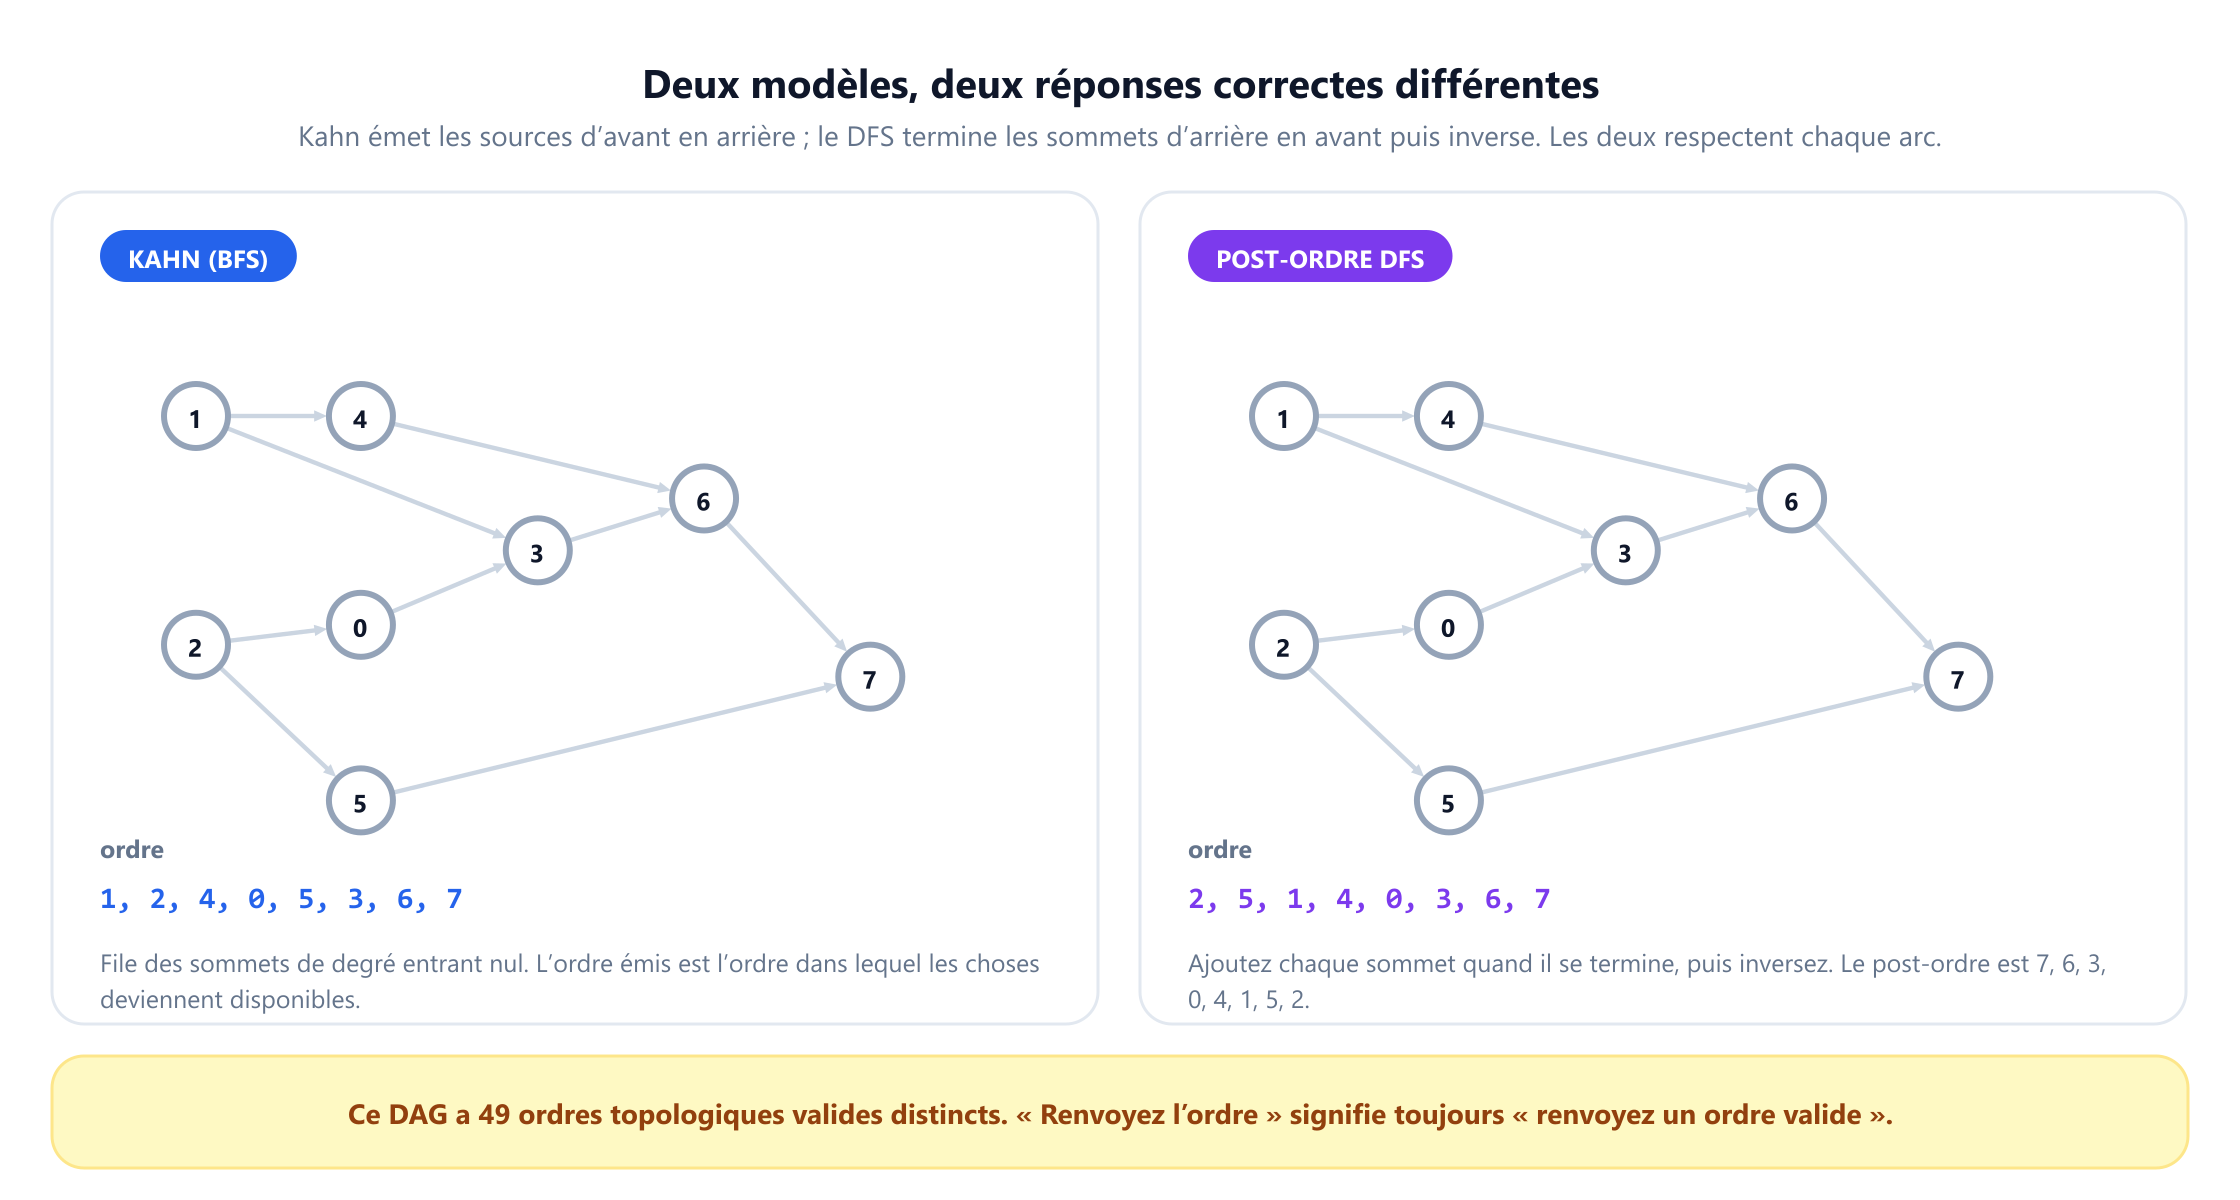
Kahn renvoie 1, 2, 4, 0, 5, 3, 6, 7 et le DFS renvoie 2, 5, 1, 4, 0, 3, 6, 7. Aucun n'est plus correct que l'autre, et un comptage exhaustif indique que ce graphe a 49 ordres valides distincts. Si votre solution est comparée à une unique réponse attendue, c'est le test qui est cassé, pas la solution.
La relance : renvoyez le plus petit ordre lexicographique. Remplacez la file par un tas min. À chaque étape, vous sortez le plus petit sommet disponible plutôt que le premier mis en file, ce qui fixe de manière gloutonne la plus petite valeur possible à chaque position. Le coût passe de O(V + E) à O(V + E log V), et savoir énoncer ce compromis est tout l'objet de la relance. Sur le graphe d'exemple, le plus petit ordre est 1, 2, 0, 3, 4, 5, 6, 7.
Le piège. Renvoyer order sans le test de longueur. Sur une entrée cyclique, vous rendez un planning partiel qui paraît tout à fait plausible, et chaque test automatique avec un cycle échoue alors que votre exécution locale du cas nominal réussit.
5. Alien dictionary : retrouver un alphabet
La question. On vous donne des mots triés selon un alphabet inconnu. Retrouvez un ordre des lettres cohérent avec ce tri, ou signalez qu'il n'en existe aucun.
Rien ici ne ressemble à un graphe tant qu'on n'a pas remarqué ce que « trié » nous apprend. Comparez deux mots adjacents, trouvez la première position où ils diffèrent, et vous avez appris exactement un fait : cette lettre du premier mot précède cette lettre du second. Tout ce qui suit la première différence ne vous apprend rien. Triez ensuite les lettres topologiquement.
def alien_order(words):
    adj = {c: set() for w in words for c in w}
    indeg = {c: 0 for c in adj}
    for w1, w2 in zip(words, words[1:]):
        if len(w1) > len(w2) and w1.startswith(w2):
            return ""                       # « abc » avant « ab » est impossible
        for a, b in zip(w1, w2):
            if a != b:
                if b not in adj[a]:         # ne pas compter un doublon deux fois
                    adj[a].add(b)
                    indeg[b] += 1
                break                       # seule la PREMIÈRE différence compte
    ...                                     # puis Kahn sur les lettres
Trois détails en six lignes, et les recruteurs vérifient les trois. Seulement les paires adjacentes. Comparer chaque paire de mots ajoute des arêtes que l'entrée ne justifie pas. Seulement la première position différente, puis break. La règle du préfixe : si un mot est un préfixe strict du mot précédent, l'entrée se contredit et la réponse est la chaîne vide, sans construire le moindre graphe.
Sur l'entrée classique ["wrt", "wrf", "er", "ett", "rftt"], les comparaisons donnent t → f, w → e, r → t et e → r, et le tri renvoie "wertf". Sur ["abc", "ab"], la règle du préfixe se déclenche et renvoie "". Sur ["z", "x", "z"], les arêtes z → x et x → z forment un cycle, donc le test de longueur renvoie aussi "".
La relance : l'alphabet renvoyé est-il le seul ? C'est la question d'unicité de la section 7 : l'ordre est imposé exactement quand la file contient une seule lettre à chaque étape. Toute lettre qui n'apparaît dans aucune comparaison flotte librement, et sa position est arbitraire.
Le piège. Construire le graphe à partir des lettres qui apparaissent dans les comparaisons plutôt qu'à partir de toutes les lettres de tous les mots. Les lettres jamais comparées doivent quand même figurer dans la sortie, et les oublier est l'erreur que détecte un test caché plutôt que le vôtre.
6. Cours en parallèle : le nombre minimal de semestres
La question. Vous pouvez suivre autant de cours que vous voulez en même temps, tant que chaque prérequis est déjà validé. Quel est le nombre minimal de semestres nécessaire ?
La réponse est le nombre de niveaux du DAG, et le niveau d'un sommet vaut un de plus que le plus grand niveau parmi ses prédécesseurs. Transportez ce nombre dans le même balayage.
def min_semesters(n, edges):
    order = kahn(n, edges)
    if len(order) != n:
        return -1                          # un cycle : ne finit jamais
    level = [1] * n
    for u in order:                        # chaque prédécesseur de u est définitif
        for v in adj[u]:
            level[v] = max(level[v], level[u] + 1)
    return max(level)
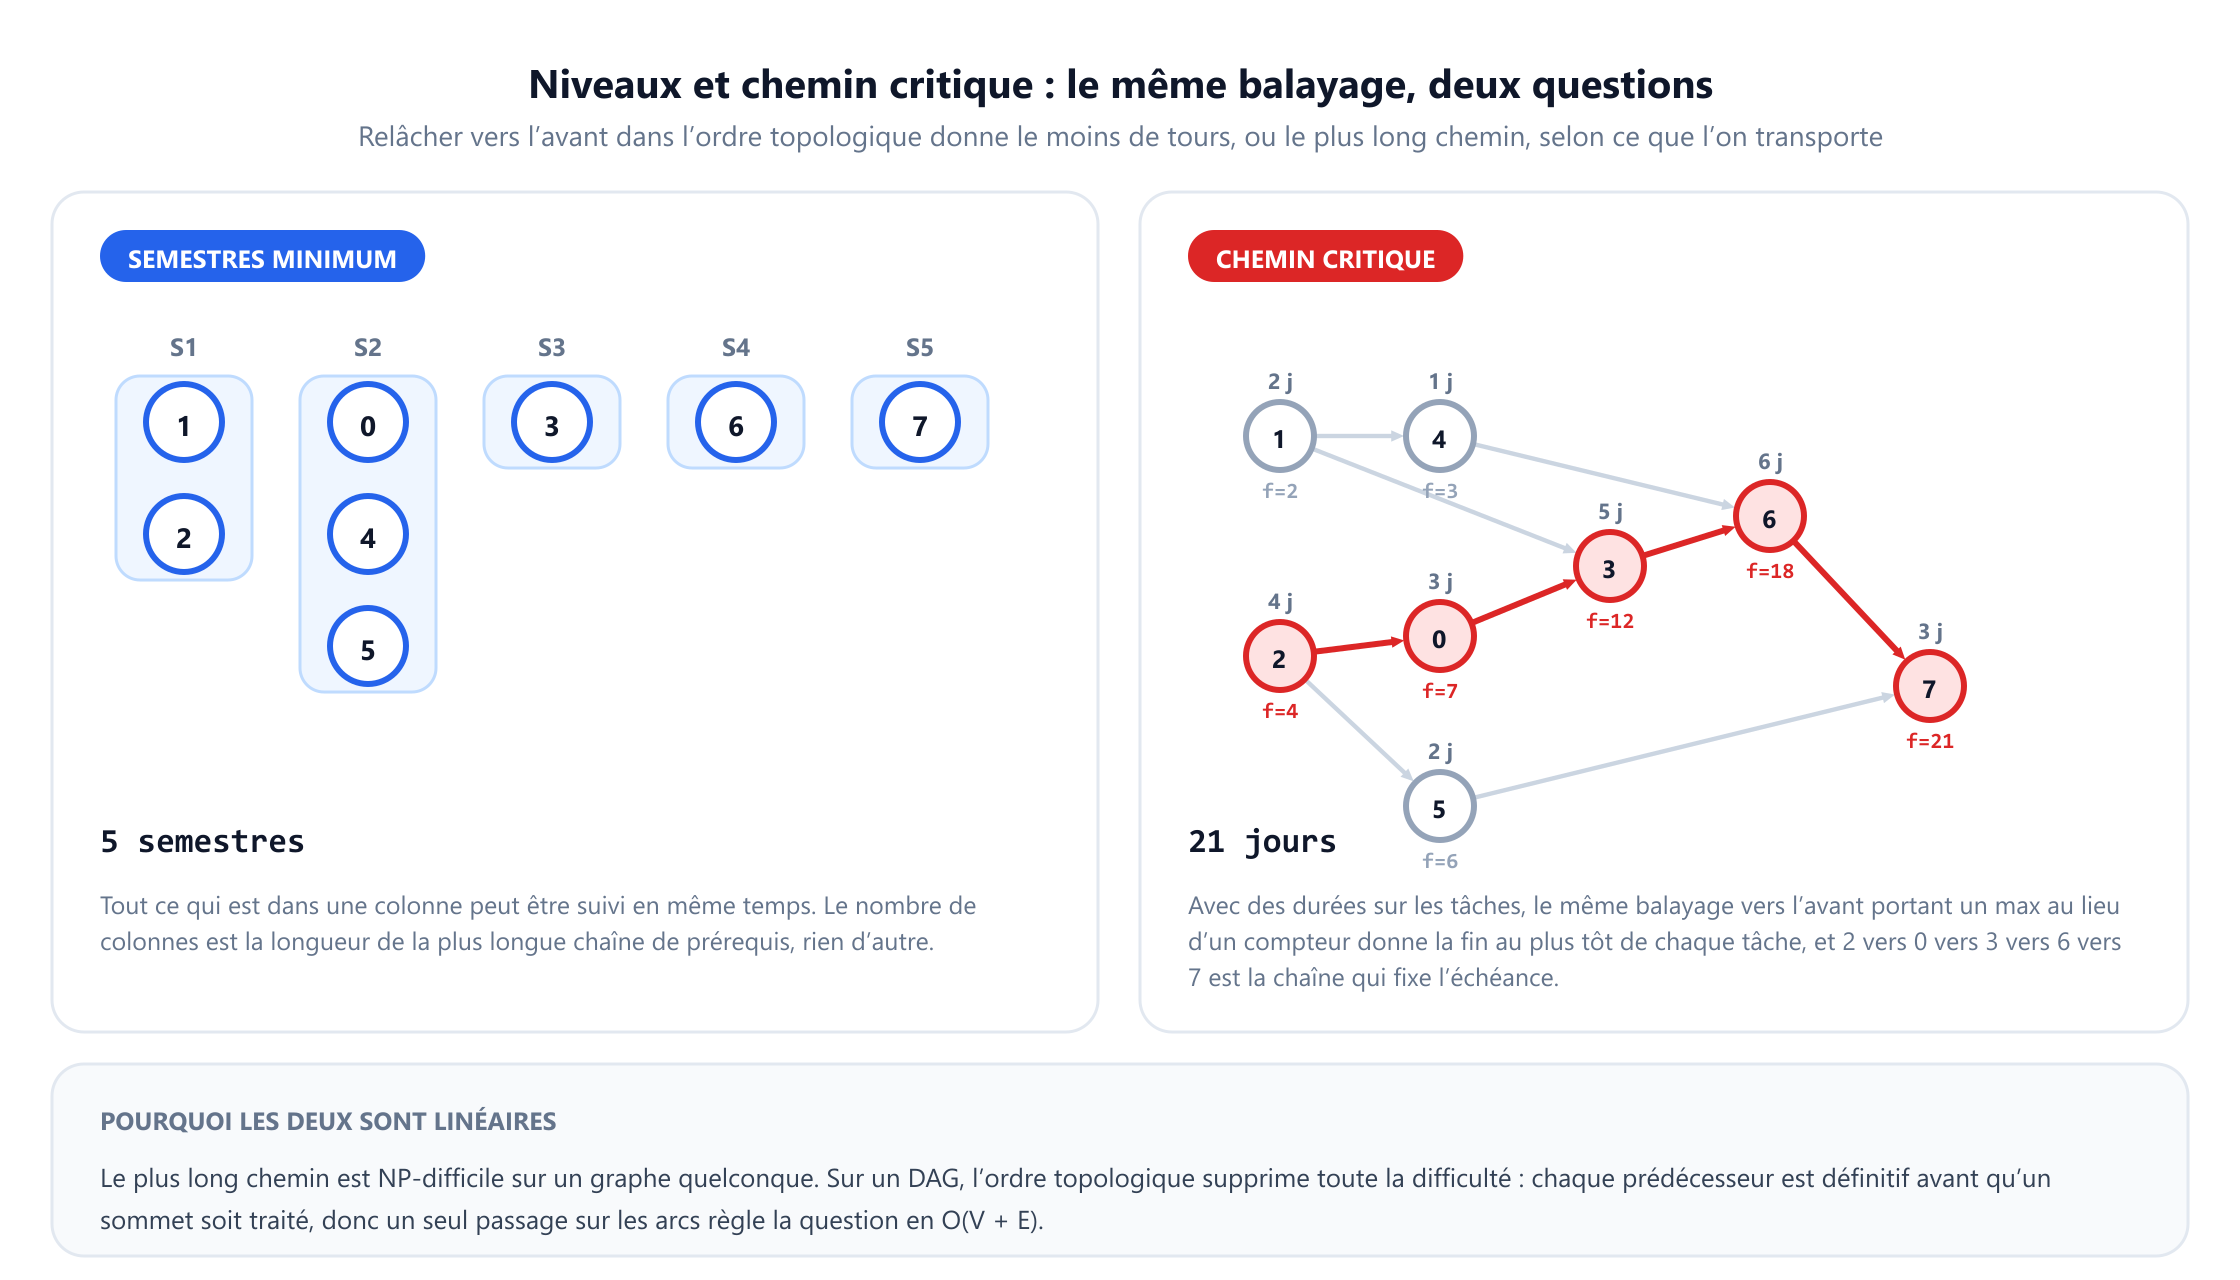
Comme la boucle suit l'ordre topologique, chaque prédécesseur de u a déjà contribué avant que u ne soit lu, et c'est cette propriété qui fait qu'une seule passe suffit. Sur le graphe d'exemple, les niveaux sont {1, 2}, puis {0, 4, 5}, puis {3}, puis {6}, puis {7}, donc la réponse est 5 semestres.
La relance : et si l'on ne peut suivre qu'au plus k cours par semestre ? La réponse facile s'effondre. Le parallélisme illimité est linéaire parce que prendre goulûment tout ce qui est disponible est optimal ; limiter la largeur en fait un problème d'ordonnancement avec contraintes de précédence sur k machines, NP-difficile en général. Deux machines identiques avec des tâches unitaires, c'est le cas traitable classique, résolu par Coffman et Graham en 1972. Reconnaître que la relance change de classe de complexité, plutôt que d'essayer de rafistoler la boucle, c'est ce que le recruteur attend.
Le piège. Attribuer un niveau la première fois qu'un sommet est atteint, comme s'il s'agissait d'un BFS ordinaire depuis les sources. Un sommet doit attendre son prédécesseur le plus lent, donc le niveau est un maximum, pas une première arrivée. La variante BFS par vagues ne fonctionne que si vous sortez une couche entière à la fois et ne regardez jamais un sommet avant que son degré entrant n'atteigne zéro.
7. L'ordre est-il unique ? Reconstruction de séquence
La question. Étant donné un DAG, déterminez s'il possède exactement un ordre topologique valide. L'habillage habituel est la reconstruction de séquence : on vous donne une séquence et un ensemble de sous-séquences, et on vous demande si la séquence est la seule cohérente avec elles.
Le test tient en une ligne dans la boucle de Kahn.
    while q:
        if len(q) > 1:
            return False              # il y avait un choix : ordre non imposé
        u = q.popleft()
        ...
Si la file contient un jour deux sommets, les deux sont disponibles et l'un ou l'autre peut venir ensuite, donc il existe au moins deux ordres valides. Si elle en contient exactement un à chaque étape, aucun choix n'a jamais été fait et l'ordre est imposé.
Il existe une seconde formulation équivalente qui fait impression : l'ordre est unique exactement quand les sommets consécutifs y sont reliés par un arc, c'est-à-dire quand l'ordre topologique est un chemin hamiltonien du DAG. Les deux formulations se vérifient en O(V + E), et citer la version du chemin hamiltonien montre que vous comprenez pourquoi l'unicité est une propriété structurelle et non un hasard de la file.
Sur le graphe d'exemple, les tailles de la file aux huit sorties sont 2, 2, 3, 2, 2, 1, 1, 1. La toute première étape offre déjà le choix entre 1 et 2, donc l'ordre n'est pas unique, ce que confirment les 49 ordres valides comptés à la section 4. Sur la chaîne 0 → 1 → 2 → 3, les tailles sont 1, 1, 1, 1 et l'ordre est imposé.
La relance : la reconstruction de séquence elle-même. Construisez le graphe à partir des paires consécutives de chaque sous-séquence, lancez le test ci-dessus, et vérifiez en plus que l'ordre émis est égal à la séquence donnée. Les deux conditions sont nécessaires : un ordre unique différent de la séquence qu'on vous a donnée reste un « non ».
Le piège. Ne vérifier la taille de la file qu'une seule fois, au début. Un graphe peut commencer par une seule source et se ramifier trois étapes plus loin, donc la comparaison doit se faire à chaque itération. Bon à savoir : « chaque niveau contient exactement un sommet » est un test équivalent, car un ordre imposé fait des niveaux une chaîne stricte ; raisonner par niveaux n'est donc pas faux, cela coûte seulement une seconde passe pour les calculer.
8. Le plus long chemin, et le chemin critique
La question. Chaque tâche prend un nombre de jours connu et ne peut commencer qu'une fois ses prérequis terminés. Quand le projet se termine-t-il, et quelles tâches en décident ?
C'est le problème du plus long chemin, NP-difficile sur un graphe quelconque. Sur un DAG, il est linéaire, et la raison en est l'ordre topologique : chaque prédécesseur d'un sommet est définitif avant que ce sommet ne soit lu, donc une seule passe vers l'avant le règle.
def critical_path(n, edges, dur):
    order = kahn(n, edges)
    finish = list(dur)                     # fin au plus tôt si rien ne bloque
    prev = [-1] * n
    for u in order:
        for v in adj[u]:
            if finish[u] + dur[v] > finish[v]:
                finish[v] = finish[u] + dur[v]
                prev[v] = u                # retenir qui a imposé le retard
    end = max(range(n), key=lambda v: finish[v])
    path = []
    while end != -1:
        path.append(end); end = prev[end]
    return max(finish), path[::-1]
Donnez au graphe d'exemple les durées 3, 2, 4, 5, 1, 2, 6, 3 pour les sommets 0 à 7, et les fins au plus tôt valent 7, 2, 4, 12, 3, 6, 18, 21. Le projet dure 21 jours et le chemin critique est 2 → 0 → 3 → 6 → 7, dont les durées totalisent exactement 21. Cette chaîne est ce qu'un chef de projet appelle « le chemin critique » : si une tâche qui en fait partie glisse d'un jour, tout le projet glisse d'un jour, alors que la tâche 5 dispose d'une marge et peut dériver plusieurs jours sans que personne ne le remarque. C'est la méthode de Kelley et Walker de 1959, et dire son nom à voix haute ne coûte rien.
La relance : le plus court chemin à la place. Changez la comparaison en < et vous obtenez les plus courts chemins à source unique sur un DAG, en O(V + E), et cela fonctionne avec des poids négatifs, ce que Dijkstra ne sait pas faire. Chaque fois qu'un recruteur mentionne des arêtes négatives sur un graphe acyclique, c'est la réponse, pas Bellman-Ford. Comparez avec le cas général dans les algorithmes de plus court chemin.
Le piège. Relâcher dans le mauvais ordre. Itérer sur les sommets de 0 à n-1 au lieu de suivre l'ordre topologique donne une valeur qui dépend de la numérotation : sur ce graphe, on obtient silencieusement 17 au lieu de 21, car le sommet 0 est lu avant que le sommet 2 n'y ait contribué. Tout l'intérêt de l'ordre topologique est qu'il rend une seule passe suffisante.
9. États finalement sûrs : trier le graphe inversé
La question. Un nœud est sûr si chaque chemin qui en part atteint un nœud terminal, de sorte qu'on ne peut jamais rester coincé dans un cycle. Renvoyez tous les nœuds sûrs par ordre croissant.
Formulé dans le sens direct, c'est malcommode. Inversez chaque arc et cela devient un tri topologique : retirez les nœuds de degré sortant nul, qui sont les terminaux, et chaque fois que le degré sortant restant d'un nœud atteint zéro, tous ses successeurs étaient sûrs, donc lui aussi.
def safe_nodes(graph):
    n = len(graph)
    rev = [[] for _ in range(n)]
    outdeg = [len(graph[u]) for u in range(n)]
    for u in range(n):
        for v in graph[u]:
            rev[v].append(u)
    q = deque(v for v in range(n) if outdeg[v] == 0)   # terminaux
    safe = []
    while q:
        u = q.popleft()
        safe.append(u)
        for p in rev[u]:
            outdeg[p] -= 1
            if outdeg[p] == 0:
                q.append(p)
    return sorted(safe)
C'est l'algorithme de Kahn avec le degré entrant remplacé par le degré sortant et les arcs inversés, ce qu'il vaut la peine de dire explicitement, car cela montre que vous reconnaissez le modèle sous un déguisement. Sur l'exemple standard [[1,2], [2,3], [5], [0,5], [5], [], []], la réponse est [2, 4, 5, 6] : les nœuds 5 et 6 sont terminaux, 2 et 4 ne mènent qu'à eux, et 0, 1 et 3 sont sur le cycle 0 → 1 → 3 → 0.
La relance : faites-le avec un DFS. Encore trois couleurs. Un nœud est sûr si aucun arc qui en part n'atteint un sommet gris, et vous pouvez mémoïser le résultat par nœud pour que tout reste linéaire. Les recruteurs veulent souvent entendre les deux, car la version par graphe inversé est celle que les candidats trouvent rarement seuls.
Le piège. Répondre « les nœuds qui ne sont pas sur un cycle ». Selon cette lecture, le nœud 3 n'est sur aucun cycle qui lui soit propre, mais il a un arc vers le cycle passant par 0, donc il n'est pas sûr. La sûreté concerne chaque chemin issu du nœud, pas le nœud lui-même.
10. Trier des éléments par groupe : deux niveaux à la fois
La question. Des éléments appartiennent à des groupes, certains éléments doivent en précéder d'autres, et les éléments d'un même groupe doivent être contigus dans la sortie. Renvoyez un ordre valide ou une liste vide.
C'est la variante difficile, et l'idée clé est modeste : lancez deux tris topologiques. L'un sur les groupes, avec un arc entre deux groupes chaque fois qu'un élément de l'un doit précéder un élément de l'autre, et l'autre sur les éléments à l'intérieur de chaque groupe. Concaténez ensuite les groupes dans l'ordre des groupes, chacun rempli de ses propres éléments triés.
La seule partie délicate concerne les éléments sans groupe. Un élément de groupe -1 n'est contraint par aucun regroupement, donnez-en donc à chacun un nouveau groupe rien qu'à lui. Les réunir tous dans un seul groupe est la mauvaise réponse classique : cela force des éléments sans rapport à être contigus et peut rendre insoluble une instance soluble.
L'échec de l'un ou l'autre tri fait échouer toute l'instance, donc le test de longueur s'exécute deux fois. La complexité reste en O(V + E) sur les deux passes, puisque chaque élément et chaque dépendance sont touchés un nombre constant de fois.
La relance : un cours est-il prérequis d'un autre ? C'est Course Schedule IV, qui demande l'accessibilité plutôt qu'un ordre. Traitez les sommets dans l'ordre topologique et fusionnez l'ensemble accessible de chaque sommet dans ses successeurs, avec des bitsets : O(V × E / 64) en pratique, et c'est l'ordre topologique qui garantit qu'un ensemble est complet avant d'être recopié vers l'avant.
Le piège. Trier les groupes en oubliant qu'un groupe peut aussi former un cycle avec lui-même via deux éléments de groupes différents. Ne construisez l'arc du graphe des groupes à partir d'une dépendance d'éléments que lorsque les deux groupes diffèrent, sinon vous créez des boucles qui font échouer le tri sans raison.
11. Les réponses sur la complexité
Ayez-les prêtes, car elles sont demandées mot pour mot et la réponse est courte.
| Variante | Temps | Espace | Pourquoi |
|---|---|---|---|
| Kahn, ou DFS | O(V + E) | O(V + E) | Chaque sommet émis une fois, chaque arc relâché une fois |
| Plus petit ordre lexicographique | O(V + E log V) | O(V + E) | La file devient un tas |
| Niveaux, ou plus long chemin | O(V + E) | O(V + E) | Un tableau de plus porté par le même balayage |
| Test d'unicité | O(V + E) | O(V + E) | Une comparaison par sortie |
| Accessibilité entre toutes les paires | O(V × E / 64) | O(V2 / 64) | Union de bitsets dans l'ordre topologique |
Deux choses à ajouter spontanément. D'abord, le graphe ne vous est généralement pas donné sous forme de liste d'adjacence : il arrive comme une liste de paires, et construire la liste coûte aussi O(V + E), donc citer une borne qui ignore la construction est faux. Ensuite, un tri topologique n'est pas un tri par comparaison et n'est pas limité par O(n log n) : il est linéaire justement parce que l'entrée fournit déjà les contraintes d'ordre au lieu de vous obliger à les découvrir.
La version DFS récursive utilise aussi une profondeur de pile en O(V) dans le pire cas, ce qui est une vraie limite et non une limite théorique. Une chaîne de 100 000 tâches épuise la limite de récursion par défaut de Python, fixée à 1 000, bien avant d'épuiser la mémoire.
12. Les erreurs qui font échouer l'entretien
Classées par fréquence ; les deux premières expliquent la plupart des solutions rejetées.
- Construire les arcs à l'envers. La paire
[a, b]dans Course Schedule signifie b avant a. Inversé, le code renvoie quand même un ordre, simplement celui du problème miroir. Lisez la paire à voix haute avant de taper. - Oublier le test
len(order) == V. Sans lui, une entrée cyclique produit un planning partiel qui a l'air correct. Le compte est le test de cycle, et l'ordre est le sous-produit. - Utiliser un ensemble des visités dans la version DFS. Deux états ne peuvent pas distinguer un arc arrière d'un arc vers une branche terminée, si bien que vous manquez des cycles ou en inventez. Trois couleurs, à chaque fois.
- Perdre les sommets sans arête. Construire le graphe à partir de la seule liste de paires supprime silencieusement tous les cours sans prérequis ni dépendants. Partez du nombre de sommets qu'on vous a donné.
- Attribuer les niveaux à la première arrivée. Un sommet attend son prédécesseur le plus lent, donc son niveau est un maximum sur les prédécesseurs, pas la première valeur qui l'atteint.
- Relâcher hors de l'ordre topologique. Les balayages de plus long et de plus court chemin ne sont corrects que parce que chaque prédécesseur est définitif quand un sommet est lu. Itérer sur les indices des sommets renvoie en silence un nombre plus petit.
- Compter deux fois les dépendances en double. Si l'entrée peut répéter une paire, dédupliquez avant de compter les degrés entrants, ou décrémentez une fois par arc stocké. Compter un doublon à un endroit et pas à l'autre laisse un sommet bloqué pour toujours à un degré entrant de un.
- Affirmer que l'ordre est unique. C'est rarement le cas, et l'affirmer appelle la relance que vous n'avez pas préparée. Dites « un ordre valide » et proposez le test d'unicité si on le souhaite.
- Ne pas poser de questions sur l'entrée. Les dépendances peuvent-elles se répéter ? Un cours peut-il dépendre de lui-même ? Les identifiants de sommets sont-ils des entiers consécutifs ou des chaînes arbitraires ? Chaque réponse change les dix premières lignes que vous écrivez.
L'habitude qui évite la plupart de ces erreurs : avant d'écrire quoi que ce soit, dites dans quel sens vont les arcs et quelle est la réponse quand le tri s'arrête trop tôt. Si vous ne pouvez pas énoncer les deux en une phrase, vous n'êtes pas encore prêt à taper.
13. Questions fréquentes
Qu'est-ce qu'un tri topologique, en termes simples ?
+
C'est un ordre des sommets d'un graphe orienté dans lequel chaque arc pointe vers l'avant, de sorte que rien n'apparaît avant quelque chose dont il dépend. Les cours après leurs prérequis, les cibles de compilation après leurs entrées, les tâches après celles qui les bloquent. Il existe si et seulement si le graphe n'a pas de cycle orienté, et le trouver prend un temps O(V + E).
Kahn ou DFS : lequel écrire en entretien ?
+
Celui que vous pouvez écrire sans hésiter, puisque les deux sont en O(V + E) et que les deux sont acceptés. Kahn est le meilleur choix par défaut : il est itératif, donc sans limite de récursion, son test de cycle est une comparaison de longueur plutôt qu'un argument de couleurs, et il s'étend naturellement aux niveaux, à l'ordre lexicographique avec un tas, et à tout ce qui se traite par vagues. Préférez le DFS quand vous avez déjà besoin d'un parcours en profondeur pour une autre partie du problème, ou quand vous voulez le post-ordre inversé pour une passe de composantes fortement connexes.
Comment détecter un cycle avec un tri topologique ?
+
Avec Kahn, comptez ce qui sort : si moins de V sommets sont émis, ceux qui restent n'ont jamais atteint un degré entrant nul et sont exactement les sommets situés sur un cycle ou en aval. Avec le DFS, coloriez les sommets en blanc, gris et noir, gris signifiant qu'ils sont actuellement sur la pile de récursion ; un arc vers un sommet gris est un arc arrière, et un arc arrière est un cycle. Un ensemble des visités à deux états ne peut pas faire cette distinction et signalera des cycles qui n'existent pas.
L'ordre topologique est-il unique ?
+
Presque jamais. Le graphe à huit sommets utilisé tout au long de cet article possède 49 ordres valides. L'ordre est unique exactement quand la file de Kahn contient un seul sommet à chaque étape, ce qui revient à dire que les sommets consécutifs de l'ordre sont reliés par un arc, donc que l'ordre est un chemin hamiltonien du DAG. Si un énoncé attend une réponse précise, il demande généralement le plus petit ordre lexicographique, que l'on obtient en remplaçant la file par un tas min.
Peut-on trier topologiquement un graphe non orienté ?
+
Non, et la question mérite une réponse soignée car c'est parfois un test. Une arête non orientée n'impose aucun ordre entre ses extrémités, il n'y a donc rien à trier. Si un problème vous donne un graphe non orienté et demande un ordre, soit le sens est implicite quelque part dans l'énoncé et il faut le retrouver, soit la technique attendue est autre, comme l'épluchage des feuilles pour les arbres de hauteur minimale.
Pourquoi le plus long chemin est-il facile sur un DAG mais difficile en général ?
+
Parce qu'un ordre topologique permet de fixer chaque sommet une seule fois. Chaque prédécesseur d'un sommet a sa valeur définitive avant que ce sommet ne soit lu, donc une seule passe vers l'avant suffit et le coût est en O(V + E). Sur un graphe avec des cycles, un tel ordre n'existe pas, un chemin ne peut pas répéter de sommets, et le problème du plus long chemin élémentaire est NP-difficile. C'est pourquoi l'ordonnancement de projets, qui est un plus long chemin avec des durées, se calcule en pratique en temps linéaire.
Quels problèmes d'entretien sont en réalité des tris topologiques ?
+
Course Schedule I et II, Alien Dictionary, Parallel Courses, Sequence Reconstruction, Find Eventual Safe States, Sort Items by Group, Course Schedule IV, Minimum Time to Complete All Tasks, et toute question d'ordre de compilation, de planification de tâches ou de résolution de dépendances. L'indice est l'expression « doit venir avant », ou une entrée de paires dont les deux éléments ne sont pas symétriques.
14. Références
Les articles qui ont introduit ces techniques et les ouvrages qui les analysent, par ordre chronologique.
- Kelley, J. E. et Walker, M. R. (1959). “Critical-path planning and scheduling.” Proceedings of the Eastern Joint Computer Conference, 160–173.
- Kahn, A. B. (1962). “Topological sorting of large networks.” Communications of the ACM, 5(11), 558–562.
- Knuth, D. E. (1968). The Art of Computer Programming, Volume 1: Fundamental Algorithms, section 2.2.3. Addison-Wesley.
- Coffman, E. G. et Graham, R. L. (1972). “Optimal scheduling for two-processor systems.” Acta Informatica, 1(3), 200–213.
- Tarjan, R. E. (1972). “Depth-first search and linear graph algorithms.” SIAM Journal on Computing, 1(2), 146–160.
- Tarjan, R. E. (1976). “Edge-disjoint spanning trees and depth-first search.” Acta Informatica, 6(2), 171–185.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. et Stein, C. (2009). Introduction to Algorithms, 3e édition, section 22.4. MIT Press.
- Sedgewick, R. et Wayne, K. (2011). Algorithms, 4e édition, section 4.2. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6e édition. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3e édition, section 5.10. Springer.