
目录
1. BFS 题目真正考察的是什么
几乎没有人会被要求“实现 BFS”。你拿到的是一个看起来不像图的问题,而面试考察三件事:你能否看出其中的图,是否知道 BFS 是合适的工具,以及能否写出没有 bug 的代码。
信号是最少这个词,或者它的任何同义词:最少步数、最短变换、最早的时刻、最近的出口。BFS 能回答这些问题,但前提是每一步的代价都相同。这个条件就是关键所在:当每步代价相同时,BFS 能在 O(V + E)内给出精确的最小值;当代价不同时,它就是错的,而下意识地用 BFS 正是这道题想要引出的错误。
下面八道是反复出现的题目。每道题都按实际面试的流程展开:问题、解答、面试官接下来会问的追问,以及让你丢掉 offer 的错误。每个示例都经过脚本实际运行验证。
2. 需要默写的模板
一个模板就能覆盖这里的所有题目。你应该能在两分钟内不假思索地写出来,因为面试时间应该花在建模上,而不是打字上。
from collections import deque

def bfs(start, neighbours):
    dist = {start: 0}
    q = deque([start])
    while q:
        u = q.popleft()
        for v in neighbours(u):
            if v not in dist:          # 入队时标记,绝不在出队时标记
                dist[v] = dist[u] + 1
                q.append(v)
    return dist
有四个细节决定了你的表现是干净利落还是磕磕绊绊。
- 在入队时标记为已访问,而不是在出队时。在出队时标记,会让一个顶点每被边界上的一条入边发现一次就入队一次,队列会膨胀到
O(E)。距离仍然正确,所以能通过测试,却过不了代码审查。 - 使用真正的队列。
deque.popleft()是O(1);list.pop(0)是O(n),会悄悄把线性算法变成二次算法。 - 距离表同时充当已访问集合。能用一个结构却用两个,就多了两次忘记更新的机会。
neighbours是一个函数,而不是一个数据结构。正因如此,同样的八行代码无需修改就能解决网格、单词谜题和状态空间问题。大多数面试中的图根本不会被显式构建出来,这一点在图的表示一文中有详细讨论。
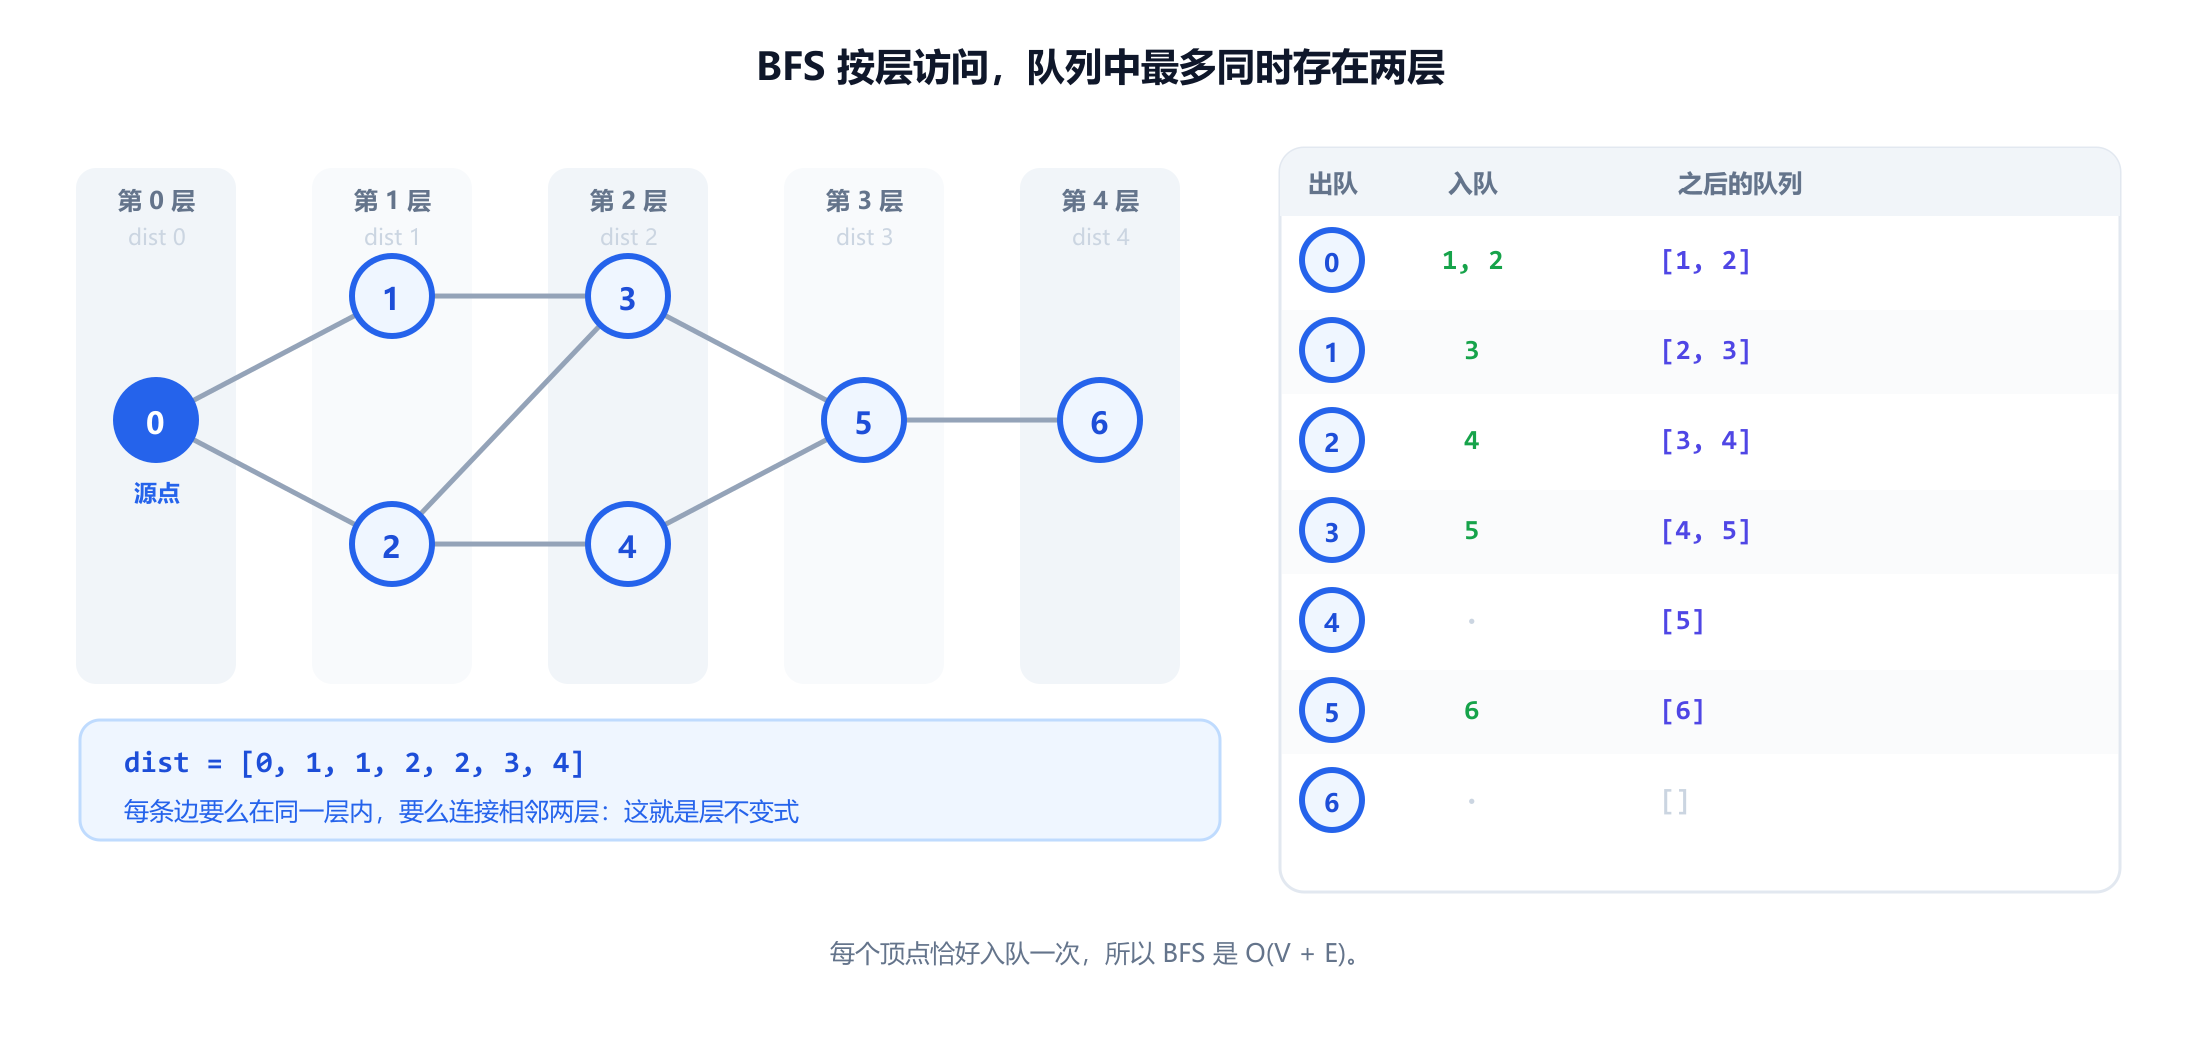
让这一切成立的性质是层不变式:每条边连接的顶点要么在同一层,要么在相邻两层,从不跨层。上图的八条边都满足这一点,这也是 BFS 第一次到达某个顶点时一定沿着最短路径的原因。要把它说出来:只说“BFS 能找到最短路径”而不给理由,听起来像是背的。
3. 无权图中的最短路径
题目。给定一个无权图和两个顶点,返回最短路径的长度以及路径本身。
这是基础题。相比模板,唯一增加的是父指针。
def shortest_path(adj, src, dst):
    dist, parent = {src: 0}, {src: None}
    q = deque([src])
    while q:
        u = q.popleft()
        if u == dst:                     # 提前退出:在出队时停止
            break
        for v in adj[u]:
            if v not in dist:
                dist[v] = dist[u] + 1
                parent[v] = u
                q.append(v)
    if dst not in dist:
        return None
    path, cur = [], dst
    while cur is not None:
        path.append(cur)
        cur = parent[cur]
    return dist[dst], path[::-1]
在图中的例子上,它返回距离 4 和路径 0 → 1 → 3 → 5 → 6。要主动说明这是一条最短路径,而不是唯一的一条: 0 → 2 → 3 → 5 → 6 同样短,你得到哪一条取决于邻接表的顺序。
追问:能提前退出吗?可以,微妙之处在于在哪里退出。在出队时检测目标总是正确的。在入队时检测对普通 BFS 也可行,还能省下一层,但一旦出现权重就不再正确,所以出队时检查才是值得养成的习惯。最坏情况仍然是 O(V + E)。
陷阱。当面试官说“现在边有权重了”,不要去修补 BFS。改用 Dijkstra 算法;如果权重只有 0 和 1,则改用第 8 节中的双端队列技巧。为了应对权重而让 BFS 重复访问顶点的候选人,其实是在无意中写一个又慢又有 bug 的 Bellman-Ford。
4. 岛屿数量
题目。给定一个由 '1' (陆地)和 '0' (水)组成的网格,统计相连的陆地块数。对角线不算相连。
这里没有显式的图,而这正是重点。顶点是陆地格子,边是共享的边界,所以一个格子最多有四个邻居,你根本不需要构建邻接结构。
def num_islands(grid):
    if not grid: return 0
    R, C = len(grid), len(grid[0])
    seen, count = set(), 0
    for i in range(R):
        for j in range(C):
            if grid[i][j] != '1' or (i, j) in seen:
                continue
            count += 1
            seen.add((i, j))
            q = deque([(i, j)])
            while q:
                r, c = q.popleft()
                for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
                    a, b = r + dr, c + dc
                    if 0 <= a < R and 0 <= b < C \
                       and grid[a][b] == '1' and (a, b) not in seen:
                        seen.add((a, b))
                        q.append((a, b))
    return count
每个格子最多入队一次,每次只做常数量的工作,所以时间复杂度是 O(R × C)。空间是已访问集合加上队列,在整个网格都是陆地的最坏情况下同样是 O(R × C)。
追问:BFS 还是 DFS?两者都可以,因为你是在标记连通分量,而不是测量距离。出于实际原因更推荐 BFS:在一个 106 个格子、全是陆地的网格上,递归 DFS 会递归一百万层,导致栈溢出。如果你选择 DFS,要说明你会用迭代方式来写;这句话往往就是这个追问的全部用意。两者的比较见 BFS 与 DFS。
陷阱。直接修改输入网格,也就是把 '0' 写到陆地上,而不是维护一个已访问集合,这是一种合理的优化,但要说出来。悄悄破坏调用方的数据,是代码审查中的失败,而不是聪明。
5. 腐烂的橘子:多源 BFS
题目。网格中有空格(0)、新鲜橘子(1)和腐烂橘子(2)。每分钟,每个腐烂的橘子都会让上下左右相邻的新鲜橘子腐烂。返回直到没有新鲜橘子为止所需的分钟数;如果这永远不会发生,返回 -1。
这道题能区分出背下 BFS 的人和真正理解 BFS 的人。直觉做法是从每个腐烂的橘子分别运行一次 BFS,再合并结果,既复杂又慢。正确答案是在循环开始前把所有腐烂的橘子都放进队列。这样 BFS 会扩展一个共同的波前,每个格子都会最先被离它最近的源点到达。
def oranges_rotting(grid):
    R, C = len(grid), len(grid[0])
    q, fresh = deque(), 0
    for i in range(R):
        for j in range(C):
            if grid[i][j] == 2: q.append((i, j, 0))
            elif grid[i][j] == 1: fresh += 1

    minutes = 0
    while q:
        r, c, t = q.popleft()
        minutes = max(minutes, t)
        for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
            a, b = r + dr, c + dc
            if 0 <= a < R and 0 <= b < C and grid[a][b] == 1:
                grid[a][b] = 2                  # 入队时标记
                fresh -= 1
                q.append((a, b, t + 1))
    return -1 if fresh else minutes
在这个网格上的演算:
2 1 1 0          每格腐烂的分钟:            0  1  2  .
1 1 0 2                                      1  2  .  0
0 1 1 1                                      .  3  2  1

两个源点,7 个新鲜橙子,剩余 0 个,答案 = 3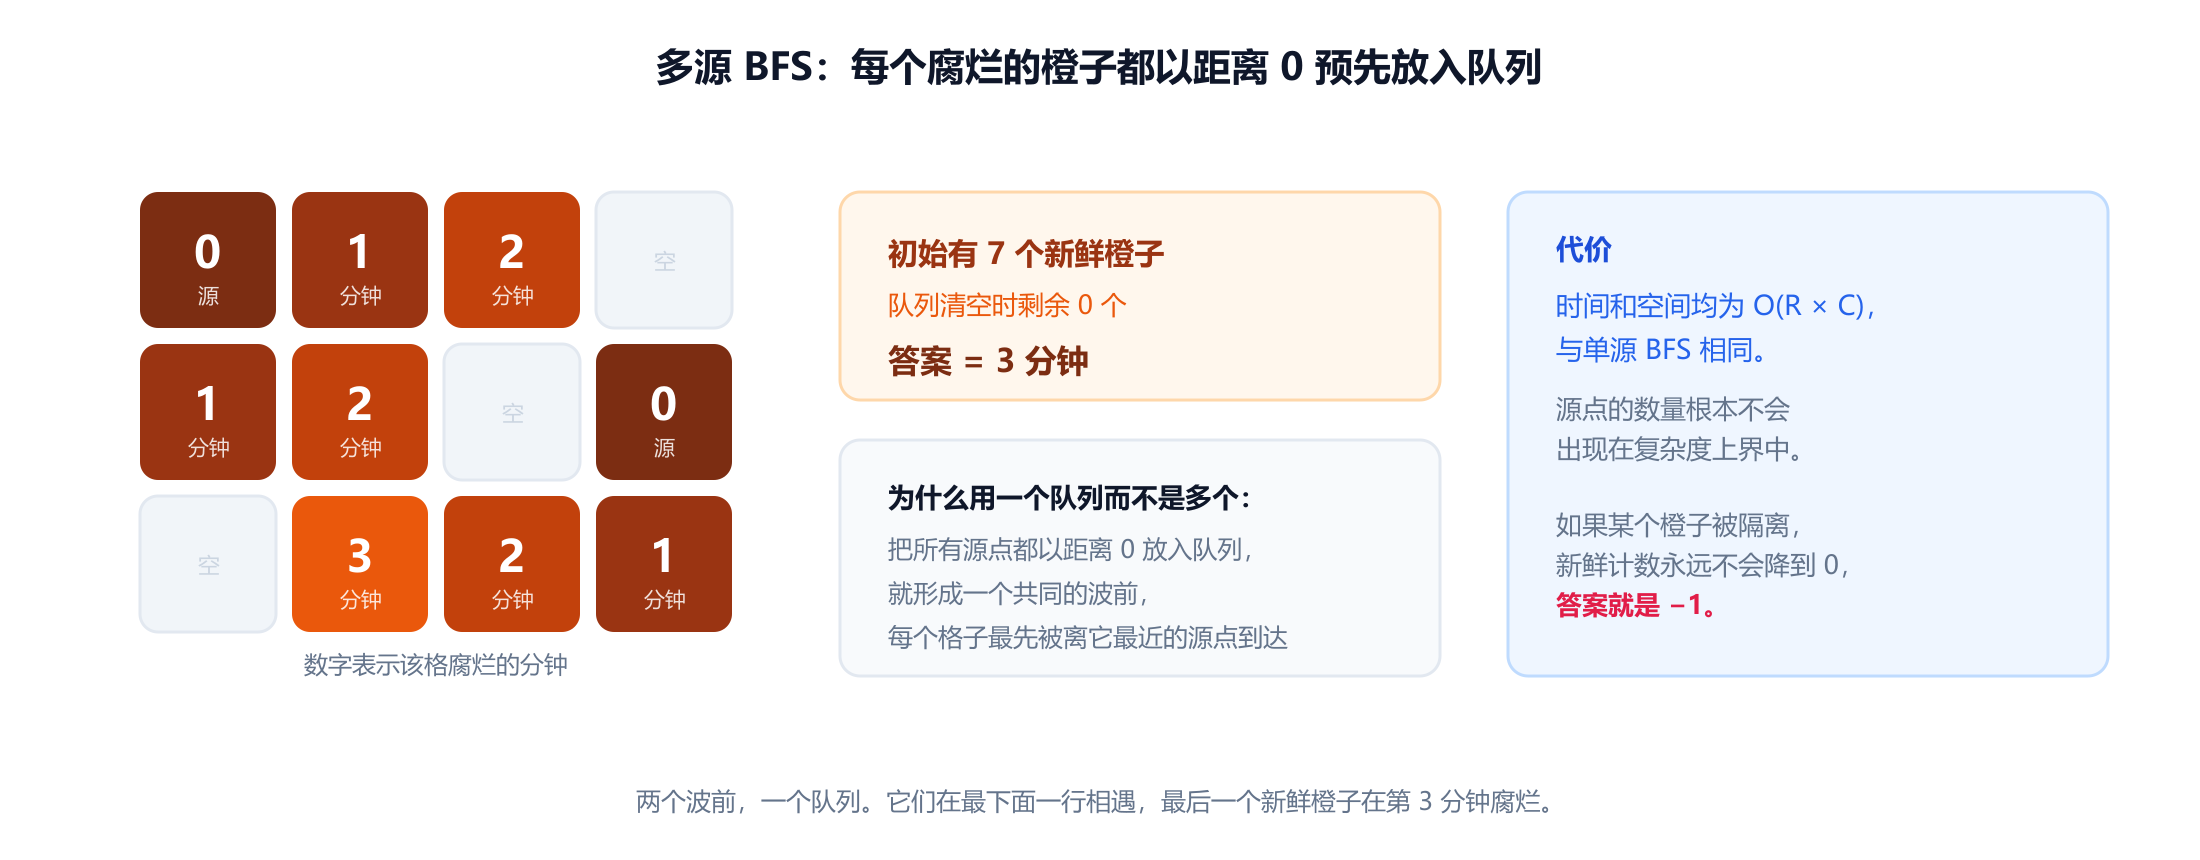
复杂度是 O(R × C),与源点数量无关。多源 BFS 与单源 BFS 代价相同,这正是题目要考察的洞见。
追问:如果某个橘子永远不会腐烂呢?这就是返回 -1 的情况,也是需要 fresh 计数器的原因。不要通过比较已访问格子数和网格大小来判断:空格不是橘子,算术会出错。先统计新鲜橘子的数量,每腐烂一个就减一,最后检查剩余数量。如果把左下角那个橘子旁边的两个格子清空,它就被隔离了,于是有一个始终保持新鲜,答案是 -1。
陷阱。空网格。零个新鲜橘子和零个腐烂橘子应该返回 0,而差一错误返回 1 是最常见的错误提交。
6. 单词接龙:隐式图与中间相遇
题目。给定一个起始单词、一个目标单词和一个字典,求最短转换链的长度,要求每一步恰好改变一个字母,并且每个中间单词都在字典中。
这个图中每个字典单词是一个顶点,只有一个位置不同的两个单词之间有一条边。显式构建它需要 O(N2 L) 的时间,这是大多数候选人首先写出的慢速解法。快速解法从不构建它:在 L 个位置中的每一个上尝试全部 26 个字母,按需生成邻居,并用哈希集合检查,正如下面的代码所做的那样。每个位置上有一次替换会生成单词本身,它会被已访问检查丢弃。对于十个字母的单词,每个顶点需要 260 次查找,与字典大小无关。
def ladder_length(begin, end, word_list):
    words = set(word_list)
    if end not in words: return 0
    q, dist = deque([begin]), {begin: 1}
    while q:
        w = q.popleft()
        if w == end: return dist[w]
        for i in range(len(w)):
            for ch in "abcdefghijklmnopqrstuvwxyz":
                nxt = w[:i] + ch + w[i+1:]
                if nxt in words and nxt not in dist:
                    dist[nxt] = dist[w] + 1
                    q.append(nxt)
return 0追问:让它更快。期望的答案是双向 BFS,由 Pohl 于 1971 年提出:同时从起点向前、从终点向后搜索,每次扩展较小的那个边界,在两者相遇时停止。深度为 d、分支因子为 b 的单向搜索大约触及 bd 个顶点;两次深度为 d/2 的搜索触及 2bd/2个。这是指数减半,而不是常数倍的差别。
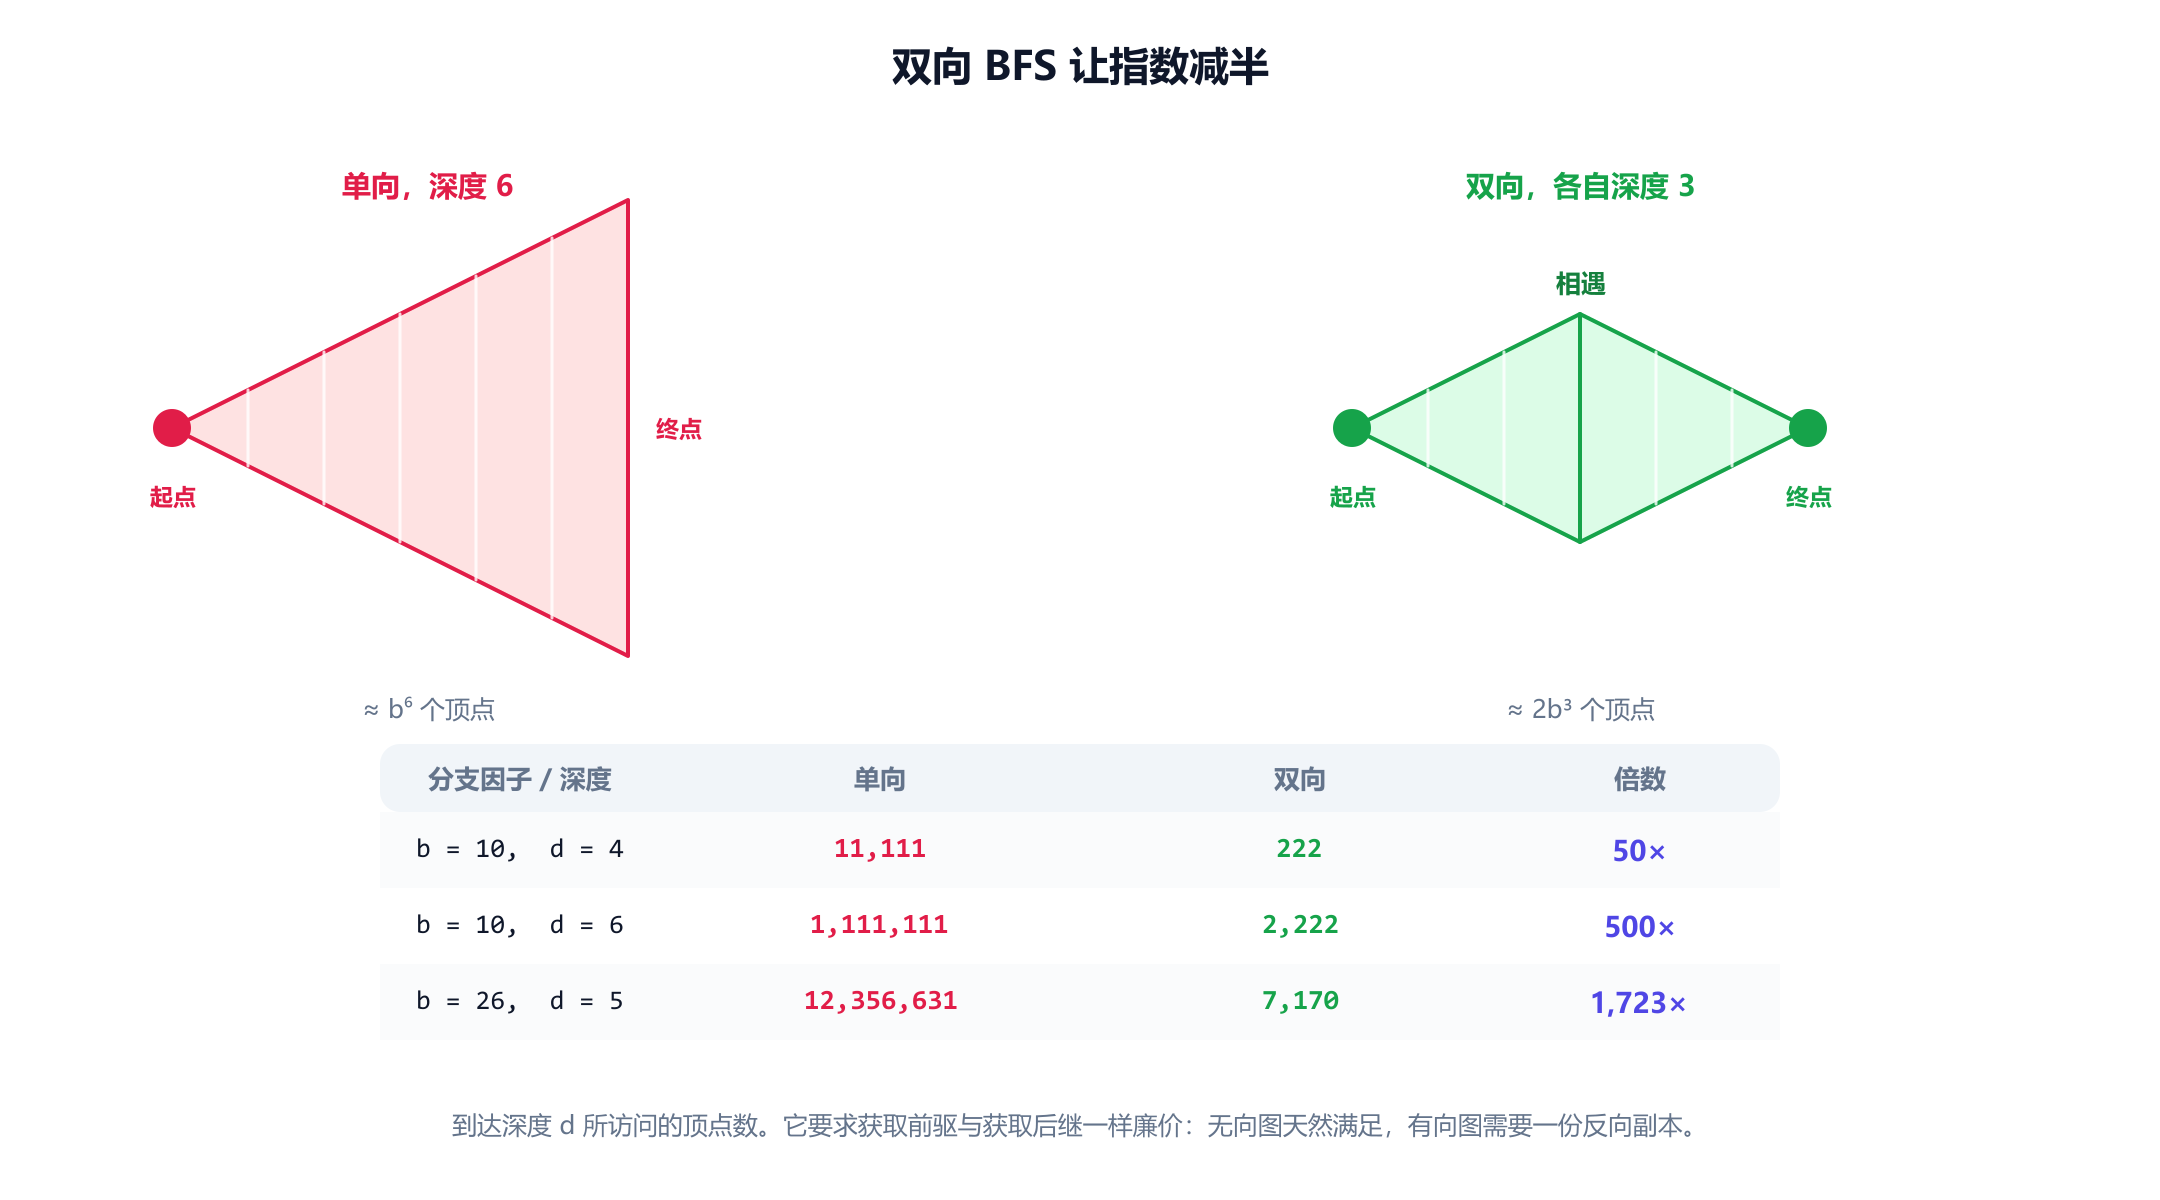
答案越深,收益越大。
陷阱。双向 BFS 要求获取前驱与获取后继一样廉价:这里是免费的,因为关系是对称的,但在有向图上需要一份反向副本。相遇点也需要小心。答案是两个深度之和,只有在每次扩展一整层时,一旦某个顶点同时出现在两个已访问集合中就立即停止才是正确的。
7. 二叉树的层序遍历
题目。返回二叉树的节点值,按深度分组,每层一个列表。
唯一的新想法是一次处理一整层,技巧在于在内层循环之前记下队列的长度。
def level_order(root):
    if not root: return []
    out, q = [], deque([root])
    while q:
        level = []
        for _ in range(len(q)):        # 先记下这一层的大小
            node = q.popleft()
            level.append(node.val)
            if node.left:  q.append(node.left)
            if node.right: q.append(node.right)
        out.append(level)
    return out
把 len(q) 放在 range 调用中捕获,正是这一点让它能正确工作:即使队列在循环中不断增长,循环也恰好执行该层节点数那么多次。在循环内部读取长度会悄悄把多层合并在一起,这就是这里的经典 bug。
树不需要已访问集合:没有环,每个节点只有一个父节点。要说明你省略它,是因为输入是一棵树,因为在图上悄悄省略它会导致死循环。
追问。之字形遍历是在奇数深度上反转 level,而不是倒着入队。右视图就是每一层的最后一个元素。最小深度就是第一个出队的叶子的深度,在这里 BFS 确实胜过 DFS,因为 DFS 必须遍历整棵树。
8. 0-1 BFS:BFS 胜过 Dijkstra 的场景
题目。每条边的权重为 0 或 1;求从某个源点出发的最短距离。变体包括某些移动免费的网格,或者“最少需要拆掉几堵墙”。
Dijkstra 可以在 O(E log V) 内解决,也会被接受。而面试官真正想要的答案运行时间是 O(V + E):使用双端队列,经过权重为 0 的边松弛的顶点压到队首,经过权重为 1 的边松弛的顶点压到队尾。这样,双端队列中同时最多只有两个不同的距离值,这恰好就是优先队列原本提供的顺序。
def zero_one_bfs(adj, src, n):        # adj[u] = [(v, w), ...] 其中 w 属于 {0, 1}
    dist = [float('inf')] * n
    dist[src] = 0
    dq = deque([src])
    while dq:
        u = dq.popleft()
        for v, w in adj[u]:
            if dist[u] + w < dist[v]:
                dist[v] = dist[u] + w
                if w == 0: dq.appendleft(v)
                else:      dq.append(v)
    return dist
在边为 0-1 (权重 1)、 0-2 (0)、 2-3 (1)、 1-3 (0)、 3-4 (1)和 2-4 (1)的图上,它返回 0, 1, 0, 1, 1,与 Dijkstra 完全一致。普通 BFS 返回 0, 1, 1, 2, 2,五个顶点中错了三个,因为它数的是边数,而不是把权重相加。这种对比是展示 BFS 实际优化目标的最清晰方式。
这项技术属于标号修正算法家族,Bertsekas 在 1993 年给出了其一般形式。它与普通 BFS 有一个重要的结构差异:一个顶点可能会被松弛不止一次,所以守卫条件是距离比较,而不是已访问检查。
陷阱。写成 if v not in visited 而不是 if dist[u] + w < dist[v]。已访问检查让最先到达者获胜,而经过权重为 0 的边时,最先到达的未必是最好的。代码照样能运行,并返回看似合理的数字。
9. 这个图是二分图吗?
题目。能否把顶点分成两个集合,使每条边都横跨这两个集合?面试中常见的说法是“把这些人分成两组,使任意两个敌人不在同一组”,或者“这个图能否 2-着色”。
把源点涂成 0,把每个邻居涂成相反的颜色,一旦遇到已经和自己同色的邻居就判定失败。
def is_bipartite(adj, n):
    colour = [-1] * n
    for s in range(n):
        if colour[s] != -1: continue      # 一个新的连通分量
        colour[s] = 0
        q = deque([s])
        while q:
            u = q.popleft()
            for v in adj[u]:
                if colour[v] == -1:
                    colour[v] = 1 - colour[u]
                    q.append(v)
                elif colour[v] == colour[u]:
                    return False
return True清晰的解释是:颜色就是 BFS 层号的奇偶性。冲突意味着有一条边连接了同一层的两个顶点,从而闭合了一个长度为奇数的环,而一个图是二分图当且仅当它没有奇环。4 元环是二分图,5 元环不是,算法对两者都能给出正确判断。
陷阱,它导致的错误提交比其他任何陷阱都多:外层的 for s in range(n) 循环。对于不连通的图,需要从每个未着色的顶点重新启动 BFS,所以只从顶点 0 开始的解法能通过所有连通的测试,一旦有两个连通分量就会失败。统计连通分量和检测环都需要同样的循环。
10. 课程表:用 BFS 做拓扑排序
题目。给定 n 门课程和一组先修关系对,能否修完所有课程?追问会要求给出一个合法的顺序。
这是有向图上的环检测,BFS 的解法是 Kahn 算法(1962):反复取出一个没有剩余先修课的顶点,将其删除,并把它的后继的入度减一。
def find_order(n, prerequisites):
    adj = [[] for _ in range(n)]
    indeg = [0] * n
    for course, prereq in prerequisites:
        adj[prereq].append(course)
        indeg[course] += 1

    q = deque(i for i in range(n) if indeg[i] == 0)
    order = []
    while q:
        u = q.popleft()
        order.append(u)
        for v in adj[u]:
            indeg[v] -= 1
            if indeg[v] == 0:
                q.append(v)
    return order if len(order) == n else []    # 变短 == 有环
有 6 门课程、先修关系为 1←0, 2←0, 3←1, 3←2, 4←3, 5←4 时,它把六门课全部排为 0, 1, 2, 3, 4, 5。对于有环的集合 1←0, 2←1, 0←2,它排出的课程一门也没有:每个顶点的初始入度都是 1,所以初始队列为空。一个检查同时覆盖两种情况,这正是答案的核心:如果输出的长度小于 n,剩下的顶点就构成了环。
陷阱。把边的方向弄反。先修对 [a, b] 表示“要修 a,必须先修 b”,所以边的方向是 b → a,增加的是 a的入度。如果弄反了,你会得到反向图的一个合法拓扑序:它看起来是对的,也能通过环检测,但它是错的。写循环之前,先把方向大声说出来。更完整的讨论见拓扑排序。
对应的深度优先版本,涵盖环检测、拓扑排序、强连通分量和桥,请见 DFS 面试题。
11. 面试官期望的复杂度回答
BFS 面试有一半是分析。该说什么,以及为什么:
| 问题类型 | 时间 | 空间 | 应给出的理由 |
|---|---|---|---|
| 图,邻接表 | O(V + E) | O(V) | 每个顶点入队一次,每条边被检查两次 |
| 图,邻接矩阵 | O(V2) | O(V) | 查找一个顶点的邻居需要扫描一整行 |
网格, R × C | O(R × C) | O(R × C) | V = RC 且 E < 2RC,所以 V + E 与格子数呈线性关系 |
| 多源网格 | O(R × C) | O(R × C) | 不变:源点只是为同一个波前播种 |
单词接龙: N 个单词,长度 L | O(N × L2 × 26) | O(N × L) | 26L 个候选,每个需要 O(L) 来构造并计算哈希 |
双向,分支因子 b,深度 d | O(bd/2) | O(bd/2) | 两次半深度搜索,所以指数减半 |
| 0-1 BFS | O(V + E) | O(V) | 用双端队列代替堆,所以没有 log 因子 |
有两点值得主动提出。空间复杂度 O(V) 并非偶然:BFS 会保存一整层,而在很宽的图上,这就是大部分顶点。这才是在又深又窄的图上更倾向于 DFS 的真正原因,也比“DFS 更省内存”这种并不总是成立的回答更好。另外,边的项在有向图中是 E,而在无向图中是 2E。Cormen、Leiserson、Rivest 和 Stein 给出了完整的分析;Sedgewick 和 Wayne 给出了最清晰的简短分析。
BFS 在有名字之前就被发表过两次:Moore 在 1959 年用它求迷宫中的最短路径,Lee 在 1961 年用它为电路板布线。Lee 的版本恰恰就是第 4 节和第 5 节中的网格 BFS,这也是网格寻路至今有时仍被称为 Lee 算法的原因。
一旦边带有不同的权重,队列就变成了优先队列;这类问题在 Dijkstra 面试题中有详细讲解。
12. 导致面试失败的错误
按出现频率而非严重程度排序。前三个错误占了大多数被拒的解答。
- 在出队时而不是入队时标记已访问。距离仍然正确,所以测试能通过,但队列会膨胀到
O(E),在稠密图上,这就是通过与超时之间的差别。 - 把列表当作队列使用。
list.pop(0)和 JavaScript 的shift()都是O(n)。请使用collections.deque;在没有它的语言中,就用一个指向数组的下标指针。 - 忘记遍历所有连通分量的外层循环。二分图判定、连通分量计数和环检测,都需要从每个未访问的顶点重新启动 BFS。只从顶点 0 开始,能通过所有连通的测试,却会在第一个不连通的测试上失败。
- 在带权图上使用 BFS。 BFS 最小化的是边的数量,而不是总权重。如果两条边的代价不同,就需要 Dijkstra;如果权重只有 0 和 1,则用 0-1 BFS。
- 在层循环内部读取队列长度。在层序遍历中,
for _ in range(len(q))必须在循环之前记下长度,否则各层会合并在一起。 - 不询问输入的情况。有向吗?连通吗?有自环或平行边吗?网格的对角线算邻居吗?起点可能等于终点吗?每个答案都会改变代码,Skiena 的观点在这里成立:问题是在建模中赢下来的,而不是在遍历中。
- 宣称
O(V + E)却不说明是哪种表示。这个界属于邻接表。在邻接矩阵上,同样的代码是O(V2)。
有一个习惯胜过以上所有建议。写代码之前,先大声说出顶点是什么、边是什么、每一步的代价是多少。如果每一步的代价相同,BFS 就是正确的;如果不同,你就避开了陷阱。McDowell 在一般意义上也提出了同样的观点,而在图问题上它最为关键,因为图往往是隐藏的。
13. 常见问题
如何判断一个问题需要 BFS 而不是 DFS?
+
留意“最少”这个词或它的同义词:最少步数、最短变换、最早的时刻、最近的出口。只要每一步的代价相同,BFS 就能精确回答这些问题。如果题目只问可达性或连通分量,两种遍历都可以,而 BFS 能避免在大输入上出现深层递归。
为什么必须在入队时就把顶点标记为已访问?
+
因为在入队和出队之间,同一边界上的其他顶点可能会再次发现它。在出队时标记,会让它每条入边都入队一次,于是队列中有 O(E) 个条目而不是 O(V) 个。距离仍然是正确的,这正是这个 bug 容易被忽略的原因。
什么是多源 BFS,什么时候需要它?
+
在循环开始之前,把所有源点都以距离零放入队列。BFS 会扩展一个共同的波前,所以每个格子都会最先被离它最近的源点到达。它的代价与单源 BFS 相同,都是 O(V + E)。腐烂的橘子和最近出口类问题是标准例子。
BFS 能处理带权的边吗?
+
只有当所有权重都是 0 或 1 时才可以。这时使用双端队列,经过权重为零的边就压到队首,经过权重为一的边就压到队尾,能在 O(V + E) 内给出正确答案,没有对数因子。对于其他任何权重,BFS 都是错的,因为它最小化的是边数而不是总权重,这时你需要 Dijkstra。
双向 BFS 能快多少?
+
它把指数减半,而不是除以一个常数:大约把 b 的 d 次方变成 2 乘以 b 的 d/2 次方。在分支因子为 10、深度为 6 时,就是 1,111,111 个顶点对比约 2,222 个,相差 500 倍。它要求获取前驱与获取后继一样廉价:无向图天然满足,有向图需要一份反向副本。
网格 BFS 应该给出什么复杂度?
+
时间和空间都是 O(R 乘以 C)。应给出的理由是:网格是一个有 R 乘以 C 个顶点、少于 2 R C 条边的图,所以 V 加 E 与格子数呈线性关系。空间是已访问集合加上队列,队列可能同时容纳网格中很大一部分格子。
在树上运行 BFS 需要已访问集合吗?
+
不需要。树没有环,每个节点只有一个父节点,所以没有节点会被到达两次,这个集合永远不会拒绝任何东西。要说明你为什么省略它,而不是悄悄省略:在一般图上同样的省略会造成死循环,而面试官无法分辨你指的是哪种情况。
14. 参考文献
提出这些技术的论文以及分析它们的教材,按时间顺序排列。
- Moore, E. F. (1959). “The shortest path through a maze.” Proceedings of an International Symposium on the Theory of Switching, Harvard University Press, 285–292.
- Lee, C. Y. (1961). “An algorithm for path connections and its applications.” IRE Transactions on Electronic Computers, EC-10(3), 346–365.
- Kahn, A. B. (1962). “Topological sorting of large networks.” Communications of the ACM, 5(11), 558–562.
- Pohl, I. (1971). “Bi-directional search.” In Machine Intelligence 6, Edinburgh University Press, 127–140.
- Bertsekas, D. P. (1993). “A simple and fast label correcting algorithm for shortest paths.” Networks, 23(8), 703–709.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. and Stein, C. (2009). Introduction to Algorithms,第 3 版,第 22.2 节。MIT Press。
- Sedgewick, R. and Wayne, K. (2011). Algorithms,第 4 版,第 4.1 节。Addison-Wesley。
- McDowell, G. L. (2015). Cracking the Coding Interview,第 6 版。CareerCup。
- Skiena, S. S. (2020). The Algorithm Design Manual,第 3 版,第 5 章。Springer。