
Table des Matières
- 1. Ce qu'une question sur le BFS évalue vraiment
- 2. Le modèle à écrire de mémoire
- 3. Plus court chemin dans un graphe non pondéré
- 4. Nombre d'îles
- 5. Oranges pourries : BFS multi-source
- 6. Word ladder : graphes implicites et rencontre au milieu
- 7. Parcours par niveaux d'un arbre binaire
- 8. BFS 0-1 : quand le BFS bat Dijkstra
- 9. Le graphe est-il biparti ?
- 10. Course schedule : tri topologique par BFS
- 11. Les réponses de complexité qu'attendent les recruteurs
- 12. Les erreurs qui font échouer l'entretien
- 13. Questions fréquentes
- 14. Références
1. Ce qu'une question sur le BFS évalue vraiment
Presque personne n'a à « implémenter un BFS ». On vous donne un problème qui ne ressemble pas à un graphe, et l'entretien pose trois questions : savez-vous voir le graphe, savez-vous que le BFS est le bon outil, et pouvez-vous l'écrire sans bogue ?
Le signal, c'est le mot moins ou l'un de ses synonymes : nombre minimal d'étapes, transformation la plus courte, première minute, sortie la plus proche. Le BFS répond à ces questions, et seulement quand chaque étape coûte la même chose. Toute la subtilité est là : quand les étapes coûtent autant, le BFS donne le minimum exact en O(V + E) ; sinon, il est tout simplement faux, et y recourir est justement l'erreur autour de laquelle la question a été construite.
Les huit ci-dessous sont celles qui reviennent. Chacune est présentée comme elle se déroule : le problème, la solution, la relance que pose ensuite le recruteur et l'erreur qui coûte l'offre. Chaque exemple détaillé a été exécuté par script.
2. Le modèle à écrire de mémoire
Un seul modèle couvre toutes les questions de cette page. Vous devez pouvoir l'écrire en deux minutes sans réfléchir, car le temps de l'entretien appartient à la modélisation, pas à la frappe.
from collections import deque

def bfs(start, neighbours):
    dist = {start: 0}
    q = deque([start])
    while q:
        u = q.popleft()
        for v in neighbours(u):
            if v not in dist:          # marquer à l'ENFILAGE, jamais au défilage
                dist[v] = dist[u] + 1
                q.append(v)
    return dist
Quatre détails séparent un passage propre d'un passage hésitant.
- Marquez comme visité à l'enfilage, pas au défilage. Marquer au défilage laisse un sommet être enfilé une fois par arête entrante de la frontière, et la file enfle jusqu'à
O(E). Les distances restent correctes : le code passe les tests et échoue à la revue. - Utilisez une vraie file.
deque.popleft()est enO(1);list.pop(0)est enO(n)et rend silencieusement quadratique un algorithme linéaire. - La table des distances sert aussi d'ensemble des visités. Deux structures là où une suffit, ce sont deux occasions d'oublier une mise à jour.
neighboursest une fonction, pas une structure de données. C'est ce qui permet aux mêmes huit lignes de résoudre sans modification une grille, un jeu de mots et un espace d'états. La plupart des graphes d'entretien ne sont jamais matérialisés, un point développé dans la représentation des graphes.
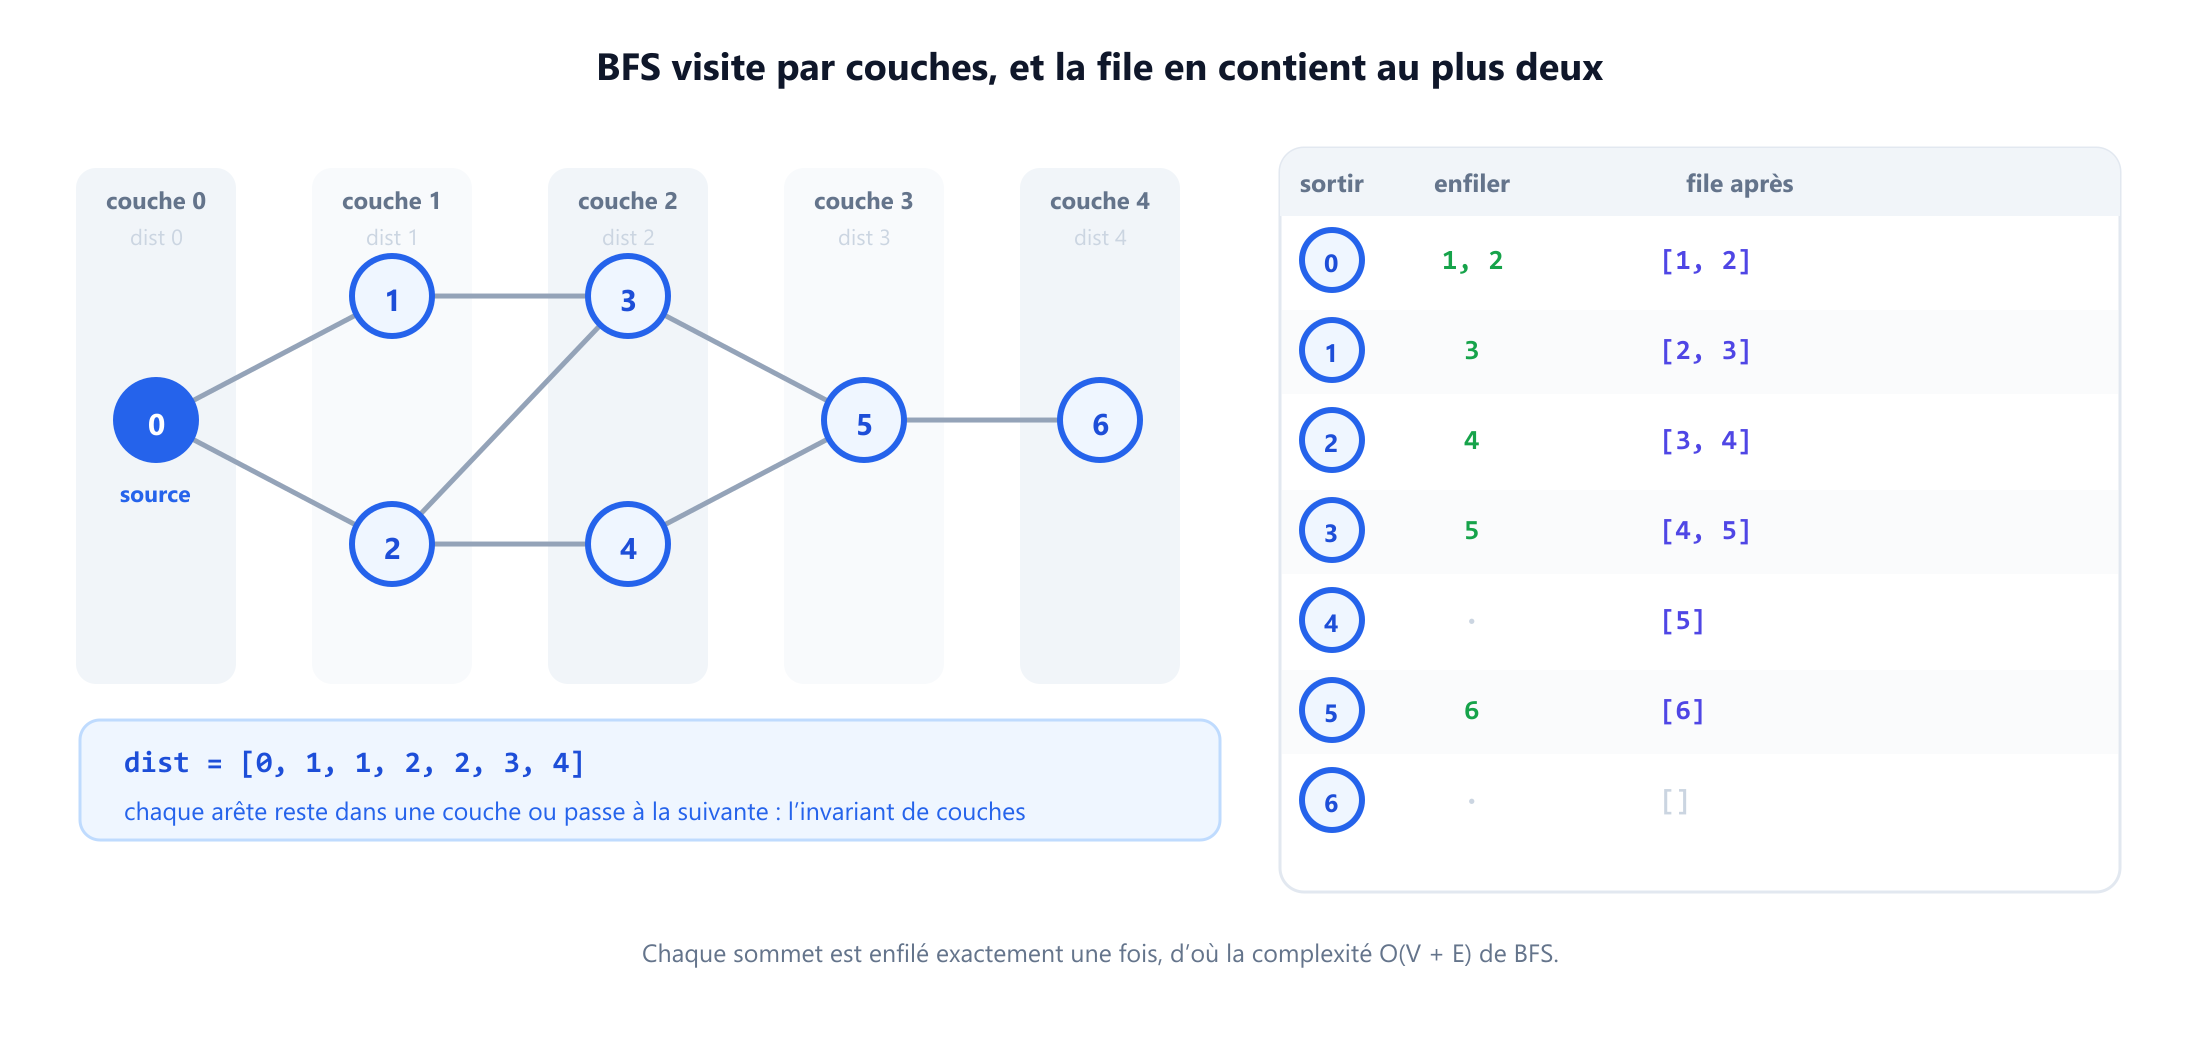
La propriété qui fait fonctionner tout cela est l'invariant de couches : chaque arête relie des sommets d'une même couche ou de couches consécutives, sans jamais en sauter une. Les huit arêtes ci-dessus le respectent, et c'est pourquoi la première fois que le BFS atteint un sommet, c'est par un plus court chemin. Dites-le à voix haute : « le BFS trouve le plus court chemin » sans justification sonne comme du par cœur.
3. Plus court chemin dans un graphe non pondéré
La question. Étant donné un graphe non pondéré et deux sommets, renvoyez la longueur du plus court chemin et le chemin lui-même.
Le cas de base. Le seul ajout au modèle est un pointeur vers le parent.
def shortest_path(adj, src, dst):
    dist, parent = {src: 0}, {src: None}
    q = deque([src])
    while q:
        u = q.popleft()
        if u == dst:                     # sortie anticipée : arrêter à la SORTIE
            break
        for v in adj[u]:
            if v not in dist:
                dist[v] = dist[u] + 1
                parent[v] = u
                q.append(v)
    if dst not in dist:
        return None
    path, cur = [], dst
    while cur is not None:
        path.append(cur)
        cur = parent[cur]
    return dist[dst], path[::-1]
Sur le graphe de la figure, cela renvoie la distance 4 et le chemin 0 → 1 → 3 → 5 → 6. Précisez spontanément qu'il s'agit d'un plus court chemin, et non du seul : 0 → 2 → 3 → 5 → 6 est tout aussi court, et celui que vous obtenez dépend de l'ordre des listes d'adjacence.
La relance : pouvez-vous vous arrêter plus tôt ? Oui, et la subtilité porte sur l'endroit. Tester la cible au moment où elle sort de la file est toujours correct. La tester au moment où elle entre fonctionne aussi pour le BFS simple et économise une couche, mais cesse d'être correct dès que des poids apparaissent : le test à la sortie est donc la bonne habitude. Le pire cas reste O(V + E).
Le piège. Quand le recruteur dit « maintenant les arêtes ont des poids », ne rafistolez pas le BFS. Passez à l'algorithme de Dijkstra, ou à l'astuce de la deque de la section 8 si les poids valent seulement 0 et 1. Les candidats qui font revisiter des sommets au BFS pour gérer les poids écrivent sans le vouloir un Bellman-Ford lent et bogué.
4. Nombre d'îles
La question. Étant donné une grille de '1' (terre) et de '0' (eau), comptez les groupes de terre connexes. Les diagonales ne relient pas.
Il n'y a pas de graphe explicite, et c'est tout l'enjeu. Les sommets sont les cases de terre, les arêtes sont les côtés communs : une case a donc au plus quatre voisins, et vous ne construisez jamais de structure d'adjacence.
def num_islands(grid):
    if not grid: return 0
    R, C = len(grid), len(grid[0])
    seen, count = set(), 0
    for i in range(R):
        for j in range(C):
            if grid[i][j] != '1' or (i, j) in seen:
                continue
            count += 1
            seen.add((i, j))
            q = deque([(i, j)])
            while q:
                r, c = q.popleft()
                for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
                    a, b = r + dr, c + dc
                    if 0 <= a < R and 0 <= b < C \
                       and grid[a][b] == '1' and (a, b) not in seen:
                        seen.add((a, b))
                        q.append((a, b))
    return count
Chaque case est enfilée au plus une fois et fait un travail constant : c'est donc O(R × C) en temps. L'espace est l'ensemble des visités plus la file, également O(R × C) dans le pire cas, quand la grille n'est que de la terre.
La relance : BFS ou DFS ? Les deux conviennent, puisque vous étiquetez des composantes au lieu de mesurer des distances. Préférez le BFS pour une raison pratique : un DFS récursif sur une grille de 106 cases de terre pleine s'enfonce d'un million de niveaux et fait déborder la pile. Si vous choisissez le DFS, dites que vous l'écririez de manière itérative ; cette phrase est souvent tout l'objet de la relance. La comparaison se trouve dans BFS vs DFS.
Le piège. Modifier la grille d'entrée, en écrivant '0' sur la terre au lieu de tenir un ensemble des visités, est une optimisation légitime, mais dites que vous le faites. Détruire silencieusement les données de l'appelant est un échec de revue de code, pas une astuce.
5. Oranges pourries : BFS multi-source
La question. Une grille contient des cases vides (0), des oranges fraîches (1) et des oranges pourries (2). Chaque minute, chaque orange pourrie contamine les oranges fraîches qui lui sont adjacentes horizontalement ou verticalement. Renvoyez le nombre de minutes jusqu'à ce qu'il n'y ait plus d'orange fraîche, ou -1 si cela n'arrive jamais.
Cette question sépare ceux qui ont appris le BFS par cœur de ceux qui le comprennent. Le réflexe est de lancer un BFS depuis chaque orange pourrie et de combiner les résultats, ce qui est compliqué et lent. La réponse consiste à placer toutes les oranges pourries dans la file avant le début de la boucle. Le BFS étend alors un seul front d'onde commun, et chaque case est atteinte d'abord par la source la plus proche.
def oranges_rotting(grid):
    R, C = len(grid), len(grid[0])
    q, fresh = deque(), 0
    for i in range(R):
        for j in range(C):
            if grid[i][j] == 2: q.append((i, j, 0))
            elif grid[i][j] == 1: fresh += 1

    minutes = 0
    while q:
        r, c, t = q.popleft()
        minutes = max(minutes, t)
        for dr, dc in ((1,0), (-1,0), (0,1), (0,-1)):
            a, b = r + dr, c + dc
            if 0 <= a < R and 0 <= b < C and grid[a][b] == 1:
                grid[a][b] = 2                  # marquer à l'enfilage
                fresh -= 1
                q.append((a, b, t + 1))
    return -1 if fresh else minutes
Déroulé sur cette grille :
2 1 1 0          minute de pourrissement :   0  1  2  .
1 1 0 2                                      1  2  .  0
0 1 1 1                                      .  3  2  1

deux sources, 7 oranges fraîches, 0 restante, réponse = 3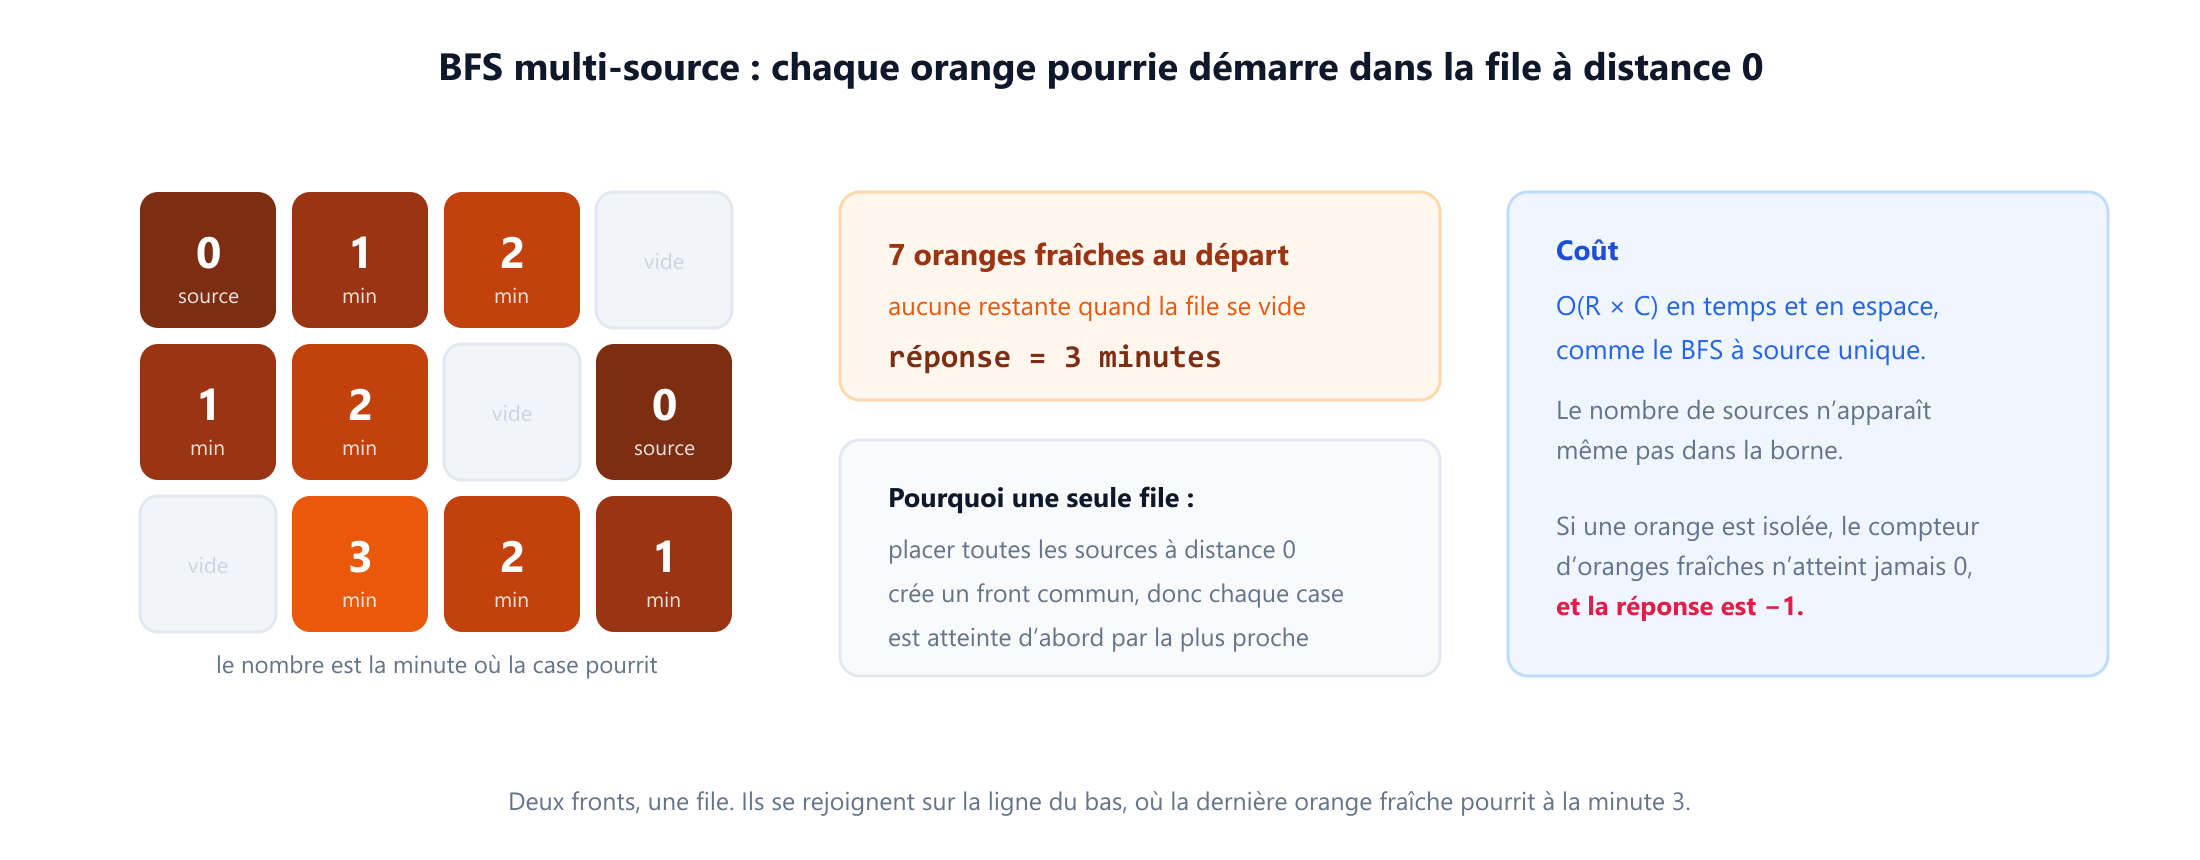
La complexité est O(R × C), quel que soit le nombre de sources. Que le BFS multi-source coûte autant que le BFS à source unique, c'est précisément ce qui est évalué.
La relance : et si une orange ne peut jamais pourrir ? C'est le cas -1, et la raison d'être du compteur fresh. Ne le détectez pas en comparant les cases visitées à la taille de la grille : les cases vides ne sont pas des oranges et le calcul tombe faux. Comptez les oranges fraîches au départ, décrémentez à chaque contamination et vérifiez ce qui reste. Videz les deux cases voisines de l'orange en bas à gauche : elle se retrouve isolée, une orange reste fraîche et la réponse est -1.
Le piège. La grille vide. Zéro orange fraîche et zéro pourrie doivent renvoyer 0, et une erreur d'une unité qui renvoie 1 est la soumission fausse la plus courante.
6. Word ladder : graphes implicites et rencontre au milieu
La question. Étant donné un mot de départ, un mot d'arrivée et un dictionnaire, trouvez la longueur de la plus courte chaîne où chaque étape change exactement une lettre et où chaque mot intermédiaire figure dans le dictionnaire.
Le graphe a un sommet par mot du dictionnaire et une arête entre les mots qui diffèrent en une position. Le construire explicitement coûte O(N2 L) en temps, et c'est la solution lente que la plupart des candidats écrivent d'abord. La solution rapide ne le construit jamais : elle génère les voisins à la demande en essayant les 26 lettres à chacune des L positions et en testant contre un ensemble haché, exactement comme le code ci-dessous. Une substitution par position régénère le mot lui-même, et le test des visités l'élimine. Pour des mots de dix lettres, cela fait 260 recherches par sommet, quelle que soit la taille du dictionnaire.
def ladder_length(begin, end, word_list):
    words = set(word_list)
    if end not in words: return 0
    q, dist = deque([begin]), {begin: 1}
    while q:
        w = q.popleft()
        if w == end: return dist[w]
        for i in range(len(w)):
            for ch in "abcdefghijklmnopqrstuvwxyz":
                nxt = w[:i] + ch + w[i+1:]
                if nxt in words and nxt not in dist:
                    dist[nxt] = dist[w] + 1
                    q.append(nxt)
    return 0
La relance : allez plus vite. La réponse attendue est le BFS bidirectionnel, introduit par Pohl en 1971 : chercher simultanément vers l'avant depuis le départ et vers l'arrière depuis l'arrivée, en développant toujours la plus petite frontière, et s'arrêter quand elles se rencontrent. Une recherche unidirectionnelle jusqu'à la profondeur d avec un facteur de branchement b touche environ bd sommets ; deux recherches de profondeur d/2 en touchent 2bd/2. L'exposant est divisé par deux, ce n'est pas un simple facteur constant.
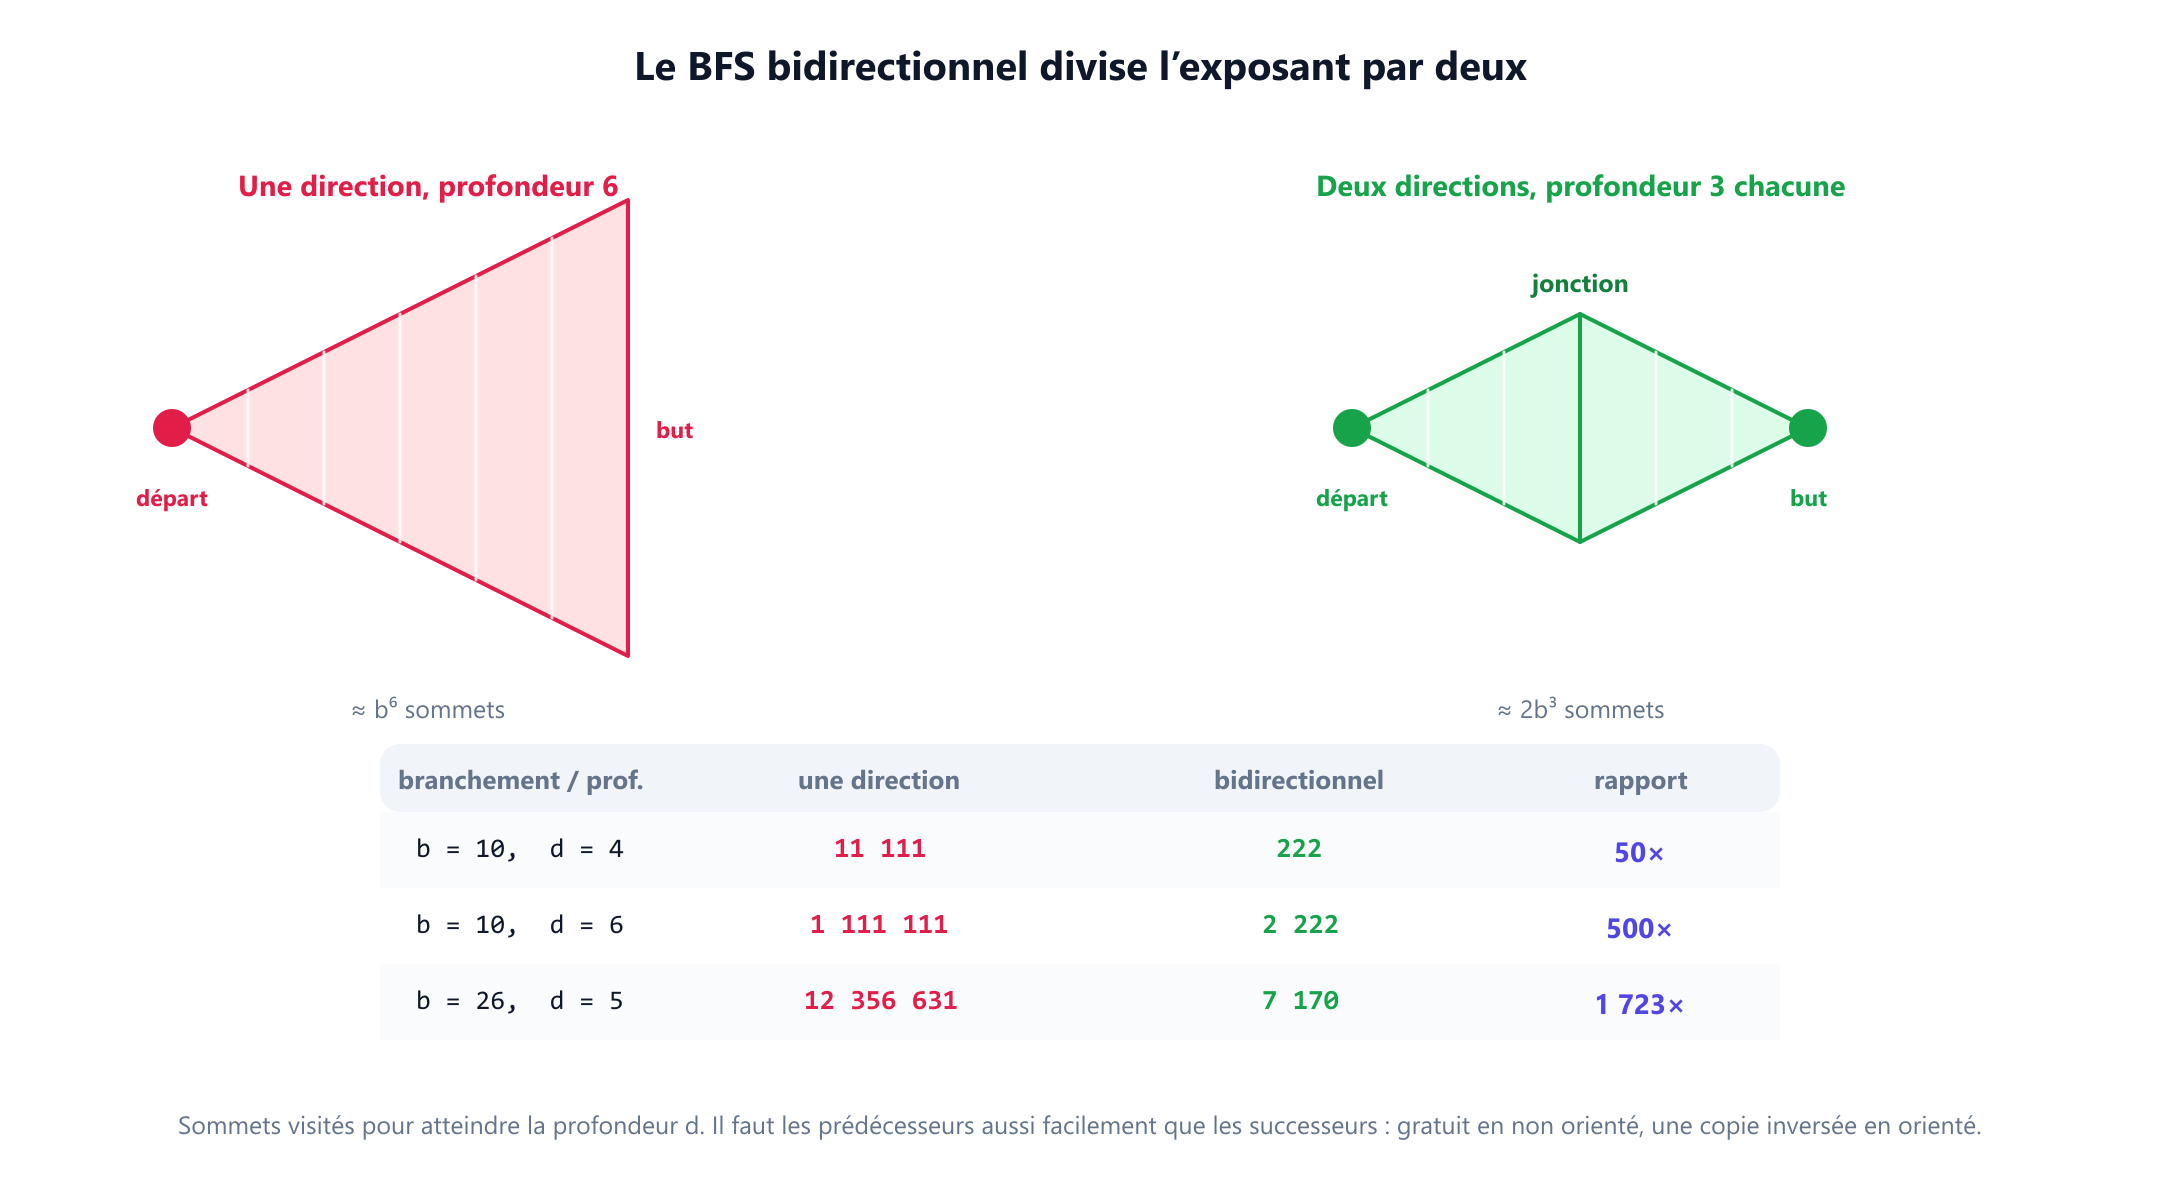
Plus la réponse est profonde, plus le gain est grand.
Le piège. Le BFS bidirectionnel exige d'obtenir les prédécesseurs aussi facilement que les successeurs : gratuit ici puisque la relation est symétrique, mais au prix d'une copie inversée sur un graphe orienté. Le point de rencontre demande aussi du soin. La réponse est la somme des deux profondeurs, et s'arrêter dès qu'un sommet apparaît dans les deux ensembles de visités n'est valide que si vous développez une couche entière à la fois.
7. Parcours par niveaux d'un arbre binaire
La question. Renvoyez les valeurs d'un arbre binaire regroupées par profondeur, une liste par niveau.
La seule idée nouvelle consiste à traiter une couche entière à la fois, et l'astuce est d'enregistrer la longueur de la file avant la boucle intérieure.
def level_order(root):
    if not root: return []
    out, q = [], deque([root])
    while q:
        level = []
        for _ in range(len(q)):        # figer D'ABORD la taille de la couche
            node = q.popleft()
            level.append(node.val)
            if node.left:  q.append(node.left)
            if node.right: q.append(node.right)
        out.append(level)
    return out
C'est la capture de len(q) dans l'appel à range qui fait tout fonctionner : la boucle s'exécute exactement autant de fois qu'il y avait de nœuds au niveau, même si la file grandit pendant ce temps. Lire la longueur à l'intérieur de la boucle fusionne silencieusement les niveaux, et c'est le bogue classique ici.
Un arbre n'a pas besoin d'ensemble des visités : pas de cycle, un seul parent par nœud. Dites que vous l'omettez parce que l'entrée est un arbre, car l'omettre silencieusement sur un graphe provoque une boucle infinie.
Les relances. L'ordre en zigzag inverse level aux profondeurs impaires, au lieu d'enfiler à rebours. La vue de droite est le dernier élément de chaque niveau. La profondeur minimale est la profondeur de la première feuille sortie, et là, le BFS bat vraiment le DFS, qui doit explorer tout l'arbre.
8. BFS 0-1 : quand le BFS bat Dijkstra
La question. Chaque arête a un poids 0 ou 1 ; trouvez la plus courte distance depuis une source. Les variantes prennent la forme d'une grille où certains déplacements sont gratuits, ou du « nombre minimal de murs à abattre ».
Dijkstra résout cela en O(E log V) et c'est accepté. La réponse recherchée s'exécute en O(V + E) : utilisez une file à double entrée, en plaçant un sommet relâché à l'avant s'il arrive par une arête de poids 0 et à l'arrière s'il arrive par une arête de poids 1. La deque contient alors au plus deux valeurs de distance distinctes à la fois, ce qui est exactement l'ordre que fournissait la file de priorité.
def zero_one_bfs(adj, src, n):        # adj[u] = [(v, w), ...] avec w dans {0, 1}
    dist = [float('inf')] * n
    dist[src] = 0
    dq = deque([src])
    while dq:
        u = dq.popleft()
        for v, w in adj[u]:
            if dist[u] + w < dist[v]:
                dist[v] = dist[u] + w
                if w == 0: dq.appendleft(v)
                else:      dq.append(v)
    return dist
Sur un graphe avec les arêtes 0-1 (poids 1), 0-2 (0), 2-3 (1), 1-3 (0), 3-4 (1) et 2-4 (1), cela renvoie 0, 1, 0, 1, 1, exactement comme Dijkstra. Le BFS simple renvoie 0, 1, 1, 2, 2, faux pour trois des cinq sommets, car il compte les arêtes au lieu d'additionner les poids. Ce contraste est la façon la plus claire de montrer ce que le BFS optimise vraiment.
La technique appartient à la famille des algorithmes à correction d'étiquettes, dont Bertsekas a formulé la forme générale en 1993. Une différence structurelle avec le BFS ordinaire compte : un sommet peut être relâché plus d'une fois, donc la garde est une comparaison de distances, pas un test de visite.
Le piège. Écrire if v not in visited au lieu de if dist[u] + w < dist[v]. Le test de visite laisse gagner la première arrivée, et à travers une arête de poids 0, la première arrivée n'est pas forcément la meilleure. Le code s'exécute quand même et renvoie des nombres plausibles.
9. Le graphe est-il biparti ?
La question. Peut-on répartir les sommets en deux ensembles de sorte que chaque arête passe de l'un à l'autre ? En entretien, la question est formulée comme « répartissez ces personnes pour que deux ennemis ne soient jamais dans le même groupe » ou « ce graphe est-il 2-coloriable ? ».
Coloriez la source en 0, chaque voisin de la couleur opposée, et échouez si vous rencontrez un voisin qui porte déjà votre propre couleur.
def is_bipartite(adj, n):
    colour = [-1] * n
    for s in range(n):
        if colour[s] != -1: continue      # une nouvelle composante
        colour[s] = 0
        q = deque([s])
        while q:
            u = q.popleft()
            for v in adj[u]:
                if colour[v] == -1:
                    colour[v] = 1 - colour[u]
                    q.append(v)
                elif colour[v] == colour[u]:
                    return False
    return True
L'explication propre : la couleur est la parité de la couche du BFS. Un conflit signifie qu'une arête relie deux sommets de la même couche, fermant un cycle de longueur impaire, et un graphe est biparti exactement quand il n'a pas de cycle impair. Le cycle à 4 sommets est biparti, celui à 5 ne l'est pas, et l'algorithme confirme les deux.
Le piège, qui fait échouer plus de soumissions que tout autre : la boucle extérieure for s in range(n). Un graphe non connexe exige de relancer le BFS depuis chaque sommet non colorié ; une solution qui ne part que du sommet 0 passe donc tous les tests connexes et échoue dès qu'il y a deux composantes. Compter les composantes et détecter les cycles exigent la même boucle.
10. Course schedule : tri topologique par BFS
La question. Étant donné n cours et une liste de paires de prérequis, peut-on suivre tous les cours ? La relance demande un ordre valide.
C'est de la détection de cycles dans un graphe orienté, et la réponse par BFS est l'algorithme de Kahn (1962) : prendre à répétition un sommet sans prérequis restant, le retirer et décrémenter le degré entrant de ses successeurs.
def find_order(n, prerequisites):
    adj = [[] for _ in range(n)]
    indeg = [0] * n
    for course, prereq in prerequisites:
        adj[prereq].append(course)
        indeg[course] += 1

    q = deque(i for i in range(n) if indeg[i] == 0)
    order = []
    while q:
        u = q.popleft()
        order.append(u)
        for v in adj[u]:
            indeg[v] -= 1
            if indeg[v] == 0:
                q.append(v)
    return order if len(order) == n else []    # trop courte == cycle
Avec 6 cours et les prérequis 1←0, 2←0, 3←1, 3←2, 4←3, 5←4, cela planifie les six dans l'ordre 0, 1, 2, 3, 4, 5. Avec l'ensemble cyclique 1←0, 2←1, 0←2, cela n'en planifie aucun : chaque sommet commence avec un degré entrant de 1, donc la file initiale est vide. Un seul test couvre les deux cas, et c'est le cœur de la réponse : si la sortie est plus courte que n, les sommets restants forment un cycle.
Le piège. Inverser le sens des arêtes. La paire [a, b] signifie « pour suivre a, suivez d'abord b », donc l'arête est b → a et c'est le degré entrant de a qui augmente. Inversez-la et vous obtenez un ordre topologique valide du graphe inversé : il a l'air juste, passe le test de cycle et il est faux. Énoncez le sens à voix haute avant d'écrire la boucle. Traitement plus complet dans le tri topologique.
Le pendant en profondeur, qui couvre la détection de cycles, le tri topologique, les composantes fortement connexes et les ponts, se trouve dans les questions d'entretien sur le DFS.
11. Les réponses de complexité qu'attendent les recruteurs
La moitié d'un entretien sur le BFS, c'est de l'analyse. Quoi dire, et pourquoi :
| Type de problème | Temps | Espace | La justification à donner |
|---|---|---|---|
| Graphe, liste d'adjacence | O(V + E) | O(V) | Chaque sommet est enfilé une fois, chaque arête examinée deux fois |
| Graphe, matrice d'adjacence | O(V2) | O(V) | Trouver les voisins d'un sommet parcourt une ligne entière |
Grille R × C | O(R × C) | O(R × C) | V = RC et E < 2RC, donc V + E est linéaire en nombre de cases |
| Grille multi-source | O(R × C) | O(R × C) | Inchangé : les sources ne font qu'amorcer le même front unique |
Word ladder, N mots de longueur L | O(N × L2 × 26) | O(N × L) | 26L candidats par mot, chacun en O(L) pour le construire et le hacher |
Bidirectionnel, branchement b, profondeur d | O(bd/2) | O(bd/2) | Deux recherches à mi-profondeur, donc l'exposant est divisé par deux |
| 0-1 BFS | O(V + E) | O(V) | Une deque remplace le tas, donc pas de facteur log. |
Deux points méritent d'être avancés spontanément. L'espace en O(V) n'est pas un détail : le BFS garde une couche entière, qui sur un graphe large représente l'essentiel des sommets. C'est la vraie raison de préférer le DFS sur des graphes profonds et étroits, et une meilleure réponse que « le DFS consomme moins de mémoire », ce qui n'est pas toujours vrai. Et le terme des arêtes vaut E en orienté mais 2E en non orienté. Cormen, Leiserson, Rivest et Stein donnent l'analyse complète ; Sedgewick et Wayne, la plus claire en peu de mots.
Le BFS a été publié deux fois avant d'avoir un nom : par Moore en 1959 pour le plus court chemin dans un labyrinthe, et par Lee en 1961 pour le routage des circuits imprimés. La version de Lee est littéralement le BFS sur grille des sections 4 et 5, c'est pourquoi la recherche de chemin sur grille s'appelle encore parfois l'algorithme de Lee.
Dès que les arêtes portent des poids différents, la file devient une file de priorité ; ces problèmes sont traités dans les questions d'entretien sur Dijkstra.
12. Les erreurs qui font échouer l'entretien
Classées par fréquence, pas par gravité. Les trois premières expliquent la plupart des solutions rejetées.
- Marquer comme visité au défilage plutôt qu'à l'enfilage. Les distances restent correctes, donc les tests passent, mais la file enfle jusqu'à
O(E), ce qui, sur un graphe dense, fait la différence entre réussir et dépasser le temps imparti. - Utiliser une liste comme file.
list.pop(0)et leshift()de JavaScript sont enO(n). Utilisezcollections.deque, ou un indice qui avance dans un tableau dans un langage qui n'en a pas. - Oublier la boucle extérieure sur les composantes. Le test de bipartition, le comptage des composantes et la détection de cycles relancent tous le BFS depuis chaque sommet non visité. Ne partir que du sommet 0 passe tous les tests connexes et échoue au premier test non connexe.
- Recourir au BFS sur un graphe pondéré. Le BFS minimise le nombre d'arêtes, pas le poids total. Si deux arêtes ont des coûts différents, il vous faut Dijkstra, ou le BFS 0-1 quand les poids valent seulement 0 et 1.
- Lire la longueur de la file à l'intérieur de la boucle de couche. Dans le parcours par niveaux,
for _ in range(len(q))doit figer la longueur avant la boucle, sinon les niveaux fusionnent. - Ne pas poser de questions sur l'entrée. Orienté ? Connexe ? Boucles ou arêtes multiples ? Les diagonales de la grille sont-elles voisines ? Le départ peut-il être égal à l'arrivée ? Chaque réponse change le code, et la remarque de Skiena tient : les problèmes se gagnent dans la modélisation, pas dans le parcours.
- Annoncer
O(V + E)sans préciser la représentation. La borne vaut pour la liste d'adjacence. Sur une matrice, le même code est enO(V2).
Une habitude vaut mieux que tout ce qui précède. Avant d'écrire du code, dites à voix haute ce que sont les sommets, ce que sont les arêtes et ce que coûte une étape. Si chaque étape coûte autant, le BFS est correct ; sinon, vous avez évité le piège. McDowell fait la même remarque en général, et c'est sur les graphes qu'elle mord le plus, car le graphe y est si souvent caché.
13. Questions fréquentes
Comment savoir si un problème demande un BFS plutôt qu'un DFS ?
+
Cherchez le mot « moins » ou un synonyme : nombre minimal d'étapes, transformation la plus courte, première minute, sortie la plus proche. Le BFS y répond exactement, à condition que chaque étape coûte la même chose. Si la question ne porte que sur l'accessibilité ou les composantes connexes, les deux parcours conviennent, et le BFS évite une récursion profonde sur les grandes entrées.
Pourquoi dois-je marquer un sommet comme visité quand je l'enfile ?
+
Parce qu'entre son enfilage et son défilage, un sommet peut être redécouvert par d'autres sommets de la même frontière. Le marquer au défilage lui permet d'être enfilé une fois par arête entrante, si bien que la file contient O(E) entrées au lieu de O(V). Les distances restent justes, et c'est ce qui rend ce bogue facile à manquer.
Qu'est-ce que le BFS multi-source et quand en ai-je besoin ?
+
Vous placez toutes les sources dans la file avant le début de la boucle, toutes à distance zéro. Le BFS étend un seul front d'onde commun, de sorte que chaque case est atteinte d'abord par la source la plus proche. Il coûte autant que le BFS à source unique, O(V + E). Les oranges pourries et les problèmes de sortie la plus proche en sont les exemples classiques.
Le BFS peut-il gérer des arêtes pondérées ?
+
Seulement quand tous les poids valent 0 ou 1. Une file à double entrée, qui insère à l'avant par une arête de poids zéro et à l'arrière par une arête de poids un, donne alors la bonne réponse en O(V + E), sans facteur logarithmique. Pour tout autre poids, le BFS est tout simplement faux, car il minimise le nombre d'arêtes et non le poids total, et il vous faut Dijkstra.
Le BFS bidirectionnel est-il beaucoup plus rapide ?
+
Il divise l'exposant par deux au lieu de diviser par une constante : environ b puissance d devient 2 fois b puissance d sur 2. Avec un facteur de branchement de 10 et une profondeur de 6, cela fait 1 111 111 sommets contre environ 2 222, un facteur de 500. Il exige que les prédécesseurs soient aussi faciles à obtenir que les successeurs : gratuit en non orienté, une copie inversée en orienté.
Quelle complexité annoncer pour un BFS sur grille ?
+
O(R fois C) en temps comme en espace. La justification : la grille est un graphe à R fois C sommets et moins de 2 R C arêtes, donc V plus E est linéaire en nombre de cases. L'espace est l'ensemble des visités plus la file, qui peut contenir une grande partie de la grille à la fois.
Ai-je besoin d'un ensemble des visités pour un BFS sur un arbre ?
+
Non. Un arbre n'a pas de cycle et chaque nœud a un seul parent, donc aucun nœud n'est atteint deux fois et l'ensemble ne rejetterait jamais rien. Dites pourquoi vous l'omettez au lieu de l'omettre en silence : la même omission sur un graphe général est une boucle infinie, et le recruteur ne peut pas savoir ce que vous vouliez dire.
14. Références
Les articles qui ont introduit ces techniques et les ouvrages qui les analysent, par ordre chronologique.
- Moore, E. F. (1959). “The shortest path through a maze.” Proceedings of an International Symposium on the Theory of Switching, Harvard University Press, 285–292.
- Lee, C. Y. (1961). “An algorithm for path connections and its applications.” IRE Transactions on Electronic Computers, EC-10(3), 346–365.
- Kahn, A. B. (1962). “Topological sorting of large networks.” Communications of the ACM, 5(11), 558–562.
- Pohl, I. (1971). “Bi-directional search.” In Machine Intelligence 6, Edinburgh University Press, 127–140.
- Bertsekas, D. P. (1993). “A simple and fast label correcting algorithm for shortest paths.” Networks, 23(8), 703–709.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. et Stein, C. (2009). Introduction to Algorithms, 3e édition, section 22.2. MIT Press.
- Sedgewick, R. et Wayne, K. (2011). Algorithms, 4e édition, section 4.1. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6e édition. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3e édition, chapitre 5. Springer.