
Table des Matières
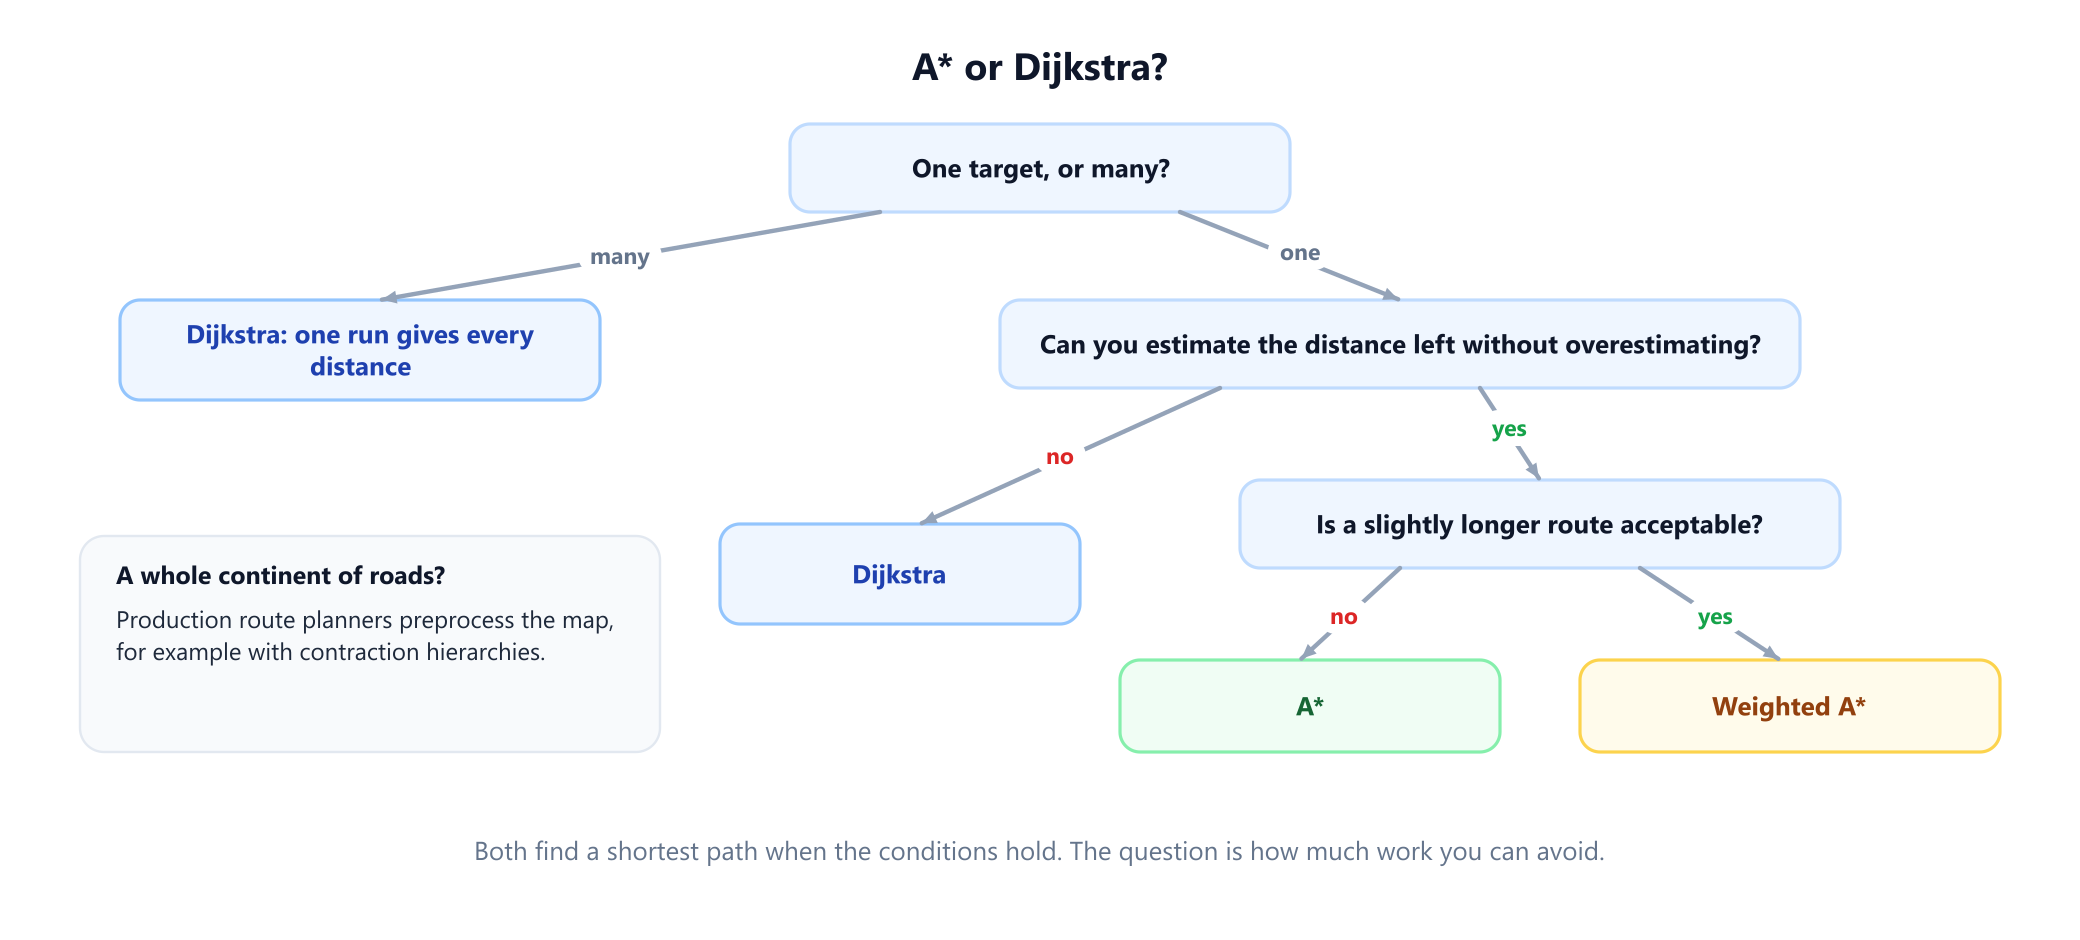
- 1. La réponse courte
- 2. Une seule ligne de différence
- 3. Une carte, deux recherches
- 4. Pourquoi A* trouve quand même le plus court chemin
- 5. L'heuristique est un bouton de réglage
- 6. Ce qu'A* économise sur des cartes typiques
- 7. Le coût caché des égalités
- 8. Quand Dijkstra est le meilleur choix
- 9. Les heuristiques qui brisent la garantie
- 10. Où sert chacun d'eux
- 11. Un bref historique
- 12. Erreurs fréquentes
- 13. Glossaire
- 14. Questions fréquentes
- 15. Références
1. La réponse courte
L'algorithme de Dijkstra et A* trouvent tous deux un plus court chemin dans un graphe pondéré dont les poids d'arêtes sont positifs ou nuls. La différence tient à ce qu'ils savent. Dijkstra cherche vers l'extérieur dans toutes les directions, car il n'a aucune idée de l'endroit où se trouve la cible. A* ajoute une estimation de la distance restante, et concentre donc ses efforts dans la direction qui semble prometteuse.
| Dijkstra | A* | |
|---|---|---|
| Répond à | Une source vers tous les sommets, ou vers une cible | Une source vers une cible |
| Priorité d'un sommet | g : distance depuis la source | f = g + h : distance parcourue plus distance restante estimée |
| Prérequis | Poids d'arêtes positifs ou nuls | Poids d'arêtes positifs ou nuls et une heuristique h |
| Plus court chemin garanti | Oui | Oui, si h ne surestime jamais |
| Sommets explorés | Tout ce qui est plus proche que la cible | Généralement bien moins ; leur nombre dépend de h |
| Pire cas sur un graphe explicite | O((V + E) log V) | Le même, avec une heuristique cohérente h calculée en temps constant |
| À utiliser quand | Vous avez besoin de nombreuses cibles ou n'avez aucune estimation utile | Vous voulez un seul itinéraire et pouvez estimer la distance |
En une phrase : utilisez A* pour un seul itinéraire sur une carte, où les coordonnées fournissent une bonne estimation, et utilisez Dijkstra lorsqu'il vous faut les distances vers de nombreux endroits ou lorsque rien n'indique de quel côté se trouve la cible. Les deux sont moins des rivaux que le même algorithme avec des informations différentes, comme le montre la section suivante. Pour comparer Dijkstra aux méthodes qui gèrent les poids négatifs, voir Dijkstra vs Bellman-Ford vs Floyd-Warshall.
2. Une seule ligne de différence
Les deux algorithmes gèrent une file de priorité de sommets et développent à chaque étape celui dont la priorité est la plus basse. Notons g(v) le coût du meilleur itinéraire trouvé jusqu'ici entre le départ et v, et h(v) une estimation du coût de v jusqu'à l'objectif, appelée heuristique.
Dijkstra :  priorité(v) = g(v)
A* :        priorité(v) = g(v) + h(v)
C'est toute la différence. Posez h(v) = 0 pour chaque sommet et A* devient l'algorithme de Dijkstra. Ainsi, tout énoncé sur Dijkstra est un énoncé sur A* avec l'heuristique la moins informative possible, et tout ce qu'A* gagne vient de h. Le guide sur l'algorithme de Dijkstra et le guide sur l'algorithme de recherche A* détaillent chacun leur algorithme pas à pas.
L'effet sur la recherche est géométrique. Dijkstra développe les sommets par ordre de distance au départ, si bien que sa région explorée croît comme un cercle. A* les développe par ordre de longueur totale estimée d'un itinéraire passant par chaque sommet, de sorte que les sommets situés dans la mauvaise direction reçoivent une priorité élevée et restent dans la file. Le cercle devient quelque chose de plus proche d'une bande étroite entre le départ et l'objectif.
3. Une carte, deux recherches
L'exemple suivi est une grille de 288 cases avec un mur en forme de coupe, qui bloque 24 cases. Un robot part de S et doit atteindre G, en se déplaçant d'une case vers le haut, le bas, la gauche ou la droite, pour un coût de 1 par pas. Le mur impose un détour : sur une grille vide, G serait à 22 pas, mais l'itinéraire le plus court en compte 26. L'heuristique est la distance de Manhattan, c'est-à-dire le nombre de lignes plus le nombre de colonnes entre une case et l'objectif, qui ignore les murs et ne peut donc jamais surestimer.
import heapq

MAP = ["........................",
       "..........#########.....",
       "..S...............#.....",
       "..................#.....",
       "..................#.....",
       "..................#..G..",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "............#######.....",
       "........................"]

def locate(grid, ch):
    return next((r, row.index(ch)) for r, row in enumerate(grid) if ch in row)

def search(grid, start, goal, h, weight=1):
    """Recherche meilleur d'abord sur f = g + weight * h. Avec h = 0, c'est Dijkstra."""
    g = {start: 0}
    done, count = set(), 0
    heap = [(weight * h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue                                   # entrée périmée
        done.add(u)
        if u == goal:
            return g[u], len(done)                     # coût de l'itinéraire, sommets développés
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < len(grid) and 0 <= v[1] < len(grid[0]) and grid[v[0]][v[1]] != '#':
                if g[u] + 1 < g.get(v, float('inf')):
                    g[v] = g[u] + 1
                    count += 1
                    heapq.heappush(heap, (g[v] + weight * h(v), count, v))
    return None

S, G = locate(MAP, 'S'), locate(MAP, 'G')
manhattan = lambda v: abs(v[0] - G[0]) + abs(v[1] - G[1])

print('Dijkstra        ', search(MAP, S, G, lambda v: 0))
# Dijkstra         (26, 232)
print('A* (Manhattan)  ', search(MAP, S, G, manhattan))
# A* (Manhattan)   (26, 149)
for w in (2, 5):
    print(f'weighted A*, w={w}', search(MAP, S, G, manhattan, weight=w))
# weighted A*, w=2 (26, 124)
# weighted A*, w=5 (26, 116)
print('greedy best-first', search(MAP, S, G, manhattan, weight=1000))
# greedy best-first (46, 108)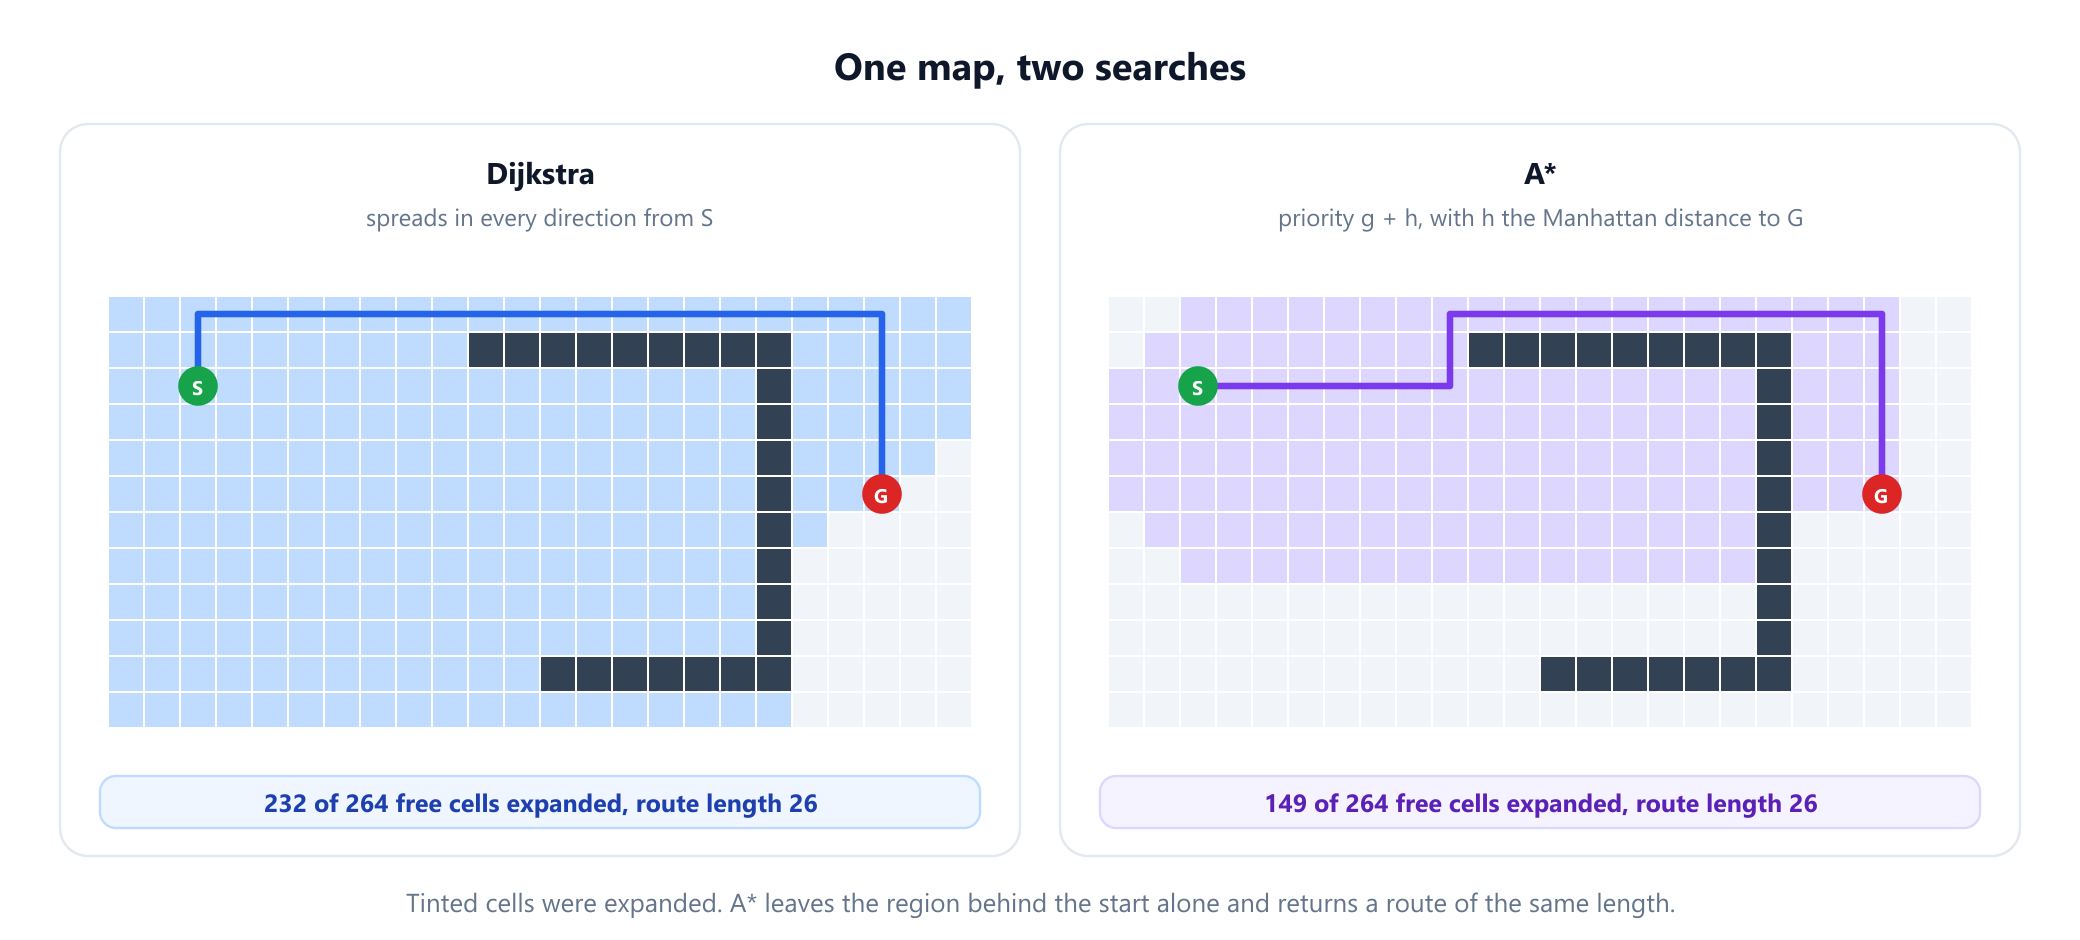
Tous deux renvoient un itinéraire de longueur 26. Dijkstra développe 232 des 264 cases libres avant d'atteindre G, y compris des cases à l'extrême gauche qui ne mènent nulle part. A* en développe 149. Il n'a pas besoin des 232 car toute case dont la valeur f dépasse 26 ne peut jamais se trouver sur un itinéraire le plus court, et A* n'y arrive jamais avant d'avoir terminé.
Ce gain de 36 % est modeste, car cette carte a été conçue pour tromper l'heuristique : à l'intérieur de la coupe, la distance de Manhattan continue de promettre une ligne droite à travers le mur. La section 6 mesure A* sur 800 itinéraires moins hostiles.
4. Pourquoi A* trouve quand même le plus court chemin
Une estimation semble risquée. La garantie vient d'une seule condition. Une heuristique est admissible si elle ne surestime jamais le vrai coût restant. Supposons qu'A* s'apprête à terminer à l'objectif avec un itinéraire de coût C, alors qu'un itinéraire moins cher de coût C* < C existe. Un certain sommet n de cet itinéraire moins cher attend encore dans la file et, comme h ne surestime jamais, f(n) = g(n) + h(n) ≤ C*. Donc f(n) est inférieur à la priorité de l'objectif, C, et A* aurait développé n en premier. L'itinéraire moins cher ne peut pas être manqué.
Une condition plus forte simplifie l'implémentation. Une heuristique est cohérente si, pour toute arête de u vers v de poids w, h(u) ≤ w + h(v) : parcourir une arête ne fait jamais baisser l'estimation de plus que le coût de cette arête. Avec une heuristique cohérente, A* n'a jamais besoin de développer un sommet deux fois, exactement comme Dijkstra. En fait, A* avec une heuristique cohérente est l'algorithme de Dijkstra exécuté sur les arêtes repondérées w'(u, v) = w(u, v) - h(u) + h(v), qui sont toutes de poids positif ou nul. Le guide sur A* en IA donne la preuve complète et un contre-exemple pour les heuristiques admissibles mais non cohérentes.
A* est également, en un sens précis, aussi économe qu'une recherche sûre unidirectionnelle peut l'être. Rina Dechter et Judea Pearl ont montré en 1985 que, lorsque l'heuristique est cohérente, tout algorithme qui développe les sommets vers l'extérieur à partir du départ, utilise la même heuristique et garantit de trouver un plus court chemin dès lors que l'heuristique ne surestime jamais, doit développer tous les sommets qu'A* est certain de développer, c'est-à-dire tous les sommets qu'un chemin issu du départ atteint avec f inférieur au coût optimal. Seul le traitement des égalités laisse une marge d'amélioration, et les recherches bidirectionnelles échappent à ce résultat.
5. L'heuristique est un bouton de réglage
Entre « ne sait rien » et « sait tout » s'étend toute une gamme de comportements, et le même code les couvre tous, à l'aide d'un poids w dans f = g + w * h. La sortie du programme de la section 3 montre ce qui se passe sur l'exemple :
| Recherche | Priorité | Cases développées | Longueur de l'itinéraire | Garantie |
|---|---|---|---|---|
| Dijkstra | g | 232 | 26 | Le plus court |
| A* | g + h | 149 | 26 | Le plus court |
A* pondéré, w = 2 | g + 2h | 124 | 26 | Au plus 2 fois le plus court |
A* pondéré, w = 5 | g + 5h | 116 | 26 | Au plus 5 fois le plus court |
| Recherche gloutonne meilleur d'abord | h | 108 | 46 | Aucune |
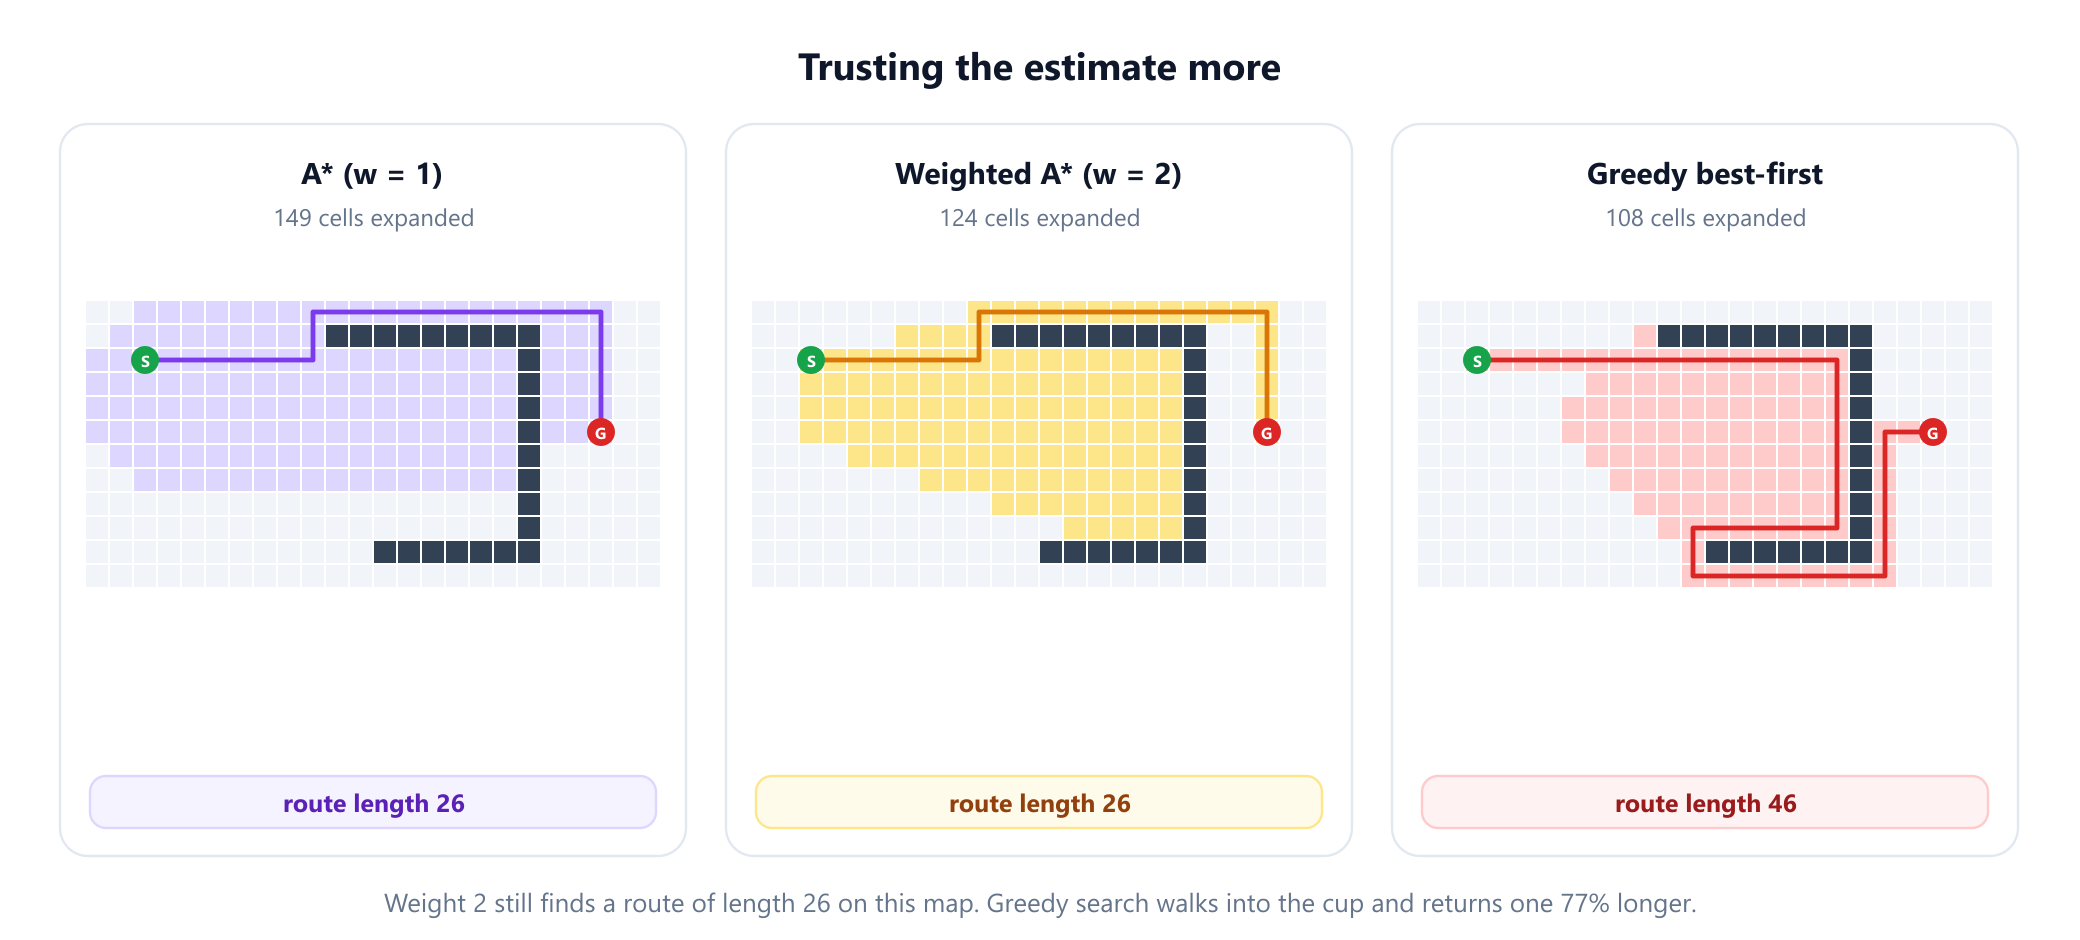
A* pondéré renonce à la garantie de façon contrôlée : avec une heuristique cohérente h, l'itinéraire qu'il renvoie mesure au plus w fois la longueur du plus court. Sur cette carte, des poids de 2 et 5 trouvent tout de même un itinéraire de longueur 26 avec moins de travail. La recherche gloutonne meilleur d'abord, qui ignore g complètement, n'économise qu'un peu plus et s'engouffre droit dans la coupe, renvoyant un itinéraire de 46 pas, 77 % plus long que nécessaire. Le travail économisé est faible au regard de la qualité perdue.
À l'autre extrémité du réglage, une heuristique parfaite, toujours égale au vrai coût restant, ferait marcher A* presque directement vers l'objectif. Plus une heuristique admissible h se rapproche de la vérité, moins A* développe de sommets. C'est pourquoi la conception de l'heuristique compte plus que n'importe quel détail d'implémentation.
6. Ce qu'A* économise sur des cartes typiques
Une seule carte ne prouve pas grand-chose. Le programme ci-dessous compare les deux recherches sur 200 itinéraires aléatoires pour chacun des quatre types de carte : des grilles de 60 par 60 sans murs, avec 20 % de murs et avec 35 % de murs, et un réseau routier de 1 500 villes placées au hasard, chacune reliée à ses 4 plus proches voisines par une route jusqu'à 40 % plus longue que la ligne droite. Sur les grilles, l'heuristique est la distance de Manhattan, et sur les routes, la distance en ligne droite. Dijkstra s'arrête dès qu'il atteint la cible, ce qui garde la comparaison équitable.
import heapq, math, random

def search(neighbours, start, goal, h):
    """A* ; passer h = lambda v: 0 pour Dijkstra. Renvoie (coût, sommets développés)."""
    g, done, count = {start: 0}, set(), 0
    heap = [(h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return g[u], len(done)
        for v, w in neighbours(u):
            if g[u] + w < g.get(v, float('inf')):
                g[v] = g[u] + w
                count += 1
                heapq.heappush(heap, (g[v] + h(v), count, v))
    return None

def compare(neighbours, h_for, pairs):
    """Nombre moyen de développements de Dijkstra et d'A* sur les paires reliées."""
    dij = star = runs = 0
    for s, t in pairs:
        d = search(neighbours, s, t, lambda v: 0)
        if d is None:
            continue
        a = search(neighbours, s, t, h_for(t))
        assert abs(a[0] - d[0]) < 1e-9                 # même coût, à chaque fois
        dij += d[1]; star += a[1]; runs += 1
    return dij // runs, star // runs

def grid_trial(density, rnd, n=60, trials=200):
    wall = {(r, c) for r in range(n) for c in range(n) if rnd.random() < density}
    free = [(r, c) for r in range(n) for c in range(n) if (r, c) not in wall]
    def neighbours(u):
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < n and 0 <= v[1] < n and v not in wall:
                yield v, 1
    h_for = lambda t: lambda v: abs(v[0] - t[0]) + abs(v[1] - t[1])
    return compare(neighbours, h_for, [rnd.sample(free, 2) for _ in range(trials)])

def road_trial(rnd, n=1500, trials=200):
    """Villes placées au hasard, chacune reliée à ses 4 plus proches voisines ; les routes serpentent et font jusqu'à 40 % de plus qu'à vol d'oiseau."""
    pts = [(rnd.random(), rnd.random()) for _ in range(n)]
    adj = [{} for _ in range(n)]
    for i, p in enumerate(pts):
        for j in sorted((j for j in range(n) if j != i), key=lambda j: math.dist(p, pts[j]))[:4]:
            w = math.dist(p, pts[j]) * rnd.uniform(1.0, 1.4)
            adj[i][j] = adj[j][i] = min(w, adj[i].get(j, w))
    neighbours = lambda u: adj[u].items()
    h_for = lambda t: lambda v: math.dist(pts[v], pts[t])
    return compare(neighbours, h_for, [rnd.sample(range(n), 2) for _ in range(trials)])

rnd = random.Random(1)
for density in (0.0, 0.2, 0.35):
    print(f'grid 60x60, {density:.0%} walls:', grid_trial(density, rnd))
print('road network, 1500 towns:', road_trial(rnd))
# grid 60x60, 0% walls: (1767, 451)
# grid 60x60, 20% walls: (1312, 238)
# grid 60x60, 35% walls: (1105, 397)
# road network, 1500 towns: (731, 235)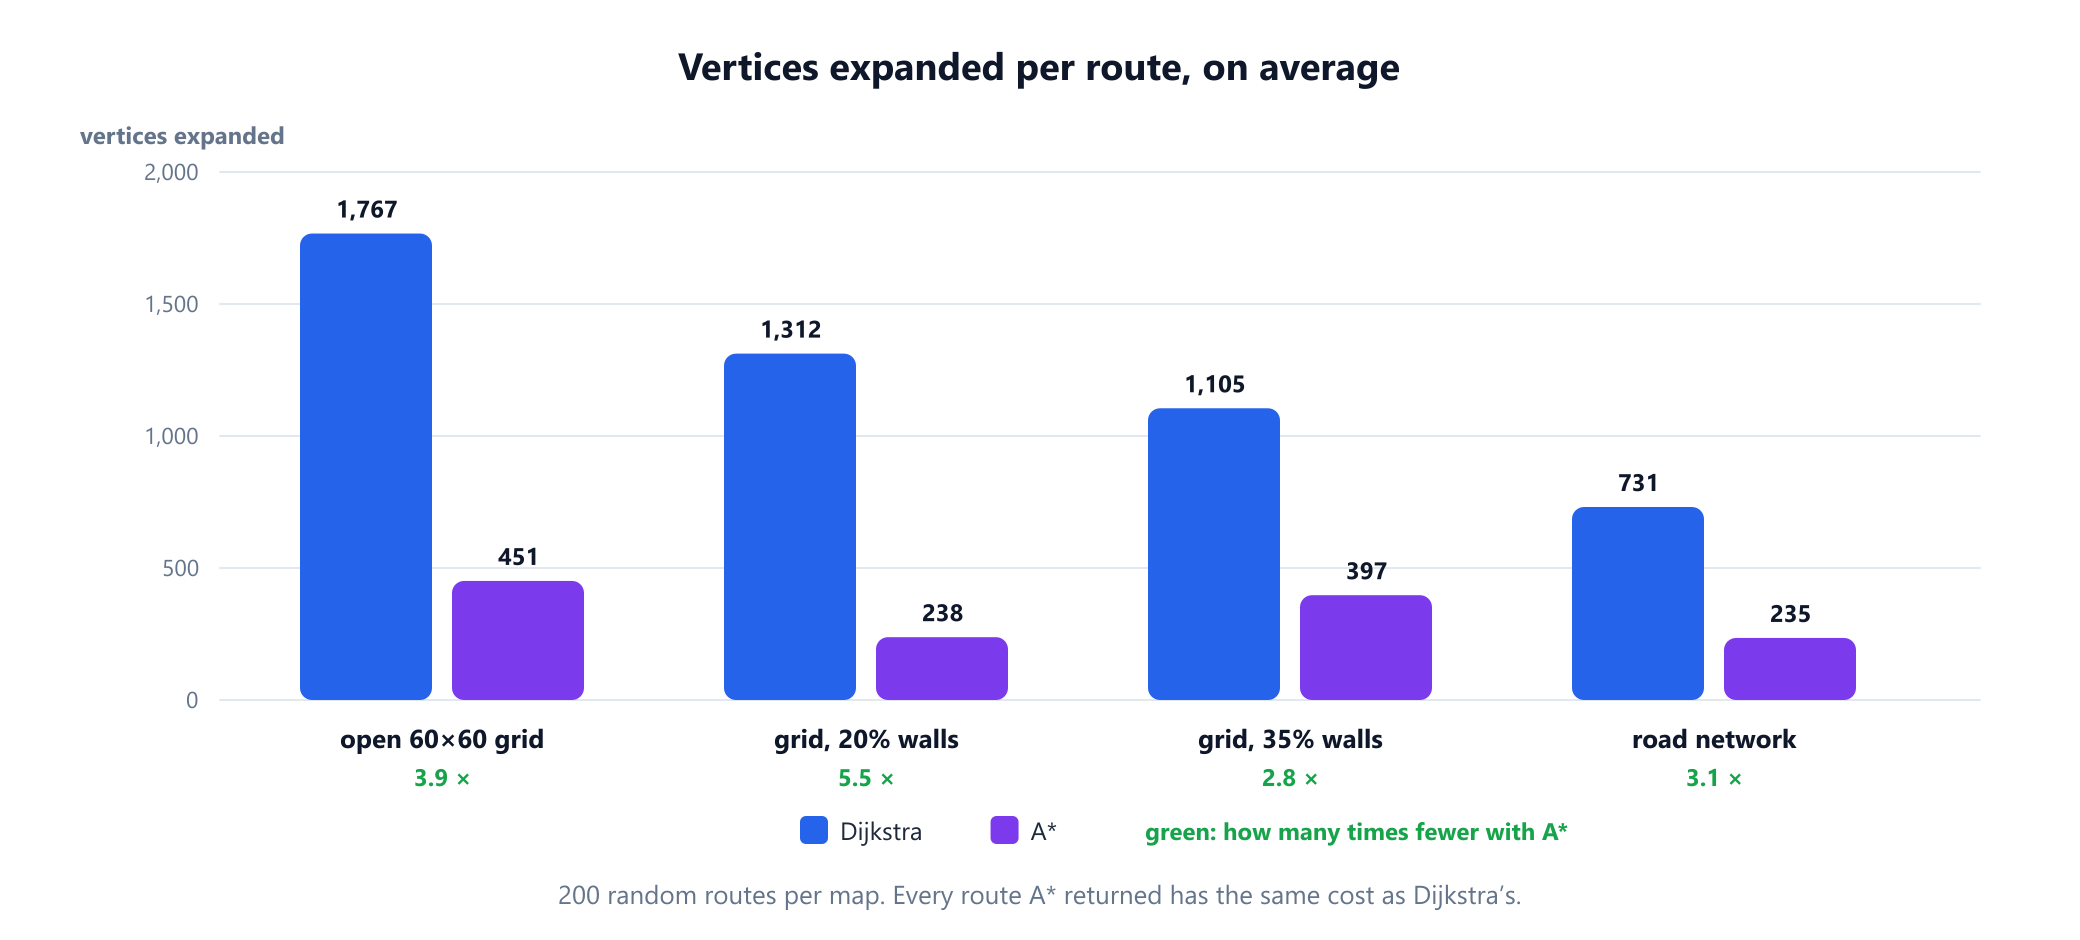
Sur tous les types de carte, A* a développé environ un tiers à un cinquième de ce qu'a développé Dijkstra, et a renvoyé exactement le même coût sur chaque itinéraire ; le programme le vérifie à chaque exécution. Le gain est le plus important à 20 % de murs (environ 5,5 fois). Sur la grille vide, s'il est plus faible, c'est uniquement à cause des égalités décrites à la section 7, et à 35 % de murs (2,8 fois) les détours fréquents rendent l'estimation moins précise. Sur le réseau routier, le gain est d'environ 3 fois, car les routes serpentent et la distance en ligne droite est une sous-estimation.
Développer moins de sommets ne signifie pas automatiquement gagner du temps. A* doit calculer h pour chaque sommet qu'il touche, et la file de priorité contient davantage d'entrées aux priorités voisines. Sur ces cartes, l'heuristique tient en une ligne d'arithmétique, le gain est donc réel. Une heuristique coûteuse à calculer peut annuler cet avantage.
7. Le coût caché des égalités
Sur une grille sans murs, un très grand nombre de cases partagent exactement la même valeur de f et l'ordre dans lequel A* les prend décide de tout. Le programme ci-dessous exécute A* d'un coin à l'autre d'une grille vide de 40 par 40 avec trois règles de départage différentes.
import heapq

def expansions(n, tie):
    """A* sur une grille vide de n par n, d'un coin à l'autre. tie(h, count) ordonne les valeurs de f égales."""
    goal = (n - 1, n - 1)
    h = lambda v: abs(v[0] - goal[0]) + abs(v[1] - goal[1])
    g, done, count = {(0, 0): 0}, set(), 0
    heap = [(h((0, 0)), tie(h((0, 0)), 0), (0, 0))]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return len(done)
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < n and 0 <= v[1] < n and g[u] + 1 < g.get(v, float('inf')):
                g[v] = g[u] + 1
                count += 1
                heapq.heappush(heap, (g[v] + h(v), tie(h(v), count), v))

n = 40
print('oldest entry first  ', expansions(n, lambda h, c: (c,)))
print('newest entry first  ', expansions(n, lambda h, c: (-c,)))
print('closest to the goal ', expansions(n, lambda h, c: (h, c)))
# oldest entry first   1600
# newest entry first   79
# closest to the goal  79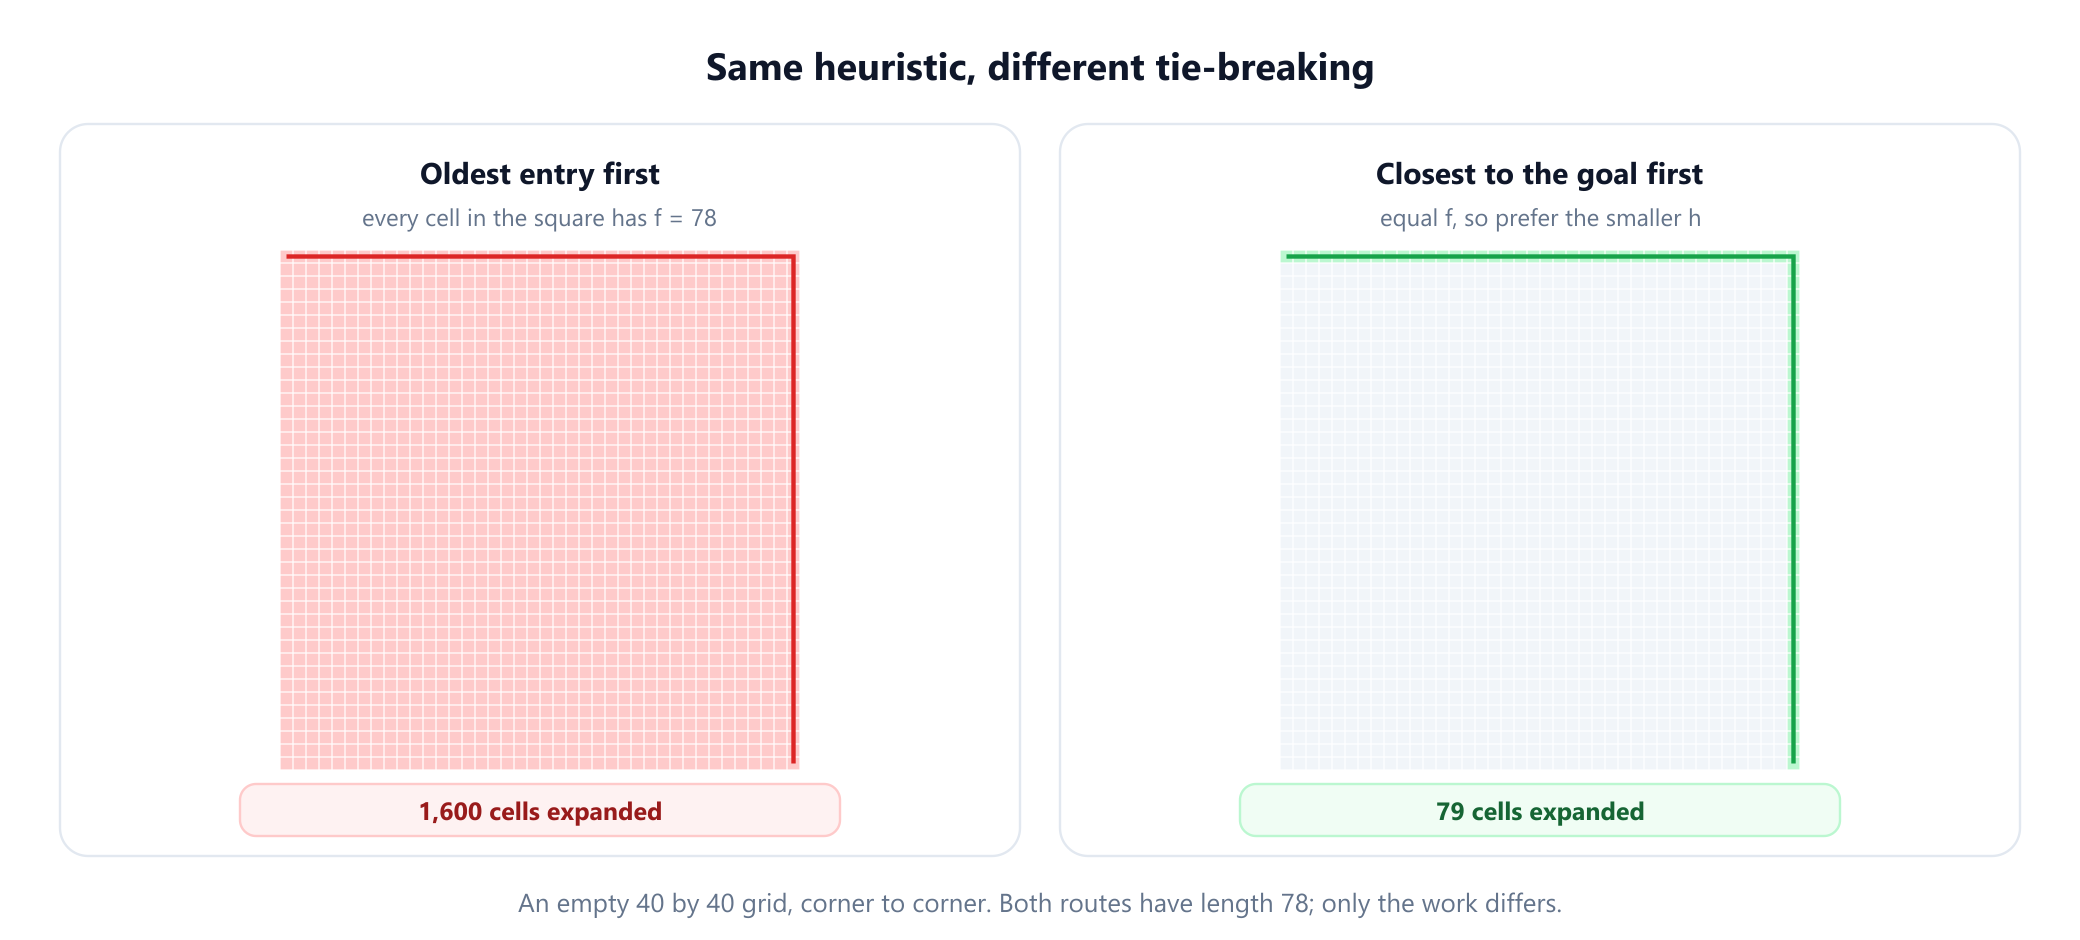
Lorsque les égalités sont départagées en faveur de l'entrée la plus ancienne, A* développe les 1 600 cases, sans faire mieux que Dijkstra. Préférez la case ayant le plus petit h, c'est-à-dire celle ayant le plus grand g, et il en développe 79, les cases d'un seul itinéraire ; prendre l'entrée la plus récente d'abord donne ici, par hasard, le même résultat. Chaque case du carré se trouve sur un itinéraire le plus court, elles ont donc toutes f = 78 ; la règle décide simplement s'il faut explorer tous ces itinéraires équivalents ou s'engager sur l'un d'eux. Pour comparer des implémentations d'A*, la règle de départage peut compter plus que la structure de données.
8. Quand Dijkstra est le meilleur choix
- Vous avez besoin de nombreuses cibles. Une seule exécution de Dijkstra depuis une source donne la distance vers tous les sommets. Exécuter A* une fois par cible répète du travail, et une heuristique visant un objectif est inutile pour les autres.
- Il n'existe pas d'estimation pertinente. A* a besoin d'une idée de la distance à laquelle se trouve l'objectif. Dans un réseau social, un graphe de citations ou un graphe de dépendances, il n'y a pas de coordonnées à partir desquelles mesurer, et
h = 0ramène A* à Dijkstra avec une comptabilité supplémentaire. - La cible est proche de tout. Si l'objectif est près du départ ou si le graphe est petit, il y a peu à gagner.
- La réponse est réutilisée. Une table de distances ou un arbre de plus courts chemins calculé une seule fois par Dijkstra peut servir à de nombreuses requêtes ultérieures depuis la même source.
- Vous voulez le code correct le plus simple. Dijkstra n'a aucune heuristique à concevoir, ni à mal concevoir.
Et certains problèmes n'ont besoin d'aucun des deux. Si chaque arête compte autant que les autres, le parcours en largeur trouve les itinéraires les plus courts sans aucune file de priorité, comme BFS vs DFS l'explique.
9. Les heuristiques qui brisent la garantie
A* ne vaut que ce que vaut son heuristique, et l'erreur classique est d'en utiliser une conçue pour d'autres déplacements. La distance de Manhattan est sûre lorsqu'on ne peut se déplacer que dans quatre directions. Autorisez les déplacements en diagonale et elle surestime, puisqu'un pas en diagonale couvre ce qu'elle compte pour deux. L'estimation correcte pour un déplacement à huit directions est la distance octile. Le programme suivant utilise des déplacements droits de coût 10 et des déplacements en diagonale de coût 14 sur la même carte.
import heapq

MAP = ["........................",
       "..........#########.....",
       "..S...............#.....",
       "..................#.....",
       "..................#.....",
       "..................#..G..",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "............#######.....",
       "........................"]
STEPS = [(-1, 0, 10), (0, 1, 10), (1, 0, 10), (0, -1, 10), (-1, 1, 14), (1, 1, 14), (1, -1, 14), (-1, -1, 14)]

def search(start, goal, h):
    """A* à 8 directions : un déplacement droit coûte 10, un déplacement en diagonale 14."""
    g, done, count = {start: 0}, set(), 0
    heap = [(h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return g[u], len(done)
        for dr, dc, w in STEPS:
            v = (u[0] + dr, u[1] + dc)
            if 0 <= v[0] < len(MAP) and 0 <= v[1] < len(MAP[0]) and MAP[v[0]][v[1]] != '#':
                if g[u] + w < g.get(v, float('inf')):
                    g[v] = g[u] + w
                    count += 1
                    heapq.heappush(heap, (g[v] + h(v), count, v))

S, G = (1, 19), (10, 0)                        # du haut à droite au bas à gauche, en contournant le mur
def manhattan(v):
    return 10 * (abs(v[0] - G[0]) + abs(v[1] - G[1]))
def octile(v):
    dr, dc = abs(v[0] - G[0]), abs(v[1] - G[1])
    return 10 * max(dr, dc) + 4 * min(dr, dc)

print('Dijkstra ', search(S, G, lambda v: 0))
print('octile   ', search(S, G, octile))
print('Manhattan', search(S, G, manhattan))
# Dijkstra  (234, 261)
# octile    (234, 21)
# Manhattan (288, 45)
Dijkstra et A* avec la distance octile trouvent tous deux le véritable itinéraire le plus court, de coût 234, et A* n'a besoin que de 21 développements au lieu de 261. La distance de Manhattan renvoie un itinéraire de coût 288, 23 % trop long, sans aucun avertissement. Une heuristique qui surestime est à la fois rapide et fausse, ce qui fait que l'erreur passe facilement inaperçue.
Deux pièges apparentés méritent d'être connus. Une heuristique peut être admissible et pourtant incohérente, auquel cas un sommet peut devoir être développé plus d'une fois : une implémentation dotée d'un ensemble fermé qui refuse de rouvrir les sommets, comme celles présentées ici, peut alors renvoyer un itinéraire qui n'est pas le plus court. Et les poids d'arêtes négatifs mettent en échec les deux algorithmes : pour ce cas, voir l'algorithme de Bellman-Ford.
10. Où sert chacun d'eux
- Jeux. A* sur les grilles et les maillages de navigation est la norme pour le déplacement des unités. Jump Point Search, de Daniel Harabor et Alban Grastien, accélère A* sur les grilles uniformes en sautant les cases que des itinéraires symétriques rendent redondantes.
- Robotique. A* a été créé pour cela : Peter Hart, Nils Nilsson et Bertram Raphael l'ont mis au point au Stanford Research Institute, et l'IEEE Milestone consacré au robot Shakey en attribue le mérite à ce projet.
- Réseaux. Les protocoles de routage à état de liens comme OSPF utilisent Dijkstra, car chaque routeur a besoin d'itinéraires vers toutes les destinations et non vers une seule.
- Routage routier à l'échelle d'un continent. Dijkstra et A* dans leur forme simple sont tous deux trop lents pour un continent entier. Les systèmes à l'échelle continentale documentés publiquement prétraitent la carte. Les hiérarchies de contraction ajoutent à l'avance des arêtes de raccourci, et ALT combine A* avec les distances à quelques points de repère choisis pour obtenir une meilleure heuristique.
- Puzzles et planification. A* et sa variante économe en mémoire IDA*, due à Richard Korf, résolvent des problèmes comme le taquin, où le graphe est bien trop grand pour être stocké et est généré au fil de la recherche.
La mémoire est souvent la vraie limite. Les deux algorithmes stockent chaque sommet atteint, si bien que sur d'immenses graphes implicites, A* peut manquer de mémoire bien avant de manquer de temps. C'est le cas pour lequel IDA* a été conçu.
11. Un bref historique
Edsger Dijkstra a publié son algorithme en 1959. Neuf ans plus tard, Hart, Nilsson et Raphael ont publié A* dans « A Formal Basis for the Heuristic Determination of Minimum Cost Paths », puis, en 1972, une courte correction sur le rôle de la cohérence dans leur preuve d'optimalité. Ira Pohl a étudié les fonctions d'évaluation pondérées en 1970. Dechter et Pearl ont établi en 1985 en quel sens exactement A* est optimal. Les deux algorithmes sont souvent présentés comme une progression, mais comme l'a montré la section 2, A* contient Dijkstra comme cas particulier h = 0.
12. Erreurs fréquentes
| Erreur | Pourquoi c'est faux | Correction |
|---|---|---|
| Utiliser A* pour calculer de nombreuses cibles | L'heuristique vise un seul objectif, et le travail est répété pour chacun | Exécuter Dijkstra une seule fois depuis la source |
| Utiliser la distance de Manhattan avec des déplacements en diagonale | Elle surestime et, sur l'exemple, renvoie 288 au lieu de 234 | Utiliser la distance octile |
| Supposer qu'A* est toujours plus rapide | Avec h = 0 ou une h coûteuse, il fait autant de travail, voire plus | Mesurer, et garder une heuristique peu coûteuse |
| Ignorer les égalités | Sur une grille ouverte de 40 par 40, la règle fait passer de 1 600 développements à 79 | Départager en faveur du plus petit h |
| Comparer à un Dijkstra qui ne s'arrête pas à la cible | Une exécution complète explore tout le graphe et exagère le gain | Arrêter Dijkstra lorsque la cible est développée |
| Traiter la recherche gloutonne meilleur d'abord comme un A* plus rapide | Elle n'offre aucune garantie et a renvoyé 46 pas au lieu de 26 | Utiliser A* pondéré pour un compromis borné |
| Utiliser un ensemble fermé avec une heuristique incohérente | Un meilleur itinéraire vers un sommet fermé est rejeté | Utiliser une heuristique cohérente, ou autoriser la réouverture |
| Exécuter l'un ou l'autre sur des arêtes négatives | Tous deux supposent que les coûts ne diminuent jamais le long d'un itinéraire | Utiliser Bellman-Ford ou l'algorithme de Johnson |
13. Glossaire
| Terme | Signification |
|---|---|
| g(v) | Le coût du meilleur itinéraire trouvé jusqu'ici entre le départ et v |
| h(v) | L'heuristique : une estimation du coût de v jusqu'à l'objectif |
| f(v) | g(v) + h(v), le coût total estimé d'un itinéraire passant par v |
| Développement | Retirer un sommet de la file et examiner ses voisins |
| Heuristique admissible | Heuristique qui ne surestime jamais le vrai coût restant |
| Heuristique cohérente | Heuristique vérifiant h(u) ≤ w + h(v) pour toute arête |
| Distance de Manhattan | Lignes plus colonnes entre deux cases ; sûre pour un déplacement à quatre directions |
| Distance octile | La distance sur grille lorsque les déplacements en diagonale sont autorisés |
| A* pondéré | A* avec f = g + w * h, qui échange de la qualité d'itinéraire contre de la vitesse |
| Recherche gloutonne meilleur d'abord | Recherche ordonnée par h seule, sans garantie |
| Départage | La règle qui ordonne les sommets dont les valeurs f sont égales |
| IDA* | Une variante en profondeur d'A* qui utilise très peu de mémoire |
14. Questions fréquentes
Quelle est la différence entre A* et Dijkstra ?
Dijkstra ordonne les sommets selon g, la distance depuis le départ. A* les ordonne selon f = g + h, où h est une estimation de la distance restant jusqu'à l'objectif. Avec h = 0, les deux sont le même algorithme. L'estimation permet à A* de se concentrer dans la direction de l'objectif, si bien qu'il explore généralement bien moins de sommets tout en trouvant un plus court chemin.
A* est-il toujours plus rapide que Dijkstra ?
Pas toujours. A* développe généralement bien moins de sommets lorsqu'une bonne estimation existe : environ trois à cinq fois et demie moins sur les cartes aléatoires mesurées ici. Avec une heuristique nulle, une heuristique lente à calculer ou un mauvais départage, il peut faire autant de travail que Dijkstra, voire plus. Une seule exécution de Dijkstra est aussi préférable lorsqu'il faut les distances vers de nombreuses cibles.
A* trouve-t-il toujours le plus court chemin ?
Seulement si l'heuristique est admissible, c'est-à-dire si elle ne surestime jamais le vrai coût restant. Si elle peut surestimer, A* peut renvoyer un itinéraire plus long sans aucun avertissement. Une implémentation qui ne rouvre jamais un sommet a aussi besoin que l'heuristique soit cohérente, c'est-à-dire que h(u) soit au plus w(u, v) + h(v) pour toute arête.
A* est-il la même chose que Dijkstra avec une heuristique ?
Oui, en un sens précis. A* avec h = 0 est l'algorithme de Dijkstra, et A* avec une heuristique cohérente se comporte exactement comme Dijkstra exécuté sur les arêtes repondérées w(u, v) - h(u) + h(v), qui sont toutes de poids positif ou nul.
Quand utiliser Dijkstra plutôt qu'A* ?
Utilisez Dijkstra lorsque vous avez besoin des distances d'une source vers de nombreux sommets ou vers tous, lorsqu'aucune estimation utile de la distance restante n'existe, comme dans les graphes sociaux ou de dépendances, ou lorsque la simplicité d'un code correct compte le plus. Utilisez A* lorsque vous voulez un seul itinéraire vers une seule cible et que vous pouvez estimer la distance, par exemple à partir des coordonnées sur une carte.
Quelle est la meilleure heuristique pour A* sur une grille ?
Cela dépend des déplacements. Utilisez la distance de Manhattan pour un déplacement à quatre directions et la distance octile lorsque les déplacements en diagonale sont autorisés. Utiliser la distance de Manhattan avec des déplacements en diagonale surestime et peut renvoyer un itinéraire trop long. Départager en faveur du sommet le plus proche de l'objectif fait aussi une grande différence sur les grilles ouvertes.
15. Références
Les algorithmes, résultats et attributions ci-dessus proviennent des sources suivantes, classées par ordre chronologique.
- Dijkstra, E. W. (1959). "A Note on Two Problems in Connexion with Graphs." Numerische Mathematik 1, 269 à 271.
- Hart, P. E., Nilsson, N. J. et Raphael, B. (1968). "A Formal Basis for the Heuristic Determination of Minimum Cost Paths." IEEE Transactions on Systems Science and Cybernetics 4(2), 100 à 107.
- Pohl, I. (1970). "Heuristic Search Viewed as Path Finding in a Graph." Artificial Intelligence 1(3 à 4), 193 à 204.
- Hart, P. E., Nilsson, N. J. et Raphael, B. (1972). "Correction to 'A Formal Basis for the Heuristic Determination of Minimum Cost Paths'." SIGART Newsletter 37, 28 à 29.
- Pearl, J. (1984). Heuristics: Intelligent Search Strategies for Computer Problem Solving. Reading, MA : Addison-Wesley.
- Dechter, R. et Pearl, J. (1985). "Generalized Best-First Search Strategies and the Optimality of A*." Journal of the ACM 32(3), 505 à 536.
- Korf, R. E. (1985). "Depth-First Iterative-Deepening: An Optimal Admissible Tree Search." Artificial Intelligence 27(1), 97 à 109.
- Moy, J. (1998). "OSPF Version 2." RFC 2328. Internet Engineering Task Force.
- Goldberg, A. V. et Harrelson, C. (2005). "Computing the Shortest Path: A* Search Meets Graph Theory." Dans Proceedings of the 16th ACM-SIAM Symposium on Discrete Algorithms, 156 à 165.
- Geisberger, R., Sanders, P., Schultes, D. et Delling, D. (2008). "Contraction Hierarchies: Faster and Simpler Hierarchical Routing in Road Networks." Dans Experimental Algorithms, Lecture Notes in Computer Science 5038, 319 à 333.
- Thayer, J. T. et Ruml, W. (2008). "Faster than Weighted A*: An Optimistic Approach to Bounded Suboptimal Search." Dans Proceedings of the 18th International Conference on Automated Planning and Scheduling, 355 à 362.
- Harabor, D. et Grastien, A. (2011). "Online Graph Pruning for Pathfinding on Grid Maps." Dans Proceedings of the 25th AAAI Conference on Artificial Intelligence, 1114 à 1119.
- Bast, H., Delling, D., Goldberg, A., Müller-Hannemann, M., Pajor, T., Sanders, P., Wagner, D. et Werneck, R. F. (2016). "Route Planning in Transportation Networks." Dans Algorithm Engineering, Lecture Notes in Computer Science 9220, 19 à 80.
Faites-les s'affronter sur votre propre carte
Dessinez un mur dans le visualiseur A* et observez jusqu'où la recherche s'étend. Exécutez ensuite Dijkstra sur le même graphe et comparez le nombre de sommets visités par chacun.
Ouvrir le visualiseur