
Inhaltsverzeichnis
- 1. Die kurze Antwort
- 2. Ein Graph, drei Durchläufe
- 3. Warum alle drei korrekt sind
- 4. Wenn sich die Bäume unterscheiden
- 5. Geschwindigkeit: Welcher ist schneller, und wann
- 6. Die Form Ihrer Eingabe
- 7. Unzusammenhängende Graphen und frühes Anhalten
- 8. Negative Gewichte, maximale Bäume und gerichtete Graphen
- 9. Prim ist nicht Dijkstra
- 10. Eine verworrene Geschichte
- 11. Wo welcher Algorithmus eingesetzt wird
- 12. Häufige Fehler
- 13. Glossar
- 14. Häufig gestellte Fragen
- 15. Quellen
1. Die kurze Antwort
Die Algorithmen von Prim, Kruskal und Borůvka finden alle einen minimalen Spannbaum: die günstigste Menge von Kanten, die alle Knoten eines gewichteten Graphen verbindet. Sie bauen ihn in unterschiedlicher Reihenfolge auf, und das entscheidet darüber, welcher zu einem gegebenen Graphen passt. Der Leitfaden zu minimalen Spannbäumen führt in das Problem selbst ein.
| Prim | Kruskal | Borůvka | |
|---|---|---|---|
| Strategie | Einen Baum von einem Startknoten aus nach außen wachsen lassen | Kanten von der günstigsten an aufwärts nehmen und jede überspringen, die einen Kreis schließt | Jede Gruppe wählt gleichzeitig ihre günstigste ausgehende Kante |
| Wichtigste Datenstruktur | Prioritätswarteschlange oder einfaches Array | Sortierte Kantenliste und Union-Find | Union-Find oder Neubeschriftung |
| Zeit | O(E log V) mit binärem Heap, O(V2) mit einem Array | O(E log E), nahezu linear, wenn die Kanten bereits sortiert sind | O(E log V) |
| Natürliche Eingabe | Adjazenzliste oder -matrix | Kantenliste | Kantenliste |
| Unzusammenhängender Graph | Erfasst nur die Komponente des Startknotens | Liefert einen Spannwald | Liefert einen Spannwald |
| Am besten für | Dichte Graphen, mit der Array-Version | Dünne Graphen, vorsortierte Kanten, Clustering | Paralleles und verteiltes Rechnen |
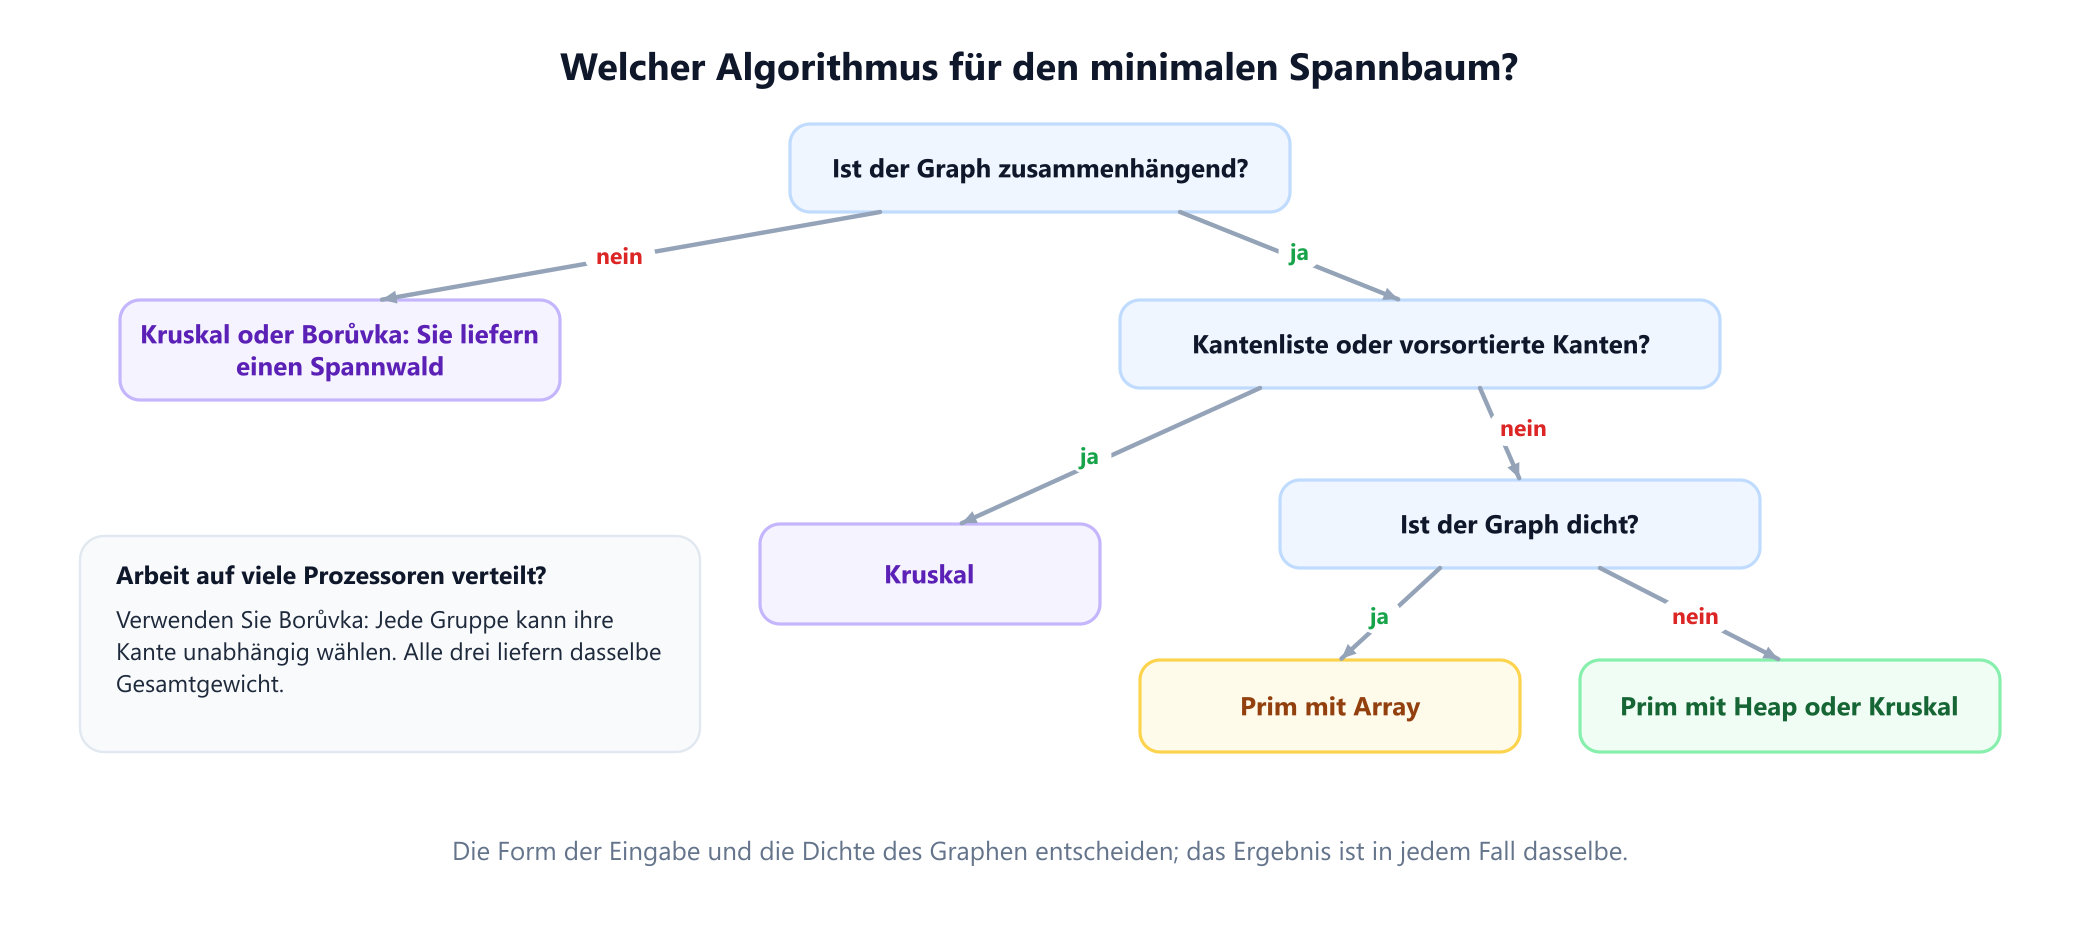
Dabei ist V die Anzahl der Knoten und E die Anzahl der Kanten. In einem Satz: Verwenden Sie Kruskal bei dünnen Graphen oder wenn der Graph als Kantenliste vorliegt, verwenden Sie Prim bei dichten Graphen oder wenn er als Matrix vorliegt, und ziehen Sie Borůvka in Betracht, wenn die Arbeit auf viele Prozessoren verteilt werden muss. Auf einem dünnen Graphen kosten Kruskal und Prim mit Heap etwa gleich viel, daher ist der Code, der für Ihre Daten einfacher ist, die richtige Wahl.
2. Ein Graph, drei Durchläufe
Acht Dörfer, A bis H, sollen durch Wasserleitungen verbunden werden. Es gibt 14 mögliche Trassen, jede mit Kosten in Kilometern Graben, und am Ende muss jedes Dorf mit jedem anderen verbunden sein. Zusammen würden alle 14 Trassen 117 kosten.
A-B 3    A-C 6    B-C 4    B-D 13   C-D 7    C-E 12   D-E 2
D-F 11   E-F 8    E-G 14   E-H 5    F-G 1    F-H 15   G-H 16

8 Dörfer, 14 mögliche Leitungen
Eine günstigste Verbindung benutzt genau 7 Leitungen, eine weniger als die Anzahl der Dörfer, denn jede weitere Leitung würde einen Kreis schließen, den man auflösen könnte, um Geld zu sparen. Dieser Graph hat 712 Spannbäume, und genau einer davon kostet das Minimum von 30. Das folgende Programm implementiert alle drei Algorithmen und führt sie auf ihm aus.
import heapq

PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

class Groups:
    """Union-Find: In welcher Gruppe liegt jeder Knoten?"""
    def __init__(self, items):
        self.parent = {x: x for x in items}
    def find(self, x):
        while self.parent[x] != x:
            self.parent[x] = self.parent[self.parent[x]]   # Pfadhalbierung
            x = self.parent[x]
        return x
    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False
        self.parent[ra] = rb
        return True

def vertices(edges):
    return sorted({x for u, v, _ in edges for x in (u, v)})

def prim(edges, start):
    """Einen Baum wachsen lassen: immer die günstigste Kante hinzufügen, die ihn verlässt."""
    adj = {v: [] for v in vertices(edges)}
    for u, v, w in edges:
        adj[u].append((w, u, v))
        adj[v].append((w, v, u))
    seen, heap, tree = {start}, list(adj[start]), []
    heapq.heapify(heap)
    while heap:
        w, u, v = heapq.heappop(heap)
        if v in seen:
            continue                                  # beide Enden liegen bereits im Baum
        seen.add(v)
        tree.append((u, v, w))
        for e in adj[v]:
            if e[2] not in seen:
                heapq.heappush(heap, e)
    return tree

def kruskal(edges):
    """Die Kanten von der günstigsten an aufwärts nehmen und jede überspringen, die einen Kreis schließen würde."""
    groups, tree = Groups(vertices(edges)), []
    for u, v, w in sorted(edges, key=lambda e: e[2]):
        if groups.union(u, v):
            tree.append((u, v, w))
    return tree

def boruvka(edges):
    """In jeder Runde wählt jede Gruppe gleichzeitig ihre günstigste ausgehende Kante."""
    groups, tree, rounds = Groups(vertices(edges)), [], []
    while True:
        cheapest = {}
        for u, v, w in edges:
            ru, rv = groups.find(u), groups.find(v)
            if ru != rv:
                for r in (ru, rv):                    # Gleichstände werden überall gleich aufgelöst
                    if r not in cheapest or (w, u, v) < cheapest[r]:
                        cheapest[r] = (w, u, v)
        if not cheapest:
            return tree, rounds
        added = []
        for w, u, v in sorted(set(cheapest.values())):
            if groups.union(u, v):
                added.append((u, v, w))
        tree += added
        rounds.append(added)

def show(tree):
    return ' '.join(f'{u}{v}:{w}' for u, v, w in tree) + f'   total {sum(w for *_, w in tree)}'

print('Prim    ', show(prim(PIPES, 'A')))
# Prim     AB:3 BC:4 CD:7 DE:2 EH:5 EF:8 FG:1   total 30
print('Kruskal ', show(kruskal(PIPES)))
# Kruskal  FG:1 DE:2 AB:3 BC:4 EH:5 CD:7 EF:8   total 30
tree, rounds = boruvka(PIPES)
print('Boruvka ', show(tree))
# Boruvka  FG:1 DE:2 AB:3 BC:4 EH:5 CD:7 EF:8   total 30
for i, added in enumerate(rounds, 1):
    print('round', i, show(added))
# round 1 FG:1 DE:2 AB:3 BC:4 EH:5   total 15
# round 2 CD:7 EF:8   total 15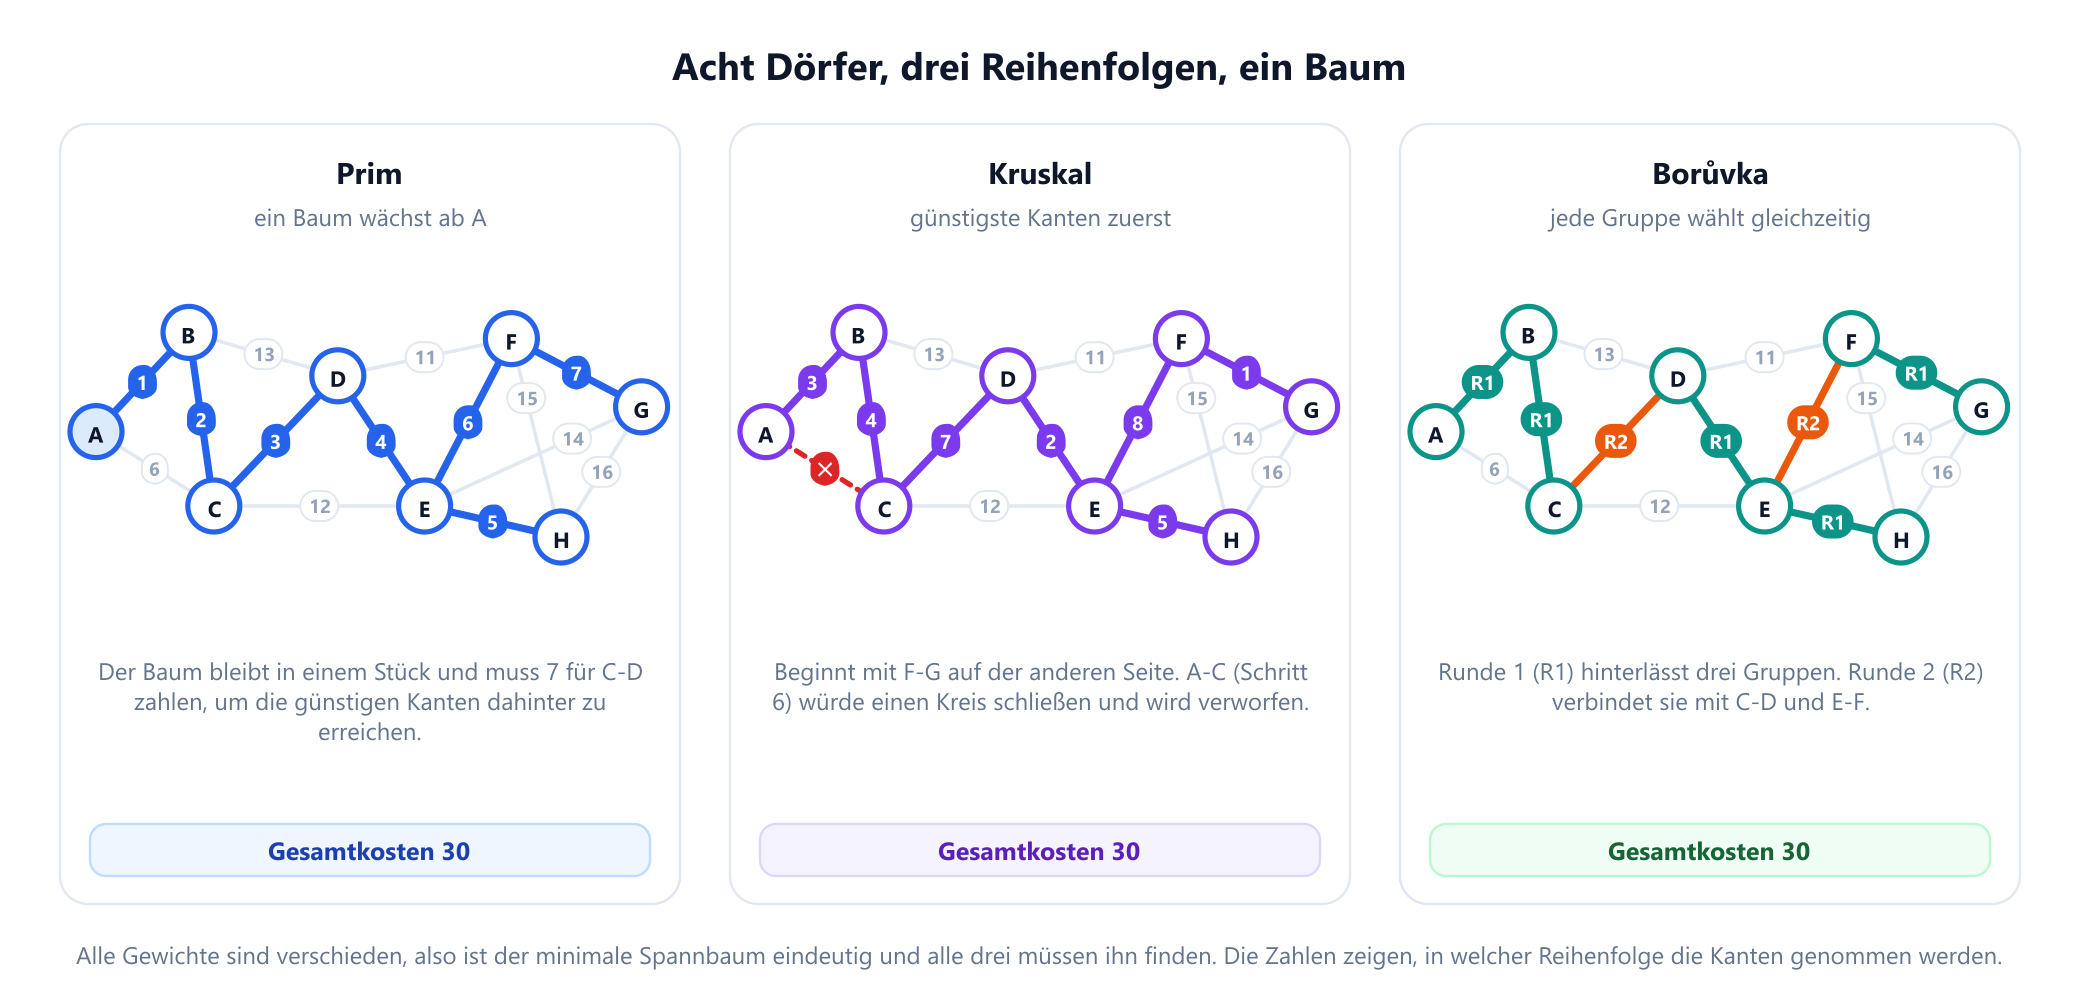
Die drei Reihenfolgen erzählen die Geschichte jedes Verfahrens:
- Prim beginnt bei
Aund erweitert immer den einen Baum, den er hat. Er nimmtA-Bfür 3,B-Cfür 4 und muss dann 7 fürC-Dzahlen, bevor er die günstigen KantenD-EundF-Gweiter hinten erreichen kann. - Kruskal ignoriert die Geografie. Er nimmt zuerst
F-Gfür 1, auf der anderen Seite des Graphen, und arbeitet sich die Preisliste hinauf. Wenn erA-Cfür 6 erreicht, sindAundCbereits überBverbunden, also verwirft er diese Leitung. NachE-Ffür 8 hat er 7 Leitungen und kann aufhören, ohne sich je die sechs teuersten Trassen anzusehen. - Borůvka arbeitet in Runden. In Runde 1 wählt jedes Dorf seine günstigste Leitung, was fünf verschiedene Leitungen und drei Gruppen ergibt:
{A, B, C},{D, E, H}und{F, G}. In Runde 2 wählt jede Gruppe ihre günstigste Leitung zu einer anderen Gruppe, undC-DundE-Fvollenden die Arbeit.
3. Warum alle drei korrekt sind
So verschieden sie auch aussehen, alle drei beruhen auf derselben Tatsache über Schnitte. Ein Schnitt teilt die Knoten in zwei Gruppen, wie der Leitfaden zum minimalen Schnitt erklärt. Die Schnitteigenschaft besagt: Für jeden Schnitt gehört die günstigste Kante, die ihn kreuzt, zu einem minimalen Spannbaum, und wenn alle Gewichte verschieden sind, gehört sie zu jedem. Der Beweis ist ein Austauschargument. Nehmen Sie einen Spannbaum, der diese Kante nicht benutzt, und fügen Sie sie hinzu: Das schließt einen Kreis, der Kreis muss den Schnitt ein zweites Mal über eine teurere Kante kreuzen, und das Entfernen dieser teureren Kante ergibt einen günstigeren Baum.
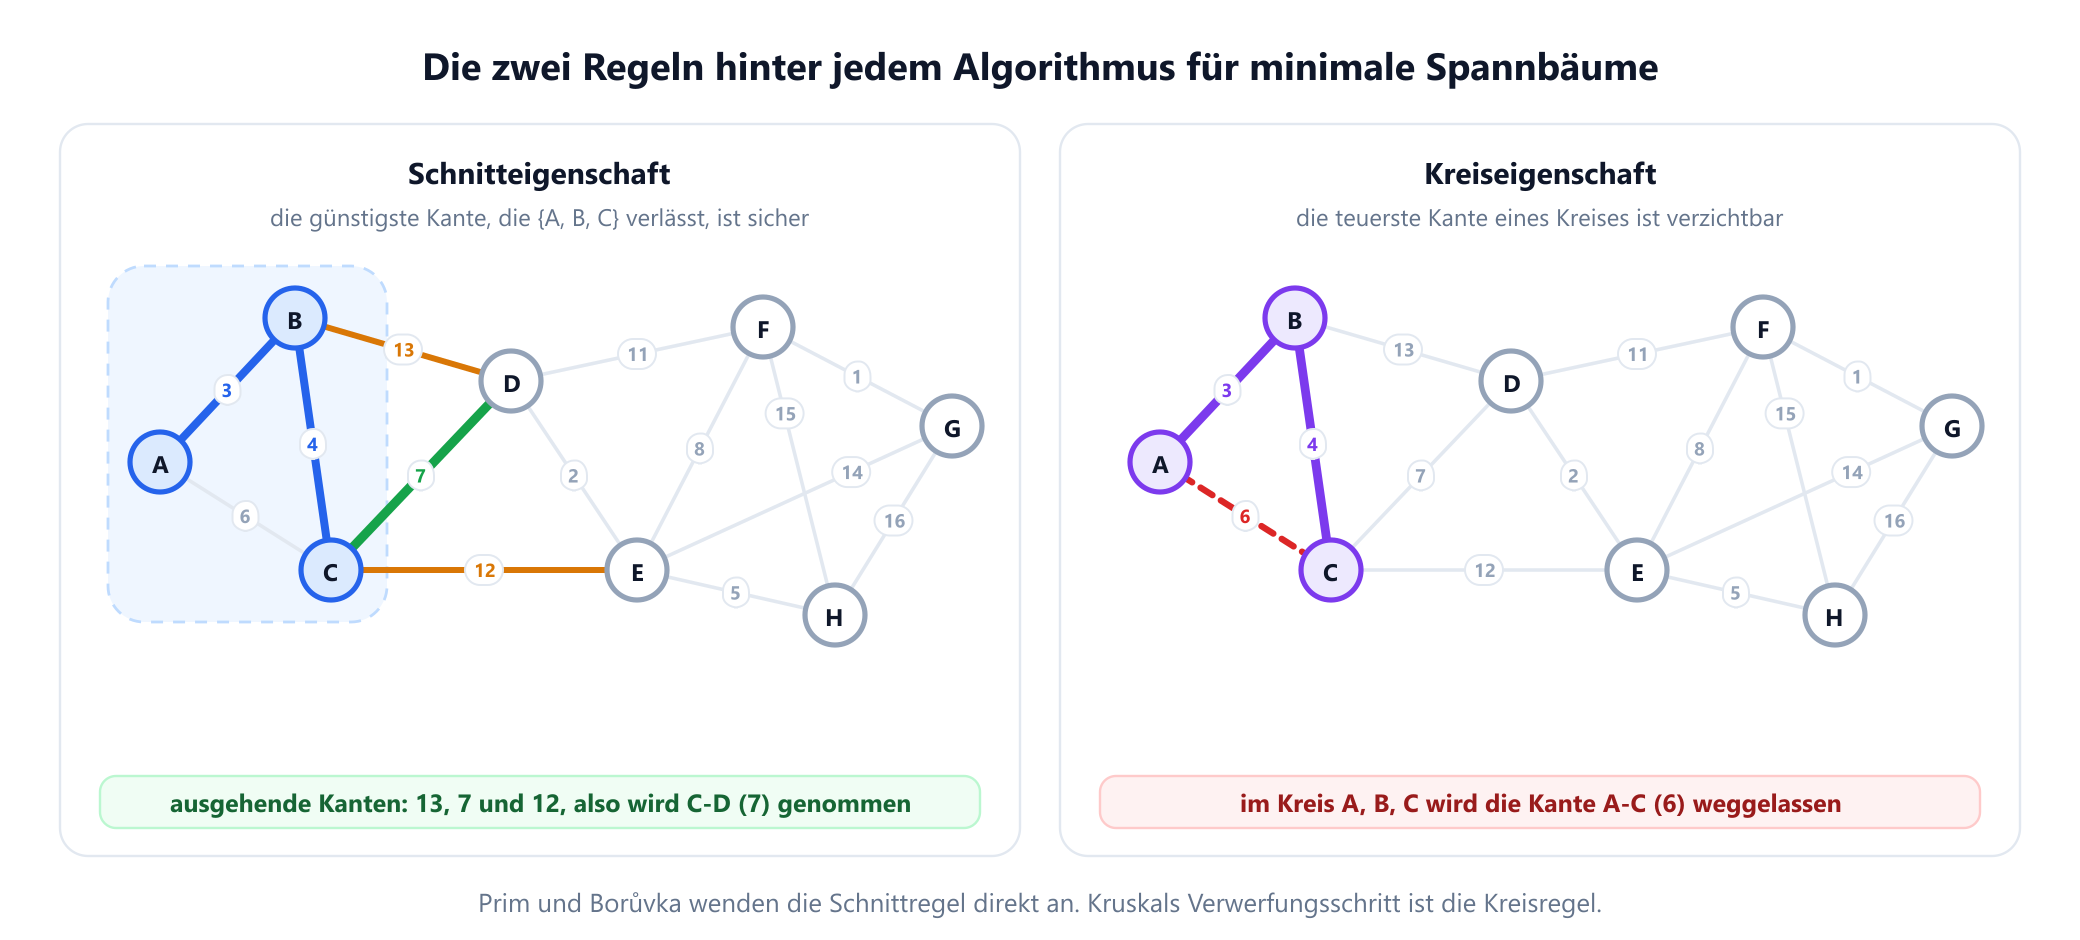
Jeder Algorithmus wendet diese Regel auf einen anderen Schnitt an:
- Prim verwendet den Schnitt zwischen seinem Baum und allem Übrigen. Im Bild führen aus dem Baum
{A, B, C}drei Kanten hinaus, und die günstigste,C-Dfür 7, wird hinzugefügt. - Kruskal verwendet den Schnitt um eine der beiden Gruppen, die die Kante verbindet. Die Kanten werden in aufsteigender Reihenfolge genommen; wenn also eine Kante zwei Gruppen verbindet, verlässt keine günstigere Kante eine der beiden.
- Borůvka verwendet den Schnitt um jede Gruppe, für alle Gruppen gleichzeitig.
Das Spiegelbild ist die Kreiseigenschaft: Die teuerste Kante eines beliebigen Kreises kann aus einem minimalen Spannbaum weggelassen werden. Das ist Kruskals Verwerfungsschritt. Wenn A-C für 6 den Kreis A, B, C schließen würde, ist sie die teuerste Kante dieses Kreises, weil jede andere Kante darauf früher genommen wurde. Ein minimaler Spannbaum braucht diese Kante nie.
4. Wenn sich die Bäume unterscheiden
Wenn alle Kantengewichte verschieden sind, ist der minimale Spannbaum eindeutig, also müssen alle drei Algorithmen genau dieselben Kanten liefern, wie im Beispiel. Bei gleichen Gewichten kann es mehrere minimale Spannbäume geben, alle mit derselben Summe, und welchen Sie erhalten, hängt vom Algorithmus und sogar von der Reihenfolge der Eingabe ab. Setzen Sie die Kosten von A-C auf 4, genauso viel wie bei B-C, und es gibt genau zwei minimale Spannbäume:
PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

def kruskal(edges):
    parent = {x: x for u, v, _ in edges for x in (u, v)}
    def find(x):
        while parent[x] != x:
            x = parent[x]
        return x
    tree = []
    for u, v, w in sorted(edges, key=lambda e: e[2]):  # stabil: Gleichstände behalten ihre Eingabereihenfolge
        if find(u) != find(v):
            parent[find(u)] = find(v)
            tree.append(u + v)
    return sorted(tree), sum(w for u, v, w in edges if u + v in tree)

tied = [(u, v, 4 if (u, v) == ('A', 'C') else w) for u, v, w in PIPES]   # A-C kostet jetzt 4, wie B-C
print(kruskal(tied))
# (['AB', 'AC', 'CD', 'DE', 'EF', 'EH', 'FG'], 30)
print(kruskal(tied[::-1]))
# (['AB', 'BC', 'CD', 'DE', 'EF', 'EH', 'FG'], 30)
Beide Bäume kosten 30 und unterscheiden sich in einer Leitung. Pythons Sortierung ist stabil, gleiche Kanten behalten also ihre Eingabereihenfolge, und das Umkehren der Liste ändert, welche der beiden zuerst genommen wird. Wenn Ihre Tests die genauen Kanten eines Baums vergleichen, können sie bei einem korrekten Programm fehlschlagen; vergleichen Sie stattdessen das Gesamtgewicht.
Gleichstände sind auch die klassische Fehlerquelle im Algorithmus von Borůvka. Wenn zwei Gruppen jeweils zwischen Kanten gleichen Gewichts wählen, können inkonsistente Entscheidungen einen Kreis erzeugen. Das obige Programm vermeidet das, indem es überall (w, u, v) vergleicht, sodass jede Gruppe Gleichstände auf dieselbe Weise auflöst.
5. Geschwindigkeit: Welcher ist schneller, und wann
| Variante | Zeit | Wo die Zeit verbraucht wird |
|---|---|---|
| Prim, binärer Heap | O(E log V) | Höchstens eine Heap-Operation pro Kante |
| Prim, einfaches Array | O(V2) | Durchsuchen aller verbleibenden Knoten, einmal pro hinzugefügtem Knoten |
| Prim, Fibonacci-Heap | O(E + V log V) | Theoretisch schnell, in der Praxis große konstante Faktoren |
| Kruskal | O(E log E) | Sortieren; die Union-Find-Arbeit danach ist fast linear |
| Borůvka | O(E log V) | Höchstens log2 V Runden, von denen jede alle Kanten durchsucht |
Da E höchstens V2 ist, ist log E höchstens 2 log V, daher gehören O(E log E) und O(E log V) zur selben Klasse. Die Formeln allein trennen die Verfahren nicht, daher zählt das folgende Programm elementare Schritte, also Vergleiche, Kanteninspektionen und Union-Find-Sprünge, auf zwei Zufallsgraphen mit 1.000 Knoten. Einer ist dünn, mit 3.000 Kanten, und einer dicht, mit 249.750 Kanten, der Hälfte aller möglichen Paare.
import heapq, random
from functools import cmp_to_key

def random_graph(n, m, seed):
    """Ein zusammenhängender Graph: ein zufälliger Spannbaum plus zufällige weitere Kanten, alle Gewichte verschieden."""
    rnd = random.Random(seed)
    order = list(range(n))
    rnd.shuffle(order)
    pairs = {tuple(sorted((order[i], order[rnd.randrange(i)]))) for i in range(1, n)}
    while len(pairs) < m:
        u, v = rnd.sample(range(n), 2)
        pairs.add((min(u, v), max(u, v)))
    weights = rnd.sample(range(1, 10 * m), m)
    return [(u, v, w) for (u, v), w in zip(sorted(pairs), weights)]

class Item:
    """Ein Heap-Eintrag, der zählt, wie oft der Heap ihn vergleicht."""
    compared = 0
    def __init__(self, w, v):
        self.w, self.v = w, v
    def __lt__(self, other):
        Item.compared += 1
        return self.w < other.w

def prim_heap(n, edges):
    adj = [[] for _ in range(n)]
    for u, v, w in edges:
        adj[u].append((w, v))
        adj[v].append((w, u))
    Item.compared = 0
    seen, steps = {0}, len(adj[0])
    heap = [Item(w, v) for w, v in adj[0]]
    heapq.heapify(heap)
    while heap:
        item = heapq.heappop(heap)
        if item.v in seen:
            continue
        seen.add(item.v)
        for w, v in adj[item.v]:
            steps += 1                                # eine Kante geprüft
            if v not in seen:
                heapq.heappush(heap, Item(w, v))
    return steps + Item.compared

def prim_array(n, edges):
    """Prim ohne Heap: die besten bekannten Kosten jedes verbleibenden Knotens durchsuchen."""
    adj = [[] for _ in range(n)]
    for u, v, w in edges:
        adj[u].append((w, v))
        adj[v].append((w, u))
    best, done, steps = [float('inf')] * n, [False] * n, 0
    best[0] = 0
    for _ in range(n):
        left = [v for v in range(n) if not done[v]]
        u = min(left, key=best.__getitem__)
        steps += len(left)
        done[u] = True
        for w, v in adj[u]:
            steps += 1
            if not done[v] and w < best[v]:
                best[v] = w
    return steps

def kruskal(n, edges):
    compared = [0]
    def cmp(a, b):
        compared[0] += 1
        return a[2] - b[2]
    parent, steps = list(range(n)), 0
    def find(x):
        nonlocal steps
        while parent[x] != x:
            steps += 1
            parent[x] = parent[parent[x]]
            x = parent[x]
        steps += 1
        return x
    for u, v, w in sorted(edges, key=cmp_to_key(cmp)):
        ru, rv = find(u), find(v)
        if ru != rv:
            parent[ru] = rv
    return compared[0] + steps

def boruvka(n, edges):
    parent, steps = list(range(n)), 0
    def find(x):
        nonlocal steps
        while parent[x] != x:
            steps += 1
            parent[x] = parent[parent[x]]
            x = parent[x]
        steps += 1
        return x
    while True:
        cheapest = {}
        for u, v, w in edges:
            ru, rv = find(u), find(v)
            if ru != rv:
                for r in (ru, rv):
                    steps += 1
                    if r not in cheapest or w < cheapest[r][2]:
                        cheapest[r] = (u, v, w)
        if not cheapest:
            return steps
        for u, v, w in set(cheapest.values()):
            ru, rv = find(u), find(v)
            if ru != rv:
                parent[ru] = rv

n = 1000
for name, m in [('sparse', 3 * n), ('dense', n * (n - 1) // 4)]:
    edges = random_graph(n, m, seed=1)
    print(f'{name:6} E={m:6,}  Prim heap {prim_heap(n, edges):9,}  Prim array {prim_array(n, edges):9,}  '
          f'Kruskal {kruskal(n, edges):9,}  Boruvka {boruvka(n, edges):9,}')
# sparse E= 3,000  Prim heap    46,360  Prim array   506,500  Kruskal    44,414  Boruvka    73,486
# dense  E=249,750  Prim heap 5,231,906  Prim array 1,000,000  Kruskal 5,151,232  Boruvka 7,417,850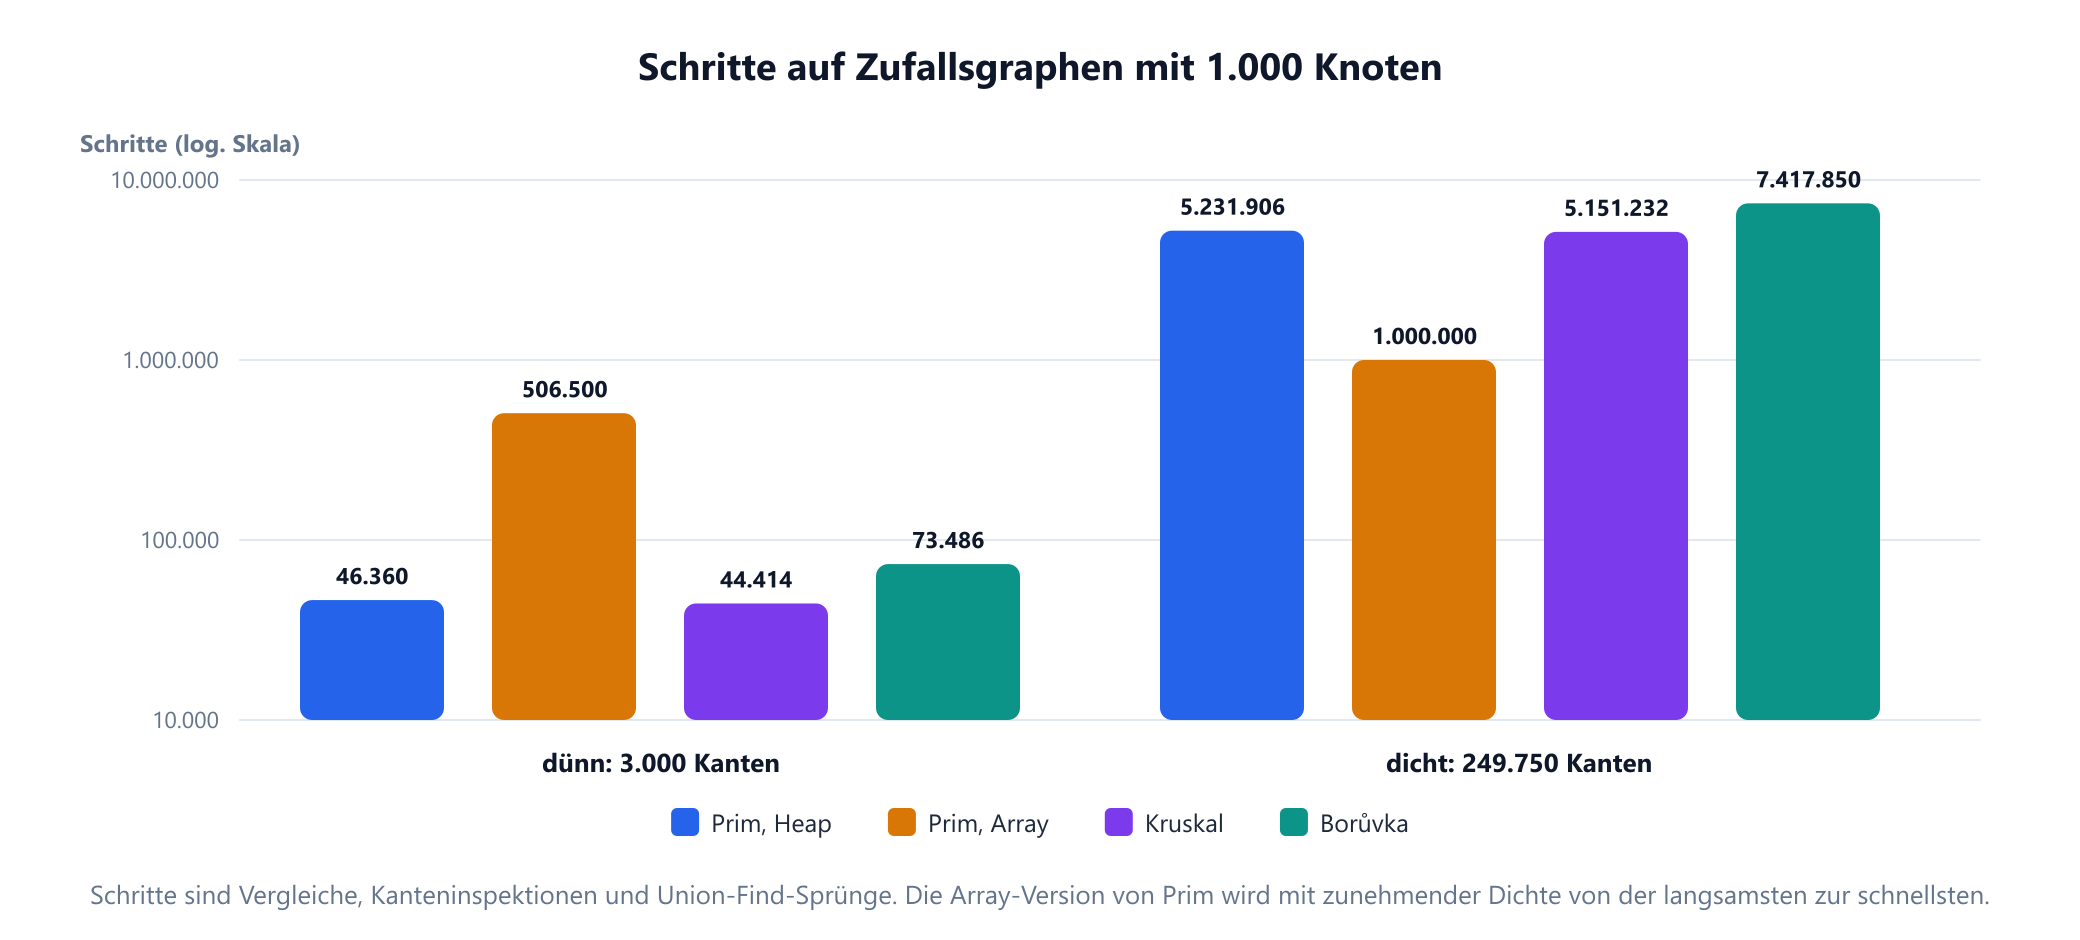
Mit der Dichte kehren sich die Ergebnisse um. Auf dem dünnen Graphen liegen Kruskal und Prim mit Heap innerhalb von 5 % beieinander, Borůvka braucht etwa 60 % mehr, und Prim mit Array ist etwa 11-mal langsamer, weil er jeden verbleibenden Knoten durchsucht, obwohl jeder nur wenige Kanten hat. Auf dem dichten Graphen braucht die Array-Version genau 1.000.000 Schritte und gewinnt etwa um den Faktor fünf: Sie muss nie mehr als V Kandidaten betrachten, während Heap und Sortierung auf fast 250.000 Kanten einen logarithmischen Aufwand zahlen.
Diese Zahlen zählen Schritte, nicht Sekunden. Das Sortieren eines Zahlen-Arrays ist auf realer Hardware sehr schnell, was oft Kruskal begünstigt, und die Heap-Version hier ist die einfache, die mehrere Einträge pro Knoten enthalten kann. Eine Version, die Einträge direkt aktualisiert, hält den Heap kleiner, um den Preis von mehr Code. Wenn es auf die Zeit ankommt, messen Sie mit Ihren eigenen Daten.
6. Die Form Ihrer Eingabe
Oft entscheidet die Eingabe, noch bevor es eine Komplexitätsanalyse tut. Der Leitfaden zur Darstellung von Graphen vergleicht die Formate.
- Eine Kantenliste passt direkt zu Kruskal: Außer dem Union-Find-Array muss nichts aufgebaut werden.
- Bereits sortierte Kanten, oder Gewichte, die kleine ganze Zahlen sind und per Counting Sort sortiert werden können, beseitigen Kruskals einzigen teuren Schritt. Übrig bleibt die Union-Find-Arbeit, die fast linear ist.
- Eine Adjazenzmatrix, oder auch Distanzen, die Sie bei Bedarf berechnen können, etwa bei Punkten in einer Ebene, wo jedes Paar eine Kante ist, spricht für Prim mit Array. Er speichert die Kanten überhaupt nicht und braucht nur
O(V)Speicher, während Kruskal etwaV2 / 2davon vorhalten und sortieren müsste. - Eine für den Speicher zu große Kantenliste spricht für Borůvka, der nur wiederholte Durchläufe über die Kanten braucht, und für Kruskal-Varianten wie filter-Kruskal, die das Sortieren von Kanten vermeiden, die klar verworfen werden.
Es lohnt sich, Kruskals Union-Find-Struktur für sich genommen zu verstehen, und der Leitfaden zu Union-Find behandelt sie ausführlich.
7. Unzusammenhängende Graphen und frühes Anhalten
Die drei Verfahren unterscheiden sich auch darin, was sie tun, wenn der Graph nicht aus einem Stück besteht, und was sie Ihnen sagen können, wenn Sie früh anhalten.
Unzusammenhängende Graphen. Prim erreicht nur die Zusammenhangskomponente seines Startknotens; um den ganzen Graphen abzudecken, muss er in jeder Komponente neu gestartet werden. Kruskal und Borůvka brauchen keine Änderung: Ihnen gehen einfach die Kanten aus, und sie liefern einen minimalen Spannwald, einen Baum pro Komponente.
Clustering. Kruskals Zwischenzustände sind für sich genommen nützlich. Halten Sie an, wenn k Gruppen übrig sind, und diese Gruppen sind die Single-Linkage-Cluster der Daten: die Aufteilung in k Gruppen, bei der das nächstgelegene Paar von Punkten aus verschiedenen Gruppen so weit wie möglich auseinanderliegt.
PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

def kruskal_until(edges, groups_wanted):
    """Kruskal, angehalten, sobald nur noch groups_wanted Gruppen übrig sind."""
    parent = {x: x for u, v, _ in edges for x in (u, v)}
    def find(x):
        while parent[x] != x:
            parent[x] = parent[parent[x]]
            x = parent[x]
        return x
    count, tree = len(parent), []
    for u, v, w in sorted(edges, key=lambda e: e[2]):
        if count == groups_wanted:
            break
        if find(u) != find(v):
            parent[find(u)] = find(v)
            tree.append((u, v, w))
            count -= 1
    members = {}
    for x in sorted(parent):
        members.setdefault(find(x), []).append(x)
    return tree, sorted(''.join(m) for m in members.values())

print(kruskal_until(PIPES, 3)[1])              # drei Cluster von Dörfern
# ['ABC', 'DEH', 'FG']
print(kruskal_until(PIPES, 2)[1])
# ['ABCDEH', 'FG']

# Ein Graph aus zwei Teilen: jede Leitung zwischen A bis E und F, G, H entfernen.
split = [e for e in PIPES if not (set(e[:2]) & set('FGH')) or set(e[:2]) <= set('FGH')]
tree, parts = kruskal_until(split, 1)          # verlangt 1 Gruppe, aber es können nur 2 existieren
print(parts, sum(w for *_, w in tree))
# ['ABCDE', 'FGH'] 32
Bei drei Gruppen angehalten, liefert das Programm {A, B, C}, {D, E, H} und {F, G}, dieselben drei, die Borůvkas erste Runde auf diesem Graphen erzeugt hat, wobei diese Übereinstimmung ein Zufall des Beispiels ist. Im letzten Lauf, ohne die Leitungen zwischen den beiden Hälften, liefert Kruskal einen Wald aus zwei Bäumen mit Kosten von 32. Prim von A aus würde nach fünf Dörfern anhalten und käme nie zu F, G oder H.
8. Negative Gewichte, maximale Bäume und gerichtete Graphen
- Negative Gewichte sind kein Problem. Anders als der Algorithmus von Dijkstra lässt sich keiner der drei davon stören, weil jeder Spannbaum genau
V - 1Kanten hat. Wird zu jedem Gewicht dieselbe Konstante addiert, steigen die Kosten jedes Baums um denselben Betrag, und die Wahl bleibt unverändert. Zieht man im Beispiel von jeder Leitung 10 ab, wodurch die meisten Gewichte negativ werden, ergibt sich derselbe Baum. - Maximale Spannbäume. Negieren Sie die Gewichte oder sortieren Sie absteigend. Der teuerste Spannbaum des Beispiels kostet 87.
- Engpässe. Ein minimaler Spannbaum minimiert auch seine schwerste Kante. Im Beispiel ist das
E-Fmit 8, und kein Spannbaum kann eine Kante von mindestens 8 vermeiden. - Gerichtete Graphen. Keiner der drei funktioniert auf gerichteten Graphen. Die gerichtete Version des Problems, die minimale Arboreszenz, erfordert den Chu-Liu/Edmonds-Algorithmus.
9. Prim ist nicht Dijkstra
Die Algorithmen von Prim und Dijkstra sehen im Code fast identisch aus, und der Unterschied ist eine Zeile: Prim ordnet die Warteschlange nach dem Gewicht der einzelnen Kante, die einen Knoten erreicht, Dijkstra dagegen nach der Gesamtdistanz von der Quelle. Sie optimieren verschiedene Dinge und bauen verschiedene Bäume auf. Der Leitfaden zum Algorithmus von Prim vergleicht sie Zeile für Zeile.
Im Beispiel benutzt Dijkstras Kürzeste-Wege-Baum von A aus A-C für 6 statt B-C für 4. Er kostet insgesamt 32, gegenüber 30 beim minimalen Spannbaum. Dafür liegt jedes Dorf mindestens ebenso nah an A entlang dieses Baums: C ist 6 entfernt statt 7, H 20 statt 21 und G 24 statt 25. Ein minimaler Spannbaum minimiert die Kosten für den Aufbau des Netzes und sagt nichts über die Länge einer einzelnen Route aus.
10. Eine verworrene Geschichte
Die drei Namen führen in die Irre, was die Frage angeht, wer zuerst da war. Der früheste Algorithmus ist der von Borůvka. 1926 veröffentlichte ihn der tschechische Mathematiker Otakar Borůvka, nachdem Jindřich Saxel, ein Angestellter des Westmährischen Elektrizitätswerks, ihn im Winter 1925 gefragt hatte, wie man Südwestmähren möglichst günstig elektrifizieren könne. Vojtěch Jarník beschrieb dann 1930 den heute als Algorithmus von Prim bekannten Algorithmus, in einer Arbeit, die als Brief an Borůvka verfasst war. Joseph Kruskal veröffentlichte sein Verfahren 1956, und Robert Prim entdeckte Jarníks Algorithmus 1957 in den Bell Laboratories wieder, ebenso Edsger Dijkstra 1959. Der Algorithmus von Prim wird daher manchmal Algorithmus von Jarník oder DJP-Algorithmus genannt, obwohl „Prim“ bei Weitem der gebräuchlichste Name bleibt. Auch Borůvkas Verfahren wurde mehrfach wiederentdeckt und trägt in manchen Büchern den Namen von Sollin, der es 1961 auf einem Seminar in Paris vorstellte und nie veröffentlichte.
Die schnellsten bekannten Verfahren haben sich weit von diesen Klassikern entfernt. David Karger, Philip Klein und Robert Tarjan gaben 1995 einen randomisierten Algorithmus mit erwarteter linearer Laufzeit an. Bernard Chazelle gab im Jahr 2000 einen deterministischen Algorithmus an, der in O(E α(E, V)) läuft, wobei α die inverse Ackermann-Funktion ist, die für jeden Graphen, der je gespeichert werden könnte, höchstens 4 beträgt. 2002 fanden Seth Pettie und Vijaya Ramachandran einen Algorithmus, der beweisbar optimal ist, obwohl niemand weiß, wie groß seine Laufzeit tatsächlich ist: Sie liegt irgendwo zwischen linear und Chazelles Schranke. Der Algorithmus von Karger, Klein und Tarjan verwendet Borůvkas Runden als Baustein.
11. Wo welcher Algorithmus eingesetzt wird
- Netzwerkdesign. Das kostengünstigste Verlegen von Kabeln, Leitungen oder Straßen ist die ursprüngliche Anwendung. Reale Entwürfe fügen Nebenbedingungen hinzu, wie der Leitfaden zum Netzwerkdesign zeigt, und der minimale Spannbaum ist der übliche Ausgangspunkt.
- Clustering. Single-Linkage-Clustering ist der früh angehaltene Algorithmus von Kruskal, und deshalb ist Kruskal für diese Aufgabe die übliche Wahl. Das graphbasierte Bildsegmentierungsverfahren von Pedro Felzenszwalb und Daniel Huttenlocher verarbeitet die Kanten auf dieselbe Weise in sortierter Reihenfolge.
- Approximation schwererer Probleme. Bei nichtnegativen Gewichten kostet die beste Rundreise des Handlungsreisenden nie weniger als ein minimaler Spannbaum. Die Heuristik von Christofides geht von einem solchen Baum aus und garantiert eine Rundreise von höchstens dem 1,5-Fachen des Optimums, wenn die Distanzen die Dreiecksungleichung erfüllen.
- Geometrische Daten. Wenn jedes Punktpaar eine mögliche Kante ist, ist der Graph vollständig, und Prim mit Array ist die naheliegende Wahl.
- Paralleles Rechnen. In jeder Borůvka-Runde kann jede Gruppe unabhängig arbeiten, daher ist Borůvka der übliche Ausgangspunkt für parallele Algorithmen, während Prim und Kruskal von Natur aus sequenziell sind.
12. Häufige Fehler
| Fehler | Warum es falsch ist | Abhilfe |
|---|---|---|
| Prim auf einem unzusammenhängenden Graphen ausführen und dem Ergebnis vertrauen | Er spannt nur die Komponente des Startknotens auf | Starten Sie ihn in jeder Komponente neu, oder verwenden Sie Kruskal |
| Annehmen, dass Prim mit Heap immer am besten ist | Auf dem dichten Graphen brauchte die Array-Version nur ein Fünftel der Schritte | Verwenden Sie die Array-Version bei E nahe V2 |
| Einen minimalen Spannbaum als Menge kürzester Wege behandeln | Im Beispiel erreicht er C mit 7, doch die kürzeste Route kostet 6 | Verwenden Sie Dijkstra für Routen, einen Spannbaum für die Baukosten |
| Auf genau einen Baum testen, wenn Gewichte gleich sein können | Es kann mehrere minimale Bäume geben, und die Eingabereihenfolge wählt einen aus | Vergleichen Sie das Gesamtgewicht |
| Gleichstände bei Borůvka inkonsistent auflösen | Gruppen können Kanten wählen, die einen Kreis bilden | Vergleichen Sie nach Gewicht, dann nach einer festen Kantenreihenfolge |
| Die Algorithmen wegen negativer Gewichte meiden | Negative Gewichte beeinträchtigen keinen der drei | Führen Sie sie unverändert aus |
| Sie auf einem gerichteten Graphen ausführen | Die Schnitteigenschaft betrifft ungerichtete Kanten | Verwenden Sie den Chu-Liu/Edmonds-Algorithmus |
| Kruskal jede Kante durchsuchen lassen | Der Baum ist nach V - 1 aufgenommenen Kanten vollständig | Halten Sie an, sobald Sie sie haben |
13. Glossar
| Begriff | Bedeutung |
|---|---|
| Spannbaum | Ein Baum, der alle Knoten des Graphen enthält |
| Minimaler Spannbaum | Ein Spannbaum mit kleinstem Gesamtgewicht |
| Spannwald | Ein Spannbaum für jede Zusammenhangskomponente |
| Schnitteigenschaft | Die günstigste Kante über einen beliebigen Schnitt kann in einem minimalen Spannbaum liegen |
| Kreiseigenschaft | Die teuerste Kante eines beliebigen Kreises kann weggelassen werden |
| Union-Find | Eine Struktur, die Gruppen verwaltet und schnell verschmilzt |
| Prioritätswarteschlange | Eine Struktur, die stets den kleinsten Schlüssel liefert; meist ein binärer Heap |
| Dichter Graph | Ein Graph, in dem ein großer Anteil aller Knotenpaare durch Kanten verbunden ist |
| Dünner Graph | Ein Graph mit wenigen Kanten im Vergleich zu V2, typischerweise ein kleines Vielfaches von V |
| Single-Linkage-Clustering | Gruppieren durch wiederholtes Verbinden der beiden nächstgelegenen Gruppen |
| Engpasskante | Die schwerste Kante eines Baums |
| Arboreszenz | Ein gerichteter Baum, in dem jede Kante von einer Wurzel weg zeigt |
14. Häufig gestellte Fragen
Was ist der Unterschied zwischen dem Algorithmus von Prim und dem von Kruskal?
Der Algorithmus von Prim lässt einen zusammenhängenden Baum von einem Startknoten aus wachsen und fügt immer die günstigste Kante hinzu, die ihn verlässt. Der Algorithmus von Kruskal sortiert alle Kanten und nimmt sie von der günstigsten an aufwärts, wobei er jede Kante überspringt, die einen Kreis schließen würde; sein Baum beginnt daher als verstreute Fragmente, die verschmelzen. Beide finden einen minimalen Spannbaum mit demselben Gesamtgewicht.
Was ist besser, Prim oder Kruskal?
Das hängt vom Graphen ab. Kruskal ist die naheliegende Wahl für dünne Graphen und für Kanten, die als Liste oder bereits sortiert vorliegen. Prim mit einfachem Array ist die naheliegende Wahl für dichte Graphen, da er in O(V zum Quadrat) läuft und die Kanten nicht sortieren muss. Auf dünnen Graphen kosten Prim mit binärem Heap und Kruskal etwa gleich viel.
Liefern Prim und Kruskal denselben minimalen Spannbaum?
Wenn alle Kantengewichte verschieden sind, ist der minimale Spannbaum eindeutig, und beide liefern genau dieselben Kanten. Wenn einige Gewichte gleich sind, kann es mehrere minimale Spannbäume geben, und die beiden Algorithmen können verschiedene liefern, die aber immer dasselbe Gesamtgewicht haben.
Was ist der Algorithmus von Borůvka?
Der Algorithmus von Borůvka arbeitet in Runden. In jeder Runde wählt jede Gruppe verbundener Knoten ihre günstigste Kante zu einer anderen Gruppe, und alle diese Kanten werden auf einmal hinzugefügt. Die Anzahl der Gruppen halbiert sich in jeder Runde mindestens, daher gibt es höchstens log2 V Runden, und die Laufzeit beträgt O(E log V). Weil die Gruppen unabhängig arbeiten, eignet er sich gut für paralleles Rechnen.
Können Prim und Kruskal mit negativen Kantengewichten umgehen?
Ja. Anders als der Algorithmus von Dijkstra arbeiten Prim, Kruskal und Borůvka auch mit negativen Gewichten korrekt. Jeder Spannbaum hat genau V - 1 Kanten, daher ändert das Addieren derselben Konstante zu jedem Gewicht die Kosten jedes Baums gleichermaßen und ändert nicht, welcher Baum am günstigsten ist.
Was ist der Unterschied zwischen dem Algorithmus von Prim und dem von Dijkstra?
Ihr Code ist fast identisch, aber Prim ordnet die Knoten nach dem Gewicht der einzelnen Kante, die sie erreicht, Dijkstra dagegen nach der Gesamtdistanz von der Quelle. Prim baut den Baum mit dem kleinsten Gesamtgewicht auf. Dijkstra baut einen Baum kürzester Wege von einer Quelle auf, der insgesamt mehr kosten kann, aber kürzere Routen von dieser Quelle aus liefert.
15. Quellen
Die Algorithmen, Schranken und Zuschreibungen oben stammen aus diesen Quellen, in chronologischer Reihenfolge.
- Borůvka, O. (1926). "O jistém problému minimálním." Práce Moravské přírodovědecké společnosti 3, 37 bis 58.
- Jarník, V. (1930). "O jistém problému minimálním (Z dopisu panu O. Borůvkovi)." Práce Moravské přírodovědecké společnosti 6, 57 bis 63.
- Kruskal, J. B. (1956). "On the Shortest Spanning Subtree of a Graph and the Traveling Salesman Problem." Proceedings of the American Mathematical Society 7(1), 48 bis 50.
- Prim, R. C. (1957). "Shortest Connection Networks and Some Generalizations." Bell System Technical Journal 36(6), 1389 bis 1401.
- Dijkstra, E. W. (1959). "A Note on Two Problems in Connexion with Graphs." Numerische Mathematik 1, 269 bis 271.
- Chu, Y.-J. und Liu, T.-H. (1965). "On the Shortest Arborescence of a Directed Graph." Scientia Sinica 14, 1396 bis 1400.
- Edmonds, J. (1967). "Optimum Branchings." Journal of Research of the National Bureau of Standards 71B, 233 bis 240.
- Gower, J. C. und Ross, G. J. S. (1969). "Minimum Spanning Trees and Single Linkage Cluster Analysis." Journal of the Royal Statistical Society, Series C 18(1), 54 bis 64.
- Tarjan, R. E. (1975). "Efficiency of a Good But Not Linear Set Union Algorithm." Journal of the ACM 22(2), 215 bis 225.
- Christofides, N. (1976). Worst-Case Analysis of a New Heuristic for the Travelling Salesman Problem. Report 388. Pittsburgh: Carnegie Mellon University.
- Graham, R. L. und Hell, P. (1985). "On the History of the Minimum Spanning Tree Problem." Annals of the History of Computing 7(1), 43 bis 57.
- Fredman, M. L. und Tarjan, R. E. (1987). "Fibonacci Heaps and Their Uses in Improved Network Optimization Algorithms." Journal of the ACM 34(3), 596 bis 615.
- Karger, D. R., Klein, P. N. und Tarjan, R. E. (1995). "A Randomized Linear-Time Algorithm to Find Minimum Spanning Trees." Journal of the ACM 42(2), 321 bis 328.
- Chazelle, B. (2000). "A Minimum Spanning Tree Algorithm with Inverse-Ackermann Type Complexity." Journal of the ACM 47(6), 1028 bis 1047.
- Nešetřil, J., Milková, E. und Nešetřilová, H. (2001). "Otakar Borůvka on Minimum Spanning Tree Problem." Discrete Mathematics 233(1 bis 3), 3 bis 36.
- Pettie, S. und Ramachandran, V. (2002). "An Optimal Minimum Spanning Tree Algorithm." Journal of the ACM 49(1), 16 bis 34.
- Felzenszwalb, P. F. und Huttenlocher, D. P. (2004). "Efficient Graph-Based Image Segmentation." International Journal of Computer Vision 59(2), 167 bis 181.
- Kleinberg, J. und Tardos, É. (2005). Algorithm Design. Boston: Addison-Wesley.
- Bader, D. A. und Cong, G. (2006). "Fast Shared-Memory Algorithms for Computing the Minimum Spanning Forest of Sparse Graphs." Journal of Parallel and Distributed Computing 66(11), 1366 bis 1378.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. und Stein, C. (2009). Introduction to Algorithms, 3. Auflage. Cambridge, MA: MIT Press.
- Osipov, V., Sanders, P. und Singler, J. (2009). "The Filter-Kruskal Minimum Spanning Tree Algorithm." In Proceedings of the 11th Workshop on Algorithm Engineering and Experiments, 52 bis 61.
Sehen Sie dem Baum beim Wachsen zu
Bauen Sie die acht Dörfer im Visualisierer nach und führen Sie Prim von A aus. Führen Sie dann Kruskal auf demselben Graphen aus und vergleichen Sie die Reihenfolge, in der die Kanten erscheinen.
Visualisierer öffnen