
Inhaltsverzeichnis
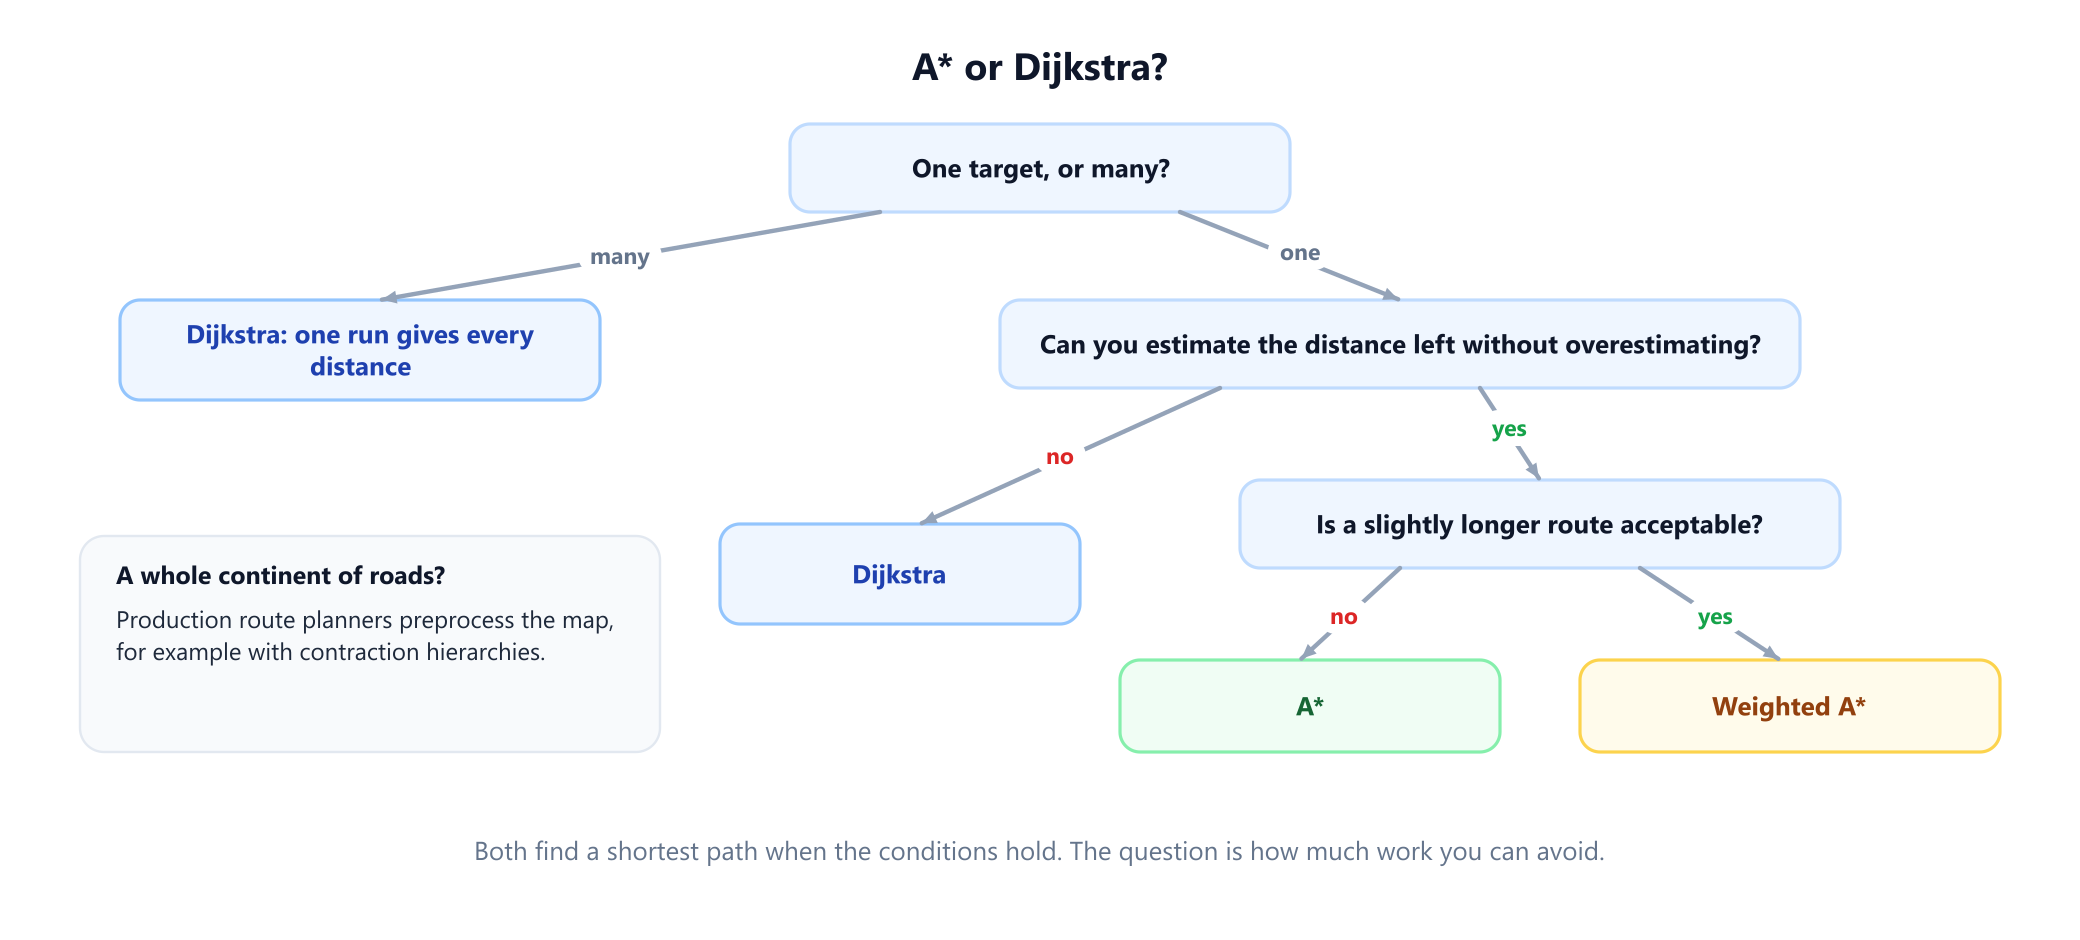
- 1. Die kurze Antwort
- 2. Eine Zeile Unterschied
- 3. Eine Karte, zwei Suchen
- 4. Warum A* trotzdem den kürzesten Weg findet
- 5. Die Heuristik ist ein Drehregler
- 6. Wie viel A* auf typischen Karten spart
- 7. Die versteckten Kosten von Gleichständen
- 8. Wann Dijkstra die bessere Wahl ist
- 9. Heuristiken, die die Garantie brechen
- 10. Wo welcher Algorithmus eingesetzt wird
- 11. Eine kurze Geschichte
- 12. Häufige Fehler
- 13. Glossar
- 14. Häufig gestellte Fragen
- 15. Quellen
1. Die kurze Antwort
Der Algorithmus von Dijkstra und A* finden beide einen kürzesten Weg in einem gewichteten Graphen mit nichtnegativen Kantengewichten. Der Unterschied liegt darin, was sie wissen. Dijkstra sucht in alle Richtungen nach außen, weil er keine Ahnung hat, wo das Ziel liegt. A* ergänzt eine Schätzung der Restdistanz und investiert seinen Aufwand daher in die Richtung, die vielversprechend aussieht.
| Dijkstra | A* | |
|---|---|---|
| Beantwortet | Von einer Quelle zu jedem Knoten oder zu einem Ziel | Von einer Quelle zu einem Ziel |
| Priorität eines Knotens | g: Distanz von der Quelle | f = g + h: bisherige Distanz plus geschätzte Restdistanz |
| Benötigt | Nichtnegative Kantengewichte | Nichtnegative Kantengewichte und eine Heuristik h |
| Kürzester Weg garantiert | Ja | Ja, wenn h nie überschätzt |
| Erkundete Knoten | Alles, was näher liegt als das Ziel | Meist weit weniger; wie viele, bestimmt h |
| Schlechtester Fall auf einem expliziten Graphen | O((V + E) log V) | Genauso, wenn ein konsistentes h in konstanter Zeit berechnet wird |
| Wählen, wenn | Sie viele Ziele brauchen oder keine brauchbare Schätzung haben | Sie eine Route wollen und die Distanz schätzen können |
In einem Satz: Verwenden Sie A* für eine einzelne Route auf einer Karte, wo Koordinaten eine gute Schätzung liefern, und Dijkstra dann, wenn Sie Distanzen zu vielen Orten brauchen oder nichts verrät, in welcher Richtung das Ziel liegt. Die beiden sind weniger Rivalen als vielmehr derselbe Algorithmus mit unterschiedlichen Informationen, wie der nächste Abschnitt zeigt. Für den Vergleich von Dijkstra mit Verfahren, die negative Gewichte verarbeiten, siehe Dijkstra vs Bellman-Ford vs Floyd-Warshall.
2. Eine Zeile Unterschied
Beide Algorithmen führen eine Prioritätswarteschlange von Knoten und expandieren wiederholt den mit der niedrigsten Priorität. Wir schreiben g(v) für die Kosten der besten bisher gefundenen Route vom Start bis v und h(v) für eine Schätzung der Kosten von v bis zum Ziel, die sogenannte Heuristik.
Dijkstra:   Priorität(v) = g(v)
A*:         Priorität(v) = g(v) + h(v)
Das ist der ganze Unterschied. Setzt man h(v) = 0 für jeden Knoten, wird A* zum Algorithmus von Dijkstra. Jede Aussage über Dijkstra ist also eine Aussage über A* mit der am wenigsten informativen Heuristik, die möglich ist, und alles, was A* gewinnt, stammt von h. Der Leitfaden zum Algorithmus von Dijkstra und der Leitfaden zum A*-Suchalgorithmus erklären beide Schritt für Schritt.
Die Auswirkung auf die Suche ist geometrisch. Dijkstra expandiert Knoten in der Reihenfolge ihrer Distanz vom Start, daher wächst der erkundete Bereich wie ein Kreis. A* expandiert in der Reihenfolge der geschätzten Gesamtlänge einer Route durch den jeweiligen Knoten, sodass Knoten in der falschen Richtung einen hohen Prioritätswert bekommen und in der Warteschlange liegen bleiben. Aus dem Kreis wird eher ein schmales Band vom Start zum Ziel.
3. Eine Karte, zwei Suchen
Das durchgehende Beispiel ist ein Raster aus 288 Zellen mit einer becherförmigen Wand aus 24 blockierten Zellen. Ein Roboter startet bei S und muss G erreichen und bewegt sich dabei um je eine Zelle nach oben, unten, links oder rechts, zu Kosten von 1 pro Schritt. Die Wand erzwingt einen Umweg: Auf einem leeren Raster wäre G 22 Schritte entfernt, die kürzeste Route braucht aber 26. Die Heuristik ist die Manhattan-Distanz, also die Anzahl der Zeilen plus die Anzahl der Spalten zwischen einer Zelle und dem Ziel. Sie ignoriert Wände und kann deshalb nie überschätzen.
import heapq

MAP = ["........................",
       "..........#########.....",
       "..S...............#.....",
       "..................#.....",
       "..................#.....",
       "..................#..G..",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "............#######.....",
       "........................"]

def locate(grid, ch):
    return next((r, row.index(ch)) for r, row in enumerate(grid) if ch in row)

def search(grid, start, goal, h, weight=1):
    """Best-First-Suche nach f = g + weight * h. Mit h = 0 ist das Dijkstra."""
    g = {start: 0}
    done, count = set(), 0
    heap = [(weight * h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue                                   # veralteter Eintrag
        done.add(u)
        if u == goal:
            return g[u], len(done)                     # Routenkosten, expandierte Knoten
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < len(grid) and 0 <= v[1] < len(grid[0]) and grid[v[0]][v[1]] != '#':
                if g[u] + 1 < g.get(v, float('inf')):
                    g[v] = g[u] + 1
                    count += 1
                    heapq.heappush(heap, (g[v] + weight * h(v), count, v))
    return None

S, G = locate(MAP, 'S'), locate(MAP, 'G')
manhattan = lambda v: abs(v[0] - G[0]) + abs(v[1] - G[1])

print('Dijkstra        ', search(MAP, S, G, lambda v: 0))
# Dijkstra         (26, 232)
print('A* (Manhattan)  ', search(MAP, S, G, manhattan))
# A* (Manhattan)   (26, 149)
for w in (2, 5):
    print(f'weighted A*, w={w}', search(MAP, S, G, manhattan, weight=w))
# weighted A*, w=2 (26, 124)
# weighted A*, w=5 (26, 116)
print('greedy best-first', search(MAP, S, G, manhattan, weight=1000))
# greedy best-first (46, 108)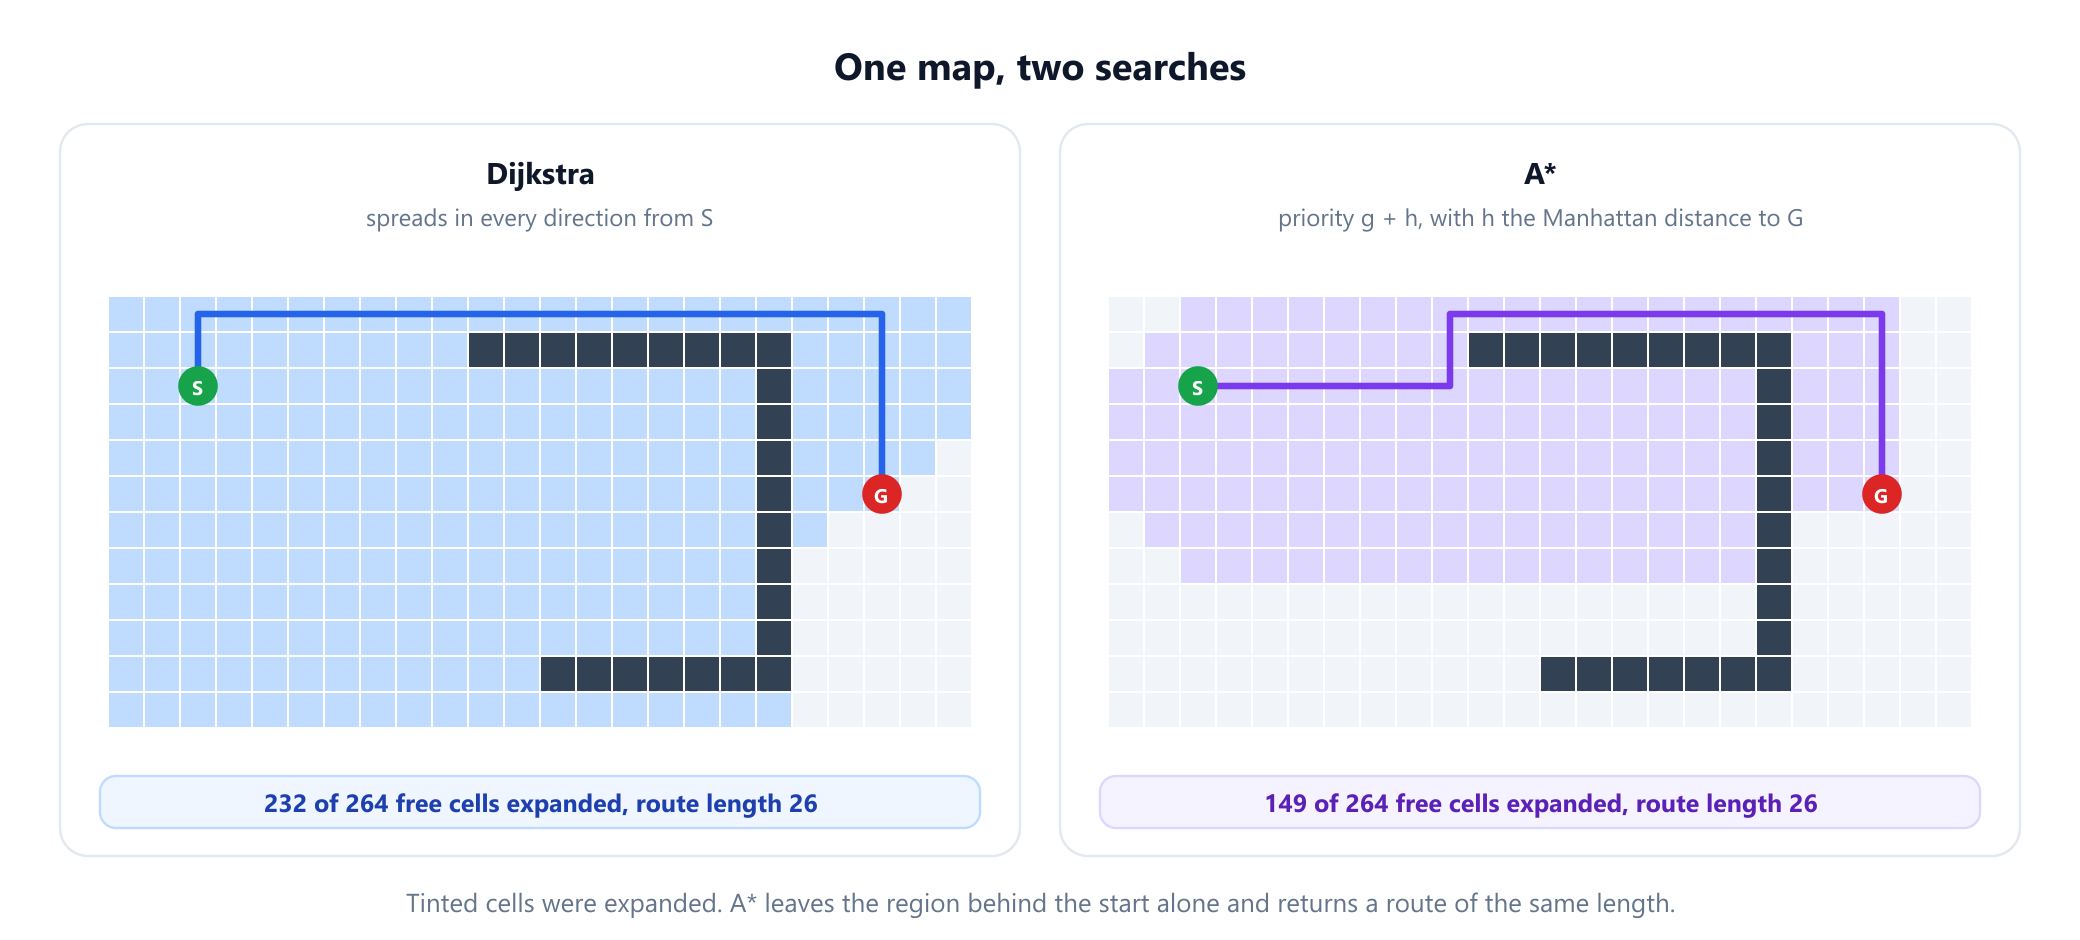
Beide liefern eine Route der Länge 26. Dijkstra expandiert 232 der 264 freien Zellen, bevor er G erreicht, darunter Zellen ganz links, die nirgendwohin führen. A* expandiert 149. Er braucht nicht alle 232, weil jede Zelle, deren Wert f größer als 26 ist, nie auf einer kürzesten Route liegen kann und A* solche Zellen gar nicht erreicht, bevor er fertig ist.
Diese Einsparung von 36 % ist bescheiden, denn diese Karte wurde gebaut, um die Heuristik zu täuschen: Im Inneren des Bechers verspricht die Manhattan-Distanz immer wieder einen geraden Weg durch die Wand. Abschnitt 6 misst A* auf 800 weniger feindseligen Routen.
4. Warum A* trotzdem den kürzesten Weg findet
Eine Schätzung klingt riskant. Die Garantie beruht auf einer einzigen Bedingung. Eine Heuristik ist zulässig genau dann, wenn sie die tatsächlichen Restkosten nie überschätzt. Angenommen, A* beendet die Suche gerade am Ziel mit einer Route der Kosten C, obwohl eine günstigere Route der Kosten C* < C existiert. Ein Knoten n auf dieser günstigeren Route wartet noch in der Warteschlange, und weil h nie überschätzt, gilt f(n) = g(n) + h(n) ≤ C*. Also ist f(n) kleiner als die Priorität des Ziels, also C, und A* hätte n zuerst expandiert. Die günstigere Route kann nicht übersehen werden.
Eine stärkere Bedingung macht die Implementierung einfach. Eine Heuristik ist konsistent genau dann, wenn für jede Kante von u nach v mit Gewicht w die Ungleichung h(u) ≤ w + h(v) gilt: Ein Schritt über eine Kante senkt die Schätzung nie um mehr, als diese Kante kostet. Mit einer konsistenten Heuristik muss A* einen Knoten nie zweimal expandieren, genau wie Dijkstra. A* mit einer konsistenten Heuristik ist tatsächlich der Algorithmus von Dijkstra, angewandt auf die umgewichteten Kanten w'(u, v) = w(u, v) - h(u) + h(v), die alle nichtnegativ sind. Der Leitfaden zu A* in der KI liefert den vollständigen Beweis und ein Gegenbeispiel für Heuristiken, die zulässig, aber nicht konsistent sind.
A* ist in einem präzisen Sinn auch so sparsam, wie eine sichere Suche in nur einer Richtung sein kann. Rina Dechter und Judea Pearl zeigten 1985: Ist die Heuristik konsistent, dann muss jeder Algorithmus, der Knoten vom Start aus nach außen expandiert, dieselbe Heuristik verwendet und immer dann garantiert einen kürzesten Weg findet, wenn die Heuristik nie überschätzt, jeden Knoten expandieren, den A* mit Sicherheit expandiert, also jeden Knoten, den irgendein Weg vom Start aus mit f unter den optimalen Kosten erreicht. Nur die Behandlung von Gleichständen lässt Raum für Besseres, und Suchen in beide Richtungen fallen nicht unter dieses Ergebnis.
5. Die Heuristik ist ein Drehregler
Zwischen „weiß nichts“ und „weiß alles“ liegt eine ganze Bandbreite an Verhalten, und derselbe Code deckt sie ab, mit einem Gewicht w in f = g + w * h. Die Ausgabe des Programms aus Abschnitt 3 zeigt, was im Beispiel passiert:
| Suche | Priorität | Expandierte Zellen | Routenlänge | Garantie |
|---|---|---|---|---|
| Dijkstra | g | 232 | 26 | Kürzeste Route |
| A* | g + h | 149 | 26 | Kürzeste Route |
Gewichteter A*, w = 2 | g + 2h | 124 | 26 | Höchstens das 2-Fache der kürzesten |
Gewichteter A*, w = 5 | g + 5h | 116 | 26 | Höchstens das 5-Fache der kürzesten |
| Greedy-Best-First | h | 108 | 46 | Keine |
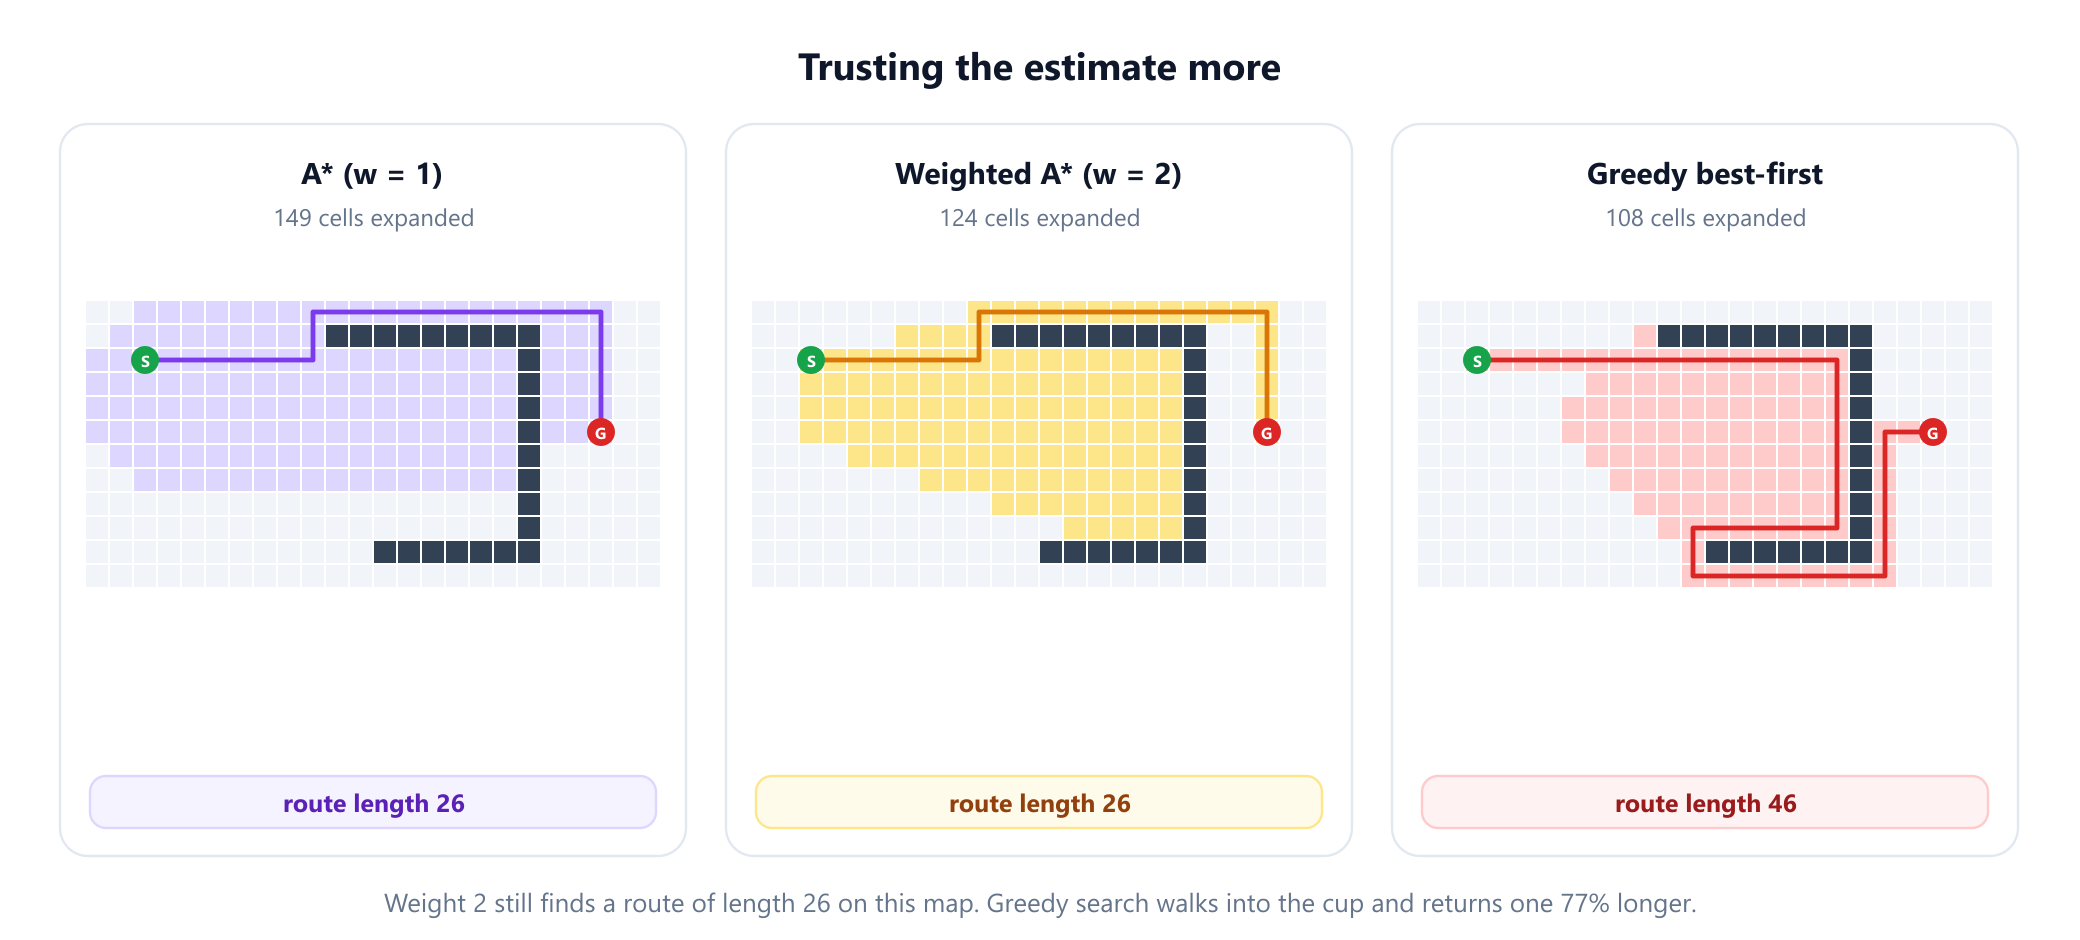
Gewichteter A* gibt die Garantie kontrolliert auf: Mit einer konsistenten h ist die Route, die er liefert, höchstens w mal so lang wie die kürzeste. Auf dieser Karte finden die Gewichte 2 und 5 zufällig trotzdem eine Route der Länge 26, mit weniger Arbeit. Die Greedy-Best-First-Suche, die g vollständig ignoriert, spart nur wenig mehr und läuft geradewegs in den Becher, mit einer Route von 46 Schritten, 77 % länger als nötig. Die Arbeit, die sie spart, ist klein im Vergleich zur Qualität, die sie verliert.
Am anderen Ende des Reglers würde eine perfekte Heuristik, also eine, die immer genau den tatsächlichen Restkosten entspricht, A* fast direkt zum Ziel führen. Je näher eine zulässige h der Wahrheit kommt, desto weniger expandiert A*. Deshalb ist der Entwurf der Heuristik wichtiger als jedes Implementierungsdetail.
6. Wie viel A* auf typischen Karten spart
Eine Karte beweist wenig. Das folgende Programm vergleicht die beiden Suchen über je 200 zufällige Routen auf vier Arten von Karten: 60-mal-60-Raster ohne Wände, mit 20 % und mit 35 % Wänden sowie ein Straßennetz aus 1.500 Städten an zufälligen Positionen, jede mit ihren 4 nächsten Nachbarn durch eine Straße verbunden, die bis zu 40 % länger ist als die Luftlinie. Auf den Rastern ist die Heuristik die Manhattan-Distanz, auf den Straßen die Luftlinie. Dijkstra hält an, sobald er das Ziel erreicht, damit der Vergleich fair bleibt.
import heapq, math, random

def search(neighbours, start, goal, h):
    """A*; für Dijkstra h = lambda v: 0 übergeben. Liefert (Kosten, expandierte Knoten)."""
    g, done, count = {start: 0}, set(), 0
    heap = [(h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return g[u], len(done)
        for v, w in neighbours(u):
            if g[u] + w < g.get(v, float('inf')):
                g[v] = g[u] + w
                count += 1
                heapq.heappush(heap, (g[v] + h(v), count, v))
    return None

def compare(neighbours, h_for, pairs):
    """Mittlere Expansionen von Dijkstra und A* über die verbundenen Paare."""
    dij = star = runs = 0
    for s, t in pairs:
        d = search(neighbours, s, t, lambda v: 0)
        if d is None:
            continue
        a = search(neighbours, s, t, h_for(t))
        assert abs(a[0] - d[0]) < 1e-9                 # immer dieselben Kosten
        dij += d[1]; star += a[1]; runs += 1
    return dij // runs, star // runs

def grid_trial(density, rnd, n=60, trials=200):
    wall = {(r, c) for r in range(n) for c in range(n) if rnd.random() < density}
    free = [(r, c) for r in range(n) for c in range(n) if (r, c) not in wall]
    def neighbours(u):
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < n and 0 <= v[1] < n and v not in wall:
                yield v, 1
    h_for = lambda t: lambda v: abs(v[0] - t[0]) + abs(v[1] - t[1])
    return compare(neighbours, h_for, [rnd.sample(free, 2) for _ in range(trials)])

def road_trial(rnd, n=1500, trials=200):
    """Städte an zufälligen Punkten, jede mit ihren 4 nächsten verbunden; Straßen sind bis zu 40 % länger als die Luftlinie."""
    pts = [(rnd.random(), rnd.random()) for _ in range(n)]
    adj = [{} for _ in range(n)]
    for i, p in enumerate(pts):
        for j in sorted((j for j in range(n) if j != i), key=lambda j: math.dist(p, pts[j]))[:4]:
            w = math.dist(p, pts[j]) * rnd.uniform(1.0, 1.4)
            adj[i][j] = adj[j][i] = min(w, adj[i].get(j, w))
    neighbours = lambda u: adj[u].items()
    h_for = lambda t: lambda v: math.dist(pts[v], pts[t])
    return compare(neighbours, h_for, [rnd.sample(range(n), 2) for _ in range(trials)])

rnd = random.Random(1)
for density in (0.0, 0.2, 0.35):
    print(f'grid 60x60, {density:.0%} walls:', grid_trial(density, rnd))
print('road network, 1500 towns:', road_trial(rnd))
# grid 60x60, 0% walls: (1767, 451)
# grid 60x60, 20% walls: (1312, 238)
# grid 60x60, 35% walls: (1105, 397)
# road network, 1500 towns: (731, 235)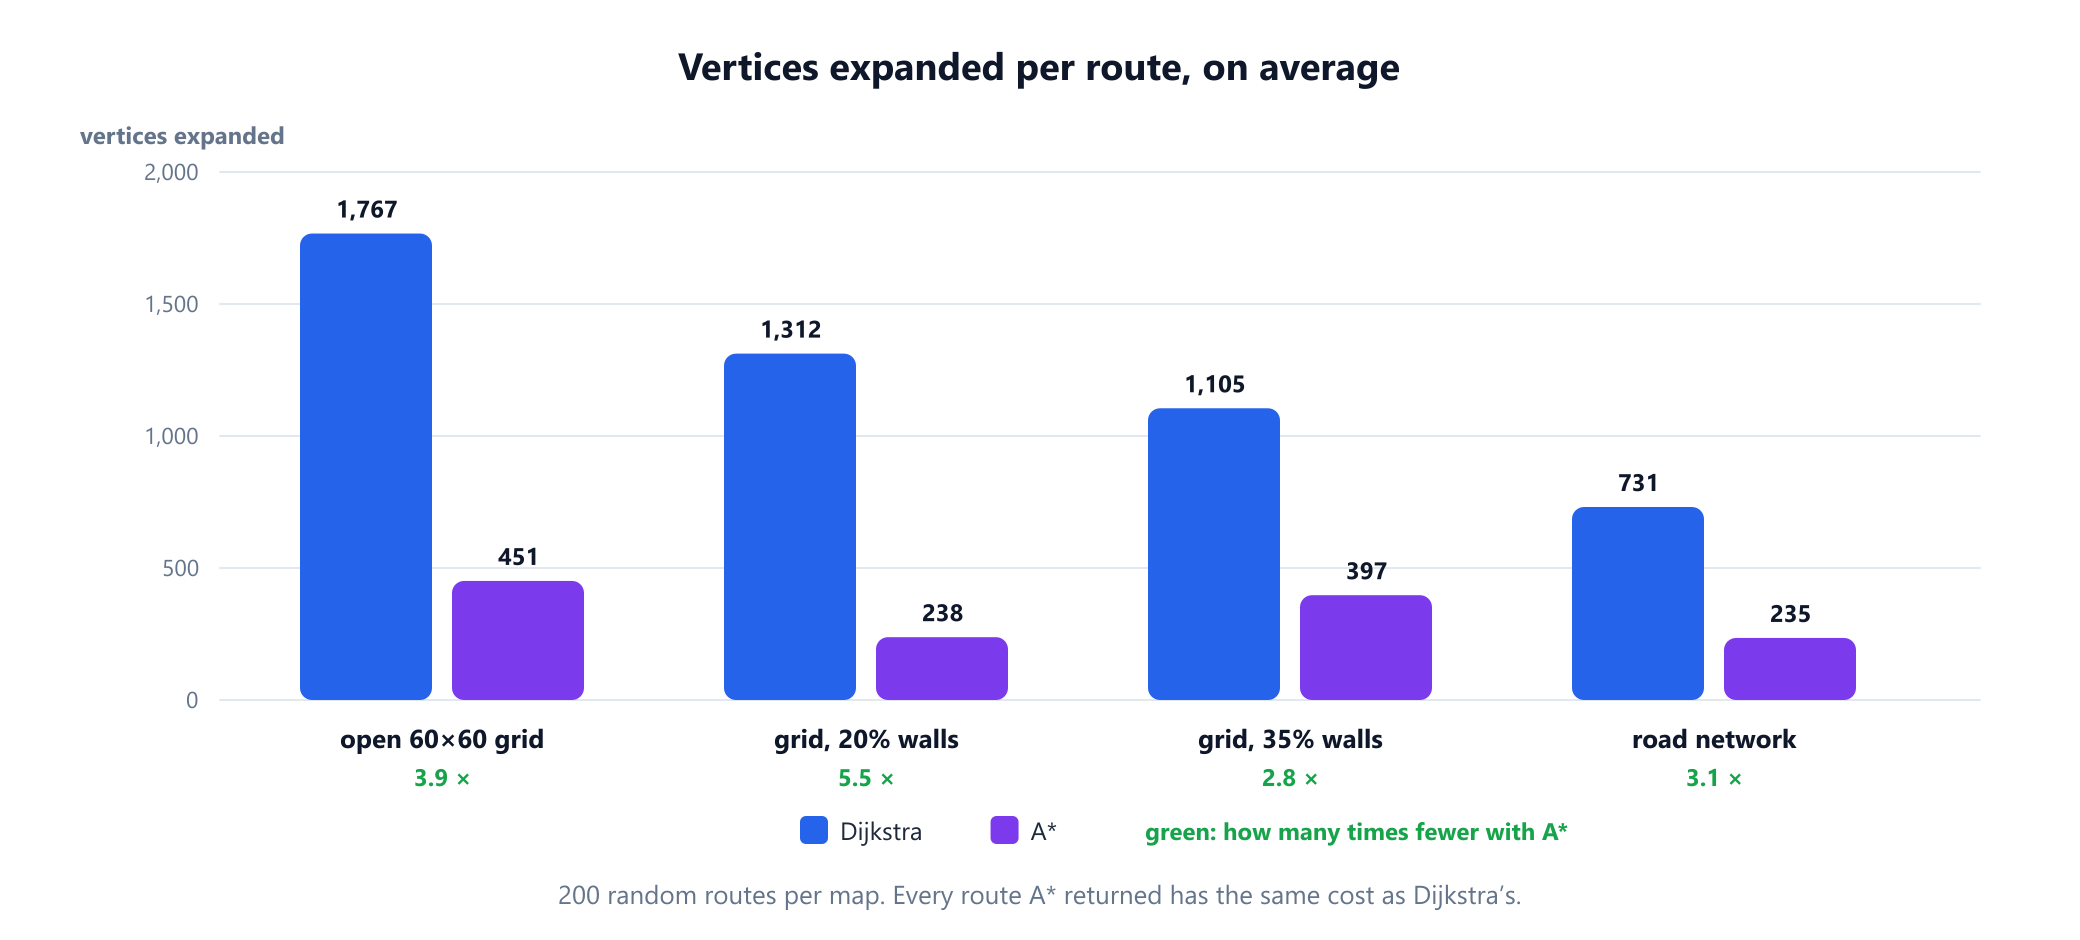
Auf jedem Kartentyp expandierte A* etwa ein Drittel bis ein Fünftel dessen, was Dijkstra expandierte, und lieferte auf jeder Route exakt dieselben Kosten; das Programm prüft das bei jedem Lauf. Die Einsparung ist bei 20 % Wänden am größten (etwa das 5,5-Fache). Auf dem leeren Raster ist sie nur wegen der in Abschnitt 7 beschriebenen Gleichstände kleiner, und bei 35 % Wänden (das 2,8-Fache) machen die häufigen Umwege die Schätzung ungenauer. Im Straßennetz beträgt die Einsparung etwa das 3-Fache, weil Straßen sich winden und die Luftlinie eine Unterschätzung ist.
Weniger expandierte Knoten bedeuten nicht automatisch weniger Zeit. A* muss h für jeden Knoten berechnen, den er berührt, und die Prioritätswarteschlange enthält mehr Einträge mit ähnlichen Prioritäten. Auf diesen Karten ist die Heuristik eine Zeile Arithmetik, die Einsparung ist also real. Eine Heuristik, die teuer zu berechnen ist, kann den Vorteil wieder zunichtemachen.
7. Die versteckten Kosten von Gleichständen
Auf einem Raster ohne Wände haben sehr viele Zellen genau denselben Wert f und die Reihenfolge, in der A* sie abarbeitet, entscheidet alles. Das folgende Programm lässt A* von Ecke zu Ecke über ein leeres 40-mal-40-Raster laufen, mit drei verschiedenen Regeln zur Gleichstandsauflösung.
import heapq

def expansions(n, tie):
    """A* über ein leeres n-mal-n-Raster, von Ecke zu Ecke. tie(h, count) ordnet gleiche f-Werte."""
    goal = (n - 1, n - 1)
    h = lambda v: abs(v[0] - goal[0]) + abs(v[1] - goal[1])
    g, done, count = {(0, 0): 0}, set(), 0
    heap = [(h((0, 0)), tie(h((0, 0)), 0), (0, 0))]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return len(done)
        r, c = u
        for v in ((r - 1, c), (r, c + 1), (r + 1, c), (r, c - 1)):
            if 0 <= v[0] < n and 0 <= v[1] < n and g[u] + 1 < g.get(v, float('inf')):
                g[v] = g[u] + 1
                count += 1
                heapq.heappush(heap, (g[v] + h(v), tie(h(v), count), v))

n = 40
print('oldest entry first  ', expansions(n, lambda h, c: (c,)))
print('newest entry first  ', expansions(n, lambda h, c: (-c,)))
print('closest to the goal ', expansions(n, lambda h, c: (h, c)))
# oldest entry first   1600
# newest entry first   79
# closest to the goal  79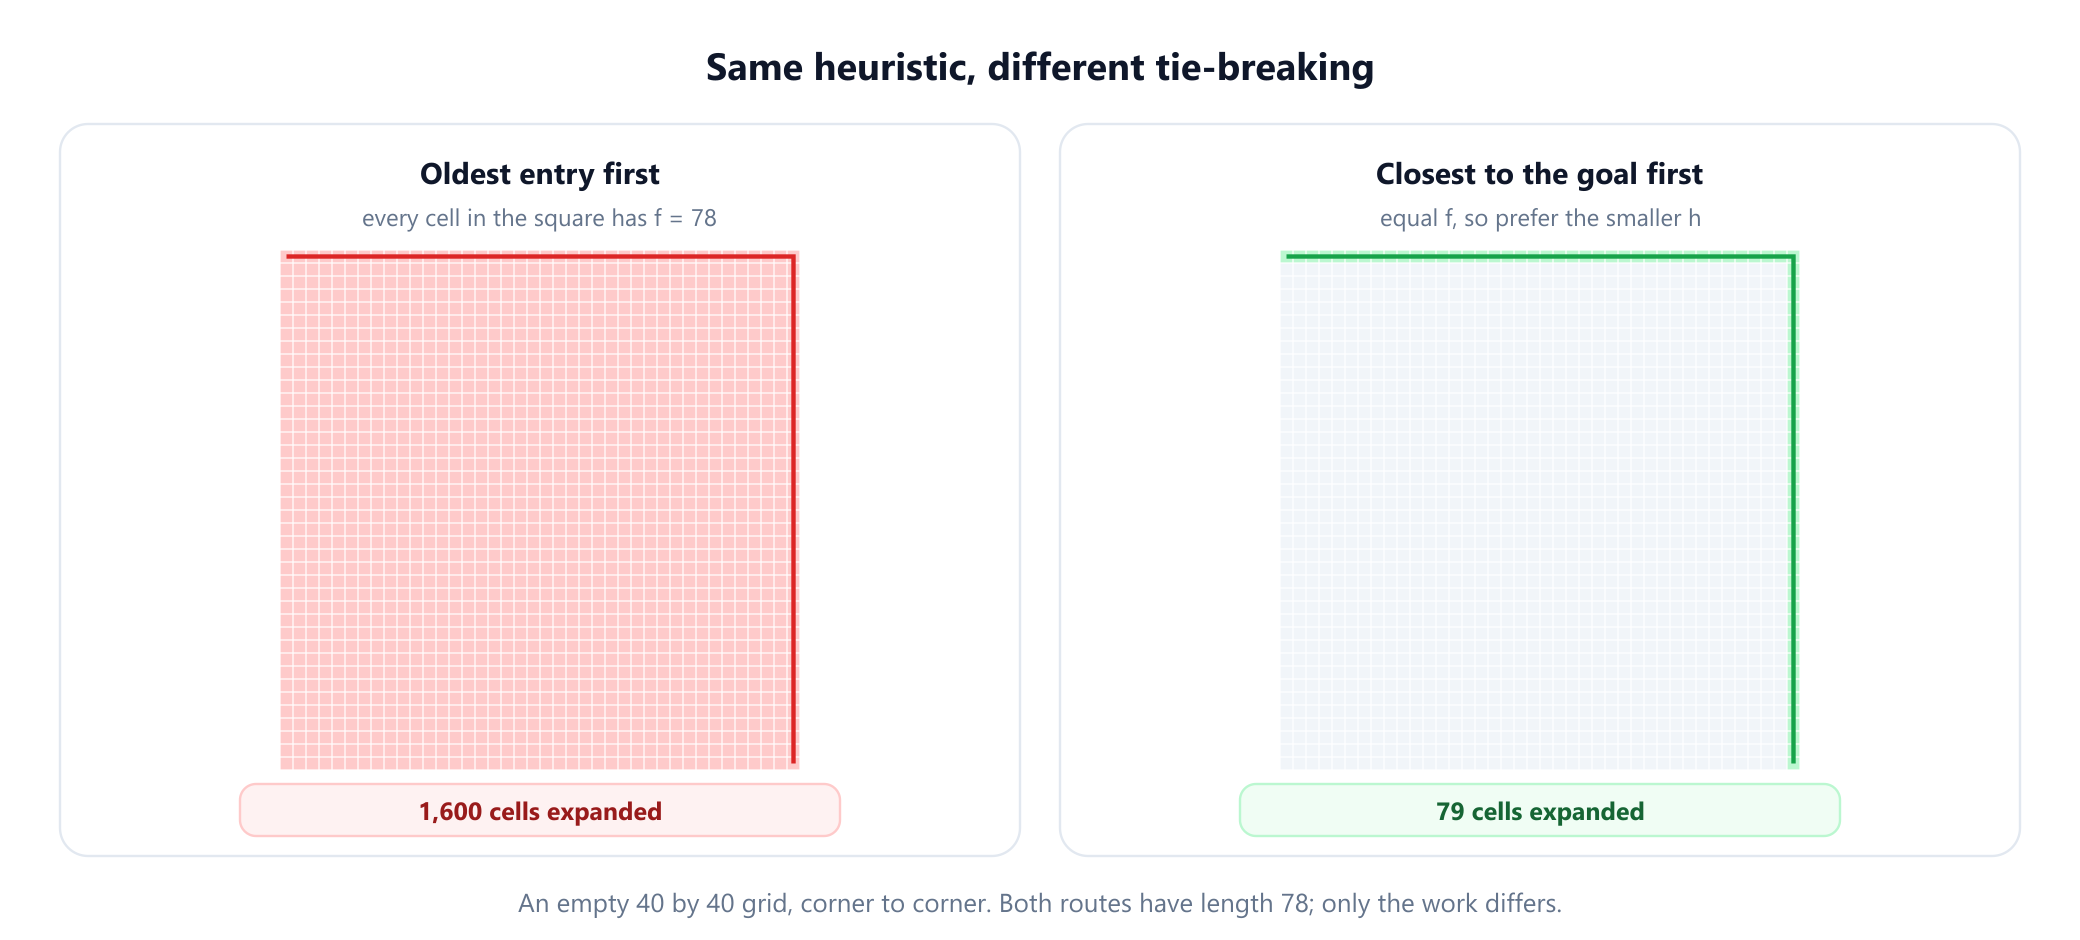
Werden Gleichstände zugunsten des ältesten Eintrags aufgelöst, expandiert A* alle 1.600 Zellen, nicht besser als Dijkstra. Bevorzugt man die Zelle mit dem kleineren h, also die mit dem größeren g, dann expandiert er 79, die Zellen einer einzigen Route; den neuesten Eintrag zuerst zu nehmen, führt hier zufällig zum selben Ergebnis. Jede Zelle im Quadrat liegt auf irgendeiner kürzesten Route, daher haben alle f = 78; die Regel entscheidet lediglich, ob all diese gleich guten Routen erkundet werden oder ob man sich auf eine festlegt. Beim Vergleich von A*-Implementierungen kann die Regel zur Gleichstandsauflösung wichtiger sein als die Datenstruktur.
8. Wann Dijkstra die bessere Wahl ist
- Sie brauchen viele Ziele. Ein einziger Dijkstra-Lauf von einer Quelle liefert die Distanz zu jedem Knoten. Führt man A* einmal pro Ziel aus, wiederholt sich Arbeit, und eine auf ein Ziel ausgerichtete Heuristik nützt für die anderen nichts.
- Es gibt keine sinnvolle Schätzung. A* braucht eine Vorstellung davon, wie weit das Ziel entfernt ist. In einem sozialen Netzwerk, einem Zitationsgraphen oder einem Abhängigkeitsgraphen gibt es keine Koordinaten, von denen aus man messen könnte, und
h = 0macht A* wieder zu Dijkstra mit zusätzlicher Buchführung. - Das Ziel ist von allem aus nah. Wenn das Ziel nahe am Start liegt oder der Graph klein ist, gibt es wenig zu sparen.
- Die Antwort wird wiederverwendet. Eine Distanztabelle oder ein Baum kürzester Wege, einmal von Dijkstra berechnet, kann viele spätere Anfragen von derselben Quelle bedienen.
- Sie wollen den einfachsten korrekten Code. Dijkstra hat keine Heuristik, die entworfen werden muss oder falsch sein kann.
Und manche Probleme brauchen keinen von beiden. Wenn jede Kante gleich zählt, findet die Breitensuche kürzeste Routen ohne jede Prioritätswarteschlange, wie BFS vs DFS erklärt.
9. Heuristiken, die die Garantie brechen
A* ist nur so vertrauenswürdig wie seine Heuristik, und der klassische Fehler besteht darin, eine zu verwenden, die für andere Schritte entworfen wurde. Die Manhattan-Distanz ist sicher, wenn man sich nur in vier Richtungen bewegen kann. Erlaubt man diagonale Schritte, überschätzt sie, denn ein diagonaler Schritt legt zurück, was sie als zwei zählt. Die korrekte Schätzung für Bewegung in acht Richtungen ist die Oktil-Distanz. Das nächste Programm verwendet auf derselben Karte gerade Schritte mit Kosten 10 und diagonale Schritte mit Kosten 14.
import heapq

MAP = ["........................",
       "..........#########.....",
       "..S...............#.....",
       "..................#.....",
       "..................#.....",
       "..................#..G..",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "..................#.....",
       "............#######.....",
       "........................"]
STEPS = [(-1, 0, 10), (0, 1, 10), (1, 0, 10), (0, -1, 10), (-1, 1, 14), (1, 1, 14), (1, -1, 14), (-1, -1, 14)]

def search(start, goal, h):
    """A* mit 8 Richtungen: gerade Schritte kosten 10, diagonale 14."""
    g, done, count = {start: 0}, set(), 0
    heap = [(h(start), count, start)]
    while heap:
        _, _, u = heapq.heappop(heap)
        if u in done:
            continue
        done.add(u)
        if u == goal:
            return g[u], len(done)
        for dr, dc, w in STEPS:
            v = (u[0] + dr, u[1] + dc)
            if 0 <= v[0] < len(MAP) and 0 <= v[1] < len(MAP[0]) and MAP[v[0]][v[1]] != '#':
                if g[u] + w < g.get(v, float('inf')):
                    g[v] = g[u] + w
                    count += 1
                    heapq.heappush(heap, (g[v] + h(v), count, v))

S, G = (1, 19), (10, 0)                        # von rechts oben nach links unten, um die Wand herum
def manhattan(v):
    return 10 * (abs(v[0] - G[0]) + abs(v[1] - G[1]))
def octile(v):
    dr, dc = abs(v[0] - G[0]), abs(v[1] - G[1])
    return 10 * max(dr, dc) + 4 * min(dr, dc)

print('Dijkstra ', search(S, G, lambda v: 0))
print('octile   ', search(S, G, octile))
print('Manhattan', search(S, G, manhattan))
# Dijkstra  (234, 261)
# octile    (234, 21)
# Manhattan (288, 45)
Dijkstra und A* mit der Oktil-Distanz finden beide die wirklich kürzeste Route mit Kosten 234, und A* braucht nur 21 Expansionen statt 261. Die Manhattan-Distanz liefert eine Route mit Kosten 288, 23 % zu lang, und warnt nicht. Eine überschätzende Heuristik ist schnell und falsch zugleich, weshalb der Fehler leicht übersehen wird.
Zwei verwandte Fallen sind wissenswert. Eine Heuristik kann zulässig und trotzdem inkonsistent sein; in diesem Fall muss ein Knoten unter Umständen mehrmals expandiert werden: Eine Implementierung mit einer geschlossenen Menge, die Knoten nicht wieder öffnet, wie die hier gezeigten, kann dann eine Route liefern, die nicht die kürzeste ist. Und negative Kantengewichte brechen beide Algorithmen; dazu siehe den Bellman-Ford-Algorithmus.
10. Wo welcher Algorithmus eingesetzt wird
- Spiele. A* auf Rastern und Navigationsnetzen ist der Standard für die Bewegung von Einheiten. Jump Point Search von Daniel Harabor und Alban Grastien beschleunigt A* auf uniformen Rastern, indem Zellen übersprungen werden, die durch symmetrische Routen überflüssig sind.
- Robotik. A* wurde genau dafür geschaffen: Peter Hart, Nils Nilsson und Bertram Raphael entwickelten ihn am Stanford Research Institute, und der IEEE Milestone für den Roboter Shakey schreibt ihn diesem Projekt zu.
- Netzwerke. Link-State-Routingprotokolle wie OSPF verwenden Dijkstra, weil jeder Router Routen zu allen Zielen braucht und nicht nur zu einem.
- Straßenrouting im Kontinentmaßstab. Reiner Dijkstra und reiner A* sind beide zu langsam für einen ganzen Kontinent. Die öffentlich dokumentierten Systeme im Kontinentmaßstab bereiten die Karte vor. Contraction Hierarchies fügen vorab Abkürzungskanten hinzu, und ALT kombiniert A* mit Distanzen zu einigen ausgewählten Landmarken, um eine bessere Heuristik zu erhalten.
- Rätsel und Planung. A* und seine speichersparende Variante IDA*, die auf Richard Korf zurückgeht, lösen Probleme wie das Schiebepuzzle, bei denen der Graph viel zu groß zum Speichern ist und während der Suche erzeugt wird.
Oft ist der Speicher die eigentliche Grenze. Beide Algorithmen speichern jeden erreichten Knoten, daher kann A* auf riesigen impliziten Graphen der Speicher ausgehen, lange bevor die Zeit knapp wird. Für diesen Fall wurde IDA* gebaut.
11. Eine kurze Geschichte
Edsger Dijkstra veröffentlichte seinen Algorithmus 1959. Neun Jahre später veröffentlichten Hart, Nilsson und Raphael A* in „A Formal Basis for the Heuristic Determination of Minimum Cost Paths“, und 1972 veröffentlichten sie eine kurze Korrektur zur Rolle der Konsistenz in ihrem Optimalitätsbeweis. Ira Pohl untersuchte 1970 gewichtete Bewertungsfunktionen. Dechter und Pearl legten 1985 genau dar, in welchem Sinn A* optimal ist. Die beiden Algorithmen werden oft als Fortschritt dargestellt, aber wie Abschnitt 2 gezeigt hat, enthält A* Dijkstra als Spezialfall h = 0.
12. Häufige Fehler
| Fehler | Warum es falsch ist | Abhilfe |
|---|---|---|
| A* für viele Ziele verwenden | Die Heuristik zielt auf ein Ziel, und die Arbeit wiederholt sich für jedes | Dijkstra einmal von der Quelle aus ausführen |
| Manhattan-Distanz bei diagonalen Schritten verwenden | Sie überschätzt und liefert im Beispiel 288 statt 234 | Die Oktil-Distanz verwenden |
| Annehmen, A* sei immer schneller | Mit h = 0 oder einem teuren h ist die Arbeit gleich groß oder größer | Messen und die Heuristik billig halten |
| Gleichstände ignorieren | Auf einem offenen 40-mal-40-Raster macht die Regel aus 1.600 Expansionen 79 | Bei Gleichstand gewinnt das kleinere h |
| Mit einem Dijkstra vergleichen, der nicht am Ziel anhält | Ein vollständiger Lauf erkundet den ganzen Graphen und übertreibt die Einsparung | Dijkstra anhalten, wenn das Ziel expandiert wird |
| Greedy-Best-First als schnelleren A* behandeln | Sie hat keine Garantie und lieferte 46 Schritte statt 26 | Gewichteten A* verwenden, wenn Sie einen begrenzten Kompromiss wollen |
| Geschlossene Menge mit inkonsistenter Heuristik verwenden | Eine bessere Route zu einem geschlossenen Knoten wird verworfen | Konsistente Heuristik verwenden oder erneutes Öffnen erlauben |
| Einen von beiden auf negativen Kanten ausführen | Beide setzen voraus, dass die Kosten entlang einer Route nie sinken | Bellman-Ford oder den Algorithmus von Johnson verwenden |
13. Glossar
| Begriff | Bedeutung |
|---|---|
| g(v) | Die Kosten der besten bisher gefundenen Route vom Start bis v |
| h(v) | Die Heuristik: eine Schätzung der Kosten von v bis zum Ziel |
| f(v) | g(v) + h(v), die geschätzten Gesamtkosten einer Route durch v |
| Expansion | Einen Knoten aus der Warteschlange nehmen und seine Nachbarn untersuchen |
| Zulässige Heuristik | Eine, die die tatsächlichen Restkosten nie überschätzt |
| Konsistente Heuristik | Eine mit h(u) ≤ w + h(v) für jede Kante |
| Manhattan-Distanz | Zeilen plus Spalten zwischen zwei Zellen; sicher bei Bewegung in vier Richtungen |
| Oktil-Distanz | Die Rasterdistanz, wenn diagonale Schritte erlaubt sind |
| Gewichteter A* | A* mit f = g + w * h, der Routenqualität gegen Tempo tauscht |
| Greedy-Best-First-Suche | Suche, die allein nach h geordnet ist, ohne Garantie |
| Gleichstandsauflösung | Die Regel, die Knoten mit gleichem Wert f ordnet |
| IDA* | Eine auf Tiefensuche basierende Variante von A*, die sehr wenig Speicher braucht |
14. Häufig gestellte Fragen
Was ist der Unterschied zwischen A* und Dijkstra?
Dijkstra ordnet Knoten nach g, der Distanz vom Start. A* ordnet sie nach f = g + h, wobei h eine Schätzung der verbleibenden Distanz zum Ziel ist. Mit h = 0 sind beide derselbe Algorithmus. Die Schätzung erlaubt A*, sich auf die Richtung des Ziels zu konzentrieren, sodass er meist weit weniger Knoten erkundet und trotzdem einen kürzesten Weg findet.
Ist A* immer schneller als Dijkstra?
Nicht immer. A* expandiert meist weit weniger Knoten, wenn es eine gute Schätzung gibt: auf den hier gemessenen Zufallskarten etwa drei- bis fünfeinhalbmal weniger. Mit einer Heuristik von null, einer langsam zu berechnenden Heuristik oder schlechter Gleichstandsauflösung kann er genauso viel Arbeit leisten wie Dijkstra oder mehr. Ein einzelner Dijkstra-Lauf ist außerdem besser, wenn Sie Distanzen zu vielen Zielen brauchen.
Findet A* immer den kürzesten Weg?
Nur wenn die Heuristik zulässig ist, also die tatsächlichen Restkosten nie überschätzt. Kann sie überschätzen, liefert A* womöglich ohne jede Warnung eine längere Route. Eine Implementierung, die Knoten nie wieder öffnet, braucht außerdem eine konsistente Heuristik, das heißt, h(u) ist für jede Kante höchstens w(u, v) + h(v).
Ist A* dasselbe wie Dijkstra mit einer Heuristik?
Ja, in einem präzisen Sinn. A* mit h = 0 ist der Algorithmus von Dijkstra, und A* mit einer konsistenten Heuristik verhält sich genau wie Dijkstra auf den umgewichteten Kanten w(u, v) - h(u) + h(v), die alle nichtnegativ sind.
Wann sollte ich Dijkstra statt A* verwenden?
Verwenden Sie Dijkstra, wenn Sie Distanzen von einer Quelle zu vielen oder allen Knoten brauchen, wenn es keine brauchbare Schätzung der Restdistanz gibt, etwa in sozialen Graphen oder Abhängigkeitsgraphen, oder wenn der einfachste korrekte Code am wichtigsten ist. Verwenden Sie A*, wenn Sie eine Route zu einem Ziel wollen und die Distanz schätzen können, zum Beispiel anhand von Koordinaten auf einer Karte.
Was ist die beste Heuristik für A* auf einem Raster?
Das hängt von den Schritten ab. Verwenden Sie die Manhattan-Distanz bei Bewegung in vier Richtungen und die Oktil-Distanz, wenn diagonale Schritte erlaubt sind. Die Manhattan-Distanz mit diagonalen Schritten überschätzt und kann eine zu lange Route liefern. Gleichstände zugunsten des Knotens aufzulösen, der näher am Ziel liegt, macht auf offenen Rastern ebenfalls einen großen Unterschied.
15. Quellen
Die oben genannten Algorithmen, Ergebnisse und Zuschreibungen stammen aus diesen Quellen, in chronologischer Reihenfolge.
- Dijkstra, E. W. (1959). "A Note on Two Problems in Connexion with Graphs." Numerische Mathematik 1, 269 bis 271.
- Hart, P. E., Nilsson, N. J. und Raphael, B. (1968). "A Formal Basis for the Heuristic Determination of Minimum Cost Paths." IEEE Transactions on Systems Science and Cybernetics 4(2), 100 bis 107.
- Pohl, I. (1970). "Heuristic Search Viewed as Path Finding in a Graph." Artificial Intelligence 1(3 bis 4), 193 bis 204.
- Hart, P. E., Nilsson, N. J. und Raphael, B. (1972). "Correction to 'A Formal Basis for the Heuristic Determination of Minimum Cost Paths'." SIGART Newsletter 37, 28 bis 29.
- Pearl, J. (1984). Heuristics: Intelligent Search Strategies for Computer Problem Solving. Reading, MA: Addison-Wesley.
- Dechter, R. und Pearl, J. (1985). "Generalized Best-First Search Strategies and the Optimality of A*." Journal of the ACM 32(3), 505 bis 536.
- Korf, R. E. (1985). "Depth-First Iterative-Deepening: An Optimal Admissible Tree Search." Artificial Intelligence 27(1), 97 bis 109.
- Moy, J. (1998). "OSPF Version 2." RFC 2328. Internet Engineering Task Force.
- Goldberg, A. V. und Harrelson, C. (2005). "Computing the Shortest Path: A* Search Meets Graph Theory." In Proceedings of the 16th ACM-SIAM Symposium on Discrete Algorithms, 156 bis 165.
- Geisberger, R., Sanders, P., Schultes, D. und Delling, D. (2008). "Contraction Hierarchies: Faster and Simpler Hierarchical Routing in Road Networks." In Experimental Algorithms, Lecture Notes in Computer Science 5038, 319 bis 333.
- Thayer, J. T. und Ruml, W. (2008). "Faster than Weighted A*: An Optimistic Approach to Bounded Suboptimal Search." In Proceedings of the 18th International Conference on Automated Planning and Scheduling, 355 bis 362.
- Harabor, D. und Grastien, A. (2011). "Online Graph Pruning for Pathfinding on Grid Maps." In Proceedings of the 25th AAAI Conference on Artificial Intelligence, 1114 bis 1119.
- Bast, H., Delling, D., Goldberg, A., Müller-Hannemann, M., Pajor, T., Sanders, P., Wagner, D. und Werneck, R. F. (2016). "Route Planning in Transportation Networks." In Algorithm Engineering, Lecture Notes in Computer Science 9220, 19 bis 80.
Lassen Sie beide auf Ihrer eigenen Karte gegeneinander antreten
Zeichnen Sie eine Wand in den A*-Visualisierer und beobachten Sie, wie weit sich die Suche ausbreitet. Führen Sie dann Dijkstra auf demselben Graphen aus und vergleichen Sie, wie viele Knoten jeder besucht.
Visualisierer öffnen