
目录
1. 简短的答案
Prim 算法、Kruskal 算法和 Borůvka 算法都用来求最小生成树,即连接带权图所有顶点的最便宜的边集。它们的构建顺序不同,这决定了各自适合什么样的图。这个问题本身的介绍见最小生成树指南。
| Prim | Kruskal | Borůvka | |
|---|---|---|---|
| 策略 | 从起始顶点向外生长一棵树 | 按权重从小到大取边,跳过会形成环的边 | 每个组同时选出自己最便宜的外连边 |
| 主要数据结构 | 优先队列,或普通数组 | 已排序的边列表和并查集 | 并查集,或重新标号 |
| 时间 | O(E log V) (二叉堆)或 O(V2) (数组) | O(E log E),若边已排序则接近线性 | O(E log V) |
| 适合的输入形式 | 邻接表或邻接矩阵 | 边列表 | 边列表 |
| 非连通图 | 只覆盖起始顶点所在的连通分量 | 得到生成森林 | 得到生成森林 |
| 最适合 | 稠密图,使用数组版本 | 稀疏图、已排序的边、聚类 | 并行与分布式计算 |
这里 V 是顶点数, E 是边数。一句话概括: Kruskal 适用于稀疏图或以边列表给出的图, Prim 适用于稠密图或以矩阵给出的图, Borůvka 则在工作必须分配给多个处理器时值得考虑。在稀疏图上,Kruskal 和使用堆的 Prim 代价差不多,所以选择对你的数据来说代码更简单的那个即可。
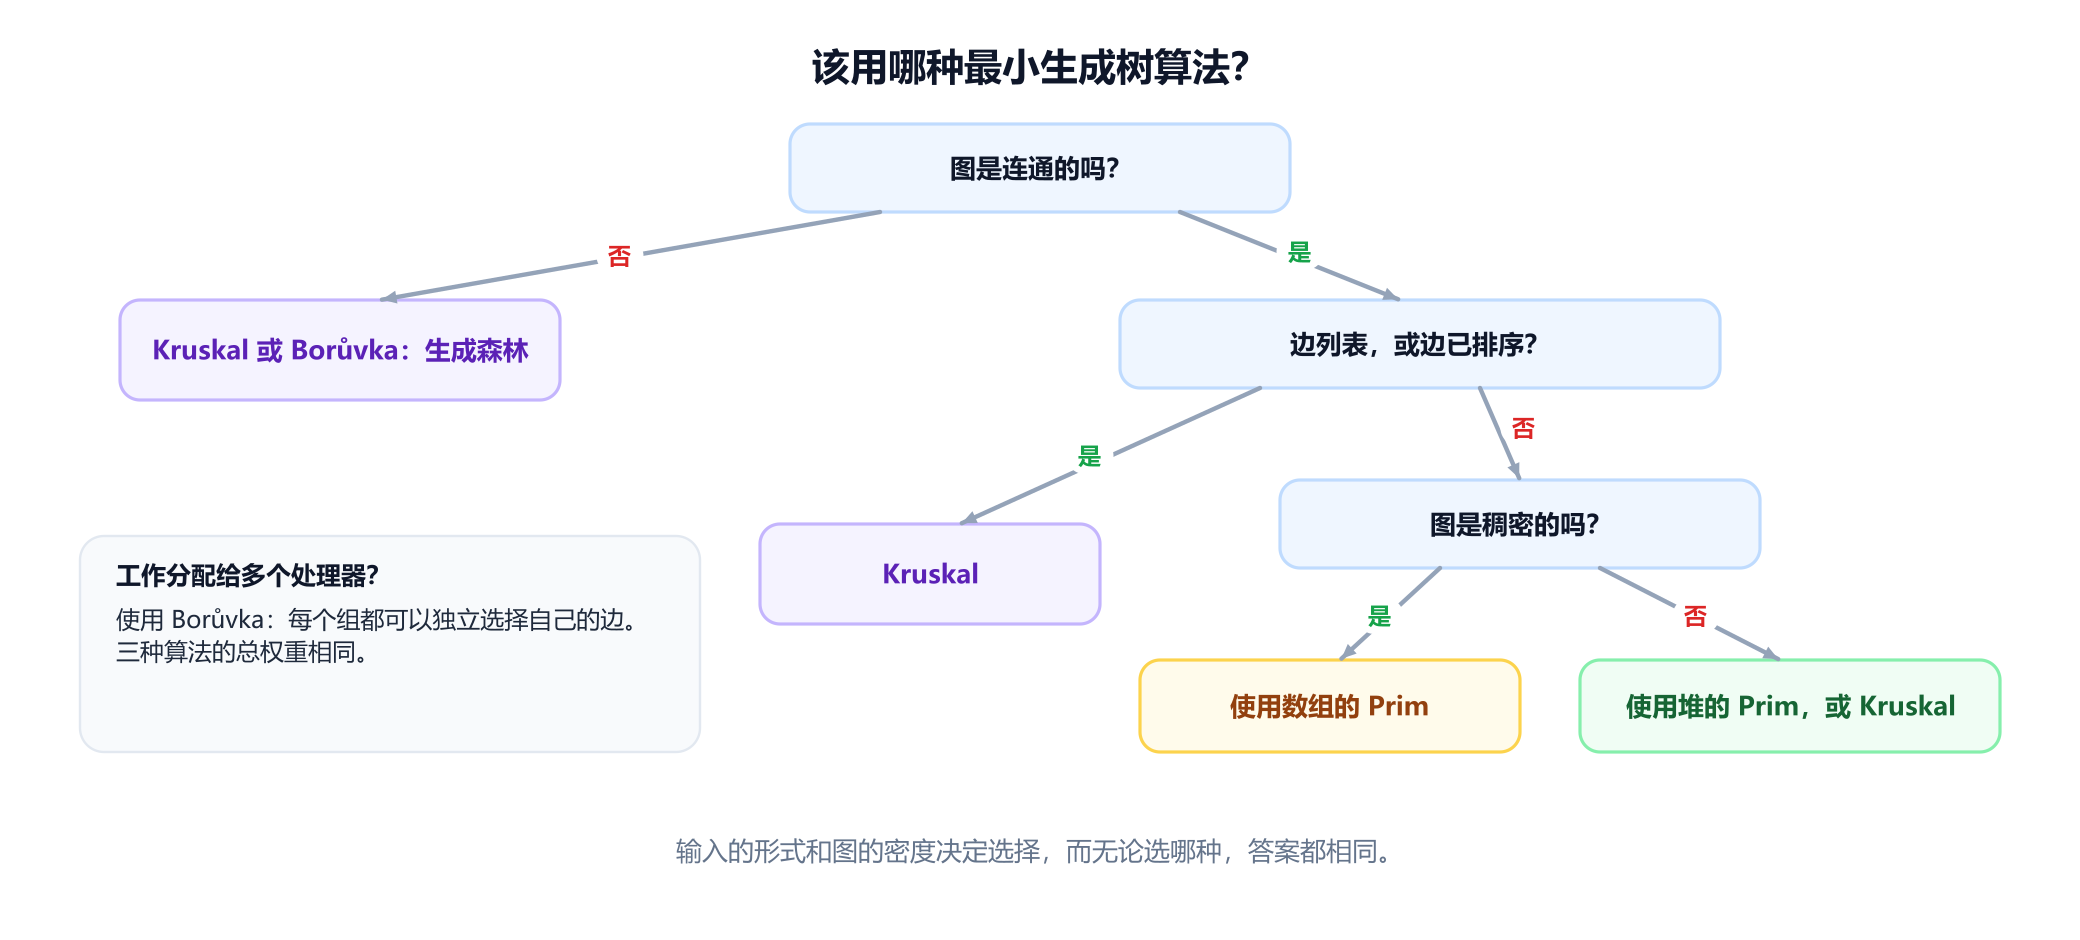
2. 一张图,三次运行
八个村庄 A 到 H要用输水管道连接起来。共有 14 条可选路线,每条路线的成本是要挖的沟渠公里数,最终每个村庄都必须与其他所有村庄连通。全部 14 条路线加起来的成本是 117。
A-B 3    A-C 6    B-C 4    B-D 13   C-D 7    C-E 12   D-E 2
D-F 11   E-F 8    E-G 14   E-H 5    F-G 1    F-H 15   G-H 16

8 个村庄,14 条可选管道
最便宜的连接方案恰好使用 7 条管道,比村庄数少一条,因为任何多余的管道都会形成一个环,而去掉环上的一条管道就能省钱。这张图有 712 棵生成树,其中恰好有一棵达到最低成本 30。下面的程序实现了全部三种算法,并在这张图上运行。
import heapq

PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

class Groups:
    """并查集:每个顶点在哪个组中?"""
    def __init__(self, items):
        self.parent = {x: x for x in items}
    def find(self, x):
        while self.parent[x] != x:
            self.parent[x] = self.parent[self.parent[x]]   # 路径减半
            x = self.parent[x]
        return x
    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False
        self.parent[ra] = rb
        return True

def vertices(edges):
    return sorted({x for u, v, _ in edges for x in (u, v)})

def prim(edges, start):
    """生长一棵树:始终加入离开这棵树的最便宜的边。"""
    adj = {v: [] for v in vertices(edges)}
    for u, v, w in edges:
        adj[u].append((w, u, v))
        adj[v].append((w, v, u))
    seen, heap, tree = {start}, list(adj[start]), []
    heapq.heapify(heap)
    while heap:
        w, u, v = heapq.heappop(heap)
        if v in seen:
            continue                                  # 两个端点都已在树中
        seen.add(v)
        tree.append((u, v, w))
        for e in adj[v]:
            if e[2] not in seen:
                heapq.heappush(heap, e)
    return tree

def kruskal(edges):
    """按权重从小到大取边,跳过会形成环的边。"""
    groups, tree = Groups(vertices(edges)), []
    for u, v, w in sorted(edges, key=lambda e: e[2]):
        if groups.union(u, v):
            tree.append((u, v, w))
    return tree

def boruvka(edges):
    """每一轮中,每个组同时选出自己最便宜的外连边。"""
    groups, tree, rounds = Groups(vertices(edges)), [], []
    while True:
        cheapest = {}
        for u, v, w in edges:
            ru, rv = groups.find(u), groups.find(v)
            if ru != rv:
                for r in (ru, rv):                    # 所有地方都用同样的方式打破平局
                    if r not in cheapest or (w, u, v) < cheapest[r]:
                        cheapest[r] = (w, u, v)
        if not cheapest:
            return tree, rounds
        added = []
        for w, u, v in sorted(set(cheapest.values())):
            if groups.union(u, v):
                added.append((u, v, w))
        tree += added
        rounds.append(added)

def show(tree):
    return ' '.join(f'{u}{v}:{w}' for u, v, w in tree) + f'   total {sum(w for *_, w in tree)}'

print('Prim    ', show(prim(PIPES, 'A')))
# Prim     AB:3 BC:4 CD:7 DE:2 EH:5 EF:8 FG:1   total 30
print('Kruskal ', show(kruskal(PIPES)))
# Kruskal  FG:1 DE:2 AB:3 BC:4 EH:5 CD:7 EF:8   total 30
tree, rounds = boruvka(PIPES)
print('Boruvka ', show(tree))
# Boruvka  FG:1 DE:2 AB:3 BC:4 EH:5 CD:7 EF:8   total 30
for i, added in enumerate(rounds, 1):
    print('round', i, show(added))
# round 1 FG:1 DE:2 AB:3 BC:4 EH:5   total 15
# round 2 CD:7 EF:8   total 15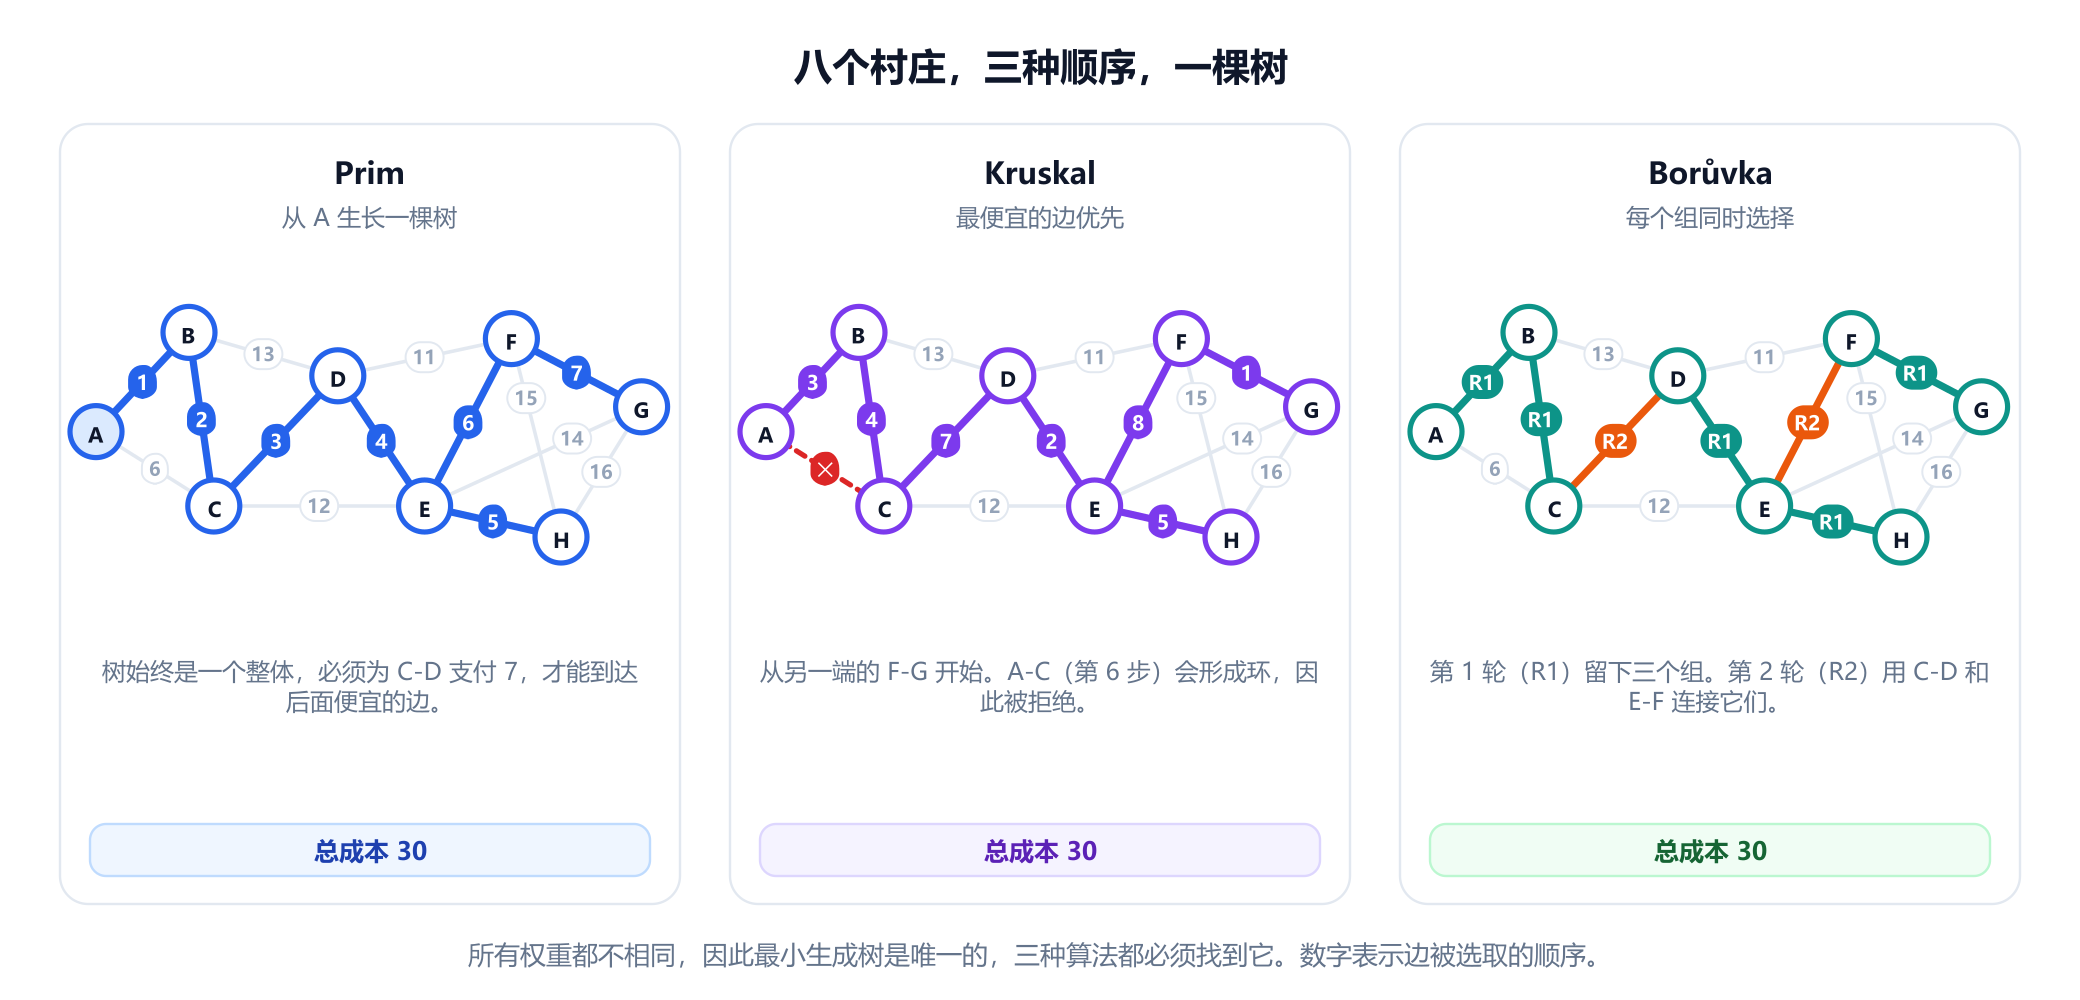
这三种顺序说明了每种方法的特点:
- Prim 从
A开始,始终扩展它手上的那一棵树。它依次选取A-B(权重 3)、B-C(权重 4),然后必须为C-D支付 7,才能到达D-E和F-G这些更远处的便宜的边。 - Kruskal 不管地理位置。它首先选取位于图另一端的
F-G(权重 1),然后沿着价格表逐级向上。当轮到A-C(权重 6)时,A和C已经通过B相连,所以它拒绝这条管道。选取E-F(权重 8)之后,它已有 7 条管道,可以停止,根本不用查看最贵的六条路线。 - Borůvka 按轮工作。第 1 轮中,每个村庄选出自己最便宜的管道,得到五条不同的管道和三个组:
{A, B, C}、{D, E, H}和{F, G}。第 2 轮中,每个组选出通往其他组的最便宜的管道,C-D和E-F完成了全部工作。
3. 为什么三种算法都正确
尽管看起来各不相同,这三种算法都依赖关于割的同一个事实。割把顶点分成两组,详见最小割指南。割性质指出:对于任意一个割,穿过它的最便宜的边属于某棵最小生成树;当所有权重都不相同时,它属于每一棵最小生成树。证明用的是交换论证。取一棵不使用这条边的生成树,把这条边加进去:这会形成一个环,这个环必定在另一条更贵的边上再次穿过这个割,去掉这条更贵的边就得到一棵更便宜的树。
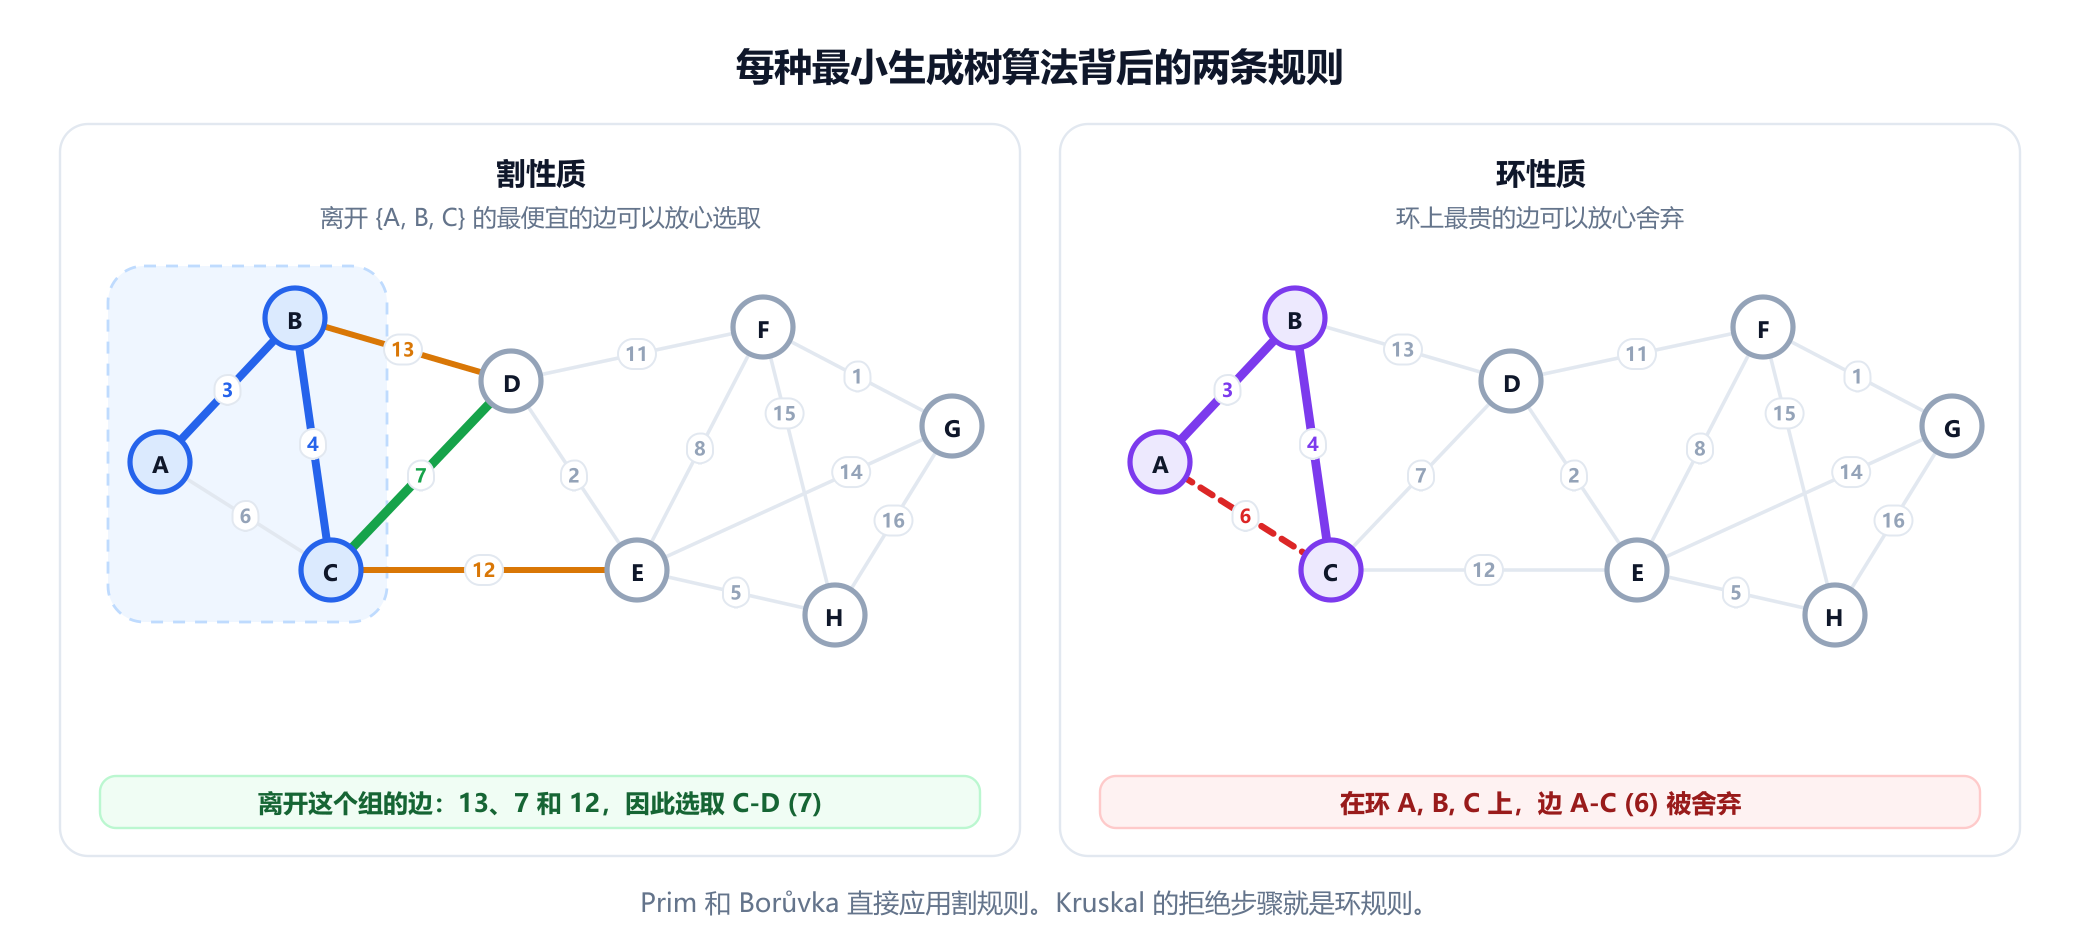
每种算法把这条规则应用于不同的割:
- Prim 使用它的树与其余所有顶点之间的割。在图中,树
{A, B, C}可以沿三条边向外延伸,其中最便宜的C-D(权重 7)被加入。 - Kruskal 使用这条边所连接的两个组之一周围的割。边按权重递增的顺序选取,因此当一条边连接两个组时,离开其中任何一组的边都不会比它更便宜。
- Borůvka 对每个组使用围绕该组的割,所有组同时进行。
与之对称的是环性质:任何环上最贵的边都可以不放入最小生成树。这正是 Kruskal 的拒绝步骤。当 A-C (权重 6)将形成环 A, B, C时,它是这个环上最贵的边,因为环上其他每条边都更早被选取。最小生成树从不需要这条边。
4. 什么时候得到的树不同
如果所有边的权重都不相同,最小生成树就是唯一的,因此三种算法必须返回完全相同的边,示例中正是如此。如果存在相等的权重,可能有多棵最小生成树,它们的总权重相同,而你得到哪一棵取决于算法,甚至取决于输入顺序。把 A-C 的成本改为 4,与 B-C相同,就恰好有两棵最小生成树:
PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

def kruskal(edges):
    parent = {x: x for u, v, _ in edges for x in (u, v)}
    def find(x):
        while parent[x] != x:
            x = parent[x]
        return x
    tree = []
    for u, v, w in sorted(edges, key=lambda e: e[2]):  # 稳定排序:相等的元素保持输入顺序
        if find(u) != find(v):
            parent[find(u)] = find(v)
            tree.append(u + v)
    return sorted(tree), sum(w for u, v, w in edges if u + v in tree)

tied = [(u, v, 4 if (u, v) == ('A', 'C') else w) for u, v, w in PIPES]   # A-C 现在的成本是 4,与 B-C 相同
print(kruskal(tied))
# (['AB', 'AC', 'CD', 'DE', 'EF', 'EH', 'FG'], 30)
print(kruskal(tied[::-1]))
# (['AB', 'BC', 'CD', 'DE', 'EF', 'EH', 'FG'], 30)
两棵树的成本都是 30,只有一条管道不同。Python 的排序是稳定的,所以相等的边保持输入顺序,把列表反转就会改变两者中哪一条先被选取。如果你的测试比较树的确切边集,正确的程序也可能无法通过;应改为比较总权重。
权重相同也是 Borůvka 算法的经典 bug 来源。当两个组各自在权重相等的边之间选择时,不一致的选择可能产生环。上面的程序通过在所有地方都比较 (w, u, v) 来避免这一问题,这样每个组打破平局的方式都相同。
5. 速度:哪个更快,什么时候更快
| 版本 | 时间 | 时间花在哪里 |
|---|---|---|
| Prim,二叉堆 | O(E log V) | 每条边最多一次堆操作 |
| Prim,普通数组 | O(V2) | 每加入一个顶点就扫描一遍所有剩余顶点 |
| Prim,Fibonacci 堆 | O(E + V log V) | 理论上快,实践中常数很大 |
| Kruskal | O(E log E) | 排序;此后的并查集操作几乎是线性的 |
| Borůvka | O(E log V) | 最多 log2 V 轮,每轮扫描所有边 |
由于 E 最多为 V2, log E 最多为 2 log V,所以 O(E log E) 和 O(E log V) 属于同一类别。仅凭公式无法区分这些方法,所以下面的程序在两个有 1,000 个顶点的随机图上统计基本步数,即比较次数、边检查次数和并查集跳转次数。一个是稀疏图,有 3,000 条边;另一个是稠密图,有 249,750 条边,占所有可能顶点对的一半。
import heapq, random
from functools import cmp_to_key

def random_graph(n, m, seed):
    """连通图:一棵随机生成树加上随机的额外边,权重各不相同。"""
    rnd = random.Random(seed)
    order = list(range(n))
    rnd.shuffle(order)
    pairs = {tuple(sorted((order[i], order[rnd.randrange(i)]))) for i in range(1, n)}
    while len(pairs) < m:
        u, v = rnd.sample(range(n), 2)
        pairs.add((min(u, v), max(u, v)))
    weights = rnd.sample(range(1, 10 * m), m)
    return [(u, v, w) for (u, v), w in zip(sorted(pairs), weights)]

class Item:
    """一个堆条目,统计堆比较它的次数。"""
    compared = 0
    def __init__(self, w, v):
        self.w, self.v = w, v
    def __lt__(self, other):
        Item.compared += 1
        return self.w < other.w

def prim_heap(n, edges):
    adj = [[] for _ in range(n)]
    for u, v, w in edges:
        adj[u].append((w, v))
        adj[v].append((w, u))
    Item.compared = 0
    seen, steps = {0}, len(adj[0])
    heap = [Item(w, v) for w, v in adj[0]]
    heapq.heapify(heap)
    while heap:
        item = heapq.heappop(heap)
        if item.v in seen:
            continue
        seen.add(item.v)
        for w, v in adj[item.v]:
            steps += 1                                # 检查了一条边
            if v not in seen:
                heapq.heappush(heap, Item(w, v))
    return steps + Item.compared

def prim_array(n, edges):
    """不用堆的 Prim:扫描每个剩余顶点的当前最优成本。"""
    adj = [[] for _ in range(n)]
    for u, v, w in edges:
        adj[u].append((w, v))
        adj[v].append((w, u))
    best, done, steps = [float('inf')] * n, [False] * n, 0
    best[0] = 0
    for _ in range(n):
        left = [v for v in range(n) if not done[v]]
        u = min(left, key=best.__getitem__)
        steps += len(left)
        done[u] = True
        for w, v in adj[u]:
            steps += 1
            if not done[v] and w < best[v]:
                best[v] = w
    return steps

def kruskal(n, edges):
    compared = [0]
    def cmp(a, b):
        compared[0] += 1
        return a[2] - b[2]
    parent, steps = list(range(n)), 0
    def find(x):
        nonlocal steps
        while parent[x] != x:
            steps += 1
            parent[x] = parent[parent[x]]
            x = parent[x]
        steps += 1
        return x
    for u, v, w in sorted(edges, key=cmp_to_key(cmp)):
        ru, rv = find(u), find(v)
        if ru != rv:
            parent[ru] = rv
    return compared[0] + steps

def boruvka(n, edges):
    parent, steps = list(range(n)), 0
    def find(x):
        nonlocal steps
        while parent[x] != x:
            steps += 1
            parent[x] = parent[parent[x]]
            x = parent[x]
        steps += 1
        return x
    while True:
        cheapest = {}
        for u, v, w in edges:
            ru, rv = find(u), find(v)
            if ru != rv:
                for r in (ru, rv):
                    steps += 1
                    if r not in cheapest or w < cheapest[r][2]:
                        cheapest[r] = (u, v, w)
        if not cheapest:
            return steps
        for u, v, w in set(cheapest.values()):
            ru, rv = find(u), find(v)
            if ru != rv:
                parent[ru] = rv

n = 1000
for name, m in [('sparse', 3 * n), ('dense', n * (n - 1) // 4)]:
    edges = random_graph(n, m, seed=1)
    print(f'{name:6} E={m:6,}  Prim heap {prim_heap(n, edges):9,}  Prim array {prim_array(n, edges):9,}  '
          f'Kruskal {kruskal(n, edges):9,}  Boruvka {boruvka(n, edges):9,}')
# sparse E= 3,000  Prim heap    46,360  Prim array   506,500  Kruskal    44,414  Boruvka    73,486
# dense  E=249,750  Prim heap 5,231,906  Prim array 1,000,000  Kruskal 5,151,232  Boruvka 7,417,850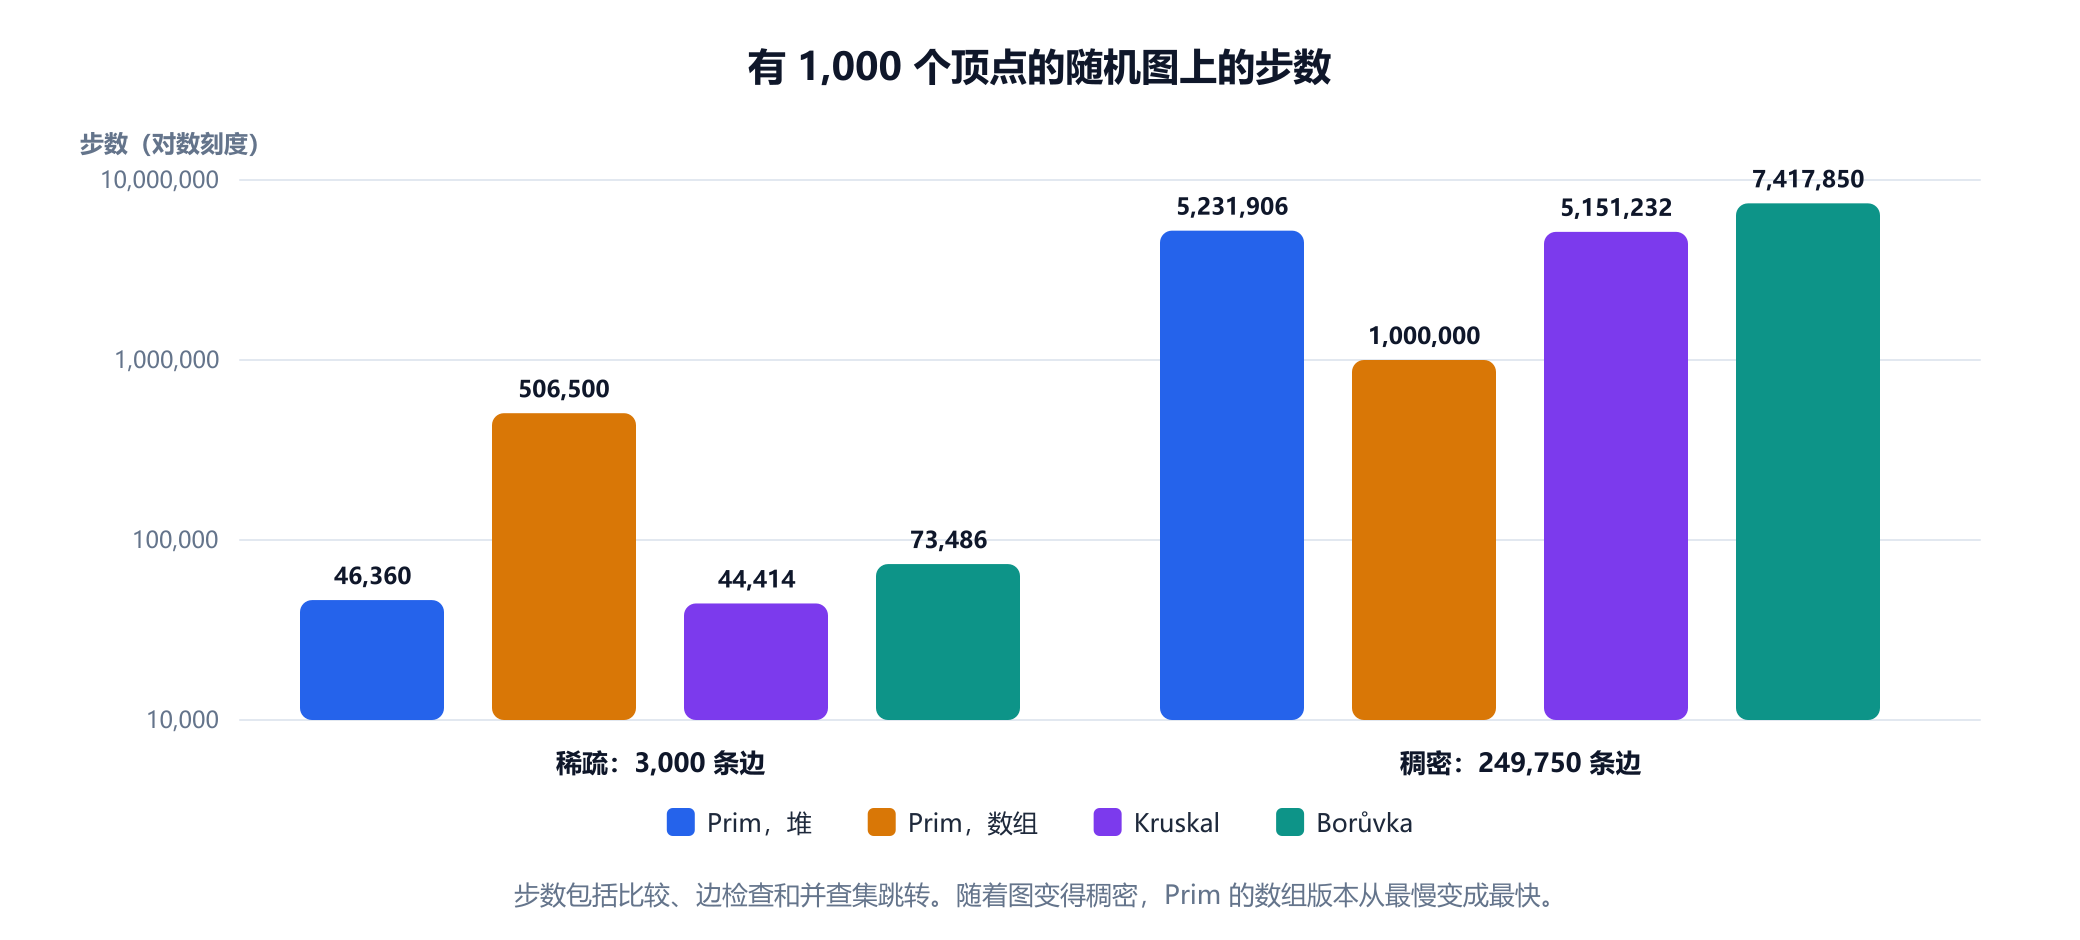
结果随密度而反转。在稀疏图上,Kruskal 和使用堆的 Prim 相差不到 5%,Borůvka 多需要约 60%,而基于数组的 Prim 慢约 11 倍,因为尽管每个顶点的边很少,它仍要扫描每个剩余顶点。在稠密图上,数组版本恰好用了 1,000,000 步,以约五倍的优势获胜:它要查看的候选项从不超过 V 个,而堆和排序要在近 250,000 条边上付出对数级的代价。
这些数字统计的是步数,不是秒数。在真实硬件上,对数字数组排序非常快,这常常对 Kruskal 有利,而这里的堆版本是简单版本,每个顶点可能有多个条目。就地更新条目的版本能让堆更小,代价是代码更多。如果时间很重要,请在自己的数据上测量。
6. 输入的形式
通常在进行任何复杂度分析之前,输入就已经决定了答案。各种格式的比较见图的表示指南。
- 边列表直接适合 Kruskal:除了并查集数组之外,不需要构建任何东西。
- 已排序的边,或者可以用计数排序的小整数权重,省去了 Kruskal 唯一昂贵的步骤。剩下的只有几乎线性的并查集操作。
- 邻接矩阵,或者可以按需计算的距离(例如平面上的点,每对点之间都有一条边),适合基于数组的 Prim。它根本不存储边,只需要
O(V)的内存,而 Kruskal 必须保存并排序大约V2 / 2条边。 - 内存放不下的边列表适合 Borůvka 和 filter-Kruskal 等 Kruskal 变体,前者只需要反复遍历所有边,后者不对明显会被拒绝的边排序。
Kruskal 的并查集结构本身就值得深入了解,详见并查集指南。
7. 非连通图与提前停止
当图不是一个整体时,这三种方法的行为也不同;提前停止时,它们能告诉你的信息也不同。
非连通图。 Prim 只能到达起始顶点所在连通分量内的顶点;要覆盖整个图,必须在每个连通分量中重新启动。Kruskal 和 Borůvka 无需改动:它们只是用完所有边,然后返回一个最小生成森林,每个连通分量一棵树。
聚类。 Kruskal 的中间状态本身就很有用。当还剩 k 个组时停止,这些组就是数据的单链接聚类结果,即把数据划分为 k 个组,并使来自不同组的最近点对相距尽可能远。
PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

def kruskal_until(edges, groups_wanted):
    """Kruskal,一旦只剩 groups_wanted 个组就停止。"""
    parent = {x: x for u, v, _ in edges for x in (u, v)}
    def find(x):
        while parent[x] != x:
            parent[x] = parent[parent[x]]
            x = parent[x]
        return x
    count, tree = len(parent), []
    for u, v, w in sorted(edges, key=lambda e: e[2]):
        if count == groups_wanted:
            break
        if find(u) != find(v):
            parent[find(u)] = find(v)
            tree.append((u, v, w))
            count -= 1
    members = {}
    for x in sorted(parent):
        members.setdefault(find(x), []).append(x)
    return tree, sorted(''.join(m) for m in members.values())

print(kruskal_until(PIPES, 3)[1])              # 村庄的三个聚类
# ['ABC', 'DEH', 'FG']
print(kruskal_until(PIPES, 2)[1])
# ['ABCDEH', 'FG']

# 分成两部分的图:去掉 A 到 E 与 F、G、H 之间的所有管道。
split = [e for e in PIPES if not (set(e[:2]) & set('FGH')) or set(e[:2]) <= set('FGH')]
tree, parts = kruskal_until(split, 1)          # 要求 1 个组,但实际只能有 2 个
print(parts, sum(w for *_, w in tree))
# ['ABCDE', 'FGH'] 32
停在三个组时,程序返回 {A, B, C}、 {D, E, H} 和 {F, G},与 Borůvka 第一轮在这张图上得到的三个组相同,不过这种一致只是这个示例的巧合。最后一次运行中,两半之间的管道已被移除,Kruskal 返回由两棵树组成的森林,成本为 32。从 A 出发的 Prim 会在五个村庄后停止,永远看不到 F、 G 或 H。
8. 负权重、最大生成树与有向图
- 负权重没有问题。与 Dijkstra 算法不同,这三种算法都不受负权重影响,因为每棵生成树恰好有
V - 1条边。给每个权重加上同一个常数,每棵树的成本都增加相同的量,选择不变。示例中把每条管道的权重减去 10,这会使大多数权重变成负数,得到的仍是同一棵树。 - 最大生成树。把权重取负,或按降序排序。示例中最贵的生成树成本为 87。
- 瓶颈。最小生成树同时也使最重的边最小化。在示例中,这条边是
E-F(权重 8),没有任何生成树能避开权重至少为 8 的边。 - 有向图。这三种算法都不适用于有向图。这个问题的有向版本,即最小树形图,需要使用 Chu-Liu/Edmonds 算法。
9. Prim 不是 Dijkstra
Prim 算法和 Dijkstra 算法的代码看起来几乎相同,区别只有一行:Prim 按到达某个顶点的单条边的权重排列队列,而 Dijkstra 按从源点出发的总距离排列。它们优化的目标不同,构建的树也不同。逐行比较见 Prim 算法指南。
在示例中,从 A 出发的 Dijkstra 最短路径树使用 A-C (权重 6)而不是 B-C (权重 4)。它的总成本是 32,而最小生成树是 30。作为回报,沿这棵树,每个村庄到 A 的距离都不会更远: C 的距离是 6 而不是 7, H 是 20 而不是 21, G 是 24 而不是 25。最小生成树使建设网络的成本最小,但对任何单条路线的长度不作任何保证。
10. 错综复杂的历史
这三个名字会让人误解谁先提出。最早的算法是 Borůvka 算法。1925 年冬天,西摩拉维亚电力公司的员工 Jindřich Saxel 向捷克数学家 Otakar Borůvka 询问如何以最低成本为摩拉维亚西南部供电,Borůvka 随后在 1926 年发表了这一算法。1930 年,Vojtěch Jarník 在一篇以致 Borůvka 的信的形式写成的论文中描述了现在被称为 Prim 算法的方法。Joseph Kruskal 于 1956 年发表了他的方法,1957 年 Robert Prim 在贝尔实验室重新发现了 Jarník 的算法,1959 年 Edsger Dijkstra 也重新发现了它。因此,Prim 算法有时被称为 Jarník 算法或 DJP 算法,不过“Prim 算法”仍是迄今最常见的名称。Borůvka 的方法本身也被多次重新发现,在一些书中它冠以 Sollin 的名字,Sollin 于 1961 年在巴黎的一次研讨会上介绍了它,但从未发表。
已知最快的方法已经远离这些经典算法。1995 年,David Karger、Philip Klein 和 Robert Tarjan 给出了一种期望线性时间的随机算法。2000 年,Bernard Chazelle 给出了一种确定性算法,其运行时间为 O(E α(E, V)),其中 α 是反 Ackermann 函数,对于任何可能被存储下来的图,它最多为 4。2002 年,Seth Pettie 和 Vijaya Ramachandran 找到了一种可证明最优的算法,尽管没有人知道它的实际运行时间是多少:它介于线性和 Chazelle 的界之间。Karger、Klein 和 Tarjan 的算法把 Borůvka 的轮作为构建模块。
11. 各自的应用场景
- 网络设计。以最低成本铺设电缆、管道或道路是最初的应用。正如网络设计指南所示,实际设计会增加约束,而最小生成树通常是起点。
- 聚类。单链接聚类就是提前停止的 Kruskal 算法,这也是 Kruskal 通常被用于这项工作的原因。Pedro Felzenszwalb 和 Daniel Huttenlocher 的基于图的图像分割方法同样按排序顺序处理边。
- 近似更难的问题。在权重非负时,最小生成树的成本绝不会超过最优的旅行商回路。Christofides 启发式算法从最小生成树出发,在距离满足三角不等式时保证回路长度不超过最优解的 1.5 倍。
- 几何数据。当每对点都是候选边时,图是完全图,基于数组的 Prim 是自然的选择。
- 并行计算。 Borůvka 的每一轮都让每个组独立工作,因此它通常是并行算法的起点,而 Prim 和 Kruskal 本质上是顺序执行的。
12. 常见错误
| 错误 | 为什么错 | 修正 |
|---|---|---|
| 在非连通图上使用 Prim 并相信结果 | 它只覆盖起始顶点所在的连通分量 | 在每个连通分量中重新启动,或使用 Kruskal |
| 认为使用堆的 Prim 总是最好 | 在稠密图上,数组版本的步数只有五分之一 | 使用数组版本,前提是 E 接近 V2 |
| 把最小生成树当作一组最短路径 | 在示例中,它到达 C 的代价是 7,而最短路线只需 6 | 路线用 Dijkstra,建设成本用生成树 |
| 在权重可能相同时测试某一棵确切的树 | 可能存在多棵最小生成树,输入顺序决定得到哪一棵 | 比较总权重 |
| 在 Borůvka 中以不一致的方式打破平局 | 各组可能选出构成环的边 | 先比较权重,再按固定的边顺序比较 |
| 因为有负权重而回避这些算法 | 负权重对三种算法都没有影响 | 无需改动,直接运行 |
| 在有向图上运行它们 | 割性质针对的是无向边 | 使用 Chu-Liu/Edmonds 算法 |
| 让 Kruskal 扫描所有边 | 接受 V - 1 条边后,树就已完成 | 一旦接受够这么多条边就立即停止 |
13. 术语表
| 术语 | 含义 |
|---|---|
| 生成树 | 包含图中所有顶点的树 |
| 最小生成树 | 总权重最小的生成树 |
| 生成森林 | 每个连通分量一棵生成树 |
| 割性质 | 穿过任意割的最便宜的边可以属于最小生成树 |
| 环性质 | 任何环上最贵的边都可以舍去 |
| 并查集 | 跟踪各组并快速合并它们的数据结构 |
| 优先队列 | 总是返回最小键的数据结构;通常用二叉堆实现 |
| 稠密图 | 所有顶点对中有很大比例由边相连的图 |
| 稀疏图 | 与 V2相比边数很少的图,边数通常是一个小的常数乘以 V |
| 单链接聚类 | 反复合并最近的两个组来进行分组 |
| 瓶颈边 | 树中最重的边 |
| 树形图 | 每条边都从同一个根指向外的有向树 |
14. 常见问题
Prim 算法和 Kruskal 算法有什么区别?
Prim 算法从起始顶点生长一棵连通的树,始终加入离开这棵树的最便宜的边。Kruskal 算法对所有边排序,按权重从小到大选取,跳过会形成环的边,因此它的树一开始是分散的片段,然后逐渐合并。两者都能找到总权重相同的最小生成树。
Prim 和 Kruskal 哪个更好?
取决于图。对于稀疏图,以及边以列表形式给出或已排序的情况,Kruskal 是自然的选择。对于稠密图,使用普通数组的 Prim 是自然的选择,因为它的运行时间是 O(V²),而且不需要对边排序。在稀疏图上,使用二叉堆的 Prim 和 Kruskal 代价差不多。
Prim 和 Kruskal 得到的最小生成树相同吗?
如果所有边的权重都不相同,最小生成树就是唯一的,两者返回完全相同的边。如果有些权重相等,可能存在多棵最小生成树,两种算法可能返回不同的树,但总权重始终相同。
什么是 Borůvka 算法?
Borůvka 算法按轮工作。每一轮中,每个由相连顶点组成的组选出通往其他组的最便宜的边,所有这些边同时加入。每一轮组的数量至少减半,所以最多有 log2 V 轮,运行时间为 O(E log V)。由于各组独立工作,它非常适合并行计算。
Prim 和 Kruskal 能处理负权重的边吗?
可以。与 Dijkstra 算法不同,Prim、Kruskal 和 Borůvka 在负权重下都能正确工作。每棵生成树恰好有 V - 1 条边,所以给每个权重加上同一个常数,每棵树的成本变化相同,最便宜的树也不会改变。
Prim 算法和 Dijkstra 算法有什么区别?
它们的代码几乎相同,但 Prim 按到达顶点的单条边的权重排列顶点,而 Dijkstra 按从源点出发的总距离排列顶点。Prim 构建总权重最小的树。Dijkstra 构建从一个源点出发的最短路径树,总成本可能更高,但从该源点出发的路线更短。
15. 参考文献
上文中的算法、界和归属均来自以下文献,按时间顺序排列。
- Borůvka, O. (1926). "O jistém problému minimálním." Práce Moravské přírodovědecké společnosti 3,37 至 58 页。
- Jarník, V. (1930). "O jistém problému minimálním (Z dopisu panu O. Borůvkovi)." Práce Moravské přírodovědecké společnosti 6,57 至 63 页。
- Kruskal, J. B. (1956). "On the Shortest Spanning Subtree of a Graph and the Traveling Salesman Problem." Proceedings of the American Mathematical Society 7(1),48 至 50 页。
- Prim, R. C. (1957). "Shortest Connection Networks and Some Generalizations." Bell System Technical Journal 36(6),1389 至 1401 页。
- Dijkstra, E. W. (1959). "A Note on Two Problems in Connexion with Graphs." Numerische Mathematik 1,269 至 271 页。
- Chu, Y.-J. 和 Liu, T.-H. (1965). "On the Shortest Arborescence of a Directed Graph." Scientia Sinica 14,1396 至 1400 页。
- Edmonds, J. (1967). "Optimum Branchings." Journal of Research of the National Bureau of Standards 71B,233 至 240 页。
- Gower, J. C. 和 Ross, G. J. S. (1969). "Minimum Spanning Trees and Single Linkage Cluster Analysis." Journal of the Royal Statistical Society, Series C 18(1),54 至 64 页。
- Tarjan, R. E. (1975). "Efficiency of a Good But Not Linear Set Union Algorithm." Journal of the ACM 22(2),215 至 225 页。
- Christofides, N. (1976). Worst-Case Analysis of a New Heuristic for the Travelling Salesman Problem. 报告 388。匹兹堡:Carnegie Mellon University。
- Graham, R. L. 和 Hell, P. (1985). "On the History of the Minimum Spanning Tree Problem." Annals of the History of Computing 7(1),43 至 57 页。
- Fredman, M. L. 和 Tarjan, R. E. (1987). "Fibonacci Heaps and Their Uses in Improved Network Optimization Algorithms." Journal of the ACM 34(3),596 至 615 页。
- Karger, D. R., Klein, P. N. 和 Tarjan, R. E. (1995). "A Randomized Linear-Time Algorithm to Find Minimum Spanning Trees." Journal of the ACM 42(2),321 至 328 页。
- Chazelle, B. (2000). "A Minimum Spanning Tree Algorithm with Inverse-Ackermann Type Complexity." Journal of the ACM 47(6),1028 至 1047 页。
- Nešetřil, J., Milková, E. 和 Nešetřilová, H. (2001). "Otakar Borůvka on Minimum Spanning Tree Problem." Discrete Mathematics 233(1 至 3),3 至 36 页。
- Pettie, S. 和 Ramachandran, V. (2002). "An Optimal Minimum Spanning Tree Algorithm." Journal of the ACM 49(1),16 至 34 页。
- Felzenszwalb, P. F. 和 Huttenlocher, D. P. (2004). "Efficient Graph-Based Image Segmentation." International Journal of Computer Vision 59(2),167 至 181 页。
- Kleinberg, J. 和 Tardos, É. (2005). Algorithm Design. 波士顿:Addison-Wesley。
- Bader, D. A. 和 Cong, G. (2006). "Fast Shared-Memory Algorithms for Computing the Minimum Spanning Forest of Sparse Graphs." Journal of Parallel and Distributed Computing 66(11),1366 至 1378 页。
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. 和 Stein, C. (2009). Introduction to Algorithms,第 3 版。马萨诸塞州剑桥:MIT Press。
- Osipov, V., Sanders, P. 和 Singler, J. (2009). "The Filter-Kruskal Minimum Spanning Tree Algorithm." 载于 Proceedings of the 11th Workshop on Algorithm Engineering and Experiments,52 至 61 页。