
Table des Matières
- 1. La réponse courte
- 2. Un graphe, trois exécutions
- 3. Pourquoi les trois sont corrects
- 4. Quand les arbres diffèrent
- 5. Vitesse : lequel est le plus rapide, et quand
- 6. La forme de vos données
- 7. Graphes non connexes et arrêt anticipé
- 8. Poids négatifs, arbres maximaux et graphes orientés
- 9. Prim n'est pas Dijkstra
- 10. Une histoire embrouillée
- 11. Où chacun est utilisé
- 12. Erreurs fréquentes
- 13. Glossaire
- 14. Questions fréquentes
- 15. Références
1. La réponse courte
L'algorithme de Prim, l'algorithme de Kruskal et l'algorithme de Borůvka trouvent tous un arbre couvrant de poids minimal : l'ensemble d'arêtes le moins coûteux qui relie tous les sommets d'un graphe pondéré. Ils le construisent dans des ordres différents, et c'est ce qui détermine lequel convient à un graphe donné. Le guide des arbres couvrants de poids minimal présente le problème lui-même.
| Prim | Kruskal | Borůvka | |
|---|---|---|---|
| Stratégie | Faire croître un seul arbre vers l'extérieur depuis un sommet de départ | Prendre les arêtes de la moins chère à la plus chère, en ignorant celles qui ferment un cycle | Chaque groupe choisit son arête sortante la moins chère, tous en même temps |
| Structure de données principale | File de priorité, ou simple tableau | Liste d'arêtes triée et union-find | Union-find, ou réétiquetage |
| Temps | O(E log V) avec un tas binaire, O(V2) avec un tableau | O(E log E), quasi linéaire si les arêtes sont déjà triées | O(E log V) |
| Entrée naturelle | Liste d'adjacence ou matrice | Liste d'arêtes | Liste d'arêtes |
| Graphe non connexe | Ne couvre que la composante du sommet de départ | Donne une forêt couvrante | Donne une forêt couvrante |
| Idéal pour | Graphes denses, avec la version à tableau | Graphes creux, arêtes pré-triées, classification | Calcul parallèle et distribué |
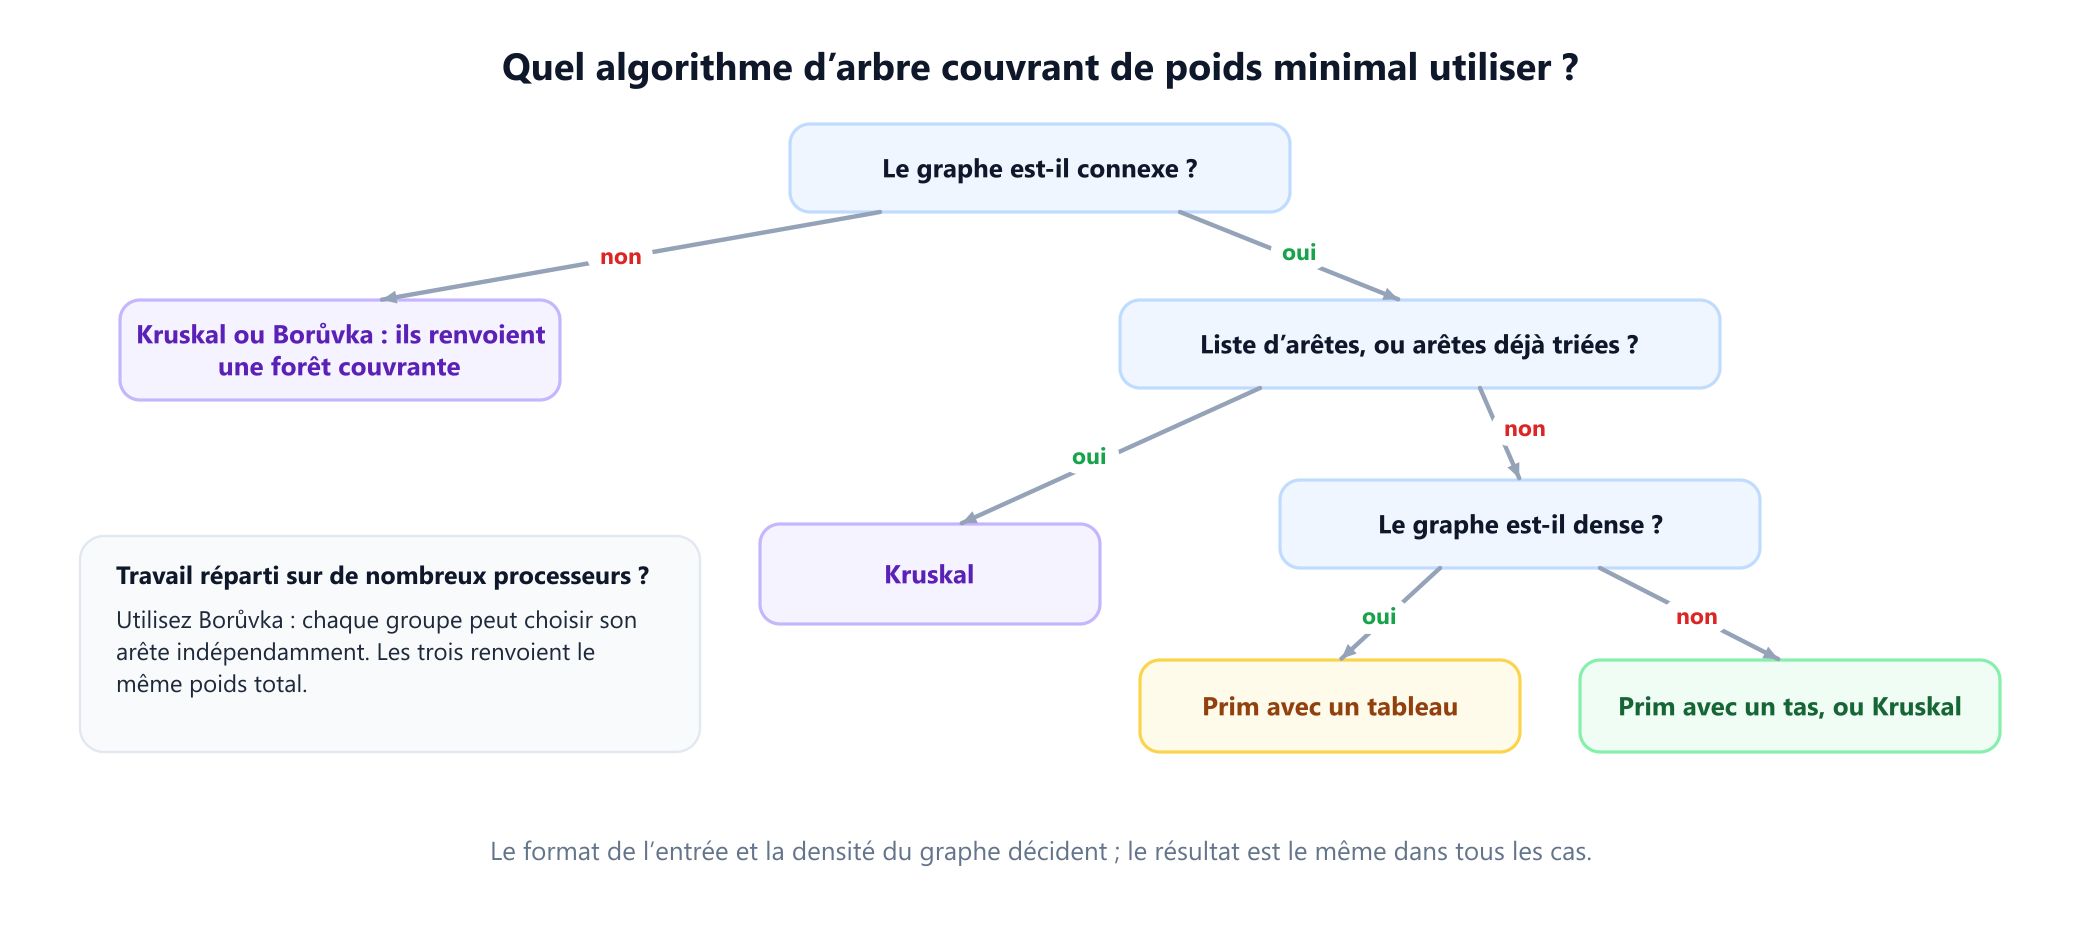
Ici, V est le nombre de sommets et E le nombre d'arêtes. En une phrase : utilisez Kruskal lorsque le graphe est creux ou donné sous forme de liste d'arêtes, utilisez Prim lorsqu'il est dense ou donné sous forme de matrice, et envisagez Borůvka lorsque le travail doit être réparti entre de nombreux processeurs. Sur un graphe creux, Kruskal et Prim avec un tas coûtent à peu près la même chose, le bon choix est donc le code le plus simple pour vos données.
2. Un graphe, trois exécutions
Huit villages, A à H, souhaitent être reliés par des canalisations d'eau. Il existe 14 tracés possibles, chacun avec un coût en kilomètres de tranchée, et chaque village doit finir par être relié à tous les autres. Réunis, les 14 tracés coûteraient 117.
A-B 3    A-C 6    B-C 4    B-D 13   C-D 7    C-E 12   D-E 2
D-F 11   E-F 8    E-G 14   E-H 5    F-G 1    F-H 15   G-H 16

8 villages, 14 canalisations possibles
Un réseau de coût minimal utilise exactement 7 canalisations, une de moins que le nombre de villages, car toute canalisation supplémentaire fermerait une boucle qu'on pourrait supprimer pour économiser. Ce graphe possède 712 arbres couvrants, et un seul d'entre eux atteint le coût minimal de 30. Le programme ci-dessous implémente les trois algorithmes et les exécute sur ce graphe.
import heapq

PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

class Groups:
    """Union-find : à quel groupe appartient chaque sommet ?"""
    def __init__(self, items):
        self.parent = {x: x for x in items}
    def find(self, x):
        while self.parent[x] != x:
            self.parent[x] = self.parent[self.parent[x]]   # réduction de moitié du chemin
            x = self.parent[x]
        return x
    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False
        self.parent[ra] = rb
        return True

def vertices(edges):
    return sorted({x for u, v, _ in edges for x in (u, v)})

def prim(edges, start):
    """Fait croître un seul arbre : ajoute toujours l'arête la moins chère qui en sort."""
    adj = {v: [] for v in vertices(edges)}
    for u, v, w in edges:
        adj[u].append((w, u, v))
        adj[v].append((w, v, u))
    seen, heap, tree = {start}, list(adj[start]), []
    heapq.heapify(heap)
    while heap:
        w, u, v = heapq.heappop(heap)
        if v in seen:
            continue                                  # les deux extrémités sont déjà dans l'arbre
        seen.add(v)
        tree.append((u, v, w))
        for e in adj[v]:
            if e[2] not in seen:
                heapq.heappush(heap, e)
    return tree

def kruskal(edges):
    """Prend les arêtes de la moins chère à la plus chère, en ignorant celles qui fermeraient un cycle."""
    groups, tree = Groups(vertices(edges)), []
    for u, v, w in sorted(edges, key=lambda e: e[2]):
        if groups.union(u, v):
            tree.append((u, v, w))
    return tree

def boruvka(edges):
    """À chaque tour, chaque groupe choisit en même temps son arête sortante la moins chère."""
    groups, tree, rounds = Groups(vertices(edges)), [], []
    while True:
        cheapest = {}
        for u, v, w in edges:
            ru, rv = groups.find(u), groups.find(v)
            if ru != rv:
                for r in (ru, rv):                    # égalités départagées partout de la même façon
                    if r not in cheapest or (w, u, v) < cheapest[r]:
                        cheapest[r] = (w, u, v)
        if not cheapest:
            return tree, rounds
        added = []
        for w, u, v in sorted(set(cheapest.values())):
            if groups.union(u, v):
                added.append((u, v, w))
        tree += added
        rounds.append(added)

def show(tree):
    return ' '.join(f'{u}{v}:{w}' for u, v, w in tree) + f'   total {sum(w for *_, w in tree)}'

print('Prim    ', show(prim(PIPES, 'A')))
# Prim     AB:3 BC:4 CD:7 DE:2 EH:5 EF:8 FG:1   total 30
print('Kruskal ', show(kruskal(PIPES)))
# Kruskal  FG:1 DE:2 AB:3 BC:4 EH:5 CD:7 EF:8   total 30
tree, rounds = boruvka(PIPES)
print('Boruvka ', show(tree))
# Boruvka  FG:1 DE:2 AB:3 BC:4 EH:5 CD:7 EF:8   total 30
for i, added in enumerate(rounds, 1):
    print('round', i, show(added))
# round 1 FG:1 DE:2 AB:3 BC:4 EH:5   total 15
# round 2 CD:7 EF:8   total 15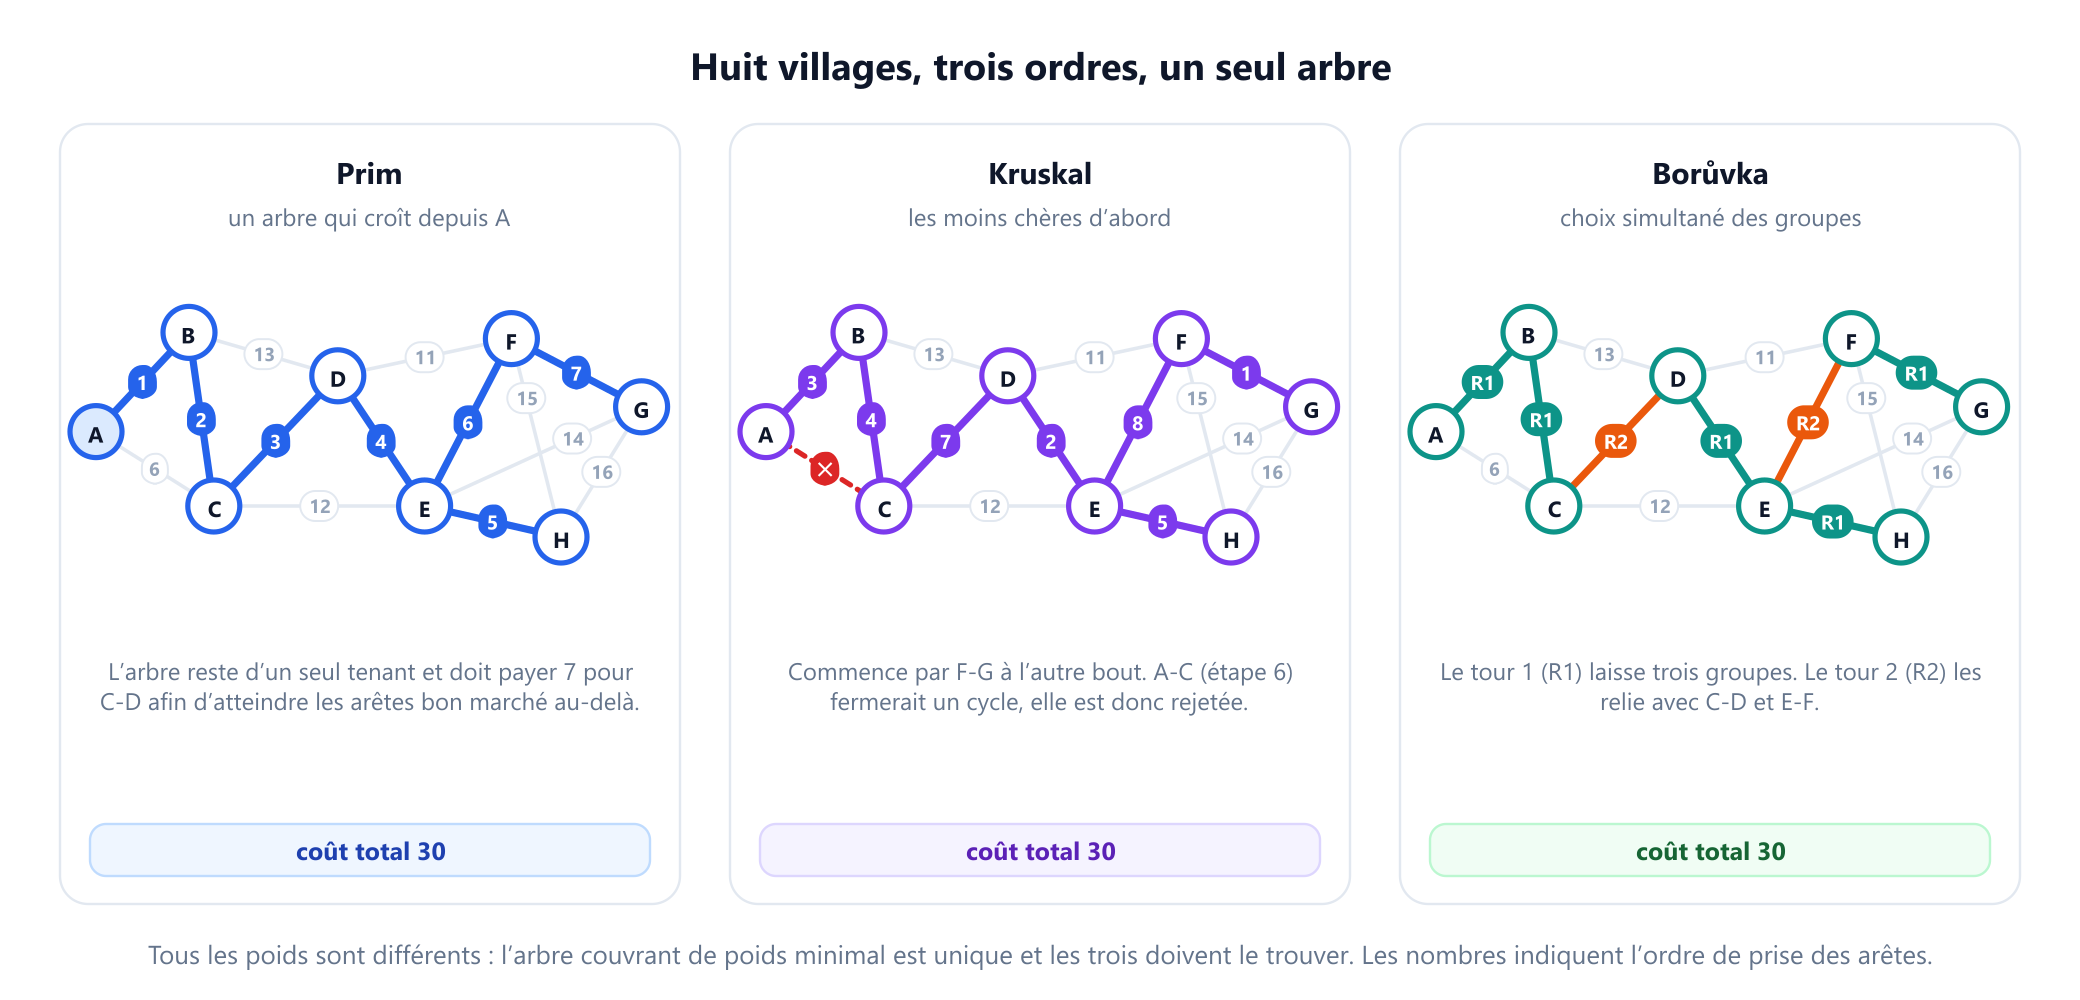
Les trois ordres racontent l'histoire de chaque méthode :
- Prim part de
Aet étend toujours l'unique arbre dont il dispose. Il prendA-Bà 3,B-Cà 4, puis doit payer 7 pourC-Davant de pouvoir atteindre les arêtes bon marchéD-EetF-Gplus loin. - Kruskal ignore la géographie. Il prend d'abord
F-Gà 1, à l'autre bout du graphe, puis remonte la liste des prix. Lorsqu'il atteintA-Cà 6,AetCsont déjà reliés parB, il rejette donc cette canalisation. AprèsE-Fà 8, il a 7 canalisations et peut s'arrêter, sans jamais regarder les six tracés les plus chers. - Borůvka procède par tours. Au tour 1, chaque village choisit sa canalisation la moins chère, ce qui donne cinq canalisations différentes et trois groupes :
{A, B, C},{D, E, H}et{F, G}. Au tour 2, chaque groupe choisit sa canalisation la moins chère vers un autre groupe, etC-DetE-Fterminent le travail.
3. Pourquoi les trois sont corrects
Aussi différents qu'ils paraissent, les trois reposent sur le même fait concernant les coupes. Une coupe partage les sommets en deux groupes, comme le guide sur la coupe minimale l'explique. La propriété de coupe affirme : pour toute coupe, l'arête la moins chère qui la traverse appartient à un arbre couvrant de poids minimal, et lorsque les poids sont tous différents, elle appartient à chacun d'eux. La preuve est un échange. Prenez un arbre couvrant qui n'utilise pas cette arête et ajoutez-la : cela ferme un cycle, ce cycle doit traverser la coupe une seconde fois par une arête plus chère, et retirer cette arête plus chère donne un arbre moins cher.
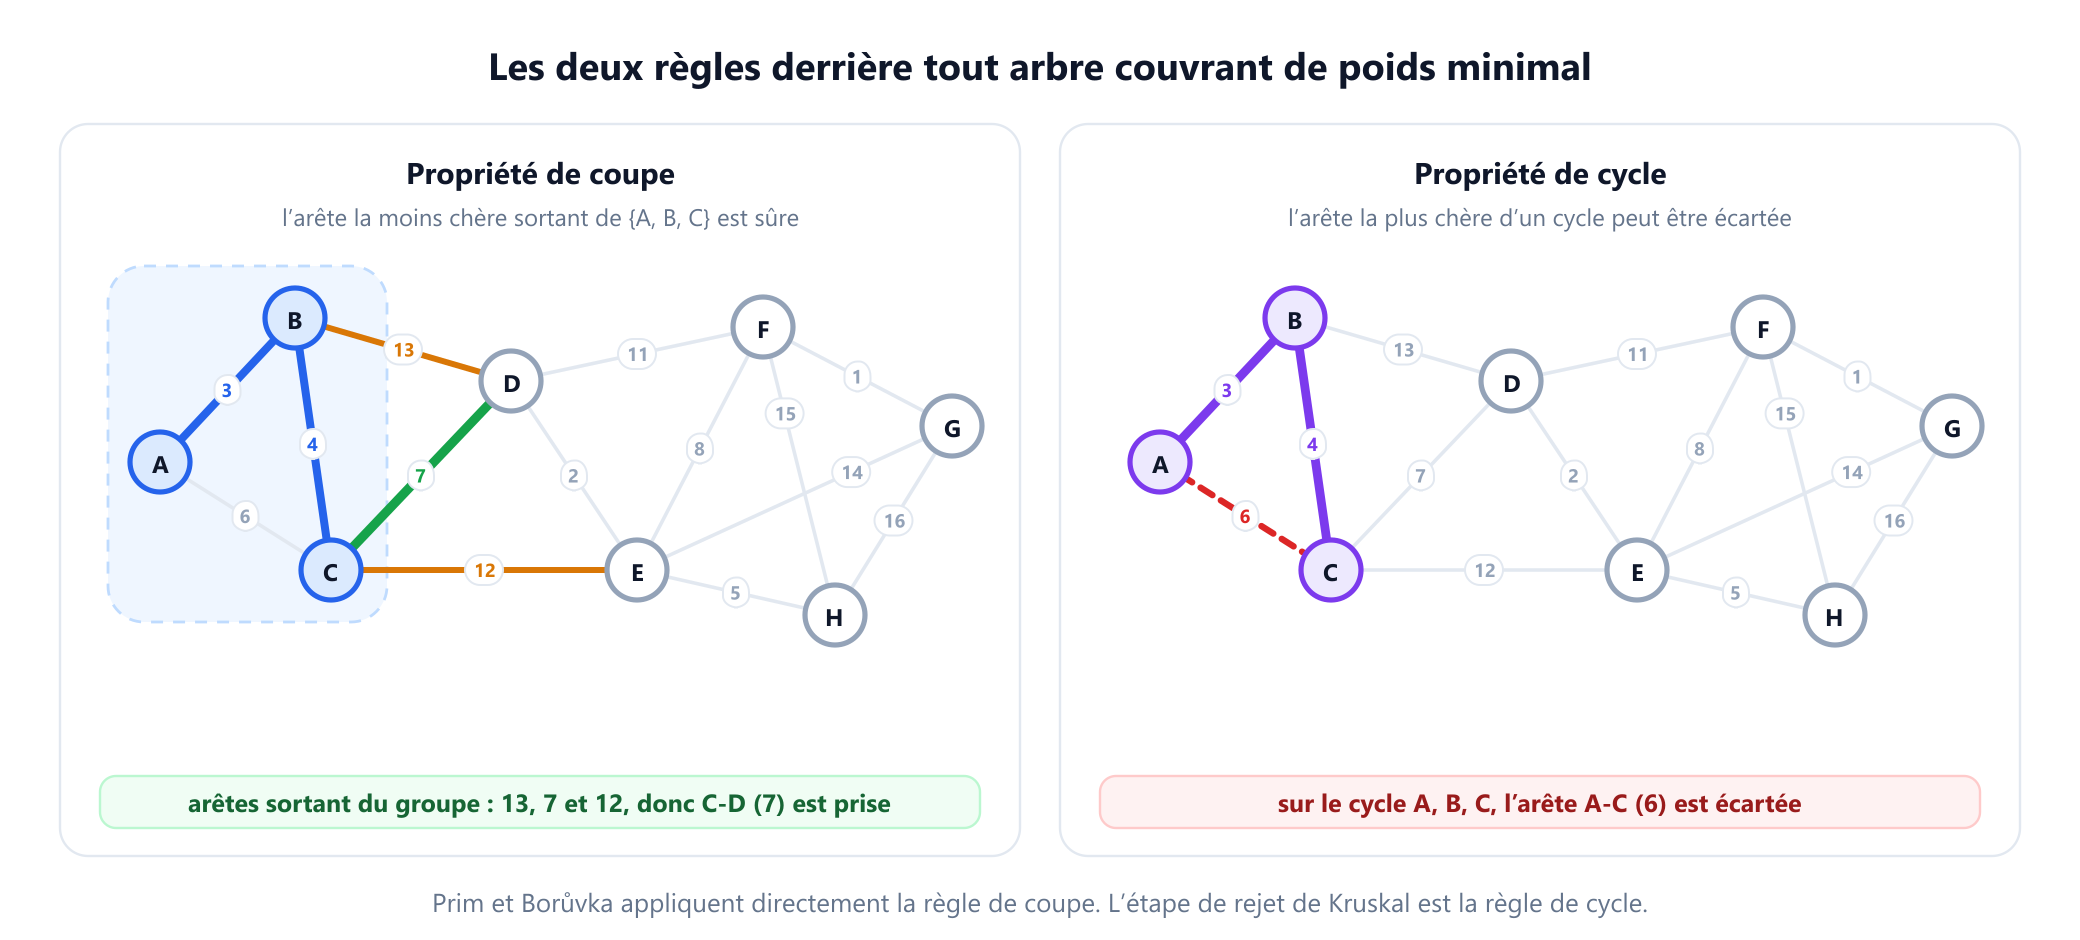
Chaque algorithme applique cette règle à une coupe différente :
- Prim utilise la coupe entre son arbre et tout le reste. Sur la figure, l'arbre
{A, B, C}peut sortir par trois arêtes, et la moins chère,C-Dà 7, est ajoutée. - Kruskal utilise la coupe autour de l'un des deux groupes que l'arête relie. Les arêtes sont prises par ordre croissant, donc lorsqu'une arête relie deux groupes, rien de moins cher ne sort de l'un ou de l'autre.
- Borůvka utilise la coupe autour de chaque groupe, pour tous les groupes en même temps.
L'image miroir est la propriété de cycle : l'arête la plus chère de n'importe quel cycle peut être exclue d'un arbre couvrant de poids minimal. C'est l'étape de rejet de Kruskal. Lorsque A-C à 6 fermerait le cycle A, B, C, c'est l'arête la plus chère de ce cycle, car toutes les autres ont été prises avant elle. Un arbre couvrant de poids minimal n'a jamais besoin de cette arête.
4. Quand les arbres diffèrent
Si tous les poids d'arêtes sont différents, l'arbre couvrant de poids minimal est unique, donc les trois algorithmes doivent renvoyer exactement les mêmes arêtes, comme sur l'exemple. Avec des poids égaux, il peut exister plusieurs arbres couvrants de poids minimal, tous de même total, et celui que vous obtenez dépend de l'algorithme et même de l'ordre de l'entrée. Passez le coût de A-C à 4, comme celui de B-C, et il existe exactement deux arbres couvrants de poids minimal :
PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

def kruskal(edges):
    parent = {x: x for u, v, _ in edges for x in (u, v)}
    def find(x):
        while parent[x] != x:
            x = parent[x]
        return x
    tree = []
    for u, v, w in sorted(edges, key=lambda e: e[2]):  # stable : les égalités gardent leur ordre d'entrée
        if find(u) != find(v):
            parent[find(u)] = find(v)
            tree.append(u + v)
    return sorted(tree), sum(w for u, v, w in edges if u + v in tree)

tied = [(u, v, 4 if (u, v) == ('A', 'C') else w) for u, v, w in PIPES]   # A-C coûte maintenant 4, comme B-C
print(kruskal(tied))
# (['AB', 'AC', 'CD', 'DE', 'EF', 'EH', 'FG'], 30)
print(kruskal(tied[::-1]))
# (['AB', 'BC', 'CD', 'DE', 'EF', 'EH', 'FG'], 30)
Les deux arbres coûtent 30 et diffèrent d'une canalisation. Le tri de Python est stable, donc les arêtes égales conservent leur ordre d'entrée, et inverser la liste change celle des deux qui est prise en premier. Si vos tests comparent les arêtes exactes d'un arbre, ils peuvent échouer sur un programme correct ; comparez plutôt le poids total.
Les égalités sont aussi le bogue classique de l'algorithme de Borůvka. Lorsque deux groupes choisissent chacun entre des arêtes de même poids, des choix incohérents peuvent créer un cycle. Le programme ci-dessus l'évite en comparant (w, u, v) partout, de sorte que tous les groupes départagent les égalités de la même façon.
5. Vitesse : lequel est le plus rapide, et quand
| Version | Temps | Où passe le temps |
|---|---|---|
| Prim, tas binaire | O(E log V) | Au plus une opération de tas par arête |
| Prim, simple tableau | O(V2) | Parcours de tous les sommets restants, une fois par sommet ajouté |
| Prim, tas de Fibonacci | O(E + V log V) | Rapide en théorie, constantes élevées en pratique |
| Kruskal | O(E log E) | Le tri ; le travail d'union-find qui suit est quasi linéaire |
| Borůvka | O(E log V) | Au plus log2 V tours, chacun parcourant toutes les arêtes |
Comme E vaut au plus V2, log E vaut au plus 2 log V, donc O(E log E) et O(E log V) sont de la même classe. Les formules seules ne départagent pas les méthodes, aussi le programme ci-dessous compte les étapes de base, c'est-à-dire les comparaisons, les inspections d'arêtes et les sauts d'union-find, sur deux graphes aléatoires à 1 000 sommets. L'un est creux, avec 3 000 arêtes, et l'autre dense, avec 249 750 arêtes, soit la moitié de toutes les paires possibles.
import heapq, random
from functools import cmp_to_key

def random_graph(n, m, seed):
    """Un graphe connexe : un arbre couvrant aléatoire plus des arêtes aléatoires supplémentaires, poids tous différents."""
    rnd = random.Random(seed)
    order = list(range(n))
    rnd.shuffle(order)
    pairs = {tuple(sorted((order[i], order[rnd.randrange(i)]))) for i in range(1, n)}
    while len(pairs) < m:
        u, v = rnd.sample(range(n), 2)
        pairs.add((min(u, v), max(u, v)))
    weights = rnd.sample(range(1, 10 * m), m)
    return [(u, v, w) for (u, v), w in zip(sorted(pairs), weights)]

class Item:
    """Une entrée de tas qui compte combien de fois le tas la compare."""
    compared = 0
    def __init__(self, w, v):
        self.w, self.v = w, v
    def __lt__(self, other):
        Item.compared += 1
        return self.w < other.w

def prim_heap(n, edges):
    adj = [[] for _ in range(n)]
    for u, v, w in edges:
        adj[u].append((w, v))
        adj[v].append((w, u))
    Item.compared = 0
    seen, steps = {0}, len(adj[0])
    heap = [Item(w, v) for w, v in adj[0]]
    heapq.heapify(heap)
    while heap:
        item = heapq.heappop(heap)
        if item.v in seen:
            continue
        seen.add(item.v)
        for w, v in adj[item.v]:
            steps += 1                                # une arête inspectée
            if v not in seen:
                heapq.heappush(heap, Item(w, v))
    return steps + Item.compared

def prim_array(n, edges):
    """Prim sans tas : parcourt le meilleur coût connu de chaque sommet restant."""
    adj = [[] for _ in range(n)]
    for u, v, w in edges:
        adj[u].append((w, v))
        adj[v].append((w, u))
    best, done, steps = [float('inf')] * n, [False] * n, 0
    best[0] = 0
    for _ in range(n):
        left = [v for v in range(n) if not done[v]]
        u = min(left, key=best.__getitem__)
        steps += len(left)
        done[u] = True
        for w, v in adj[u]:
            steps += 1
            if not done[v] and w < best[v]:
                best[v] = w
    return steps

def kruskal(n, edges):
    compared = [0]
    def cmp(a, b):
        compared[0] += 1
        return a[2] - b[2]
    parent, steps = list(range(n)), 0
    def find(x):
        nonlocal steps
        while parent[x] != x:
            steps += 1
            parent[x] = parent[parent[x]]
            x = parent[x]
        steps += 1
        return x
    for u, v, w in sorted(edges, key=cmp_to_key(cmp)):
        ru, rv = find(u), find(v)
        if ru != rv:
            parent[ru] = rv
    return compared[0] + steps

def boruvka(n, edges):
    parent, steps = list(range(n)), 0
    def find(x):
        nonlocal steps
        while parent[x] != x:
            steps += 1
            parent[x] = parent[parent[x]]
            x = parent[x]
        steps += 1
        return x
    while True:
        cheapest = {}
        for u, v, w in edges:
            ru, rv = find(u), find(v)
            if ru != rv:
                for r in (ru, rv):
                    steps += 1
                    if r not in cheapest or w < cheapest[r][2]:
                        cheapest[r] = (u, v, w)
        if not cheapest:
            return steps
        for u, v, w in set(cheapest.values()):
            ru, rv = find(u), find(v)
            if ru != rv:
                parent[ru] = rv

n = 1000
for name, m in [('sparse', 3 * n), ('dense', n * (n - 1) // 4)]:
    edges = random_graph(n, m, seed=1)
    print(f'{name:6} E={m:6,}  Prim heap {prim_heap(n, edges):9,}  Prim array {prim_array(n, edges):9,}  '
          f'Kruskal {kruskal(n, edges):9,}  Boruvka {boruvka(n, edges):9,}')
# sparse E= 3,000  Prim heap    46,360  Prim array   506,500  Kruskal    44,414  Boruvka    73,486
# dense  E=249,750  Prim heap 5,231,906  Prim array 1,000,000  Kruskal 5,151,232  Boruvka 7,417,850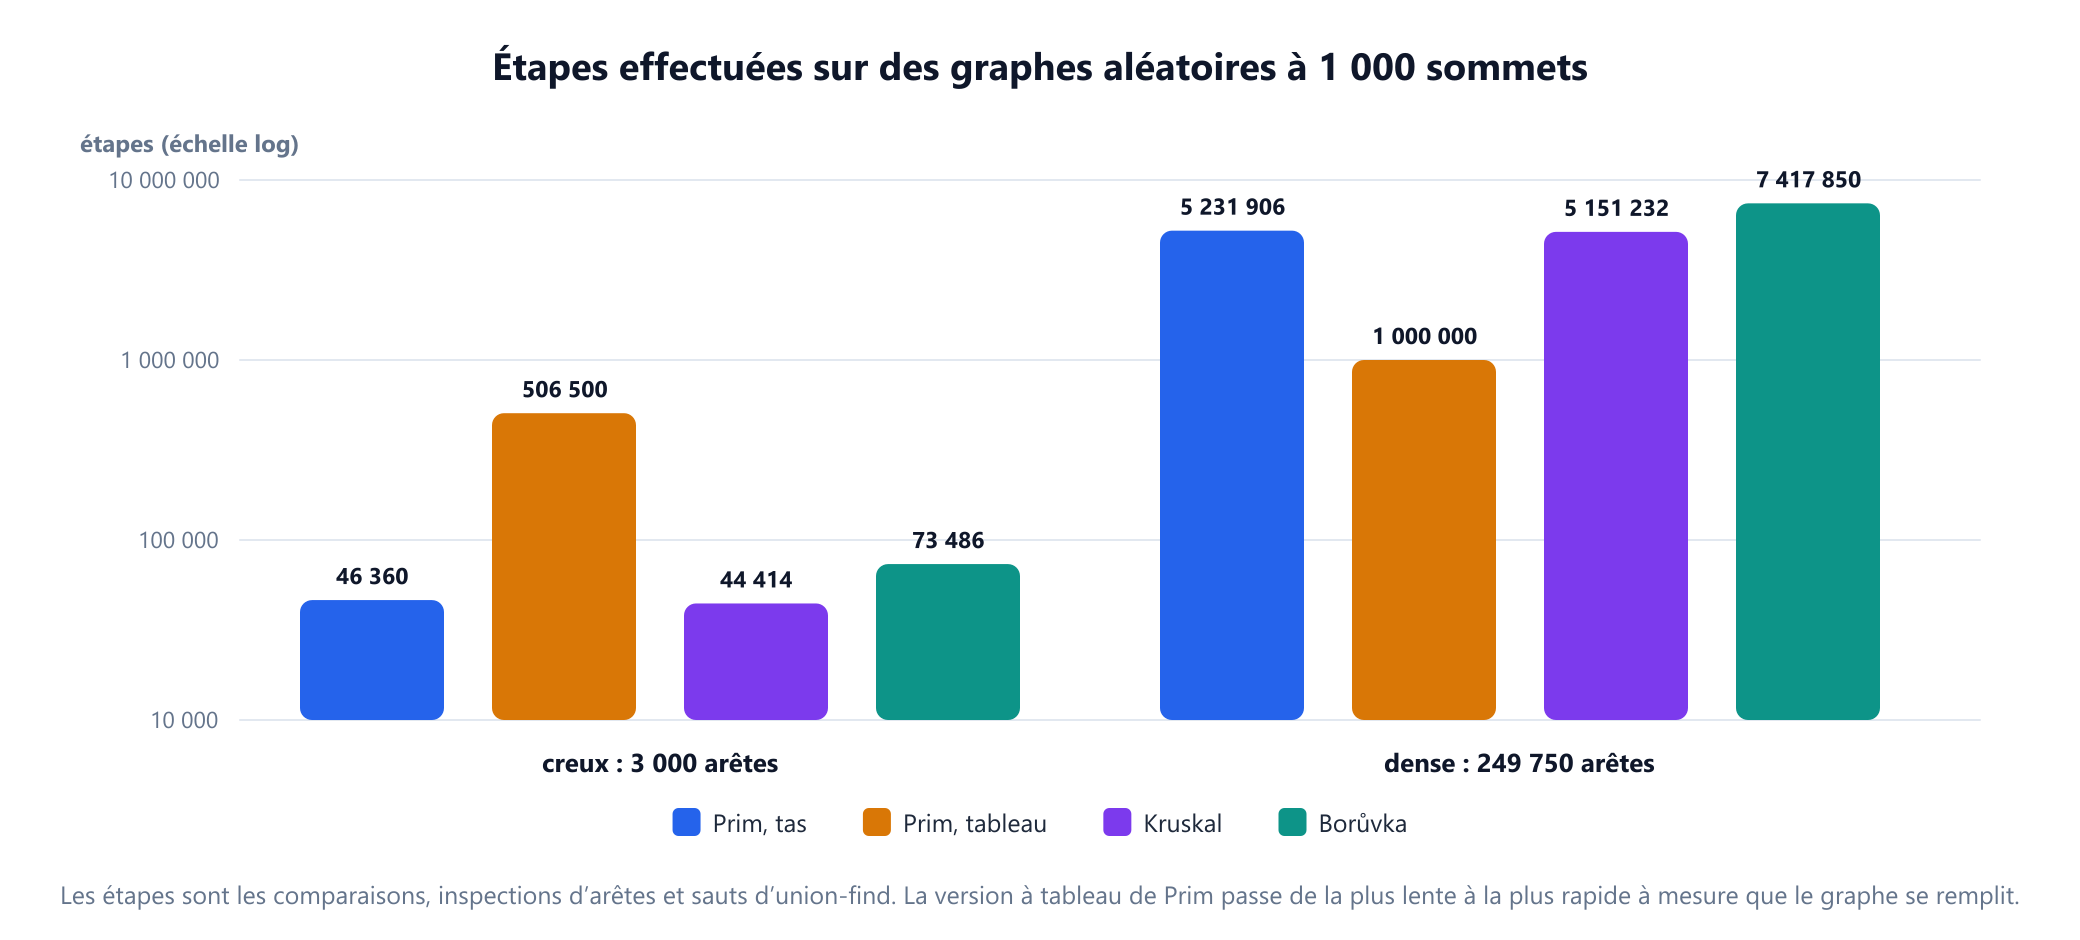
Les résultats s'inversent avec la densité. Sur le graphe creux, Kruskal et Prim avec un tas sont à moins de 5 % l'un de l'autre, Borůvka a besoin d'environ 60 % de plus, et Prim avec un tableau est environ 11 fois plus lent, car il parcourt tous les sommets restants alors que chacun a peu d'arêtes. Sur le graphe dense, la version à tableau prend exactement 1 000 000 d'étapes et gagne d'un facteur d'environ cinq : elle n'a jamais plus de V candidats à examiner, tandis que le tas et le tri paient un coût logarithmique sur près de 250 000 arêtes.
Ces chiffres comptent des étapes, pas des secondes. Trier un tableau de nombres est très rapide sur du matériel réel, ce qui favorise souvent Kruskal, et la version à tas présentée ici est la version simple, qui peut contenir plusieurs entrées par sommet. Une version qui met à jour les entrées sur place garde un tas plus petit, au prix de plus de code. Si le temps compte, mesurez sur vos propres données.
6. La forme de vos données
Souvent, l'entrée décide avant toute analyse de complexité. Le guide sur la représentation des graphes compare les formats.
- Une liste d'arêtes convient directement à Kruskal : il n'y a rien à construire, hormis le tableau d'union-find.
- Des arêtes déjà triées, ou des poids qui sont de petits entiers triables par dénombrement, suppriment la seule étape coûteuse de Kruskal. Reste le travail d'union-find, qui est quasi linéaire.
- Une matrice d'adjacence, ou des distances calculables à la demande, comme des points d'un plan où chaque paire forme une arête, convient à Prim avec un tableau. Il ne stocke jamais les arêtes et n'a besoin que de
O(V)de mémoire, tandis que Kruskal devrait conserver et trier environV2 / 2arêtes. - Une liste d'arêtes trop grande pour la mémoire favorise Borůvka, qui n'a besoin que de passes répétées sur les arêtes, ainsi que les variantes de Kruskal telles que filter-Kruskal, qui évitent de trier les arêtes qui seront manifestement rejetées.
La structure union-find de Kruskal mérite d'être comprise pour elle-même, et le guide consacré à union-find la traite en profondeur.
7. Graphes non connexes et arrêt anticipé
Les trois méthodes diffèrent aussi par ce qu'elles font lorsque le graphe n'est pas d'un seul tenant, et par ce qu'elles peuvent vous apprendre si vous vous arrêtez tôt.
Graphes non connexes. Prim n'atteint que la composante connexe de son sommet de départ ; pour couvrir tout le graphe, il faut le relancer dans chaque composante. Kruskal et Borůvka n'ont besoin d'aucune modification : ils épuisent simplement les arêtes et renvoient une forêt couvrante de poids minimal, avec un arbre par composante.
Classification. Les états intermédiaires de Kruskal sont utiles en eux-mêmes. Arrêtez-vous lorsqu'il reste k groupes : ces groupes sont les classes à lien simple des données, c'est-à-dire la division en k groupes dans laquelle la paire de points la plus proche issue de groupes différents est aussi éloignée que possible.
PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

def kruskal_until(edges, groups_wanted):
    """Kruskal, arrêté dès qu'il ne reste que groups_wanted groupes."""
    parent = {x: x for u, v, _ in edges for x in (u, v)}
    def find(x):
        while parent[x] != x:
            parent[x] = parent[parent[x]]
            x = parent[x]
        return x
    count, tree = len(parent), []
    for u, v, w in sorted(edges, key=lambda e: e[2]):
        if count == groups_wanted:
            break
        if find(u) != find(v):
            parent[find(u)] = find(v)
            tree.append((u, v, w))
            count -= 1
    members = {}
    for x in sorted(parent):
        members.setdefault(find(x), []).append(x)
    return tree, sorted(''.join(m) for m in members.values())

print(kruskal_until(PIPES, 3)[1])              # trois classes de villages
# ['ABC', 'DEH', 'FG']
print(kruskal_until(PIPES, 2)[1])
# ['ABCDEH', 'FG']

# Un graphe en deux morceaux : retirer toutes les canalisations entre A à E et F, G, H.
split = [e for e in PIPES if not (set(e[:2]) & set('FGH')) or set(e[:2]) <= set('FGH')]
tree, parts = kruskal_until(split, 1)          # demande 1 groupe, mais seuls 2 peuvent exister
print(parts, sum(w for *_, w in tree))
# ['ABCDE', 'FGH'] 32
Arrêté à trois groupes, le programme renvoie {A, B, C}, {D, E, H} et {F, G}, les trois mêmes que ceux produits par le premier tour de Borůvka sur ce graphe, bien que cette concordance soit une coïncidence de l'exemple. Dans la dernière exécution, une fois retirées les canalisations entre les deux moitiés, Kruskal renvoie une forêt de deux arbres coûtant 32. Prim depuis A s'arrêterait après cinq villages et ne verrait jamais F, G ni H.
8. Poids négatifs, arbres maximaux et graphes orientés
- Les poids négatifs ne posent aucun problème. Contrairement à l'algorithme de Dijkstra, aucun des trois n'en est perturbé, car tout arbre couvrant possède exactement
V - 1arêtes. Ajouter la même constante à chaque poids augmente le coût de chaque arbre du même montant et laisse le choix inchangé. Soustraire 10 à chaque canalisation de l'exemple, ce qui rend la plupart des poids négatifs, donne le même arbre. - Arbres couvrants maximaux. Prenez l'opposé des poids, ou triez par ordre décroissant. L'arbre couvrant le plus cher de l'exemple coûte 87.
- Goulots d'étranglement. Un arbre couvrant de poids minimal minimise aussi son arête la plus lourde. Dans l'exemple, cette arête est
E-Fà 8, et aucun arbre couvrant ne peut éviter une arête d'au moins 8. - Graphes orientés. Aucun des trois ne fonctionne sur les graphes orientés. La version orientée du problème, l'arborescence minimale, nécessite l'algorithme de Chu-Liu/Edmonds.
9. Prim n'est pas Dijkstra
L'algorithme de Prim et celui de Dijkstra se ressemblent presque à l'identique dans le code, et la différence tient à une ligne : Prim ordonne la file selon le poids de l'unique arête qui atteint un sommet, tandis que Dijkstra l'ordonne selon la distance totale depuis la source. Ils optimisent des choses différentes et construisent des arbres différents. Le guide de l'algorithme de Prim les compare ligne par ligne.
Sur l'exemple, l'arbre des plus courts chemins de Dijkstra depuis A utilise A-C à 6 au lieu de B-C à 4. Il coûte 32 au total, contre 30 pour l'arbre couvrant de poids minimal. En contrepartie, chaque village est au moins aussi proche de A par cet arbre : C est à 6 au lieu de 7, H à 20 au lieu de 21 et G à 24 au lieu de 25. Un arbre couvrant de poids minimal minimise le coût de construction du réseau et ne dit rien de la longueur d'un itinéraire donné.
10. Une histoire embrouillée
Les trois noms sont trompeurs quant à savoir qui est arrivé en premier. L'algorithme le plus ancien est celui de Borůvka. En 1926, le mathématicien tchèque Otakar Borůvka l'a publié après que Jindřich Saxel, employé de la compagnie d'électricité de Moravie occidentale, lui a demandé, durant l'hiver 1925, comment électrifier le sud-ouest de la Moravie au moindre coût. Vojtěch Jarník a ensuite décrit ce qu'on appelle aujourd'hui l'algorithme de Prim en 1930, dans un article rédigé sous forme de lettre à Borůvka. Joseph Kruskal a publié sa méthode en 1956, et Robert Prim a redécouvert l'algorithme de Jarník en 1957 aux Bell Laboratories, tout comme Edsger Dijkstra en 1959. L'algorithme de Prim est donc parfois appelé algorithme de Jarník ou algorithme DJP, bien que « Prim » reste de loin le nom le plus courant. La méthode de Borůvka a elle-même été redécouverte plusieurs fois, et dans certains ouvrages elle porte le nom de Sollin, qui l'a présentée lors d'un séminaire à Paris en 1961 sans jamais la publier.
Les méthodes les plus rapides connues se sont bien éloignées de ces classiques. David Karger, Philip Klein et Robert Tarjan ont donné en 1995 un algorithme randomisé en temps linéaire espéré. Bernard Chazelle a donné en 2000 un algorithme déterministe qui s'exécute en O(E α(E, V)), où α est la fonction d'Ackermann inverse, qui vaut au plus 4 pour tout graphe qu'il serait possible de stocker. En 2002, Seth Pettie et Vijaya Ramachandran ont trouvé un algorithme prouvablement optimal, bien que personne ne sache quel est réellement son temps d'exécution : il se situe quelque part entre le linéaire et la borne de Chazelle. L'algorithme de Karger, Klein et Tarjan utilise les tours de Borůvka comme brique de base.
11. Où chacun est utilisé
- Conception de réseaux. Poser des câbles, des canalisations ou des routes au moindre coût est l'application d'origine. Les projets réels ajoutent des contraintes, comme le guide sur la conception de réseaux le montre, et l'arbre couvrant de poids minimal est le point de départ habituel.
- Classification. La classification à lien simple est l'algorithme de Kruskal arrêté tôt, et c'est pourquoi Kruskal est le choix habituel pour cette tâche. La méthode de segmentation d'images par graphes de Pedro Felzenszwalb et Daniel Huttenlocher traite les arêtes triées de la même manière.
- Approximation de problèmes plus difficiles. Avec des poids positifs ou nuls, la meilleure tournée du voyageur de commerce coûte toujours au moins autant qu'un arbre couvrant de poids minimal. L'heuristique de Christofides part d'un tel arbre et garantit une tournée d'au plus 1,5 fois l'optimum lorsque les distances respectent l'inégalité triangulaire.
- Données géométriques. Lorsque chaque paire de points est une arête candidate, le graphe est complet et Prim avec un tableau est le choix naturel.
- Calcul parallèle. Chaque tour de Borůvka permet à chaque groupe de travailler indépendamment, c'est pourquoi cette méthode est le point de départ habituel des algorithmes parallèles, tandis que Prim et Kruskal sont intrinsèquement séquentiels.
12. Erreurs fréquentes
| Erreur | Pourquoi c'est faux | Correction |
|---|---|---|
| Utiliser Prim sur un graphe non connexe et se fier au résultat | Il ne couvre que la composante du sommet de départ | Relancez-le dans chaque composante, ou utilisez Kruskal |
| Supposer que Prim avec un tas est toujours le meilleur | Sur le graphe dense, la version à tableau a pris cinq fois moins d'étapes | Utilisez la version à tableau lorsque E est proche de V2 |
| Traiter un arbre couvrant de poids minimal comme un ensemble de plus courts chemins | Dans l'exemple, il atteint C à 7, alors que le plus court trajet coûte 6 | Utilisez Dijkstra pour les trajets, un arbre couvrant pour le coût de construction |
| Tester un arbre exact lorsque des poids peuvent être égaux | Plusieurs arbres minimaux peuvent exister, et l'ordre de l'entrée en choisit un | Comparez le poids total |
| Départager les égalités de façon incohérente dans Borůvka | Des groupes peuvent choisir des arêtes qui forment un cycle | Comparez par poids, puis selon un ordre fixe des arêtes |
| Éviter ces algorithmes à cause de poids négatifs | Les poids négatifs n'affectent aucun des trois | Exécutez-les sans modification |
| Les exécuter sur un graphe orienté | La propriété de coupe concerne les arêtes non orientées | Utilisez l'algorithme de Chu-Liu/Edmonds |
| Laisser Kruskal parcourir toutes les arêtes | L'arbre est complet après V - 1 arêtes acceptées | Arrêtez-vous dès que vous les avez |
13. Glossaire
| Terme | Signification |
|---|---|
| Arbre couvrant | Un arbre qui contient tous les sommets du graphe |
| Arbre couvrant de poids minimal | Un arbre couvrant dont le poids total est le plus petit |
| Forêt couvrante | Un arbre couvrant pour chaque composante connexe |
| Propriété de coupe | L'arête la moins chère traversant une coupe peut faire partie d'un arbre couvrant de poids minimal |
| Propriété de cycle | L'arête la plus chère d'un cycle peut être écartée |
| Union-find | Une structure qui suit des groupes et les fusionne rapidement |
| File de priorité | Une structure qui renvoie toujours la plus petite clé ; généralement un tas binaire |
| Graphe dense | Un graphe dans lequel une grande partie des paires de sommets sont reliées par des arêtes |
| Graphe creux | Un graphe ayant peu d'arêtes par rapport à V2, typiquement un petit multiple de V |
| Classification à lien simple | Regroupement par fusion répétée des deux groupes les plus proches |
| Arête goulot d'étranglement | L'arête la plus lourde d'un arbre |
| Arborescence | Un arbre orienté dont toutes les arêtes s'éloignent d'une même racine |
14. Questions fréquentes
Quelle est la différence entre l'algorithme de Prim et celui de Kruskal ?
L'algorithme de Prim fait croître un seul arbre connexe depuis un sommet de départ, en ajoutant toujours l'arête la moins chère qui en sort. L'algorithme de Kruskal trie toutes les arêtes et les prend de la moins chère à la plus chère, en ignorant celles qui fermeraient un cycle, de sorte que son arbre commence en fragments épars qui fusionnent. Les deux trouvent un arbre couvrant de poids minimal de même poids total.
Lequel est le meilleur, Prim ou Kruskal ?
Cela dépend du graphe. Kruskal est le choix naturel pour les graphes creux et pour les arêtes données sous forme de liste ou déjà triées. Prim avec un simple tableau est le choix naturel pour les graphes denses, puisqu'il s'exécute en O(V au carré) et n'a pas besoin de trier les arêtes. Sur les graphes creux, Prim avec un tas binaire et Kruskal coûtent à peu près la même chose.
Prim et Kruskal donnent-ils le même arbre couvrant de poids minimal ?
Si tous les poids d'arêtes sont différents, l'arbre couvrant de poids minimal est unique et les deux renvoient exactement les mêmes arêtes. Si certains poids sont égaux, il peut exister plusieurs arbres couvrants de poids minimal, et les deux algorithmes peuvent en renvoyer des différents, mais ils ont toujours le même poids total.
Qu'est-ce que l'algorithme de Borůvka ?
L'algorithme de Borůvka procède par tours. À chaque tour, chaque groupe de sommets connectés choisit son arête la moins chère vers un autre groupe, et toutes ces arêtes sont ajoutées en même temps. Le nombre de groupes est au moins divisé par deux à chaque tour, il y a donc au plus log2 V tours et le temps d'exécution est O(E log V). Comme les groupes travaillent indépendamment, il se prête bien au calcul parallèle.
Prim et Kruskal gèrent-ils les poids d'arêtes négatifs ?
Oui. Contrairement à l'algorithme de Dijkstra, Prim, Kruskal et Borůvka fonctionnent tous correctement avec des poids négatifs. Tout arbre couvrant a exactement V - 1 arêtes, donc ajouter la même constante à chaque poids modifie le coût de chaque arbre de la même quantité et ne change pas l'arbre le moins cher.
Quelle est la différence entre l'algorithme de Prim et l'algorithme de Dijkstra ?
Leur code est presque identique, mais Prim ordonne les sommets selon le poids de l'unique arête qui les atteint, tandis que Dijkstra les ordonne selon la distance totale depuis la source. Prim construit l'arbre de poids total minimal. Dijkstra construit un arbre de plus courts chemins depuis une source, qui peut coûter plus cher au total, mais donne des trajets plus courts depuis cette source.
15. Références
Les algorithmes, bornes et attributions ci-dessus proviennent des sources suivantes, classées par ordre chronologique.
- Borůvka, O. (1926). "O jistém problému minimálním." Práce Moravské přírodovědecké společnosti 3, 37 à 58.
- Jarník, V. (1930). "O jistém problému minimálním (Z dopisu panu O. Borůvkovi)." Práce Moravské přírodovědecké společnosti 6, 57 à 63.
- Kruskal, J. B. (1956). "On the Shortest Spanning Subtree of a Graph and the Traveling Salesman Problem." Proceedings of the American Mathematical Society 7(1), 48 à 50.
- Prim, R. C. (1957). "Shortest Connection Networks and Some Generalizations." Bell System Technical Journal 36(6), 1389 à 1401.
- Dijkstra, E. W. (1959). "A Note on Two Problems in Connexion with Graphs." Numerische Mathematik 1, 269 à 271.
- Chu, Y.-J. et Liu, T.-H. (1965). "On the Shortest Arborescence of a Directed Graph." Scientia Sinica 14, 1396 à 1400.
- Edmonds, J. (1967). "Optimum Branchings." Journal of Research of the National Bureau of Standards 71B, 233 à 240.
- Gower, J. C. et Ross, G. J. S. (1969). "Minimum Spanning Trees and Single Linkage Cluster Analysis." Journal of the Royal Statistical Society, Series C 18(1), 54 à 64.
- Tarjan, R. E. (1975). "Efficiency of a Good But Not Linear Set Union Algorithm." Journal of the ACM 22(2), 215 à 225.
- Christofides, N. (1976). Worst-Case Analysis of a New Heuristic for the Travelling Salesman Problem. Report 388. Pittsburgh : Carnegie Mellon University.
- Graham, R. L. et Hell, P. (1985). "On the History of the Minimum Spanning Tree Problem." Annals of the History of Computing 7(1), 43 à 57.
- Fredman, M. L. et Tarjan, R. E. (1987). "Fibonacci Heaps and Their Uses in Improved Network Optimization Algorithms." Journal of the ACM 34(3), 596 à 615.
- Karger, D. R., Klein, P. N. et Tarjan, R. E. (1995). "A Randomized Linear-Time Algorithm to Find Minimum Spanning Trees." Journal of the ACM 42(2), 321 à 328.
- Chazelle, B. (2000). "A Minimum Spanning Tree Algorithm with Inverse-Ackermann Type Complexity." Journal of the ACM 47(6), 1028 à 1047.
- Nešetřil, J., Milková, E. et Nešetřilová, H. (2001). "Otakar Borůvka on Minimum Spanning Tree Problem." Discrete Mathematics 233(1 à 3), 3 à 36.
- Pettie, S. et Ramachandran, V. (2002). "An Optimal Minimum Spanning Tree Algorithm." Journal of the ACM 49(1), 16 à 34.
- Felzenszwalb, P. F. et Huttenlocher, D. P. (2004). "Efficient Graph-Based Image Segmentation." International Journal of Computer Vision 59(2), 167 à 181.
- Kleinberg, J. et Tardos, É. (2005). Algorithm Design. Boston : Addison-Wesley.
- Bader, D. A. et Cong, G. (2006). "Fast Shared-Memory Algorithms for Computing the Minimum Spanning Forest of Sparse Graphs." Journal of Parallel and Distributed Computing 66(11), 1366 à 1378.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. et Stein, C. (2009). Introduction to Algorithms, 3e édition. Cambridge, MA : MIT Press.
- Osipov, V., Sanders, P. et Singler, J. (2009). "The Filter-Kruskal Minimum Spanning Tree Algorithm." Dans Proceedings of the 11th Workshop on Algorithm Engineering and Experiments, 52 à 61.
Regardez l'arbre grandir
Construisez les huit villages dans le visualiseur et exécutez Prim depuis A. Exécutez ensuite Kruskal sur le même graphe et comparez l'ordre dans lequel les arêtes apparaissent.
Ouvrir le visualiseur