
目录
1. 两个图“相同”是什么意思
两个图如果只是顶点的名字不同、实际上是同一个图,就称它们是同构的。形式化地说, G 与 H 同构(记作 G ≅ H),是指存在一个双射 f,把 G 的顶点映到 H 的顶点上,使得 u 与 v 在 G 中相邻,当且仅当 f(u) 与 f(v) 在 H中相邻。这样的 f 称为一个同构。两个方向都很重要:边必须映为边,非边也必须映为非边。
同构忽略一切不属于结构的东西。顶点的名字不算数,画法也不算数:顶点在纸面上的位置、边的长短、边是否交叉,都无关紧要。两幅看起来毫不相像的图可以表示同一个图,这正是这个问题有趣的地方。顶点与边指南用一句话介绍了这个概念;本文讨论的是如何判定它。
贯穿全文的示例是三棱柱,取自平面图指南,这里记作 G;另外还有一个图 H,画成带三条弦的六边形:
G = {AB, BC, CA, DE, EF, FD, AD, BE, CF}          两个三角形加三条连接边
H = {12, 23, 34, 45, 56, 61, 13, 25, 46}          六边形 1..6 加弦 13, 25, 46

f:  A→1   B→2   C→3   D→6   E→5   F→4
检查 G 的任意一条边,它的像都是 H中的一条边: AD 映到 16, DF 映到 64, BE 映到 25。两个图都有九条边,而 f 把这九条边映到那九条边上,所以它也把非边映为非边。 G 与 H 是同一个图。同构是一种等价关系,所以图可以划分为若干同构类,人们通常所说的给定顶点数的图的“形状”,指的就是这些同构类。
2. 一个看似相同却不同的图
现在取第三个图 K:同样的六边形,但以三条长直径 14、 25 和 36 作为弦。它有 6 个顶点和 9 条边,每个顶点的度都是 3,而且画法与 H相同。它与 G不同构。
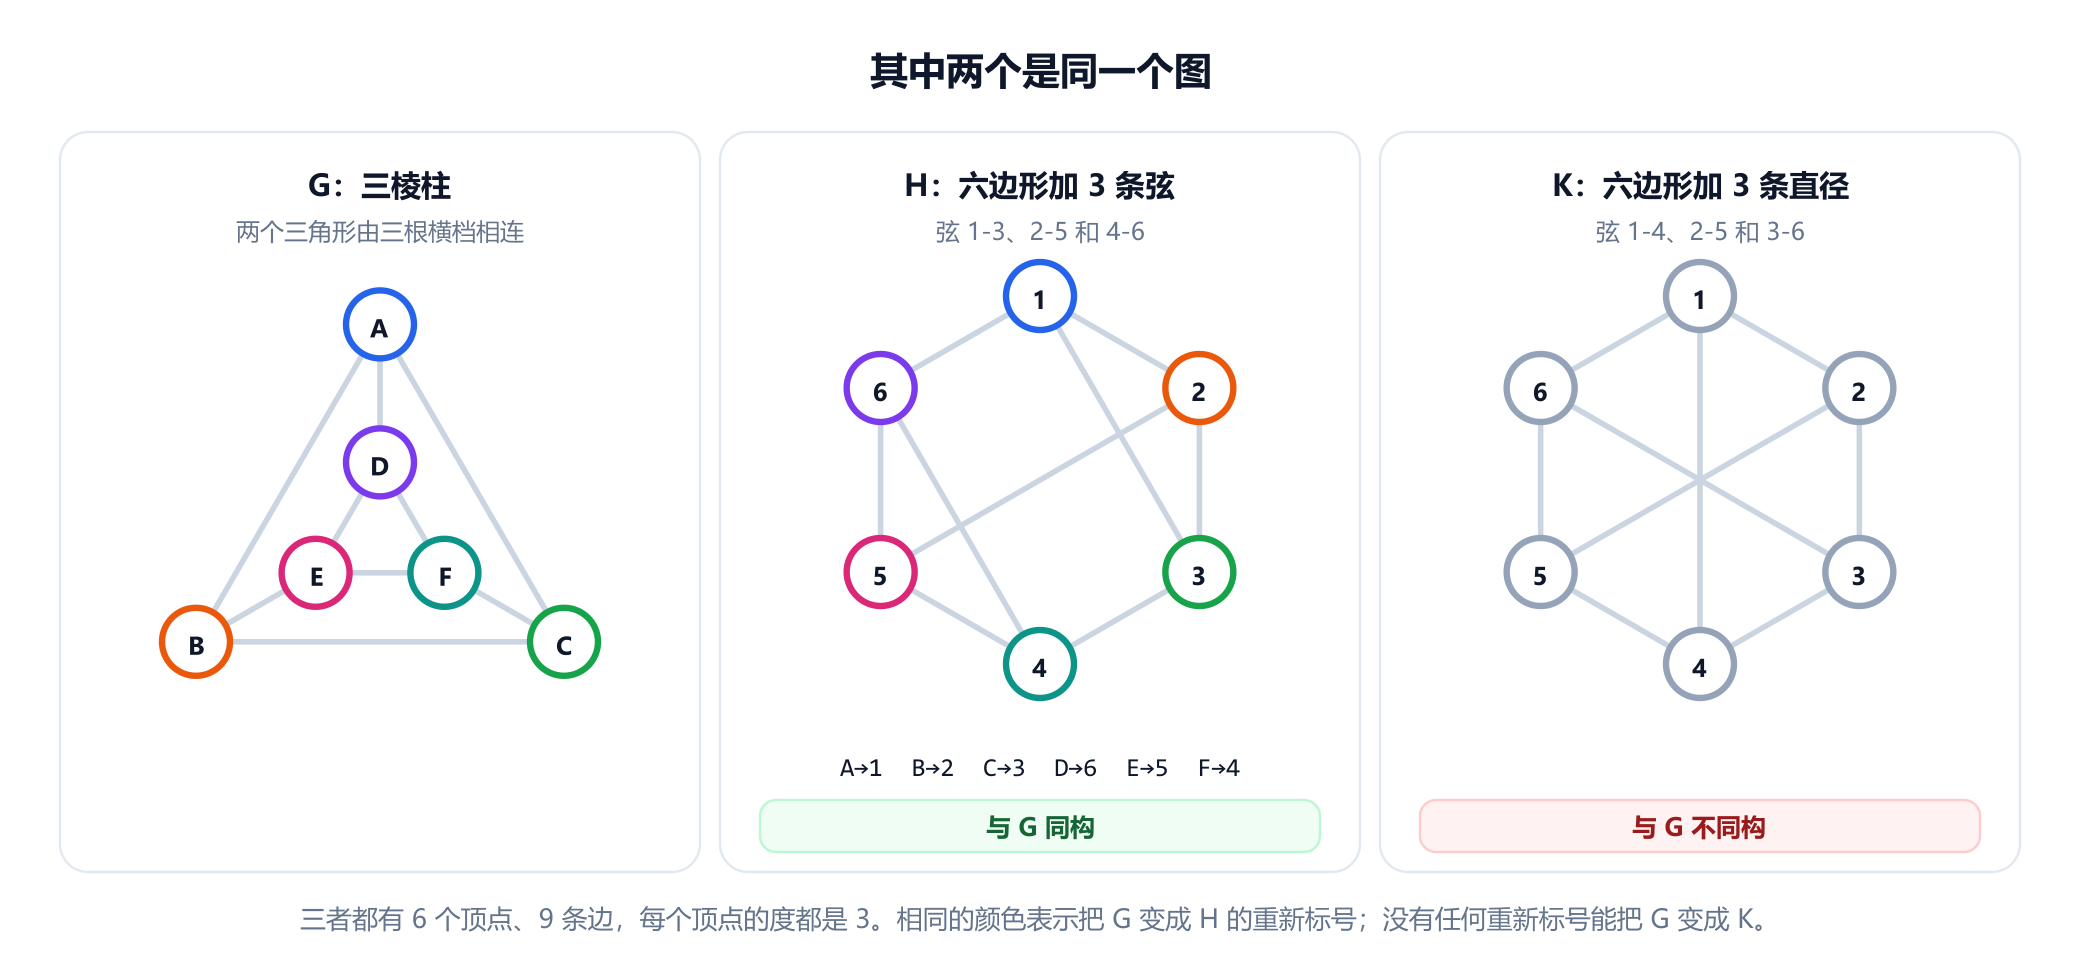
最快的证明是找三角形。 G 有两个三角形, ABC 和 DEF,而同构必须把三角形映为三角形。 K 一个三角形也没有:它的顶点分成奇数号和偶数号两组,每条边都连接一个奇数号顶点和一个偶数号顶点,所以 K 是二分图,不含长度为奇数的环,正如二分图指南所解释的。事实上, K 就是完全二分图 K3,3,也就是让三公用设施谜题无解的那个图。在所有显而易见的计数上都一致的两个图仍然可能不同,这门学问的很大一部分就是寻找能把它们区分开的那个计数。
3. 不变量:证明两个图不同
所谓图不变量,是指同构的图总是共有的任何量:顶点数和边数、度序列、三角形的个数、图是否连通或是否为二分图、围长、色数、邻接矩阵的特征值,等等。不变量只在一个方向上起作用。
如果两个图在任何一个不变量上不同,它们就不同构。如果它们在你计算过的每个不变量上都一致,你并没有得到任何确定的结论。
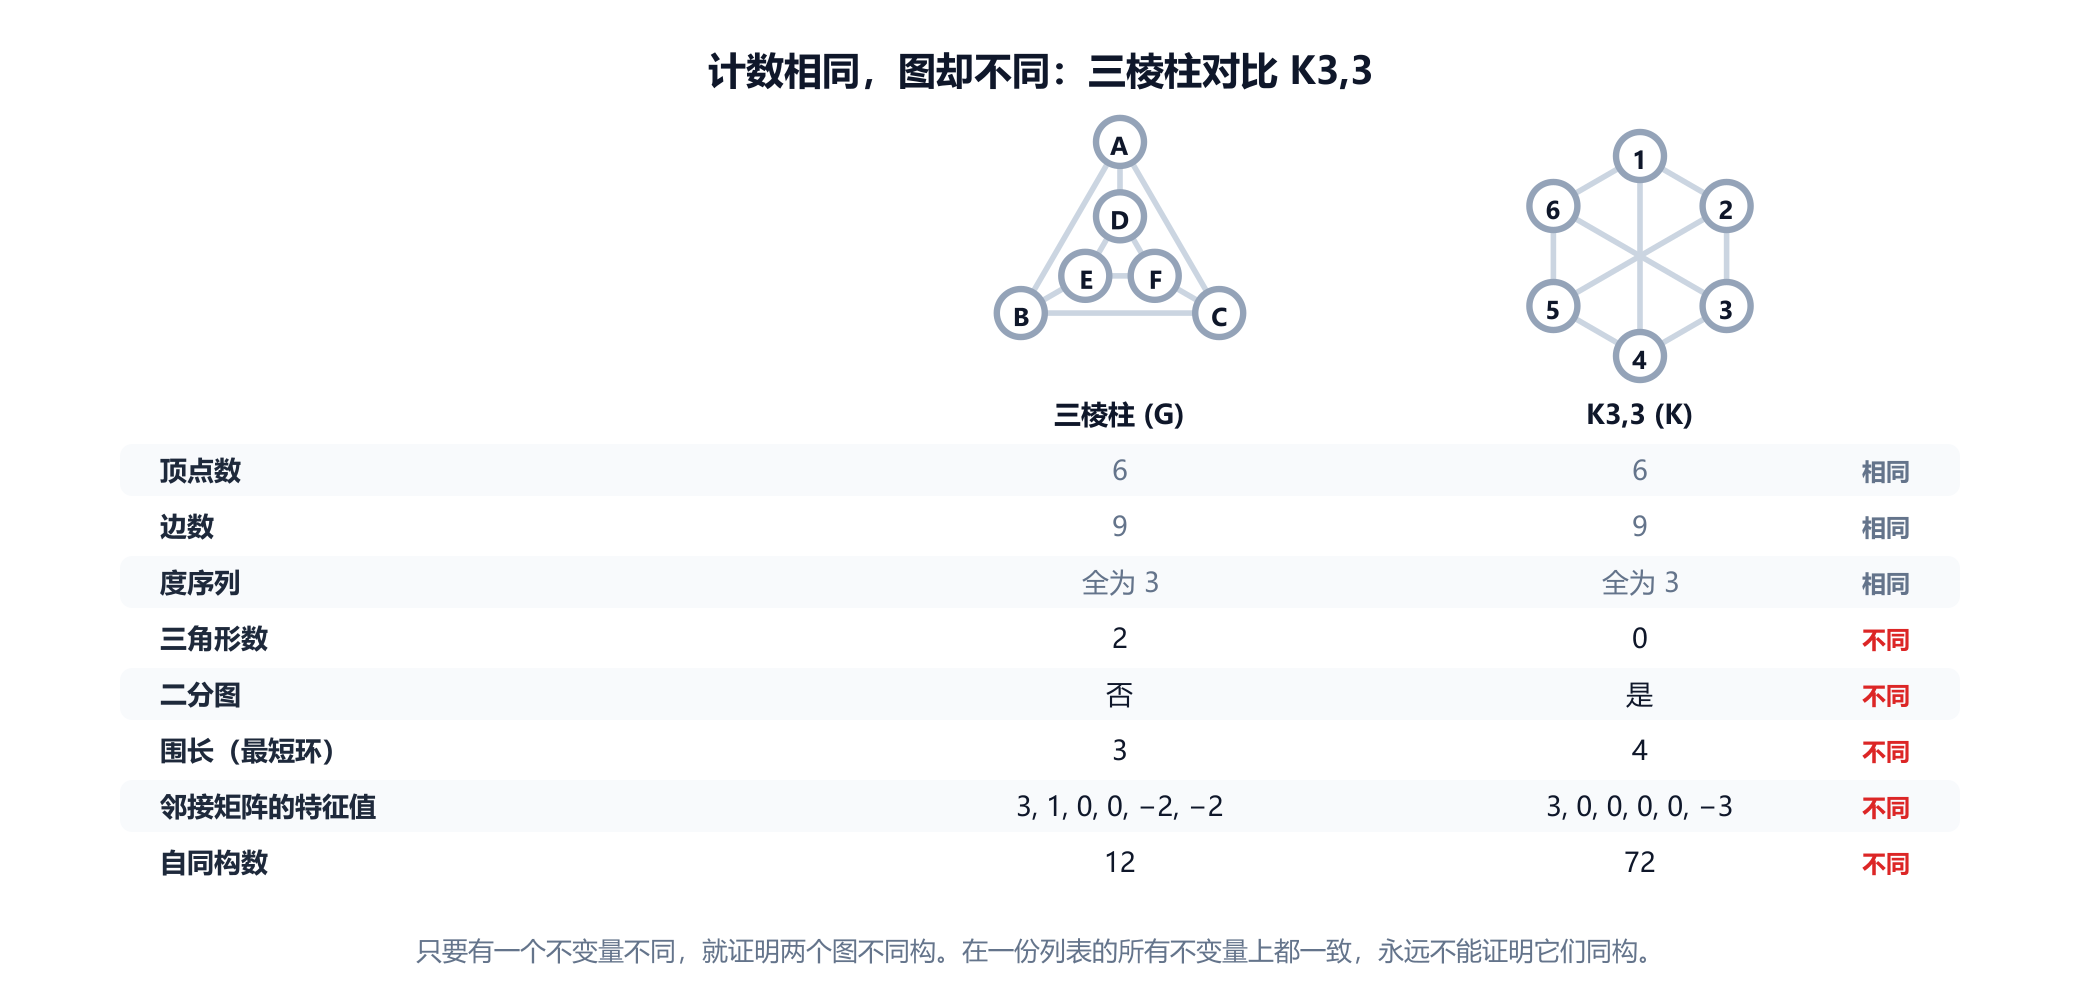
每个简单的不变量都有盲点。度序列察觉不到三棱柱与 K3,3之间的区别。即使是完整的特征值列表,看起来像是指纹,其实也不是:星形图 K1,4 与“长度为 4 的环加一个孤立顶点”的特征值都是 2, 0, 0, 0, −2,而它们显然是不同的图。这是最小的同谱图对,归功于 Collatz 和 Sinogowitz(1957 年)。如果有一个不变量能区分每一对不同构的图,并且能被快速计算,整个问题就解决了,但目前还不知道有这样的不变量。
4. 不同的图到底有多少个?
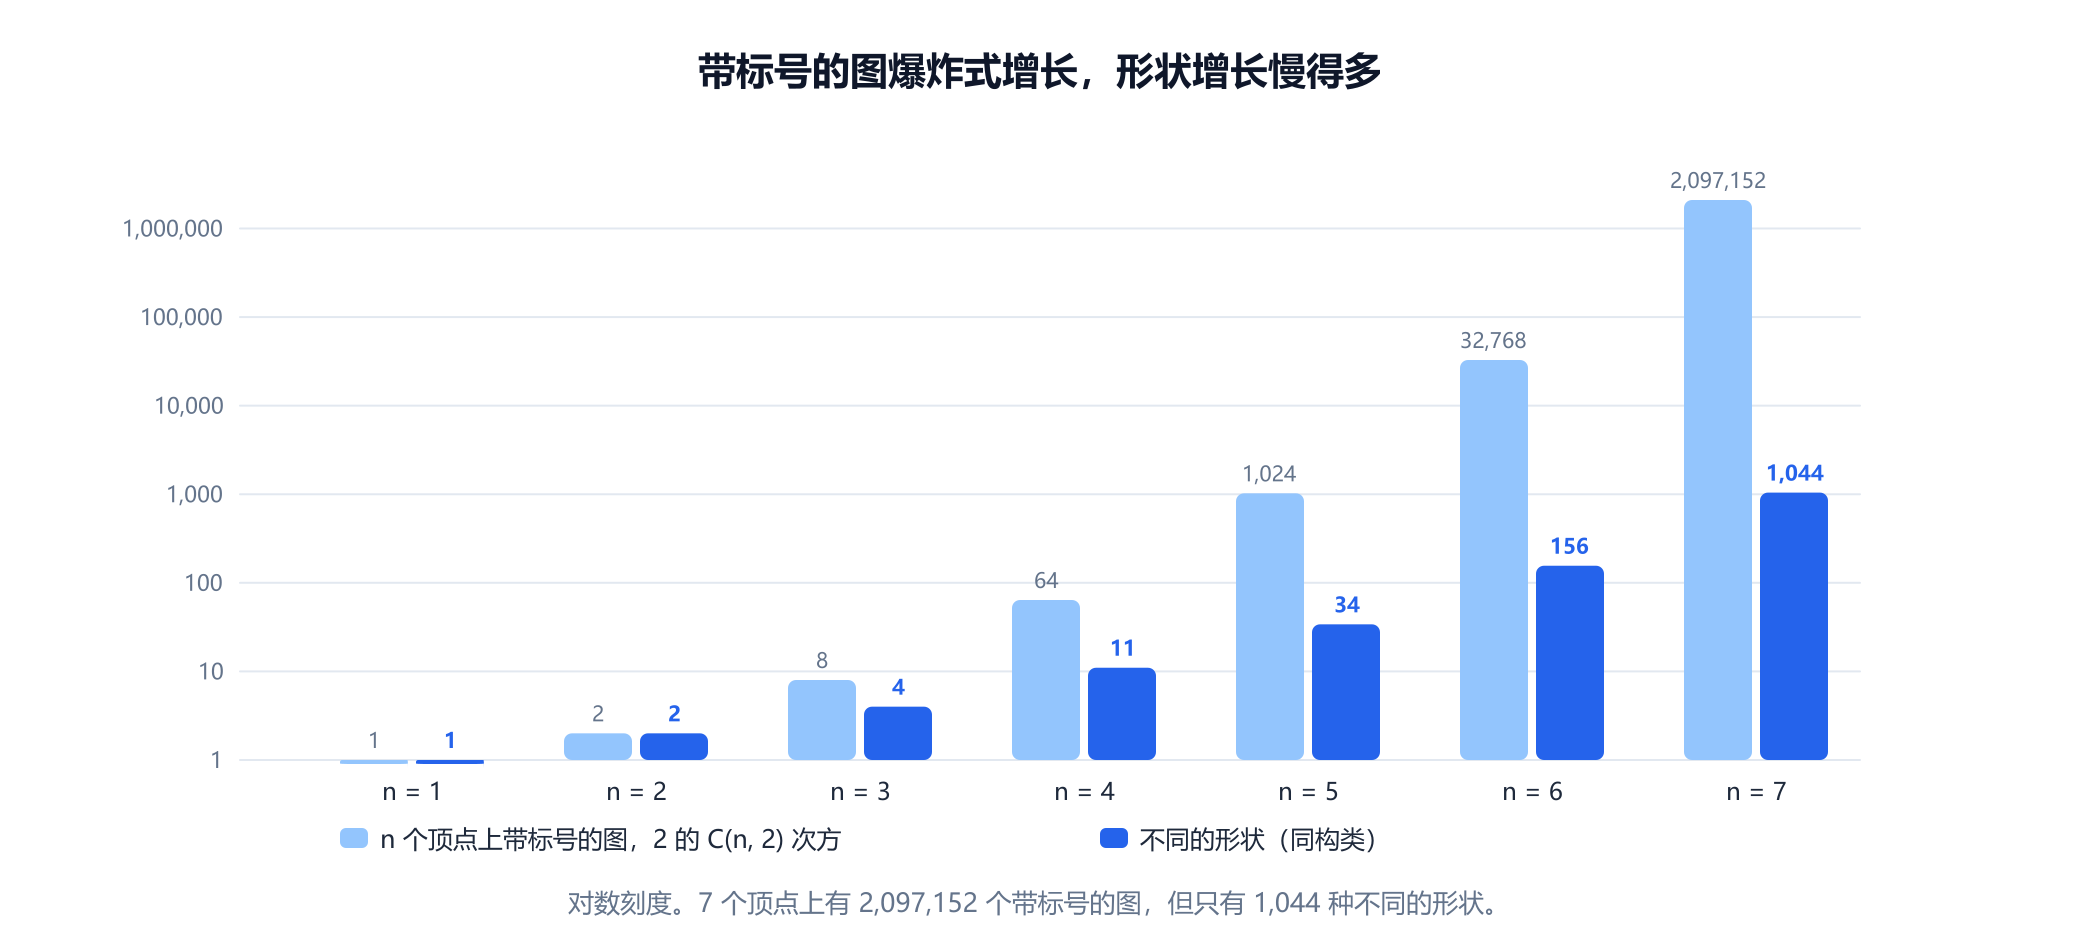
在 n 个带标号的顶点上,共有 C(n, 2) 条可能的边,每条边可以存在或不存在,因此共有 2C(n, 2) 个带标号的图。其中大多数是彼此的重新标号。真正不同的形状(即同构类)的数量增长得要慢得多:
from itertools import combinations, permutations

def count_graphs(n):
    """n 个顶点上带标号的图的个数,以及它们分属多少种不同的形状。"""
    pairs = list(combinations(range(n), 2))
    index = {p: i for i, p in enumerate(pairs)}
    seen, shapes = set(), 0
    for mask in range(1 << len(pairs)):
        if mask in seen:
            continue
        shapes += 1                           # 一个新的同构类:标记它的所有重新标号
        edges = [p for i, p in enumerate(pairs) if mask >> i & 1]
        for perm in permutations(range(n)):
            m = 0
            for u, v in edges:
                a, b = sorted((perm[u], perm[v]))
                m |= 1 << index[(a, b)]
            seen.add(m)
    return 1 << len(pairs), shapes

for n in range(1, 6):
    print(n, count_graphs(n))
# 1 (1, 1)
# 2 (2, 2)
# 3 (8, 4)
# 4 (64, 11)
# 5 (1024, 34)
暴力计数止步于五个顶点,因为它要尝试每个图的每一种重新标号。这个数列接下来是:六个顶点 156 个,七个顶点 1,044 个,八个顶点 12,346 个。它没有简单的闭合公式;标准工具是 Pólya 于 1937 年提出的计数理论,它在不计对称差别的意义下对对象计数。两列数字之间的差距正是同构检验之所以重要的原因:一个列举图、分子或电路的程序,必须能识别出它的两个输出何时是同一个对象换了一副面孔。
5. 通过搜索检验
定义本身就给出了一个算法:尝试每一个双射,逐个检查。对于 n 个顶点,共有 n! 个双射,六个顶点的示例只有 720 个,而二十个顶点时约有 2.4 × 10¹⁸ 个,所以朴素方法只适用于玩具规模。有两个想法使搜索在中小规模的图上变得可行。第一,只要某个廉价的不变量(如度序列)不同,就立即拒绝。第二,一次一个顶点地构建映射,只尝试度相同的像,一旦某条边或非边无法匹配就立即回溯。
def graph(edges):
    adj = {}
    for e in edges:
        u, v = e.split('-')
        adj.setdefault(u, set()).add(v)
        adj.setdefault(v, set()).add(u)
    return adj

def isomorphisms(G, H):
    """逐个生成所有双射 f: V(G) -> V(H),使得 uv 是边当且仅当 f(u)f(v) 是边。"""
    if len(G) != len(H) or sorted(map(len, G.values())) != sorted(map(len, H.values())):
        return                                # 一个廉价的不变量已经给出否定答案
    order = sorted(G, key=lambda v: -len(G[v]))
    def extend(f, used):
        if len(f) == len(order):
            yield dict(f)
            return
        u = order[len(f)]
        for x in H:
            if x in used or len(H[x]) != len(G[u]):
                continue                      # 度必须相同
            if all((w in G[u]) == (f[w] in H[x]) for w in f):
                f[u] = x                      # 与目前已映射的每个顶点都一致
                yield from extend(f, used | {x})
                del f[u]
    yield from extend({}, set())

G = graph(['A-B', 'B-C', 'C-A', 'D-E', 'E-F', 'F-D', 'A-D', 'B-E', 'C-F'])   # 三棱柱
H = graph(['1-2', '2-3', '3-4', '4-5', '5-6', '6-1', '1-3', '2-5', '4-6'])   # 六边形 + 3 条弦
K = graph(['1-2', '2-3', '3-4', '4-5', '5-6', '6-1', '1-4', '2-5', '3-6'])   # 六边形 + 3 条直径

print(next(isomorphisms(G, H)))
# {'A': '1', 'B': '2', 'C': '3', 'D': '6', 'E': '5', 'F': '4'}
print(sum(1 for _ in isomorphisms(G, H)))     # 与 G 的对称个数一样多
# 12
print(next(isomorphisms(G, K), None))         # 度相同,但不存在同构
# None
第一行输出就是第 1 节中的映射。第二行表明,从 G 到 H恰好有 12 个不同的同构,第 7 节将解释这个数并非偶然。第三行确认,从三棱柱到 K3,3 的映射并不存在,尽管度的检查已经通过。这个函数在 3,000 对随机图上与 networkx 做过对照检验,其中一半是彼此的重新标号副本,它返回的每个映射都逐边验证过。回溯在最坏情况下仍是指数级的:所有顶点看起来都一样的图会让度剪枝失效,这正是下一个想法的用武之地。
6. 颜色细化及其盲点
颜色细化,也称为一维 Weisfeiler–Leman 算法(得名于 Weisfeiler 和 Leman 1968 年的论文),它给每个顶点一种颜色,并不断利用邻域来细化这些颜色。开始时所有顶点都是同一种颜色。每一轮中,只有当两个顶点原来的颜色相同、且它们的邻居所带旧颜色的多重集也相同时,才给它们相同的新颜色。当没有颜色类再分裂时停止。把它同时运行在两个图上:如果最终各颜色的计数不同,这两个图就不同构。
from collections import Counter

def colour_refinement(adj, rounds=None):
    """1-WL:反复根据每个顶点自身的颜色及其邻居颜色的多重集为它重新着色。"""
    colour = {v: 0 for v in adj}
    for _ in range(rounds or len(adj)):
        signature = {v: (colour[v], tuple(sorted(colour[w] for w in adj[v]))) for v in adj}
        palette = {s: i for i, s in enumerate(sorted(set(signature.values())))}
        new = {v: palette[signature[v]] for v in adj}
        if len(set(new.values())) == len(set(colour.values())):
            break                             # 已稳定:没有颜色类分裂
        colour = new
    return colour

def joint(G, H):
    """若细化无法区分 G 和 H,则返回 True。将两者一起细化,使颜色可以对应。"""
    union = {('g', v): {('g', w) for w in G[v]} for v in G}
    union.update({('h', v): {('h', w) for w in H[v]} for v in H})
    c = colour_refinement(union)
    return (sorted(Counter(c[k] for k in union if k[0] == 'g').items()) ==
            sorted(Counter(c[k] for k in union if k[0] == 'h').items()))

def graph(edges):
    adj = {}
    for e in edges:
        u, v = e.split('-')
        adj.setdefault(u, set()).add(v)
        adj.setdefault(v, set()).add(u)
    return adj

T1 = graph(['a-b', 'b-c', 'c-d', 'b-e', 'e-f'])       # 中心为 b,三条腿的长度为 2、2 和 1
T2 = graph(['a-b', 'b-c', 'c-d', 'd-e', 'b-f'])       # 中心为 b,三条腿的长度为 3、1 和 1
prism = graph(['A-B', 'B-C', 'C-A', 'D-E', 'E-F', 'F-D', 'A-D', 'B-E', 'C-F'])
k33 = graph(['1-2', '2-3', '3-4', '4-5', '5-6', '6-1', '1-4', '2-5', '3-6'])

print(joint(T1, T2))      # 度序列相同,但细化能区分它们
# False
print(joint(prism, k33))  # 都是 3 正则图:细化无法区分它们
# True
示例中的两棵树具有相同的度序列 (3, 2, 2, 1, 1, 1),所以度的检查无法区分它们。细化却可以:经过几轮之后,紧挨中心的叶子和长腿末端的叶子会得到不同的颜色,两棵树的颜色计数便不再相同。总体而言,细化很强大。Babai、Erdős 和 Selkow 在 1980 年证明,一种基于度的简单细化可以识别几乎所有的图,因此在随机图上,同构是容易判定的。
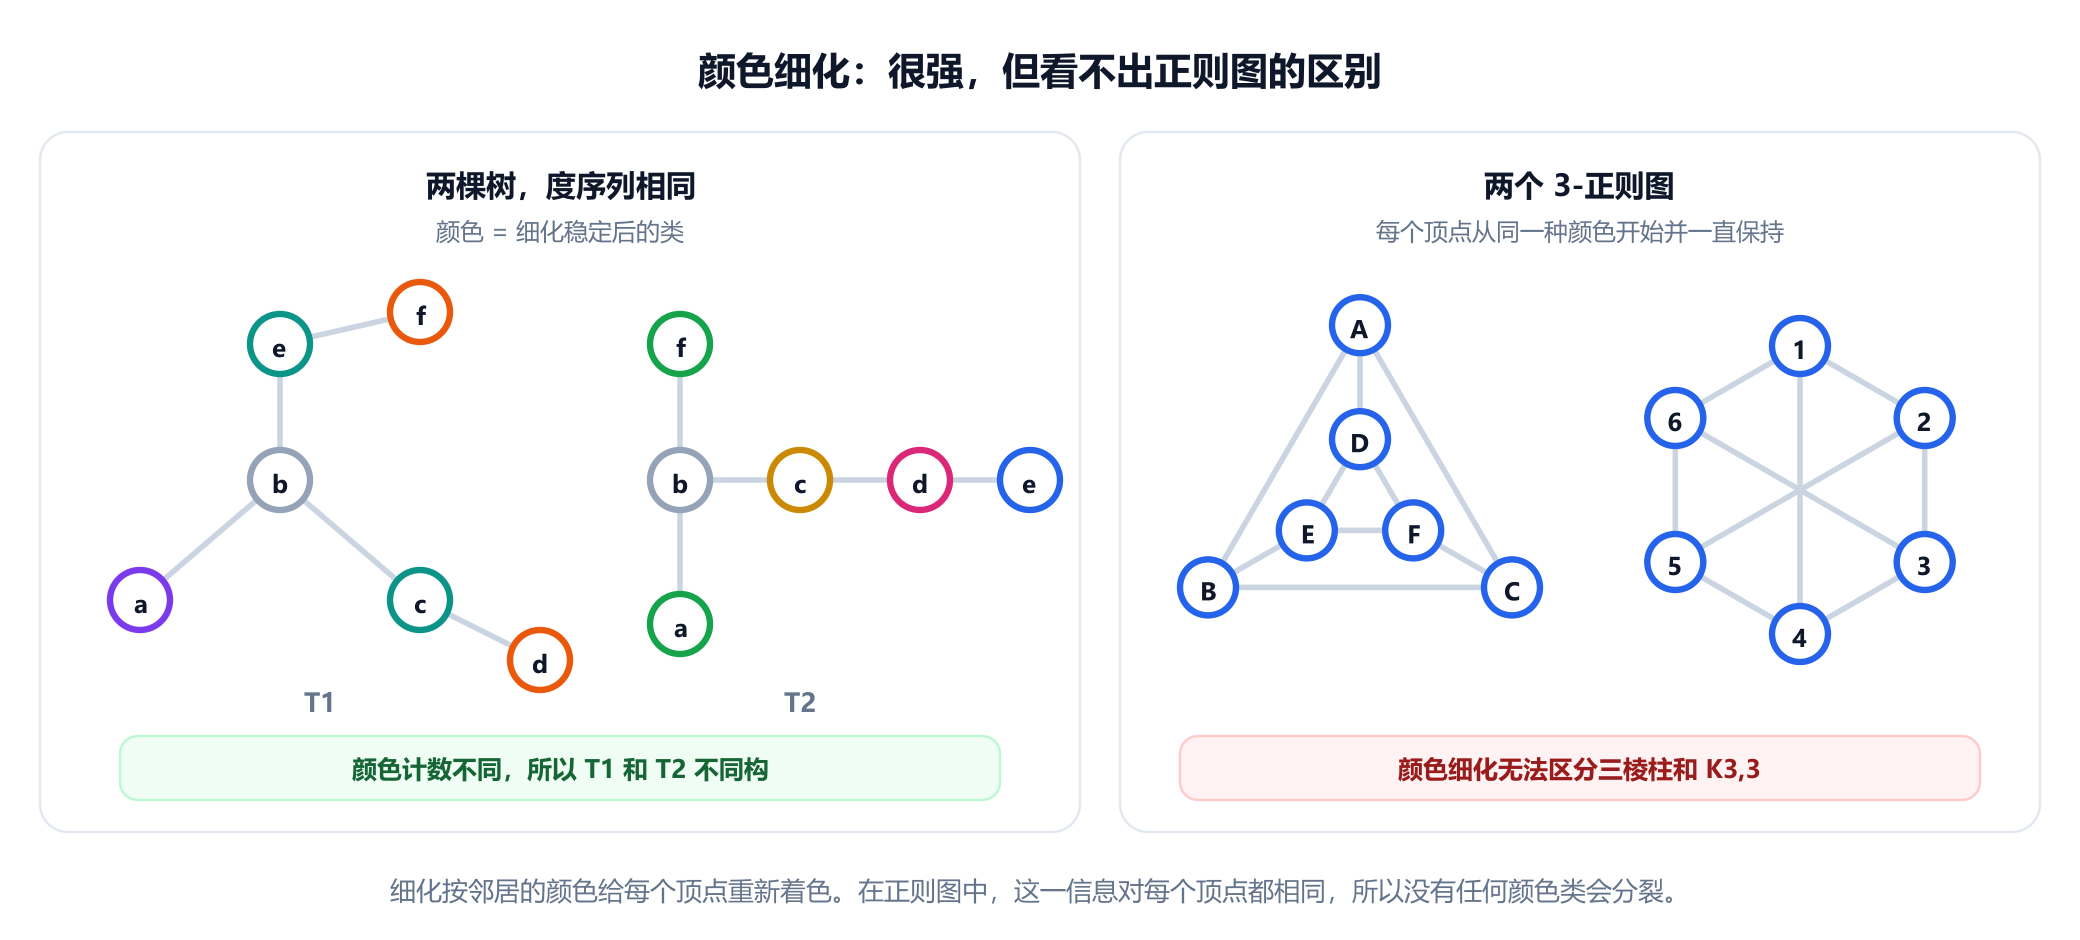
盲点在于正则性。在 k正则图中,每个顶点开始时颜色相同,并且都有 k 个该颜色的邻居,所以第一轮什么也不会改变,算法立即停止。任何两个顶点数相同、度也相同的正则图,在它看来都一模一样,这就是三棱柱与 K3,3 会一起通过这项检验的原因。同样的局限也延伸到机器学习:Xu 等人在 2019 年证明,消息传递图神经网络只有在颜色细化能区分两个图时才能区分它们,这就是为什么图神经网络指南把 Weisfeiler–Leman 检验当作衡量它们的标尺。更强的版本对顶点对或顶点三元组而非单个顶点进行颜色细化;它们看得更多,但代价也更高。
7. 自同构:图自身的对称性
从一个图到它自身的同构称为自同构,即图的一种对称。一个图的所有自同构构成一个群,群的大小衡量了这个图有多对称。三棱柱有 12 个自同构:把两个三角形一起旋转或翻转,得到 6 种对称,再选择是否交换两个三角形。 K3,3 有 72 个,因为每一侧可以有 6 种排列方式,并且两侧可以互换;Petersen 图则有 120 个。
这就解释了第 5 节中的 12。如果 f 是从 G 到 H的一个同构,那么其他每一个同构都是 f 与 G的某个自同构的复合,所以两个同构的图之间的同构个数,总是恰好等于其中任一个图的自同构个数。只想要一个答案的搜索会浪费时间去探索同一映射的对称副本,最好的实用算法会利用它们发现的自同构来剪枝。
两个经典结果展示了对称性在两个方向上能走多远。Frucht 在 1939 年证明,每个有限群都是某个图的自同构群,所以对称性可以取任何形式。而 Erdős 和 Rényi 在 1963 年证明,几乎所有的图都是非对称的,即除了恒等映射之外没有任何自同构。在这一点上,小图具有欺骗性:顶点数在二到五之间的图没有一个是非对称的,最小的非对称图有六个顶点,共有八个;而在七个顶点的 1,044 个图中,只有 152 个是非对称的。“几乎所有”只有在 n 增大时才会占据主导。
8. 规范形式:每种形状一个名字
当数据库中有数百万个图时,两两比较是行不通的。另一种方法是规范形式:一种重新标号的规则,把每个图映到其同构类中一个固定的代表,使得两个图同构当且仅当它们的规范形式完全相同。一旦每个图都有了规范形式,同构就变成了字符串相等,数据库就可以像对待其他任何键一样,对图进行索引、哈希和去重。
最简单的规范形式是:在全部 n! 种重新标号中,取邻接矩阵读作比特串时最小的那一种。这是正确的,但太慢了。实用工具用个体化与细化来计算规范形式:先运行颜色细化,当它卡在一类看起来相同的顶点上时,挑出其中一个赋予新颜色,再次细化;如此探索由这些选择构成的搜索树,并用沿途发现的自同构对其剪枝。McKay 的程序 nauty(1981 年发表)以及 McKay 和 Piperno 于 2014 年与 nauty 一同介绍的 Traces 都是这样工作的,在实践中能处理有成千上万个顶点的图。
9. 图同构有多难?
图同构在复杂性理论中占有特殊的位置。它属于 NP,因为给出的映射可以在多项式时间内验证。目前不知道它能否在多项式时间内求解。它也不太可能是 NP 完全的:Boppana、Håstad 和 Zachos 在 1987 年证明,如果它是 NP 完全的,多项式层级就会坍缩到第二层,而大多数研究者认为这不太可能。它是极少数被认为严格介于容易问题与 NP 完全问题之间的自然问题之一。
目前最好的通用算法来自 Babai。他在 2015 年 11 月宣布了这一结果,并于 2016 年在 STOC 上发表:图同构可以在拟多项式时间内判定,即 exp((log n)O(1)),这不是多项式时间,但比指数时间好得多。2017 年 1 月,Helfgott 发现其中一步有错误,Babai 撤回了拟多项式的结论,几天之内他又宣布了修正,并得到 Helfgott 的确认。对于特殊的图类,已知的结果要多得多:
- 树可以用 Aho、Hopcroft 和 Ullman 的算法在线性时间内检验,该算法从叶子开始自底向上为每棵树构建一个规范编码,这一技术在图论中的树一文中有讨论。
- 平面图可以在线性时间内检验,这是 Hopcroft 和 Wong 在 1974 年证明的。
- 有界度的图可以在多项式时间内检验,这是 Luks 在 1982 年得到的结果,后来成为 Babai 算法的基石之一。
10. 子图同构是另一个问题
一个与之密切相关的问题是:一个图是否出现在另一个图之中?也就是说,是否存在 H 的一个子图与 G同构?这个子图同构问题要难得多。Cook 1971 年的论文(正是这篇论文奠定了 NP 完全性理论)就已经证明它与可满足性问题一样难,用今天的话说就是 NP 完全的。它把团问题作为特例包含在内:问一个图是否包含 Kk,就是问 Kk 是否是它的子图。
这两个问题很容易混淆,因为它们名字相近,算法风格也相同。实用的子图匹配器,如 Ullmann 1976 年的算法和 Cordella 等人 2004 年的 VF2,使用的都是第 5 节中带剪枝的回溯思想,但它们搜索的是一个模式,而不是完美匹配,人们也并不期望它们有拟多项式的上界。当有人说某个问题是“图同构问题”时,值得问一问他指的是这两者中的哪一个。
11. 同构检验用在哪里
- 化学。分子的化学键构成一个图,化学数据库利用规范形式把每种结构只存储一次,并能即时查找化合物。图同构是化学同一性的必要条件而非充分条件:立体异构体具有相同的键图,只是在空间中的排列不同。
- 电路验证。检查芯片版图是否实现了它的原理图(即所谓的版图与原理图对照检查),需要把从版图中提取出的晶体管网络与预期的网络进行匹配。
- 枚举与数据库。生成给定规模的所有图、所有分子或所有设计时,需要剔除重复项,这意味着要为每个候选对象计算规范形式。
- 图上的机器学习。第 6 节中与 Weisfeiler–Leman 的联系,既被用来衡量图神经网络的表达能力,也被用作比较图的快速基线方法。
- 优化中的对称性。问题结构的自同构意味着存在许多等价解;检测出它们可以让求解器跳过这些副本。
12. 常见错误
| 错误 | 为什么错 | 修正 |
|---|---|---|
| “度序列相同,所以同构” | 三棱柱与 K3,3 都是 6 个顶点上的 3 正则图 | 只用不变量来证明图不同;要证明它们相同,就找出一个映射 |
| 只检查边是否映为边 | 一个映射可以把边映为边,却仍在像中多出新的边 | 要求边和非边都被保持,或者检查边数是否相等 |
| 根据画法来判断 | H 和 K 画法相似却不同; G 和 H 画法不同却同构 | 忽略位置,比较结构 |
| 把谱相同当作证明 | K1,4 和 C4 加一个顶点是同谱的,却是不同的图 | 把谱当作不变量,而不是证书 |
| 对正则图依赖颜色细化 | 它无法区分任何两个顶点数相同、度也相同的正则图 | 像 nauty 那样使用个体化与细化 |
| 把同构与子图同构混为一谈 | 前者可在拟多项式时间内求解;后者是 NP 完全的 | 确认你需要的是完美匹配,还是在更大的图中寻找一个模式 |
| 称图同构是 NP 完全的 | 它属于 NP,但人们并不认为它是 NP 完全的 | 应说“尚不知道它是否属于 P”,并提及 Babai 的拟多项式时间算法 |
13. 术语表
| 术语 | 含义 |
|---|---|
| 同构 | 顶点集之间保持相邻与不相邻关系的双射 |
同构的, G ≅ H | 两图之间存在同构;在不计名称的意义下是同一个图 |
| 同构类 | 与某个给定图同构的所有图;图的一种“形状” |
| 图不变量 | 同构的图总是共有的量 |
| 同谱图 | 邻接矩阵特征值相同的图 |
| 颜色细化,1-WL | 根据邻居的颜色反复为顶点重新着色 |
| 自同构 | 从一个图到它自身的同构;一种对称 |
| 非对称图 | 唯一的自同构是恒等映射的图 |
| 规范形式 | 同构类的一个固定代表,可从该类的任何成员计算得到 |
| 个体化与细化 | 挑出一个顶点,再次细化,并在这些选择上进行搜索 |
| 拟多项式时间 | 运行时间为 exp((log n)O(1)) |
| 子图同构 | 判定一个图是否出现在另一个图之中;NP 完全 |
14. 常见问题
两个图同构是什么意思?
如果两个图的顶点之间存在一个保持相邻关系的一一对应,即两个顶点在第一个图中相连当且仅当它们的像在第二个图中相连,那么这两个图就是同构的。同构的图是顶点名字不同的同一个图,无论它们画得多么不同。
如何判断两个图是否同构?
先比较不变量,如顶点数、边数、度序列和三角形的个数。任何一处不同都证明这两个图不同构。如果全都一致,就用回溯搜索一个映射,只尝试度相匹配的顶点,或者使用 nauty 这类计算规范形式的工具。仅凭不变量一致永远不构成证明。
什么是图不变量?
图不变量是同构的图总是共有的性质,例如边数、度序列、三角形的个数、是否为二分图、围长或邻接矩阵的特征值。一个不同的不变量就能证明两个图不同。目前还没有已知既能快速计算、又能区分每一对不同构图的不变量。
图同构是 NP 完全的吗?
图同构属于 NP,但不知道它是否是 NP 完全的,而且人们普遍认为它不是:如果它是,多项式层级就会坍缩。目前也不知道它能否在多项式时间内求解。Babai 在 2016 年证明它可以在拟多项式时间内求解,这远快于指数时间。
什么是 Weisfeiler-Leman 检验?
一维 Weisfeiler-Leman 检验,也就是颜色细化,会根据每个顶点自身的颜色及其邻居颜色的多重集,反复为每个顶点重新着色。如果两个图最终的颜色计数不同,它们就不同构。它能识别几乎所有的图,但无法区分任何两个顶点数相同、度也相同的正则图。
图同构与子图同构有什么区别?
图同构问的是两个图是否相同。子图同构问的是一个图是否作为子图出现在另一个图之中。后者是 NP 完全的,并把团问题作为特例包含在内,而图同构可以在拟多项式时间内求解。
15. 参考文献
以上定义、定理和归属均出自以下文献,按时间顺序排列。
- Pólya, G. (1937). "Kombinatorische Anzahlbestimmungen für Gruppen, Graphen und chemische Verbindungen." Acta Mathematica 68,145 至 254 页。在不计对称差别的意义下对对象计数。
- Frucht, R. (1939). "Herstellung von Graphen mit vorgegebener abstrakter Gruppe." Compositio Mathematica 6,239 至 250 页。
- Collatz, L. 和 Sinogowitz, U. (1957). "Spektren endlicher Grafen." Abhandlungen aus dem Mathematischen Seminar der Universität Hamburg 21,63 至 77 页。同谱图。
- Erdős, P. 和 Rényi, A. (1963). "Asymmetric Graphs." Acta Mathematica Academiae Scientiarum Hungaricae 14,295 至 315 页。
- Weisfeiler, B. 和 Leman, A. (1968). "The Reduction of a Graph to Canonical Form and the Algebra Which Appears Therein." Nauchno-Technicheskaya Informatsia,第 2 辑,第 9 期,12 至 16 页。
- Cook, S. A. (1971). "The Complexity of Theorem-Proving Procedures." Proceedings of the 3rd Annual ACM Symposium on Theory of Computing,151 至 158 页。证明子图同构与可满足性问题一样难。
- Aho, A. V., Hopcroft, J. E. 和 Ullman, J. D. (1974). The Design and Analysis of Computer Algorithms. 马萨诸塞州雷丁:Addison-Wesley。线性时间的树同构。
- Hopcroft, J. E. 和 Wong, J. K. (1974). "Linear Time Algorithm for Isomorphism of Planar Graphs (Preliminary Report)." Proceedings of the 6th Annual ACM Symposium on Theory of Computing,172 至 184 页。
- Ullmann, J. R. (1976). "An Algorithm for Subgraph Isomorphism." Journal of the ACM 23(1),31 至 42 页。
- Babai, L., Erdős, P. 和 Selkow, S. M. (1980). "Random Graph Isomorphism." SIAM Journal on Computing 9(3),628 至 635 页。
- McKay, B. D. (1981). "Practical Graph Isomorphism." Congressus Numerantium 30,45 至 87 页。
- Luks, E. M. (1982). "Isomorphism of Graphs of Bounded Valence Can Be Tested in Polynomial Time." Journal of Computer and System Sciences 25(1),42 至 65 页。
- Boppana, R. B., Håstad, J. 和 Zachos, S. (1987). "Does co-NP Have Short Interactive Proofs?" Information Processing Letters 25(2),127 至 132 页。
- Cordella, L. P., Foggia, P., Sansone, C. 和 Vento, M. (2004). "A (Sub)Graph Isomorphism Algorithm for Matching Large Graphs." IEEE Transactions on Pattern Analysis and Machine Intelligence 26(10),1367 至 1372 页。
- McKay, B. D. 和 Piperno, A. (2014). "Practical Graph Isomorphism, II." Journal of Symbolic Computation 60,94 至 112 页。
- Babai, L. (2016). "Graph Isomorphism in Quasipolynomial Time." Proceedings of the 48th Annual ACM Symposium on Theory of Computing,684 至 697 页。
- Diestel, R. (2017). Graph Theory,第 5 版。Graduate Texts in Mathematics 173。柏林:Springer。
- Xu, K., Hu, W., Leskovec, J. 和 Jegelka, S. (2019). "How Powerful are Graph Neural Networks?" International Conference on Learning Representations。