
Tabla de Contenidos
- 1. La respuesta corta
- 2. Un grafo, tres ejecuciones
- 3. Por qué los tres son correctos
- 4. Cuándo difieren los árboles
- 5. Velocidad: cuál es más rápido y cuándo
- 6. La forma de tu entrada
- 7. Grafos no conexos y parada anticipada
- 8. Pesos negativos, árboles máximos y grafos dirigidos
- 9. Prim no es Dijkstra
- 10. Una historia enredada
- 11. Dónde se usa cada uno
- 12. Errores comunes
- 13. Glosario
- 14. Preguntas frecuentes
- 15. Referencias
1. La respuesta corta
El algoritmo de Prim, el algoritmo de Kruskal y el algoritmo de Borůvka encuentran todos un árbol de expansión mínima: el conjunto de aristas más barato que conecta todos los vértices de un grafo ponderado. Lo construyen en órdenes distintos, y eso decide cuál conviene para cada grafo. La guía sobre árboles de expansión mínima presenta el problema en sí.
| Prim | Kruskal | Borůvka | |
|---|---|---|---|
| Estrategia | Hacer crecer un solo árbol desde un vértice inicial | Tomar las aristas de la más barata hacia arriba, saltándose las que cierran un ciclo | Cada grupo elige su arista saliente más barata, todos a la vez |
| Estructura de datos principal | Cola de prioridad o un arreglo simple | Lista de aristas ordenada y union-find | Union-find o reetiquetado |
| Tiempo | O(E log V) con un montículo binario, O(V2) con un arreglo | O(E log E), casi lineal si las aristas ya están ordenadas | O(E log V) |
| Entrada natural | Lista de adyacencia o matriz | Lista de aristas | Lista de aristas |
| Grafo no conexo | Cubre solo la componente del vértice inicial | Da un bosque de expansión | Da un bosque de expansión |
| Ideal para | Grafos densos, con la versión de arreglo | Grafos dispersos, aristas preordenadas, agrupamiento | Computación paralela y distribuida |
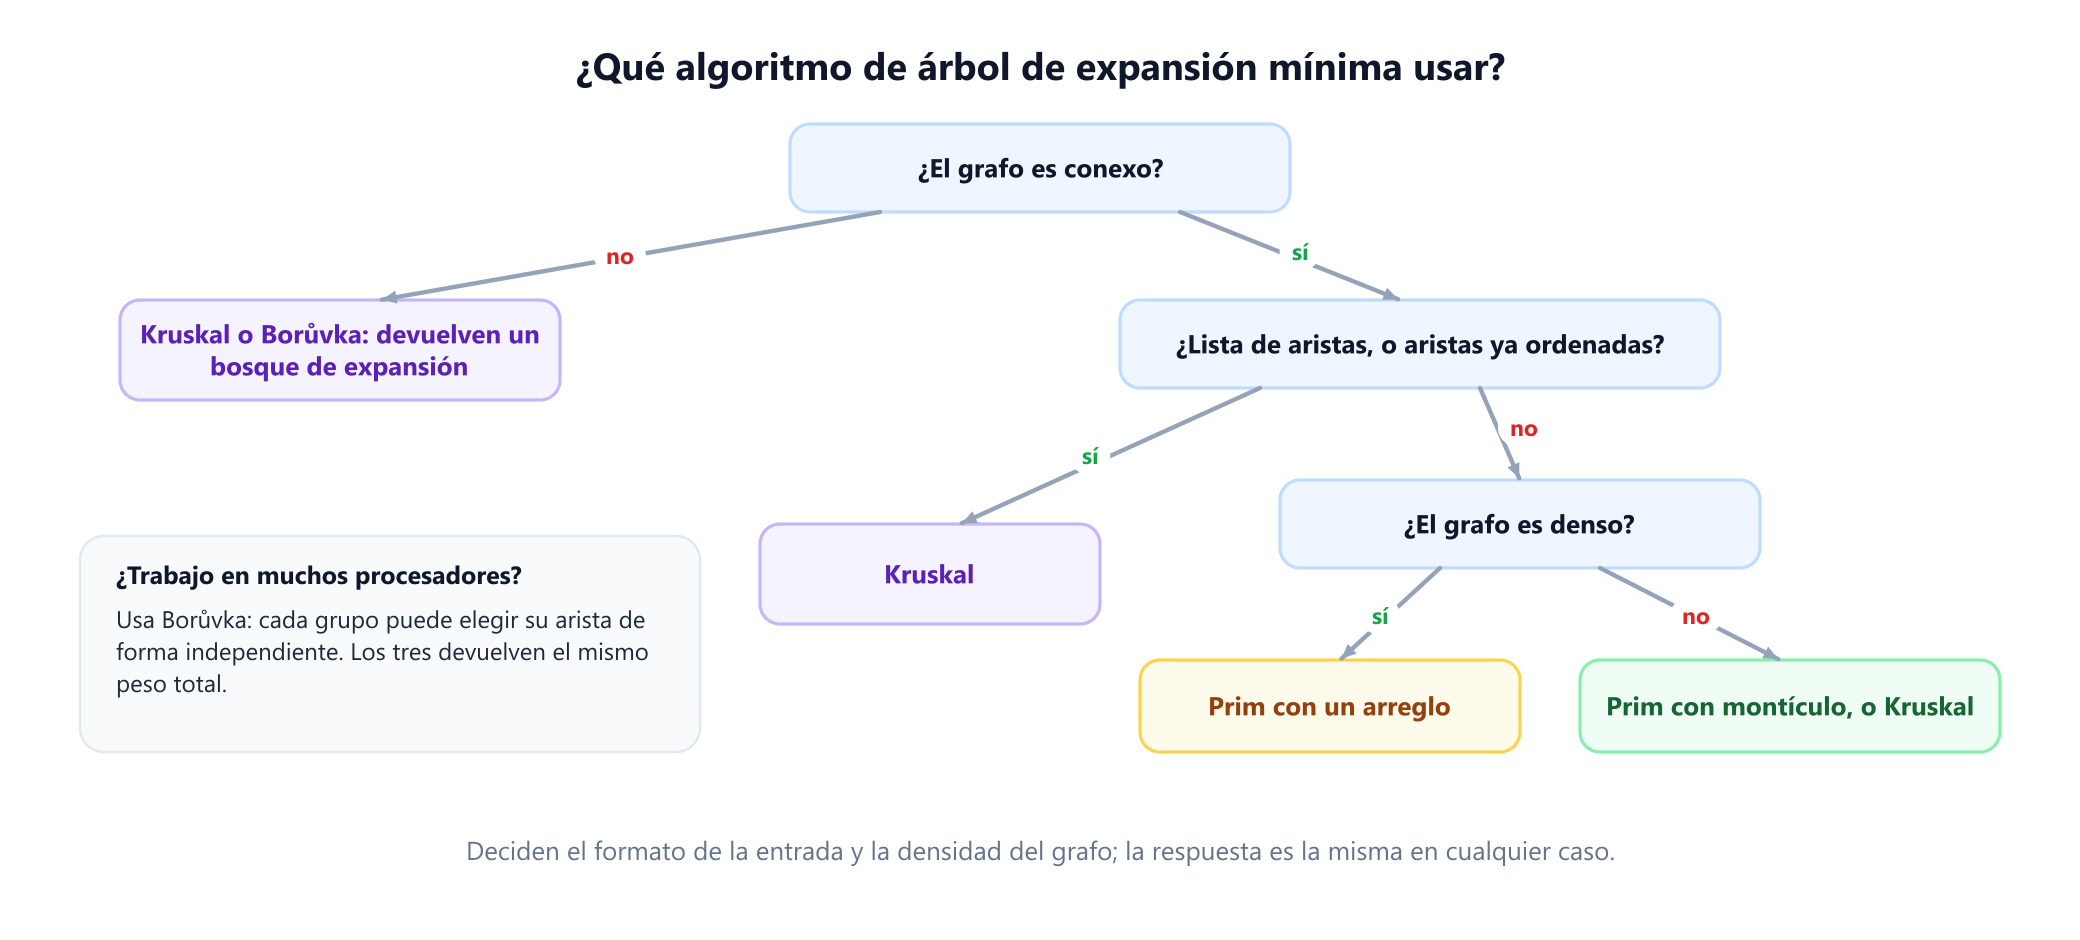
Aquí V es el número de vértices y E el número de aristas. En una frase: usa Kruskal cuando el grafo es disperso o viene dado como lista de aristas, usa Prim cuando es denso o viene dado como matriz, y considera Borůvka cuando el trabajo deba repartirse entre muchos procesadores. En un grafo disperso, Kruskal y Prim con montículo cuestan más o menos lo mismo, así que lo correcto es elegir el código más sencillo para tus datos.
2. Un grafo, tres ejecuciones
Ocho pueblos, de A a H, quieren unirse mediante tuberías de agua. Hay 14 rutas posibles, cada una con un coste en kilómetros de zanja, y cada pueblo debe acabar conectado con todos los demás. Las 14 rutas juntas costarían 117.
A-B 3    A-C 6    B-C 4    B-D 13   C-D 7    C-E 12   D-E 2
D-F 11   E-F 8    E-G 14   E-H 5    F-G 1    F-H 15   G-H 16

8 pueblos, 14 tuberías posibles
Una conexión de coste mínimo usa exactamente 7 tuberías, una menos que el número de pueblos, porque cualquier tubería adicional cerraría un ciclo que se podría eliminar para ahorrar dinero. Este grafo tiene 712 árboles de expansión, y exactamente uno de ellos cuesta el mínimo de 30. El programa siguiente implementa los tres algoritmos y los ejecuta sobre él.
import heapq

PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

class Groups:
    """Union-find: ¿en qué grupo está cada vértice?"""
    def __init__(self, items):
        self.parent = {x: x for x in items}
    def find(self, x):
        while self.parent[x] != x:
            self.parent[x] = self.parent[self.parent[x]]   # reducción del camino a la mitad
            x = self.parent[x]
        return x
    def union(self, a, b):
        ra, rb = self.find(a), self.find(b)
        if ra == rb:
            return False
        self.parent[ra] = rb
        return True

def vertices(edges):
    return sorted({x for u, v, _ in edges for x in (u, v)})

def prim(edges, start):
    """Hace crecer un árbol: añade siempre la arista más barata que sale de él."""
    adj = {v: [] for v in vertices(edges)}
    for u, v, w in edges:
        adj[u].append((w, u, v))
        adj[v].append((w, v, u))
    seen, heap, tree = {start}, list(adj[start]), []
    heapq.heapify(heap)
    while heap:
        w, u, v = heapq.heappop(heap)
        if v in seen:
            continue                                  # los dos extremos ya están en el árbol
        seen.add(v)
        tree.append((u, v, w))
        for e in adj[v]:
            if e[2] not in seen:
                heapq.heappush(heap, e)
    return tree

def kruskal(edges):
    """Toma las aristas de la más barata hacia arriba, saltándose las que cerrarían un ciclo."""
    groups, tree = Groups(vertices(edges)), []
    for u, v, w in sorted(edges, key=lambda e: e[2]):
        if groups.union(u, v):
            tree.append((u, v, w))
    return tree

def boruvka(edges):
    """En cada ronda, cada grupo elige a la vez su arista saliente más barata."""
    groups, tree, rounds = Groups(vertices(edges)), [], []
    while True:
        cheapest = {}
        for u, v, w in edges:
            ru, rv = groups.find(u), groups.find(v)
            if ru != rv:
                for r in (ru, rv):                    # los empates se resuelven igual en todas partes
                    if r not in cheapest or (w, u, v) < cheapest[r]:
                        cheapest[r] = (w, u, v)
        if not cheapest:
            return tree, rounds
        added = []
        for w, u, v in sorted(set(cheapest.values())):
            if groups.union(u, v):
                added.append((u, v, w))
        tree += added
        rounds.append(added)

def show(tree):
    return ' '.join(f'{u}{v}:{w}' for u, v, w in tree) + f'   total {sum(w for *_, w in tree)}'

print('Prim    ', show(prim(PIPES, 'A')))
# Prim     AB:3 BC:4 CD:7 DE:2 EH:5 EF:8 FG:1   total 30
print('Kruskal ', show(kruskal(PIPES)))
# Kruskal  FG:1 DE:2 AB:3 BC:4 EH:5 CD:7 EF:8   total 30
tree, rounds = boruvka(PIPES)
print('Boruvka ', show(tree))
# Boruvka  FG:1 DE:2 AB:3 BC:4 EH:5 CD:7 EF:8   total 30
for i, added in enumerate(rounds, 1):
    print('round', i, show(added))
# round 1 FG:1 DE:2 AB:3 BC:4 EH:5   total 15
# round 2 CD:7 EF:8   total 15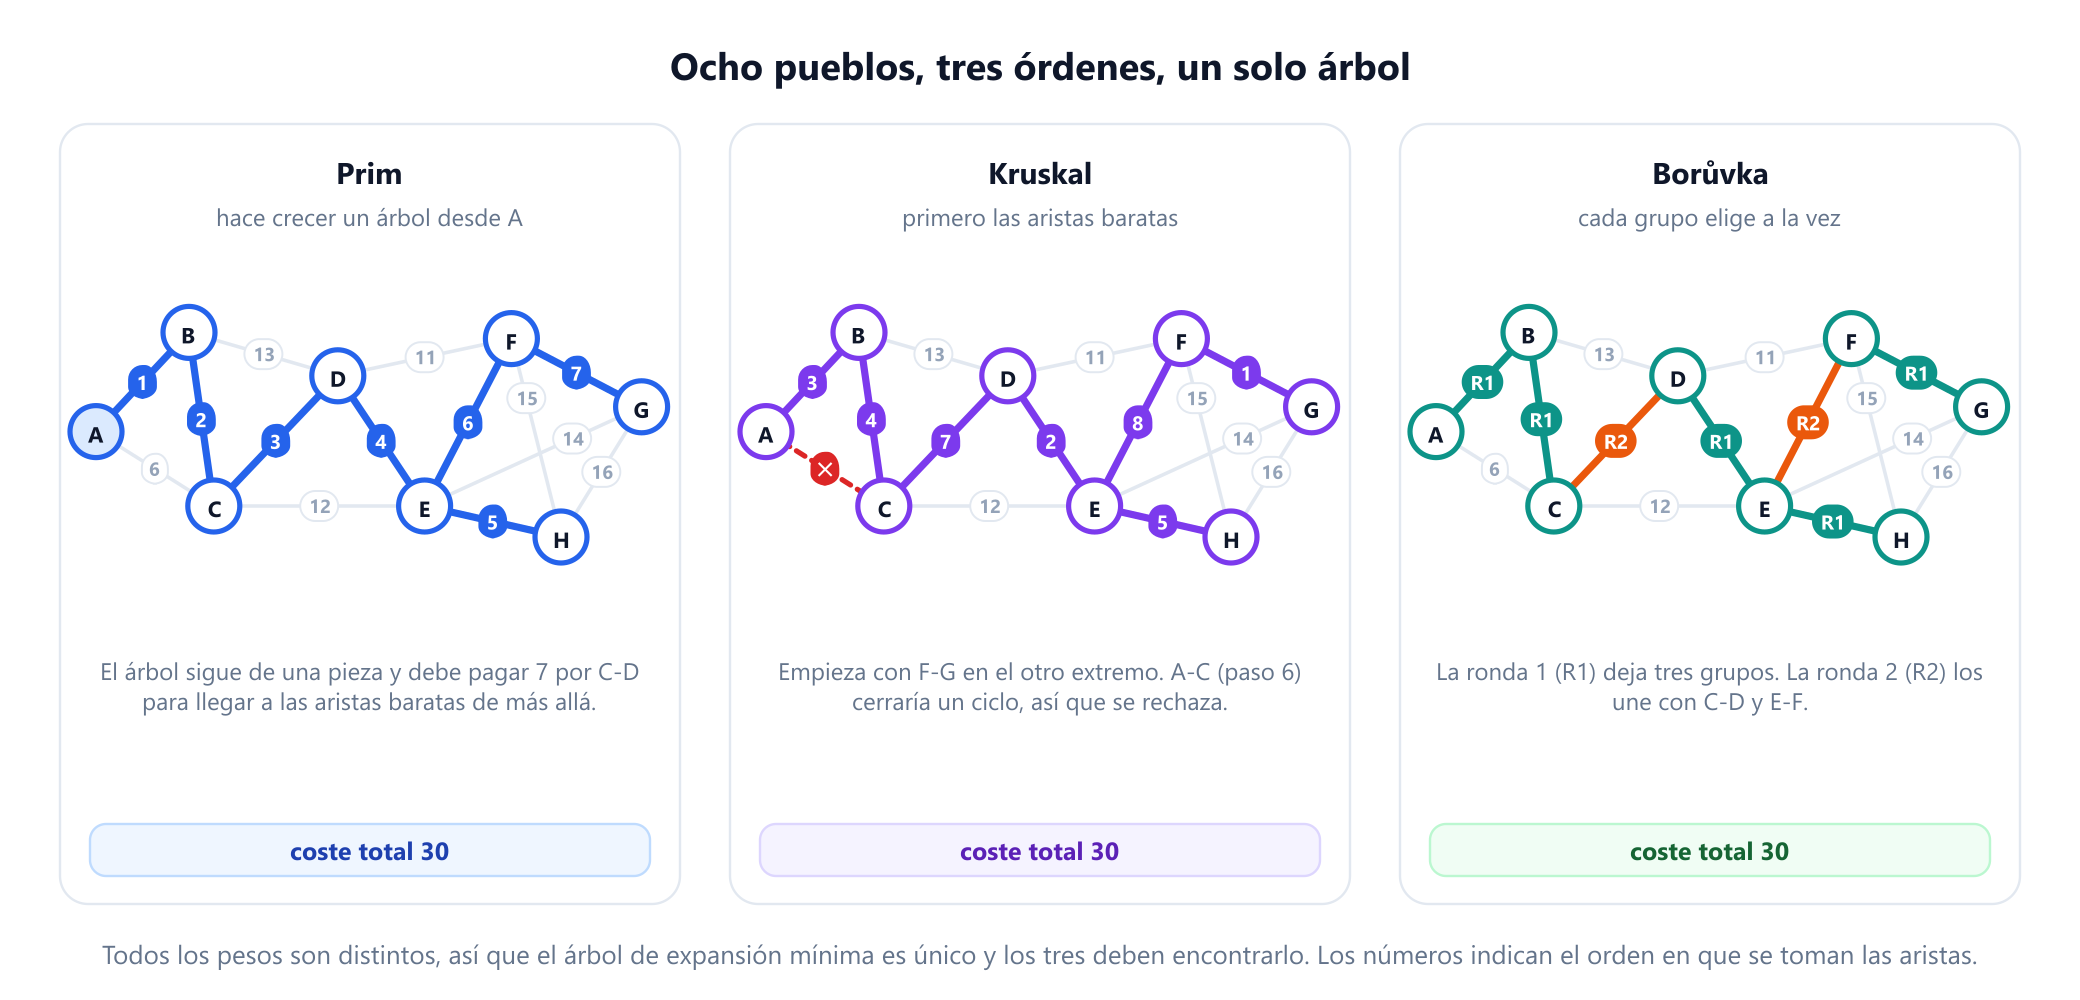
Los tres órdenes cuentan la historia de cada método:
- Prim empieza en
Ay siempre amplía el único árbol que tiene. TomaA-Bpor 3,B-Cpor 4 y luego tiene que pagar 7 porC-Dantes de poder llegar a las aristas baratasD-EyF-Gque quedan más allá. - Kruskal ignora la geografía. Toma primero
F-Gpor 1, en el otro extremo del grafo, y va subiendo por la lista de precios. Cuando llega aA-Cpor 6,AyCya están unidos a través deB, así que rechaza esa tubería. Después deE-Fpor 8 ya tiene 7 tuberías y puede parar, sin haber mirado siquiera las seis rutas más caras. - Borůvka trabaja por rondas. En la ronda 1 cada pueblo elige su tubería más barata, lo que da cinco tuberías distintas y tres grupos:
{A, B, C},{D, E, H}y{F, G}. En la ronda 2 cada grupo elige su tubería más barata hacia otro grupo, yC-DyE-Frematan el trabajo.
3. Por qué los tres son correctos
Por distintos que parezcan, los tres se apoyan en el mismo hecho sobre los cortes. Un corte divide los vértices en dos grupos, como la guía del corte mínimo explica. La propiedad del corte dice: para cualquier corte, la arista más barata que lo cruza pertenece a un árbol de expansión mínima, y cuando todos los pesos son distintos pertenece a todos ellos. La demostración es por intercambio. Toma un árbol de expansión que no use esa arista y añádela: esto cierra un ciclo, el ciclo debe cruzar el corte una segunda vez por alguna arista más cara, y al quitar esa arista más cara se obtiene un árbol más barato.
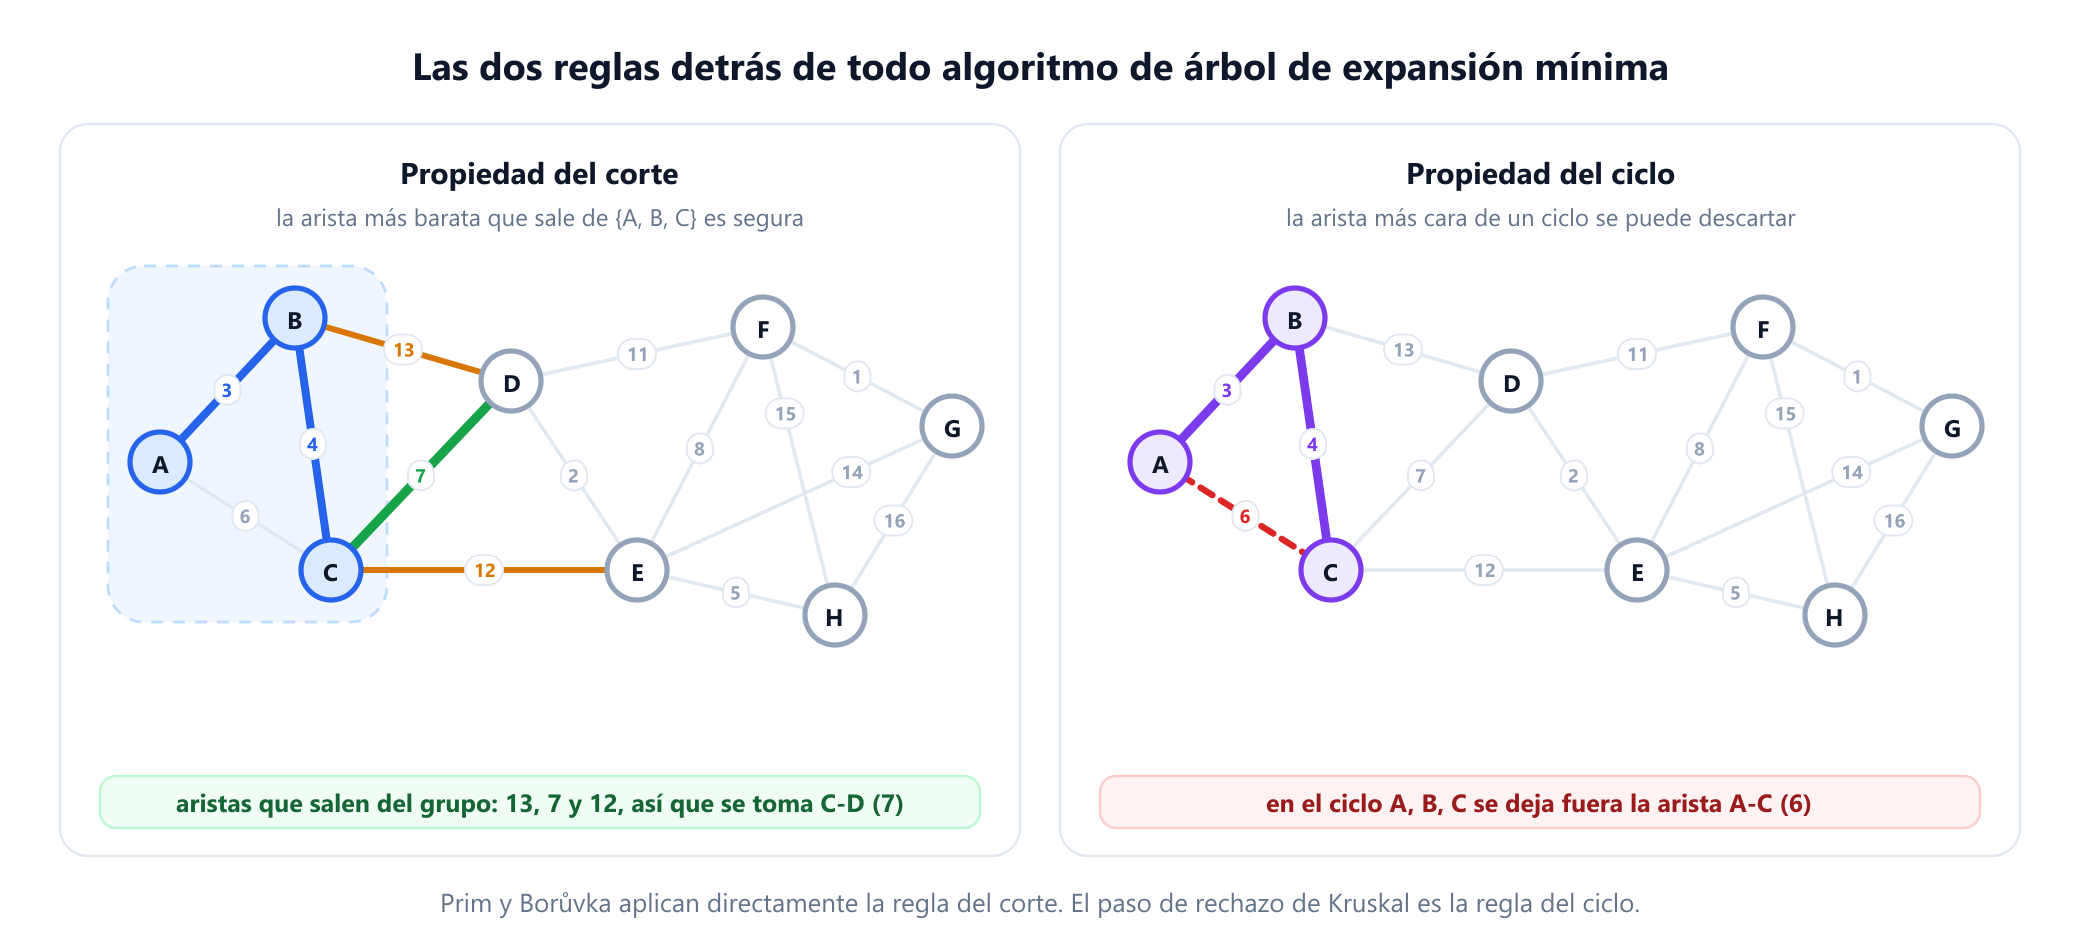
Cada algoritmo aplica esta regla a un corte distinto:
- Prim usa el corte entre su árbol y todo lo demás. En la figura, el árbol
{A, B, C}puede salir por tres aristas, y se añade la más barata,C-Dpor 7. - Kruskal usa el corte que rodea a uno de los dos grupos que une la arista. Las aristas se toman en orden creciente, así que cuando una arista une dos grupos, no sale de ninguno de ellos nada más barato.
- Borůvka usa el corte que rodea a cada grupo, para todos los grupos a la vez.
La imagen especular es la propiedad del ciclo: la arista más cara de cualquier ciclo se puede dejar fuera de un árbol de expansión mínima. Ese es el paso de rechazo de Kruskal. Cuando A-C por 6 cerraría el ciclo A, B, C, es la arista más cara de ese ciclo, porque todas las demás se tomaron antes. Un árbol de expansión mínima nunca necesita esa arista.
4. Cuándo difieren los árboles
Si todos los pesos de las aristas son distintos, el árbol de expansión mínima es único, así que los tres algoritmos deben devolver exactamente las mismas aristas, como ocurre en el ejemplo. Con pesos iguales puede haber varios árboles de expansión mínima, todos con el mismo total, y cuál obtienes depende del algoritmo e incluso del orden de la entrada. Cambia A-C para que cueste 4, igual que B-C, y hay exactamente dos árboles de expansión mínima:
PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

def kruskal(edges):
    parent = {x: x for u, v, _ in edges for x in (u, v)}
    def find(x):
        while parent[x] != x:
            x = parent[x]
        return x
    tree = []
    for u, v, w in sorted(edges, key=lambda e: e[2]):  # estable: los empates conservan su orden de entrada
        if find(u) != find(v):
            parent[find(u)] = find(v)
            tree.append(u + v)
    return sorted(tree), sum(w for u, v, w in edges if u + v in tree)

tied = [(u, v, 4 if (u, v) == ('A', 'C') else w) for u, v, w in PIPES]   # A-C ahora cuesta 4, igual que B-C
print(kruskal(tied))
# (['AB', 'AC', 'CD', 'DE', 'EF', 'EH', 'FG'], 30)
print(kruskal(tied[::-1]))
# (['AB', 'BC', 'CD', 'DE', 'EF', 'EH', 'FG'], 30)
Ambos árboles cuestan 30 y difieren en una tubería. La ordenación de Python es estable, así que las aristas de igual peso conservan su orden de entrada, y al invertir la lista cambia cuál de las dos se toma primero. Si tus pruebas comparan las aristas exactas de un árbol, pueden fallar con un programa correcto; compara el peso total.
Los empates son también el error clásico del algoritmo de Borůvka. Cuando dos grupos eligen cada uno entre aristas de igual peso, unas elecciones incoherentes pueden crear un ciclo. El programa anterior lo evita comparando (w, u, v) en todas partes, de modo que todos los grupos desempatan de la misma forma.
5. Velocidad: cuál es más rápido y cuándo
| Versión | Tiempo | En qué se va el tiempo |
|---|---|---|
| Prim, montículo binario | O(E log V) | Hasta una operación de montículo por arista |
| Prim, arreglo simple | O(V2) | Recorrer todos los vértices restantes, una vez por cada vértice añadido |
| Prim, montículo de Fibonacci | O(E + V log V) | Rápido en teoría, constantes altas en la práctica |
| Kruskal | O(E log E) | La ordenación; el trabajo de union-find posterior es casi lineal |
| Borůvka | O(E log V) | Como máximo log2 V rondas, y cada una recorre todas las aristas |
Dado que E es a lo sumo V2, log E es a lo sumo 2 log V, así que O(E log E) y O(E log V) son la misma clase. Las fórmulas por sí solas no separan los métodos, así que el programa siguiente cuenta pasos básicos, es decir, comparaciones, inspecciones de aristas y saltos de union-find, en dos grafos aleatorios con 1000 vértices. Uno es disperso, con 3000 aristas, y otro denso, con 249.750 aristas, la mitad de todos los pares posibles.
import heapq, random
from functools import cmp_to_key

def random_graph(n, m, seed):
    """Un grafo conexo: un árbol de expansión aleatorio más aristas extra aleatorias, con todos los pesos distintos."""
    rnd = random.Random(seed)
    order = list(range(n))
    rnd.shuffle(order)
    pairs = {tuple(sorted((order[i], order[rnd.randrange(i)]))) for i in range(1, n)}
    while len(pairs) < m:
        u, v = rnd.sample(range(n), 2)
        pairs.add((min(u, v), max(u, v)))
    weights = rnd.sample(range(1, 10 * m), m)
    return [(u, v, w) for (u, v), w in zip(sorted(pairs), weights)]

class Item:
    """Una entrada del montículo que cuenta cuántas veces la compara el montículo."""
    compared = 0
    def __init__(self, w, v):
        self.w, self.v = w, v
    def __lt__(self, other):
        Item.compared += 1
        return self.w < other.w

def prim_heap(n, edges):
    adj = [[] for _ in range(n)]
    for u, v, w in edges:
        adj[u].append((w, v))
        adj[v].append((w, u))
    Item.compared = 0
    seen, steps = {0}, len(adj[0])
    heap = [Item(w, v) for w, v in adj[0]]
    heapq.heapify(heap)
    while heap:
        item = heapq.heappop(heap)
        if item.v in seen:
            continue
        seen.add(item.v)
        for w, v in adj[item.v]:
            steps += 1                                # una arista inspeccionada
            if v not in seen:
                heapq.heappush(heap, Item(w, v))
    return steps + Item.compared

def prim_array(n, edges):
    """Prim sin montículo: recorre el mejor coste conocido de cada vértice restante."""
    adj = [[] for _ in range(n)]
    for u, v, w in edges:
        adj[u].append((w, v))
        adj[v].append((w, u))
    best, done, steps = [float('inf')] * n, [False] * n, 0
    best[0] = 0
    for _ in range(n):
        left = [v for v in range(n) if not done[v]]
        u = min(left, key=best.__getitem__)
        steps += len(left)
        done[u] = True
        for w, v in adj[u]:
            steps += 1
            if not done[v] and w < best[v]:
                best[v] = w
    return steps

def kruskal(n, edges):
    compared = [0]
    def cmp(a, b):
        compared[0] += 1
        return a[2] - b[2]
    parent, steps = list(range(n)), 0
    def find(x):
        nonlocal steps
        while parent[x] != x:
            steps += 1
            parent[x] = parent[parent[x]]
            x = parent[x]
        steps += 1
        return x
    for u, v, w in sorted(edges, key=cmp_to_key(cmp)):
        ru, rv = find(u), find(v)
        if ru != rv:
            parent[ru] = rv
    return compared[0] + steps

def boruvka(n, edges):
    parent, steps = list(range(n)), 0
    def find(x):
        nonlocal steps
        while parent[x] != x:
            steps += 1
            parent[x] = parent[parent[x]]
            x = parent[x]
        steps += 1
        return x
    while True:
        cheapest = {}
        for u, v, w in edges:
            ru, rv = find(u), find(v)
            if ru != rv:
                for r in (ru, rv):
                    steps += 1
                    if r not in cheapest or w < cheapest[r][2]:
                        cheapest[r] = (u, v, w)
        if not cheapest:
            return steps
        for u, v, w in set(cheapest.values()):
            ru, rv = find(u), find(v)
            if ru != rv:
                parent[ru] = rv

n = 1000
for name, m in [('sparse', 3 * n), ('dense', n * (n - 1) // 4)]:
    edges = random_graph(n, m, seed=1)
    print(f'{name:6} E={m:6,}  Prim heap {prim_heap(n, edges):9,}  Prim array {prim_array(n, edges):9,}  '
          f'Kruskal {kruskal(n, edges):9,}  Boruvka {boruvka(n, edges):9,}')
# sparse E= 3,000  Prim heap    46,360  Prim array   506,500  Kruskal    44,414  Boruvka    73,486
# dense  E=249,750  Prim heap 5,231,906  Prim array 1,000,000  Kruskal 5,151,232  Boruvka 7,417,850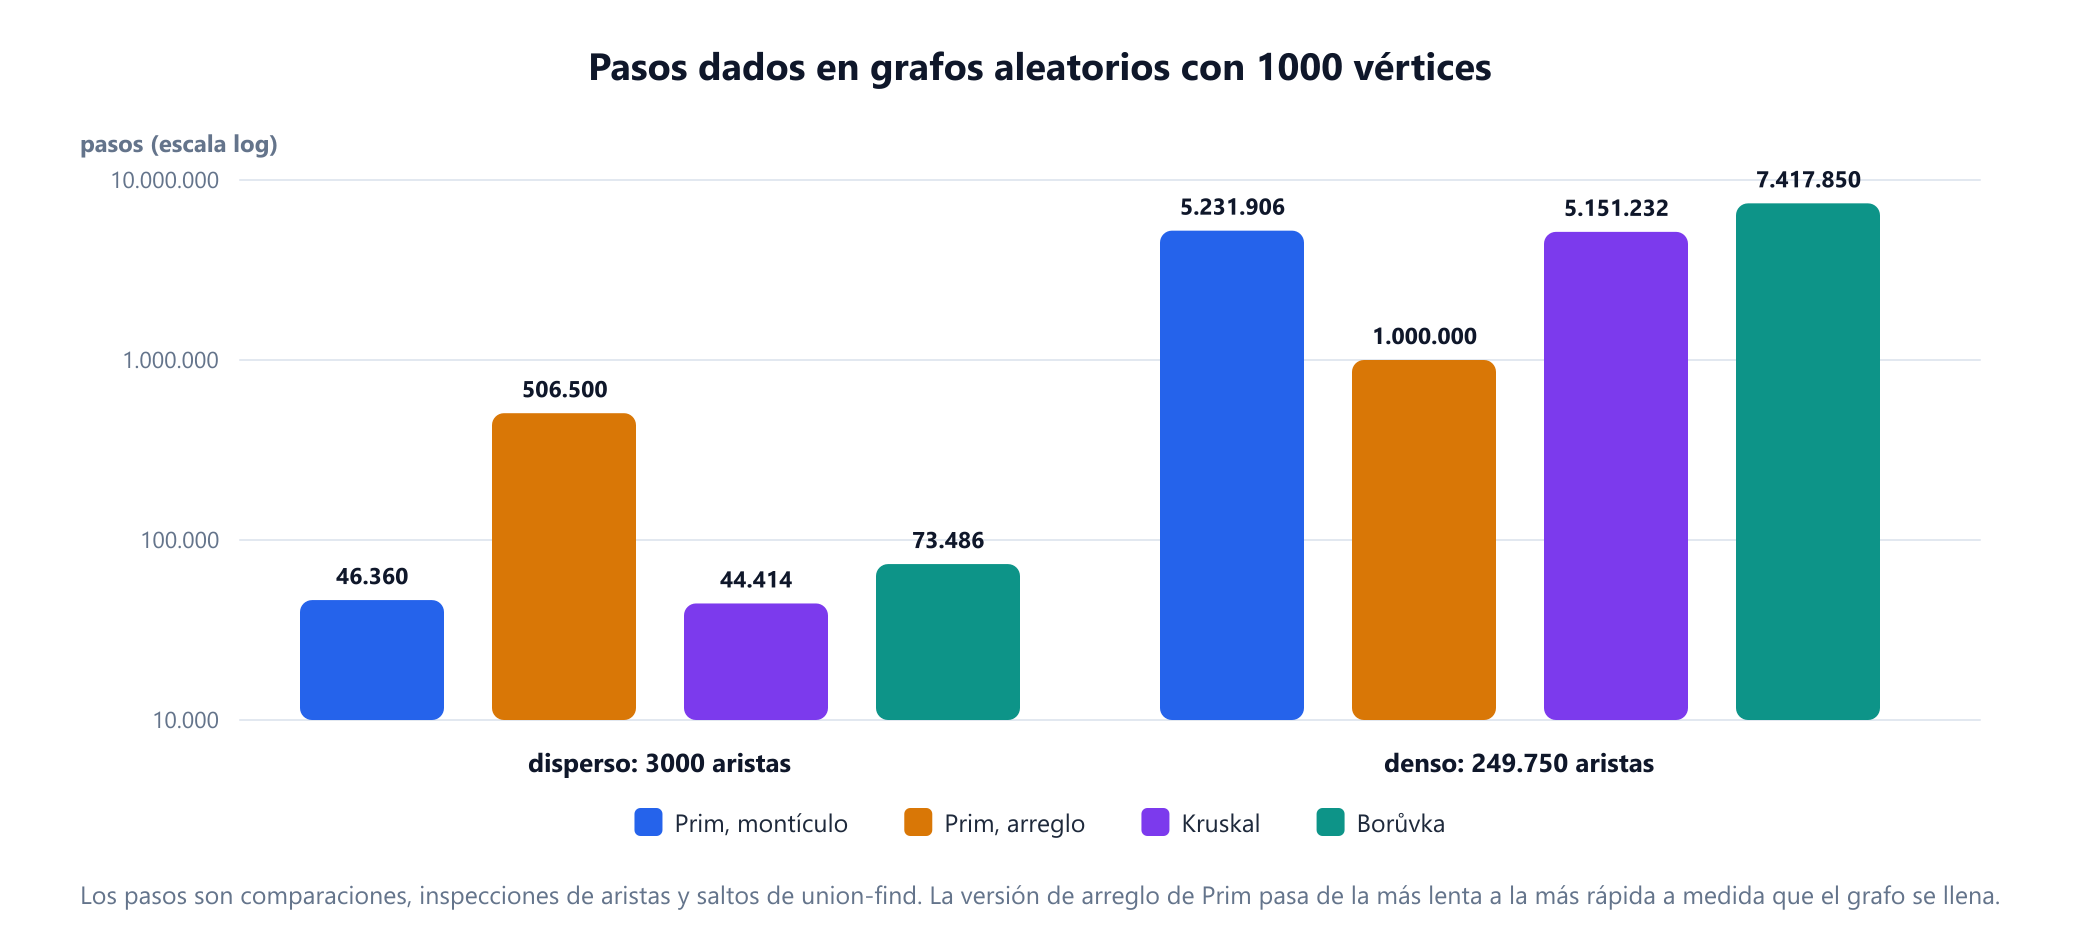
Los resultados se invierten con la densidad. En el grafo disperso, Kruskal y Prim con montículo están a menos de un 5 % uno de otro, Borůvka necesita alrededor de un 60 % más, y Prim con arreglo es unas 11 veces más lento, porque recorre todos los vértices restantes aunque cada uno tenga pocas aristas. En el grafo denso la versión de arreglo da exactamente 1.000.000 de pasos y gana por un factor de alrededor de cinco: nunca tiene más de V candidatos que examinar, mientras que el montículo y la ordenación pagan un coste logarítmico sobre casi 250.000 aristas.
Estas cifras cuentan pasos, no segundos. Ordenar un arreglo de números es muy rápido en hardware real, lo que suele favorecer a Kruskal, y la versión con montículo de aquí es la sencilla, que puede guardar varias entradas por vértice. Una versión que actualice las entradas en su sitio mantiene el montículo más pequeño a costa de más código. Si el tiempo importa, mide con tus propios datos.
6. La forma de tu entrada
A menudo la entrada decide antes que cualquier análisis de complejidad. La guía sobre la representación de grafos compara los formatos.
- Una lista de aristas le va directamente a Kruskal: no hay nada que construir salvo el arreglo de union-find.
- Las aristas ya ordenadas, o los pesos que sean enteros pequeños y admitan ordenación por conteo, eliminan el único paso caro de Kruskal. Lo que queda es el trabajo de union-find, que es casi lineal.
- Una matriz de adyacencia, o las distancias que puedes calcular bajo demanda, como puntos en un plano donde cada par es una arista, le van bien a Prim con arreglo. Nunca almacena las aristas, así que solo necesita
O(V)de memoria, mientras que Kruskal tendría que guardar y ordenar unasV2 / 2de ellas. - Una lista de aristas demasiado grande para la memoria favorece a Borůvka, que solo necesita pasadas repetidas sobre las aristas, y a variantes de Kruskal como filter-Kruskal, que evitan ordenar las aristas que claramente serán rechazadas.
Merece la pena entender por sí misma la estructura union-find de Kruskal, y la guía sobre union-find la trata a fondo.
7. Grafos no conexos y parada anticipada
Los tres métodos también difieren en lo que hacen cuando el grafo no es de una sola pieza, y en lo que pueden decirte si paras antes de tiempo.
Grafos no conexos. Prim solo alcanza la componente conexa de su vértice inicial; para cubrir todo el grafo hay que reiniciarlo en cada componente. Kruskal y Borůvka no necesitan ningún cambio: simplemente se quedan sin aristas y devuelven un bosque de expansión mínima, un árbol por componente.
Agrupamiento. Los estados intermedios de Kruskal son útiles por sí mismos. Detente cuando queden k grupos, y esos son los grupos de enlace simple de los datos: la división en k grupos en la que el par de puntos más cercano de grupos distintos está lo más alejado posible.
PIPES = [('A', 'B', 3), ('A', 'C', 6), ('B', 'C', 4), ('B', 'D', 13), ('C', 'D', 7),
         ('C', 'E', 12), ('D', 'E', 2), ('D', 'F', 11), ('E', 'F', 8), ('E', 'G', 14),
         ('E', 'H', 5), ('F', 'G', 1), ('F', 'H', 15), ('G', 'H', 16)]

def kruskal_until(edges, groups_wanted):
    """Kruskal, detenido en cuanto solo quedan groups_wanted grupos."""
    parent = {x: x for u, v, _ in edges for x in (u, v)}
    def find(x):
        while parent[x] != x:
            parent[x] = parent[parent[x]]
            x = parent[x]
        return x
    count, tree = len(parent), []
    for u, v, w in sorted(edges, key=lambda e: e[2]):
        if count == groups_wanted:
            break
        if find(u) != find(v):
            parent[find(u)] = find(v)
            tree.append((u, v, w))
            count -= 1
    members = {}
    for x in sorted(parent):
        members.setdefault(find(x), []).append(x)
    return tree, sorted(''.join(m) for m in members.values())

print(kruskal_until(PIPES, 3)[1])              # tres grupos de pueblos
# ['ABC', 'DEH', 'FG']
print(kruskal_until(PIPES, 2)[1])
# ['ABCDEH', 'FG']

# Un grafo en dos piezas: elimina todas las tuberías entre los pueblos de A a E y F, G, H.
split = [e for e in PIPES if not (set(e[:2]) & set('FGH')) or set(e[:2]) <= set('FGH')]
tree, parts = kruskal_until(split, 1)          # pide 1 grupo, pero solo pueden existir 2
print(parts, sum(w for *_, w in tree))
# ['ABCDE', 'FGH'] 32
Detenido en tres grupos, el programa devuelve {A, B, C}, {D, E, H} y {F, G}, los mismos tres que produjo la primera ronda de Borůvka en este grafo, aunque esa coincidencia es casual en el ejemplo. En la última ejecución, sin las tuberías entre las dos mitades, Kruskal devuelve un bosque de dos árboles que cuesta 32. Prim desde A se detendría tras cinco pueblos y nunca vería F, G o H.
8. Pesos negativos, árboles máximos y grafos dirigidos
- Los pesos negativos no son problema. A diferencia del algoritmo de Dijkstra, a ninguno de los tres le afectan, porque todo árbol de expansión tiene exactamente
V - 1aristas. Sumar la misma constante a todos los pesos aumenta el coste de todos los árboles en la misma cantidad y deja la elección sin cambios. Restar 10 a cada tubería del ejemplo, lo que hace negativos la mayoría de los pesos, da el mismo árbol. - Árboles de expansión máxima. Cambia el signo de los pesos, u ordena de mayor a menor. El árbol de expansión más caro del ejemplo cuesta 87.
- Cuellos de botella. Un árbol de expansión mínima también minimiza su arista más pesada. En el ejemplo esa arista es
E-Fcon peso 8, y ningún árbol de expansión puede evitar una arista de al menos 8. - Grafos dirigidos. Ninguno de los tres funciona en grafos dirigidos. La versión dirigida del problema, la arborescencia mínima, necesita el algoritmo de Chu-Liu/Edmonds.
9. Prim no es Dijkstra
El algoritmo de Prim y el de Dijkstra son casi idénticos en código, y la diferencia es una sola línea: Prim ordena la cola por el peso de la única arista que llega a un vértice, mientras que Dijkstra la ordena por la distancia total desde el origen. Optimizan cosas distintas y construyen árboles distintos. La guía del algoritmo de Prim los compara línea por línea.
En el ejemplo, el árbol de caminos más cortos de Dijkstra desde A usa A-C por 6 en lugar de B-C por 4. Cuesta 32 en total, frente a los 30 del árbol de expansión mínima. A cambio, cada pueblo queda al menos igual de cerca de A a través de él: C está a 6 en lugar de 7, H a 20 en lugar de 21 y G a 24 en lugar de 25. Un árbol de expansión mínima minimiza el coste de construir la red y no dice nada sobre la longitud de ninguna ruta concreta.
10. Una historia enredada
Los tres nombres inducen a error sobre quién llegó primero. El algoritmo más antiguo es el de Borůvka. En 1926 el matemático checo Otakar Borůvka lo publicó después de que Jindřich Saxel, empleado de la compañía eléctrica de Moravia Occidental, le preguntara en el invierno de 1925 cómo electrificar el suroeste de Moravia de la forma más barata posible. Vojtěch Jarník describió después, en 1930, lo que hoy se llama algoritmo de Prim, en un artículo escrito como carta a Borůvka. Joseph Kruskal publicó su método en 1956, y Robert Prim redescubrió el algoritmo de Jarník en 1957 en los Laboratorios Bell, igual que Edsger Dijkstra en 1959. Por eso el algoritmo de Prim se llama a veces algoritmo de Jarník o algoritmo DJP, aunque "algoritmo de Prim" sigue siendo, con mucho, el nombre más común. El método de Borůvka también se redescubrió varias veces, y en algunos libros lleva el nombre de Sollin, que lo presentó en un seminario en París en 1961 y nunca lo publicó.
Los métodos más rápidos que se conocen se han alejado mucho de estos clásicos. David Karger, Philip Klein y Robert Tarjan dieron en 1995 un algoritmo aleatorizado con tiempo lineal esperado. Bernard Chazelle dio en 2000 un algoritmo determinista que se ejecuta en O(E α(E, V)), donde α es la función inversa de Ackermann, que vale como máximo 4 para cualquier grafo que se pudiera llegar a almacenar. En 2002 Seth Pettie y Vijaya Ramachandran encontraron un algoritmo demostrablemente óptimo, aunque nadie sabe cuál es realmente su tiempo de ejecución: está en algún punto entre lo lineal y la cota de Chazelle. El algoritmo de Karger, Klein y Tarjan usa las rondas de Borůvka como componente básico.
11. Dónde se usa cada uno
- Diseño de redes. Tender cable, tuberías o carreteras al mínimo coste es la aplicación original. Los diseños reales añaden restricciones, como la guía sobre diseño de redes muestra, y el árbol de expansión mínima es el punto de partida habitual.
- Agrupamiento. El agrupamiento de enlace simple es el algoritmo de Kruskal detenido antes de tiempo, y por eso Kruskal es la elección habitual para esa tarea. El método de segmentación de imágenes basado en grafos de Pedro Felzenszwalb y Daniel Huttenlocher procesa las aristas en orden de la misma manera.
- Aproximación de problemas más difíciles. Con pesos no negativos, un árbol de expansión mínima nunca cuesta más que el mejor recorrido del problema del viajante de comercio. La heurística de Christofides parte de un árbol así y garantiza un recorrido de como máximo 1,5 veces el óptimo cuando las distancias cumplen la desigualdad triangular.
- Datos geométricos. Cuando cada par de puntos es una arista candidata, el grafo es completo y Prim con arreglo es la elección natural.
- Computación paralela. Cada ronda de Borůvka permite que cada grupo trabaje de forma independiente, por lo que es el punto de partida habitual de los algoritmos paralelos, mientras que Prim y Kruskal son inherentemente secuenciales.
12. Errores comunes
| Error | Por qué está mal | Solución |
|---|---|---|
| Usar Prim en un grafo no conexo y fiarse del resultado | Solo abarca la componente del vértice inicial | Reinícialo en cada componente, o usa Kruskal |
| Suponer que Prim con montículo siempre es lo mejor | En el grafo denso la versión de arreglo necesitó cinco veces menos pasos | Usa la versión de arreglo cuando E esté cerca de V2 |
| Tratar un árbol de expansión mínima como un conjunto de caminos más cortos | En el ejemplo llega a C con un coste de 7, pero la ruta más corta cuesta 6 | Usa Dijkstra para rutas y un árbol de expansión para el coste de construcción |
| Comprobar un único árbol exacto cuando los pesos pueden empatar | Puede haber varios árboles mínimos, y el orden de entrada elige uno | Compara el peso total |
| Desempatar de forma incoherente en Borůvka | Los grupos pueden elegir aristas que formen un ciclo | Compara por peso y luego por un orden fijo de aristas |
| Evitar los algoritmos por los pesos negativos | Los pesos negativos no afectan a ninguno de los tres | Ejecútalos sin cambios |
| Ejecutarlos en un grafo dirigido | La propiedad del corte se refiere a aristas no dirigidas | Usa el algoritmo de Chu-Liu/Edmonds |
| Dejar que Kruskal recorra todas las aristas | El árbol está completo tras V - 1 aristas aceptadas | Detente en cuanto las tengas |
13. Glosario
| Término | Significado |
|---|---|
| Árbol de expansión | Un árbol que contiene todos los vértices del grafo |
| Árbol de expansión mínima | Un árbol de expansión de peso total mínimo |
| Bosque de expansión | Un árbol de expansión por cada componente conexa |
| Propiedad del corte | La arista más barata que cruza cualquier corte puede estar en un árbol de expansión mínima |
| Propiedad del ciclo | La arista más cara de cualquier ciclo se puede dejar fuera |
| Union-find | Una estructura que registra grupos y los fusiona rápidamente |
| Cola de prioridad | Una estructura que siempre devuelve la clave más pequeña; normalmente un montículo binario |
| Grafo denso | Un grafo en el que una gran parte de todos los pares de vértices están unidos por aristas |
| Grafo disperso | Un grafo con pocas aristas en comparación con V2, normalmente un pequeño múltiplo de V |
| Agrupamiento de enlace simple | Agrupar uniendo repetidamente los dos grupos más cercanos |
| Arista cuello de botella | La arista más pesada de un árbol |
| Arborescencia | Un árbol dirigido en el que todas las aristas se alejan de una raíz |
14. Preguntas frecuentes
¿Cuál es la diferencia entre el algoritmo de Prim y el de Kruskal?
El algoritmo de Prim hace crecer un único árbol conexo desde un vértice inicial, añadiendo siempre la arista más barata que sale de él. El algoritmo de Kruskal ordena todas las aristas y las toma de la más barata hacia arriba, saltándose las que cerrarían un ciclo, así que su árbol empieza como fragmentos dispersos que se van uniendo. Ambos encuentran un árbol de expansión mínima del mismo peso total.
¿Qué es mejor, Prim o Kruskal?
Depende del grafo. Kruskal es la elección natural para grafos dispersos y para aristas dadas como lista o ya ordenadas. Prim con un arreglo simple es la elección natural para grafos densos, porque se ejecuta en O(V al cuadrado) y no necesita ordenar las aristas. En grafos dispersos, Prim con un montículo binario y Kruskal cuestan más o menos lo mismo.
¿Prim y Kruskal dan el mismo árbol de expansión mínima?
Si todos los pesos de las aristas son distintos, el árbol de expansión mínima es único y ambos devuelven exactamente las mismas aristas. Si algunos pesos son iguales, puede haber varios árboles de expansión mínima y los dos algoritmos pueden devolver árboles distintos, pero siempre tienen el mismo peso total.
¿Qué es el algoritmo de Borůvka?
El algoritmo de Borůvka trabaja por rondas. En cada ronda, cada grupo de vértices conectados elige su arista más barata hacia otro grupo, y todas esas aristas se añaden a la vez. El número de grupos se reduce al menos a la mitad en cada ronda, así que hay como máximo log2 V rondas y el tiempo de ejecución es O(E log V). Como los grupos trabajan de forma independiente, se adapta bien a la computación paralela.
¿Pueden Prim y Kruskal manejar pesos negativos en las aristas?
Sí. A diferencia del algoritmo de Dijkstra, Prim, Kruskal y Borůvka funcionan correctamente con pesos negativos. Todo árbol de expansión tiene exactamente V - 1 aristas, así que sumar la misma constante a todos los pesos cambia por igual el coste de todos los árboles y no cambia cuál es el más barato.
¿Cuál es la diferencia entre el algoritmo de Prim y el algoritmo de Dijkstra?
Su código es casi idéntico, pero Prim ordena los vértices por el peso de la única arista que llega a ellos, mientras que Dijkstra los ordena por la distancia total desde el origen. Prim construye el árbol de menor peso total. Dijkstra construye un árbol de caminos más cortos desde un origen, que puede costar más en total pero da rutas más cortas desde ese origen.
15. Referencias
Los algoritmos, las cotas y las atribuciones anteriores proceden de estas fuentes, listadas en orden cronológico.
- Borůvka, O. (1926). "O jistém problému minimálním." Práce Moravské přírodovědecké společnosti 3, 37 a 58.
- Jarník, V. (1930). "O jistém problému minimálním (Z dopisu panu O. Borůvkovi)." Práce Moravské přírodovědecké společnosti 6, 57 a 63.
- Kruskal, J. B. (1956). "On the Shortest Spanning Subtree of a Graph and the Traveling Salesman Problem." Proceedings of the American Mathematical Society 7(1), 48 a 50.
- Prim, R. C. (1957). "Shortest Connection Networks and Some Generalizations." Bell System Technical Journal 36(6), 1389 a 1401.
- Dijkstra, E. W. (1959). "A Note on Two Problems in Connexion with Graphs." Numerische Mathematik 1, 269 a 271.
- Chu, Y.-J. y Liu, T.-H. (1965). "On the Shortest Arborescence of a Directed Graph." Scientia Sinica 14, 1396 a 1400.
- Edmonds, J. (1967). "Optimum Branchings." Journal of Research of the National Bureau of Standards 71B, 233 a 240.
- Gower, J. C. y Ross, G. J. S. (1969). "Minimum Spanning Trees and Single Linkage Cluster Analysis." Journal of the Royal Statistical Society, Series C 18(1), 54 a 64.
- Tarjan, R. E. (1975). "Efficiency of a Good But Not Linear Set Union Algorithm." Journal of the ACM 22(2), 215 a 225.
- Christofides, N. (1976). Worst-Case Analysis of a New Heuristic for the Travelling Salesman Problem. Informe 388. Pittsburgh: Carnegie Mellon University.
- Graham, R. L. y Hell, P. (1985). "On the History of the Minimum Spanning Tree Problem." Annals of the History of Computing 7(1), 43 a 57.
- Fredman, M. L. y Tarjan, R. E. (1987). "Fibonacci Heaps and Their Uses in Improved Network Optimization Algorithms." Journal of the ACM 34(3), 596 a 615.
- Karger, D. R., Klein, P. N. y Tarjan, R. E. (1995). "A Randomized Linear-Time Algorithm to Find Minimum Spanning Trees." Journal of the ACM 42(2), 321 a 328.
- Chazelle, B. (2000). "A Minimum Spanning Tree Algorithm with Inverse-Ackermann Type Complexity." Journal of the ACM 47(6), 1028 a 1047.
- Nešetřil, J., Milková, E. y Nešetřilová, H. (2001). "Otakar Borůvka on Minimum Spanning Tree Problem." Discrete Mathematics 233(1 a 3), 3 a 36.
- Pettie, S. y Ramachandran, V. (2002). "An Optimal Minimum Spanning Tree Algorithm." Journal of the ACM 49(1), 16 a 34.
- Felzenszwalb, P. F. y Huttenlocher, D. P. (2004). "Efficient Graph-Based Image Segmentation." International Journal of Computer Vision 59(2), 167 a 181.
- Kleinberg, J. y Tardos, É. (2005). Algorithm Design. Boston: Addison-Wesley.
- Bader, D. A. y Cong, G. (2006). "Fast Shared-Memory Algorithms for Computing the Minimum Spanning Forest of Sparse Graphs." Journal of Parallel and Distributed Computing 66(11), 1366 a 1378.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. y Stein, C. (2009). Introduction to Algorithms, 3.ª edición. Cambridge, MA: MIT Press.
- Osipov, V., Sanders, P. y Singler, J. (2009). "The Filter-Kruskal Minimum Spanning Tree Algorithm." En Proceedings of the 11th Workshop on Algorithm Engineering and Experiments, 52 a 61.
Observa cómo crece el árbol
Construye los ocho pueblos en el visualizador y ejecuta Prim desde A. Luego ejecuta Kruskal en el mismo grafo y compara el orden en que aparecen las aristas.
Abrir el visualizador