
Inhaltsverzeichnis
- 1. Cliquen, unabhängige Mengen und Knotenüberdeckungen
- 2. Ein Graph, drei Antworten, eine Identität
- 3. Maximal ist nicht maximum
- 4. Alle maximalen Cliquen auflisten: Bron–Kerbosch
- 5. Die größte unabhängige Menge exakt finden
- 6. Knotenüberdeckung: eine 2-Approximation und ein schneller exakter Test
- 7. Wie schwer sind diese Probleme?
- 8. Schranken, die Sie von Hand prüfen können
- 9. Ramsey-Theorie: Ordnung ist unvermeidlich
- 10. Spezielle Graphen, in denen die Probleme leicht werden
- 11. Wo Cliquen, unabhängige Mengen und Überdeckungen eingesetzt werden
- 12. Häufige Fehler
- 13. Glossar
- 14. Häufig gestellte Fragen
- 15. Quellen
1. Cliquen, unabhängige Mengen und Knotenüberdeckungen
Drei der am meisten untersuchten Fragen der Graphentheorie betreffen Mengen von Knoten, und jede lässt sich in einer Zeile formulieren.
- Eine Clique ist eine Menge von Knoten, in der je zwei benachbart sind. Eine Clique auf
kKnoten ist eine Kopie des vollständigen GraphenKkinnerhalb des Graphen. Die Größe der größten Clique ist die Cliquenzahl, geschriebenω(G). - Eine unabhängige Menge, auch stabile Menge genannt, ist eine Menge von Knoten, in der keine zwei benachbart sind. Die Größe der größten ist die Unabhängigkeitszahl,
α(G). - Eine Knotenüberdeckung ist eine Menge von Knoten, die jede Kante berührt: Jede Kante hat mindestens einen Endknoten in der Menge. Die Größe der kleinsten ist die Knotenüberdeckungszahl,
τ(G).
Eine Clique und eine unabhängige Menge sind Gegensätze: Die eine verlangt alle möglichen Kanten zwischen den gewählten Knoten, die andere keine. In einem Freundschaftsnetz ist eine Clique eine Gruppe, in der jeder jeden kennt, und eine unabhängige Menge eine Gruppe von einander Fremden. Das Wort „Clique“ kam aus der Soziologie in das Fachgebiet, wo Luce und Perry es 1949 für genau solche Gruppen verwendeten. Der Leitfaden zu Knoten und Kanten behandelt das Vokabular, auf dem diese Definitionen beruhen.
Jede Frage birgt eine Falle in der Formulierung. Als maximal gilt eine Menge, wenn sich nichts zu ihr hinzufügen (bei einer Überdeckung: nichts aus ihr entfernen) lässt, ohne die Eigenschaft zu verletzen. Als maximum gilt sie, wenn es keine größere Menge mit der Eigenschaft gibt, bei einer Überdeckung keine kleinere. Jede Menge, die maximum ist, ist auch maximal, aber nicht umgekehrt, und am Unterschied zwischen beiden scheitern die meisten Algorithmen.
2. Ein Graph, drei Antworten, eine Identität
Das durchgehende Beispiel hat 8 Knoten und 12 Kanten. Die Knoten A, B, C und D sind alle miteinander verbunden, D, E und F bilden ein Dreieck, und ein 5-Kreis C, D, F, G, H verläuft unten herum:
E = {AB, AC, AD, BC, BD, CD, CH, DE, DF, EF, FG, GH}      8 Knoten, 12 Kanten

deg:   A 3   B 3   C 4   D 5   E 2   F 3   G 2   H 2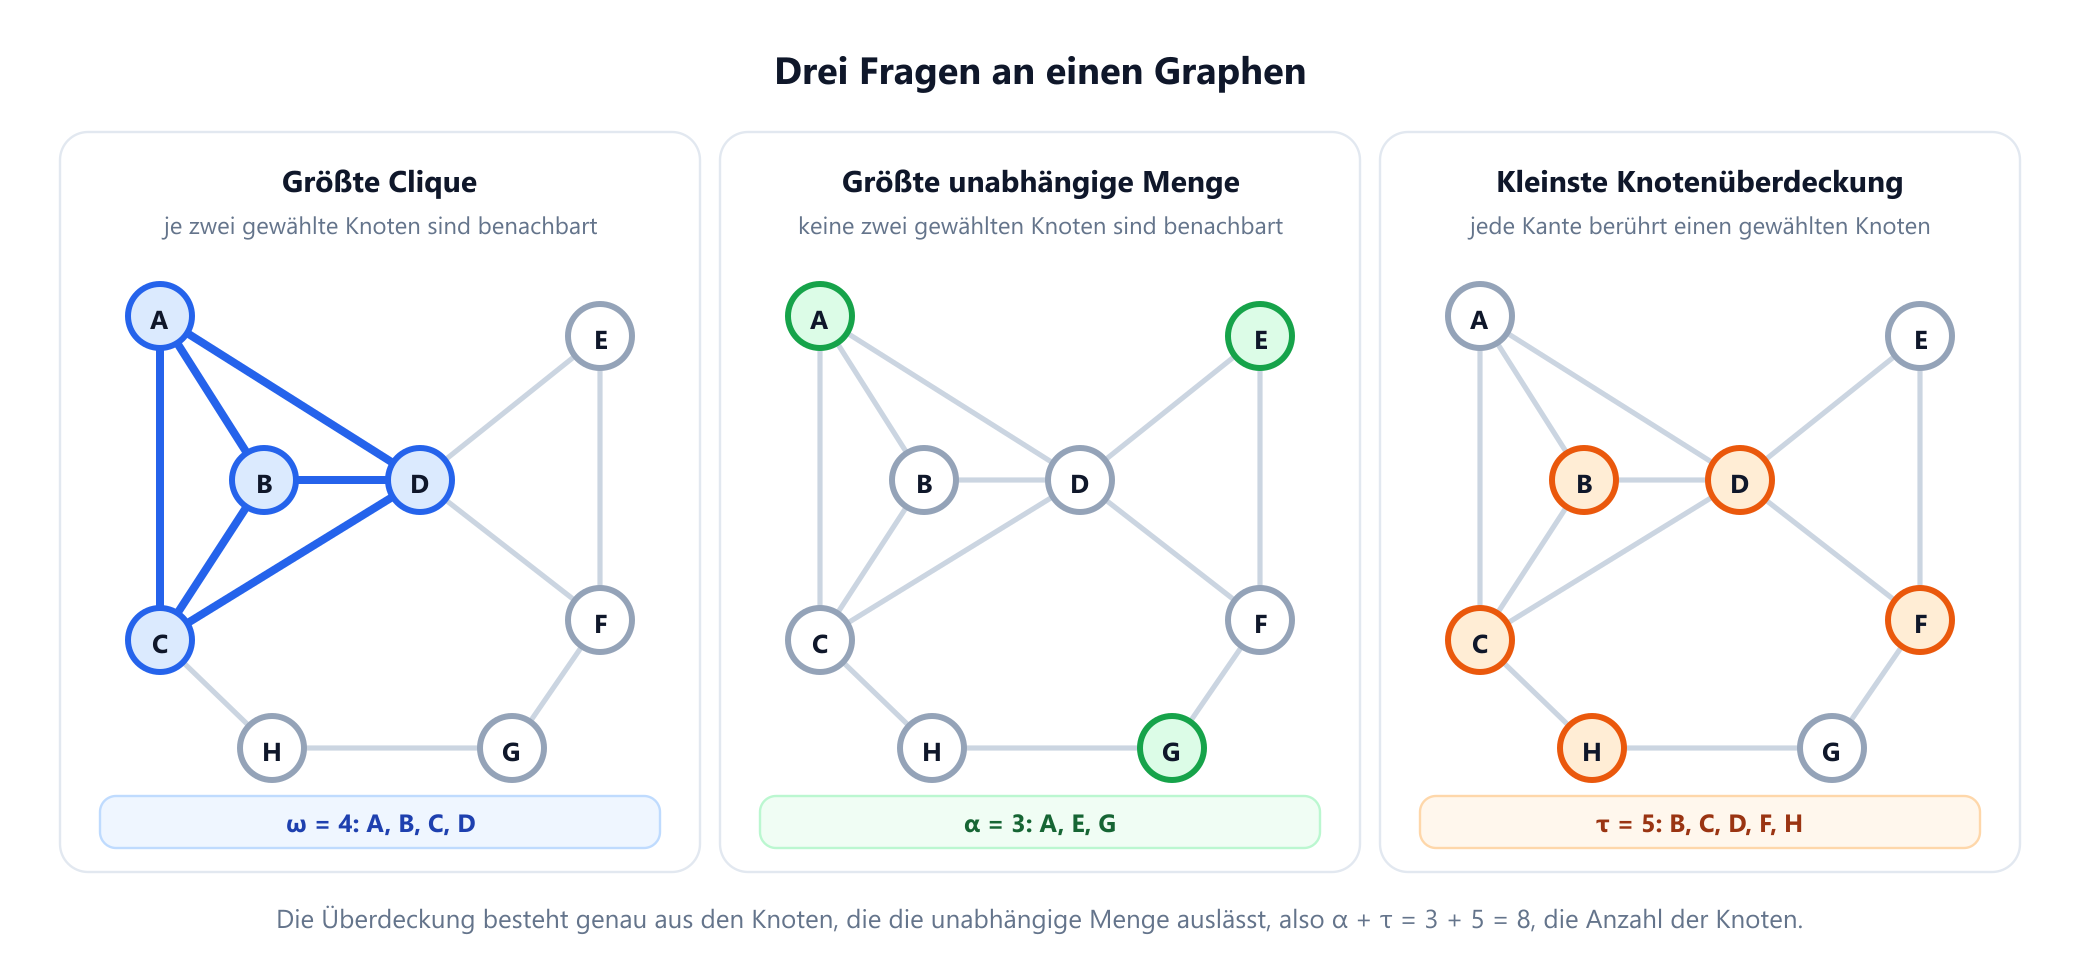
Die größte Clique ist {A, B, C, D}, also ω = 4, und sie ist die einzige Clique dieser Größe. Die größten unabhängigen Mengen haben 3 Knoten, zum Beispiel {A, E, G}, also α = 3; es gibt sieben davon. Die kleinsten Knotenüberdeckungen haben 5 Knoten, zum Beispiel {B, C, D, F, H}, also τ = 5, und wieder gibt es sieben. Die beiden Siebenen sind kein Zufall.
Zwei kurze Argumente verbinden die drei Zahlen. Erstens hat das Komplement eines Graphen genau dort eine Kante, wo der Graph keine hat, daher ist eine Clique in G eine unabhängige Menge im Komplement und umgekehrt: ω(G) ist gleich α des Komplements. Zweitens ist eine Menge S genau dann unabhängig, wenn die übrigen Knoten eine Knotenüberdeckung bilden. Würde eine Kante die übrigen Knoten verfehlen, lägen beide ihrer Endknoten in S, also wäre S nicht unabhängig, und das Argument funktioniert genauso in umgekehrter Richtung. Das größte S liefert die kleinste Überdeckung:
α(G) + τ(G) = n, für jeden Graphen mit n Knoten.
Diese Identität wird meist Gallai zugeschrieben, der sie 1959 veröffentlichte. Im Beispiel gilt 3 + 5 = 8, und die sieben größten unabhängigen Mengen sind genau die Komplemente der sieben kleinsten Überdeckungen. Die praktische Folge: Die drei Probleme sind ein einziges Problem in drei Verkleidungen. Ein Algorithmus für eines von ihnen, auf den Graphen oder auf sein Komplement angewandt, löst die beiden anderen exakt.
3. Maximal ist nicht maximum
Das Dreieck {D, E, F} ist eine Clique, und kein Knoten lässt sich hinzufügen, weil kein anderer Knoten zu allen dreien von D, E und F benachbart ist. Es ist eine maximale Clique der Größe 3, während das Maximum 4 ist. Die Kanten CH, FG und GH sind ebenfalls maximale Cliquen, der Größe 2: Keine von ihnen liegt in einem Dreieck. Insgesamt hat das Beispiel fünf maximale Cliquen, und nur eine von ihnen ist eine größte Clique.
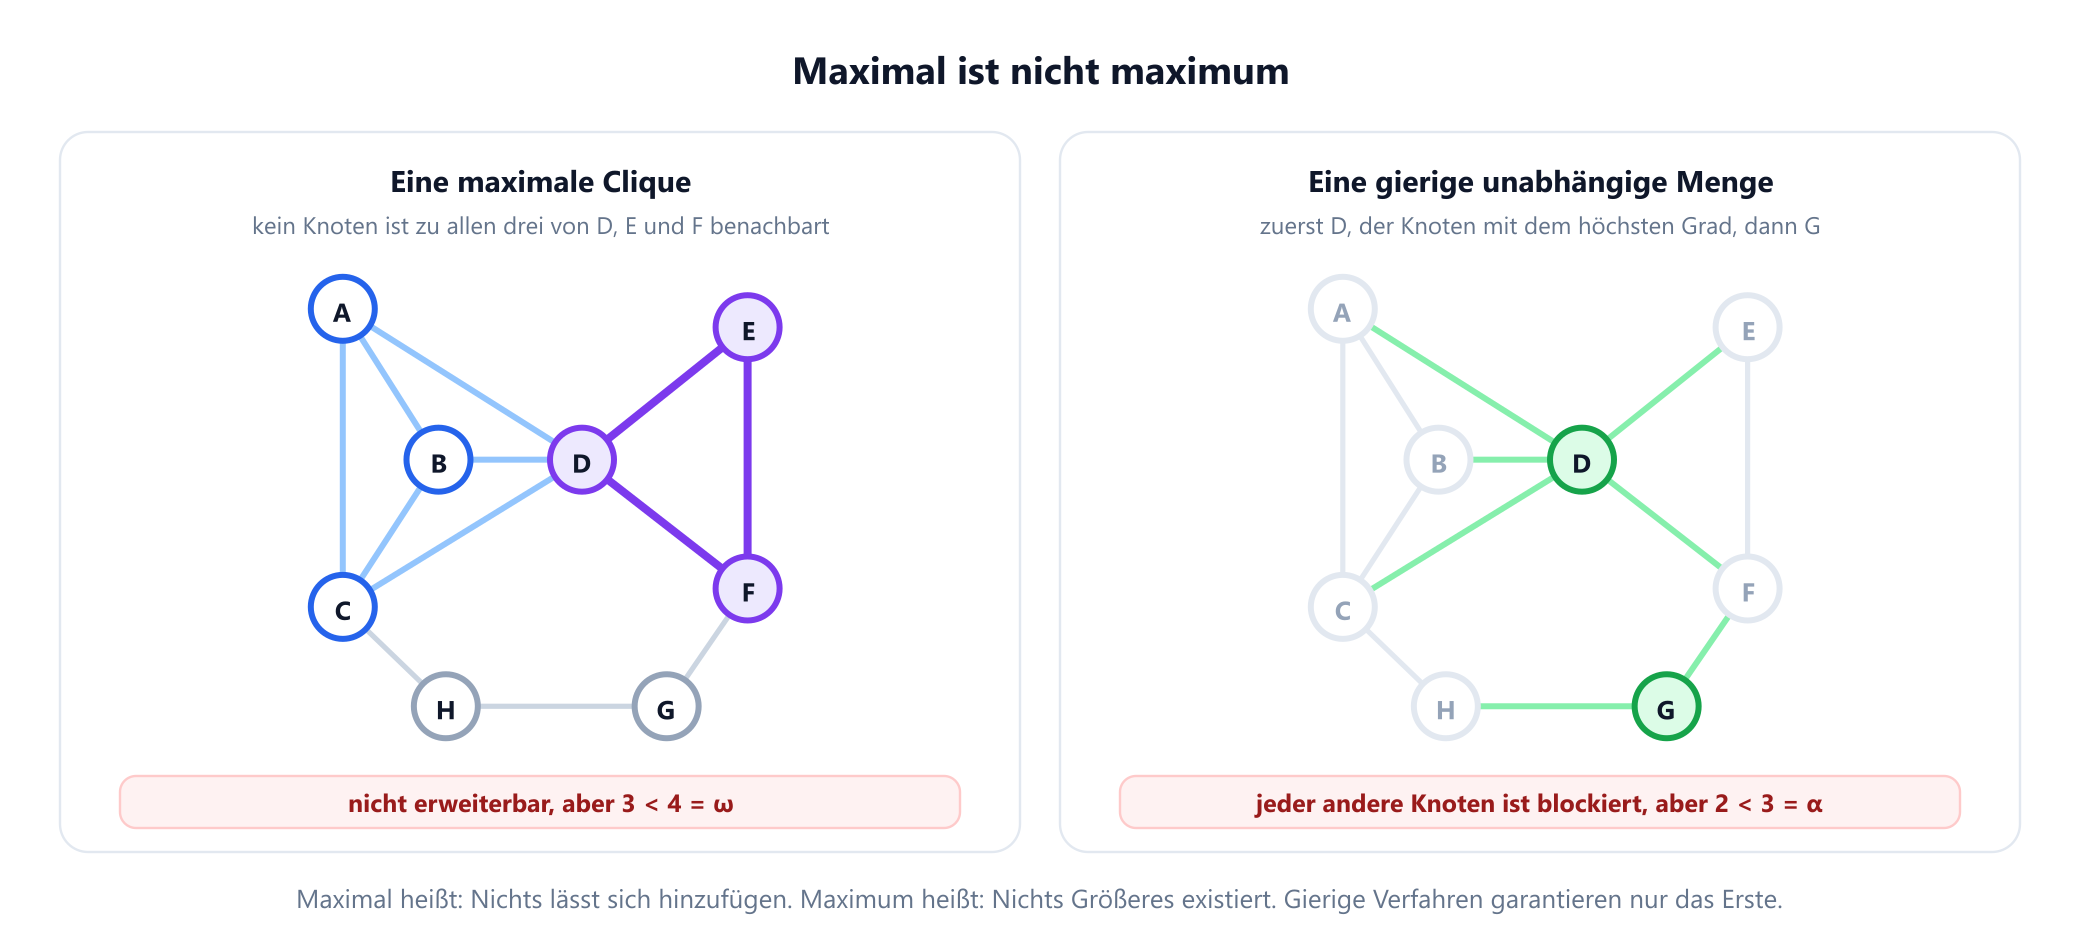
Unabhängige Mengen tappen noch leichter in dieselbe Falle. Das naheliegende gierige Verfahren geht die Knoten durch und nimmt jeden, dessen Nachbarn noch nicht genommen wurden. Das Ergebnis ist immer maximal, aber seine Größe hängt von der Reihenfolge ab. Beginnt man mit D, dem Knoten mit dem höchsten Grad, dann blockiert D fünf Knoten auf einmal; nachdem G genommen ist, ist jeder verbleibende Knoten zu einem der beiden benachbart, und das Verfahren endet bei {D, G}, einen Knoten unter dem Optimum. Das Beispiel hat zehn maximale unabhängige Mengen, drei der Größe 2 und sieben der Größe 3. Mit Knoten niedrigen Grades zu beginnen, die wenige andere blockieren, ist eine bessere Gewohnheit, aber keine gierige Reihenfolge ist für jeden Graphen richtig.
Die Lehre überträgt sich auf Software. Eine Routine, die „eine Clique findet“ oder „eine unabhängige Menge findet“, liefert meist schnell eine maximale. Eine größte zu finden ist eine andere und viel schwerere Aufgabe, und im Rest dieses Artikels geht es darum, sie zu finden, sie zu approximieren und sie abzuschätzen.
4. Alle maximalen Cliquen auflisten: Bron–Kerbosch
Der klassische Weg, alle maximalen Cliquen zu finden, ist der Algorithmus, den Bron und Kerbosch 1973 veröffentlichten. Er lässt eine Clique R Knoten für Knoten wachsen und führt zwei weitere Mengen: P, die Knoten, die noch hinzugefügt werden könnten, weil sie zu allem in R benachbart sind, und X, die Knoten, die hinzugefügt werden könnten, aber bereits untersucht wurden, sodass jede Clique, die sie verwendet, schon gemeldet wurde. Wenn P und X beide leer sind, kann R nicht wachsen und nichts wurde übersprungen, also ist R eine maximale Clique.
def graph(edges):
    adj = {}
    for u, v in edges:
        adj.setdefault(u, set()).add(v)
        adj.setdefault(v, set()).add(u)
    return adj

def bron_kerbosch(R, P, X, adj, out):
    """Meldet jede maximale Clique, die R enthält, nur P verwendet und X meidet."""
    if not P and not X:
        out.append(sorted(R))                 # nichts kann hinzugefügt werden: R ist maximal
        return
    pivot = max(P | X, key=lambda u: len(P & adj[u]))
    for v in sorted(P - adj[pivot]):          # Nachbarn des Pivots werden später versucht
        bron_kerbosch(R | {v}, P & adj[v], X & adj[v], adj, out)
        P.remove(v)
        X.add(v)                              # jede Clique mit v wurde nun gemeldet

def maximal_cliques(adj):
    out = []
    bron_kerbosch(set(), set(adj), set(), adj, out)
    return sorted(out, key=lambda c: (-len(c), c))

def complement(adj):
    return {v: set(adj) - adj[v] - {v} for v in adj}

G = graph(['AB', 'AC', 'AD', 'BC', 'BD', 'CD', 'CH', 'DE', 'DF', 'EF', 'FG', 'GH'])

print(maximal_cliques(G))
# [['A', 'B', 'C', 'D'], ['D', 'E', 'F'], ['C', 'H'], ['F', 'G'], ['G', 'H']]
print(maximal_cliques(complement(G)))   # die maximalen unabhängigen Mengen von G
# [['A', 'E', 'G'], ['A', 'E', 'H'], ['A', 'F', 'H'], ['B', 'E', 'G'], ['B', 'E', 'H'], ['B', 'F', 'H'], ['C', 'E', 'G'], ['C', 'F'], ['D', 'G'], ['D', 'H']]
Der Pivot macht ihn schnell. Jede maximale Clique muss den Pivot oder einen nicht zu ihm benachbarten Knoten enthalten, daher muss die Schleife nur über die Nicht-Nachbarn des Pivots verzweigen; die Wahl desjenigen Knotens aus P oder X mit den meisten Nachbarn in P als Pivot spart die meiste Arbeit. Tomita, Tanaka und Takahashi bewiesen 2006, dass die Laufzeit mit dieser Regel O(3n/3) beträgt, und diese Schranke lässt sich nicht verbessern, denn Moon und Moser zeigten 1965, dass ein Graph auf n Knoten 3n/3 maximale Cliquen haben kann, wenn n ein Vielfaches von 3 ist. Der extreme Graph ist das Komplement von n/3 disjunkten Dreiecken: Auf 9 Knoten hat er 27 maximale Cliquen, auf 30 Knoten 59.049.
Die erste Ausgabezeile listet die fünf maximalen Cliquen aus Abschnitt 3 auf, die größte zuerst. Die zweite Zeile wendet dieselbe Funktion auf das Komplement an und listet so die zehn maximalen unabhängigen Mengen auf. Die Funktion wurde an 3.000 Zufallsgraphen mit bis zu 10 Knoten gegen die Cliquensuche von networkx geprüft, die denselben Algorithmus verwendet.
5. Die größte unabhängige Menge exakt finden
Alle maximalen Mengen aufzulisten ist oft mehr als nötig, und die Antwort lässt sich stattdessen mit einer direkten Suche finden. Zwei Regeln genügen für ein korrektes Verfahren. Ein Knoten vom Grad 0 kann immer genommen werden. Ein Knoten v vom Grad 1 kann ebenfalls immer genommen werden: Enthält eine größte unabhängige Menge seinen einzigen Nachbarn u, so bleibt sie beim Austausch von u gegen v unabhängig und gleich groß. Wenn keine der beiden Regeln greift, wählt man einen Knoten und probiert beide Möglichkeiten aus: ihn nehmen und seine Nachbarn löschen, oder ihn weglassen.
def graph(edges):
    adj = {}
    for u, v in edges:
        adj.setdefault(u, set()).add(v)
        adj.setdefault(v, set()).add(u)
    return adj

def remove(adj, gone):
    return {u: adj[u] - gone for u in adj if u not in gone}

def greedy_independent_set(adj, order):
    """Nimmt jeden Knoten der Reihe nach, außer ein Nachbar ist schon genommen. Immer maximal."""
    chosen = set()
    for v in order:
        if not adj[v] & chosen:
            chosen.add(v)
    return chosen

def max_independent_set(adj):
    """Exakt: Ein Knoten vom Grad 0 oder 1 kann immer gefahrlos genommen werden; sonst verzweigen."""
    if not adj:
        return set()
    v = min(adj, key=lambda u: len(adj[u]))
    if len(adj[v]) <= 1:
        return {v} | max_independent_set(remove(adj, {v} | adj[v]))
    v = max(adj, key=lambda u: len(adj[u]))
    take = {v} | max_independent_set(remove(adj, {v} | adj[v]))   # v rein, Nachbarn raus
    skip = max_independent_set(remove(adj, {v}))                  # v raus
    return take if len(take) >= len(skip) else skip

G = graph(['AB', 'AC', 'AD', 'BC', 'BD', 'CD', 'CH', 'DE', 'DF', 'EF', 'FG', 'GH'])

print(sorted(greedy_independent_set(G, 'DGABCEFH')))   # mit dem meistverbundenen Knoten beginnen
# ['D', 'G']
best = max_independent_set(G)
print(sorted(best), sorted(set(G) - best))             # größte unabhängige Menge, kleinste Überdeckung
# ['A', 'E', 'G'] ['B', 'C', 'D', 'F', 'H']
Die erste Zeile wiederholt die gierige Sackgasse aus Abschnitt 3. Die zweite Zeile liefert eine größte unabhängige Menge, {A, E, G}, und nach der Identität aus Abschnitt 2 bilden die Knoten, die sie auslässt, eine kleinste Knotenüberdeckung, {B, C, D, F, H}. Die Funktion wurde an denselben 3.000 Zufallsgraphen gegen networkx geprüft, und jede zurückgegebene Menge war unabhängig und hatte die richtige Größe.
Das Verzweigen an einem Knoten größten Grades ist Absicht: Ihn zu nehmen löscht die meisten Knoten, sodass dieser Zweig den Graphen am schnellsten verkleinert. Die Gradregeln bedeuten außerdem, dass die Suche auf einem Wald überhaupt nie verzweigt, da jeder Wald einen Knoten vom Grad 0 oder 1 hat und das Löschen von Knoten ihn zu einem Wald lässt. Auf allgemeinen Graphen ist die Suche weiterhin exponentiell, aber weit kleiner als die 2n Teilmengen: Tarjan und Trojanowski verfeinerten 1977 Regeln dieser Art zu einem Algorithmus, der in O(2n/3) läuft, und spätere Arbeiten haben die Basis weiter gesenkt.
6. Knotenüberdeckung: eine 2-Approximation und ein schneller exakter Test
Die Knotenüberdeckung hat zwei Eigenschaften, die ihren Partnern fehlen, und beide ergeben sich aus dem Blick auf die Kanten. Die erste ist eine einfache Approximation. Man geht die Kanten durch, und immer wenn eine Kante noch keinen Endknoten in der Überdeckung hat, fügt man beide Endknoten hinzu. Die so gewählten Kanten haben keinen gemeinsamen Knoten, bilden also ein Matching, und keine weitere Kante könnte hinzukommen, also ist es ein maximales Matching. Jede Überdeckung überhaupt muss mindestens einen Endknoten jeder Matchingkante enthalten, und diese Endknoten sind alle verschieden, also ist τ mindestens so groß wie die Zahl der Matchingkanten. Das Verfahren nimmt genau zwei Knoten pro Matchingkante, also ist seine Überdeckung nie mehr als doppelt so groß wie das Optimum. Dieses Argument wird meist Gavril und Yannakakis zugeschrieben, und das Buch von Garey und Johnson aus dem Jahr 1979 machte es weithin bekannt.
def matching_cover(edges):
    """2-Approximation: beide Endknoten jeder noch nicht überdeckten Kante nehmen."""
    cover = set()
    for u, v in edges:
        if u not in cover and v not in cover:
            cover |= {u, v}                   # diese Kanten bilden ein maximales Matching
    return cover

def cover_of_size(edges, k):
    """Eine Knotenüberdeckung mit höchstens k Knoten oder None. Höchstens 2^k Zweige."""
    if not edges:
        return set()
    if k == 0:
        return None
    u, v = edges[0]                           # u oder v muss in jeder Überdeckung liegen
    for w in (u, v):
        rest = [e for e in edges if w not in e]
        found = cover_of_size(rest, k - 1)
        if found is not None:
            return found | {w}
    return None

E = ['AB', 'AC', 'AD', 'BC', 'BD', 'CD', 'CH', 'DE', 'DF', 'EF', 'FG', 'GH']

print(sorted(matching_cover(E)))
# ['A', 'B', 'C', 'D', 'E', 'F', 'G', 'H']
print(cover_of_size(E, 4))
# None
print(sorted(cover_of_size(E, 5)))
# ['A', 'B', 'D', 'F', 'H']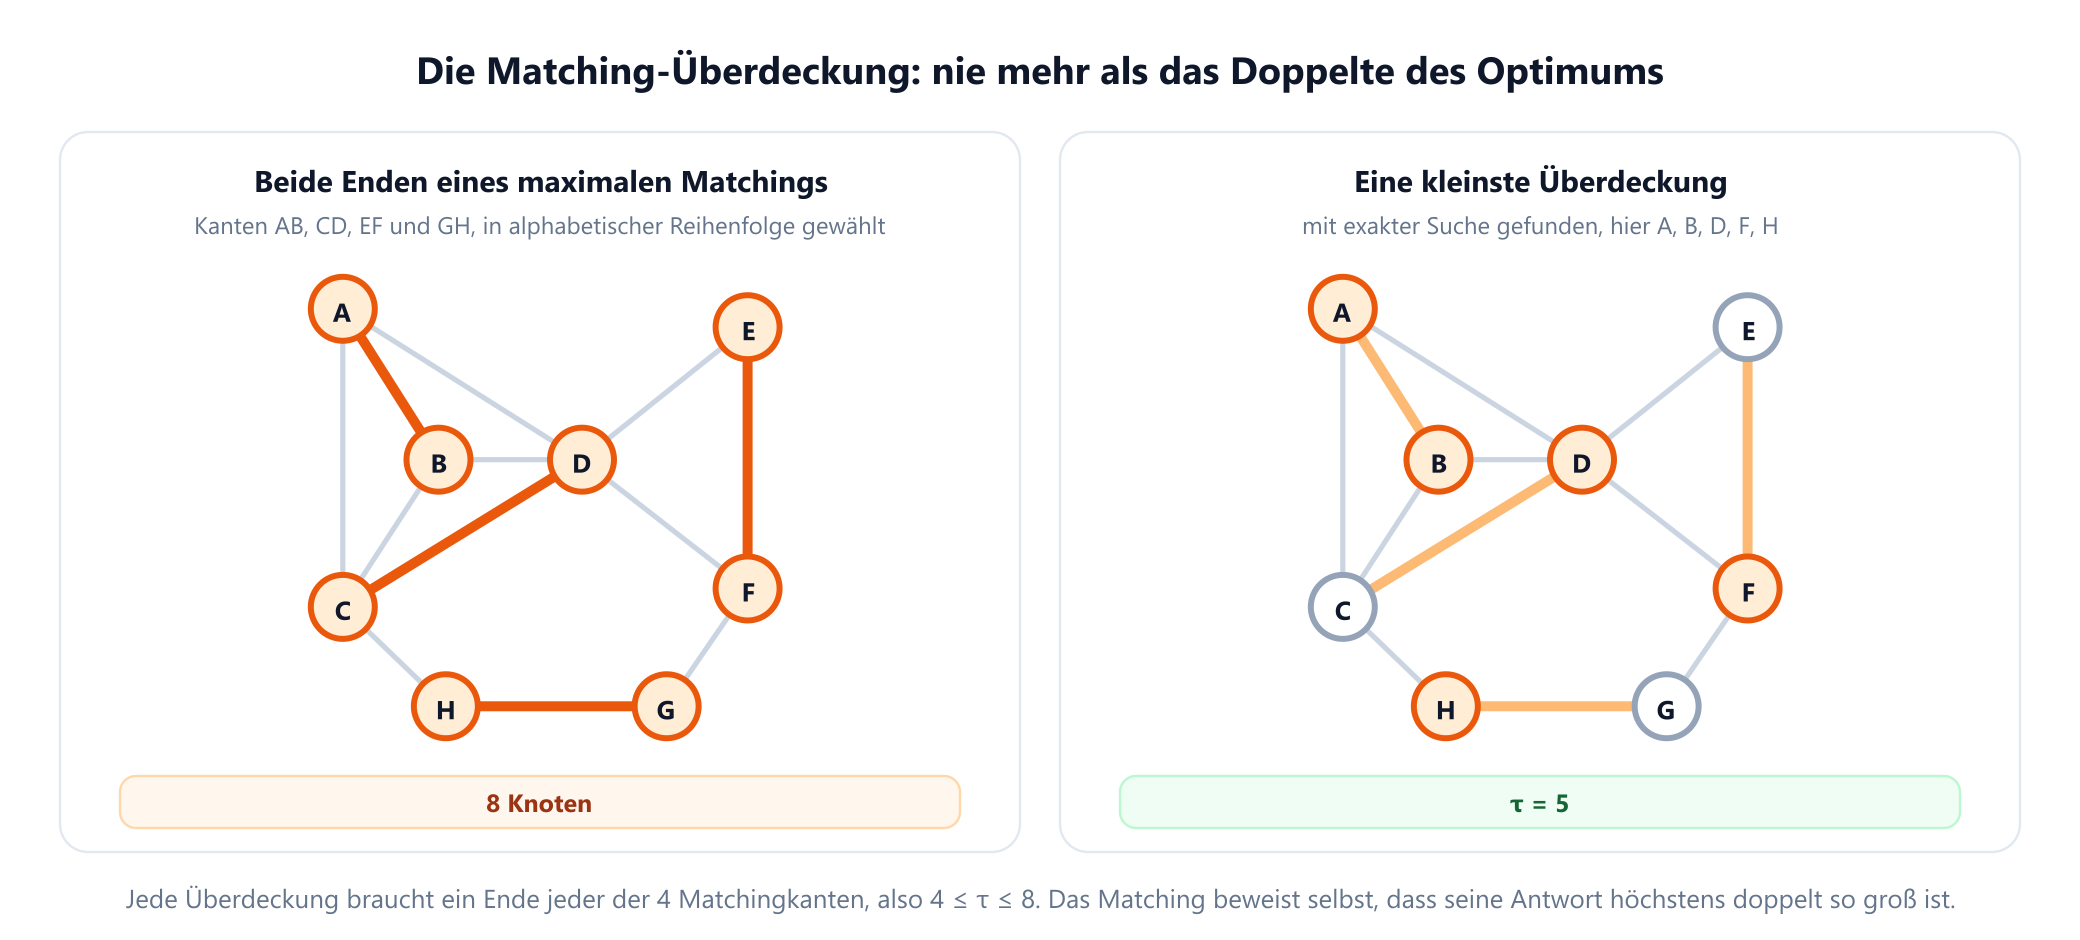
Im Beispiel besteht das Matching aus AB, CD, EF und GH, und das Verfahren nimmt alle acht Knoten. Das ist eine schlechte Überdeckung, aber das Matching beweist auch, dass keine Überdeckung weniger als vier Knoten hat, sodass das Verfahren weiß, dass seine eigene Antwort innerhalb eines Faktors 2 liegt, ohne das Optimum zu kennen. Eine verlockende Alternative, wiederholt den Knoten mit dem höchsten Grad zu nehmen, hat keine solche Garantie: Auf sorgfältig konstruierten Graphen kann ihre Überdeckung um einen Faktor schlechter als das Optimum sein, der mit der Größe des Graphen wächst.
Die zweite Eigenschaft ist, dass sich kleine Überdeckungen leicht exakt finden lassen. Jede Kante uv muss u oder v in der Überdeckung haben, daher probiert die Funktion cover_of_size beides aus und fährt mit einem Budget von k − 1 fort. Der Suchbaum hat höchstens die Tiefe k und höchstens 2k Blätter, unabhängig von der Zahl der Knoten. Im Beispiel meldet sie, dass es keine Überdeckung mit 4 Knoten gibt, und findet eine mit 5. Mit k = 20 hat der Baum höchstens etwa eine Million Blätter, so groß der Graph auch ist: Der Umfang der Suche hängt von der Größe der Überdeckung ab, nicht von der Zahl der Knoten. Probleme mit diesem Verhalten heißen festparameterberechenbar.
Eine Vorverarbeitungsregel aus der Arbeit von Buss und Goldsmith von 1993 verkleinert zuerst die Eingabe. Ein Knoten mit mehr als k Nachbarn muss in jeder Überdeckung der Größe k liegen, weil sonst alle seine Nachbarn nötig wären. Nachdem solche Knoten genommen sind, überdeckt jeder verbleibende Knoten höchstens k Kanten; wenn also mehr als k2 Kanten übrig bleiben, lautet die Antwort nein. Der beste bekannte exakte Algorithmus, von Chen, Kanj und Xia aus dem Jahr 2010, läuft in O(1,2738k + kn) Zeit.
7. Wie schwer sind diese Probleme?
Zu entscheiden, ob ein Graph eine Clique der Größe k hat, ist NP-vollständig, und ebenso zu entscheiden, ob er eine Knotenüberdeckung der Größe k hat. Beide standen auf Karps Liste von 21 NP-vollständigen Problemen aus dem Jahr 1972, und die unabhängige Menge folgt aus jedem der beiden über die Identitäten aus Abschnitt 2. Für keines von ihnen ist ein Polynomialzeitalgorithmus bekannt, und einen zu finden würde P = NP beweisen.
Die Identitäten erhalten exakte Antworten, aber keine Näherungen, und hier gehen die drei Probleme auseinander. Die Knotenüberdeckung lässt sich innerhalb eines Faktors 2 approximieren, wie Abschnitt 6 zeigte. Clique und unabhängige Menge lassen sich im Wesentlichen gar nicht approximieren: Håstad bewies 1999, dass für jedes ε > 0 kein Polynomialzeitalgorithmus die größte Clique innerhalb eines Faktors n1−ε approximiert, außer wenn NP = ZPP gilt, und Zuckerman zeigte 2007, dass dasselbe schon unter der alleinigen Annahme P ≠ NP gilt. Eine kleine Rechnung zeigt, warum die Identität die Garantie nicht überträgt: In einem Graphen mit 1.000 Knoten und τ = 500 liegt eine Überdeckung aus 1.000 Knoten innerhalb eines Faktors 2, doch die unabhängige Menge, die sie übrig lässt, ist leer.
Selbst der Faktor 2 für die Knotenüberdeckung könnte das Ende der Fahnenstange sein. Dinur und Safra bewiesen 2005, dass ihre Approximation innerhalb eines Faktors 1,36 NP-schwer ist, und Khot und Regev bewiesen 2008, dass ein Faktor 2 − ε schwer ist, falls die Unique-Games-Vermutung zutrifft. Auch das parametrisierte Bild unterscheidet sich. Die Knotenüberdeckung ist festparameterberechenbar, wie Abschnitt 6 zeigte, während das Finden einer Clique der Größe k vollständig für die Klasse W[1] ist, wie Downey und Fellows 1995 bewiesen, was ein starkes Indiz dafür ist, dass es dafür keinen Algorithmus mit Laufzeit f(k) · nc gibt.
8. Schranken, die Sie von Hand prüfen können
Da die exakten Zahlen schwer zu berechnen sind, sind einfache Schranken wertvoll, und mehrere davon verbinden diese Probleme mit Färbungen und Graden.
- Cliquen erzwingen Farben. Die Knoten einer Clique sind paarweise benachbart, also braucht jeder seine eigene Farbe:
χ(G) ≥ ω(G), wobeiχdie chromatische Zahl aus dem Leitfaden zur Graphenfärbung ist. Im Beispiel erzwingt die Clique{A, B, C, D}4 Farben, und 4 genügen. - Farben liefern unabhängige Mengen. Jede Farbklasse einer zulässigen Färbung ist eine unabhängige Menge, also zerfallen die
nKnoten inχunabhängige Mengen, und die größte hat mindestensn / χKnoten:α(G) ≥ n / χ(G). Im Beispiel ergibt dasα ≥ 2. - Niedrige Grade liefern unabhängige Mengen. Die Caro–Wei-Schranke, unabhängig voneinander gefunden von Caro 1979 und Wei 1981, besagt
α(G) ≥ ∑ 1 / (d(v) + 1). Man bringe die Knoten in eine zufällige Reihenfolge und behalte jeden Knoten, der vor allen seinen Nachbarn kommt: Die behaltene Menge ist unabhängig, und jeder Knoten wird mit Wahrscheinlichkeit1 / (d(v) + 1)behalten. Für das Beispiel beträgt die Summe127/60 ≈ 2,12, und daαeine ganze Zahl ist, giltα ≥ 3, was hier exakt ist. Der Leitfaden zum Knotengrad erklärt, warum solche Gradsummen so nützlich sind. - Viele Kanten erzwingen Cliquen. Der Satz von Turán aus dem Jahr 1941 besagt, dass ein Graph auf
nKnoten ohne Clique der Größer + 1höchstens(1 − 1/r) n2 / 2Kanten hat, und das Maximum wird erreicht, indem man die Knoten inrnahezu gleich große Gruppen aufteilt und jedes Paar aus verschiedenen Gruppen verbindet. Fürr = 2ist das der Satz von Mantel aus dem Jahr 1907: Ein dreiecksfreier Graph hat höchstensn2 / 4Kanten. Bei 8 Knoten enthält jeder Graph mit mehr als 16 Kanten ein Dreieck und jeder Graph mit mehr als 21 Kanten einK4.
9. Ramsey-Theorie: Ordnung ist unvermeidlich
Der Satz von Turán besagt, dass dichte Graphen große Cliquen enthalten. Die Ramsey-Theorie sagt etwas Stärkeres: Jeder große Graph enthält eine große Clique oder eine große unabhängige Menge, unabhängig von seiner Dichte. Die Ramsey-Zahl R(s, t) ist das kleinste n mit der Eigenschaft, dass jeder Graph auf n Knoten eine Clique der Größe s oder eine unabhängige Menge der Größe t enthält. Ramsey bewies 1930, dass diese Zahlen existieren.
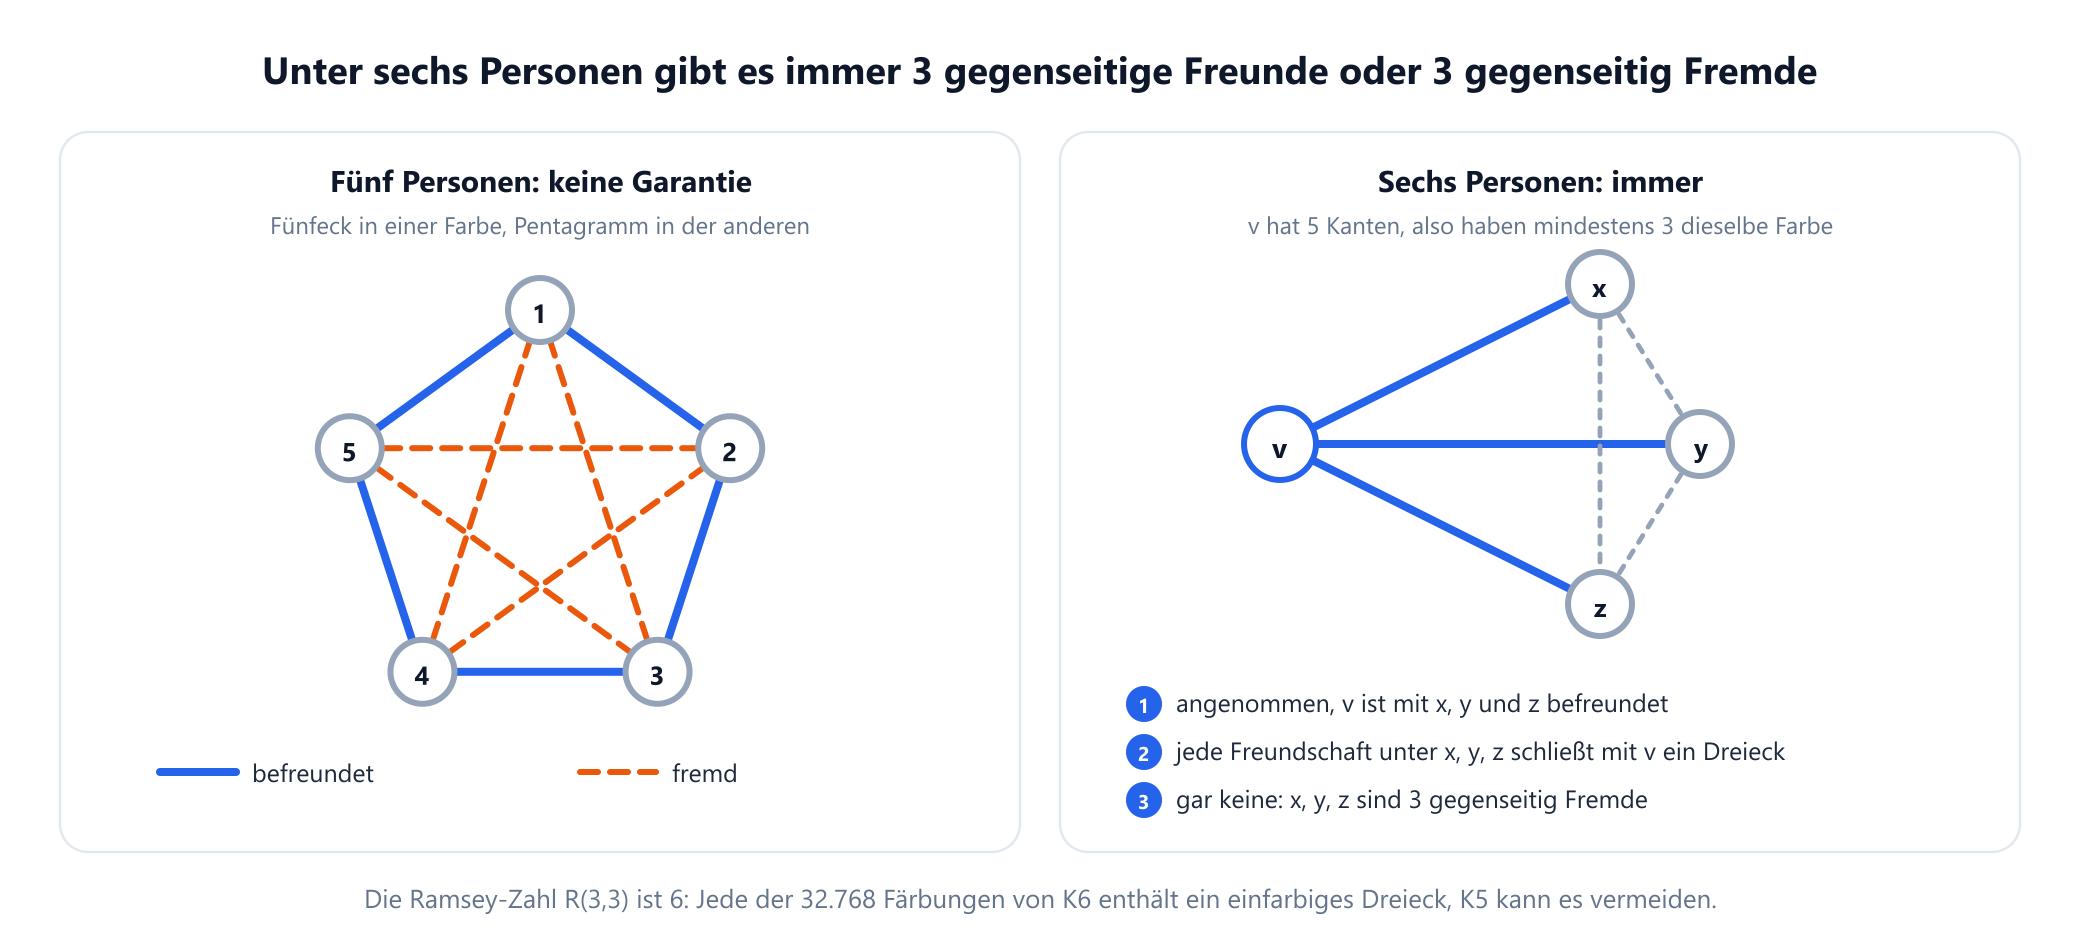
Der kleinste Fall ist das Partyproblem: Unter je sechs Personen gibt es drei, die alle miteinander befreundet sind, oder drei, die einander alle fremd sind, also R(3, 3) = 6. Der Beweis passt in wenige Zeilen. Wählen Sie eine beliebige Person v. Von den anderen fünf sind mindestens drei mit v befreundet oder mindestens drei sind v fremd; etwa die drei Freunde x, y und z. Sind zwei von ihnen befreundet, bilden sie mit v ein Trio von Freunden. Sind keine zwei befreundet, so sind x, y und z drei einander Fremde. Fünf Personen genügen nicht: Ordnen Sie sie in einem Fünfeck an, machen Sie Nachbarn zu Freunden und alle anderen zu Fremden, dann tritt kein Trio der einen oder anderen Art auf. Eine Brute-Force-Prüfung aller 32.768 Möglichkeiten, 15 Paare von sechs Personen als befreundet oder fremd zu markieren, bestätigt das Ergebnis.
Über die kleinsten Fälle hinaus sind Ramsey-Zahlen berüchtigt schwer. Greenwood und Gleason fanden R(4, 4) = 18 im Jahr 1955. Für R(5, 5) zeigte Exoo 1989, dass sie mindestens 43 ist, und Angeltveit und McKay bewiesen 2024 nach jahrzehntelangen Berechnungen, dass sie höchstens 46 ist; der genaue Wert ist weiterhin unbekannt. Für allgemeines k bewiesen Erdős und Szekeres 1935, dass R(k, k) kleiner ist als 4k, und Erdős bewies 1947 die untere Schranke 2k/2 durch den Nachweis, dass ein Zufallsgraph meist weder eine große Clique noch eine große unabhängige Menge hat, eine der ersten Anwendungen der probabilistischen Methode. Spätere Arbeiten verbesserten die obere Schranke, doch die Basis 4 hielt sich, bis Campos, Griffiths, Morris und Sahasrabudhe sie auf (4 − ε)k senkten, in einer erstmals 2023 veröffentlichten Arbeit.
10. Spezielle Graphen, in denen die Probleme leicht werden
NP-Schwere ist eine Aussage über alle Graphen. Viele Graphklassen, die in der Praxis auftreten, haben eine Struktur, die diese Probleme handhabbar macht.
- Bipartite Graphen. Der Satz von Kőnig aus dem Jahr 1931 besagt, dass in einem bipartiten Graphen die kleinste Knotenüberdeckung genau so groß ist wie das größte Matching, und größte Matchings lassen sich in Polynomialzeit mit den Flussmethoden aus dem Leitfaden zum maximalen Fluss finden. Die größte unabhängige Menge folgt dann aus
α = n − τ. Der Leitfaden zu bipartiten Graphen führt ein Beispiel durch. - Bäume und Wälder. Die Gradregeln aus Abschnitt 5 lösen jeden Wald ohne Verzweigung, was mit den richtigen Datenstrukturen einen Linearzeitalgorithmus ergibt.
- Chordale Graphen. Gavril zeigte 1972, dass sich die größte Clique, die größte unabhängige Menge und eine optimale Färbung eines chordalen Graphen alle in Polynomialzeit aus einer perfekten Eliminationsordnung bestimmen lassen, wie der Leitfaden zu chordalen Graphen beschreibt.
- Perfekte Graphen. In einem perfekten Graphen ist in jedem induzierten Teilgraphen die chromatische Zahl gleich der Cliquenzahl. Grötschel, Lovász und Schrijver zeigten 1981, dass sich die Cliquenzahl und die Unabhängigkeitszahl eines perfekten Graphen mit der Ellipsoidmethode in Polynomialzeit berechnen lassen.
- Planare Graphen. Ein planarer Graph enthält keinen
K5, daher hat seine größte Clique höchstens 4 Knoten und lässt sich finden, indem man jede Menge aus höchstens 4 Knoten prüft. Unabhängige Menge und Knotenüberdeckung bleiben jedoch NP-vollständig: Garey, Johnson und Stockmeyer zeigten dies 1976 für planare Graphen, und Garey und Johnson erweiterten es 1977 auf planare Graphen mit Maximalgrad 3.
11. Wo Cliquen, unabhängige Mengen und Überdeckungen eingesetzt werden
- Planung und Konflikte. In einem Konfliktgraphen, in dem Aufgaben verbunden sind, die sich kein Zeitfenster teilen können, ist eine unabhängige Menge eine Gruppe von Aufgaben, die gleichzeitig laufen können, und eine Clique eine Gruppe, die so viele Zeitfenster braucht, wie sie Mitglieder hat. Die Cliquenzahl ist daher eine untere Schranke für die Zahl der Zeitfenster.
- Soziale und biologische Netzwerke. Cliquen modellieren eng verbundene Personengruppen und Proteinkomplexe. Echte Daten sind verrauscht, daher verwenden Analysten oft abgeschwächte Varianten wie die k-Kerne aus dem Leitfaden zum Knotengrad, und Bron–Kerbosch bleibt das Standardwerkzeug, um exakte Cliquen in dünnen Netzwerken aufzulisten.
- Überwachung. Sensoren an möglichst wenigen Knoten so zu platzieren, dass jede Verbindung eines Netzwerks überwacht wird, ist ein Knotenüberdeckungsproblem, ebenso wie die Wahl möglichst weniger Wachen an Straßenecken, sodass jede Straße von einer von ihnen aus einsehbar ist.
- Codierungstheorie. Eine Menge von Codewörtern mit Mindestabstand
dist eine unabhängige Menge in dem Graphen, der je zwei Wörter mit Abstand kleiner alsdverbindet, daher sind die besten Codes einer gegebenen Länge größte unabhängige Mengen. - Strukturen abgleichen. Barrow und Burstall stellten 1976 fest, dass die größte gemeinsame Teilstruktur zweier Graphen, die zum Vergleich von Molekülen dient, der größten Clique in einem aus dem Paar gebildeten Produktgraphen entspricht. Der Leitfaden zur Graphisomorphie behandelt das verwandte Problem, zu entscheiden, ob zwei Graphen gleich sind.
12. Häufige Fehler
| Fehler | Warum es falsch ist | Abhilfe |
|---|---|---|
| Eine maximale Menge für maximum halten | {D, E, F} kann nicht wachsen, doch die größte Clique hat 4 Knoten | Angeben, welche von beiden eine Routine liefert; die meisten schnellen Verfahren liefern maximale Mengen |
| Der gierigen Reihenfolge vertrauen | Wer mit dem meistverbundenen Knoten D beginnt, endet bei {D, G}, einen weniger als α = 3 | Für kleine Graphen exakte Suche verwenden und gierige Ergebnisse als untere Schranke behandeln |
| Unabhängige Menge über die Knotenüberdeckung approximieren | Eine Überdeckung innerhalb eines Faktors 2 kann eine leere unabhängige Menge übrig lassen | Die Identität α + τ = n nur für exakte Antworten verwenden |
| Knoten statt Kanten überdecken | Eine Knotenüberdeckung muss jede Kante berühren, nicht jeden Knoten erreichen | Prüfen, dass jede Kante einen Endknoten in der Menge hat; dominierende Mengen sind ein anderes Problem |
Gleichheit erwarten: ω = χ | Ein 5-Kreis hat Cliquenzahl 2 und braucht 3 Farben | Die Cliquenzahl ω als untere Schranke behandeln; Gleichheit gilt in perfekten Graphen |
| Cliquen ohne Pivot auflisten | Einfaches Backtracking untersucht dieselben Cliquen viele Male | Bron–Kerbosch mit Tomitas Pivotregel verwenden |
| Annehmen, dass Planarität alles leicht macht | Die Knotenüberdeckung bleibt auf planaren Graphen mit Maximalgrad 3 NP-vollständig | Nur das Cliquenproblem wird leicht, da ω ≤ 4 |
13. Glossar
| Begriff | Bedeutung |
|---|---|
| Clique | Eine Menge paarweise benachbarter Knoten |
Cliquenzahl, ω(G) | Die Größe der größten Clique |
| Unabhängige Menge | Eine Menge von Knoten, von denen keine zwei benachbart sind; auch stabile Menge genannt |
Unabhängigkeitszahl, α(G) | Die Größe der größten unabhängigen Menge |
| Knotenüberdeckung | Eine Menge von Knoten, die mindestens einen Endknoten jeder Kante enthält |
Knotenüberdeckungszahl, τ(G) | Die Größe der kleinsten Knotenüberdeckung |
| Maximal | Lässt sich nicht erweitern, ohne die Eigenschaft zu verlieren |
| Maximum | So groß wie möglich unter allen Mengen mit der Eigenschaft |
| Komplement | Der Graph mit einer Kante genau dort, wo das Original keine hat |
| Pivot | Der Knoten, mit dem Bron–Kerbosch Zweige überspringt, die keine neuen Cliquen liefern können |
| Festparameterberechenbar | Lösbar in Zeit f(k) · nc für einen Parameter k |
Ramsey-Zahl, R(s, t) | Die kleinste Knotenzahl mit garantierter Clique der Größe s oder garantierter unabhängiger Menge der Größe t |
14. Häufig gestellte Fragen
Was ist eine Clique in der Graphentheorie?
Eine Clique ist eine Menge von Knoten, in der je zwei Knoten durch eine Kante verbunden sind, sodass die Knoten innerhalb des größeren Graphen einen vollständigen Graphen bilden. Die Größe der größten Clique ist die Cliquenzahl, geschrieben omega(G). Eine maximale Clique lässt sich nicht durch Hinzufügen eines weiteren Knotens erweitern, während eine größte Clique die größte Clique im ganzen Graphen ist.
Was ist der Unterschied zwischen maximal und maximum?
Eine maximale Menge lässt sich nicht vergrößern, ohne ihre Eigenschaft zu verlieren, aber anderswo im Graphen kann es eine größere Menge geben. Eine Menge ist maximum, wenn sie die größte ist, die es gibt. Jede größte Clique oder unabhängige Menge ist maximal, aber nicht umgekehrt, und gierige Verfahren garantieren nur eine maximale Menge.
Wie hängen unabhängige Mengen und Knotenüberdeckungen zusammen?
Eine Menge von Knoten ist genau dann unabhängig, wenn die übrigen Knoten eine Knotenüberdeckung bilden. In jedem Graphen mit n Knoten ist daher die Unabhängigkeitszahl plus die Knotenüberdeckungszahl gleich n, eine Identität, die Gallai zugeschrieben wird. Eine größte unabhängige Menge und eine kleinste Knotenüberdeckung sind Komplemente voneinander, und eine Clique in einem Graphen ist eine unabhängige Menge in seinem Komplement.
Ist das Problem der größten Clique NP-schwer?
Ja. Zu entscheiden, ob ein Graph eine Clique einer gegebenen Größe hat, ist NP-vollständig und stand auf Karps Liste von 21 NP-vollständigen Problemen aus dem Jahr 1972, ebenso wie die Knotenüberdeckung. Das Cliquenproblem ist außerdem schwer zu approximieren: Kein Polynomialzeitalgorithmus kann die größte Clique innerhalb eines Faktors n hoch 1 minus Epsilon approximieren, außer wenn P gleich NP ist.
Wie approximiert man eine kleinste Knotenüberdeckung?
Man wählt wiederholt eine Kante, die keinen Endknoten in der Überdeckung hat, und fügt beide Endknoten hinzu. Die gewählten Kanten bilden ein maximales Matching, und jede Überdeckung braucht mindestens einen Endknoten jeder dieser Kanten, also ist das Ergebnis höchstens doppelt so groß wie das Optimum. Besser als etwa das 1,36-Fache des Optimums zu sein ist NP-schwer, und besser als das Zweifache ist schwer, falls die Unique-Games-Vermutung gilt.
Was macht der Bron-Kerbosch-Algorithmus?
Der Bron-Kerbosch-Algorithmus listet durch Backtracking jede maximale Clique eines Graphen auf. Er führt die aktuelle Clique, die Kandidaten, die sie erweitern könnten, und die bereits untersuchten Knoten. Mit einem gut gewählten Pivot läuft er im schlechtesten Fall in O(3 hoch n/3) Zeit, was optimal ist, weil ein Graph so viele maximale Cliquen haben kann.
15. Quellen
Die Definitionen, Sätze und Zuschreibungen oben stammen aus diesen Quellen, in chronologischer Reihenfolge.
- Mantel, W. (1907). "Problem 28 (Solution by H. Gouwentak, W. Mantel, J. Teixeira de Mattes, F. Schuh and W. A. Wythoff)." Wiskundige Opgaven 10, 60 bis 61.
- Ramsey, F. P. (1930). "On a Problem of Formal Logic." Proceedings of the London Mathematical Society s2-30, 264 bis 286.
- Kőnig, D. (1931). "Gráfok és mátrixok." Matematikai és Fizikai Lapok 38, 116 bis 119.
- Erdős, P. und Szekeres, G. (1935). "A Combinatorial Problem in Geometry." Compositio Mathematica 2, 463 bis 470.
- Turán, P. (1941). "Egy gráfelméleti szélsőértékfeladatról." Matematikai és Fizikai Lapok 48, 436 bis 452.
- Erdős, P. (1947). "Some Remarks on the Theory of Graphs." Bulletin of the American Mathematical Society 53, 292 bis 294.
- Luce, R. D. und Perry, A. D. (1949). "A Method of Matrix Analysis of Group Structure." Psychometrika 14(2), 95 bis 116.
- Greenwood, R. E. und Gleason, A. M. (1955). "Combinatorial Relations and Chromatic Graphs." Canadian Journal of Mathematics 7, 1 bis 7.
- Gallai, T. (1959). "Über extreme Punkt- und Kantenmengen." Annales Universitatis Scientiarum Budapestinensis de Rolando Eötvös Nominatae, Sectio Mathematica 2, 133 bis 138.
- Moon, J. W. und Moser, L. (1965). "On Cliques in Graphs." Israel Journal of Mathematics 3, 23 bis 28.
- Gavril, F. (1972). "Algorithms for Minimum Coloring, Maximum Clique, Minimum Covering by Cliques, and Maximum Independent Set of a Chordal Graph." SIAM Journal on Computing 1(2), 180 bis 187.
- Karp, R. M. (1972). "Reducibility Among Combinatorial Problems." In Complexity of Computer Computations, herausgegeben von R. E. Miller und J. W. Thatcher, 85 bis 103. New York: Plenum.
- Bron, C. und Kerbosch, J. (1973). "Algorithm 457: Finding All Cliques of an Undirected Graph." Communications of the ACM 16(9), 575 bis 577.
- Barrow, H. G. und Burstall, R. M. (1976). "Subgraph Isomorphism, Matching Relational Structures and Maximal Cliques." Information Processing Letters 4(4), 83 bis 84.
- Garey, M. R., Johnson, D. S. und Stockmeyer, L. (1976). "Some Simplified NP-Complete Graph Problems." Theoretical Computer Science 1(3), 237 bis 267.
- Garey, M. R. und Johnson, D. S. (1977). "The Rectilinear Steiner Tree Problem is NP-Complete." SIAM Journal on Applied Mathematics 32(4), 826 bis 834. Knotenüberdeckung auf planaren Graphen mit Maximalgrad 3.
- Tarjan, R. E. und Trojanowski, A. E. (1977). "Finding a Maximum Independent Set." SIAM Journal on Computing 6(3), 537 bis 546.
- Caro, Y. (1979). "New Results on the Independence Number." Technischer Bericht, Universität Tel Aviv.
- Garey, M. R. und Johnson, D. S. (1979). Computers and Intractability: A Guide to the Theory of NP-Completeness. San Francisco: W. H. Freeman. Die 2-Approximation für die Knotenüberdeckung.
- Wei, V. K. (1981). "A Lower Bound on the Stability Number of a Simple Graph." Bell Laboratories Technical Memorandum 81-11217-9.
- Grötschel, M., Lovász, L. und Schrijver, A. (1981). "The Ellipsoid Method and Its Consequences in Combinatorial Optimization." Combinatorica 1(2), 169 bis 197.
- Exoo, G. (1989). "A Lower Bound for R(5, 5)." Journal of Graph Theory 13(1), 97 bis 98.
- Buss, J. F. und Goldsmith, J. (1993). "Nondeterminism within P." SIAM Journal on Computing 22(3), 560 bis 572.
- Downey, R. G. und Fellows, M. R. (1995). "Fixed-Parameter Tractability and Completeness II: On Completeness for W[1]." Theoretical Computer Science 141, 109 bis 131.
- Håstad, J. (1999). "Clique is Hard to Approximate within n1−ε." Acta Mathematica 182(1), 105 bis 142.
- Dinur, I. und Safra, S. (2005). "On the Hardness of Approximating Minimum Vertex Cover." Annals of Mathematics 162(1), 439 bis 485.
- Tomita, E., Tanaka, A. und Takahashi, H. (2006). "The Worst-Case Time Complexity for Generating All Maximal Cliques and Computational Experiments." Theoretical Computer Science 363(1), 28 bis 42.
- Zuckerman, D. (2007). "Linear Degree Extractors and the Inapproximability of Max Clique and Chromatic Number." Theory of Computing 3, 103 bis 128.
- Khot, S. und Regev, O. (2008). "Vertex Cover Might Be Hard to Approximate to within 2 − ε." Journal of Computer and System Sciences 74(3), 335 bis 349.
- Chen, J., Kanj, I. A. und Xia, G. (2010). "Improved Upper Bounds for Vertex Cover." Theoretical Computer Science 411(40–42), 3736 bis 3756.
- Diestel, R. (2017). Graph Theory, 5. Auflage. Graduate Texts in Mathematics 173. Berlin: Springer.
- Angeltveit, V. und McKay, B. D. (2024). "R(5, 5) ≤ 46." arXiv:2409.15709.
- Campos, M., Griffiths, S., Morris, R. und Sahasrabudhe, J. (2026). "An Exponential Improvement for Diagonal Ramsey." Annals of Mathematics 203(3), 869 bis 932. Erstmals 2023 veröffentlicht als arXiv:2303.09521.
Sehen Sie Bron–Kerbosch bei der Arbeit zu
Zeichnen Sie das Beispiel im Visualisierer und starten Sie die Suche nach maximalen Cliquen. Sie meldet alle fünf maximalen Cliquen, darunter das Dreieck und die drei Kanten, die lange vor der größten Clique aufhören zu wachsen.
Visualisierer öffnen