
目录
1. Dijkstra 题目真正考察的是什么
没有人会被要求背诵 Dijkstra 算法。你拿到的是一个权重并非距离的问题,面试真正问的是,你能否看出这个算法的框架依然适用。
这个框架是:一个按代价标签排序的优先队列、一条改进邻居标签的松弛规则,以及一个保证:顶点一旦出堆,它的标签就是最终的。改变“代价”的含义、改变比较方式,同样的十二行代码就能解决最小体力消耗、最大概率、最便宜航班以及另外五六道题。面试考察的是你是否知道哪些部分可以改,哪一部分不能改。 Dijkstra 1959 年的原始论文只有两页,而这个思想此后从未需要修改。
下面八道是反复出现的题目,每道都附有解答、追问,以及让你丢掉 offer 的错误。每个示例都经过脚本实际运行验证。
2. 模板与惰性删除
要能不假思索地写出下面的代码。注释标出的两行,正是正确实现与看似正确的实现之间的区别。
import heapq

def dijkstra(adj, src, n):          # adj[u] = [(v, w), ...] 其中 w >= 0
    dist = [float('inf')] * n
    dist[src] = 0
    heap = [(0, src)]
    while heap:
        d, u = heapq.heappop(heap)
        if d > dist[u]:             # 过期条目:在它入堆之后
            continue                # 又找到了更好的标签。跳过它。
        for v, w in adj[u]:
            if d + w < dist[v]:
                dist[v] = d + w
                heapq.heappush(heap, (dist[v], v))   # 压入,绝不用 decrease-key
    return dist
那行 if d > dist[u]: continue 就是“你如何处理 decrease-key”这个问题的完整答案。二叉堆没有高效的 decrease-key,所以你不去更新条目,而是再压入一个新条目,并忽略过期的出堆。这就是惰性删除,能说出这个名字比周围的代码更有价值。因此堆中最多可能有 O(E) 个条目,而不是 O(V)个,这就是为什么上界是 O((V + E) log V) 而不是 O((V + E) log E):两个对数只差一个常数因子,因为 E < V2。
还有两点要说出来。一个顶点在带着当前标签出堆的那一刻就被确定了,此后它的距离不会再变;这就是贪心选择所依赖的不变式。另外,你不需要单独的 visited 集合,因为过期检查已经会拒绝任何第二次出堆。
3. 网络延迟时间与路径重建
题目。给定一个有向带权图和一个源点,需要多长时间才能到达每个顶点?如果某个顶点永远无法到达,返回 -1。面试中的说法包括信号传播、包裹投递,或者“最后一台服务器什么时候收到消息”。
这就是普通的 Dijkstra 再加一行:答案是 max(dist);如果任何条目仍为无穷大,则返回 -1。
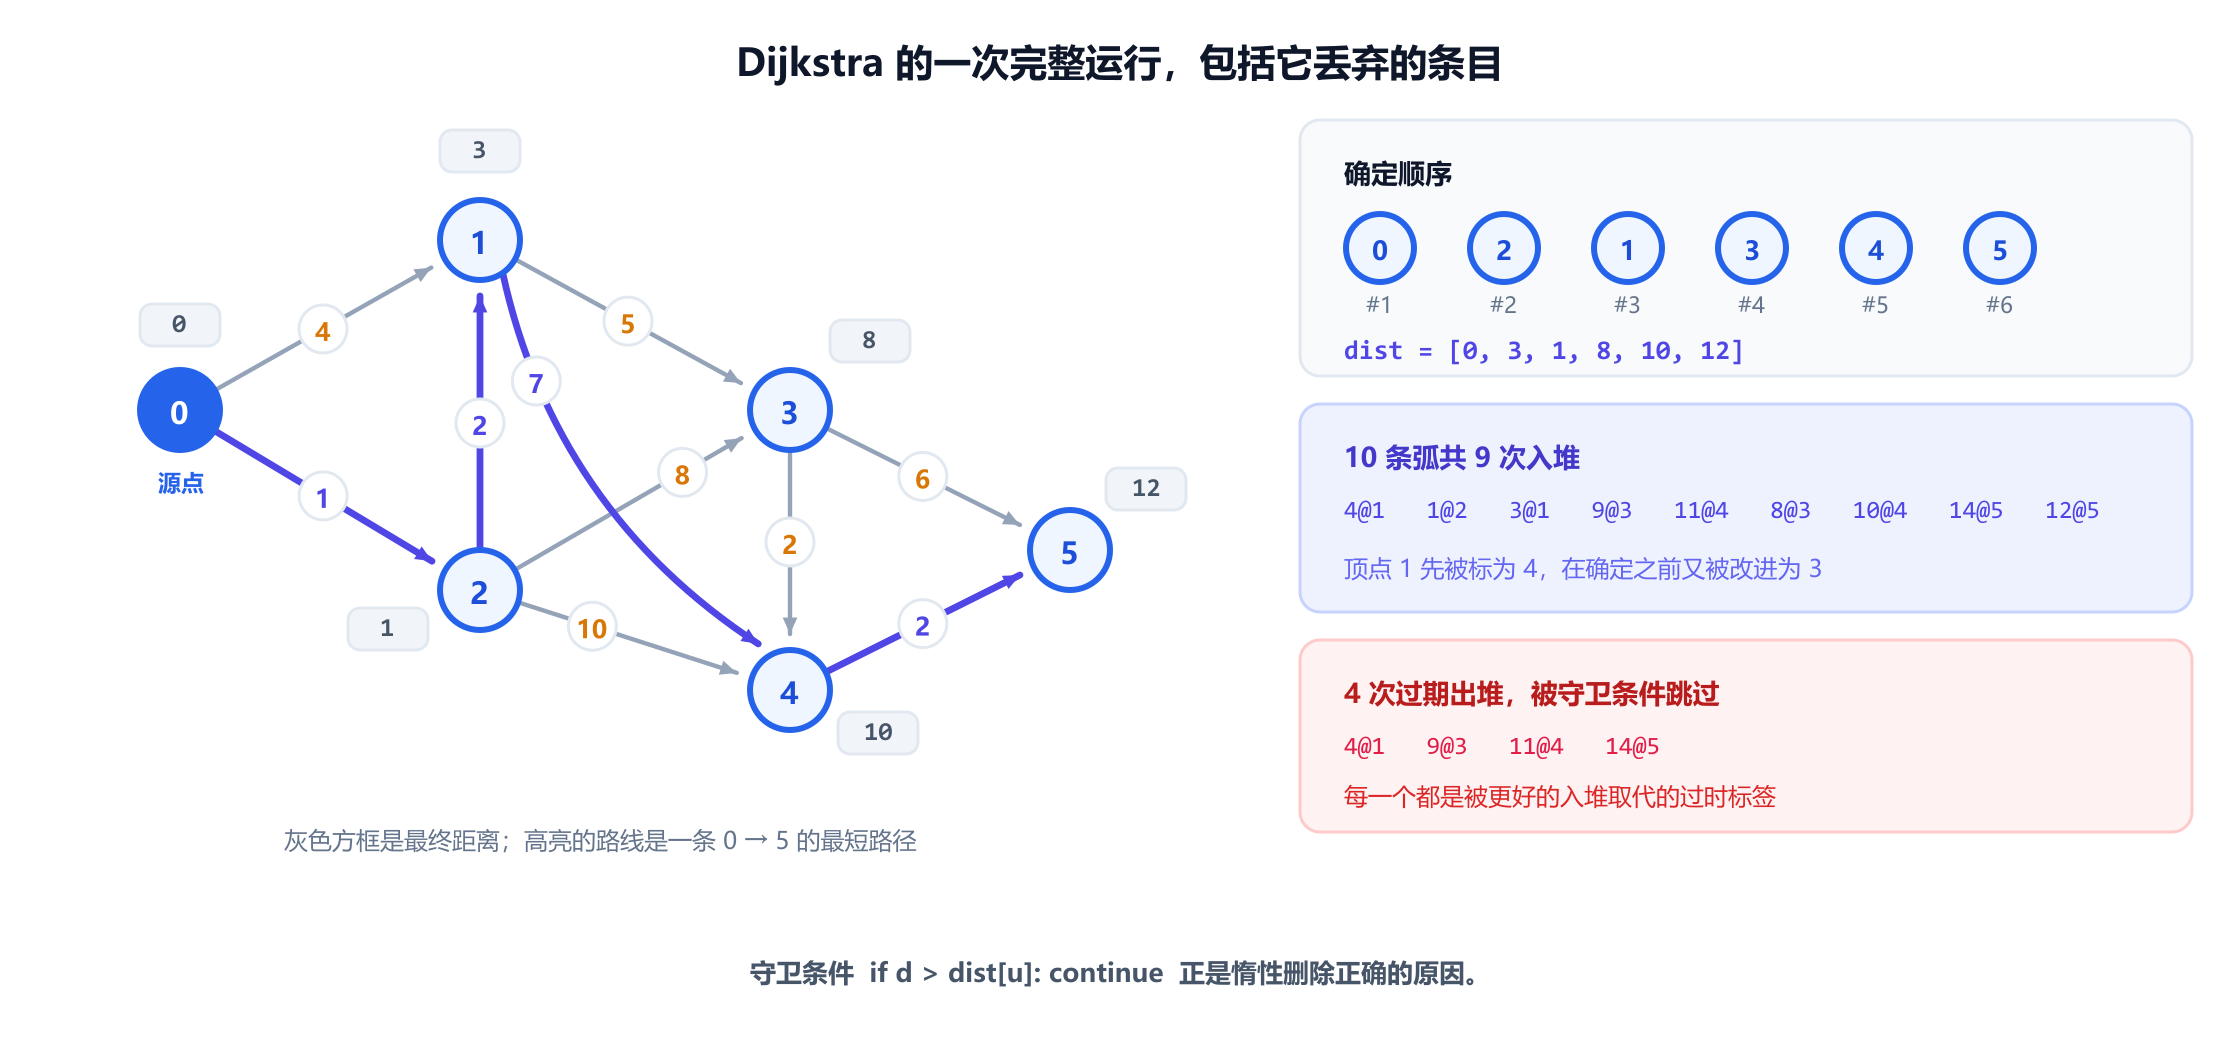
在示例图上,从 0 出发的 Dijkstra 按 0, 2, 1, 3, 4, 5 的顺序确定顶点,并返回距离 0, 3, 1, 8, 10, 12。注意顶点 1:弧 0 → 1 先把它标为 4,然后 0 → 2 → 1 在它出堆之前就把它改进为 3。这正是算法按预期工作的方式,也是你绝不能在入堆时就认定标签的原因。
追问:返回路径本身,而不只是长度。维护一个 parent 数组,设置 parent[v] = u,并把它放在改进 dist[v]的同一个分支里,然后从目标沿它反向回溯再反转。在这个图上得到 0 → 2 → 1 → 4 → 5,代价为 12。要说“一条最短路径”而不是“那条最短路径”:这里有两条代价为 12 的路径,正如第 7 节所示。
陷阱。把 parent[v] 放在改进分支之外设置,这样它记录的是最后一个尝试过的顶点,而不是成功的那个。距离仍然正确,重建出的路径却是错的,这是代码审查中最糟糕的一类 bug。
4. K 站中转内最便宜的航班
题目。求从源点到目标、最多经过 K 个中转站的最便宜路线。
这道题会难倒很多人,因为普通的 Dijkstra 在这里是错误的。它的正确性依赖于每个顶点只有一个最终标签,但在中转次数受限时,一个顶点对每种已用中转次数都有不同的最佳代价,而一条便宜却用掉太多跳数的路线,可能比一条贵但短的路线更差。只确定一次顶点,恰好会丢掉你需要的那个备选。
有两个正确答案,两个都知道才是重点。
扩展状态。保留 Dijkstra,但把顶点变成一个二元组 (node, stops_used)。现在标签对每个二元组是最终的,不变式重新成立。
def cheapest(adj, src, dst, K, n):
    best = [[float('inf')] * (K + 2) for _ in range(n)]
    best[src][0] = 0
    heap = [(0, src, 0)]                     # (代价, 节点, 中转数)
    while heap:
        c, u, k = heapq.heappop(heap)
        if u == dst: return c                # dst 第一次出堆即为最优
        if k > K or c > best[u][k]: continue
        for v, w in adj[u]:
            if c + w < best[v][k + 1]:
                best[v][k + 1] = c + w
                heapq.heappush(heap, (c + w, v, k + 1))
    return -1
或者使用 Bellman-Ford,这是更简洁的答案。每条边恰好松弛 K + 1 轮,每一轮都基于上一轮的快照,就能直接得到最多使用 K + 1 条边的最便宜路线。这是 Bellman 1958 年的表述,复杂度为 O(K × E),完全不需要堆。主动提出它会给人很好的印象。
陷阱。 Bellman-Ford 版本必须基于上一轮距离的副本进行松弛。原地松弛会让一轮更新沿多条边传播,从而悄悄允许超过 K 次中转,并返回一个看似合理却过于便宜的答案。
5. 最小体力消耗路径:替换加号
题目。最小化路线上最大的单条边,而不是总和。常见说法:最小体力消耗路径、水位上升的泳池中游泳、你必须能承载的最大重量。
关键洞见是,Dijkstra 其实从来不需要加法。它要求的是:延长一条路径不能改善它的代价,这样已确定的标签才会保持最终。 max 与 +一样满足这一点,所以只需改一行:
        cand = max(d, w)          # 代替 d + w
        if cand < best[v]:
            best[v] = cand
            heapq.heappush(heap, (cand, v))
在示例图上,从顶点 0 出发的 minimax 值为 0, 2, 1, 5, 5, 5,所以到顶点 5 的最佳瓶颈值是 5:穷举每条路线可以验证这一点。它确实是一个不同的目标,这一点从两条最便宜的路线就能看出:它们的代价都是 12,但最大弧分别为 5 和 7。最小化总和与最小化最大弧并不是同一个问题,而且一般来说,瓶颈最优的路线根本不必是最短路线。
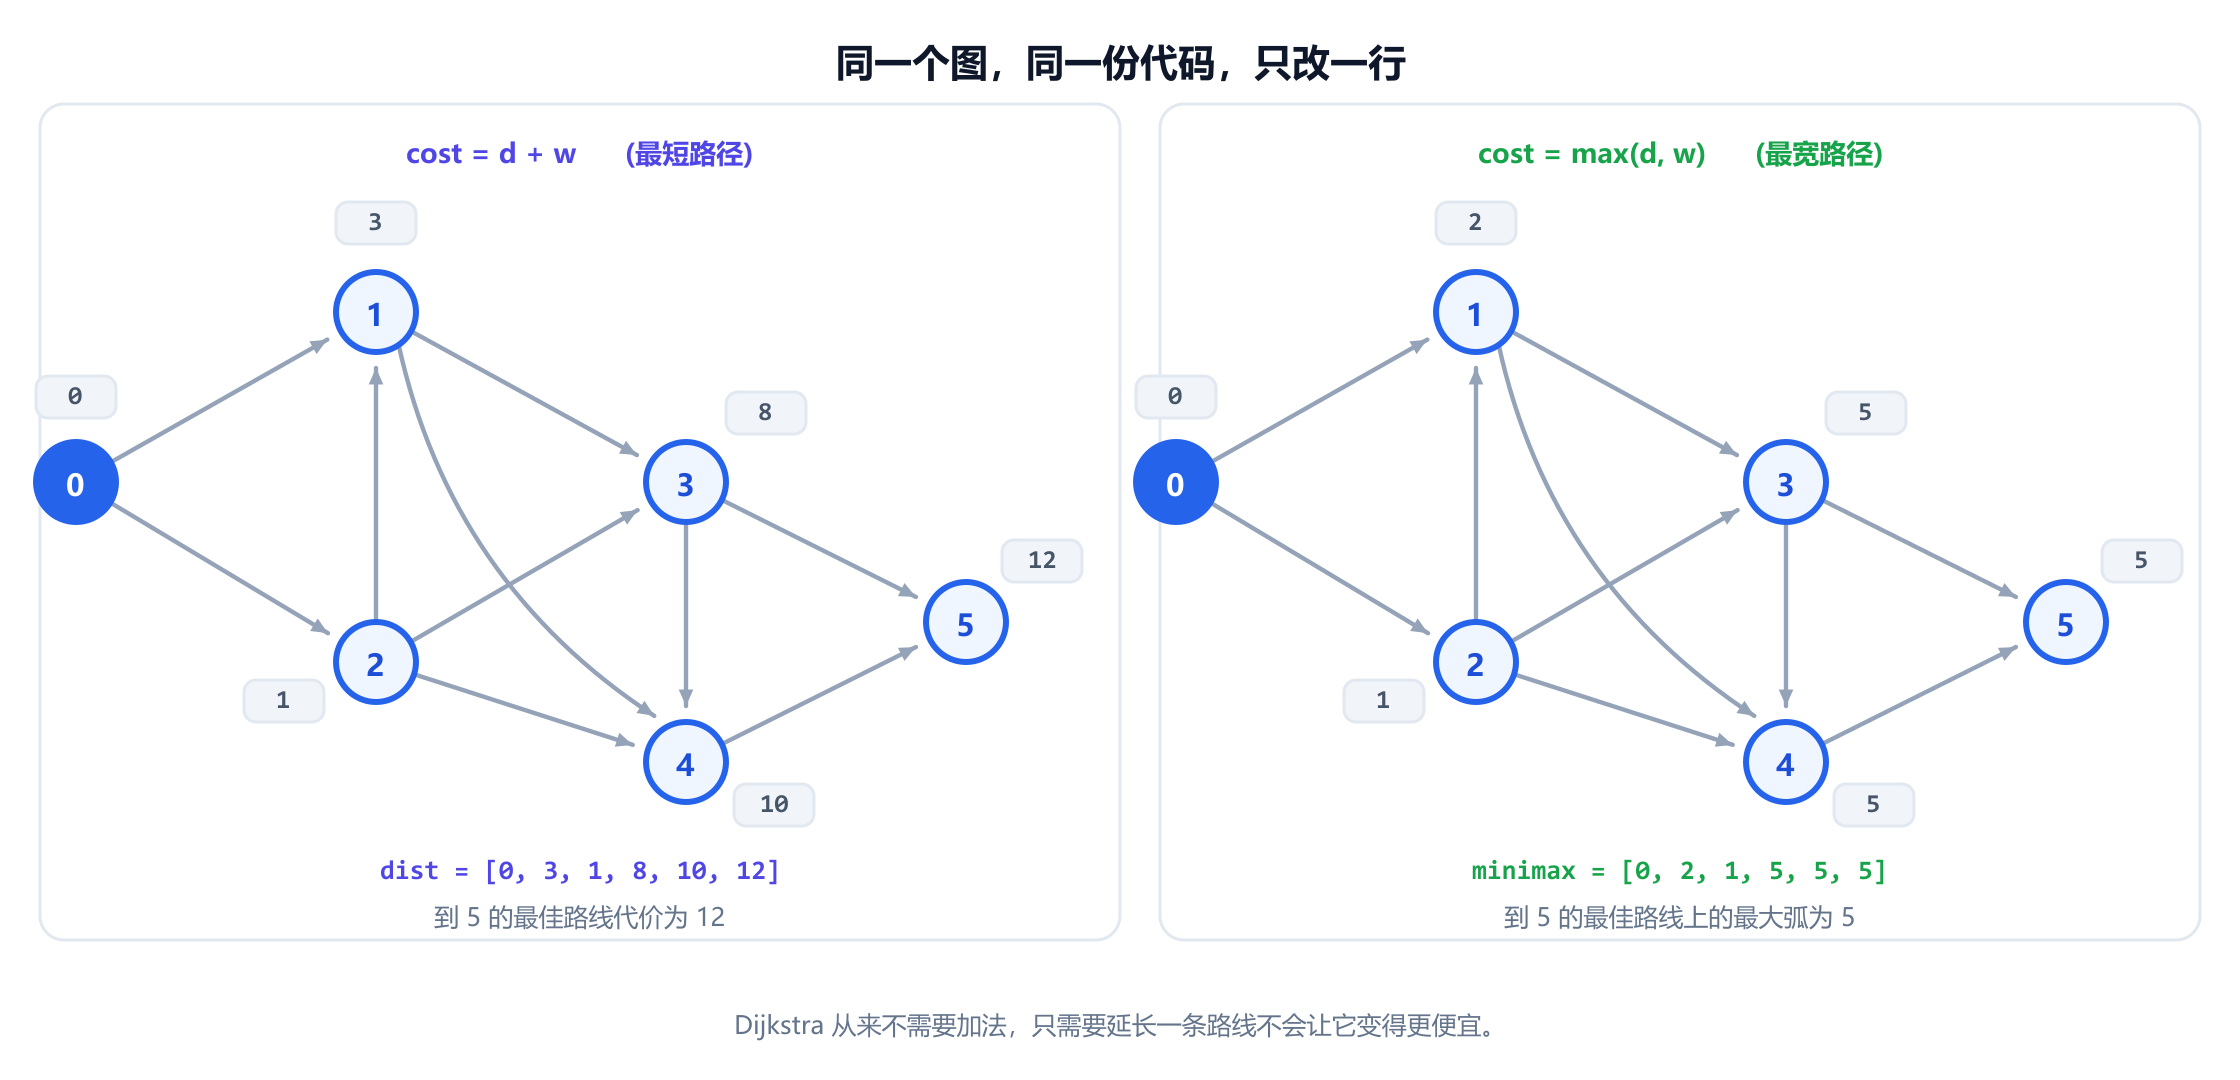
+ 换成 max,最短路径就变成了最宽路径。追问:还有什么能替换加号?任何单调的运算都可以,也就是延长路径永远不会降低其代价。 max 可以;对区间 [0,1] 内的概率做乘法,只要你是在求最大值,也可以;非负权重的普通加法当然也可以。减法则不行,这和禁止负权边是同一个原因。
陷阱。在网格版本中,用并查集或二分答案加 BFS 的解法也会被接受,有时还更快。如果你给出 Dijkstra,要准备好说明理由:不需要对任何参数做二分,而且只需一遍。
6. 概率最大的路径
题目。每条边都有一个成功概率;找出从源点到目标、所有边都成功的概率最高的路线。
代价是相乘而不是相加,而且你想要最大的乘积,所以要把队列反过来变成最大堆,并用 ×来松弛。概率位于 [0,1]之间,所以延长路径只会让乘积变小,这恰好是 Dijkstra 所需的单调性。
        cand = p * pw                     # 代替 d + w
        if cand > best[v]:                # 用 >,因为我们求最大值
            best[v] = cand
            heapq.heappush(heap, (-cand, v))   # 取负:heapq 是最小堆
在一个有从 0 到 3 的直达弧(概率 0.30)以及两段弧路线 0 → 1 → 3 (概率分别为 0.9 和 0.8)的图上,最佳概率是沿两段弧路线得到的 0.72,胜过单条弧。要说出的那句话是:这里边越多反而可能越好,而这对正权重的普通最短路径永远不成立。
追问:为什么不取对数?可以,而且这是个好答案。由于 log(ab) = log a + log b,最大化概率的乘积就等于最小化 -log p之和,而这些值都是非负的,所以可以直接使用原版 Dijkstra。要提到一个注意事项:对接近零的概率取浮点 log 会损失精度,而概率为 0 的边会得到无穷大,必须单独处理。
7. 最短路径计数
题目。从源点到目标有多少条不同的最短路线?通常要求对 109+7 取模。
多一个数组,多一个分支。除了 dist 之外,再维护 ways,即到达每个顶点的最短路线数。当一次松弛改进了标签时,计数被替换;当它持平时,计数相加。
        if d + w < dist[v]:
            dist[v] = d + w
            ways[v] = ways[u]              # 严格更优:替换
            heapq.heappush(heap, (dist[v], v))
        elif d + w == dist[v]:
            ways[v] = (ways[v] + ways[u]) % MOD   # 平局:相加
在示例图上,计数为 1, 1, 1, 1, 2, 2。暴力验证一致:从 0 到 5 的 9 条路线中,有两条代价为 12,即 0→2→1→3→4→5 和 0→2→1→4→5。注意,边数更少的路线并不是唯一最优的,这正是值得指出的那类细节。
追问:平局分支安全吗?是安全的,但前提是 ways[u] 在 u 出堆时已经是最终值,并且每次松弛都从已出堆的顶点进行。从一个尚未确定的顶点累加计数会导致重复计数。这是说明“确定即最终”才是关键不变式、而不是代码本身的最清楚的例子。
陷阱。忘记 elif 必须放在相等判断上,而不是在改进分支内部。如果写成单个 if d + w <= dist[v],平局时计数会被替换而不是相加,每个顶点的答案都会是 1。
8. 次短路径
题目。找出从源点到目标的第二短路线。立刻澄清“第二”指的是严格长于最优路线,还是仅仅指在平局也分别计数的列表中的下一条路线。两种答案不同,面试官是故意这样问的。
技巧是放宽“只确定一次”的规则:为每个顶点保留两个最佳标签,并允许一个顶点出堆两次。
best1 = [inf] * n; best2 = [inf] * n
best1[src] = 0
heap = [(0, src)]
while heap:
    d, u = heapq.heappop(heap)
    if d > best2[u]: continue          # 比保留的两个标签都差
    for v, w in adj[u]:
        nd = d + w
        if nd < best1[v]:
            best1[v], nd = nd, best1[v]     # 把原来的最优降为候选
            heapq.heappush(heap, (best1[v], v))   # 新的最优也必须传播出去
        if best1[v] < nd < best2[v]:        # 严格差于最优
            best2[v] = nd
            heapq.heappush(heap, (nd, v))
在示例图上,从 0 到 5 的不同路线代价为 12, 13, 14, 15,所以严格意义上的次优是 13。如果平局分别计数,答案又是 12,因为有两条不同的路线达到这个值。写代码之前先问清楚。
追问:推广到 K。为每个顶点保留 K 个最佳标签的列表,或者使用 Yen 算法求 K 条最短的无环路径,这是一个本质上不同且重得多的问题。说出“无环会让问题完全改变”是正确的直觉:没有这个限制,最短的途径可以永远重复一个零权环。
9. 为什么非负权重没有商量余地
每个面试官都会问这个问题,而大多数候选人回答“因为 Dijkstra 是贪心的”,这没错,但什么也没解释。准确的原因是:算法假定当一个顶点以队列中最小的标签出堆时,任何仍在构建中的路线都无法以更低的代价到达它。负权边打破了这一点,因为延长路径可能降低它的代价。
准备好一个具体的反例。取四个顶点,弧为 0→1 (1)、 0→2 (2)、 2→1 (−2)和 1→3 (1)。
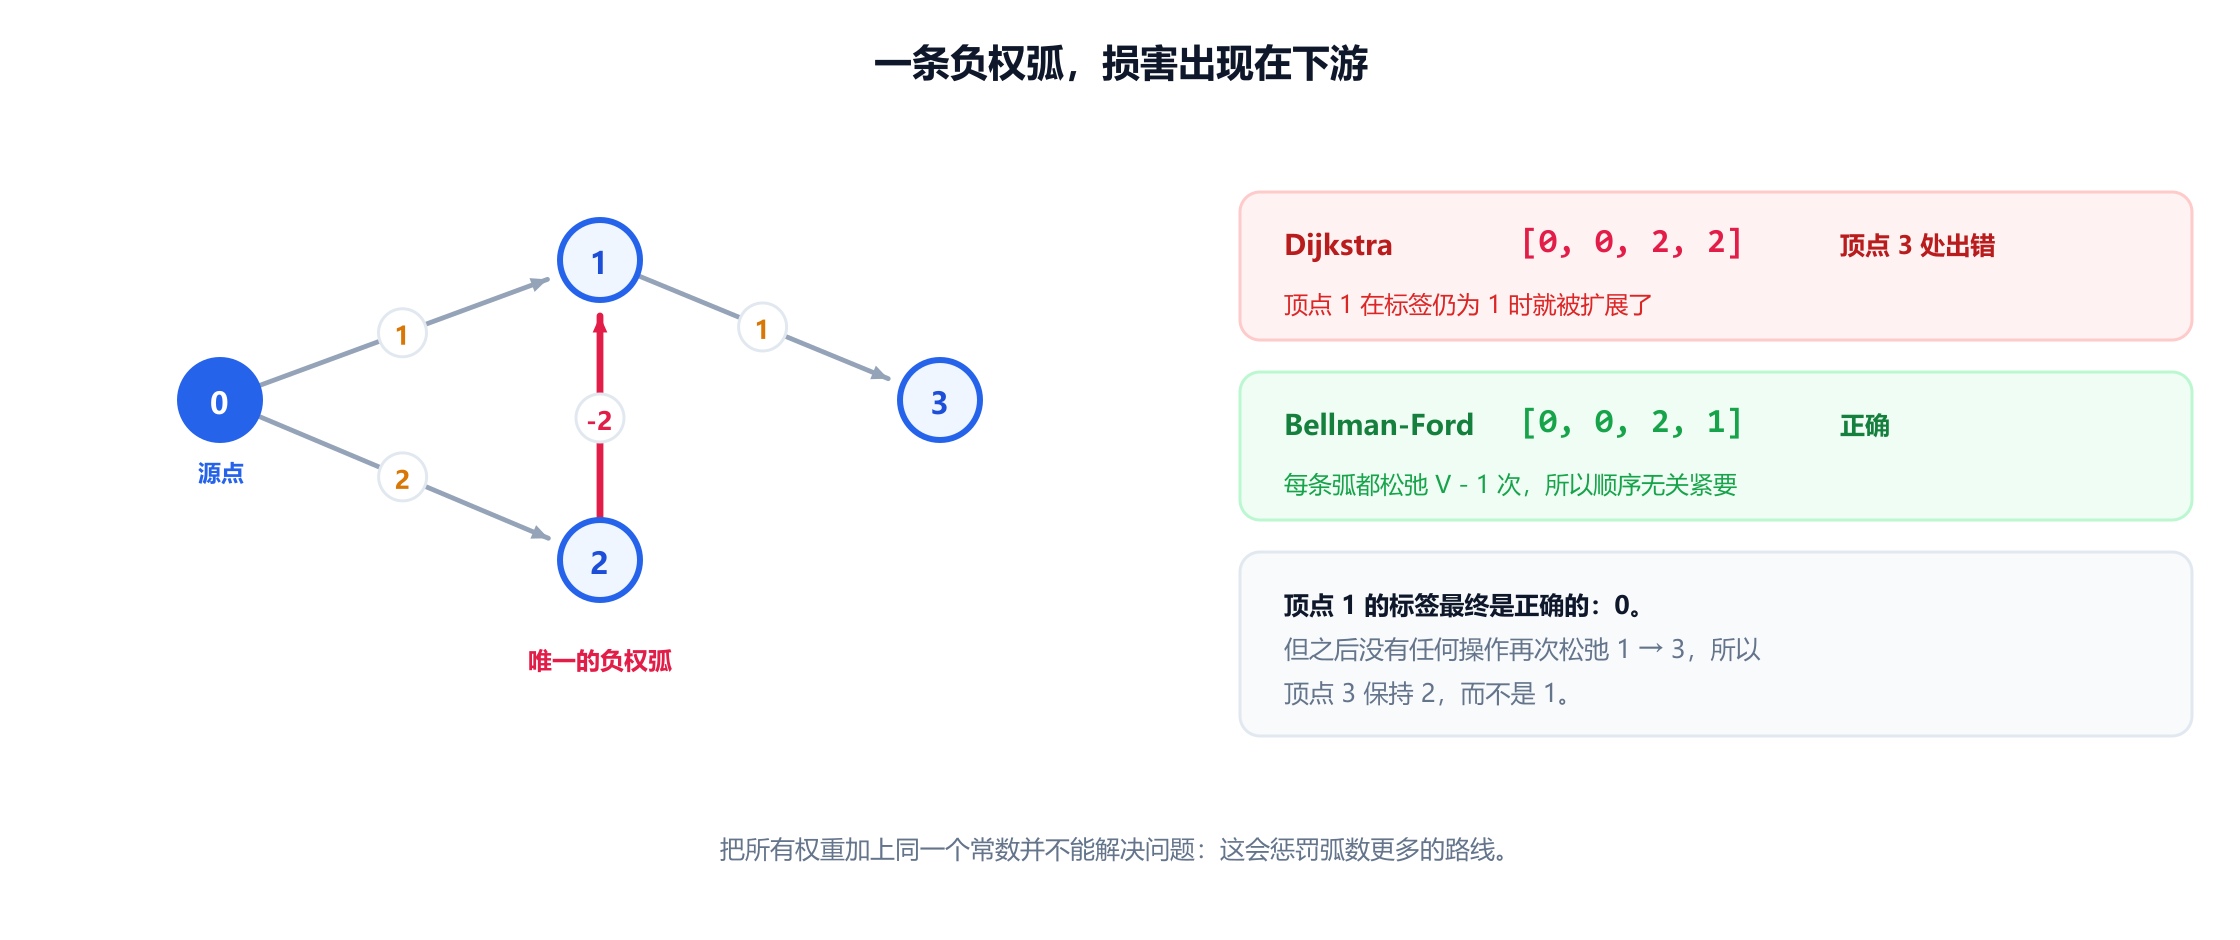
Dijkstra 返回 0, 0, 2, 2;正确答案是 0, 0, 2, 1。这个微妙之处值得准确说明,因为它比通常的答案更有意思:顶点 1 的标签最终是正确的。它在标签仍为 1 时被扩展,之后改进为 0 的更新也确实被写入了。但之后没有任何操作再次松弛 1 → 3,所以顶点 3 保持 2 而不是 1。能说出“错误的值出现在负权边的下游,而不是负权边本身”的候选人,显然是亲手试过的。
追问:那应该用什么? Bellman-Ford,它把每条边松弛 V - 1 次,时间为 O(VE),并在第 V轮检测负环。如果你需要所有点对之间的距离,存在负权边但没有负环,Johnson 算法会先用一次 Bellman-Ford 对权重重新赋权,使所有权重都变为非负,然后从每个顶点运行 Dijkstra。Cormen、Leiserson、Rivest 和 Stein 给出了贪心选择正确性的完整证明。
陷阱。 “只要给每个权重加上一个常数,让它们都变成正数就行了。”这行不通,而能用一句话说出原因是一个很强的信号:给每条边加上 c,就会给一条路线加上 c × (number of edges),这会惩罚边数更多的路线,从而改变哪条路线最短。
10. 复杂度回答
准备好界和理由,并说出数据结构的名字。只说“Dijkstra 是 O(E log V)”却不说是哪种堆,会引来一个你答不上的追问。
| 优先队列 | 时间 | 应给出的理由 |
|---|---|---|
| 二叉堆,惰性删除 | O((V + E) log V) | 最多 E 个条目入堆,每次出堆和入堆都是对数时间 |
| 斐波那契堆 | O(E + V log V) | decrease-key 是 O(1) 均摊,所以边不带对数因子 |
| 无序数组 | O(V2 + E) | 每轮扫描求最小值;最适合稠密图 |
| 空间,任意变体 | O(V + E) | 图本身,加上一个条目数从不超过 E 的堆 |
基于堆的界是 Johnson 1977 年的结果;斐波那契堆的改进来自 Fredman 和 Tarjan,1987 年。二叉堆本身是 Williams 1964 年的构造。斐波那契变体在理论上更好,但在实践中几乎总是更慢,因为它的常数很大,说出这一点体现的是判断力而不是背诵。Sedgewick 和 Wayne 对支持 decrease-key 的索引优先队列方案给出了最简短清晰的讲解。
有两个数字值得记住。在 V = 105 且 E = 5 × 10⁵的稀疏图上,二叉堆的界大约是 1000 万次操作,而斐波那契堆约为 220 万次:纸面上确实有差距,但实践中常数会抹平它。而在 E 接近 V2的稠密图上,时间为 O(V2) 的普通数组胜过二叉堆的 O(V2 log V),这是“朴素”实现唯一正确的场合。
11. 导致面试失败的错误
按出现频率排序;前三个错误占了大多数被拒的解答。
- 省略过期条目检查。没有
if d > dist[u]: continue,你会从过时的标签出发重新扩展顶点。答案通常仍然正确,而运行时间会严重退化,这就是它能通过测试的原因。 - 在状态不只是顶点时使用 Dijkstra。中转次数限制、燃料预算或“最多 K 次折扣”这样的条件,意味着标签是按
(vertex, resource)对来定义的。只确定顶点本身会丢掉你需要的路线。 - 在负权重上使用 Dijkstra。使用 Bellman-Ford,绝不要尝试把权重平移成正数。
- 忘记
heapq是最小堆。要求最大值就意味着压入取负后的键,而取出时忘记第二次取负是经典的隐蔽 bug。 - 比较第二个元素不可排序的元组。
heappush(heap, (dist, node_object))一旦两个距离相等,Python 就会转而比较对象并抛出异常。压入一个下标,或者加一个用于打破平局的计数器。 - 在改进分支之外设置父指针。距离仍然正确,重建出的路径却是错的。
- 平局时替换计数而不是相加。用一个
<=代替本该使用的<和==,每个最短路径计数都会变成 1。 - 给出界却不说数据结构。二叉堆、斐波那契堆和数组会给出三个不同的答案,面试官想知道你清楚这一点。
- 不询问输入的情况。有向吗?权重非负吗?目标可能不可达吗?有没有权重不同的平行边?每个答案都会改变代码,Skiena 的观点在这里成立:问题是在建模中赢下来的。
能避免大多数这些错误的习惯是:写代码之前,先说出标签的含义,以及为什么延长一条路线永远无法改善它。如果你说不出这句话,这个问题就不是 Dijkstra 问题,而你刚刚为自己省下了二十分钟。McDowell 对面试题目一般也提出了同样的观点。
12. 常见问题
为什么 Dijkstra 不能处理负权重?
+
因为它假定一个顶点一旦以队列中最小的标签出堆,任何仍在构建中的路线都无法以更低的代价到达它。负权边打破了这一点,因为延长路径可能降低其代价。在四顶点的例子中,弧为 0 到 1 权重 1、0 到 2 权重 2、2 到 1 权重负 2、1 到 3 权重 1,Dijkstra 返回 0、0、2、2,而正确答案是 0、0、2、1。请改用 Bellman-Ford。
什么是惰性删除,为什么需要它?
+
二叉堆没有高效的 decrease-key,所以你不去更新顶点的条目,而是压入一个带有更优标签的新条目,并在过期条目浮出时忽略它。守卫条件只有一行:如果出堆的距离大于该顶点当前的最优值,就跳过它。代价是堆中最多可能有 E 个条目而不是 V 个,这就是为什么上界是 O((V + E) log V)。
当路径的边数有限制时,可以用 Dijkstra 吗?
+
不能直接用,因为一个顶点不再只有一个最终标签:它的最佳代价随已用跳数不同而不同。要么扩展状态,让队列保存顶点与已用跳数组成的二元组,从而恢复不变式;要么使用 Bellman-Ford,基于上一轮的快照把每条边恰好松弛 K 加 1 次。后者通常是更简洁的答案。
可以用什么来替换加法?
+
任何单调的运算,也就是延长路线永远不会降低其代价的运算。用 max 代替加号可以解决瓶颈或最小体力消耗问题。把零到一之间的概率相乘并求最大值也可以,它等价于最小化负对数之和。减法恰恰是行不通的,这和禁止负权边是同一个原因。
如何统计最短路径的数量?
+
再维护一个数组,记录到达每个顶点的最短路线数。当一次松弛严格改进了标签时,把该计数替换为前驱的计数;当它与现有标签恰好持平时,则加上前驱的计数。这之所以正确,只是因为顶点的计数在出堆时已是最终值,而每次松弛都从已出堆的顶点进行。
面试中用 Dijkstra 还是 A*?
+
A* 是在优先级中加入启发式的 Dijkstra,即 Hart、Nilsson 和 Raphael 1968 年的表述;当启发式为零时,它就退化为 Dijkstra。只有在目标唯一、并且确实有可采纳启发式(例如地图或网格上的直线距离)时才使用它。没有启发式,就没有任何东西引导搜索;在抽象图上提出 A*,说明你是在套模式,而不是在思考。
应该说自己会用哪种堆?
+
带惰性删除的二叉堆,复杂度为 O((V + E) log V),因为每个标准库都提供它,而且常数很小。要提到斐波那契堆能把界改进到 O(E + V log V),但在实践中更慢;而在稠密图上,O(V 的平方) 的普通数组扫描会胜过两者。说出取舍,比说出最快的那个更重要。
13. 参考文献
提出这些技术的论文以及分析它们的教材,按时间顺序排列。
- Bellman, R. (1958). “On a routing problem.” Quarterly of Applied Mathematics, 16(1), 87–90.
- Dijkstra, E. W. (1959). “A note on two problems in connexion with graphs.” Numerische Mathematik, 1, 269–271.
- Williams, J. W. J. (1964). “Algorithm 232: Heapsort.” Communications of the ACM, 7(6), 347–348.
- Hart, P. E., Nilsson, N. J. and Raphael, B. (1968). “A formal basis for the heuristic determination of minimum cost paths.” IEEE Transactions on Systems Science and Cybernetics, 4(2), 100–107.
- Johnson, D. B. (1977). “Efficient algorithms for shortest paths in sparse networks.” Journal of the ACM, 24(1), 1–13.
- Fredman, M. L. and Tarjan, R. E. (1987). “Fibonacci heaps and their uses in improved network optimization algorithms.” Journal of the ACM, 34(3), 596–615.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. and Stein, C. (2009). Introduction to Algorithms,第 3 版,第 24.3 节。MIT Press。
- Sedgewick, R. and Wayne, K. (2011). Algorithms,第 4 版,第 4.4 节。Addison-Wesley。
- McDowell, G. L. (2015). Cracking the Coding Interview,第 6 版。CareerCup。
- Skiena, S. S. (2020). The Algorithm Design Manual,第 3 版,第 8 章。Springer。