
Table des Matières
- 1. Ce qu'une question sur Dijkstra évalue vraiment
- 2. Le modèle et la suppression paresseuse
- 3. Network delay time, et la reconstruction du chemin
- 4. Les vols les moins chers avec au plus K escales
- 5. Chemin d'effort minimal : remplacer le plus
- 6. Chemin de probabilité maximale
- 7. Compter les plus courts chemins
- 8. Le deuxième plus court chemin
- 9. Pourquoi les poids positifs ou nuls ne se négocient pas
- 10. Les réponses sur la complexité
- 11. Les erreurs qui font échouer l'entretien
- 12. Questions fréquentes
- 13. Références
1. Ce qu'une question sur Dijkstra évalue vraiment
Personne ne vous demande de réciter l'algorithme de Dijkstra. Ce qu'on vous donne, c'est un problème dont les poids ne sont pas des distances, et l'entretien demande si vous voyez que la forme de l'algorithme convient encore.
Cette forme, c'est : une file de priorité ordonnée par une étiquette de coût, une règle de relâchement qui améliore l'étiquette d'un voisin, et la garantie qu'une fois un sommet sorti, son étiquette est définitive. Changez ce que « coût » signifie, changez la comparaison, et les mêmes douze lignes résolvent l'effort minimal, la probabilité maximale, les vols les moins chers et une demi-douzaine d'autres questions. L'entretien vérifie si vous savez quelles parties vous avez le droit de changer, et laquelle non. La note originale de Dijkstra de 1959 fait deux pages, et l'idée n'a pas eu besoin d'être révisée depuis.
Les huit problèmes ci-dessous sont ceux qui reviennent, chacun avec la solution, la relance et l'erreur qui coûte l'offre. Chaque exemple détaillé a été exécuté par script.
2. Le modèle et la suppression paresseuse
Écrivez ceci sans réfléchir. Les commentaires signalent les deux lignes qui séparent une implémentation correcte d'une implémentation seulement plausible.
import heapq

def dijkstra(adj, src, n):          # adj[u] = [(v, w), ...] avec w >= 0
    dist = [float('inf')] * n
    dist[src] = 0
    heap = [(0, src)]
    while heap:
        d, u = heapq.heappop(heap)
        if d > dist[u]:             # entrée PÉRIMÉE : une meilleure étiquette a été
            continue                # trouvée après son insertion. On l'ignore.
        for v, w in adj[u]:
            if d + w < dist[v]:
                dist[v] = d + w
                heapq.heappush(heap, (dist[v], v))   # insérer, jamais de decrease-key
    return dist
La ligne if d > dist[u]: continue est toute la réponse à « comment gérez-vous le decrease-key ? ». Un tas binaire n'a pas de decrease-key efficace : au lieu de mettre à jour une entrée, vous en insérez une seconde et vous ignorez la sortie obsolète. C'est la suppression paresseuse, et savoir la nommer vaut plus que le code qui l'entoure. Le tas peut donc contenir jusqu'à O(E) entrées au lieu de O(V), et c'est pourquoi la borne est O((V + E) log V) et non O((V + E) log E) : les logarithmes ne diffèrent que d'un facteur constant, puisque E < V2.
Deux autres points à dire à voix haute. Un sommet est fixé dès qu'il sort avec une étiquette à jour, et sa distance ne change plus jamais ensuite ; c'est l'invariant sur lequel repose le choix glouton. Et vous n'avez pas besoin d'un ensemble visited séparé, car le test d'obsolescence rejette déjà toute seconde sortie.
3. Network delay time, et la reconstruction du chemin
La question. Étant donné un graphe orienté pondéré et une source, combien de temps faut-il pour que chaque sommet soit atteint ? Renvoyez -1 si un sommet n'est jamais atteint. En entretien, il est question de propagation de signal, de livraison de colis ou de « quand le dernier serveur est-il prévenu ? ».
C'est Dijkstra tout simple, plus une ligne : la réponse est max(dist), et -1 si une entrée est encore infinie.
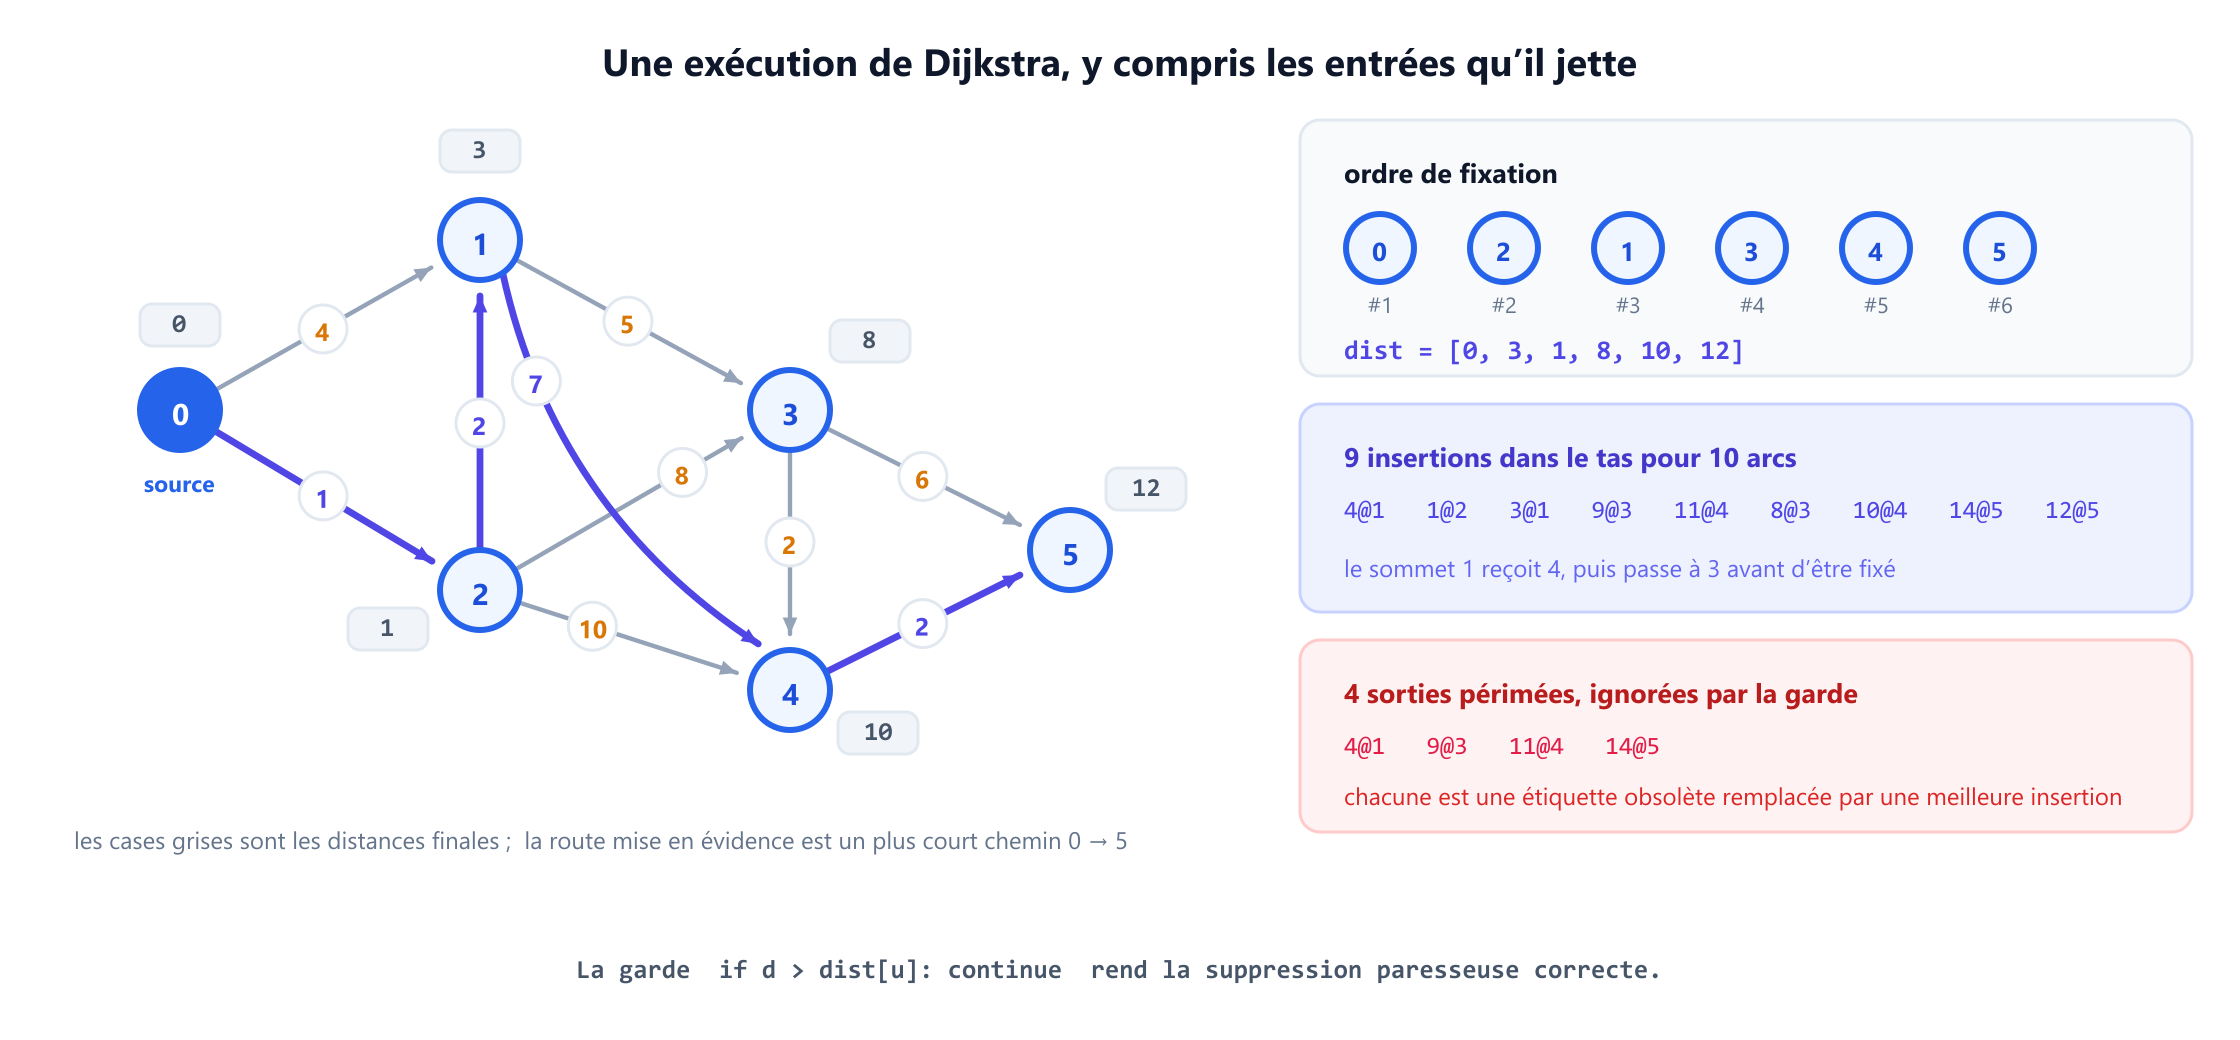
Sur le graphe d'exemple, Dijkstra depuis 0 fixe les sommets dans l'ordre 0, 2, 1, 3, 4, 5 et renvoie les distances 0, 3, 1, 8, 10, 12. Regardez le sommet 1 : l'arc 0 → 1 lui donne l'étiquette 4, puis 0 → 2 → 1 l'améliore à 3 avant qu'il ne sorte jamais de la file. C'est l'algorithme qui fonctionne exactement comme prévu, et c'est pourquoi il ne faut jamais s'engager sur une étiquette au moment de l'insertion.
La relance : renvoyez le chemin, pas seulement la longueur. Tenez un tableau parent, affectez parent[v] = u dans la même branche qui améliore dist[v], puis parcourez-le à rebours depuis la cible et inversez. Sur ce graphe, cela donne 0 → 2 → 1 → 4 → 5, de coût 12. Dites « un plus court chemin » plutôt que « le » : il y en a deux de coût 12 ici, comme le montre la section 7.
Le piège. Affecter parent[v] hors de la branche d'amélioration, si bien qu'il enregistre le dernier sommet qui a essayé plutôt que celui qui a réussi. Les distances restent justes et le chemin reconstruit est faux, ce qui est le pire genre de bogue à trouver en revue.
4. Les vols les moins chers avec au plus K escales
La question. La route la moins chère de la source à la cible en utilisant au plus K escales intermédiaires.
C'est la question qui piège les candidats, car le Dijkstra simple est faux ici. Sa correction repose sur le fait qu'un sommet a une seule étiquette définitive, mais avec une limite d'escales, un sommet a un meilleur coût différent pour chaque nombre d'escales utilisées, et une route bon marché qui consomme trop de sauts peut être pire qu'une route chère et courte. Fixer un sommet une seule fois jette précisément l'alternative dont vous avez besoin.
Deux réponses correctes, et connaître les deux, c'est tout l'enjeu.
Élargir l'état. Gardez Dijkstra, mais faites du sommet une paire (node, stops_used). L'étiquette est désormais définitive par paire, donc l'invariant tient à nouveau.
def cheapest(adj, src, dst, K, n):
    best = [[float('inf')] * (K + 2) for _ in range(n)]
    best[src][0] = 0
    heap = [(0, src, 0)]                     # (coût, nœud, escales)
    while heap:
        c, u, k = heapq.heappop(heap)
        if u == dst: return c                # la première sortie de dst est optimale
        if k > K or c > best[u][k]: continue
        for v, w in adj[u]:
            if c + w < best[v][k + 1]:
                best[v][k + 1] = c + w
                heapq.heappush(heap, (c + w, v, k + 1))
    return -1
Ou utilisez Bellman-Ford, qui est la réponse la plus propre. Relâcher chaque arête exactement K + 1 fois, chaque tour à partir d'une copie du tour précédent, donne directement la route la moins chère utilisant au plus K + 1 arêtes. C'est la formulation de Bellman de 1958, en O(K × E) sans aucun tas. La proposer spontanément fait très bonne impression.
Le piège. La version Bellman-Ford doit relâcher à partir d'une copie des distances du tour précédent. Relâcher sur place laisse un seul tour se propager le long de plusieurs arêtes, ce qui autorise silencieusement plus de K escales et renvoie une réponse trop bon marché qui semble plausible.
5. Chemin d'effort minimal : remplacer le plus
La question. Minimisez la plus grande arête de la route plutôt que le total. Formulations : chemin d'effort minimal, nager dans l'eau qui monte, le poids maximal que vous devez pouvoir porter.
L'idée clé est que Dijkstra n'a jamais vraiment eu besoin de l'addition. Il exige que prolonger un chemin ne puisse pas améliorer son coût, pour qu'une étiquette fixée reste définitive. max satisfait cela tout aussi bien que +, donc changez une ligne :
        cand = max(d, w)          # au lieu de d + w
        if cand < best[v]:
            best[v] = cand
            heapq.heappush(heap, (cand, v))
Sur le graphe d'exemple, les valeurs minimax depuis le sommet 0 sont 0, 2, 1, 5, 5, 5, donc le meilleur goulot d'étranglement jusqu'au sommet 5 vaut 5 : essayer toutes les routes le confirme. Qu'il s'agisse d'un objectif réellement différent se voit sur les deux routes les moins chères, qui coûtent toutes deux 12 mais ont un plus grand arc de 5 et 7. Minimiser le total et minimiser le plus grand arc ne sont pas la même question, et en général la route optimale pour le goulot n'a aucune raison d'être un plus court chemin.
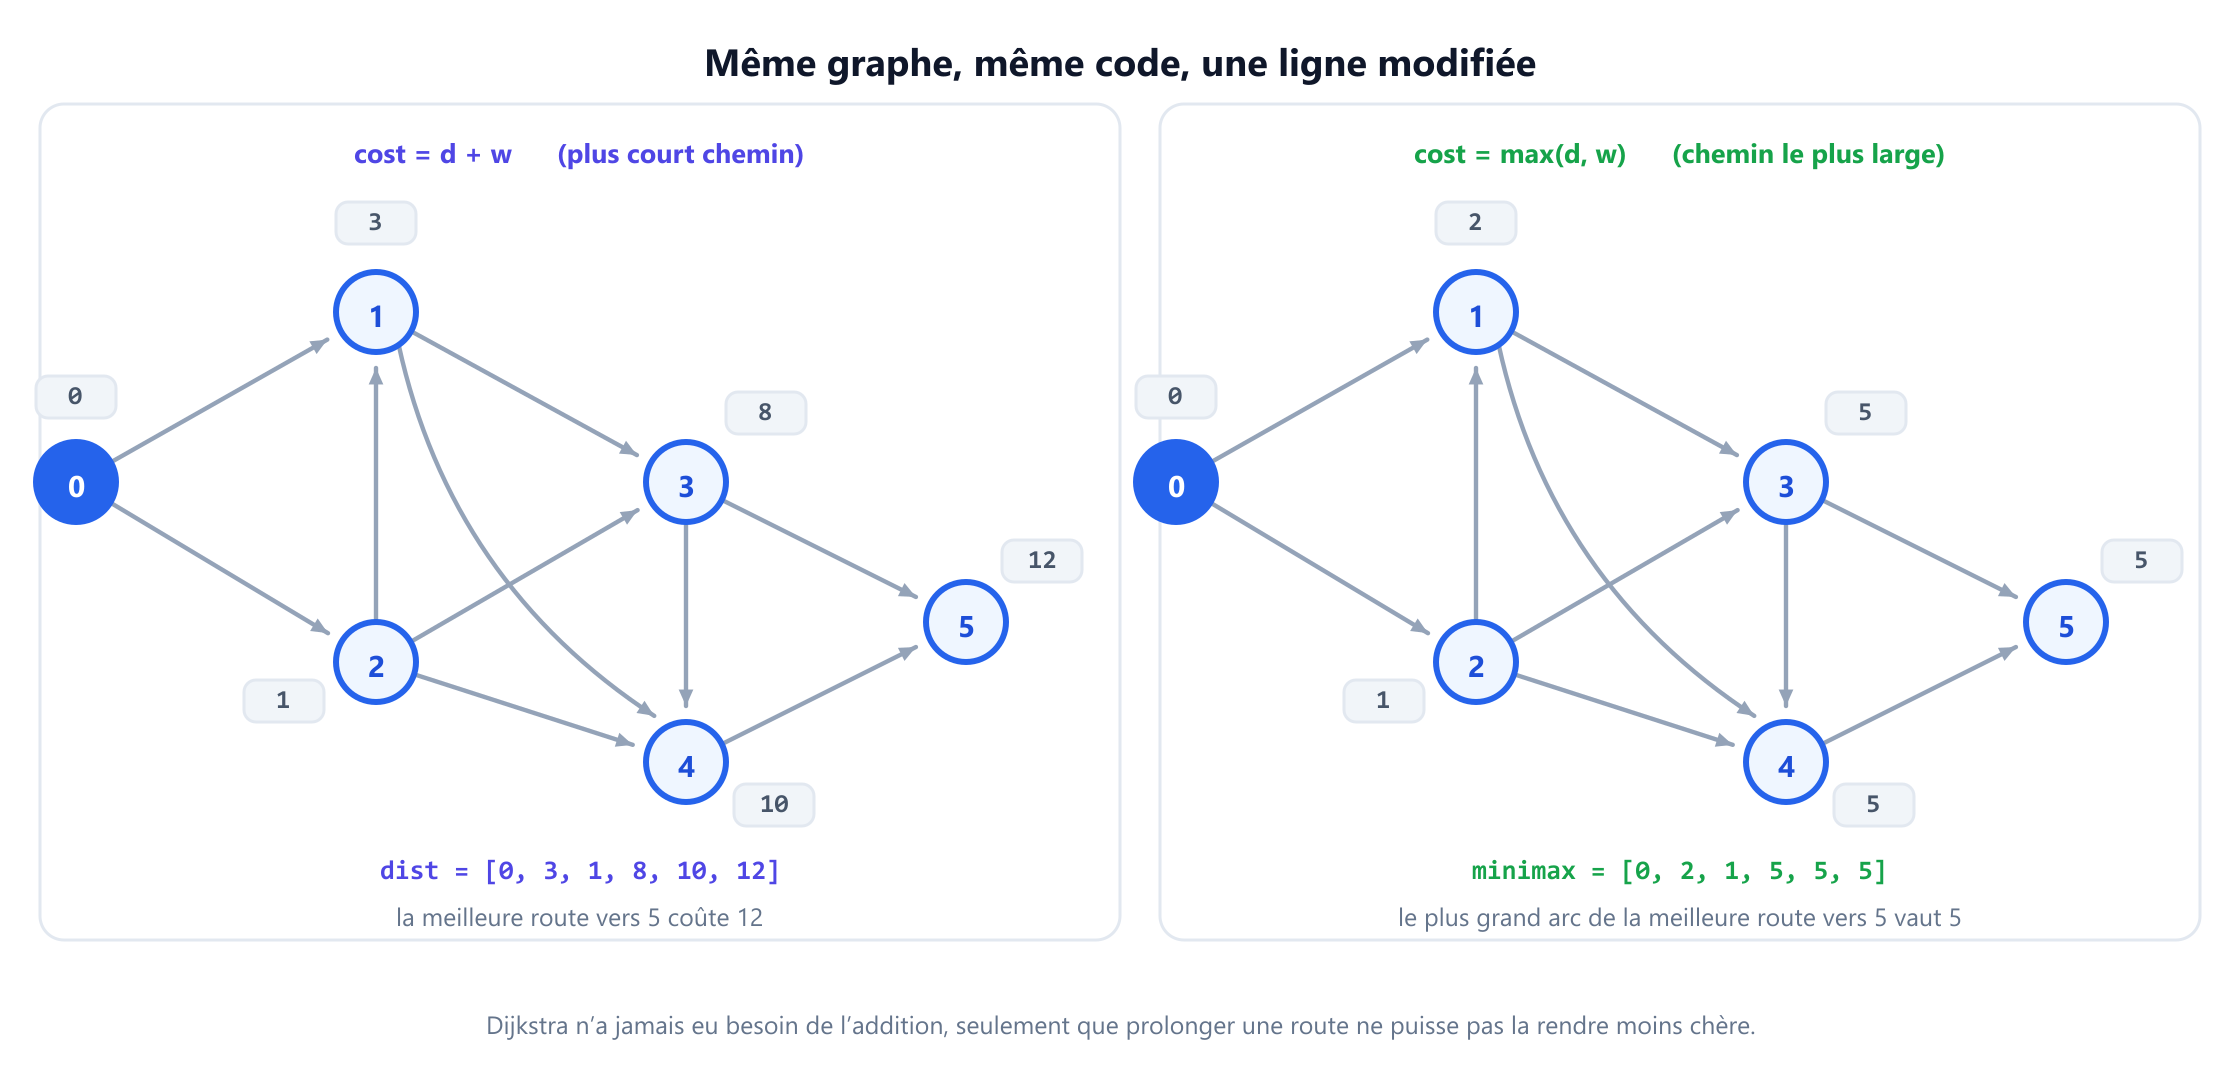
+ par max transforme le plus court chemin en chemin le plus large.La relance : qu'est-ce qui peut encore remplacer le plus ? Toute opération monotone, c'est-à-dire où prolonger un chemin ne fait jamais baisser son coût. max convient, la multiplication de probabilités dans [0,1] convient si vous maximisez, et l'addition ordinaire de poids positifs ou nuls convient. La soustraction non, pour la même raison que les arêtes négatives sont interdites.
Le piège. Dans une version sur grille, une solution par union-find ou par recherche binaire plus BFS est aussi acceptée et parfois plus rapide. Si vous proposez Dijkstra, soyez prêt à dire pourquoi : aucun paramètre sur lequel faire une recherche binaire, et une seule passe.
6. Chemin de probabilité maximale
La question. Chaque arête a une probabilité de succès ; trouvez la route de la source à la cible qui maximise la probabilité que toutes les arêtes réussissent.
Les coûts se multiplient au lieu de s'additionner, et vous voulez le plus grand produit : inversez donc la file en tas max et relâchez avec ×. Les probabilités sont dans [0,1], donc prolonger un chemin ne peut que réduire le produit, ce qui est exactement la monotonie dont Dijkstra a besoin.
        cand = p * pw                     # au lieu de d + w
        if cand > best[v]:                # > car on maximise
            best[v] = cand
            heapq.heappush(heap, (-cand, v))   # négation : heapq est un tas MIN
Sur un graphe avec un arc direct de 0,30 de 0 à 3, plus la route à deux arcs 0 → 1 → 3 à 0,9 et 0,8, la meilleure probabilité est 0.72 par la route à deux arcs, qui bat l'arc unique. Voilà la phrase à dire : ici, plus d'arêtes peut être mieux, ce qui n'est jamais vrai pour les plus courts chemins ordinaires à poids positifs.
La relance : pourquoi ne pas prendre les logarithmes ? C'est possible, et c'est une bonne réponse. Comme log(ab) = log a + log b, maximiser un produit de probabilités revient à minimiser une somme de -log p, qui sont positifs ou nuls, donc Dijkstra s'applique sans modification. Mentionnez la réserve : le log en virgule flottante d'une probabilité proche de zéro perd de la précision, et une arête de probabilité 0 donne un infini qu'il faut traiter à part.
7. Compter les plus courts chemins
La question. Combien existe-t-il de plus courtes routes distinctes de la source à la cible ? Généralement demandé modulo 109+7.
Un tableau en plus, et une branche en plus. À côté de dist, tenez ways, le nombre de plus courtes routes jusqu'à chaque sommet. Quand un relâchement améliore une étiquette, le compte est remplacé. Quand il y a égalité, le compte est additionné.
        if d + w < dist[v]:
            dist[v] = d + w
            ways[v] = ways[u]              # strictement meilleur : remplacer
            heapq.heappush(heap, (dist[v], v))
        elif d + w == dist[v]:
            ways[v] = (ways[v] + ways[u]) % MOD   # égalité : ADDITIONNER
Sur le graphe d'exemple, les comptes sont 1, 1, 1, 1, 2, 2. La force brute confirme : sur les 9 routes de 0 à 5, deux coûtent 12, à savoir 0→2→1→3→4→5 et 0→2→1→4→5. Notez que la route la plus courte en nombre d'arêtes n'est pas seule à être la meilleure, le genre de détail qui mérite d'être souligné.
La relance : la branche d'égalité est-elle sûre ? Oui, mais seulement parce que ways[u] est définitif quand u sort de la file, et que chaque relâchement part d'un sommet sorti. Additionner des comptes depuis un sommet non fixé compterait en double. C'est l'exemple le plus clair de la raison pour laquelle « fixé signifie définitif » est l'invariant qui compte, et non le code.
Le piège. Oublier que le elif doit porter sur l'égalité, et non se trouver dans la branche d'amélioration. Écrit comme un seul if d + w <= dist[v], les comptes sont remplacés en cas d'égalité au lieu d'être additionnés, et la réponse vaut 1 pour tous les sommets.
8. Le deuxième plus court chemin
La question. Trouvez la deuxième plus courte route de la source à la cible. Précisez immédiatement si « deuxième » signifie strictement plus long que le meilleur, ou simplement la route suivante dans une liste où les égalités comptent séparément. Les deux réponses diffèrent, et les recruteurs posent la question exprès.
La technique consiste à assouplir la règle du « fixé une seule fois » : gardez les deux meilleures étiquettes par sommet et laissez un sommet sortir deux fois.
best1 = [inf] * n; best2 = [inf] * n
best1[src] = 0
heap = [(0, src)]
while heap:
    d, u = heapq.heappop(heap)
    if d > best2[u]: continue          # pire que les deux étiquettes conservées
    for v, w in adj[u]:
        nd = d + w
        if nd < best1[v]:
            best1[v], nd = nd, best1[v]     # rétrograder l'ancien meilleur en candidat
            heapq.heappush(heap, (best1[v], v))   # le NOUVEAU meilleur doit aussi se propager
        if best1[v] < nd < best2[v]:        # strictement pire que le meilleur
            best2[v] = nd
            heapq.heappush(heap, (nd, v))
Sur le graphe d'exemple, les coûts de route distincts de 0 à 5 sont 12, 13, 14, 15, donc le deuxième meilleur au sens strict est 13. Si les égalités comptent séparément, la réponse est de nouveau 12, car deux routes différentes l'atteignent. Demandez avant de coder.
La relance : généralisez à K. Gardez une liste des K meilleures étiquettes par sommet, ou utilisez l'algorithme de Yen pour les K plus courts chemins élémentaires, qui est un problème réellement différent et bien plus lourd. Dire « élémentaire change tout » est le bon réflexe : sans cette contrainte, une plus courte marche peut répéter indéfiniment un cycle de poids nul.
9. Pourquoi les poids positifs ou nuls ne se négocient pas
Tous les recruteurs posent cette question, et la plupart des candidats répondent « parce que Dijkstra est glouton », ce qui est vrai et n'explique rien. La raison précise : l'algorithme suppose que, lorsqu'un sommet sort avec la plus petite étiquette de la file, aucune route encore en construction ne peut l'atteindre à moindre coût. Une arête négative casse cela, car prolonger un chemin peut réduire son coût.
Ayez un contre-exemple concret prêt. Prenez quatre sommets avec les arcs 0→1 (1), 0→2 (2), 2→1 (−2) et 1→3 (1).
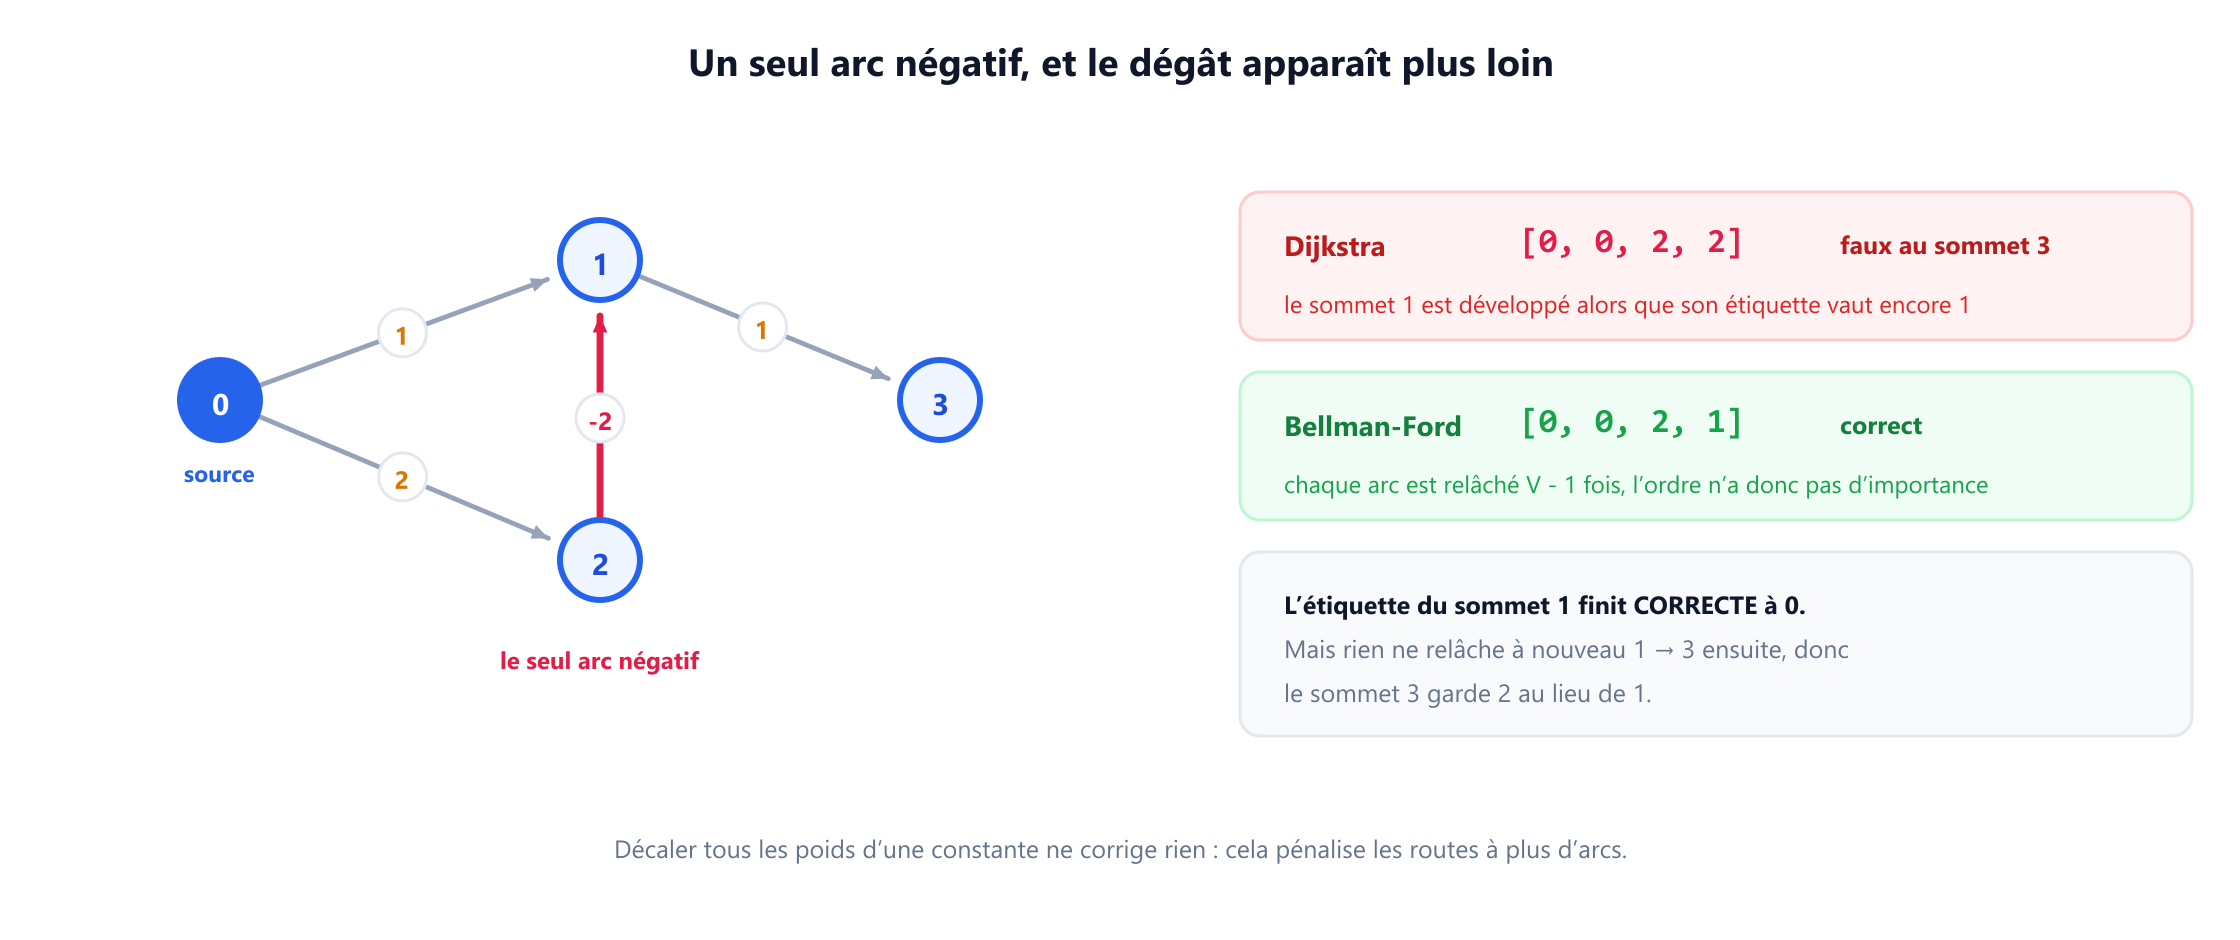
Dijkstra renvoie 0, 0, 2, 2 ; la bonne réponse est 0, 0, 2, 1. La subtilité mérite d'être énoncée précisément, car elle est plus intéressante que la réponse habituelle : l'étiquette du sommet 1 finit juste. Il est développé alors que son étiquette vaut encore 1, et l'amélioration ultérieure à 0 est bien écrite. Mais rien ne relâche à nouveau 1 → 3 ensuite, donc le sommet 3 garde 2 au lieu de 1. Un candidat qui dit « la mauvaise valeur apparaît en aval de l'arête négative, pas sur elle » montre clairement qu'il a essayé.
La relance : qu'utilisez-vous à la place ? Bellman-Ford, qui relâche chaque arête V - 1 fois en O(VE) et détecte les cycles négatifs à la V-ième passe. Si vous avez besoin de toutes les paires avec des arêtes négatives mais sans cycle négatif, l'algorithme de Johnson repondère avec une exécution de Bellman-Ford pour rendre tous les poids positifs ou nuls, puis lance Dijkstra depuis chaque sommet. Cormen, Leiserson, Rivest et Stein donnent la preuve complète de la correction du choix glouton.
Le piège. « Il suffit d'ajouter une constante à chaque poids pour les rendre positifs. » Cela ne marche pas, et savoir dire pourquoi en une phrase est un signal fort : ajouter c à chaque arête ajoute c × (number of edges) à une route, ce qui pénalise les routes à plus d'arêtes et change donc la route la plus courte.
10. Les réponses sur la complexité
Ayez la borne et la justification prêtes, et nommez la structure de données. Dire « Dijkstra est en O(E log V) » sans nommer le tas appelle une relance que vous raterez ensuite.
| File de priorité | Temps | La justification à donner |
|---|---|---|
| Tas binaire, suppression paresseuse | O((V + E) log V) | Jusqu'à E entrées insérées, chaque sortie et insertion est logarithmique |
| Tas de Fibonacci | O(E + V log V) | decrease-key est en O(1) amorti, donc les arêtes ne coûtent aucun logarithme |
| Tableau non trié | O(V2 + E) | Chercher le minimum à chaque tour ; idéal sur les graphes denses |
| Espace, toute variante | O(V + E) | Le graphe, plus un tas qui ne dépasse jamais E entrées |
La borne à base de tas est le résultat de Johnson de 1977 ; l'amélioration par tas de Fibonacci est due à Fredman et Tarjan, 1987. Le tas binaire lui-même est la construction de Williams de 1964. La variante de Fibonacci est meilleure en théorie et presque toujours plus lente en pratique, car ses constantes sont grandes, et le dire montre du jugement plutôt que de la récitation. Sedgewick et Wayne donnent l'exposé clair le plus court de l'alternative par file de priorité indexée, qui prend en charge le decrease-key.
Deux chiffres à connaître. Sur un graphe creux avec V = 105 et E = 5 × 10⁵, la borne du tas binaire donne environ 10 millions d'opérations contre environ 2,2 millions pour le tas de Fibonacci : un vrai écart sur le papier que les constantes effacent en pratique. Et sur un graphe dense où E approche V2, le tableau simple en O(V2) bat le O(V2 log V) du tas binaire, le seul cas où l'implémentation « naïve » est le bon choix.
11. Les erreurs qui font échouer l'entretien
Classées par fréquence ; les trois premières expliquent la plupart des solutions rejetées.
- Omettre le test des entrées périmées. Sans
if d > dist[u]: continue, vous redéveloppez des sommets à partir d'étiquettes obsolètes. La réponse reste généralement juste, et le temps d'exécution se dégrade fortement, ce qui explique que l'erreur survive aux tests. - Utiliser Dijkstra quand l'état n'est pas seulement le sommet. Une limite d'escales, un budget de carburant ou une clause « au plus K réductions » signifie que l'étiquette est définie par paire
(vertex, resource). Fixer le sommet seul jette la route dont vous aviez besoin. - Recourir à Dijkstra avec des poids négatifs. Utilisez Bellman-Ford, et n'essayez jamais de décaler les poids pour les rendre positifs.
- Oublier que
heapqest un tas min. Maximiser quoi que ce soit implique d'insérer la clé négée, et oublier la seconde négation à la sortie est le bogue silencieux classique. - Comparer des tuples dont le second élément n'est pas ordonnable.
heappush(heap, (dist, node_object))lève une exception dès que deux distances sont égales et que Python passe à la comparaison des objets. Insérez un indice, ou ajoutez un compteur pour départager. - Affecter le pointeur parent hors de la branche d'amélioration. Les distances restent correctes et le chemin reconstruit est faux.
- Remplacer les comptes en cas d'égalité au lieu de les additionner. Un
<=là où il fallait<et==, et chaque comptage de plus courts chemins devient 1. - Citer une borne sans la structure de données. Tas binaire, tas de Fibonacci et tableau donnent trois réponses différentes, et le recruteur veut savoir que vous le savez.
- Ne pas poser de questions sur l'entrée. Orienté ? Poids positifs ou nuls ? La cible peut-elle être inaccessible ? Y a-t-il des arêtes parallèles de poids différents ? Chaque réponse change le code, et la remarque de Skiena tient : les problèmes se gagnent dans la modélisation.
L'habitude qui évite la plupart de ces erreurs : avant d'écrire, dites ce que signifie l'étiquette et pourquoi prolonger une route ne peut jamais l'améliorer. Si vous ne pouvez pas formuler cette phrase, le problème n'est pas un problème de Dijkstra, et vous venez d'économiser vingt minutes. McDowell défend la même idée pour les problèmes d'entretien en général.
12. Questions fréquentes
Pourquoi Dijkstra ne gère-t-il pas les poids négatifs ?
+
Parce qu'il suppose qu'une fois qu'un sommet est sorti avec la plus petite étiquette de la file, aucune route encore en construction ne peut l'atteindre à moindre coût. Une arête négative casse cela, puisque prolonger un chemin peut réduire son coût. Sur l'exemple à quatre sommets avec les arcs de 0 à 1 de poids 1, de 0 à 2 de poids 2, de 2 à 1 de poids moins 2 et de 1 à 3 de poids 1, Dijkstra renvoie 0, 0, 2, 2 alors que la vérité est 0, 0, 2, 1. Utilisez Bellman-Ford à la place.
Qu'est-ce que la suppression paresseuse et pourquoi en ai-je besoin ?
+
Un tas binaire n'a pas de decrease-key efficace : au lieu de mettre à jour l'entrée d'un sommet, vous en insérez une seconde avec la meilleure étiquette et vous ignorez l'entrée obsolète quand elle ressort. La garde tient en une ligne : si la distance sortie dépasse la meilleure actuelle pour ce sommet, ignorez-la. Le prix est que le tas peut contenir jusqu'à E entrées au lieu de V, d'où la borne O((V + E) log V).
Puis-je utiliser Dijkstra quand le chemin a une limite sur le nombre d'arêtes ?
+
Pas tel quel, car un sommet n'a plus une seule étiquette définitive : son meilleur coût diffère selon le nombre de sauts utilisés. Soit vous élargissez l'état pour que la file contienne des paires sommet et sauts utilisés, ce qui rétablit l'invariant, soit vous utilisez Bellman-Ford en relâchant chaque arête exactement K plus une fois à partir d'une copie du tour précédent. La seconde est généralement la réponse la plus propre.
Par quoi puis-je remplacer l'addition ?
+
Par toute opération monotone, c'est-à-dire où prolonger une route ne fait jamais baisser son coût. Utiliser le max au lieu du plus résout les problèmes de goulot d'étranglement ou d'effort minimal. Multiplier des probabilités entre zéro et un et maximiser fonctionne aussi, et revient à minimiser la somme des logarithmes négatifs. La soustraction est précisément ce qui échoue, pour la même raison que les arêtes négatives sont interdites.
Comment compter le nombre de plus courts chemins ?
+
Tenez un second tableau avec le nombre de plus courtes routes jusqu'à chaque sommet. Quand un relâchement améliore strictement une étiquette, remplacez ce compte par celui du prédécesseur. Quand il égale exactement l'étiquette existante, ajoutez plutôt le compte du prédécesseur. Ce n'est correct que parce que le compte d'un sommet est définitif quand il sort de la file, et que chaque relâchement part d'un sommet sorti.
Dijkstra ou A* en entretien ?
+
A* est Dijkstra avec une heuristique ajoutée à la priorité, la formulation de 1968 de Hart, Nilsson et Raphael, et il se réduit à Dijkstra quand cette heuristique est nulle. N'y recourez que s'il y a une seule cible et une véritable heuristique admissible, comme la distance à vol d'oiseau sur une carte ou une grille. Sans elle, rien ne guide la recherche, et proposer A* sur un graphe abstrait montre que vous appliquez un schéma au lieu de réfléchir.
Quel tas dois-je dire que j'utiliserais ?
+
Un tas binaire avec suppression paresseuse, qui donne O((V + E) log V), car c'est ce que fournit toute bibliothèque standard et ses constantes sont petites. Mentionnez qu'un tas de Fibonacci améliore la borne à O(E + V log V) mais est plus lent en pratique, et que sur un graphe dense un simple parcours de tableau en O(V au carré) bat les deux. Nommer le compromis compte plus que nommer le plus rapide.
13. Références
Les articles qui ont introduit ces techniques et les ouvrages qui les analysent, par ordre chronologique.
- Bellman, R. (1958). “On a routing problem.” Quarterly of Applied Mathematics, 16(1), 87–90.
- Dijkstra, E. W. (1959). “A note on two problems in connexion with graphs.” Numerische Mathematik, 1, 269–271.
- Williams, J. W. J. (1964). “Algorithm 232: Heapsort.” Communications of the ACM, 7(6), 347–348.
- Hart, P. E., Nilsson, N. J. et Raphael, B. (1968). “A formal basis for the heuristic determination of minimum cost paths.” IEEE Transactions on Systems Science and Cybernetics, 4(2), 100–107.
- Johnson, D. B. (1977). “Efficient algorithms for shortest paths in sparse networks.” Journal of the ACM, 24(1), 1–13.
- Fredman, M. L. et Tarjan, R. E. (1987). “Fibonacci heaps and their uses in improved network optimization algorithms.” Journal of the ACM, 34(3), 596–615.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. et Stein, C. (2009). Introduction to Algorithms, 3e édition, section 24.3. MIT Press.
- Sedgewick, R. et Wayne, K. (2011). Algorithms, 4e édition, section 4.4. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6e édition. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3e édition, chapitre 8. Springer.