
Tabla de Contenidos
- 1. Qué evalúa realmente una pregunta de Dijkstra
- 2. La plantilla y el borrado perezoso
- 3. Network delay time y la reconstrucción del camino
- 4. Vuelos más baratos con K escalas como máximo
- 5. Camino de mínimo esfuerzo: sustituir la suma
- 6. Camino de máxima probabilidad
- 7. Contar caminos más cortos
- 8. El segundo camino más corto
- 9. Por qué los pesos no negativos no son negociables
- 10. Las respuestas de complejidad
- 11. Errores que suspenden la entrevista
- 12. Preguntas frecuentes
- 13. Referencias
1. Qué evalúa realmente una pregunta de Dijkstra
A nadie le piden recitar el algoritmo de Dijkstra. Lo que te dan es un problema cuyos pesos no son distancias, y la entrevista pregunta si ves que la forma del algoritmo sigue encajando.
Esa forma es: una cola de prioridad ordenada por una etiqueta de coste, una regla de relajación que mejora la etiqueta de un vecino y la garantía de que, una vez extraído un vértice, su etiqueta es definitiva. Cambia lo que significa «coste», cambia la comparación, y las mismas doce líneas resuelven mínimo esfuerzo, máxima probabilidad, vuelos más baratos y media docena de preguntas más. La entrevista evalúa si sabes qué partes puedes cambiar y cuál no. La nota original de Dijkstra de 1959 ocupa dos páginas, y la idea no ha necesitado revisión desde entonces.
Los ocho problemas de abajo son los que se repiten, cada uno con la solución, el seguimiento y el error que te cuesta la oferta. Cada ejemplo resuelto se ejecutó con un script.
2. La plantilla y el borrado perezoso
Escribe esto sin pensar. Los comentarios marcan las dos líneas que separan una implementación correcta de una que solo lo parece.
import heapq

def dijkstra(adj, src, n):          # adj[u] = [(v, w), ...] con w >= 0
    dist = [float('inf')] * n
    dist[src] = 0
    heap = [(0, src)]
    while heap:
        d, u = heapq.heappop(heap)
        if d > dist[u]:             # entrada OBSOLETA: se encontró una etiqueta mejor
            continue                # después de insertar esta. Saltarla.
        for v, w in adj[u]:
            if d + w < dist[v]:
                dist[v] = d + w
                heapq.heappush(heap, (dist[v], v))   # insertar, nunca decrease-key
    return dist
La línea if d > dist[u]: continue es toda la respuesta a «¿cómo manejas decrease-key?». Un montículo binario no tiene un decrease-key eficiente, así que en lugar de actualizar una entrada insertas otra e ignoras la extracción obsoleta. Esto es el borrado perezoso, y saber nombrarlo vale más que el código que lo rodea. Por eso el montículo puede contener hasta O(E) entradas en lugar de O(V), y por eso la cota es O((V + E) log V) y no O((V + E) log E): los logaritmos difieren en un factor constante, ya que E < V2.
Dos cosas más que decir en voz alta. Un vértice queda fijado en el momento en que se extrae con una etiqueta vigente, y su distancia no cambia nunca después; ese es el invariante en el que se apoya la elección voraz. Y no necesitas un conjunto visited aparte, porque la comprobación de obsolescencia ya rechaza cualquier segunda extracción.
3. Network delay time y la reconstrucción del camino
La pregunta. Dado un grafo dirigido ponderado y un origen, ¿cuánto tarda en alcanzarse cada vértice? Devuelve -1 si algún vértice no se alcanza nunca. En las entrevistas aparece como propagación de señales, reparto de paquetes o «cuándo se entera el último servidor».
Es Dijkstra sin más, con una línea extra: la respuesta es max(dist), y -1 si alguna entrada sigue siendo infinita.
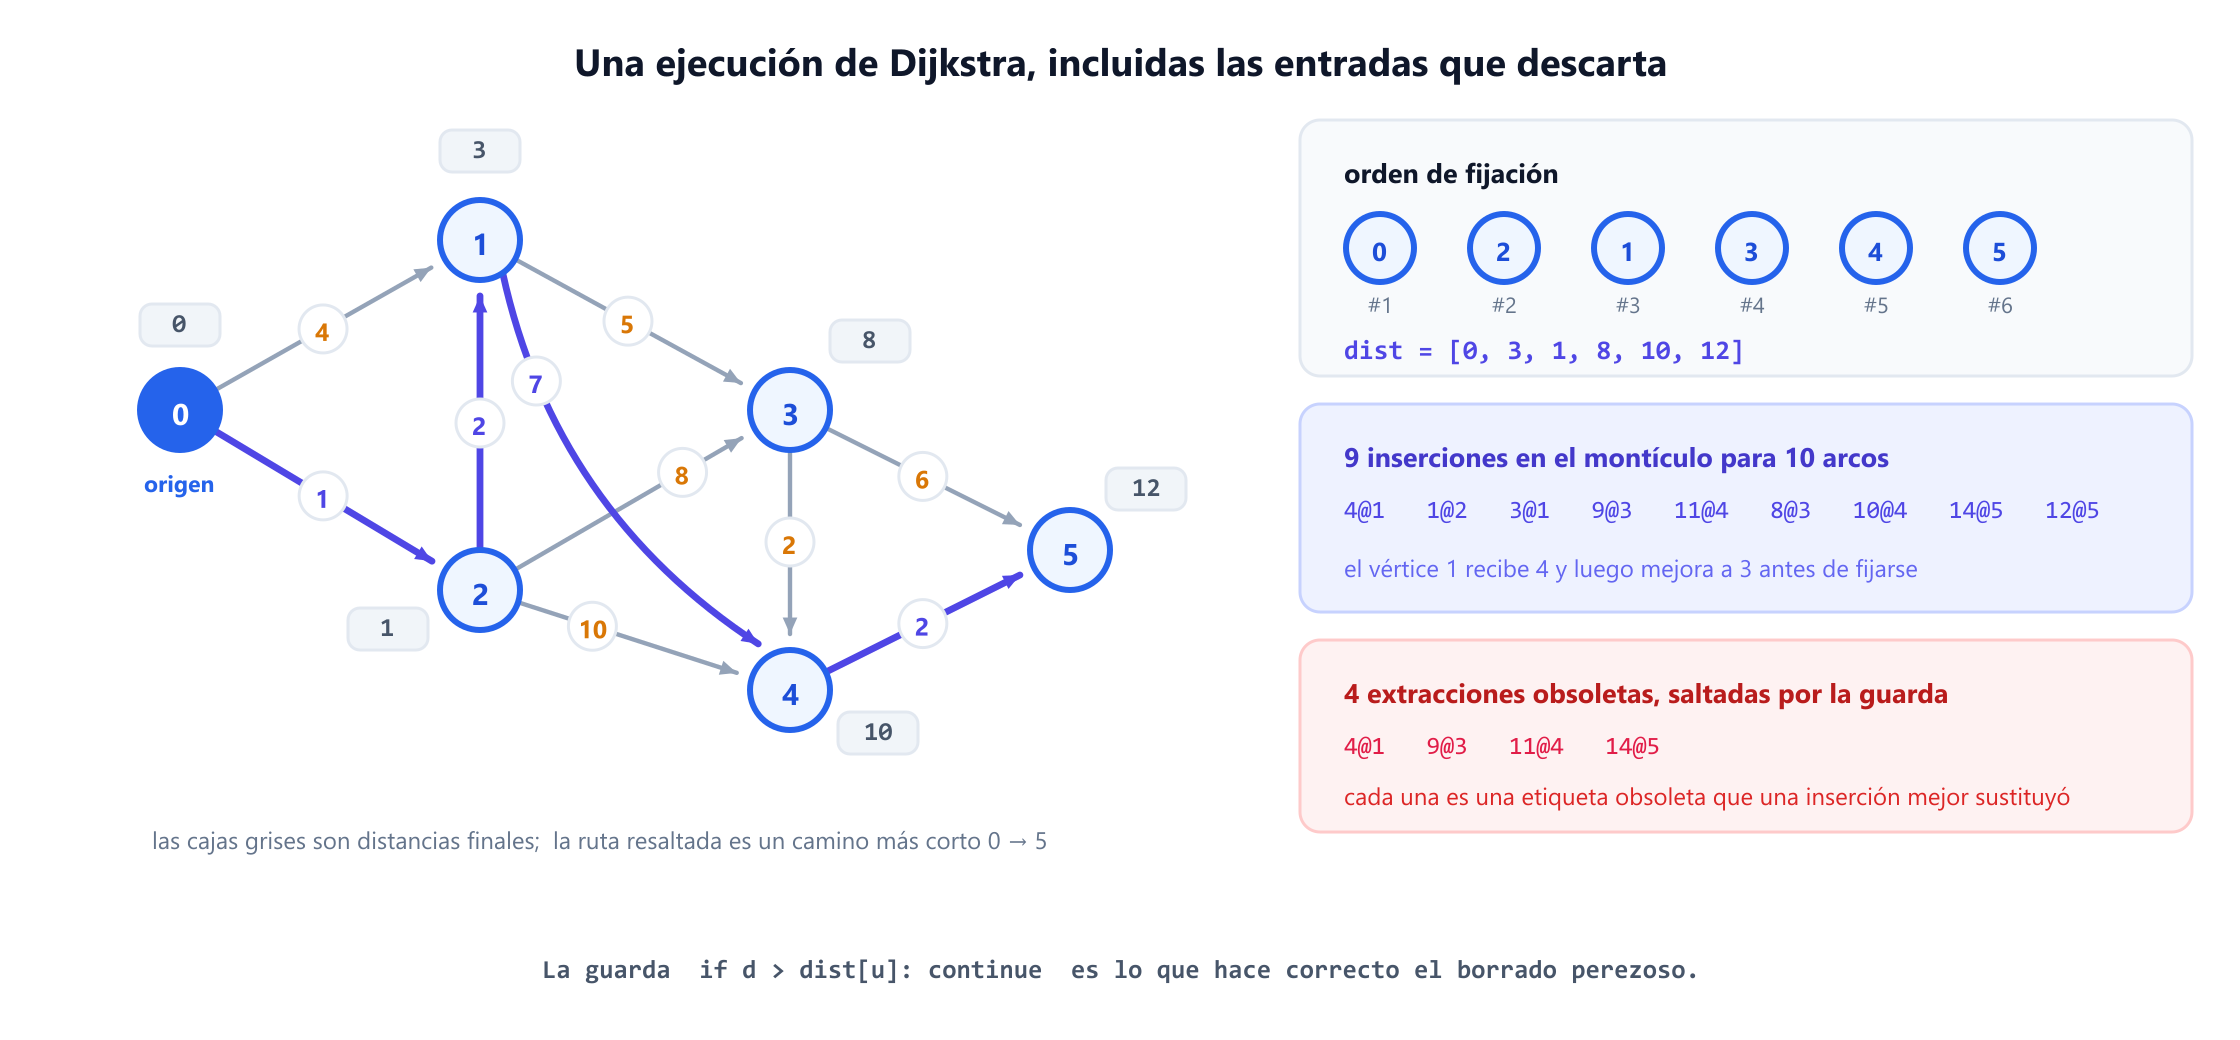
En el grafo de ejemplo, Dijkstra desde 0 fija los vértices en el orden 0, 2, 1, 3, 4, 5 y devuelve las distancias 0, 3, 1, 8, 10, 12. Fíjate en el vértice 1: el arco 0 → 1 le da la etiqueta 4, luego 0 → 2 → 1 la mejora a 3 antes de que llegue a extraerse. Eso es el algoritmo funcionando exactamente como debe, y es la razón por la que no debes comprometerte con una etiqueta al insertar.
El seguimiento: devuelve el camino, no solo la longitud. Mantén un array parent, asigna parent[v] = u en la misma rama que mejora dist[v] y luego recórrelo hacia atrás desde el destino e inviértelo. En este grafo da 0 → 2 → 1 → 4 → 5, coste 12. Di «un camino más corto» en lugar de «el»: aquí hay dos de coste 12, como muestra la sección 7.
La trampa. Asignar parent[v] fuera de la rama de mejora, de modo que registra el último vértice que lo intentó en lugar del que tuvo éxito. Las distancias siguen bien y el camino reconstruido está mal, que es el peor tipo de error que encontrar en una revisión.
4. Vuelos más baratos con K escalas como máximo
La pregunta. La ruta más barata del origen al destino con como mucho K escalas intermedias.
Esta es la pregunta que atrapa a la gente, porque el Dijkstra simple es incorrecto aquí. Su corrección se basa en que un vértice tiene una única etiqueta definitiva, pero con un límite de escalas un vértice tiene un mejor coste distinto para cada número de escalas usadas, y una ruta barata que gasta demasiados saltos puede ser peor que una cara y corta. Fijar un vértice una sola vez descarta justo la alternativa que necesitas.
Dos respuestas correctas, y conocer ambas es la clave.
Amplía el estado. Mantén Dijkstra, pero haz que el vértice sea un par (node, stops_used). La etiqueta ahora es definitiva por par, así que el invariante vuelve a cumplirse.
def cheapest(adj, src, dst, K, n):
    best = [[float('inf')] * (K + 2) for _ in range(n)]
    best[src][0] = 0
    heap = [(0, src, 0)]                     # (coste, nodo, escalas)
    while heap:
        c, u, k = heapq.heappop(heap)
        if u == dst: return c                # la primera extracción de dst es óptima
        if k > K or c > best[u][k]: continue
        for v, w in adj[u]:
            if c + w < best[v][k + 1]:
                best[v][k + 1] = c + w
                heapq.heappush(heap, (c + w, v, k + 1))
    return -1
O usa Bellman-Ford, que es la respuesta más limpia. Relajar cada arista exactamente K + 1 veces, cada ronda a partir de una copia de la ronda anterior, da directamente la ruta más barata con como mucho K + 1 aristas. Es la formulación de Bellman de 1958, y cuesta O(K × E) sin ningún montículo. Ofrecerla sin que te la pidan causa muy buena impresión.
La trampa. La versión de Bellman-Ford debe relajar a partir de una copia de las distancias de la ronda anterior. Relajar en el sitio deja que una sola ronda se propague por varias aristas, lo que en silencio permite más de K escalas y devuelve una respuesta demasiado barata que parece plausible.
5. Camino de mínimo esfuerzo: sustituir la suma
La pregunta. Minimiza la arista individual más grande de la ruta en lugar del total. Formulaciones: camino de mínimo esfuerzo, nadar con el agua subiendo, el peso máximo que debes poder cargar.
La idea clave es que Dijkstra nunca necesitó realmente la suma. Necesita que alargar un camino no pueda mejorar su coste, para que una etiqueta fijada siga siendo definitiva. max cumple eso igual de bien que +, así que cambia una línea:
        cand = max(d, w)          # en lugar de d + w
        if cand < best[v]:
            best[v] = cand
            heapq.heappush(heap, (cand, v))
En el grafo de ejemplo, los valores minimax desde el vértice 0 son 0, 2, 1, 5, 5, 5, así que el mejor cuello de botella hasta el vértice 5 es 5: probar todas las rutas lo confirma. Que es un objetivo realmente distinto se ve en las dos rutas más baratas, que cuestan 12 ambas pero tienen arcos máximos de 5 y 7. Minimizar el total y minimizar el arco más grande no son la misma pregunta, y en general la ruta óptima en cuello de botella no tiene por qué ser una ruta más corta.
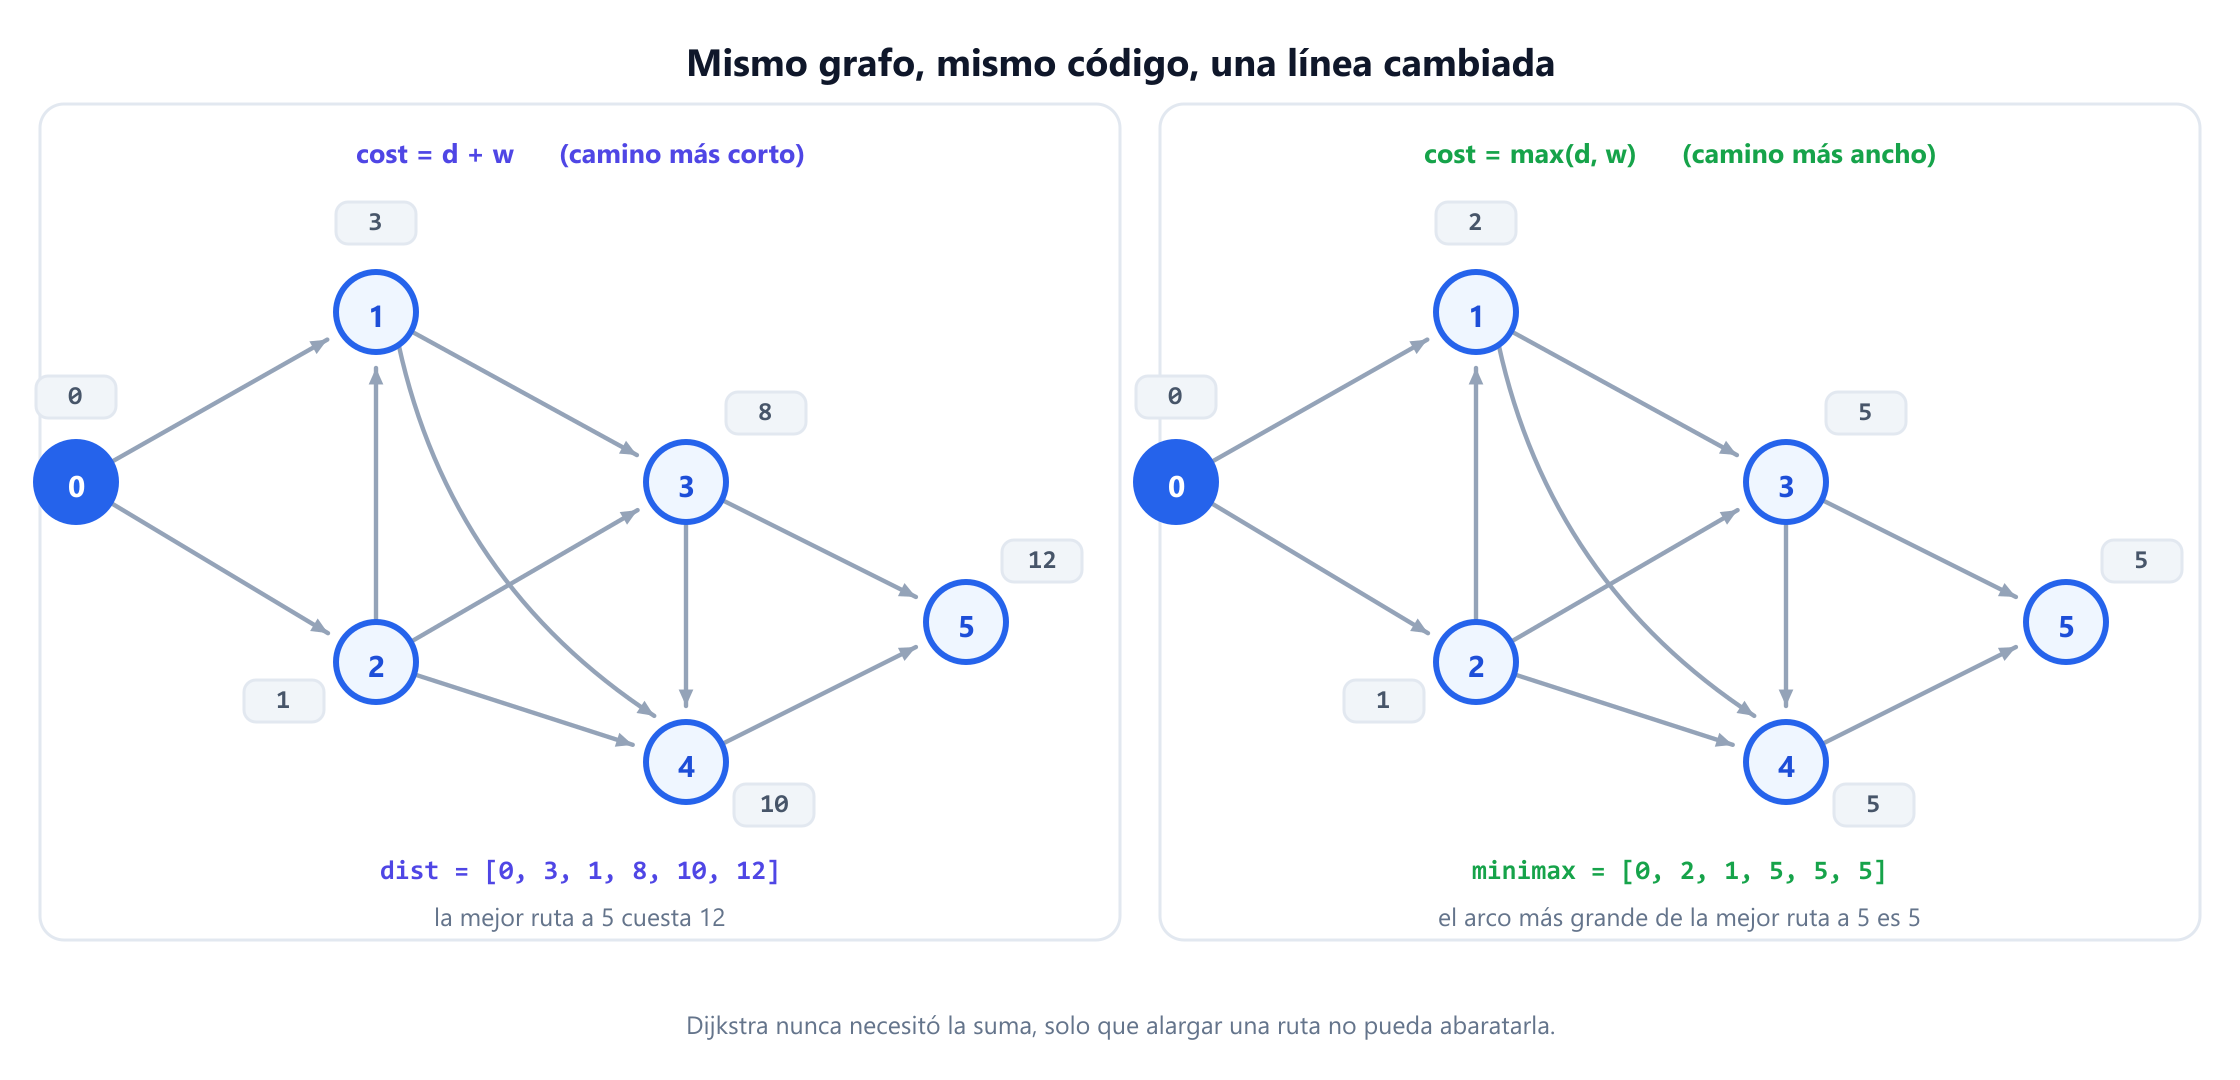
+ por max convierte el camino más corto en el camino más ancho.El seguimiento: ¿qué más puede sustituir a la suma? Cualquier operación monótona, es decir, en la que alargar un camino nunca reduce su coste. max funciona, la multiplicación de probabilidades en [0,1] funciona si maximizas, y la suma ordinaria de pesos no negativos funciona. La resta no, y es por la misma razón por la que se prohíben las aristas negativas.
La trampa. En una versión en cuadrícula también se acepta una solución con union-find o con búsqueda binaria más BFS, que a veces es más rápida. Si ofreces Dijkstra, prepárate para decir por qué lo elegiste: no hay parámetro sobre el que hacer búsqueda binaria y basta una pasada.
6. Camino de máxima probabilidad
La pregunta. Cada arista tiene una probabilidad de éxito; encuentra la ruta del origen al destino con la mayor probabilidad de que todas las aristas tengan éxito.
Los costes se multiplican en lugar de sumarse, y quieres el producto más grande, así que conviertes la cola en un montículo de máximos y relajas con ×. Las probabilidades están en [0,1], así que alargar un camino solo puede reducir el producto, que es exactamente la monotonía que Dijkstra necesita.
        cand = p * pw                     # en lugar de d + w
        if cand > best[v]:                # > porque maximizamos
            best[v] = cand
            heapq.heappush(heap, (-cand, v))   # negar: heapq es un montículo de MÍNIMOS
En un grafo con un arco directo de 0,30 de 0 a 3 y la ruta de dos arcos 0 → 1 → 3 con 0,9 y 0,8, la mejor probabilidad es 0.72 por la ruta de dos arcos, que supera al arco único. Esa es la frase que hay que decir: aquí más aristas pueden ser mejores, algo que nunca ocurre en los caminos más cortos ordinarios con pesos positivos.
El seguimiento: ¿por qué no usar logaritmos? Puedes, y es una buena respuesta. Como log(ab) = log a + log b, maximizar un producto de probabilidades equivale a minimizar una suma de -log p, que son no negativos, así que se aplica Dijkstra sin cambios. Menciona la salvedad: el log en coma flotante de una probabilidad cercana a cero pierde precisión, y una arista de probabilidad 0 da un infinito que tienes que tratar aparte.
7. Contar caminos más cortos
La pregunta. ¿Cuántas rutas más cortas distintas hay del origen al destino? Normalmente se pide módulo 109+7.
Un array extra y una rama extra. Junto a dist mantén ways, el número de rutas más cortas hasta cada vértice. Cuando una relajación mejora una etiqueta, el conteo se sustituye. Cuando empata, el conteo se suma.
        if d + w < dist[v]:
            dist[v] = d + w
            ways[v] = ways[u]              # estrictamente mejor: sustituir
            heapq.heappush(heap, (dist[v], v))
        elif d + w == dist[v]:
            ways[v] = (ways[v] + ways[u]) % MOD   # empate: SUMAR
En el grafo de ejemplo, los conteos son 1, 1, 1, 1, 2, 2. La fuerza bruta coincide: de las 9 rutas de 0 a 5, dos cuestan 12, que son 0→2→1→3→4→5 y 0→2→1→4→5. Fíjate en que la ruta más corta en número de aristas no es la única mejor, justo el tipo de detalle que conviene señalar.
El seguimiento: ¿es segura la rama del empate? Lo es, pero solo porque ways[u] es definitivo cuando u se extrae, y toda relajación se hace desde un vértice extraído. Sumar conteos desde un vértice que no se ha fijado contaría de más. Es el ejemplo más claro de por qué «fijado significa definitivo» es el invariante que importa, no el código.
La trampa. Olvidar que el elif debe ir en la igualdad, no dentro de la rama de mejora. Escrito como un único if d + w <= dist[v], los conteos se sustituyen en los empates en lugar de sumarse, y la respuesta es 1 para todos los vértices.
8. El segundo camino más corto
La pregunta. Encuentra la segunda ruta más corta del origen al destino. Aclara de inmediato si «segunda» significa estrictamente más larga que la mejor o simplemente la siguiente ruta de una lista en la que los empates cuentan por separado. Las dos respuestas difieren y los entrevistadores lo preguntan a propósito.
La técnica consiste en relajar la regla de fijar una sola vez: guarda las dos mejores etiquetas de cada vértice y deja que un vértice se extraiga dos veces.
best1 = [inf] * n; best2 = [inf] * n
best1[src] = 0
heap = [(0, src)]
while heap:
    d, u = heapq.heappop(heap)
    if d > best2[u]: continue          # peor que las dos etiquetas que guardamos
    for v, w in adj[u]:
        nd = d + w
        if nd < best1[v]:
            best1[v], nd = nd, best1[v]     # degradar el antiguo mejor a candidato
            heapq.heappush(heap, (best1[v], v))   # el NUEVO mejor también debe propagarse
        if best1[v] < nd < best2[v]:        # estrictamente peor que el mejor
            best2[v] = nd
            heapq.heappush(heap, (nd, v))
En el grafo de ejemplo, los costes de ruta distintos de 0 a 5 son 12, 13, 14, 15, así que el segundo mejor en sentido estricto es 13. Si en cambio los empates cuentan por separado, la respuesta vuelve a ser 12, porque dos rutas distintas la alcanzan. Pregunta antes de programar.
El seguimiento: generaliza a K. Guarda una lista de las K mejores etiquetas por vértice, o usa el algoritmo de Yen para los K caminos más cortos sin ciclos, que es un problema realmente distinto y mucho más pesado. Decir «sin ciclos lo cambia todo» es el instinto correcto: sin esa restricción, un recorrido más corto puede repetir para siempre un ciclo de peso cero.
9. Por qué los pesos no negativos no son negociables
Todos los entrevistadores lo preguntan, y la mayoría de los candidatos responde «porque Dijkstra es voraz», lo cual es cierto y no explica nada. La razón precisa: el algoritmo supone que, cuando un vértice se extrae con la menor etiqueta de la cola, ninguna ruta aún en construcción puede llegar a él más barato. Una arista negativa lo rompe, porque alargar un camino puede reducir su coste.
Ten preparado un contraejemplo concreto. Toma cuatro vértices con los arcos 0→1 (1), 0→2 (2), 2→1 (−2) y 1→3 (1).
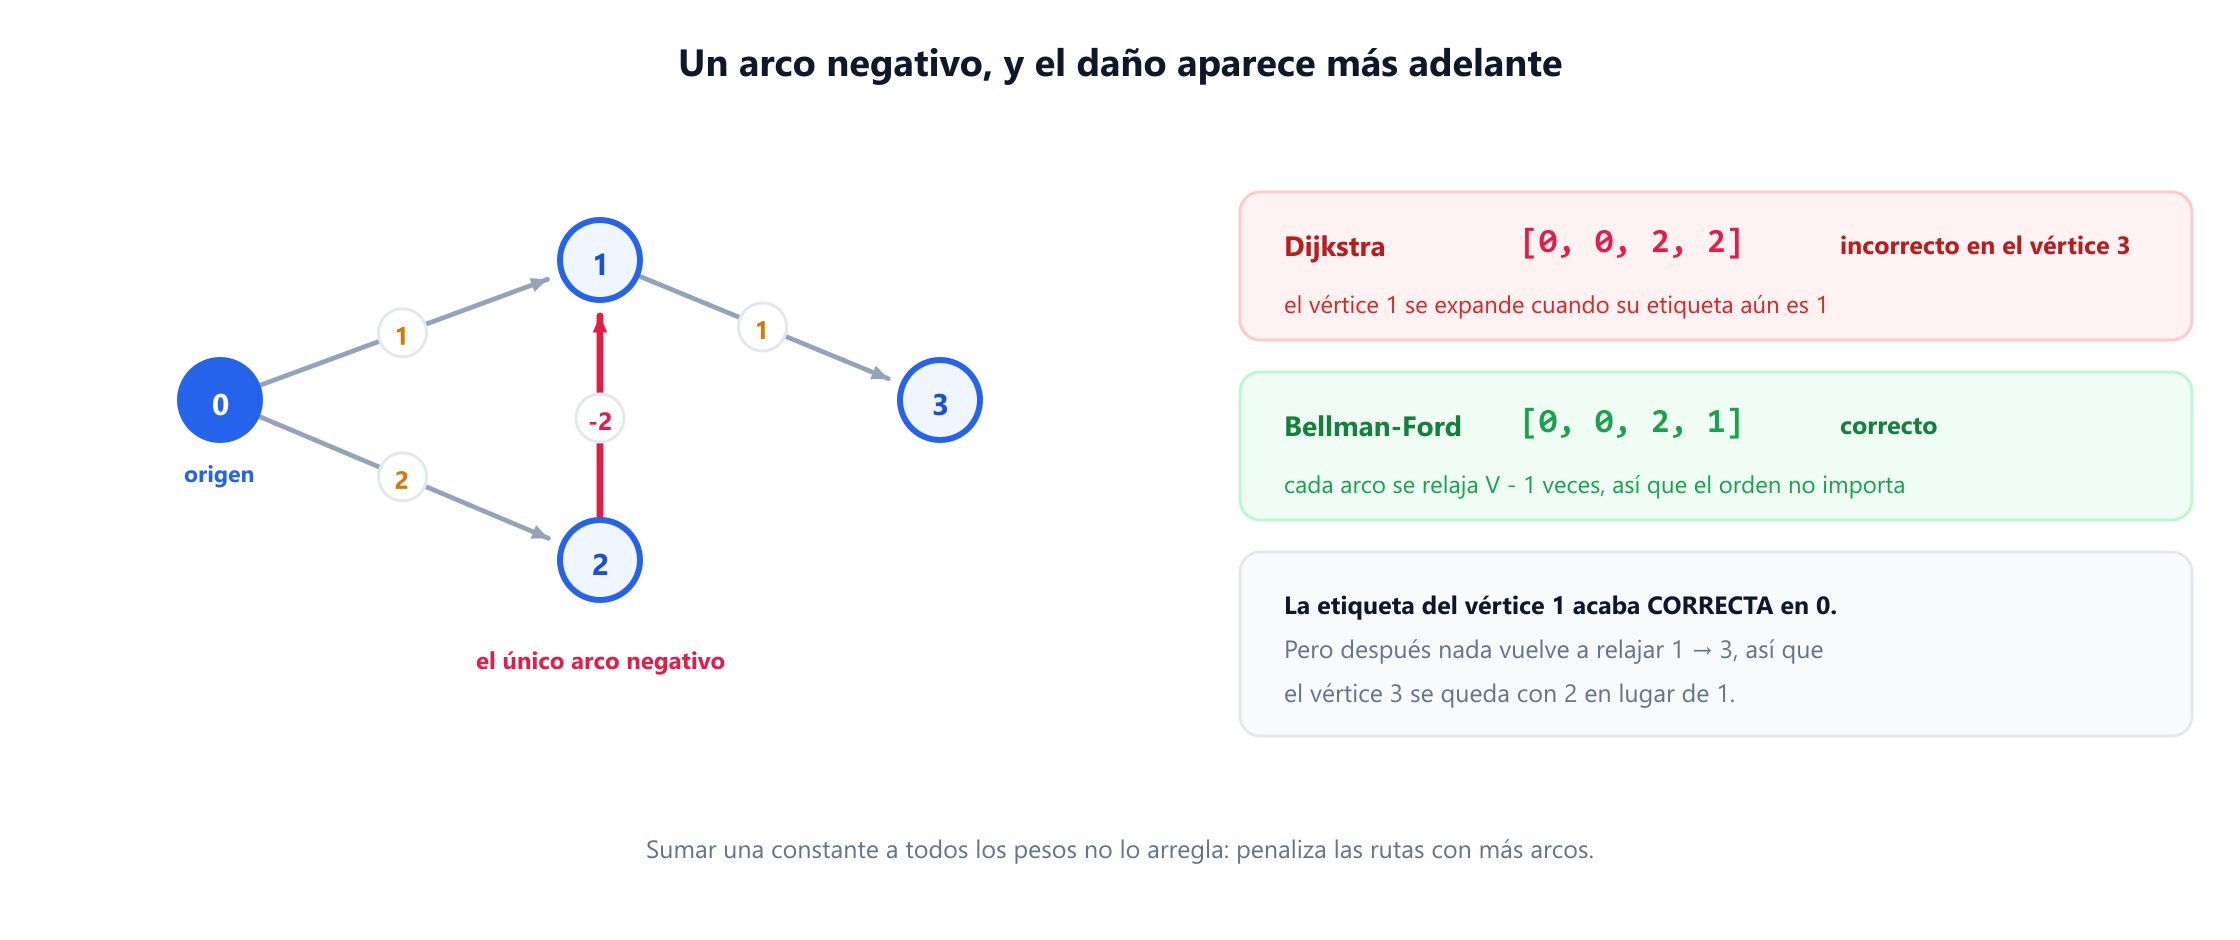
Dijkstra devuelve 0, 0, 2, 2; la respuesta correcta es 0, 0, 2, 1. Vale la pena precisar la sutileza, porque es más interesante que la respuesta habitual: la etiqueta del vértice 1 acaba siendo correcta. Se expande cuando su etiqueta aún es 1, y la mejora posterior a 0 sí se escribe. Pero después nada vuelve a relajar 1 → 3, así que el vértice 3 se queda con 2 en lugar de 1. Un candidato que dice «el valor incorrecto aparece después de la arista negativa, no en ella» demuestra claramente que lo ha probado.
El seguimiento: ¿qué usas en su lugar? Bellman-Ford, que relaja cada arista V - 1 veces en O(VE) y detecta ciclos negativos en la pasada número V. Si necesitas todos los pares y hay aristas negativas pero ningún ciclo negativo, el algoritmo de Johnson repondera con una ejecución de Bellman-Ford para que todos los pesos pasen a ser no negativos y luego ejecuta Dijkstra desde cada vértice. Cormen, Leiserson, Rivest y Stein dan la prueba completa de corrección de la elección voraz.
La trampa. «Basta con sumar una constante a cada peso para que sean positivos.» No funciona, y poder decir por qué en una frase es una señal fuerte: sumar c a cada arista suma c × (number of edges) a una ruta, lo que penaliza las rutas con más aristas y, por tanto, cambia cuál es la más corta.
10. Las respuestas de complejidad
Ten preparadas la cota y la razón, y nombra la estructura de datos. Decir «Dijkstra es O(E log V)» sin nombrar el montículo invita a una pregunta de seguimiento que luego no sabrás responder.
| Cola de prioridad | Tiempo | La razón que debes dar |
|---|---|---|
| Montículo binario, borrado perezoso | O((V + E) log V) | Hasta E entradas insertadas, cada extracción e inserción es logarítmica |
| Montículo de Fibonacci | O(E + V log V) | decrease-key es O(1) amortizado, así que las aristas no cuestan ningún logaritmo |
| Array sin ordenar | O(V2 + E) | Buscar el mínimo en cada ronda; lo mejor en grafos densos |
| Espacio, cualquier variante | O(V + E) | El grafo, más un montículo que nunca supera E entradas |
La cota basada en montículo es el resultado de Johnson de 1977; la mejora con montículos de Fibonacci es de Fredman y Tarjan, 1987. El montículo binario en sí es la construcción de Williams de 1964. La variante de Fibonacci es mejor en teoría y casi siempre más lenta en la práctica, porque sus constantes son grandes, y decirlo demuestra criterio en lugar de memoria. Sedgewick y Wayne ofrecen la explicación clara más breve de la alternativa con cola de prioridad indexada, que sí admite decrease-key.
Dos números que conviene tener. En un grafo disperso con V = 105 y E = 5 × 10⁵, la cota del montículo binario sale en unos 10 millones de operaciones frente a unos 2,2 millones con el montículo de Fibonacci: una diferencia real sobre el papel que las constantes borran en la práctica. Y en un grafo denso donde E se acerca a V2, el array simple en O(V2) supera al O(V2 log V) del montículo binario, que es el único caso en que la implementación «ingenua» es la decisión correcta.
11. Errores que suspenden la entrevista
Ordenados por frecuencia; los tres primeros explican la mayoría de las soluciones rechazadas.
- Omitir la comprobación de entradas obsoletas. Sin
if d > dist[u]: continuevuelves a expandir vértices desde etiquetas obsoletas. La respuesta suele seguir saliendo bien y el tiempo de ejecución se degrada mucho, por eso sobrevive a las pruebas. - Usar Dijkstra cuando el estado no es solo el vértice. Un límite de escalas, un presupuesto de combustible o una cláusula de «como mucho K descuentos» significa que la etiqueta es por par
(vertex, resource). Fijar solo el vértice descarta la ruta que necesitabas. - Recurrir a Dijkstra con pesos negativos. Usa Bellman-Ford y nunca intentes desplazar los pesos a positivos.
- Olvidar que
heapqes un montículo de mínimos. Maximizar cualquier cosa implica insertar la clave negada, y olvidar la segunda negación al sacarla es el clásico error silencioso. - Comparar tuplas que contienen un segundo elemento no ordenable.
heappush(heap, (dist, node_object))lanza una excepción en cuanto dos distancias empatan y Python pasa a comparar los objetos. Inserta un índice o añade un contador de desempate. - Asignar el puntero al padre fuera de la rama de mejora. Las distancias siguen siendo correctas y el camino reconstruido está mal.
- Sustituir los conteos en un empate en lugar de sumarlos. Un
<=donde iban<y==, y todos los conteos de caminos más cortos pasan a ser 1. - Dar una cota sin la estructura de datos. Montículo binario, montículo de Fibonacci y array dan tres respuestas distintas, y el entrevistador quiere saber que lo sabes.
- No preguntar por la entrada. ¿Dirigido? ¿Pesos no negativos? ¿Puede ser inalcanzable el destino? ¿Hay aristas paralelas con pesos distintos? Cada respuesta cambia el código, y la observación de Skiena se cumple: los problemas se ganan en el modelado.
El hábito que evita la mayoría de estos errores: antes de escribir, di qué significa la etiqueta y por qué alargar una ruta nunca puede mejorarla. Si no puedes decir esa frase, el problema no es de Dijkstra, y acabas de ahorrarte veinte minutos. McDowell defiende lo mismo para los problemas de entrevista en general.
12. Preguntas frecuentes
¿Por qué Dijkstra no puede manejar pesos negativos?
+
Porque supone que, una vez que un vértice se extrae con la menor etiqueta de la cola, ninguna ruta aún en construcción puede llegar a él más barato. Una arista negativa lo rompe, ya que alargar un camino puede reducir su coste. En el ejemplo de cuatro vértices con arcos 0 a 1 de peso 1, 0 a 2 de peso 2, 2 a 1 de peso menos 2 y 1 a 3 de peso 1, Dijkstra devuelve 0, 0, 2, 2 cuando lo correcto es 0, 0, 2, 1. Usa Bellman-Ford en su lugar.
¿Qué es el borrado perezoso y por qué lo necesito?
+
Un montículo binario no tiene un decrease-key eficiente, así que en lugar de actualizar la entrada de un vértice insertas otra con la mejor etiqueta e ignoras la entrada obsoleta cuando sale. La guarda es una línea: si la distancia extraída supera la mejor actual de ese vértice, sáltala. El coste es que el montículo puede contener hasta E entradas en lugar de V, y por eso la cota es O((V + E) log V).
¿Puedo usar Dijkstra cuando el camino tiene un límite de aristas?
+
No tal cual, porque un vértice ya no tiene una única etiqueta definitiva: su mejor coste cambia según el número de saltos usados. O amplías el estado para que la cola contenga pares de vértice y saltos usados, lo que restaura el invariante, o usas Bellman-Ford y relajas cada arista exactamente K más una veces a partir de una copia de la ronda anterior. La segunda suele ser la respuesta más limpia.
¿Con qué puedo sustituir la suma?
+
Por cualquier cosa monótona, es decir, en la que alargar una ruta nunca reduce su coste. Usar el máximo en lugar de la suma resuelve problemas de cuello de botella o de mínimo esfuerzo. Multiplicar probabilidades entre cero y uno y maximizar también funciona, y equivale a minimizar la suma de logaritmos negativos. La resta es justo lo que falla, por la misma razón por la que se prohíben las aristas negativas.
¿Cómo cuento el número de caminos más cortos?
+
Lleva un segundo array con el número de rutas más cortas hasta cada vértice. Cuando una relajación mejora estrictamente una etiqueta, sustituye ese conteo por el del predecesor. Cuando empata exactamente con la etiqueta existente, suma en su lugar el conteo del predecesor. Solo es correcto porque el conteo de un vértice es definitivo cuando se extrae, y toda relajación se hace desde un vértice extraído.
¿Dijkstra o A* en una entrevista?
+
A* es Dijkstra con una heurística añadida a la prioridad, la formulación de 1968 de Hart, Nilsson y Raphael, y se reduce a Dijkstra cuando esa heurística es cero. Recurre a él solo cuando hay un único destino y una heurística admisible de verdad, como la distancia en línea recta en un mapa o una cuadrícula. Sin ella no hay nada que guíe la búsqueda, y ofrecer A* sobre un grafo abstracto indica que estás reconociendo patrones en lugar de pensar.
¿Qué montículo debería decir que usaría?
+
Un montículo binario con borrado perezoso, que da O((V + E) log V), porque es lo que ofrece toda biblioteca estándar y sus constantes son pequeñas. Menciona que un montículo de Fibonacci mejora la cota a O(E + V log V) pero es más lento en la práctica, y que en un grafo denso un simple recorrido de array en O(V al cuadrado) supera a ambos. Nombrar el compromiso importa más que nombrar el más rápido.
13. Referencias
Los artículos que introdujeron estas técnicas y los libros que las analizan, en orden cronológico.
- Bellman, R. (1958). “On a routing problem.” Quarterly of Applied Mathematics, 16(1), 87–90.
- Dijkstra, E. W. (1959). “A note on two problems in connexion with graphs.” Numerische Mathematik, 1, 269–271.
- Williams, J. W. J. (1964). “Algorithm 232: Heapsort.” Communications of the ACM, 7(6), 347–348.
- Hart, P. E., Nilsson, N. J. y Raphael, B. (1968). “A formal basis for the heuristic determination of minimum cost paths.” IEEE Transactions on Systems Science and Cybernetics, 4(2), 100–107.
- Johnson, D. B. (1977). “Efficient algorithms for shortest paths in sparse networks.” Journal of the ACM, 24(1), 1–13.
- Fredman, M. L. y Tarjan, R. E. (1987). “Fibonacci heaps and their uses in improved network optimization algorithms.” Journal of the ACM, 34(3), 596–615.
- Cormen, T. H., Leiserson, C. E., Rivest, R. L. y Stein, C. (2009). Introduction to Algorithms, 3.ª edición, sección 24.3. MIT Press.
- Sedgewick, R. y Wayne, K. (2011). Algorithms, 4.ª edición, sección 4.4. Addison-Wesley.
- McDowell, G. L. (2015). Cracking the Coding Interview, 6.ª edición. CareerCup.
- Skiena, S. S. (2020). The Algorithm Design Manual, 3.ª edición, capítulo 8. Springer.